16GB 显存本地编程 LLM 怎么选:gpt-oss、Gemma 4 12B 与 Qwen3.8
16GB 显存编程先用 gpt-oss-20b(64K 上下文约 12.8 GiB);宽上下文选 Gemma 4 12B,Qwen3.8-27B 需 3-bit 文件加量化 KV。
文章目录
16GB 显存跑本地编程模型,截至 2026 年 10 月 22 日的选择是:先装 gpt-oss-20b,它是候选里唯一由官方写明能在 16GB 内存内运行的模型;需要更长上下文、或者显卡还要留给别的程序时,用 Gemma 4 12B;想要更强的 Qwen,试 Qwen3.8-27B 的 3-bit 文件,并把 KV cache 量化到 q8_0。
和 7 月相比变了三处:Qwen3.8-27B(8 月 5 日发布)取代 Qwen3.6 35B A3B 成为先试的 Qwen;Gemma 4 12B(5 月 23 日发布)在 16GB 显卡上取代 E4B,E4B 留给 8GB 显卡和 16GB 内存的笔记本;专用代码模型从 Qwen2.5-Coder、DeepSeek Coder 换成 Devstral Small 2,但它在 16GB 上只能走短上下文。
能不能装下,不靠“感觉能跑”,而是用两项加起来判断:量化文件大小 + 该上下文长度的 KV cache。下文每个数字都写明是哪个量化文件,计算过程也写出来,可以自己复算。
还有一个坑要先知道:Ollama 在显存低于 24 GiB 时默认只给 4k 上下文,而 Ollama 自己建议编程工具至少用 64000。16GB 显卡不改这个设置,编程助手很快就会“忘记”前面读过的文件。
快速结论:先选路线,不要先排冠军
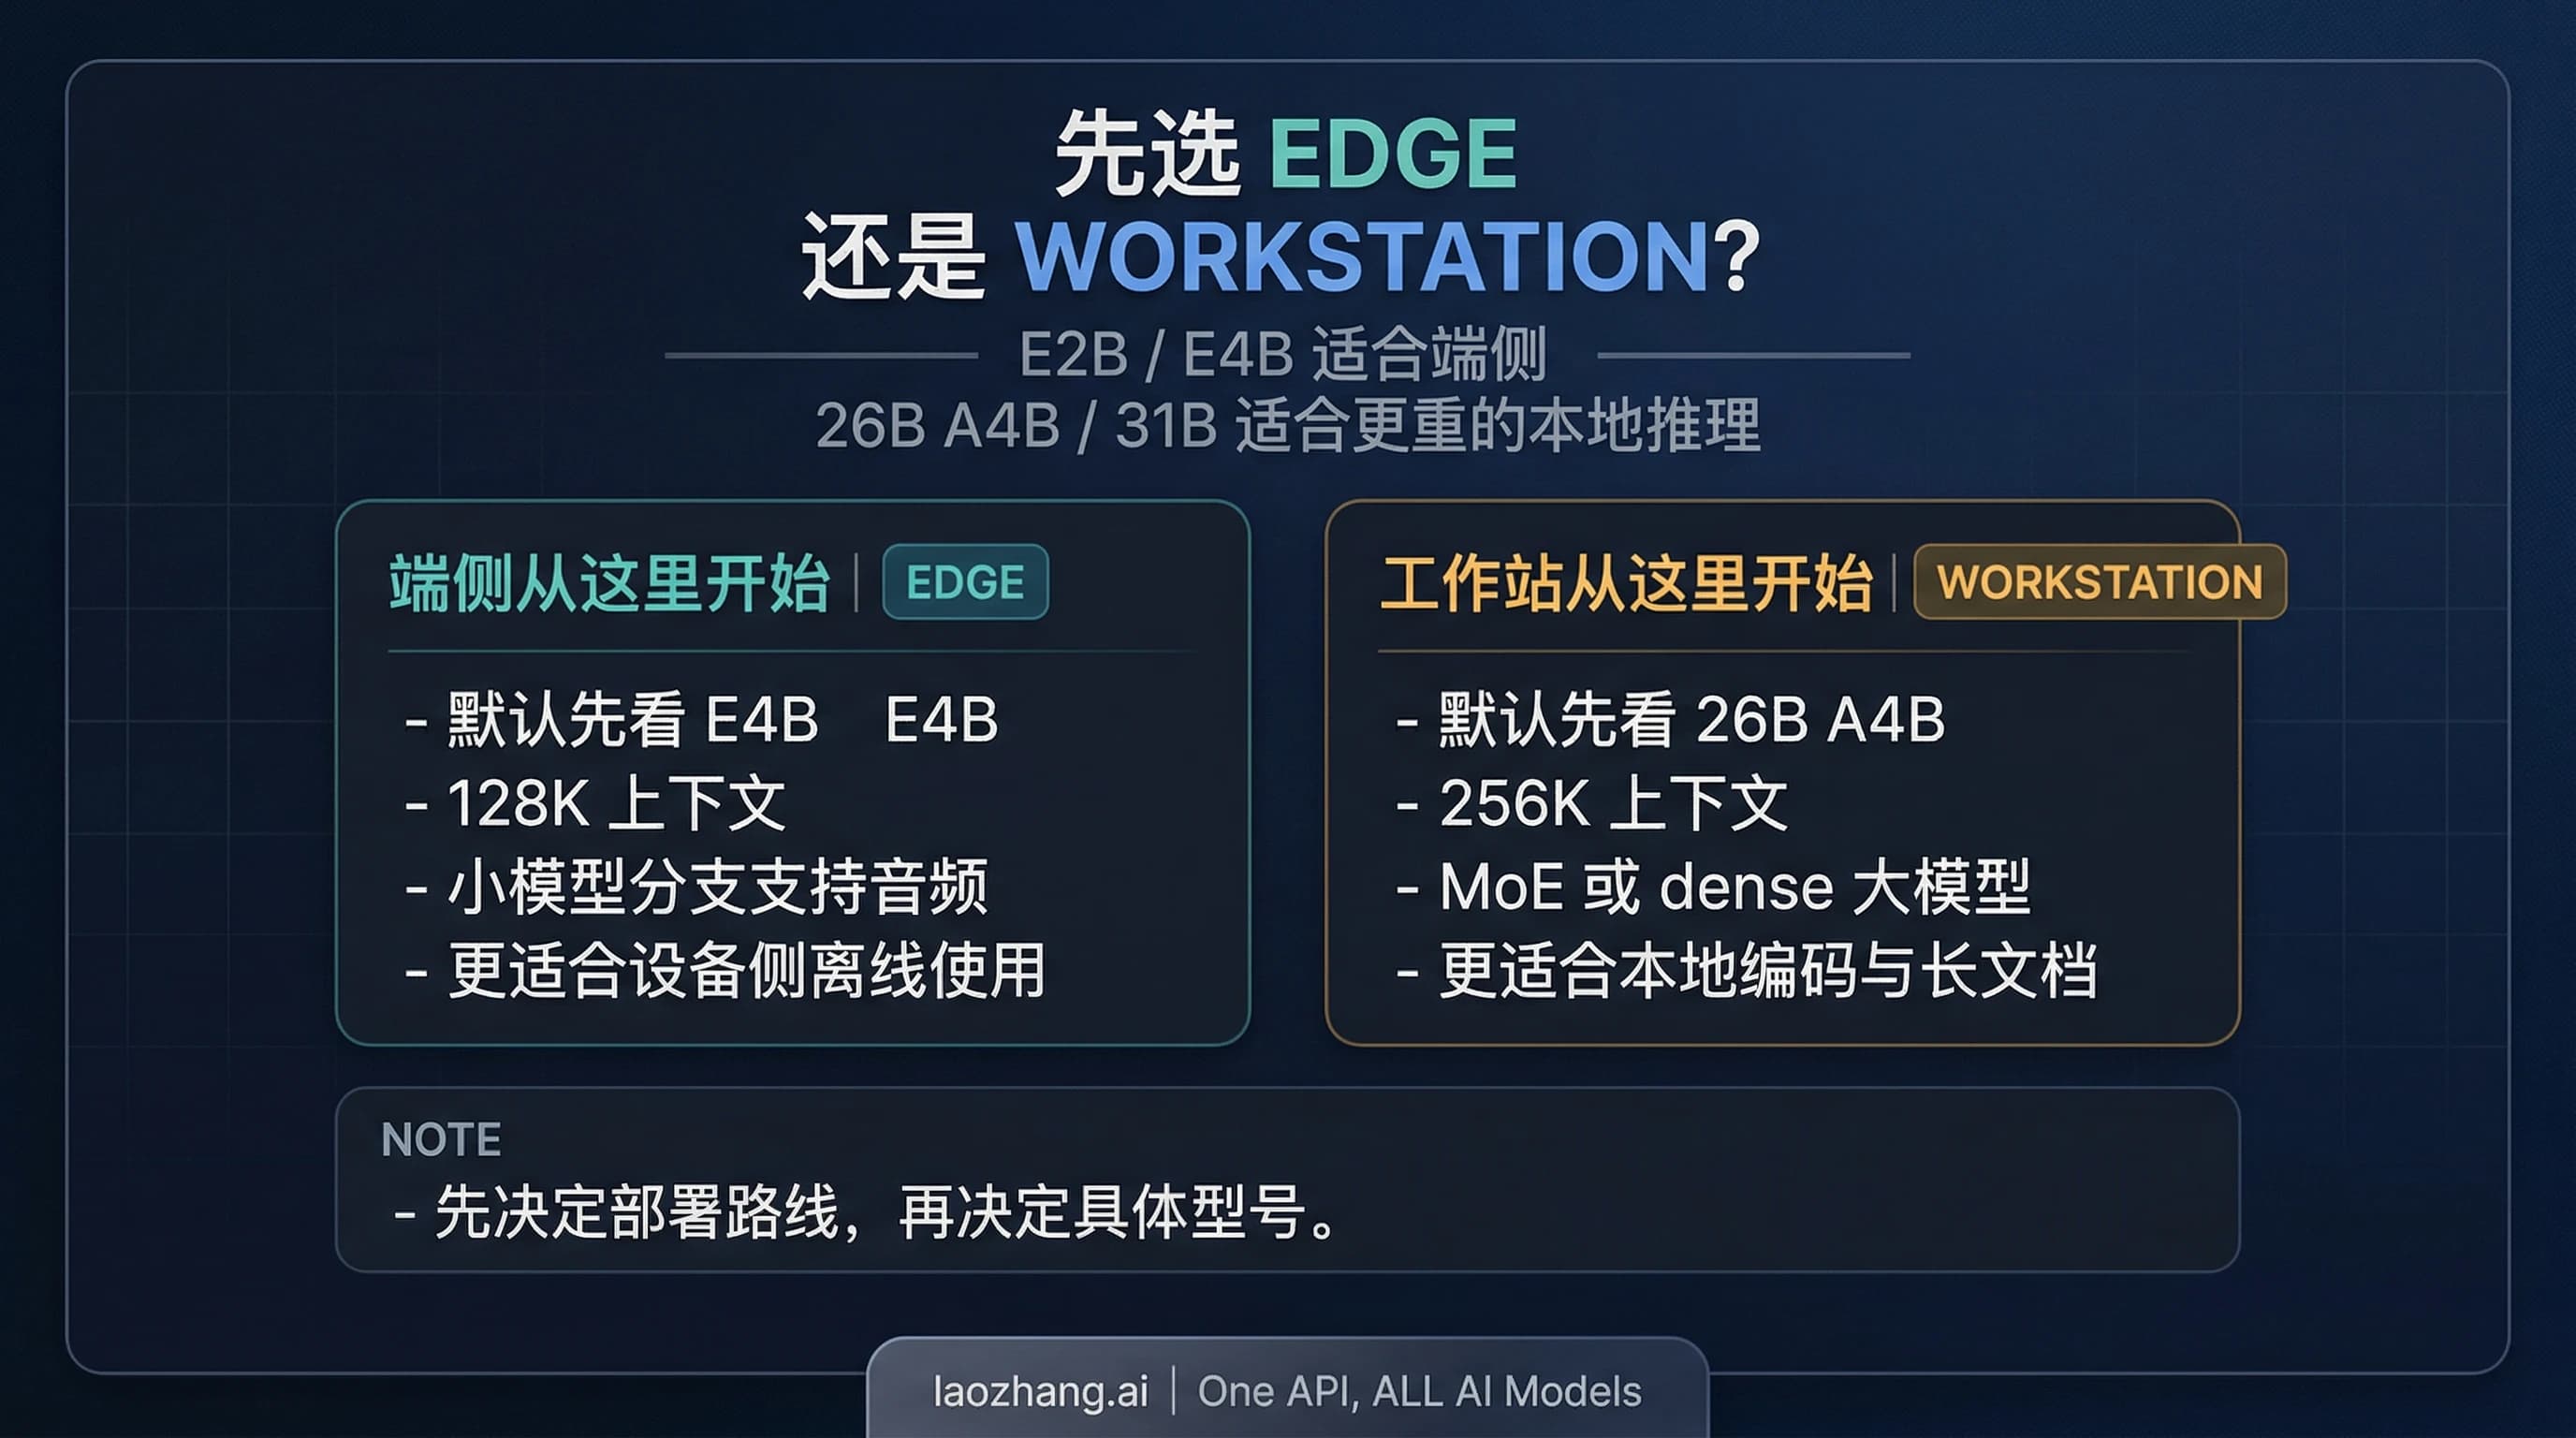
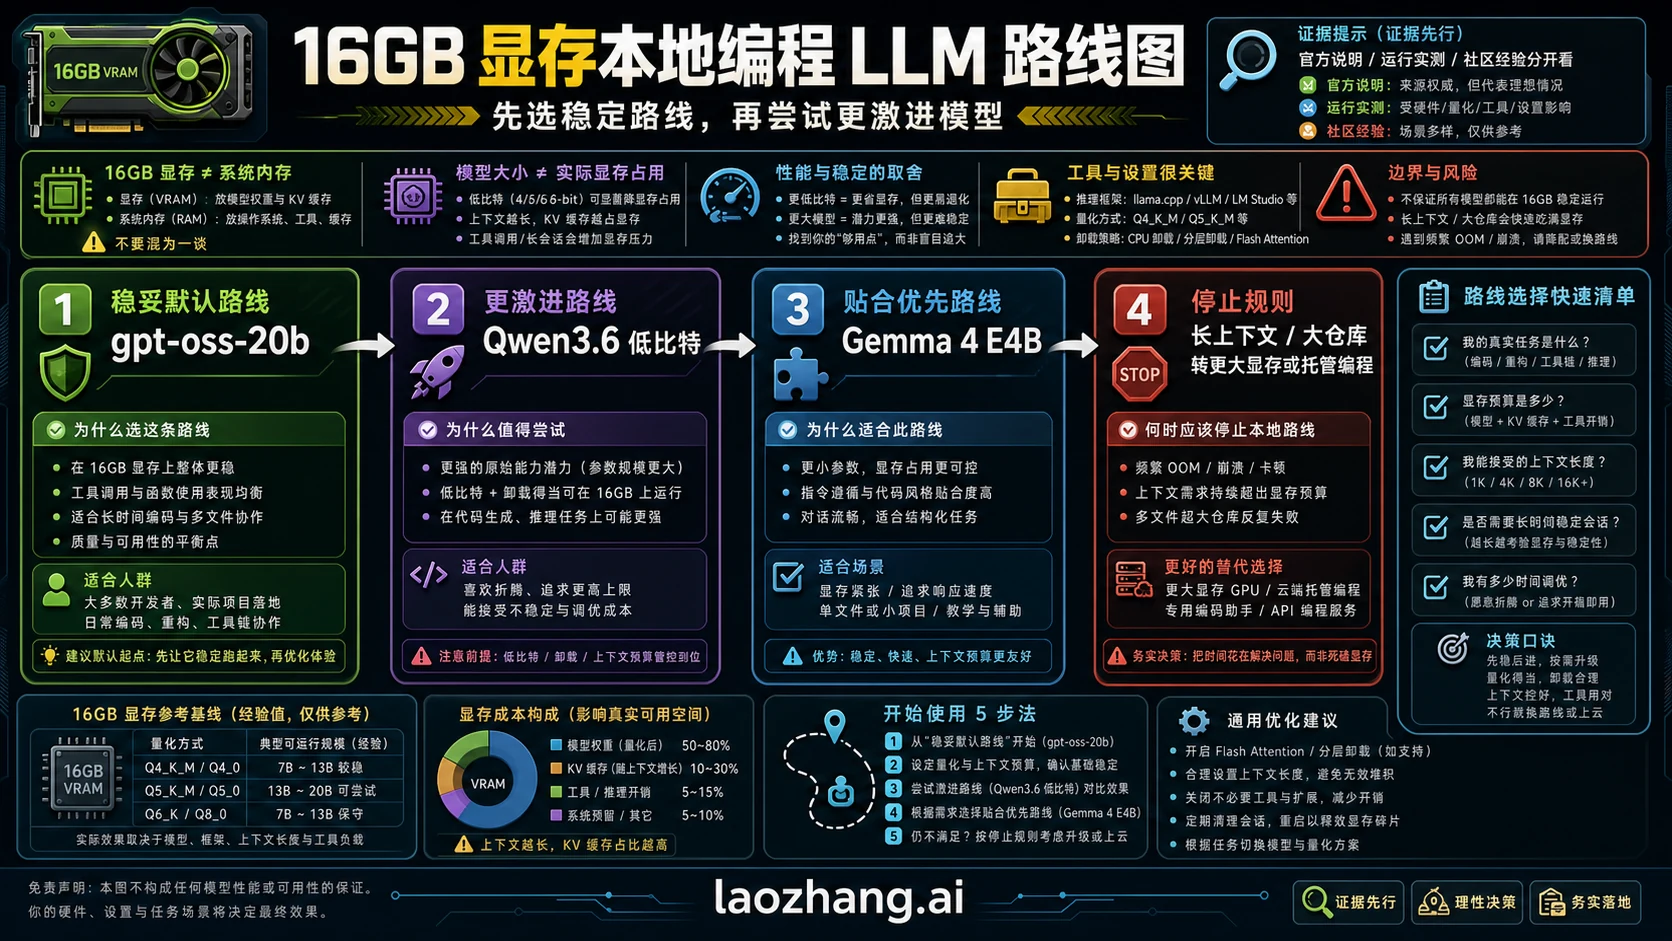
图中是 2026 年 7 月的路线标注(Qwen3.6 低比特、Gemma 4 E4B);当前该先试哪个模型,以下面的表格为准。
16GB 显存没有一个“冠军模型”:同一张卡,能放下多大的模型取决于你要多长的上下文,而编程工具恰恰最需要上下文。所以先按自己的情况选路线,再按失败信号切换。
| 你的情况 | 先试 | 量化文件与大小 | 权重 + KV cache(计算值) | 代价 |
|---|---|---|---|---|
| 第一次搭本地编程助手 | gpt-oss-20b | ggml-org MXFP4 GGUF 12.11 GB(11.28 GiB);Ollama gpt-oss:20b 标注 14 GB | 64K 约 12.8 GiB | 128K 约 14.3 GiB,余量很小 |
| 要长上下文,或显卡还要跑别的 | Gemma 4 12B | Google 官方 QAT Q4_0 GGUF 6.98 GB(6.50 GiB);Ollama gemma4:12b 标注 7.7–8.0 GB | 64K 约 7.8 GiB;128K 约 8.8 GiB | 厂商公布的编程分数低于 Qwen3.8-27B |
| 想要更强的 Qwen,愿意调参 | Qwen3.8-27B | Unsloth UD-Q3_K_XL GGUF 13.15 GB(12.24 GiB) | 32K + q8_0 KV 约 13.3 GiB;64K + q8_0 约 14.4 GiB | 3-bit 社区量化;Ollama 默认 qwen3.8:27b(18 GB)装不下 |
| 短任务、agent 式改代码 | Devstral Small 2 24B | Unsloth Q3_K_M GGUF 11.47 GB(10.69 GiB) | 32K + q8_0 KV 约 13.3 GiB | 每 token 的 KV cache 很重,到不了 64K |
| 系统内存大,能接受卸载到内存 | Qwen3.6 35B A3B | Unsloth UD-Q4_K_M 22.13 GB,配 --n-cpu-moe | 专家权重放系统内存 | 速度受内存带宽限制 |
| 长上下文、多文件代理任务 | 24GB 以上显卡或托管编程 | — | — | 继续在 16GB 上硬调会消耗开发时间 |
表里的“权重 + KV cache”是按模型配置算出来的,没有计入 CUDA/Metal 运行时缓冲区和桌面显示占用,计算方法见下文“16GB 显存真正买到的是什么”。GB 指 10⁹ 字节(Hugging Face 和 Ollama 标注的文件大小),GiB 指 2³⁰ 字节(显存实际按这个算)。
顺序建议:gpt-oss-20b 先在你的仓库上通过烟测,再换 Gemma 4 12B 比上下文,最后才试 Qwen3.8-27B 的 3-bit 文件。这样每一步只改一个变量。
证据边界:官方、运行时和社区不能混用
一个“16GB 能跑”的说法,至少要看清它来自哪一层,四层的分量不同:
官方模型卡说明模型定位和硬件口径。OpenAI 的 gpt-oss-20b 模型卡写的是 “within 16GB of memory”(21B 总参数、3.6B 激活参数、MoE 权重为 MXFP4),这是候选里唯一一条官方 16GB 表述。Google 把 Gemma 4 的 12B、26B A4B、31B 定位为消费级显卡和工作站尺寸,E2B、E4B 定位为手机和边缘设备。Mistral 说 Devstral Small 2 “可以在单张 RTX 4090 或 32GB 内存的 Mac 上运行”,也就是 24GB 显卡口径,不是 16GB。
厂商 benchmark 只说明全精度模型的上限。Qwen3.8-27B 模型卡上的编程分数全面高于 Qwen3.6-27B(例如 SWE-bench Pro 61.7 对 53.5),但其中 SWE-bench Pro 等项目是在 256K 上下文、Claude Code 框架下测的。16GB 显卡逼你用 3-bit 文件和 32K–64K 上下文,这些分数不能直接搬过来。
量化文件决定能不能装下。Google 官方的 Gemma 4 QAT(量化感知训练)文件、ggml-org 的 gpt-oss MXFP4 文件,和 Unsloth 发布的 Qwen3.8、Devstral 社区量化不是一回事:前两者由模型方或运行时维护者发布,后者是第三方量化。文中文件大小取自 Hugging Face 仓库文件列表,截至 2026 年 10 月 22 日。
社区帖子说明大家在什么硬件上试什么,但很多帖子没写量化文件、上下文长度和运行时版本,只能当线索。
还有一层要分清:计算值和实测值。文中所有“能装下”的判断都是按文件大小加 KV cache 算出来的。实际观察只有两项,都在一台 16 GiB 统一内存的 Apple M4 Mac 上:llama.cpp(Homebrew 构建 11429)的 llama-server --help 确实列出了文中用到的参数;llama-cli --list-devices 显示 Metal 可用预算为 12,124 MiB。这台机器上没有下载或运行任何模型,所以文中没有速度、生成质量或实际装载的测试结果。
16GB 显存真正买到的是什么
16GB 显存买到的是“权重 + 上下文”的总预算,模型越大,留给上下文的就越少。显存是 GPU 上的专用内存,不是系统内存,也不是 Mac 的统一内存;超出的部分可以卸载到系统内存,但速度会掉。
编程任务比聊天更吃上下文:文件片段、函数定义、测试失败信息和多轮修改都要留在窗口里。上下文占用的就是 KV cache,它随 token 数线性增长,可以按模型配置自己算:
每 token KV cache(F16)= 全注意力层数 × KV 头数 × head_dim × 2(K 和 V)× 2 字节只算全注意力层,因为滑动窗口层和线性注意力层的缓存有上限或是固定大小。把 KV cache 量化成 q8_0,大约是 F16 的 0.53 倍(每 32 个值占 34 字节)。
| 模型 | 全注意力层配置 | 每 token KV(F16) | 32K | 64K |
|---|---|---|---|---|
| gpt-oss-20b | 12 层 × 8 头 × 64 | 24 KiB | 0.75 GiB | 1.5 GiB |
| Gemma 4 12B | 8 层全局 × 1 头 × 512 | 16 KiB(另加滑动窗口约 0.31 GiB 封顶) | 0.5 GiB | 1 GiB |
| Qwen3.8-27B | 16 层 × 4 头 × 256 | 64 KiB | 2 GiB(q8_0 约 1.06) | 4 GiB(q8_0 约 2.13) |
| Qwen3.6 35B A3B | 10 层 × 2 头 × 256 | 20 KiB | 0.63 GiB | 1.25 GiB |
| Devstral Small 2 | 40 层 × 8 头 × 128 | 160 KiB | 5 GiB(q8_0 约 2.66) | 10 GiB |
把权重文件和 KV cache 加起来,就是下面这张装载表(单位 GiB,都是计算值):
| 量化文件 | 权重 | + 32K | + 64K | + 128K | 16GB 显卡上 |
|---|---|---|---|---|---|
| gpt-oss-20b MXFP4 | 11.28 | 12.0 | 12.8 | 14.3 | 64K 可以,128K 偏紧 |
| Gemma 4 12B QAT Q4_0 | 6.50 | 7.3 | 7.8 | 8.8 | 256K 约 10.8,仍有余量 |
| Qwen3.8-27B UD-Q3_K_XL | 12.24 | 14.2(F16)/ 13.3(q8_0) | 16.2(F16)/ 14.4(q8_0) | — | 必须量化 KV |
| Qwen3.8-27B UD-IQ4_XS | 13.27 | 15.3(F16)/ 14.3(q8_0) | 15.4(q8_0) | — | 只适合 32K |
| Qwen3.8-27B UD-Q4_K_M | 15.33 | — | — | — | 光权重就占满 |
| Devstral Small 2 Q3_K_M | 10.69 | 15.7(F16)/ 13.3(q8_0) | — | — | 32K 要量化 KV |
| Devstral Small 2 IQ4_XS | 11.90 | 16K F16 时 14.4 | — | — | 只适合 16K |
| Qwen3.6 35B A3B UD-IQ3_XXS | 12.30 | 12.9 | 13.6 | 14.8 | 模型卡建议思考模式 ≥128K |
举一个可以复算的例子:Qwen3.8-27B UD-Q3_K_XL 文件 13,146,393,504 字节 ÷ 2³⁰ = 12.24 GiB;32K 上下文 q8_0 缓存 = 32,768 × 64 KiB × 0.53 ≈ 1.06 GiB;合计约 13.3 GiB。
这张表没有计入三样东西:运行时的计算缓冲区和 CUDA/Metal 工作区;桌面显示占用的显存;Qwen3.8 线性注意力层的固定状态。加载视觉投影文件(mmproj)还要再多:Qwen3.8-27B 的 mmproj-F16 约 0.86 GiB。所以计算值越接近 16 GiB,越要以运行时实际报告的显存为准。
常听到的“27B 模型要 24GB 显存起步”,对 Q4_K_M 是对的:Qwen3.8-27B 的 UD-Q4_K_M 文件 16.46 GB(15.33 GiB),光权重就占满 16GB 显卡。换成 3-bit 的 UD-Q3_K_XL、把 KV cache 量化到 q8_0、上下文限制在 32K–64K,才能放进 16GB。这三项都是让步。
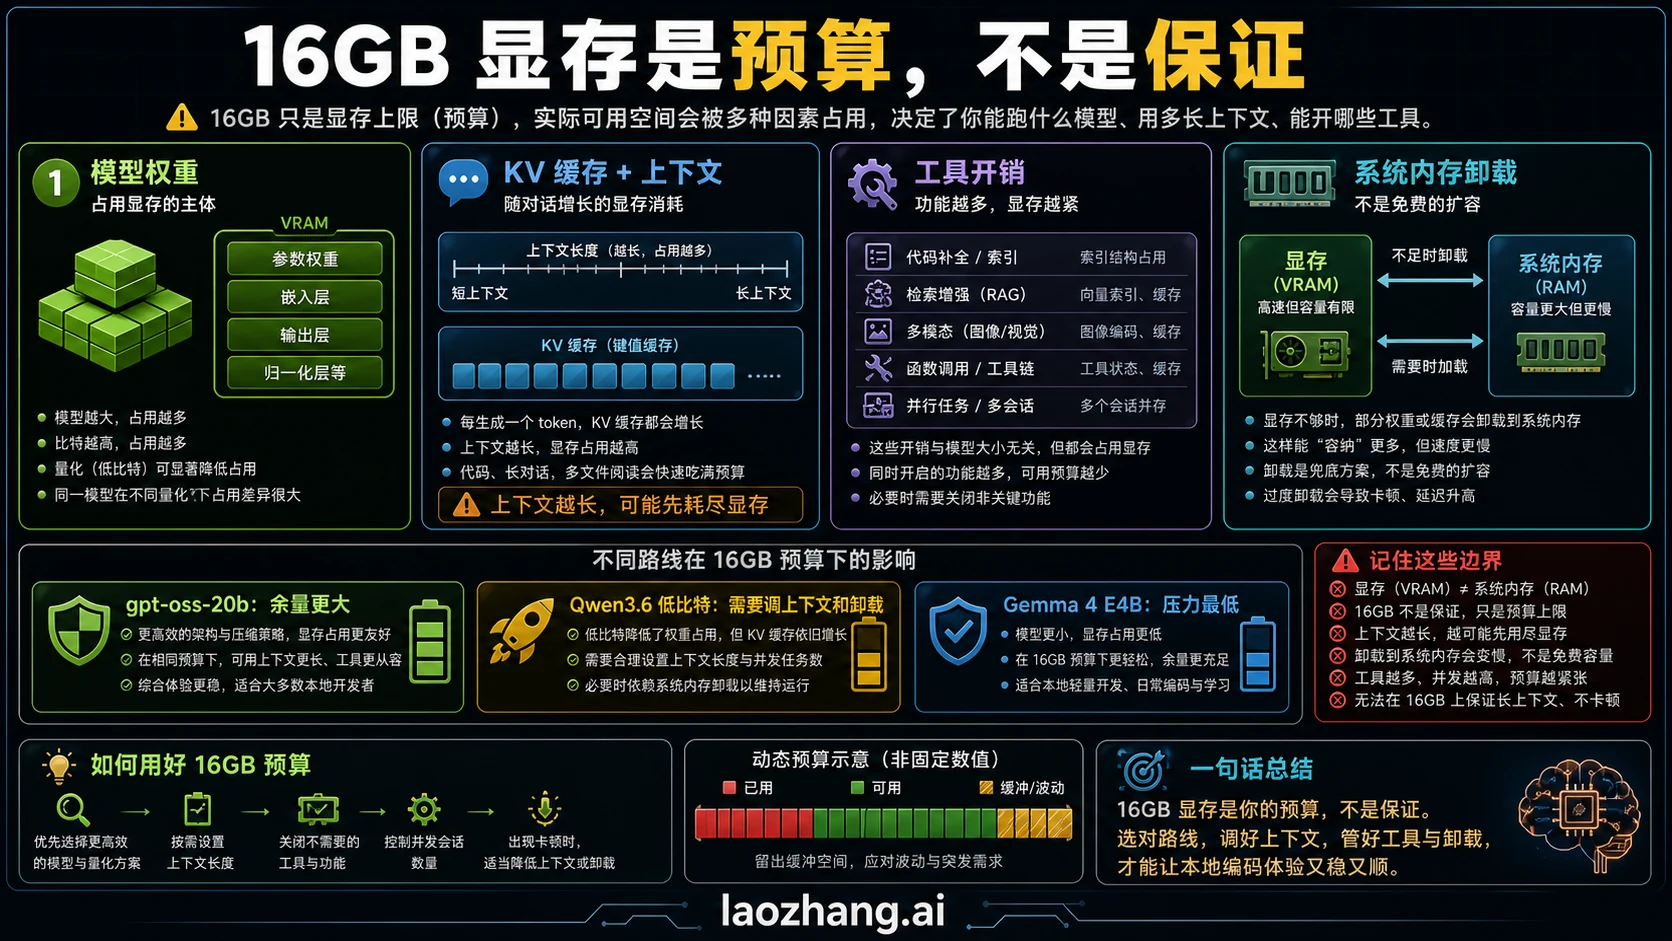
图中是 2026 年 7 月的路线标注(gpt-oss-20b、Qwen3.6 低比特、Gemma 4 E4B);各模型的当前数字以上面的装载表为准。
路线一:把 gpt-oss-20b 当作稳妥起点
gpt-oss-20b 仍然是 16GB 显存的稳妥起点,7 月以后没有被取代。原因有三个:官方模型卡写明 16GB 内存级别;MoE 权重本来就是 MXFP4 训练后格式,ggml-org 的 GGUF 文件 12.11 GB,不需要再挑第三方量化;每 token 的 KV cache 只有 24 KiB,64K 上下文合计约 12.8 GiB,能满足 Ollama 对编程工具的 64000 建议。
截至 2026 年 10 月,OpenAI 在 Hugging Face 上没有发布更新的 gpt-oss 小尺寸模型;2025 年 9 月出的 gpt-oss-safeguard-20b 是安全分类模型,不是编程模型。
用 Ollama 起步时,先把上下文改到 64000,再拉模型:
OLLAMA_CONTEXT_LENGTH=64000 ollama serve
ollama pull gpt-oss:20b
ollama run gpt-oss:20b
另开一个终端运行 ollama ps,看 PROCESSOR 一列:如果出现 CPU 份额,说明有一部分已经卸载到系统内存,速度会下降,这时先把上下文降到 32K 再试。
先不要把整个仓库塞进去。选一个文件、一个相邻测试和一个明确问题,让模型解释函数、给出最小补丁、说明要更新哪个测试。如果这一步已经慢、经常丢上下文,就没必要马上换更大的 Qwen;先检查上下文设置和运行时是否在卸载。能稳定完成小补丁后,再逐步加测试、相邻模块和错误日志。
路线二:Qwen3.6 35B A3B 只能当进阶实验
现在先试的 Qwen 是 Qwen3.8-27B,不是 Qwen3.6 35B A3B。Qwen3.8-27B 是 8 月 5 日发布的稠密模型,原生 262K 上下文,Apache-2.0 许可,Qwen 把它定位为编程和长程 agent 任务;它在 Qwen 自己的编程表上每一项都高于 Qwen3.6-27B。Qwen3.6 35B A3B 仍有用处,但只适合系统内存大、能接受卸载的机器。
现在先试 Qwen3.8-27B 的 3-bit 文件
16GB 显卡上,Qwen3.8-27B 只能用 3-bit 或 IQ4 级别的文件,并且要量化 KV cache。Qwen3.8 在 2B 和 27B 之间没有别的尺寸,所以没有“小一号的 Qwen3.8”可选。
| Unsloth 文件 | 大小 | 16GB 上的用法(计算值) |
|---|---|---|
UD-Q4_K_M(Ollama qwen3.8:27b 默认,标注 18 GB) | 16.46 GB(15.33 GiB) | 装不下 |
| UD-IQ4_XS | 14.25 GB(13.27 GiB) | 32K + q8_0 KV 约 14.3 GiB |
| UD-Q3_K_XL | 13.15 GB(12.24 GiB) | 32K + q8_0 约 13.3 GiB;64K + q8_0 约 14.4 GiB |
| UD-IQ3_XXS | 10.93 GB(10.18 GiB) | 余量最大,但比特数更低 |
用 llama.cpp 起服务时,直接从 Hugging Face 拉指定文件,关掉视觉投影,打开 flash attention 并把 K、V 缓存都设成 q8_0:
llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XL --no-mmproj -c 32768 -ngl 99 -fa on -ctk q8_0 -ctv q8_032K 稳定后再试 -c 65536。用 Ollama 的话,默认标签装不下,要用 ollama run hf.co/unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XL 拉 3-bit 文件;如果运行时用的是 F16 KV cache,64K 时合计约 16.2 GiB,超过 16GB 显卡,上下文要停在 32K(约 14.2 GiB)。
这是调参路线,不是默认路线:3-bit 社区量化的质量损失没有官方数据,厂商分数是在全精度、256K 上下文下测的。值得试的前提是 gpt-oss-20b 已经在你的仓库上通过烟测,而你确实需要更强的结果。32GB 显卡或双卡上的完整配置,看 Qwen3.8-27B 显存指南:RTX 5090 如何选择量化、双卡与 262K 配置。
Qwen3.6 35B A3B 还适合什么
Qwen3.6 35B A3B(4 月 15 日发布)是 35B 总参数、3B 激活参数的 MoE 模型,256 个专家、每次路由 8 个。“A3B”指每个 token 只算 3B 参数,不是只占 3B 的显存:它的 UD-Q4_K_M 文件 22.13 GB,Ollama qwen3.6:35b 标注 23–24 GB,16GB 显卡全放显存装不下。
它仍然适合一种情况:系统内存足够大,愿意把专家权重留在内存里。llama.cpp 的 --n-cpu-moe N 会把前 N 层的 MoE 专家权重放在 CPU 侧,注意力层和共享权重留在显卡上:
llama-server -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_M --no-mmproj -c 131072 -ngl 99 --n-cpu-moe 40 -fa on这个模型共 40 层,--n-cpu-moe 40 表示所有专家都先放内存;显存还有余量时逐步调小 N,把更多层挪回显卡。速度主要受内存带宽限制,需要在自己的机器上测。另一个选择是全放显存的 UD-IQ3_XXS 文件(13.21 GB,即 12.30 GiB),但 Qwen 模型卡建议思考模式保持至少 128K 上下文,那时合计约 14.8 GiB,余量很小。
同尺寸的 Qwen3.6-27B 也已被 Qwen3.8-27B 超过;它的 Ollama 编程标签 qwen3.6:27b-coding 标注 19 GB,同样装不进 16GB。更早的 Qwen3-30B-A3B 和 Qwen3-Coder-30B-A3B 包怎么选,见 Qwen3-30B-A3B 本地部署:版本怎么选、显存怎么估?。
路线三:Gemma 4 E4B 和小型代码模型
在 16GB 显卡上,这条路线现在由 Gemma 4 12B 领头,Gemma 4 E4B 退到 8GB 显卡和 16GB 内存的笔记本。专用代码模型换成 Devstral Small 2,但它在 16GB 上只能跑短上下文。
Gemma 4 12B:16GB 显卡上上下文最宽裕的选择
Gemma 4 12B 是 2026 年 5 月 23 日加入 Gemma 4 的尺寸(3 月首发时只有 E2B、E4B、26B A4B、31B 四个尺寸),11.95B 参数,256K 上下文,Apache-2.0 许可。Google 官方 QAT Q4_0 GGUF 文件只有 6.98 GB(6.50 GiB),64K 上下文合计约 7.8 GiB,128K 约 8.8 GiB,256K 约 10.8 GiB(计算值,按全局层 K、V 分开存储取上限)。
和 E4B 比,Google 公布的 LiveCodeBench v6 是 72.0% 对 52.0%,Codeforces ELO 是 1659 对 940。这是 Google 自己的测试框架,没有 SWE-bench 这类仓库级 agent 测试,所以它说明的是解题能力的差距,不等于改仓库的能力。
ollama pull gemma4:12b它适合三种人:需要把长文件、长日志放进上下文;显卡同时还要跑浏览器、IDE 或其他 GPU 程序;或者 gpt-oss-20b 在你的机器上偏紧。
Gemma 4 E4B 和更小的模型
Gemma 4 E4B 的 QAT Q4_0 文件 5.15 GB(4.80 GiB),另有 0.99 GB 的 mmproj,128K 上下文。在 16GB 显卡上它已经不是最佳选择,但在 8GB 显卡、只有 16GB 内存的笔记本和 Mac 上,它仍是放得下、还有余量的那一个。IBM 8 月 25 日发布的 Granite 4.2 8B(Q4_K_M GGUF 5.35 GB,Apache-2.0)也属于这一档。
Devstral Small 2:专用代码模型,但只能走短上下文
7 月列出的 Qwen2.5-Coder、DeepSeek Coder、Qwen3-Coder-30B-A3B 已经是旧一代了。现在的专用编程候选是 Mistral 的 Devstral Small 2(24B,Apache-2.0,256K 上下文),Mistral 报告的 SWE-bench Verified 为 68.0%。
问题在于 KV cache:它 40 层全是全注意力,每 token 160 KiB,是 gpt-oss-20b 的 6 倍多。Ollama 默认的 devstral-small-2:24b(Q4_K_M,标注 15 GB)加 32K 的 F16 缓存约 18.4 GiB,装不下。16GB 上的可行组合:
- Q3_K_M(11.47 GB)+ 32K q8_0 缓存,约 13.3 GiB;
- IQ4_XS(12.78 GB)+ 16K F16 缓存,约 14.4 GiB。
llama-server -hf unsloth/Devstral-Small-2-24B-Instruct-2512-GGUF:Q3_K_M --no-mmproj -c 32768 -ngl 99 -fa on -ctk q8_0 -ctv q8_0这意味着它到不了 Ollama 建议的 64K,适合任务边界清楚、一次只改一两个文件的 agent 式编程,不适合长会话。
也检查过、但不是首选的
- Gemma 4 26B A4B:QAT Q4_0 文件 14.44 GB(13.45 GiB),另有 1.19 GB 的 mmproj,16GB 显卡上剩给上下文的空间不多;Qwen 在自己的测试框架下给它的 SWE-bench Verified 是 17.4(竞争对手测的,不是 Google 的数据)。
- GLM-4.7-Flash(2026 年 1 月,MIT):Q4_K_M 文件 18.31 GB 装不下,只有 UD-Q3_K_XL(13.78 GB)等 3-bit 文件能放进 16GB。
- Granite 4.2 30B:Q4_K_M 文件 17.72 GB,Q3_K_M 14.13 GB,同样只能用 3-bit。
GLM-5.3-Flash、Qwen3.8-Flash-Next 不是 16GB 级模型
名字里带 Flash 或 Next,不代表能在 16GB 显卡上跑。这三个模型都属于 API 或多卡级别:
| 模型 | 规模 | 官方或量化文件大小 |
|---|---|---|
| GLM-5.3-Flash | MIT 许可 | 官方 FP8 权重约 305.8 GiB |
| Qwen3.8-Flash-Next | 125B 稀疏 MoE,6B 激活 | 官方 BF16 仓库约 360 GB |
| Qwen3-Coder-Next | — | Q4_K_M GGUF 四个分片合计 48.4 GB |
“6B 激活”说的是每个 token 的计算量,不是显存需求,权重仍要全部放得下。想用 GLM-5.3-Flash,先看 GLM-5.3-Flash 选型指南:从 Ox Alpha 到 API 与本地部署;Flash-Next 和 27B 的区别见 Qwen3.8 Flash-Next 对比 27B:本地部署该选谁?。
16GB 内存的笔记本和 Mac:统一内存不等于 16GB 显存
只有 16GB 内存的笔记本或 Mac,可用预算比 16GB 显卡小得多,能稳定用来写代码的是 Gemma 4 12B 以下的模型。
一台 16 GiB 统一内存的 Apple M4 Mac 上,llama.cpp 的 llama-cli --list-devices 报告 MTL0: Apple M4 (12124 MiB, 12123 MiB free),也就是 Metal 能用的预算约 11.84 GiB,剩下的留给系统和其他程序。按这个预算算:
- Gemma 4 12B QAT Q4_0:64K 上下文约 7.8 GiB,还剩约 4 GiB,是这类机器上最合适的编程模型;
- gpt-oss-20b MXFP4:光权重就 11.28 GiB,只剩约 0.56 GiB,连 32K 上下文(0.75 GiB)都放不下;
- Qwen3.8-27B:UD-Q3_K_XL 权重 12.24 GiB,已经超过预算;最小的 UD-IQ3_XXS(10.18 GiB)加 32K q8_0 缓存约 11.24 GiB,只剩 0.6 GiB 左右,不现实;
- Gemma 4 E4B:4.80 GiB,余量最大。
这是预算数字,不是运行结果:这台机器上没有下载或运行模型,调高 macOS GPU 内存上限的做法也没有测试。
没有 16GB 独显、只有 16GB 内存的 Windows 或 Linux 笔记本,模型全部在 CPU 上跑,选 Gemma 4 E4B、Granite 4.2 8B 这一档。带 16GB 显存独显的笔记本,按前面 16GB 显卡的装载表算。
如果是为了在高铁、飞机上离线用,要在出发前把模型文件下载好,并在有网时完成一次烟测;模型文件加载后 Ollama 和 llama.cpp 都在本地推理,不需要联网。
运行时选择:Ollama、LM Studio、llama.cpp 和编辑器包装层
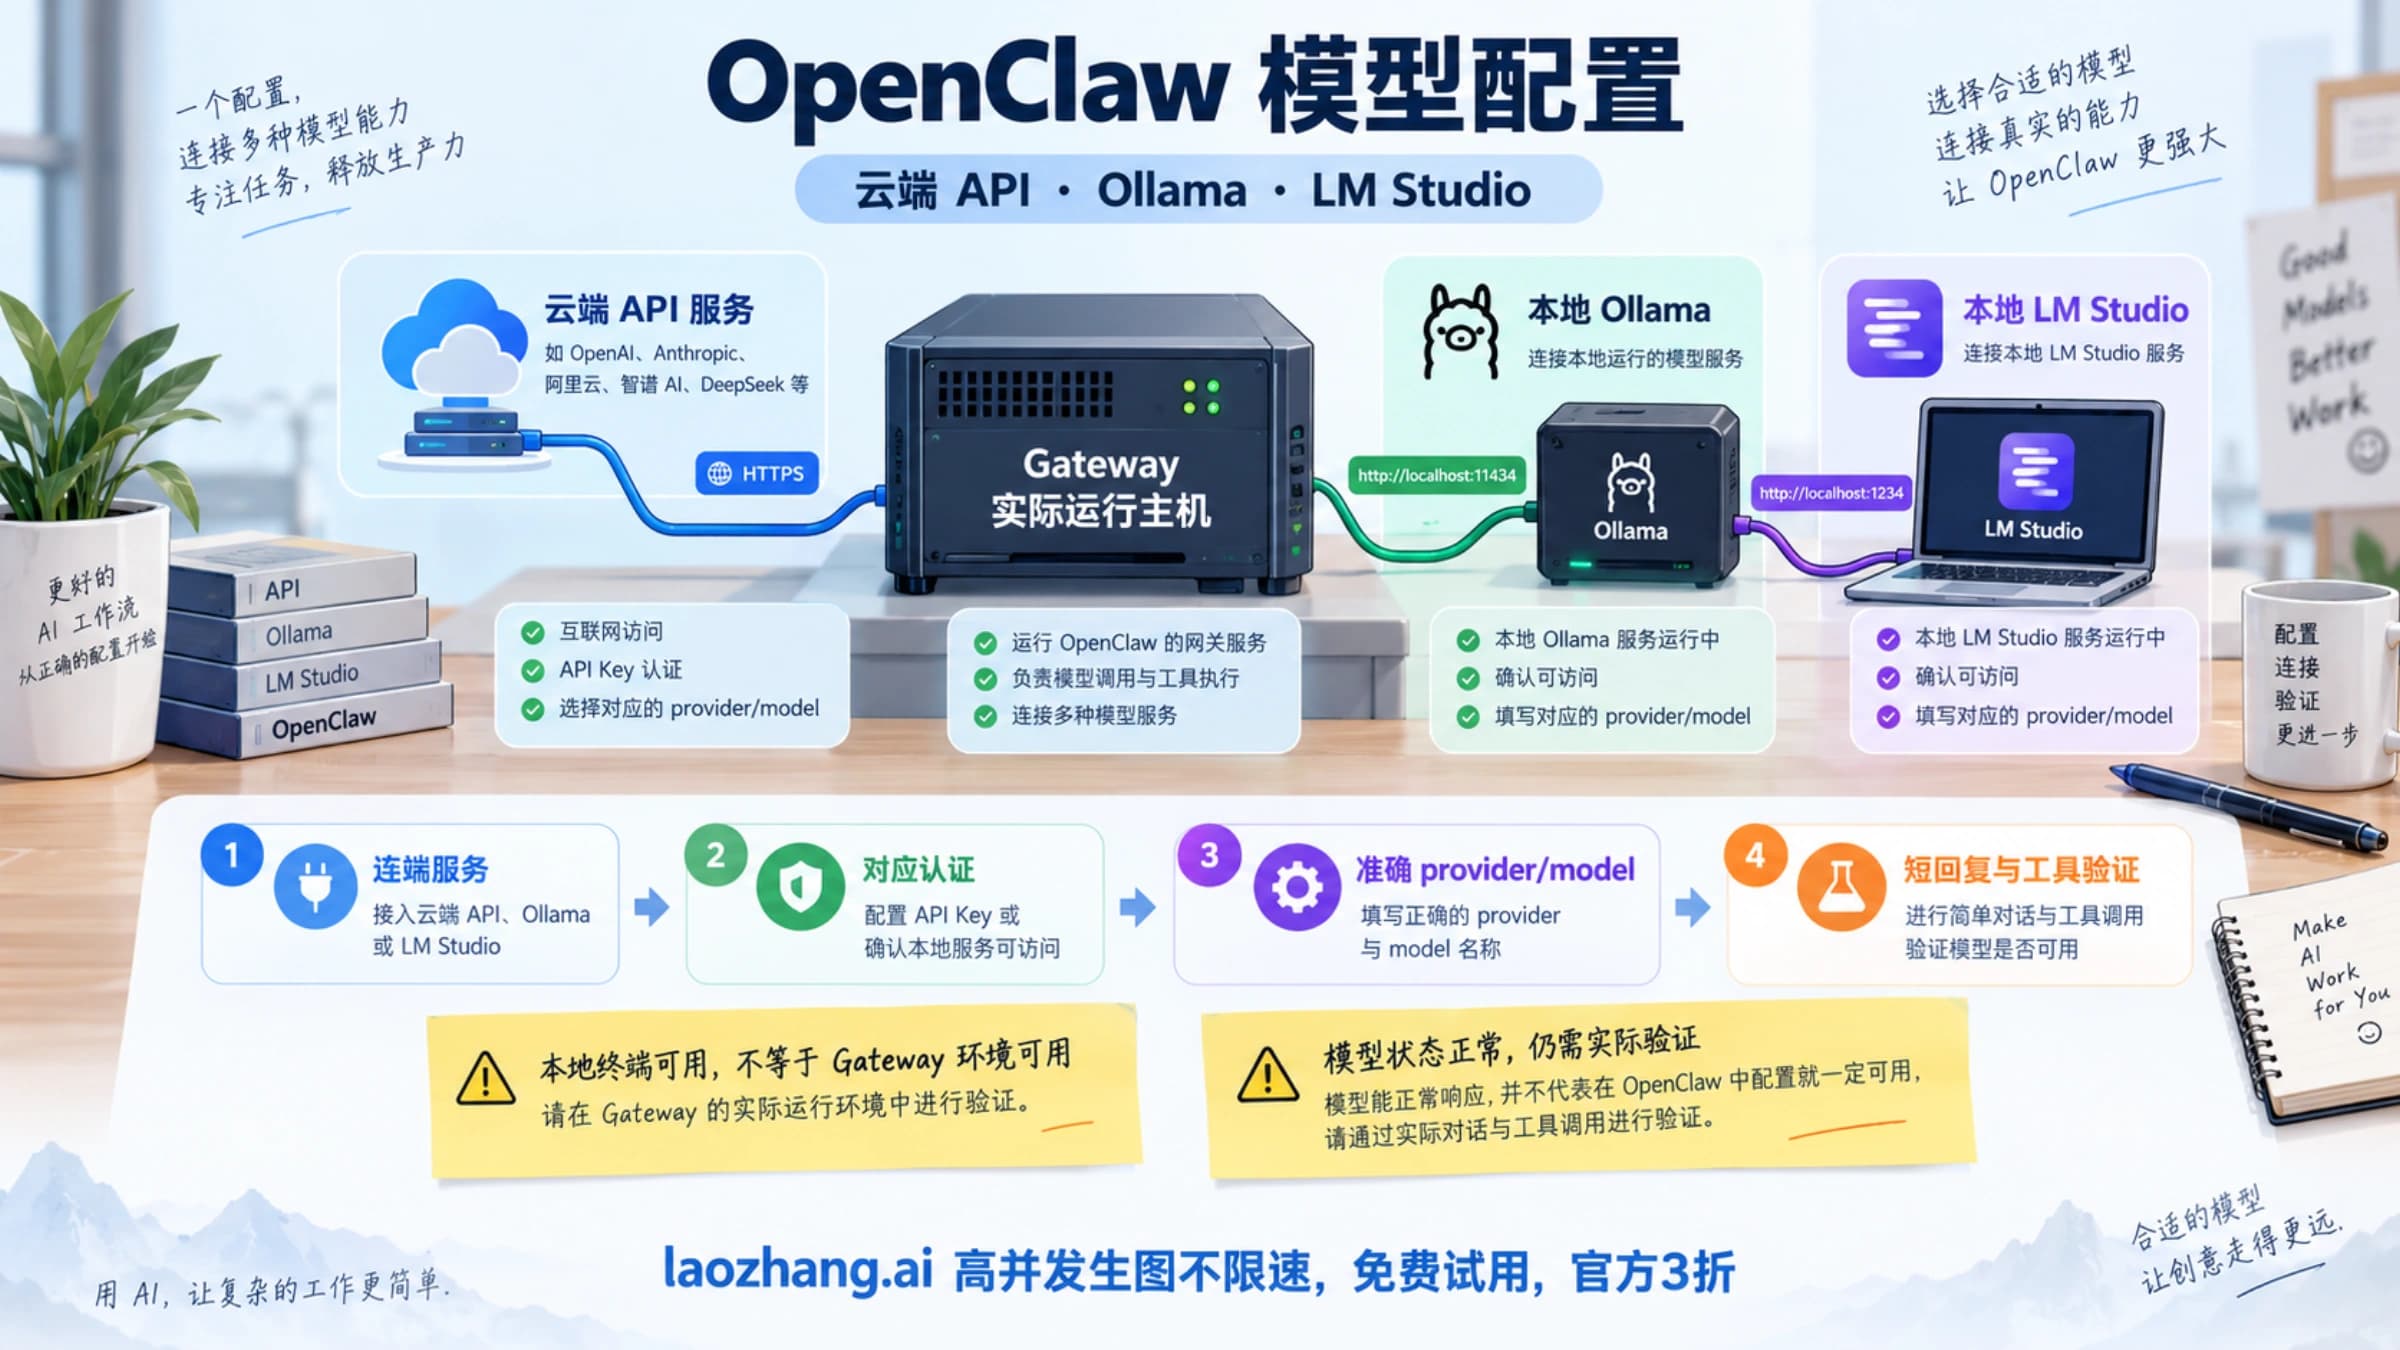
运行时会改变结论:同一个模型名,在不同运行时里可能对应不同的量化文件和不同的上下文默认值。推荐一个模型时,至少要写清楚运行时、文件名和上下文长度。
Ollama 适合快速建立基线,但要先改上下文。Ollama 按显存决定默认上下文:低于 24 GiB 为 4k,24–48 GiB 为 32k,48 GiB 以上为 256k。它建议 agent 和编程工具至少用 64000,可以在应用里拖滑块,也可以用 OLLAMA_CONTEXT_LENGTH=64000 ollama serve 启动。默认标签不合适时(例如 qwen3.8:27b 是 18 GB 的 Q4_K_M),用 ollama run hf.co/{用户}/{仓库}:{量化} 直接拉 Hugging Face 上的指定 GGUF 文件,量化名要和仓库里的文件名一致。
llama.cpp 适合细调。会用到的参数:-c 设上下文,-ngl 设放进显卡的层数,-fa 开 flash attention,-ctk/-ctv 设 K、V 缓存的量化类型,--n-cpu-moe 把 MoE 专家留在内存,-hf user/repo:quant 直接拉文件,--no-mmproj 不加载视觉投影。这些参数都出现在 llama.cpp 构建 11429 的 llama-server --help 里;文中的命令没有在 16GB 显卡上实际运行过,换版本后先用 --help 确认。
LM Studio 适合在图形界面里挑 GGUF 文件、起本地 server。要看的是它最终选中的具体文件名和上下文设置,而不是模型名。
编辑器包装层决定哪些文件被送进本地 endpoint。如果插件把整个工作区打包进 prompt,上下文会比你以为的大得多。包装层隐藏了显存压力时,先回到命令行做烟测,才能分清问题出在模型、上下文还是 IDE 集成。
烟测流程:先证明它能改你的代码
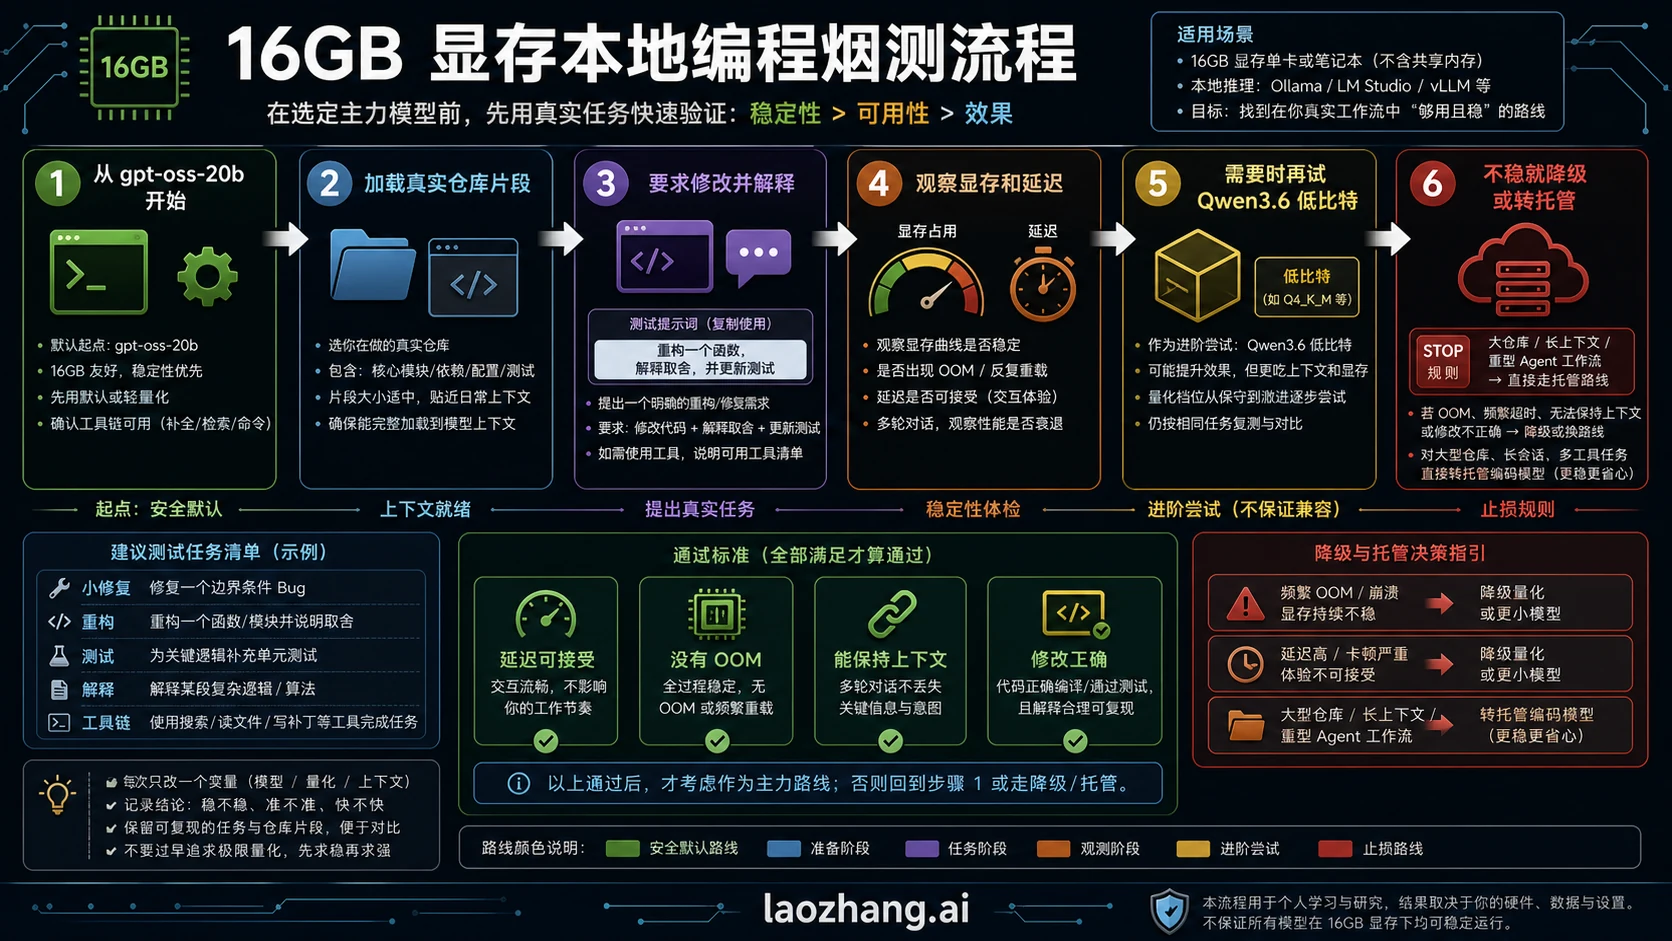
图中是 2026 年 7 月的路线标注(第 5 步写的是 Qwen3.6 低比特);现在的进阶尝试是 Qwen3.8-27B 3-bit 文件,流程本身不变。
本地编程模型能当日常助手,不是因为能启动,而是因为能在你的仓库里通过小工作流。烟测要用你的代码,不要用玩具题。
推荐任务:选一个函数、一个相邻测试、一个明确目标,让模型解释当前逻辑、给出最小补丁、说明取舍,并指出应该更新哪个测试。如果它说上下文不足,答案必须具体到文件或符号。
Given the files below, refactor one function without changing behavior.
Explain the tradeoff, show the patch, and name the test that should be updated.
If the context is insufficient, say exactly what file or symbol you need next.
通过标准有四个:延迟能接受;没有 OOM,也没有意外卸载到内存;模型没有忘记函数和测试约束;补丁小且可以 review。任何一项失败,先调整上下文或换模型,而不是直接宣布哪个模型最好。
顺序是:第一轮用 gpt-oss-20b 建基线;第二轮换 Gemma 4 12B,或把上下文加到 64K;第三轮才试 Qwen3.8-27B 的 3-bit 文件。这个顺序能防止把显存调参误当成模型评估。模型装上了却频繁出错时,按 本地 Coding Agent 失败?先区分量化、上下文还是 Harness 逐项排查。
停止规则:什么时候别再硬调 16GB
停止规则要提前写好。16GB 用户最容易浪费时间的地方,是把一个勉强能加载的模型调到“看起来能跑”,真正改代码时却慢到不可用。
| 症状 | 可能原因 | 更好的做法 |
|---|---|---|
加载后很慢,ollama ps 显示有 CPU 份额 | 权重或 KV cache 卸载到了内存 | 降上下文、换更小的文件或换 Gemma 4 12B |
| 短片段答得好、仓库任务差 | 上下文不够,Ollama 可能还停在默认 4k | 把上下文设到 64000,或缩小任务 |
| 上下文一加就 OOM | KV cache 挤爆预算 | 量化 KV cache、降上下文,或上 24GB 以上显卡 |
| Qwen3.8-27B 3-bit 结果不如 gpt-oss-20b | 低比特损失或上下文被压得太短 | 退回基线,不要继续换更低比特 |
| 补丁循环里丢文件状态 | 代理任务超出 16GB 的舒适区 | 换更大显存或托管编程 |
下一步不一定是买显卡。可以缩小任务、换小模型、固定 prompt 模板、减少工具层,或者把长上下文代理工作交给托管编程环境。目标是更快交付代码,不是证明 16GB 什么都能扛。
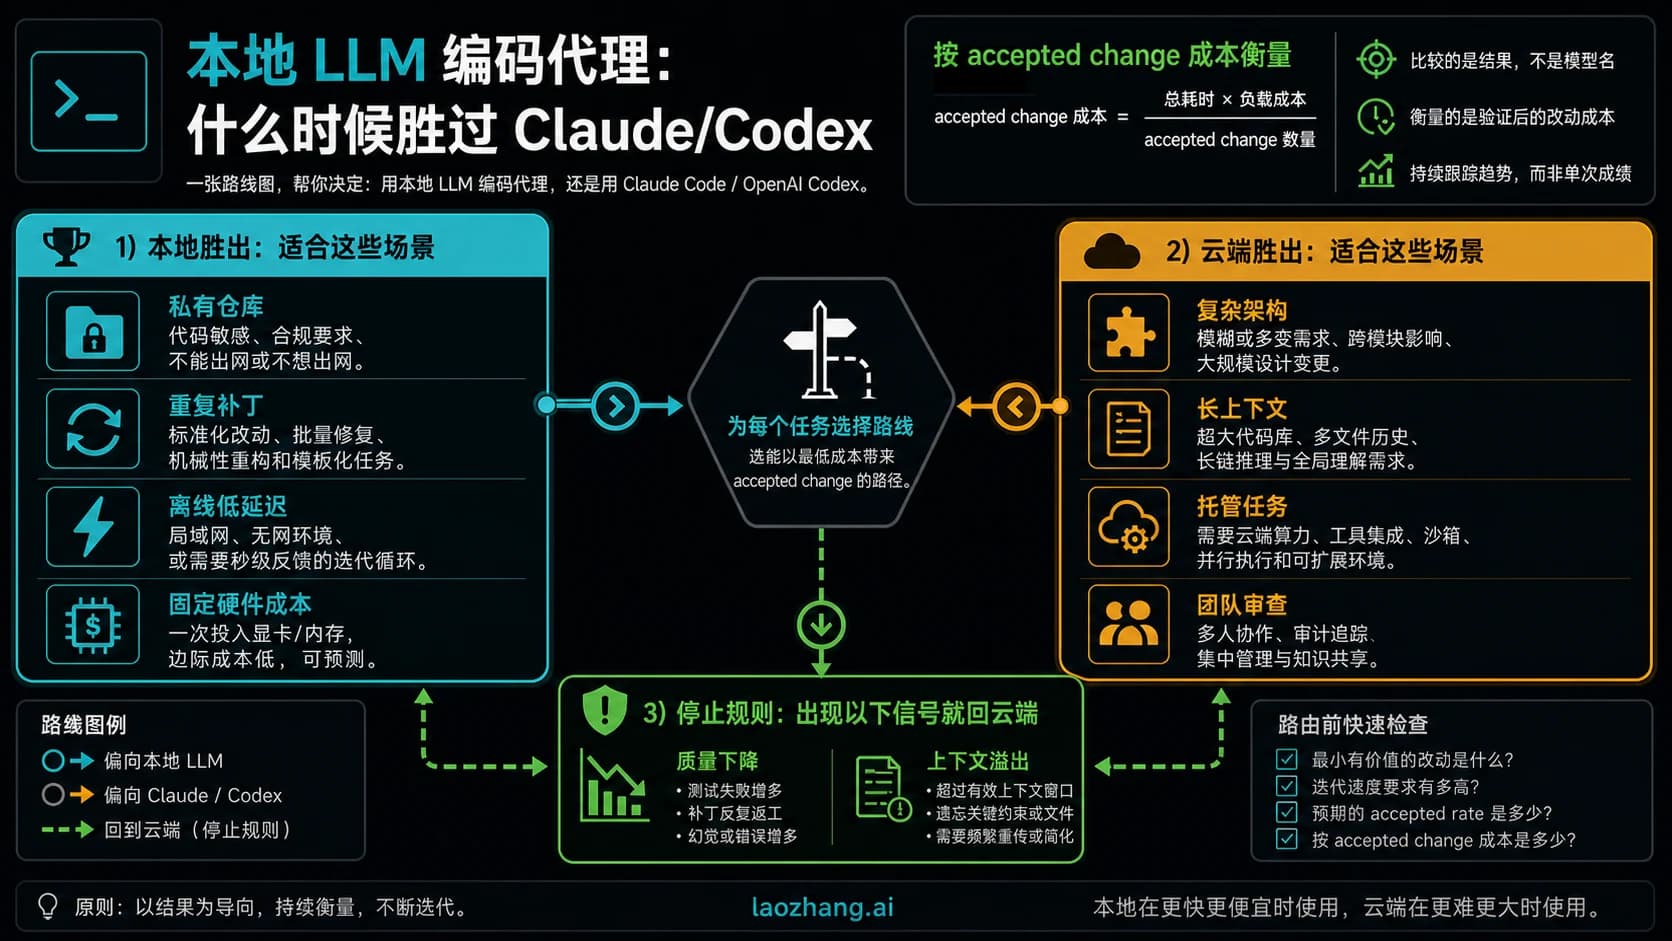
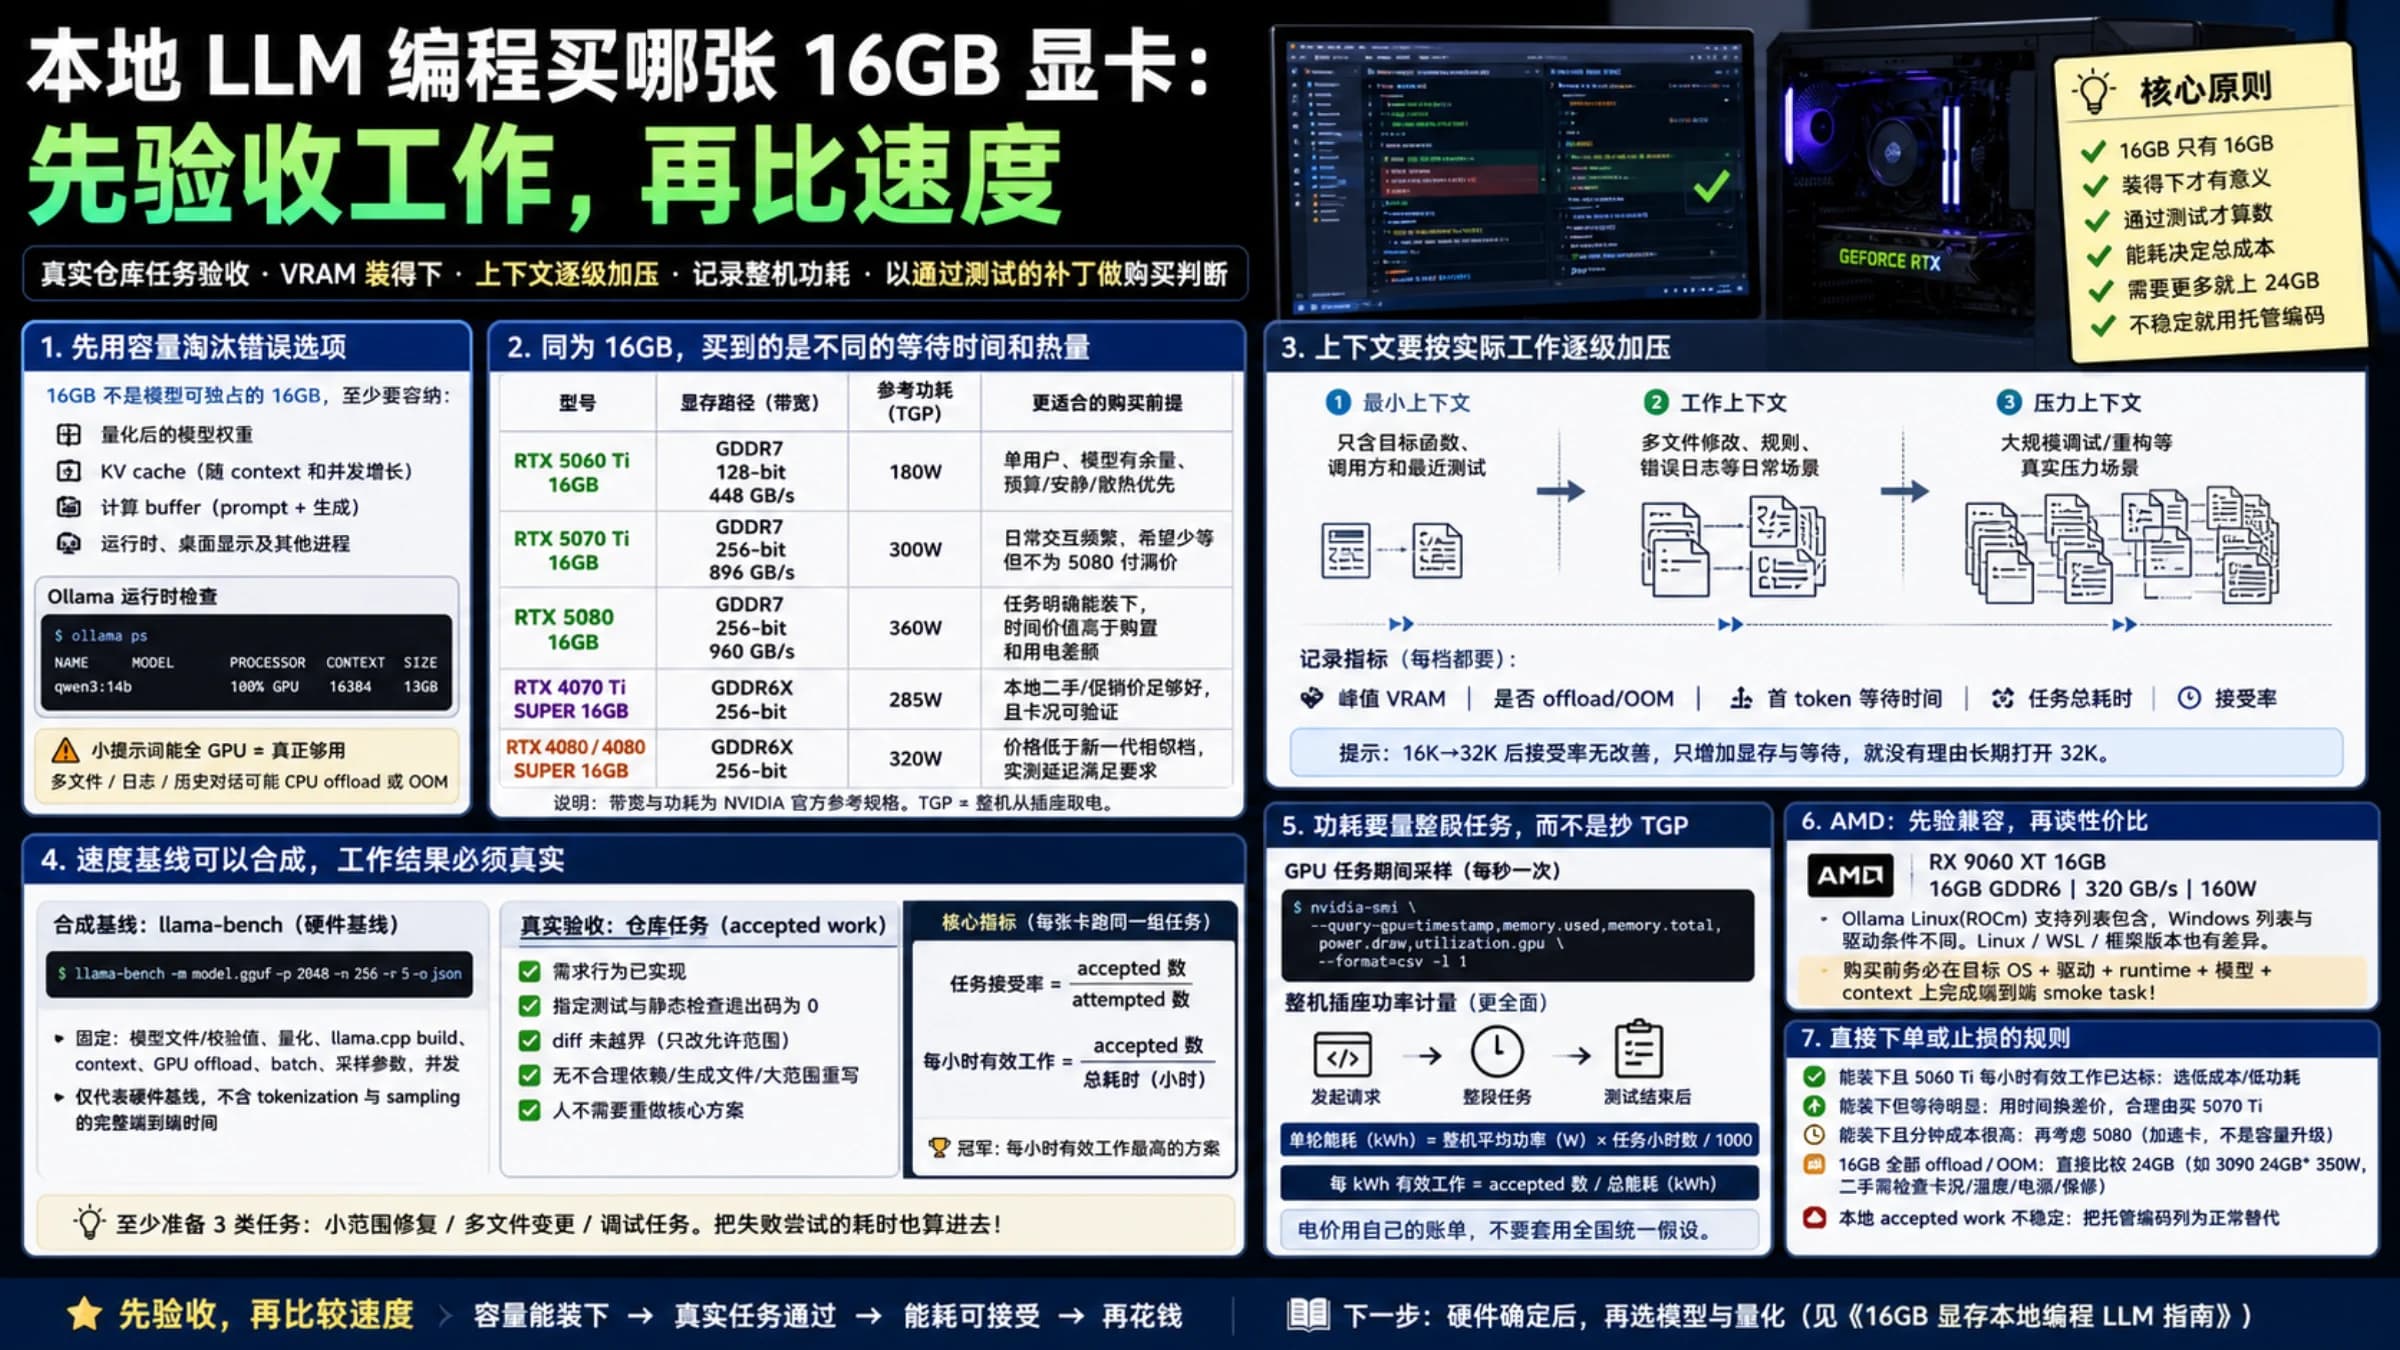
什么时候本地比 Claude、Codex 这类托管工具更合适,见 本地 LLM 编码代理:什么时候比 Claude/Codex 更合适;如果决定升级硬件,先看 本地 LLM 编程买哪张 16GB 显卡:先看模型能否运行,再比任务速度。
本地验证记录怎么写
每次测试至少记下这些字段,下一次才能复现。下面是一份填写示例:
显卡 / 显存:RTX 4060 Ti 16GB
系统内存:32 GB
驱动与运行时版本:
模型与量化文件:unsloth/Qwen3.8-27B-GGUF  UD-Q3_K_XL(13.15 GB)
上下文与 KV 类型:-c 32768  -ctk q8_0 -ctv q8_0
是否卸载:ollama ps 的 PROCESSOR 列 / 实际显存占用
任务:一个文件 + 一个测试,重构一个函数
结果:延迟、补丁是否通过 review、测试是否通过
结论:保留 / 降级 / 继续观察 / 复测 / 停止
各路线记录的重点不同:gpt-oss-20b 记它在你的仓库里能稳定处理多大的代码片段;Gemma 4 12B 记更长的上下文是否真的让结果变好;Qwen3.8-27B 记 3-bit 文件在 32K 和 64K 下是否比基线强,强多少;Devstral Small 2 记 32K 是否够完成一个任务。
不要只记“能跑”,要记“能不能改对”。编程助手的价值来自补丁质量、上下文保持和可审查性,而不是模型启动截图。
一次有价值的 16GB 测试分三轮:第一轮只给一个文件和一个测试,确认模型读懂当前行为;第二轮加入错误日志或需求说明,看它是否还能保持目标;第三轮才加入相邻模块,判断上下文增长后是否开始丢约束。三轮都通过,才值得放进日常工作流。
同一轮里不要同时换模型、量化、运行时和插件,否则不知道是哪个因素改变了结果。固定任务和 prompt,只改一个变量:先比 gpt-oss-20b 和 Gemma 4 12B,再比 Qwen3.8-27B 的 UD-Q3_K_XL 和 UD-IQ4_XS,最后才比 IDE 插件。
装载表里的计算值没有计入运行时缓冲区和桌面显示占用,实际使用时还要给编辑器、浏览器、终端和测试进程留余量。计算值越接近 16 GiB,越要以运行时报告的实际占用为准,而不是把显存压到 99%。
写团队推荐时,不要只说“我这里能跑”,要写成“在某张 GPU、某个运行时、某个量化文件、某个上下文、某类任务下通过”。还要记录能否连续三次通过同一任务:一次成功只说明可行,连续通过才说明适合当本地编程助手。
失败归因要具体:速度问题归到卸载、量化或上下文;质量问题归到模型能力或任务切分;稳定性问题归到显存余量、运行时版本或插件包装。这样下一步才是工程调整,而不是换一个更大的名字。
常见问题
16GB 显存最先该试哪个本地编程 LLM?
先试 gpt-oss-20b。它是候选里唯一有官方 16GB 内存表述的模型,MXFP4 文件 12.11 GB,64K 上下文合计约 12.8 GiB(计算值)。用 Ollama 时先把上下文设到 64000。基线通过后,再比较 Gemma 4 12B 和 Qwen3.8-27B 的 3-bit 文件。
Qwen3.6 35B A3B 能在 16GB 显存上跑吗?
全放显存只能用 3-bit 以下的文件,例如 UD-IQ3_XXS(13.21 GB),而模型卡建议思考模式保持至少 128K 上下文,那时合计约 14.8 GiB,余量很小。系统内存大的话,可以用 Q4_K_M 文件配 llama.cpp 的 --n-cpu-moe 把专家权重留在内存,代价是速度。现在先试的 Qwen 已换成 Qwen3.8-27B。
Qwen3.8 27B 能在 16GB 显存上跑吗?
只能用 3-bit 或 IQ4 文件,并量化 KV cache。Ollama 默认的 qwen3.8:27b 是 Q4_K_M,标注 18 GB,装不下;Unsloth 的 UD-Q3_K_XL(13.15 GB)加 32K 上下文的 q8_0 缓存约 13.3 GiB,64K 约 14.4 GiB(计算值)。厂商分数是全精度、256K 下测的,3-bit 版本要在你的仓库上自己验证。
gpt-oss-20b 够不够写代码?
适合当 16GB 的起点:函数解释、小补丁、测试建议和短仓库片段。64K 上下文能放下,128K 约 14.3 GiB(计算值),余量很小。它不是大型多文件代理的永久答案,要用烟测判断。
Gemma 4 E4B 的位置是什么?
在 16GB 显卡上,它已被 Gemma 4 12B 取代:12B 的 QAT Q4_0 文件 6.98 GB,128K 上下文合计约 8.8 GiB,Google 公布的 LiveCodeBench v6 为 72.0%,E4B 为 52.0%。E4B(QAT Q4_0 文件 5.15 GB)留给 8GB 显卡和只有 16GB 内存的笔记本、Mac。
Ollama 和 LM Studio 哪个更适合?
Ollama 适合命令行基线和快速切换,LM Studio 适合在图形界面里挑文件、起本地 server。关键不是工具名,而是它实际加载的量化文件和上下文长度。Ollama 在 16GB 显卡上默认只给 4k 上下文,要手动改到 64000。
RTX 4060 Ti 16GB 或 5060 Ti 16GB 可以吗?
可以,这些卡的 16GB 显存都按前面的装载表算:gpt-oss-20b 64K、Gemma 4 12B 128K、Qwen3.8-27B 3-bit 32K–64K 都在预算内(计算值)。不同显卡的速度差别要看任务实测,买哪张卡见 本地 LLM 编程买哪张 16GB 显卡:先看模型能否运行,再比任务速度。
8GB 显存怎么办?
把目标降到 Gemma 4 E4B(QAT Q4_0 文件 5.15 GB)或 Granite 4.2 8B(Q4_K_M 文件 5.35 GB)这一档,用短上下文做轻任务。Gemma 4 12B 的文件 6.98 GB,在 8GB 显卡上留给上下文的空间很少。不要照搬 16GB 的 Qwen3.8 3-bit 方案。
16GB 内存的笔记本或 Mac 能跑本地编程模型吗?
能跑小一档的模型。16 GiB 的 M4 Mac 上,llama.cpp 看到的 Metal 预算是 12,124 MiB(约 11.84 GiB):Gemma 4 12B 64K 约 7.8 GiB,放得下;gpt-oss-20b 光权重就 11.28 GiB,几乎占满;Qwen3.8-27B 放不下。没有独显的 16GB 内存笔记本只能用 CPU 跑 Gemma 4 E4B 这类小模型。
GLM-5.3-Flash 能在 16GB 显存上本地跑吗?
不能。它的官方 FP8 权重约 305.8 GiB,是多卡或 API 级别的模型。Qwen3.8-Flash-Next(BF16 约 360 GB)和 Qwen3-Coder-Next(Q4_K_M 合计 48.4 GB)同样不是 16GB 级。
Devstral Small 2 适合 16GB 显存吗?
只适合短上下文。它每 token 的 KV cache 是 160 KiB,Q4_K_M 文件加 32K 的 F16 缓存约 18.4 GiB,装不下;Q3_K_M 加 32K q8_0 缓存约 13.3 GiB,IQ4_XS 加 16K 约 14.4 GiB(计算值)。Mistral 自己给的硬件口径是单张 RTX 4090 或 32GB 内存的 Mac。
24GB 显存是不是就够了?
24GB 会宽松很多:Qwen3.8-27B 的 Q4_K_M(15.33 GiB)和 Devstral Small 2 的 Q4_K_M 都能放进显存。但长上下文、KV cache 和工具调用仍会吃预算,24GB 降低压力,不取消烟测。
什么时候该停止本地路线?
当 OOM、卸载导致的延迟、上下文丢失或补丁循环失败成为主要问题时停止。换小模型、降上下文、升级显存或改用托管编程,都比继续硬调更合理。
社区 benchmark 能直接决定最佳模型吗?
不能。社区结果只提示候选和失败样本;厂商 benchmark 是全精度、长上下文下测的。真正的选择要绑定具体量化文件、运行时、上下文长度和你自己仓库上的烟测结果。