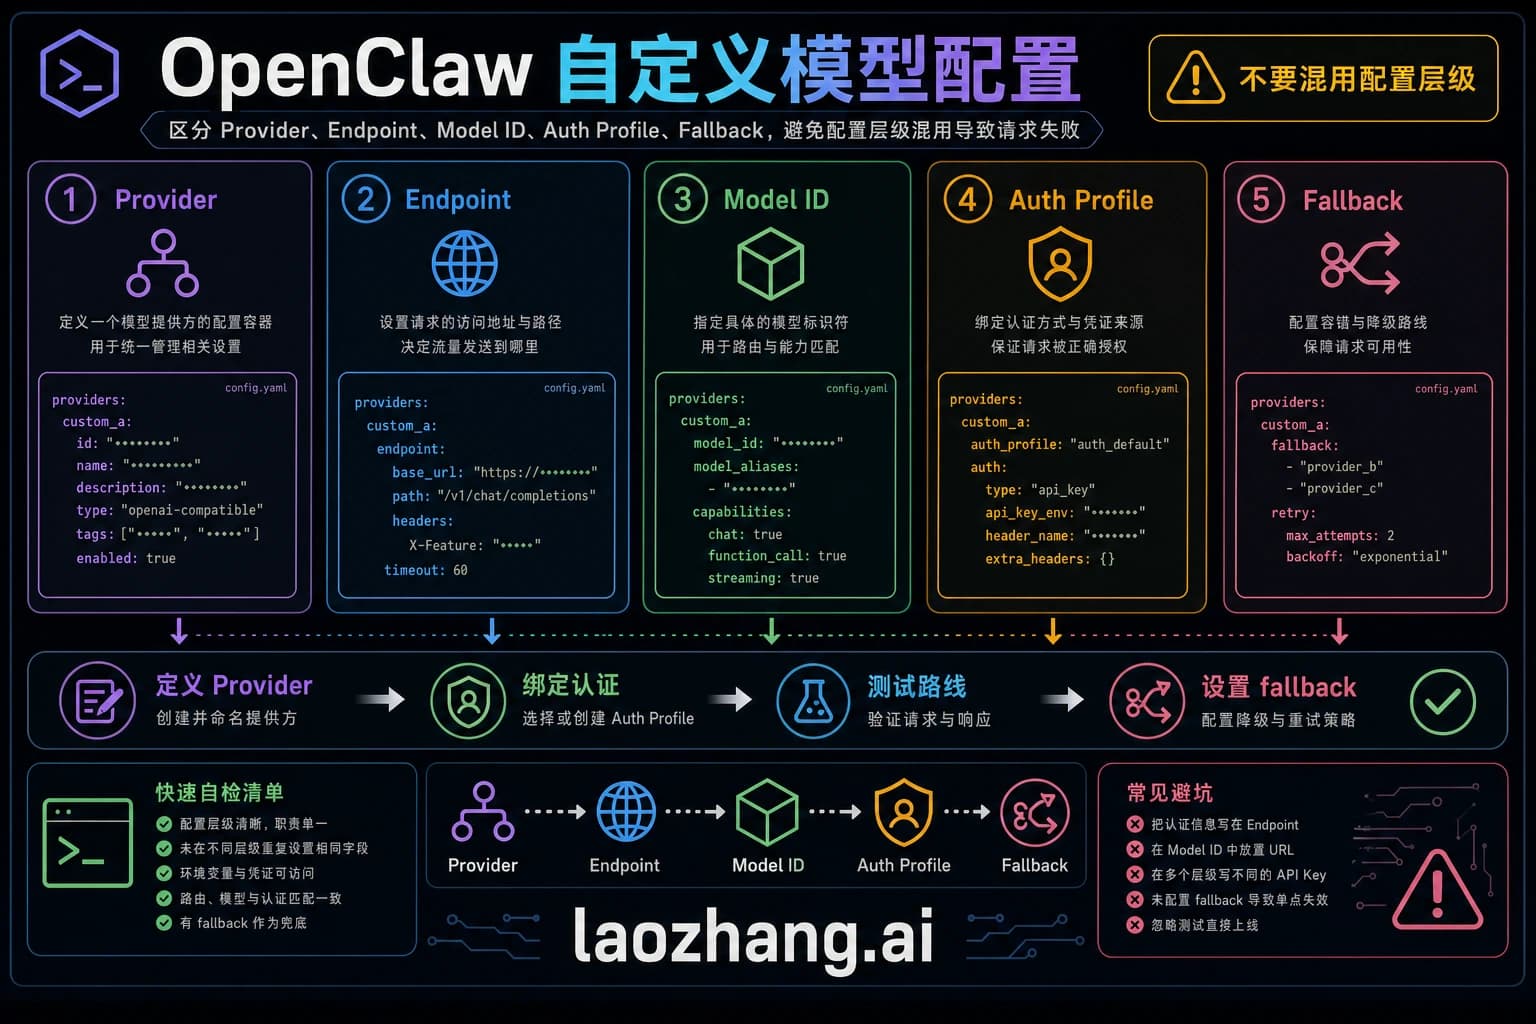
OpenClaw 模型配置指南:云端 API、Ollama 与 LM Studio 接入
配置 OpenClaw 模型,先在 Gateway 所在主机连接并认证服务商,再选择准确的 provider/model,最后分别验证短回复和真实工具调用。Ollama 使用原生 API,LM Studio 与 vLLM 的兼容接口保留 /v1;修改默认模型不会清除已有会话的固定选择。
文章目录
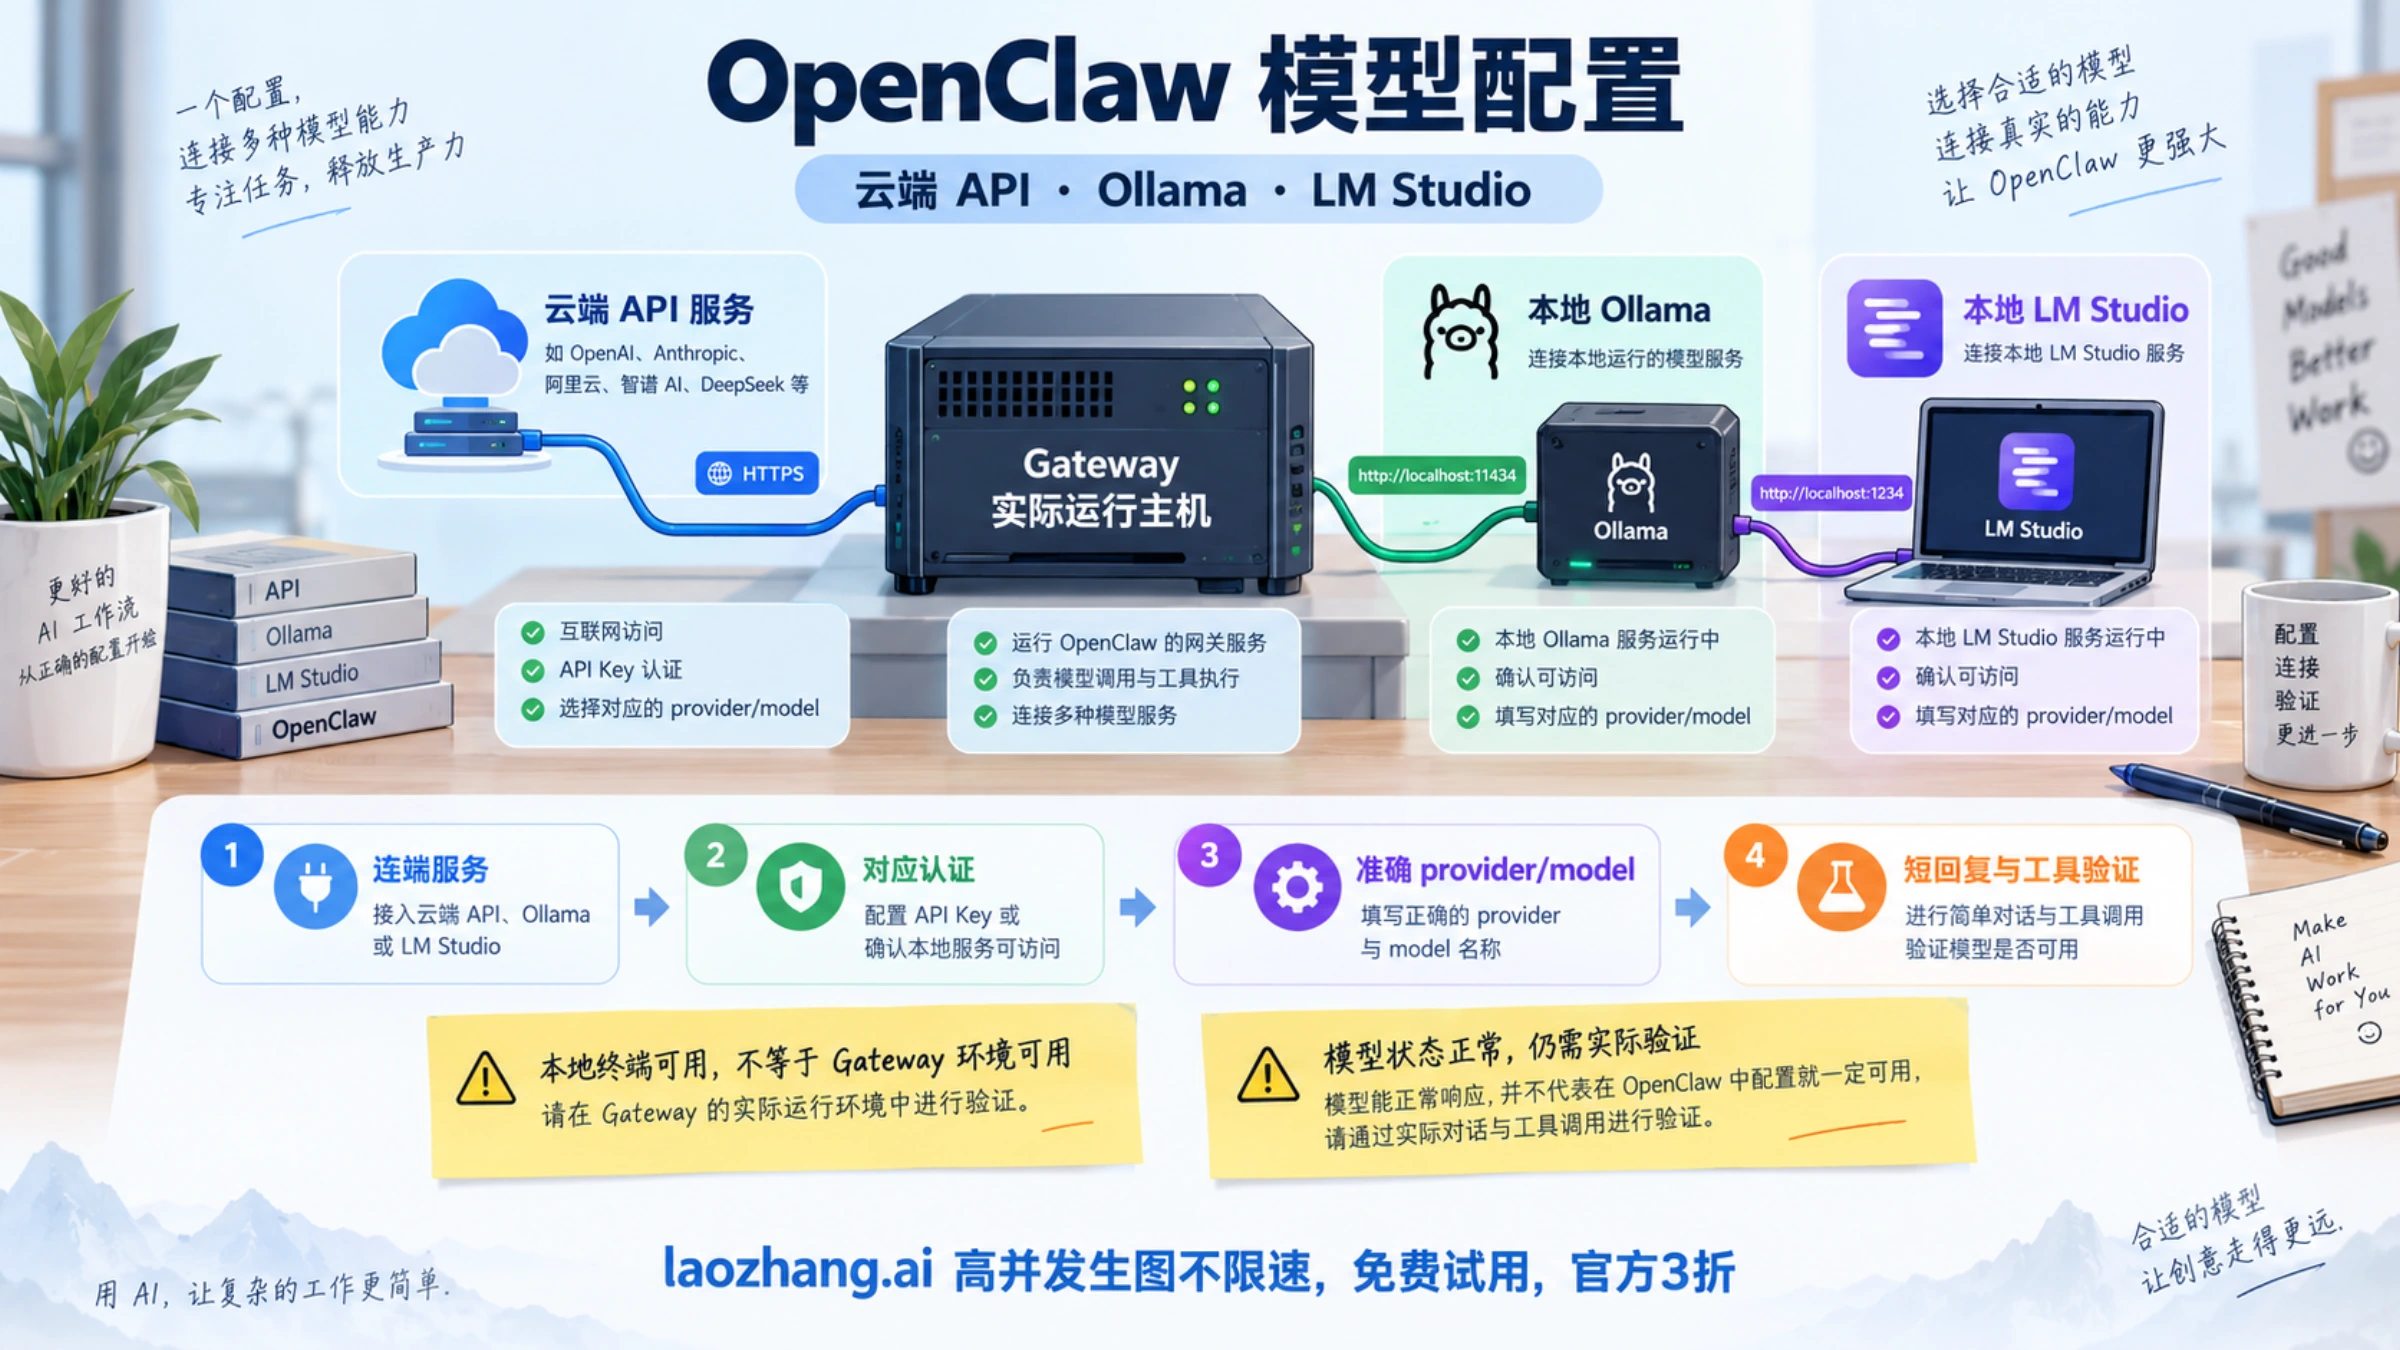
OpenClaw 模型配置的顺序是:连接服务商或本地推理服务 → 完成对应认证 → 选择准确的 provider/model → 验证短回复和工具调用。 第一次接入优先运行 openclaw onboard;已有配置先查 openclaw models status,确认实际默认模型和认证,再决定改哪一项。
如果要把模型运行在自己的机器上,Ollama 和 LM Studio 都有官方接入流程。Ollama 应使用原生 /api/chat,baseUrl 不加 /v1;LM Studio 和 vLLM 的 OpenAI 兼容推理接口则需要 /v1,不能把三者的地址格式混用。云端模型先选择自己有权限的账号与模型,不凭模型名称推断订阅资格、运行时或费用。
下面的命令和条件依据截至 2026 年 10 月 4 日的官方文档。本文没有执行账户登录、付费调用或本地硬件基准测试;操作中的成功信号是供你在自己的 Gateway 环境中核对的结果。
先决定接哪条路线
已有可用云端账号、想先跑通代理任务,可以从对应服务商的交互认证开始。已有本地模型或希望控制模型推理的数据去向,优先使用 Ollama 或 LM Studio;已经部署 vLLM 的团队再沿用 vLLM 的兼容服务。这里的选择依据是现有账户和运行环境,不是未经测试的性能排名。
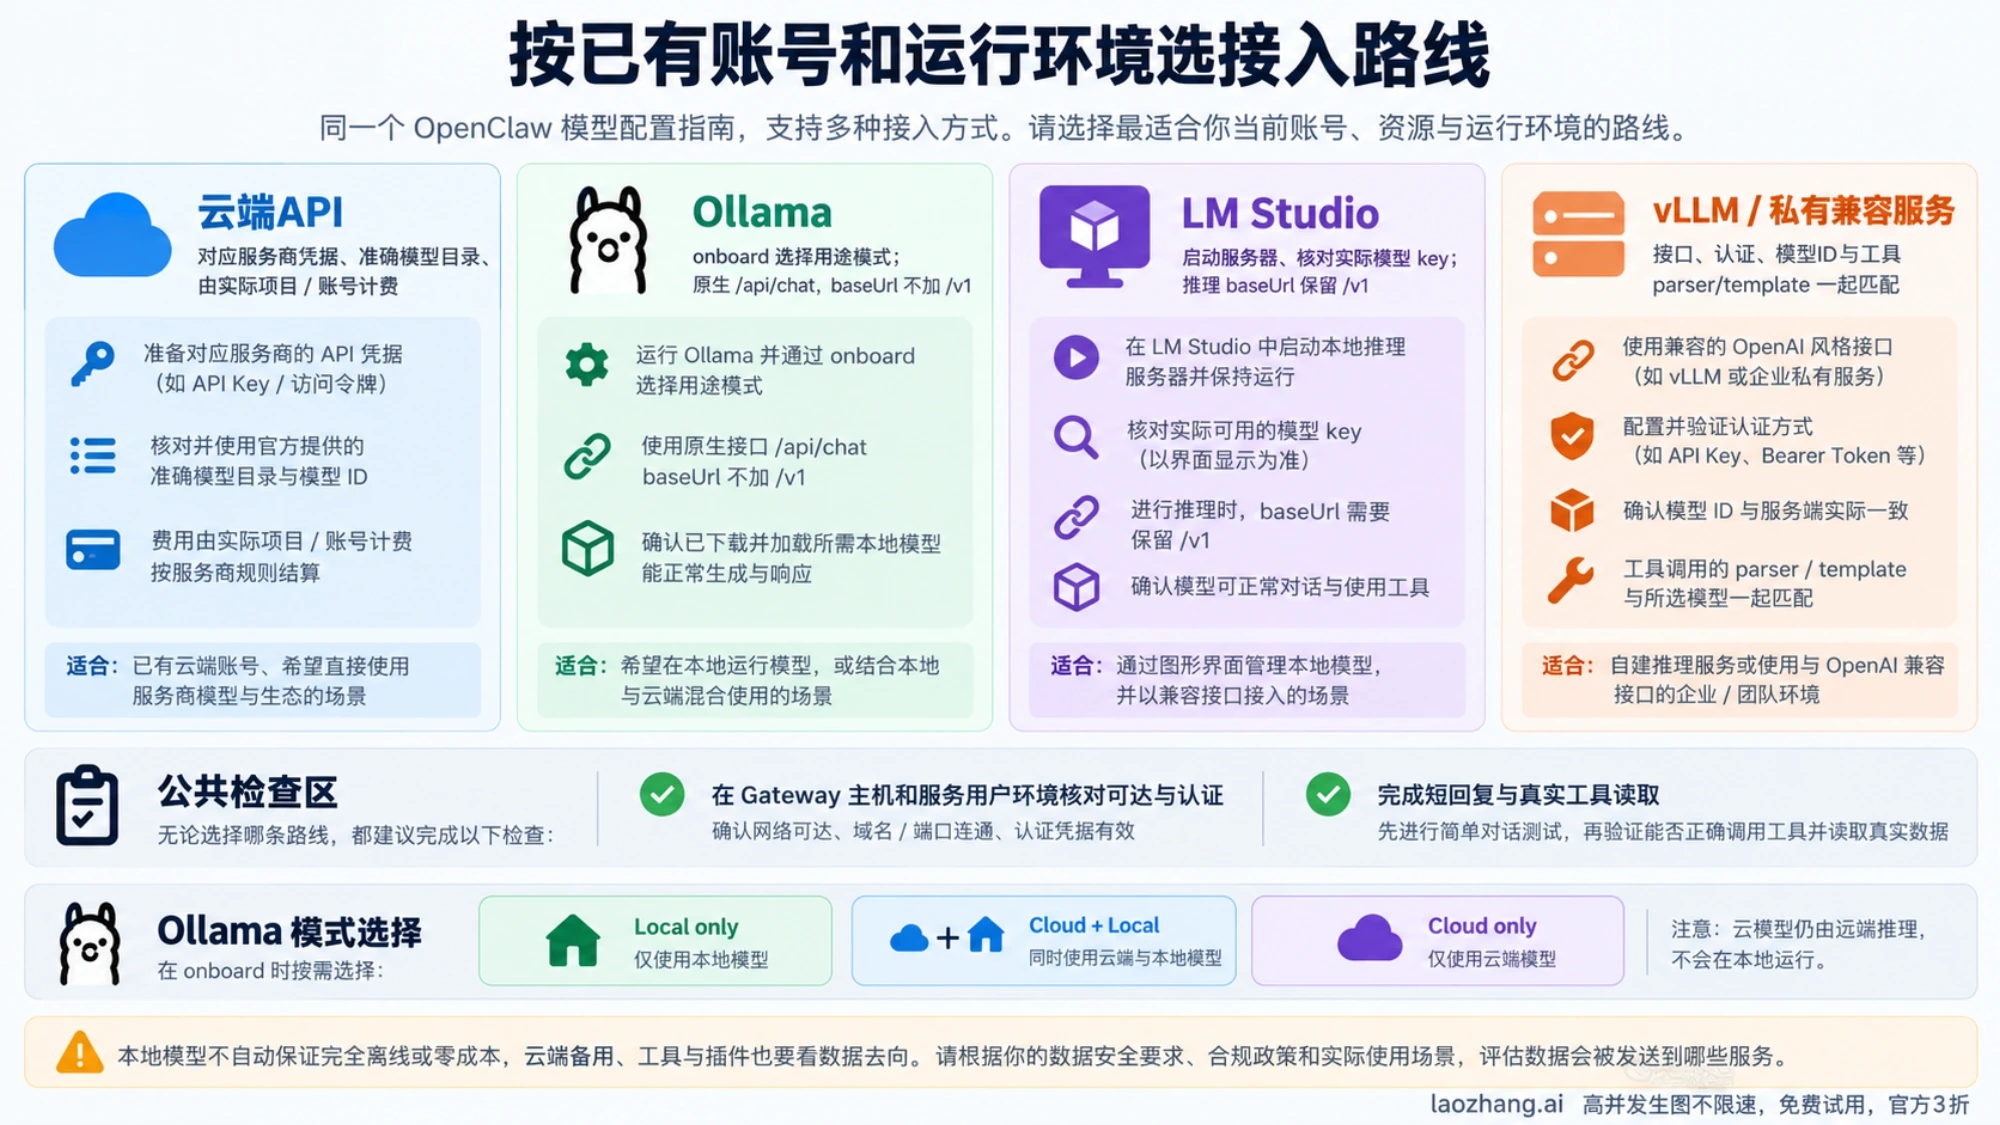
| 你的起点 | 可先选择的接入方式 | 配置前要确认 |
|---|---|---|
| 有 OpenAI Platform 项目与 API key | OpenAI API 认证,模型引用为 openai/模型ID | 项目是否能访问该模型,API 用量由哪个项目付费 |
| 有可用的 ChatGPT/Codex 账号 | OpenClaw 支持的 OpenAI 登录方式 | 登录后账号实际提供的目录与额度,不能用 API key 权限代替订阅权限 |
| 有 Anthropic API key,或同机已登录 Claude Code | 分别选择 Anthropic API 或 Claude CLI | API key 与原生 CLI 登录是不同凭证;Gateway 用户必须能使用相应来源 |
| 有 Google AI Studio API key | Google provider,模型引用为 google/模型ID | 当前账号目录;新接入不沿用旧 Gemini CLI OAuth 教程 |
| 已有 Ollama 或 LM Studio 本地服务 | 对应的原生 provider | Gateway 能否访问服务,模型是否支持工具,实际上下文是否足够 |
| 已部署 vLLM、私有兼容网关或 AWS 环境 | vLLM、自定义 provider 或 Bedrock | 接口格式、准确模型 ID、服务器认证;Bedrock 另查 AWS 凭据和区域权限 |
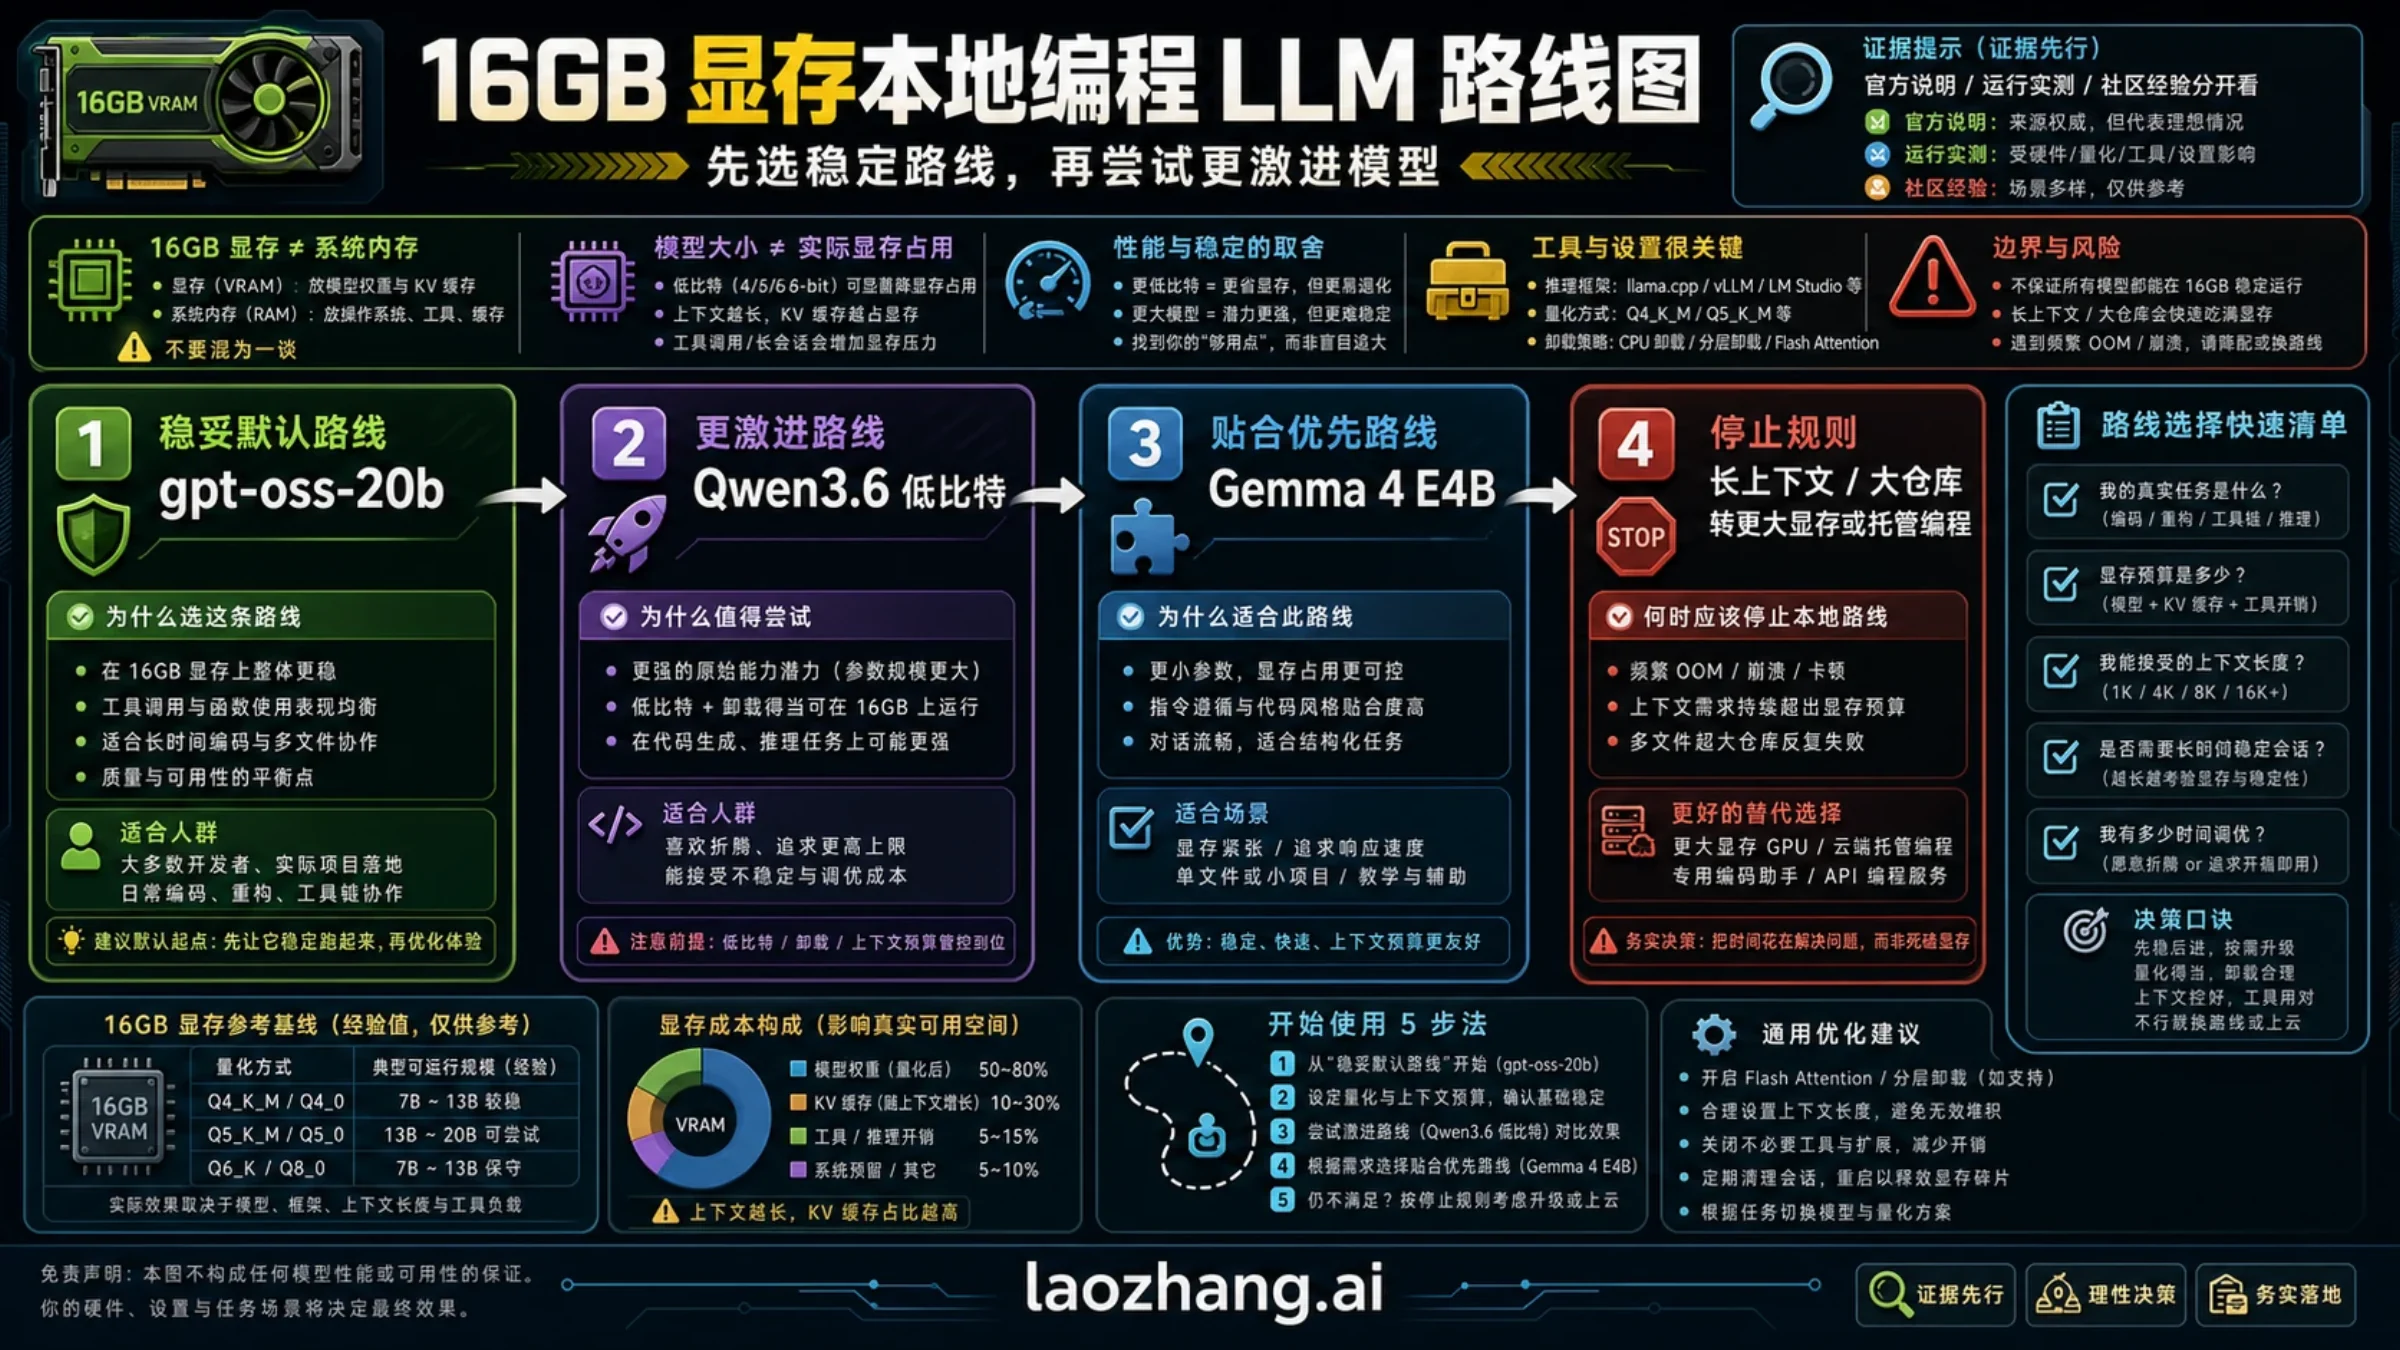
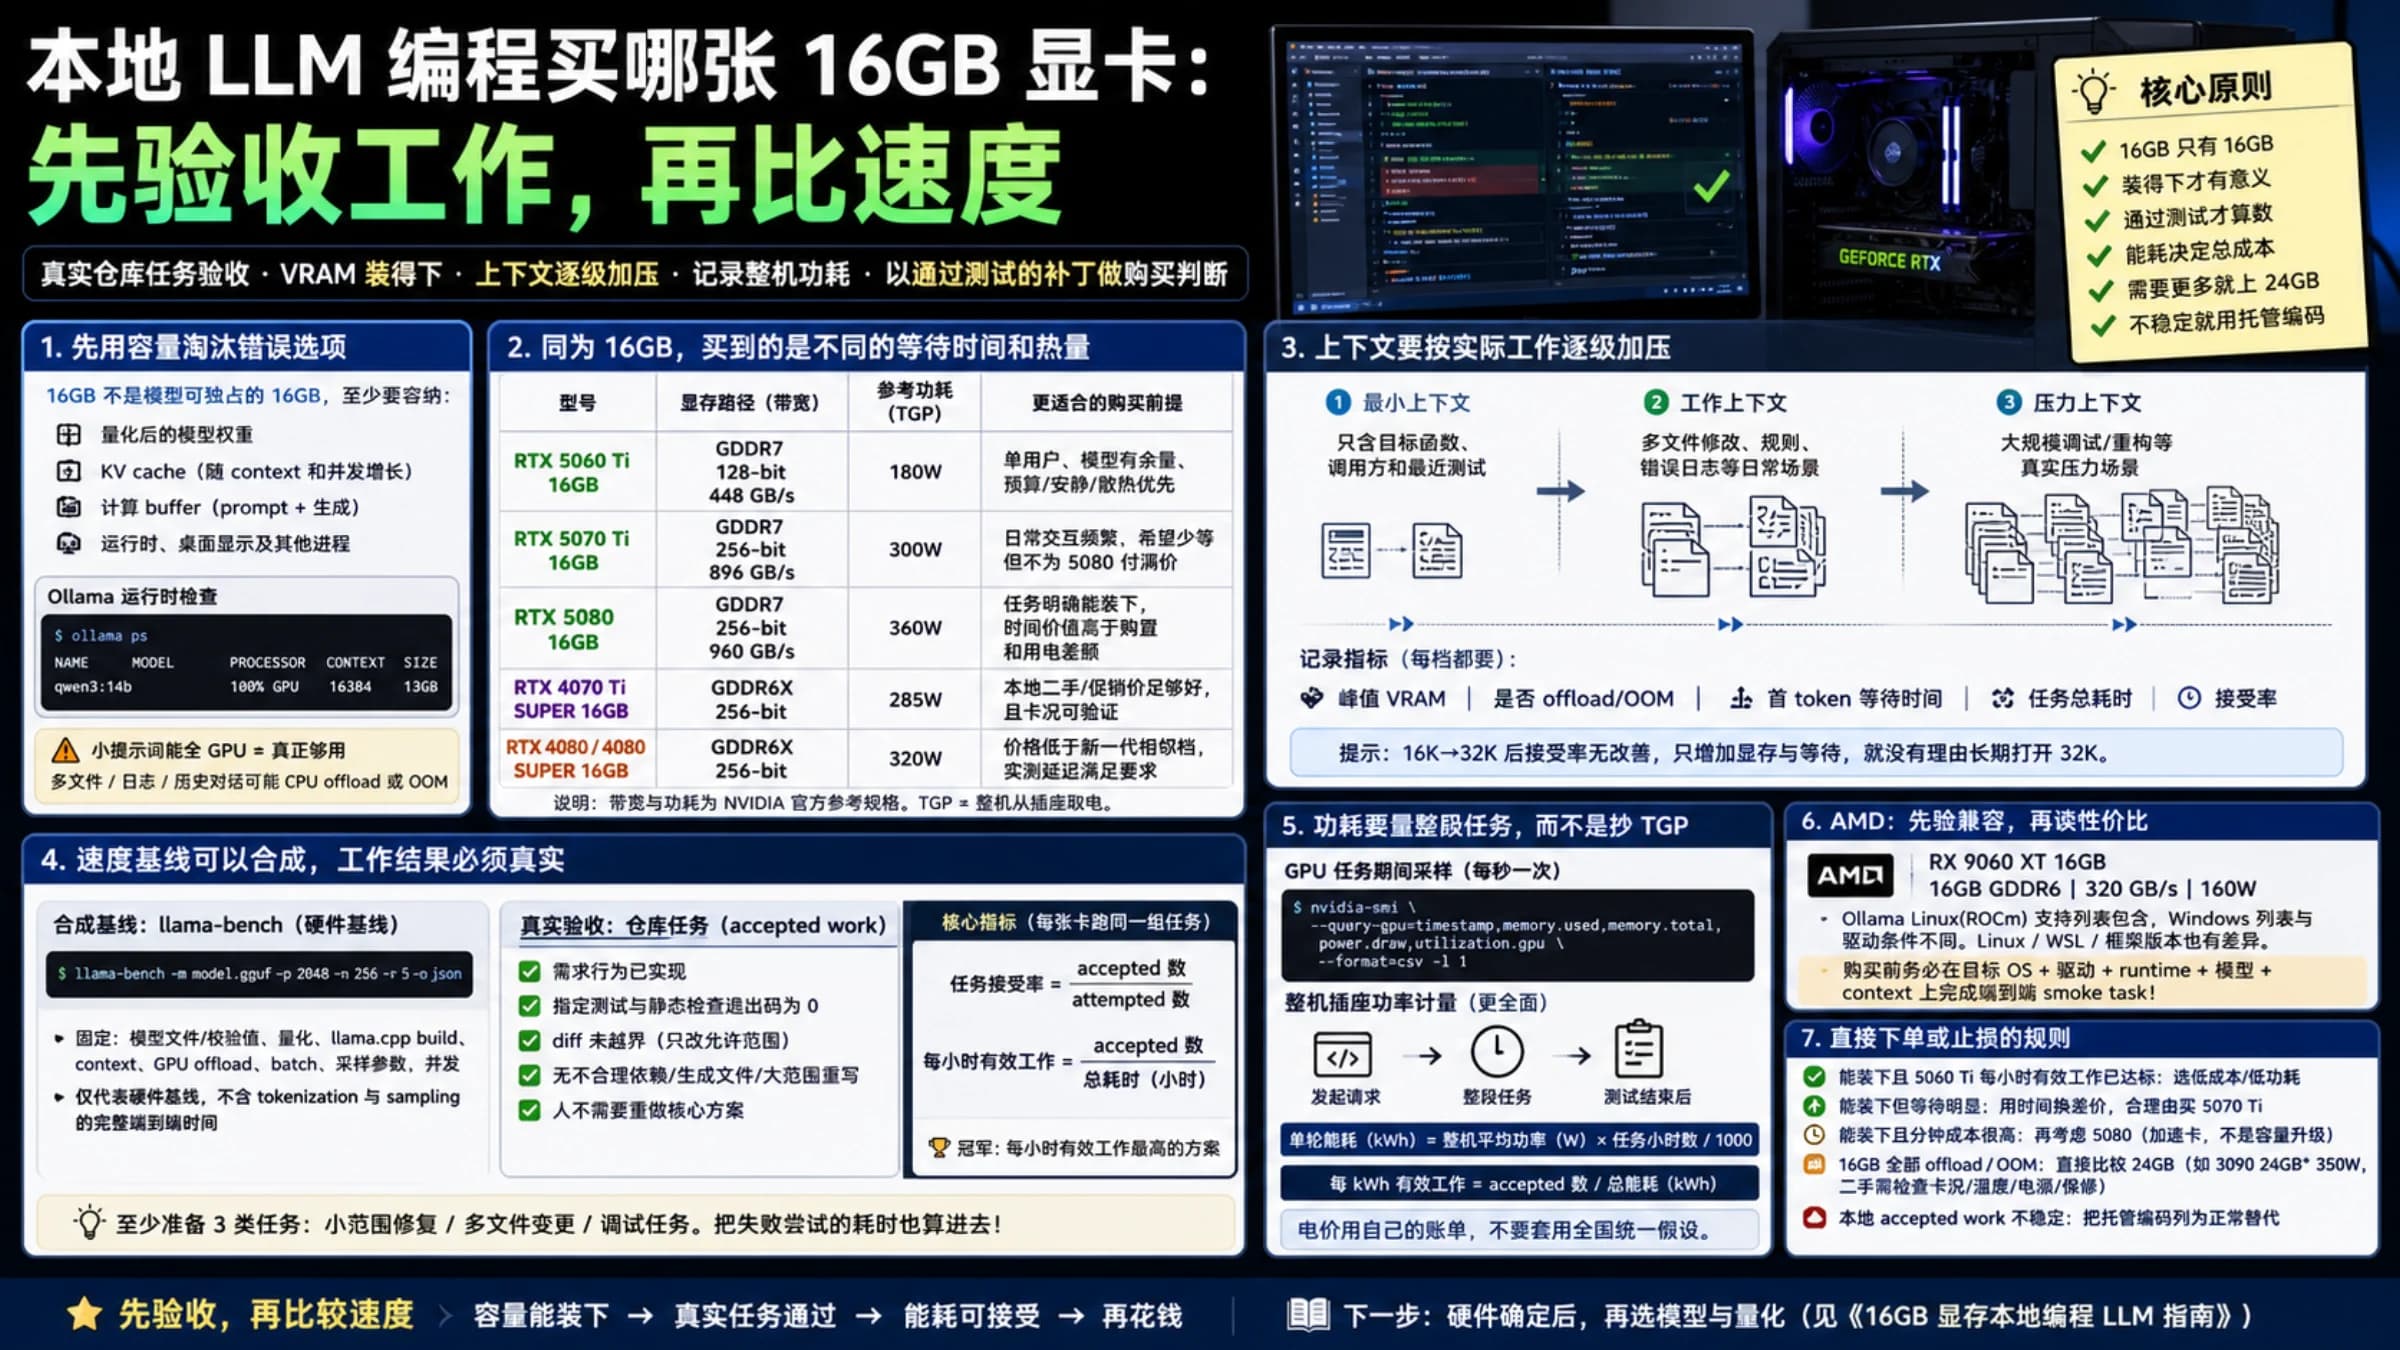
这些路线的入口分别见 OpenAI 设置、Anthropic 设置、Google 设置及模型 provider 目录。本地硬件能否承载模型,还取决于权重、量化、上下文与运行时;不能只用参数量套一个固定内存或速度表。
在真正运行 Gateway 的主机上配置
先确定 Gateway 跑在个人电脑、远端服务器、容器还是常驻系统服务中。下面的诊断与认证应在那个主机、那个服务用户的环境中进行:笔记本终端能访问本地模型或读到 API key,并不证明远端 Gateway 也能。
openclaw --version
openclaw gateway status
openclaw doctor
openclaw models status
如果有多个 agent,要单独检查目标 agent。以下 YOUR_AGENT_ID 是占位符,换成自己的 agent ID:
openclaw models status --agent YOUR_AGENT_ID现在应能分清四件事:
| 项目 | 它解决什么问题 | 不能据此推断什么 |
|---|---|---|
| provider 和模型 ID | 请求走哪个提供商、选择哪个模型 | 不能证明账号有权限,或服务器实际存在该模型 |
| 认证 | 使用哪个账号、key 或登录状态 | 不能代替服务地址与 API 格式配置 |
| 运行时 | 谁执行代理循环与工具,例如 OpenClaw、Codex、Claude CLI | 不能单靠运行时名称判断最终计费账号 |
| 默认模型与会话选择 | 新的未固定会话起点,以及当前会话实际选项 | 修改默认值不会覆盖已有会话的固定模型 |
OpenClaw 的模型设置保存在配置中;当前认证使用 SQLite 存储,共享凭证可被 agent 读取,agent 本地同 ID profile 可以覆盖共享记录。不要把旧教程中的 auth-profiles.json 当成今天应手工复制的运行时凭据。Gateway 客户端连接令牌又是另一类认证,不能用模型 API key 替换。官方认证与存储说明给出了当前归属和迁移规则。
云端模型:先认证,再明确切换默认值
运行交互式向导,选择你要使用的服务商和认证方式:
openclaw onboard已有 Gateway 也可在 Control UI 的 Settings → Models → Connect provider 保存支持的账户。这个连接入口不等于已完成模型调用;需要调用并选择模型时,使用相应的 Test & use 流程。官方 OAuth 说明区分了这两个动作。
认证完成后查看对应目录。例如 OpenAI:
openclaw models list --provider openai从目录或服务商文档确认准确的引用,再设置默认值。下面的 PROVIDER/MODEL 是格式占位符,执行前必须替换成你有权限使用的完整引用:
openclaw models set PROVIDER/MODEL
openclaw models status
models set 保存成功仍不是调用成功:已知 provider 的新模型或自托管模型未出现在本地目录时,命令可能保存选择并给出警告。此时继续核对模型 ID 和真实响应,不能把警告忽略后当成验证完成。模型 CLI 文档说明了这一行为。
API key、订阅登录和 CLI 登录怎么区分?
OpenAI 当前规范 provider 为 openai,API key 与 ChatGPT/Codex 登录都使用这个 provider。新配置不要照抄旧 openai-codex/* 引用;旧配置的迁移按 doctor 诊断处理。openai/* 前缀只指定模型归属,Codex 运行时能否被选择还受实际 endpoint、API 适配器和请求配置影响。OpenClaw 的 OpenAI 设置文档说明了实现条件;账号可用模型和费用仍需看实际登录与目录。
Anthropic API key 用于 API 访问;Claude CLI 通过同机安装的 Claude Code 使用它自己的登录。选 CLI 时先在 Gateway 用户下确认 claude auth status --text,并确保服务能从 PATH 找到 claude。OpenClaw 不复制、保存或刷新 Claude 原生登录 token。即使运行时是 Claude CLI,显式选中了 API key 账号仍可能走 API 计费,不能只看 anthropic/* 或“CLI”标签判断月费覆盖。Anthropic 路线说明对此有明确区分。
Google 新接入通常选择 AI Studio API key,模型保持 google/* 引用;google-gemini-cli 是可显式选择的运行时,并不等于当前还能新建 Gemini CLI 或 Antigravity OAuth 登录。Google provider 文档给出了现行入口。AWS Bedrock 则使用 amazon-bedrock provider 和 AWS SDK 凭据链,还要满足区域与模型访问权限,不能塞入 Anthropic key 代替 AWS 认证;详见 Bedrock 接入。
对于常驻 Gateway,官方认证指南把 API key 作为较可预测的选择。使用环境变量时,要放到服务实际读取的环境;官方也提供 ~/.openclaw/.env 供守护进程读取。完成修改后重启相应服务,再检查状态,仅在另一个 shell 中 export 不能证明凭证已生效。
添加或重新认证 provider 通常会保留已有 agents.defaults.model.primary;想改默认模型,仍要明确使用 models set,或在支持的认证命令中主动指定 --set-default。这能解释“登录了新服务商,为什么聊天还在用旧模型”。当前 provider 规则同时要求再检查会话固定选择。
Ollama:用原生接口完成本地接入
Ollama 适合已经有本地推理服务、希望自己决定模型与上下文的用户。先从 Ollama 官方下载入口安装并启动服务;桌面应用和服务安装方式可能不同。需要手动启动时,在 Ollama 主机运行 ollama serve,不要对已运行的服务再启动第二个实例。
1. 确认已安装模型与当前加载状态
在 Ollama 主机查看目录和内存中的模型:
ollama list
ollama ps
list 和 ps 回答不同问题:前者是已安装目录,后者是已加载状态。没有模型时,先根据自己的硬件和模型说明选一个支持工具调用的模型,再拉取;例如当前官方流程使用 gemma4:
ollama pull gemma4
ollama show gemma4
这个例子用于展示接入步骤,不保证它适合每台电脑。下载、首次加载、上下文分配都可能占用较多磁盘、内存和时间,实际模型名称及标签以你的 ollama list 为准。
2. 用向导选择 Local only
在 Gateway 主机运行:
openclaw onboard选择 Ollama,然后按用途选模式:
| 模式 | 实际推理去向 | 认证前提 |
|---|---|---|
| Local only | 一个可访问的 Ollama 主机上的本地模型 | 官方本地/专用网络主机规则使用 ollama-local 标记,不需要真实云端 bearer token |
| Cloud + Local | 同一个 Ollama 主机上的本地模型,以及已登录后可用的 :cloud 模型 | 同机 Ollama 的云端登录需要成立;云模型仍由远端处理 |
| Cloud only | 直接连接 Ollama Cloud | 需要真实凭据;可使用独立的 ollama-cloud provider 区分云端路线 |
向导要求服务地址时,Gateway 与 Ollama 同机可沿用本地默认连接;不同主机则填写 Gateway 实际可达的地址。Ollama 必须在模型主机上监听可被 Gateway 访问的网络接口,网络策略也要允许该连接。只更换一个主机名,不能让原本只允许本机访问的服务变成可用的远端服务。Ollama 设置文档说明了模式和认证边界。
当前首次引导的自动选择只考虑 /api/ps 中已经加载、经 /api/show 确认支持工具且至少有 16K 上下文的模型。已安装但闲置的模型不自动成为候选;自动发现也不会替你拉取或加载它。如果桌面 Model Setup 没有自动选中已安装的模型,可以在 Ollama 卡片点 Choose connection → Local only,走显式准备与验证流程。向导需要一次真实完成结果后才保存选定连接;提示拉取建议模型时,先确认模型和资源占用,再决定是否允许。当前引导条件不能简化成“安装后一定自动识别”。
3. 查看目录并指定准确模型
完成向导后,在 Gateway 主机核对:
openclaw models list --provider ollama
openclaw models status
若自己的目录确实包含 gemma4,可以明确设置:
openclaw models set ollama/gemma4如果目录显示其他标签,使用那个准确名字。一般隐式目录发现通过 /api/tags 查安装目录、再用 /api/show 读取能力;它和首次引导的“已加载自动选择”不是同一筛选过程。非空 models.providers.ollama.models 则表示手工模型列表,会跳过这类自动发现。Ollama 模型发现文档详细区分了这两种情况。
4. 手工配置时,原生 Ollama 不加 /v1
只有需要自定义主机、端口或模型列表时,才必需写 provider 配置。下面是合并到现有配置中的片段,假设 gpu-box.local 是你的真实 Ollama 主机、已经允许 Gateway 访问,且该主机目录中有 gemma4。执行前替换不符合自己环境的主机名与模型 ID:
{
  models: {
    providers: {
      ollama: {
        baseUrl: "http://gpu-box.local:11434",
        apiKey: "ollama-local",
        api: "ollama",
        models: [{ id: "gemma4", name: "gemma4" }],
      },
    },
  },
  agents: {
    defaults: {
      model: { primary: "ollama/gemma4" },
    },
  },
}
这个非空 models 数组采用手工目录。ollama-local 仅适用于官方定义的本地/专用网络连接,不能代替公开远程主机或 Ollama Cloud 的真实认证。原生 api: "ollama" 支持流式输出和工具调用一起工作;旧的 OpenAI 兼容 /v1/chat/completions 模式有不同的工具/流式限制。不要为修本地问题无条件关闭流式,也不要把 Ollama 的“无 /v1”规则套到 LM Studio 或 vLLM。原生配置与流式说明支持这一差别。
LM Studio:保留 /v1,核对真实模型 key
偏好图形界面管理本地模型,可以使用 LM Studio;无人值守环境也有 llmster 路线。安装并启动相应服务后,按官方 LM Studio 接入流程启动服务器:
lms server start --port 1234
openclaw onboard
向导中选择 LM Studio,填入模型服务器地址,再选择实际可用的默认模型。服务器未开启认证时,API key 留空;开启认证时使用匹配服务器设置的 LM_API_TOKEN,不能因为它运行在本地就填任意假 key。
LM Studio 的模型 key 可能是 author/model-name,OpenClaw 再加 provider 前缀。例如服务实际返回 qwen/qwen3.5-9b 时,对应引用为:
openclaw models list --provider lmstudio
openclaw models set lmstudio/qwen/qwen3.5-9b
openclaw models status
不要把示例名称当成已经安装的模型;先看自己的目录。OpenClaw 使用 LM Studio 原生 /api/v1/models 和加载接口进行发现与准备,默认推理走 /v1/chat/completions,所以配置中的推理 baseUrl 保留 /v1。
首次引导自动候选要求 LM Studio 报告工具训练和至少 16K 有效上下文;已经加载的实例若上下文较小,以实例值为准,而不是宣传的最大窗口。默认预加载与 LM Studio 自己的 JIT、TTL、自动卸载也有分工;需要让后者管理生命周期时,再按文档设置 params.preload: false。
远端或局域网使用时,LM Studio 必须在服务器上绑定可被 Gateway 访问的接口,填入真正可达的地址并保留 /v1。认证失败查 token,连接失败查主机/监听/网络,上下文不足查加载实例;这三种情况不能靠重复修改模型名称一起解决。
vLLM 与兼容网关:能聊天,还不等于能调用工具
已部署 vLLM 时,使用 vllm provider、openai-completions 适配器和包含 /v1 的服务地址。VLLM_API_KEY 可以启用隐式发现;只有服务器没有实施认证时,非秘密标记才足够。服务开启认证则必须用真实匹配的 key。vLLM 文档给出了发现和显式配置条件。
模型生成了看似工具调用的 JSON 或 XML 文本,也不代表工具真正执行。vLLM 的工具调用还受所用模型、tool-call parser 和 chat template 影响;先核对该模型的服务启动配置,再做实际工具验证。文档中的 tool_choice: "required" 只是特定组合的可选措施,会强制带工具的回合调用工具,不能作为所有模型的全局修复。
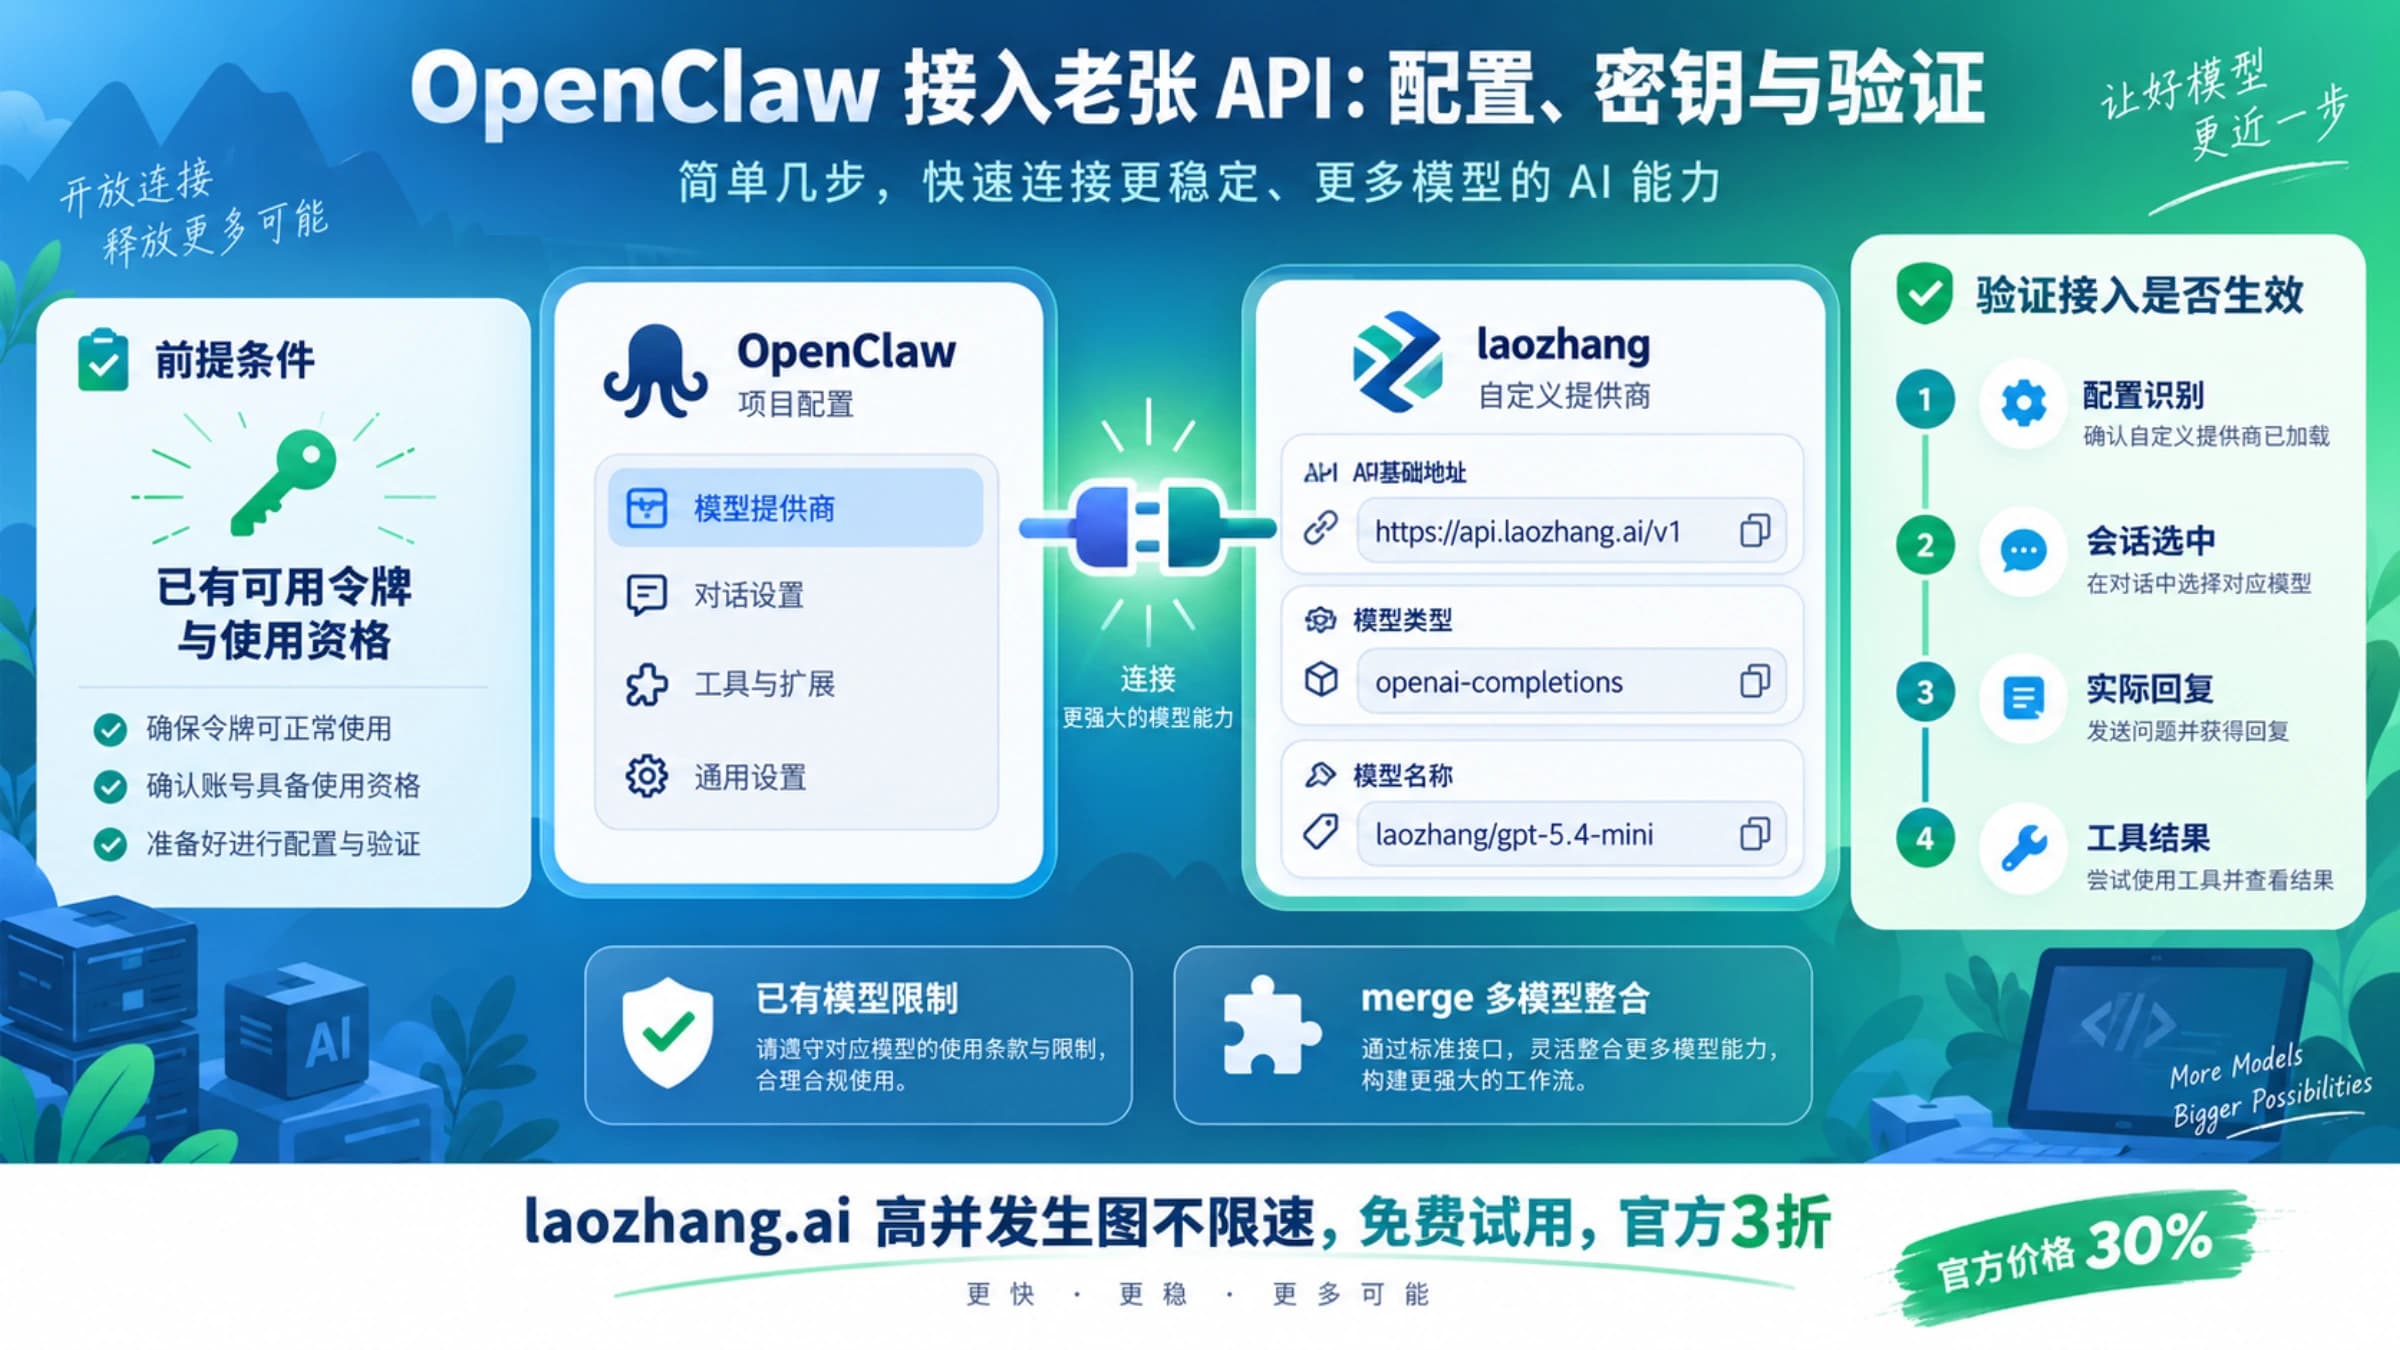
私有代理或兼容网关同样要在 models.providers 中指定真实 baseUrl、API 适配器和准确模型 ID。仅添加 agents.defaults.models 别名不会注册新的运行时模型,也不能创造图片或工具能力。以下元数据各有含义:
| 字段 | 正确用途 |
|---|---|
contextWindow | 声明模型的原生上下文窗口 |
contextTokens | 限制 OpenClaw 使用的活动输入预算 |
maxTokens | 输出上限;provider 级可作为默认值,模型级可覆盖 |
input、reasoning、compat | 描述该 endpoint 和模型确实支持的能力 |
cost | 本地估算元数据;省略后显示 0 不证明账单免费 |
手工填写更大的数字不会增加模型能力,也不能解决实际内存不足。兼容 endpoint 不自动继承原生 OpenAI 或 Anthropic 的全部请求特性,声明能力前要核对端点合约。自定义 provider 说明是这类配置的具体参考。
默认模型、会话固定选择与回退怎么配合?
默认模型是 agents.defaults.model.primary。会话中用 /model、模型选择器或其他显式入口选择某个模型后,那个会话会固定自己的选择;随后执行 models set 并不会清除它。
在实际聊天会话中查看:
/model status想让它重新跟随配置默认值,用:
/model default想临时测试准确模型,可以输入 /model 加完整引用,例如 /model ollama/gemma4。这属于用户明确选择:当前规则下,选定的 provider/model 失败会报错,不会悄悄让不相关的备用模型替你回答。模型选择说明与当前回退规则需要一起看。
| 选择来自哪里 | 当前回退行为 |
|---|---|
配置的共享默认 primary | 可按 agents.defaults.model.fallbacks 的顺序尝试 |
原生 agent 自己的 primary | 默认严格选择;需要 agent 自己的 model.fallbacks 才加入回退 |
| 用户在会话中明确指定模型 | 严格选择,失败可见 |
显式 fallbacks: [] | 禁用该处的模型回退 |
要配置备用模型,先把它单独接入并完成相同验证,再加入默认回退链。比如已有云端默认、且 ollama/gemma4 已在本机通过验证时,可添加它:
openclaw models fallbacks add ollama/gemma4
openclaw models status
这不是把 Ollama 设成所有任务的自动低价路线,也不会保证网络中断时仍能完成任务。符合条件的短暂故障先进行有界同模型恢复和 provider 内认证轮换,才轮到跨模型回退;超时、取消和运行预算等条件可以终止整个链。当前回退只用于这一回合,下一回合从选定模型重新开始。旧版本曾保存的自动回退状态是兼容处理,不能据此把备用模型描述为永久新默认。官方 failover 文档说明了顺序与版本边界。
对敏感数据,回退链尤其要逐条检查。如果备用模型是云端,失败后的请求就可能出网;已经执行的工具动作也不能当作完全未发生,重试前应核对结果。需要保持仅本地推理时,不添加云端备用,并同时检查工具、插件、记忆与其他模型功能的数据去向。
配置后的验证:目录、回复、工具分别看
不要把 models status 显示正常作为最后一步。官方 CLI 说明明确指出,不带 --probe 的状态命令不是模型调用测试。
- 核对目录。 确认 provider 和模型 ID 符合实际服务;本地模型还要确认服务所在主机、加载状态与工具能力。
- 核对目标 agent。 运行
openclaw models status --agent YOUR_AGENT_ID,查看默认、备用、认证来源与运行时问题。 - 核对实际会话。 在同一个会话输入
/model status,确认它没有固定在另一模型、运行时或 profile 上。 - 发一条短文本。 例如“只回复:连接成功”。观察是否由预期模型完成,有无认证、连接或上下文错误。
- 执行一次无害的真实工具任务。 在自己的测试工作区放一个不含敏感信息的
setup-check.txt,写入一句容易核对的话,再要求代理“读取 setup-check.txt,准确返回第一行;不要修改文件”。检查工具调用记录和返回内容是否一致。
第五步要真的发生文件读取。如果模型只是猜测内容、打印工具 JSON,或工具权限拒绝读取,就还没有完成工具验证。文件读取通过只证明这一小项任务可用,之后应继续用自己的低风险任务评估上下文、稳定性与等待时间。
需要把 Ollama endpoint 与完整代理任务分开排查时,可以使用官方提供的窄文本测试。下面只适用于自己的目录中确实存在 gemma4 的环境:
openclaw infer model run \
  --model ollama/gemma4 \
  --prompt "只回复:ok"
这个测试跳过聊天工具、记忆和会话上下文;它通过而代理失败时,继续查工具能力、权限与上下文,不重复证明同一个文本 endpoint。Ollama 发现与测试说明明确限定了范围。
以上短消息、引导测试和推理命令都会执行真实推理;云端路线可能消耗额度或产生费用。单独运行 models status --probe 还有状态独占要求:先停止 Gateway,等待探测和清理完整结束后再恢复。结果提前显示、命令超时或被中断,都不证明锁与临时状态已释放。初次接入通常先用自己的实际会话完成短验证,需要限定 provider/profile 的专门诊断时再使用 CLI probe 流程。
出错时,从失败位置找到下一步
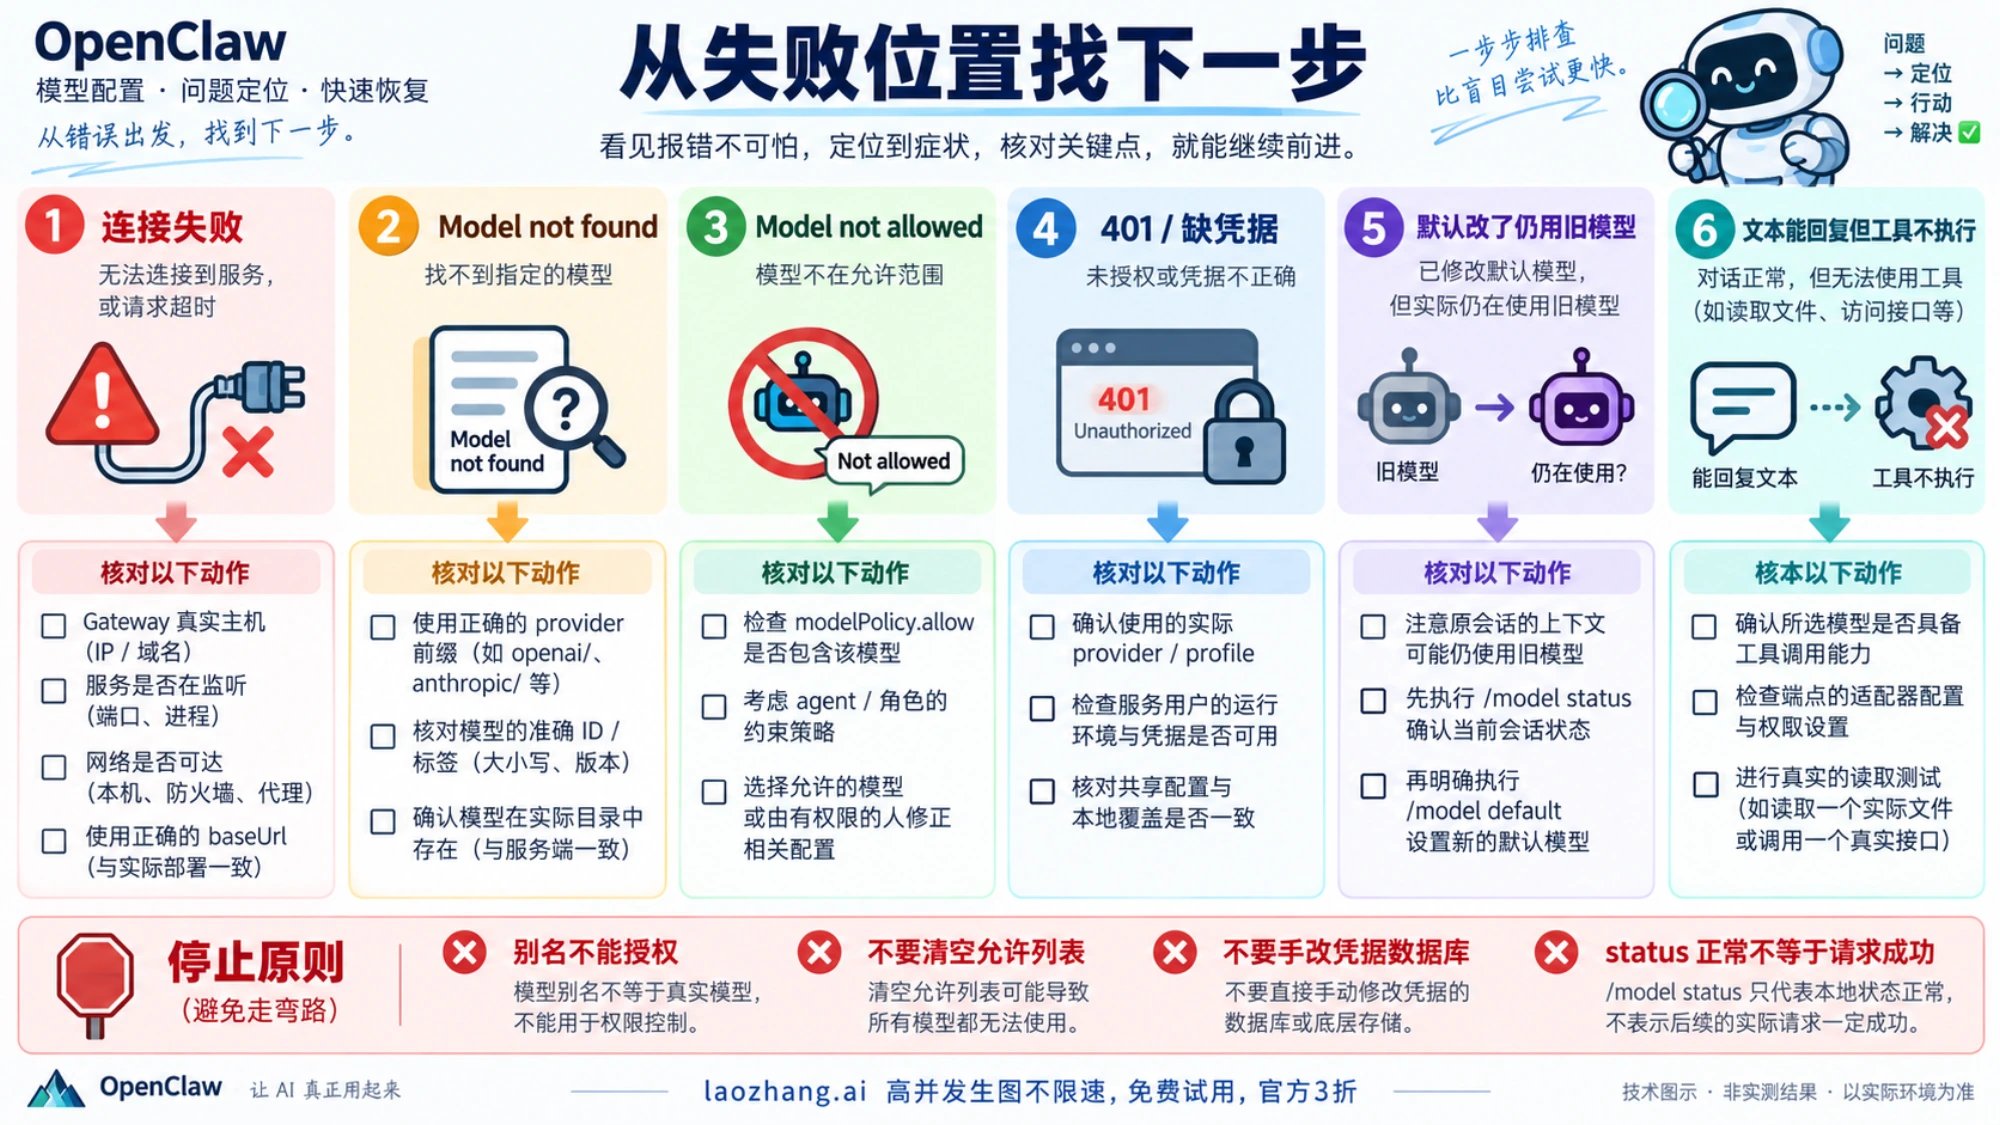
| 现象 | 先检查 | 下一动作 |
|---|---|---|
| 连接被拒绝、服务无法访问 | 服务有没有启动;Gateway 是不是在另一主机或容器;服务绑定和网络是否允许连接 | 在实际 Gateway 环境确认可达,再检查正确的 provider 地址与接口 |
| Ollama 已安装模型却未被首次引导自动选中 | ollama ps 加载状态、工具能力、至少 16K 上下文 | 区分自动候选与安装目录;走显式 Local only 准备流程 |
Model not allowed | 当前 modelPolicy.allow、agent 或角色限制;旧策略迁移诊断 | 选择允许的模型,或由有权限的人明确修正策略;别名不能授予权限 |
Model not found | provider 前缀、模型 ID 与标签、服务器目录 | 改为准确引用;确实未安装才拉取,不把所有错误都当成未下载 |
| 401、缺少认证头或找不到凭证 | 实际 provider/profile、服务用户环境、agent 本地覆盖 | 处理正确的认证来源,见 OpenClaw 401 认证失败排查 |
| 默认值已改,会话仍用旧模型 | 原会话的 /model status | 用 /model default 解除固定,或明确选择另一模型 |
| 文本能回复,工具不执行 | 模型工具能力、端点适配器、工具权限;vLLM 另查 parser/template | 用读取测试文件的真实任务验证,不把文本工具语法当执行结果 |
| 内存不足、加载很慢或超时 | 模型权重/量化、已加载模型、实际上下文与服务日志 | 减少同时加载,降低与硬件不匹配的上下文或换合适模型,再测试 |
| 主模型失败但没有回退 | 是否为会话固定选择、agent 独立 primary 或空链;是否已到运行终止条件 | 先确认选择来源与允许的回退,不无条件延长重试 |
agents.defaults.models 在完成旧策略迁移后用于别名和每模型设置,显式限制放在 agents.defaults.modelPolicy.allow。目录里能看到模型不等于可以调用,允许选择也不等于账号有权限。遇到旧配置迁移诊断,先备份,再按 doctor 指出的修复路径处理;不要通过手工改凭证数据库或批量复制旧认证文件解决。
常见问题
OpenClaw 本地模型最低需要多少内存?
没有适用于所有模型的统一数值。权重精度、量化、加载上下文、运行时和并行请求都会改变资源占用。先选择模型文档允许、自己机器能加载的候选,再完成短回复与工具读取测试;参数量和宣传窗口不能代替实际验证。
Ollama 不需要 key,为什么配置里有 OLLAMA_API_KEY?
官方本地/专用网络规则使用非秘密的 ollama-local 标记,让 OpenClaw 识别这条连接;公开远程服务器与 Ollama Cloud 需要真实凭据。不能把“本地标记可用”扩展成所有 Ollama 主机都不认证。Ollama 认证规则按主机类型区分。
Ollama 的自动发现会下载并加载模型吗?
首次引导的自动发现不会。它只考虑已加载且满足工具与上下文条件的候选;显式 Local only 设置可以准备已安装模型,向导也可能在得到允许后拉取建议模型。一般目录发现读取安装目录,是另一个流程。当前设置说明保留了这些条件。
本地模型能保证 OpenClaw 完全离线吗?
不能仅凭聊天模型本地运行作这个判断。Ollama :cloud 模型仍是远端推理;云端备用、工具、插件、搜索和记忆配置也可能向外部服务发送数据。要运行仅本地工作流,除了选 Local only,还需逐项确认其他功能和回退的数据去向。
配了 fallbacks,为什么 /model 选中的模型失败就停止?
因为当前显式会话模型选择是严格选择,不允许悄悄使用不相关的备用回答。要恢复共享默认模型的正常回退策略,在该会话使用 /model default;独立 agent primary 则需要自己的回退配置。当前回退策略明确区分了这些来源。
models status 正常就证明配置成功了吗?
还没有。它说明配置、认证与运行时的已知状态,不证明实际请求成功。完成同一 agent、同一会话的短回复,再确认一次无害工具真正执行,才有与代理用途相符的初步验证结果。状态命令说明也明确区分状态检查与真实请求。
参考来源19
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月5日。
参考来源19
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月5日。
- 1.OpenAI 设置docs.openclaw.ai/providers/openai/setup
- 2.Anthropic 设置docs.openclaw.ai/providers/anthropic
- 3.Google 设置docs.openclaw.ai/providers/google
- 4.模型 provider 目录docs.openclaw.ai/providers/models
- 5.官方认证与存储说明docs.openclaw.ai/concepts/oauth
- 6.模型 CLI 文档docs.openclaw.ai/cli/models
- 7.Bedrock 接入docs.openclaw.ai/providers/bedrock
- 8.官方认证指南docs.openclaw.ai/gateway/authentication
- 9.当前 provider 规则docs.openclaw.ai/concepts/model-providers/quick-rules
- 10.Ollama 官方下载入口ollama.com/download
- 11.Ollama 设置文档docs.openclaw.ai/providers/ollama/setup
- 12.Ollama 模型发现文档docs.openclaw.ai/providers/ollama/model-discovery
- 13.原生配置docs.openclaw.ai/providers/ollama/configuration
- 14.流式说明docs.openclaw.ai/providers/ollama/advanced
- 15.官方 LM Studio 接入流程docs.openclaw.ai/providers/lmstudio
- 16.vLLM 文档docs.openclaw.ai/providers/vllm
- 17.自定义 provider 说明docs.openclaw.ai/concepts/model-providers/custom-providers
- 18.模型选择说明docs.openclaw.ai/concepts/models
- 19.当前回退规则docs.openclaw.ai/concepts/model-failover