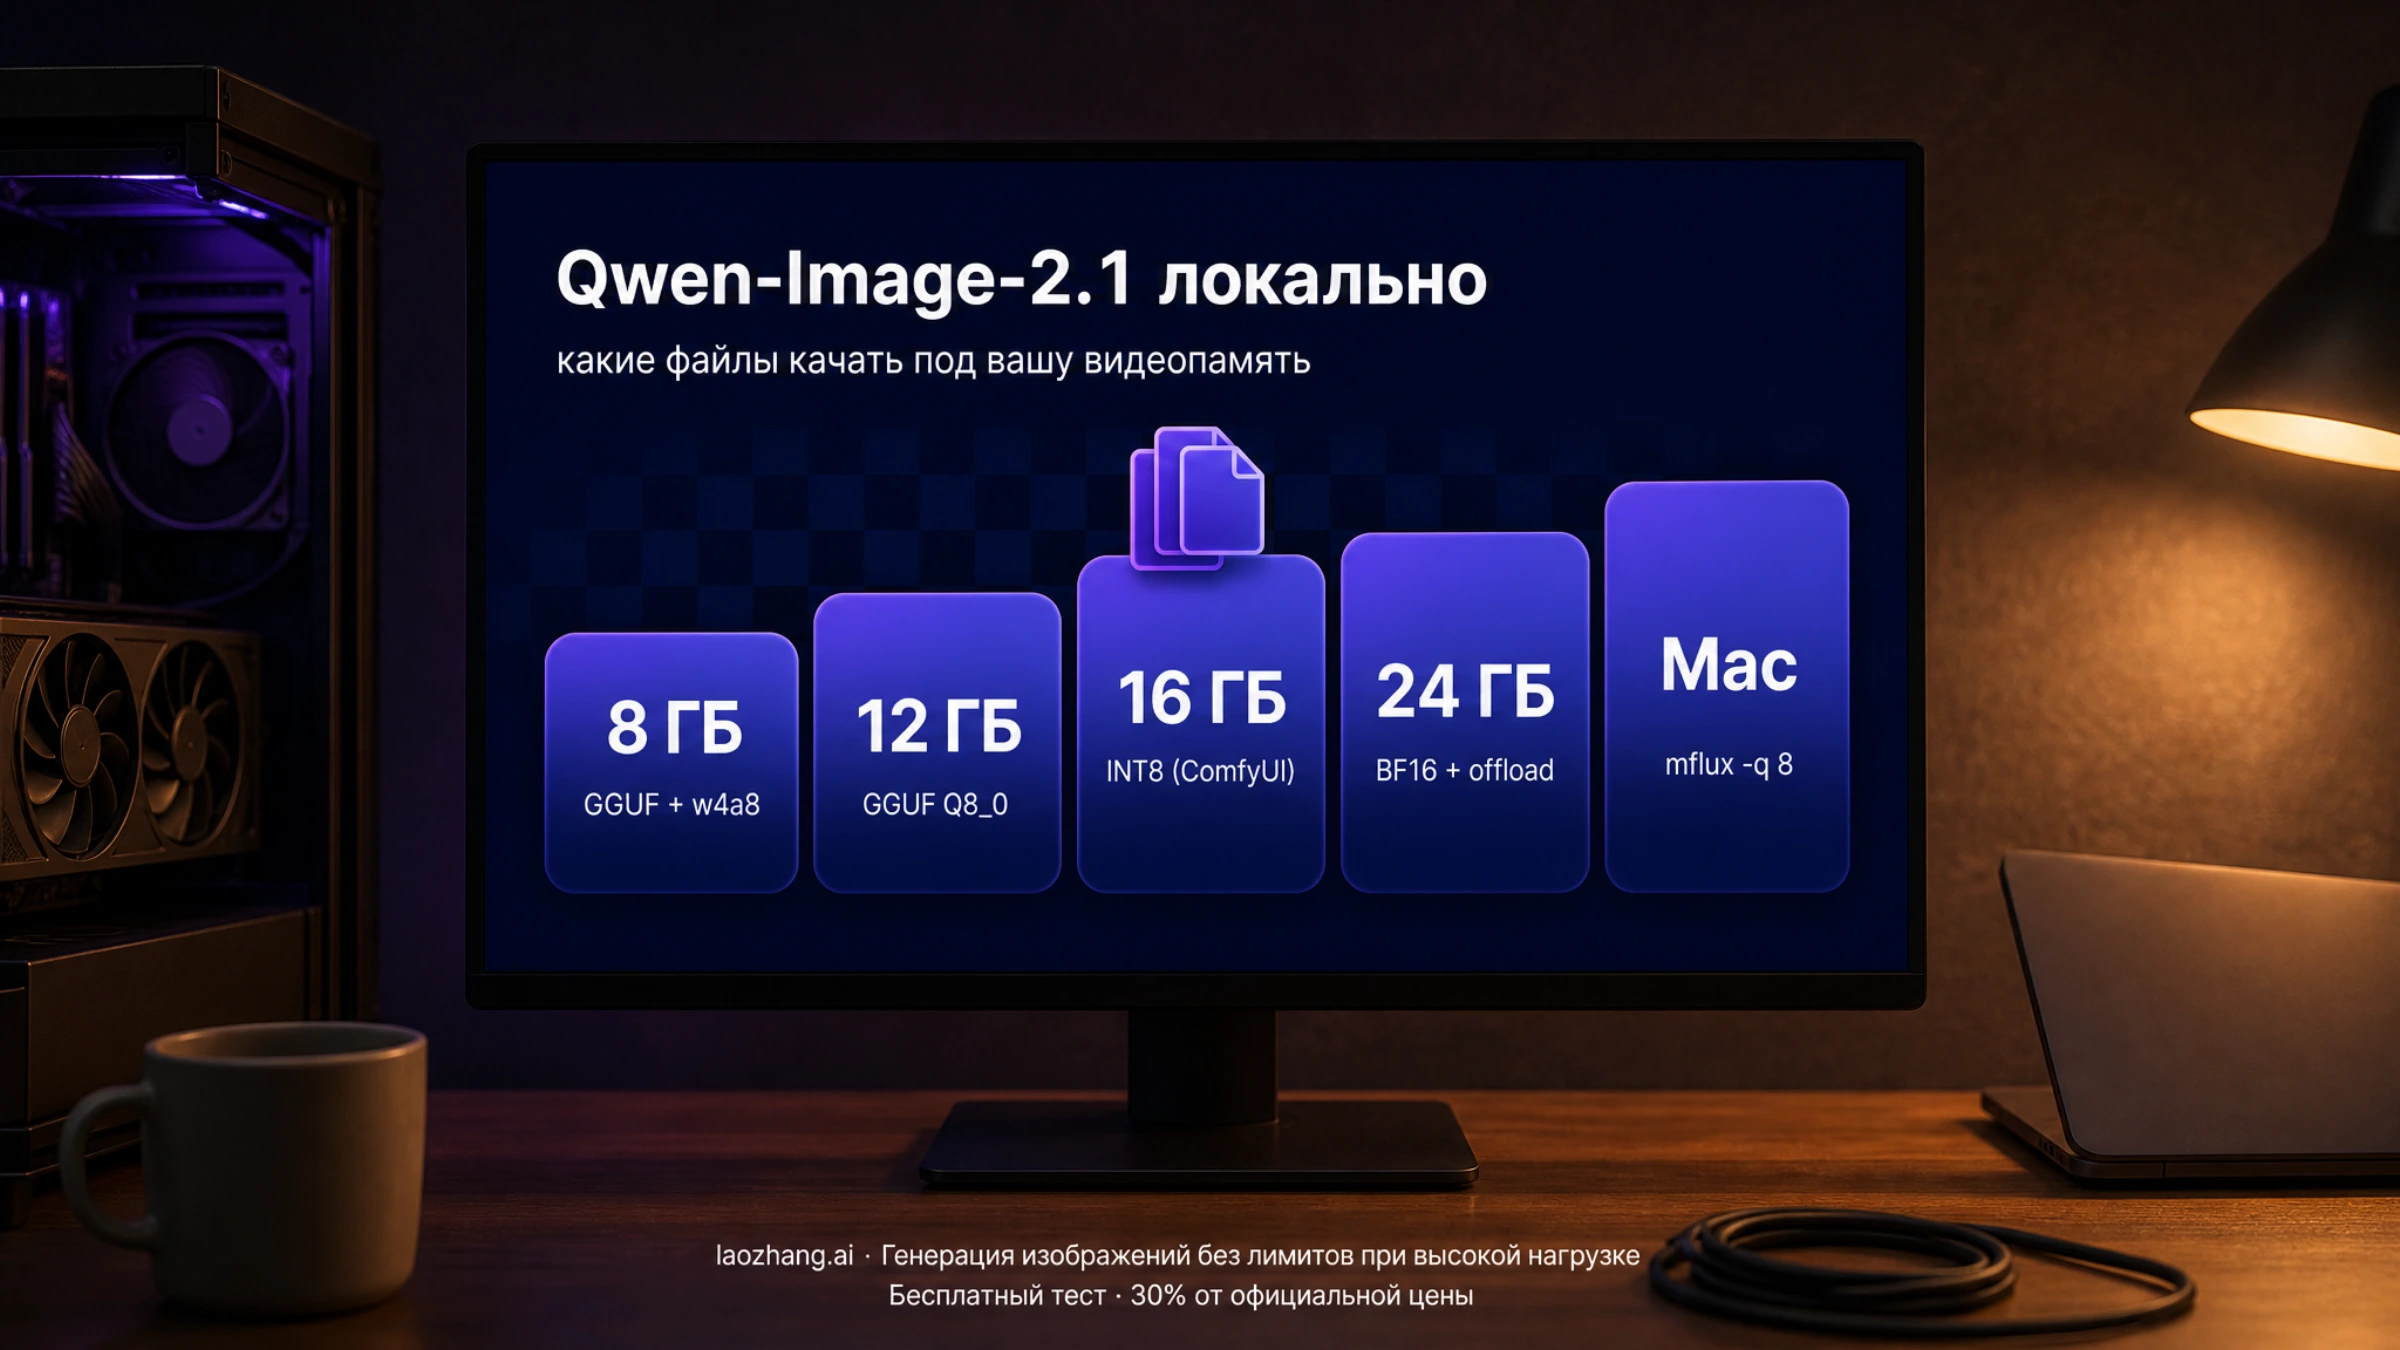
Qwen-Image-2.1 вышла с открытыми весами 20 сентября 2026 года, и локально её запускают не «одной моделью», а одним из нескольких наборов файлов — выбор зависит от памяти, а не от желания. Если у вас видеокарта на 16–24 ГБ, берите официальный набор INT8 для ComfyUI: три файла общим объёмом около 17,3 ГБ на диске и готовые шаблоны из библиотеки ComfyUI. Если 8–12 ГБ — GGUF-версию диффузионной части от сообщества плюс энкодер w4a8 (11,6–14,6 ГБ на диске в зависимости от квантования). На Mac с Apple Silicon — mflux с флагом -q 8, но пока только для генерации по тексту и img2img, без редактирования по референсам. Полный BF16-пайплайн для Diffusers весит 33 ГБ и без offload в чужих замерах занимал около 31 ГБ видеопамяти.
Два уточнения, которые нужно знать до загрузки. Первое: ни Qwen, ни Comfy-Org не публиковали «минимальный объём видеопамяти» — все цифры в этой статье взяты из документации фреймворков и из замеров других людей, с указанием карты, разрешения и настроек. Второе: веса распространяются под Qwen Research License, которая разрешает только некоммерческое использование; чем это ограничивает вас на практике, разобрано в отдельном разделе ниже.
Что именно вы запускаете и почему энкодер важнее DiT
По README проекта Qwen-Image-2.1 состоит из трёх частей: диффузионный трансформер на 7 млрд параметров (32 single-stream-слоя), текстовый энкодер Qwen3-VL 8B и 64-канальный VAE с поддержкой альфа-канала и 16-кратным сжатием. Одна и та же модель делает генерацию по тексту и редактирование: до десяти референсных изображений за запрос, локальные правки по обведённой области, закрашенной области или отдельной маске, нативная генерация RGBA-картинок с прозрачным фоном и вырезание объектов из обычных фото. Родное разрешение — 2048×2048, то есть около 4 мегапикселей.
Для локального запуска ключевая деталь — соотношение размеров. В BF16 текстовый энкодер занимает 17,5 ГБ, а сам трансформер — 14,2 ГБ (по данным Hugging Face API для репозитория Qwen/Qwen-Image-2.1). Поэтому квантование энкодера экономит больше памяти, чем квантование DiT: в рецепте vLLM-Omni на серверных GPU (1024×1024, 40 шагов) перевод энкодера в FP8 снизил пик с 34,0 до 27,5–28,1 ГБ, а перевод DiT в FP8 — только до 32,0–32,7 ГБ. Практический вывод для видеокарты с 8–16 ГБ: сначала решите, какой файл энкодера вы качаете, и только потом — какой файл диффузионной модели.
Ещё одна особенность архитектуры влияет на скорость редактирования: референсы и инструкция кодируются один раз на первом шаге и переиспользуются (в Diffusers это параметр causal_condition, включённый по умолчанию; в ComfyUI за это отвечает узел «Qwen Image 2.1 Cache»).
Ярусы памяти: что качать под вашу карту
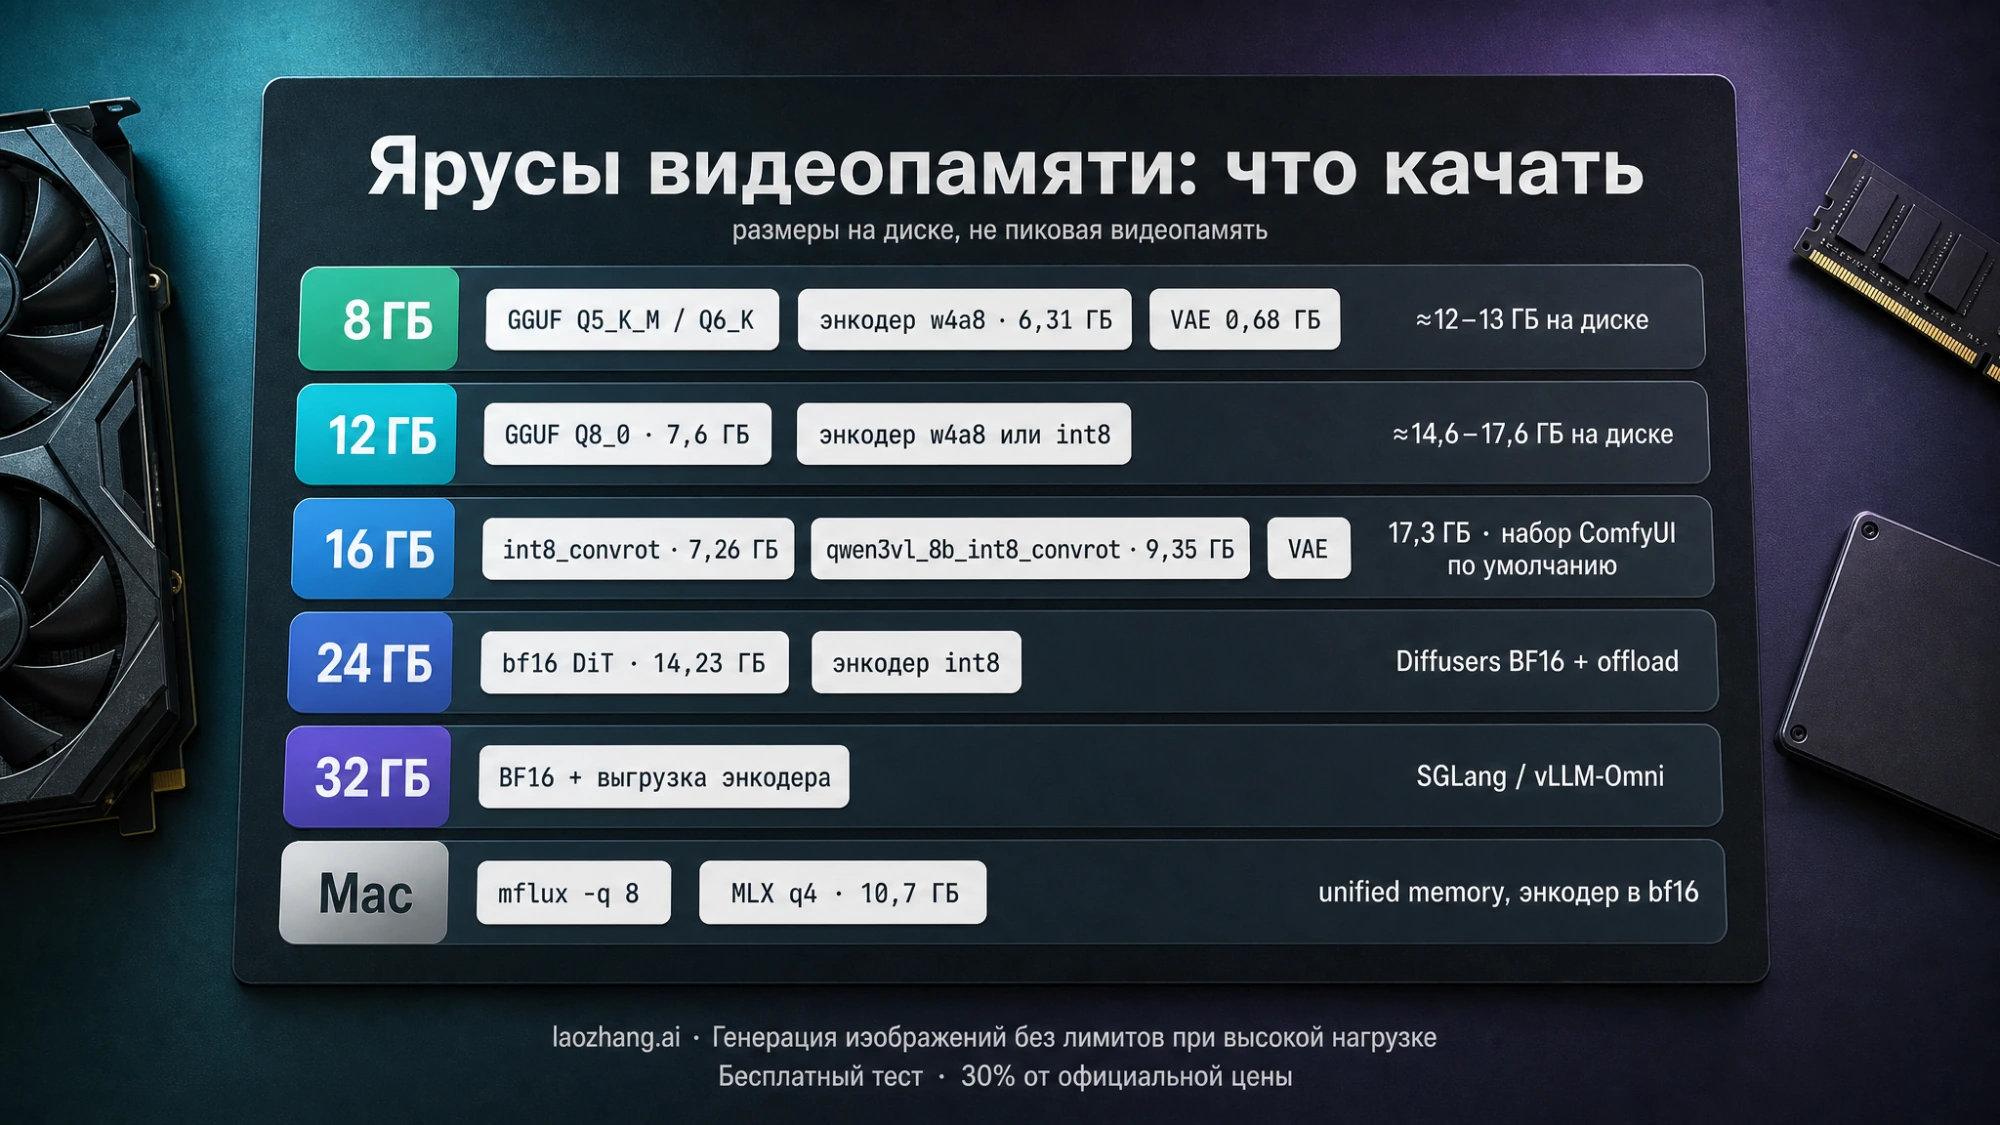
Размеры ниже — десятичные гигабайты на диске по Hugging Face API на 22 сентября 2026 года; это не пиковая видеопамять, поскольку энкодер и трансформер работают по очереди, а фреймворки умеют выгружать часть весов в оперативную память. Столбец с замерами — чужие наблюдения с их условиями; ни одно из них не является требованием.
| Память | Набор файлов | На диске | Чужие замеры и оговорки |
|---|---|---|---|
| 8 ГБ | GGUF Q5_K_M или Q6_K (4,9–5,9 ГБ) + энкодер qwen3vl_8b_w4a8 (6,31 ГБ) + VAE (0,68 ГБ) | ≈12–13 ГБ | Автор GGUF-пака AlperKTS советует Q5_K_M для 8 ГБ, Q6_K для 8–12 ГБ — это рекомендация загрузившего, не замер. Автор японского руководства negi-lab пишет, что Q4_K_M «теоретически» идёт на 8 ГБ, но у него падал при подаче изображения на вход. |
| 12 ГБ | GGUF Q8_0 (7,6 ГБ) + энкодер w4a8 или int8_convrot (6,31 / 9,35 ГБ) + VAE | ≈14,6–17,6 ГБ | AlperKTS: Q8_0 для 12 ГБ и больше. Local Model Watch оценивает Q8_0 в ≈8,5 ГБ видеопамяти с 20-процентным запасом — расчёт, не тест. |
| 16 ГБ | Официальный набор INT8 для ComfyUI: qwen_image_2.1_int8_convrot (7,26 ГБ) + qwen3vl_8b_int8_convrot (9,35 ГБ) + VAE | 17,3 ГБ | Сводка AIReiter со ссылкой на пользователя X: RTX 5070 Ti 16 ГБ, 1024×1024, 20 шагов — около 25 с, пик ≈13,9 ГБ (квантование не указано). negi-lab называет 16 ГБ (RTX 4060 Ti) практическим минимумом. |
| 24 ГБ | Тот же набор INT8 с запасом или qwen_image_2.1_bf16 (14,23 ГБ) + энкодер INT8; в Diffusers — BF16 с enable_model_cpu_offload() | 17,3–24,3 ГБ | Замер на Colab (Zenn, kun432, 2026-09-21): Diffusers BF16 с offload — пик ≈17 ГБ при 2048×2048, 40 шагов. По сводке AIReiter, на RTX 4090 в BF16 — ≈21 с при 1024² и ≈56 с при 1536², модель при этом занимала ≈30 ГБ суммарно по системе. |
| 32 ГБ (RTX 5090) | BF16 DiT + энкодер с послойной выгрузкой; серверные маршруты SGLang / vLLM-Omni | ≈33 ГБ | Документация SGLang (раздел Cookbook): одна RTX 5090, 1024 px, 40 шагов — 14,12 с при потоковой выгрузке энкодера. |
| Mac Apple Silicon | mflux (-q 8 или -q 4, энкодер остаётся в bf16) или MLX-пак toxicdog/Qwen-Image-2.1-MLX (q4, 10,7 ГБ) | 10,7–33 ГБ | Автор PR в mflux на M5 Max: 1024², 40 шагов, bf16 — ≈1,5 с/шаг, ≈78 с на картинку, пик ≈46 ГБ; с -q 8 — ≈30,7 ГБ. Рецензент на M3 Ultra: ≈2,95 с/шаг. Для 32-гигабайтного Mac negi-lab оценивает доступную память в ≈20 ГБ и советует 64 ГБ. |
Расхождения в строке 8 ГБ — не ошибка таблицы, а разные условия. Генерация по тексту на 1024×1024 и редактирование с несколькими референсами 2048×2048 нагружают память по-разному: во втором случае энкодер обрабатывает все входные изображения, и именно на этом этапе у negi-lab падал Q4_K_M. Если у вас 8 ГБ, планируйте первый запуск как генерацию по тексту в 1024×1024 и с энкодером w4a8, а редактирование проверяйте отдельно.
Маршрут 1: ComfyUI с официальными файлами (16 ГБ и больше)
Это самый короткий путь до первой картинки, потому что Comfy-Org выложила и веса, и шаблоны рабочих процессов в день релиза. Официальный туториал требует свежую версию ComfyUI: для локальной установки — nightly, поскольку шаблоны опираются на новые узлы ядра; в стабильном релизе они появятся позже.
Файлы качаются из репозитория Comfy-Org/Qwen-Image-2.1 — не весь репозиторий на 74 ГБ, а по одному файлу каждого типа:
| Папка в ComfyUI | Файл | Размер | Когда брать |
|---|---|---|---|
models/diffusion_models | qwen_image_2.1_int8_convrot.safetensors | 7,26 ГБ | По умолчанию в шаблонах |
models/diffusion_models | qwen_image_2.1_bf16.safetensors | 14,23 ГБ | 24 ГБ и больше, максимальное качество |
models/text_encoders | qwen3vl_8b_w4a8.safetensors | 6,31 ГБ | Самый лёгкий официальный энкодер |
models/text_encoders | qwen3vl_8b_int8_convrot.safetensors | 9,35 ГБ | По умолчанию в шаблонах |
models/text_encoders | qwen3vl_8b_bf16.safetensors | 17,53 ГБ | Только при большом запасе памяти |
models/vae | qwen_image_2.1_vae_bf16.safetensors | 0,68 ГБ | Всегда, один вариант |
Набор по умолчанию (INT8 + INT8 + VAE) — 17,29 ГБ на диске; самый лёгкий официальный набор (INT8 + w4a8 + VAE) — 14,25 ГБ. Туториал не приводит ни размеров, ни цифр видеопамяти; он лишь отмечает, что bf16-варианты «требуют больше памяти».
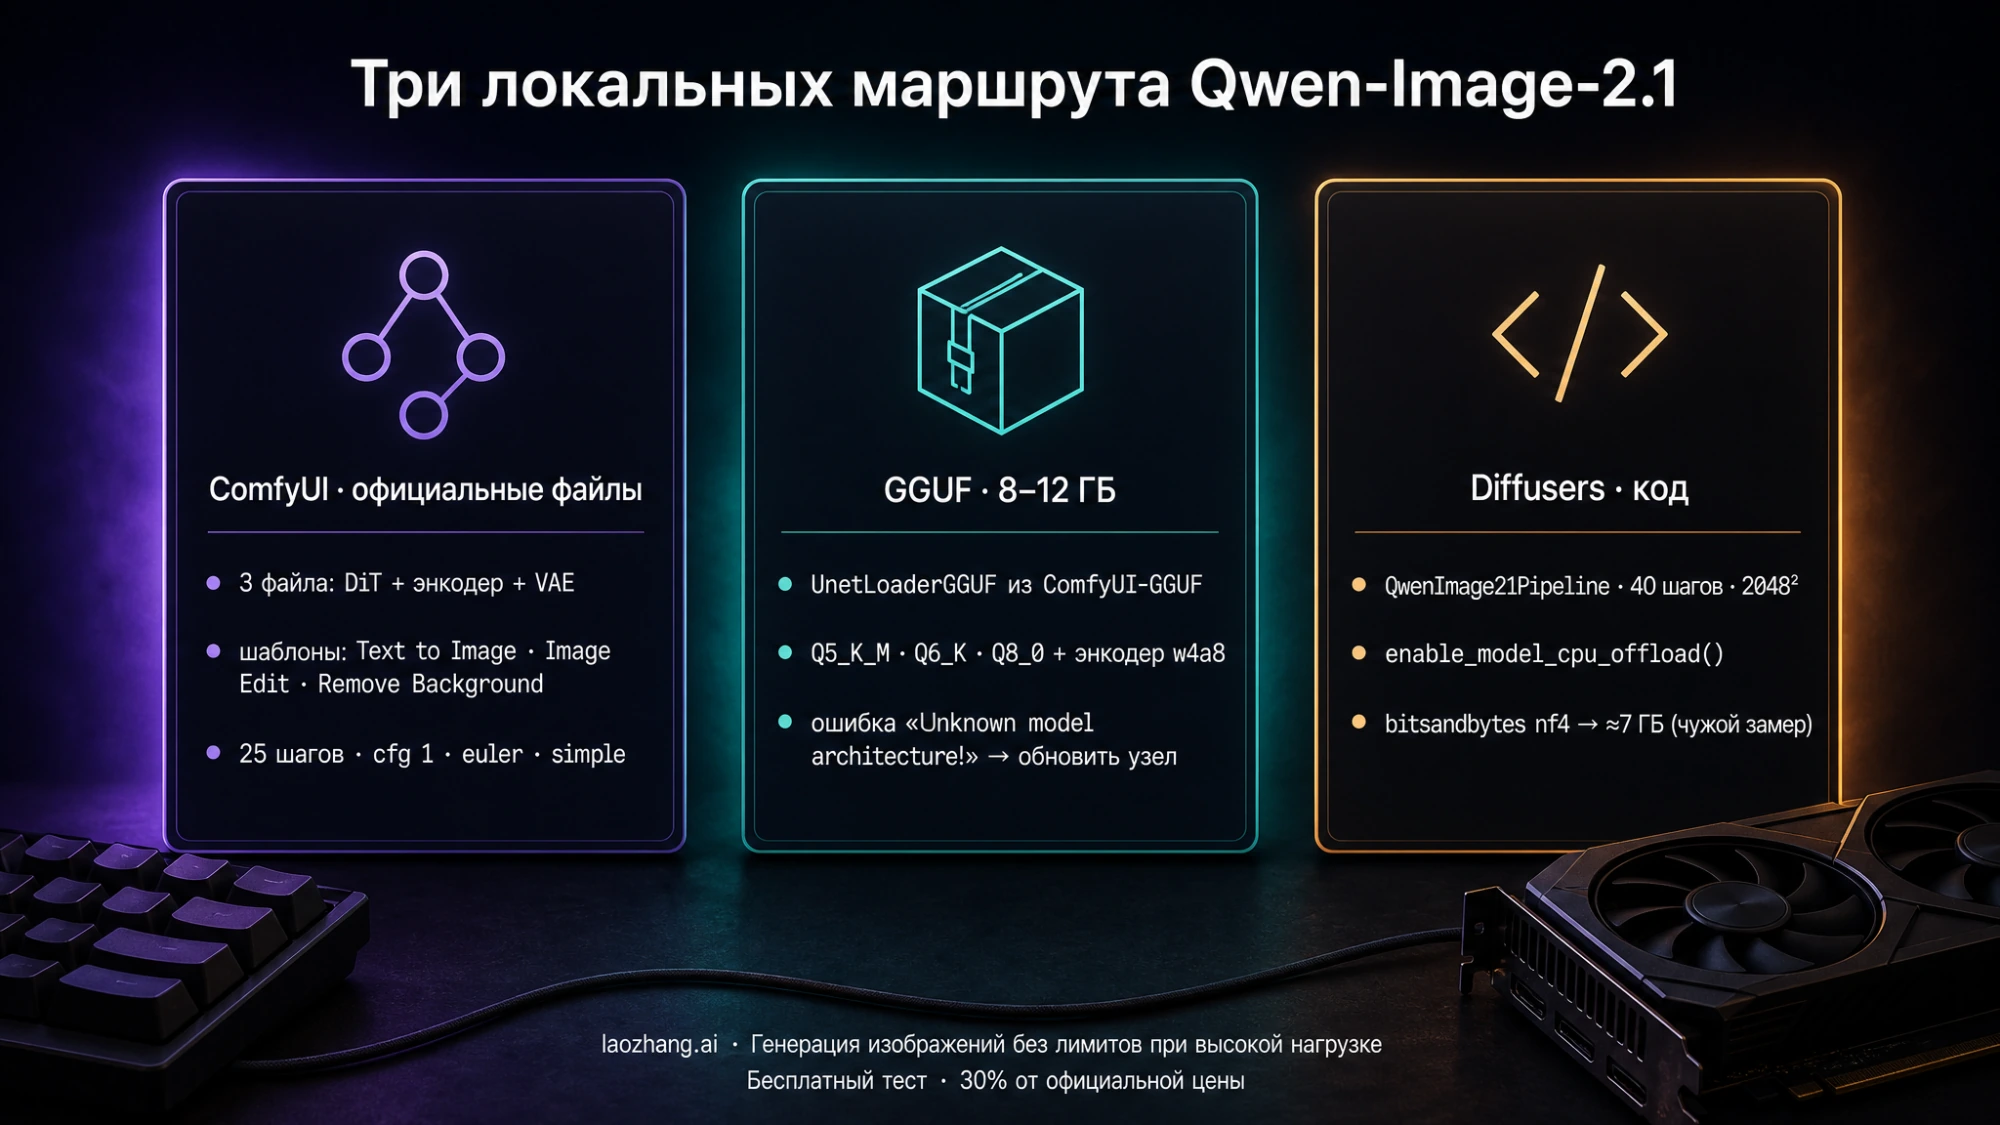
После перезапуска ComfyUI откройте библиотеку шаблонов — там три рабочих процесса: «Qwen-Image-2.1 Text to Image», «Qwen Image 2.1 Image Edit» и «Remove Background: Qwen Image 2.1». Все три используют одинаковые настройки сэмплера: 25 шагов, cfg 1, sampler euler, scheduler simple, цель по разрешению — около 4 МП (2048×2048). Пользователи русской comfyui-wiki отдельно предупреждают, что CFG ниже 1 непригоден, а значение около 1 ведёт себя как у прежней линейки Qwen-Image. Промпт кодируется узлом «Text Encode Qwen Image 2.1».
Для первой картинки достаточно шаблона «Text to Image»: выберите три файла в загрузчиках (если имена совпадают с официальными, они подставятся сами), впишите промпт и запустите. Прозрачный PNG получается через шаблон «Remove Background»: четырёхканальный VAE отдаёт альфа-канал напрямую, без узлов матирования, — загрузите фото объекта, и на выходе будет RGBA-изображение. Редактирование по референсам идёт через шаблон «Image Edit»: он же используется как подграф для удаления фона, поэтому файлы для всех трёх сценариев одни и те же.
Если вы хотите сравнить локальный результат с облачным узлом в том же ComfyUI, порядок настройки официального узла GPT Image 2.5 описан в статье GPT Image 2.5 в ComfyUI — там другая модель и другая лицензия, но одинаковый интерфейс для масок и референсов.
Маршрут 2: GGUF для 8–12 ГБ
GGUF-паки — это перепаковка только диффузионной части; текстовый энкодер и VAE всё равно берутся из Comfy-Org/Qwen-Image-2.1 в формате safetensors. На 22 сентября в Hugging Face было два репозитория с тегом quantized:Qwen/Qwen-Image-2.1:
AlperKTS/Qwen-Image-2.1-GGUF(20 сентября): Q5_K_M 4,89 ГБ, Q6_K 5,84 ГБ, Q8_0 7,62 ГБ.JohnsonHsu/Qwen-Image-2.1-GGUF(22 сентября): Q4_0 4,05 ГБ, Q4_K_M 4,60 ГБ, Q5_K_M 5,22 ГБ, Q6_K 5,88 ГБ, Q8_0 7,59 ГБ.
Это работы сообщества, а не Qwen или Comfy-Org: авторы сами предупреждают о потере качества на Q4, а рекомендации «Q8_0 для 12 ГБ, Q6_K для 8–12 ГБ, Q5_K_M для 8 ГБ» на карточке AlperKTS — это оценка загрузившего. Самая лёгкая связка — Q4_K_M + qwen3vl_8b_w4a8 + VAE — занимает 11,6 ГБ на диске.
Загружаются GGUF-файлы узлом «Unet Loader (GGUF)» (UnetLoaderGGUF) из расширения ComfyUI-GGUF. Установка: клонировать репозиторий в ComfyUI/custom_nodes и выполнить pip install --upgrade gguf в окружении ComfyUI, либо поставить через ComfyUI Manager. GGUF-файл кладётся в ComfyUI/models/unet, после чего в официальном шаблоне «Text to Image» узел загрузки диффузионной модели заменяется на GGUF-загрузчик, остальные узлы остаются как есть.
Одна ловушка: старые версии ComfyUI-GGUF не знают архитектуру Qwen-Image-2.1 и выдают ошибку «Unknown model architecture!». Если вы её видите, обновите расширение (Local Model Watch ссылается на форк leejet, где поддержка уже есть) — файл модели в этом случае в порядке. README основного репозитория city96/ComfyUI-GGUF на момент проверки не перечислял Qwen-Image-2.1 в списке поддерживаемых моделей, поэтому совместимость зависит от версии узла, а не только от наличия файла.
Маршрут 3: Diffusers, если нужен код
Официальный путь для Python — класс QwenImage21Pipeline из dev-ветки Diffusers. Установка по README:
bashpip install "torch>=2.4.0" "transformers>=5.17"
pip install git+https://github.com/huggingface/diffusers
pip install accelerate pillow
Генерация по тексту с настройками по умолчанию — 40 шагов и 2048×2048:
pythonimport torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
).to("cuda")

image = pipe(
    prompt="Неоновая вывеска с надписью \"QWEN IMAGE 2.1\", дождливая ночь, отражения на мокром асфальте",
    num_inference_steps=40,
    generator=torch.Generator("cuda").manual_seed(42),
).images[0]
image.save("t2i.png")
Такой вызов тянет с Hugging Face все 33,13 ГБ (энкодер 17,5 ГБ в четырёх шардах, трансформер 14,2 ГБ, VAE 1,35 ГБ) и загружает их в видеопамять целиком. В замере kun432 на Colab (A100 80 ГБ, 2048×2048, 40 шагов) пик без оптимизаций составил около 31 ГБ. Для карт поменьше README предлагает pipe.enable_model_cpu_offload() вместо .to("cuda") — у того же тестера это дало пик ≈17 ГБ, а исходный прогон на A100 без оптимизаций занимал чуть больше минуты на картинку 2048×2048. На L4 с 24 ГБ даже с offload случался OOM на этапе декодирования, пока не включили pipe.vae.enable_tiling(); правда, тайлинг при 2048×2048 давал вертикальные полосы на изображении, так что это компромисс, а не бесплатная опция.
Самый экономный вариант в том же замере — 4-битное квантование через bitsandbytes для трансформера и энкодера одновременно, пик ≈7 ГБ:
pythonfrom diffusers import PipelineQuantizationConfig

quant = PipelineQuantizationConfig(
    quant_backend="bitsandbytes_4bit",
    quant_kwargs={
        "load_in_4bit": True,
        "bnb_4bit_quant_type": "nf4",
        "bnb_4bit_compute_dtype": torch.bfloat16,
        "bnb_4bit_use_double_quant": True,
    },
    components_to_quantize=["transformer", "text_encoder"],
)
pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", quantization_config=quant, torch_dtype=torch.bfloat16
)
pipe.enable_model_cpu_offload()
Это конфигурация одного тестера на облачных GPU, а не гарантия для вашей карты; но она показывает, что порядок величины «около 7 ГБ» для полного пайплайна в 4 битах достижим — и это согласуется с рекомендациями GGUF-паков для 8-гигабайтных карт.
Редактирование в Diffusers делается тем же пайплайном: параметр image= принимает одно изображение PIL или список до десяти. Для прозрачных изображений README задаёт шаблон промпта — This is an RGBA image with transparency. <описание>. The image has alpha channel and the background is transparent. — и напоминает сохранять результат в PNG, иначе альфа-канал потеряется.
Отдельно существуют модели переписывания промптов Qwen/Qwen-Image-2.1-PE-T2I и Qwen/Qwen-Image-2.1-PE-I2I (≈18,8 ГБ в bf16; для ComfyUI есть INT8-версии по 9,47 ГБ в том же репозитории Comfy-Org). Они необязательны, но kun432 отмечает заметное улучшение результата, особенно для промптов не на английском, — для русских промптов это стоит проверить, если качество с сырым текстом не устраивает. Запускаются через vLLM или локально из папки prompt_rewrite/ репозитория.
Маршрут 4: Mac на Apple Silicon
README Qwen описывает только CUDA-путь; на Mac рабочим вариантом на 22 сентября был mflux — MLX-реализация, в которую 21 сентября приняли PR #736 с командой mflux-generate-qwen-2.1:
bashuv tool install --upgrade mflux

mflux-generate-qwen-2.1 \
  --prompt "Плакат в стиле конструктивизма, красный и чёрный, геометрические формы" \
  --steps 40 \
  --seed 42 \
  -q 8
Цифры автора PR на M5 Max при 1024×1024 и 40 шагах: в bf16 около 1,5 с на шаг и 78 с на картинку при пике ≈46 ГБ unified memory; с -q 8 пик снижается до ≈30,7 ГБ. Рецензент на M3 Ultra получил ≈2,95 с на шаг, то есть около двух минут. Документация mflux называет 64 ГБ «комфортным значением по умолчанию» и советует -q 8 при нехватке памяти. Важная деталь: квантование в mflux затрагивает только диффузионную часть, а энкодер Qwen3-VL остаётся в bf16 — именно поэтому даже -q 4 не превращает модель в «лёгкую» для Mac на 16–32 ГБ.
Ограничения первой версии: PR #736 отложил вариант с редактированием по референсам (ему нужна визуальная башня Qwen3-VL), LoRA и кэш префикса. Более поздний PR #741 по названию добавляет редактирование, RGBA и кэширование, но на момент подготовки статьи его содержимое не проверялось — уточните в репозитории mflux, если редактирование на Mac для вас главное. Есть также img2img через --image-path и --image-strength, и настоящий CFG через --negative-prompt с --guidance — по умолчанию сэмплирование идёт без guidance.
Альтернатива — пак toxicdog/Qwen-Image-2.1-MLX в 4 битах (DiT 4,00 ГБ + энкодер 6,02 ГБ + VAE 0,68 ГБ = 10,7 ГБ на диске); здесь квантован и энкодер, но замеров памяти автор не публиковал. Diffusers на MPS тоже отрабатывает: автор PR в mflux сравнивал своё время (78 с) с 85 с у Diffusers на том же M5 Max, — но без квантования, то есть с тем же порядком памяти, что и bf16.
Серверные маршруты для 24 и 32 ГБ
Если нужен API для нескольких клиентов, а не интерфейс, у SGLang-Diffusion есть готовый раздел Cookbook с флагами под потребительские карты: для RTX 4090 — --performance-mode manual --dit-layerwise-offload true --text-encoder-cpu-offload true, для RTX 5090 — --performance-mode manual --component-residency text_encoder=layerwise-offload. Замер авторов на одной RTX 5090 при 1024 px и 40 шагах: 14,12 с с потоковой выгрузкой энкодера против 19,95 с при потоковой выгрузке DiT — ещё одно подтверждение, что выгружать выгоднее энкодер. Прозрачные изображения запрашиваются параметром "background": "transparent", правки — через /v1/images/edits с загрузкой PNG; CLI генерации использует --num-inference-steps 40 --guidance-scale 1.
vLLM-Omni поддерживает FP8 для энкодера и трансформера (quantization_config={"transformer": {"method": "fp8", "ignored_layers": ["img_mlp"]}, "text_encoder": {"method": "fp8"}}), но рецепт написан под NVIDIA-серверы: измерения делались на GB200/GB300, пик BF16 — 34,0 ГБ. Для домашней карты это ориентир по структуре памяти, а не инструкция.
Лицензия: что можно, а что нет
Веса Qwen-Image-2.1 выпущены под Qwen Research License Agreement, а не под Apache 2.0, как предыдущая Qwen-Image-2512 на 20 млрд параметров. Текст лицензии разрешает использовать, воспроизводить, распространять и модифицировать материалы «только в некоммерческих целях» — для исследований или оценки. Для любого коммерческого применения нужна отдельная лицензия; контакт в документе — model-business@notice.qwencloud.com. При распространении производных (в том числе GGUF- и MLX-перепаковок, которые в Hugging Face помечены как license:other) требуется приложить текст соглашения, отметить изменённые файлы, сохранить уведомления, указать «Built with Qwen» или «Improved using Qwen» и не использовать «Qwen» как основное название производной.
Про сгенерированные изображения в тексте лицензии отдельного пункта нет. 21 сентября команда Qwen написала в X, что результаты генерации не входят в лицензируемые материалы и права на них остаются у пользователя; текст поста известен только по поисковому фрагменту, а в обсуждении №6 на странице модели участники возражают, что пост в соцсети не переписывает файл LICENSE. Рабочая трактовка на сегодня: продавать картинки, сделанные локально «для оценки», — серая зона, о которой команда высказалась в вашу пользу; строить на весах коммерческий сервис или встроить модель в продукт — однозначно требует отдельной лицензии. Там же в обсуждении спорят, считается ли хобби «исследованием или оценкой». Это не юридическая консультация.
Если памяти не хватает или мешает лицензия
Для оценки модели без загрузки 14–33 ГБ есть официальное демо в Hugging Face Space Qwen/Qwen-Image-2.1; на ModelScope выложены те же веса и DiffSynth-Studio с онлайн-генерацией и обучением LoRA. Если вы выбираете видеокарту под такие задачи, разбор компромиссов между 16-гигабайтными моделями есть в статье как выбрать видеокарту с 16 ГБ — там речь про LLM, но соображения о памяти и энергопотреблении те же.
Если результат нужен для коммерческой работы уже сейчас, честнее не искать обходные пути вокруг лицензии, а взять модель с подходящими условиями. В каталоге laozhang.ai на 22 сентября нет моделей семейства Qwen-Image; из хостинговых моделей для изображений там перечислены gpt-image-2.5-flare и gpt-image-2.5-sunburst, gemini-3.1-flash-image, gemini-3-pro-image, flux-2-pro, flux-kontext-pro и seedream-5-0-260128 через эндпоинты Images и Chat Completions; актуальные цены смотрите в документации моделей, они меняются. Обзор облачных и открытых вариантов редактирования по загруженной картинке — в статье альтернативы для AI-редактирования изображений.
Частые вопросы
Пойдёт ли Qwen-Image-2.1 на видеокарте с 8 ГБ?
Для генерации по тексту в 1024×1024 — по чужим наблюдениям да: 4-битный пайплайн в Diffusers дал пик ≈7 ГБ в замере на Colab, авторы GGUF-паков советуют Q5_K_M или Q6_K для 8 ГБ, а энкодер нужно брать w4a8 (6,31 ГБ). Редактирование с несколькими референсами на 8 ГБ — риск: у автора negi-lab Q4_K_M падал именно при подаче изображения. Официального требования к памяти не существует, поэтому проверяйте на своей карте, начиная с малого разрешения.
Сколько места на диске занимает локальная установка?
Официальный набор INT8 для ComfyUI — 17,3 ГБ; самый лёгкий официальный набор с энкодером w4a8 — 14,3 ГБ; GGUF Q4_K_M + w4a8 + VAE — 11,6 ГБ; MLX-пак в 4 битах — 10,7 ГБ; полный BF16 для Diffusers — 33,1 ГБ. Модели переписывания промптов добавляют 9,5 ГБ (INT8 для ComfyUI) или 18,8 ГБ (bf16 на Hugging Face) каждая. Это десятичные гигабайты по данным Hugging Face API, без учёта кэшей и выходных файлов.
ComfyUI или Diffusers — что выбрать для первого запуска?
ComfyUI, если нужна первая картинка сегодня: три файла, три шаблона, настройки уже выставлены (25 шагов, cfg 1, euler, simple). Diffusers — если результат нужно встроить в скрипт или включить 4-битное квантование bitsandbytes; там по умолчанию 40 шагов и 2048×2048, и без enable_model_cpu_offload() пайплайн рассчитан на 30+ ГБ видеопамяти. Разница в шагах — особенности двух реализаций, а не противоречие.
Как получить PNG с прозрачным фоном?
В ComfyUI — шаблон «Remove Background: Qwen Image 2.1»: VAE выдаёт альфа-канал напрямую, без узлов матирования. В Diffusers — шаблон промпта из README (This is an RGBA image with transparency. … The image has alpha channel and the background is transparent.) и сохранение в PNG. В SGLang — параметр "background": "transparent". В mflux первой версии генерация RGBA была отложена.
Можно ли продавать изображения, сделанные локально?
Лицензия разрешает использовать саму модель только в некоммерческих целях, а про права на результаты молчит. Команда Qwen заявила в X, что права на сгенерированные изображения остаются у пользователя, но это пост, а не текст соглашения, и в обсуждении на Hugging Face с этим спорят. Для коммерческого сервиса на базе модели в любом случае нужна отдельная лицензия по адресу model-business@notice.qwencloud.com.
Нужна ли модель переписывания промптов?
Нет, базовый пайплайн работает и без неё. Но по наблюдению kun432 модели PE-T2I / PE-I2I заметно улучшали результат, особенно для промптов не на английском. Если русские промпты дают слабую композицию или ошибки в тексте на картинке, добавьте INT8-версию PE-энкодера в ComfyUI (9,47 ГБ) и сравните на тех же seed.