MiniMax M3.1 Flash: размер модели 252 ГБ и что влезет в память
MiniMax M3.1 Flash — около 428 млрд параметров и 252,4 ГБ весов. В 32-гигабайтную карту не влезает; на 256 ГБ — MLX 3-bit или GGUF Q3, на 8×H100 — оригинал.
Содержание
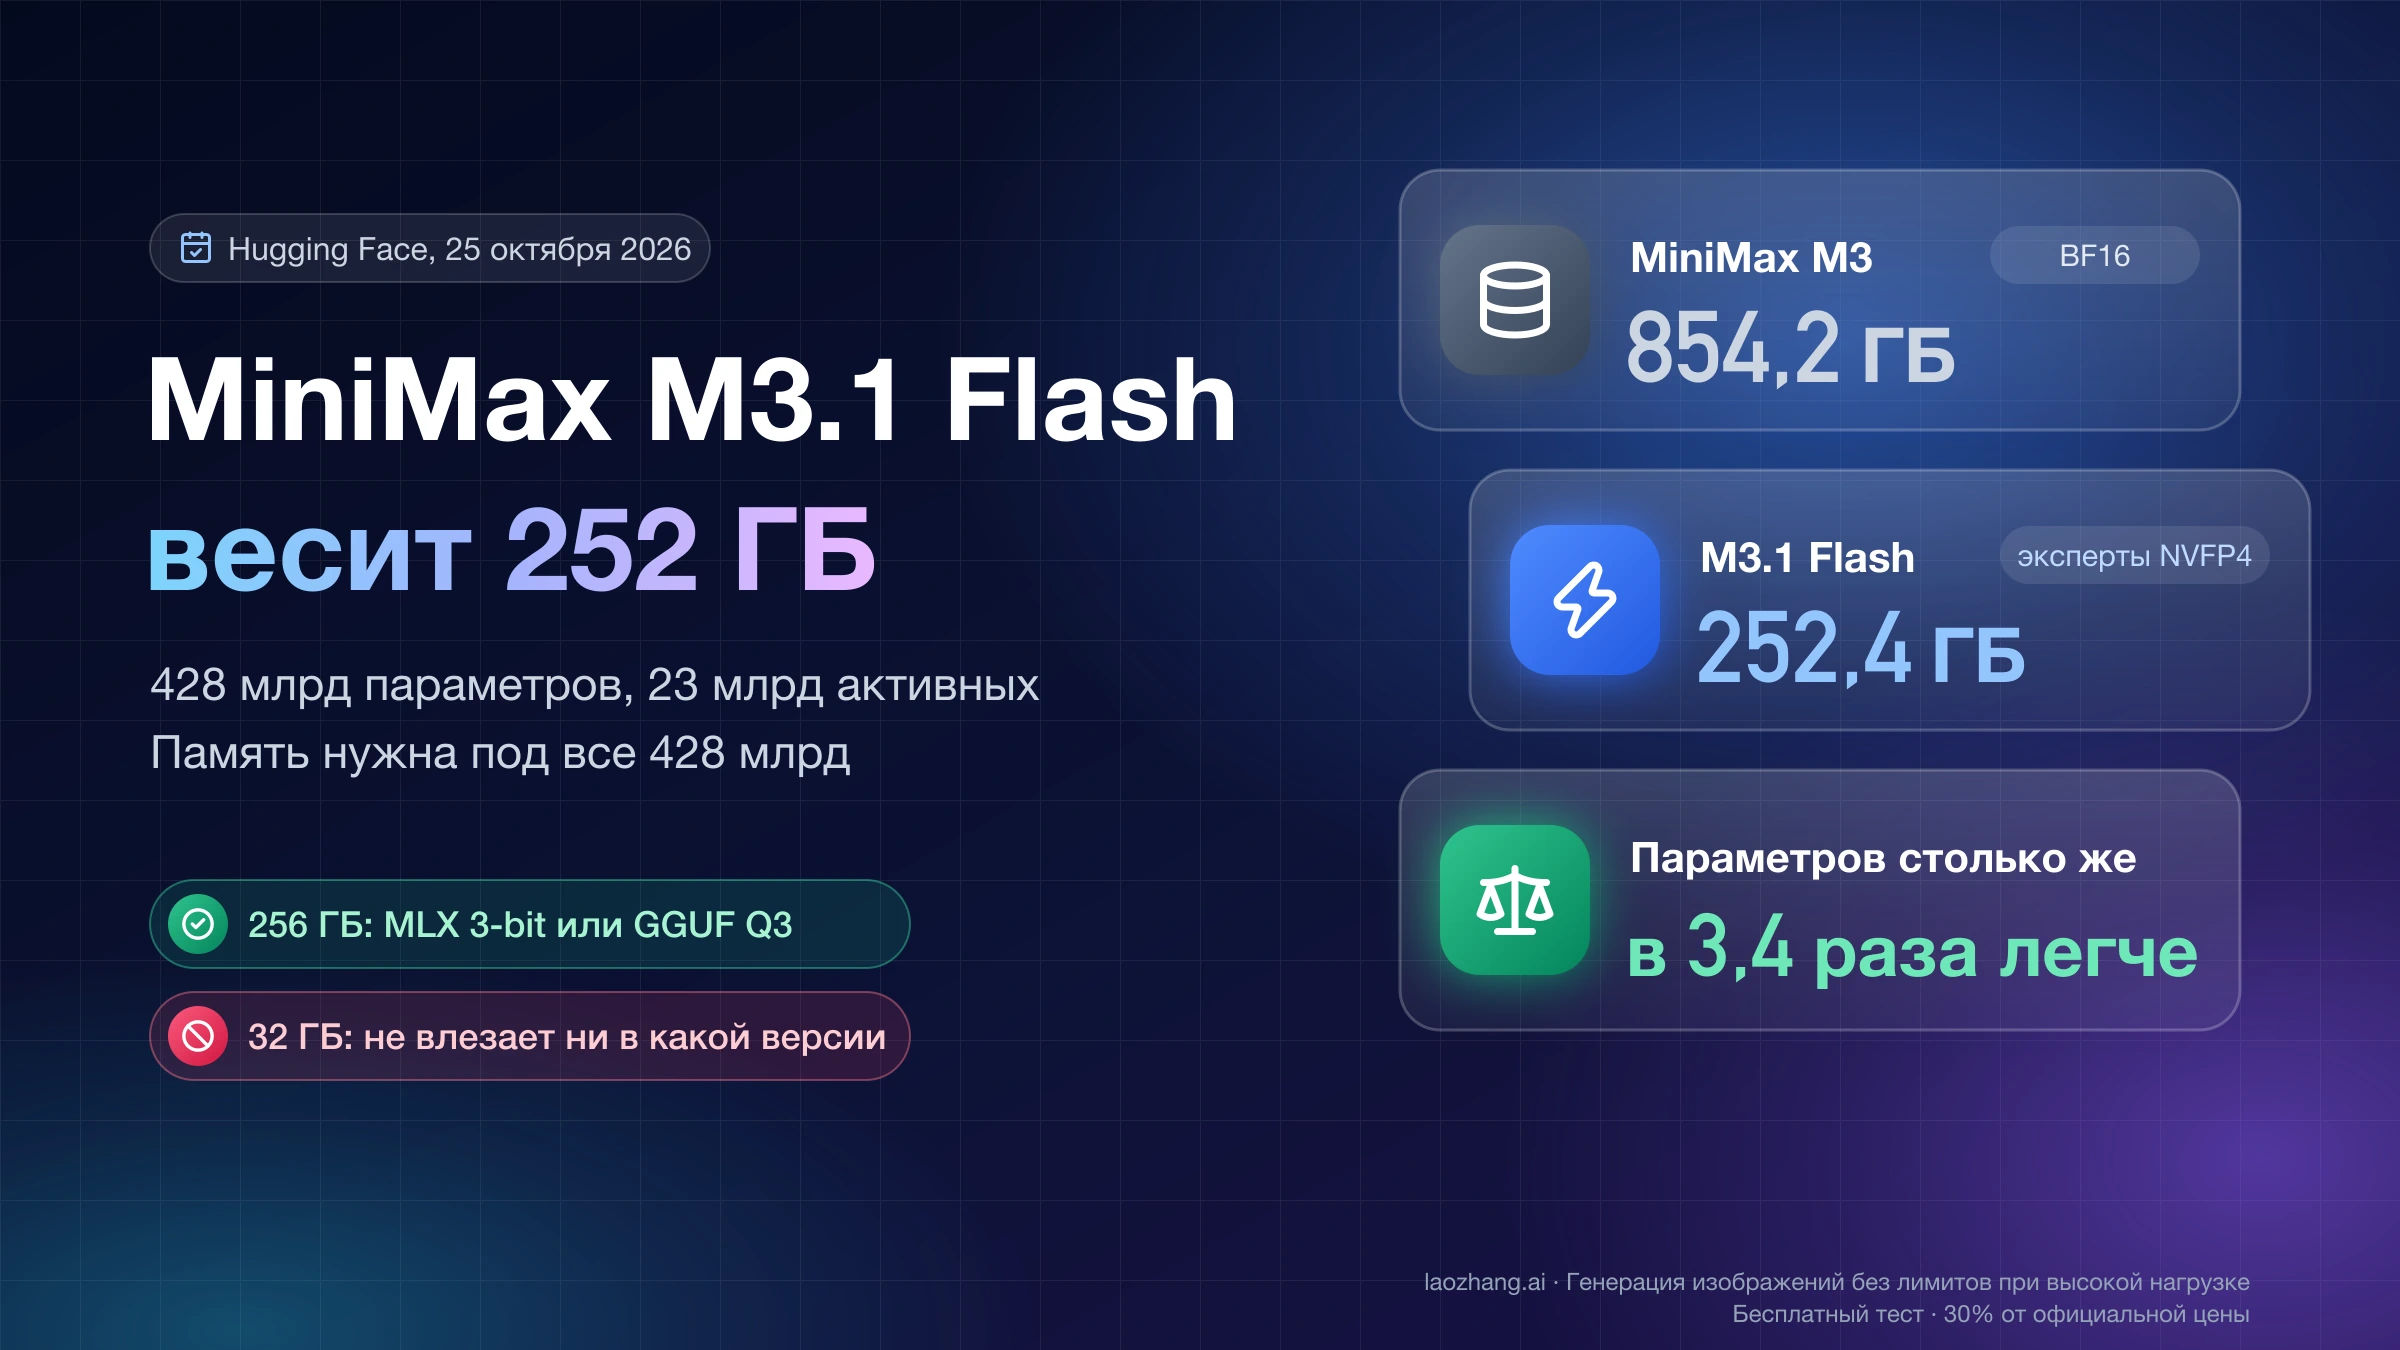
MiniMax M3.1 Flash — не маленькая модель. В ней около 428 млрд параметров, из которых на каждый токен работают примерно 23 млрд, а официальный репозиторий MiniMaxAI/MiniMax-M3.1-Flash на Hugging Face по состоянию на 25 октября 2026 года весит 252,4 ГБ. «Flash» здесь означает 4-битные эксперты, обученные сразу с квантованием, а не меньшее число параметров: у MiniMax M3 параметров столько же, но её BF16-репозиторий занимает 854,2 ГБ.
Какую версию качать, решает суммарная память ваших GPU или объединённая память Mac. Сервер на 8×H100 или 4×B200 берёт официальный чекпойнт и vLLM 0.33.0 или новее. Mac Studio на 512 ГБ — mlx-community/MiniMax-M3.1-Flash-Text-4bit, на 256 ГБ — MLX 3-bit или GGUF UD-Q3_K_XL из unsloth/MiniMax-M3.1-Flash-GGUF в llama.cpp сборки b11861 или новее. В одну видеокарту на 32 ГБ модель не помещается ни в какой версии, а на 128 ГБ влезает только 1-битный квант без запаса, поэтому в этих случаях разумнее API MiniMax за $0,15 за 1 млн входных и $0,60 за 1 млн выходных токенов.
Размеры всех версий ниже сняты 25 октября 2026 года через API Hugging Face, число параметров пересчитано по config.json, а таблица «что во что помещается» посчитана по этим размерам. Саму модель не скачивали и не запускали, поэтому всё, что касается скорости и поддержки движками, взято из документации MiniMax, vLLM, SGLang, llama.cpp и сообщений сообщества.
Размер MiniMax M3.1 Flash: 428B параметров, из них 23B активных
В карточке модели на Hugging Face MiniMax указывает «примерно 428B параметров всего, 23B активных на токен». Это нативно мультимодальная MoE-модель (mixture of experts): на вход принимает текст, изображения и видео, на выходе даёт текст, контекст — до 1 млн токенов. Пересчёт по config.json сходится с карточкой: 60 слоёв, из них 3 плотных и 57 с экспертами, в каждом MoE-слое 128 маршрутизируемых экспертов, из которых на токен выбираются 4, плюс один общий. Только маршрутизируемые эксперты дают 57 × 128 × 3 × 6144 × 3072 ≈ 413,1 млрд параметров; вместе с вниманием (6,42 млрд), общими экспертами (3,23 млрд), эмбеддингами и выходным слоем (2,46 млрд) текстовая часть набирает около 425,9 млрд, а нормализации, роутер, индексные проекции разреженного внимания и визуальный энкодер добирают остаток до 428 млрд.
Почему такая модель весит «всего» 250 ГБ, объясняет раскладка точности в quantization_config. Маршрутизируемые эксперты хранятся в 4-битном NVFP4, внимание и плотные слои — в 8-битном MXFP8, а эмбеддинги, выходной слой, роутер и визуальная часть остаются в BF16. Квантование здесь не наложено после обучения: по словам MiniMax, эксперты и пути внимания квантовались уже во время обучения (quantization-aware training), и результаты бенчмарков в карточке относятся именно к этим официальным весам, а не к сторонним квантам.
Число 23B не является требованием к памяти. Роутер на каждом токене выбирает других экспертов, поэтому в памяти должны лежать все 428 млрд параметров, а 23 млрд определяют только объём вычислений на токен. Та же путаница встречается у другой Flash-модели с открытыми весами — подробнее в статье GLM-5.3-Flash: что скрывалось под именем Ox Alpha и как выбрать способ запуска.
Flash также не меньше MiniMax M3. Метаданные репозитория MiniMaxAI/MiniMax-M3 на 25 октября 2026 года показывают 427,0 млрд параметров в BF16 при общем объёме 854,2 ГБ, то есть официальная загрузка M3.1 Flash легче примерно в 3,4 раза только за счёт 4-битных экспертов. Отдельной BF16-версии M3.1 Flash MiniMax не выпускала, поэтому цифра «856 ГБ в BF16» — теоретическая оценка (428 млрд параметров × 2 байта), а не файл, который можно скачать. Кроме квантования, M3.1 Flash отличается от M3 разреженным вниманием MSA во всех слоях (у M3 первые три слоя были с полным вниманием) и черновой моделью DSpark для спекулятивного декодирования вместо прежнего MTP.
Почему Hugging Face показывает 220B params, а не 428B
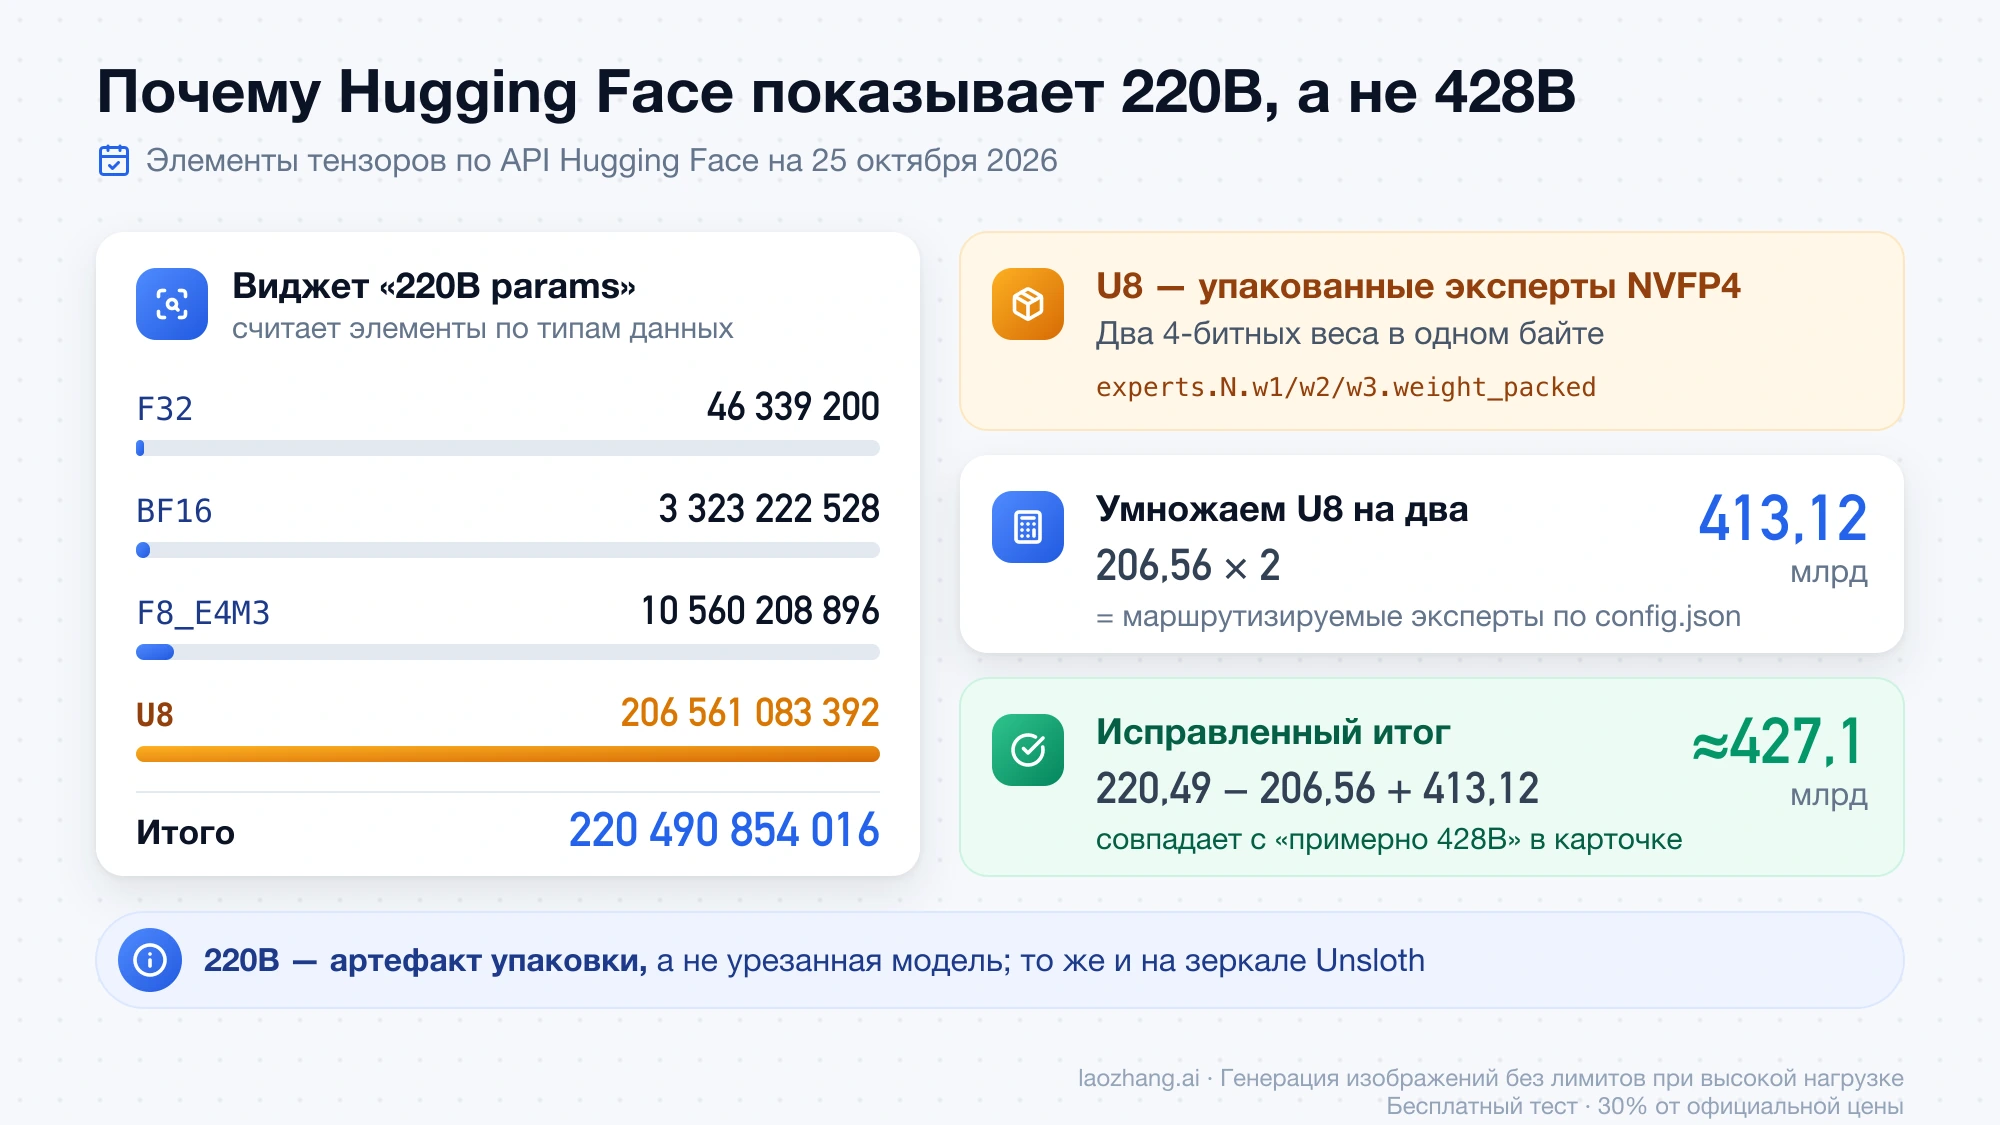
Виджет «220B params» на странице репозитория считает элементы тензоров по типам данных из метаданных safetensors, а упакованные 4-битные эксперты хранятся как U8 — по два веса в одном байте. По API Hugging Face на 25 октября 2026 года в официальном репозитории числятся F32 — 46 339 200, BF16 — 3 323 222 528, F8_E4M3 — 10 560 208 896 и U8 — 206 561 083 392 элемента, итого 220 490 854 016. Тензоры U8 в индексе весов называются experts.N.w1/w2/w3.weight_packed, а в конфиге стоит moe_quant_format: "nvfp4-pack-quantized".
Если умножить U8 на два, получится 413,1 млрд — ровно столько, сколько дал пересчёт маршрутизируемых экспертов по конфигу. Исправленный итог: 220,49 − 206,56 + 413,12 ≈ 427,1 млрд, что совпадает с «примерно 428B» в карточке. Значит, 220B — артефакт упаковки, а не урезанная модель; тот же виджет показывает 220B и на зеркале unsloth/MiniMax-M3.1-Flash.
Какую версию MiniMax M3.1 Flash качать с Hugging Face
Для большинства задач выбор сводится к трём семействам: официальный чекпойнт для серверов NVIDIA и AMD, MLX-версии для Mac и GGUF от Unsloth для llama.cpp, в том числе с выгрузкой части весов в оперативную память. На 25 октября 2026 года поиск Hugging Face по названию модели выдавал 49 репозиториев; в таблице — версии от MiniMax, AMD, FlagOS, mlx-community и Unsloth плюс одна заметная сборка сообщества. Размеры — сумма файлов весов по API Hugging Face в десятичных гигабайтах, как их показывает сам Hugging Face; в скобках — гибибайты (1 ГиБ = 1,074 ГБ), в которых удобнее сравнивать с памятью. Последний столбец — сколько памяти нужно, чтобы веса занимали не больше 80 % и оставалось место под KV-кэш и среду выполнения (размер в ГиБ ÷ 0,8).
| Репозиторий или квант | Размер, ГБ (ГиБ) | Формат | Чем запускать | Память при запасе 20 %, ГиБ |
|---|---|---|---|---|
MiniMaxAI/MiniMax-M3.1-Flash (официальный) | 250,1 + 2,3 DSpark (235,0) | эксперты NVFP4, остальное MXFP8/BF16 | vLLM 0.33.0+, SGLang; NVIDIA Blackwell и Hopper, AMD MI355X | ≈294 |
unsloth/MiniMax-M3.1-Flash | 250,1 + 2,3 DSpark (235,0) | копия официальных safetensors | то же | ≈294 |
amd/MiniMax-M3.1-Flash-Quark-MXFP4 | 237,2 + 2,3 DSpark (223,0) | MXFP4 | SGLang на AMD MI350X/MI355X | ≈279 |
FlagRelease/MiniMax-M3.1-Flash-W8A8-nvidia-FlagOS-Express | 430,9 + 2,3 DSpark (403,4) | W8A8, 8 бит | vLLM-plugin-FL; у FlagOS есть сборки для девяти производителей ускорителей | ≈504 |
mlx-community/MiniMax-M3.1-Flash-Text-4bit | 248,4 (231,3) | MLX, 4 бита, только текст | Mac с Apple Silicon | ≈289 |
mlx-community/MiniMax-M3.1-Flash-Text-3bit | 186,5 (173,7) | MLX, 3 бита, только текст | Mac с Apple Silicon | ≈217 |
GGUF UD-Q8_K_XL | 259,1 (241,3) | GGUF | llama.cpp b11861+ | ≈302 |
GGUF UD-Q4_K_XL | 249,4 (232,3) | GGUF | llama.cpp b11861+ | ≈290 |
GGUF UD-Q3_K_XL | 194,0 (180,6) | GGUF | llama.cpp b11861+ | ≈226 |
GGUF UD-IQ3_S | 175,5 (163,4) | GGUF | llama.cpp b11861+ | ≈204 |
GGUF UD-IQ3_XXS | 160,0 (149,1) | GGUF | llama.cpp b11861+ | ≈186 |
GGUF UD-Q2_K_XL | 143,9 (134,0) | GGUF | llama.cpp b11861+ | ≈168 |
GGUF UD-IQ2_XXS | 134,9 (125,7) | GGUF | llama.cpp b11861+ | ≈157 |
GGUF UD-IQ1_M | 129,4 (120,5) | GGUF | llama.cpp b11861+ | ≈151 |
primitive-ai/MiniMax-M3.1-Flash-pruned-272B-NVFP4 | 162,9 + 2,3 DSpark (153,8) | NVFP4, часть экспертов удалена | эксперимент сообщества, рецептов от MiniMax и vLLM нет | ≈192 |
Главная ловушка таблицы — GGUF UD-Q4_K_XL. Он весит 249,4 ГБ, почти столько же, сколько официальный чекпойнт, потому что официальные эксперты уже 4-битные и выигрывать на «четвёрке» нечего; реальная экономия начинается с 3-битных квантов. Все GGUF лежат в одном репозитории unsloth/MiniMax-M3.1-Flash-GGUF, каждый квант в своей папке, а для работы с изображениями отдельно нужен файл mmproj-F32.gguf на 3,5 ГБ. README этого репозитория 25 октября 2026 года начинался со строки «Work in progress» и обновлялся в тот же день, так что набор квантов и их размеры ещё могут поменяться.
Кванты ниже трёх бит (IQ2 и IQ1) — способ вообще загрузить модель на 128–160 ГиБ, а не рабочий вариант по умолчанию: MiniMax публикует результаты только для официальных весов, а сторонних замеров качества этих квантов пока нет. Если вы собираетесь использовать такой квант для агента, который пишет код, сначала прочитайте Локальный coding agent сбоит? Разделите квантование, контекст и Harness. Остальные GGUF-репозитории из поиска, в том числе самые скачиваемые, выложены отдельными авторами, и публичных сравнений их качества нет.
Влезет ли M3.1 Flash в вашу видеопамять: от одной RTX 5090 до 8×H100
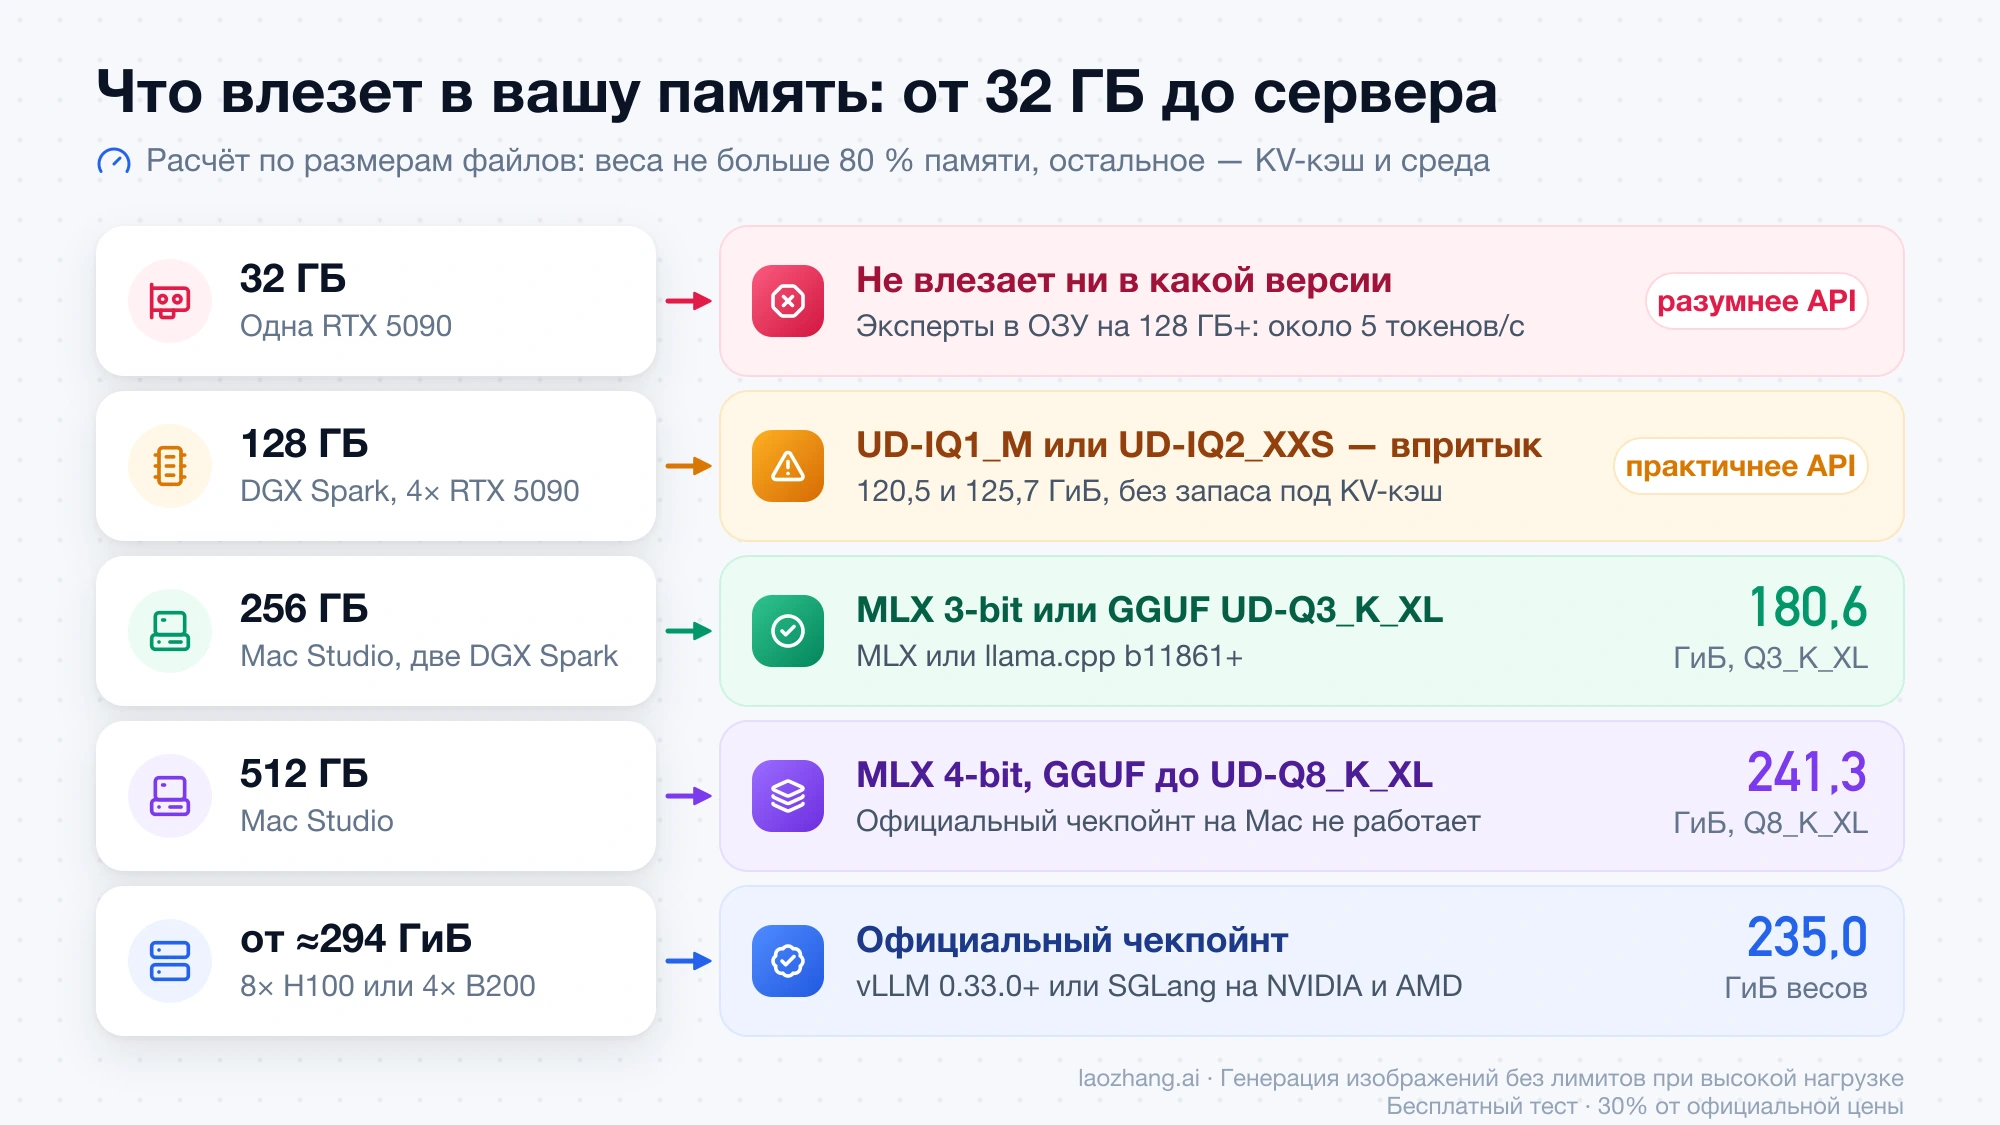
Если коротко: в одну видеокарту на 32 ГБ — нет, на 128 ГБ — только 1-битный квант без запаса, на 256 ГБ — 3-битные версии и ниже, а официальный чекпойнт с запасом начинается примерно с 294 ГиБ памяти на поддерживаемом железе. Таблица ниже — расчёт по размерам файлов с тем же правилом «веса не больше 80 % памяти»; объём памяти взят по паспорту (80 ГБ у H100 или 512 ГБ у Mac Studio — это двоичные гигабайты).
| Железо | Память | Что помещается с запасом 20 % | Чем запускать |
|---|---|---|---|
| Одна RTX 5090 | 32 ГБ | ничего; только GGUF с выгрузкой экспертов в ОЗУ на 128 ГБ и больше | llama.cpp b11861+; в единственном отчёте — около 5 токенов/с |
| Одна DGX Spark или 4× RTX 5090 | 128 ГБ | ничего с запасом; UD-IQ1_M (120,5 ГиБ) и UD-IQ2_XXS (125,7 ГиБ) входят впритык — остаётся 7,5 и 2,3 ГиБ, места под KV-кэш почти нет | llama.cpp; практичнее API |
| Mac Studio на 256 ГБ | 256 ГБ | MLX 3-bit (173,7 ГиБ); GGUF от UD-IQ1_M до UD-Q3_K_XL (180,6 ГиБ) | MLX или llama.cpp |
| Две или четыре DGX Spark | 256 / 512 ГБ | на двух — те же кванты, что для Mac на 256 ГБ; на четырёх по объёму проходит официальный чекпойнт | официальных рецептов нет; kie.ai пересказывает отчёт сообщества о запуске на четырёх Spark через vLLM TP4 |
| Mac Studio на 512 ГБ | 512 ГБ | MLX 4-bit (231,3 ГиБ); GGUF вплоть до UD-Q8_K_XL (241,3 ГиБ) | MLX или llama.cpp |
| 8× H100 80 ГБ или 8× H200 | 640 / 1128 ГБ | официальный чекпойнт (235,0 ГиБ), FlagOS W8A8 (403,4 ГиБ) | vLLM TP8, эксперты на ядре Marlin, без DSpark |
| 4× B200 или 4× B300, GB200, GB300 | 768 / 1152 ГБ | официальный чекпойнт с большим запасом под длинный контекст | vLLM TP4, SGLang |
| AMD MI355X (в SGLang также MI350X) | 4 GPU по рецепту | официальный чекпойнт или amd/MiniMax-M3.1-Flash-Quark-MXFP4 | vLLM TP4 на ROCm 7.2+, SGLang TP4 |
Запас в 20 % — допущение для расчёта, а не цифра от MiniMax или разработчиков движков. Он покрывает KV-кэш, активации, CUDA-графы и систему; при длинном контексте кэш растёт сверх весов, и MiniMax прямо пишет, что доступная длина контекста зависит от памяти GPU и настроек сервера. Например, на Mac Studio на 256 ГБ официальные веса формально помещаются (235,0 ГиБ — 92 % памяти), но для контекста и macOS остаётся около 21 ГиБ, поэтому эта строка в таблице отдана 3-битным версиям.
«Помещается» не значит «запустится». Официальный NVFP4-чекпойнт обслуживают vLLM и SGLang на CUDA или ROCm, на Mac он не работает ни при каком объёме памяти — там нужны MLX или GGUF. По объёму официальным весам хватает и 4× H200 (564 ГБ), но опубликованный рецепт vLLM для Hopper рассчитан на TP8, то есть на все восемь GPU одного узла.
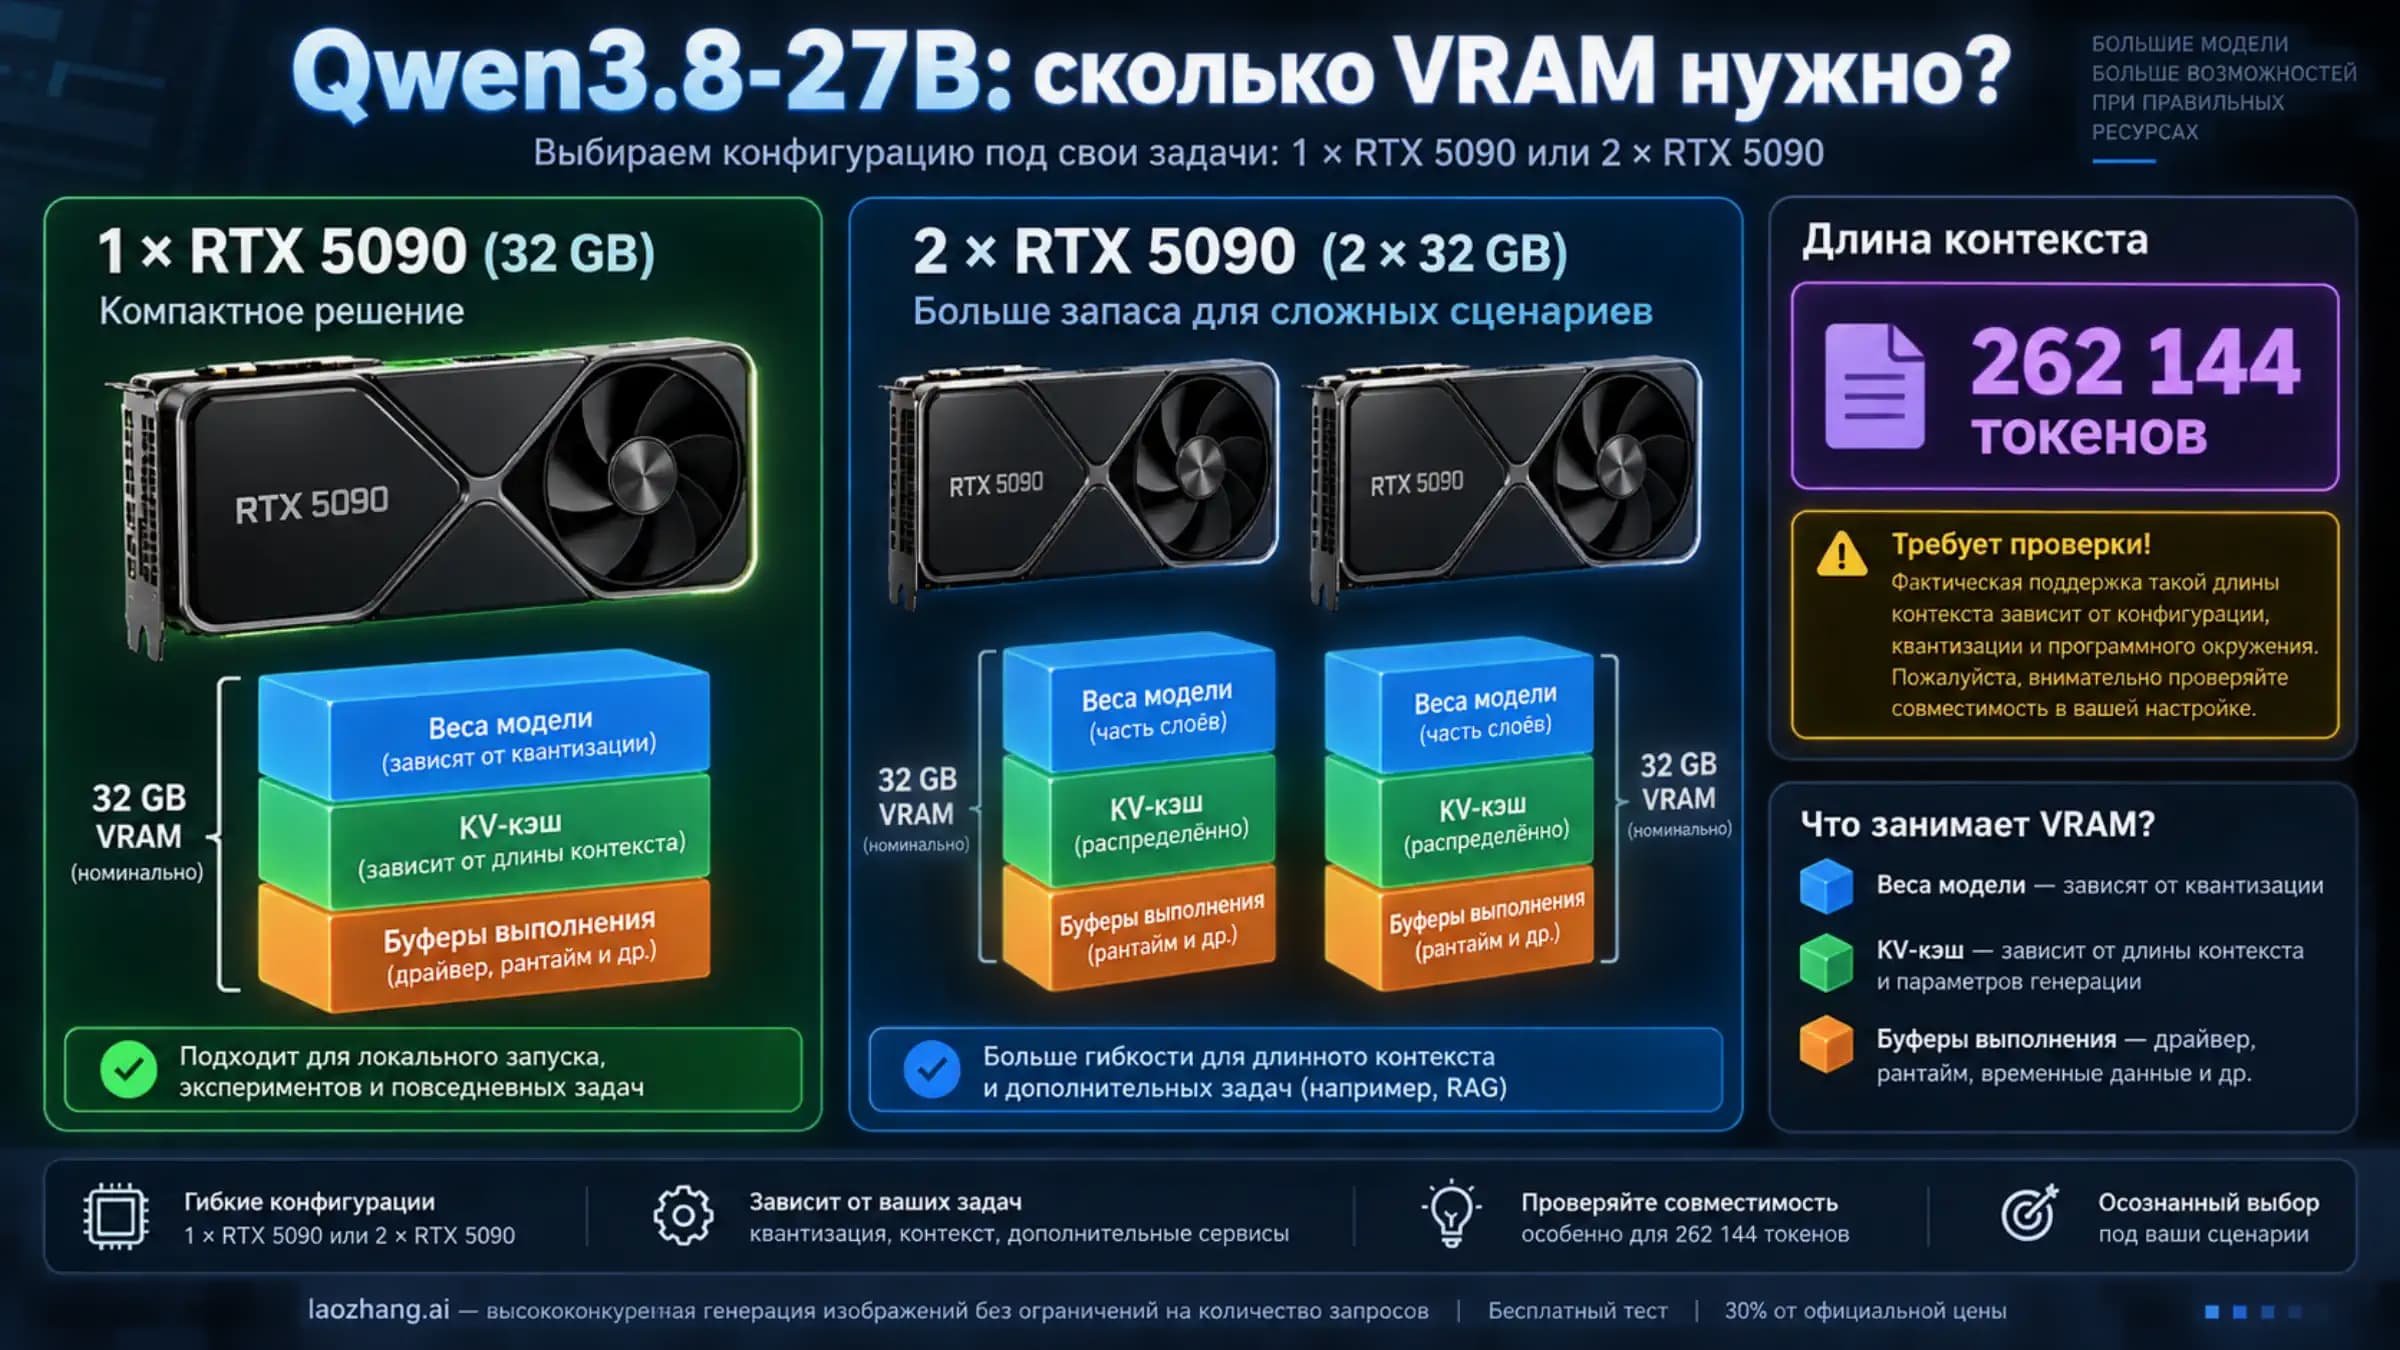
Одна видеокарта на 32 ГБ годится только для схемы, где эксперты лежат в оперативной памяти, а на GPU остаётся внимание: тогда VRAM и ОЗУ вместе должны вместить файл кванта. Автор issue #31063 в llama.cpp собрал именно такую машину — RTX 5090 на 32 ГБ и 128 ГБ ОЗУ с самостоятельно сделанным квантом Q2_K на 146 ГиБ и флагом -cmoe (эксперты на CPU). После его исправления, которое потом вошло в llama.cpp, полная 60-слойная модель стала отвечать связно со скоростью 3,59 токена/с на обработке запроса и 5,12 токена/с на генерации. Это один отчёт сообщества с квантом, сделанным вручную, а не с файлами Unsloth, но порядок цифр понятен: для интерактивной работы с агентом такой скорости мало. Если нужна именно локальная модель на одной карте, смотрите модели другого класса, например Qwen3.8-27B: сколько видеопамяти нужно для RTX 5090 и двух GPU.
Запуск официального чекпойнта в vLLM и SGLang: TP4 на Blackwell, TP8 на Hopper
Рецепт vLLM для MiniMax-M3.1-Flash (обновлён 23 октября 2026 года) требует vLLM 0.33.0 или новее и описывает три платформы с одним и тем же официальным чекпойнтом. На NVIDIA Blackwell (GB200, GB300, B200, B300) модель идёт в TP4, и NVFP4-эксперты работают нативно на FP4-тензорных ядрах. На AMD MI355X тоже TP4, но нужен ROCm 7.2+, а эксперты при загрузке переквантуются в MXFP8 флагом --quantization-config.moe mxfp8. На Hopper (H100, H200) — TP8 на полном узле: FP4-ядер там нет, поэтому KV-кэш и кэш индексатора хранятся в FP8, эксперты считаются ядром Marlin, а DSpark не включается. Во всех вариантах обязателен --block-size 128, иначе сервер падает с ошибкой No common block size for 16.
Перед загрузкой убедитесь, что на диске есть 252,4 ГБ свободного места. Команда скачивания из карточки модели:
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-FlashПапка dspark/ (2,3 ГБ) — черновая модель для спекулятивного декодирования. Для обычного инференса она не нужна, а на Hopper не используется вовсе, так что там её можно не качать, добавив к команде --exclude "dspark/*". На Blackwell и AMD она подхватывается автоматически через --speculative-config с методом dspark, путь к черновой модели указывать не нужно.
Команда для одного узла 8× H100 или H200 из рецепта vLLM; пример ограничивает контекст 262 144 токенами и отключает видеовход (изображения при этом работают):
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
 --tensor-parallel-size 8 \
 --reasoning-parser minimax_m3 \
 --block-size 128 \
 --kv-cache-dtype fp8 \
 --attention-config '{"indexer_kv_dtype": "fp8"}' \
 --compilation-config '{"cudagraph_mode": "FULL_AND_PIECEWISE"}' \
 --max-model-len 262144 \
 --max-num-seqs 80 \
 --limit-mm-per-prompt '{"video": 0}' \
 --gpu-memory-utilization 0.9 \
 --no-enable-log-requests \
 --disable-hybrid-kv-cache-manager \
 --moe-backend marlin \
 --enable-auto-tool-choice \
 --tool-call-parser minimax_m3
Команда для узла с четырьмя GPU Blackwell (в рецепте — GB200) с включённым DSpark:
VLLM_FLOAT32_MATMUL_PRECISION=high \
vllm serve MiniMaxAI/MiniMax-M3.1-Flash \
 -tp 4 \
 --reasoning-parser minimax_m3 \
 --block-size 128 \
 --kv-cache-dtype nvfp4 \
 --attention-config '{"indexer_kv_dtype": "nvfp4", "use_prefill_query_quantization": true}' \
 --compilation-config '{"cudagraph_mode": "FULL_AND_PIECEWISE"}' \
 --speculative-config '{"method":"dspark","num_speculative_tokens":7,"attention_backend":"FLASHINFER_TS","kv_cache_dtype":"fp8","draft_sample_method":"probabilistic","rejection_sample_method":"block"}' \
 --max-num-seqs 256 \
 --disable-hybrid-kv-cache-manager
Рекомендованные параметры генерации — temperature 1.0 и top_p 0.95, глубина рассуждений задаётся в каждом запросе через chat_template_kwargs: {"reasoning_effort": "..."} со значениями low, medium, high, xhigh или max. Указывайте её явно: по сообщениям kie.ai и DataLearner, рассуждения в M3.1 Flash не отключаются, а без параметра используется max, и на длинных ответах это заметно раздувает число выходных токенов. Холодный старт с компиляцией ядер может занять больше 10 минут; в конфигурациях с data parallel рецепт поднимает таймаут переменной VLLM_ENGINE_READY_TIMEOUT_S=3600.
В руководстве SGLang по MiniMax M3.1 есть рецепты для B300 (TP4, низкая задержка) и B200 (TP8, высокая пропускная способность), для AMD MI350X/MI355X (TP4, ROCm 7.2), а рецепта для Hopper нет. Поддержка модели на 25 октября 2026 года ещё не вошла в релиз SGLang: руководство предлагает собрать SGLang из ветки PR с поддержкой (его номер на странице пока не указан) или взять dev-образ lmsysorg/sglang:dev-minimax-m31-flash. На Blackwell ядрам MSA нужен CUDA toolkit 13.4 или новее, и при старом toolkit сервер не падает, а молча переходит на медленный путь, поэтому проверьте, что в логе запуска есть строка nvfp4_to_fp8 backend=qmul4. Цифры скорости в этом руководстве — замеры команды SGLang: на 4× B300 при одном запросе 1028 токенов/с на контексте 1K и 723 токена/с на 1M с фирменным MonoKernel.
GGUF в llama.cpp и MLX на Mac: нужна сборка llama.cpp b11861 или новее
GGUF-версии M3.1 Flash дают осмысленный текст только в llama.cpp сборки b11861 (вышла 24 октября 2026 года) или новее. 23 октября в issue #31063 в репозитории llama.cpp описали, что модель загружается без ошибок, но на любой запрос выдаёт мешанину токенов: код архитектуры MiniMax M3 не передавал в граф масштабы NVFP4-экспертов. Исправление PR #31097 в llama.cpp влили 24 октября, и первая сборка с ним — b11861; на более старых сборках та же мешанина будет с любым GGUF этой модели. Если вы запускаете GGUF через программу со встроенным llama.cpp, проверьте, на какой его сборке она основана.
Качать репозиторий GGUF целиком не нужно, достаточно папки одного кванта, например:
hf download unsloth/MiniMax-M3.1-Flash-GGUF --include "UD-Q3_K_XL/*" --local-dir MiniMax-M3.1-Flash-GGUFОтдельной инструкции Unsloth для M3.1 Flash на 25 октября 2026 года не было, есть только руководство по MiniMax M3. Для M3 Unsloth называет свои GGUF экспериментальными, только текстовыми и без поддержки разреженного внимания MSA (вместо него используется плотное), советует для UD-IQ1_M иметь не меньше 133 ГБ ОЗУ и рекомендует UD-IQ3_XXS. Насколько это переносится на M3.1 Flash, неизвестно: файл mmproj для изображений в репозитории есть, но описания того, что работает, пока нет.
На Mac официальный чекпойнт не запускается, поэтому выбор — между MLX-версиями mlx-community и GGUF в llama.cpp. По названию MLX-репозиториев (-Text-4bit, -Text-3bit) это только текстовые сборки, так что для работы с изображениями на Mac остаётся GGUF с mmproj, с оговоркой выше.
В Ollama модель называется minimax-m3.1-flash:cloud, и эта метка означает облачный запуск на серверах Ollama: веса не скачиваются, а память вашего компьютера не используется.
Лицензия MiniMax M3.1 Flash: бесплатно для некоммерческого использования
Веса открыты, но не под открытой лицензией в смысле OSI: MINIMAX COMMUNITY LICENSE бесплатно разрешает только некоммерческое использование. Коммерческим считается платный продукт или сервис на основе модели, коммерческое использование API к ней и развёртывание дообученных версий в коммерческих целях. В этом случае нужно заметно указать «Built with MiniMax M3.1-Flash» на сайте, в интерфейсе или документации и один раз отправить уведомление на api@minimax.io с темой «M3.1-Flash licensing — notice», если годовая выручка продукта не превышает $20 млн; при большей выручке нужно заранее получить письменное разрешение MiniMax. Отдельное приложение к лицензии запрещает, среди прочего, военное применение и вред несовершеннолетним. Это пересказ условий, а не юридическая консультация.
Когда проще взять API MiniMax, чем собирать сервер
Если у вас нет уже готовых 8× H100 или 4× B200, Mac Studio на 512 ГБ или хотя бы 256 ГБ памяти под 3-битный квант, модель дешевле брать по API. На странице цен MiniMax по состоянию на 25 октября 2026 года MiniMax-M3.1-Flash стоит $0,15 за 1 млн входных токенов, $0,60 за 1 млн выходных и $0,015 за 1 млн токенов, прочитанных из кэша, без отдельных тарифов для длинного контекста. Для сравнения, MiniMax M3 на контексте до 512K токенов стоит $0,30 за вход и $1,20 за выход.
Пример расчёта: 100 млн входных и 10 млн выходных токенов в месяц — это 100 × $0,15 + 10 × $0,60 = $15 + $6 = $21. Локальный запуск оправдан, когда железо уже есть, данные нельзя отправлять наружу или нужны собственные дообученные веса. Кроме самой MiniMax, по данным kie.ai, открытые веса развернул как бессерверный эндпоинт Together AI, а OpenRouter по состоянию на 25 октября 2026 года рекламировал доступ к MiniMax M3.1 Flash. Как сравнивать стоимость своего сервера и облака для агентов, разобрано в статье Локальная LLM для coding agents: когда она лучше Claude/Codex.
Источники7
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 25 окт. 2026 г..
Источники7
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 25 окт. 2026 г..
- 1.карточке модели на Hugging Facehuggingface.co/MiniMaxAI/MiniMax-M3.1-Flash
- 2.Рецепт vLLM для MiniMax-M3.1-Flashrecipes.vllm.ai/MiniMaxAI/MiniMax-M3.1-Flash
- 3.руководстве SGLang по MiniMax M3.1docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3.1
- 4.issue #31063 в репозитории llama.cppgithub.com/ggml-org/llama.cpp/issues/31063
- 5.PR #31097 в llama.cppgithub.com/ggml-org/llama.cpp/pull/31097
- 6.MINIMAX COMMUNITY LICENSEhuggingface.co/MiniMaxAI/MiniMax-M3.1-Flash/blob/main/LICENSE
- 7.странице цен MiniMaxplatform.minimax.io/docs/guides/pricing