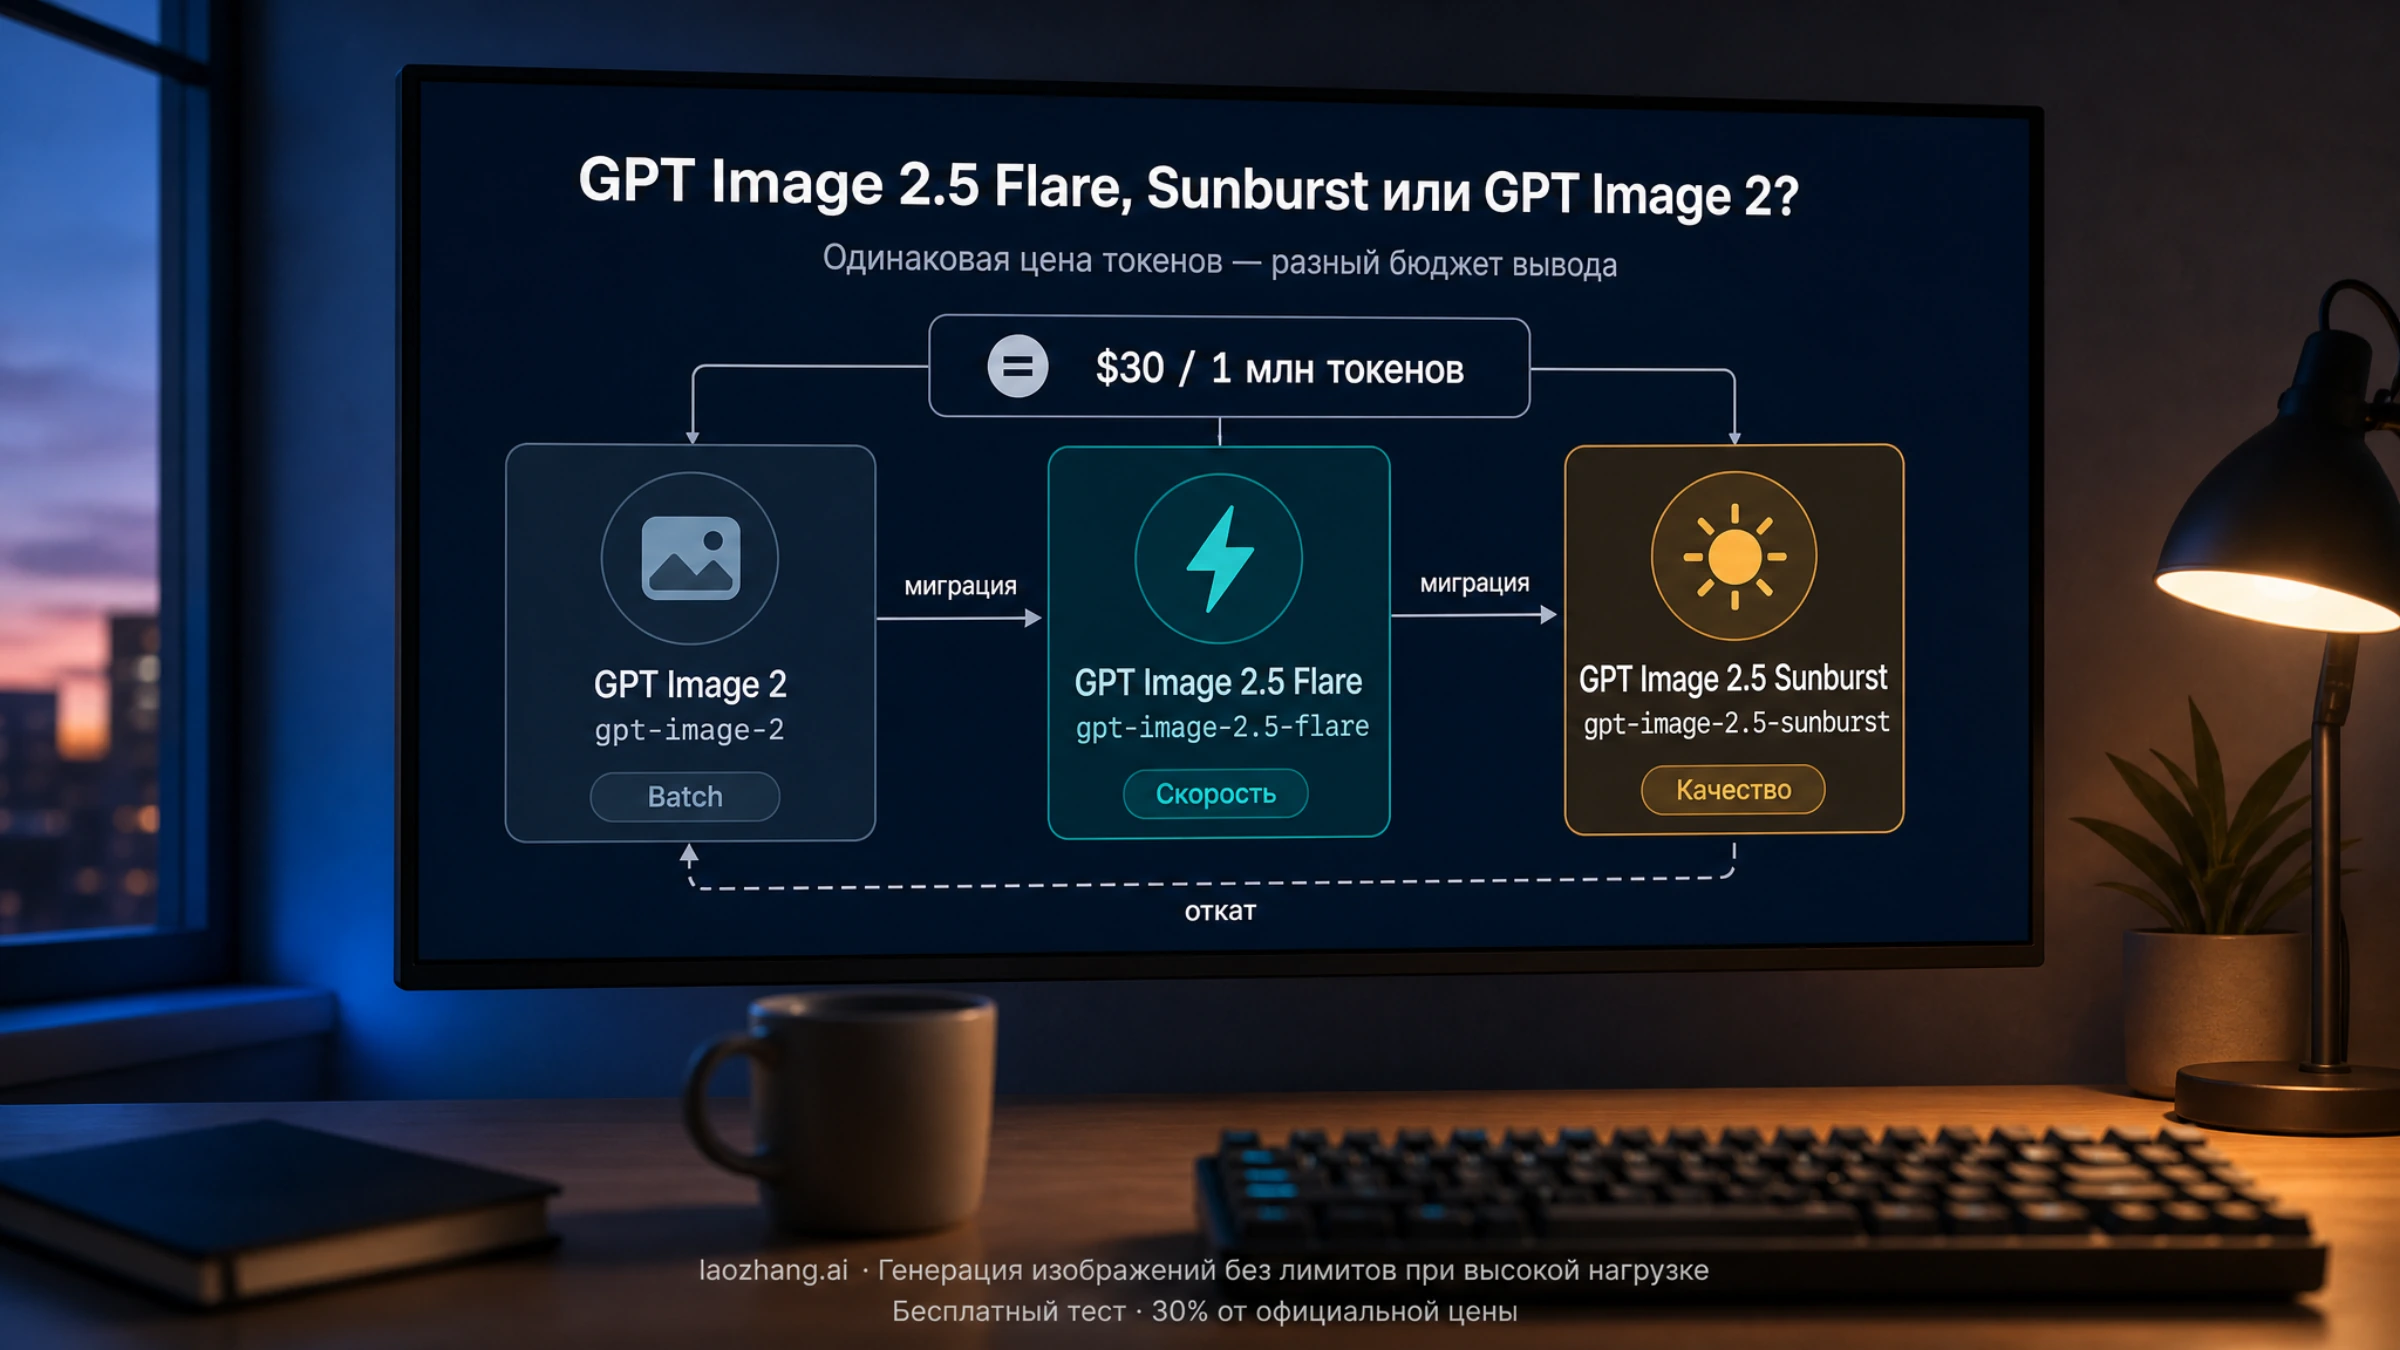
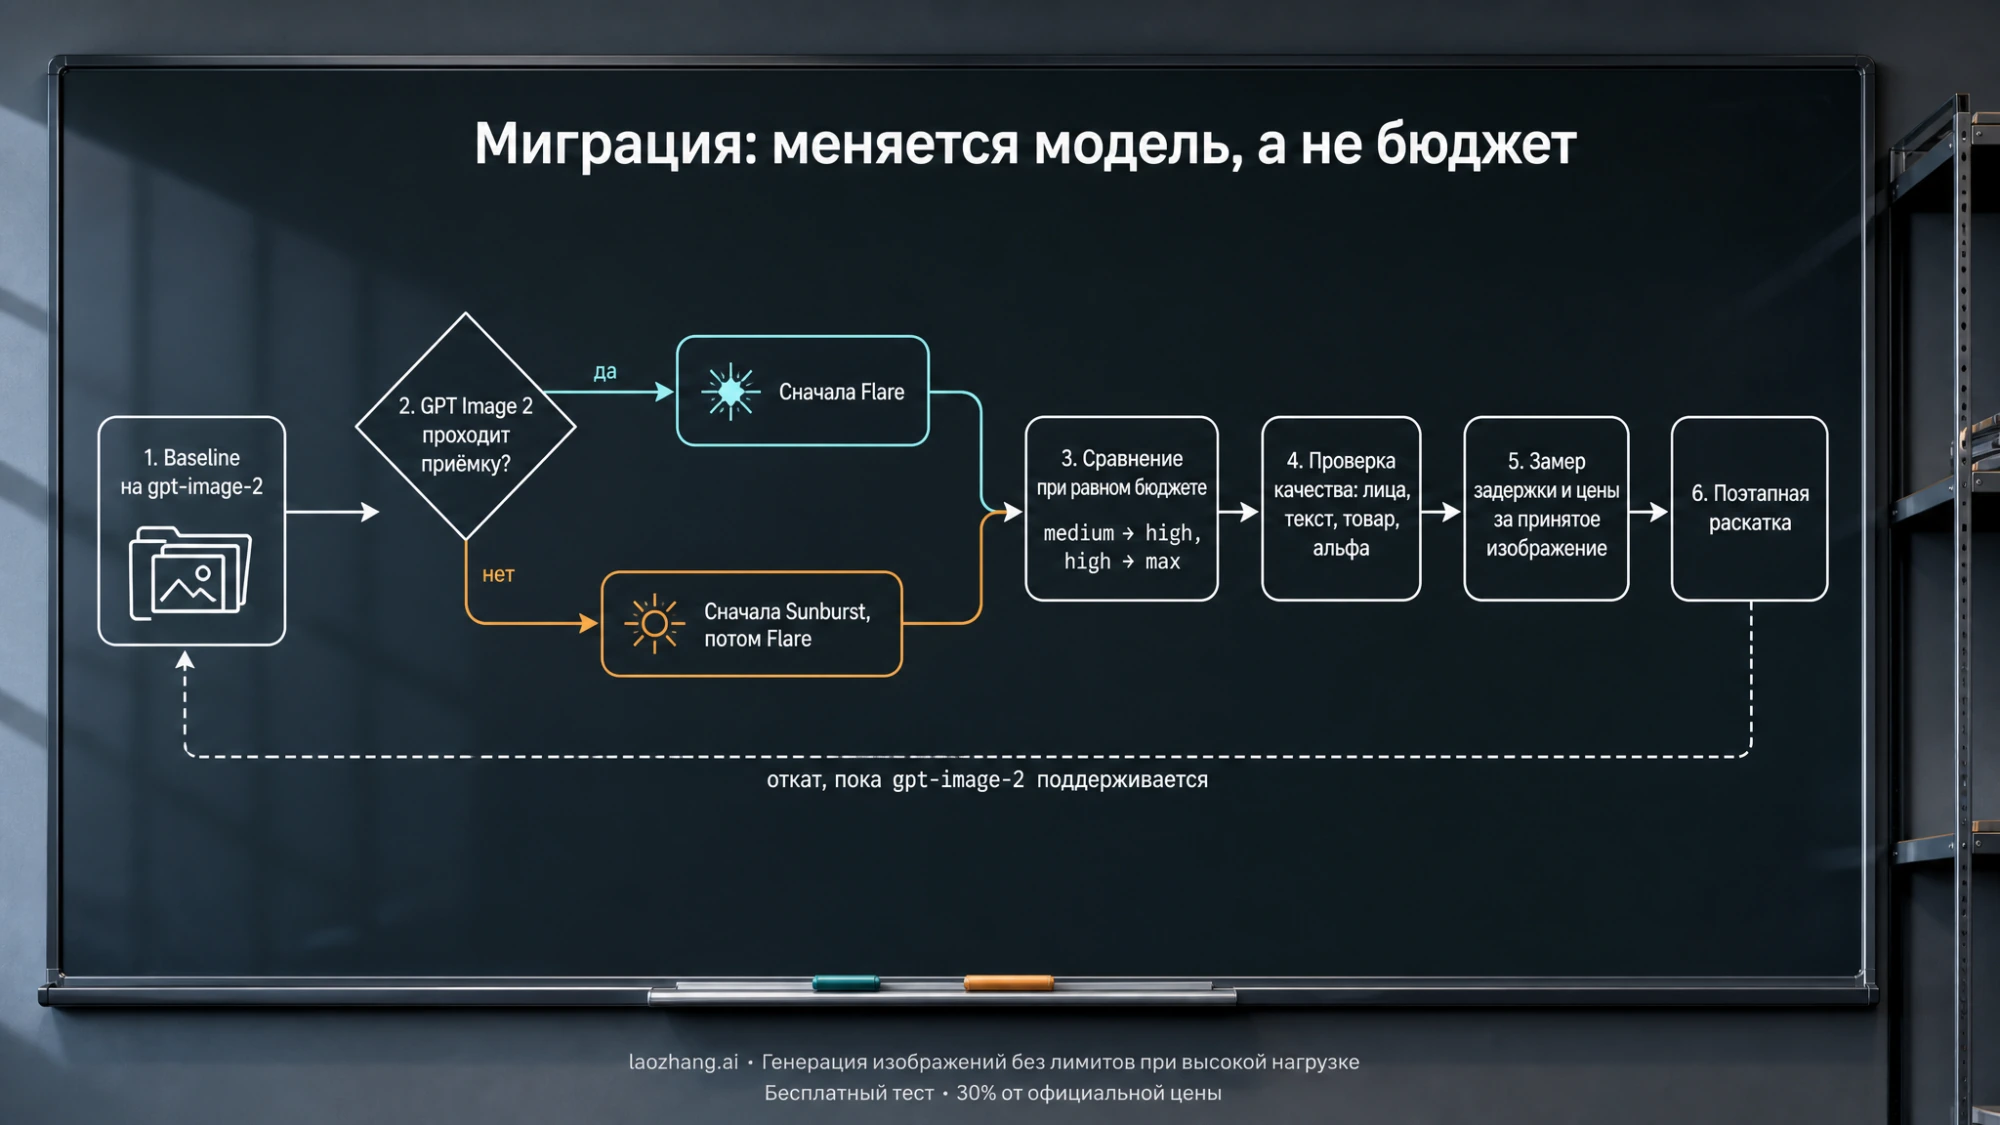
Если рабочий процесс на gpt-image-2 уже проходит вашу приёмку, первым кандидатом на замену OpenAI называет gpt-image-2.5-flare: задача — сохранить приемлемое качество и выиграть во времени ответа. Если GPT Image 2 не дотягивает по качеству на сложных задачах, сначала проверяйте gpt-image-2.5-sunburst, а затем Flare на тех же промптах и референсах. В обоих случаях старую модель держат для отката, пока она поддерживается. Это официальный порядок из гайда OpenAI по промптам для GPT Image 2.5, а не результат чьего-то замера.
Две вещи ломают такую миграцию чаще всего, и обе видны только в документации, а не в коде. Первая: ставки за токены у трёх моделей одинаковые ($30 за миллион выходных токенов изображения, $8 за миллион входных), но одна и та же метка quality даёт разный бюджет вывода. По официальному калькулятору на 22 сентября 2026 года medium у GPT Image 2 при 1024×1024 — это 1 756 выходных токенов, а medium у 2.5 — 439. Замена строки model при неизменном quality: "medium" тихо урезает бюджет картинки примерно в четыре раза, и счёт вместе с ним. Вторая: утверждение «GPT Image 2 вдвое дешевле» на сторонних страницах взято из вкладки Batch, а Batch на странице цен сегодня указан только для gpt-image-2.
Ниже — что именно различается у трёх ID, как их честно сравнить у себя, кому стоит переходить, а кому лучше остаться, и как провести миграцию так, чтобы изменилась только модель, а не бюджет.
Три модели и что о них говорит сама OpenAI
Актуальных ID для изображений в OpenAI API три; gpt-image-2.5 без суффикса моделью не является.
| Параметр | gpt-image-2 | gpt-image-2.5-flare | gpt-image-2.5-sunburst |
|---|---|---|---|
| Снапшот | gpt-image-2-2026-04-21 | gpt-image-2.5-flare-2026-09-08 | gpt-image-2.5-sunburst-2026-09-08 |
| Позиционирование на странице модели | Performance «Higher», Speed «Medium» | Speed «Very fast», «самая быстрая модель для качественной повседневной генерации» | Performance «Highest», «самая мощная модель для генерации и редактирования» |
Значения quality | low, medium, high, auto | low, medium, high, xhigh, max, auto | те же, что у Flare |
Batch (v1/batch) | поддерживается | сегодня не указан | сегодня не указан |
| Прозрачный фон | background: "transparent" + PNG/WebP, в статусе preview | background: "transparent" + PNG/WebP | background: "transparent" + PNG/WebP |
Источники: страницы моделей gpt-image-2, gpt-image-2.5-flare и gpt-image-2.5-sunburst, проверены 22 сентября 2026 года. Все три принимают текст и изображения на входе, генерируют, редактируют и делают inpainting через v1/images/generations и v1/images/edits; ограничения по размеру общие (стороны кратны 16, соотношение не более 3:1, от 655 360 до 8 294 400 пикселей, ребро до 3840; всё крупнее 2560×1440 помечено как экспериментальное).
В оценке качества Flare OpenAI сама расходится в формулировках, и это стоит знать до того, как вы пообещаете команде «улучшение». Гайд по промптам описывает Flare как «малую модель, оптимизированную под скорость, с качеством изображений, сопоставимым с GPT Image 2», а Sunburst — как «базовую модель, оптимизированную под качество, с более высоким качеством, чем у GPT Image 2»; обеим приписаны улучшения в точности правок и сохранении объекта. Анонс от 8 сентября 2026 года говорит о Flare сильнее: «изображения более высокого качества, чем у GPT‑Image‑2, при задержке на 50% ниже». Обе фразы — слова вендора; какая из них верна для ваших промптов, покажет только собственная проверка. Заявления «в 2–4 раза быстрее», которые встречаются в пересказах, в тексте анонса отсутствуют.
Цена за токен одинаковая, а счёт за изображение — нет
На странице цен OpenAI во вкладке Standard у gpt-image-2.5-flare и gpt-image-2.5-sunburst одинаковые ставки, а страницы обеих моделей 2.5 прямо пишут: «ставки за токены совпадают с GPT Image 2».
| Ставка (Standard, за 1 млн токенов) | GPT Image 2 | 2.5 Flare | 2.5 Sunburst |
|---|---|---|---|
| Текст на входе | $5,00 | $5,00 | $5,00 |
| Текст на входе из кэша | $1,25 | $1,25 | $1,25 |
| Изображение на входе | $8,00 | $8,00 | $8,00 |
| Изображение на входе из кэша | $2,00 | $2,00 | $2,00 |
| Изображение на выходе | $30,00 | $30,00 | $30,00 |
| Текст на выходе | не тарифицируется | не тарифицируется | не тарифицируется |
Откуда тогда популярный тезис «2.5 вдвое дороже»? Из соседней вкладки Batch: там gpt-image-2 стоит $4 за миллион входных токенов изображения, $15 за миллион выходных и $2,50 за текст — ровно половина Standard. Несколько сторонних обзоров напечатали эти цифры как обычные ставки GPT Image 2 и сделали вывод о двукратной разнице. На страницах, прочитанных 22 сентября, это неверно: Standard-ставки равны, а Batch для 2.5 просто не указан — на страницах моделей Flare и Sunburst v1/batch отображается как неподдерживаемый эндпоинт. Формулировка «сегодня не указан» точнее, чем «никогда не будет».
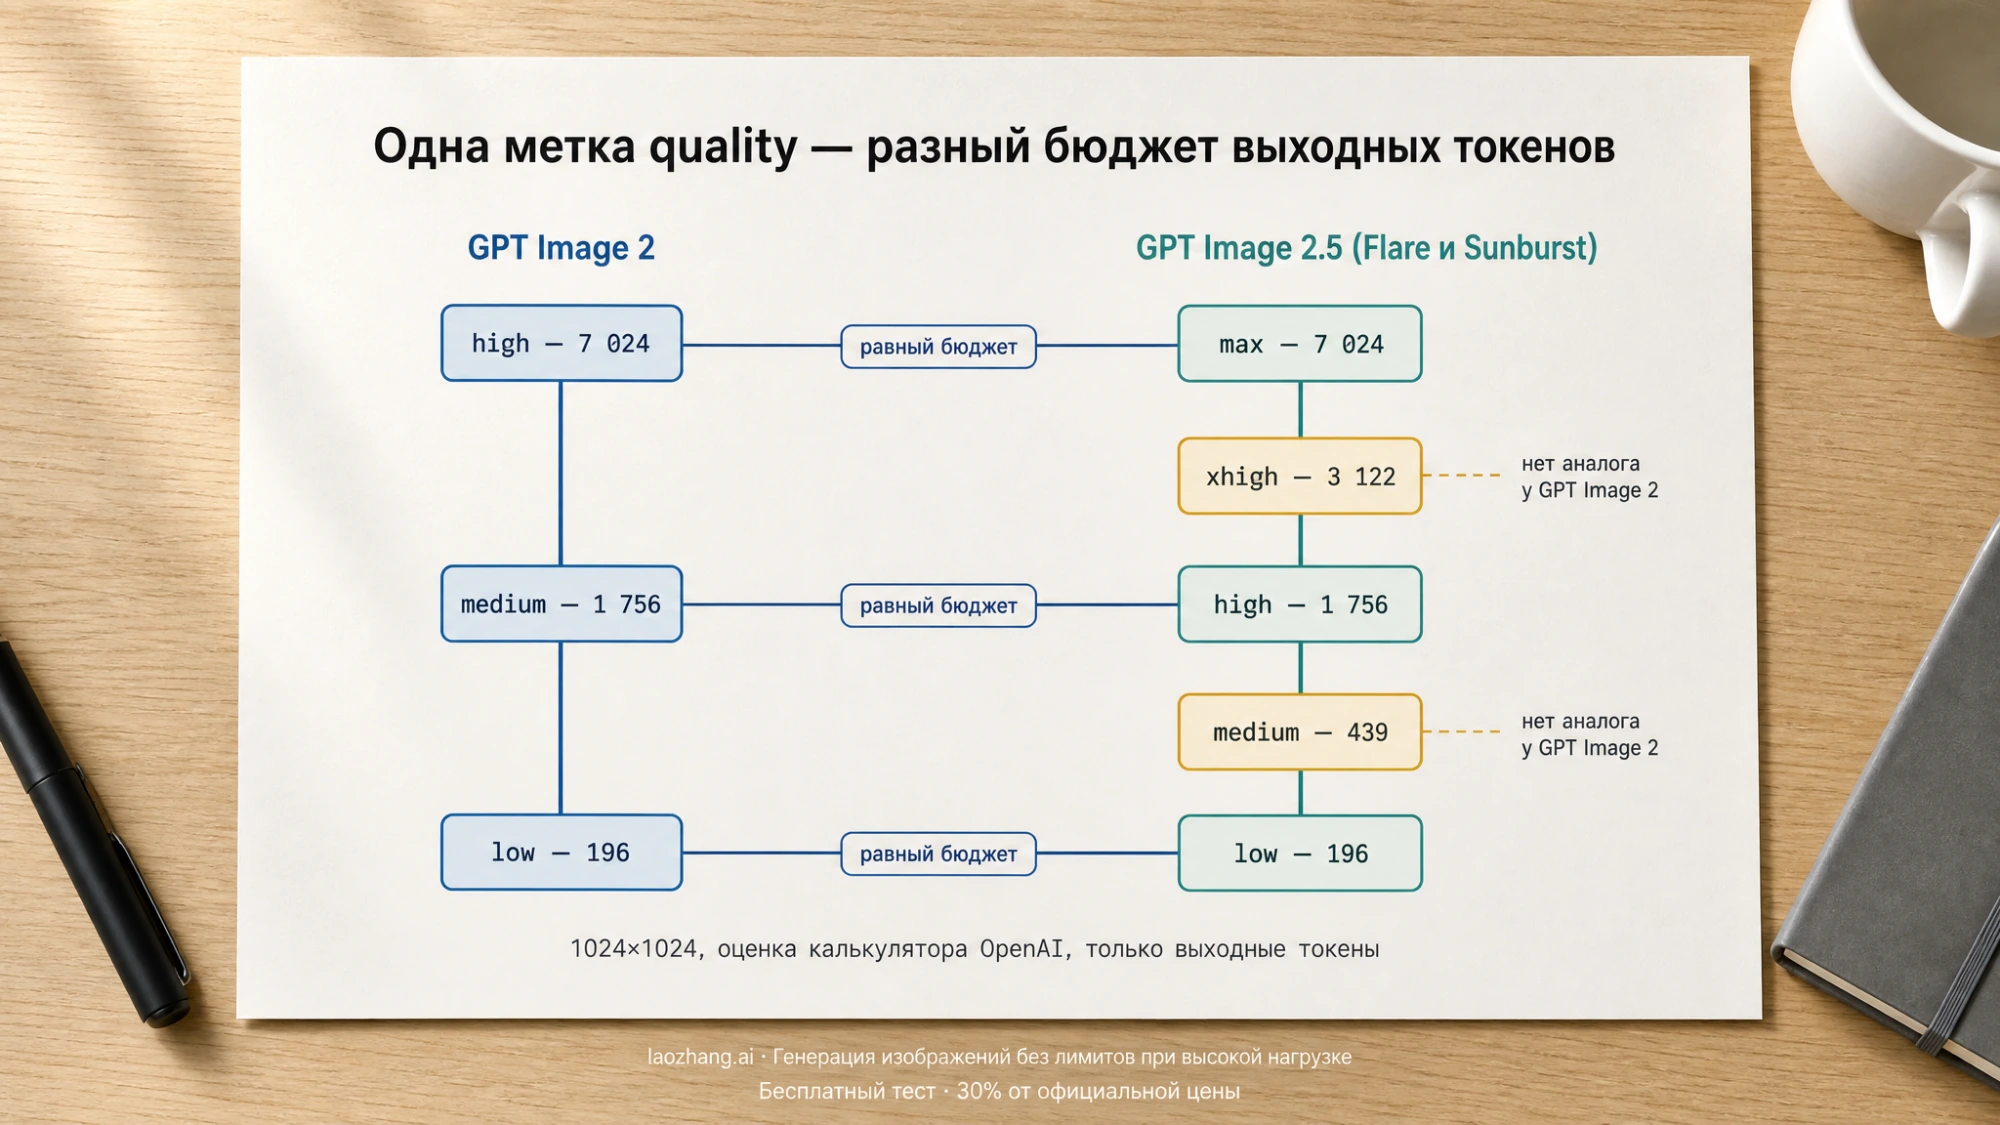
Одна метка quality — разный бюджет вывода
Ставка умножается на количество токенов, а количество токенов при одной и той же метке у поколений разное. OpenAI пишет об этом прямо: «модели могут использовать разное число токенов при одной настройке quality и делят одну цену за выходной токен» и «одинаковая метка качества не означает одинакового качества изображения или времени ответа у разных моделей». Вот оценки официального калькулятора, снятые 22 сентября 2026 года; в них только выходные токены изображения, без входа и без промежуточных кадров стриминга.
Метка quality | GPT Image 2, 1024×1024 | GPT Image 2.5, 1024×1024 | GPT Image 2, 2048×1152 | GPT Image 2.5, 2048×1152 |
|---|---|---|---|---|
low | 196 ток. ≈ $0,006 | 196 ток. ≈ $0,006 | 157 ток. ≈ $0,005 | 157 ток. ≈ $0,005 |
medium | 1 756 ток. ≈ $0,053 | 439 ток. ≈ $0,013 | 1 413 ток. ≈ $0,042 | 367 ток. ≈ $0,011 |
high | 7 024 ток. ≈ $0,211 | 1 756 ток. ≈ $0,053 | 5 650 ток. ≈ $0,170 | 1 413 ток. ≈ $0,042 |
xhigh | нет | 3 122 ток. ≈ $0,094 | нет | 2 511 ток. ≈ $0,075 |
max | нет | 7 024 ток. ≈ $0,211 | нет | 5 650 ток. ≈ $0,170 |
Калькулятор объединяет Sunburst и Flare в один пункт, то есть бюджет у них на одной метке одинаковый; отличается модель, которая этот бюджет тратит. Практическое соответствие читается из таблицы: low совпадает у обоих поколений, high у 2.5 равен medium у GPT Image 2, max у 2.5 равен high у GPT Image 2, а medium и xhigh у 2.5 — промежуточные ступени, которых у GPT Image 2 нет.
Отсюда два следствия для счёта. Если вы просто заменили model и оставили quality: "medium", стоимость выходных токенов упала примерно в четыре раза — но вместе с ней упал и бюджет детализации, и сравнивать такую картинку с прежней некорректно. Если же вы держали GPT Image 2 на high и хотите тот же бюджет у 2.5, нужен max; счёт за выход останется тем же, потому что ставка и токены равны. Экономия от перехода, если она есть, берётся из того, что модели 2.5 при меньшем бюджете могут проходить вашу приёмку, — а это уже вопрос проверки, а не тарифа. Реальные расходы считайте по полю usage в ответе: калькулятор не учитывает входные токены (у edits с референсами они заметны, и gpt-image-2 всегда обрабатывает вход в высокой точности), а каждый промежуточный кадр при partial_images добавляет 100 выходных токенов. Подробный разбор уровней и бюджета для Sunburst есть в статье о ценах API GPT Image 2.5.
Как сравнивать честно: равный бюджет, а не равная метка
Ставить рядом gpt-image-2 на medium и gpt-image-2.5-flare на medium — значит сравнивать 1 756 токенов с 439. Корректные пары при 1024×1024: GPT Image 2 medium против 2.5 high (по 1 756 токенов) и GPT Image 2 high против 2.5 max (по 7 024). Тогда одинаковы и бюджет, и стоимость выхода, и разница в результате объясняется только моделью.
Что известно о поведении при равном бюджете из внешних источников, с их условиями:
- Собственный тест Tosea.ai от 9 сентября 2026 года (оригинал на японском): 41 одиночный вызов
images/editsчерез официальный API, промпт-план плюс 1–3 шаблонных референса, слайды деловой презентации 2048×1152, без повторов, среднее по 5 страницам. Их значенияusageпо токенам совпали с калькулятором. При равных 1 413 токенах среднее время ответа: GPT Image 2medium37,3 с, Sunbursthigh27,7 с, Flarehigh19,7 с; при 5 650 токенах — 82,9 / 59,8 / 33,7 с. Дрейф пикселей после 1/2/3 последовательных правок: GPT Image 2 5,6/8,1/11,4 %, Sunburst 4,1/6,8/9,9 %, Flare 3,8/6,7/9,2 %. Текст и числа на всех 15 слайдах верны у всех трёх моделей. Это одна визуальная область и один автор; портреты, сохранение лица с личных фото, прозрачность и маскированный inpainting там не проверялись. - Слепые голосования Arena (text-to-image, image edit; на странице указано обновление 7 сентября 2026 года): в генерации Sunburst 1421 ±13 (3 149 голосов), Flare 1399 ±13 (2 856), GPT Image 2
medium1381 ±4 (78 731); в редактировании 1520 / 1491 / 1461. Записи 2.5 помечены как Preliminary — голосов у них на порядок меньше. - Artificial Analysis (рейтинг text-to-image): Sunburst
max1197 ±9, Flaremax1190 ±9, GPT Image 2high1171 ±9 — и здесь сравнение как раз при равных 7 024 токенах.
Все три источника показывают, что 2.5 при равном бюджете не проигрывает GPT Image 2 в предпочтениях, а по замерам Tosea — быстрее на их нагрузке. Ни один из них не является тестом этого сайта и не гарантирует ваш результат: OpenAI сама предупреждает, что «ускорение на одной нагрузке не устанавливает фиксированного ускорения на другой».
Кому переходить, а кому остаться
| Ваша ситуация | С чего начать | Почему |
|---|---|---|
Пайплайн на gpt-image-2 проходит приёмку, узкое место — время ответа | Flare с явным quality, равным по бюджету текущему | Официальный первый кандидат при уже достигнутом качестве; выигрыш — задержка, качество нужно удержать |
| GPT Image 2 не проходит приёмку на сложных правках, лицах, геометрии товара | Sunburst, затем Flare на тех же входах | OpenAI просит сначала доказать, что Sunburst закрывает требование, и лишь потом искать скорость |
| Основной объём идёт через Batch по половинным ставкам | Оставаться на gpt-image-2 для этого объёма | Batch сегодня указан только у GPT Image 2; переход на Standard-ставки 2.5 удвоит цену токена для этого потока |
| Промпты под GPT Image 2 настроены годами и стабильны, спешки нет | Оставаться, но собрать baseline уже сейчас | Модель не объявлена устаревшей; baseline пригодится, когда переход станет нужен |
| Многошаговое редактирование одного изображения | Проверить 2.5 в полной цепочке правок | И Flare, и Sunburst заявлены с улучшенным сохранением объекта; у Tosea дрейф был ниже, но на слайдах, а не на фото |
| Новая интеграция, GPT Image 2 ещё не использовали | Flare при приоритете скорости, Sunburst при жёстких требованиях | Гайд OpenAI помечает раздел GPT Image 2 как «для более ранних моделей» и советует новые интеграции строить на 2.5 |
Внутри 2.5 выбор между Flare и Sunburst — отдельный вопрос, и его лучше решать после того, как вы определились, уходить ли с GPT Image 2 вообще. Критерии для этого разобраны в сравнении Flare и Sunburst; здесь достаточно правила из гайда: если Sunburst прошёл, прогоняете Flare на тех же входах и переключаетесь только когда качество удержалось, а задержка снизилась.
Об отключении GPT Image 2 речи нет. На странице deprecations записи ни для gpt-image-2, ни для моделей 2.5 отсутствуют. Наоборот, gpt-image-2 — рекомендованная замена для gpt-image-1 (отключение 23 октября 2026 года) и для gpt-image-1.5, gpt-image-1-mini и chatgpt-image-latest (отключение 1 декабря 2026 года). Отсутствие даты — не гарантия, поэтому гайд и формулирует откат как «пока предыдущая модель поддерживается». Если вы сейчас на 1.x, разумная траектория — не прыгать через поколение вслепую, а перенести baseline на gpt-image-2, где параметры уже описаны, и от него измерять 2.5; настройка запросов к GPT Image 2 описана в руководстве по API GPT Image 2.
Миграция по шагам: меняется модель, а не бюджет
Порядок ниже повторяет официальный раздел «Migrate an existing workflow», а конкретика про quality добавлена из калькулятора, потому что именно там команды чаще всего ошибаются.
- Сохраните baseline на GPT Image 2. Соберите представительный набор боевых промптов и референсов: сложные правки, точный текст, лица, геометрия товара, прозрачные ассеты. Запишите модель (лучше снапшот
gpt-image-2-2026-04-21), все параметры запроса и полученные результаты вместе сusage. - Выберите первого кандидата по текущему качеству. Приёмка проходит — Flare; не проходит на сложных задачах — Sunburst.
- Первое сравнение — при неизменных промпте, референсах, размере, формате и равном бюджете. Не копируйте метку
quality, переведите её: GPT Image 2medium→ 2.5high; GPT Image 2high→ 2.5max;lowостаётсяlow. Если у вас стоялauto, зафиксируйте явное значение на обеих сторонах —autoкалькулятор не оценивает, а у Toseaautoна 2.5 при 2048×1152 четыре раза из пяти попадал на ступень 1 413 токенов и один раз на 628. - Проверяйте результат целиком. Следование инструкции, сохранение личности и товара, точность текста, нежелательные изменения, альфа-канал прозрачных ассетов. Повторяйте одинаковые запросы, чтобы измерить стабильность; для редактирования прогоняйте всю цепочку правок, а не только отдельные шаги.
- Скорость — после прохождения качества. Если начинали с Sunburst и он прошёл, прогоните Flare по тем же требованиям; переключайтесь только при удержанном качестве и реальном выигрыше в задержке. Измеряйте типичные и медленные ответы, ошибки, повторы.
- Считайте цену за принятое изображение. Все оплаченные попытки (вход + выход + промежуточные кадры + повторы) делите на число принятых результатов. Гайд отдельно просит «подтвердить актуальные цены, а не предполагать, что быстрая модель стоит дешевле».
- Раскатывайте по рабочим процессам. Малая доля трафика, те же метрики, постепенное расширение; старая модель остаётся доступной для отката.
В коде переход выглядит как одна дополнительная таблица соответствия, чтобы смена модели не тянула за собой смену бюджета:
pythonfrom openai import OpenAI

client = OpenAI()

# Равный бюджет выходных токенов по официальному калькулятору (1024x1024)
QUALITY_MAP = {"low": "low", "medium": "high", "high": "max"}

def generate(prompt: str, use_25: bool, legacy_quality: str = "medium"):
    if use_25:
        model, quality = "gpt-image-2.5-flare", QUALITY_MAP[legacy_quality]
    else:
        model, quality = "gpt-image-2", legacy_quality
    result = client.images.generate(
        model=model,
        prompt=prompt,
        size="1024x1024",
        quality=quality,
    )
    # usage — единственный источник фактического расхода токенов
    return result.data[0].b64_json, result.usage
Если картинки генерируются из Responses API через инструмент image_generation, модель 2.5 задаётся в самом инструменте (tools: [{"type": "image_generation", "model": "gpt-image-2.5-sunburst"}]), а счёт дополнительно включает токены основной модели — это стоит учесть при сравнении цены за принятое изображение. Прозрачные ассеты после переезда проверяйте отдельно: у GPT Image 2 прозрачный фон в статусе preview, у 2.5 — штатная возможность, но края волос, стекла и теней всё равно нужно смотреть в альфа-канале; порядок проверки описан в материале о прозрачном фоне в GPT Image 2.5. А если после перехода на низкие ступени quality в результатах появились шум и зернистость, сначала исключите потерю бюджета из шага 3 — разбор источников шума в GPT Image 2.5 поможет отделить это от проблем экспорта.
Что делать пользователям Batch
Если существенная доля вашего объёма идёт через v1/batch на gpt-image-2, экономика перехода отличается от всех таблиц выше. Batch-ставки GPT Image 2 — половина Standard, а для моделей 2.5 Batch на странице цен и на страницах моделей сегодня не указан. Перенос такого потока на 2.5 означает не «столько же за токен», а удвоение ставки; компенсировать это можно только тем, что 2.5 пройдёт приёмку на меньшем бюджете (например, high вместо max), и это нужно доказать на своих данных, а не предполагать.
Разумная схема — разделить трафик: интерактивные запросы, где важна задержка, переводить на Flare или Sunburst, а отложенную массовую генерацию оставить в Batch на GPT Image 2 до тех пор, пока для 2.5 не появится Batch или пока GPT Image 2 не получит дату отключения. Как устроен Batch у GPT Image 2 и как он соотносится с другими способами снизить цену, разобрано в статье о самом дешёвом API GPT Image 2.
Частые вопросы
GPT Image 2.5 дороже, чем GPT Image 2?
По ставкам за токен — нет: во вкладке Standard у всех трёх моделей $30 за миллион выходных токенов изображения, $8 за миллион входных и $5 за миллион текстовых на входе. Разница в счёте возникает из-за числа токенов, а оно при одинаковой метке quality у 2.5 меньше. Тезис «вдвое дороже» основан на Batch-ставках GPT Image 2, которые к Standard-сравнению не относятся.
Можно ли просто заменить gpt-image-2 на gpt-image-2.5-flare в конфиге и ничего больше не трогать?
Технически запрос пройдёт, но при quality: "medium" бюджет вывода при 1024×1024 упадёт с 1 756 до 439 токенов, а при auto станет непредсказуемым для сравнения. Перед заменой переведите метку по бюджету (medium → high, high → max) и сравните на тех же входах.
Flare действительно лучше GPT Image 2 по качеству? OpenAI даёт две формулировки: в гайде — «сопоставимое» качество, в анонсе — «более высокое». Слепые голосования Arena и Artificial Analysis ставят Flare выше GPT Image 2 при равном бюджете, но записи 2.5 пока помечены как предварительные. Для вашего пайплайна ответ даёт только собственное сравнение по baseline.
GPT Image 2 скоро отключат?
На странице deprecations записи для gpt-image-2 нет; модель сама является рекомендованной заменой для gpt-image-1 (до 23 октября 2026 года) и для gpt-image-1.5, 1-mini и chatgpt-image-latest (до 1 декабря 2026 года). Это не гарантия на будущее, поэтому старую модель держат для отката, пока она поддерживается.
Есть ли Batch для GPT Image 2.5?
На 22 сентября 2026 года — нет: во вкладке Batch среди моделей изображений указан только gpt-image-2, а на страницах Flare и Sunburst v1/batch отображается как неподдерживаемый. Это состояние на дату проверки, а не обещание.
Какой источник считать надёжным по скорости 2.5? Официальная цифра «на 50% ниже задержка» — заявление OpenAI без опубликованной методики. Единственный прочитанный независимый замер при равном бюджете — тест Tosea.ai на слайдах 2048×1152, где Flare был быстрее GPT Image 2 примерно на 47%, а Sunburst — на 26%; переносить эти проценты на другие нагрузки нельзя, свою задержку измеряйте на своих запросах.