GPT Image 2.5 в n8n: узел OpenAI, HTTP Request и агрегаторы
Узел OpenAI в n8n даёт GPT Image 2.5 только качество до high, три размера и теряет usage. Для xhigh, 4K, прозрачного фона и агрегаторов нужен HTTP Request.
Содержание
Короткий ответ: узел OpenAI или HTTP Request
Встроенный узел OpenAI в n8n работает с GPT Image 2.5, если указать полный ID модели: gpt-image-2.5-flare или gpt-image-2.5-sunburst. Модели с ID просто gpt-image-2.5 не существует. Но операция Generate an Image даёт для неё только три уровня качества (low, medium, high) и три размера (1024x1024, 1024x1536, 1536x1024), а сведения о потраченных токенах (usage) дальше по цепочке не передаёт.
Узла достаточно, если одновременно верно всё перечисленное:
- ключ выдан OpenAI или агрегатором, который отвечает так же, как OpenAI, — чистой строкой
b64_json; - хватает качества high и размеров до 1536 пикселей по длинной стороне;
- не нужны прозрачный фон, JPEG или WebP и учёт токенов по каждой картинке.
Если хотя бы одно условие не выполняется — нужны xhigh, max или auto, 2K, 4K или свой размер, прозрачный фон, учёт usage, либо агрегатор присылает ссылку, Base64 с префиксом или работает через задачи, — ставьте HTTP Request и собирайте цепочку сами: запрос → проверка ответа → файл → хранилище → доставка.
Что можно задать в узле OpenAI и в HTTP Request
Поведение узлов ниже соответствует исходному коду n8n: файлы операций с изображениями в основной ветке не менялись с 20 мая 2026 года, последний релиз по состоянию на 25 сентября 2026 года — n8n@2.40.6. Проверить свою установку просто: выберите в узле модель 2.5, нажмите Add Option и посмотрите, какие поля появятся.
| Что нужно | Generate an Image (версия узла от 2.2) | Edit an Image (версия узла от 2.3) | HTTP Request к API |
|---|---|---|---|
| Модель 2.5 | из списка или вручную по ID | из списка или вручную по ID | любой ID в теле запроса |
| Качество | low, medium, high | auto, high, medium, low | low, medium, high, xhigh, max, auto |
| Размер | 1024x1024, 1024x1536, 1536x1024 | те же три и auto | любой допустимый, до 3840 по стороне |
| Прозрачный фон | нет | Background | background |
| Формат файла | только PNG по умолчанию | поля Output Format и Output Compression видны, но по коду, скорее всего, не доходят до API | output_format, output_compression |
| Несколько референсов | нет | несколько двоичных полей, уходят как image[] | Form-Data с повтором image[] |
| Маска | нет | Image Mask | поле mask |
usage в выходных данных | теряется | теряется | приходит в ответе |
| Ответ ссылкой или Base64 с префиксом | не разбирает | не разбирает | разбираете сами |
Что важно в этой таблице:
- «Версия узла» здесь — typeVersion конкретного узла на холсте, а не версия n8n. Узел, добавленный в процесс давно, может остаться на старой версии: тогда Generate показывает фиксированный список DALL·E 2, DALL·E 3 и GPT Image 1, а Edit — DALL·E 2 и GPT Image 1. Выход — удалить узел и добавить заново.
- В Edit в списке размеров остались 256x256 и 512x512 со времён DALL·E 2. Для GPT Image 2.5 они не подходят: минимум — 655 360 пикселей, а 512x512 — это 262 144. В списке качества там же есть
standard, которого в документации GPT Image 2.5 нет. - Опцию Input Fidelity в Edit не добавляйте. OpenAI описывает
input_fidelityтолько для ранних моделей GPT Image, а для GPT Image 2 прямо просит этот параметр не передавать; для 2.5 он не документирован. - Output Format и Output Compression в Edit объявлены как отдельные поля узла, а код при отправке ищет их внутри Options. Поэтому выбранный в интерфейсе формат, скорее всего, в запрос не попадает, и приходит формат по умолчанию — PNG. Если нужен JPEG или WebP, правьте через HTTP Request и проверяйте MIME type полученного файла.
- Number of Images в Generate показывается только для DALL·E 2, поэтому узел всегда получает одну картинку на запрос.
Полный набор значений качества у обеих моделей 2.5 одинаковый: low, medium, high, xhigh, max и auto, по умолчанию auto. Собственный размер задаётся строкой ШИРИНАxВЫСОТА, если обе стороны кратны 16, соотношение сторон лежит между 1:3 и 3:1, ни одна сторона не больше 3840 пикселей, а всего пикселей от 655 360 до 8 294 400. Размеры больше 2560x1440 OpenAI называет экспериментальными (руководство по генерации изображений). Как выбрать между Flare и Sunburst, разобрано в статье «GPT Image 2.5 Flare или Sunburst: скорость, правки и цена».
Учётные данные: OpenAI напрямую и агрегатор через Base URL
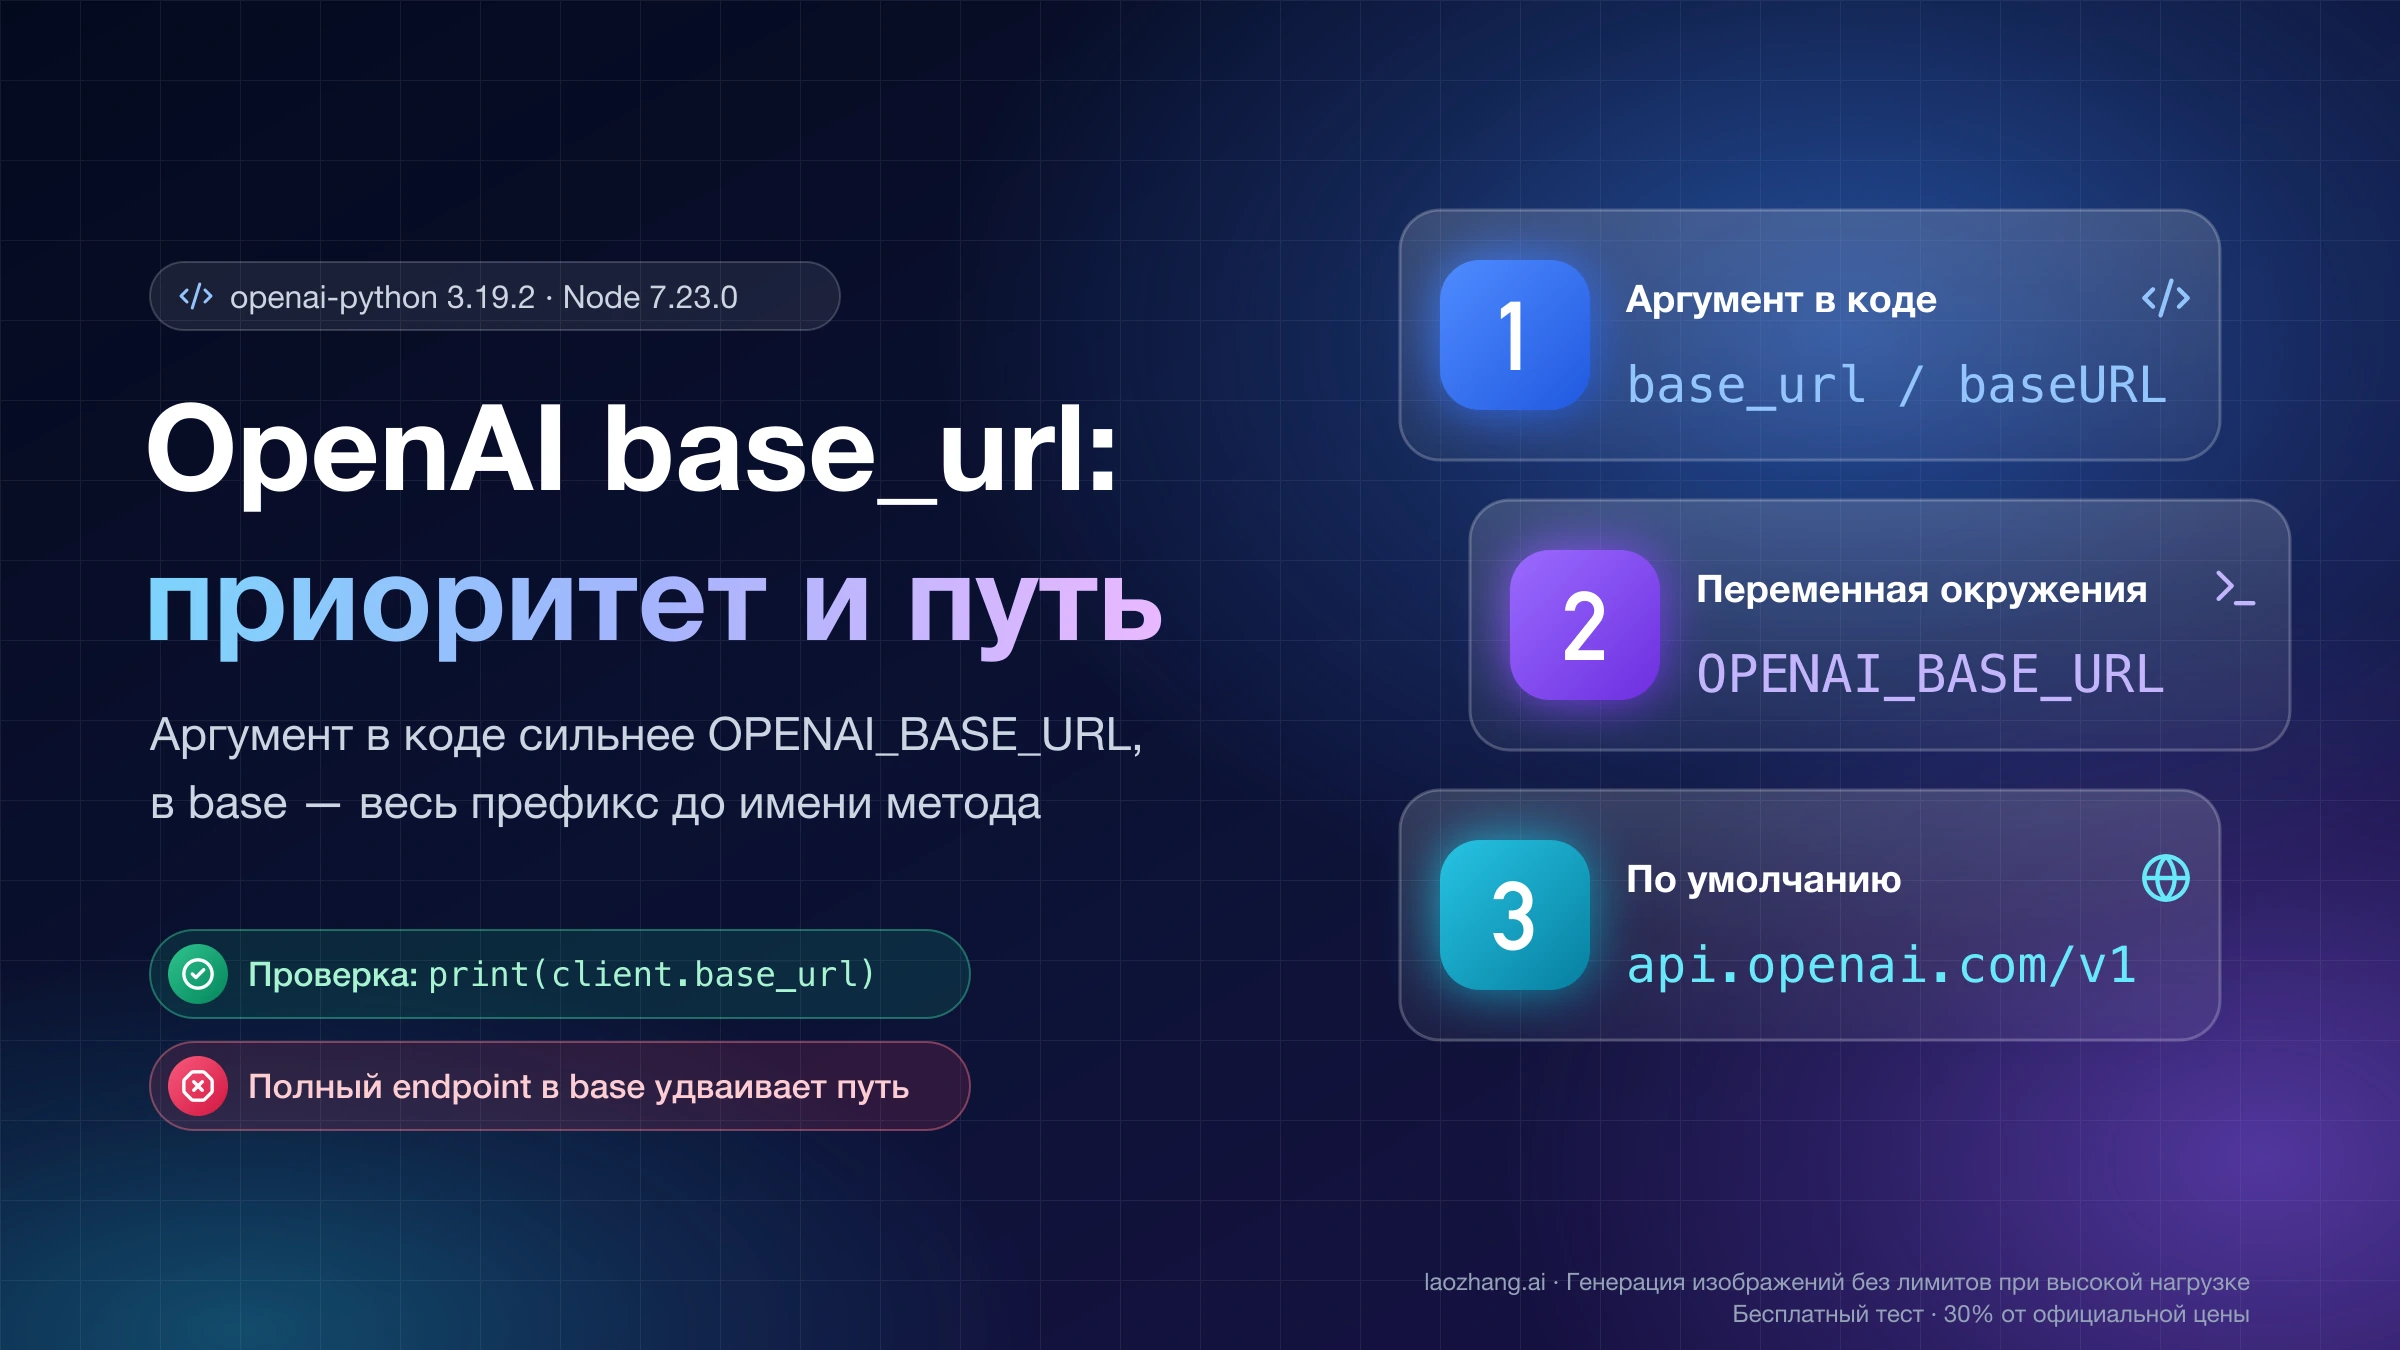
В учётных данных OpenAI (Credentials) в n8n четыре поля: API Key, Organization ID (необязательное), Base URL (по умолчанию https://api.openai.com/v1) и Add Custom Header. Узел отправляет запрос на адрес «Base URL + путь операции», например …/v1/images/generations. Список моделей в режиме From List он получает запросом GET /models к тому же Base URL и оставляет из ответа только ID, где есть dall-e или gpt-image. Если нужной модели в списке нет, переключите поле Model в режим ID и введите идентификатор вручную.
При работе напрямую с OpenAI модели GPT Image могут требовать верификации организации (API Organization Verification). Если ключ рабочий, а запрос к 2.5 получает отказ в доступе, первым делом проверьте статус верификации в консоли разработчика. Нужно ли заполнять Organization ID, разобрано в материале «OpenAI API Key и Organization ID: что реально нужно в 2026 году».
Замена Base URL подходит только для агрегатора, который повторяет API OpenAI: те же пути /images/generations и /images/edits, те же поля запроса и data[].b64_json в ответе. Перед подключением найдите в его документации три ответа:
- Какой ID у модели. У агрегаторов бывают свои идентификаторы. Например, у Gen API для подключения по API указан ID
gpt-image-2-5, а не ID OpenAI. Такой сервис подключается через HTTP Request по его собственной документации. - В каком виде приходит картинка. Чистая строка Base64, Base64 с префиксом, временная ссылка или идентификатор задачи — от этого зависит вся цепочка (следующий раздел).
- Сразу ли приходит результат. Если сервис сначала возвращает ID задачи, а картинку нужно забирать отдельным запросом, узел OpenAI не подойдёт в принципе.
Пример агрегатора, совместимого с API OpenAI, — laozhang.ai: Base URL https://api.laozhang.ai/v1, пути те же. Маршрут официальной переадресации принимает ID OpenAI (gpt-image-2.5-flare, gpt-image-2.5-sunburst) и оплачивается по токенам: в группе ключа Sora2Official ставки совпадают с OpenAI, в GPTImage2 Sora2 Enterprise они на 20 % выше. Группа выбирается при создании ключа, в поле model её не указывают. Там же есть оплата за вызов: gpt-image-2.5-flare-vip и gpt-image-2.5-sunburst-vip стоят $0,03 и не принимают маску, а gpt-image-2.5-web стоит столько же, но не даёт выбрать между Flare и Sunburst. Модели -vip отключали с 16 по 22 сентября 2026 года, с 22 сентября они снова работают. Цены приведены по прайсу на 24 сентября 2026 года.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Для n8n в этом примере важнее другое: по документации laozhang.ai элемент data[] может прийти как Base64 с префиксом data:image/png;base64,, без = в конце или как временная ссылка url. Встроенный узел такие ответы не разбирает, поэтому с этим агрегатором надёжнее путь через HTTP Request с шагом очистки, описанным ниже.
Форма ответа определяет цепочку
OpenAI в Image API всегда возвращает картинку строкой Base64 в поле data[].b64_json. У агрегаторов встречаются и другие варианты, и для каждого нужна своя последовательность узлов.
| Что приходит в ответе | Цепочка в n8n |
|---|---|
data[].b64_json, чистая строка | узел OpenAI либо HTTP Request → Edit Fields → Convert to File |
b64_json с префиксом data:image/...;base64, или без = в конце | HTTP Request → Code (очистка строки) → Convert to File |
data[].url, временная ссылка | HTTP Request → второй HTTP Request методом GET по ссылке с Response Format: File, сразу, пока ссылка жива |
| ID задачи вместо картинки | HTTP Request (отправить задачу) → Wait → HTTP Request (статус) → IF «готово?» → скачивание по ссылке |
Почему встроенный узел ломается на нестандартных ответах, видно из кода: он берёт каждое data[].b64_json и декодирует как Base64, больше ничего не проверяя. Если вместо b64_json пришёл url, декодировать нечего, и узел упадёт с ошибкой. С префиксом ситуация хуже: символы data, image, png, base64 и / допустимы в Base64, поэтому вероятный итог — файл с мусором в начале, который не открывается, хотя узел отработал без ошибок.
Для асинхронного варианта обязательно ограничьте число попыток опроса счётчиком, иначе процесс будет ждать вечно. Для ориентира: в шаблоне n8n у HiAPI статус задачи проверяется каждые 5 секунд, не более 36 раз, а сохранение файла вынесено в отдельный шаг.
Цепочка через HTTP Request: от запроса к файлу
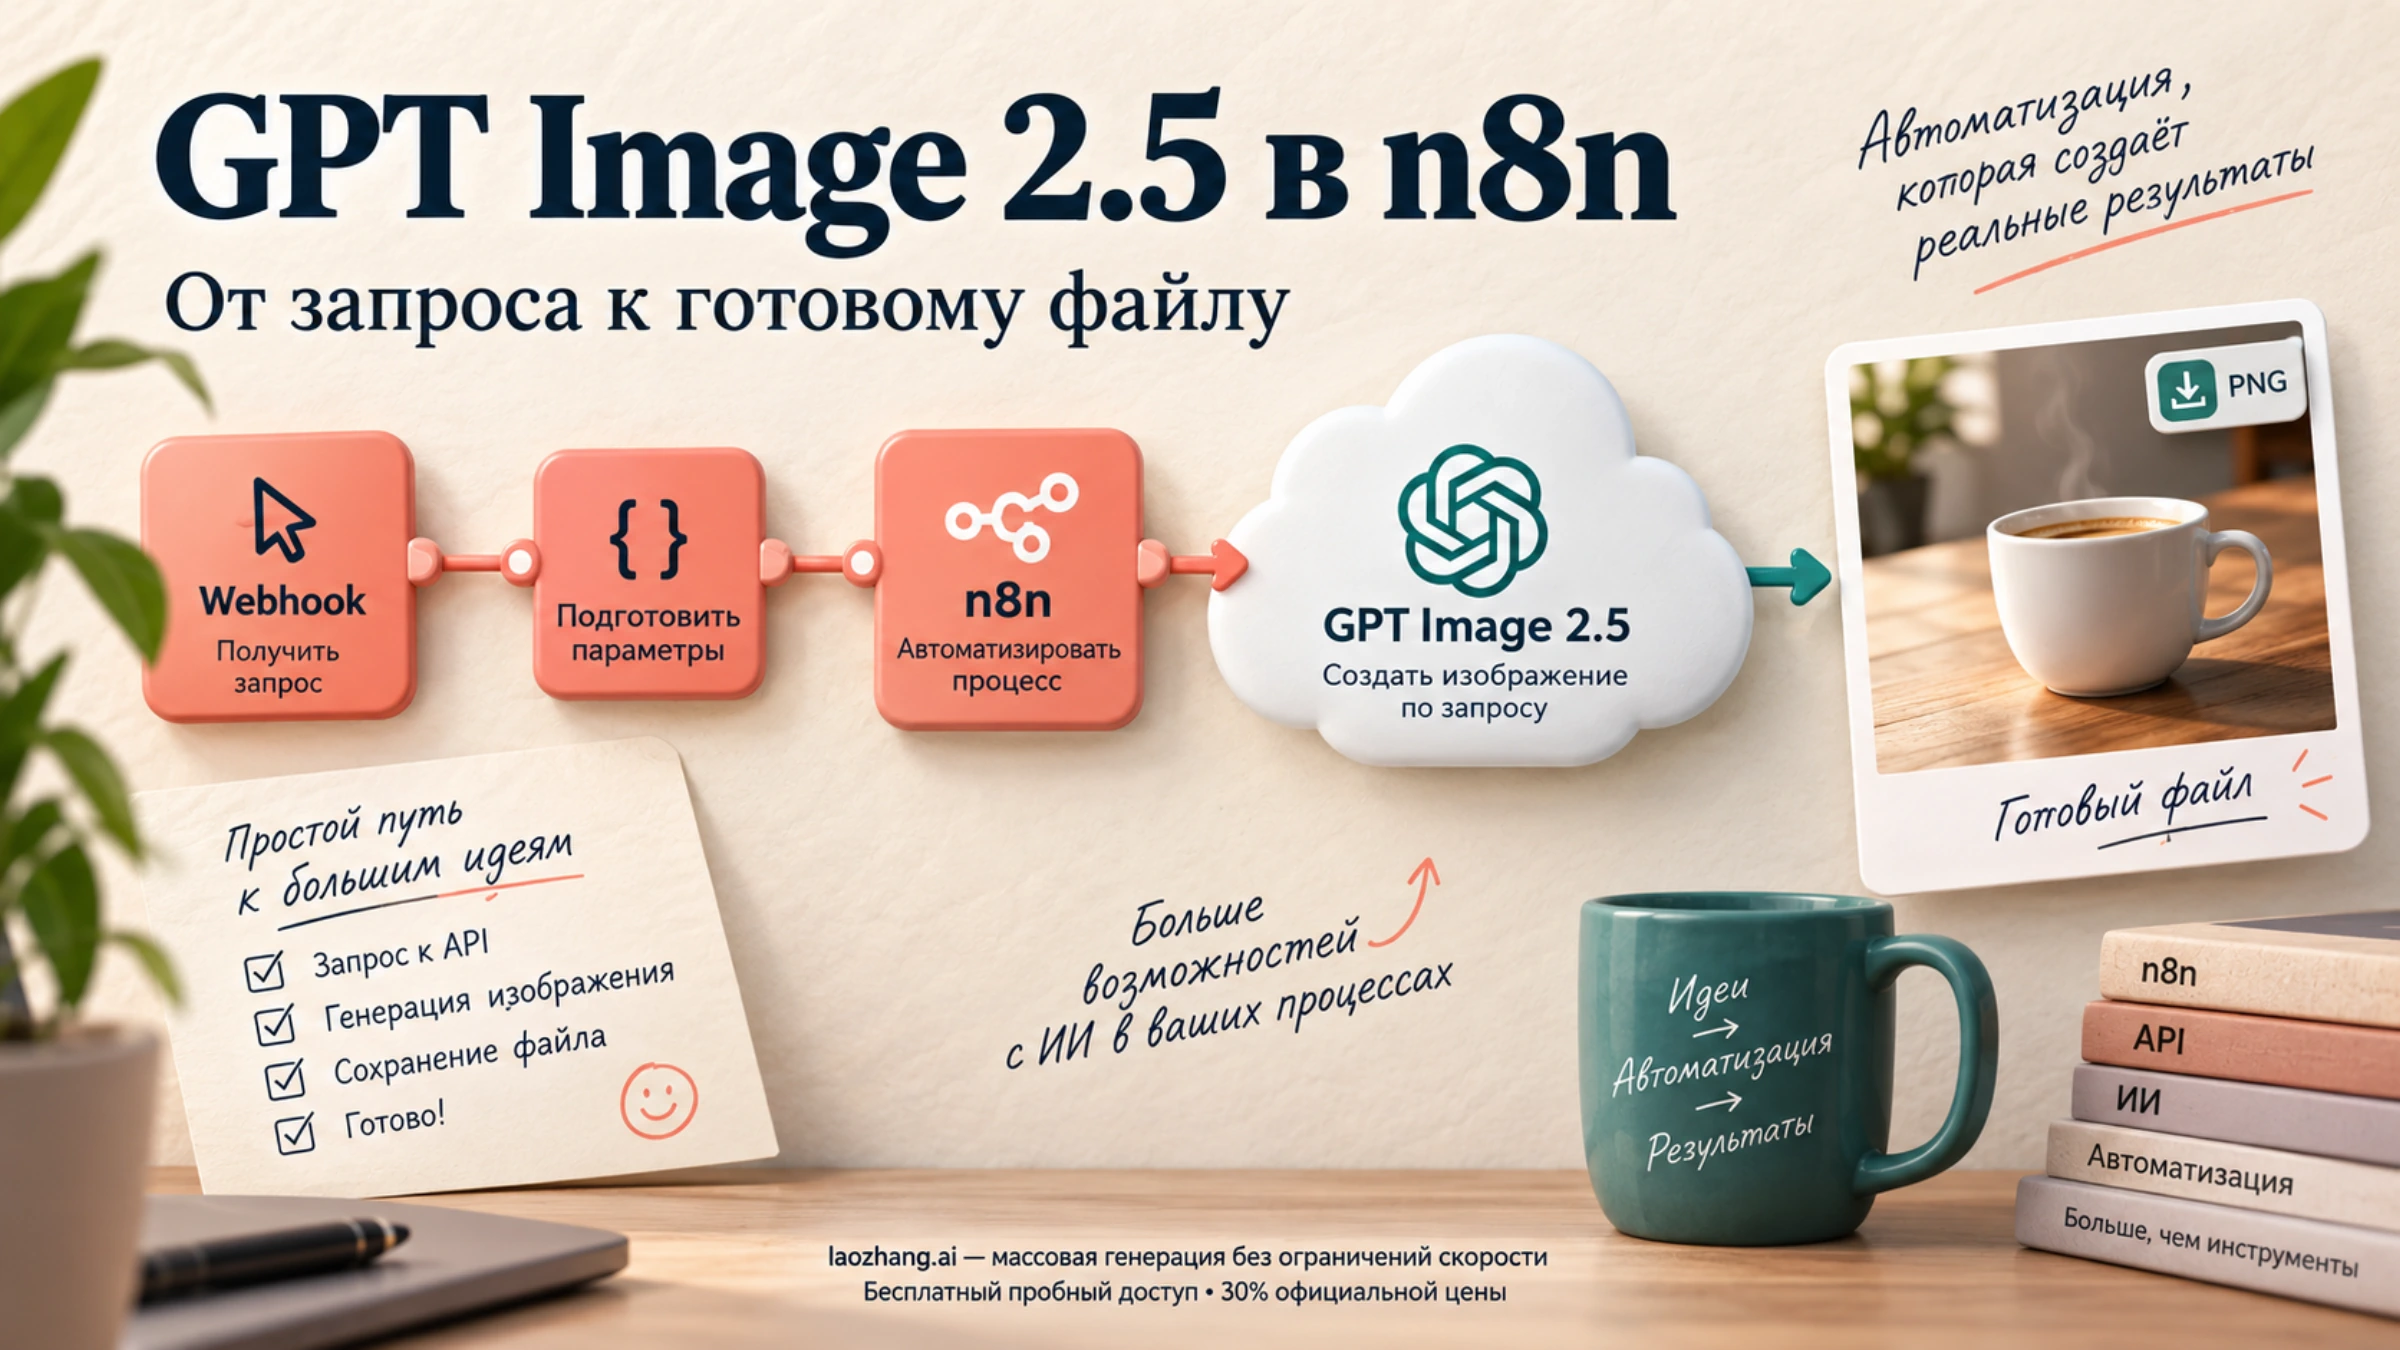
Базовая цепочка для OpenAI и совместимых агрегаторов — четыре узла.
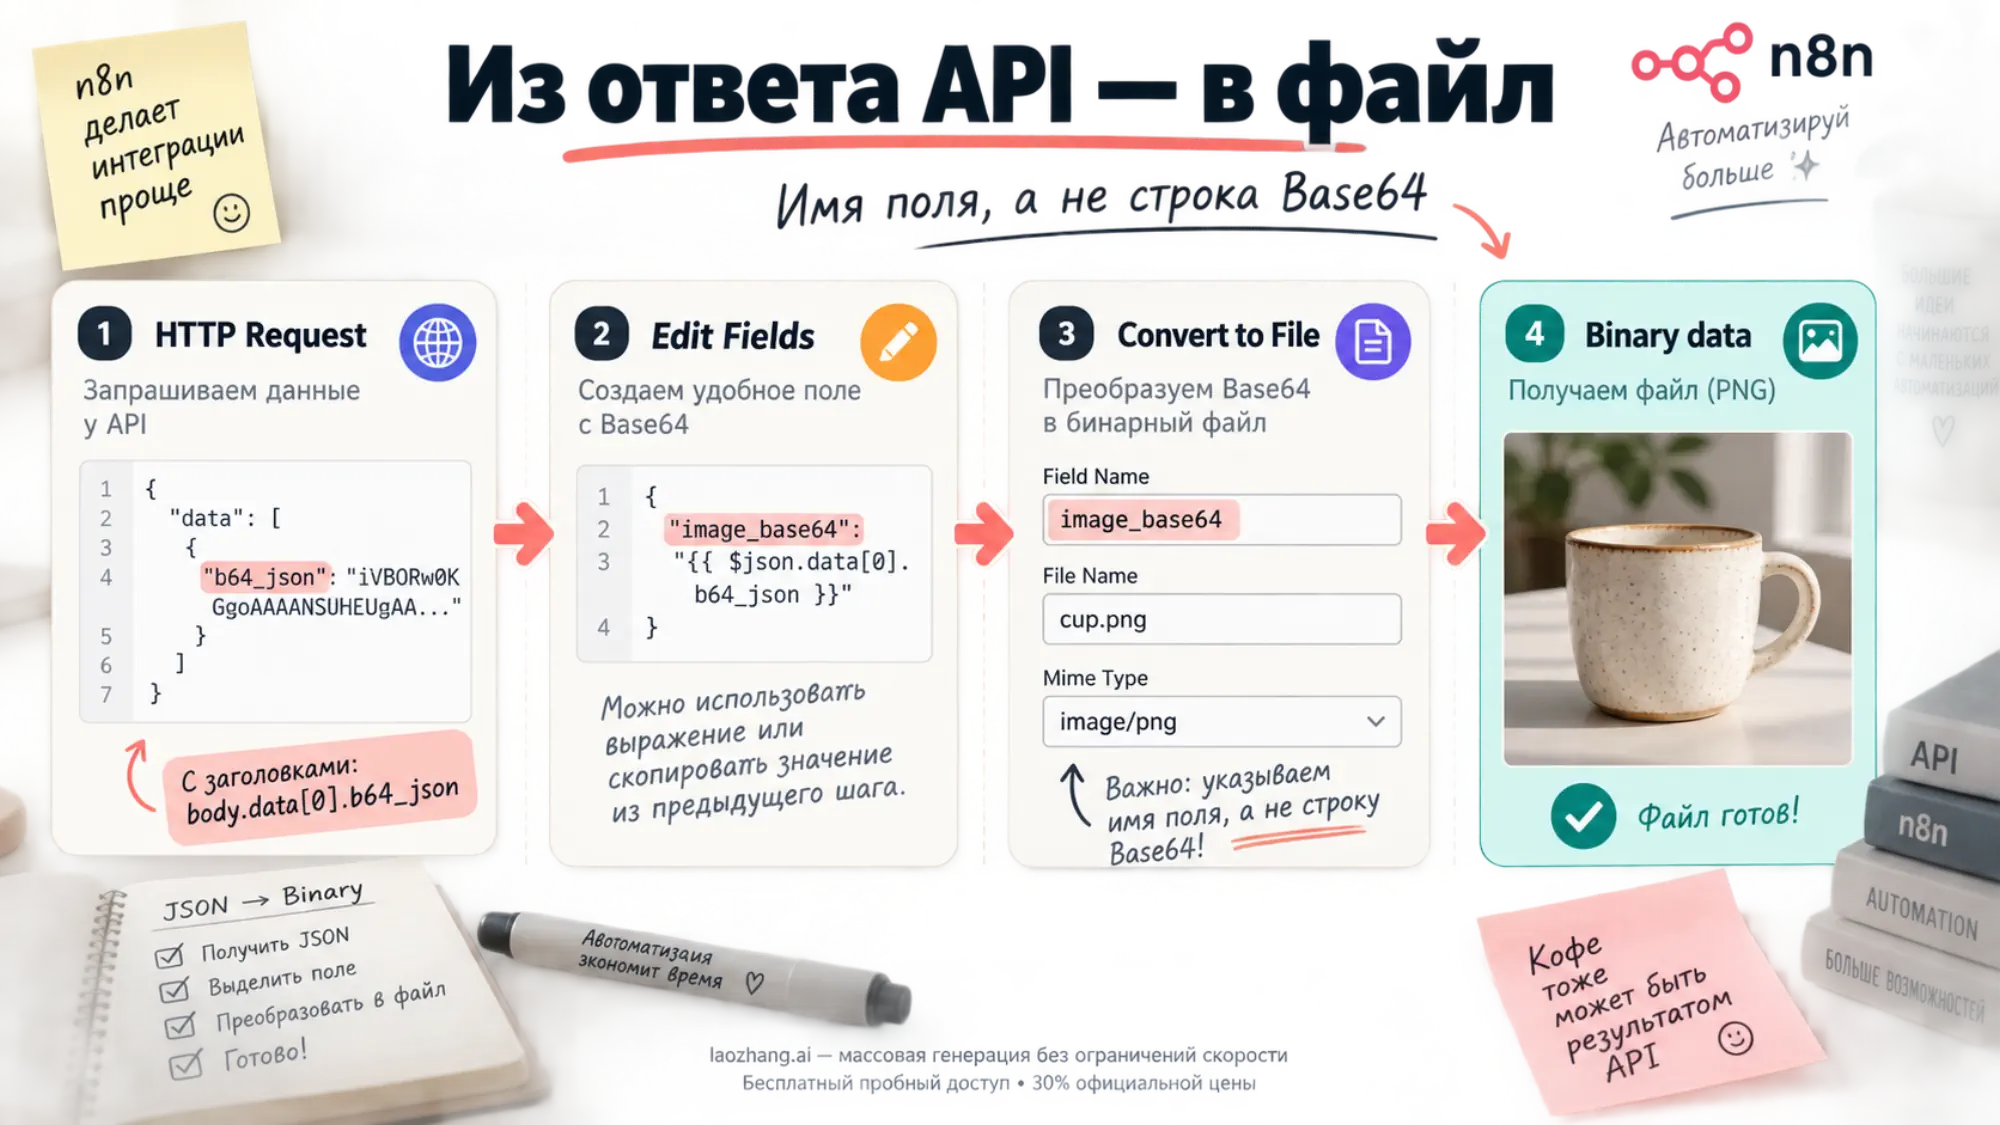
1. HTTP Request. Method — POST, URL — https://api.openai.com/v1/images/generations (для агрегатора — его Base URL плюс /images/generations). Адрес пишется целиком. В Authentication выберите Predefined Credential Type и те же учётные данные OpenAI, что и у узла, — n8n рекомендует этот вариант, когда он доступен. Включите Send Body, тип JSON, режим Using JSON, и переключите поле в режим выражения, чтобы подставлять промпт из предыдущего шага:
{
  "model": "gpt-image-2.5-flare",
  "prompt": {{ JSON.stringify($json.prompt) }},
  "size": "2048x1152",
  "quality": "xhigh",
  "background": "transparent",
  "output_format": "png"
}
JSON.stringify нужен, чтобы кавычки и переносы строк в промпте не ломали JSON. Размер 2048x1152 удовлетворяет всем правилам: обе стороны кратны 16, соотношение 16:9, около 2,36 млн пикселей, и он меньше экспериментальной границы 2560x1440. Прозрачный фон работает только с output_format png или webp. Для JPEG и WebP можно добавить output_compression от 0 до 100; JPEG, по данным OpenAI, генерируется быстрее PNG. Поле response_format не добавляйте: модели GPT Image всё равно отвечают Base64, а часть агрегаторов на этот параметр возвращает ошибку.
2. Edit Fields (Set). Создайте поле image_base64 со значением {{ $json.data[0].b64_json }}. Если в HTTP Request включена опция Include Response Headers and Status, тело ответа лежит под body, и путь становится {{ $json.body.data[0].b64_json }}.
3. Convert to File. Операция Move Base64 String to File. В поле Base64 Input Field укажите имя поля — image_base64, а не саму строку и не выражение в фигурных скобках. Put Output File in Field оставьте data, в Options задайте File Name (например, cup.png) и MIME Type image/png. Расширение и MIME должны совпадать с output_format из запроса.
4. Проверка. Откройте двоичные данные на выходе Convert to File: предпросмотр должен показывать картинку, размер файла — быть ненулевым. Только после этого подключайте хранилище и отправку.
Если агрегатор отвечает Base64 с префиксом или ссылкой, замените Edit Fields узлом Code (JavaScript, Run Once for All Items). Он приводит все варианты к одному виду и заодно сохраняет usage:
const out = [];
for (const item of $input.all()) {
  // с Include Response Headers and Status ответ лежит в body
  const res = item.json.body ?? item.json;
  const usage = res.usage ?? null;
  (res.data ?? []).forEach((entry, index) => {
    let b64 = entry.b64_json ?? null;
    if (b64) {
      b64 = b64.replace(/^data:[^,]*,/, '').replace(/\s/g, '');
      b64 += '='.repeat((4 - (b64.length % 4)) % 4);
    }
    out.push({
      json: { index, image_base64: b64, image_url: entry.url ?? null, usage },
    });
  });
}
return out;
За ним поставьте IF: если image_base64 не пустое, элемент идёт в Convert to File; если пустое — во второй HTTP Request, который методом GET скачивает {{ $json.image_url }} с Response Format: File. Если в data не оказалось ни одного элемента, Code вернёт пустой список — такой случай разбирается в разделе про ошибки.
Про размеры 4K и проверку итоговых пикселей подробно написано на примере предыдущей модели в статье «GPT Image 2 4K API: как сгенерировать, сохранить и проверить 3840x2160»; правила размеров у 2.5 такие же, как перечислены выше.
Правки: несколько референсов и маска
Во встроенном узле Edit an Image референсы добавляются как несколько двоичных полей в Images (каждое — Binary Field Name), а маска — через Options → Image Mask, где указывается имя двоичного поля с PNG-маской. Узел сам отправит их как повторяющиеся image[] и mask.
Через HTTP Request то же самое собирается вручную: POST на /images/edits, Send Body с типом Form-Data. Параметры model, prompt, size и quality — обычные Form Data. Каждый референс — отдельный параметр типа n8n Binary File с Name image[] и Input Data Field Name, равным имени двоичного поля (data, ref2 и так далее). Маска — ещё один n8n Binary File с Name mask. Этот путь нужен, если в правке требуются xhigh, max или размер крупнее 1536 пикселей, которых в узле Edit нет, либо определённый формат файла: добавьте Form Data output_format и после ответа проверьте MIME type файла.
Требования OpenAI к маске:
- при нескольких входных изображениях маска относится к первому;
- изображение и маска должны быть одного формата и размера, у маски должен быть альфа-канал: прозрачные области показывают, что менять;
- маска для GPT Image — подсказка для модели, а не точная граница: форму она может соблюсти не идеально.
Ограничения по объёму в источниках расходятся: руководство OpenAI говорит о файлах меньше 50 МБ, подсказка в узле n8n — о маске PNG меньше 4 МБ. Если держать маску меньше 4 МБ, подойдут оба условия. Сколько референсов принимает OpenAI, в руководстве не указано; у laozhang.ai на маршруте официальной переадресации заявлено до 16 изображений.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Usage, пакеты и таймаут
Где теряется usage
Ответ Image API содержит объект usage с полями input_tokens, output_tokens, total_tokens и детализацией input_tokens_details. Встроенный узел OpenAI его отбрасывает во всех операциях с изображениями: в issue #38482 это воспроизведено на n8n 2.38.6 с узлом версии 2.3 и моделью gpt-image-2.5-flare, и достать usage выражением или узлом Code там нельзя. По состоянию на 25 сентября 2026 года issue открыт. Пустой usage не означает бесплатную генерацию.
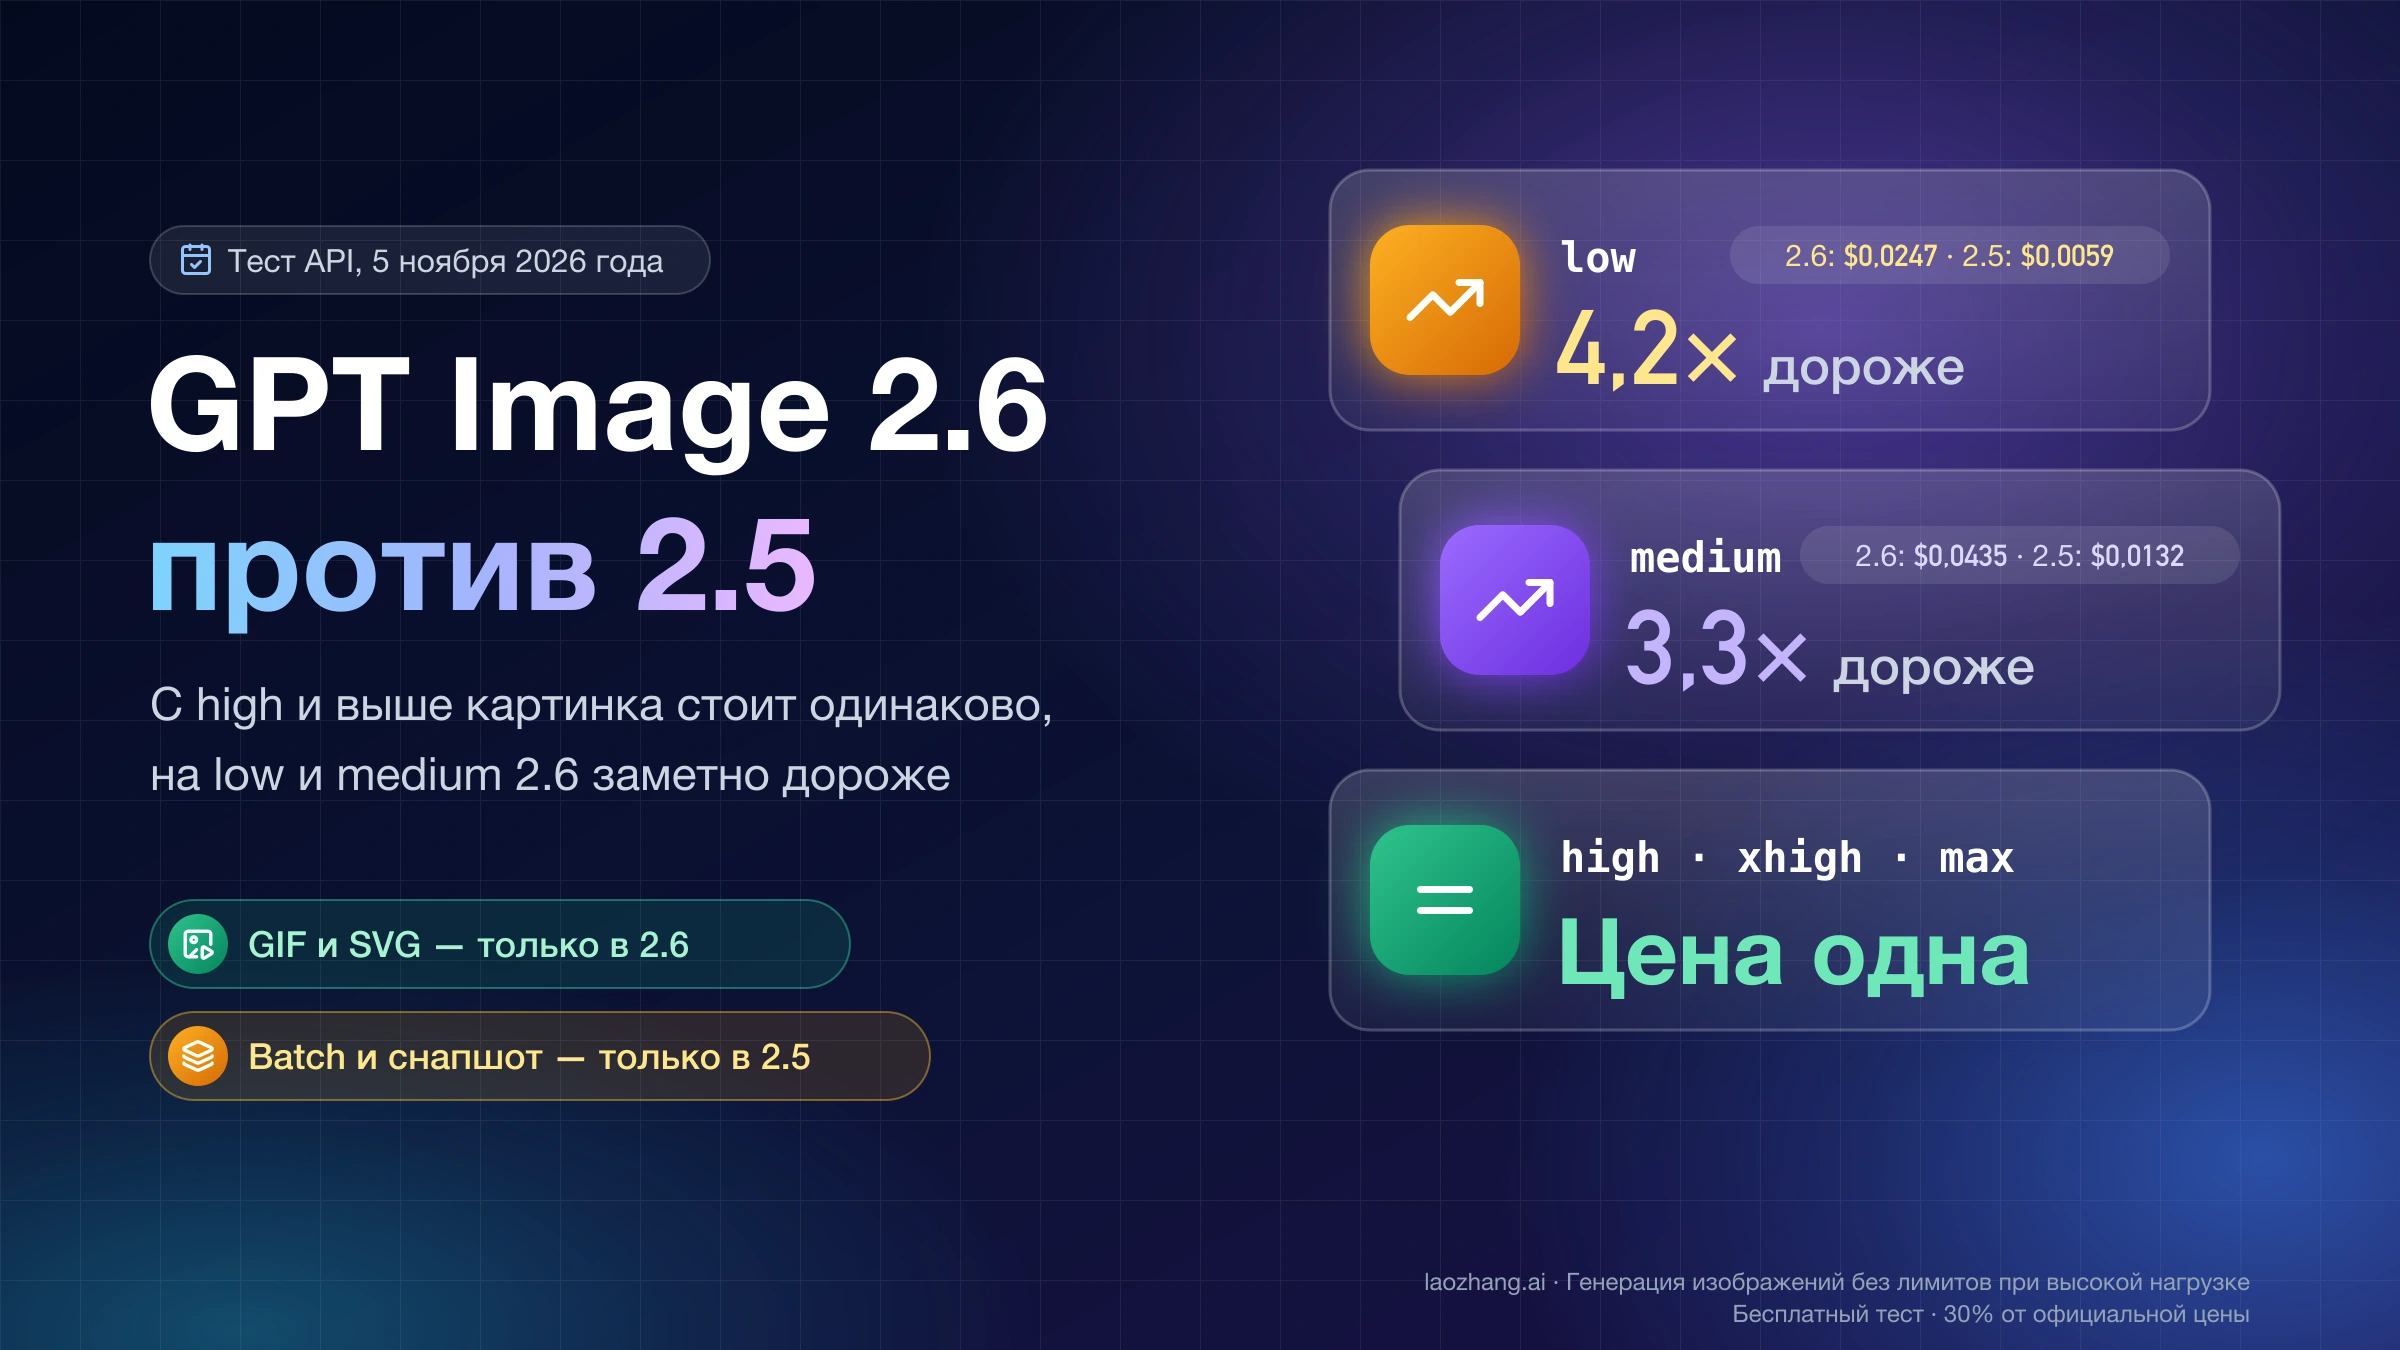
Учёт важен потому, что GPT Image 2.5 оплачивается по токенам. Ставки у Flare и Sunburst одинаковые, но это не делает одинаковой цену картинки: расход токенов зависит от модели и качества, а при quality: auto модель выбирает сама, и одинаковые запросы могут стоить по-разному. Как пересчитать токены в стоимость одного изображения, разобрано в статье «GPT Image 2.5 Sunburst: цена API и бюджет генерации».
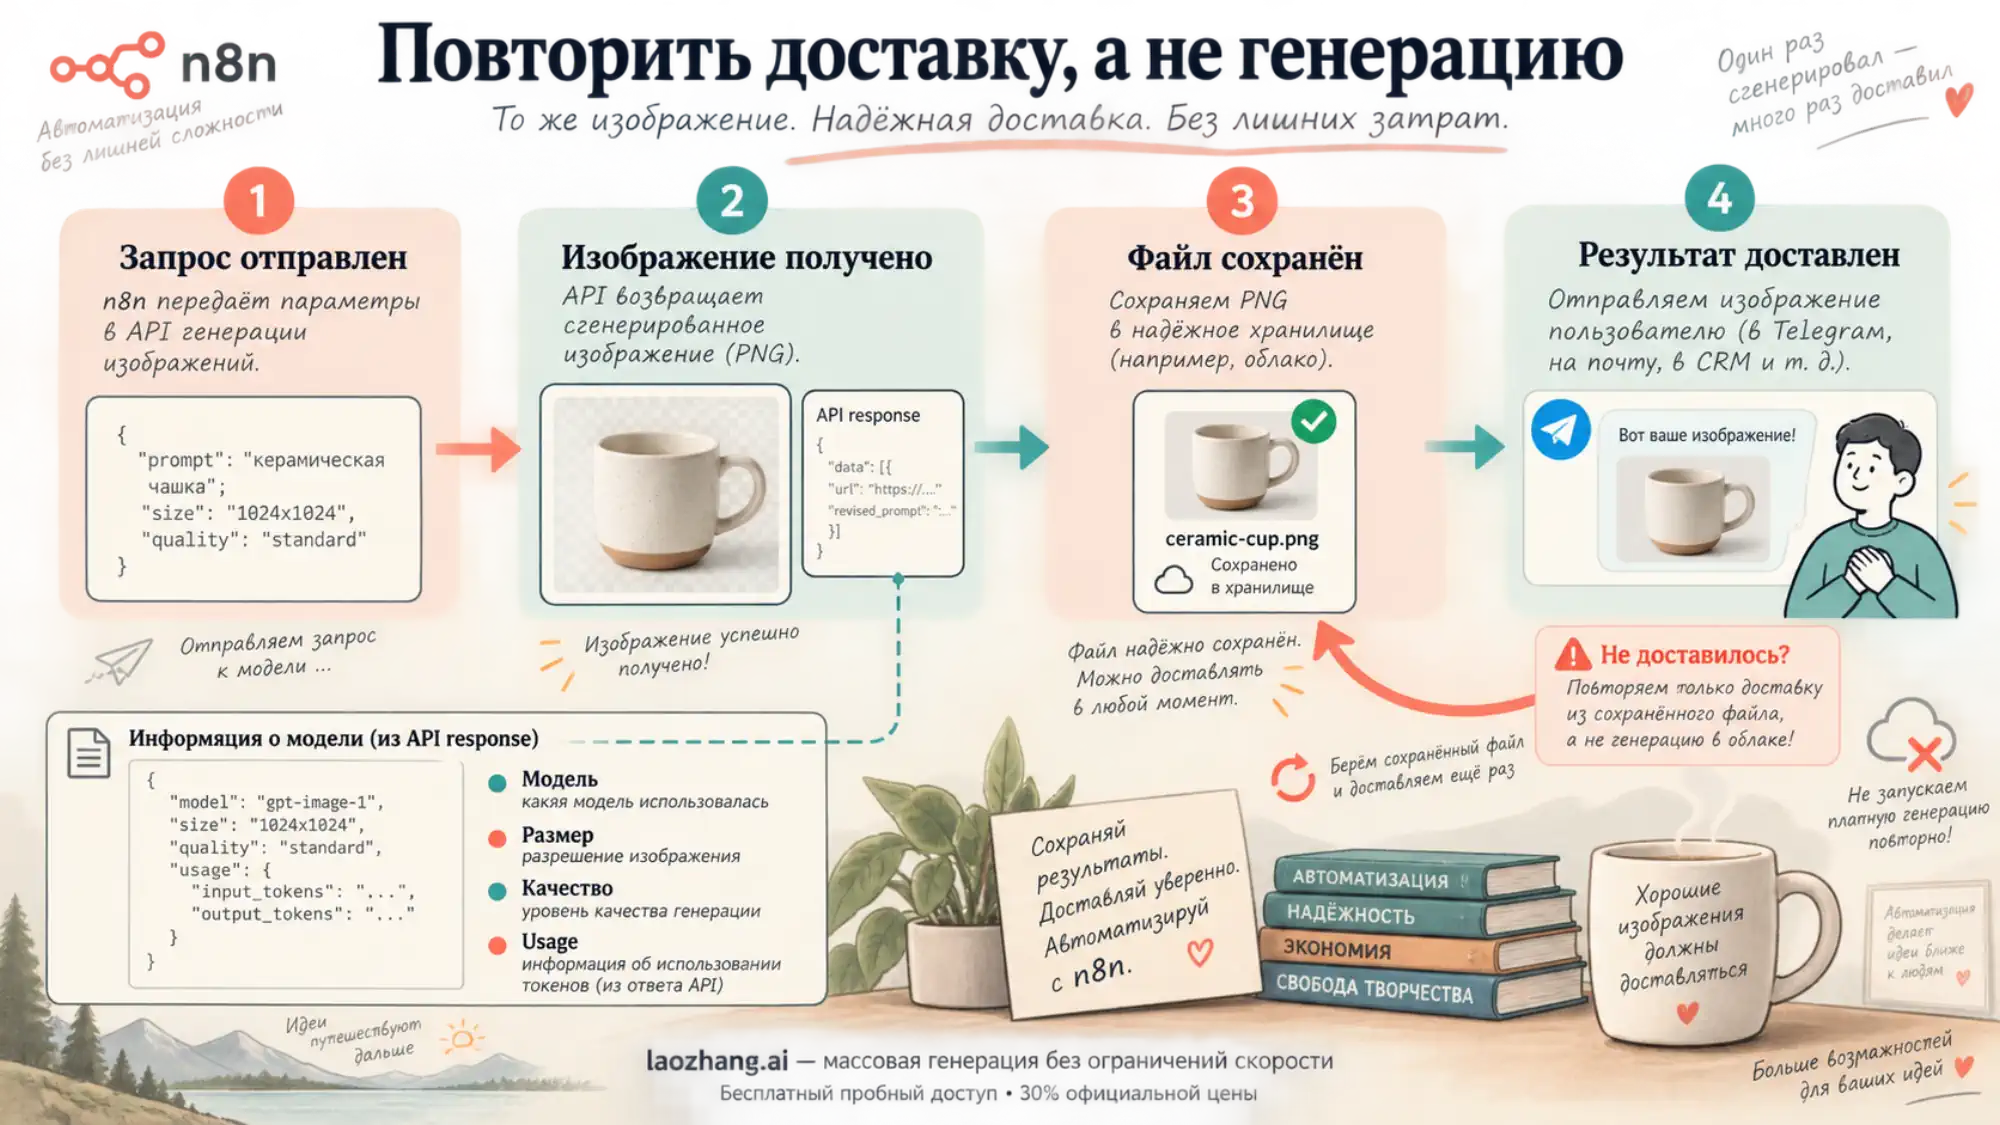
В HTTP-цепочке есть своя ловушка: Convert to File выдаёт элемент с пустым JSON и файлом, всё, что было до него, включая usage, пропадает. Поэтому запись в журнал (Google Sheets, база данных, таблица n8n) ставьте отдельной веткой после HTTP Request или Code, до Convert to File. Удобно сохранять вместе с usage модель, размер, качество, время и ID запроса из заголовков ответа.
Интервал между запросами
У OpenAI лимит на изображения в минуту (IPM) зависит от уровня организации и одинаков для Flare и Sunburst. Чтобы не упираться в него, в HTTP Request откройте Options → Batching, поставьте Items per Batch = 1, а Batch Interval (в миллисекундах) — не меньше 60 000 ÷ IPM:
| Уровень | Изображений в минуту | Batch Interval, мс, не меньше |
|---|---|---|
| Tier 1 | 5 | 12 000 |
| Tier 2 | 20 | 3 000 |
| Tier 3 | 50 | 1 200 |
| Tier 4 | 150 | 400 |
| Tier 5 | 250 | 240 |
Расчёт верен для одной картинки на запрос и без другой нагрузки на ту же организацию. Batching действует внутри одного запуска: если процесс одновременно запускают несколько триггеров или с тем же ключом работают другие сервисы, интервал нужно брать с запасом. У агрегаторов свои лимиты — берите IPM из их документации.
Таймаут
Опция Timeout в HTTP Request задаёт, сколько узел ждёт, пока сервер пришлёт заголовки ответа. Image API присылает ответ целиком после генерации, а сложный промпт, по данным OpenAI, может обрабатываться до 2 минут. Значит, Timeout должен быть больше 120 000 мс, с запасом — например, 180 000. Значение по умолчанию в документации n8n не указано, поэтому задайте его явно.
Ошибки: что повторять, а что нет
Чтобы разбирать ошибки внутри процесса, включите в HTTP Request опции Never Error и Include Response Headers and Status. Тогда ответ с любым кодом не останавливает процесс, а следующий узел IF видит statusCode и body.error. Разводите ветки по error.type и error.code, а не только по коду статуса: OpenAI называет error.code надёжным признаком для программной обработки.
| Ситуация | Повторять автоматически? | Что делать |
|---|---|---|
| Превышен лимит запросов | да | Wait с растущей паузой, затем повтор |
| Ошибка на стороне сервера | да | так же, с паузой и ограничением числа попыток |
| Исчерпана квота | нет | остановить процесс и уведомить ответственного |
image_generation_user_error, в том числе moderation_blocked | нет, пока не изменены промпт или изображения | moderation_details.moderation_stage покажет, где сработала модерация: input, output или unknown |
| Таймаут | не сразу | сначала проверить, не была ли картинка создана |
| Сбой доставки | повторять только доставку | взять сохранённый файл из хранилища |
Строгостью модерации управляет параметр moderation: auto по умолчанию или low.
Таймаут не доказывает, что изображение не создано. Как OpenAI поступает с оплатой при обрыве соединения со стороны клиента, в документации не описано. У laozhang.ai прямо сказано, что обрыв на стороне клиента не отменяет генерацию и она оплачивается после завершения, а запросы, не давшие картинки (ошибка параметров, блокировка модерацией, ошибка авторизации, превышение лимита), как правило, не списываются. Поэтому перед повтором после таймаута смотрите журнал вызовов в консоли провайдера.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
По той же причине разделяйте генерацию и доставку. Сначала сохраните файл в хранилище (облако, S3, диск сервера), и только потом отправляйте его в Telegram, на почту или в CRM. Если отправка упала, ветка ошибки повторяет только её, беря уже сохранённый файл, и платная генерация не запускается второй раз.
Узел зелёный, а файла нет: порядок проверки
Идите сверху вниз и останавливайтесь на первом шаге, который не проходит.
- Есть ли в выходе HTTP Request массив
data? Нет — смотритеerrorв теле ответа и разбирайте по таблице выше. Если включён Never Error, ошибка не остановила процесс, и узел остаётся зелёным. - Путь к полю верный? С Include Response Headers and Status всё тело лежит под
body:body.data[0].b64_jsonвместоdata[0].b64_json. - В
data[0]лежитb64_jsonилиurl? Еслиurl, строки Base64 нет, нужен шаг скачивания. - Строка начинается с
data:? Префикс надо удалить до Convert to File (узел Code выше). Это же объясняет «битые» файлы из встроенного узла при работе через агрегатор. - В Convert to File указано имя поля? В Base64 Input Field пишется
image_base64, а не сама строка и не выражение. - Файл есть, но не открывается? Сверьте расширение и MIME Type с
output_formatзапроса. Если они совпадают, а файл всё равно битый, вернитесь к шагу 4: в строке мог остаться префикс. - Файл открывается в n8n, но не дошёл до адресата? Проблема в узле доставки — повторяйте отправку сохранённого файла, а не генерацию.
- Файл есть, но
usageпустой? Работает встроенный узел OpenAI, он теряет эти данные. Для учёта токенов нужен HTTP Request.
Если файл сохраняется и открывается, но на картинке шум или зерно, это уже вопрос качества генерации, а не цепочки n8n; что проверить в таком случае, описано в статье «Шум и зерно в GPT Image 2.5: где появились и что с ними делать».
Когда n8n — не лучший вариант
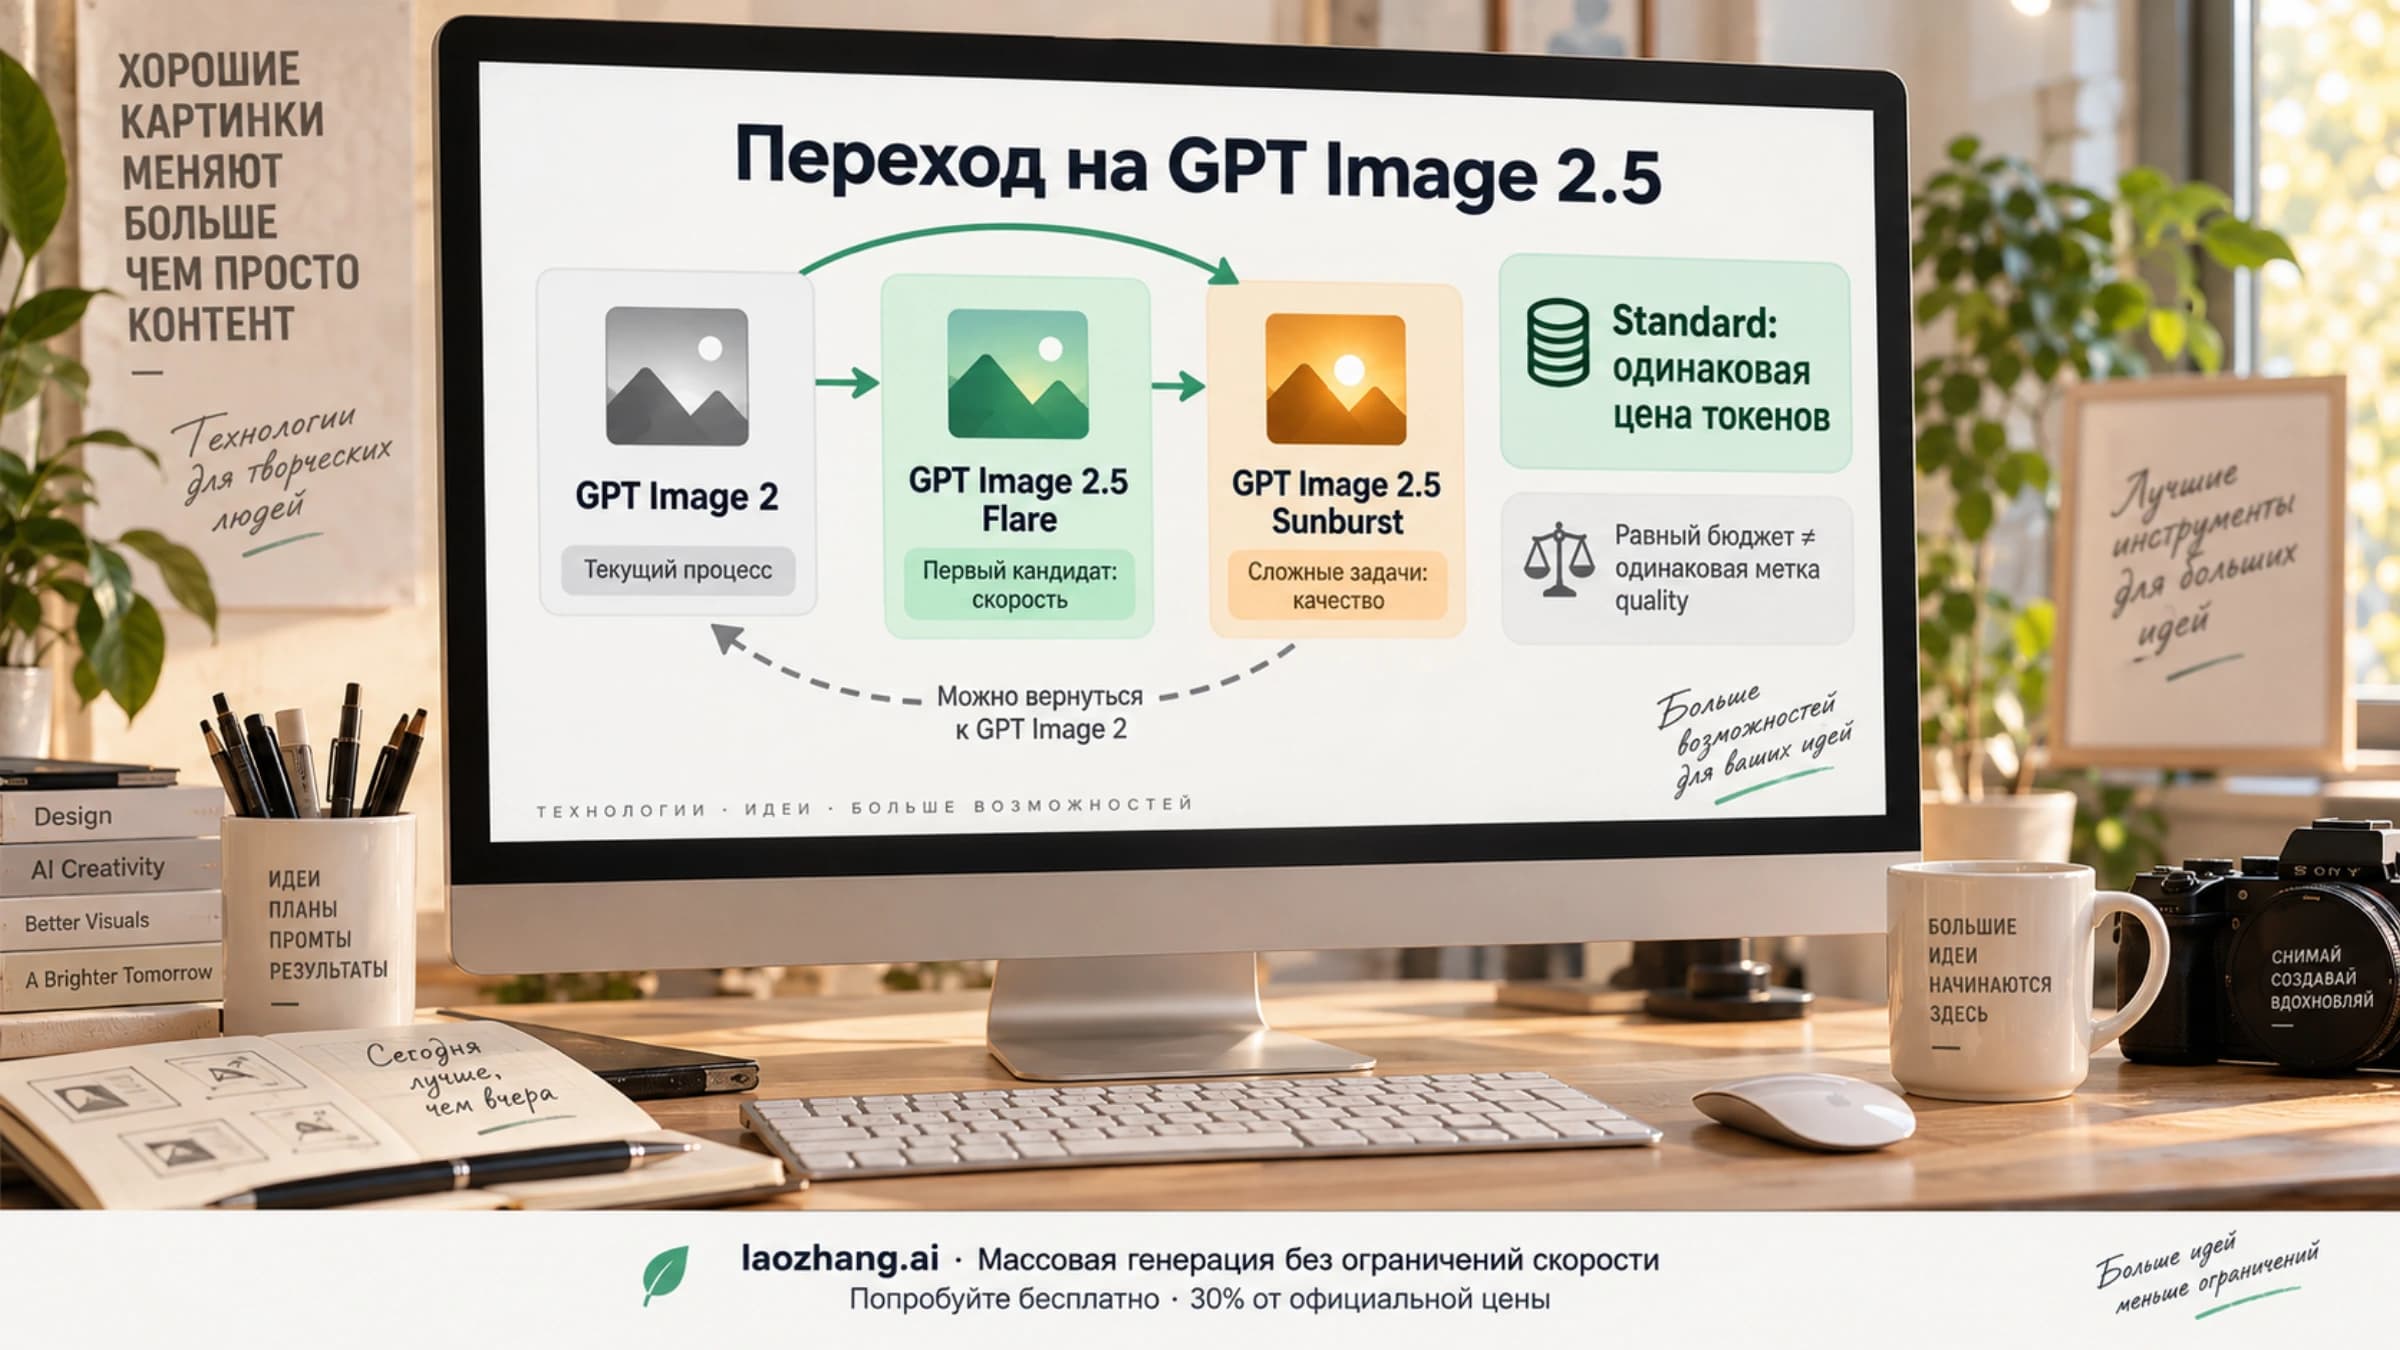
n8n удобен, когда картинка — часть процесса: пришла заявка, товар или пост, и изображение нужно создать, сохранить и отправить без участия человека. Для ручной работы с референсами и масками, где результат оценивают глазами после каждой правки, удобнее графический интерфейс; этот сценарий описан в статье «GPT Image 2.5 в ComfyUI: как подключить и сколько стоит запуск». Если в процессах пока работает GPT Image 2 и вы решаете, стоит ли менять модель в узлах, начните с материала «GPT Image 2.5 или GPT Image 2: стоит ли переходить и что с ценой».
Источники3
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 25 сент. 2026 г..
Источники3
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 25 сент. 2026 г..