Ошибка 400 prefill в Claude: на каких моделях и чем заменить
Claude Opus 4.6 и новее, Sonnet 4.6 и новее и Fable 5 отвечают 400, если запрос заканчивается ходом assistant. Уберите его и замените по назначению.
Содержание
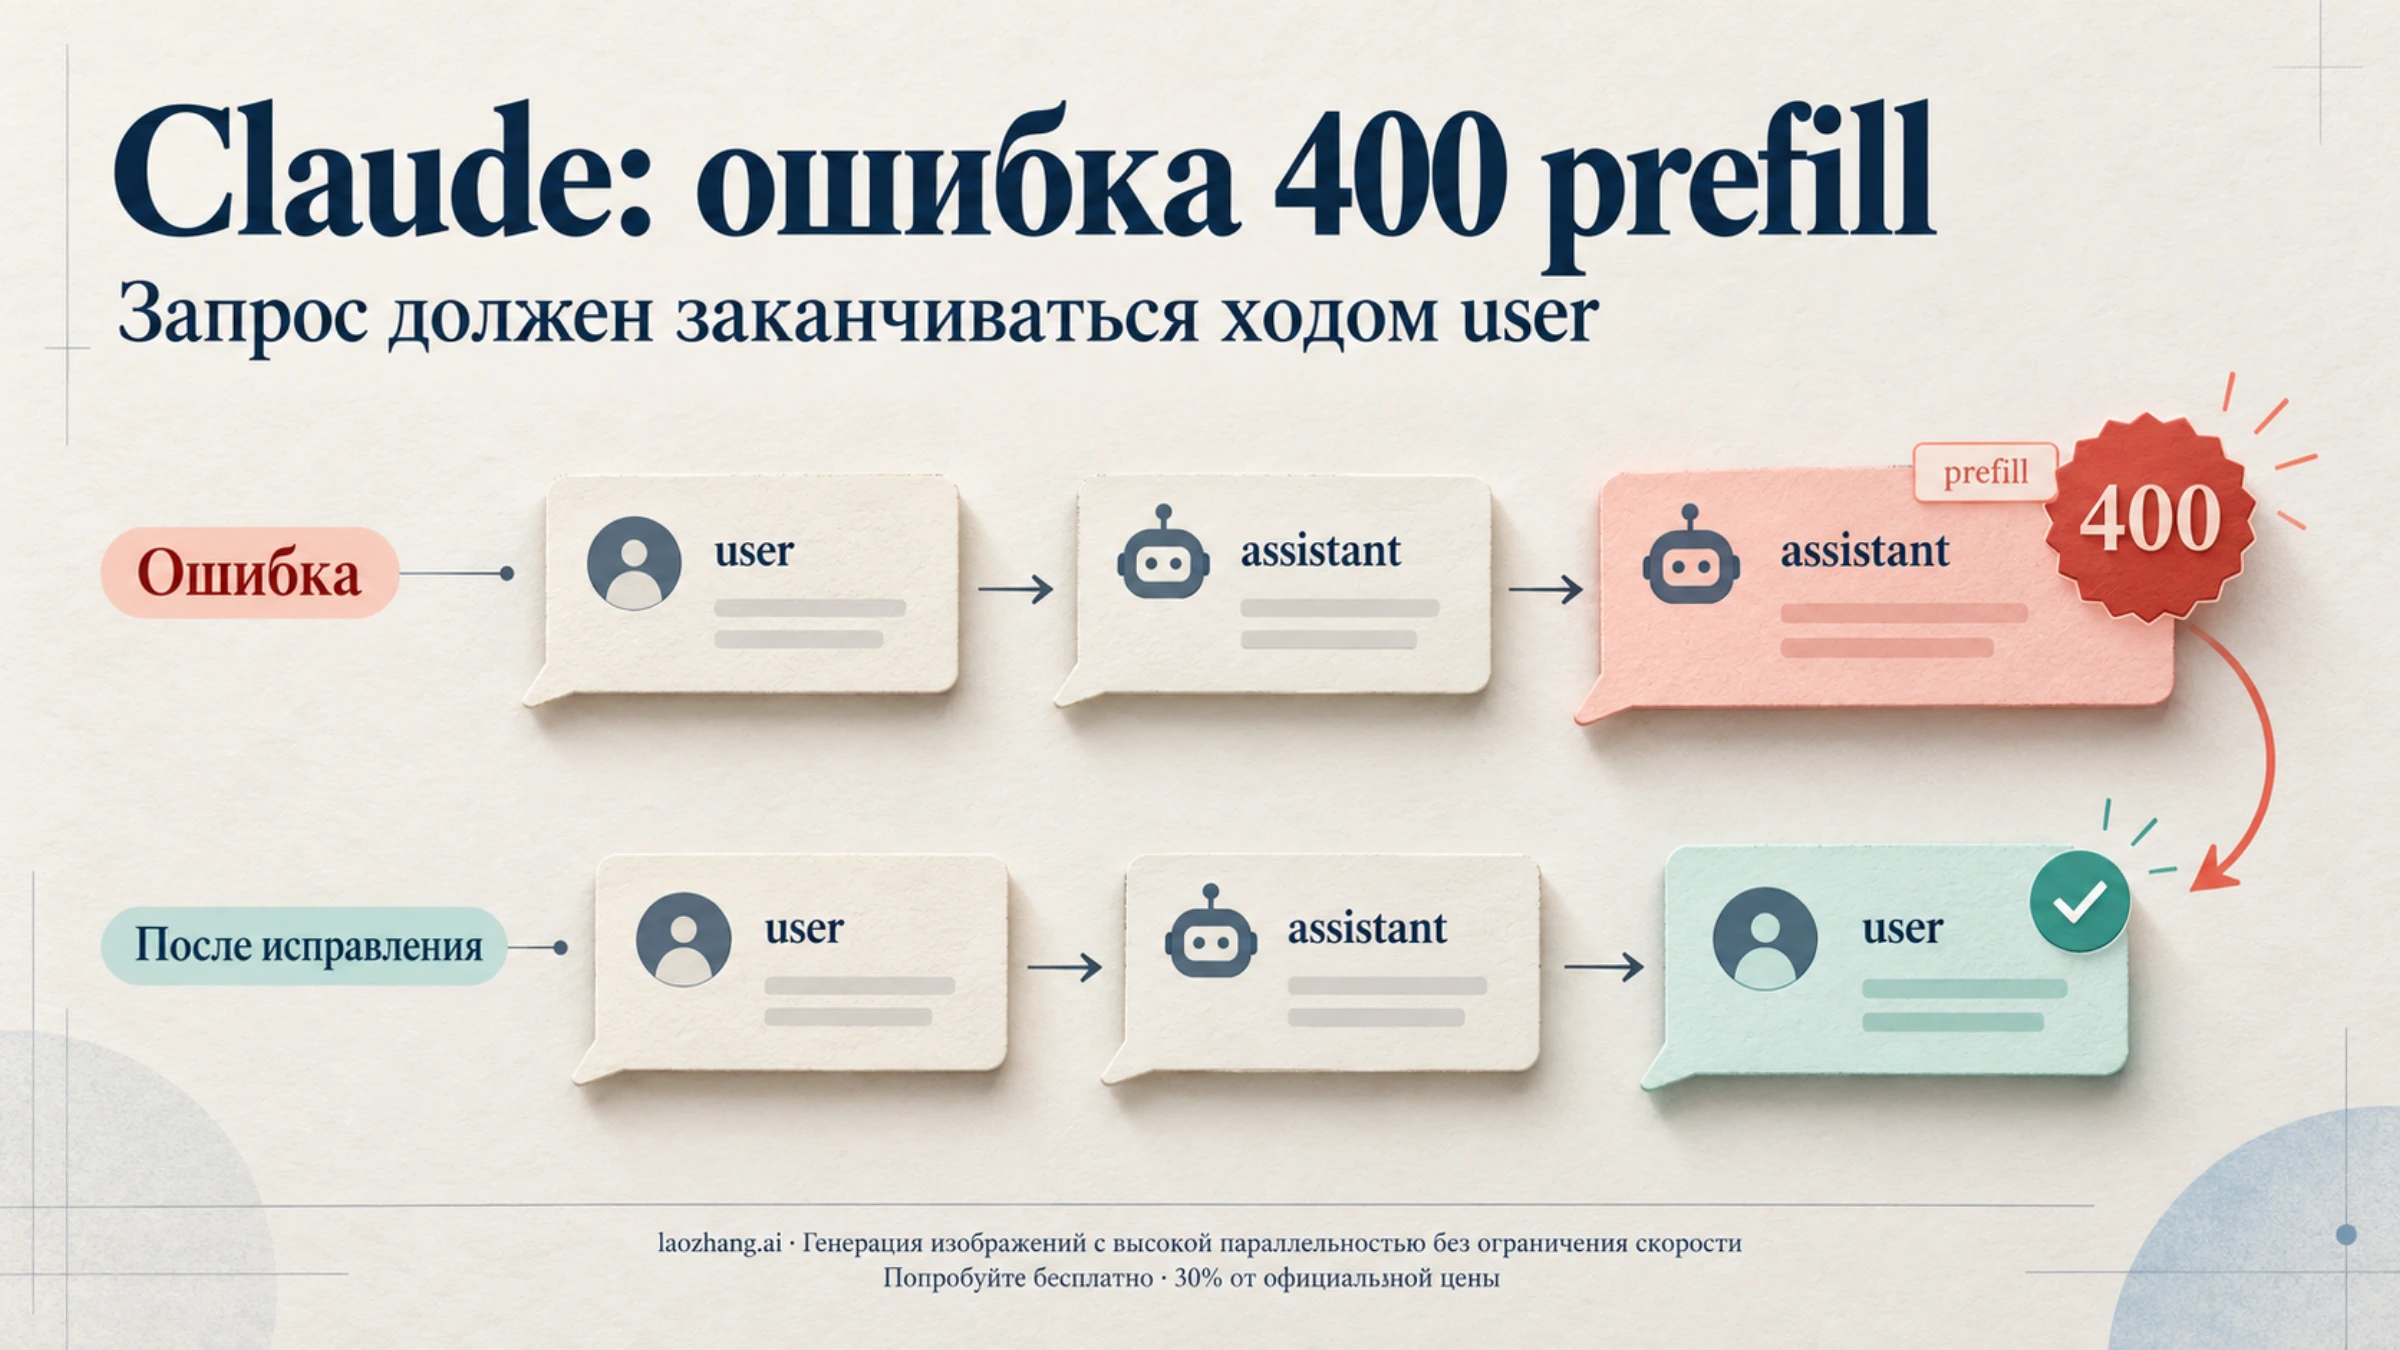
Ошибка This model does not support assistant message prefill. The conversation must end with a user message. значит одно: последнее сообщение в массиве messages имеет роль assistant, а выбранная модель такой запрос не принимает. Так ведут себя все модели Claude начиная с поколения 4.6: Opus 4.6–5.5, Sonnet 4.6–5.5, Fable 5 и 5.1, Mythos Preview. Sonnet 4.5, Haiku 4.5 и более старые модели предзаполнение ещё принимают.
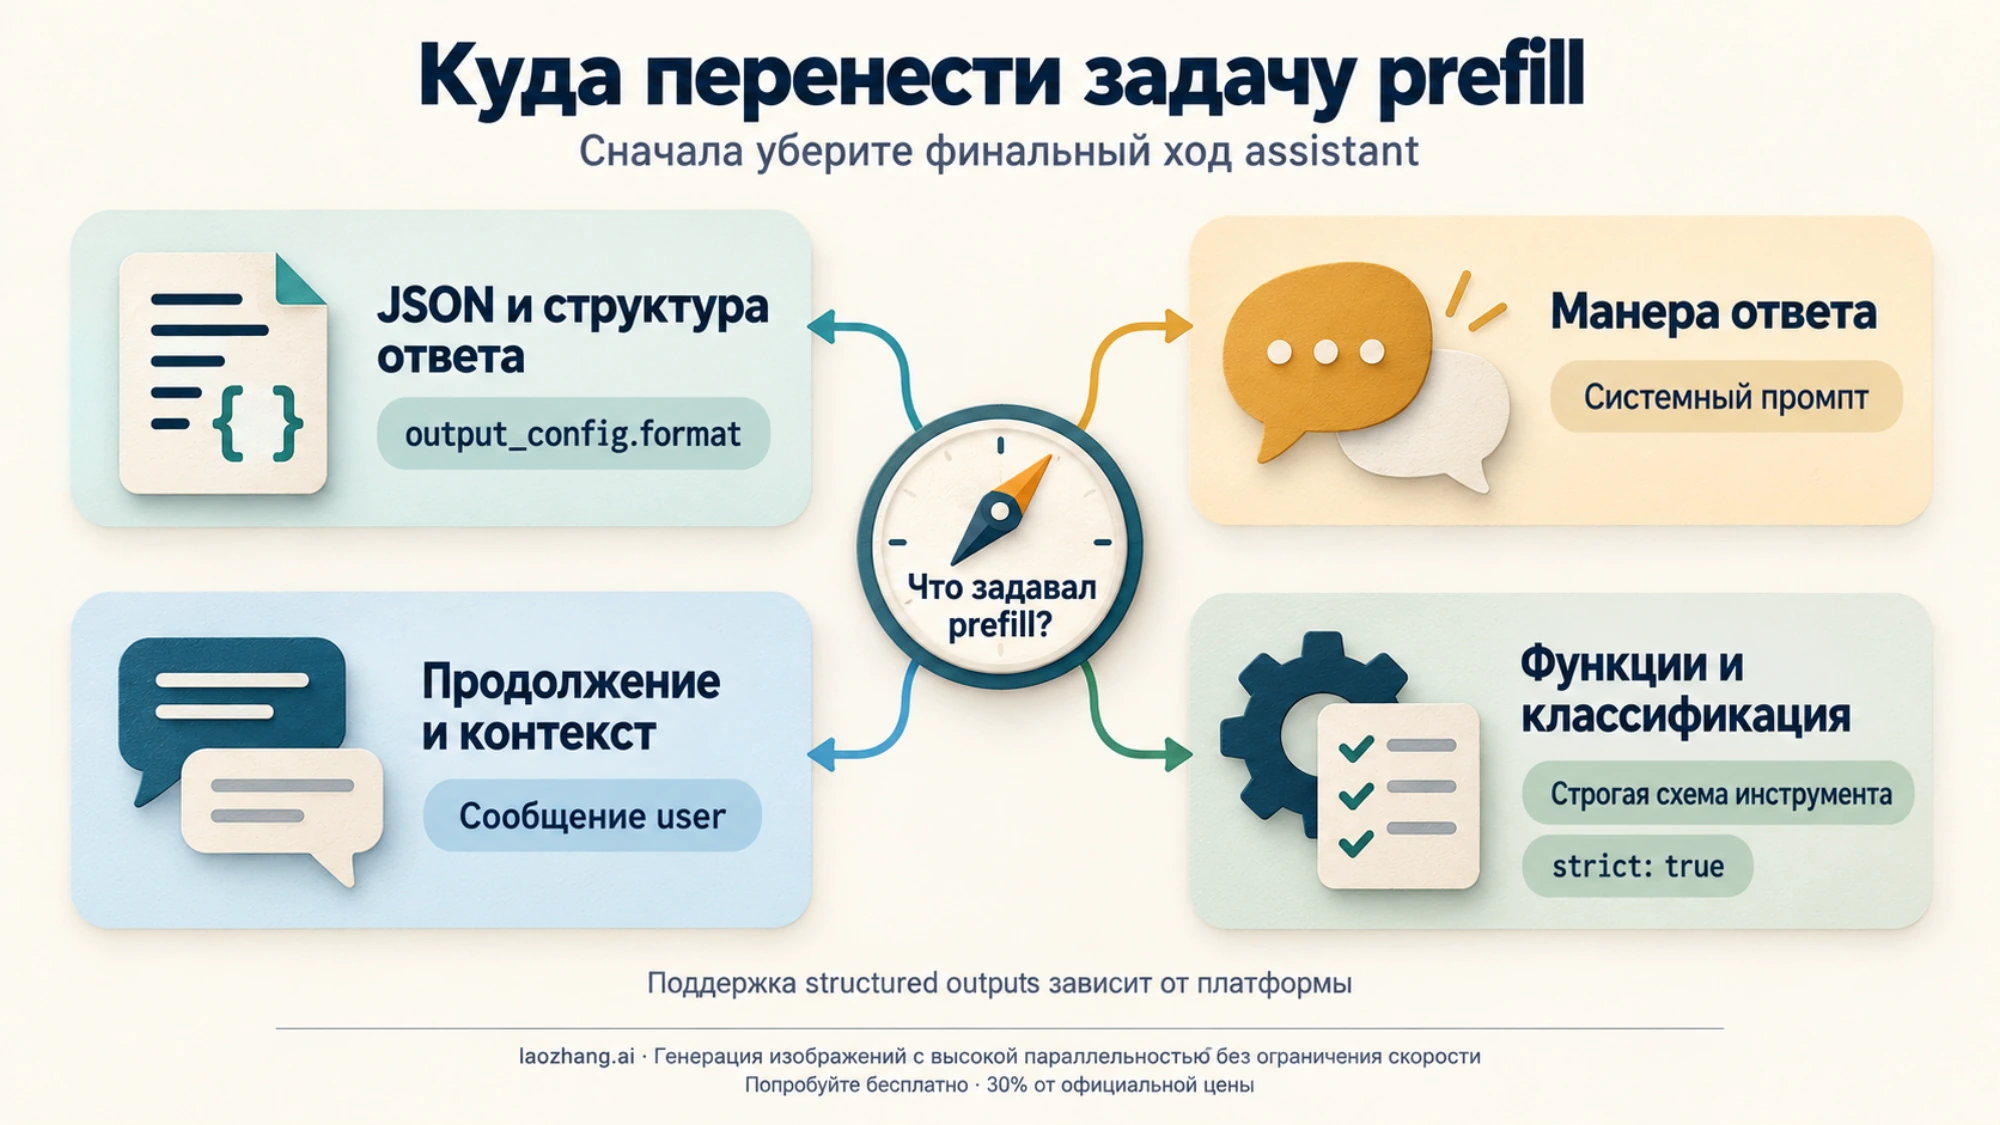
Исправление — убрать финальный ход assistant и перенести его задачу в другое место: формат ответа — в схему output_config.format, тон и отсутствие вступления — в системный промпт, продолжение оборванного ответа и напоминания — в сообщение user. Если ошибку выдаёт чужой инструмент (Copilot, opencode, LibreChat), поправить запрос может только его разработчик, а вам остаются обходные пути из раздела про инструменты.
Что означает ошибка 400 assistant message prefill
Предзаполнение (prefill) — приём, при котором запрос заканчивается не вопросом пользователя, а началом ответа модели. Раньше так заставляли Claude начать с {, с заголовка или с нужной фразы:
messages = [
    {"role": "user", "content": "List the top 3 programming languages"},
    {"role": "assistant", "content": "{"},  # prefill: модель продолжит отсюда
]
На моделях, которые prefill не поддерживают, API отклоняет такой запрос ещё до генерации и возвращает 400 invalid_request_error. Текст ошибки в документации Anthropic:
{
  "type": "error",
  "error": {
    "type": "invalid_request_error",
    "message": "This model does not support assistant message prefill. The conversation must end with a user message."
  }
}
Через посредников то же сообщение приходит в обёртке. LiteLLM пишет litellm.BadRequestError: AnthropicException и дальше исходный JSON. GitHub Copilot отдаёт его с кодом invalid_request_body. Bedrock оборачивает его в ValidationException. Через OpenRouter клиент может увидеть только Provider returned error, а исходный текст останется в логах с пометкой о 400 от Anthropic. Ищите в теле ответа слова assistant message prefill: если их нет, это другая ошибка 400, и её разбор — в конце статьи.
Параметра или бета-заголовка, который вернул бы prefill на этих моделях, в документации Anthropic нет. Остаётся либо переделать запрос, либо направить его на модель, которая prefill ещё принимает.
Какие модели Claude отклоняют prefill, а какие ещё принимают
По состоянию на 5 октября 2026 года документация Anthropic формулирует правило так: Claude 4.6 и более поздние модели, а также Claude Mythos Preview не поддерживают предзаполнение ответа.
| Модель | ID в Claude API | Запрос, который заканчивается ходом assistant |
|---|---|---|
| Claude Opus 5.5, Opus 5, Opus 4.8, Opus 4.7, Opus 4.6 | claude-opus-5-5, claude-opus-5, claude-opus-4-8, claude-opus-4-7, claude-opus-4-6 | 400 |
| Claude Sonnet 5.5, Sonnet 5, Sonnet 4.6 | claude-sonnet-5-5, claude-sonnet-5, claude-sonnet-4-6 | 400 |
| Claude Fable 5.1, Fable 5 (и Mythos 5.1 с теми же настройками) | claude-fable-5-1, claude-fable-5 | 400 |
| Claude Mythos Preview | claude-mythos-preview | 400 |
| Claude Sonnet 4.5, Haiku 4.5, Opus 4.5 и старше | claude-sonnet-4-5-20250929, claude-haiku-4-5-20251001, claude-opus-4-5-20251101 | принимается |
Источники: руководства по миграции на Opus 5.5, Sonnet 5.5 и Fable 5.1, а также справочник ошибок. Для Opus это изменение действует с версии 4.6: кто переходит на Opus 5.5 с Opus 4.6 или новее, уже живёт без prefill, а кто с Opus 4.5 — встретит ошибку впервые. Если вы выбираете между Opus 4.7 и 4.6 по другим причинам, сравнение версий есть в статье «Claude Opus 4.7 vs Claude Opus 4.6 в 2026 году: стоит ли обновляться уже сейчас»; для prefill разницы между ними нет.
Вернуться на Sonnet 4.5 или Haiku 4.5 — рабочая временная мера, если исправить код прямо сейчас нельзя. Но это откладывание, а не решение: перед переключением проверьте, что модель ещё есть в списке доступных у вашего провайдера, и всё равно планируйте замену prefill.
Чем заменить prefill: выбор по тому, для чего он был нужен
Универсальной замены нет: решает то, что делал ваш prefill. Руководство Anthropic по миграции на Sonnet 5.5 сводит это к пяти случаям.
| Для чего был prefill | Чем заменить |
|---|---|
Формат ответа: JSON начинался с {, ответ — с заданной структуры | Structured outputs: схема в output_config.format, для классификации — инструмент с полем enum |
| Без вступления: ответ начинался сразу с сути | В системном промпте попросить отвечать сразу, без вводных фраз |
| Против лишних отказов: начало ответа «подталкивало» модель | Обычно хватает чёткой инструкции в сообщении пользователя |
| Продолжение прерванного ответа | Перенести оборванный текст в сообщение user с просьбой продолжить |
| Напоминание контекста в конце диалога | Поставить напоминание в ход user |
Если prefill использовался в нескольких местах проекта, найти их помогает одна проверка: где массив messages может закончиться элементом с "role": "assistant". Помимо явных литералов, это сборка истории во вспомогательных функциях, повторы после таймаута и восстановление сессий. В Claude Code для этого есть встроенный навык Claude API: команда /claude-api migrate this project to claude-opus-5-5 (или другой целевой ID) меняет ID модели, ломающие параметры и prefill по всему проекту и выдаёт чек-лист для ручной проверки. Перед правкой файлов навык спрашивает, на какую часть проекта распространить миграцию.
Ниже — формы запросов из документации Anthropic. Код показан для Claude API; на других платформах меняется ID модели и, в случае Bedrock, набор доступных функций.
JSON без prefill: output_config.format вместо открывающей «{»
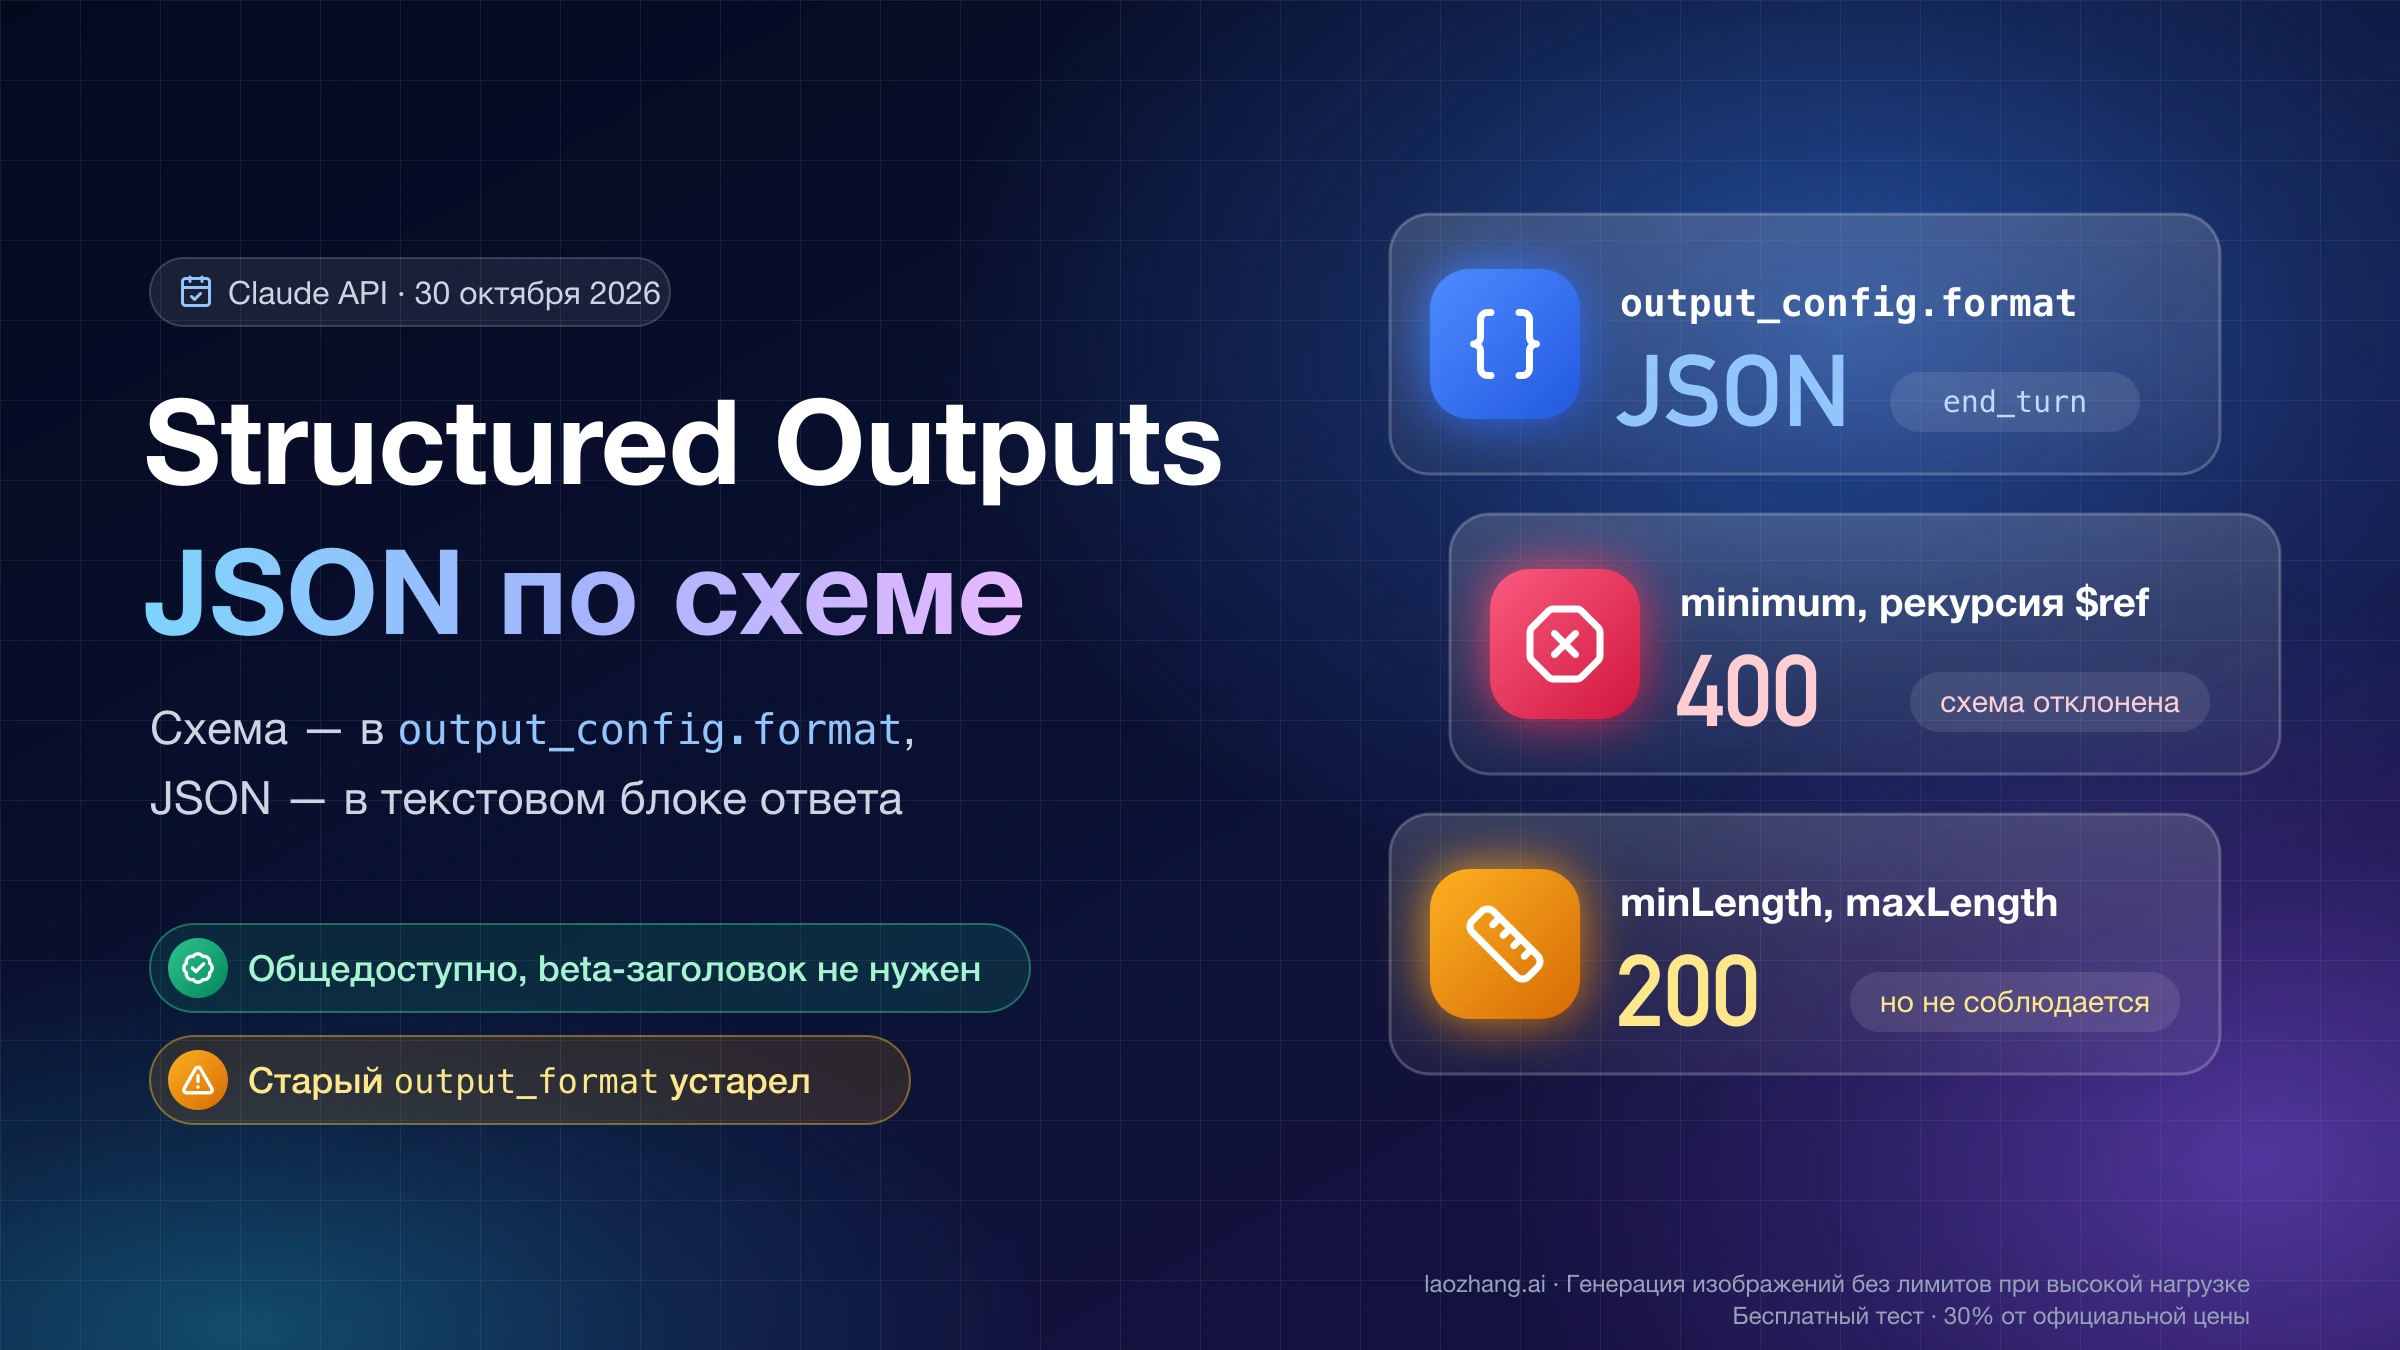
Если prefill начинал ответ с {, чтобы получить JSON, его место занимают structured outputs. Они решают ту же задачу надёжнее: модель генерирует ответ под ограничение схемы, и результат проходит JSON.parse() без повторов. Функция общедоступна (GA) в Claude API, Claude Platform on AWS, Google Cloud и Microsoft Foundry и работает на всех моделях, чьи ID перечислены в таблице выше, — и на тех, что prefill отклоняют, и на Sonnet 4.5, Haiku 4.5 и Opus 4.5.
Запрос с сырой JSON-схемой на Python:
import json
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "List the top 3 programming languages by popularity"}
    ],
    output_config={
        "format": {
            "type": "json_schema",
            "schema": {
                "type": "object",
                "properties": {
                    "languages": {
                        "type": "array",
                        "items": {
                            "type": "object",
                            "properties": {
                                "name": {"type": "string"},
                                "rank": {"type": "integer"},
                                "description": {"type": "string"},
                            },
                            "required": ["name", "rank", "description"],
                            "additionalProperties": False,
                        },
                    }
                },
                "required": ["languages"],
                "additionalProperties": False,
            },
        }
    },
)

# Ответ может начинаться с блоков thinking: берите блок по типу, а не content[0]
text = next(block.text for block in response.content if block.type == "text")
data = json.loads(text)
print(data["languages"][0]["name"])
Если вы описываете данные через Pydantic, удобнее client.messages.parse(): SDK сам строит схему, отправляет её в output_config.format, проверяет ответ и кладёт готовый объект в parsed_output.
from pydantic import BaseModel

class Language(BaseModel):
    name: str
    rank: int
    description: str

class LanguageList(BaseModel):
    languages: list[Language]

response = client.messages.parse(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "List the top 3 programming languages by popularity"}
    ],
    output_format=LanguageList,
)

for lang in response.parsed_output.languages:
    print(f"{lang.rank}. {lang.name}: {lang.description}")
На TypeScript схема Zod передаётся через zodOutputFormat(), а запрос идёт через client.messages.parse():
import Anthropic from "@anthropic-ai/sdk";
import { z } from "zod";
import { zodOutputFormat } from "@anthropic-ai/sdk/helpers/zod";

const client = new Anthropic();

const LanguageList = z.object({
  languages: z.array(
    z.object({
      name: z.string(),
      rank: z.number().int(),
      description: z.string(),
    })
  ),
});

const response = await client.messages.parse({
  model: "claude-opus-5-5",
  max_tokens: 1024,
  messages: [
    { role: "user", content: "List the top 3 programming languages by popularity" },
  ],
  output_config: { format: zodOutputFormat(LanguageList) },
});

console.log(response.parsed_output?.languages[0].name);
То же через cURL:
curl https://api.anthropic.com/v1/messages \
  -H "content-type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 1024,
    "messages": [
      {"role": "user", "content": "List 3 programming languages"}
    ],
    "output_config": {
      "format": {
        "type": "json_schema",
        "schema": {
          "type": "object",
          "properties": {
            "languages": {
              "type": "array",
              "items": {
                "type": "object",
                "properties": {
                  "name": {"type": "string"},
                  "rank": {"type": "integer"}
                },
                "required": ["name", "rank"],
                "additionalProperties": false
              }
            }
          },
          "required": ["languages"],
          "additionalProperties": false
        }
      }
    }
  }'
Что учесть при переходе на output_config.format:
- Старый параметр
output_formatустарел. На уровне запроса он работает только с бета-заголовкомstructured-outputs-2025-11-13, без него API возвращает 400. Python SDK версии 1.0 и новее не принимаетoutput_format={...}вclient.beta.messages.create()и выбрасываетTypeError. Переносите схему вoutput_config.format. Аргументoutput_formatуclient.messages.parse()— другое дело: это штатный способ передать класс Pydantic. - Несовместимость. JSON outputs нельзя сочетать с цитированием (citations): запрос вернёт 400. С предзаполнением они тоже несовместимы, так что prefill нужно убрать в любом случае.
- Схема. У каждого объекта ставьте
"additionalProperties": false; другие значения этого поля не поддерживаются. Ограничения вродеminimumиmaxLengthAPI не принимает, а SDK-помощники переносят их в описание поля и сами проверяют ответ. - Первый запрос медленнее. Схема компилируется в грамматику при первом использовании, потом кешируется на 24 часа с момента последнего обращения.
- Схема не гарантирована в двух случаях. При
stop_reason: "refusal"(отказ по соображениям безопасности, ответ 200) и приstop_reason: "max_tokens"(ответ обрезан). На Opus 5.5 мышление включено всегда, иmax_tokensпокрывает и его, и текст, поэтому запас нужен больше, чем был без мышления.
Классификация и вызов функций: strict: true без принудительного tool_choice
Если prefill подставлял начало вызова функции или метку класса, замена — инструмент со строгой схемой. С strict: true имя и входные данные инструмента проверяются по схеме, а для классификации достаточно поля enum.
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "What's the weather in Tokyo? Use the get_weather tool."}
    ],
    tools=[
        {
            "name": "get_weather",
            "description": "Get current weather for a city",
            "strict": True,
            "input_schema": {
                "type": "object",
                "properties": {
                    "city": {"type": "string", "description": "City name"},
                    "units": {"type": "string", "enum": ["celsius", "fahrenheit"]},
                },
                "required": ["city", "units"],
                "additionalProperties": False,
            },
        }
    ],
)

for block in response.content:
    if block.type == "tool_use":
        print(block.name, block.input)
Здесь есть ловушка для тех, кто переходит на новейшие модели. Sonnet 5.5, Opus 5.5 и Fable 5.1 отклоняют принудительный выбор инструмента: tool_choice с типом any или tool даёт свою ошибку 400 (более ранние модели, от 4.6 до Opus 5 и Sonnet 5, его ещё принимают). Поэтому «заставить модель вызвать инструмент» на этих трёх моделях не годится как замена prefill. Допустимы только {"type": "auto"} (по умолчанию) и {"type": "none"}. При auto модель может ответить и без вызова, поэтому в промпте прямо скажите, когда вызывать инструмент. JSON outputs и строгие инструменты можно использовать в одном запросе: первое для текста ответа, второе для параметров функций.
У строгой схемы есть ограничение на регистр: значения enum и const могут вернуться с другой заглавной буквой. Сравнивайте их без учёта регистра и не заводите значения, которые различаются только регистром.
Без вступления, против отказов, напоминания: системный промпт и ход user
Когда prefill задавал не формат данных, а манеру ответа, схема не нужна. Начало ответа переезжает в инструкцию.
Было (400 на новых моделях):
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "Analyze this code for bugs"},
        {"role": "assistant", "content": "## Bug Analysis\n\n"},
    ],
)
Стало:
response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=1024,
    system=(
        "You are a code review assistant. Answer directly, without a preamble. "
        "Always start with a '## Bug Analysis' heading, then list each bug "
        "with its severity and a suggested fix."
    ),
    messages=[
        {"role": "user", "content": "Analyze this code for bugs"},
    ],
)
Гарантии, как у схемы, здесь нет: это инструкция, а не ограничение генерации. Если структура ответа критична для парсера, используйте output_config.format. Если важно лишь, чтобы ответ начинался по делу, системного промпта обычно хватает.
Два других случая решаются в сообщении пользователя. Против лишних отказов документация советует ясно сформулировать задачу и контекст в самом запросе user — подталкивание через начало ответа для этого не требуется. Напоминание контекста («отвечай по-русски», «учитывай ограничения из первого сообщения»), которое раньше стояло в конце как ход assistant, переносится в последний ход user.
Продолжение прерванного ответа: перенесите текст в сообщение user
Раньше оборванный ответ продолжали так: отправляли его же последним ходом assistant, и модель дописывала с места обрыва. На моделях 4.6+ это ровно та ошибка 400. Документация Anthropic предлагает перенести обрывок в сообщение пользователя с такой просьбой:
Your previous response was interrupted and ended with [previous_response]. Continue from where you left off.Вместо [previous_response] подставляется сам оборванный текст. Модель допишет ответ, но склеивать фрагменты придётся вам: новый ответ начинается как отдельное сообщение, а не как продолжение строки.
Claude в Amazon Bedrock: где structured outputs нет
На Bedrock замена prefill зависит от того, какой интеграцией вы пользуетесь. Structured outputs (и JSON outputs, и строгие инструменты) доступны в старой интеграции Amazon Bedrock для Opus 4.6, Sonnet 4.6, Sonnet 4.5, Opus 4.5 и Haiku 4.5. В новой интеграции Claude in Amazon Bedrock их нет; руководство по Sonnet 5.5 отдельно отмечает это и для Sonnet 5.5.
Там prefill заменяют без схем. Для формата и манеры ответа — инструкции в системном промпте и в сообщении пользователя. Для структурированных данных — инструмент с tool_choice: {"type": "auto"} без strict, указание в промпте, когда его вызывать, и проверка входных данных инструмента в вашем коде. Перед тем как полагаться на конкретную модель, сверьтесь с текущей документацией Bedrock: список функций по моделям там меняется.
Ошибка prefill в агенте или роутере: две частые причины
Если вы не писали prefill сами, а ошибка пришла из SDK, агентного фреймворка или роутера, в публичных отчётах повторяются две причины.
Продолжение или fallback через prefill. Механизм восстановления после обрыва стрима дописывает частичный ответ в историю ходом assistant и повторяет запрос. В LiteLLM так работал mid-stream fallback: на Sonnet 4.6 и Opus 4.6+ каждый переход по цепочке fallback заканчивался той же 400, и восстановимый таймаут превращался в отказ всей цепочки. PR #30242 в LiteLLM (открыт 11 июня 2026 года, на 5 октября 2026 года не влит) переводит такие модели на продолжение через сообщение user и помечает Sonnet 4.6 как supports_assistant_prefill: false. Авторы PR связывают с той же причиной отчёты в livekit/agents, crewAI и agno. В Dyad аналогичную ошибку исправил PR #3027 (влит 23 марта 2026 года): повтор с продолжением теперь отправляет частичный ответ в сообщении пользователя.
Пустой ход assistant в конце истории. Клиент сохраняет в историю пустой или прерванный ход assistant и затем отправляет запрос без нового ввода пользователя. В OpenClaw (исправление #69268, закрыто 1 мая 2026 года) такие хвостовые пустые ходы стали отбрасывать перед отправкой, а запрос без свежего ввода пользователя — не отправлять вовсе. В обсуждении opencode #13768 участник нашёл похожую картину в режиме opencode web: после ответа уходил второй, пустой ход assistant.
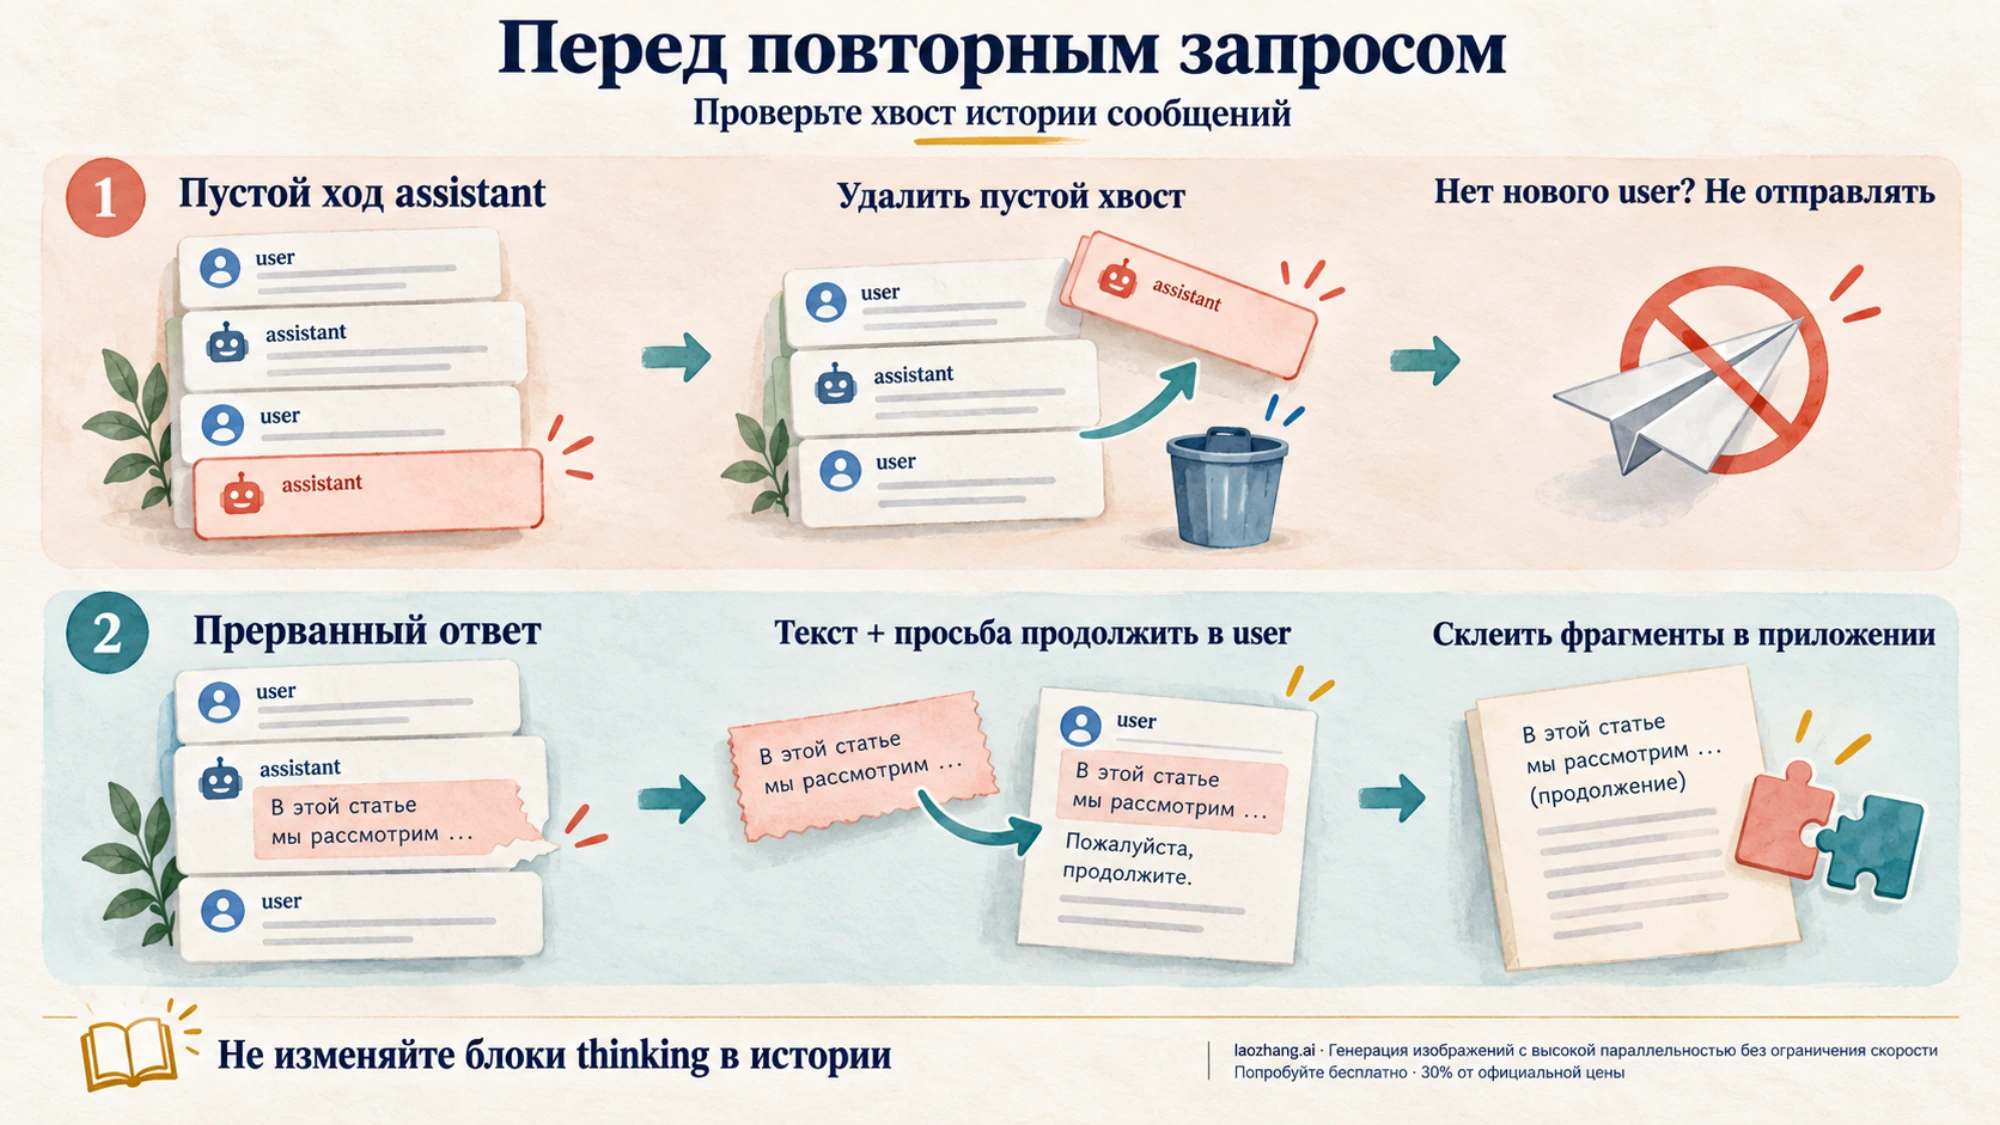
Обе причины закрывает одна проверка перед каждым вызовом API. Пример на Python для истории в формате Messages API:
CONTINUE_NOTE = (
    "Your previous response was interrupted and ended with:\n\n{partial}\n\n"
    "Continue from where you left off."
)


def _text_of(message):
    content = message["content"]
    if isinstance(content, str):
        return content
    return "".join(b.get("text", "") for b in content if b.get("type") == "text")


def _is_empty(message):
    content = message["content"]
    if isinstance(content, str):
        return not content.strip()
    return all(b.get("type") == "text" and not b.get("text", "").strip() for b in content)


def prepare_messages(messages, continue_partial=False):
    """Гарантирует, что запрос заканчивается ходом user, или возвращает None."""
    messages = list(messages)

    # 1. Пустые и прерванные ходы assistant в хвосте просто отбрасываем
    while messages and messages[-1]["role"] == "assistant" and _is_empty(messages[-1]):
        messages.pop()

    if not messages or messages[-1]["role"] == "user":
        return messages

    # 2. В хвосте остался непустой ход assistant
    if not continue_partial:
        return None  # нового ввода пользователя нет: запрос не отправляем

    partial = _text_of(messages.pop())
    note = {"type": "text", "text": CONTINUE_NOTE.format(partial=partial)}

    # 3. Просьбу продолжить добавляем к последнему ходу user или новым ходом user
    if messages and messages[-1]["role"] == "user":
        last = messages[-1]
        blocks = last["content"] if isinstance(last["content"], list) else [
            {"type": "text", "text": last["content"]}
        ]
        messages[-1] = {"role": "user", "content": blocks + [note]}
    else:
        messages.append({"role": "user", "content": [note]})
    return messages
Ход assistant здесь удаляется целиком, а не правится: отредактированные или частично выброшенные блоки thinking в последнем ходе assistant дают другую ошибку 400. Продолжение через сообщение user годится и для моделей, которые prefill ещё принимают, так что держать в коде список моделей не обязательно.
Copilot, opencode, LibreChat: что делать, если код менять нельзя
Сообщение This model does not support assistant message prefill встречается и у тех, кто не пишет запросы сам. Публичные отчёты есть о GitHub Copilot в Visual Studio, opencode (в том числе с Copilot как провайдером), Google Antigravity (форум Google AI, 29 марта 2026 года), Databricks Foundation Model API (11 мая 2026 года), агентах LibreChat (19 мая 2026 года) и OpenHands с claude-opus-5-5 (сентябрь 2026 года). В opencode #13768 последний комментарий от 2 октября 2026 года сообщает, что ошибка сохраняется и на Opus 5.5.
Исправить запрос в таком случае может только разработчик инструмента. Пользователю остаётся вот что:
- Обновить инструмент. Исправления вроде отбрасывания пустых ходов выходят в обычных релизах, и после обновления ошибка может исчезнуть.
- Начать новый диалог. Если сломанный хвост уже записан в историю сессии, повторы в той же сессии будут натыкаться на него снова.
- Сменить модель в настройках инструмента. Подойдёт модель, которая принимает prefill (Sonnet 4.5, Haiku 4.5), если инструмент её ещё предлагает, или модель другого поставщика. В обсуждении opencode пользователи писали, что ответ «continue» или «proceed» помогал не всегда, а надёжнее было переключиться на другую модель и обратно.
- Сообщить разработчику. Приложите текст ошибки, модель, режим работы (например, web или терминал) и экспорт сессии или
request-idиз заголовков ответа, если инструмент их показывает.
Другие ошибки 400 Claude, похожие на prefill
Все они приходят как 400 invalid_request_error, поэтому отличать их нужно по тексту сообщения.
| Фрагмент сообщения | Причина | Что делать |
|---|---|---|
does not support assistant message prefill | Запрос заканчивается ходом assistant | Замена по назначению, см. разделы выше |
blocks in the latest assistant message cannot be modified | Блоки мышления в последнем ходе assistant изменены, переставлены или отфильтрованы | Возвращать ход assistant таким, каким он пришёл |
"thinking.type.enabled" is not supported for this model | Ручной бюджет мышления на Claude 4.7 и новее | Перейти на thinking: {"type": "adaptive"} и output_config.effort |
tool_choice: type "tool" and "any" are not supported for this model | Принудительный выбор инструмента на новейших моделях | tool_choice: {"type": "auto"} и инструкция в промпте |
Сообщение про temperature или top_p | Параметры сэмплирования на Opus 4.7 и новее | См. разбор temperature в Opus 4.7 и разбор top_p в Claude Code |
Сообщение про tool_use без tool_result | В истории вызов инструмента без ответа на него в следующем ходе user | Добавить tool_result с тем же tool_use_id |
400 при output_format или при citations вместе с output_config.format | Устаревший параметр или несовместимые функции | См. раздел про output_config.format выше |
Если Claude вызывается через Amazon Bedrock, разбор ошибок 400 по тексту сообщения есть в статье «Claude в AWS Bedrock отвечает 400: причина по тексту ошибки». Код 500 вместо 400 означает сбой на стороне API, а не ошибку в запросе: о повторах и обращении в поддержку — в статье «Ошибка 500 в Claude API: повторы, request_id и обращение в поддержку».
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 5 окт. 2026 г..
Источники4
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 5 окт. 2026 г..