Qwen3.8 Flash-Next vs 27B: 로컬에서는 무엇을 실행할까
한 대의 시스템에 안정적으로 맞추려면 27B부터, 큰 메모리와 복잡한 코딩·에이전트 작업의 완료율이 더 중요하면 Flash-Next를 동일 작업으로 테스트하세요.
목차
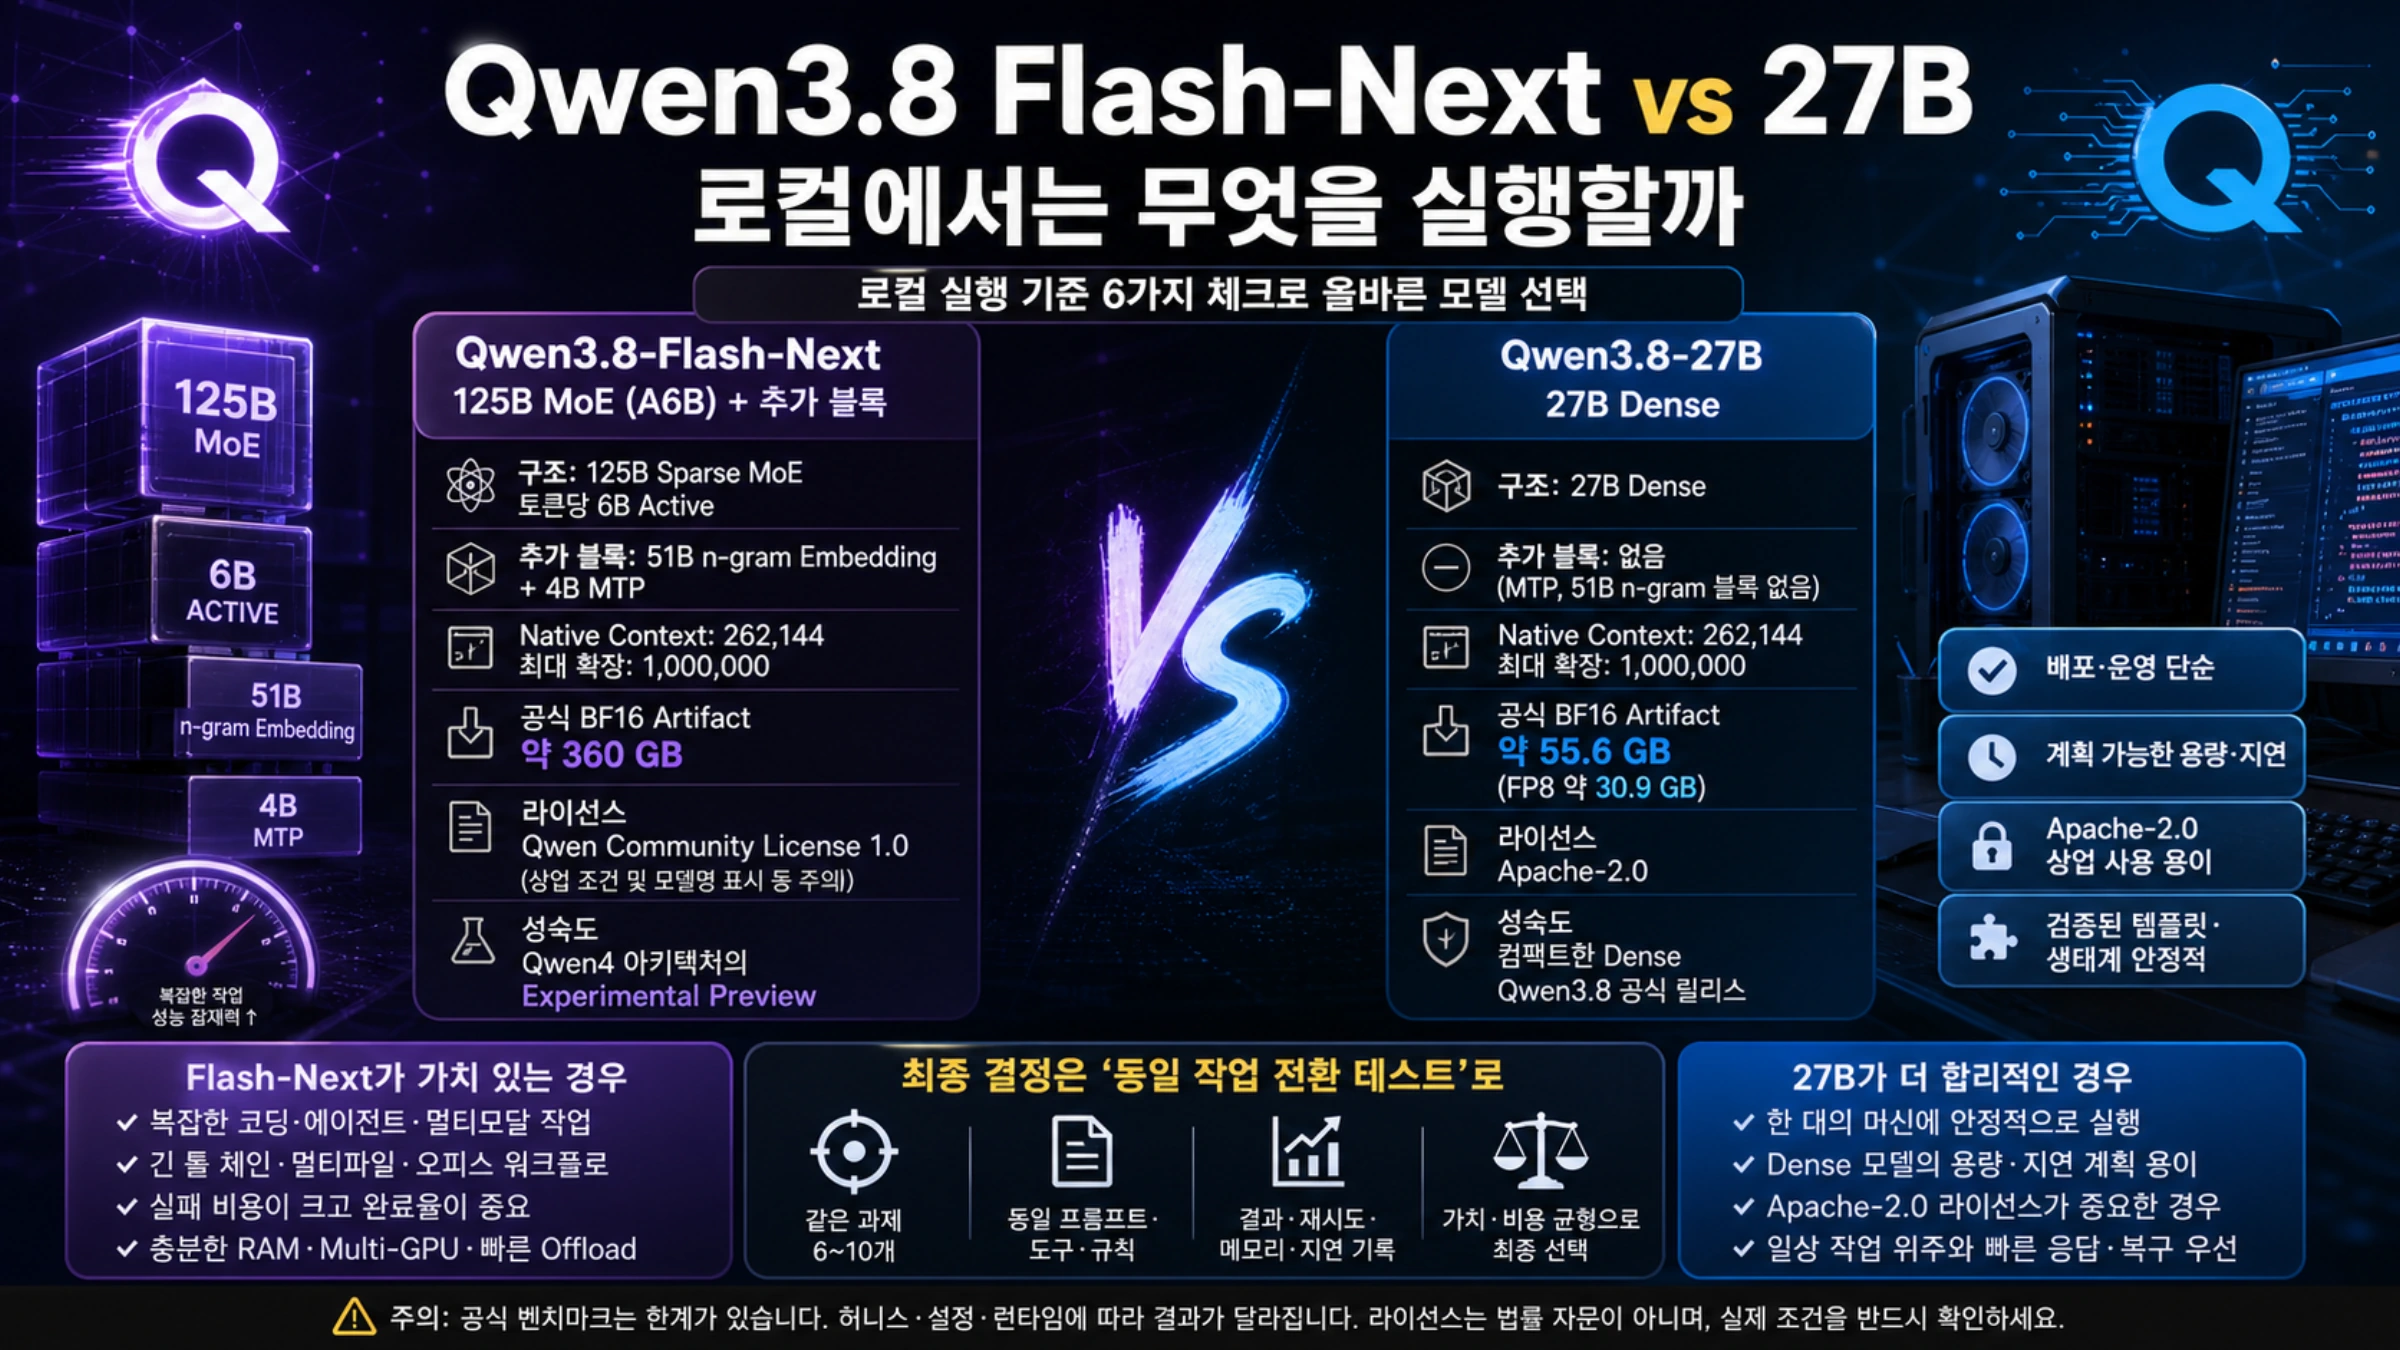
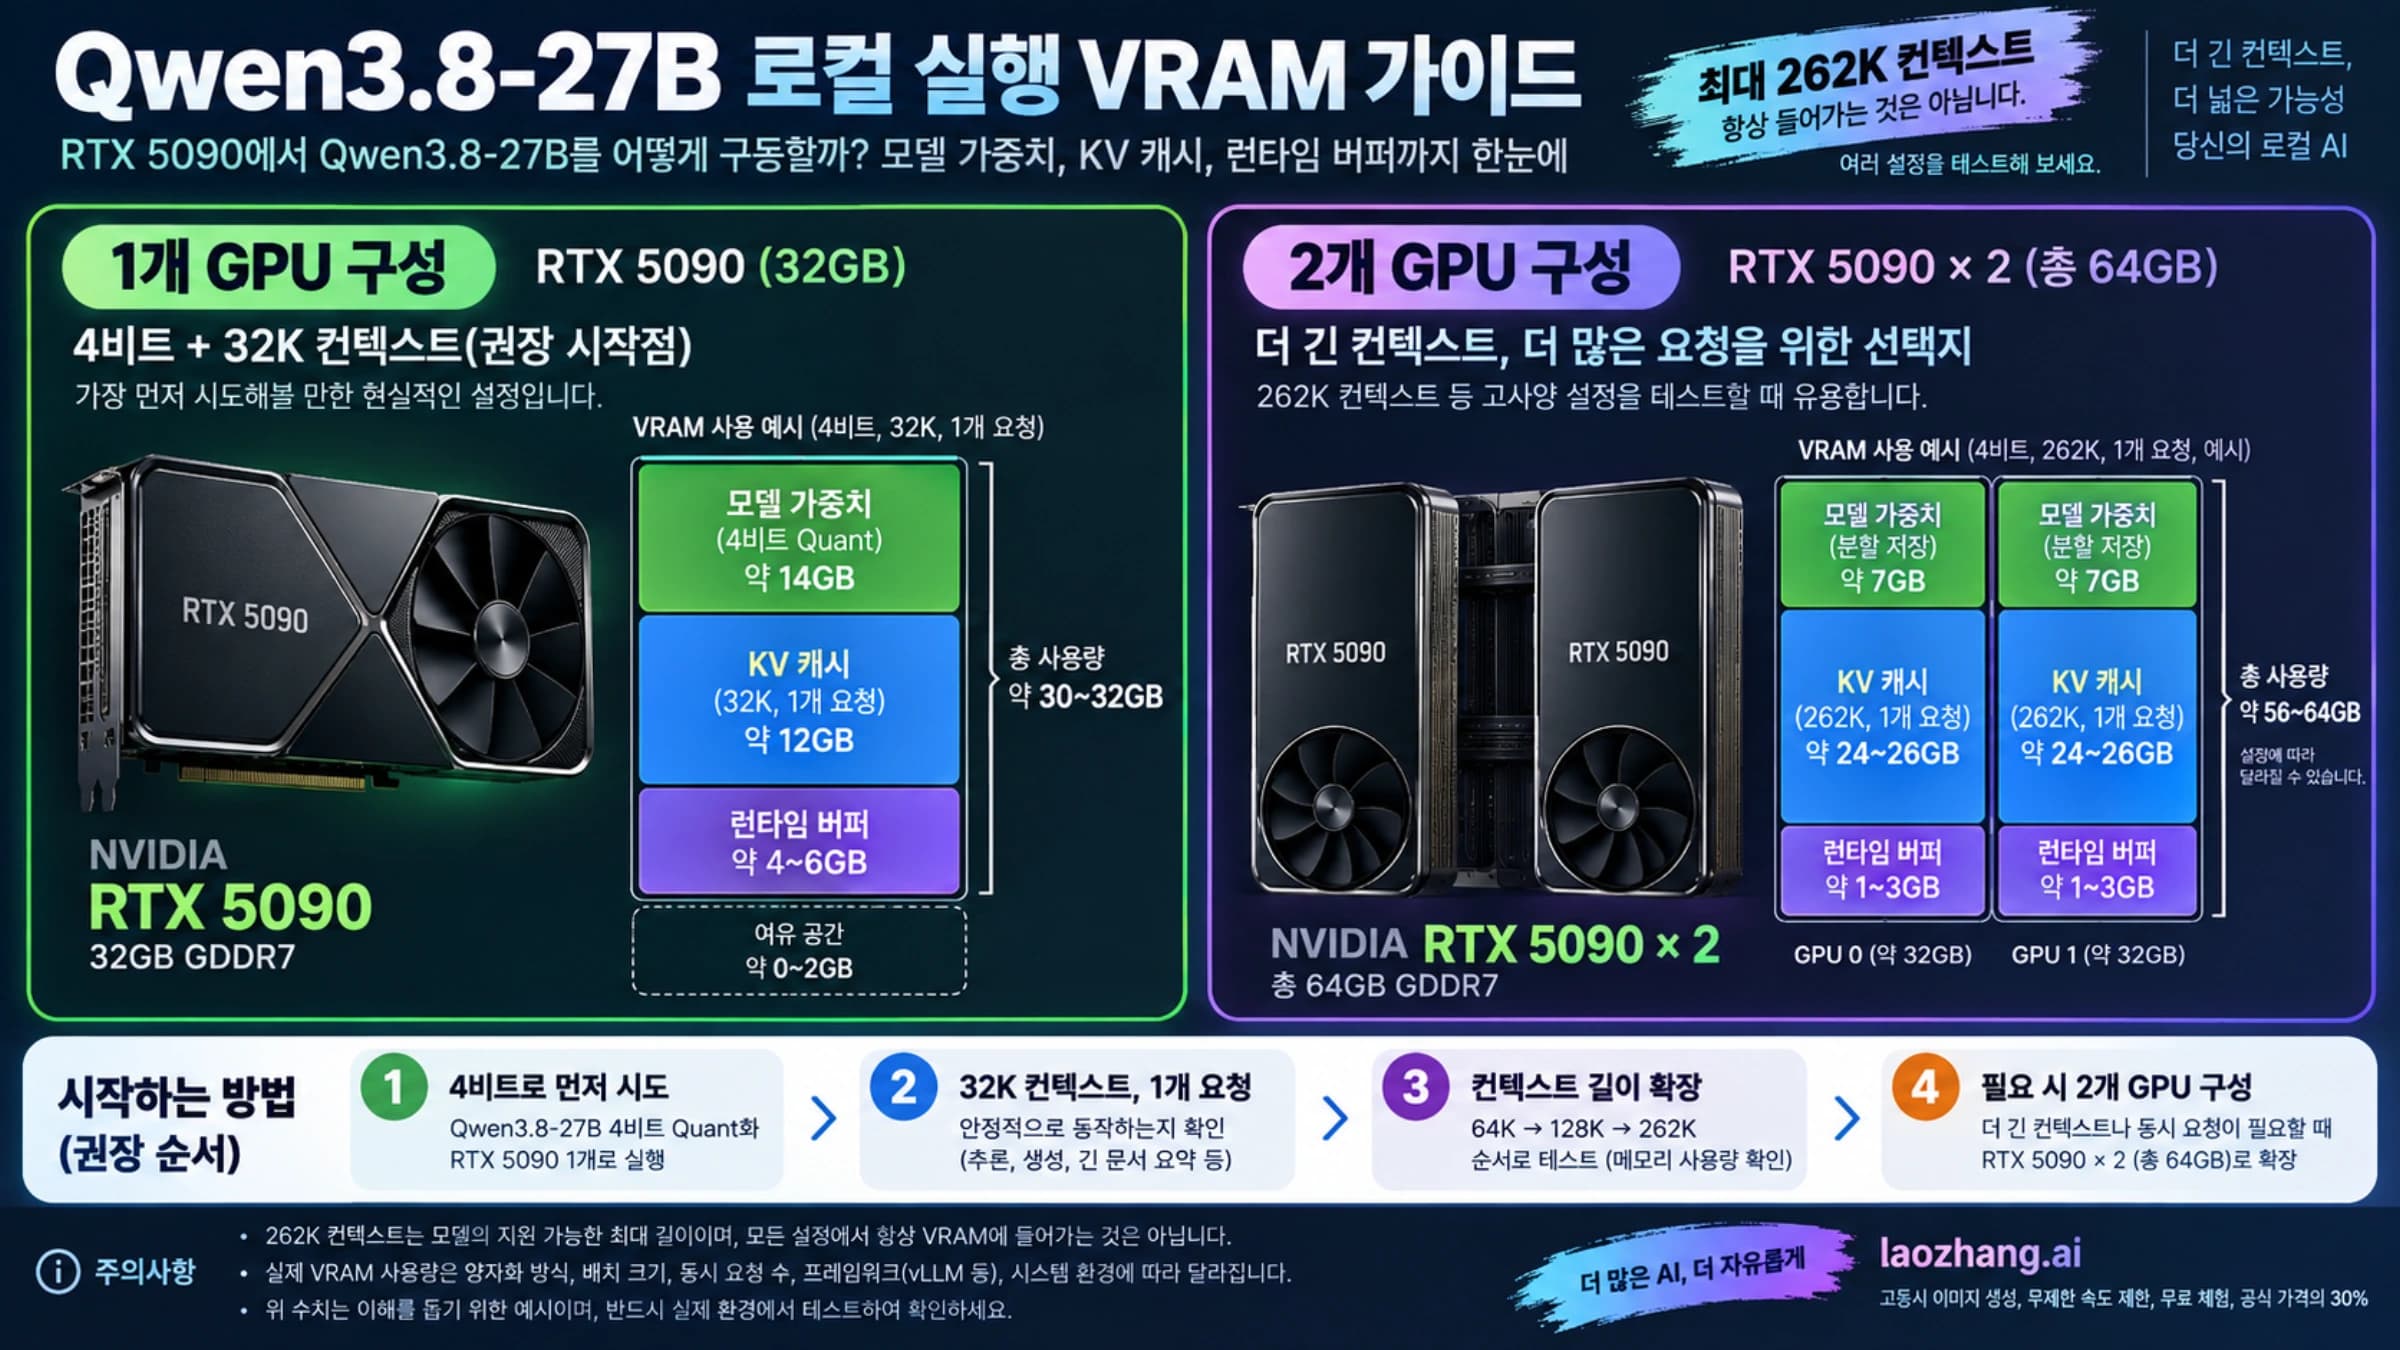
일반적인 단일 워크스테이션이라면 Qwen3.8-27B를 먼저 실행하는 편이 안전합니다. 27B 밀집 모델이고, 공식 BF16 저장소는 약 55.6 GB, 공식 FP8 저장소는 30.9 GB입니다. 기본 저장소는 Apache-2.0으로 표시됩니다. 모델이 실제 메모리에 들어가는지 판단하기 쉽고, 추론 서비스 구성도 단순합니다.
Qwen3.8-Flash-Next는 복잡한 작업에서 성능 개선을 기대하며 시험할 후보입니다. 이름의 Flash나 A6B가 작은 모델을 뜻하지 않습니다. 공식 모델 카드에는 125B 희소 MoE, 토큰당 6B 활성화, 별도로 51B n-gram 임베딩과 4B MTP가 적혀 있습니다. 확인한 공식 BF16 버전은 약 360 GB였습니다. 활성 파라미터는 계산 경로이지 다운로드 크기나 상주 가중치가 아닙니다.
따라서 선택 기준은 명확합니다. 하드웨어 적합성, 단순한 밀집 모델 운영, 익숙한 라이선스가 우선이면 27B입니다. 충분한 RAM·다중 GPU·빠른 오프로딩이 있고 복잡한 작업의 실패 비용이 크다면 Flash-Next를 테스트합니다. 공식 순위만 보고 기본 모델을 바꾸지는 않습니다.
먼저 잘못된 크기 비교를 없애기
| 항목 | Qwen3.8-Flash-Next | Qwen3.8-27B |
|---|---|---|
| 구조 | 125B 희소 MoE, 6B 활성화 | 27B 밀집 모델 |
| 추가 매개변수 구성 | 51B n-gram 임베딩, 4B MTP | MTP, 51B n-gram 블록은 없음 |
| 기본 컨텍스트 길이 | 262,144 | 262,144 |
| 공식 BF16 파일 | 확인한 버전 약 360 GB | 약 55.6 GB |
| 공식 FP8 파일 | 현재 공개된 정확한 버전 확인 | 30.9 GB |
| 라이선스 | Qwen Community License 1.0 | Apache-2.0 |
| 성숙도 | Qwen4 아키텍처의 실험적 미리보기 | 작고 안정적인 Qwen3.8 밀집 모델 |
근거는 Flash-Next 공식 모델 카드와 27B 공식 모델 카드입니다. 두 카드 모두 기본 262,144토큰 컨텍스트와 최대 100만 토큰으로 확장하는 방법를 설명합니다. 하지만 1M을 설정할 수 있다는 사실은 해당 하드웨어에서 실용적인 지연과 메모리를 보장하지 않습니다.
실제 최대 RAM/VRAM에는 가중치 외에 KV 캐시, 이미지 입력, 추론 환경의 관리 영역, 배치, 동시 요청이 들어갑니다. 양자화는 크기를 줄이지만 품질과 커널 호환성도 바꿉니다. CPU 오프로딩에서는 메모리 대역폭이 병목이 될 수 있습니다. 그래서 “필요 VRAM은 몇 GB”라는 답에는 모델 ID, 양자화, 문맥 길이, 추론 환경이 반드시 따라야 합니다.
Qwen의 공식 점수는 어디까지 믿을까
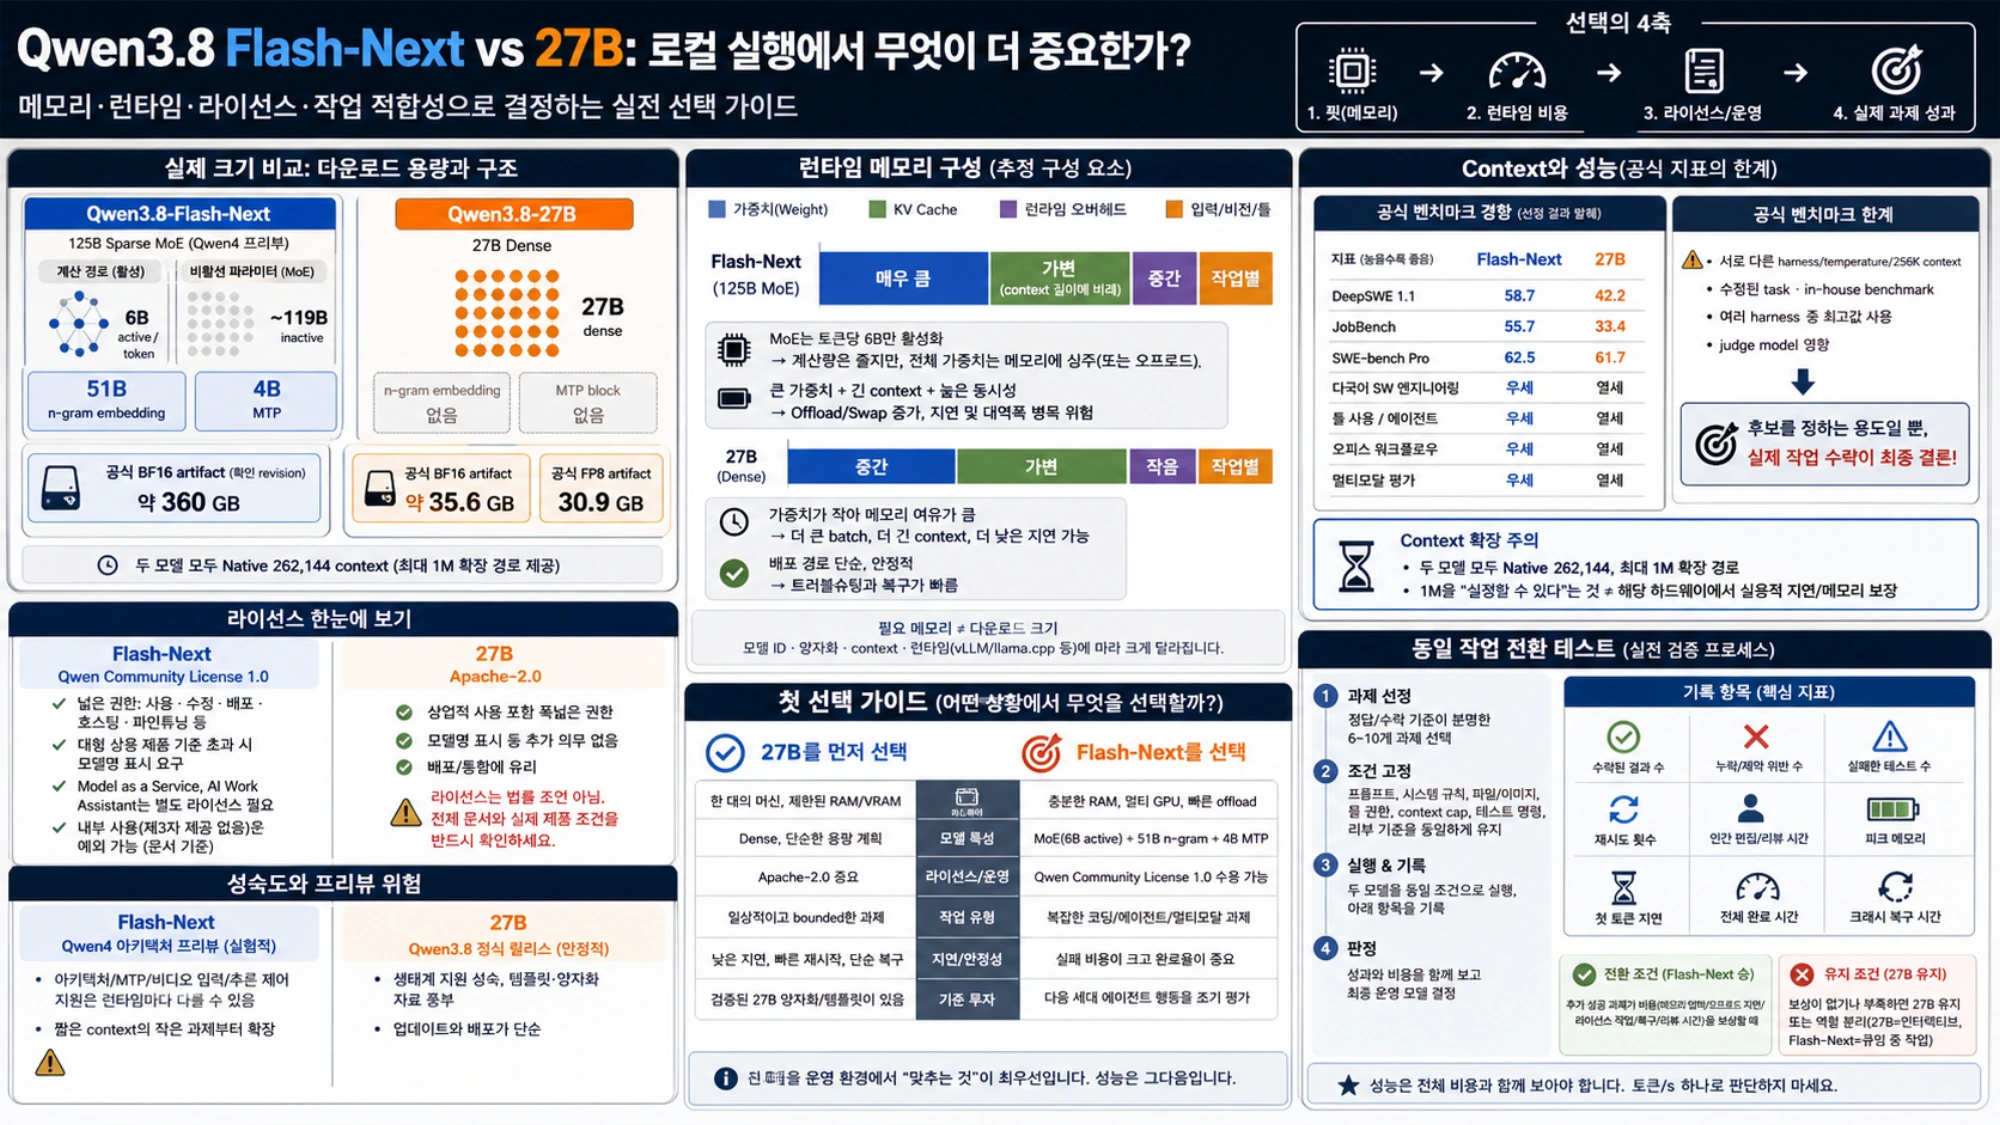
Qwen이 공개한 동일 표에서는 Flash-Next가 대부분의 항목에서 앞섭니다. DeepSWE 1.1은 58.7 대 42.2, JobBench는 55.7 대 33.4입니다. 반면 SWE-bench Pro는 62.5 대 61.7로 차이가 작습니다. 다국어 소프트웨어 개발, 도구 사용, 사무 작업, 여러 다중모달 평가에서도 Flash-Next가 높습니다.
이 결과는 복잡한 에이전트·코딩 작업에서 Flash-Next를 먼저 테스트할 이유가 됩니다. 그러나 모든 상황의 승자를 증명하지는 않습니다. 공식 평가 주석에는 서로 다른 평가 틀, 온도, 256K 문맥 길이, 수정된 과제, 자체 평가, 판정 모델이 기록되어 있습니다. 일부 항목은 여러 평가 틀 중 가장 높은 값을 사용합니다.
로컬에서는 GGUF/FP8 빌드, 프롬프트 템플릿, 추론 환경 버전, 도구 연동과 오프로딩이 결과를 바꿉니다. 제조사 평가는 후보를 정하고, 실제로 통과한 작업이 결론을 정합니다.
27B가 더 좋은 상황
다음 조건에서는 27B가 합리적입니다.
- 많은 부분을 CPU로 옮기지 않고 한 대의 컴퓨터에서 실행하고 싶다.
- 밀집 모델의 용량과 지연을 쉽게 계획하고 싶다.
- 배포·재배포·상업 검토에서 Apache-2.0이 중요하다.
- 범위가 명확한 일상 작업이 많아 공식 평가 차이가 합격 여부를 바꾸지 않는다.
- 대화형 작업의 짧은 대기 시간, 빠른 재시작과 간단한 장애 복구가 중요하다.
- 이미 검증한 27B 양자화 파일과 템플릿이 있어 변수를 한꺼번에 바꾸고 싶지 않다.
27B는 약한 대체안이 아닙니다. Qwen은 이를 코딩, 연구, 전문 업무, 장시간 에이전트 처리를 위한 처음부터 이미지와 텍스트를 함께 처리하도록 설계된 모델로 설명합니다. 공식 표에서도 일부 핵심 항목의 차이는 작습니다. Flash-Next를 심하게 압축하고 오프로딩해야 하는 반면 27B를 더 높은 정밀도로 안정 실행할 수 있다면 27B의 전체 완료 시간이 더 좋을 수 있습니다.
Flash-Next가 비용을 회수하는 작업
Flash-Next는 한 번의 누락이 큰 재작업으로 이어지는 업무에서 가치가 있습니다. 여러 파일의 코드 수정, 긴 도구 연쇄, 애플리케이션 재현, 복잡한 사무 자동화, 다국어 소프트웨어 개발, 다중모달 에이전트가 대표적입니다.
Qwen은 Qwen Sparse Attention, Gated Residual, n-gram Embedding, 새로운 학습 방법을 Qwen4 방향의 아키텍처 미리보기로 제시합니다. 다음 세대 에이전트의 동작을 일찍 평가하려는 팀에는 그 자체가 의미가 있습니다.
미리보기 모델이라는 점은 운영 위험이기도 합니다. vLLM, SGLang, TokenSpeed, llama.cpp 등이 새 아키텍처, MTP, 동영상 입력, 추론 제어를 같은 시점과 방식으로 지원하지 않을 수 있습니다. 정확한 추론 환경 버전을 확인하고 짧은 문맥의 작은 작업부터 확장해야 합니다.
라이선스는 성능 평가 이전에 확인한다
Flash-Next는 Qwen Community License 1.0을 사용합니다. 사용, 수정, 배포, 호스팅, 미세 조정 등에 넓은 권리를 부여하지만 상업적 이용에는 조건이 있습니다. 월간 활성 사용자 수나 월 매출이 정해진 기준을 넘는 대형 상용 제품은 모델명을 표시해야 합니다. 라이선스가 정의하는 상업용 Model as a Service와 AI Work Assistant 사업은 Qwen의 별도 라이선스가 필요합니다. 모델, 출력, 기능을 제3자에게 제공하지 않는 내부 사용에는 문서상 예외가 있습니다.
27B의 공식 저장소는 Apache-2.0입니다. 모델 API, 코딩 도우미, 사무 도우미를 만들 계획이라면 제품에 통합하기 전에 해당 라이선스 조건을 검토해야 합니다. 이는 법률 조언이 아니며, 현재 전체 문서와 실제 제품 조건을 담당자가 확인해야 합니다.
로컬 Flash-Next와 호스팅 Flash는 다르다
이 비교의 로컬 ID는 Qwen/Qwen3.8-Flash-Next입니다. Qwen Cloud의 qwen3.8-flash는 Flash-Next 기반 호스팅 서비스로, 기본 1M 문맥 길이, 내장 도구, 서비스 가격, 속도 제한과 제공 범위를 가집니다. 직접 운영하는 가중치와 같은 비용·기능·SLA가 아닙니다.
큰 가중치 운영이 부담이면 호스팅 모델을 별도 대안으로 평가할 수 있습니다. 개인정보 보호, 가중치 제어, 자체 양자화가 목적이면 직접 운영 비교를 유지합니다. API 가격을 로컬 비용으로 쓰거나 커뮤니티 양자화 결과를 공식 API 결과처럼 쓰면 안 됩니다.
동일 작업 전환 테스트
정답이나 합격 기준이 분명한 실제 작업 6~10개를 고릅니다. 프롬프트, 시스템 규칙, 파일, 이미지, 도구 권한, 문맥 상한, 잘라내기 방식, 테스트 명령, 사람의 평가 기준을 동일하게 유지합니다.
각 모델에 대해 합격한 결과, 놓친 제약, 근거 없는 주장, 실패한 테스트, 재시도 수, 사람의 수정량, 최대 메모리, 첫 토큰 지연, 전체 완료 시간, 장애 복구를 기록합니다. 초당 토큰 수 하나만 비교하면 평가 비용과 반복 실패를 놓칩니다.
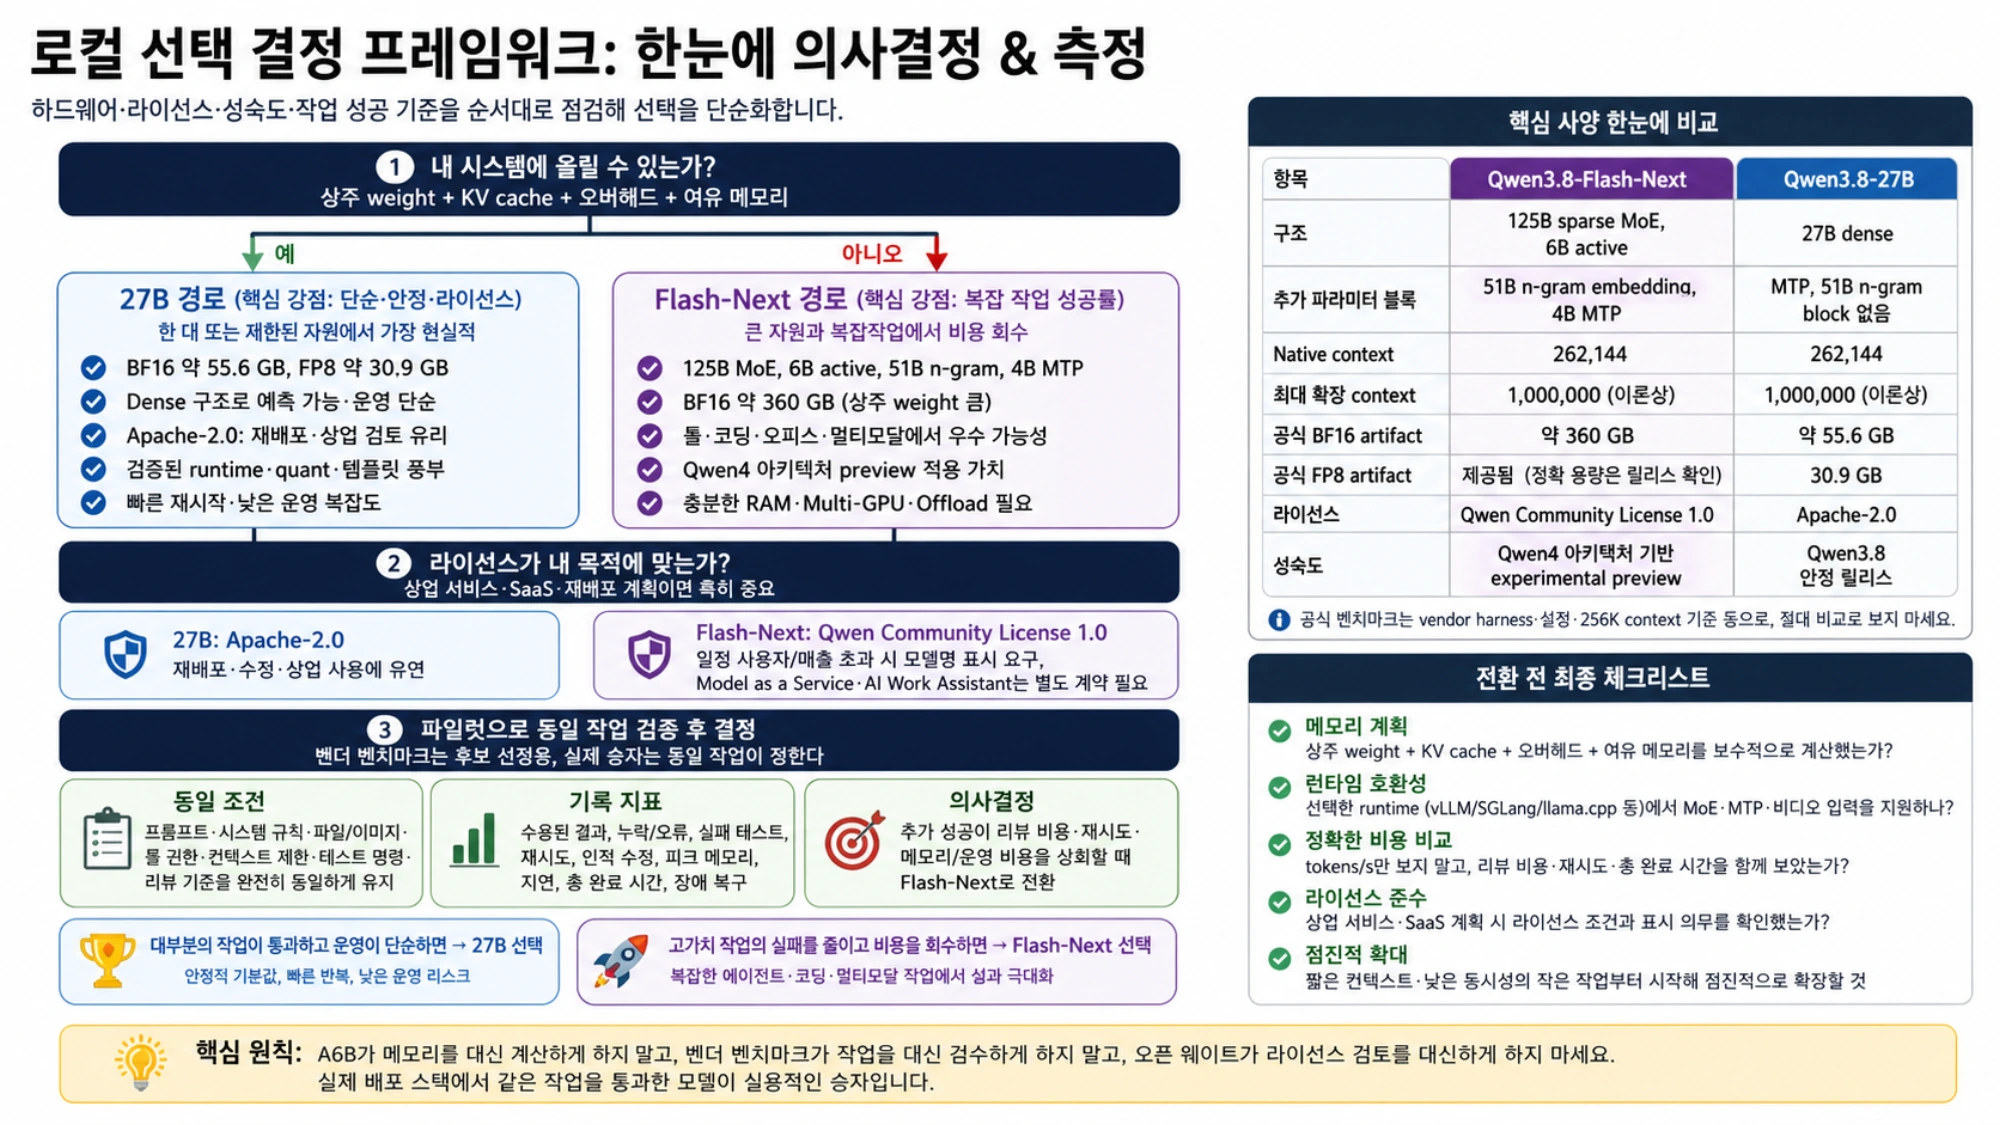
Flash-Next가 추가로 성공한 작업이 메모리 압박, 오프로딩 지연, 라이선스 검토, 복구와 사람의 평가 시간을 보상하지 못하면 27B를 유지합니다. 높은 가치의 작업에서 재시도를 꾸준히 줄이고 기반 시설 예산에 들어오면 Flash-Next 사용을 확대합니다. 27B를 대화형 기본 모델로, Flash-Next를 대기열의 무거운 작업용으로 분리하는 것도 좋은 결과입니다.
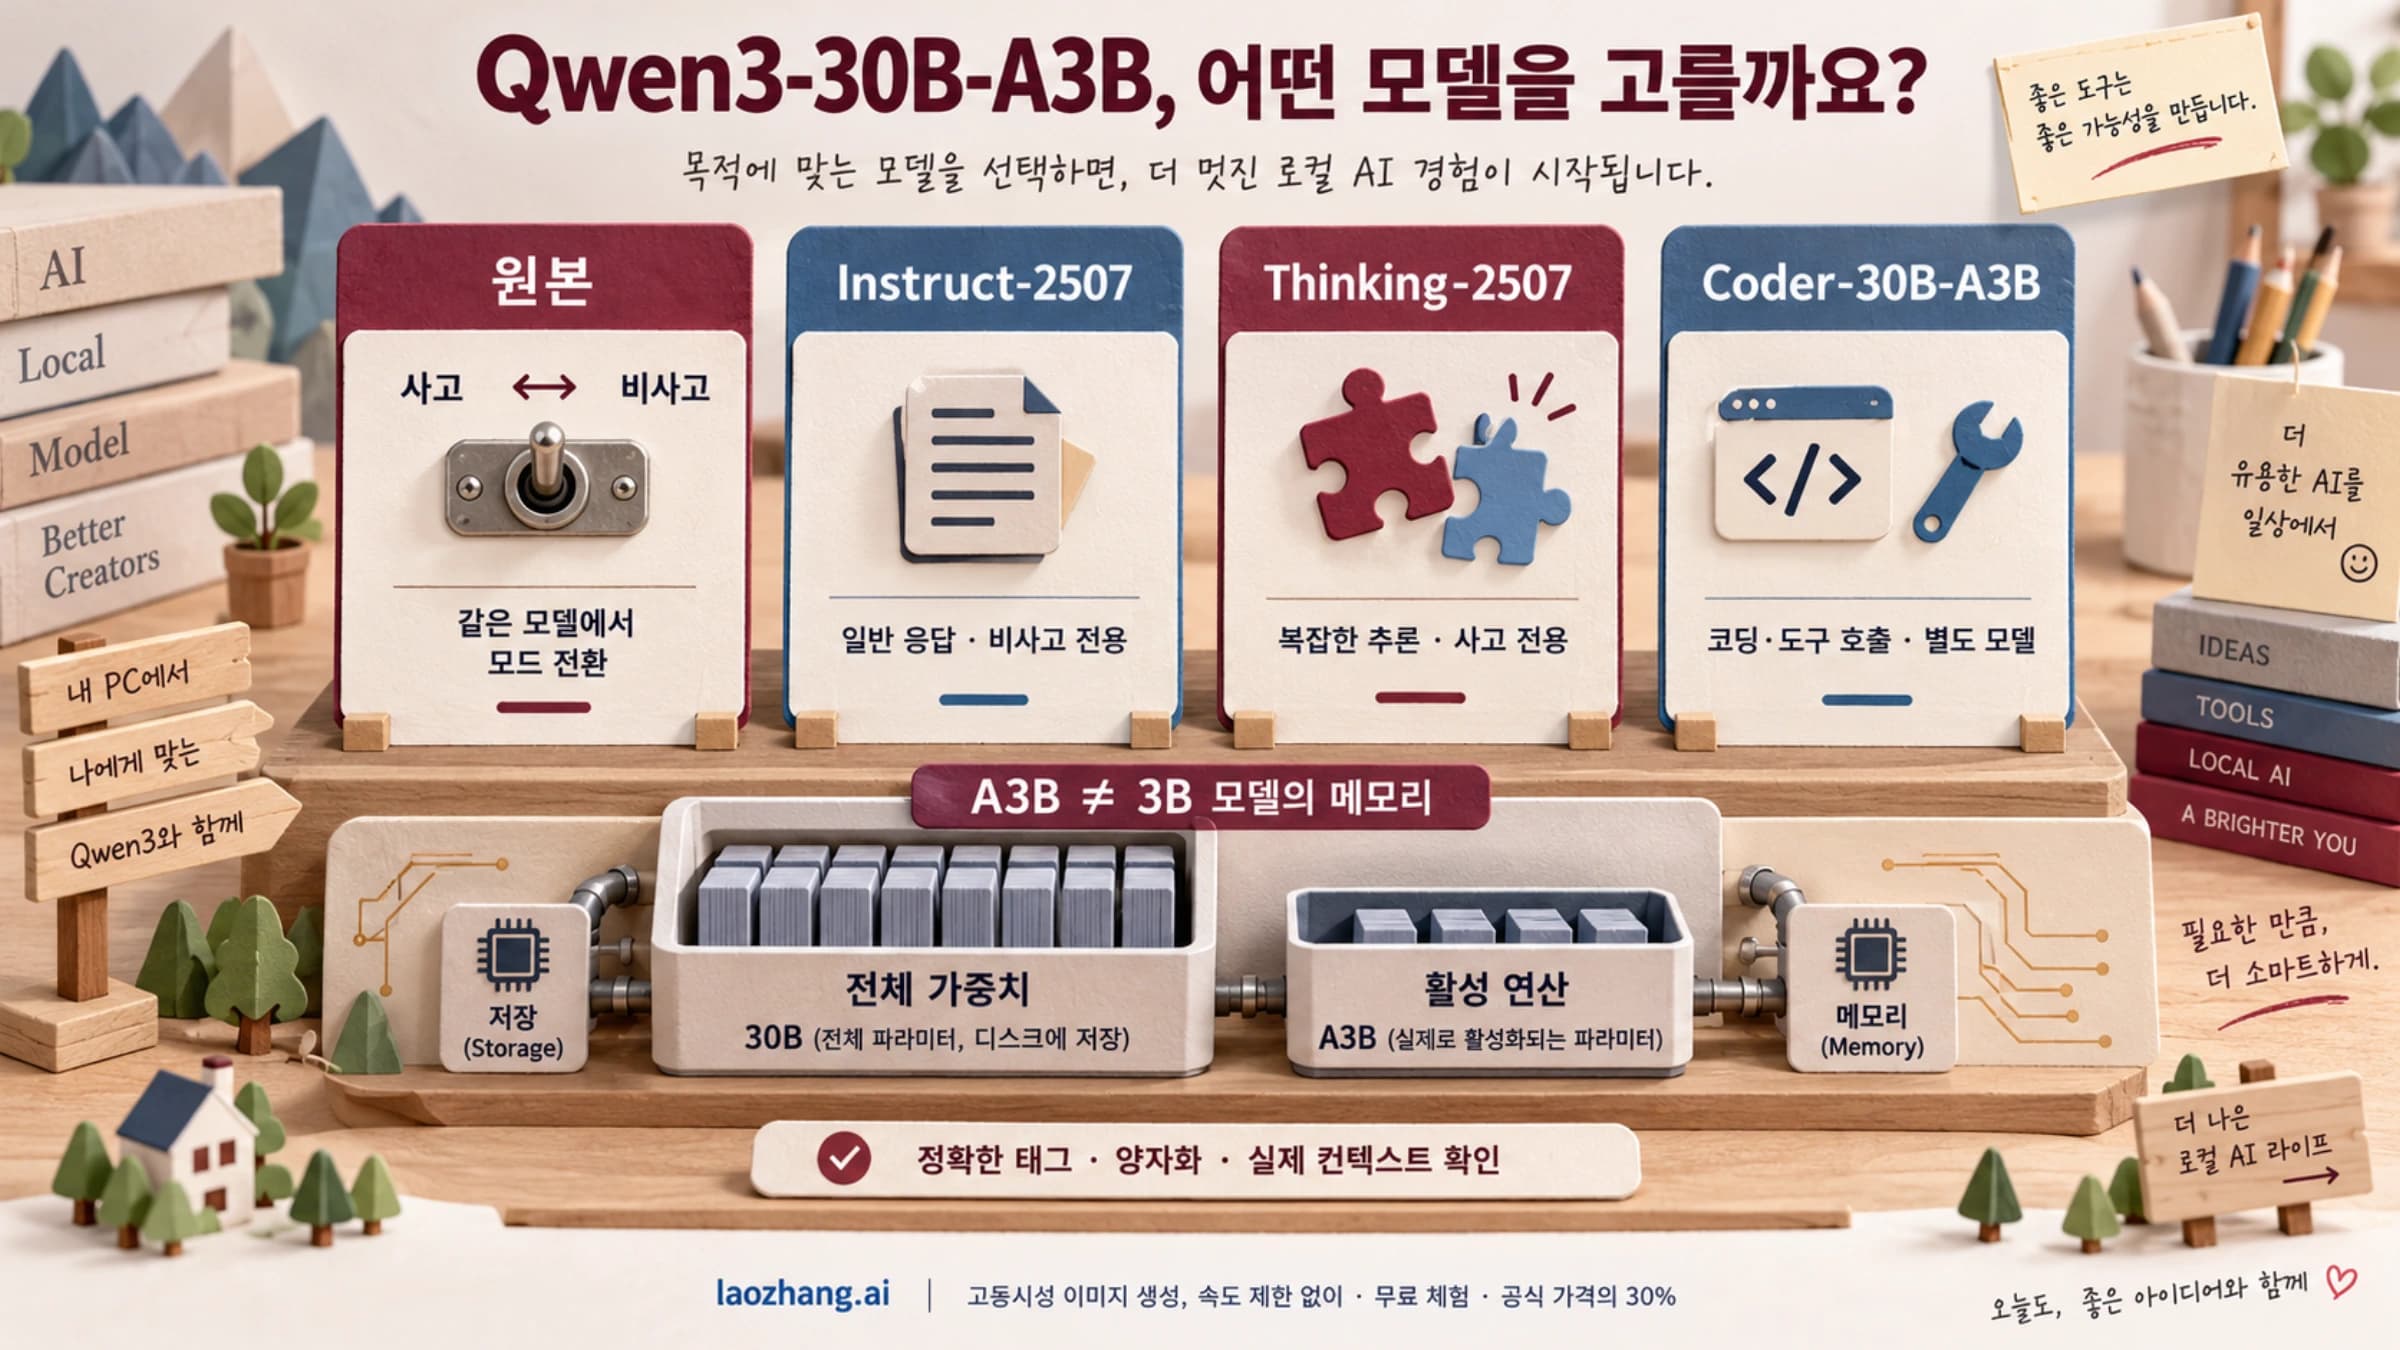
16GB VRAM이 한계라면 먼저 16GB 로컬 코딩 LLM 선택 가이드를 보세요. 이전 Qwen MoE 모델은 Qwen3-30B-A3B 로컬 가이드에서 정리할 수 있습니다.
참고 자료3
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 9월 2일.
참고 자료3
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 9월 2일.