Qwen3-30B-A3B 로컬 실행: 원본·2507·Coder 선택과 메모리
같은 모델에서 사고 모드를 전환하려면 Qwen3-30B-A3B 원본이 유효합니다. Instruct-2507과 Thinking-2507은 모드가 고정되어 있고, Coder는 코딩용 별도 모델입니다. 로컬 실행에서는 이름뿐 아니라 양자화와 실제 컨텍스트 설정도 확인해야 합니다.
목차
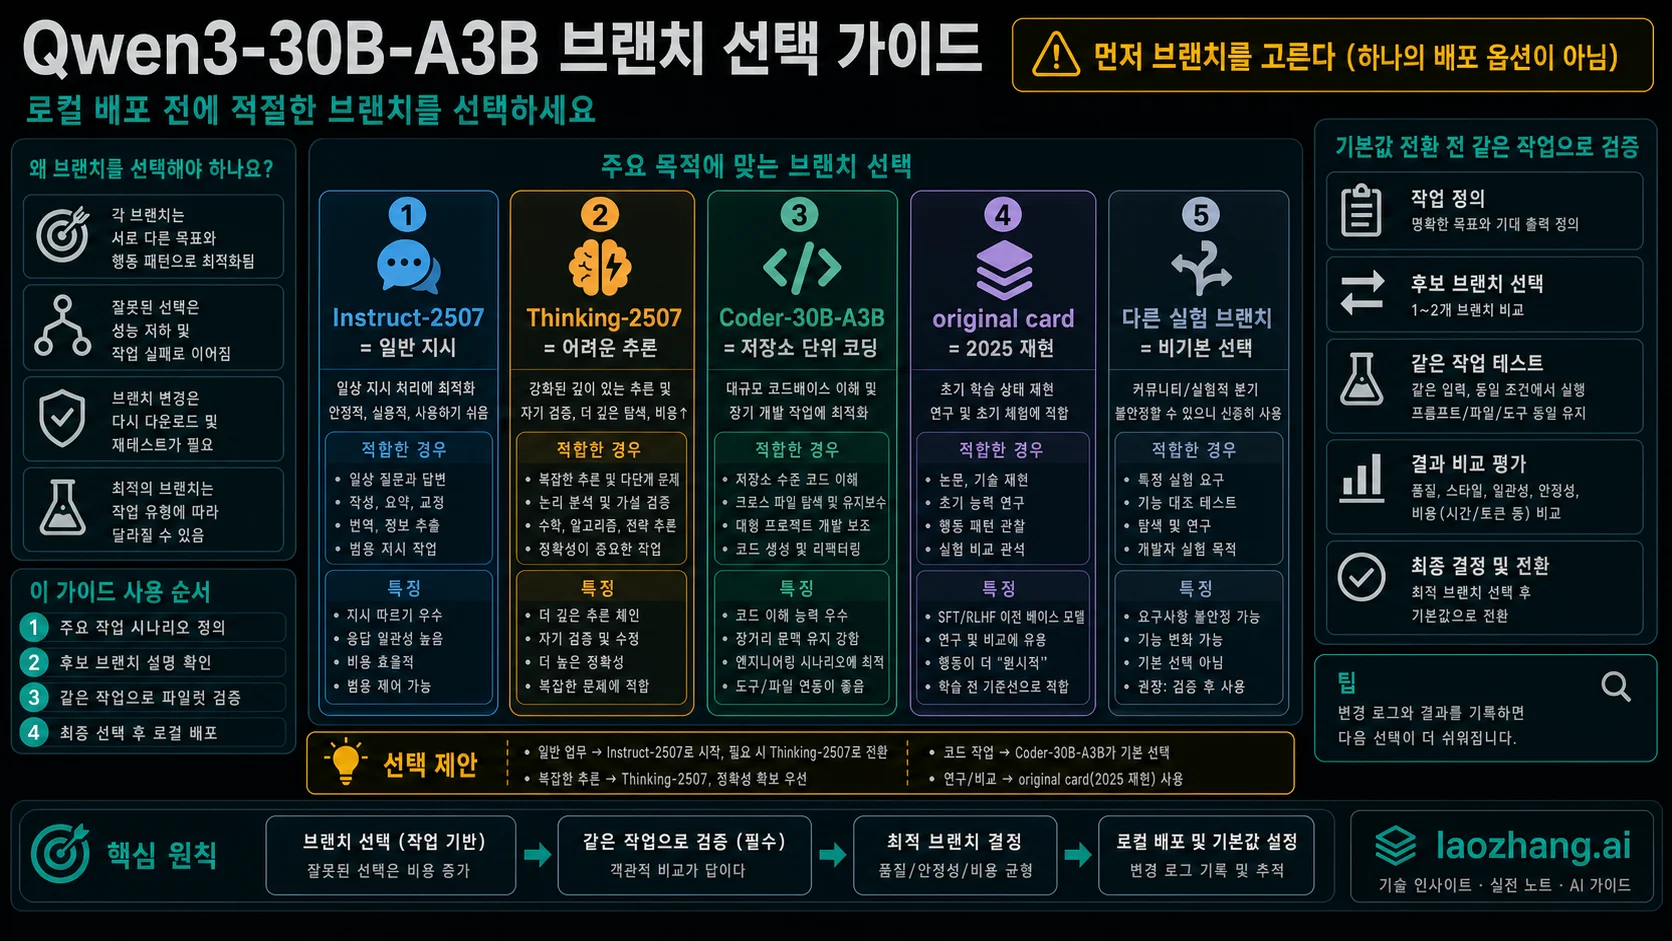
Qwen3-30B-A3B를 로컬에서 쓰려면 먼저 사고 모드를 전환할지, 한 가지 모드로 고정할지, 코딩을 주로 맡길지 정하면 됩니다. 한 모델에서 일반 답변과 긴 추론을 오가려면 원본 Qwen/Qwen3-30B-A3B가 지금도 유효한 선택입니다. 일반 문서 작업에는 Instruct-2507, 복잡한 추론에는 Thinking-2507, 코드 수정과 도구 호출에는 Qwen3-Coder-30B-A3B-Instruct를 우선 검토할 수 있습니다.
여기서 A3B는 메모리가 3B 모델만큼만 필요하다는 뜻이 아닙니다. 원본은 전체 파라미터가 305억 개이고 토큰을 처리할 때 활성화되는 파라미터가 33억 개인 MoE 모델입니다. 계산에 참여하는 부분이 작아도 전체 가중치와 대화 기록을 저장할 공간은 별도로 필요합니다. Qwen 원본 모델 설명
원본, Instruct-2507, Thinking-2507, Coder는 어떻게 고르나요?
원본은 전환형, 두 2507 모델은 고정형, Coder는 코딩과 도구 사용을 중심으로 학습한 별도 모델입니다. 아래의 선택 기준은 작업을 시작할 지점을 정하기 위한 것입니다. 이름만으로 한국어 품질이나 같은 장비에서의 속도 우열이 정해지지는 않습니다.
| 필요한 작업 | 검토할 정확한 모델 ID | 사고 동작 | 기본 지원 컨텍스트 |
|---|---|---|---|
| 같은 모델에서 사고 모드를 켜고 끄기 | Qwen/Qwen3-30B-A3B | 사고·비사고 전환 지원 | 32,768토큰 |
| 요약, 분류, 문서 작성 등 일반 응답 | Qwen/Qwen3-30B-A3B-Instruct-2507 | 비사고 전용 | 262,144토큰 |
| 여러 조건을 따지는 복잡한 추론 | Qwen/Qwen3-30B-A3B-Thinking-2507 | 사고 전용 | 262,144토큰 |
| 코드 수정, 저장소 이해, 도구 호출 | Qwen/Qwen3-Coder-30B-A3B-Instruct | 비사고 전용 | 262,144토큰 |
컨텍스트 수치는 각 모델의 기본 지원 길이이며, 현재 컴퓨터에서 그 길이만큼 사용할 수 있다는 보장은 아닙니다. 원본의 131,072토큰은 YaRN 확장 조건을 포함한 수치입니다. 출처: 원본, Instruct-2507, Thinking-2507, Coder.
일반 응답을 만들고 싶다면 Instruct-2507부터 시작해도 됩니다. 이 모델은 별도의 사고 블록을 생성하지 않지만 논리 문제나 코드 작성 자체를 못 하는 것은 아닙니다. 결과 형식을 지키는지, 필요한 정보를 빠뜨리지 않는지 먼저 확인하세요. 2507은 2025년 7월 버전을 나타냅니다.
어려운 조건 판단에 사고 과정을 쓰려면 Thinking-2507을 검토하세요. 사고 전용이므로 짧은 답만 요청한다고 비사고 모델로 바뀌지는 않습니다. 모델 설명은 긴 추론을 전제로 하며, 최종 답에 앞서 생성하는 사고 토큰도 출력 여유와 실행 시간에 영향을 줍니다. 긴 출력이 실제 오류를 줄이는지는 같은 문제로 비교해야 합니다.
원본은 모드 전환이 필요할 때 선택할 이유가 있습니다. Hugging Face의 원본 채팅 템플릿에서 enable_thinking=True가 기본값이고, False는 사고 생성을 끄는 설정입니다. 사고를 허용한 상태에서는 /think와 /no_think로 동작을 요청할 수도 있습니다. 이 문자열은 원본 템플릿의 제어 방식입니다. Instruct-2507에 /think를 붙여 Thinking-2507로 바꾸거나, Thinking-2507에 /no_think를 붙여 비사고 전용으로 바꿀 수는 없습니다. 원본의 사고 모드 전환 설명
코딩이 중심이면 Coder를 별도로 평가하세요. 코드 작성뿐 아니라 저장소 문맥과 함수 호출 형식도 고려한 모델입니다. 다만 모델이 도구 호출을 출력하는 것과 프로그램이 실제로 도구를 실행하는 것은 다릅니다. 사용하는 클라이언트와 파서가 호출 형식을 처리해야 합니다. Coder 모델 설명
Ollama에서 정확한 30B 모델로 시작하기
일반 응답용 Instruct-2507을 시작점으로 삼는 절차입니다. Ollama가 설치되어 있고 로컬 서비스가 실행 중이며, 약 19GB인 해당 모델 파일을 받을 저장 공간과 실행에 필요한 메모리가 있다는 전제입니다. 아래 명령은 공식 문서와 공개 태그에 근거한 사용 예제이며, 이 글에서 모델을 실행해 얻은 성능 측정값은 아닙니다.
1. 짧은 이름 대신 명시적인 태그를 지정합니다
2026년 10월 7일 확인한 공개 태그는 다음과 같습니다.
ollama pull qwen3:30b-a3b-instruct-2507-q4_K_M
ollama show qwen3:30b-a3b-instruct-2507-q4_K_M
ollama show --modelfile qwen3:30b-a3b-instruct-2507-q4_K_M
첫 명령은 가중치를 다운로드합니다. 다음 두 명령에서는 모델 정보, 양자화 종류, 채팅 템플릿과 기본 매개변수를 확인합니다. Q4_K_M은 양자화 형식입니다. 해당 Ollama 태그 페이지는 약 19GB의 파일을 표시하지만, 이 크기를 최대 RAM 또는 VRAM 사용량으로 읽으면 안 됩니다.
ollama run qwen3처럼 크기를 생략하면 같은 날짜에 확인한 기본 모델은 8B였습니다. 또 qwen3:30b-a3b와 qwen3:30b라는 짧은 태그가 있다고 해서 두 이름이 원하는 원본이나 2507 체크포인트를 항상 가리킨다고 단정할 수는 없습니다. 공개 태그도 갱신될 수 있으므로 다시 설치하거나 결과를 재현할 때는 로컬 ID, 양자화와 템플릿을 함께 기록하세요. Qwen3 태그 목록, 30B-A3B 짧은 태그
Coder를 선택했다면 별도로 공개된 qwen3-coder:30b를 확인할 수 있습니다. 이 역시 파일과 설정을 확인하는 절차가 필요합니다. Thinking-2507을 선택한다면 정확한 Thinking-2507 모델 ID와 사용하려는 실행 도구의 지원 여부를 맞춰야 합니다. Ollama Coder 30B
2. 첫 대화는 짧은 컨텍스트로 시작합니다
ollama run qwen3:30b-a3b-instruct-2507-q4_K_M대화창에서 다음 설정을 입력한 뒤 필요한 질문을 입력하세요.
/set parameter num_ctx 81928,192는 짧은 작업을 위한 예제 설정이며 모델의 최대 길이가 아닙니다. 시스템 지시, 질문, 대화 이력, 생성할 답변이 컨텍스트를 함께 사용합니다. 더 긴 자료가 필요하면 메모리 상태를 보면서 길이를 늘리세요. 처음부터 262,144로 설정할 필요는 없습니다. 설정 방식은 Ollama FAQ에 나와 있습니다.
모델이 메모리에 올라간 동안 별도 터미널에서 다음 명령을 확인합니다.
ollama psCONTEXT는 실제 할당된 컨텍스트 길이이고, PROCESSOR는 CPU와 GPU에 어떻게 배치되었는지 보여 줍니다. “모델이 로드되었다”와 “전부 GPU에 올라갔다”는 서로 다른 확인입니다. Ollama 컨텍스트 문서
3. 사고 동작은 사용 중인 모델과 도구에서 확인합니다
Ollama API의 모델 정보는 다음처럼 조회할 수 있습니다. 기본 로컬 주소를 사용하는 경우의 예제입니다.
curl http://127.0.0.1:11434/api/show -d '{
  "model": "qwen3:30b-a3b-instruct-2507-q4_K_M"
}'
응답에서 모델 정보와 양자화, 템플릿을 확인하고, thinking.values와 thinking.default가 있으면 허용되는 사고 설정과 기본값을 읽습니다. 이 메타데이터가 없다는 사실만으로 내부 추론을 전혀 하지 않는다고 결론 내릴 수는 없습니다. Ollama 사고 기능 문서
원본의 전환형 동작을 Ollama에서 쓰려면 먼저 설치한 모델이 그 동작을 지원하는지 확인해야 합니다. 지원하는 모델에서 API의 think: false는 사고 생성을 끄는 요청이고, think: true는 켜는 요청입니다. Hugging Face의 enable_thinking과는 매개변수 이름이 다릅니다. 또한 CLI의 --hidethinking은 사고 표시를 숨기는 옵션이므로 사고 생성 자체를 끄는 설정으로 쓰면 안 됩니다. 응답을 처리하는 프로그램에서는 message.thinking과 최종 답인 message.content도 구분하세요. Ollama 사고 문서, 현재 CLI 소스
짧은 한국어 작업으로 응답을 확인하는 예제
첫 실행에서는 긴 벤치마크보다 정답 조건을 직접 확인할 수 있는 작은 작업이 편합니다. 예를 들어 배송 문의 답장을 작성하면서, 제공한 사실만 사용하는지 확인할 수 있습니다. 다음은 위의 Instruct-2507 모델과 실행 중인 기본 로컬 서비스를 전제로 한 독립적인 요청 예제입니다.
curl http://127.0.0.1:11434/api/chat -d '{
  "model": "qwen3:30b-a3b-instruct-2507-q4_K_M",
  "stream": false,
  "messages": [
    {
      "role": "user",
      "content": "고객에게 보낼 배송 안내를 존댓말 두 문장으로 작성하세요. 확인된 사실: 주문번호는 K-218, 출고 예정일은 10월 12일, 운송장 번호는 아직 발급되지 않았습니다. 배송 도착일과 보상은 약속하지 마세요."
    }
  ],
  "options": {
    "num_ctx": 8192,
    "num_predict": 512,
    "temperature": 0.7
  }
}'
stream: false는 응답을 한 번에 받는 설정입니다. 컨텍스트와 생성 매개변수는 최상위 필드가 아니라 options 안에 둡니다. num_predict: 512는 이 짧은 답변을 위한 생성 상한이며, 2507 모델의 최대 출력이나 컨텍스트 길이를 뜻하지 않습니다. temperature: 0.7은 Instruct-2507 모델 설명의 권장값을 출발점으로 사용했습니다. Ollama API 설정 문서, Instruct-2507 권장 설정
실제 응답의 message.content에서 다음을 확인하세요.
- 존댓말 두 문장으로 답했는가?
- 주문번호 K-218과 출고 예정일 10월 12일을 정확히 넣었는가?
- 미발급 운송장 번호를 만들어 내지 않았는가?
- 출고일을 도착일로 바꾸거나 보상을 약속하지 않았는가?
이는 출력 형식과 사실 보존을 확인하는 작업입니다. 실제 결과가 조건을 만족하더라도 수학 추론, 긴 문서 이해, 코딩 성능까지 입증하지는 않습니다.
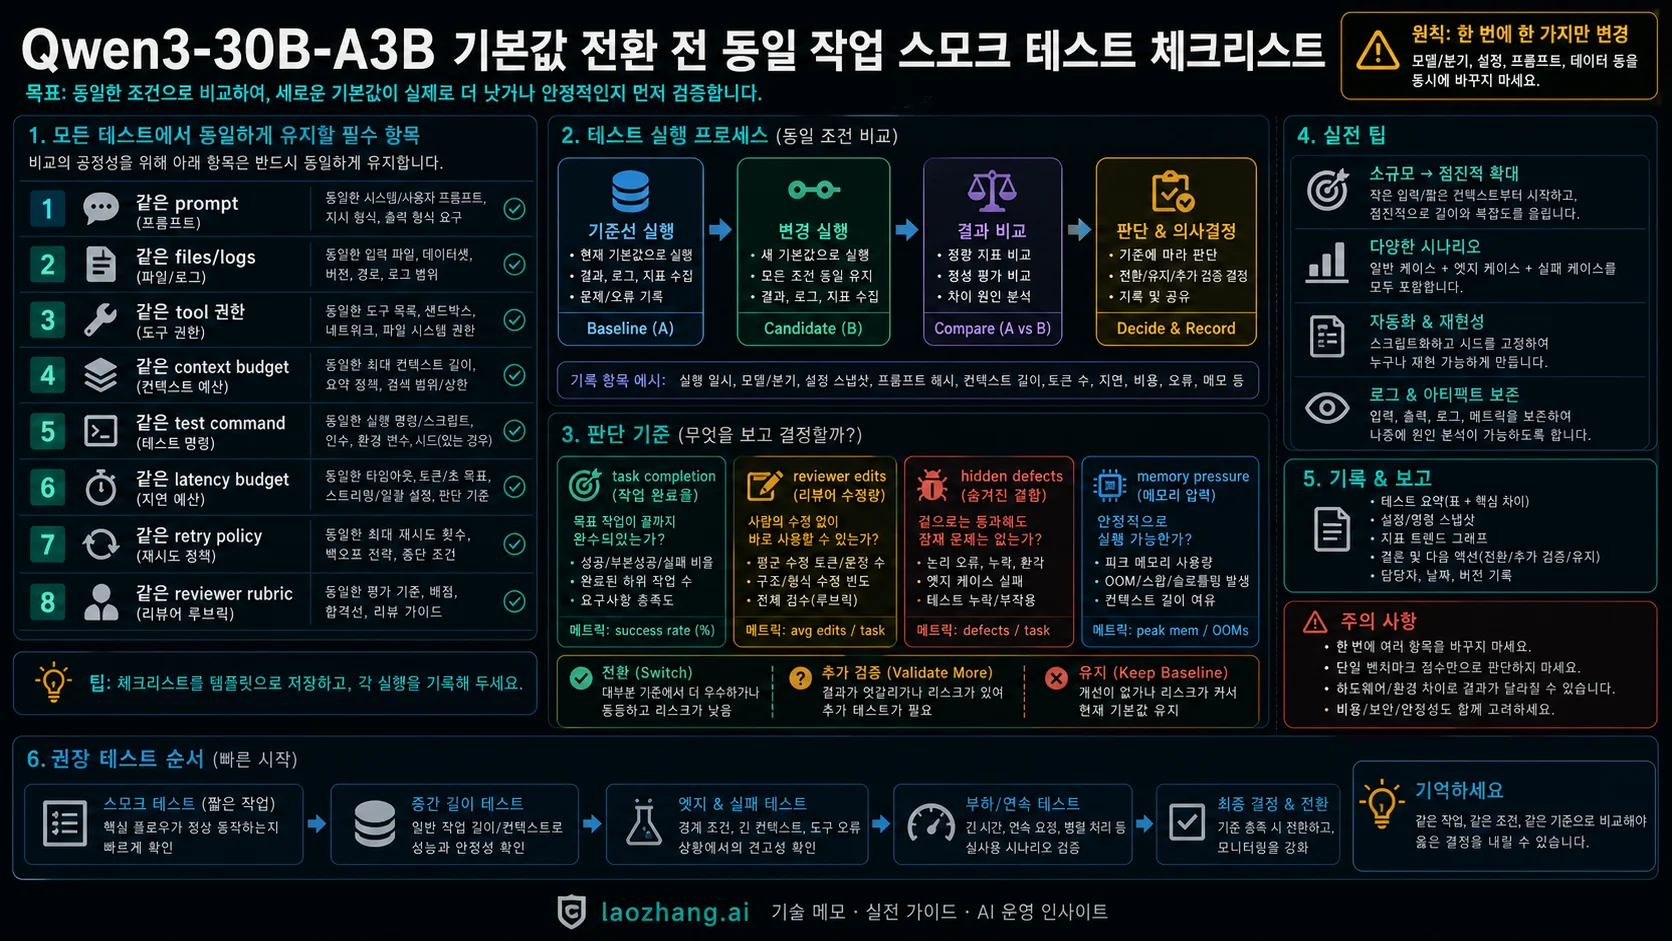
다른 모델로 바꿀지 판단할 때도 해당 작업의 확인 기준을 정하면 됩니다. Thinking-2507은 조건이 많은 문제에서 최종 답이 맞는지와 소요 시간을 함께 보고, Coder는 동일한 코드와 요구사항을 주고 테스트 통과 여부와 수정 범위를 확인하세요. 비교할 때 모델, 양자화, 입력, 컨텍스트와 출력 상한을 기록해야 원인을 구분할 수 있습니다.
A3B인데 왜 메모리가 많이 필요한가요?
MoE의 활성 파라미터 수는 주로 토큰당 계산량에 관한 정보입니다. 모델을 적재할 때는 전체 가중치가 필요하고, 대화를 처리할 때는 KV 캐시와 실행 도구의 부가 메모리도 필요합니다.
305억 파라미터를 모두 정확히 4비트로만 저장한다고 단순 계산하면 30.5 × 10⁹ × 4 ÷ 8 = 15.25GB, 약 14.20GiB입니다. 이는 양자화 스케일, 일부 고정밀도 부분, 파일 구조와 실행 메모리를 제외한 이론적인 가중치 데이터 크기입니다. 앞서 확인한 Q4_K_M 파일이 약 19GB인 것과도 같은 수치가 아닙니다. 16GB GPU에 들어가는지 판단할 때 이론값만 사용해서는 안 됩니다.
컨텍스트를 늘리면 KV 캐시도 커집니다. 예를 들어 Coder-30B-A3B의 48개 층, KV 헤드 4개, 헤드 차원 128을 바탕으로 F16 캐시와 대화 한 개를 가정하면 토큰당 데이터는 다음과 같습니다.
K와 V 두 개 × 48층 × 4개 KV 헤드 × 128차원 × 2바이트
= 98,304바이트 = 96KiB/토큰| 저장할 토큰 수 | 위 가정에서의 KV 캐시 데이터 |
|---|---|
| 8,192 | 0.75GiB |
| 32,768 | 3GiB |
| 65,536 | 6GiB |
| 262,144 | 24GiB |
이 계산은 Coder의 설정 파일에 근거하며, 실제 최대 메모리 사용량을 측정한 결과가 아닙니다. 가중치와 실행 중 임시 공간은 별도이고, 캐시 양자화, CPU로 일부 적재하는 방식, 동시 요청 수와 실행 도구에 따라 달라집니다. 특히 대화 한 개의 캐시가 24GiB라는 계산을 “24GB GPU에서 262K가 된다”로 읽으면 안 됩니다.
메모리 부족이 발생하면 먼저 컨텍스트 길이를 줄여 짧은 입력이 처리되는지 확인하세요. 다음으로 CPU·GPU 배치와 동시 요청을 확인하면 가중치 적재 문제인지, 늘어난 캐시와 작업 공간 때문인지 좁힐 수 있습니다. 일부를 CPU에서 처리하면 더 작은 GPU로 실행할 여지가 생기지만 속도가 유지된다는 보장은 없습니다.
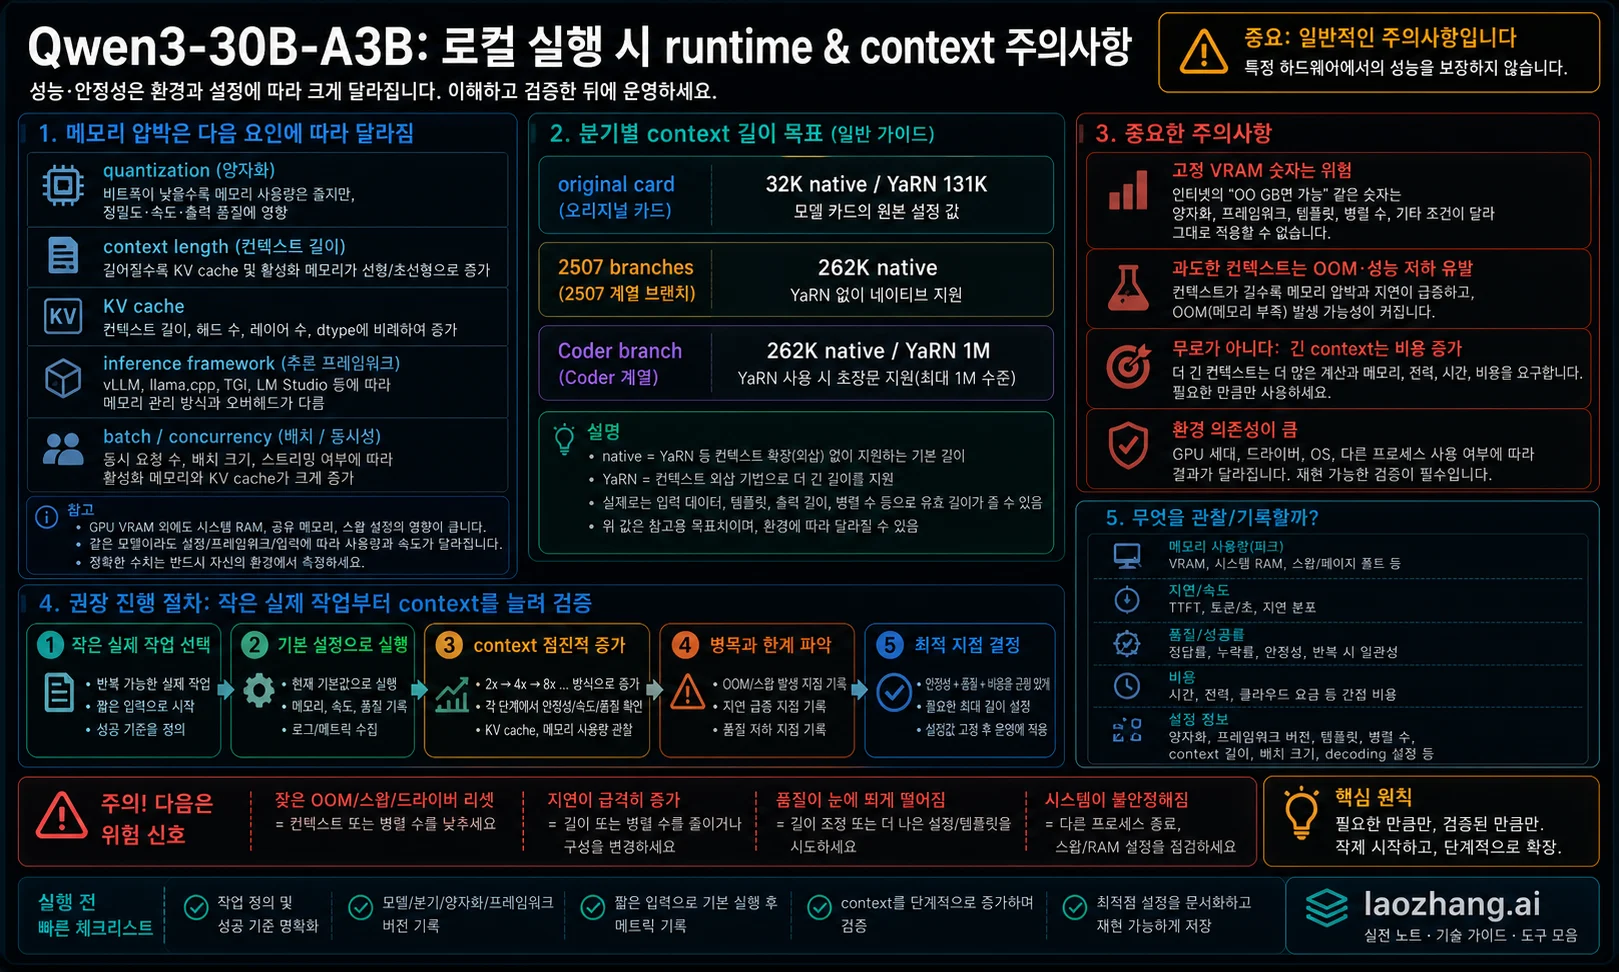
256K 지원과 실제 컨텍스트 설정은 다릅니다
모델 설명의 최대 지원 길이, 양자화 파일의 메타데이터, 실행 도구가 실제로 할당한 길이는 나누어 봐야 합니다. 특히 원본 모델 설명은 기본 32,768토큰인데, 확인한 Ollama의 짧은 30B 태그 파일은 context_length: 262144를 표시했습니다. 이 메타데이터로 원본의 기본 지원 길이를 256K로 고쳐 읽거나, 원본이 2507과 같다고 결론 내릴 수는 없습니다. 원본 모델 설명, Ollama 30B-A3B 태그
Ollama 기본값에 관한 문서도 완전히 일치하지 않습니다. 2026년 10월 7일 확인한 컨텍스트 문서는 VRAM이 24GiB 미만이면 4K, 24GiB 이상 48GiB 미만이면 32K, 48GiB 이상이면 256K라고 설명합니다. 반면 FAQ에는 기본값 4,096이라는 설명이 남아 있습니다. 따라서 모든 버전에 같은 기본값을 가정하기보다 num_ctx를 명시하고 실행 중 ollama ps의 CONTEXT로 확인하는 편이 명확합니다. 컨텍스트 문서, FAQ
262,144토큰 설정도 입력에 전부 쓸 수 있는 여유를 뜻하지 않습니다. 시스템 지시, 대화 이력, 도구 결과와 출력이 같은 창을 사용하며, 사고 모델은 추론 출력도 고려해야 합니다. 길게 읽을 수 있는지와 필요한 정보를 끝까지 정확히 활용하는지는 별개의 확인입니다.
100만 토큰이라는 설명에는 추가 조건이 있습니다. Instruct-2507과 Thinking-2507의 모델 설명은 DCA·MInference와 별도 설정을 쓰는 방법을 소개하며, 약 240GB의 전체 GPU 메모리를 명시합니다. Coder는 YaRN 확장을 통해 100만 토큰을 지원한다고 설명합니다. 두 설명을 일반적인 Ollama 4비트 실행에서 자동 적용되는 기능으로 합치면 안 됩니다. 긴 컨텍스트가 목적이라면 먼저 사용할 모델과 실행 도구의 해당 확장 지원을 확인하세요. Instruct-2507 장문 처리 설명, Thinking-2507 장문 처리 설명, Coder 모델 설명
자주 묻는 질문
Qwen3-30B-A3B 원본은 이제 쓸 필요가 없나요?
모드를 전환하고 싶다면 여전히 검토할 이유가 있습니다. 원본은 하나의 모델에서 사고·비사고 모드를 지원하고, Instruct-2507과 Thinking-2507은 각각 한 가지 모드로 고정되어 있습니다. 이전 결과 재현도 원본의 용도지만 그것만이 전부는 아닙니다. 원본 모델 설명
A3B는 3B 모델이라는 뜻인가요?
전체 모델 크기가 3B라는 뜻은 아닙니다. 원본의 전체 파라미터는 30.5B, 활성 파라미터는 3.3B입니다. 전체 가중치와 캐시가 필요하므로 메모리도 활성 파라미터 수만으로 계산할 수 없습니다. Qwen 원본 모델 설명
Thinking-2507에서 여는 think 태그가 없으면 잘못된 출력인가요?
그것만으로 잘못된 출력은 아닙니다. 공식 채팅 템플릿이 여는 <think>를 미리 넣으므로 새로 생성한 부분에는 닫는 </think>만 나타날 수 있습니다. 원시 생성 문자열과 실행 도구가 분리한 사고·최종 답변 필드를 구분해야 합니다. Thinking-2507 설명
16GB VRAM이면 Qwen3-30B-A3B를 실행할 수 있나요?
이름만으로 확답할 수 없습니다. 확인한 Ollama Q4_K_M 파일은 약 19GB이고, 실행에는 캐시와 부가 공간도 필요합니다. 일부를 CPU에 적재하거나 다른 양자화를 쓰는 선택은 가능하지만 실제 배치, 컨텍스트 길이와 지연 시간을 확인해야 합니다. 이 글의 가중치·캐시 계산은 특정 GPU의 적합성을 보장하지 않습니다. Ollama Instruct-2507 태그
Qwen3-Coder-30B-A3B는 원본의 다른 이름인가요?
코딩과 도구 사용에 초점을 둔 별도 모델입니다. 비사고 전용이며 기본 262,144토큰을 지원합니다. 원본의 사고 전환 설정이나 성능을 그대로 적용하면 안 됩니다. Coder 모델 설명
Qwen3.8-27B로 바꾸면 항상 더 낫나요?
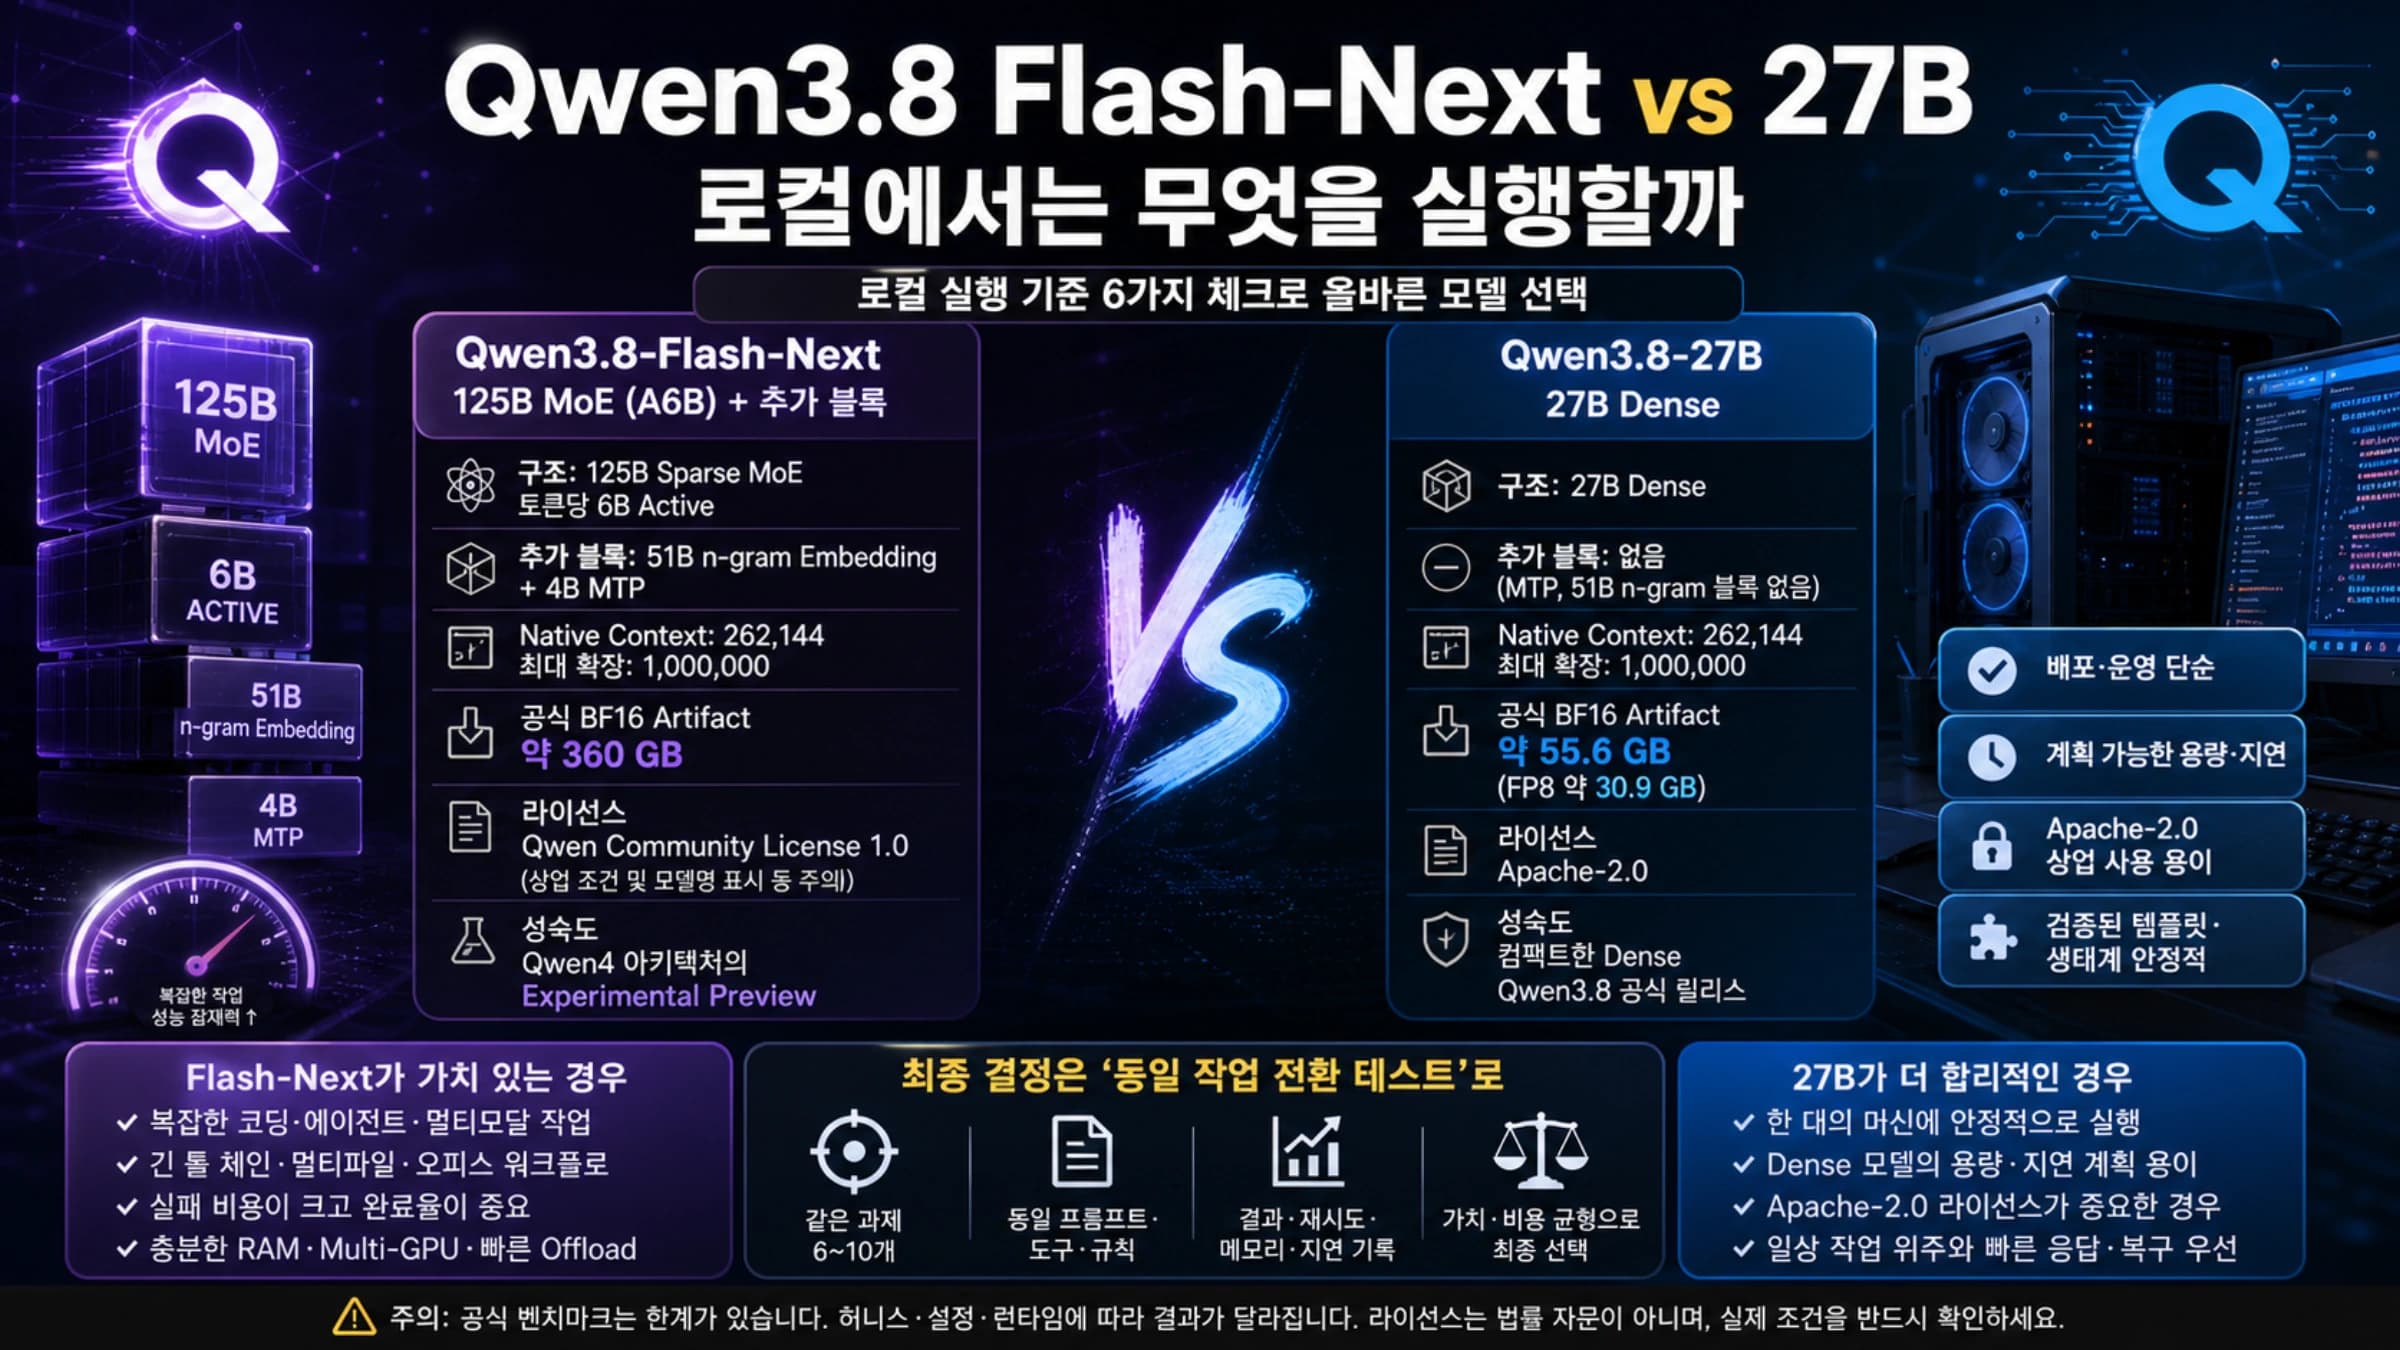
자동으로 그렇게 판단할 수는 없습니다. Qwen3.8-27B는 밀집형 비전·언어 모델이고, Qwen3.6-35B-A3B도 별도의 비전 인코더를 가진 MoE 모델입니다. 둘 다 이 글의 30B 모델을 가리키는 별칭이 아닙니다. 같은 입력과 장비에서 필요한 기능을 비교해야 합니다. Qwen3.8-27B, Qwen3.6-35B-A3B
27B 모델의 GPU 메모리 구성이 궁금하다면 Qwen3.8-27B의 RTX 5090·GPU 두 장·262K 설정 가이드를 참고하세요. 그 페이지는 별도 27B 모델의 가중치와 캐시를 다루므로, 30B-A3B의 메모리 계산을 대신하는 자료로 쓰면 안 됩니다.
참고 자료16
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 8일.
참고 자료16
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 8일.
- 1.Qwen 원본 모델 설명huggingface.co/Qwen/Qwen3-30B-A3B
- 2.Instruct-2507huggingface.co/Qwen/Qwen3-30B-A3B-Instruct-2507
- 3.Thinking-2507huggingface.co/Qwen/Qwen3-30B-A3B-Thinking-2507
- 4.Coderhuggingface.co/Qwen/Qwen3-Coder-30B-A3B-Instruct
- 5.Ollama 태그 페이지ollama.com/library/qwen3:30b-a3b-instruct-2507-q4_K_M
- 6.Qwen3 태그 목록ollama.com/library/qwen3
- 7.30B-A3B 짧은 태그ollama.com/library/qwen3:30b-a3b
- 8.Ollama Coder 30Bollama.com/library/qwen3-coder:30b
- 9.Ollama FAQdocs.ollama.com/faq
- 10.Ollama 컨텍스트 문서github.com/ollama/ollama/blob/main/docs/context-length.mdx
- 11.Ollama 사고 기능 문서docs.ollama.com/capabilities/thinking
- 12.현재 CLI 소스github.com/ollama/ollama/blob/main/cmd/cmd.go
- 13.Ollama API 설정 문서github.com/ollama/ollama/blob/main/docs/faq.mdx
- 14.Coder의 설정 파일huggingface.co/Qwen/Qwen3-Coder-30B-A3B-Instruct/blob/main/config.json
- 15.Qwen3.8-27Bhuggingface.co/Qwen/Qwen3.8-27B
- 16.Qwen3.6-35B-A3Bhuggingface.co/Qwen/Qwen3.6-35B-A3B