GPT-5.5 vs Claude Opus 4.7: API 가격과 코딩 모델 선택
두 모델 모두 API로 사용할 수 있습니다. 기존 OpenAI 연동을 유지할 때는 GPT-5.5, 출력량과 긴 문서의 단가가 중요할 때는 Opus 4.7부터 비교하고, 재시도와 검토까지 포함한 작업당 비용으로 결정하세요.
목차
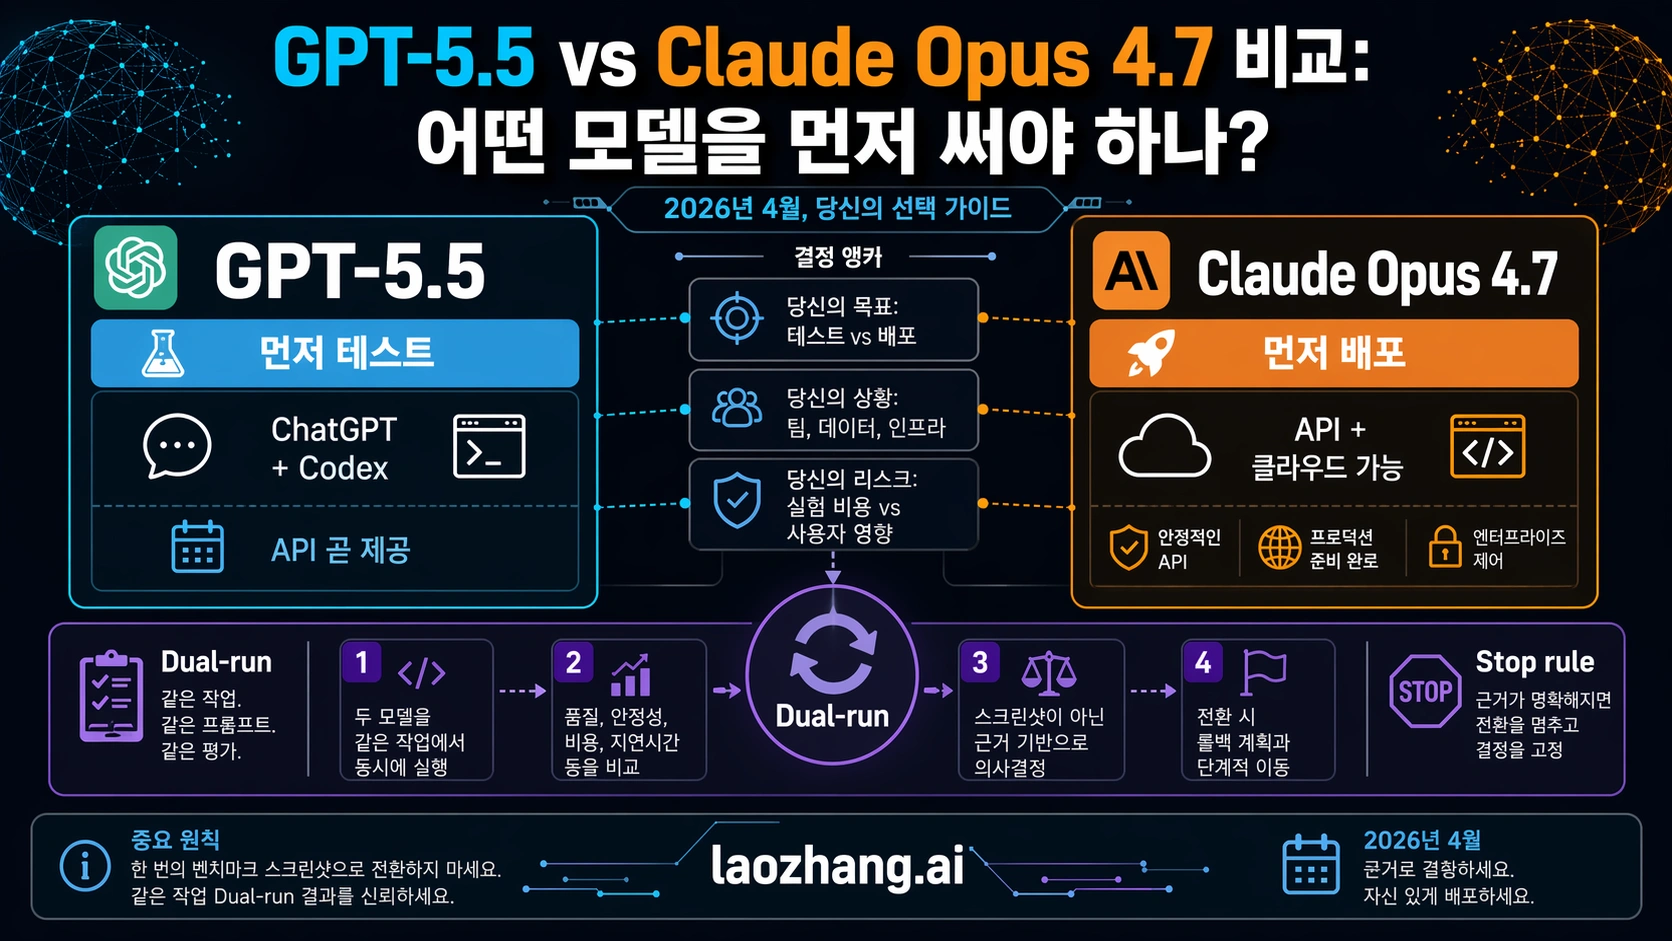
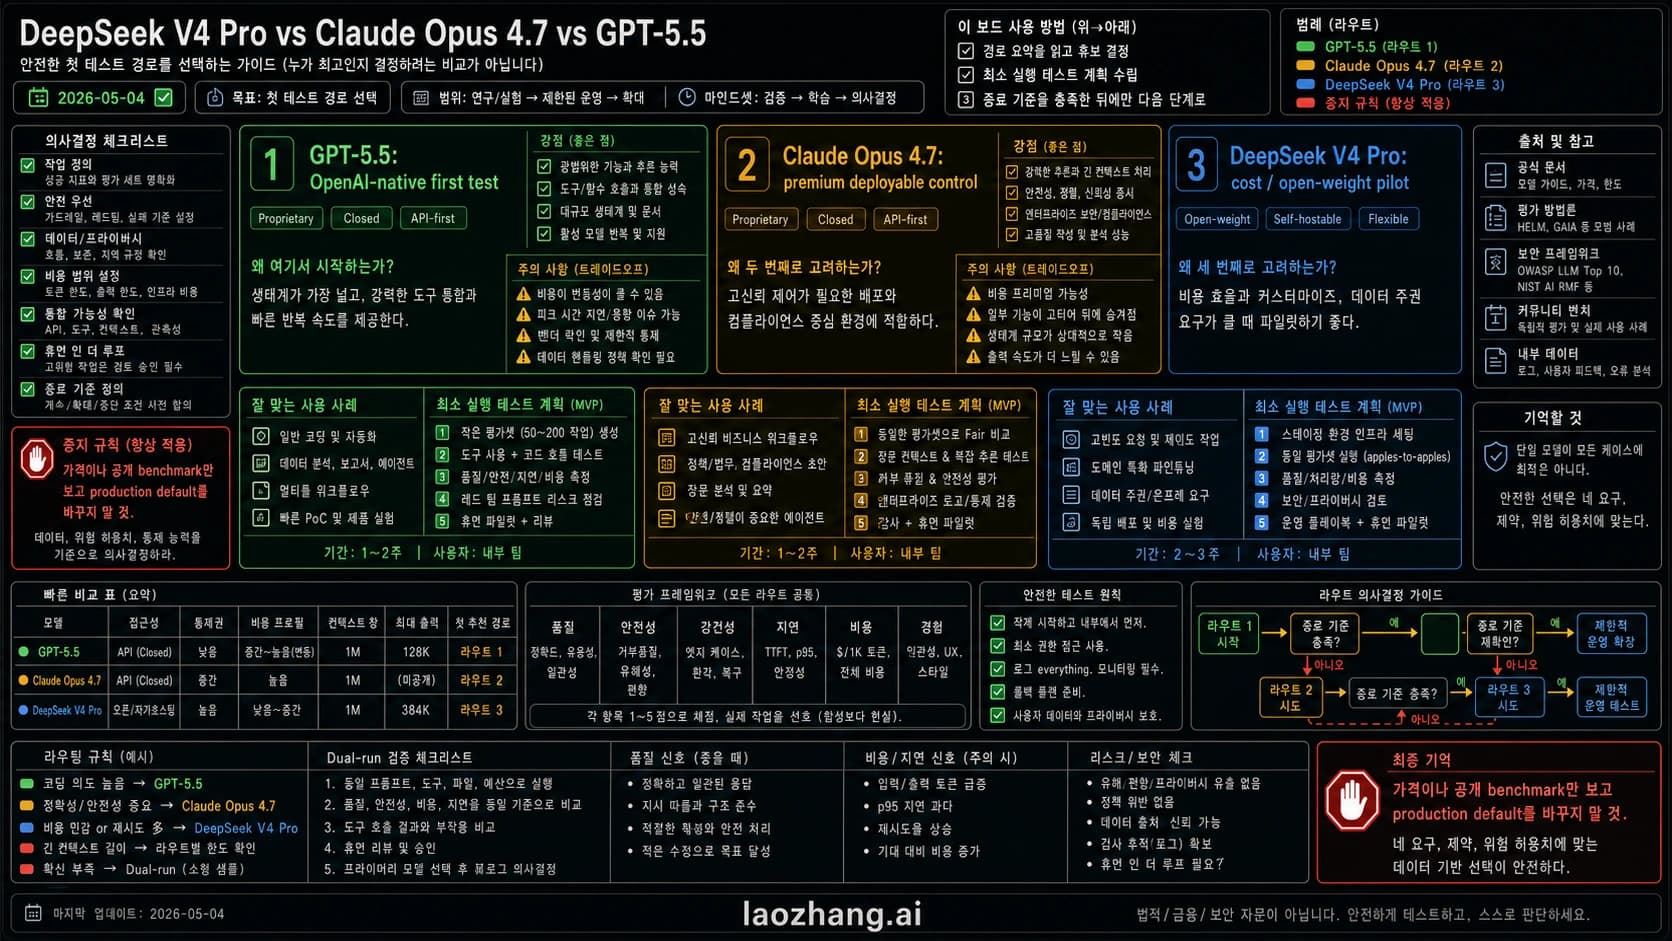
GPT-5.5와 Claude Opus 4.7 중 먼저 평가할 모델은 기존 앱의 연동 방식과 작업 비용으로 고르는 편이 합리적입니다. OpenAI Responses API와 도구를 이미 사용한다면 GPT-5.5부터, Claude Messages API를 사용하거나 긴 입력·많은 출력의 단가가 중요하다면 Opus 4.7부터 비교하세요. 두 모델 모두 현재 API로 제공되므로, 이제 GPT-5.5의 API 공개를 기다릴 필요는 없습니다. GPT-5.5 모델 문서, Opus 4.7 모델 문서
단, ChatGPT·ChatGPT Work·Codex에서 GPT-5.5를 고르는 일은 별개입니다. OpenAI는 2026년 10월 14일 이 세 제품에서 GPT-5.5를 종료하며, API에는 적용하지 않는다고 공지했습니다. 제품 화면을 기준으로 새 작업 환경을 마련하는 독자는 제공되는 후속 모델을 확인해야 합니다. 이 글의 두 모델 비교는 계속 제공되는 API를 중심으로 합니다. 공식 종료 공지
아래 가격과 제공 상태는 2026년 10월 13일 확인한 공식 문서 기준입니다. 선택 기준과 비용 예시는 문서에 근거한 판단·계산이며, 두 모델을 직접 호출해 얻은 성능 결과나 실제 청구서가 아닙니다.
어떤 작업에서 무엇부터 비교할까
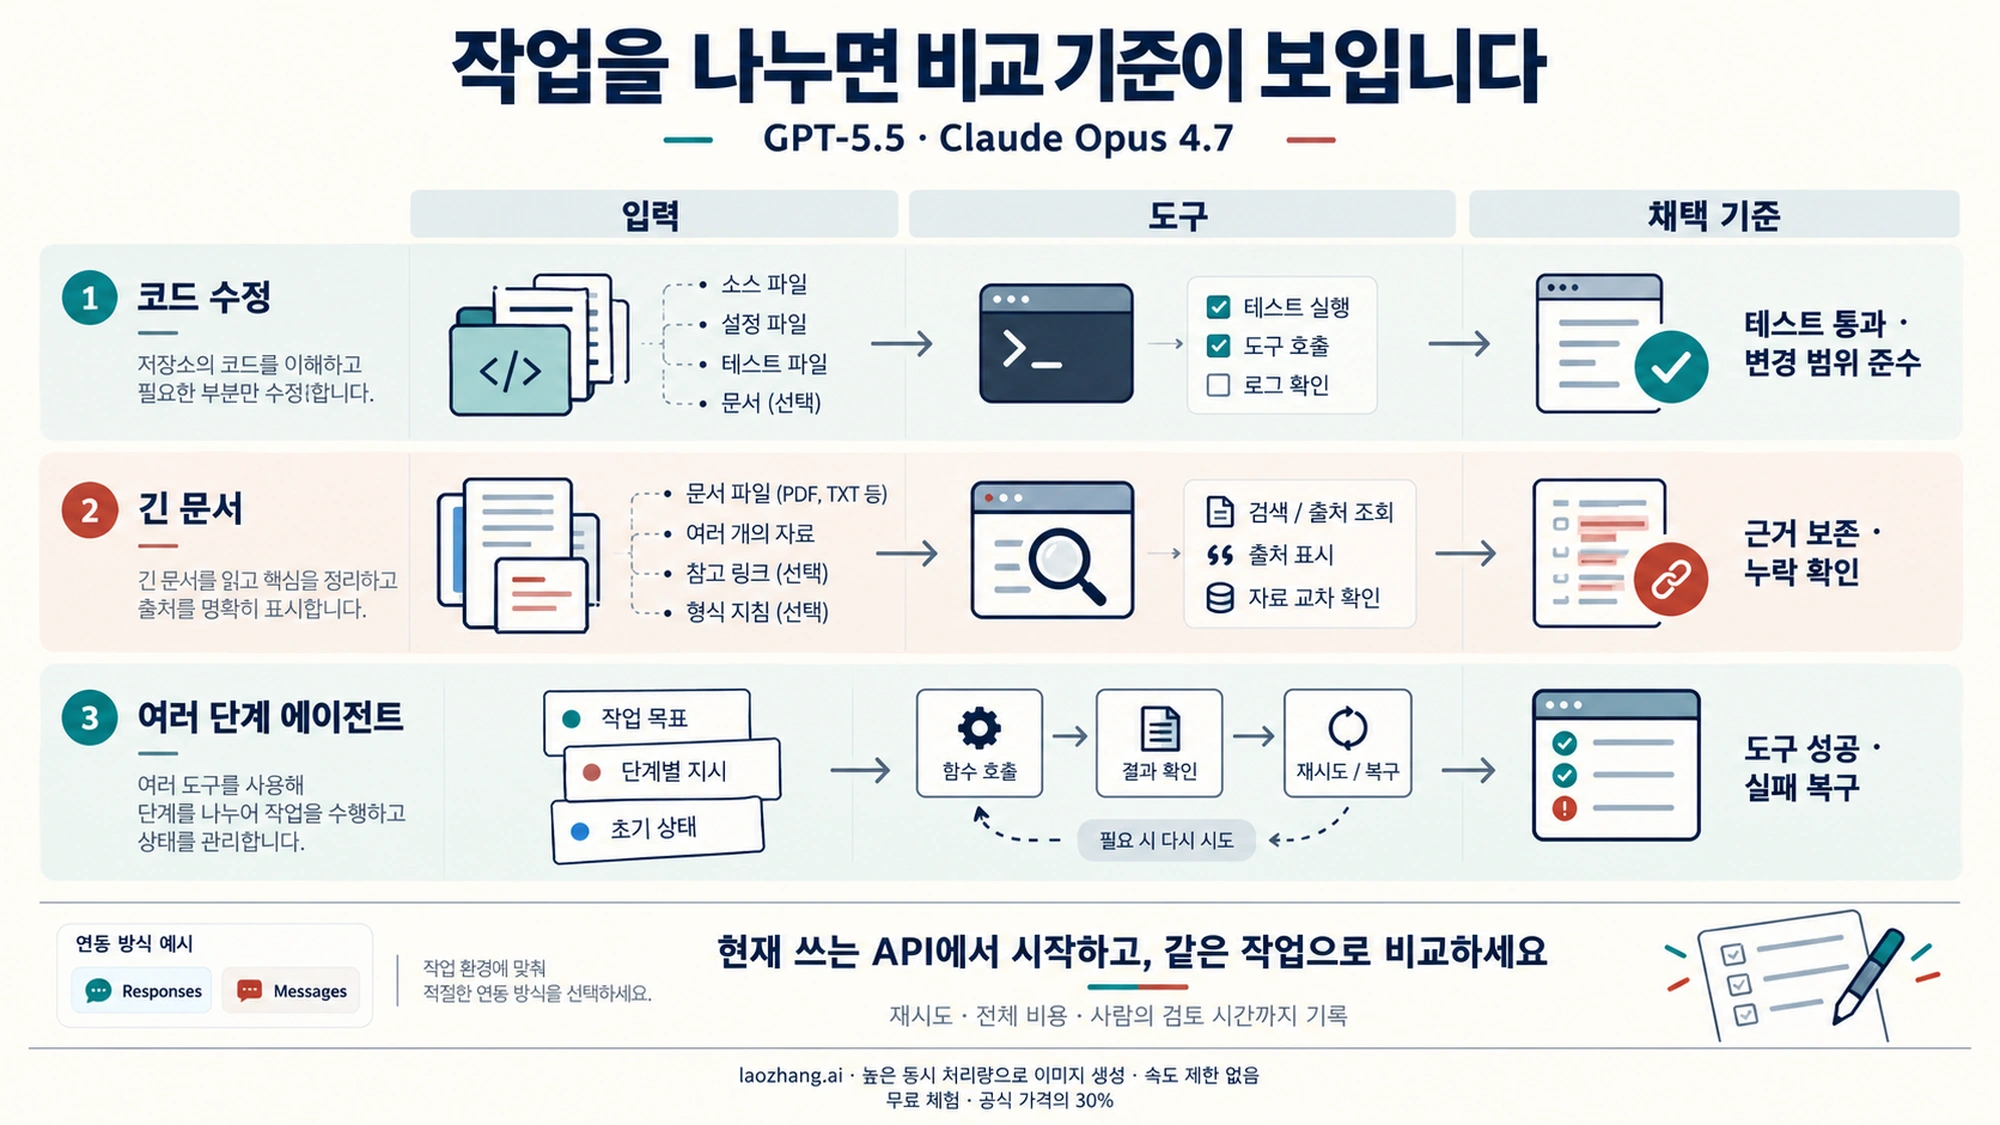
| 현재 상황 | 먼저 평가할 후보 | 함께 확인할 조건 |
|---|---|---|
| Responses API, OpenAI 도구 호출, 기존 응답 처리가 이미 구현됨 | GPT-5.5 | 기존 도구와 출력 검증을 유지해도 작업이 완성되는지, 추론 토큰과 재시도 비용 |
| Messages API와 Claude 도구 사용 흐름이 이미 구현됨 | Opus 4.7 | adaptive thinking 설정, 텍스트·도구 응답 구분, 기존 요청의 호환성 |
| 큰 문서나 코드베이스를 한 번에 넣고 긴 결과물을 생성함 | Opus 4.7을 비용 비교의 출발점으로 사용 | GPT-5.5의 272K 입력 초과 요금, 각 모델이 실제로 센 토큰 수, 필요한 근거를 빠뜨리는지 |
| 짧은 응답을 사용자에게 빠르게 보여줘야 함 | 현재 앱과 더 잘 맞는 모델에서 낮은 effort를 먼저 비교 | 출력 속도보다 첫 답변 대기 시간과 전체 응답 완료 시간 |
| 복잡한 리팩토링, 검토, 여러 도구를 쓰는 에이전트 | 기존 모델을 기준으로 두 후보 평가 | 테스트 통과, 변경 범위 준수, 실패 복구, 사람의 수정 시간과 최종 채택률 |
이것은 어느 모델의 코드가 항상 더 정확하다는 순위가 아닙니다. 이미 작동하는 연동을 활용하면 초기 비교에 들어가는 구현 비용을 줄일 수 있고, 공식 단가가 유리한 후보부터 살펴보면 비용 민감한 작업의 출발점을 정하기 쉽다는 판단입니다. 모델을 바꾸는 편익은 결과물까지 확인한 뒤 결정해야 합니다.
두 모델을 함께 쓰는 것도 가능합니다. 다만 “Claude가 설계하고 GPT가 구현한다”는 역할을 처음부터 고정할 근거는 부족합니다. 먼저 한 작업을 각각 끝까지 처리하게 해서 차이를 확인한 다음, 설계 검토나 짧은 반복 수정처럼 분리해도 결과를 검증할 수 있는 구간만 나누세요. 두 번째 모델에 문맥을 다시 전달하는 비용과 인계 중 누락되는 조건도 포함해야 합니다.
API 제공 상태와 모델 이름을 정확히 구분하기
| 항목 | GPT-5.5 | Claude Opus 4.7 |
|---|---|---|
| 기본 API 모델 ID | gpt-5.5 | claude-opus-4-7 |
| 버전을 고정할 때 | gpt-5.5-2026-04-23 | 날짜 없는 claude-opus-4-7 자체가 고정 버전 |
| 공식 API | Responses, Chat Completions, Batch | Claude Messages API, Message Batches API |
| 입력과 출력 | 텍스트·이미지 입력, 텍스트 출력 | 텍스트·이미지 입력, 텍스트 출력 |
| 공개 컨텍스트 창 | 1,050,000토큰 | 1,000,000토큰 |
| 일반 요청 최대 출력 | 128,000토큰 | 128,000토큰 |
| 현재 제공 상태의 주의점 | 제품 화면의 10월 14일 종료가 API 종료를 뜻하지 않음 | Active (legacy)이며 종료된 모델이 아님 |
출처: GPT-5.5 사양, Opus 4.7 사양, Claude 모델 ID와 버전.
큰 컨텍스트 창이 있다는 이유로 입력을 최대치까지 채운 뒤 최대 출력도 별도로 받을 수 있다고 가정하면 안 됩니다. 입력 외에 생성되는 추론과 결과가 들어갈 공간을 남겨야 합니다. 두 모델이 이미지 입력을 받는다는 사실도 같은 화면에서 같은 오류를 발견한다는 품질 보장은 아닙니다.
Anthropic의 legacy는 해당 모델이 더 이상 업데이트를 받지 않고 나중에 사용 중단 대상으로 지정될 수 있다는 뜻입니다. Opus 4.7의 표기상 종료는 2027년 4월 16일보다 이르지 않으며, 확정 종료일은 아닙니다. 이 일정은 Anthropic이 운영하는 Claude API·Claude Platform on AWS·Microsoft Foundry에 적용되고, Amazon Bedrock과 Google Cloud는 자체 일정을 정할 수 있습니다. 공식 모델 수명 주기
GPT-5.5, GPT-5.5 Pro, Claude Opus 4.7, Claude Opus 5.5는 서로 다른 모델입니다. ChatGPT와 Claude는 제품 이름이며, Claude Pro·Max 같은 구독 플랜도 모델 이름이 아닙니다. 숫자 5.5가 같다는 이유로 GPT-5.5와 Opus 5.5를 같은 후보로 취급하거나, Opus 4.7이 자동으로 후속 버전으로 바뀐다고 생각하면 비교 대상이 달라집니다.
API 가격: 출력 단가와 272K 초과 요금을 함께 보기
아래는 각 제공자에게 직접 사용하는 Standard API의 백만 토큰당 미국 달러 가격입니다. 구독료, 중개 서비스 청구액, 세금, 도구별 추가 요금은 포함하지 않습니다.
| 과금 항목 | GPT-5.5 입력 272K 이하 | GPT-5.5 입력 272K 초과 | Opus 4.7 전체 1M 컨텍스트 |
|---|---|---|---|
| 캐시되지 않은 입력 | 5달러 | 10달러 | 5달러 |
| 캐시 적중 입력 | 0.50달러 | 1달러 | 0.50달러 |
| 출력 | 30달러 | 45달러 | 25달러 |
| 캐시 쓰기 | 별도 추가 요금 없음 | 별도 추가 요금 없음 | 5분: 6.25달러, 1시간: 10달러 |
출처: OpenAI 가격표, GPT-5.5 장문 요금 조건, Anthropic 가격표.
GPT-5.5는 입력이 272K를 초과하면 Standard·Batch·Flex의 전체 세션에 입력 2배, 출력 1.5배 요금이 적용됩니다. 초과분만 비싸지는 계산이 아닙니다. 반면 Opus 4.7은 전체 1M 컨텍스트를 기본 단가로 제공하므로, 예전 Claude 모델처럼 200K를 넘으면 별도 장문 할증이 붙는다고 계산하면 안 됩니다.
출력 단가만 비교하면 Opus 4.7의 25달러는 GPT-5.5의 30달러보다 약 16.7% 낮습니다. 하지만 완성된 작업의 비용은 생성량과 성공률에도 달려 있습니다. GPT-5.5 입력이 272K 이하이고 양쪽 입력 비용이 같다고 가정할 때, GPT-5.5의 출력 토큰이 Opus의 5/6보다 적으면, 더 높은 출력 단가를 토큰 사용량으로 상쇄할 수 있습니다. 실제로 그런 절감이 발생하는지는 작업별 사용량으로 확인해야 합니다.
같은 토큰 수를 가정하면 비용은 얼마나 다를까
| 가정한 단일 요청 | GPT-5.5 Standard | Opus 4.7 Standard |
|---|---|---|
| 캐시 없는 입력 20,000토큰 + 출력 8,000토큰 | 0.10 + 0.24 = 0.34달러 | 0.10 + 0.20 = 0.30달러 |
| 캐시 없는 입력 300,000토큰 + 출력 12,000토큰 | 3.00 + 0.54 = 3.54달러 | 1.50 + 0.30 = 1.80달러 |
위 계산의 출력은 눈에 보이는 문장뿐 아니라 과금되는 전체 생성 토큰을 뜻합니다. 지역 할증·캐시·도구·재시도는 제외했고, 동일한 문서가 두 제공자에서 동일한 토큰 수로 계산된다고 보장하지 않습니다. 가격표의 차이를 이해하기 위한 예시입니다. 적용 단가는 OpenAI와 Anthropic의 Standard 요금입니다.
여러 요청과 수정이 필요한 작업이라면 각 요청의 비용을 합산해야 합니다. 실무 지표는 다음처럼 잡을 수 있습니다.
채택된 결과 한 건당 비용 = 비교 기간의 모델·도구·재시도 비용 합계 ÷ 채택된 결과 수
사람의 검토 시간을 돈으로 환산할 기준이 있다면 그 비용도 분자에 더합니다. 실패 요청을 제외한 성공 요청 평균만 보면 실제 운영 비용을 낮게 잡게 됩니다. 저렴한 첫 응답보다 수정 없이 채택할 수 있는 응답이 유리한 경우를 이 지표로 구분할 수 있습니다.
캐시, Batch, 지역 설정이 계산을 바꾸는 경우
GPT-5.5의 프롬프트 캐시는 자동 방식이고 명시적 캐시 분기점을 지원하지 않습니다. 공통 문서와 지침을 앞쪽에 유지하고 안정적인 prompt_cache_key를 사용하면 재사용을 돕습니다. 지원되는 유지 설정은 prompt_cache_retention: "24h"이며, 문서상 캐시 수명은 보통 약 30분에서 최대 24시간입니다. 24시간 동안 반드시 적중한다는 보장은 아닙니다. 최신 모델의 캐시 쓰기 할증이나 최소 1,024토큰 규칙을 GPT-5.5에 그대로 적용하지 마세요. 모델별 캐시 차이
Opus 4.7은 캐시 쓰기와 읽기가 별도 과금됩니다. 문서를 캐시에 처음 넣는 비용까지 계산하고, 후속 요청에서 실제 읽기 토큰이 보고되는지 보세요. effort나 thinking 설정을 바꾸면 캐시를 공유하던 접두부가 달라질 수 있습니다. Claude 캐시 요금, 캐시와 thinking 설정
비동기 처리에 맞는 작업은 Batch도 후보입니다. GPT-5.5의 짧은 입력 기준 Batch·Flex 단가는 입력 2.50달러, 캐시 적중 0.25달러, 출력 15달러이고, 긴 입력은 각각 5달러·0.50달러·22.50달러입니다. Opus 4.7 Batch는 입력 2.50달러·출력 12.50달러입니다. Batch와 Flex는 같은 실행 방식이나 대기 시간 계약이 아니므로, 가격이 같다고 서로 대체 가능한 것으로 보면 안 됩니다. OpenAI 처리 방식별 가격, Claude Batch 가격
GPT-5.5 Fast는 짧은 입력 기준 입력 12.50달러·캐시 적중 1.25달러·출력 75달러로 비용이 높고, Opus 4.7은 Fast를 지원하지 않습니다. 지역 처리도 확인하세요. GPT-5.5의 지역 처리 엔드포인트는 10% 할증이며, Claude API에서 Opus 4.7을 inference_geo: "us"로 요청하면 모든 토큰 과금 항목에 1.1배가 적용됩니다. Claude의 기본 global은 표준 요금이며, 제휴 클라우드 요금은 별도로 확인해야 합니다. OpenAI 모델 조건, Anthropic 처리 지역과 Fast 조건
코딩 에이전트는 effort와 응답 처리를 따로 맞춰야 한다
두 API의 같은 high라는 단어가 같은 추론량을 뜻하지 않습니다. 먼저 문서상 설정으로 출발한 뒤 같은 작업에서 결과와 비용을 비교하세요.
| 설정 | GPT-5.5 Responses | Opus 4.7 Messages |
|---|---|---|
| effort 필드 | reasoning.effort | output_config.effort |
| 지원 값 | none, low, medium, high, xhigh | low, medium, high, xhigh, max |
| 기본 effort | medium | high |
| 추론 제어 | reasoning effort 사용 | thinking은 기본 off, 켜려면 {"type": "adaptive"} |
| 한 요청의 생성 한도 | max_output_tokens | max_tokens |
출처: GPT-5.5 사용 안내, Claude effort, 모델별 thinking 지원.
GPT-5.5는 medium을 균형 잡힌 시작점으로 사용하고, 어려운 작업에서 실제 개선이 확인될 때 high나 xhigh로 올리는 것이 공식 안내입니다. Opus 4.7은 코딩·에이전트 작업에 xhigh부터 평가하도록 권장하며 기본값은 high입니다. xhigh·max에서는 요청당 충분한 생성 공간을 남겨야 하고, Anthropic은 64K부터 조정하는 방법을 제시합니다. 이 권장값은 청구액의 상한이 아닙니다. 각 모델의 안내
기존 Claude 코드에서 thinking: {"type": "enabled", "budget_tokens": ...}를 그대로 보내면 Opus 4.7은 400 오류로 거부합니다. adaptive thinking으로 바꾸고 effort를 별도로 정하세요. temperature도 기본값만 허용되므로 다른 모델의 샘플링 설정을 그대로 옮기지 않는 편이 맞습니다. Claude API 설정과 변경 조건
두 공식 SDK로 같은 문서 작업 요청하기
아래는 공식 문서의 인터페이스에 맞춘 Python 예시입니다. 실행한 비교 결과는 아닙니다. 각 예시의 전제는 해당 공식 SDK가 설치되어 있고, 서버 환경에서 OPENAI_API_KEY 또는 ANTHROPIC_API_KEY가 설정되어 있으며, 해당 모델을 사용할 권한과 API 잔액·한도가 있다는 것입니다. 키를 브라우저 코드나 공개 저장소에 넣으면 안 됩니다. SDK 준비 방법은 OpenAI 시작 문서와 Claude 시작 문서에서 확인할 수 있습니다.
먼저 GPT-5.5에 짧은 배포 메모의 필수 조건을 보존하는 요약을 요청합니다.
from openai import OpenAI

client = OpenAI()
source_note = """
다음 배포는 금요일 22시에 시작합니다.
결제 기능은 이번 배포에 포함하지 않습니다.
오류율이 1%를 넘으면 이전 버전으로 되돌립니다.
"""
prompt = (
    "다음 배포 메모를 한국어 세 문장으로 요약하세요. "
    "시각, 제외 기능, 되돌리는 조건을 모두 보존하고 새 사실은 추가하지 마세요.\n"
    + source_note
)

response = client.responses.create(
    model="gpt-5.5-2026-04-23",
    input=prompt,
    reasoning={"effort": "medium"},
    text={"verbosity": "low"},
    max_output_tokens=16000,
)

if response.status != "completed":
    raise RuntimeError(
        f"응답 미완료: {response.status}, {response.incomplete_details}"
    )
if not response.output_text.strip():
    raise RuntimeError("완성된 텍스트가 없습니다.")

print(response.output_text)
print(response.usage.model_dump())
같은 과제의 Opus 4.7 요청은 Messages 형식으로 작성합니다. 여기서는 기본 effort인 high를 명시하고 adaptive thinking을 켭니다. 실제 코딩 에이전트의 xhigh 설정과는 구분한 작은 문서 작업 예시입니다.
import anthropic

client = anthropic.Anthropic()
source_note = """
다음 배포는 금요일 22시에 시작합니다.
결제 기능은 이번 배포에 포함하지 않습니다.
오류율이 1%를 넘으면 이전 버전으로 되돌립니다.
"""
prompt = (
    "다음 배포 메모를 한국어 세 문장으로 요약하세요. "
    "시각, 제외 기능, 되돌리는 조건을 모두 보존하고 새 사실은 추가하지 마세요.\n"
    + source_note
)

message = client.messages.create(
    model="claude-opus-4-7",
    max_tokens=16000,
    thinking={"type": "adaptive"},
    output_config={"effort": "high"},
    messages=[{"role": "user", "content": prompt}],
)

if message.stop_reason != "end_turn":
    raise RuntimeError(f"응답 종료 상태 확인 필요: {message.stop_reason}")
answer = "\n".join(
    block.text for block in message.content if block.type == "text"
)
if not answer.strip():
    raise RuntimeError("완성된 텍스트가 없습니다.")

print(answer)
print(message.usage.model_dump())
원래 API가 다르므로 모델 이름만 바꿔서 같은 클라이언트로 호출할 수는 없습니다. 위 예시는 Responses의 output_text와 Messages의 유형별 content 처리를 구분합니다. Messages 응답에서 첫 블록이 항상 텍스트라고 가정하면 thinking이나 도구 블록을 잘못 읽을 수 있습니다. 후속 대화에서는 Messages에 필요한 대화 이력을 명시적으로 보내고, 도구 사용 중에는 필요한 thinking 블록도 보존해야 합니다. Claude API 기본 요청과 대화
사용량은 과금 항목별로 읽으세요. Responses의 usage.input_tokens_details.cached_tokens는 전체 입력에 포함된 캐시 적중량이고, usage.output_tokens_details.reasoning_tokens는 전체 출력에 포함된 추론량입니다. 추론을 출력에 다시 더하거나 total_tokens 전부에 출력 단가를 곱하면 중복·오계산입니다. Claude는 일반 입력, 캐시 생성, 캐시 읽기와 출력 사용량을 각각 구분합니다. OpenAI 추론 사용량, Claude 사용량과 가격
API 응답이 정상 종료되어도 요약이 조건을 누락할 수 있습니다. 위 과제라면 금요일 22시, 결제 기능 제외, 오류율 1% 초과 시 되돌리기라는 세 조건이 그대로 남았는지 확인해야 합니다. API 성공 여부와 결과물 채택 여부를 별도로 기록하는 이유입니다.
생성 한도와 작업 예산은 같은 기능이 아니다
GPT-5.5의 max_output_tokens에는 추론·보이는 출력·보이지 않는 형식 토큰이 포함됩니다. 한도를 소진하면 incomplete가 반환될 수 있고, 답변 텍스트 없이 입력과 추론 비용만 발생할 수도 있습니다. Opus 4.7의 max_tokens도 thinking과 텍스트·도구 출력에 쓰이는 요청당 생성 한도이며, 도달하면 stop_reason: "max_tokens"를 확인해야 합니다. OpenAI 생성 한도, Claude 중단 원인
Opus 4.7의 Task Budgets는 여러 요청에 걸친 에이전트 작업에 목표를 주는 beta 기능입니다. task-budgets-2026-03-13 헤더가 필요하고 task_budget.total의 최소값은 20,000토큰입니다. 이 값은 권고 예산이라 초과할 수 있으며, 전체 작업의 강제 비용 상한이 아닙니다. 모델이 보는 남은 예산은 usage에 반환되지 않고, 매 요청에 다시 보내는 전체 이력의 과금량과도 일치하지 않을 수 있습니다. Claude Code·Cowork 화면의 기능으로 가정하지 마세요. Task Budgets 공식 범위
따라서 운영에서는 요청별 생성 한도와 함께 클라이언트가 허용하는 요청 횟수·도구 호출·재시도·총 소요 시간을 관리해야 합니다. 이는 여러 요청을 합친 비용을 통제하기 위한 구현 판단입니다. 한 요청의 토큰 한도를 크게 잡는 것만으로 무한 재시도나 외부 도구 비용을 막을 수는 없습니다.
벤치마크와 속도는 설정·완료 시간을 같이 읽기
2026년 10월 13일 확인한 Artificial Analysis 비교는 GPT-5.5 High와 Opus 4.7 Max를 대상으로 합니다. Intelligence Index v4.3.2에서 GPT-5.5는 37, Opus 4.7은 41이지만, Opus의 41은 독립 평가가 예정된 추정값입니다. 이를 확정된 종합 승리로 해석할 수 없습니다.
같은 페이지의 출력 속도는 GPT-5.5 약 88토큰/초, Opus 4.7 약 51토큰/초입니다. 반면 첫 토큰 대기는 각각 30.53초·23.57초이고, 500토큰 응답의 전체 시간은 36.20초·33.38초입니다. 출력 속도는 첫 응답 조각을 받은 뒤의 생성 속도이며, 전체 시간에는 추론 대기도 포함됩니다. 빠르게 토큰을 생성하는 모델이 짧은 답변을 먼저 끝내는 모델과 같지는 않습니다. 이 수치는 해당 설정과 측정 방식의 결과이며 서비스 응답 시간 보장이 아닙니다. 측정값과 방법 설명
한국어 비교 글에서 언급되는 “출력 토큰 72% 절감”, “3.5배 저렴”, “프런트엔드는 Claude, 자동화는 GPT” 같은 일반화만으로 예산이나 역할을 확정하지 마세요. 실제 토큰 절감, 화면 오류 발견, 보안 검토 품질은 사용한 입력·도구·설정·검증 기준에 따라 달라집니다. 4월의 Terminal-Bench 2.0 결과와 현재의 다른 버전 측정값을 한 표에 섞어서도 안 됩니다.
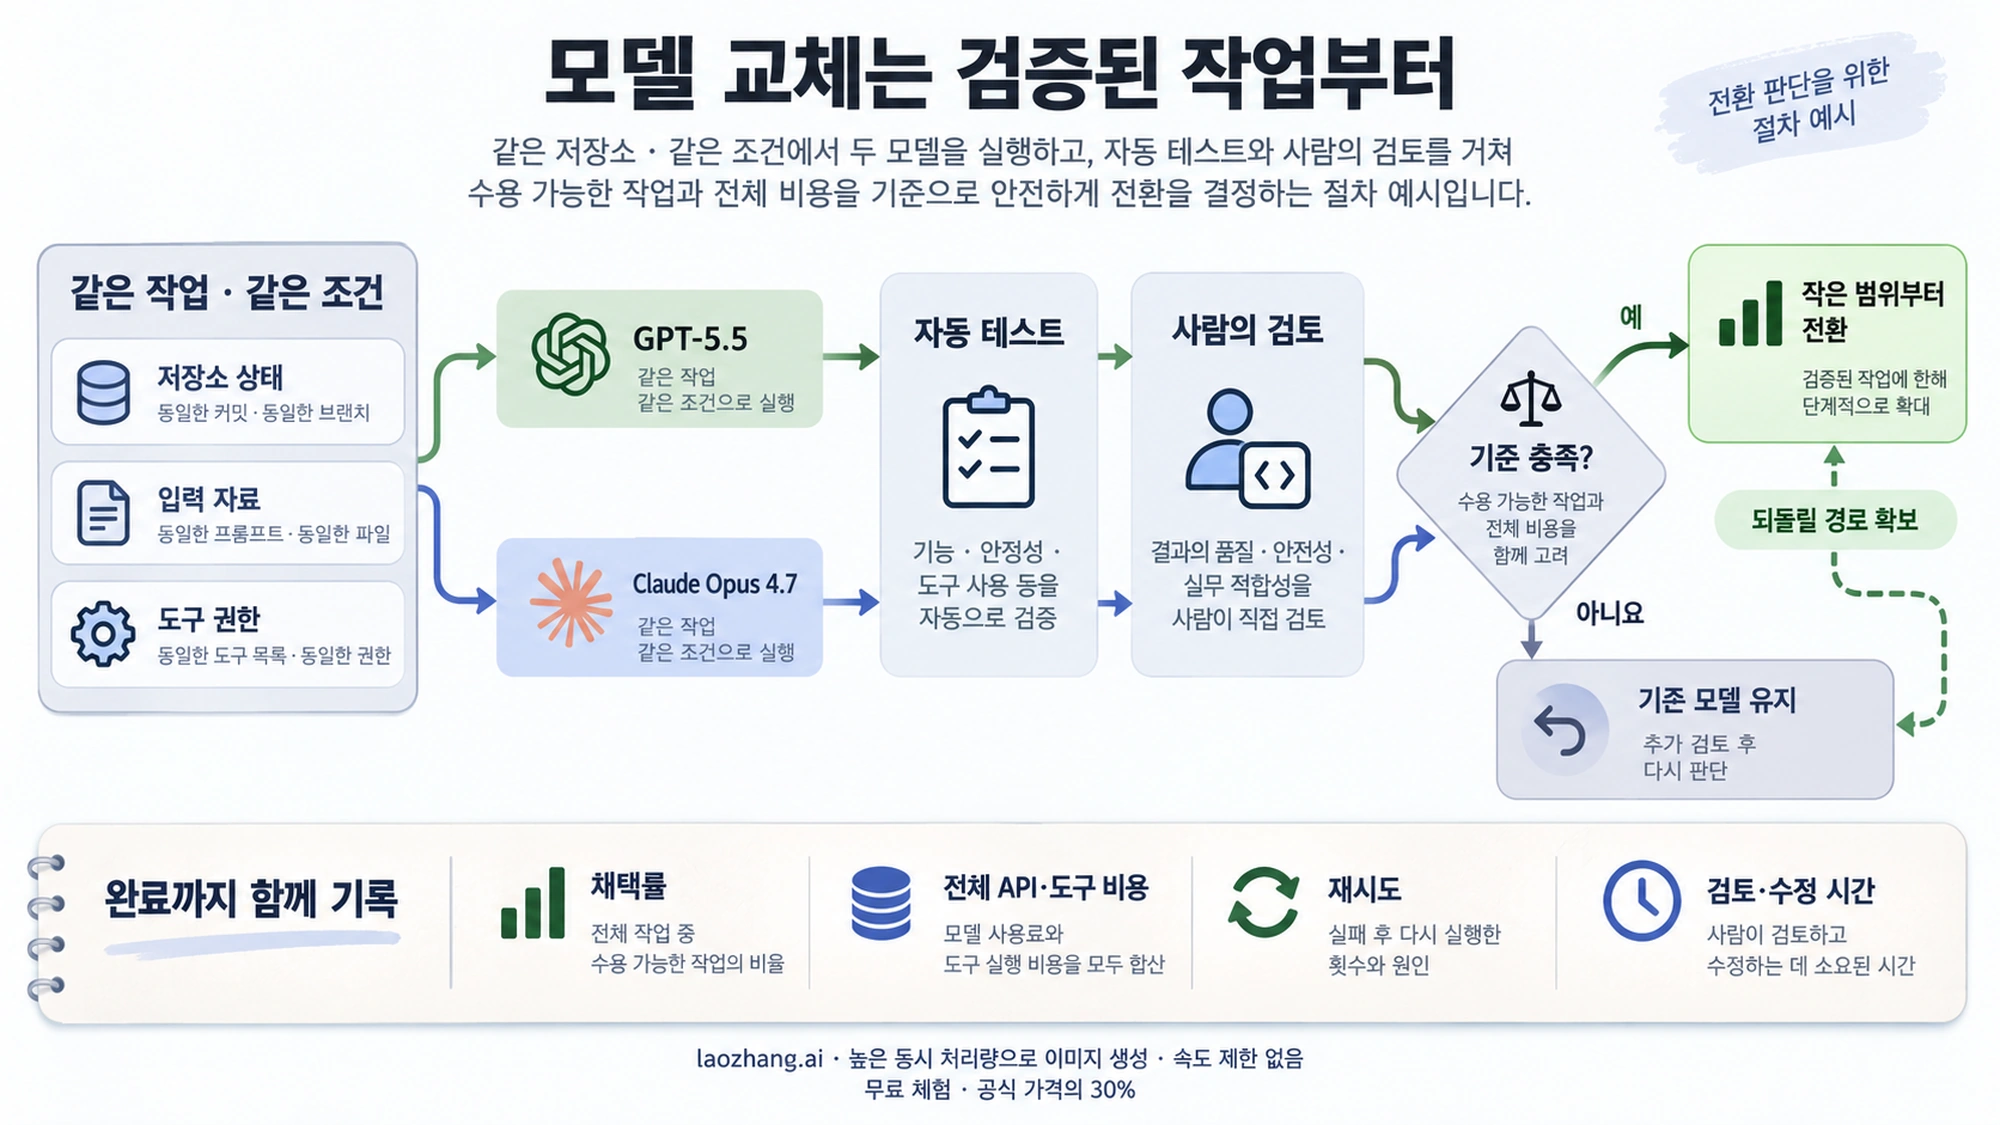
코딩이라면 같은 저장소 상태, 같은 변경 요청, 같은 도구 권한과 테스트를 사용하세요. 문서 작업이라면 빠뜨리면 안 되는 조건과 원문 근거를 정하고, 두 결과를 같은 기준으로 검토합니다. 최종 선택에 필요한 기록은 첫 시도 성공률, 채택까지 걸린 시간, 전체 API·도구 비용, 사람의 검토·수정 시간입니다. 어려운 사례와 긴 입력은 따로 묶어 평균이 실패 구간을 가리지 않게 하는 편이 좋습니다.
기본 모델을 바꾸는 기준도 미리 정하세요. 예를 들어 중요한 테스트나 필수 문서 조건을 충족하지 못하면 채택하지 않고, 기존 모델로 되돌릴 수 있도록 유지합니다. “새 모델이니까 교체한다”보다 어떤 작업에서 실패와 비용이 줄었는지 설명할 수 있는 전환이 유지보수하기 쉽습니다.
자주 묻는 질문
GPT-5.5 API는 지금 사용할 수 있나요? 10월 14일에 끝나나요?
API는 현재 제공됩니다. gpt-5.5 또는 고정 버전 gpt-5.5-2026-04-23을 사용하며, 2026년 10월 14일 종료는 ChatGPT·ChatGPT Work·Codex에 적용되고 OpenAI API에는 적용되지 않습니다. 다만 모델 제공 사실이 개인 계정의 권한·잔액·한도를 보장하지는 않습니다. 모델 문서, 종료 공지
Claude Opus 4.7은 legacy라서 더 이상 쓸 수 없나요?
사용할 수 있습니다. 현재 모델 문서는 Active (legacy), 수명 주기 표는 Active로 표시하며, Anthropic 운영 플랫폼의 종료는 2027년 4월 16일보다 이르지 않다고 안내합니다. 확정 종료 날짜가 아니고 제휴 클라우드 일정은 다를 수 있습니다. Opus 4.7 제공 상태, 수명 주기
코딩에는 GPT-5.5와 Opus 4.7 중 무엇이 더 좋은가요?
기존 API·도구 연동을 유지할 수 있는 후보부터 평가하는 것이 실용적입니다. GPT-5.5는 medium에서 시작해 필요에 따라 올리고, Opus 4.7은 공식 코딩 권장값인 xhigh도 비교하세요. 두 제공자의 같은 effort 이름은 동일한 계산량을 뜻하지 않으므로 테스트 통과율, 재시도, 검토 시간, 채택된 결과의 비용을 함께 봐야 합니다. GPT-5.5 안내, Opus 4.7 effort 안내
Opus 4.7은 입력 200K를 넘으면 더 비싼가요?
현재 공식 가격표에서는 그렇지 않습니다. Opus 4.7은 전체 1M 컨텍스트에 Standard 입력 5달러·출력 25달러/백만 토큰을 적용합니다. GPT-5.5는 입력 272K 초과 시 Standard 입력 10달러·출력 45달러로 올라가며 전체 세션에 적용됩니다. 캐시·처리 방식·지역 설정은 별도로 계산해야 합니다. Anthropic 장문 요금, GPT-5.5 조건
무료로 비교하거나 Claude 구독료 안에서 API를 쓸 수 있나요?
GPT-5.5 모델 문서는 API Free tier를 지원하지 않는다고 표시합니다. 일반 시작 문서의 무료 테스트 안내만으로 GPT-5.5 무료 할당량이 있다고 가정하면 안 됩니다. GPT-5.5 사용 등급
Claude Max·Team에는 조건부 월간 API 크레딧이 있습니다. Max 5x는 100달러, Max 20x는 200달러이며, Team은 Standard 좌석당 20달러·Premium 좌석당 100달러를 팀 전체 월 500달러 한도 안에서 합칩니다. 활성 구독 7일과 필요한 역할·조직 연결 등의 조건이 있고, Free·Pro·Enterprise는 대상이 아닙니다. 크레딧은 청구 주기에 만료되며 대화형 Claude Code나 제휴 클라우드 사용을 대신 결제하지 않습니다. 실제 계정의 표시·연결·잔액을 확인해야 하며, 무제한 API가 아닙니다. 공식 월간 API 크레딧 조건
GPT-5.5 Pro나 Claude Opus 5.5도 같은 비교인가요?
별도 후보입니다. gpt-5.5-pro는 Responses·Batch를 지원하는 고가 변형으로, 짧은 입력 Standard 기준 입력 30달러·출력 180달러/백만 토큰이고 캐시 입력 할인이 없습니다. Claude Opus 5.5는 Opus 4.7의 후속 모델이며 GPT-5.5 Pro나 Claude Pro 구독과는 다릅니다. 본문의 가격과 설정을 다른 모델에 그대로 적용하지 마세요. GPT-5.5 Pro, OpenAI 가격표, Opus 4.7과 현재 모델군
이미 Opus 4.6을 쓰고 있다면 이 비교부터 봐야 하나요?
OpenAI로 이동할지도 함께 판단한다면 이 두 모델 비교가 맞습니다. Anthropic 안에서 4.6과 4.7의 차이만 판단한다면 Opus 4.6에서 4.7로 바뀐 점을 다룬 출시 당시 비교를 참고할 수 있습니다. 해당 글은 2026년 4월 기준의 비교이므로 현재 제공 상태·가격·설정은 이 글의 공식 문서 링크로 다시 확인하세요.
참고 자료19
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 13일.
참고 자료19
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 13일.
- 1.GPT-5.5 모델 문서developers.openai.com/api/docs/models/gpt-5.5
- 2.Opus 4.7 모델 문서platform.claude.com/docs/en/models/opus-4-7/overview
- 3.공식 종료 공지learn.chatgpt.com/docs/models
- 4.Claude 모델 ID와 버전platform.claude.com/docs/en/about-claude/models/model-ids-and-versions
- 5.공식 모델 수명 주기platform.claude.com/docs/en/about-claude/model-deprecations
- 6.OpenAI 가격표developers.openai.com/api/docs/pricing
- 7.Anthropic 가격표platform.claude.com/docs/en/about-claude/pricing
- 8.모델별 캐시 차이developers.openai.com/api/docs/guides/prompt-caching
- 9.캐시와 thinking 설정platform.claude.com/docs/en/build-with-claude/thinking-troubleshooting
- 10.GPT-5.5 사용 안내developers.openai.com/api/docs/guides/latest-model
- 11.Claude effortplatform.claude.com/docs/en/build-with-claude/effort
- 12.Claude API 설정과 변경 조건platform.claude.com/docs/en/claude_api_primer
- 13.OpenAI 시작 문서developers.openai.com/api/docs/quickstart
- 14.Claude 시작 문서platform.claude.com/docs/en/get-started
- 15.OpenAI 추론 사용량developers.openai.com/api/docs/guides/reasoning
- 16.Task Budgets 공식 범위platform.claude.com/docs/en/build-with-claude/task-budgets
- 17.Artificial Analysis 비교artificialanalysis.ai/models/comparisons/gpt-5-5-high-vs-claude-opus-4-7
- 18.공식 월간 API 크레딧 조건support.claude.com/en/articles/17154008-monthly-api-credits-for-max-and-team-plans
- 19.GPT-5.5 Prodevelopers.openai.com/api/docs/models/gpt-5.5-pro