16GB VRAM 로컬 코딩 LLM 선택법: gpt-oss, Qwen3.8-27B, Gemma 4 12B
16GB VRAM 로컬 코딩 LLM은 gpt-oss-20b가 기준, 긴 컨텍스트는 Gemma 4 12B, 고급 실험은 Qwen3.8-27B 3bit입니다. Ollama는 4k 기본값부터 늘리세요.
목차
2026년 10월 22일 기준으로 16GB VRAM에서 코딩용 로컬 LLM을 고르는 순서는 이렇습니다. 기준은 gpt-oss-20b, 컨텍스트 여유가 필요하면 Gemma 4 12B, 품질을 더 밀어 보고 싶으면 Qwen3.8-27B의 3bit GGUF입니다. 2026년 7월 판에서 고급 경로였던 Qwen3.6 35B A3B와 가벼운 경로였던 Gemma 4 E4B는 각각 Qwen3.8-27B(8월 5일 공개)와 Gemma 4 12B에 앞자리를 넘겼습니다.
모델 이름만으로는 판단이 되지 않습니다. "모델 + 양자화 파일 + 컨텍스트 길이"를 한 세트로 정하고, 가중치 파일 크기에 그 컨텍스트의 KV 캐시를 더해 16GB 안에 들어가는지 봐야 합니다. 아래의 VRAM 숫자는 모두 Hugging Face 파일 크기와 각 모델의 config.json 설정값으로 계산한 값이며, 실행 중에 측정한 최대 사용량이 아닙니다.
Ollama를 쓴다면 하나를 먼저 바꿔야 합니다. Ollama 컨텍스트 길이 문서에 따르면 VRAM이 24 GiB 미만일 때 기본 컨텍스트는 4k이고, 에이전트와 코딩 도구에는 최소 64000 토큰을 권장합니다. 16GB 카드를 그대로 두면 코딩 도구가 앞에서 읽은 파일을 잊는 이유가 여기 있습니다.
빠른 결론: 모델 순위보다 경로가 먼저다
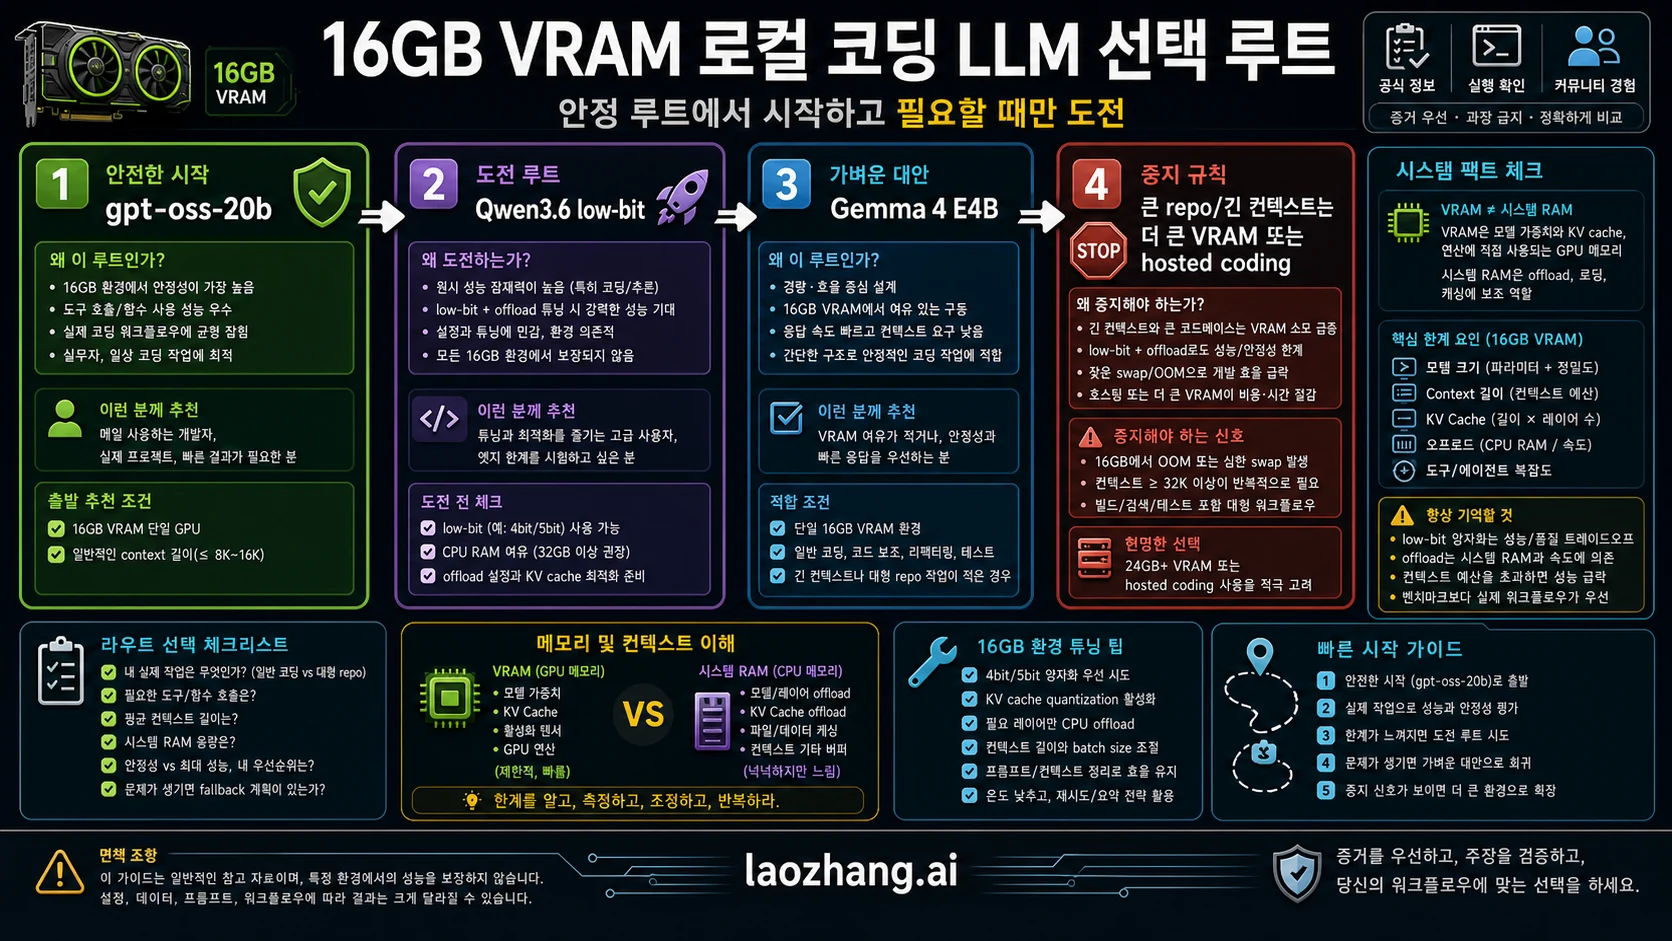
그림은 2026년 7월 기준 경로 표기입니다. 현재 선택은 아래 표를 기준으로 보세요.
16GB에서 필요한 것은 순위표가 아니라 무엇을 먼저 설치하고, 무엇을 조건부로 실험하고, 어디서 멈출지 정하는 결정표입니다. 크기와 합계는 양자화 파일 이름과 함께 적었습니다.
| 경로 | 먼저 시도할 모델과 파일 | 16GB에 맞는 이유 | 주요 위험 | 다음 행동 |
|---|---|---|---|---|
| 기준 | gpt-oss-20b, MXFP4 GGUF 12.11 GB (Ollama gpt-oss:20b 14GB) | 후보 중 제조사가 "16GB of memory"를 직접 적은 유일한 모델. 64K KV 포함 약 12.8 GiB(계산) | 큰 저장소 전체를 맡기는 에이전트 작업까지 기대하면 안 됨 | 컨텍스트를 64000으로 올리고 smoke test |
| 컨텍스트 여유 | Gemma 4 12B, Google 공식 QAT Q4_0 GGUF 6.98 GB | 128K에서도 약 8.8 GiB(계산 상한). Google 표 기준 LiveCodeBench v6 72.0% | Google 표에 저장소 단위 에이전트 코딩 점수는 없음 | 긴 파일·로그를 넣는 작업에 사용 |
| 고급 실험 | Qwen3.8-27B, Unsloth UD-Q3_K_XL GGUF 13.15 GB | q8_0 KV 32K 포함 약 13.3 GiB(계산) | Ollama 기본 태그 qwen3.8:27b는 18GB라 안 들어감. 제조사 점수는 3bit에 그대로 옮겨지지 않음 | 3bit 파일을 직접 지정하고 32K부터 |
| MoE 오프로드 | Qwen3.6 35B A3B, UD-Q4_K_M 22.13 GB 또는 UD-IQ3_XXS 13.21 GB | 전문가 가중치를 시스템 메모리에 둘 수 있음 | 시스템 메모리로 내린 만큼 느려짐 | 램이 넉넉할 때만 --n-cpu-moe |
| 코드 특화 | Devstral Small 2 24B, IQ4_XS 12.78 GB 또는 Q3_K_M 11.47 GB | 에이전트형 코딩용 모델, Mistral 보고 SWE-bench Verified 68.0% | KV가 토큰당 160 KiB로 무거워 16K~32K가 한계 | 짧은 컨텍스트 작업에만 |
| 중단 | 24GB 이상 GPU, 더 작은 모델, 호스팅 코딩 | 긴 컨텍스트와 도구 루프는 16GB를 쉽게 넘김 | 조정에 개발 시간을 계속 씀 | 메모리 부족, 지연, 컨텍스트 손실에서 멈춤 |
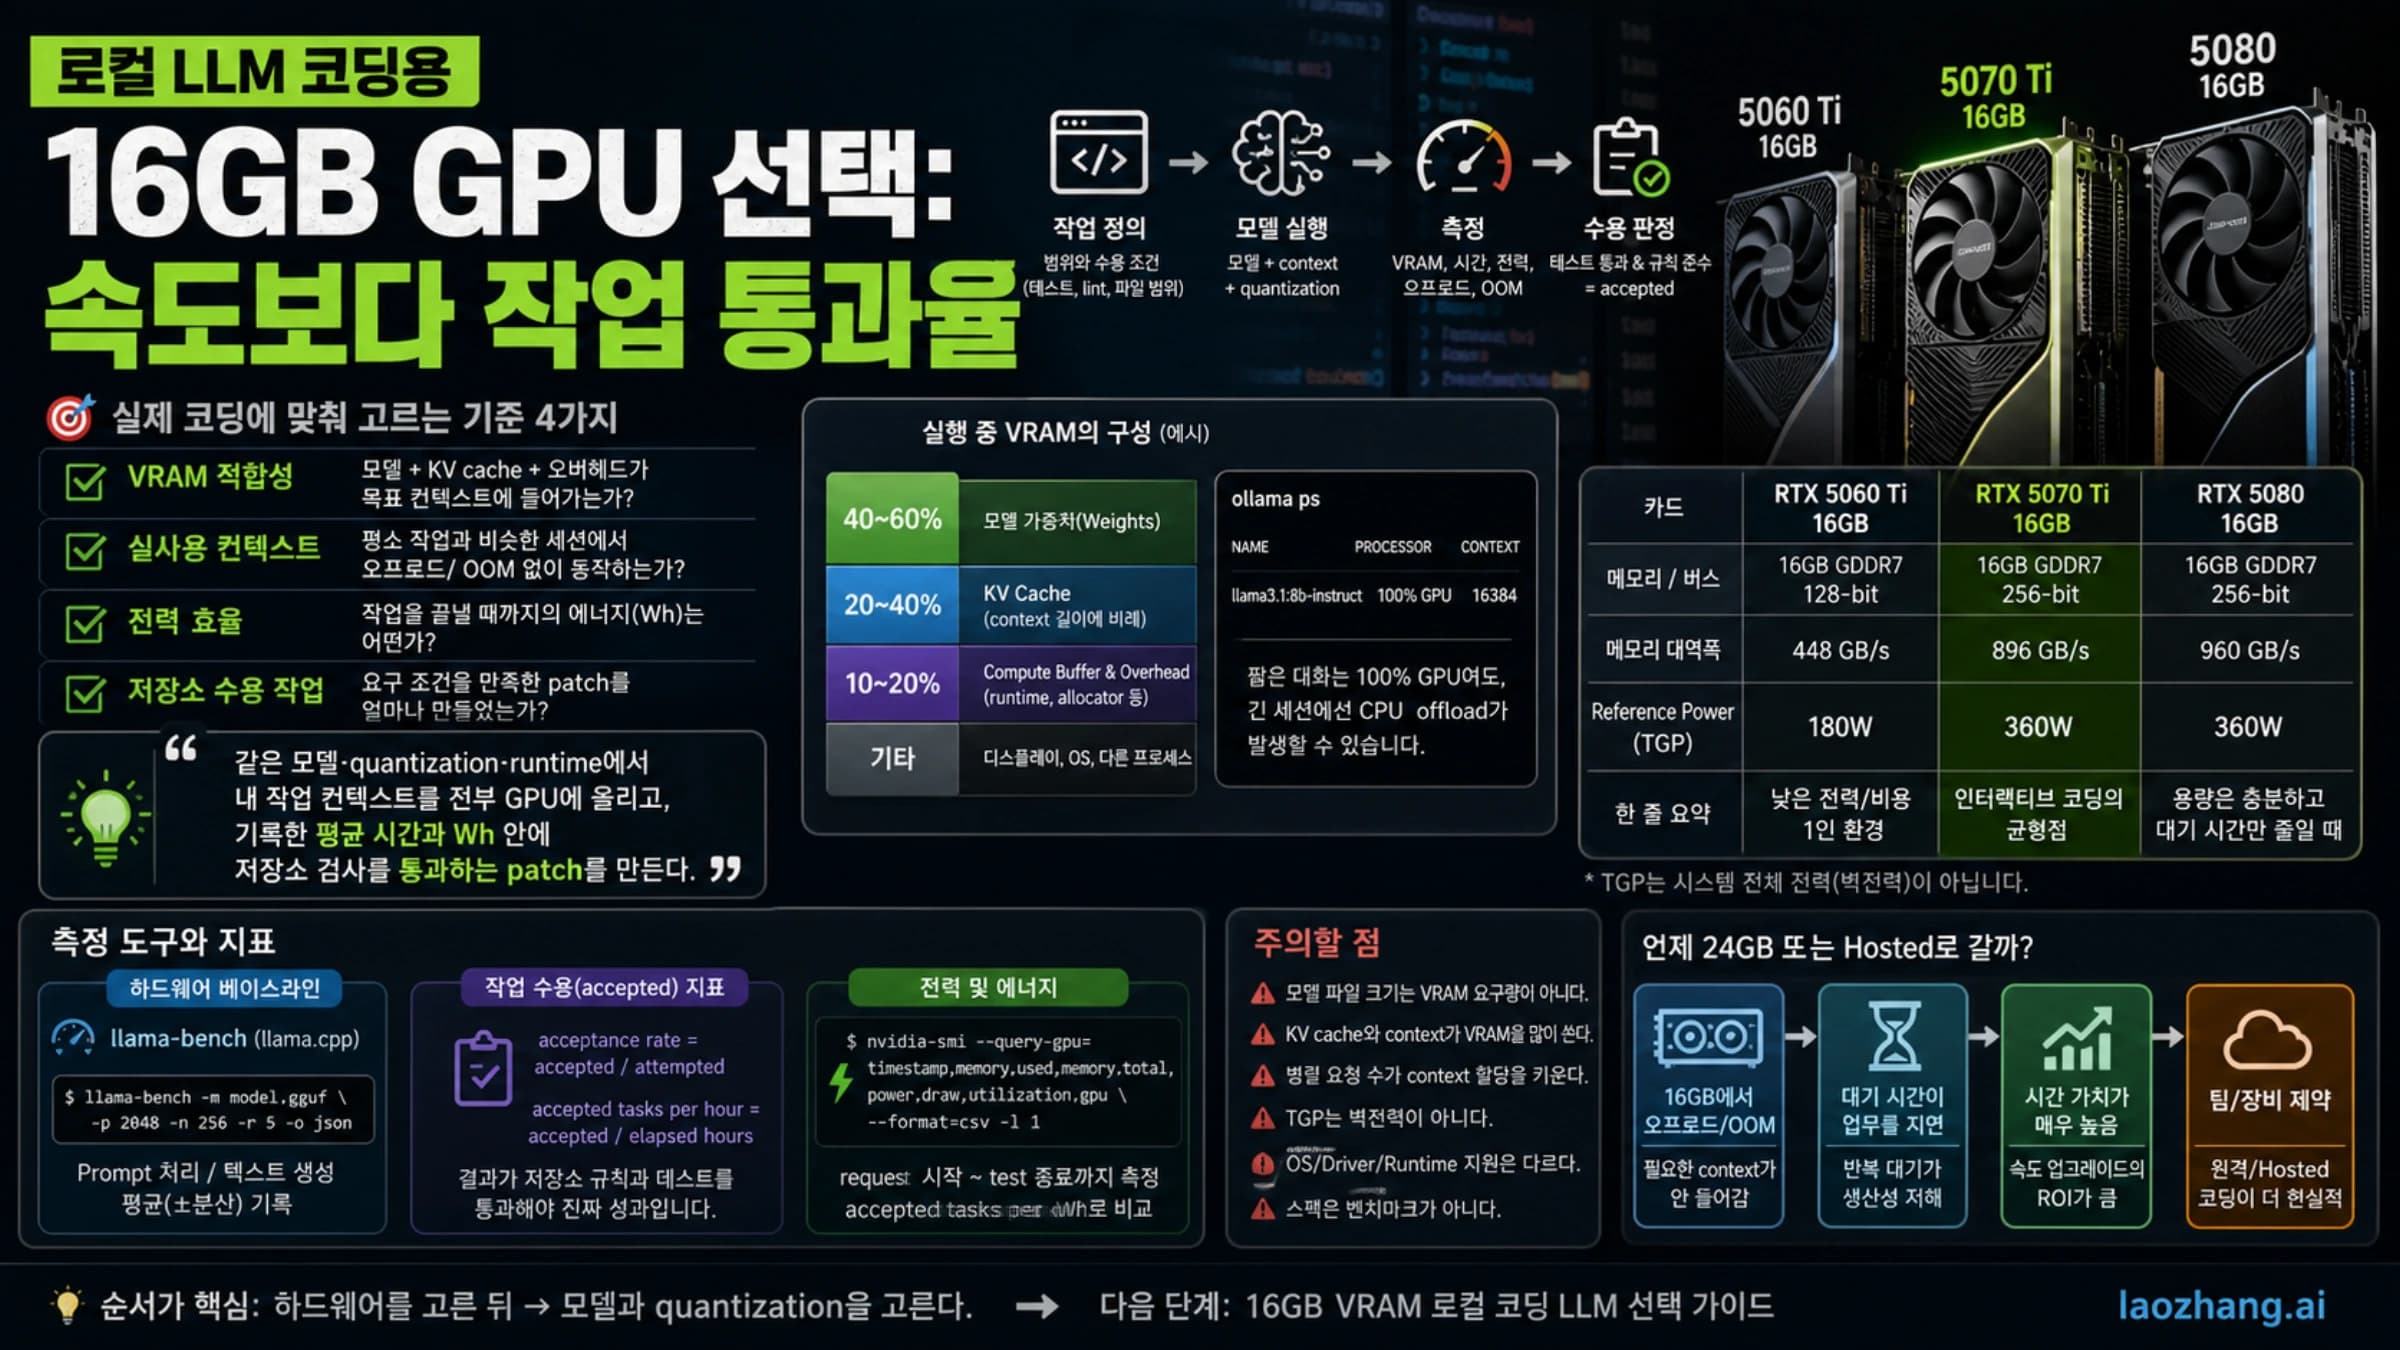
카드 자체를 고르는 단계라면 로컬 LLM 코딩용 16GB GPU 선택: 속도보다 작업 통과율을 먼저 보세요. 여기서는 16GB 카드가 이미 있다고 보고 모델과 파일을 정합니다.
2026년 7월 이후 바뀐 모델: 무엇이 무엇을 대체했나
7월 판에 있던 이름은 아직 검색되지만, 그중 둘은 앞자리가 바뀌었고 코드 특화 목록은 통째로 교체됐습니다. gpt-oss-20b만 그대로입니다.
| 7월 판 안내 | 지금 먼저 볼 모델 | 바뀐 이유 | 옛 모델이 아직 맞는 경우 |
|---|---|---|---|
| gpt-oss-20b (기준) | gpt-oss-20b 유지 | 이후 나온 작은 gpt-oss는 안전 분류기인 gpt-oss-safeguard-20b뿐 | 해당 없음 |
| Qwen3.6 35B A3B (고급 실험) | Qwen3.8-27B | 2026년 8월 5일 공개. Qwen 모델 카드의 코딩 표 전 항목에서 Qwen3.6-27B보다 높음 | 시스템 메모리가 넉넉하고 전문가 가중치를 CPU 쪽에 둘 때 |
| Gemma 4 E4B (가벼운 경로) | Gemma 4 12B | Google이 12B를 소비자 GPU용 크기로 분류. LiveCodeBench v6 72.0% 대 52.0% | 8GB 카드, 16GB 노트북·Mac |
| Qwen2.5-Coder, DeepSeek Coder, Qwen3-Coder-30B-A3B | Devstral Small 2 24B, Qwen3.6-27B | 에이전트형 코딩을 겨냥한 최신 오픈 모델 | 이미 그 모델로 검증된 작업 흐름이 있을 때 |
Gemma 4 12B는 2026년 5월 23일 Hugging Face에 올라온 크기라서 3월 출시 당시의 네 가지 크기(E2B, E4B, 26B A4B, 31B) 목록에는 없습니다. 지금 Gemma 4는 다섯 가지 크기입니다. 옛 Qwen3 MoE 계열의 Q4_K_M 패키지 크기는 Qwen3-30B-A3B 로컬 실행: 원본·2507·Coder 선택과 메모리에 정리돼 있습니다.
근거 경계: 공식, 실행 환경, 커뮤니티를 나눈다
공식 자료는 모델이 어떤 하드웨어를 겨냥했는지를 알려 줍니다. OpenAI gpt-oss-20b 모델 카드는 21B 파라미터(활성 3.6B), MXFP4로 학습 후 처리된 MoE 가중치, "within 16GB of memory"를 적고 있습니다. 후보 가운데 16GB라는 숫자를 제조사가 직접 쓴 것은 이것뿐입니다. 다만 "memory"라고 썼지 VRAM으로 한정하지는 않았습니다.
Google Gemma 4 12B 모델 카드는 E2B·E4B를 모바일·엣지용, 12B·26B A4B·31B를 소비자 GPU와 워크스테이션용으로 나눕니다. 12B는 11.95B 파라미터, 컨텍스트 256K, Apache-2.0입니다. 숫자로 된 VRAM 요구는 적혀 있지 않습니다.
Qwen3.8-27B 모델 카드의 코딩 점수는 풀 정밀도, 256K 컨텍스트, Claude Code 하네스 조건에서 나온 값입니다. 16GB 카드가 강제하는 3bit 파일과 32K~64K 컨텍스트에서 같은 점수가 나온다는 근거는 없습니다. Mistral Devstral Small 2 모델 카드는 스스로 "RTX 4090 한 장 또는 32GB 램 Mac"을 대상으로 적고 있어 16GB는 제조사가 상정한 범위 밖입니다.
실행 환경 자료는 실제로 받을 파일의 크기를 알려 줍니다. Qwen3.8-27B와 Devstral Small 2의 3bit·IQ4 파일은 Unsloth가 만든 커뮤니티 양자화이고, Gemma 4 12B의 QAT Q4_0는 Google이 직접 배포한 양자화 인식 학습 파일입니다. 같은 "Q4"라도 Q4_K_M, UD-Q4_K_M, QAT Q4_0, IQ4_XS는 크기와 품질이 다르므로 파일 이름까지 적어야 재현이 됩니다.
커뮤니티 후기는 어떤 GPU 조합에서 무엇이 터지는지 보여 줍니다. 하지만 모델 파일, 양자화, 컨텍스트 길이, KV 캐시 형식, 런타임 버전이 빠져 있으면 다른 사람의 16GB 결과를 내 환경으로 옮길 수 없습니다.
16GB VRAM이 실제로 감당하는 것
16GB VRAM은 GPU 전용 메모리입니다. 시스템 메모리(램)나 Apple Silicon의 통합 메모리와는 계산이 다르고, 그 차이는 아래 Mac 절에서 따로 다룹니다. GPU에서는 모델 가중치, KV 캐시, 런타임 버퍼, 화면 출력이 같은 16GB를 나눠 씁니다.
KV 캐시는 컨텍스트 길이에 비례해 커집니다. 토큰당 크기는 모델 설정값에서 바로 계산됩니다. 예를 들어 Qwen3.8-27B는 전체 어텐션 16개 층 × KV 헤드 4개 × head_dim 256 × K와 V 2개 × F16 2바이트 = 토큰당 64 KiB이고, 32K 토큰이면 2 GiB입니다. KV를 q8_0으로 저장하면 약 0.53배가 됩니다.
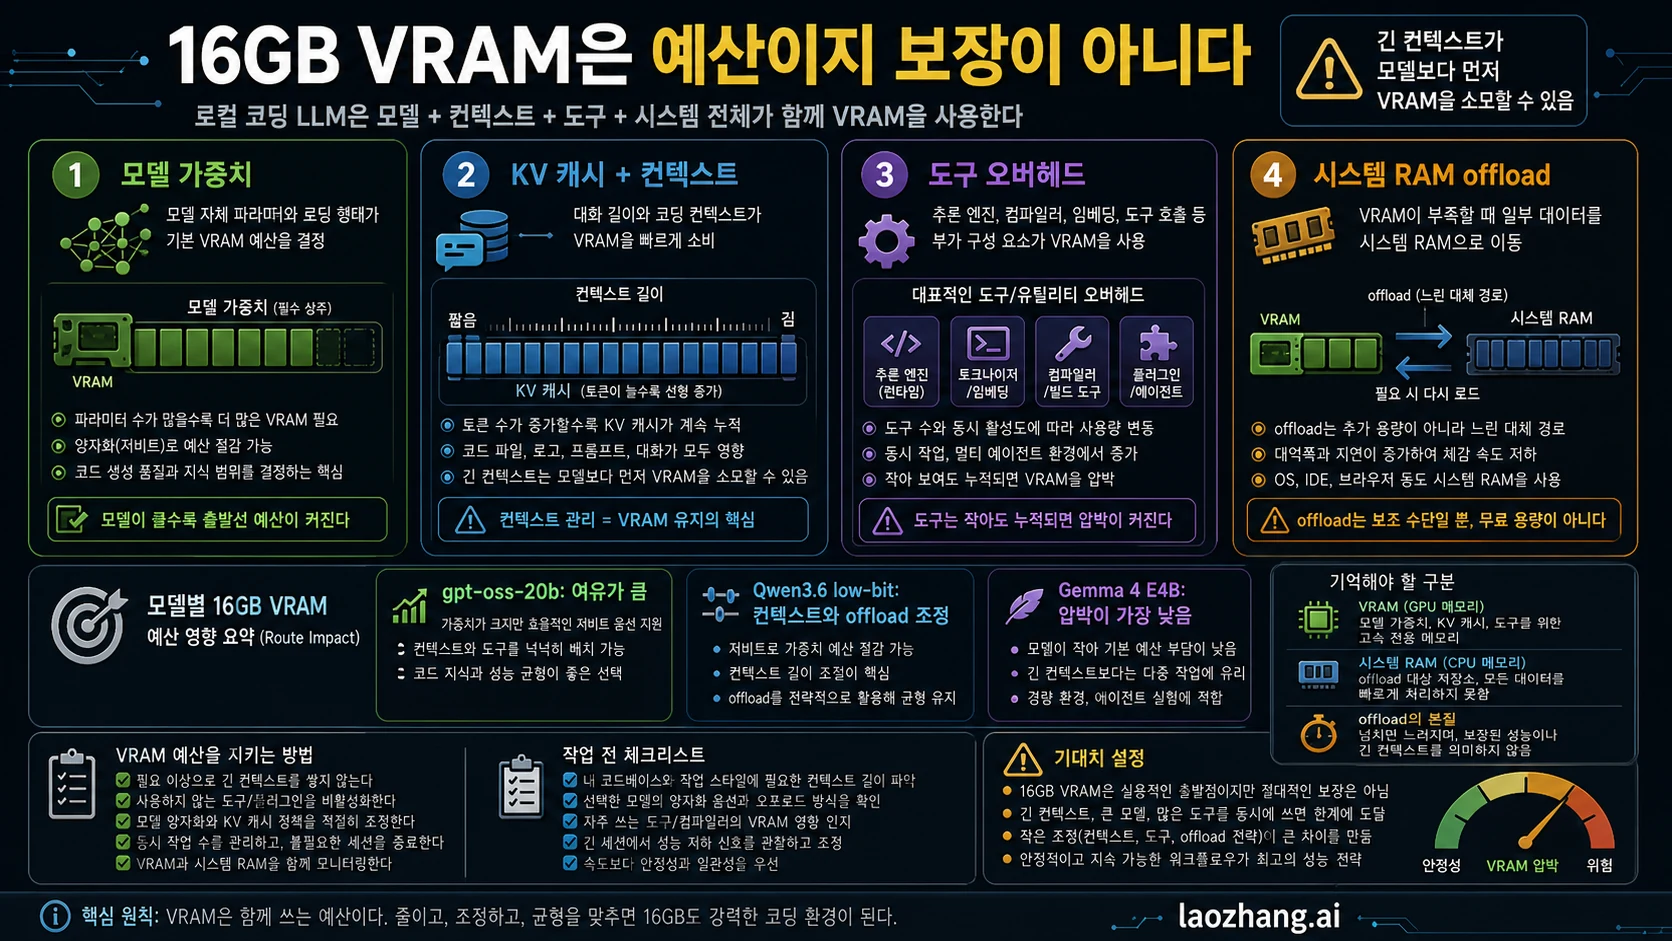
그림은 2026년 7월 기준 경로 표기입니다. 현재 모델별 계산은 아래 표를 보세요.
| 모델 | 양자화 파일 (가중치) | 토큰당 KV (F16) | 컨텍스트와 KV | 계산 합계 | 16GB 판정 |
|---|---|---|---|---|---|
| gpt-oss-20b | MXFP4 GGUF 12.11 GB (11.28 GiB) | 24 KiB | 64K F16, 1.5 GiB | 약 12.8 GiB | 들어감 |
| Gemma 4 12B | QAT Q4_0 6.98 GB (6.50 GiB) | 16 KiB + 슬라이딩 약 320 MiB 고정 | 128K F16, 2 GiB | 약 8.8 GiB | 여유 큼, 256K도 약 10.8 GiB |
| Qwen3.8-27B | UD-Q3_K_XL 13.15 GB (12.24 GiB) | 64 KiB | 32K q8_0, 1.06 GiB | 약 13.3 GiB | 들어감 |
| Qwen3.8-27B | UD-Q3_K_XL 13.15 GB (12.24 GiB) | 64 KiB | 64K q8_0, 2.13 GiB | 약 14.4 GiB | 빠듯함 |
| Qwen3.8-27B | UD-Q3_K_XL 13.15 GB (12.24 GiB) | 64 KiB | 64K F16, 4 GiB | 약 16.2 GiB | 넘침 |
| Qwen3.8-27B | UD-IQ4_XS 14.25 GB (13.27 GiB) | 64 KiB | 32K q8_0, 1.06 GiB | 약 14.3 GiB | 빠듯함 |
| Qwen3.8-27B | UD-Q4_K_M 16.46 GB (15.33 GiB) | 64 KiB | 가중치만 | 15.33 GiB | 안 들어감 |
| Qwen3.6 35B A3B | UD-IQ3_XXS 13.21 GB (12.30 GiB) | 20 KiB | 64K F16, 1.25 GiB | 약 13.6 GiB | 들어감, 128K면 약 14.8 GiB |
| Devstral Small 2 24B | Q4_K_M 14.33 GB (13.35 GiB) | 160 KiB | 32K F16, 5 GiB | 약 18.4 GiB | 안 들어감 |
| Devstral Small 2 24B | IQ4_XS 12.78 GB (11.90 GiB) | 160 KiB | 16K F16, 2.5 GiB | 약 14.4 GiB | 짧은 컨텍스트만 |
| Devstral Small 2 24B | Q3_K_M 11.47 GB (10.69 GiB) | 160 KiB | 32K q8_0, 약 2.65 GiB | 약 13.4 GiB | 들어감 |
계산식은 "가중치 파일 GiB + 토큰당 KV × 토큰 수"입니다. CUDA·Metal 작업 공간, 연산 버퍼, 화면 출력에 쓰이는 메모리는 포함하지 않았습니다. Qwen3.8-27B와 Qwen3.6 35B A3B의 선형 어텐션 층이 쓰는 고정 상태, 그리고 이미지 입력용 mmproj(Qwen3.8-27B F16 기준 0.93 GB)도 빠져 있으므로, 합계가 14 GiB를 넘는 조합은 실제로 넘칠 수 있다고 보는 편이 안전합니다. Gemma 4 12B 값은 전역 층의 K와 V를 따로 저장한다고 가정한 상한입니다.
이 표에서 가장 큰 차이를 만드는 것은 모델 크기보다 KV 캐시입니다. Devstral Small 2는 모든 층이 전체 어텐션이라 토큰당 160 KiB를 쓰고, 같은 16GB에서 Ollama가 권장하는 64000 토큰에 닿지 못합니다. 반대로 Gemma 4 12B는 대부분의 층이 1024 토큰 슬라이딩 창이라 컨텍스트를 늘려도 합계가 천천히 늘어납니다.
경로 1: gpt-oss-20b를 기준으로 삼기
gpt-oss-20b는 "16GB에서 로컬 코딩 루프가 성립하는가"를 확인하는 기준선입니다. 최종 우승자를 뽑는 단계가 아니라, 내 GPU와 런타임과 저장소 조각에서 쓸 만한 결과가 나오는지 보는 단계입니다.
파일은 MXFP4 GGUF 12.11 GB(11.28 GiB)이고 Ollama gpt-oss:20b 패키지는 14GB, 최대 컨텍스트 128K입니다. 전체 어텐션 층이 12개뿐이라 KV는 토큰당 24 KiB, 64K에서 1.5 GiB입니다. 계산상 64K까지 약 12.8 GiB라서 Ollama 권장치인 64000 토큰을 16GB 카드에서 맞출 수 있는 후보입니다.
OLLAMA_CONTEXT_LENGTH=64000 ollama serve
ollama run gpt-oss:20b
ollama ps
ollama ps의 PROCESSOR 열이 GPU 100%가 아니라 CPU와 나뉘어 있으면 일부가 시스템 메모리로 밀려난 것입니다. 이때는 컨텍스트를 32K 정도로 내려 다시 확인합니다(32K에서 계산 합계는 약 12.0 GiB).
처음부터 프로젝트 전체를 넣지 않습니다. 파일 하나, 가까운 테스트 하나, 분명한 수정 요구 하나로 시작해 현재 동작 설명, 작은 패치, 바꿔야 할 테스트, 부족한 파일을 요청합니다. 여기서 이미 느리거나 메모리가 부족하거나 앞의 내용을 잊는다면 더 큰 Qwen으로 가기 전에 컨텍스트, 런타임 설정, IDE 래퍼부터 줄여 봅니다.
경로 2: Qwen3.6 35B A3B는 고급 실험으로만 보기
지금 고급 실험에서 먼저 시도할 Qwen은 Qwen3.8-27B입니다. Qwen3.6 35B A3B는 시스템 메모리를 함께 쓰는 MoE 오프로드 경로로 한 단계 물러났습니다. 둘 다 16GB에서는 기본값으로 쓰는 모델이 아니라 양자화 파일과 KV 형식을 직접 고르는 조정 경로입니다.
먼저 시도할 Qwen: Qwen3.8-27B 3bit GGUF
Qwen3.8-27B는 2026년 8월 5일 공개된 dense 27B 모델로, 64개 층 중 16개만 전체 어텐션이고 48개는 선형 어텐션입니다. 네이티브 컨텍스트는 262,144 토큰, 라이선스는 Apache-2.0입니다. Qwen 모델 카드의 코딩 표에서는 Qwen3.6-27B보다 Terminal Bench 2.1 73.0 대 63.4, SWE-bench Pro 61.7 대 53.5, LiveCodeBench v6 90.3 대 83.9로 모든 항목이 높습니다. 다만 앞서 적은 것처럼 이 값은 풀 정밀도와 256K 컨텍스트에서 나온 제조사 수치입니다.
16GB에서 걸림돌은 기본 패키지입니다. Ollama qwen3.8:27b는 Q4_K_M이고 목록상 18GB입니다. Unsloth Qwen3.8-27B GGUF 파일 목록에서 UD-Q4_K_M은 16.46 GB(15.33 GiB)라 가중치만으로 16GB를 거의 다 씁니다. 그래서 출발점은 UD-Q3_K_XL(13.15 GB)이고, 더 줄여야 하면 UD-IQ3_XXS(10.93 GB)입니다. UD-IQ4_XS(14.25 GB)는 32K q8_0 KV에서 약 14.3 GiB라 여유가 거의 없습니다.
Ollama에서는 Hugging Face GGUF를 태그 대신 저장소와 양자화 이름으로 지정합니다.
ollama run hf.co/unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XLllama.cpp에서는 KV 캐시를 q8_0으로 지정할 수 있어 계산표의 32K 조합을 그대로 재현하기 쉽습니다. --no-mmproj는 이미지 입력용 프로젝터를 내려받지 않게 해서 그만큼 메모리를 남깁니다.
llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XL -c 32768 -ngl 99 -fa on -ctk q8_0 -ctv q8_0 --no-mmprojKV를 F16으로 둔 채 64K로 올리면 계산 합계가 약 16.2 GiB라 넘칩니다. 64K가 꼭 필요하면 q8_0 KV에서 약 14.4 GiB까지 가능하다는 계산이지만, 선형 어텐션 상태와 런타임 버퍼가 빠진 숫자라 실제 여유는 더 작습니다. 32GB 카드나 GPU 두 장으로 262K까지 쓰는 구성은 Qwen3.8-27B VRAM 가이드: RTX 5090, GPU 두 장과 262K 설정에서 다룹니다.
Qwen3.6 35B A3B가 아직 맞는 경우: 전문가 가중치를 시스템 메모리로
Qwen3.6 35B A3B(2026년 4월 15일 공개)는 전체 35B, 토큰당 활성 3B인 MoE이고, 256개 전문가 중 8개가 매 토큰에 선택됩니다. "A3B"는 계산에 쓰이는 활성 파라미터 수일 뿐 필요한 메모리 양이 아닙니다. 가중치 전체는 어딘가에 올라가 있어야 합니다.
이 모델이 여전히 쓸모 있는 이유는 llama.cpp의 --n-cpu-moe N입니다. 앞쪽 N개 층의 MoE 전문가 가중치를 CPU 쪽 시스템 메모리에 두고 나머지를 GPU에 올리는 옵션이라, UD-Q4_K_M 22.13 GB(20.61 GiB) 같은 4bit 파일도 램이 넉넉하면 16GB 카드와 나눠 담을 수 있습니다. 대신 시스템 메모리로 내린 부분은 GPU보다 느립니다.
llama-server -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_M -c 65536 -ngl 99 -fa on --n-cpu-moe 20 --no-mmproj--n-cpu-moe 20은 40개 층 중 절반을 CPU 쪽에 두는 출발값일 뿐 측정으로 정한 값이 아닙니다. GPU 메모리가 남으면 줄이고, 넘치면 늘립니다. 전부 GPU에 올리려면 UD-IQ3_XXS 13.21 GB 파일이 필요하고, 64K F16 KV를 더하면 약 13.6 GiB입니다. Qwen 모델 카드는 생각 모드를 유지하려면 128K 이상을 권장하는데, 그 경우 같은 파일로 약 14.8 GiB가 됩니다.
Ollama qwen3.6:35b는 23~24GB로 16GB 한 장에 다 올라가지 않습니다. 시스템 메모리가 32GB 이상이고 속도 손해를 받아들일 수 있을 때만 이 경로를 고릅니다.
경로 3: Gemma 4 E4B와 작은 코드 모델을 남겨두기
16GB 카드에서 가벼운 경로의 앞자리는 이제 Gemma 4 12B입니다. Gemma 4 E4B는 8GB 카드와 16GB 노트북·Mac용으로 남겨 둡니다. 작은 코드 모델 목록은 Devstral Small 2와 Qwen3.6-27B로 바뀌었습니다.
16GB 카드의 여유 경로: Gemma 4 12B
Gemma 4 12B의 Google 공식 QAT Q4_0 GGUF는 6.98 GB(6.50 GiB)이고, Ollama gemma4:12b는 7.7~8.0GB, 컨텍스트 256K입니다. 계산상 128K에서도 약 8.8 GiB라 16GB 카드에서 7 GiB 안팎이 남습니다. 긴 로그, 큰 파일 하나, 여러 테스트 파일을 한꺼번에 넣는 작업에서 gpt-oss-20b보다 컨텍스트를 더 크게 잡을 수 있습니다.
OLLAMA_CONTEXT_LENGTH=64000 ollama serve
ollama run gemma4:12b
Google의 벤치마크 표에서 12B는 LiveCodeBench v6 72.0%, Codeforces ELO 1659로 E4B(52.0%, 940)와 차이가 큽니다. 이 표는 Google 하네스에서 잰 코딩 문제 풀이 점수이고, 저장소 단위 에이전트 작업(SWE-bench 계열)은 들어 있지 않습니다. 그래서 Gemma 4 12B는 "긴 컨텍스트로 읽고 짧게 고치는" 작업에 먼저 쓰고, 여러 파일을 오가는 수정은 smoke test로 따로 확인합니다.
Gemma 4 E4B의 QAT Q4_0 파일은 5.15 GB에 이미지용 mmproj 0.99 GB가 따로 있고, Ollama gemma4:e4b는 6.6~9.5GB, 컨텍스트 128K입니다. 16GB 카드에서는 12B를 두고 E4B를 고를 이유가 거의 없지만, 8GB 카드에서는 여전히 현실적인 선택입니다.
코드 특화 모델: Devstral Small 2와 Qwen3.6-27B
Devstral Small 2 24B(Apache-2.0, 컨텍스트 256K)는 에이전트형 코딩용으로 만든 모델이고, Mistral이 보고한 SWE-bench Verified는 68.0%입니다. 16GB에서는 KV 캐시가 발목을 잡습니다. 40개 층이 모두 전체 어텐션이라 토큰당 160 KiB이고, Q4_K_M(14.33 GB, Ollama devstral-small-2:24b 15GB)에 32K F16 KV를 더하면 약 18.4 GiB로 넘칩니다. 쓸 수 있는 조합은 IQ4_XS + 16K(약 14.4 GiB)나 Q3_K_M + 32K q8_0(약 13.4 GiB)입니다. 짧은 컨텍스트로 끝나는 작업에 한정하면 후보가 됩니다.
Qwen3.6-27B는 Qwen 모델 카드 기준 SWE-bench Verified 77.2이고, Ollama에 코딩용 태그 qwen3.6:27b-coding(19GB)이 있습니다. 19GB 태그는 16GB에 들어가지 않으므로 16GB에서는 Q3_K_M(13.59 GB)이나 UD-IQ3_XXS(11.99 GB) 파일이 필요합니다. 크기는 Qwen3.8-27B와 같은 급이고 Qwen의 표에서는 3.8 쪽이 모든 코딩 항목에서 앞서므로, 새로 시작한다면 Qwen3.8-27B를 먼저 봅니다.
7월 판에서 코드 특화 대안으로 적었던 Qwen2.5-Coder, DeepSeek Coder, Qwen3-Coder-30B-A3B는 위 두 모델에 자리를 넘겼습니다. 이미 그 모델로 통과한 작업 흐름이 있다면 굳이 바꿀 필요는 없지만, 새로 고른다면 Devstral Small 2나 Qwen3.8-27B를 먼저 시험합니다.
같이 확인한 다른 16GB 후보
Gemma 4 26B A4B의 QAT Q4_0 파일은 14.44 GB(13.45 GiB)에 mmproj 1.19 GB가 따로 있고, Ollama gemma4:26b는 16~19GB라 컨텍스트 여유가 작습니다. Qwen3.6 35B A3B 모델 카드에 실린 Qwen 측 측정에서는 Gemma4-26BA4B의 SWE-bench Verified가 17.4로 나오지만, 경쟁사가 자사 스캐폴드로 잰 값입니다. GLM-4.7-Flash의 3bit 파일은 13.78~14.61 GB, IBM Granite 4.2(8월 25일 공개)는 8B Q4_K_M이 5.35 GB, 30B Q3_K_M이 14.13 GB입니다. 셋 모두 크기상 16GB에 올릴 수는 있지만 위의 세 경로를 앞설 근거가 아직 부족합니다.
16GB급이 아닌 모델: GLM-5.3-Flash, Qwen3-Coder-Next
"Flash"나 "Next"가 붙었다고 작은 모델은 아닙니다. 아래 세 모델은 16GB 카드 한 장으로 돌리는 대상이 아닙니다.
| 모델 | 공개된 크기 | 16GB에서의 의미 |
|---|---|---|
| GLM-5.3-Flash | 공식 FP8 가중치 약 305.8 GiB, MIT | API나 대형 다중 GPU 서버용 |
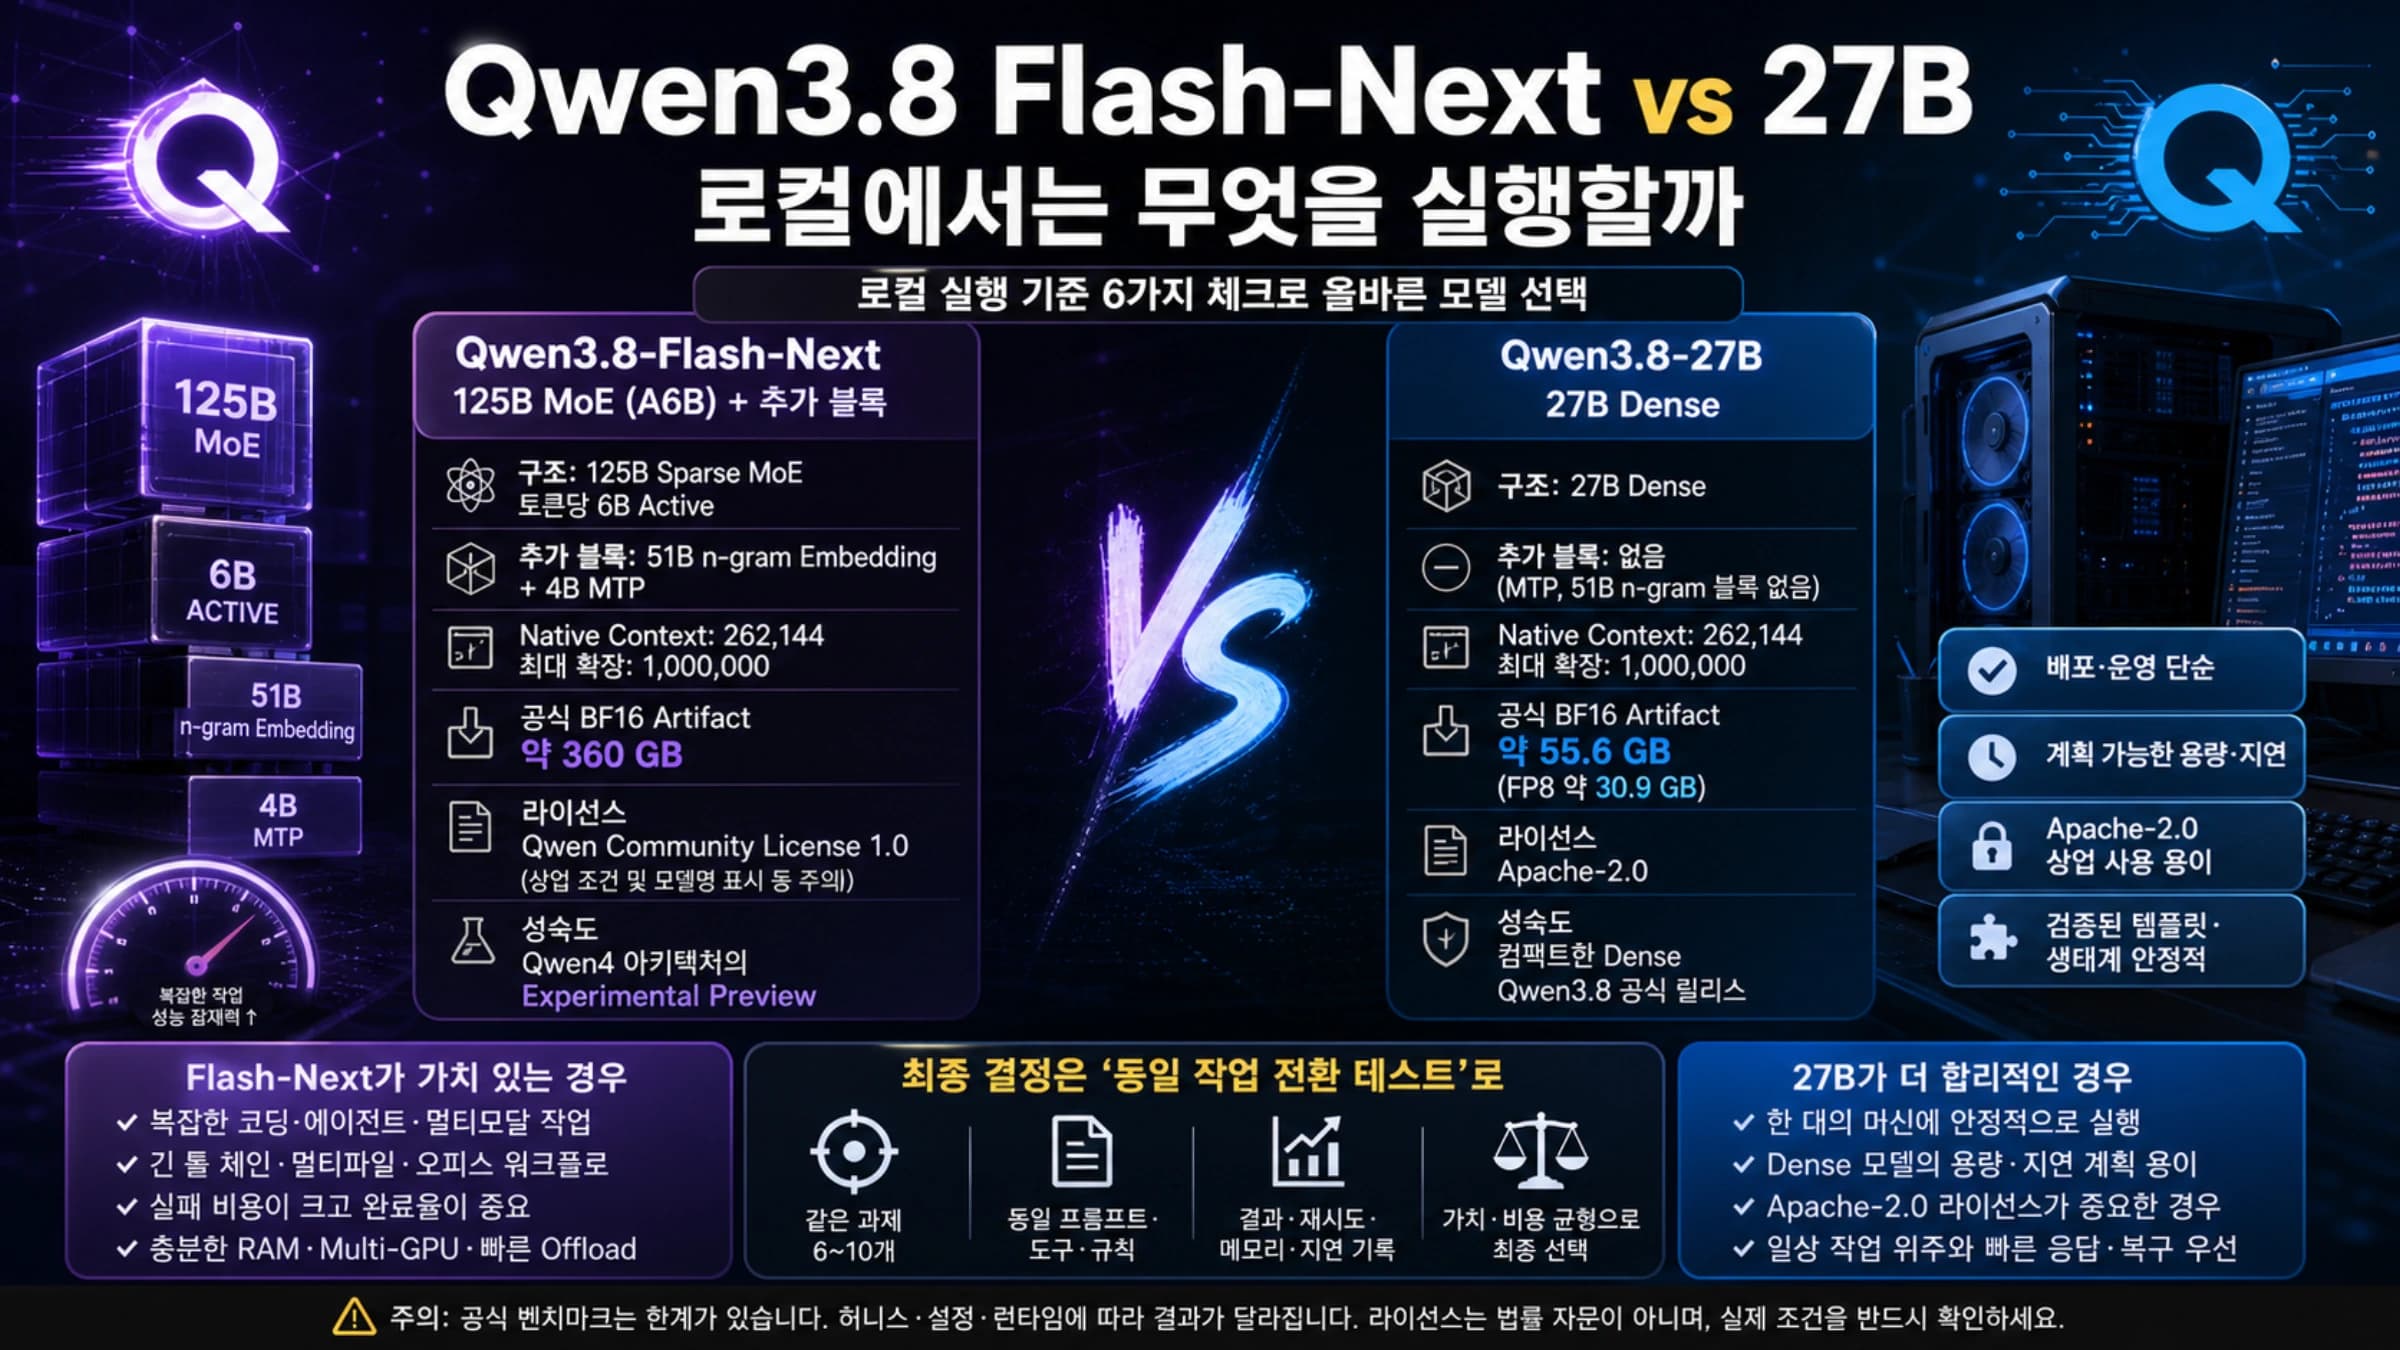
| Qwen3.8-Flash-Next | 125B 희소 MoE(활성 6B), 공식 BF16 저장소 약 360 GB | "활성 6B"는 메모리 요구가 아님 |
| Qwen3-Coder-Next | Qwen 공식 GGUF Q4_K_M 4개 분할 파일 합계 48.4 GB | 4bit로도 16GB의 세 배 |
Qwen3-Coder-Next 후기를 찾는다면, 16GB VRAM 한 장으로는 4bit 파일조차 올라가지 않는다는 점부터 확인하세요. 16GB에서 Qwen 코딩 모델을 원한다면 지금은 Qwen3.8-27B의 3bit 파일이 현실적인 상한입니다. Flash-Next가 저메모리 모델이 아닌 이유는 Qwen3.8 Flash-Next vs 27B: 로컬에서는 무엇을 실행할까에, GLM-5.3-Flash의 API 우선 사용법은 GLM-5.3-Flash 사용 가이드에 있습니다.
실행 환경: Ollama, LM Studio, llama.cpp, IDE 래퍼
같은 모델 이름이라도 실행 환경마다 받는 파일과 기본 컨텍스트가 다릅니다. 추천을 기록할 때는 모델 이름과 함께 실행 경로를 남겨야 합니다.
Ollama는 기본 태그가 곧 양자화 선택입니다. gpt-oss:20b(14GB), gemma4:12b(7.7~8.0GB)는 16GB에 맞지만 qwen3.8:27b(18GB), qwen3.6:27b-coding(19GB), qwen3.6:35b(23~24GB)는 맞지 않습니다. 맞지 않는 모델은 ollama run hf.co/{사용자}/{저장소}:{양자화} 형식으로 Hugging Face의 작은 GGUF를 직접 지정합니다. 그리고 16GB 카드에서는 기본 컨텍스트가 4k이므로 OLLAMA_CONTEXT_LENGTH=64000 ollama serve나 앱의 슬라이더로 먼저 늘리고, ollama ps로 CPU/GPU 분배를 확인합니다.
llama.cpp는 양자화 파일, 컨텍스트, KV 형식을 각각 지정할 수 있어 16GB 계산을 그대로 옮기기 좋습니다. 아래 표와 앞 절의 명령에 쓴 옵션은 모두 llama.cpp 빌드 11429의 llama-server --help에 나오는 것입니다.
| 옵션 | 역할 |
|---|---|
-hf 사용자/저장소:양자화 | Hugging Face에서 해당 GGUF를 받아 실행 |
-c | 컨텍스트 길이 |
-ngl | GPU에 올릴 층 수 |
-fa on | flash attention 사용 |
-ctk, -ctv | K·V 캐시 형식, 예: q8_0 |
--n-cpu-moe N | 앞쪽 N개 층의 MoE 전문가 가중치를 CPU에 둠 |
--no-mmproj | 이미지 입력용 프로젝터를 받지 않음 |
LM Studio는 GUI에서 GGUF 파일과 컨텍스트 길이를 눈으로 고르기 편합니다. 어떤 도구를 쓰든 확인할 것은 같습니다. 실제 파일 이름과 양자화, 컨텍스트 길이, GPU에 다 올라갔는지입니다.
IDE 플러그인은 어떤 파일이 프롬프트에 들어가는지를 결정합니다. 래퍼가 메모리 압박을 가리면 잠시 CLI로 돌아가 문제를 모델, 컨텍스트, 에디터 연동으로 나눠 봅니다.
16GB 램·Mac은 VRAM과 다르다: Metal 예산 12,124 MiB
16GB 통합 메모리 Apple M4 Mac에서 llama-cli --list-devices를 실행하면 MTL0: Apple M4 (12124 MiB, 12123 MiB free)로 표시됩니다(2026년 10월 22일, llama.cpp Homebrew 빌드 11429). llama.cpp가 GPU 쪽으로 쓸 수 있다고 보는 예산이 16 GiB 중 약 11.8 GiB라는 뜻입니다. 확인한 것은 이 장치 예산과 앞 절의 옵션 존재 여부까지이며, 모델 파일을 받아 실행한 속도·품질·적재량 측정은 없습니다. macOS의 GPU 메모리 한도를 올리는 설정도 시험하지 않았습니다.
이 예산을 앞의 파일 크기에 대 보면 다음과 같습니다. 모두 계산입니다.
- Gemma 4 12B QAT Q4_0(6.50 GiB): 약 5.3 GiB가 남아 컨텍스트를 키울 여유가 있습니다.
- gpt-oss-20b MXFP4(11.28 GiB): 가중치만으로 예산의 대부분을 쓰고 약 0.56 GiB가 남습니다. 32K KV(0.75 GiB)도 들어가지 않습니다.
- Qwen3.8-27B UD-Q3_K_XL(12.24 GiB): 가중치만으로 예산을 넘습니다. UD-IQ3_XXS(10.18 GiB)는 숫자상 1.66 GiB가 남지만 macOS와 다른 앱이 같은 메모리를 쓰므로 권하기 어렵습니다.
그래서 16GB Mac에서는 Gemma 4 12B가 사실상 첫 후보이고, 메모리를 더 아끼려면 Gemma 4 E4B입니다. 별도 GPU 없이 램만 16GB인 PC는 모두 CPU로 돌게 되므로 같은 작은 모델 위주로 봐야 합니다.
AMD 8845HS처럼 iGPU에 시스템 메모리를 크게 할당하는 PC도 통합 메모리 계열입니다. "가중치 파일 + KV 캐시"라는 계산법은 같지만, 메모리 대역폭이 독립 GPU와 다르므로 독립 GPU 기준의 16GB VRAM 판정을 그대로 옮기면 안 됩니다. 할당량 안에 파일이 들어가는지는 같은 방식으로 계산하고, 속도는 직접 확인해야 합니다.
Smoke test: 내 코드에서 먼저 증명하기
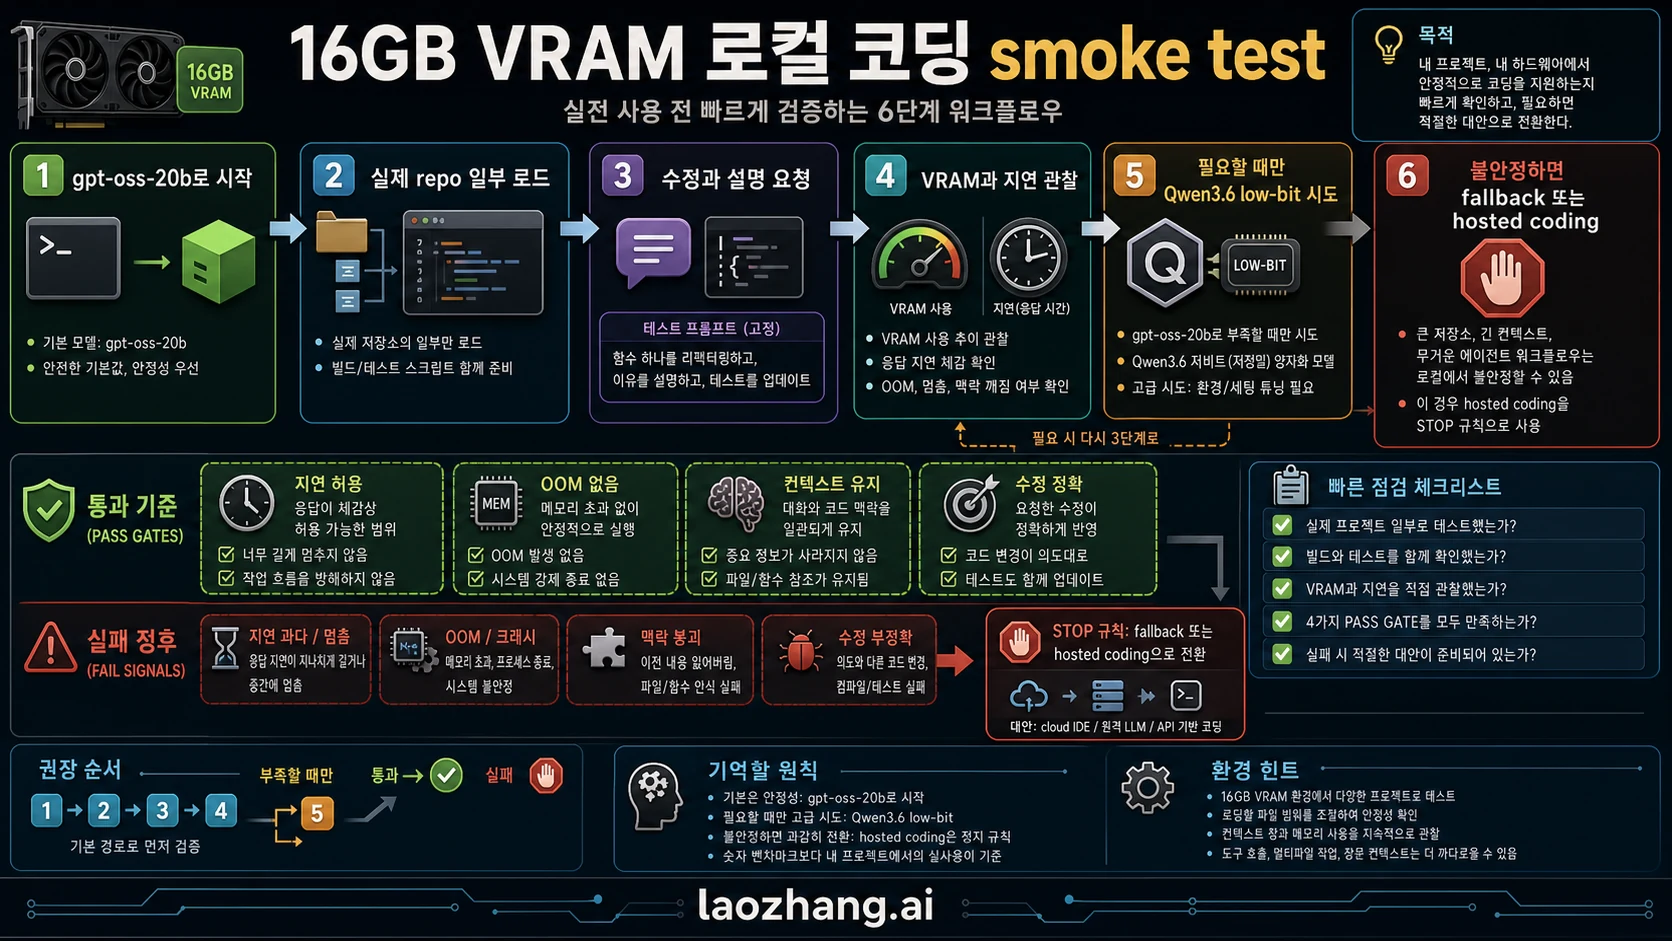
그림은 2026년 7월 기준 경로 표기입니다. 테스트 순서는 같고, 대상 모델은 본문의 현재 경로를 따릅니다.
smoke test는 내 코드로 해야 합니다. 일반 퍼즐이나 공개 벤치마크는 내 함수와 테스트와 패치 제약을 끝까지 지키는지 보여 주지 못합니다. 특히 Qwen3.8-27B처럼 제조사 점수가 풀 정밀도에서 나온 모델은 3bit 파일로 내 저장소에서 다시 확인해야 합니다.
최소 구성은 파일 하나, 테스트 하나, 수정 요구 하나입니다. 모델은 현재 동작 설명, 패치, 바꿔야 할 테스트 이름, 컨텍스트가 부족할 때 필요한 파일을 구체적으로 답해야 합니다.
Given the files below, refactor one function without changing behavior.
Explain the tradeoff, show the patch, and name the test that should be updated.
If the context is insufficient, say exactly what file or symbol you need next.
합격 기준은 네 가지입니다. 기다릴 만한 응답 시간, 메모리 부족이나 과한 오프로드 없음, 함수와 테스트 제약 유지, 작고 검토 가능한 패치입니다.
순서는 gpt-oss-20b로 기준선을 만든 뒤, 컨텍스트가 모자라면 Gemma 4 12B, 품질이 모자라면 Qwen3.8-27B UD-Q3_K_XL 32K로 넘어갑니다. 모델과 컨텍스트를 동시에 바꾸지 않아야 조정 효과와 품질 차이를 나눠 볼 수 있습니다.
중단 기준: 16GB를 더 밀어붙이지 않을 때
중단 기준은 미리 정해 둡니다. 16GB에서 가장 비싼 실수는 겨우 실행되는 모델을 일상 도구로 만들려고 끝없이 조정하는 것입니다.
| 증상 | 가능한 원인 | 더 나은 경로 |
|---|---|---|
| 실행은 되지만 너무 느림 | 오프로드, --n-cpu-moe 과다, 무거운 양자화 | 작은 모델이나 더 큰 VRAM |
| 짧은 질문은 좋은데 저장소 작업이 나쁨 | 컨텍스트 구성 문제, Ollama 4k 기본값 | 컨텍스트 확인 후 작업 범위 축소 |
| 컨텍스트를 올리자마자 메모리 부족 | KV 캐시 예산 초과 | 컨텍스트 축소, q8_0 KV, Gemma 4 12B |
| 패치를 반복하다 앞의 조건을 잊음 | 에이전트 작업이 16GB에 비해 큼 | 호스팅 코딩이나 상위 GPU |
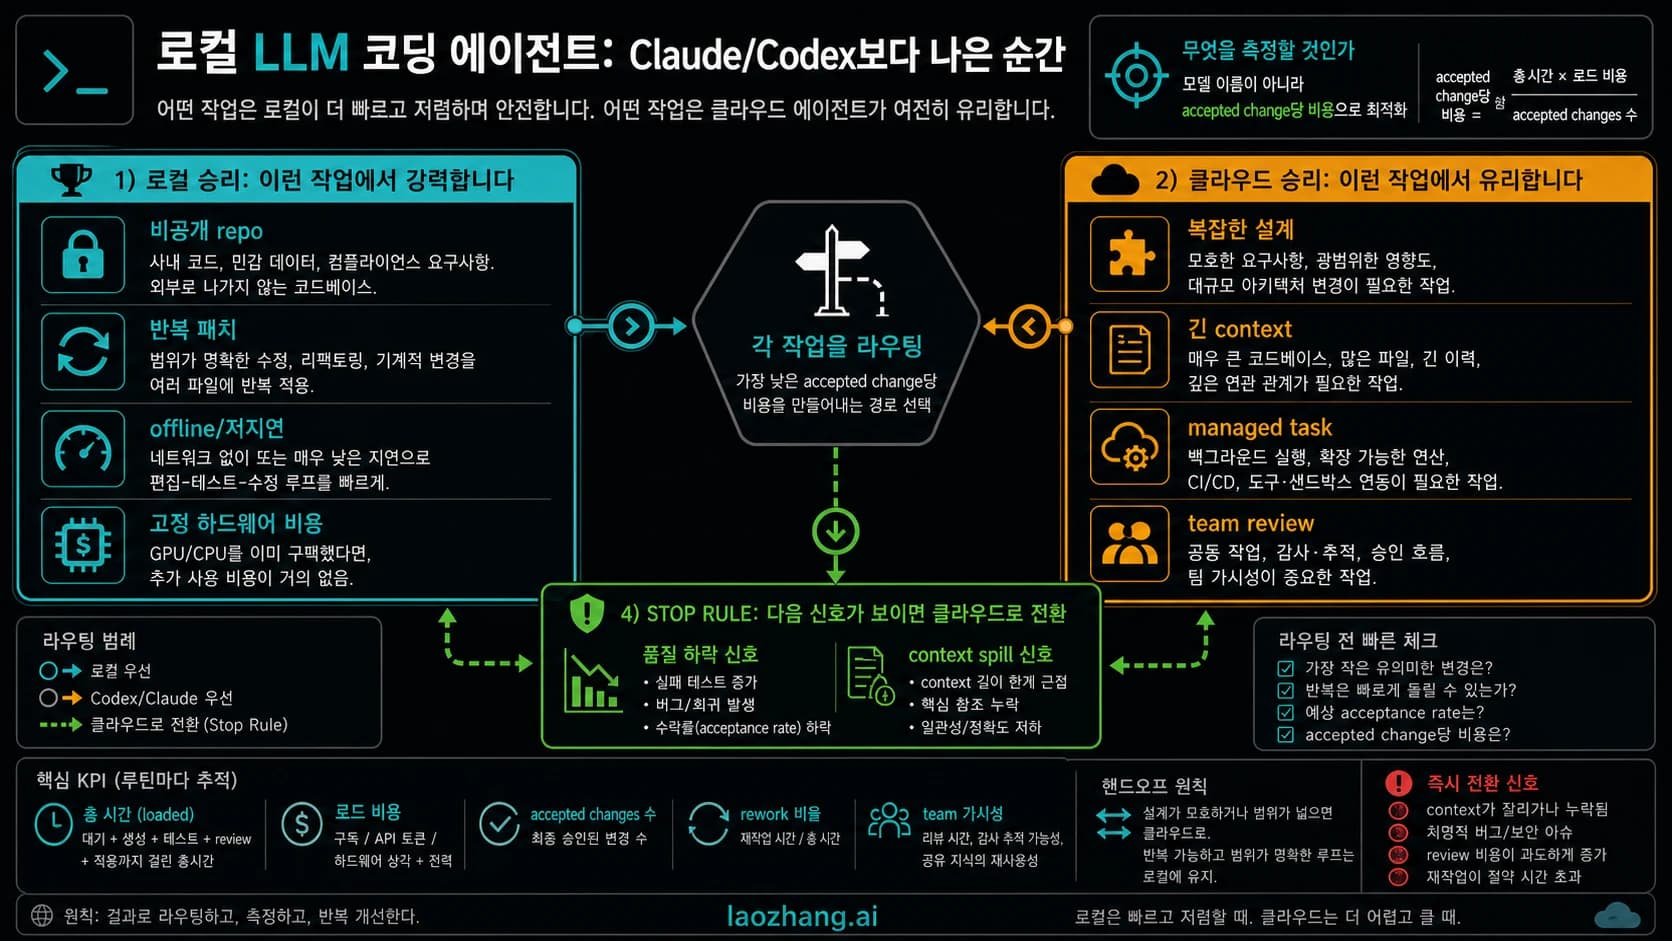
해결책은 여러 가지입니다. 작은 모델로 돌아가고, 작업을 좁히고, 컨텍스트를 낮추고, 24GB 이상으로 옮기거나, 긴 다중 파일 작업만 호스팅 코딩으로 보낼 수 있습니다. 적재 이후에도 실패가 반복된다면 로컬 coding agent가 실패할 때: 양자화, 컨텍스트, Harness를 분리 진단으로 원인을 나눠 보고, 어느 작업을 호스팅 쪽으로 넘길지는 로컬 LLM 코딩 에이전트: Claude/Codex보다 나은 순간을 참고하세요.
목표는 16GB로 모든 것을 증명하는 것이 아닙니다. 코드 작업을 더 빠르고 안정적으로, 검토 가능하게 만드는 것입니다.
로컬 검증 로그에 남길 항목
검증 로그에는 GPU, 시스템 메모리, 드라이버, 런타임과 버전, 모델 파일 이름과 양자화, 컨텍스트 길이, KV 캐시 형식, 오프로드 여부, 작업 유형, 응답 시간, 최대 메모리, 실패 이유를 남깁니다.
모델별로 볼 지점이 다릅니다. gpt-oss-20b에서는 어떤 저장소 범위까지 안정적으로 유지하는지, Gemma 4 12B에서는 컨텍스트를 키웠을 때 수정 정확도가 유지되는지, Qwen3.8-27B에서는 3bit 파일과 q8_0 KV가 품질에 주는 손해를 봅니다. Qwen3.6 35B A3B를 오프로드로 쓴다면 --n-cpu-moe 값에 따른 속도 변화를 함께 적습니다.
검증은 세 단계로 나누면 좋습니다. 첫 단계는 함수 하나와 테스트 하나, 두 번째는 에러 로그나 요구 사항 추가, 세 번째는 인접 모듈 추가입니다. 어느 단계에서 지연이 커지고 어느 단계에서 테스트 이름을 잊는지 보면 실제 한계가 드러납니다.
모델, 양자화, 런타임, IDE 래퍼를 한꺼번에 바꾸면 무엇이 좋아졌는지 알 수 없습니다. 작업과 프롬프트를 고정하고 변수 하나씩만 바꿔야 gpt-oss, Gemma, Qwen, Devstral을 공정하게 비교할 수 있습니다.
팀에 공유할 때는 "이 모델이 최고"보다 "이 GPU, 이 양자화 파일, 이 컨텍스트, 이 작업에서 통과"라고 적습니다. 16GB 로컬 모델 추천의 가치는 모델 이름보다 재현 조건에 있습니다. 커뮤니티 후기를 읽을 때도 GPU 이름보다 어떤 파일을 실행했는지, 어떤 작업을 시켰는지, 얼마나 기다렸는지를 먼저 확인합니다.
실패한 뒤의 다음 행동도 기록합니다. gpt-oss-20b 품질이 부족하지만 메모리가 남으면 Qwen3.8-27B 3bit를 32K로 시도합니다. Qwen이 느리면 컨텍스트를 더 늘리지 말고 작은 모델로 돌아갑니다. 작은 모델도 테스트 제약을 잊는다면 모델보다 작업 분할이 문제일 수 있습니다.
같은 작업을 세 번 연속 통과하는지도 적어 둡니다. 한 번 성공은 가능성이고, 반복 성공이 일상 도구의 조건입니다. 같은 16GB GPU라도 드라이버, OS 부하, 에디터 플러그인 상태에 따라 결과가 달라지므로, 조건을 남겨야 다음 실패가 모델 문제인지 런타임 변화인지 구분할 수 있습니다.
자주 묻는 질문
16GB VRAM에서 먼저 시도할 로컬 코딩 LLM은?
gpt-oss-20b입니다. MXFP4 GGUF 12.11 GB, 64K 컨텍스트 KV를 더해도 계산상 약 12.8 GiB이고, 제조사가 16GB 메모리를 직접 명시한 유일한 후보라 기준선으로 쓰기 좋습니다. 컨텍스트가 더 필요하면 Gemma 4 12B, 품질이 더 필요하면 Qwen3.8-27B 3bit로 넘어갑니다.
Qwen3.6 35B A3B는 16GB에서 돌아가나?
조건부로 가능합니다. UD-IQ3_XXS 파일(13.21 GB)에 64K KV를 더하면 계산상 약 13.6 GiB라 GPU 한 장에 올라가고, UD-Q4_K_M(22.13 GB)은 llama.cpp --n-cpu-moe로 전문가 가중치를 시스템 메모리에 나눠 두어야 합니다. 다만 지금 고급 실험에서 먼저 시도할 Qwen은 Qwen3.8-27B이고, Qwen3.6 35B A3B는 램이 넉넉할 때의 MoE 오프로드 경로입니다.
gpt-oss-20b는 코딩에 충분한가?
짧은 수정, 코드 설명, 테스트 제안의 기준선으로는 충분합니다. 64K 컨텍스트까지 16GB 안에 들어간다는 점이 장점입니다. 여러 파일을 오가는 에이전트 작업은 별도 smoke test로 확인해야 하고, 부족하면 Qwen3.8-27B 3bit와 같은 작업으로 비교합니다.
Gemma 4 E4B는 왜 남겨두나?
8GB 카드와 16GB 노트북·Mac용입니다. QAT Q4_0 파일이 5.15 GB라 작은 메모리에서도 들어갑니다. 16GB 카드에서는 Gemma 4 12B(QAT Q4_0 6.98 GB, LiveCodeBench v6 72.0%)가 E4B(52.0%)를 대신해 가벼운 경로의 앞자리에 섭니다.
Ollama와 LM Studio 중 무엇이 나은가?
CLI 기준선과 빠른 시작은 Ollama, GGUF 파일을 눈으로 고르고 로컬 서버를 띄우는 데는 LM Studio가 편합니다. Ollama를 쓴다면 16GB 카드의 기본 컨텍스트가 4k이므로 OLLAMA_CONTEXT_LENGTH=64000으로 늘리고, 기본 태그가 16GB를 넘는 Qwen3.8-27B는 hf.co/unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XL처럼 파일을 직접 지정합니다.
RTX 4060 Ti 16GB면 충분한가?
16GB 경로를 검증하기에는 충분합니다. 메모리 계산은 RTX 5060 Ti 16GB, 5070 Ti, 4080, 5080과 같으므로 위의 표가 그대로 적용됩니다. 다만 Qwen3.8-27B Q4_K_M이나 35B급 모델을 긴 컨텍스트로 편하게 돌린다는 뜻은 아닙니다. 카드 사이의 속도 차이는 로컬 LLM 코딩용 16GB GPU 선택에서 다룹니다.
8GB VRAM은 어떻게 해야 하나?
Gemma 4 E4B(QAT Q4_0 5.15 GB)나 IBM Granite 4.2 8B(Q4_K_M 5.35 GB)처럼 파일이 6GB 아래인 모델로, 짧은 컨텍스트와 좁은 작업에 한정합니다. Gemma 4 12B QAT는 가중치만 6.50 GiB라 8GB에서는 컨텍스트 여유가 거의 없습니다. 16GB용 Qwen 3bit 실험을 그대로 옮기면 안 됩니다.
24GB VRAM이면 문제가 해결되나?
선택지는 넓어집니다. Qwen3.8-27B Q4_K_M(16.46 GB, Ollama 18GB)이나 Devstral Small 2 Q4_K_M에 32K KV(계산상 약 18.4 GiB)를 올릴 수 있고, Mistral도 Devstral Small 2를 RTX 4090 한 장 대상으로 적고 있습니다. 하지만 Ollama 기본 컨텍스트는 24~48 GiB 구간에서 32k라 64000으로 따로 올려야 하고, KV 캐시 계산과 smoke test는 그대로 필요합니다.
언제 로컬 조정을 멈춰야 하나?
메모리 부족, 오프로드 지연, 컨텍스트 손실, 패치 반복 실패를 해결하는 데 쓰는 시간이 실제 코딩 시간보다 많아지면 멈춥니다. 그때는 더 작은 모델로 돌아가거나, 24GB 이상 GPU로 옮기거나, 긴 다중 파일 작업만 호스팅 코딩으로 보냅니다.
커뮤니티 벤치마크만 믿어도 되나?
후보를 찾는 데는 좋지만 보증은 아닙니다. 같은 "Q4"라도 파일에 따라 크기와 품질이 다르고, 제조사 점수도 Qwen3.8-27B처럼 풀 정밀도·256K 조건에서 나온 경우가 많습니다. 모델 파일 이름, 양자화, 컨텍스트, KV 형식, 런타임을 확인한 뒤 내 코드로 smoke test를 해야 합니다.
Qwen3.8-27B는 16GB VRAM에서 돌아가나?
3bit 파일과 짧은 컨텍스트라면 계산상 들어갑니다. Unsloth UD-Q3_K_XL(13.15 GB)에 32K q8_0 KV를 더하면 약 13.3 GiB, 64K q8_0이면 약 14.4 GiB입니다. Ollama 기본 태그 qwen3.8:27b(Q4_K_M, 18GB)는 들어가지 않으므로 ollama run hf.co/unsloth/Qwen3.8-27B-GGUF:UD-Q3_K_XL처럼 파일을 지정해야 합니다.
Devstral Small 2는 16GB VRAM에서 쓸 만한가?
짧은 컨텍스트 작업이라면 후보입니다. KV 캐시가 토큰당 160 KiB라 Q4_K_M + 32K는 약 18.4 GiB로 넘치고, IQ4_XS + 16K(약 14.4 GiB)나 Q3_K_M + 32K q8_0(약 13.4 GiB)이 현실적인 조합입니다. Mistral 스스로는 RTX 4090 한 장이나 32GB 램 Mac을 대상으로 적고 있습니다.
Qwen3-Coder-Next나 GLM-5.3-Flash도 16GB VRAM에서 돌릴 수 있나?
아닙니다. Qwen3-Coder-Next는 공식 GGUF Q4_K_M만 4개 파일 합계 48.4 GB이고, GLM-5.3-Flash는 FP8 가중치가 약 305.8 GiB, Qwen3.8-Flash-Next는 BF16 저장소가 약 360 GB입니다. 16GB 한 장에서 Qwen 코딩 모델을 원한다면 Qwen3.8-27B 3bit가 현실적인 선택입니다.
램 16GB PC나 16GB Mac에서도 로컬 코딩 LLM을 쓸 수 있나?
작은 모델 위주로는 가능합니다. 16GB M4 Mac에서 llama.cpp가 보는 Metal 예산은 12,124 MiB(약 11.8 GiB)라, Gemma 4 12B QAT(6.50 GiB)는 여유가 있지만 gpt-oss-20b(11.28 GiB)는 KV를 넣을 자리가 거의 없고 Qwen3.8-27B UD-Q3_K_XL은 넘칩니다. 별도 GPU가 없는 램 16GB PC는 CPU로만 돌기 때문에 Gemma 4 E4B 같은 작은 모델부터 시작합니다.
iGPU에 메모리를 크게 할당하면 VRAM 16GB 판정이 그대로 적용되나?
그대로는 아닙니다. 8845HS 같은 iGPU에 시스템 메모리를 할당하는 구성은 통합 메모리 계열이라, 파일 크기에 KV 캐시를 더하는 계산법은 같지만 속도를 좌우하는 메모리 대역폭이 독립 GPU와 다릅니다. 할당량 안에 들어가는 파일은 같은 방식으로 고르되, 코딩용과 일상 대화용 모두 응답 속도를 직접 확인한 뒤 정합니다.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 22일.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 22일.
- 1.Ollama 컨텍스트 길이 문서docs.ollama.com/context-length
- 2.OpenAI gpt-oss-20b 모델 카드huggingface.co/openai/gpt-oss-20b
- 3.Google Gemma 4 12B 모델 카드huggingface.co/google/gemma-4-12B-it
- 4.Qwen3.8-27B 모델 카드huggingface.co/Qwen/Qwen3.8-27B
- 5.Mistral Devstral Small 2 모델 카드huggingface.co/mistralai/Devstral-Small-2-24B-Instruct-2512
- 6.Unsloth Qwen3.8-27B GGUF 파일 목록huggingface.co/unsloth/Qwen3.8-27B-GGUF/tree/main