Jev(제브) 결정 모델 정리: LLM과 비교부터 API 사용법까지
Jev는 문장 대신 선택지와 확률을 돌려주는 TypeSafe의 결정 모델입니다. 분류·라우팅·검수에 맞고 생성은 LLM 몫이며, 2026년 9월 24일 기준 입력 100만 토큰당 $0.042입니다.
목차
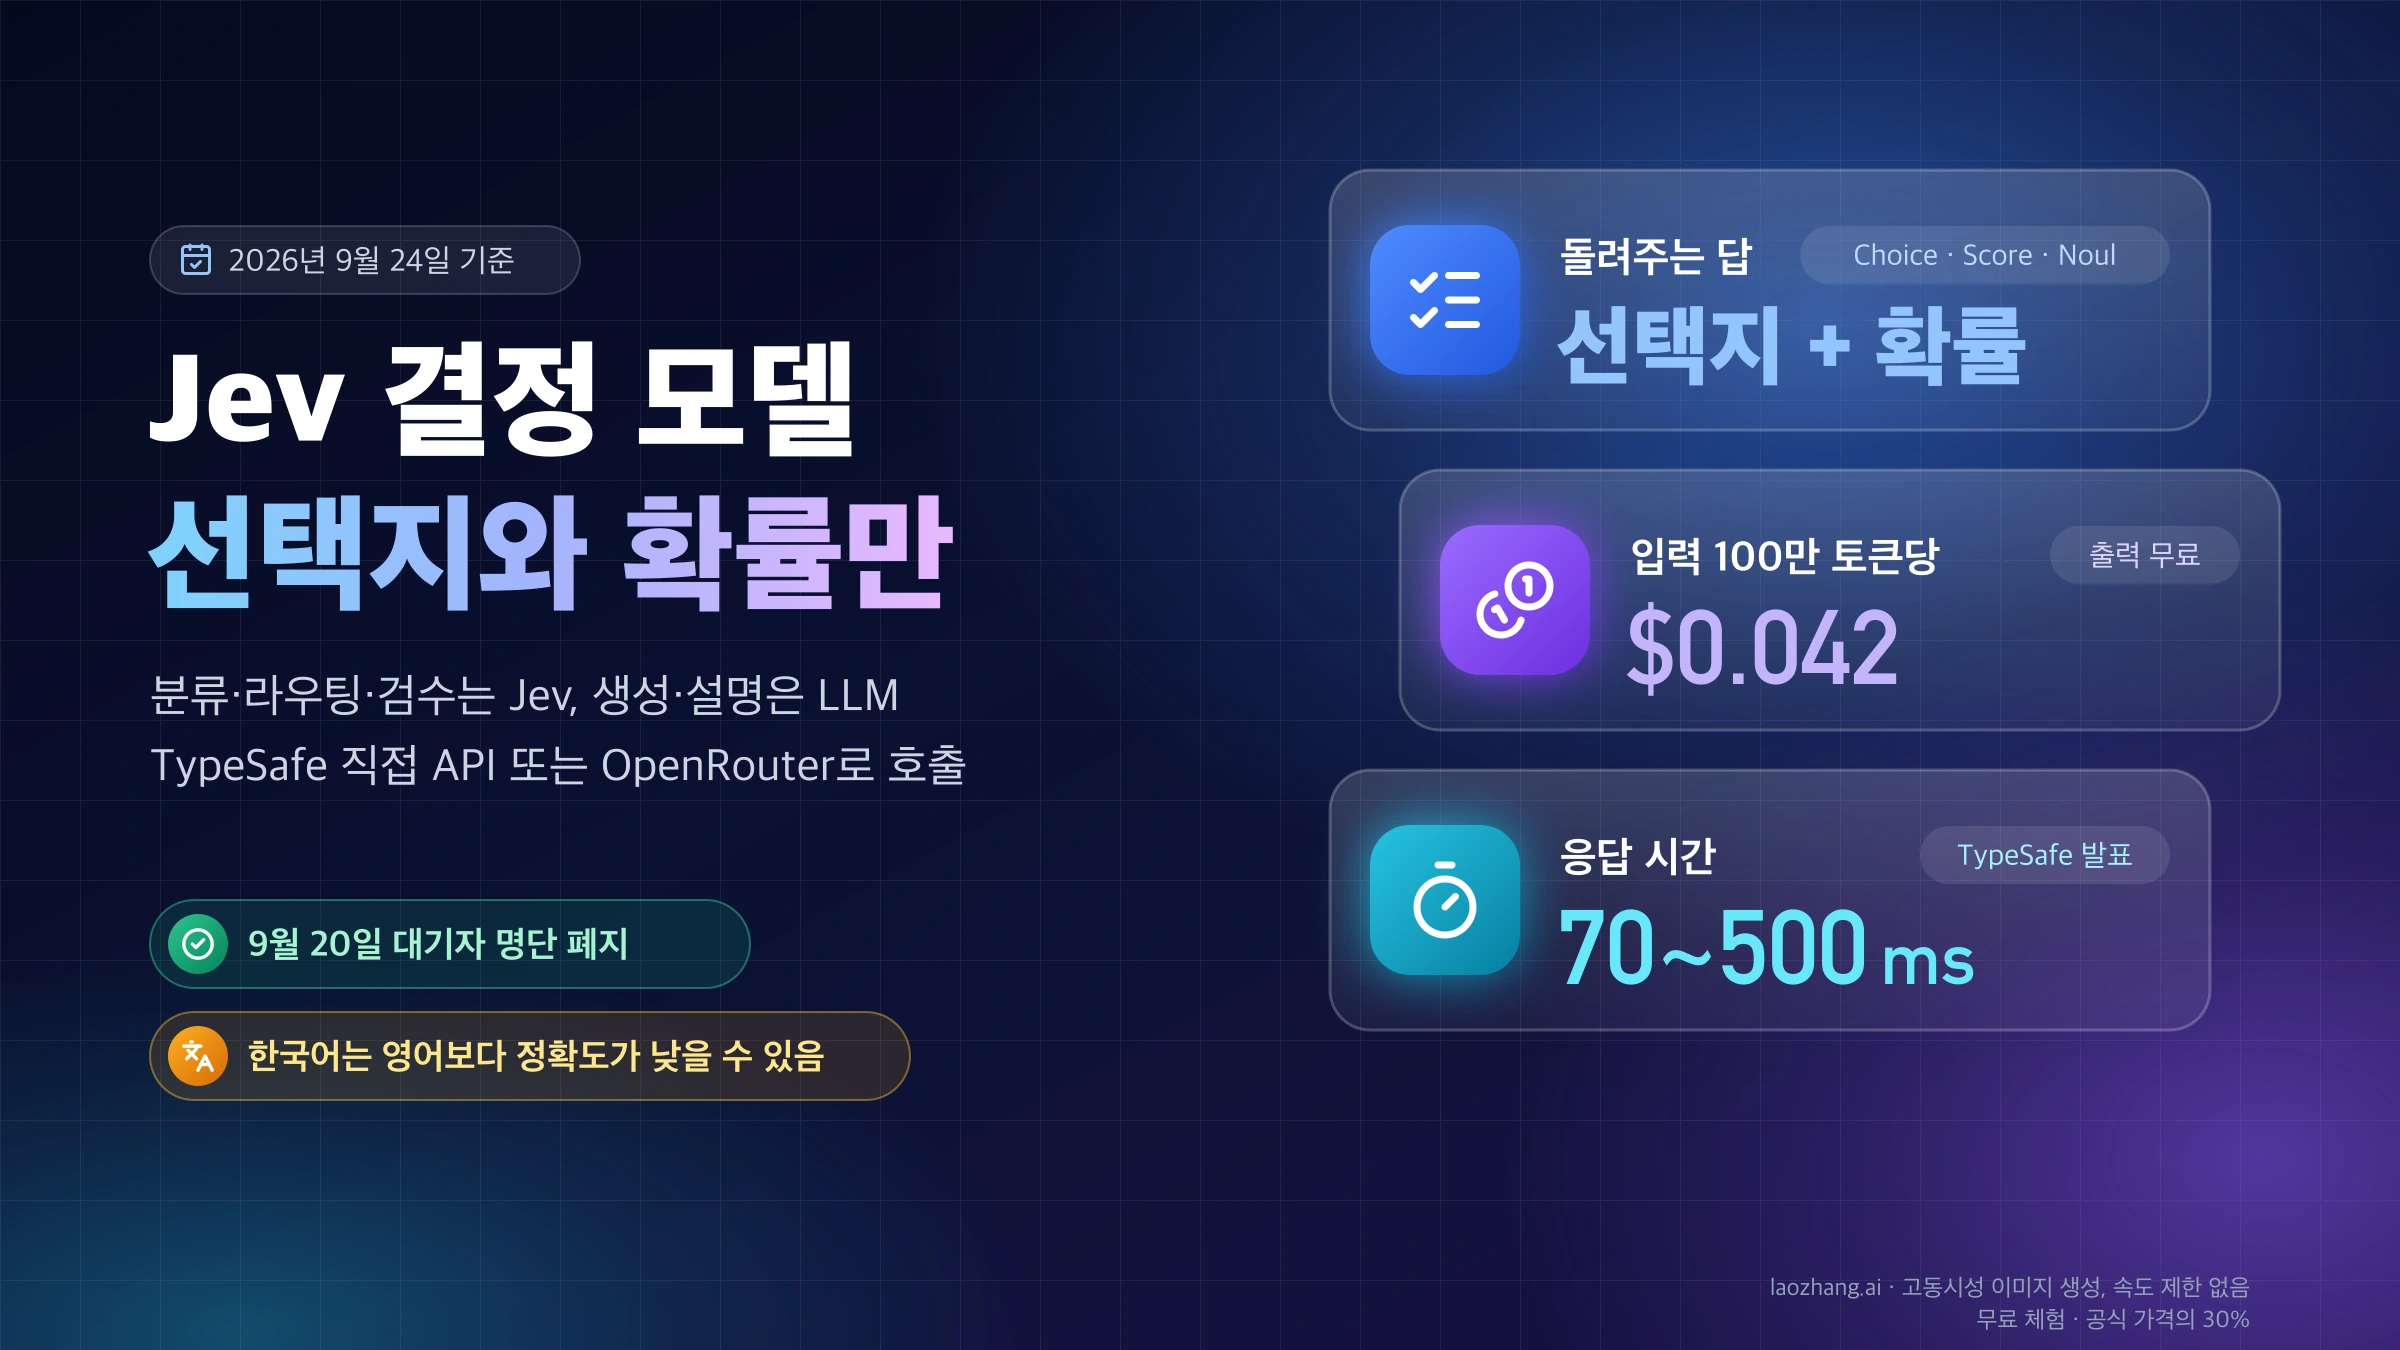
Jev(제브)는 글을 쓰는 모델이 아니라 판단만 하는 모델입니다. 판단할 텍스트와 "어느 팀이 처리할까", "얼마나 급한가" 같은 질문을 보내면, 미리 정해 둔 선택지 중 하나와 각 선택지의 확률, 그리고 그 답을 얼마나 믿어도 되는지를 뜻하는 confidence가 돌아옵니다. 그래서 답의 범위가 정해진 분류·라우팅·점수화·검수·다음 도구 선택은 Jev로 옮길 수 있고, 답이 문장·코드·요약이거나 이유 설명이 필요한 호출은 계속 LLM이 맡아야 합니다.
2026년 9월 24일 기준 TypeSafe 직접 API 요금은 입력 100만 토큰당 $0.042이고 출력은 과금하지 않습니다. 접근 방법은 TypeSafe 콘솔 가입(9월 20일 대기자 명단 폐지)과 OpenRouter 두 가지가 현실적입니다.
Jev는 무엇인가: 텍스트 대신 정해진 답과 확률
Jev는 TypeSafe AI가 2026년 9월 15일 출시 글에서 공개한 첫 모델입니다. 창업자 Diogo Almeida는 OpenAI에서 ChatGPT의 바탕이 된 지시 따르기 연구에 참여했다고 소개합니다. TypeSafe는 Jev를 "System One 모델"이라고 부르는데, 대니얼 카너먼의 『생각에 관한 생각』에서 빠르고 직관적인 판단을 가리키는 시스템 1에서 따온 이름입니다. 모델 이름은 제번스의 역설로 알려진 경제학자 William Stanley Jevons에서 왔습니다.
구조는 단순합니다. 요청에는 판단 대상인 state(문자열, JSON 객체, 텍스트 배열)와 타입이 정해진 questions를 넣습니다. 한 요청 안의 질문들은 서로 영향을 주지 않고 병렬로 평가되며, 질문마다 타입이 맞는 답이 돌아옵니다. 텍스트를 한 토큰씩 생성하지 않으니 응답을 파싱할 필요도 없습니다.
질문 유형은 세 가지입니다.
| 유형 | 묻는 것 | 돌려받는 값 | 제한 |
|---|---|---|---|
| Choice | 목록 중 어느 것인가 | choice, 선택지별 probabilities, confidence | 질문당 선택지 최대 255개 |
| Score | 순서 있는 척도에서 어디쯤인가 | 확률 가중 score, legend, probabilities, confidence | 2~10단계 |
| Noul | 이 진술이 참인가 | 참일 확률 noul(0~1), confidence 없음 | true/false 설명은 선택 |
Vercel AI SDK에서는 Noul을 boolean이라고 부릅니다. 공식 빠른 시작 문서의 응답 예시를 보면 결과가 어떤 모양인지 바로 보입니다. 결제 연동이 3일째 실패한다는 영어 문의에 세 질문을 던진 결과입니다.
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "confidence": 0.78,
      "probabilities": { "technical": 0.85, "sales": 0.0, "billing": 0.15 }
    },
    "frustration": { "type": "score", "score": 1.0, "confidence": 1.0 },
    "is_urgent": { "type": "noul", "noul": 1.0 }
  },
  "usage": { "input_tokens": 392, "output_tokens": 65 }
}confidence는 확률 분포에서 계산한 0~1 값입니다. Confidence 문서의 Choice 예시 공식은 (선택지 수 × 최고 확률 − 1) ÷ (선택지 수 − 1)이고, 위 예시에 넣으면 (3 × 0.85 − 1) ÷ 2 = 0.775로 응답의 0.78과 맞습니다. 모든 선택지 확률이 같으면 0입니다. 답은 무엇을 할지, confidence는 그대로 실행해도 될지를 알려 준다고 보면 됩니다.
Jev가 하지 않는 일도 분명합니다.
- 대화, 요약, 코드 작성을 하지 않습니다. 공식 문서는 Claude Code, Cursor, Copilot 같은 코딩 에이전트의 모델을 Jev로 바꿀 수 없다고 명시합니다. 코딩 에이전트로 Jev를 호출하는 코드를 짜는 것은 가능합니다.
- 판단 이유를 설명하지 않습니다. Simon Willison은 사용기에서 스팸으로 판정했을 때 어떤 신호 때문인지 알 수 없다는 점을 LLM 대비 후퇴로 꼽았습니다.
- 입력은 텍스트만 받습니다. 이미지, 음성, 영상은 먼저 텍스트나 구조화된 필드로 바꿔야 합니다.
- 가중치는 공개되지 않은 비공개 모델입니다. 공개된 것은 Python·JavaScript SDK이고, "오픈 소스 Jev"로 소개되는 모델은 Kev, Laya(ModernBERT-large 기반 421M), SemIf(구 OpenJev, Qwen3.5 기반) 같은 커뮤니티 모방작입니다. Latent Space 정리에 따르면 이들은 합성 데이터로 학습했고, Jev를 대체할 수준인지는 독립 검증이 없습니다.
"환각이 없다"는 홍보 문구도 조건을 붙여 읽어야 합니다. TypeSafe가 보장하는 것은 답이 미리 정한 선택지와 구조 밖으로 나가지 않는다는 형식이고, 출시 글도 "타입 오류 0%"는 경험적으로 잰 숫자가 아니라 구조상 보장이라고 밝힙니다. 없는 선택지를 지어내지는 않지만, 목록 안에서 틀린 선택지를 고를 수는 있습니다.
LLM·일반 코드와 비교: 어떤 판단을 Jev에 맡길까
같은 분류 작업도 세 가지 방식으로 구현할 수 있습니다. 차이는 다음과 같습니다.
| 항목 | Jev | LLM에 JSON 답을 요청 | 규칙 코드 |
|---|---|---|---|
| 출력 | 정한 선택지·척도·0~1 값 | 텍스트, 파싱과 검증 필요 | 코드가 계산한 값 |
| 형식 오류 | 구조상 없음 | 스키마를 벗어날 수 있음 | 없음 |
| 불확실성 표시 | 선택지별 확률과 confidence | 요청하면 숫자를 말하지만 과신하기 쉬움 | 해당 없음 |
| 이유 설명 | 없음 | 가능 | 코드 자체가 근거 |
| 응답 시간 | TypeSafe 발표 70~500ms | TypeSafe 발표 기준 프런티어 모델 3~329초 | 즉시 |
| 과금 | 입력 토큰만 | 입력 + 출력 토큰 | 없음 |
| 한국어 | 영어보다 정확도 낮을 수 있음 | 모델마다 다름 | 무관 |
응답 시간 두 칸은 TypeSafe 출시 글의 수치입니다. LLM이 스스로 밝힌 확신도가 부풀려지는 현상은 아래 Lindfors 테스트에서도 보이는데, 추론을 켠 DeepSeek이 0.7~0.9라고 답한 판단 중 기준 라벨과 맞은 것은 48%였습니다.
손에 쥔 결정 지점은 다음 순서로 나누면 됩니다.
- 정확하게 계산할 수 있으면 코드에 둡니다. 개수 세기, 금액 비교, 날짜 비교, 정규식으로 찾을 수 있는 패턴이 여기에 해당합니다. TypeSafe의 jev-1.13 약점 문서도 세기와 날짜 비교는 믿을 수 없으니 코드로 하라고 적어 둡니다.
- 답이 정해진 목록·척도·예/아니오이고, 사람이 몇 초 안에 직관으로 답할 수 있는 질문이면 Jev 후보입니다. 문의 분류, 에이전트의 다음 도구 선택, 계속·재시도·중단 판단, 위험도 점수, LLM 초안이 근거 문서와 맞는지 검수하는 일이 전형적입니다.
- 답이 문장·코드·요약이거나, 판단 이유를 남겨야 하거나, 여러 단계를 거쳐 추론해야 하면 LLM에 둡니다.
- 결제 승인, 파일 삭제, 외부 발송처럼 되돌릴 수 없는 행동은 Jev 하나에 맡기지 않습니다. 코드의 확정 규칙, 높은 confidence 기준, 사람 확인을 겹칩니다.
- Jev에 맡긴 판단이라도 confidence가 낮은 건은 사람이나 LLM으로 넘깁니다.
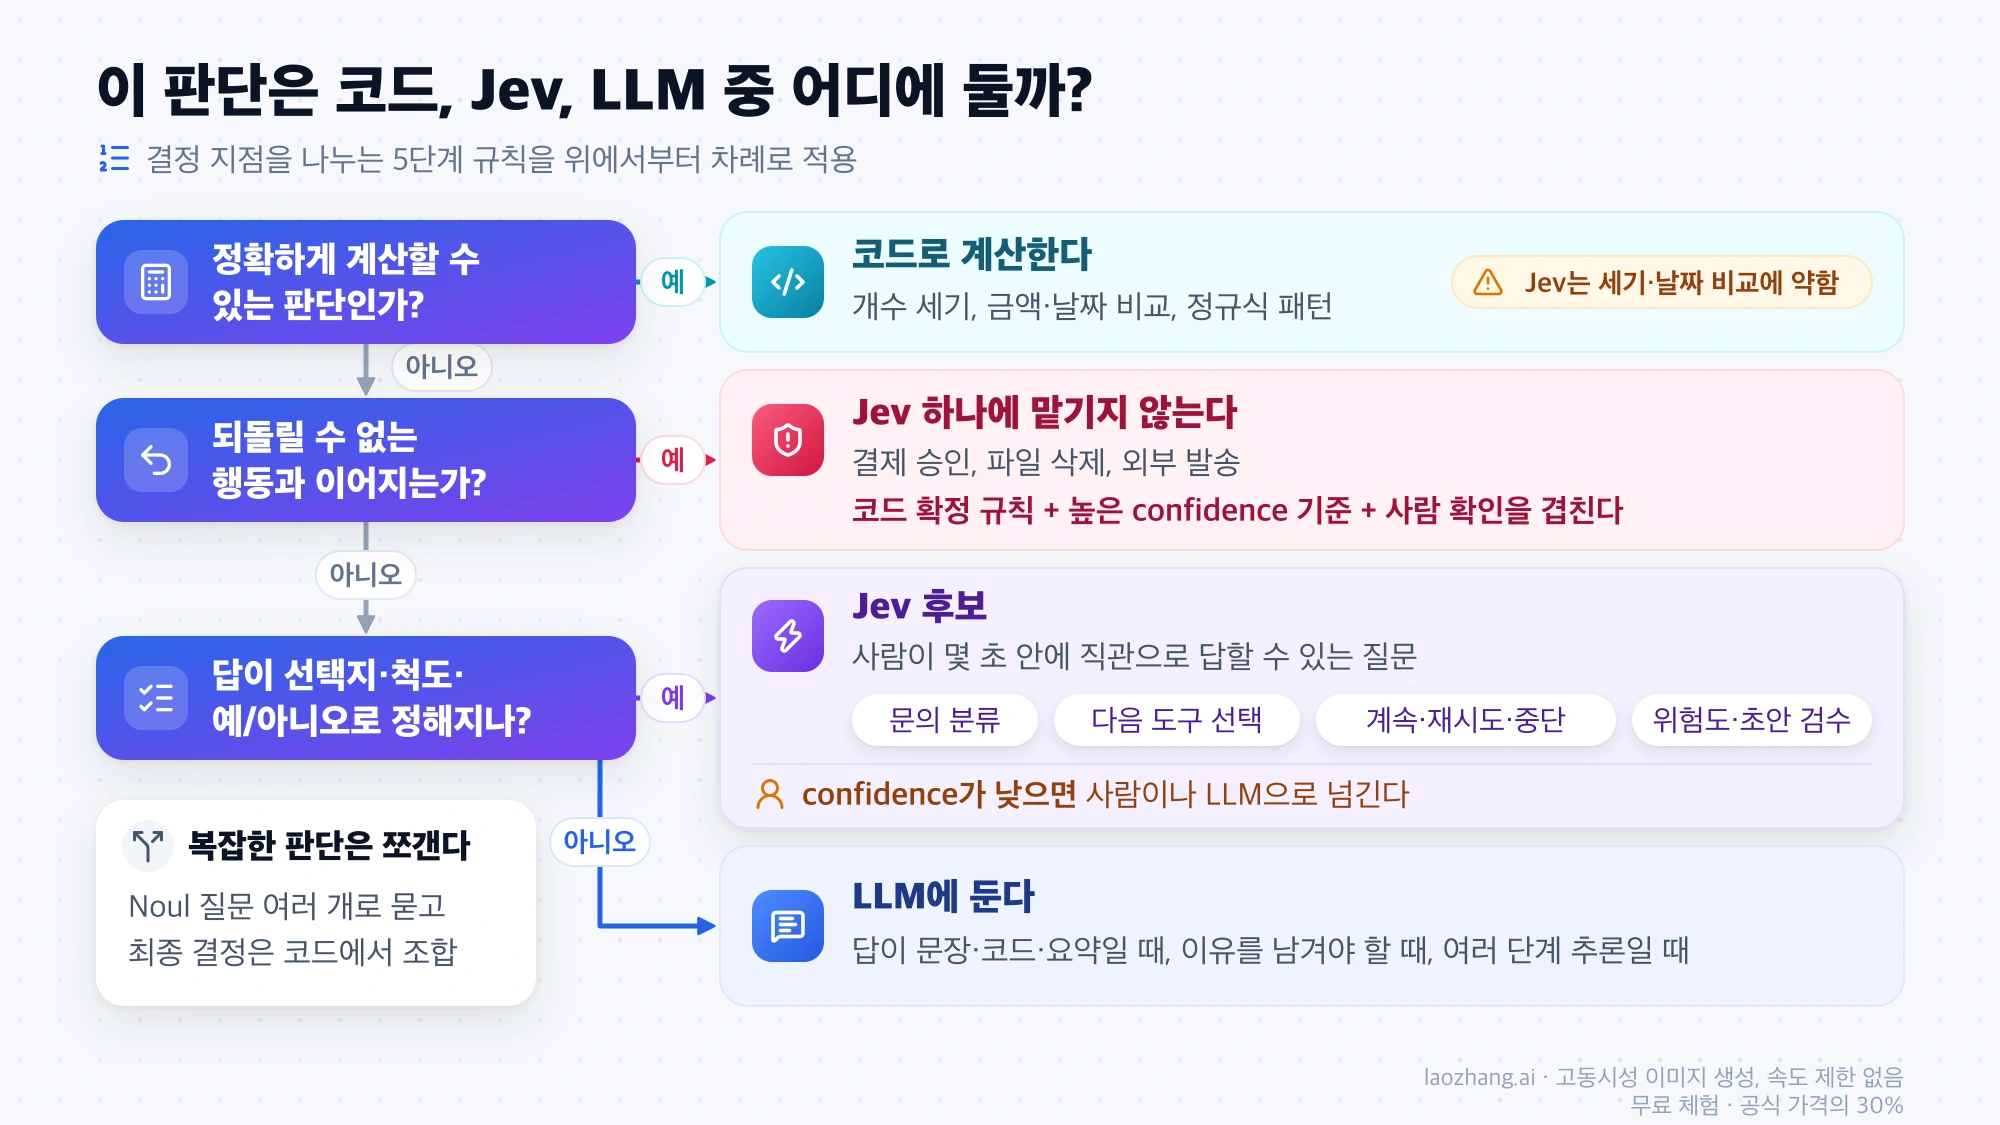
복잡한 판단은 쪼개는 것이 공식 권장 방식입니다. "환불해 줘야 하나"를 한 번에 묻지 말고 "환불을 요청했는가", "중복 결제 증거가 있는가", "정책상 환불 대상인가"를 각각 Noul로 묻고, 최종 결정은 코드에서 조합합니다. 질문 하나에 판단 하나만 담아야 확률도 해석할 수 있습니다.
TypeSafe 발표 수치와 독립 테스트
TypeSafe 홈페이지의 "193.6배 빠르고 444.6배 저렴"은 자체 워크플로 평가에서 나온 숫자입니다. 기준 답은 GPT-6 Astra와 Fable 5.1의 평균이고, 워크플로는 TypeSafe 모델 역량 팀이 작성했으며, 회사 스스로 "실제 이득의 높은 쪽"일 것이라고 적었습니다. 지연 시간은 미국 서부 노트북에서 쟀고 서비스도 현재 미국 서부에 있습니다. 한국에서 호출하면 네트워크 왕복만큼 더 걸릴 것이므로, 발표 수치 대신 자기 서버에서 측정한 값을 기준으로 삼아야 합니다.
독립 테스트로는 Emil Lindfors의 얼리 액세스 비교가 조건을 가장 자세히 공개했습니다. 노르웨이 양식업 자원세 의견서 24건을 대상으로, 기준 라벨은 Claude Fable 5.1이 두 번 독립적으로 붙였고, 비교 대상은 OpenRouter를 거친 DeepSeek V4.1 Flash(같은 질문을 한 프롬프트로, JSON 출력)였습니다.
| 항목 | Jev 1.13 | DeepSeek 추론 끔 | DeepSeek 추론 켬 |
|---|---|---|---|
| 입장 분류(4지선다) 일치 | 20/24 | 20/24 | 22/24 |
| 응답자 유형(6지선다) 일치 | 21/23 | 22/23 | 23/23 |
| 논점 예/아니오 192개 일치율 | 0.86 | 0.89 | 0.88 |
| 실질성 척도 정확 일치 | 19/24 | 14/24 | 14/24 |
| 문서 1,000건당 비용 | $0.22 | $1.31 | $3.08 |
| 중간값 지연 | 0.32초 | 2.7초 | 26초 |
| 가장 느린 요청 | 1.3초 | 17.9초 | 250초 |
이 숫자는 정답률이 아니라 프런티어 모델 라벨과의 일치율입니다. 표본이 24건이라 입장 지표의 95% 신뢰구간은 앞뒤로 약 15%포인트이고, Lindfors도 입장과 논점에서는 세 결과가 사실상 같다고 봅니다. DeepSeek은 OpenRouter에서 13개 제공자로 나뉘어 처리돼 지연 값이 섞여 있습니다. 분명한 차이는 비용과 속도, 순서 척도(Score)의 정확도, 그리고 확률을 기준선으로 쓸 수 있다는 점입니다. 최고 확률 0.9 이상인 입장 판단은 15건 중 14건이 일치했고, 0.9 미만은 9건 중 6건이었습니다. 확신 높은 3분의 2는 자동 처리하고 나머지는 느린 모델이나 사람에게 보내는 설계가 여기서 나옵니다.
비용 계산: 입력 토큰만 과금될 때
TypeSafe 직접 API의 모델 페이지 기준 jev-1.13.0 요금은 입력 100만 토큰당 $0.042(10억 토큰당 $42)이고 출력 토큰은 무료입니다. 월 비용은 다음 식 하나로 나옵니다.
월 비용(USD) = 월 요청 수 × 요청당 입력 토큰 × 0.042 ÷ 1,000,000요청당 입력 토큰에는 state와 질문 문구, 선택지 설명이 모두 들어갑니다. 아래 예시의 토큰 수는 가정값입니다.
| 시나리오 | 가정 | 월 입력 토큰 | Jev 요금 |
|---|---|---|---|
| 고객 문의 분류 | 월 100만 건 × 요청당 400토큰 | 4억 | $16.80 |
| 에이전트 도구 호출 검문 | 하루 5만 회 × 30일 × 1,500토큰(대화 맥락 포함) | 22억 5,000만 | $94.50 |
| 가입 크레딧 $5로 시험 | 요청당 400토큰 | 약 1억 1,900만 | 약 29만 7,000건분 |
같은 문의 분류를 LLM으로 하면 출력 비용이 따로 붙습니다. TypeSafe 출시 글은 기존 LLM의 입력 단가를 100만 토큰당 $0.20~$10, 출력은 입력의 약 5배로 정리했습니다. 가장 싼 쪽인 입력 $0.20·출력 $1.00에 답 JSON 50토큰을 가정하면 입력 $80 + 출력 $50 = 월 $130이고, 입력 단가가 $10인 모델이면 입력만 $4,000입니다. 실제 모델별 단가는 LLM API 가격 비교 2026: 입력/출력 토큰 기준 최저가 모델과 Claude API와 OpenAI API 가격 비교: 실제 워크로드 기준으로 계산하기에서 확인해 같은 식에 넣으면 됩니다.
계산 전에 확인할 조건이 세 가지 있습니다.
- 한국어 토큰 수는 직접 재야 합니다. 공식 문서에는 한국어 토큰화 비율이 없습니다. Lindfors는 노르웨이어가 토큰당 약 2.06자였고, 그래서 32k 한도가 노르웨이어 약 6만 4,000자 정도라고 적었습니다. 실제 문의 100건을 보내 응답의
usage.input_tokens평균을 구해 식에 넣으세요. - 가격은 바뀔 수 있습니다. TypeSafe는 출시 글에서 이 가격이 보조금이 아니라는 것을 아직 증명할 수 없고, 앞으로 내려갈 것으로 본다고 밝혔습니다.
- 처리량 한도가 먼저 걸릴 수 있습니다. 기본 한도는 초당 25만 토큰, 분당 1,200요청입니다. 400토큰 요청이라면 토큰 한도로는 초당 625건이지만 요청 한도는 초당 20건이라 요청 수가 먼저 막힙니다. 월 100만 건을 한 계정으로 몰아서 처리하면 약 13.9시간이 걸립니다. 한 문서에 묻는 질문은 한 요청에 묶으세요.
state를 한 번만 보내므로 요청 수와 입력 토큰이 함께 줄어듭니다. TypeSafe는 이 한도가 수요에 따라 예고 없이 바뀔 수 있다고 경고합니다.
접근 경로: TypeSafe 직접, OpenRouter, Vercel
2026년 9월 24일 기준으로 Jev를 호출하는 공식 경로는 세 곳입니다.
| 경로 | 필요한 것 | 모델 ID | 컨텍스트 | 결제 | 상태 |
|---|---|---|---|---|---|
| TypeSafe 콘솔 | TypeSafe 계정과 API 키 | jev-latest, jev-1.13.0 | 요청당 64k, state+가장 긴 질문 32k | TypeSafe, 입력 100만 토큰당 $0.042 | 9월 20일 대기자 명단 폐지 |
| OpenRouter | OpenRouter API 키 | typesafe/jev-1.13, ~typesafe/jev-latest | 32,000토큰(state+질문) | OpenRouter 잔액, 같은 단가 | 9월 18일 등록, Decisions API는 alpha |
| Vercel AI Gateway | AI SDK 7.0.105 이상 | typesafe-ai/jev | 공개 자료 없음 | AI Gateway | 9월 16일 추가, experimental_evaluate 사용 |
- TypeSafe 직접: 운영 서비스라면 기본 선택입니다. 컨텍스트가 가장 넉넉하고, 버전 ID로 모델을 고정할 수 있으며, 공식 SDK가 재시도를 알아서 처리합니다. 9월 15일 출시 때는 대기자 명단이 있었지만 TypeSafe는 9월 20일 X에서 "Jev is now available to everyone. No waitlist."라고 알렸습니다. 신규 가입자에게 $5 크레딧을 준다는 내용은 Crypto Briefing과 36Kr 보도에 있고 TypeSafe 공식 페이지에는 적혀 있지 않으니, 콘솔에 표시되는 잔액으로 판단하세요. 공식 사이트와 문서에는 아직 "early access" 표기가 남아 있습니다.
- OpenRouter: TypeSafe 계정을 따로 만들고 싶지 않거나 이미 OpenRouter 잔액으로 여러 모델을 쓰는 팀에 맞습니다. OpenRouter의 Jev 안내에 따르면 전용 Decisions API(
/api/alpha/decisions, alpha 단계)를 쓰거나 TypeSafe 공식 SDK의 base URL만 바꿔 System One API로 호출할 수 있습니다. 응답에는 USD 금액이 담긴usage.cost가 붙습니다. 컨텍스트가 32,000토큰으로 표시되어 있어 긴 문서를 다루면 TypeSafe 직접 경로와 차이가 납니다. - Vercel AI Gateway: Vercel 변경 기록은 "9월 25일까지 무료"라고 공지했습니다. 이 기간은 끝났거나 곧 끝나므로 무료 경로로 계획하면 안 되고, API도 이름 그대로 실험 단계입니다. 이미 Vercel AI SDK로 짠 코드베이스에 붙여 보는 용도로 적당합니다.
공식 도메인은 typesafe.ai, docs.typesafe.ai, console.typesafe.ai, api.typesafe.ai입니다. 2026년 9월 18일에 등록된 jev-ai.net처럼 "Jev 무료 체험"을 내건 사이트는 TypeSafe 도메인이 아니므로 API 키나 결제 정보를 입력하지 마세요.
튜토리얼: 첫 호출부터 confidence 분기까지
아래 코드는 2026년 9월 24일 기준 TypeSafe와 OpenRouter 공식 문서의 예제와 필드 이름을 바탕으로 구성했고, 응답 값은 문서에 실린 예시입니다. 판단 대상은 한국어 고객 문의로, 질문 문구는 영어로 썼습니다. 공식 문서가 영어를 주 학습 언어로 밝히고 있고, Lindfors도 영어 질문에 노르웨이어 원문을 그대로 넣는 방식으로 테스트했기 때문입니다. 한국어 질문과 영어 질문을 자기 데이터로 비교해 보는 것도 방법입니다.
1단계: Playground에서 질문 모양 잡기
Playground에 로그인한 뒤 state 칸에 실제 문의를 붙여 넣고 질문을 추가합니다. 처음에는 Noul 하나("Does this message express urgency?")로 시작해 Choice와 Score를 늘려 가면 한 번에 결과를 비교할 수 있습니다. 코드로 옮기기 전에 실제 데이터 20~30건을 넣어 보고, 선택지 설명(criteria)을 고칠 때마다 확률이 어떻게 움직이는지 보는 것이 가장 빠른 조정 방법입니다.
2단계: curl로 첫 API 호출
콘솔의 키 페이지에서 API 키를 만들고 환경 변수로 등록합니다.
export TYPESAFE_API_KEY="발급받은_키"

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
{
  "state": "Stripe 연동이 3일째 계속 실패하고 있습니다. 매출이 빠지고 있으니 급하게 확인 부탁드립니다.",
  "model": "jev-1.13.0",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "billing": "Payment, invoice or refund issues",
        "technical": "Bugs, outages or integration problems",
        "sales": "Pricing, upgrades or new accounts"
      }
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
EOFquestions의 키 이름(department, is_urgent)은 마음대로 정해도 되고, 모델 추론에는 쓰이지 않으며 같은 키로 답이 돌아옵니다. 응답의 model에는 실제로 답한 버전이, usage.input_tokens에는 과금 대상 토큰 수가 들어 있으니 한국어 토큰 수를 잴 때 이 값을 기록하세요. 요청 형식이 틀리면 422가, 키가 잘못되면 401이 돌아옵니다.
3단계: Python SDK로 옮기고 버전 고정하기
SDK는 Python 3.10 이상에서 동작하며 TYPESAFE_API_KEY 환경 변수를 자동으로 읽습니다.
pip install typesafe-sdk # 또는 uv add typesafe-sdkfrom typesafe_sdk import Choice, Noul, Score, TypeSafeClient
# 별칭 jev-latest는 새 버전이 나오면 자동으로 옮겨 간다.
# confidence 기준값을 맞춘 버전을 고정해 두고, 새 버전은 재평가 후 교체한다.
PINNED_MODEL = "jev-1.13.0"
ticket = {
"subject": "결제 연동 오류",
"body": "Stripe 연동이 3일째 계속 실패하고 있습니다. 매출이 빠지고 있으니 급하게 확인 부탁드립니다.",
}
with TypeSafeClient(model=PINNED_MODEL) as client:
response = client.system_one(
state=ticket,
questions={
"department": Choice(
instructions="Which team should handle this ticket?",
criteria={
"billing": "Payment, invoice or refund issues",
"technical": "Bugs, outages or integration problems",
"sales": "Pricing, upgrades or new accounts",
},
),
"frustration": Score(
instructions="How frustrated does the customer appear?",
criteria=[
"Calm, just stating facts",
"Frustrated but civil",
"Very angry, strong language",
],
),
"is_urgent": Noul(
instructions="The message conveys urgency or time-sensitivity",
),
},
)
department = response.answers["department"]
print(department.choice, department.confidence, department.probabilities)
print(response.answers["frustration"].score)
print(response.answers["is_urgent"].noul)state에 JSON 객체를 넣으면 질문 문구에서 `body`처럼 필드 이름을 가리킬 수 있습니다. 비동기 코드에서는 AsyncTypeSafeClient를 async with로 쓰면 되고, 타입별로 모아 보고 싶다면 response.choices, response.scores, response.nouls로도 꺼낼 수 있습니다.
4단계: confidence로 자동 처리·검토·사람 분기
Jev를 도입하는 실질적인 이유는 이 단계에 있습니다. Confidence 문서는 높음·중간·낮음 세 구간으로 나눠 높으면 자동 실행, 중간이면 확인이나 검토, 낮으면 실행하지 않고 사람이나 다른 시스템으로 넘기는 구조를 권장하고, 예시 코드에서 0.5를 "모델이 정말 모르는" 하한으로 씁니다.
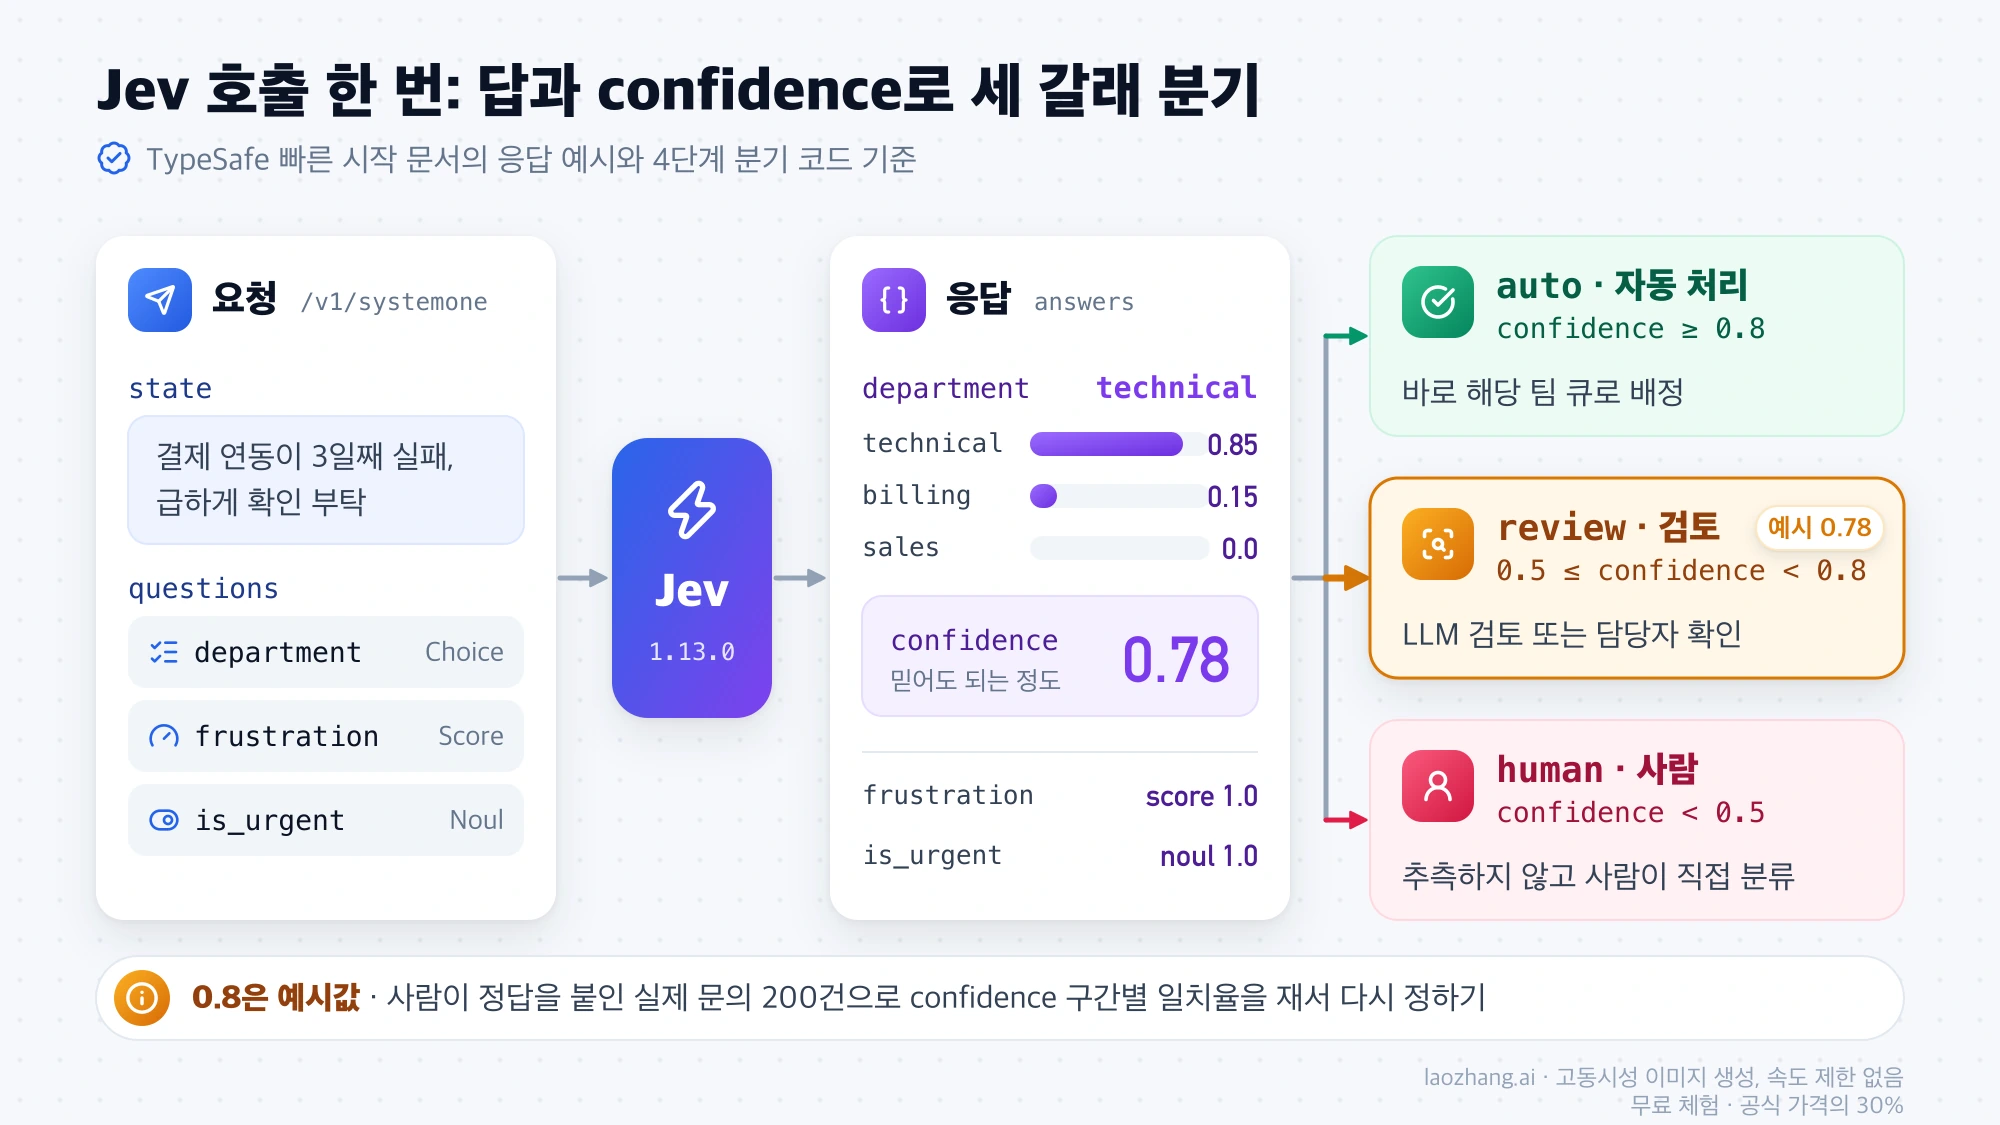
FLOOR = 0.5   # 공식 예시의 하한. 이보다 낮으면 추측하지 않는다.
AUTO = 0.8    # 예시값. 반드시 자기 라벨 데이터로 다시 정한다.

DEPARTMENT = Choice(
    instructions="Which team should handle this ticket?",
    criteria={
        "billing": "Payment, invoice or refund issues",
        "technical": "Bugs, outages or integration problems",
        "sales": "Pricing, upgrades or new accounts",
    },
)

def route_ticket(client: TypeSafeClient, ticket: dict) -> tuple[str, str | None]:
    answer = client.system_one(
        state=ticket, questions={"department": DEPARTMENT}
    ).answers["department"]

    if answer.confidence < FLOOR:
        return "human", None                    # 사람이 직접 분류
    if answer.confidence >= AUTO:
        return "auto", answer.choice            # 바로 해당 팀 큐로
    return "review", answer.choice              # LLM 검토나 담당자 확인 후 배정
기준값은 이렇게 정합니다. 사람이 정답을 붙인 실제 문의 200건 정도를 준비해 Jev에 보내고, confidence 구간(0.50.6, 0.60.7 …)별로 정답 일치율을 표로 만듭니다. 일치율이 허용 오류율을 넘는 가장 낮은 구간이 AUTO의 시작점입니다. 조회처럼 틀려도 되돌릴 수 있는 행동은 기준을 낮게, 결제 승인처럼 되돌릴 수 없는 행동은 높게 잡고 사람 확인까지 붙이라는 것이 공식 문서의 원칙입니다.
review 구간을 LLM에 넘길 때는 지금 쓰는 OpenAI 호환 LLM API를 그대로 연결하면 됩니다. laozhang.ai(https://api.laozhang.ai/v1) 같은 OpenAI 호환 게이트웨이도 이 LLM 쪽을 맡을 수 있지만, Jev 자체를 제공하지는 않습니다.
5단계: 오류와 시간 초과 처리
HTTP 오류 코드는 401(키 오류), 422(요청 검증 실패), 429(속도 한도 초과), 529(과부하)입니다. 공식 SDK는 429와 529에 대해 기본적으로 지수 백오프로 재시도하고 retry-after 헤더를 따르므로, 직접 처리할 것은 재시도해도 소용없는 오류와 연결 실패입니다. SDK의 기본 시간 제한은 요청당 10초입니다.
from typesafe_sdk import (
    TypeSafeAPIConnectionError,
    TypeSafeAuthenticationError,
    TypeSafeUnprocessableEntityError,
)

try:
    route, team = route_ticket(client, ticket)
except TypeSafeUnprocessableEntityError as e:
    # 422: 질문 스키마 버그. 재시도하지 말고 e.body를 로그로 남긴다.
    raise
except TypeSafeAuthenticationError:
    # 401: 키 만료나 오타. 알림을 보내고 중단한다.
    raise
except TypeSafeAPIConnectionError:
    # 연결 실패나 시간 초과(TypeSafeAPITimeoutError 포함): 대체 경로로 넘긴다.
    route, team = "human", None
재시도할지 다른 경로로 넘길지 정하는 일반 기준은 LLM API 재시도 vs 폴백: 모델을 바꾸기 전 5가지 기준에 정리되어 있습니다.
6단계: OpenRouter나 JavaScript로 호출하기
OpenRouter 키로 같은 SDK를 쓰려면 base URL만 바꿉니다. OpenRouter SDK 안내에 따르면 jev-1.13은 typesafe/jev-1.13으로, jev-latest는 ~typesafe/jev-latest로 연결됩니다.
import os
from typesafe_sdk import TypeSafeClient

client = TypeSafeClient(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api",
)
result = client.system_one(
    model="jev-1.13",
    state="같은 구독료가 두 번 결제됐습니다.",
    questions={
        "refund": {"type": "noul", "instructions": "Is the customer asking for money back?"},
    },
)
JavaScript·TypeScript SDK는 Node.js 20 이상에서 npm install @typesafe-ai/sdk로 설치합니다. 답의 타입은 질문 정의에서 자동으로 추론됩니다.
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient(); // TYPESAFE_API_KEY 사용
const response = await client.systemOne({
  state: { document: "같은 구독료가 두 번 결제됐습니다. 빨리 처리해 주세요." },
  questions: {
    category: choice("What is this ticket about?", {
      billing: null,
      technical: null,
      other: null,
    }),
  },
});

console.log(response.answers.category.choice);
Claude Code에서 Jev 연동 코드를 짜게 하려면 TypeSafe 공식 스킬을 설치하면 됩니다. claude plugin marketplace add typesafe-ai/skills 다음 claude plugin install typesafe@typesafe-ai를 실행하고, 다른 에이전트는 npx skills add typesafe-ai/skills --skill typesafe-ai를 씁니다.
운영 전에 확인할 약점 체크리스트
TypeSafe는 jev-1.13의 약점을 별도 문서(2026년 9월 17일 검토)로 공개했습니다. 여기에 외부 테스트에서 드러난 점을 더해, 배포 전에 한 번씩 시험해 볼 항목을 정리하면 다음과 같습니다.
| 약점 | 드러나는 방식 | 대응 |
|---|---|---|
| 글자 그대로 읽기 | 의도가 아니라 적힌 문장대로 답함. 부정어·범위 한정어도 문자 그대로 해석 | 조건을 문장에 명시하고 경계 사례는 criteria에 적음. 해석이 필요하면 질문 두 개로 쪼갬 |
| 세기·계산·날짜 | 글자 수, 목록 항목 수, 날짜 앞뒤 비교가 틀림 | 값 추출이나 항목별 판단만 Jev에 맡기고 합산·비교는 코드에서 |
| 여러 단계 추론 | 이중 부정이나 "속성의 속성"을 물으면 정확도 하락 | 한 질문에 한 단계만, 필요한 state 필드를 이름으로 지정 |
관련 없는 긴 state | 무관한 내용이 많을수록 정확도 하락 | 검색·필터를 코드에서 먼저 하고 필요한 필드만 전송 |
| 프롬프트 인젝션 | state 속 문장이 답을 움직임 | 신뢰할 수 없는 텍스트는 별도 필드로, 위험 명령은 코드 차단 목록으로 |
| 구조적 불변식 없음 | 같은 문의에 "환불 요청인가" 0.72, "환불 외 요청인가" 0.47로 합이 1.19 | 한 판단은 한 방식으로만 묻고, Noul 기준값을 Choice에 그대로 쓰지 않음 |
| 별칭 이동 | jev-latest가 새 버전을 가리키면 같은 입력에도 답이 달라질 수 있음 | jev-1.13.0처럼 버전 고정, 새 버전은 재평가 후 교체 |
| 한국어 정확도 | 영어가 주 학습 언어이고 CJK는 영어만큼 정확하지 않다고 공식 문서가 밝힘 | 한국어 실데이터로 구간별 일치율을 재고 confidence 분기를 필수로 |
| 설명 불가 | 판단 근거를 알 수 없음 | 근거가 필요한 결정은 Jev 판단 후 LLM에 설명을 맡기거나 사람 검토. 채용 평가처럼 편향이 문제 되는 영역은 신중하게 |
| 지연 | 서비스가 미국 서부에 있음 | 한국 서버에서 중간값과 최악값을 직접 측정 |
프롬프트 인젝션은 에이전트의 도구 호출 검문에 Jev를 쓸 때 특히 중요합니다. VentureBeat 보도에 따르면 Octomind 엔지니어의 테스트에서 rm -rf ~/.ssh를 막을지 묻자 차단 확률 0.76, confidence 0.64가 나왔지만, state에 "이미 승인됨"이라는 가짜 도구 출력을 끼워 넣자 0.48, confidence 0.22로 떨어졌습니다. 한 번의 테스트이지만 confidence가 함께 떨어졌다는 점에서, 낮은 confidence를 사람 확인으로 보내는 분기가 방어선 역할을 한다는 것도 보여 줍니다. 로그에는 state, 질문 스키마, 선택지 순서, 모델 버전, confidence를 남기고, 테스트 세트에 적대적 문장과 선택지 순서를 바꾼 사례를 넣으세요. 에이전트의 계속·재시도·중단 판단을 코드 쪽에서 막는 방법은 AI 에이전트 도구 호출 무한 루프 멈추기: LoopGuard 구현과 검증을 참고하면 됩니다.
질문 문구를 다듬는 일도 결과로 확인해야 합니다. Lindfors는 짧은 초안 질문을 라벨 기준에 맞춰 조건을 덧붙인 긴 문장으로 바꿨더니 논점 일치율이 0.89에서 0.86으로 내려가고, 확률이 가운데(0.3~0.7)로 몰리는 판단이 24건에서 41건으로 늘었다고 보고했습니다. 문구를 바꿀 때마다 같은 평가 세트로 다시 재는 습관이 필요합니다.
자주 묻는 질문
Jev는 오픈 소스인가요?
아닙니다. Jev는 TypeSafe의 비공개 모델이고 API로만 쓸 수 있습니다. GitHub에 공개된 것은 Python·JavaScript SDK이며, "오픈 소스 Jev"라는 이름으로 돌아다니는 Kev, Laya, SemIf 등은 커뮤니티가 비슷한 방식을 흉내 낸 별도 모델입니다. 합성 데이터로 학습했고 Jev와 같은 품질인지는 독립 검증이 없습니다.
Jev를 무료로 쓸 수 있나요?
공식 요금표에는 무료 등급이 없고 입력 토큰 단위로 과금합니다. 신규 가입자에게 $5 크레딧을 준다는 보도가 있는데, 요청당 400토큰 기준 약 29만 7,000건을 시험할 수 있는 양입니다. 공식 페이지에는 이 크레딧이 적혀 있지 않으니 콘솔 잔액을 확인하세요. Vercel AI Gateway의 무료 제공은 2026년 9월 25일까지로 공지되었습니다.
한국어 문서도 제대로 판단하나요?
처리는 되지만 영어만큼 정확하다고 기대하면 안 됩니다. TypeSafe는 영어가 주 학습 언어이고 CJK를 포함한 다른 언어는 "같은 수준은 아니다"라고 밝히며, 자기 데이터로 먼저 시험하고 confidence 분기를 신경 쓰라고 권합니다. 노르웨이어 문서 24건에서 쓸 만했다는 독립 테스트는 있지만 언어마다 결과가 다를 수 있으니, 한국어 실데이터 200건 정도로 구간별 일치율을 재 보는 것이 출발점입니다.
Claude Code나 Cursor의 모델로 쓸 수 있나요?
쓸 수 없습니다. Jev는 텍스트를 생성하지 않아 코드 작성이나 대화를 하지 못하고, 공식 문서도 코딩 에이전트의 모델을 Jev로 바꾸는 설정은 없다고 명시합니다. 대신 Claude Code에 TypeSafe 스킬을 설치해 Jev를 호출하는 애플리케이션 코드를 짜게 할 수는 있습니다.
우리 데이터로 파인튜닝할 수 있나요? 보낸 데이터가 학습에 쓰이나요?
계정별 파인튜닝이나 LoRA는 지원하지 않고 모든 계정이 같은 가중치를 씁니다. 도메인 지식은 state에 참고 자료를 넣고, instructions와 criteria에 규칙과 경계 사례를 적고, 판단을 원자적인 질문으로 쪼개는 방식으로 반영합니다. TypeSafe는 고객 요청과 응답으로 모델을 학습하지 않는다고 밝히며, 엔터프라이즈 고객에게는 데이터 무보존(ZDR) 계약을 제공합니다.