AI 에이전트 도구 호출 무한 루프 멈추기: LoopGuard 구현과 검증
AI 에이전트의 반복 호출을 멈추려면 다음 실행을 차단하고, 이미 실행된 작업의 결과를 보존해야 합니다. 직렬 LoopGuard 예제로 실제 진행과 종료를 확인하고, 결과가 불명확한 쓰기 작업의 복구 기준을 정합니다.
목차
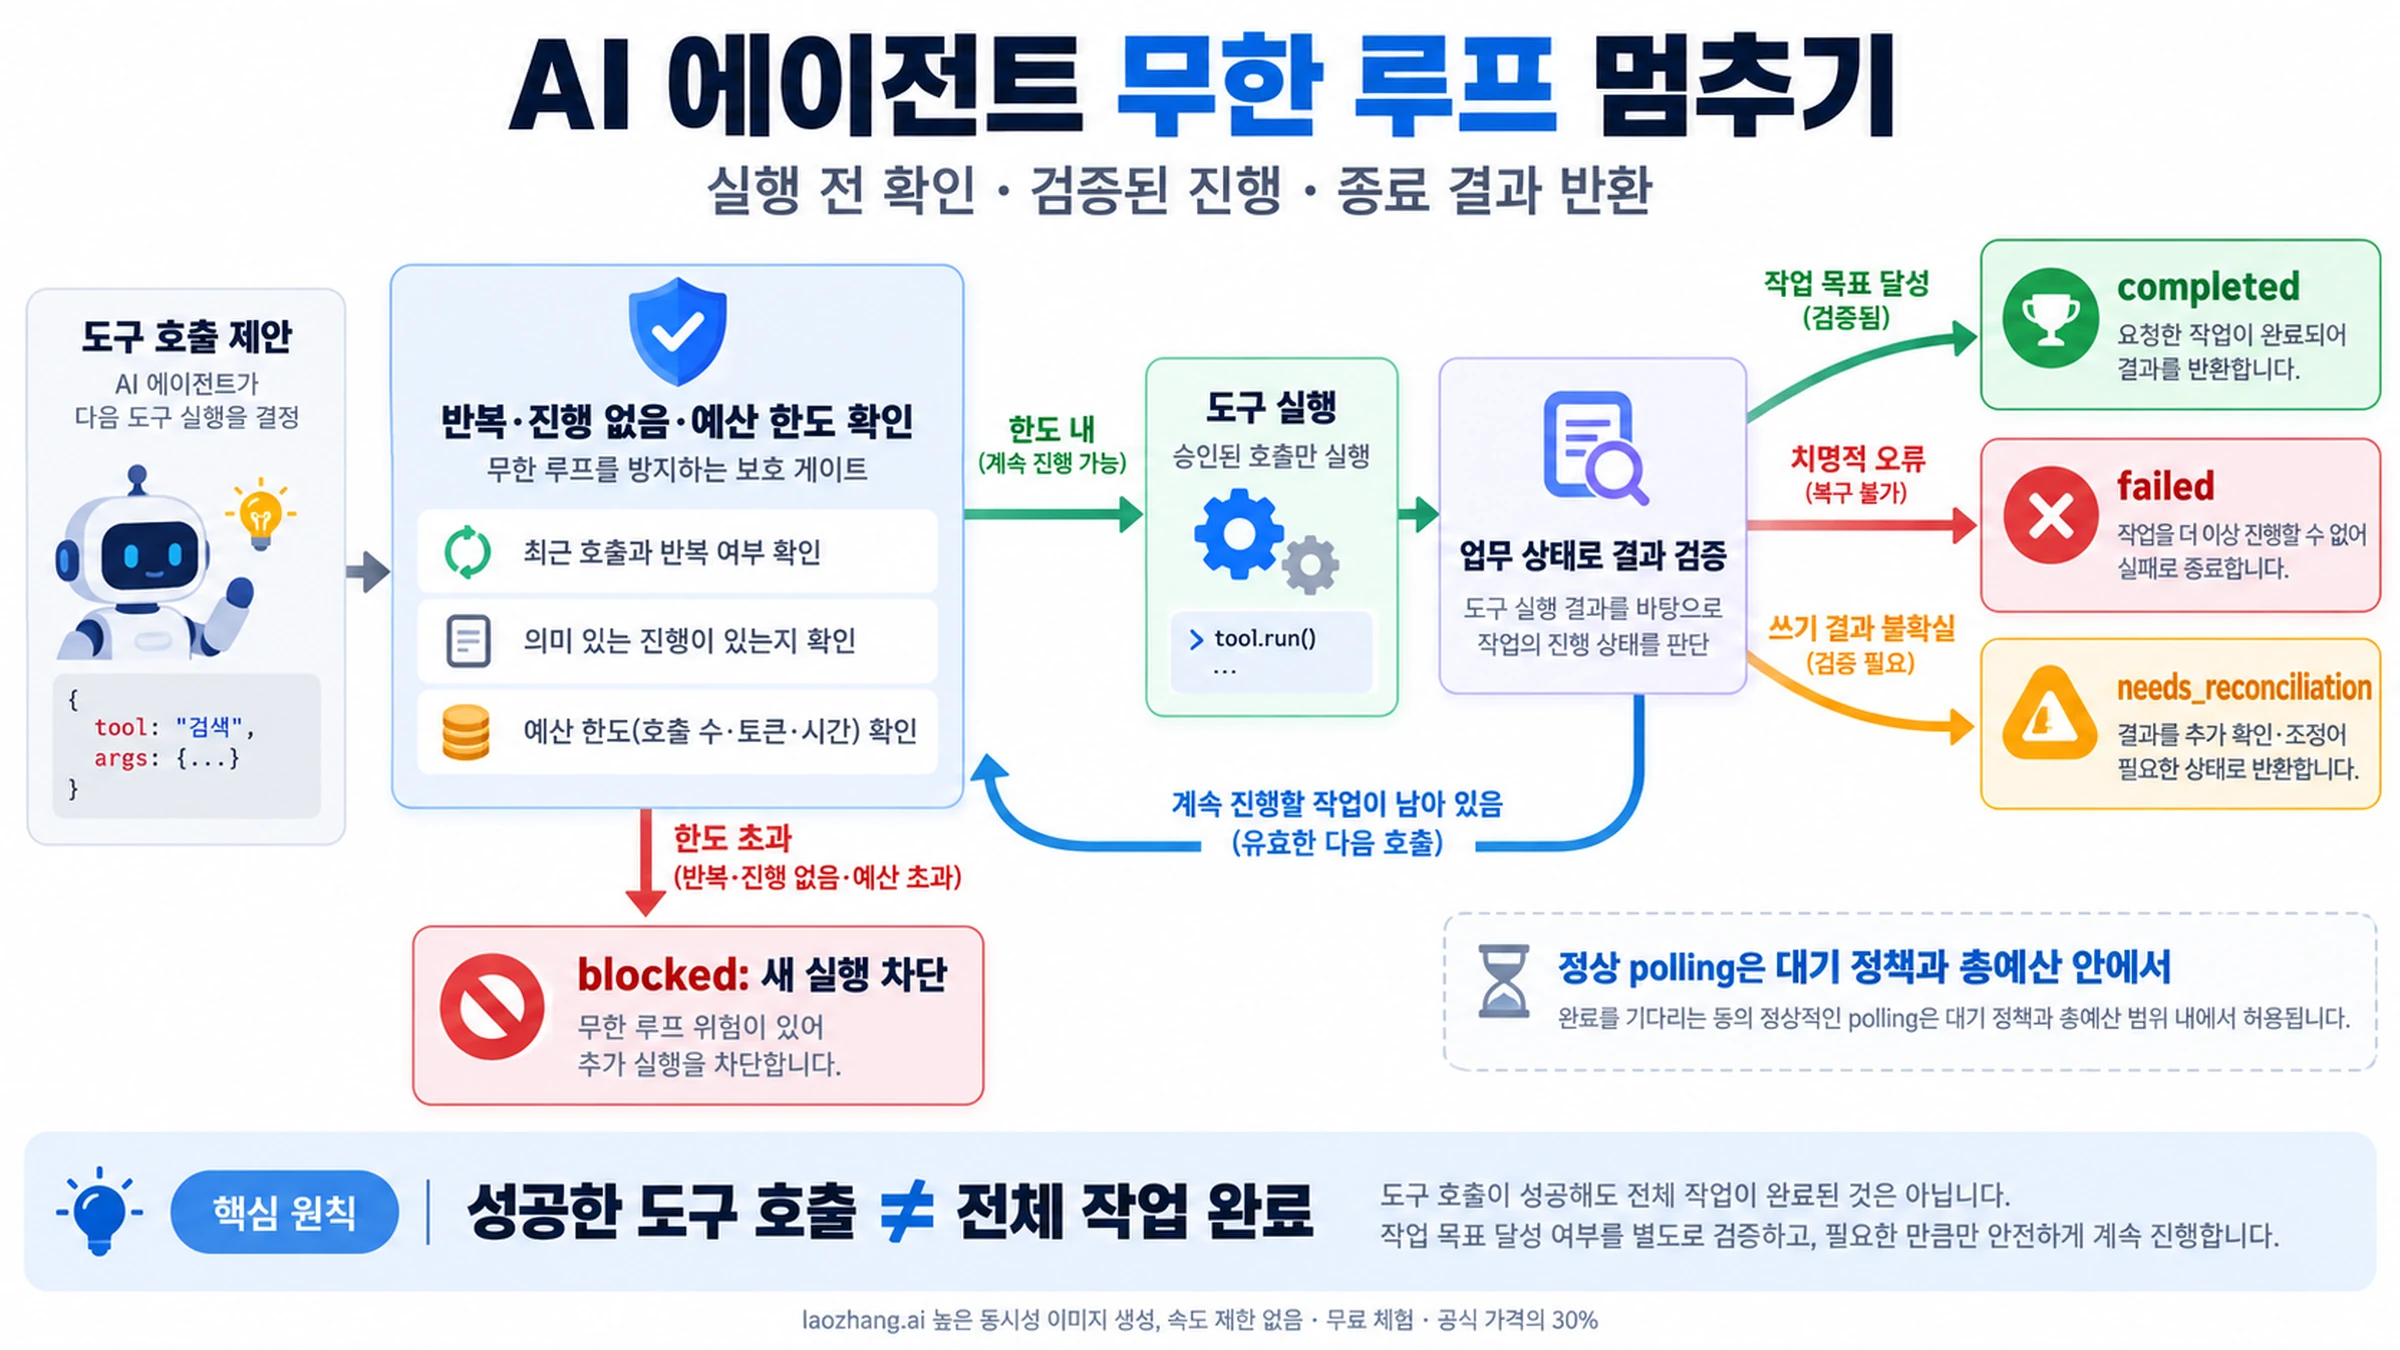
AI 에이전트가 같은 도구를 계속 호출한다면 도구 실행기 앞에서 해당 작업의 새 호출을 막고, 실행 중인 호출과 완료 기록을 먼저 보존하세요. 그다음 취소가 실제 실행기에 전달됐는지 확인합니다. 화면의 출력을 멈추거나 모델에 “이제 끝내라”고 말하는 것만으로는 뒤에서 실행되는 도구까지 멈췄다고 볼 수 없습니다.
재발을 막으려면 실행 횟수 제한과 함께 검증된 진행, 작업 완료 조건, 중복 쓰기 방지, 호출자의 종료 처리가 필요합니다. 도구가 성공했어도 사용자 요청 전체가 끝나지 않았을 수 있고, 응답이 사라졌어도 외부 쓰기는 이미 끝났을 수 있습니다. 이 두 경우를 같은 재시도로 처리하면 루프와 중복 작업이 생깁니다.
아래 LoopGuard는 특정 SDK에 종속되지 않는 직렬 실행 예제입니다. 가짜 실행기와 시계로 분기를 확인했으며, 실제 모델·CRM·결제 API를 호출한 시험은 아닙니다. 병렬 실행과 재시작까지 안전하게 만들 때 필요한 조건은 별도로 설명합니다.
지금 반복 호출을 멈추는 순서
먼저 해당 사용자 작업을 식별하는 ID로 새 도구 실행을 거절합니다. 모델 호출, 하위 에이전트, 지연 재시도가 같은 작업을 이어 갈 수 있다면 모두 같은 차단 상태를 확인해야 합니다. 한 실행의 카운터만 초기화해서 새 실행을 만드는 경로도 닫아야 합니다.
그 상태에서 취소 요청을 보내고 실행기의 응답, 대기열, 실행 중인 요청을 확인합니다. 예를 들어 Amazon Bedrock AgentCore에는 StopRuntimeSession API가 있습니다. 실제 런타임 ARN과 세션 ID, 적절한 권한이 필요한 해당 서비스의 API입니다. 이 요청의 멱등 토큰은 정지 요청을 식별하며, 에이전트가 이미 완료한 주문이나 결제를 되돌리는 키가 아닙니다.
마지막 안전 상태와 최근 호출 기록을 저장합니다. 다음 항목이면 “같은 호출을 반복했는지”와 “결과를 놓쳤는지”를 구분하는 데 도움이 됩니다.
- 사용자 작업 ID, 모델 응답의 호출 ID, 도구 이름과 필요한 인자
- 실행 전후의 검증된 상태, 결과 유형, 종료 사유
- 외부 작업 ID, 안정적인 업무 작업 키, 완료·진행 중·결과 불명 상태
- 실제 실행 횟수, 남은 예산, 재시도 및 하위 에이전트 경로
원본 인자에는 개인정보나 비밀 값이 들어갈 수 있습니다. 로그에는 필요한 필드만 남기고 접근을 제한하세요. 인자를 해시로 바꿨다는 이유만으로 개인정보 보호가 끝나는 것은 아닙니다.
이미 발송된 메시지나 반영된 쓰기는 취소 신호로 취소되지 않습니다. 실행 중이던 쓰기의 완료 여부를 확인할 수 없다면 needs_reconciliation처럼 별도 상태로 닫고, 같은 쓰기를 자동으로 다시 실행하지 않습니다. 외부 작업 조회나 운영자의 확인을 통해 결과를 맞춘 뒤 복구해야 합니다.
같은 도구를 반복해도 원인은 다릅니다
도구 이름보다 결과와 상태 변화를 보세요. 같은 poll 호출이 새 상태를 읽는 경우와 같은 빈 응답을 되풀이하는 경우는 다릅니다.
| 관측한 증상 | 먼저 확인할 것 | 다음 조치 |
|---|---|---|
| 인자도 결과도 같은 호출이 반복됨 | 같은 결과가 모델에 전달됐는지, 진행이 멈췄는지 | 동등 호출 한도와 진행 없음 한도로 실행 전 차단 |
| A와 B 도구를 번갈아 호출함 | 같은 상태로 되돌아오는지 | 작업 전체의 진행과 예산 확인, 필요하면 순환 경로 차단 |
| 성공 후 같은 쓰기를 다시 제안함 | 전체 요청 완료 조건, 결과 전달, 업무 작업 키 | 완료 결과 재사용, 목표가 충족됐다면 호출자까지 종료 |
| 인자에 시각이나 요청 ID만 바뀜 | 업무상 다른 요청인지 | 도구별로 의미 없는 차이만 정규화 |
ok: true지만 필요한 데이터가 없음 | 필수 필드와 결과의 완전성 | 불완전 결과로 분류, 확인 없는 성공 처리 금지 |
| 권한·입력·정책 오류가 반복됨 | 재시도로 달라질 조건이 있는지 | 같은 조건의 재시도 중지, 수정 또는 검토 요청 |
| 페이지나 작업 상태가 실제로 전진함 | 새 데이터, 유효한 다음 커서, 완료 단계 | 진행으로 인정하되 전체 호출·시간 예산 유지 |
성공 후에도 반복하는 사례는 실제로 보고돼 있습니다. n8n 커뮤니티의 HubSpot 도구 사례에서는 작업이 성공한 뒤 호출이 이어졌고, 작성자는 도구 사용 조건을 명확히 한 뒤 개선됐다고 설명했습니다. 그 사례는 프롬프트를 점검할 이유가 됩니다. 프롬프트가 모든 중복 실행을 막는다는 증거는 아닙니다.
종료 가능한 응답 자체가 허용돼 있는지도 확인하세요. OpenAI의 function calling 문서에서 tool_choice: "required"는 하나 이상의 도구 호출을 요구하고, auto는 호출하지 않는 선택도 허용합니다. 매 요청에 도구 호출을 강제한다면 도구 없이 최종 답변을 내야 하는 단계와 충돌할 수 있습니다. 남은 작업과 사용 중인 프로토콜에 맞춰 설정을 바꾸되, 확인되지 않은 일을 완료로 처리하려고 도구를 꺼서는 안 됩니다.
반복 횟수 제한은 무엇을 세는지부터 확인합니다
max_iterations, 모델 호출 수, 도구 호출 수를 같은 숫자로 비교하면 제한을 잘못 설계합니다. 한 번의 모델 응답에서 여러 도구 호출이 나올 수 있고, 하나의 에이전트 실행 안에서도 모델은 여러 번 호출될 수 있습니다.
| 제어 범위 | 제한하는 단위 | 남아 있는 문제 |
|---|---|---|
| 모델 호출 한도 | 모델을 요청한 횟수 | 응답 하나의 여러 도구 실행, 도구 내부 재시도 |
| 도구 호출 한도 | 도구 실행 시도 | 모델만 계속 생각하는 경우, 이미 반영된 쓰기 |
| 단일 실행 한도 | 현재 실행의 반복 또는 호출 | 새 실행·새 사용자 턴에서 카운터 초기화 |
| 스레드·사용자 작업 한도 | 이어지는 작업 전체 | 상태 저장, 병렬 갱신, 모든 실행 경로의 공유 필요 |
n8n Tools Agent 문서의 Max Iterations 기본값 10은 답변을 생성하기 위한 모델 실행 횟수입니다. 외부 쓰기 10회나 전체 워크플로 실행 10회를 뜻하지 않습니다.
LangChain의 JavaScript/TypeScript middleware 문서는 modelCallLimitMiddleware와 toolCallLimitMiddleware를 구분합니다. runLimit은 새 사용자 턴에서 초기화되고, threadLimit은 같은 스레드 ID와 체크포인터가 있어야 이어집니다. 도구 한도의 기본 exitBehavior: "continue"는 초과 호출을 막아도 모델이나 다른 도구의 진행을 허용합니다. 작업 전체를 끝내는 동작으로 간주하지 마세요. "error"와 "end"의 차이 및 여러 도구 호출이 대기 중일 때의 제약도 같은 문서에서 확인해야 합니다.
재시도도 예산에 포함해야 합니다. 같은 문서의 toolRetryMiddleware 기본 maxRetries: 2는 최초 실행에 더해 최대 두 번 재시도한다는 뜻입니다. 기본 실패 처리 onFailure: "continue"는 오류를 도구 메시지로 돌려주므로 모델이 다시 호출할 수 있습니다. SDK 내부 재시도와 애플리케이션 재시도가 겹치면 바깥 카운터보다 실제 요청이 많아질 수 있습니다. 다음 원형을 붙일 때는 모든 실제 실행 시도가 제한 경로를 지나도록 연결하세요.
Google ADK의 LoopAgent 문서에서 max_iterations는 하위 에이전트 묶음의 반복을 제한합니다. 모든 모델·도구 호출 수와 같지 않습니다. 이 템플릿은 Python·Go의 ADK 2.0에서 더 유연한 실행 방식으로 대체된다는 안내도 있으므로, 모든 최신 ADK에 필요한 구성으로 받아들이지 않습니다.
진행은 모델의 말이 아니라 업무 상태로 확인합니다
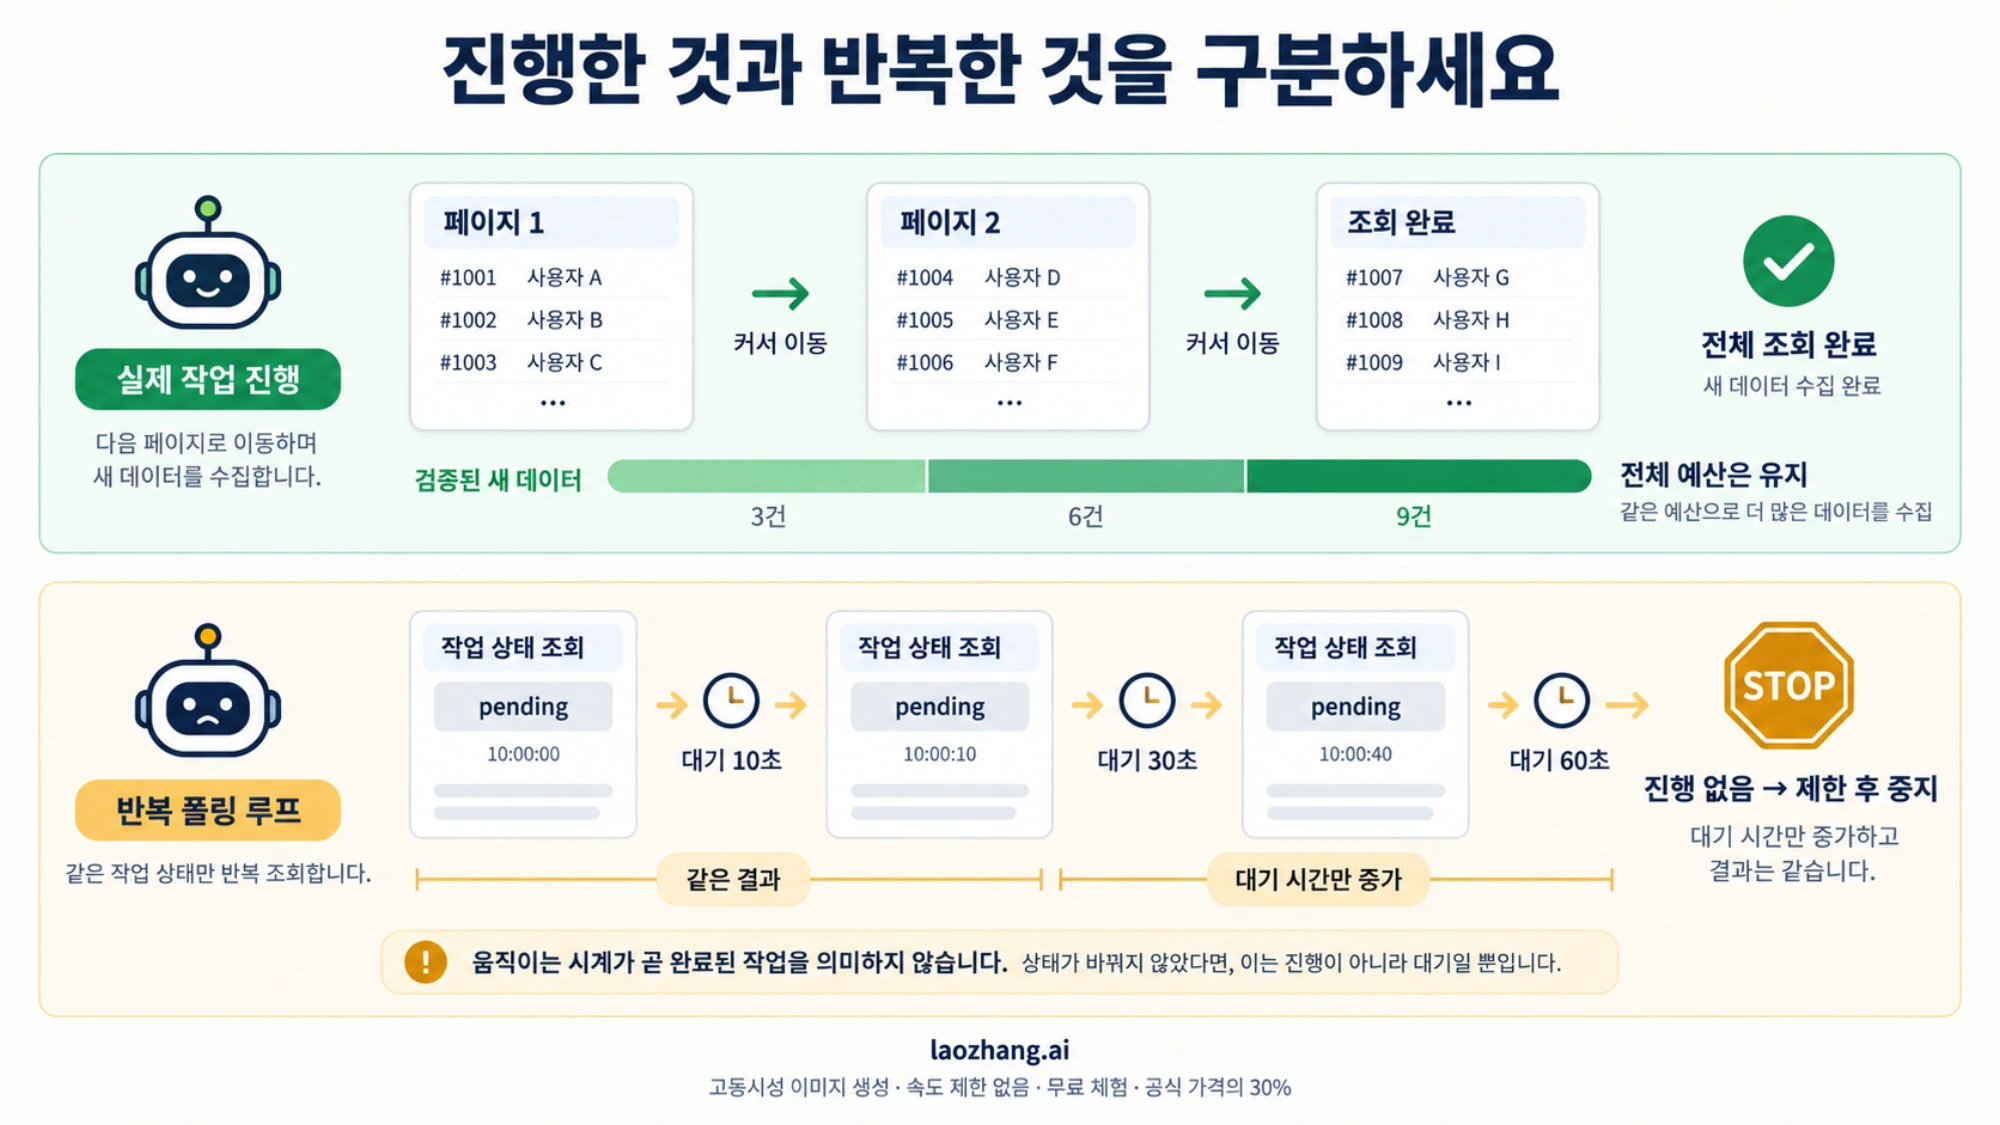
진행 판정은 “전보다 목표에 가까워졌는가”를 확인해야 합니다. 시각, 로그 수, 재시도 횟수, 기다린 시간은 업무 진행이 아닙니다. 모델이 progress: 1이라고 출력하거나 높은 확신을 보여도 별도 검증이 없다면 인정하지 않습니다.
페이지를 읽는 작업이라면 새로 확인한 레코드가 늘었는지, 다음 커서가 유효하고 이미 방문한 커서가 아닌지 검사합니다. 동일 커서로 돌아가거나 결과가 중복되면 진행으로 세지 않습니다. 작업 상태를 조회한다면 허용된 상태 전이인지 확인합니다. 모델이 만든 임의의 버전 번호 대신 신뢰할 수 있는 조회 결과에서 검증한 상태를 사용합니다.
예를 들어 “조건에 맞는 주문을 모두 확인하고 지정된 주문의 처리를 확정한다”는 요청은 페이지 조회 성공만으로 끝나지 않습니다. 조회 완료와 대상 주문의 반영 여부가 모두 확인돼야 합니다. 반대로 쓰기 한 건은 완료됐지만 다른 조회가 남아 있다면, 완료한 쓰기를 재사용하면서 남은 조회만 이어갑니다.
오래 걸리는 정상 polling도 계속 같은 상태를 읽을 수 있습니다. 그 경우에는 별도의 대기 정책에 따라 읽기 횟수와 시간을 제한하고 다음 확인 시점을 정합니다. backoff가 늘어났다는 사실을 새 진행으로 표시해서 한도를 초기화하지 마세요. 진행 감지 구간은 실제 상태가 바뀌었을 때만 새로 시작하고, 전체 예산은 유지합니다.
실행 전 차단과 종료 반환을 함께 구현한 LoopGuard
다음 코드는 JSON 인자를 받는 직렬 실행용 JavaScript 원형입니다. plan은 다음 호출 목록을 제안하고, execute는 한 번의 실행을 담당합니다. 읽기·쓰기 유형과 업무 작업 키 생성 규칙은 애플리케이션의 toolSpecs에 등록합니다. 모델이 제안한 kind나 시도별 키를 신뢰하지 않습니다. 쓰기 도구의 key(args)는 허용된 업무 대상과 입력을 확인한 뒤 안정적인 키를 반환해야 합니다. verify는 결과를 신뢰할 수 있는 업무 상태와 대조하는 애플리케이션 함수입니다. 모델의 자기 평가를 그대로 전달하는 함수가 아닙니다.
models와 tools는 따로 세고, 완료된 쓰기의 캐시 재사용은 실제 실행 횟수에 넣지 않습니다. 다만 같은 캐시를 반복 요청하는 행위는 반복 검사에 포함됩니다. 진행이 확인되면 지역 반복 기록을 비우지만 총예산은 초기화하지 않습니다. 한 번 종료된 인스턴스는 다시 run()을 불러도 종료 결과만 돌려줍니다. results에는 검증을 통과한 결과와 캐시 재사용 여부를 순서대로 보존합니다. 실제 SDK 어댑터는 callId에 모델 응답의 호출 ID를 넣고, 그 ID에 대응하는 도구 결과를 해당 프로토콜에 맞게 다음 모델 요청에 전달해야 합니다.
코드를 serial-guard.mjs에 저장합니다. 한도 값은 다음 예제의 가정이며 SDK 기본값이나 권장 공통값이 아닙니다.
const canonical = value => {
  if (Array.isArray(value)) return value.map(canonical);
  if (value && typeof value === 'object') return Object.fromEntries(
    Object.keys(value).sort().map(k => [k, canonical(value[k])]));
  return value;
};

export class LoopGuard {
  constructor(now, limits, toolSpecs, ledger = new Map()) {
    for (const k of ['models', 'tools', 'same', 'stagnant', 'ms'])
      if (!Number.isSafeInteger(limits[k]) || limits[k] <= 0) throw new TypeError('invalid limit');
    this.now = now; this.limits = limits; this.toolSpecs = toolSpecs; this.ledger = ledger;
    this.state = { started: now(), models: 0, tools: 0,
      progress: 0, stagnant: 0, history: [], results: [], terminal: null };
  }
  stop(status, reason) {
    this.state.terminal ??= { status, reason };
    return { ...this.state.terminal, models: this.state.models,
      tools: this.state.tools, progress: this.state.progress };
  }
  expired() { return this.now() - this.state.started >= this.limits.ms; }
  async run(plan, execute, verify) {
    const s = this.state, l = this.limits;
    if (s.terminal) return this.stop(s.terminal.status, s.terminal.reason);
    while (!s.terminal) {
      if (this.expired()) return this.stop('blocked', 'deadline');
      if (s.models >= l.models) return this.stop('blocked', 'model_budget');
      s.models++;
      let frame;
      try { frame = await plan({ ...s, history: [...s.history], results: [...s.results] }); }
      catch { return this.stop('failed', 'planner_error'); }
      if (!frame || !Array.isArray(frame.calls) || !frame.calls.length)
        return this.stop('needs_review', 'no_verified_completion');
      for (const proposed of frame.calls) {
        const c = { ...proposed };
        if (this.expired()) return this.stop('blocked', 'deadline');
        if (s.tools >= l.tools) return this.stop('blocked', 'tool_budget');
        if (typeof c.tool !== 'string' || !Object.hasOwn(this.toolSpecs, c.tool)
            || !c.args || typeof c.args !== 'object')
          return this.stop('failed', 'invalid_call');
        const spec = this.toolSpecs[c.tool];
        if (!['read', 'write'].includes(spec.kind)) return this.stop('failed', 'invalid_tool_spec');
        c.kind = spec.kind; // 모델이 아니라 애플리케이션의 도구 등록 정보입니다.
        try { c.operationKey = c.kind === 'write' ? spec.key(c.args) : null; }
        catch { return this.stop('failed', 'invalid_operation_key'); }
        const fp = c.tool + ':' + JSON.stringify(canonical(c.args));
        if (s.history.filter(x => x === fp).length >= l.same)
          return this.stop('blocked', 'same_call');
        if (s.stagnant >= l.stagnant) return this.stop('blocked', 'no_progress');
        if (c.kind === 'write' && (typeof c.operationKey !== 'string' || !c.operationKey))
          return this.stop('failed', 'missing_operation_key');
        const old = c.kind === 'write' ? this.ledger.get(c.operationKey) : null;
        if (old && old.fp !== fp) return this.stop('failed', 'key_conflict');
        if (old && old.status !== 'completed')
          return this.stop('needs_reconciliation', 'unknown_commit');
        let raw;
        s.history.push(fp); // 캐시 재사용도 반복 판단 대상입니다.
        if (old) raw = old.result;
        else {
          s.tools++;
          if (c.kind === 'write') this.ledger.set(c.operationKey, { fp, status: 'inflight' });
          try { raw = await execute(c); }
          catch { return this.stop(c.kind === 'write' ? 'needs_reconciliation' : 'failed', 'executor_error'); }
        }
        let v;
        try { v = verify(c, raw); } catch { v = null; }
        if (!v || !['ok', 'retry', 'fatal', 'human'].includes(v.status)
            || !Number.isSafeInteger(v.progress) || v.progress < s.progress
            || typeof v.done !== 'boolean' || (v.done && v.status !== 'ok'))
          return this.stop(c.kind === 'write' ? 'needs_reconciliation' : 'failed', 'invalid_result');
        if (c.kind === 'write' && !old) {
          if (v.status === 'ok') this.ledger.set(c.operationKey, { fp, status: 'completed', result: raw });
          else if (v.confirmedNotApplied === true) this.ledger.delete(c.operationKey);
          else return this.stop('needs_reconciliation', 'unknown_commit');
        }
        s.results.push({ tool: c.tool, callId: c.callId ?? null, result: raw, reused: !!old });
        if (v.progress > s.progress) { s.history = []; s.stagnant = 0; }
        else s.stagnant++;
        s.progress = v.progress;
        if (v.status === 'fatal') return this.stop('failed', 'fatal_result');
        if (v.status === 'human') return this.stop('needs_review', 'human_review');
        if (this.expired()) return this.stop('blocked', 'deadline');
        if (v.done) return this.stop('completed', 'verified_goal');
      }
    }
  }
}
코드의 verify는 { status, progress, done }을 반환합니다. status: "ok"는 도구 결과를 받아들였다는 뜻이고, done: true는 사용자 작업의 전체 완료 조건을 검증했다는 뜻입니다. 결과가 누락됐거나 알 수 없는 상태라면 성공으로 추정하지 않습니다. 읽기는 실패로 닫고, 쓰기는 반영 여부 확인이 필요한 상태로 닫습니다.
retry는 다음 제한된 시도를 허용하는 결과입니다. 쓰기라면 confirmedNotApplied: true로 실제 반영되지 않았음을 확인해야 예약을 풀 수 있습니다. 확인할 수 없다면 재시도보다 결과 확인이 먼저입니다. 권한·정책 거절이나 사람의 승인 대기는 fatal 또는 human으로 분류합니다. 승인 대기는 실패와 다르지만, 이 실행에서는 더 이상 자동 호출을 하지 않는 종료점입니다.
다음은 모델이나 네트워크가 없는 호출자 예제입니다. demo.mjs로 저장하면 위 모듈과 함께 실행할 수 있습니다. 가짜 조회 결과가 계속 pending이면 세 번째 동일 호출 전에 차단됩니다.
import { LoopGuard } from './serial-guard.mjs';
let executions = 0;
const guard = new LoopGuard(() => 0,
  { models: 8, tools: 8, same: 2, stagnant: 3, ms: 100 },
  { poll: { kind: 'read' } });
const result = await guard.run(
  async () => ({ calls: [{ tool: 'poll', kind: 'read', args: { job: 'J' } }] }),
  async () => { executions++; return { job: 'J', status: 'pending' }; },
  (_call, raw) => raw.job === 'J' && raw.status === 'pending'
    ? { status: 'ok', progress: 0, done: false } : null
);
console.log({ ...result, executions });
// 호출자는 이 결과를 반환하고 같은 작업을 자동으로 다시 시작하지 않습니다.
이 예제에서 출력은 status: 'blocked', reason: 'same_call', models: 3, tools: 2, executions: 2입니다. 모델이 제안한 횟수와 실제 도구를 실행한 횟수가 다릅니다. 실제 호출자는 이 결과를 상위 워크플로에 반환하고, 같은 실행을 자동으로 다시 시작하지 않아야 합니다. 예외를 잡은 뒤 continue하는 바깥 루프가 있으면 내부 차단만으로 전체 작업은 끝나지 않습니다.
원형은 실행 전후에 시간을 확인합니다. 이미 진행 중인 await execute()를 시간 제한으로 강제 중단하지는 않습니다. 타이머와 Promise.race로 기다리기만 중단해도 외부 쓰기는 계속될 수 있습니다. 실제 어댑터에는 취소 지원, 실행 상태 확인, 결과 기록이 필요합니다. 제한 시간이 지났더라도 성공이 확인된 쓰기는 완료 원장에 남겨야 이후 중복을 피할 수 있습니다.
완료 기록은 재시작해도 같은 업무를 가리켜야 합니다
위 Map은 직렬 원형의 동작을 설명하기 위한 메모리 기록입니다. 프로세스가 사라지면 기록도 사라지고, 다른 worker와 공유되지 않습니다. 병렬 실행·재시작에서 정확히 한 번만 실행된다는 보장은 없습니다.
실제 쓰기에는 안정적인 업무 작업 키가 필요합니다. 예를 들어 주문 42의 확정 작업 confirm-v1을 식별하는 키입니다. 모델 호출 ID나 매 시도마다 새로 만드는 ID, 현재 run ID만으로 구성한 키는 재시작 뒤 같은 업무를 다른 작업으로 보게 할 수 있습니다. 같은 키에 다른 입력이 들어오면 충돌로 거절해야 합니다.
내구성 있는 기록은 실행 전에 키를 원자적으로 예약하고 입력 지문, 상태, 외부 작업 ID, 완료 결과를 보존해야 합니다. “먼저 조회하고, 없으면 쓰기”를 두 단계로 구현하면 두 worker가 동시에 빈 기록을 보고 실행할 수 있습니다. 저장소의 유일성 제약이나 조건부 갱신 등으로 예약 경쟁을 해결해야 합니다.
원자 예약만으로 외부 반영과 완료 기록 사이의 장애까지 없어지는 것은 아닙니다. 외부 서비스가 멱등 키를 지원하면 그 규칙과 보존 기간을 확인해서 연결합니다. 반영은 끝났지만 기록 저장 전에 끊겼다면 외부 작업 ID 또는 조회 수단으로 결과를 맞춥니다. 확인할 방법이 없으면 자동 재실행하지 않고 검토 대상으로 남깁니다.
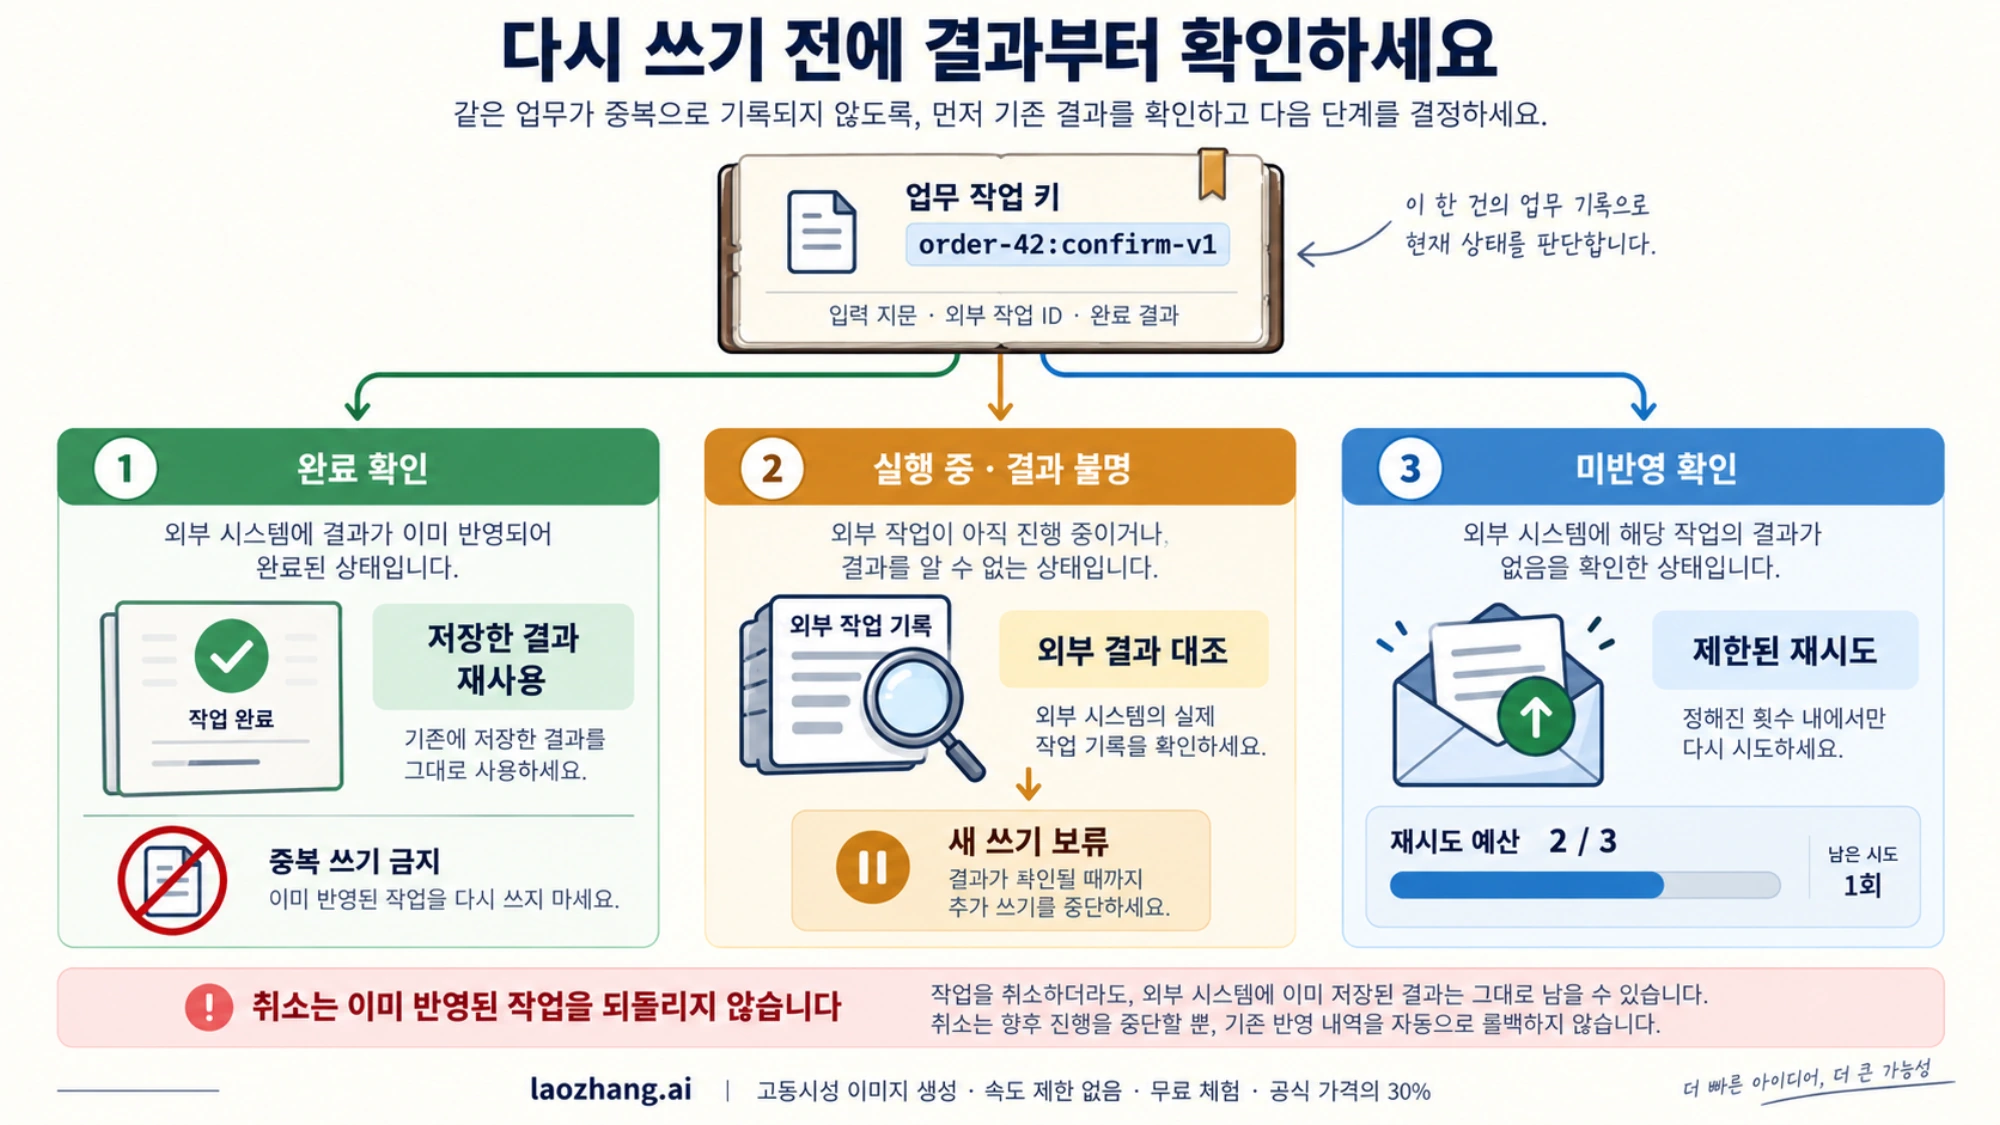
| 보존된 상태 | 복구할 때 할 일 |
|---|---|
| 완료, 같은 키·같은 입력 | 저장한 결과 재사용, 외부 쓰기 생략 |
| 같은 키, 다른 입력 | 충돌 거절, 작업 정의 확인 |
| 실행 중 또는 반영 여부 불명 | 외부 결과와 대조, 새 쓰기 보류 |
| 반영되지 않음을 확인한 일시 오류 | 남은 작업 예산 안에서 제한 재시도 |
| 승인 필요 | 승인된 동작과 보존 상태를 연결한 뒤 재개 |
| 작업 예산 소진 | 마지막 안전 상태 반환, 새 run으로 우회하지 않음 |
OpenAI Agents SDK 실행 가이드는 이력이나 세션을 이용해 실행을 이어가는 방법과 승인 중단 뒤 재개를 설명합니다. 대화 이력을 복원하는 기능은 외부 쓰기의 완료 원장을 대신하지 않습니다. 재개 전에 이미 수행한 동작과 전체 작업 예산을 함께 복원해야 합니다.
가짜 실행기로 확인한 분기와 확인하지 않은 범위
2026년 10월 6일 위 원형을 Node.js에서 실행해 합성 입력의 결과를 확인했습니다. 가짜 계획 함수, 실행기, 업무 관측값과 시계를 사용했으며 실제 모델·외부 작업은 실행하지 않았습니다. 결과는 아래와 같습니다.
| 주입한 상황 | 확인한 결과 |
|---|---|
같은 pending 결과 반복 | 실제 실행 2회 후 다음 호출 전에 same_call |
| 서로 다른 두 읽기의 교대, 진행 없음 | 실제 실행 3회 후 no_progress |
| 검증된 페이지 진행 후 전체 완료 | 실제 실행 2회 후 verified_goal |
| 모델 응답 하나가 도구 셋을 제안, 도구 예산 2회 | 셋째 도구는 실행하지 않고 tool_budget |
| 재시도 또는 backoff만 변화 | 업무 진행으로 세지 않고 동일 호출 차단 |
| 모델 호출 예산 소진 | 다음 계획 요청 없이 model_budget |
| 성공한 쓰기 직후 제한 시간 초과 | 완료 기록을 보존하고 deadline |
| 치명 오류, 승인 필요, 불완전 읽기 결과 | 각각 실패·검토·결과 오류로 종료 |
| 빈 호출 목록과 모델의 완료 주장 | 검증된 완료가 없어 no_verified_completion |
| 쓰기 예외 또는 불완전 쓰기 결과 | 결과 확인이 필요한 상태로 종료 |
| 같은 업무 키의 완료 쓰기를 다시 제안 | 저장 결과를 재사용하고 남은 읽기만 실행 |
| 같은 키에 다른 입력 또는 진행 중 기록 | 충돌·반영 여부 불명으로 차단, 추가 쓰기 없음 |
종료된 각 실행에 다시 run()을 호출해 계획 함수와 실행 횟수가 늘지 않는지도 확인했습니다. 이 검증은 정해진 입력에 대한 직렬 상태 전이의 확인입니다. 모델의 판단 정확도, 실제 API의 취소, 저장소의 병렬 예약, 장애 후 복구까지 검증한 결과는 아닙니다.
프로덕션에 붙이기 전에는 실제 어댑터가 결과를 어떻게 검증하는지, 내부 재시도가 예산을 우회하지 않는지, 완료된 외부 작업의 기록을 잃지 않는지를 별도로 확인해야 합니다. 여러 에이전트가 같은 작업을 맡으면 총예산과 완료 기록을 공유하고, 하위 에이전트의 새 로컬 한도로 우회하지 못하게 합니다.
자주 묻는 질문
max_iterations만 늘리면 해결되나요?
검증된 진행이 있고 정상 작업의 범위에 비해 한도가 작았다는 증거가 있을 때만 검토할 수 있습니다. 같은 결과나 같은 완료 쓰기를 반복하는 경우에는 한도를 늘리면 반복을 더 오래 허용합니다. 먼저 무엇을 세는 한도인지, 결과가 모델에 전달되는지, 전체 작업 종료 조건이 충족됐는지 확인하세요.
읽기 전용 도구라면 반복 호출을 계속 허용해도 되나요?
읽기에도 지연과 비용, 호출 제한이 있습니다. 이미 확보한 검증된 결과로 답할 수 있다면 그것을 사용하고, 부족하다면 근거를 밝힌 부분 결과나 검토 상태를 반환합니다. 실패한 읽기를 해결하려고 카운터를 초기화하거나 같은 요청을 새 run에서 무한히 반복하지 않습니다.
도구의 success와 에이전트의 완료는 같은가요?
같지 않습니다. 도구 성공은 해당 작업의 결과이고, 에이전트 완료는 사용자 요청의 전체 조건을 충족했다는 판단입니다. 쓰기 한 건을 완료했다면 그 결과를 보존하되, 남은 조건을 별도로 확인합니다. 모든 조건이 검증됐다면 새로운 호출 대신 상위 호출자에게 완료 결과를 반환합니다.
취소했는데 외부 작업이 이미 반영됐다면 어떻게 하나요?
완료 기록을 복구하고 같은 작업을 다시 실행하지 않습니다. 취소는 이미 반영한 쓰기를 되돌리는 기능이 아닙니다. 결과가 불명확하다면 외부 작업 ID와 실제 상태를 조회해 확인하고, 확인할 수 없으면 수동 검토로 넘깁니다. 되돌리기가 필요할 때는 별도로 승인된 보상 작업으로 다뤄야 합니다.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 6일.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 6일.
- 1.StopRuntimeSession APIdocs.aws.amazon.com/bedrock-agentcore/latest/APIReference/API_StopRuntimeSession.html
- 2.n8n 커뮤니티의 HubSpot 도구 사례community.n8n.io/t/agent-goes-into-infinite-tool-call-loop/174472
- 3.function calling 문서developers.openai.com/api/docs/guides/function-calling
- 4.n8n Tools Agent 문서docs.n8n.io/integrations/builtin/cluster-nodes/root-nodes/n8n-nodes-langchain.agent/tools-agent
- 5.LangChain의 JavaScript/TypeScript middleware 문서docs.langchain.com/oss/javascript/langchain/middleware/built-in
- 6.Google ADK의 LoopAgent 문서adk.dev/agents/workflow-agents/loop-agents
- 7.OpenAI Agents SDK 실행 가이드developers.openai.com/api/docs/guides/agents/running-agents