GPT-6.2 Sol vs 6.1 Sol vs Opus 5.5 비교: 12문제 실측과 effort 선택
GPT-6.2 Sol은 6.1 Sol과 단가가 같고 모든 추론 강도에서 AA 점수가 높아 바로 옮길 만합니다. Opus 5.5는 코딩 에이전트 점수가 가장 높지만 작업당 비용이 10배 이상입니다.
목차
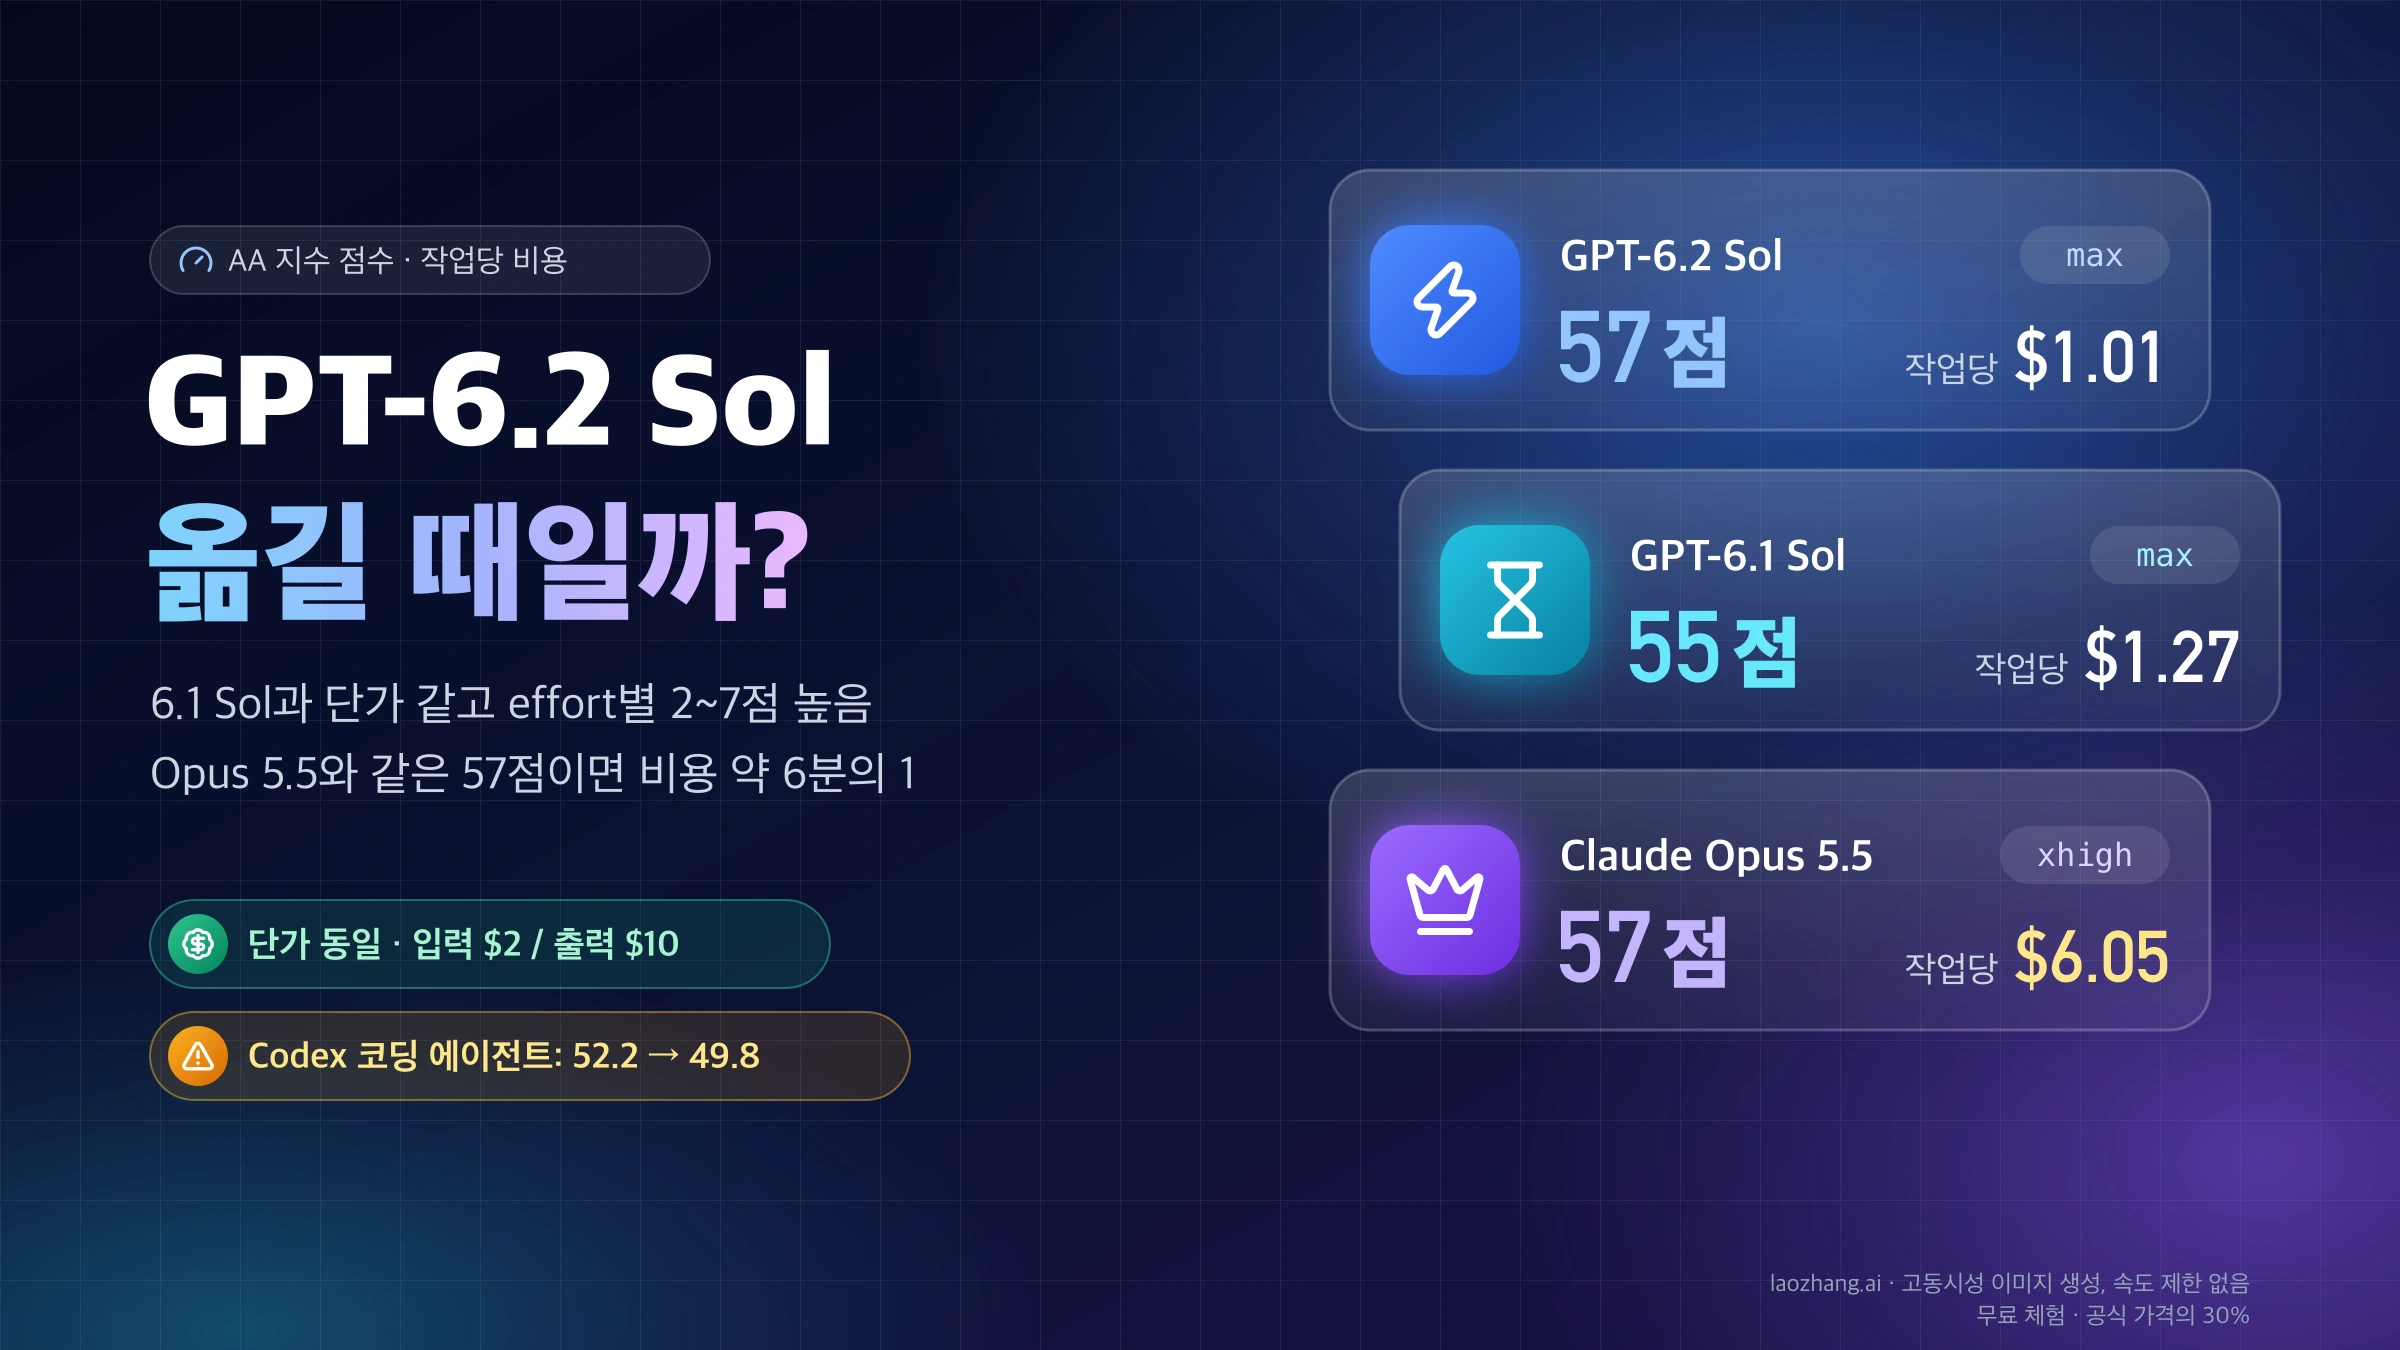
2026년 11월 17일 출시된 GPT-6.2 Sol(gpt-6.2-sol)은 GPT-6.1 Sol과 OpenAI API 표준 단가가 같습니다. 100만 토큰당 입력 $2, 출력 $10입니다. 그런데 Artificial Analysis(AA) 지수에서는 다섯 단계 추론 강도(effort) 모두에서 6.1 Sol보다 2~7점 높았고, 2026년 11월 18일 같은 12문제를 두 모델에 풀게 했을 때 걸린 시간은 약 4분의 1이었습니다. 6.1 Sol을 쓰고 있다면 모델 ID를 gpt-6.2-sol로 바꾸세요. low·medium은 그대로 두고, high 이상을 쓰던 작업은 한 단계 낮춰도 AA 점수가 같거나 높습니다. 6.1 Sol max의 55점은 6.2 Sol high로 맞출 수 있고 작업당 비용은 44%입니다.
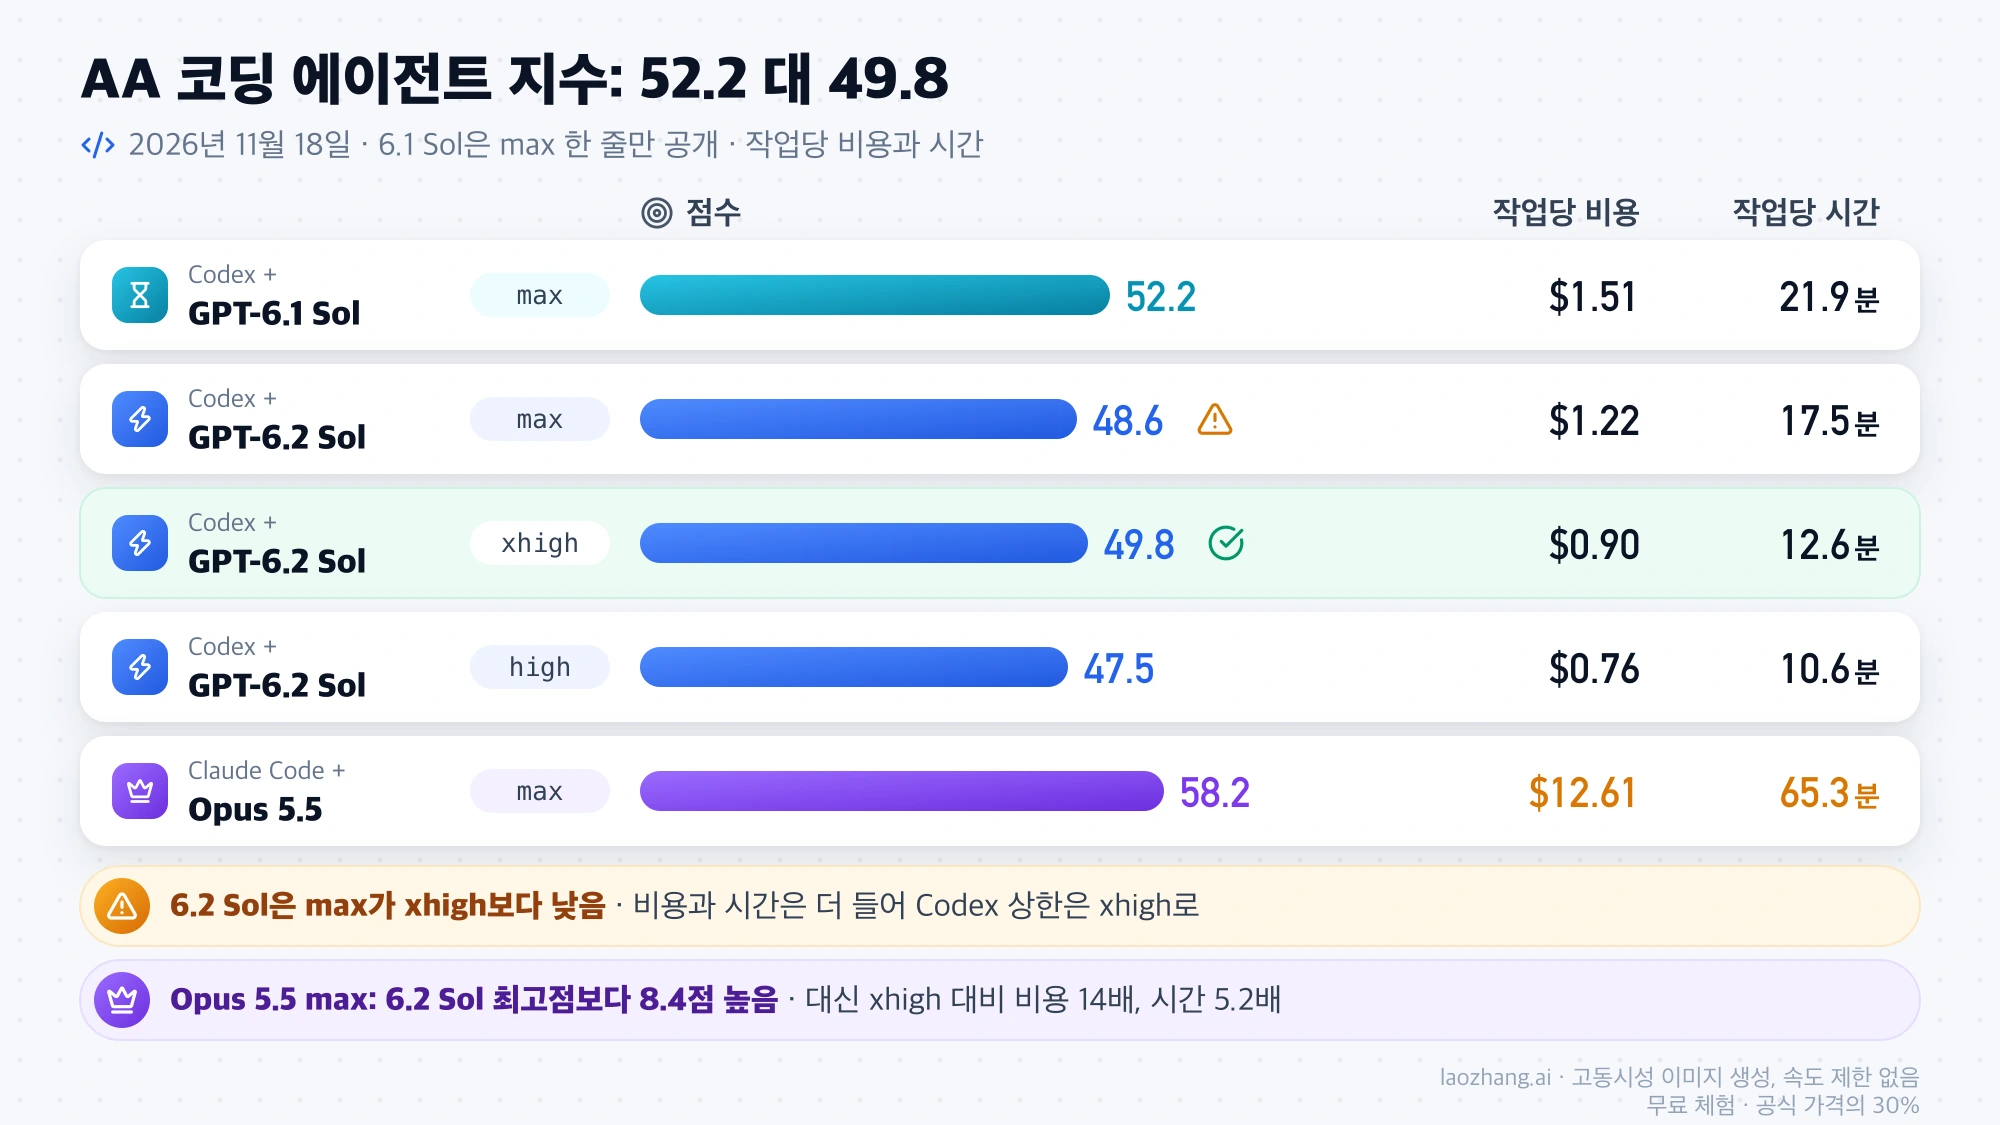
예외는 Codex에서 6.1 Sol max로 긴 코딩 작업을 맡겨 온 경우입니다. 커뮤니티에서 도는 "코딩 점수 52→49"는 AA 코딩 에이전트 지수에서 Codex + 6.1 Sol max가 52.2점, 6.2 Sol의 최고 설정인 xhigh가 49.8점이라는 데서 나온 수치입니다. 6.2 Sol 쪽이 작업당 비용은 40% 적지만 점수는 2.4점 낮으므로, 이 용도에서는 max 대신 xhigh를 쓰고 실패하는 작업만 6.1 Sol과 나란히 돌려 보세요.
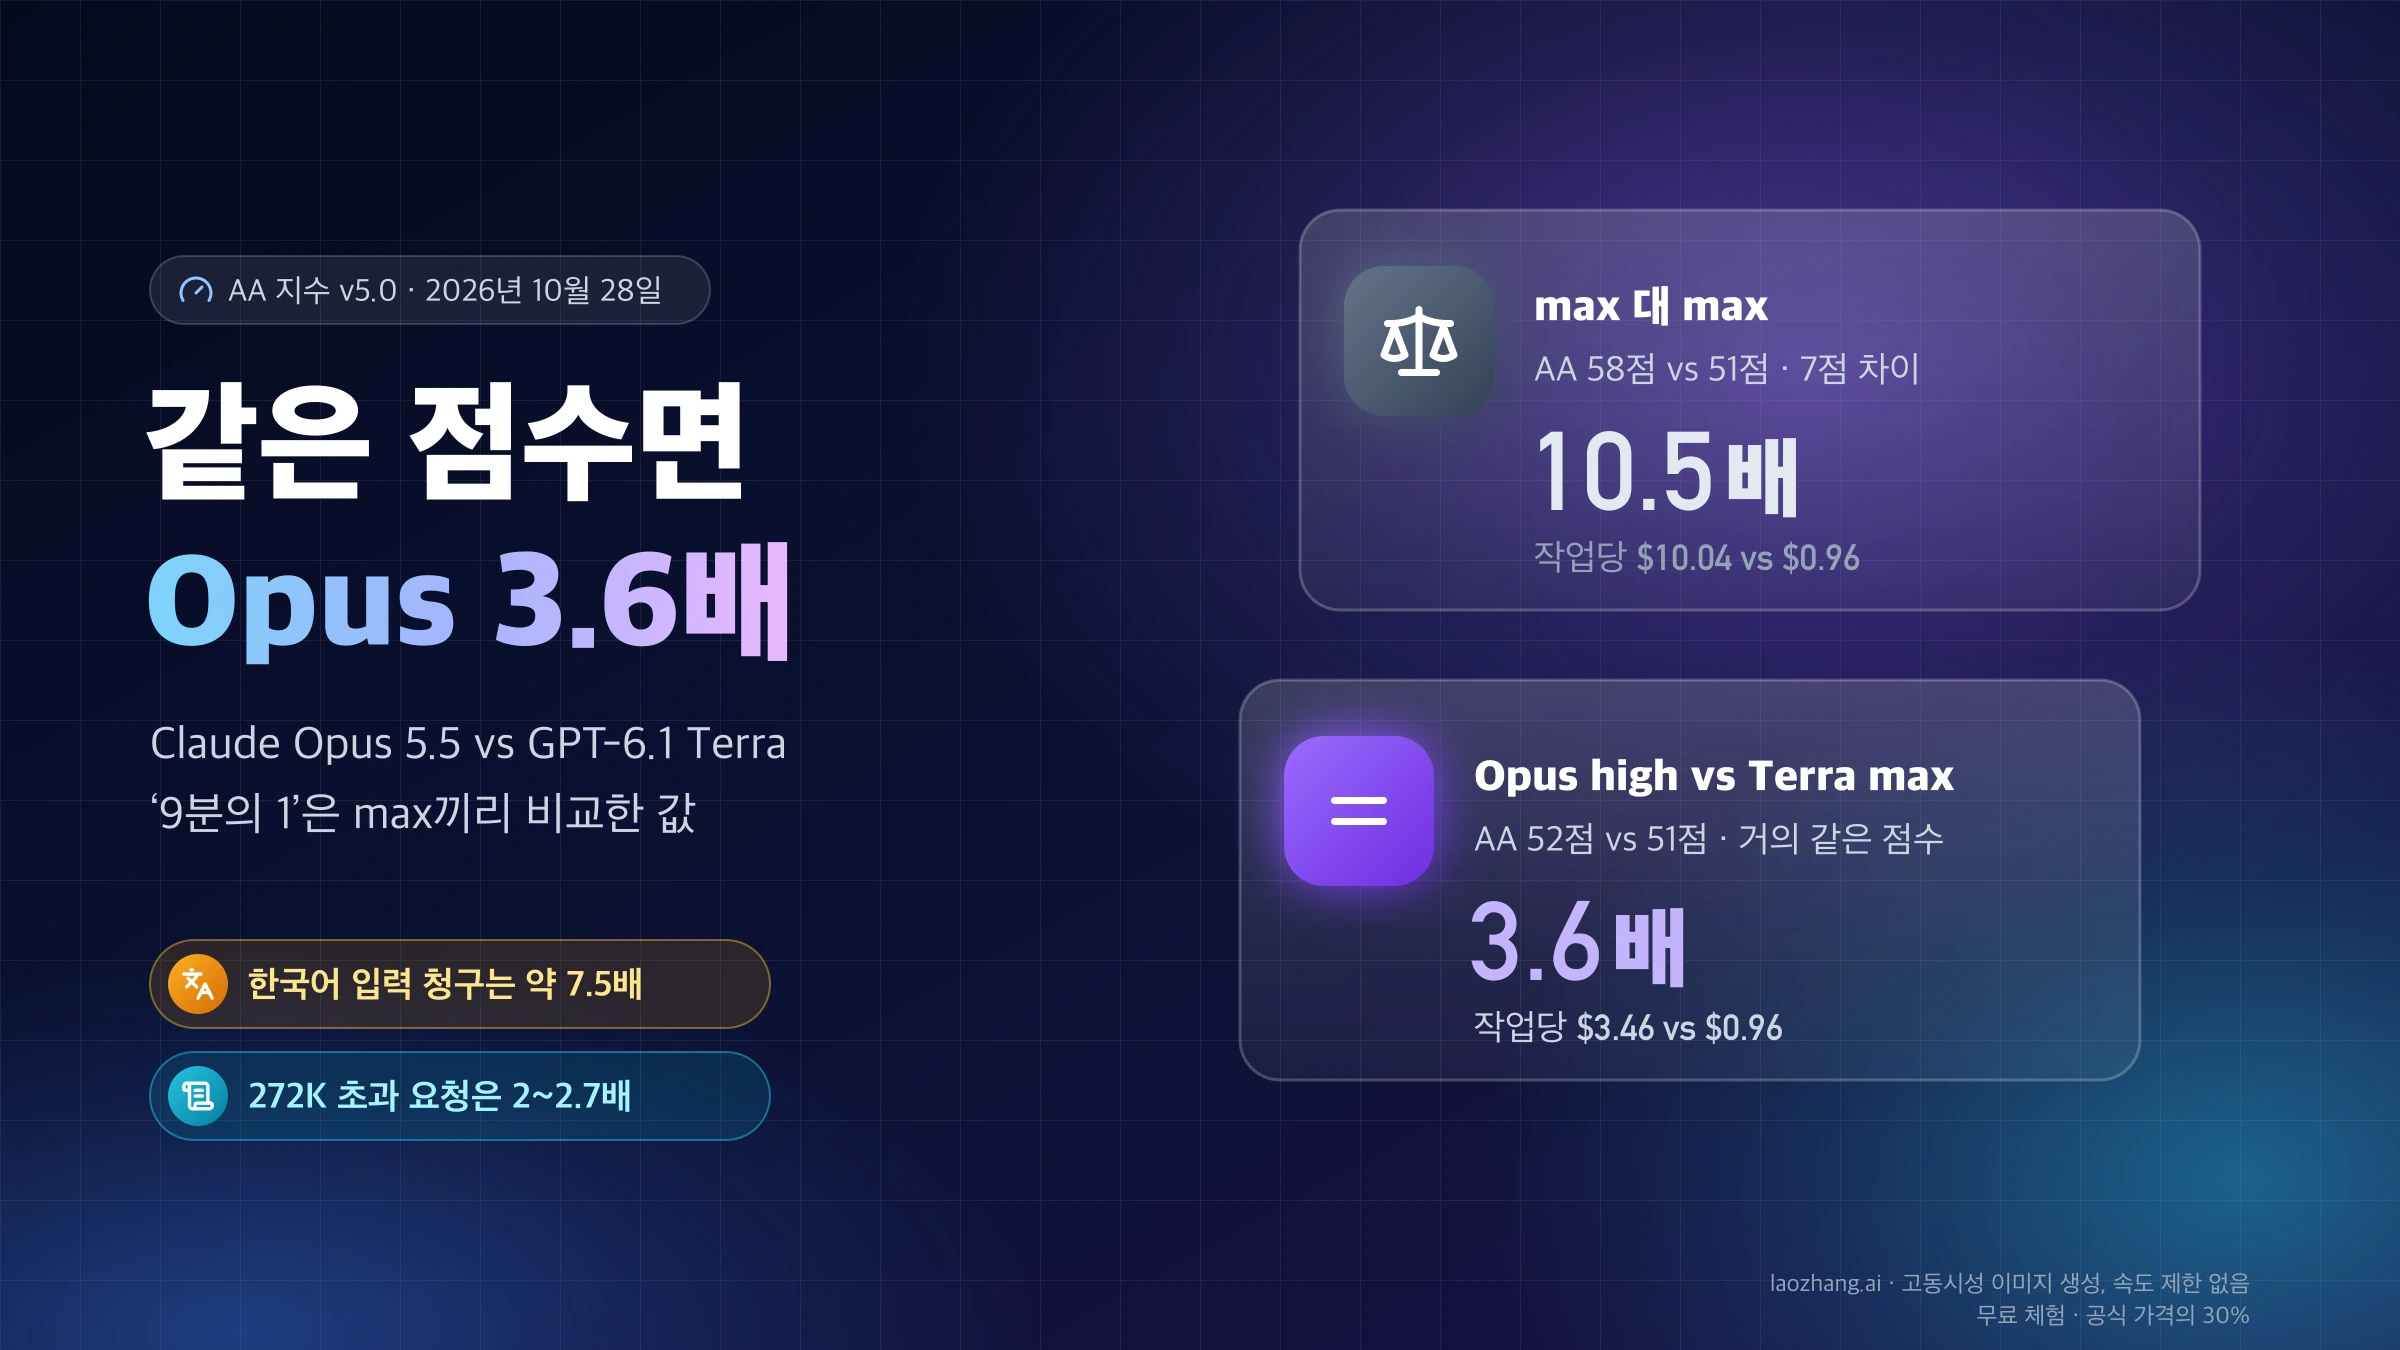
Claude Opus 5.5에 맡기던 일도 상당 부분 6.2 Sol로 옮길 수 있습니다. Opus 5.5는 토큰당 단가가 6.2 Sol의 두 배이고, AA 지수에서 6.2 Sol medium(53점)이 Opus 5.5 high(52점)보다 높습니다. 다만 Claude Code + Opus 5.5 max의 코딩 에이전트 점수 58.2는 아직 어떤 Sol 설정도 따라오지 못하므로, 실패했을 때 손해가 큰 가장 어려운 다단계 코딩은 Opus에 남기는 편이 맞습니다. 옮길 때는 재사용하는 instructions를 캐시하려면 developer 메시지로 옮겨야 한다는 점부터 확인하세요. effort none이 400 오류로 거부되는 것은 6.1 Sol도 마찬가지라, none을 받는 다른 모델과 설정을 함께 쓰던 경우에만 손보면 됩니다.
GPT-6.2 Sol과 6.1 Sol 가격은 같나: 표준 단가 동일, Opus 5.5는 2배
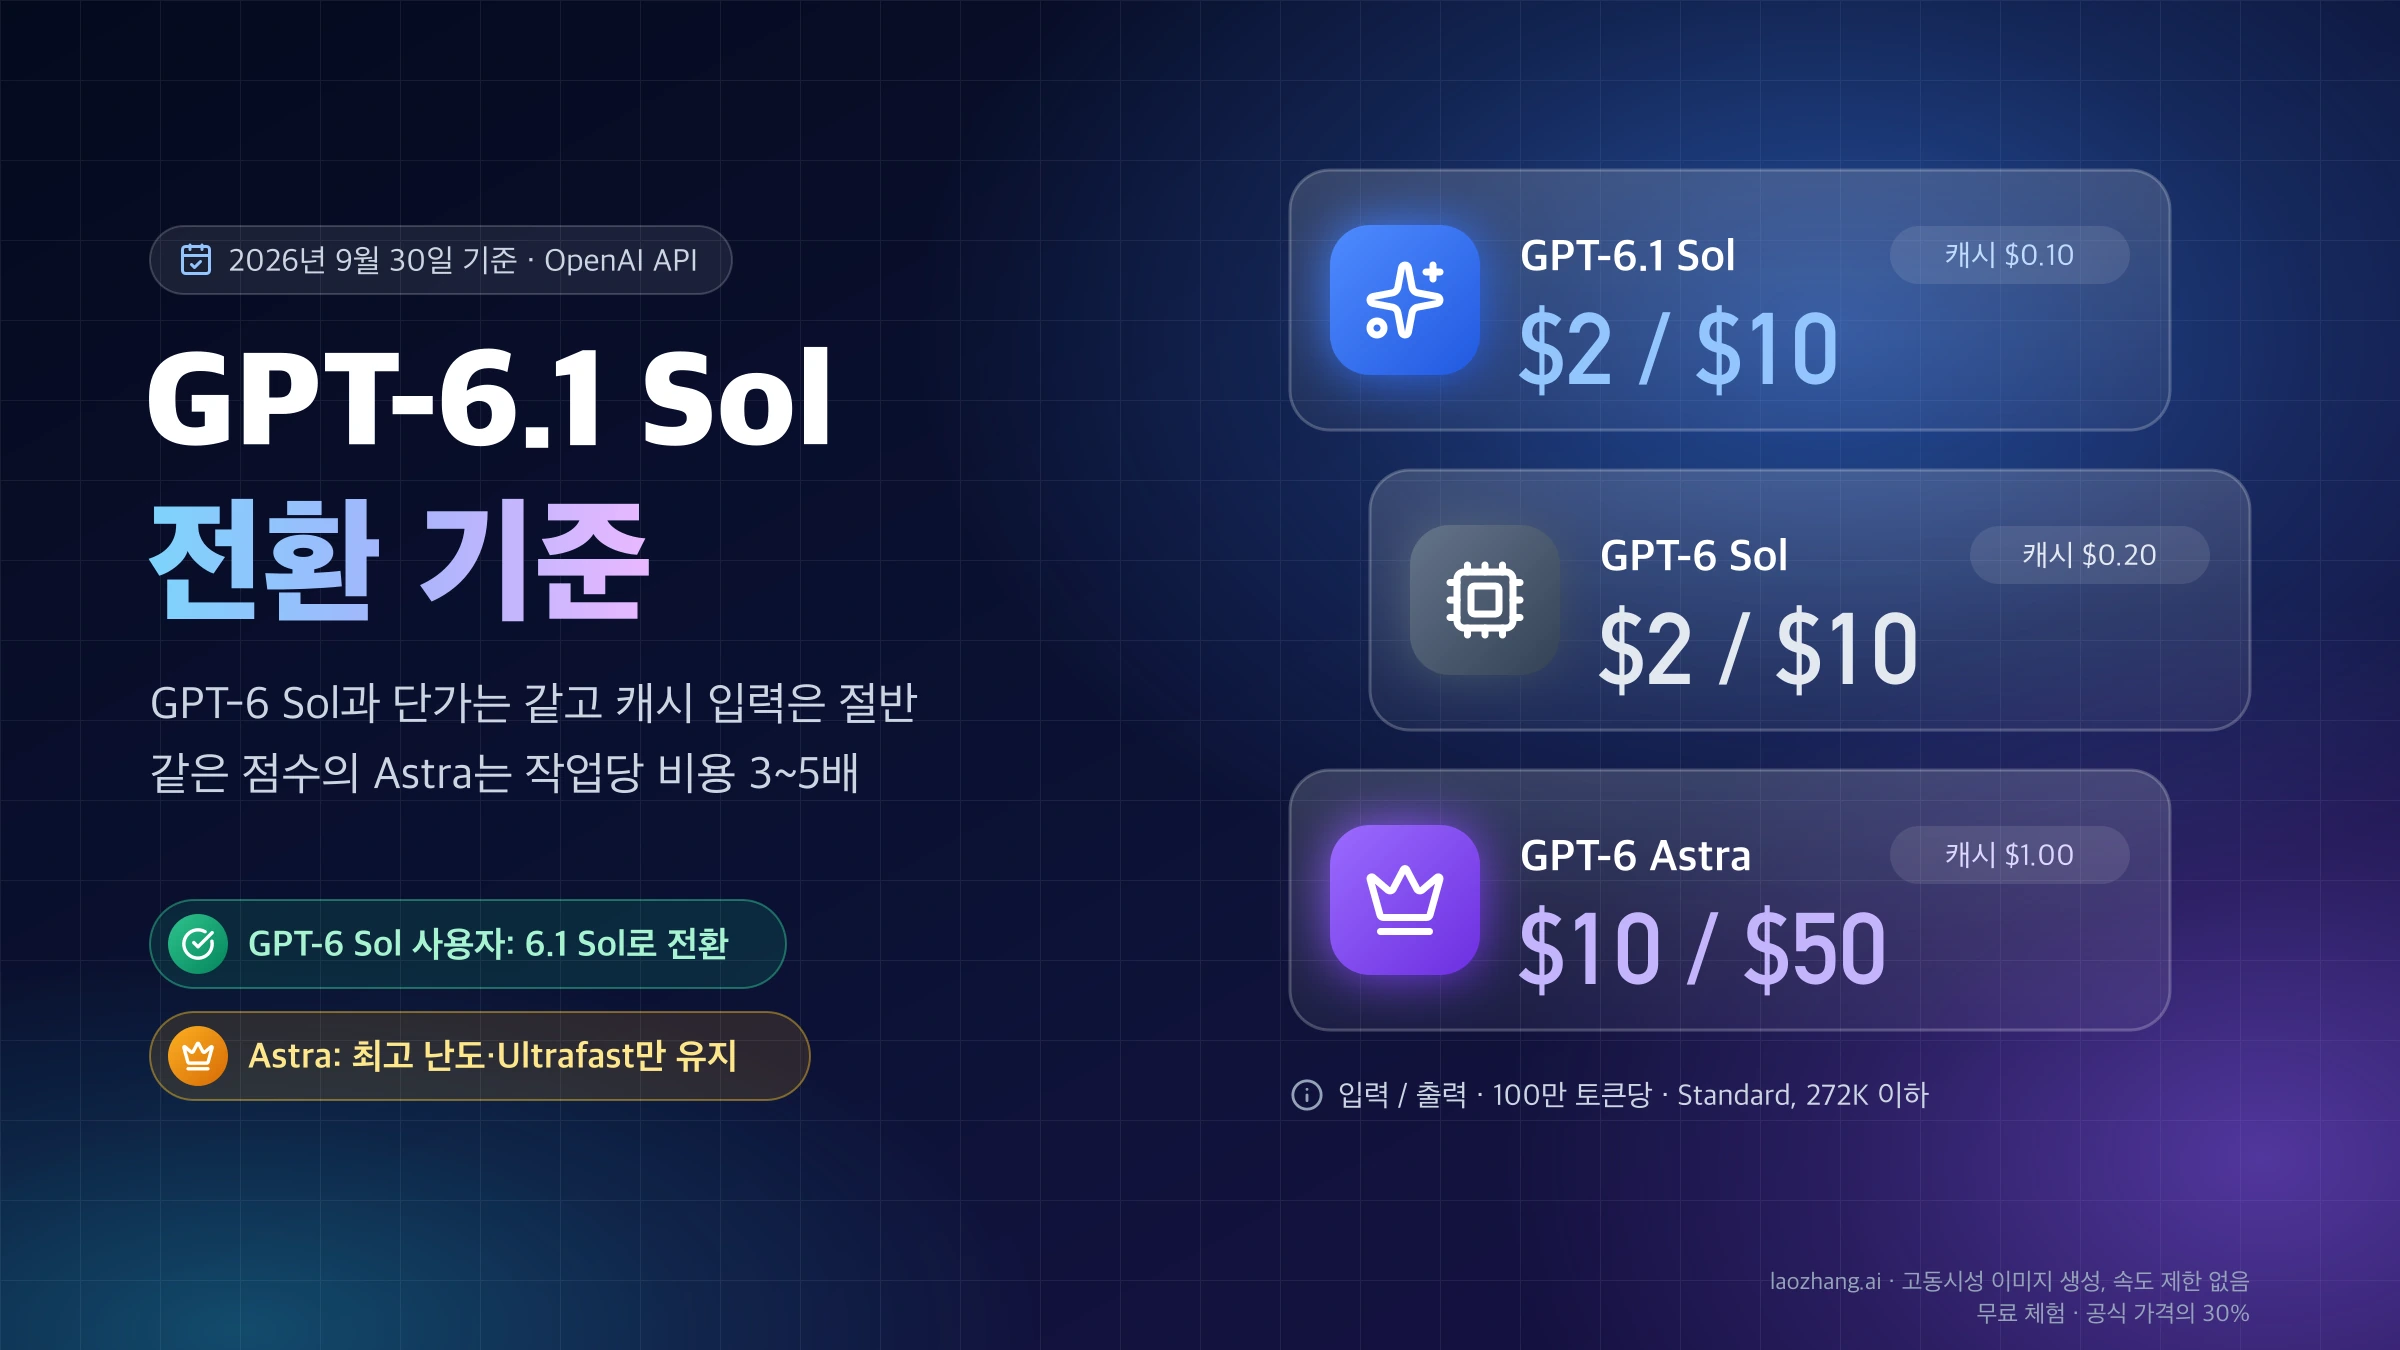
2026년 11월 18일 기준 OpenAI API 가격 페이지에서 GPT-6.2 Sol과 GPT-6.1 Sol은 표준 처리의 입력, 캐시 입력, 출력, Batch 단가가 모두 같습니다. Claude Opus 5.5(claude-opus-5-5)는 Anthropic API 요금표 기준으로 같은 항목이 전부 Sol의 2배입니다. 아래는 모두 100만 토큰당 미국 달러입니다.
| 과금 항목 | GPT-6.2 Sol | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|---|
| 입력 | $2.00 | $2.00 | $4.00 |
| 캐시 입력(캐시 읽기) | $0.10 | $0.10 | $0.20 |
| 출력 | $10.00 | $10.00 | $20.00 |
| Batch 입력 / 출력 | $1 / $5 | $1 / $5 | $2 / $10 |
두 Sol의 가격 차이는 옵션 요금에만 있습니다. Ultrafast는 6.2 Sol이 입력 $6, 출력 $30으로 표준의 3배(2027년 2월 28일까지, 3월 1일부터 6배)인 반면 6.1 Sol은 입력 $12, 출력 $60입니다. 2시간 안에 처리하면 30%, 8시간 안에 처리하면 40%를 깎아 주는 백그라운드 처리 할인도 6.2 Sol에는 있고 6.1 Sol에는 없습니다.
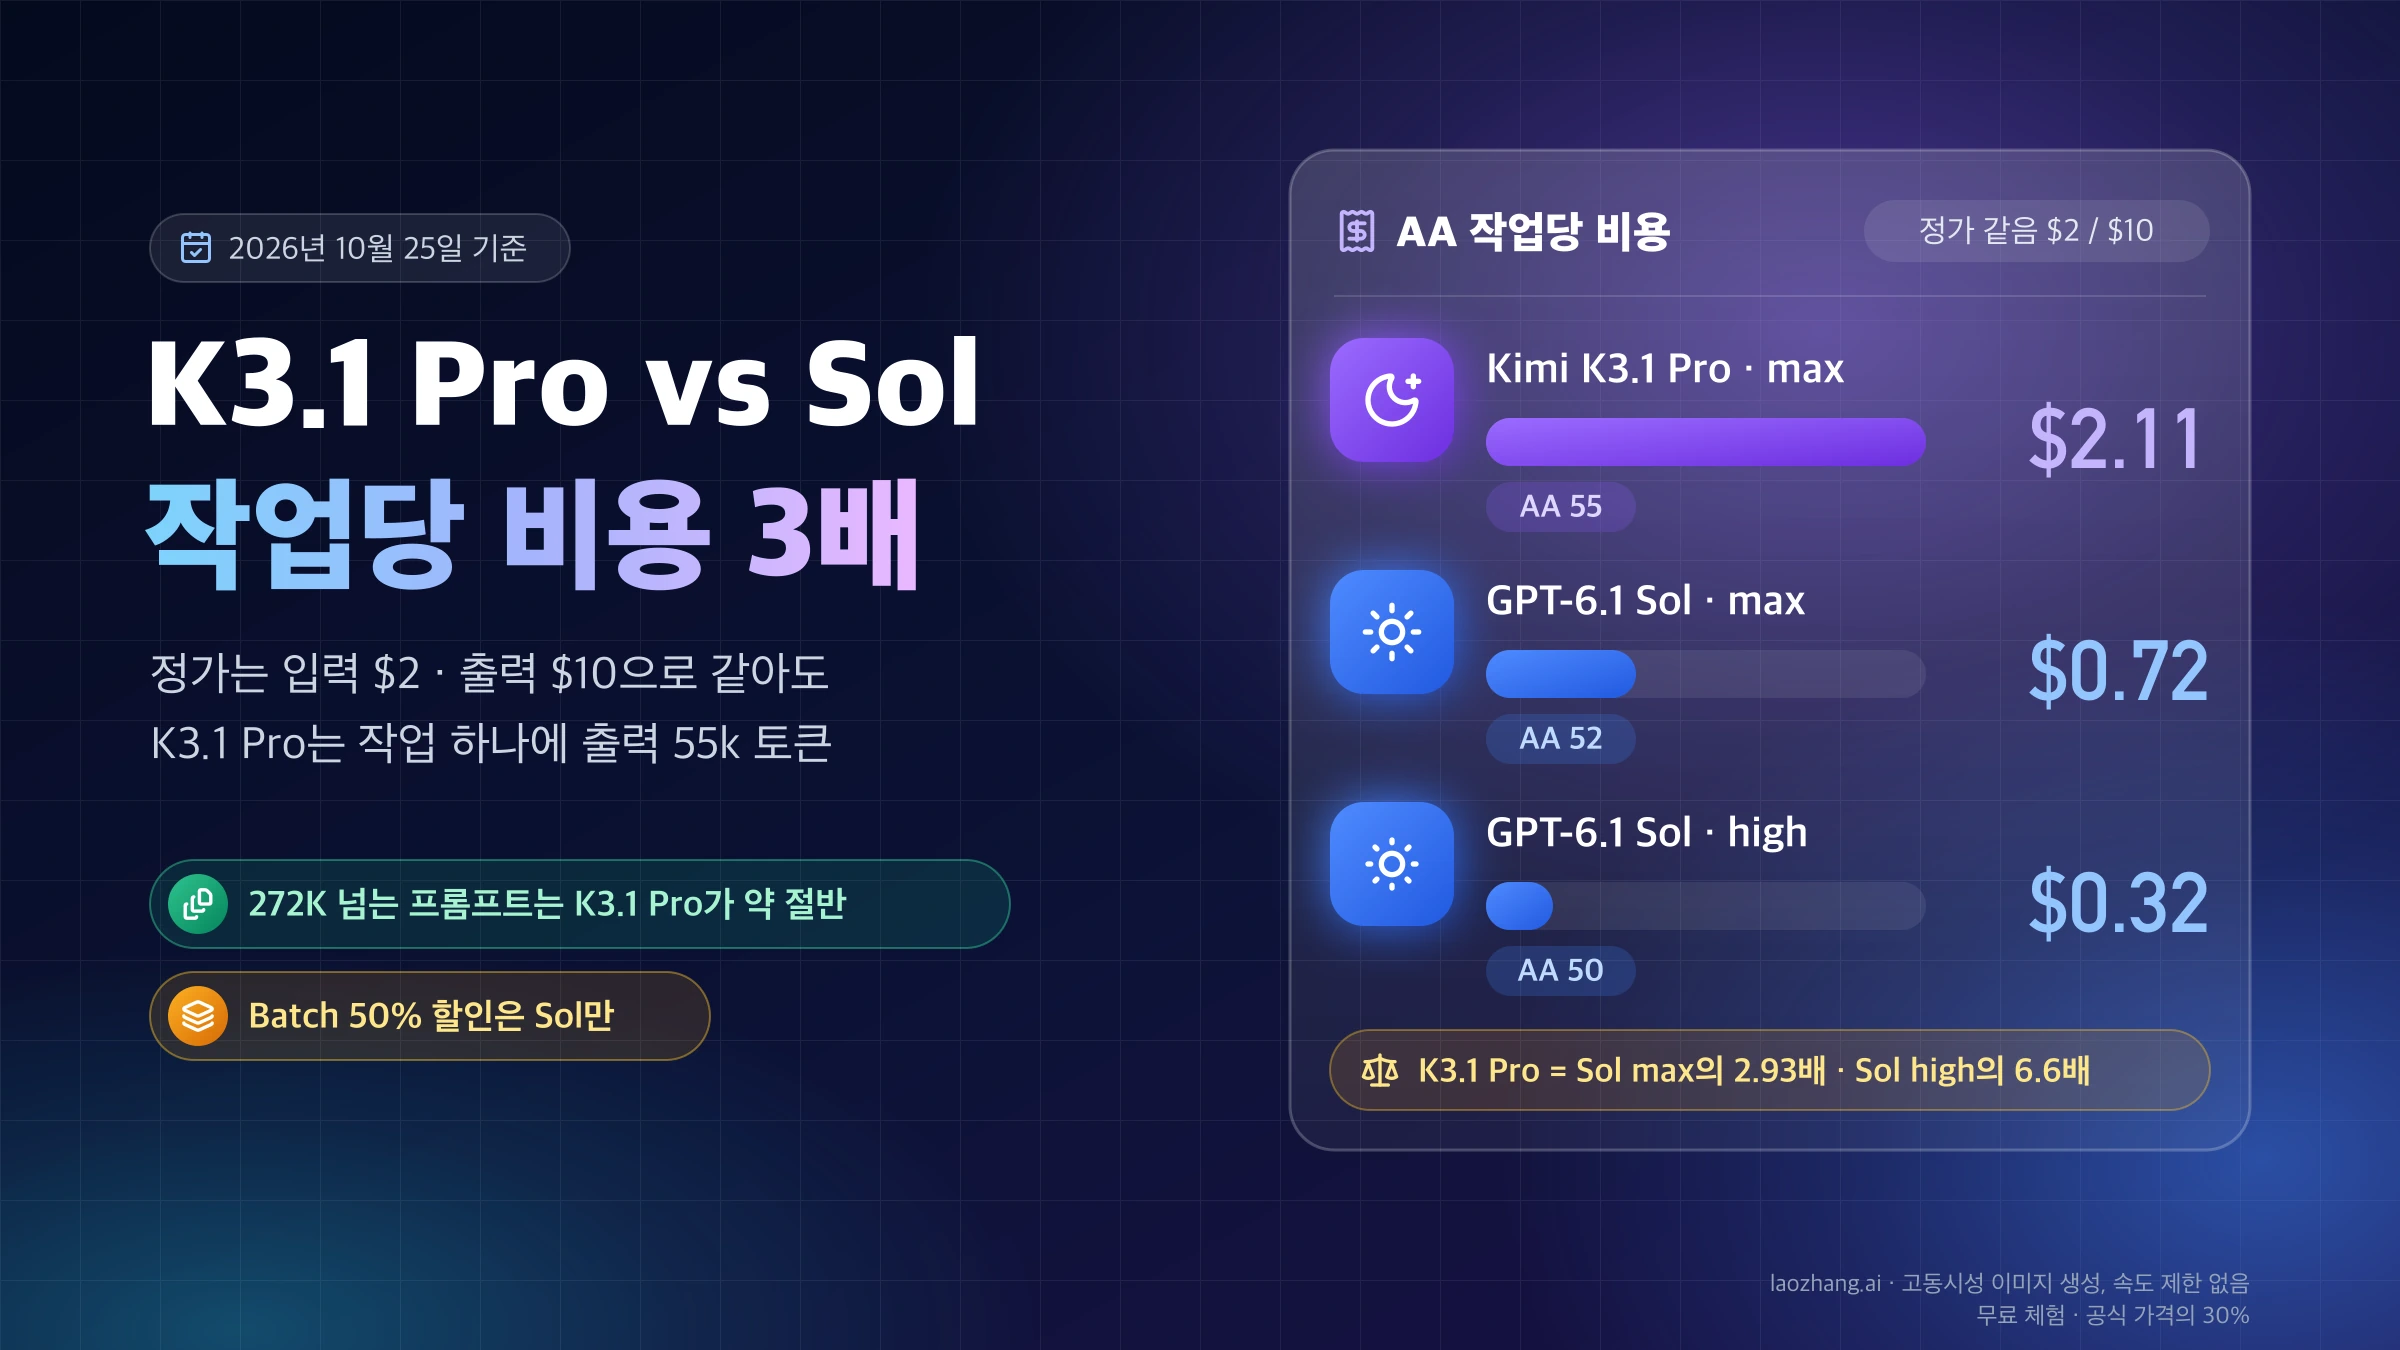
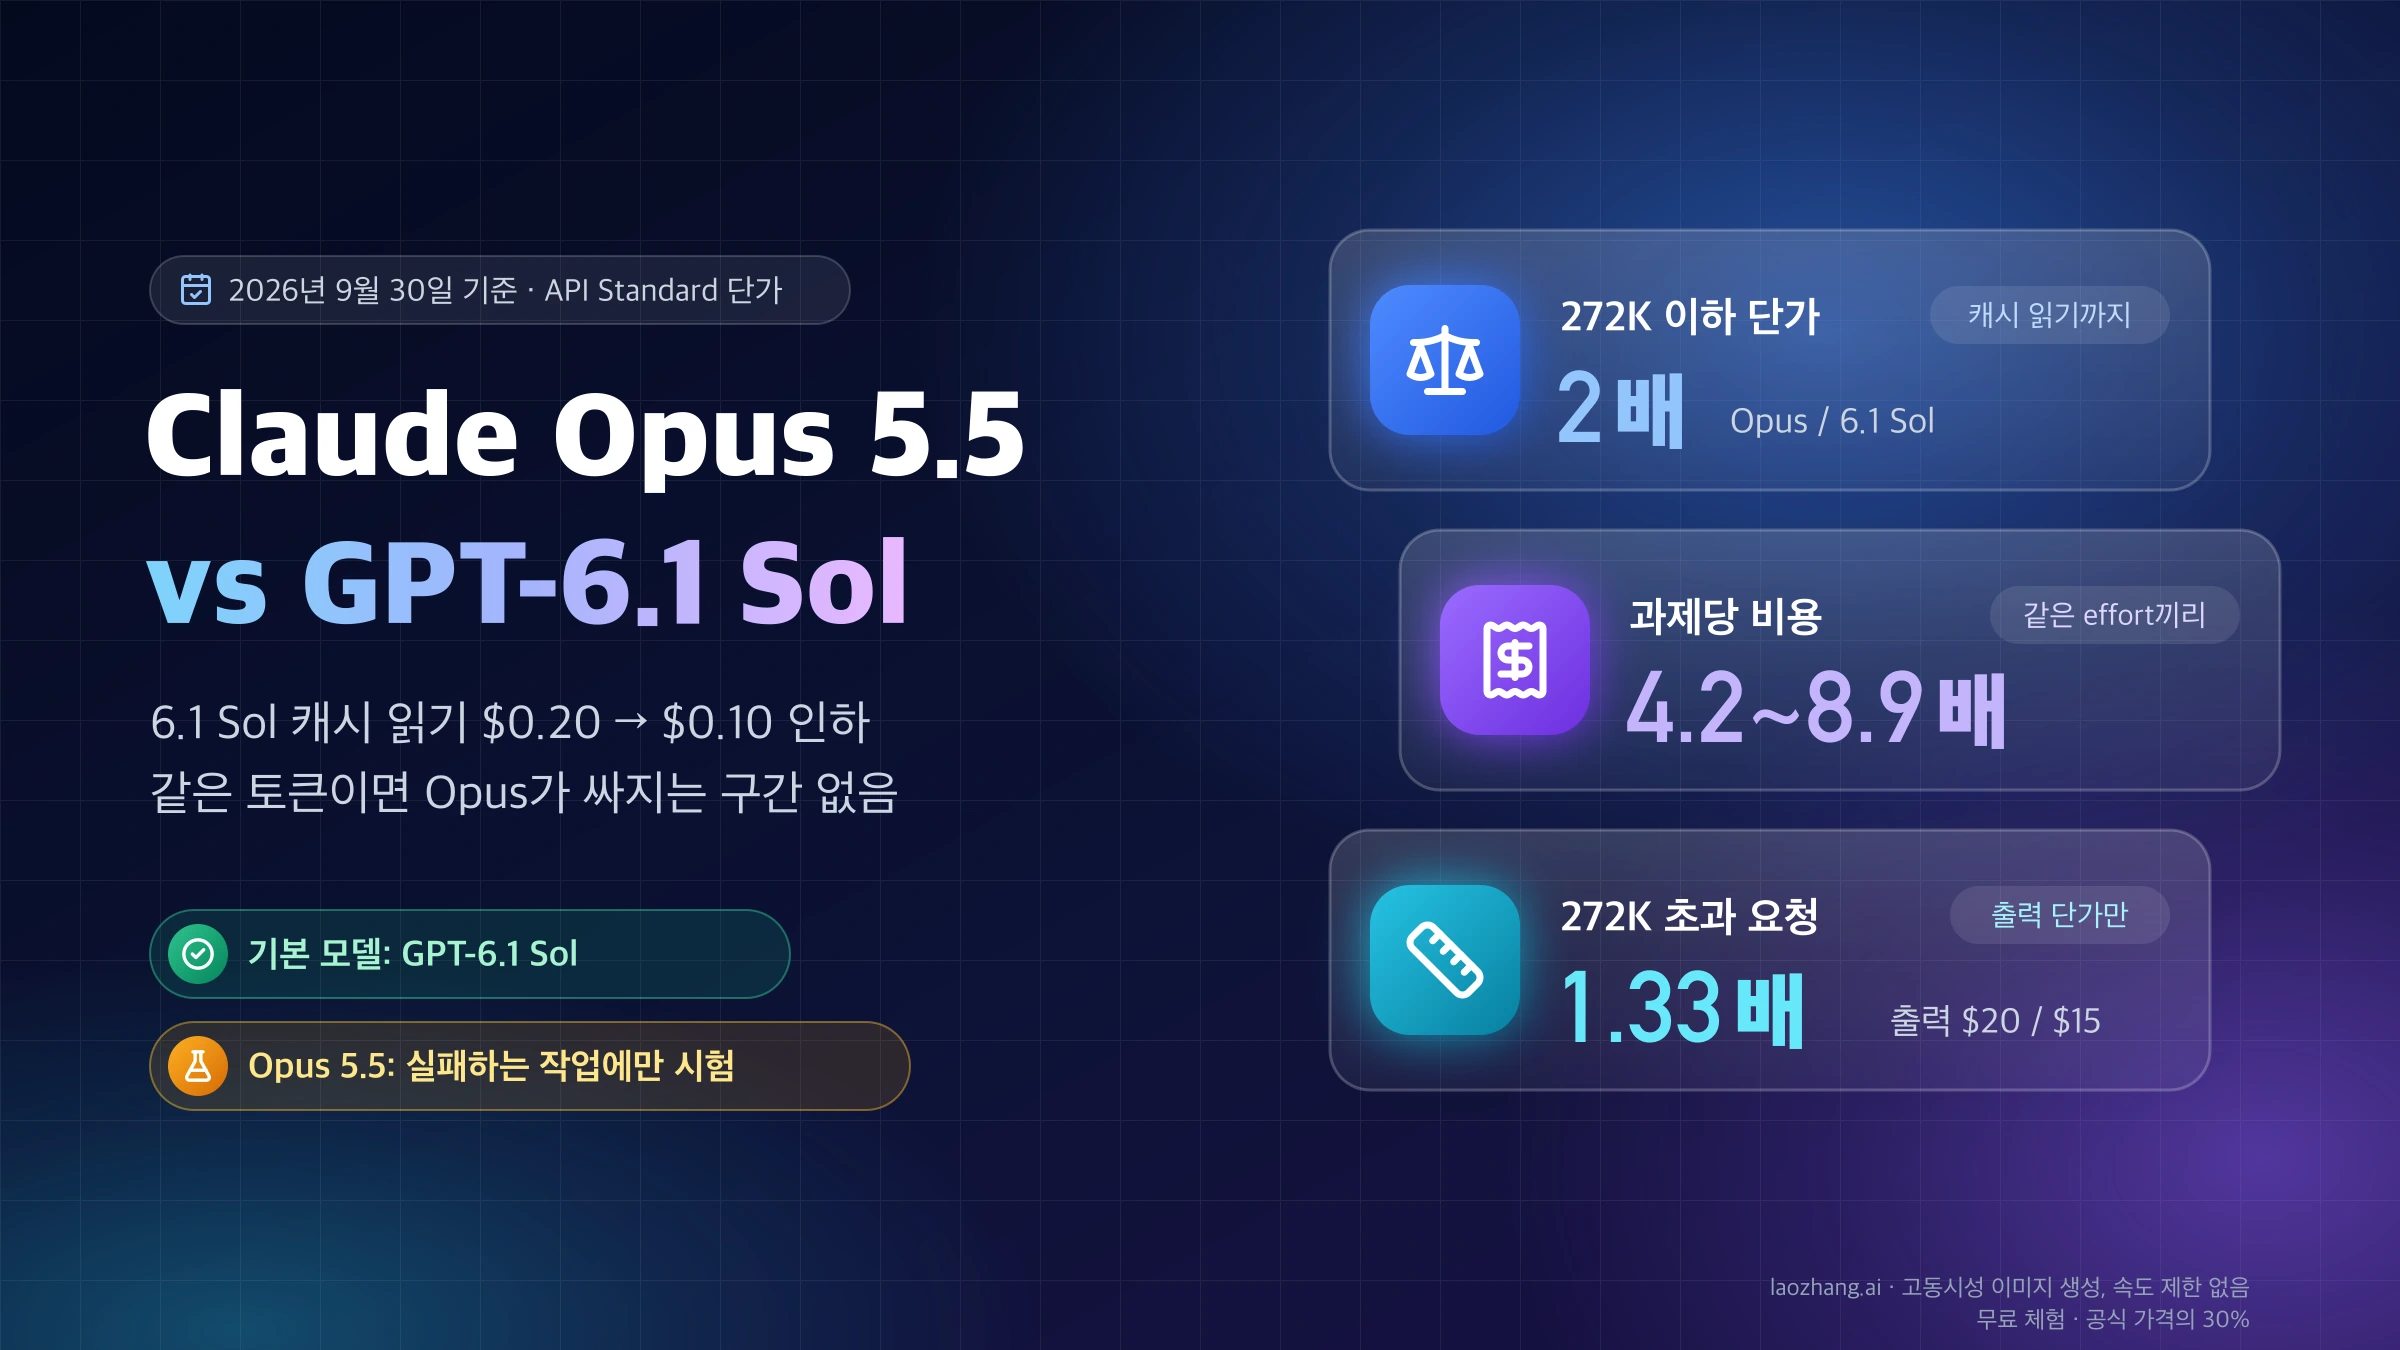
긴 입력에서는 차이가 줄어듭니다. GPT-6.2 Sol 모델 페이지에 따르면 입력이 272K 토큰을 넘는 요청은 요청 전체의 입력이 $4, 출력이 $15로 오릅니다. Opus 5.5는 100만 토큰 컨텍스트 전체에 같은 단가를 적용하므로, 이런 요청에서는 입력 단가가 같아지고 출력만 $15 대 $20으로 차이가 납니다. 실제 청구액은 모델마다 같은 일에 쓰는 토큰 수가 달라 단가 비율과 다르게 나오는데, 아래 측정이 그 차이를 보여 줍니다.
effort별 성능 차이: 6.2 Sol이 모든 단계에서 2~7점 높습니다
AA Intelligence Index v5.0.1에서 GPT-6.2 Sol은 low부터 max까지 같은 추론 강도끼리 6.1 Sol보다 항상 높았습니다. 차이는 medium에서 7점으로 가장 크고 max에서 2점으로 가장 작습니다. 6.2 Sol 수치는 2026년 11월 18일 AA의 GPT-6.2 Sol 모델 페이지 기준이고, 6.1 Sol 수치는 2026년 11월 4일(max는 11월 11일 재확인) 기준입니다.
| 추론 강도 | 6.2 Sol 점수 | 6.2 Sol 작업당 비용 | 6.1 Sol 점수 | 6.1 Sol 작업당 비용 | 점수 차 |
|---|---|---|---|---|---|
low | 41 | $0.18 | 35 | $0.16 | +6 |
medium | 53 | $0.41 | 46 | $0.36 | +7 |
high | 55 | $0.56 | 50 | $0.59 | +5 |
xhigh | 56 | $0.65 | 52 | $0.76 | +4 |
max | 57 | $1.01 | 55 | $1.27 | +2 |
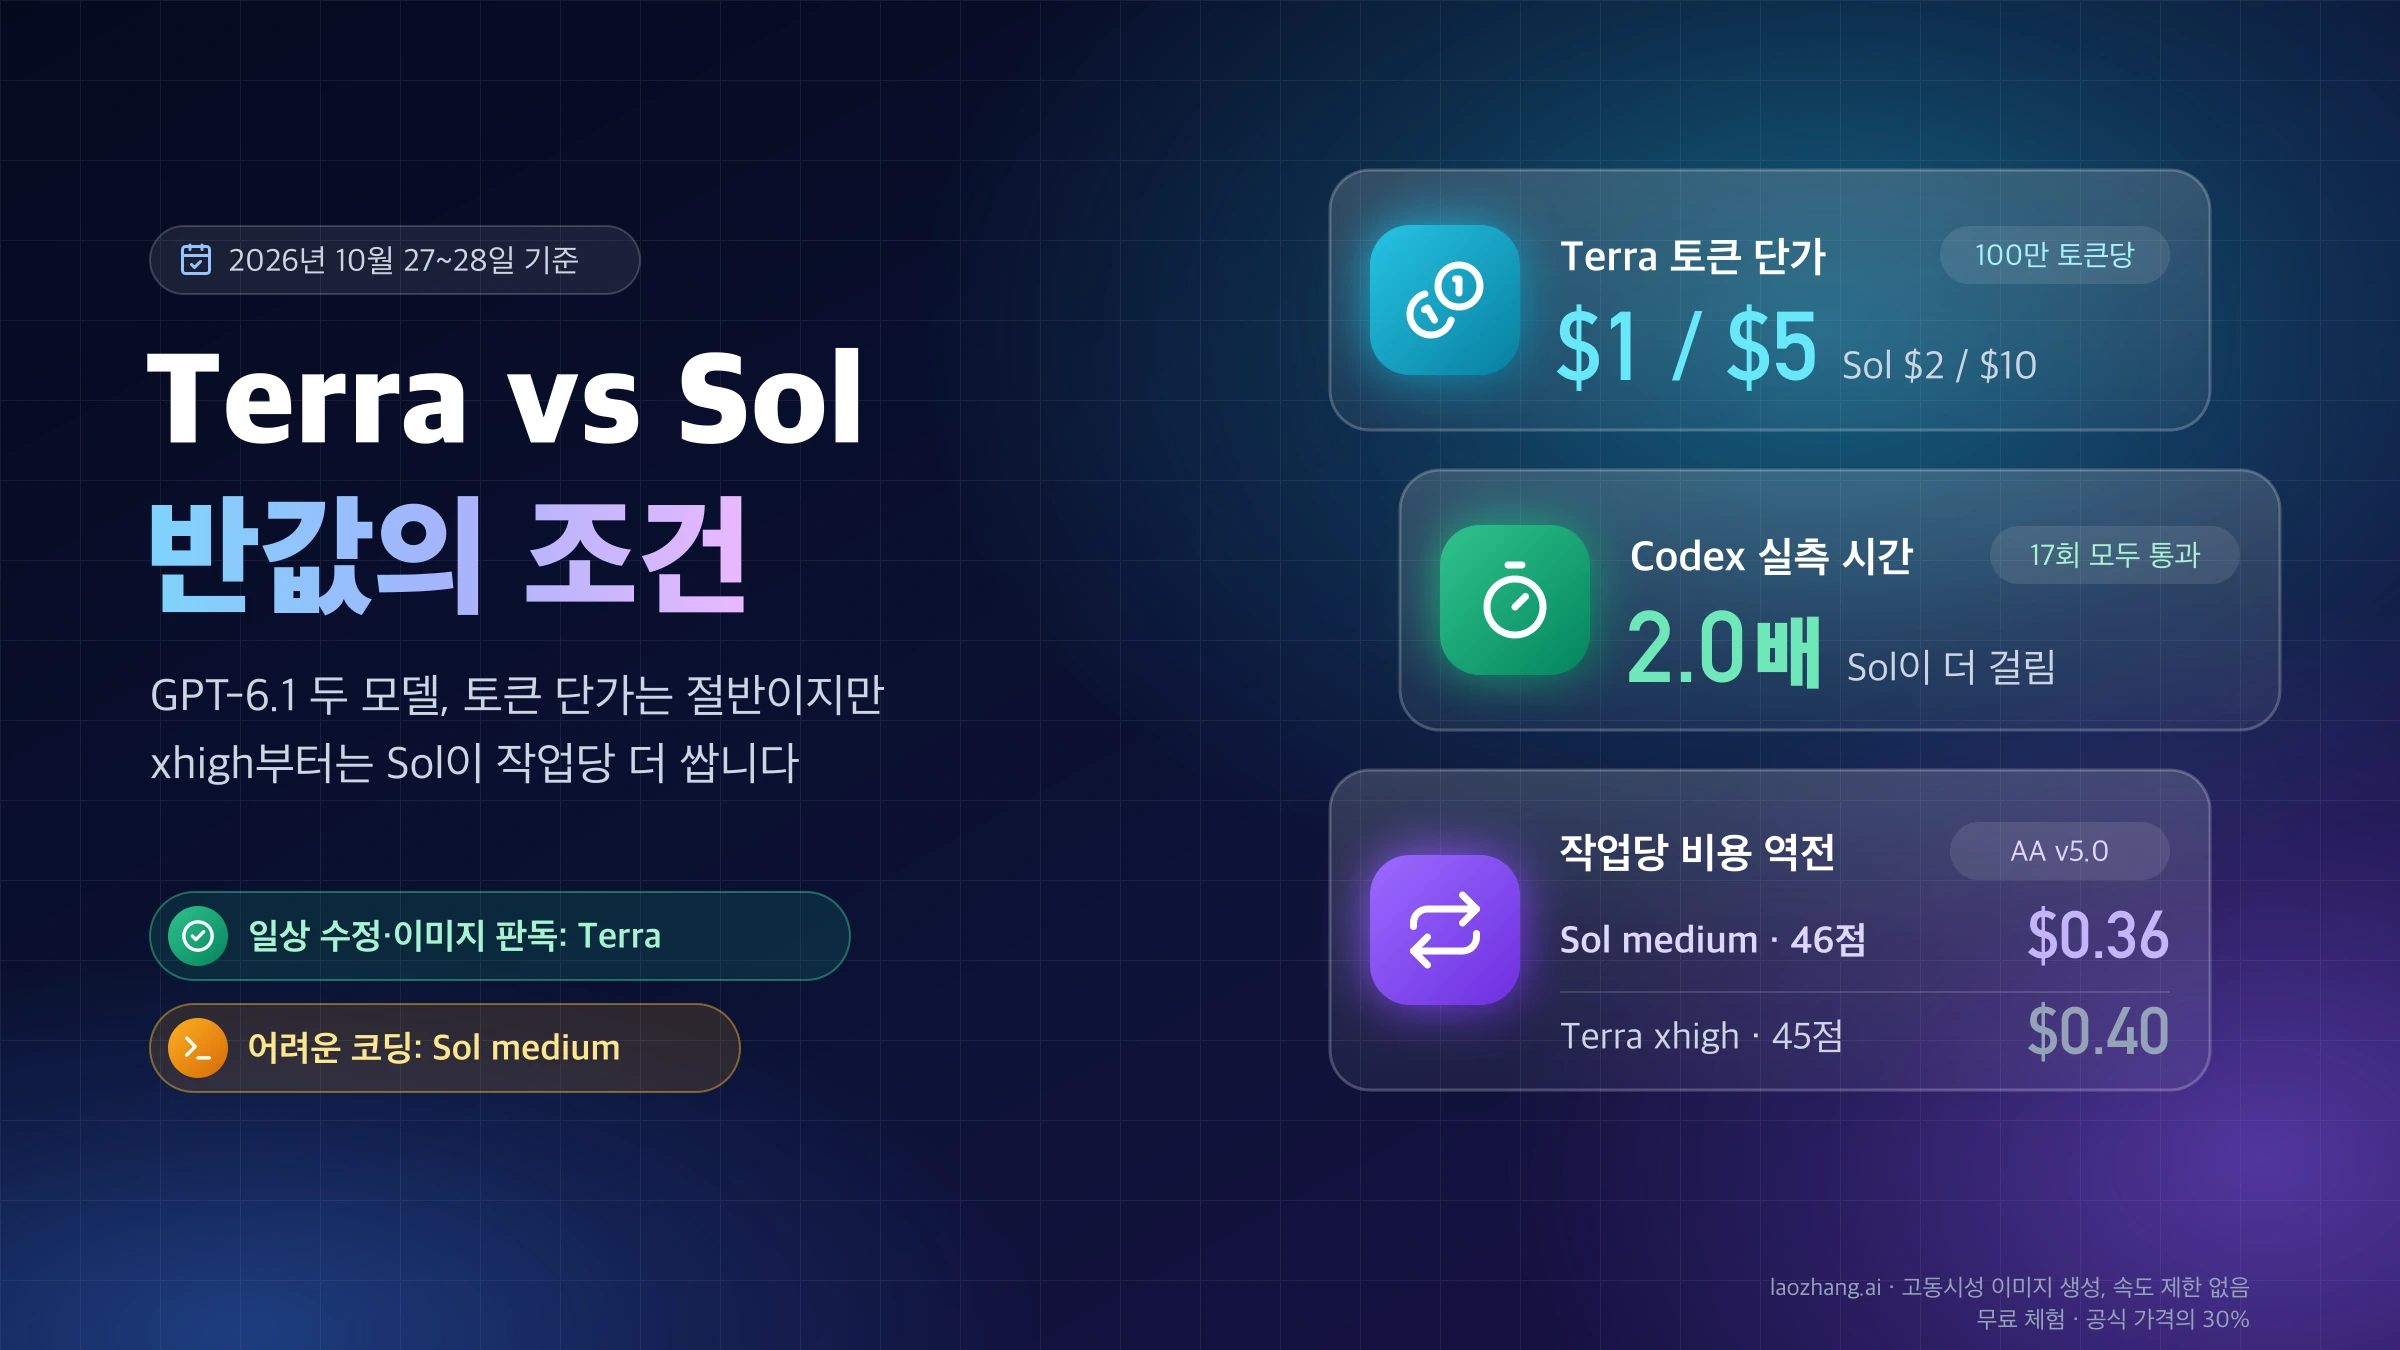
작업당 비용은 AA 지수의 문제 하나를 푸는 데 든 평균 비용입니다. low와 medium에서는 6.2 Sol이 12~14% 더 들고, high부터는 6.2 Sol이 더 적게 듭니다. 같은 단계에서 비용이 약간 늘더라도 점수가 6~7점 오르므로 low·medium 사용자는 단계를 그대로 두는 편이 낫습니다. 반대로 high 이상에서는 한 단계 낮춰도 점수가 같거나 높습니다. 6.1 Sol high(50점, $0.59)는 6.2 Sol medium(53점, $0.41)으로, 6.1 Sol max(55점, $1.27, 작업당 20.1분)는 6.2 Sol high(55점, $0.56, 4.2분)로 바꿀 수 있습니다.
새로 통합을 시작한다면 OpenAI의 GPT-6.2 사용 가이드도 medium에서 시작하라고 권합니다. 한 가지 덧붙이면, 2026년 11월 18일 AA는 자사 모델 목록에서 6.1 Sol을 "deprecated"로 표시하고 6.1 Sol 비교 페이지를 내렸습니다. 이것은 AA 목록의 상태 표시일 뿐 OpenAI의 서비스 종료 공지가 아닙니다.
같은 12문제 실측: 모두 정답, 시간과 비용에서 갈렸습니다
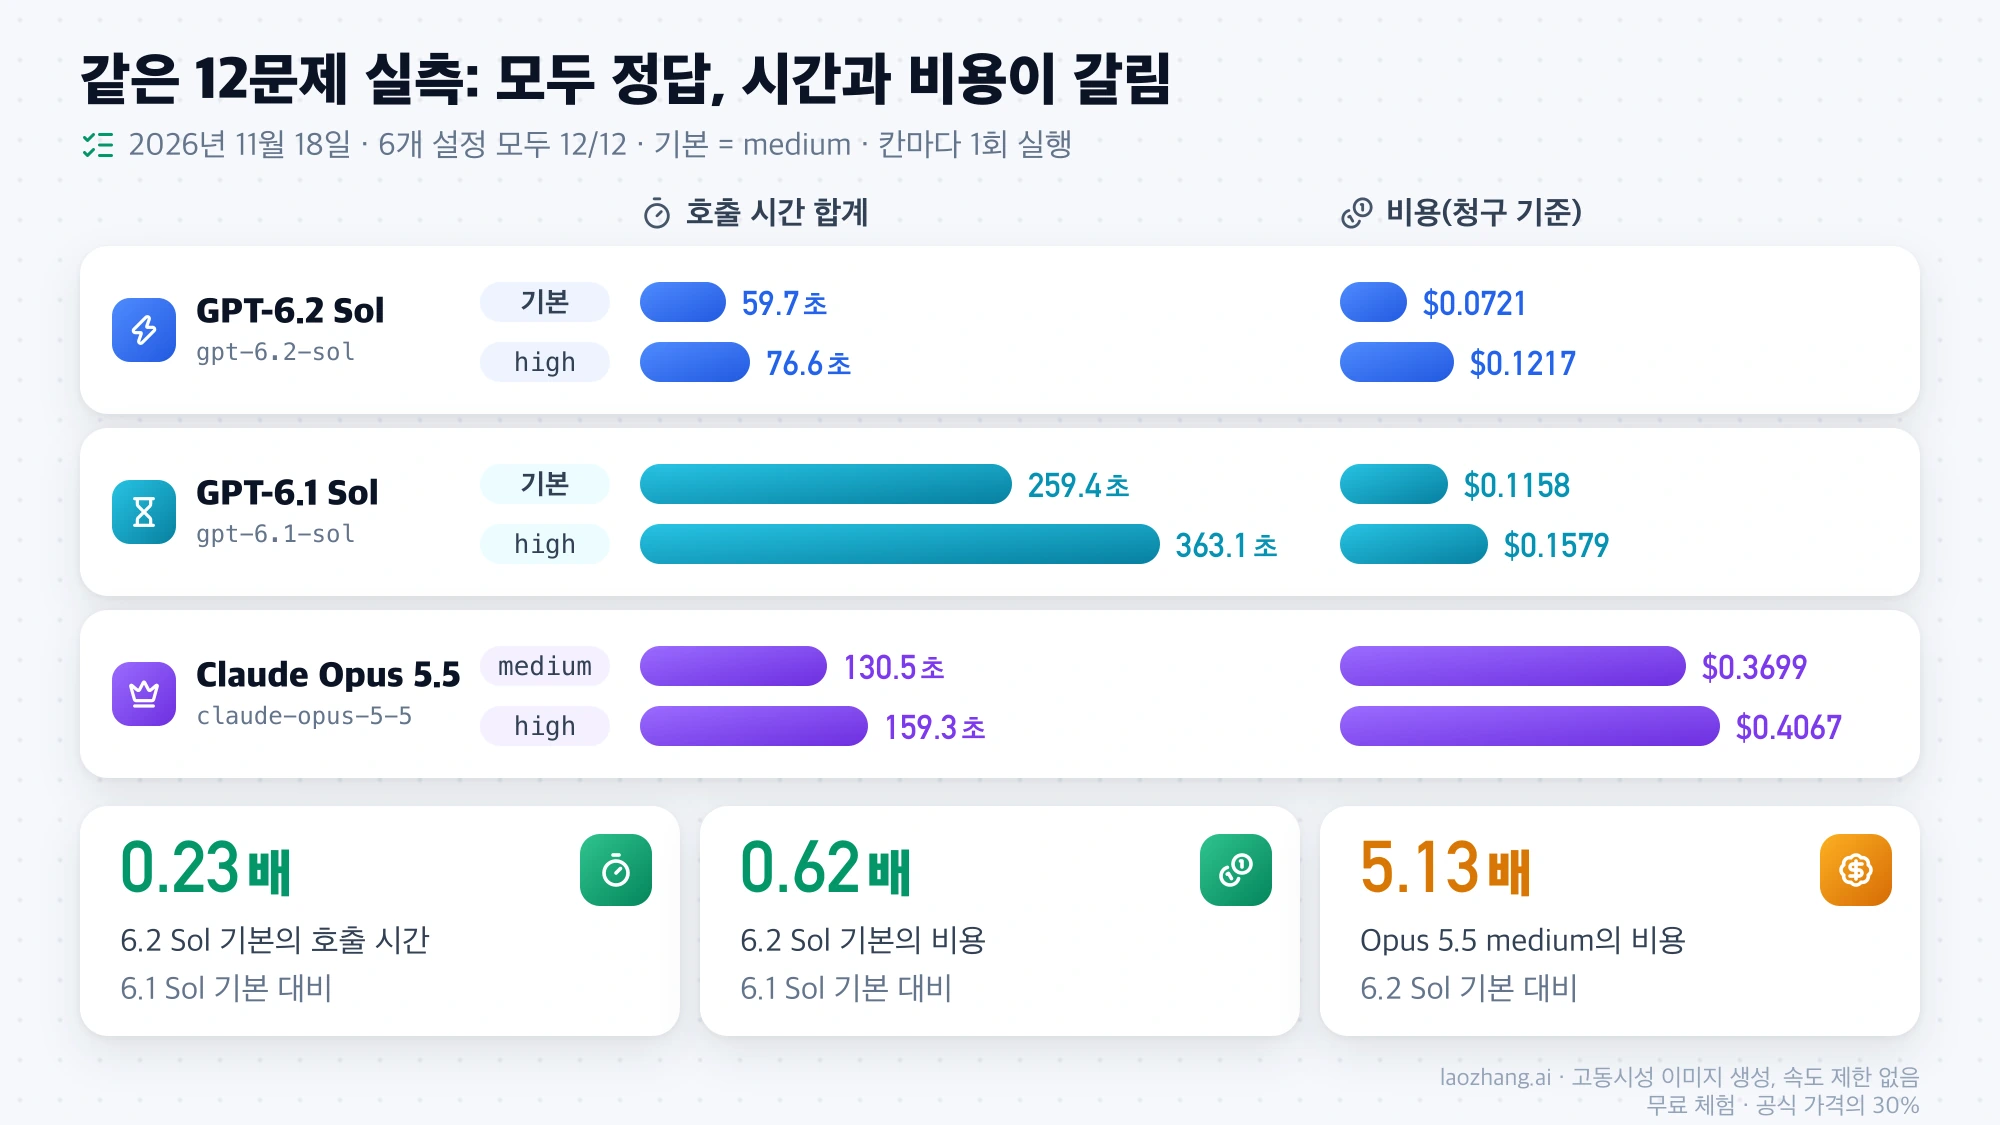
2026년 11월 18일 laozhang.ai 게이트웨이를 거쳐 숨은 테스트나 정답이 정해진 12문제(구간 병합, 수식 계산기, semver 범위 판정, 긴 문서 질의 등)를 세 모델에 같은 문장으로 풀게 했습니다. 세 모델 모두 두 가지 설정에서 12문제를 전부 맞혔고, 차이는 걸린 시간과 토큰, 비용에서 났습니다. GPT 두 모델은 Chat Completions로 호출했으며 "기본"은 reasoning_effort를 넣지 않은 요청, 즉 medium입니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
| 설정 | 정답 | 출력 토큰 | 호출 시간 합계 | 비용(청구 기준) |
|---|---|---|---|---|
| GPT-6.2 Sol 기본 | 12/12 | 4,220 | 59.7초 | $0.0721 |
GPT-6.2 Sol high | 12/12 | 6,765 | 76.6초 | $0.1217 |
| GPT-6.1 Sol 기본 | 12/12 | 6,167 | 259.4초 | $0.1158 |
GPT-6.1 Sol high | 12/12 | 10,380 | 363.1초 | $0.1579 |
Claude Opus 5.5 medium | 12/12 | 11,833 | 130.5초 | $0.3699 |
Claude Opus 5.5 high | 12/12 | 13,674 | 159.3초 | $0.4067 |
기본 설정끼리 보면 6.2 Sol은 6.1 Sol보다 출력 토큰을 32% 적게 쓰고 시간은 0.23배, 비용은 0.62배였습니다. 다만 6.2 Sol 기본 실행 중 긴 문서 문제 하나는 직전에 high로 같은 요청을 보낸 덕분에 입력 10,103토큰이 캐시로 읽혔습니다. 모든 입력을 캐시 없이 계산하면 6.2 Sol 기본은 $0.0862로, 6.1 Sol 기본($0.1056)의 0.82배입니다. Opus 5.5 medium은 6.2 Sol 기본보다 비용 5.13배(캐시 없이 계산하면 4.29배), 시간 2.19배, 출력 토큰 2.80배였고, 시간만 보면 6.1 Sol 기본보다는 빨랐습니다.
이 측정에는 분명한 한계가 있습니다. 칸마다 한 번씩만 실행했고, 문제가 단발성이라 세 모델이 모두 맞혔으므로 능력 차이가 아니라 속도·토큰·비용의 차이를 잰 결과입니다. Opus 5.5의 12문제 가운데 8문제는 2026년 11월 11일 스트리밍으로 받은 결과이고 4문제는 11월 18일 결과입니다. 시간은 게이트웨이를 거친 호출 시간의 합이라 각 회사가 직접 제공하는 API의 지연 시간과 같지 않고, 비용은 응답에 담긴 사용량에 공식 단가를 곱한 추정치입니다.
긴 로그를 다루는 작업에서도 방향은 같았습니다. 1,500줄(146KB)짜리 로그에서 정확한 숫자 7개를 세는 문제를 세 모델 모두 기본 설정으로 맞혔는데, 6.2 Sol은 13.6초·$0.1581(2026년 11월 18일), 6.1 Sol은 45.7초·$0.1654(11월 16일), Opus 5.5 medium은 57.6초·$0.4681(11월 11일)이었습니다. 이 작업은 입력이 비용 대부분을 차지해 두 Sol의 비용이 거의 같고 시간만 3.4배 차이가 납니다. Opus 5.5가 약 3배 비싼 이유는 단가가 2배인 데다 같은 로그를 78,537토큰으로 세어 Sol의 55,843토큰보다 1.41배 많이 읽었기 때문입니다.
"6.2 Sol 코딩이 6.1보다 못하다"는 말: AA 코딩 에이전트 52.2 대 49.8
AA가 Codex로 잰 코딩 에이전트 점수로는 맞는 말입니다. 2026년 11월 18일 AA 코딩 에이전트 지수에서 Codex + 6.2 Sol의 최고점은 xhigh 49.8점으로, Codex + 6.1 Sol max의 52.2점보다 2.4점 낮습니다. 대신 작업당 비용은 $0.90 대 $1.51로 40% 적고, 시간은 12.6분 대 21.9분으로 42% 짧습니다.
| 에이전트 + 모델(추론 강도) | 점수 | 작업당 비용 | 작업당 시간 |
|---|---|---|---|
Codex + GPT-6.1 Sol (max) | 52.2 | $1.51 | 21.9분 |
Codex + GPT-6.2 Sol (max) | 48.6 | $1.22 | 17.5분 |
Codex + GPT-6.2 Sol (xhigh) | 49.8 | $0.90 | 12.6분 |
Codex + GPT-6.2 Sol (high) | 47.5 | $0.76 | 10.6분 |
Claude Code + Claude Opus 5.5 (max) | 58.2 | $12.61 | 65.3분 |
이 지수는 FrontierCode 2.0, SWE-Atlas QnA, Terminal-Bench v4를 Codex CLI 0.166.0과 Claude Code로 실행해 묶은 점수입니다. 표에서 눈여겨볼 점은 두 가지입니다. 6.2 Sol은 max가 xhigh보다 점수가 낮고 비용과 시간은 더 들었으므로, Codex에서 6.2 Sol의 상한은 xhigh로 두는 편이 낫습니다. 또 AA가 6.1 Sol은 max 한 줄만 공개해서 같은 추론 강도끼리 비교할 수는 없습니다. 6.1 Sol max의 점수를 어떤 6.2 Sol 설정도 넘지 못한다는 것까지만 말할 수 있습니다.
사용자 반응도 갈립니다. Reddit r/codex에는 "Gpt 6.2 Astra is equivalent to 6 in coding, 6.2 Sol is worse than 6.1"이라는 글이 305표를 받았고, VentureBeat는 출시 기사 제목에 파워 유저들의 "Essentially unusable" 반응을 실었습니다. 반면 Hacker News 출시 스레드에는 비용이 6.1 Sol의 $2.6에서 6.2 Sol의 $1.2로 줄었고 정확도는 비슷했다는 댓글이 달렸습니다. 모두 개별 사용자의 보고이므로, 위의 단발성 12문제 실측처럼 쉬운 문제에서는 차이가 드러나지 않고 긴 에이전트 작업에서 갈린다는 정도로 받아들이는 것이 안전합니다.
Opus 5.5 대신 6.2 Sol을 써도 될까: 같은 점수면 작업당 비용 약 6분의 1
AA Intelligence Index에서 점수를 맞추면 6.2 Sol이 Opus 5.5보다 작업당 비용이 약 6분의 1입니다. 2026년 11월 18일 AA의 Opus 5.5와 GPT-6.2 Sol 비교에서 같은 57점은 6.2 Sol max가 $1.01·7.9분, Opus 5.5 xhigh가 $6.05·15.6분에 냈습니다. 6.2 Sol medium(53점, $0.41, 3.1분)은 Opus 5.5 high(52점, $3.46, 9.3분)보다 점수가 1점 높습니다.
Reddit r/ClaudeCode에서 나온 "6.2 Sol low가 Opus 5.5 medium을 이길 수 있나"라는 질문에는 AA 지수 기준으로 아니라고 답할 수 있습니다. 6.2 Sol low는 41점, Opus 5.5 medium은 48점입니다. Opus 5.5 medium(48점, $2.45, 6.8분)을 넘으려면 6.2 Sol medium(53점, $0.41)이 필요하고, 그래도 작업당 비용은 약 6분의 1입니다.
옮길 때 잃는 것도 있습니다. AA 지수 최고점은 Opus 5.5 max의 59점으로 6.2 Sol max(57점)보다 높고, 세부 평가에서도 HLE-Diamond 67.9% 대 64.0%, FrontierCode-AA 2.0 46.4% 대 44.4%로 Opus 5.5가 앞섭니다. Terminal-Bench 4.0만 6.2 Sol 60.1%, Opus 5.5 59.6%로 비슷합니다. 가장 큰 차이는 앞의 코딩 에이전트 지수로, Claude Code + Opus 5.5 max 58.2점과 6.2 Sol 최고점 49.8점은 8.4점 벌어집니다. 그 대가로 Opus 5.5는 작업당 $12.61, 65.3분이 들어 6.2 Sol xhigh보다 비용 14배, 시간 5.2배입니다.
사용자 사례도 이 비율과 비슷합니다. X의 EnvolDev는 같은 3D 장면 생성 요청에 6.2 Sol이 $2.07·30분 47초, Opus 5.5가 $31.85·2시간 45분이 들었다고 올렸습니다. 이전 세대 Sol과 Opus의 비용 비교는 Claude Opus 5.5 vs GPT-6 Sol·6.1 Sol 비용에 정리돼 있습니다.
작업별 선택: 6.2 Sol로 옮길 일과 Opus 5.5·6.1 Sol에 남길 일
정답을 테스트로 확인할 수 있는 일상 코딩, 문서·로그 처리, 대량 API 호출은 6.2 Sol medium부터 시작하고, 긴 에이전트 작업에서 실패가 반복될 때만 다른 모델을 비교하는 순서가 비용 대비 가장 낫습니다. 아래 표는 앞의 AA 수치와 2026년 11월 18일 실측을 근거로 한 권장 기준이며, 특정 작업에서 결과를 보장하지는 않습니다.
| 맡길 일 | 먼저 쓸 설정 | 다른 모델을 비교할 시점 |
|---|---|---|
| 함수 구현, 테스트 작성, 버그 수정 같은 단발성 코딩 | 6.2 Sol medium | 같은 테스트에서 실패가 반복되면 high로 올린 뒤 Opus 5.5 medium과 비교 |
| 긴 로그·문서 집계, 요약, 구조화 추출 | 6.2 Sol medium | 입력이 272K 토큰을 넘어 Sol 단가가 오를 때 Opus 5.5와 총비용 비교 |
| Codex에서 여러 단계로 이어지는 코딩 에이전트 작업 | 6.2 Sol xhigh | 6.1 Sol max에서 통과하던 작업이 실패할 때 두 모델을 나란히 실행 |
| 실패 비용이 큰 대규모 리팩터링, 가장 어려운 에이전트 코딩 | Claude Code + Opus 5.5 xhigh·max | 작업당 $12 수준의 비용이 부담될 때 6.2 Sol xhigh 결과를 같은 기준으로 검토 |
표의 기준은 합격 여부를 먼저 정해 둘 때 작동합니다. 테스트나 정답 비교로 결과를 확인할 수 있으면 싼 설정의 실패를 바로 알아챌 수 있으므로 6.2 Sol부터 시작해도 손해가 작습니다. 반대로 결과를 사람이 오래 검토해야 하는 작업이라면, API 청구액보다 검토와 재작업 시간이 더 클 수 있어 Opus 5.5를 남겨 둘 이유가 생깁니다.
6.1 Sol이나 Opus 5.5에서 6.2 Sol로 바꿀 때 요청에서 고칠 것
모델 ID만 gpt-6.2-sol로 바꿔도 대부분의 요청은 그대로 동작하지만, 추론 강도 값과 캐시, 대화 이력 처리 방식이 달라진 부분이 있습니다. 아래는 OpenAI GPT-6.2 사용 가이드의 안내와, 2026년 11월 18일 laozhang.ai를 거친 호출에서 실제로 돌아온 결과입니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
none을 받는 다른 모델과 같은 설정을 쓰던 요청이라면 확인이 필요합니다. 6.1 Sol도low~max만 받으므로 6.1 Sol에서 그대로 옮길 때는 바뀌는 점이 없습니다.reasoning.effort(Chat Completions에서는reasoning_effort)에none을 넣으면 400 오류와 함께 "Unsupported value: 'none' is not supported with the 'gpt-6.2-sol' model."이라는 메시지가 돌아옵니다. 쓸 수 있는 값은low,medium,high,xhigh,max이고, OpenAI는none이나minimal을 쓰던 요청은low로 바꾸라고 안내합니다.- Responses API의 최상위
instructions는 GPT-6.2부터 입력 뒤에 붙습니다. 재사용하는 지시문이 캐시되게 하려면input의 첫 항목인 developer 메시지로 옮기세요. 9천 토큰짜리instructions를 세 번 보냈을 때 캐시된 토큰은 0이었고, OpenAI 직접 호출에서도 같았습니다. - 같은 대화 중간에 앞쪽 대화 이력을 수정하거나, 일부 모델 변경(하위 모델로 바꾸는 경우 포함)이 있거나, 최종 사용자나 조직이 바뀌면 Responses API가 이전 추론 항목을 버립니다. OpenAI는 이때 답의 품질이 떨어지고 토큰이 더 들 수 있다고 설명하므로, 6.1 Sol에서 넘어올 때는 새 대화로 시작하는 편이 낫습니다.
- Chat Completions에서는
temperature,top_p,logprobs,top_logprobs를 빼야 합니다.reasoning_effort: "max"는 Chat Completions에서 실패했으므로max가 필요하면 Responses API를 쓰세요. - OpenAI 변경 기록은 6.2 계열의 도구 호출에 Responses API가 필요하다고 적고 있습니다. laozhang.ai 경유 Chat Completions 도구 요청은 200으로 처리됐지만 공식 안내와 다른 경로별 동작이므로, 도구를 쓰는 통합은 Responses API로 옮기는 편이 안전합니다.
같은 날 laozhang.ai 경유 Chat Completions 응답의 model 필드에는 gpt-6.2-sol-2026-11-17이 찍혀 왔습니다. 다만 OpenAI 문서에는 날짜가 붙은 스냅샷 ID가 없으므로, 이 이름을 버전 고정용으로 요청에 넣는 것은 권하지 않습니다. 6.1 Sol 시절에 바뀐 요청 조건은 GPT-6.1 Sol 가격과 사용법: 모델 ID만 바꾸면 안 되는 이유에서 확인할 수 있습니다.
GPT-6.2 Sol·6.1 Sol·Opus 5.5에 관한 다른 질문
GPT-6.1 Sol은 이제 없어지나요?
2026년 11월 18일 기준 OpenAI API 가격 페이지에 gpt-6.1-sol은 6.2 Sol과 같은 단가로 그대로 올라 있고, OpenAI 변경 기록에 종료 일정도 없습니다. Codex나 ChatGPT에서 6.1 Sol을 계속 고를 수 있는지는 OpenAI가 따로 밝히지 않았습니다.
GPT-6.1 Sol은 왜 그렇게 느렸나요?
6.1 Sol의 응답이 느린 원인과 effort·Fast 설정으로 기다리는 시간을 줄이는 방법은 GPT-6.1 Sol 느림 원인과 해결: effort·Fast 설정과 10월 26일 실측에서 다룹니다.
Claude Opus 5.5는 어디서 어떻게 쓰나요?
API 모델 ID claude-opus-5-5를 포함해 요금제별 사용 경로와 게스트 패스 조건은 Claude Opus 5.5 사용법과 무료 경로: 게스트 패스 조건과 막힌 방법에 정리돼 있습니다.
같은 날 나온 GPT-6.2 Astra와는 어떻게 다른가요?
OpenAI는 GPT-6.2 Astra를 가장 어려운 추론·코딩 작업용, 6.2 Sol을 일상적인 코딩과 에이전트 작업용으로 구분합니다. Astra는 100만 토큰당 입력 $8, 출력 $40으로 6.2 Sol의 4배입니다.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 18일.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 18일.
- 1.OpenAI API 가격 페이지developers.openai.com/api/docs/pricing
- 2.Anthropic API 요금표platform.claude.com/docs/en/about-claude/pricing
- 3.GPT-6.2 Sol 모델 페이지developers.openai.com/api/docs/models/gpt-6.2-sol
- 4.AA의 GPT-6.2 Sol 모델 페이지artificialanalysis.ai/models/gpt-6-2-sol
- 5.GPT-6.2 사용 가이드developers.openai.com/api/docs/guides/latest-model
- 6.AA 코딩 에이전트 지수artificialanalysis.ai/agents/coding
- 7.AA의 Opus 5.5와 GPT-6.2 Sol 비교artificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-gpt-6-2-sol