Gemini 4 Carbon vs GPT-6.1 Sol 코딩 비교: 단가는 같아도 실측 비용 7배
코딩은 GPT-6.1 Sol부터 시작하세요. 11월 30일까지 Gemini 4 Carbon과 단가는 같지만 같은 7문제를 맞히는 데 Carbon 비용이 7배였고, 12월 1일부터는 14배입니다.
목차
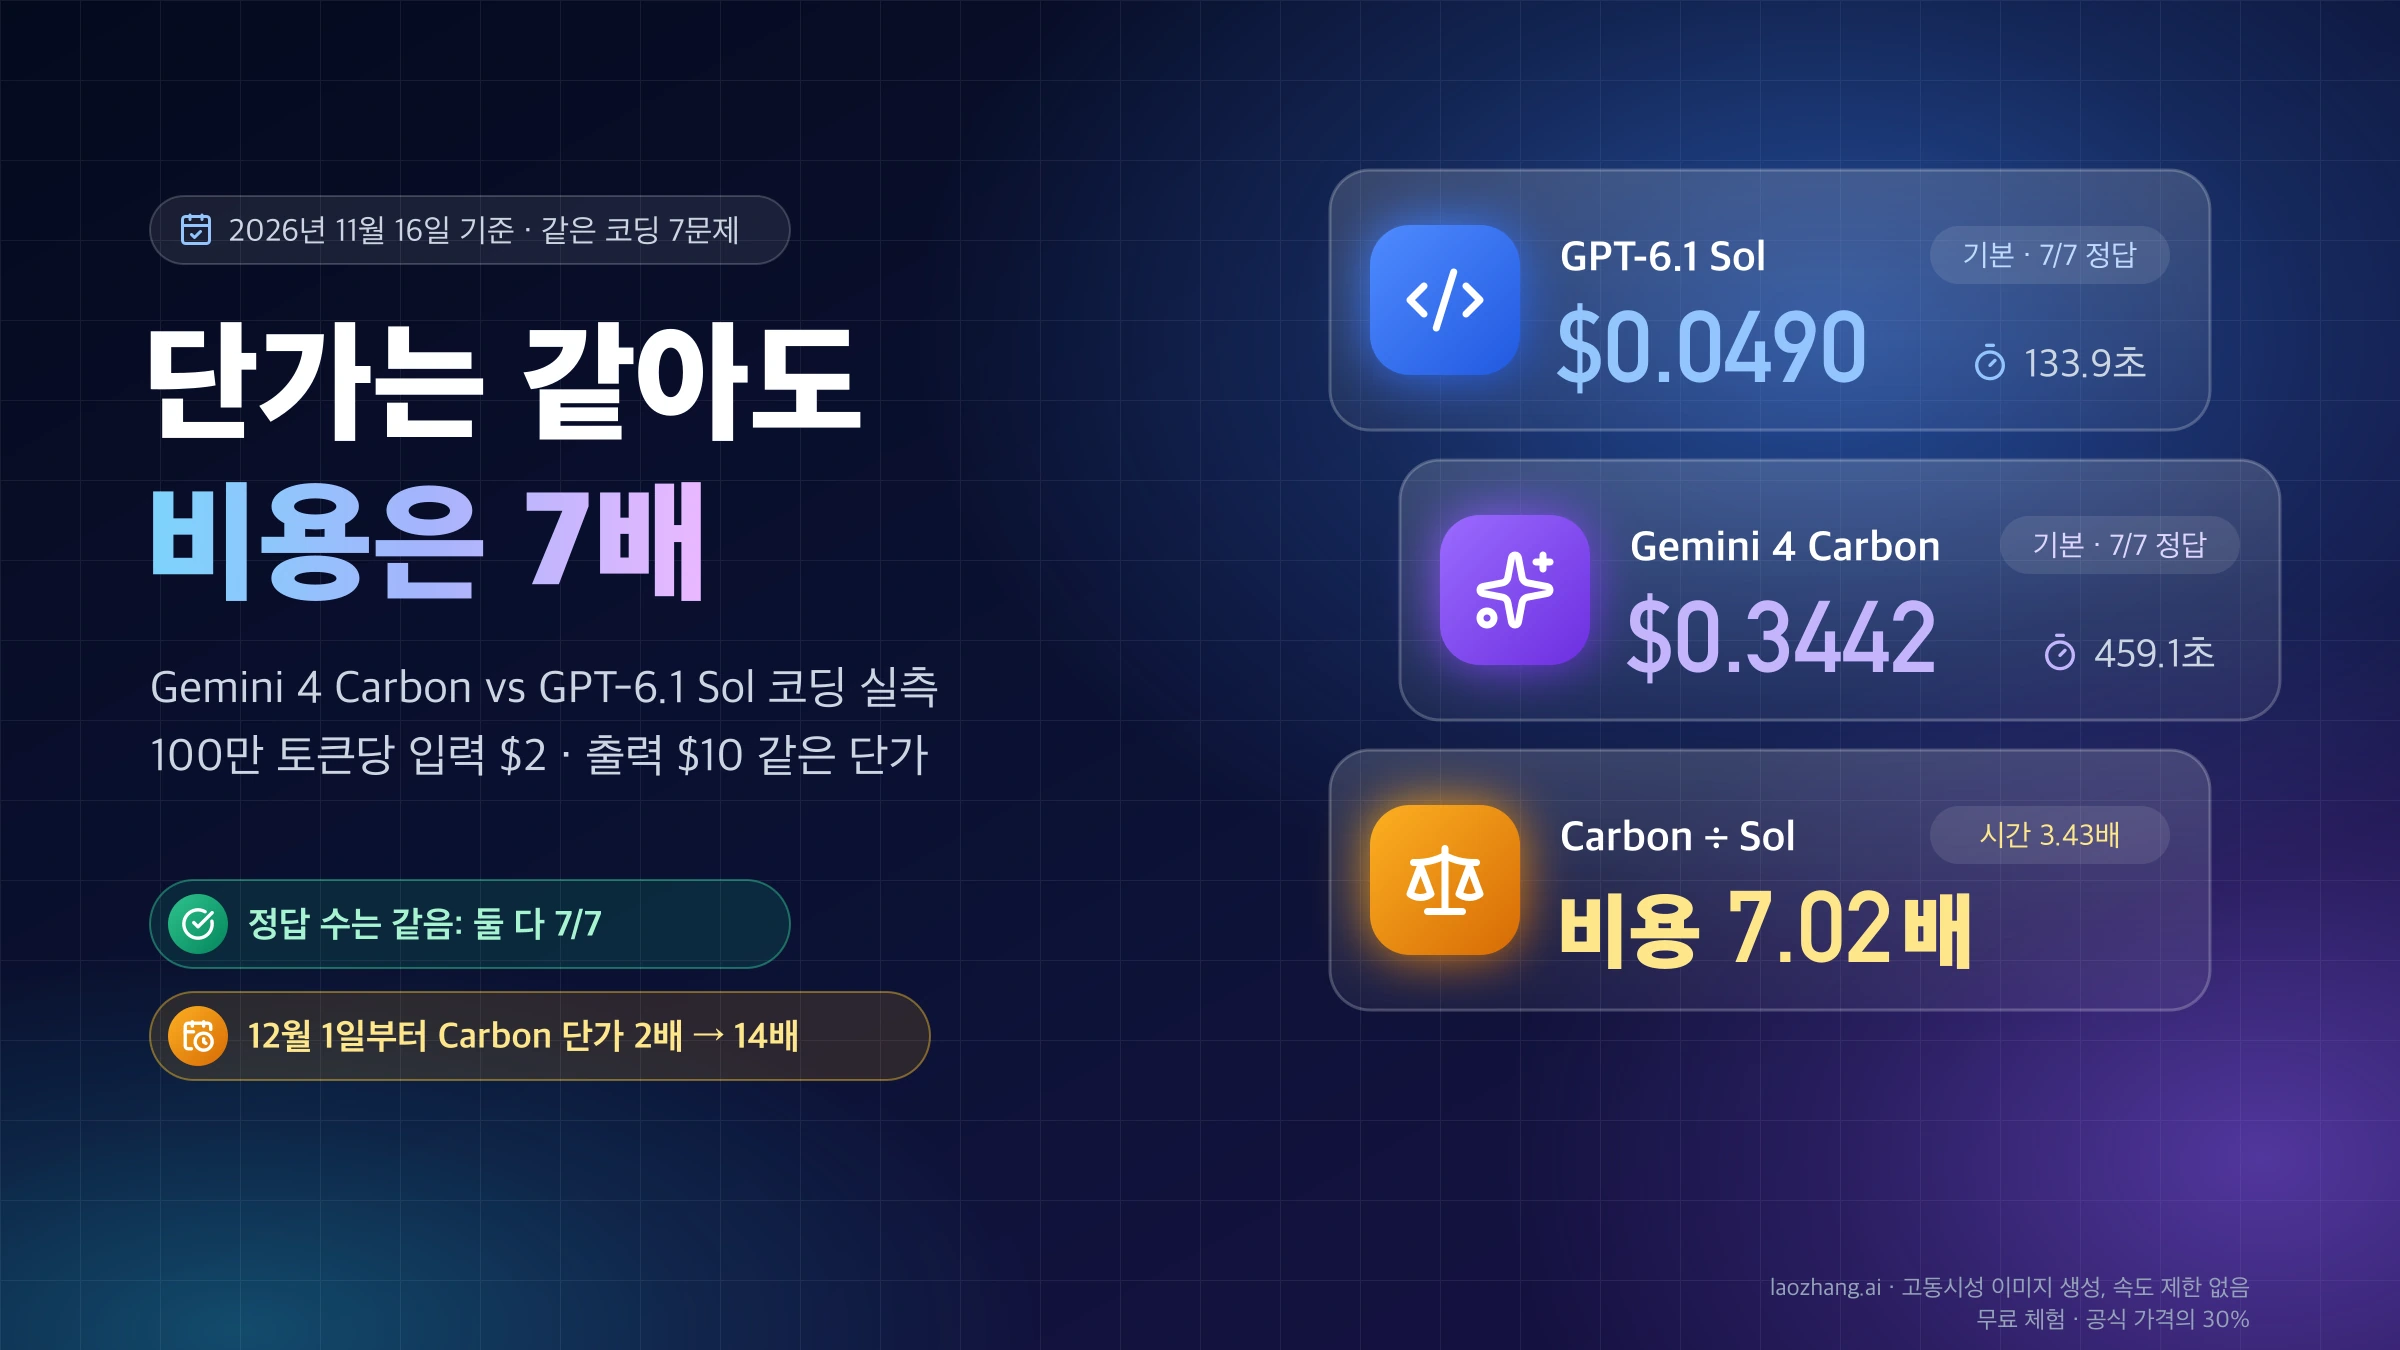
코딩 작업을 Gemini 4 Carbon으로 옮길지 고민하고 있다면, GPT-6.1 Sol(gpt-6.1-sol)을 기본 추론 강도 medium으로 먼저 쓰고 Gemini 4 Carbon(gemini-4-carbon, 제미나이 4 카본)은 터미널 명령을 많이 다루는 에이전트 작업이나 Sol의 최고 설정으로도 풀리지 않는 문제에 따로 시험해 보세요. 두 모델의 100만 토큰당 단가는 2026년 11월 30일까지 입력 $2, 출력 $10으로 같지만, 같은 문제를 푸는 데 쓰는 토큰과 시간은 크게 다릅니다.
GPT-6.1 Sol은 2026년 10월 28일, Gemini 4 Carbon은 11월 11일과 16일에 LaoZhang 게이트웨이를 거쳐 테스트가 딸린 같은 코딩 7문제를 풀었습니다. 두 모델 모두 기본 설정에서 7문제를 전부 맞혔고, Carbon은 비용이 Sol의 7.02배, 걸린 시간이 3.43배였습니다. 12월 1일부터 Carbon 단가가 두 배가 되므로 같은 7문제의 비용 차이는 14배로 벌어집니다.
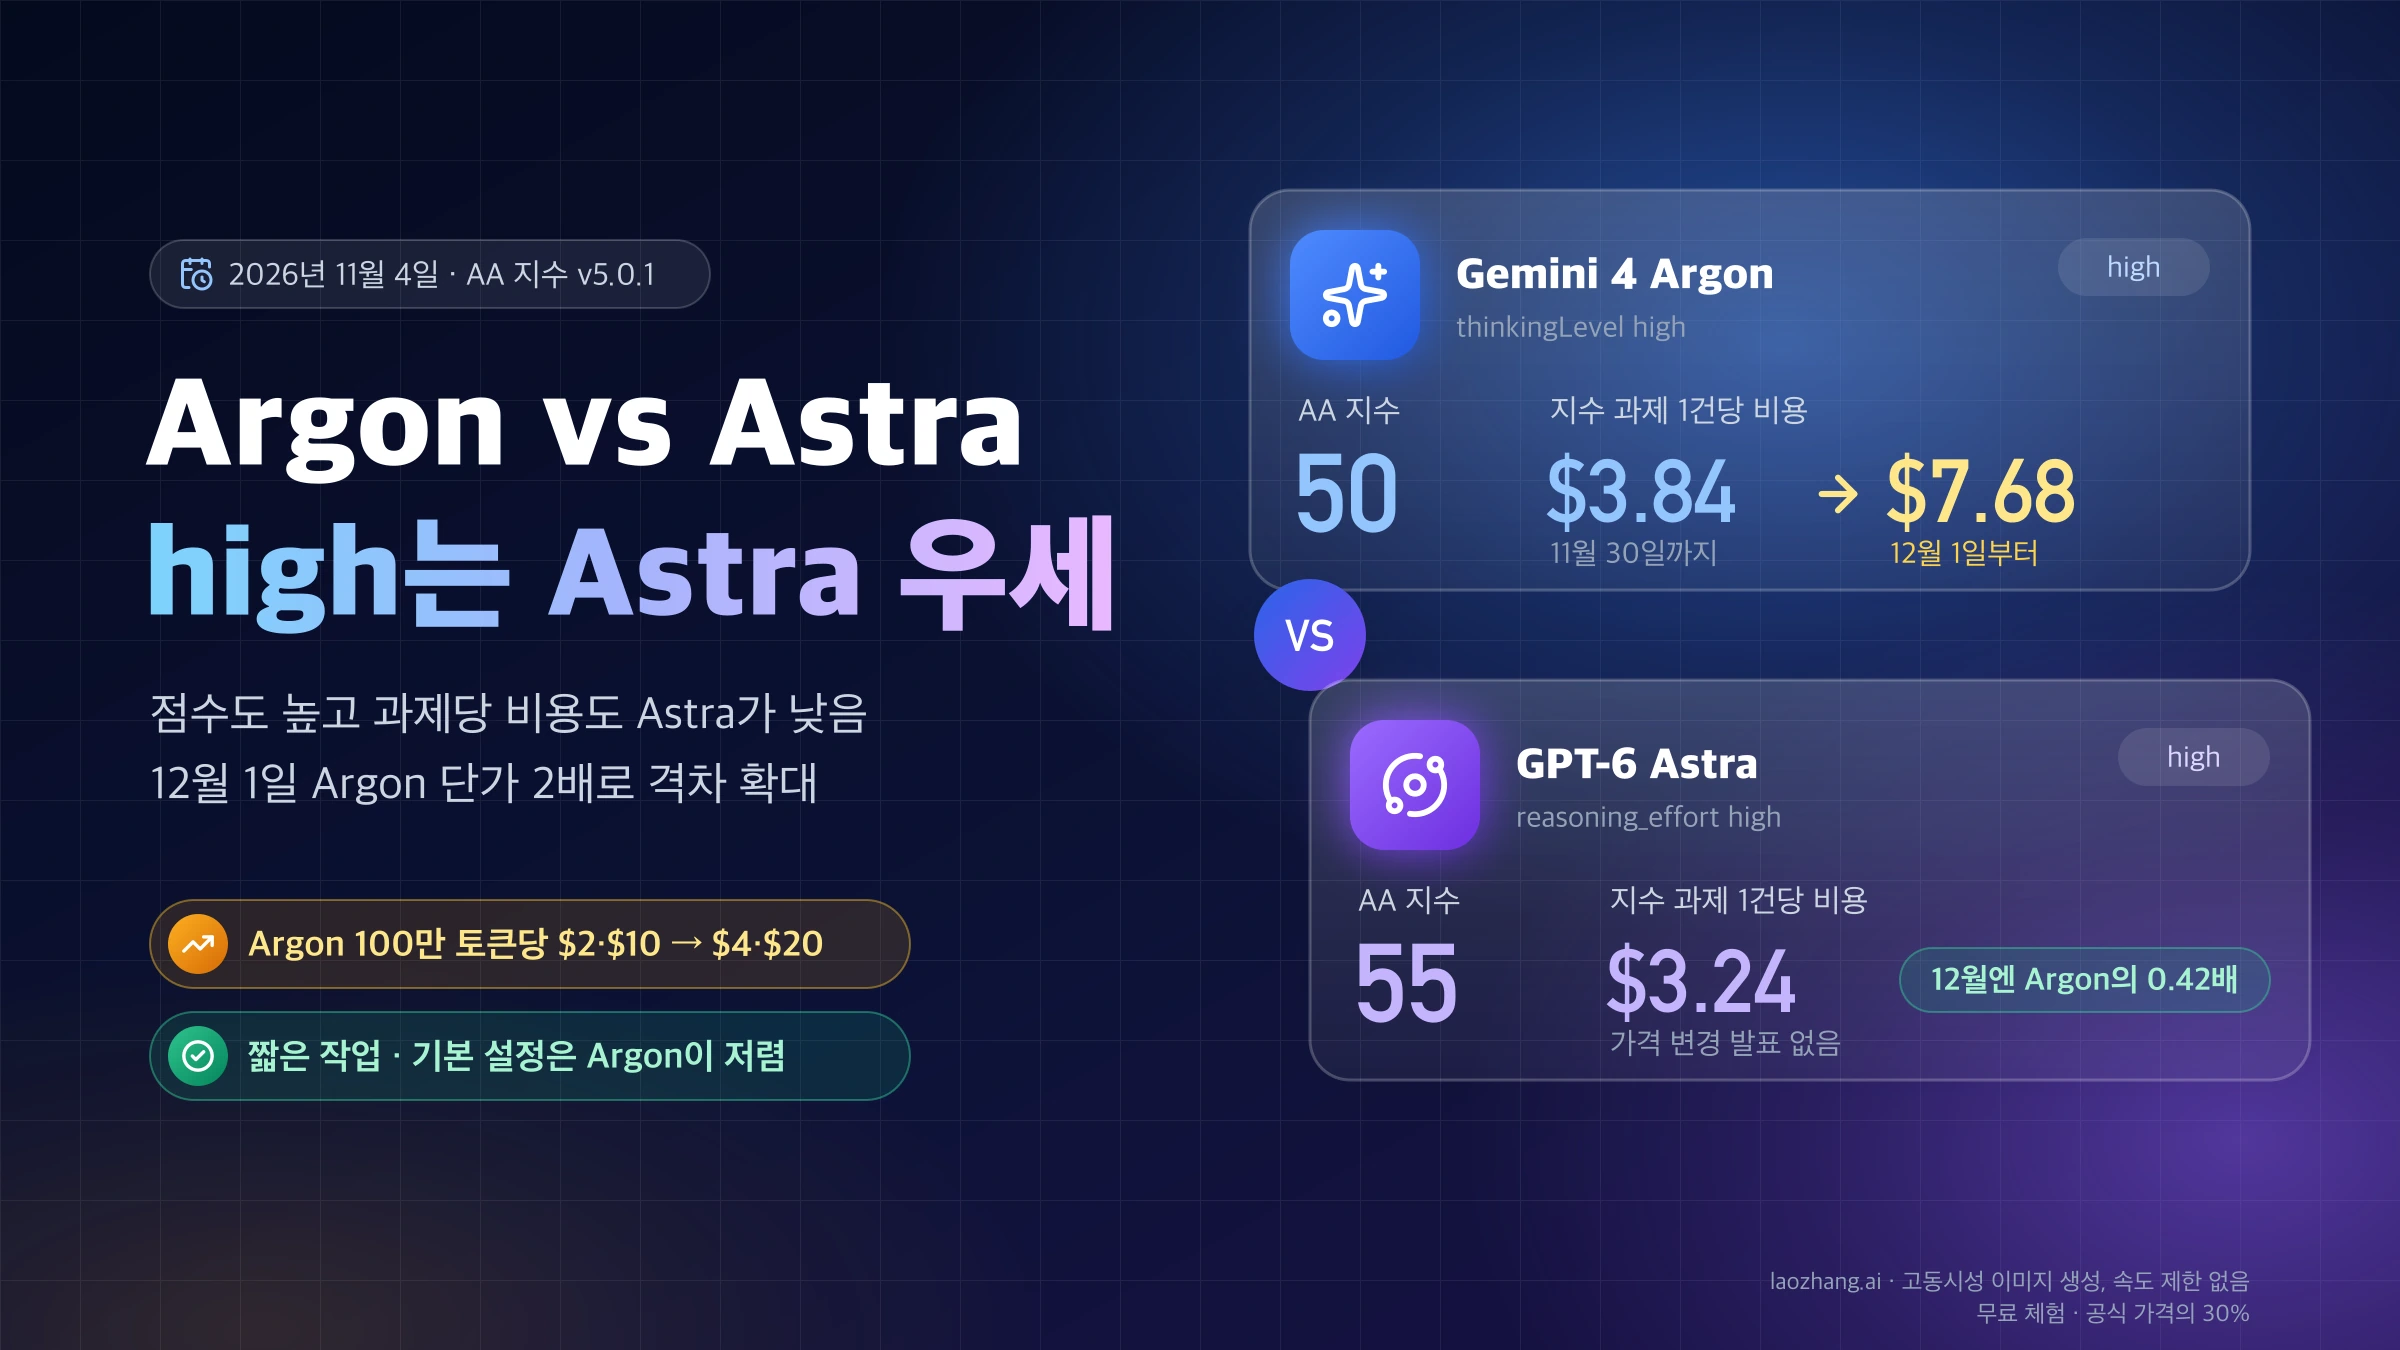
Carbon이 분명히 앞서는 곳도 있습니다. 2026년 11월 16일 기준 Artificial Analysis(AA) Intelligence Index v5.0.1에서 Carbon high는 60점으로 Sol의 최고 설정 max(55점)보다 높고, 터미널 작업을 채점하는 Terminal-Bench 4.0에서도 65.2% 대 56.1%입니다. 그 차이가 필요한 작업이라면 더 내는 돈과 기다리는 시간을 감수할 이유가 있지만, 테스트가 분명한 작은 코딩 문제에서는 두 모델 모두 정답을 냈기 때문에 Carbon에 더 낸 비용이 정답 수로 돌아오지 않았습니다.
같은 코딩 7문제 실측: 정답은 같고 비용은 Carbon이 7배
두 모델 모두 7문제를 다 맞혔으니, 이 실측에서 갈린 것은 정답이 아니라 비용과 대기 시간입니다. 문제는 겹치는 구간 합치기, 시간 길이 문자열 파싱, 단어 빈도 상위 k개, 수식 계산, CSV 한 줄 파싱, semver 버전 비교, npm 방식 semver 범위 판정이고, 모델이 짠 코드는 숨겨 둔 테스트로 채점됐습니다. 두 모델이 받은 문제 문장은 글자 하나까지 같았고, 요청은 시스템 프롬프트와 도구 없이 한 번씩만 보냈습니다. 기본 설정은 추론 강도 값을 보내지 않은 요청이며, 두 모델 모두 공식 기본값이 medium입니다. 호출 경로는 Sol이 POST /v1/chat/completions, Carbon이 제미나이 API 형식의 generateContent였고 둘 다 LaoZhang 게이트웨이를 거쳤습니다.
| 7개 코딩 문제 (칸마다 1회) | 정답 | 출력 토큰 (그중 사고) | 걸린 시간 합계 | 비용 추정 |
|---|---|---|---|---|
| GPT-6.1 Sol 기본 (2026-10-28) | 7/7 | 4,613 (1,655) | 133.9초 | $0.0490 |
| GPT-6.1 Sol high (2026-10-28) | 7/7 | 8,301 (4,995) | 237.9초 | $0.0859 |
| Gemini 4 Carbon 기본 (2026-11-11·16) | 7/7 | 34,088 (30,047) | 459.1초 | $0.3442 |
비용은 응답에 기록된 토큰 사용량에 11월 단가($2 / $10)를 곱한 추정치이고 실제 청구서가 아닙니다. 배수는 표의 값으로 계산합니다. 예를 들어 비용은 $0.3442 ÷ $0.0490 = 7.02배, 출력 토큰은 34,088 ÷ 4,613 = 7.39배입니다. Sol을 high로 올려도 Carbon 기본 설정이 비용 4.01배, 시간 1.93배로 여전히 더 듭니다.
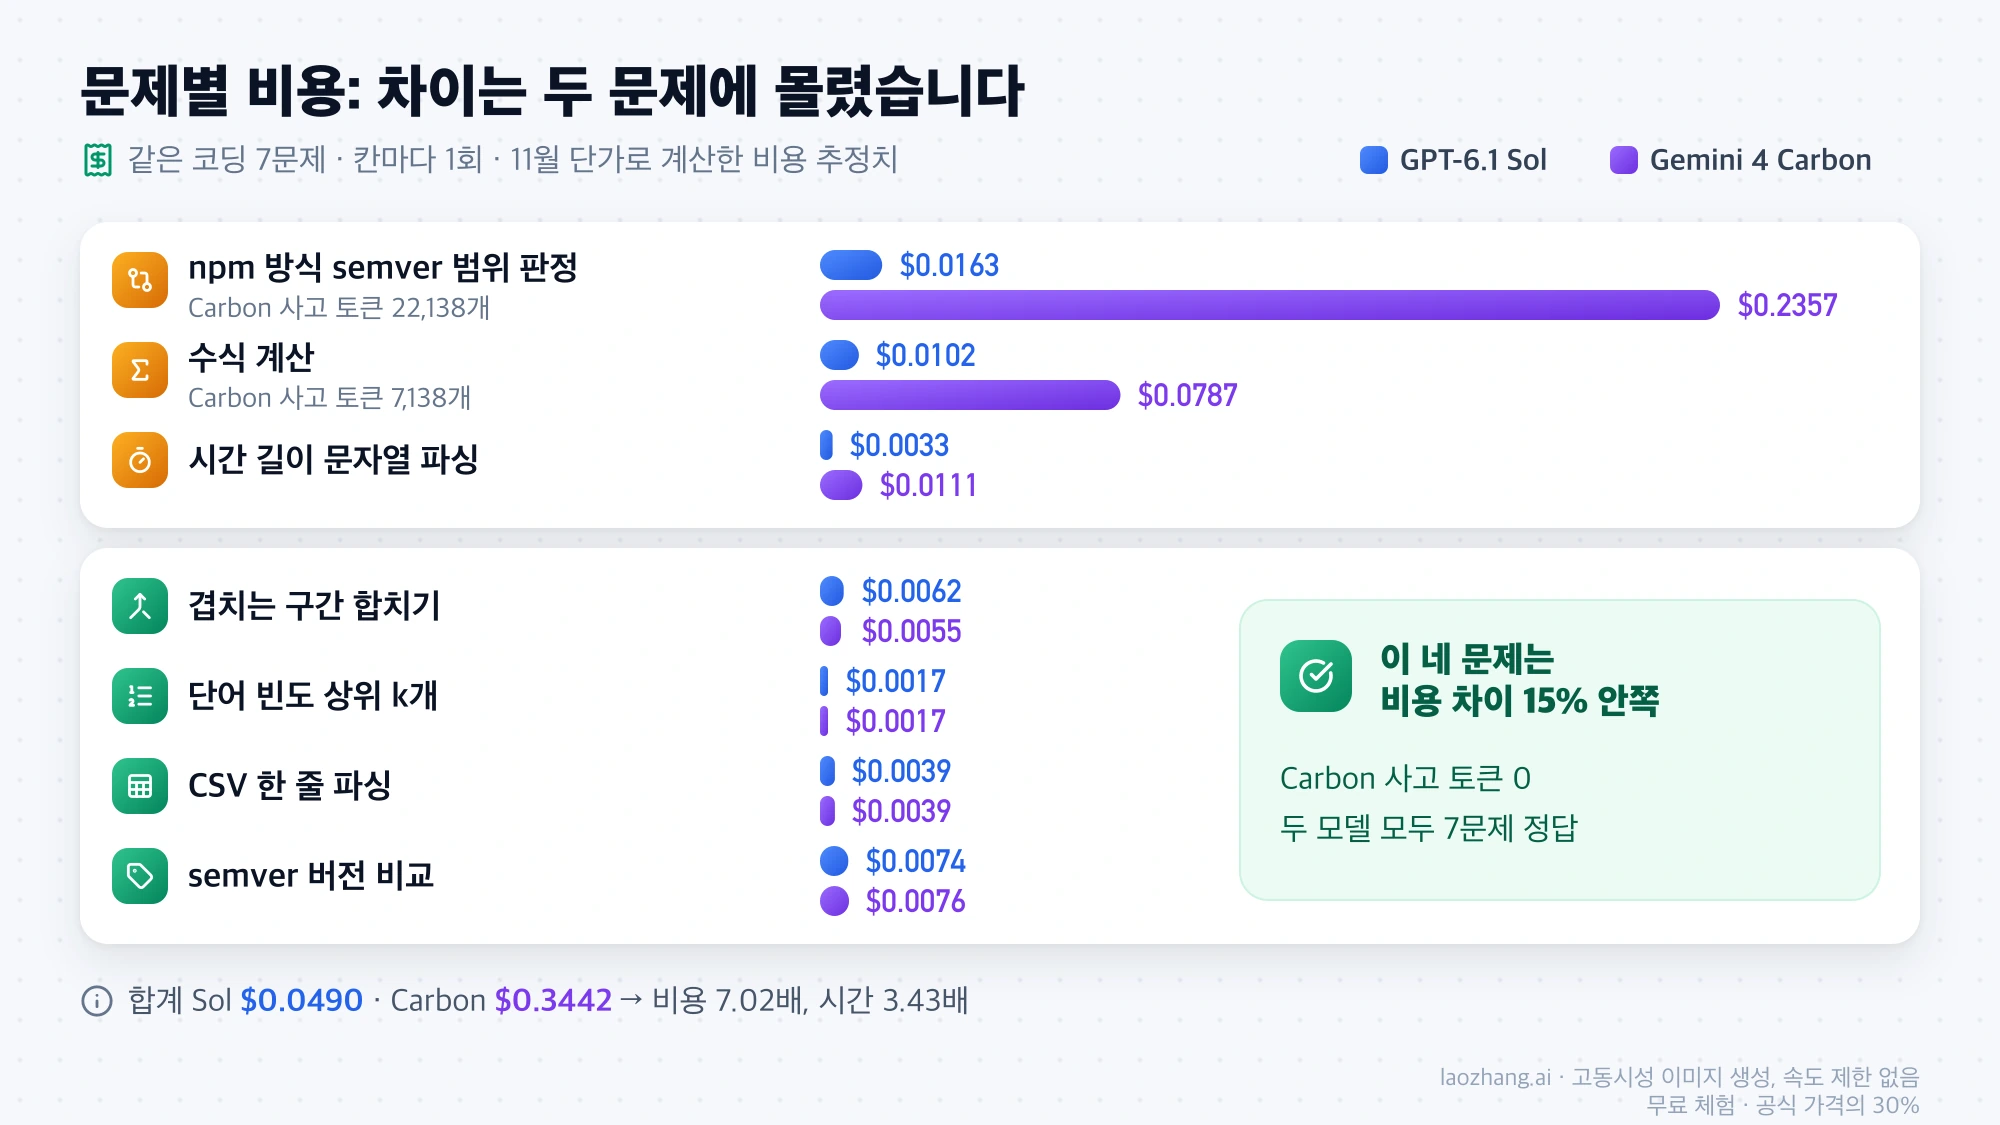
차이는 일곱 문제에 고르게 퍼져 있지 않습니다. npm 방식 semver 범위 판정에서 Carbon은 사고 토큰 22,138개를 쓰며 284.0초 동안 $0.2357을 썼고, 같은 문제에 Sol은 45.0초, $0.0163이었습니다. 수식 계산 문제도 $0.0787 대 $0.0102로 벌어졌습니다(Carbon 사고 토큰 7,138개). 반면 구간 합치기($0.0055 대 $0.0062), 단어 빈도($0.0017 대 $0.0017), CSV 파싱($0.0039 대 $0.0039), semver 비교($0.0076 대 $0.0074)는 차이가 15% 안쪽이었고, 이 네 문제에서 Carbon의 사고 토큰은 0이었습니다. 시간 길이 파싱만 $0.0111 대 $0.0033이었습니다. 그래서 Carbon의 비용은 문제 하나가 얼마나 오래 생각하게 만드느냐에 따라 크게 출렁이고, 위 7배라는 합계 배수도 문제 구성이 바뀌면 함께 바뀝니다.
Carbon을 high로 올리면 격차가 더 커집니다. 네 가지 설정을 모두 돌린 5문제(겹치는 구간 합치기, 시간 길이 파싱, 단어 빈도, 수식 계산, CSV 파싱)에서 Sol high는 $0.0387, 109.5초였고 Carbon high는 $0.6121, 614.5초였습니다. 둘 다 5문제를 맞혔지만 Carbon 쪽이 비용 15.82배, 시간 5.61배, 출력 토큰 16.40배였습니다.
코딩 문제 밖의 4문제(서술형 응용 문제, 자릿수 합 세기, 6,723단어 글 다섯 줄 요약, CPython 3.13 표준 라이브러리 질문)까지 더한 11문제에서는 Sol 기본이 11/11, Carbon 기본이 10/11이었습니다. 표준 라이브러리 질문에는 존재하지 않는 함수 두 개를 섞어 두었는데, Sol은 두 설정 모두 두 함수에 "does not exist"라고 답했습니다. Carbon 기본 설정은 11월 16일 한 번의 호출에서 functools.memoize_method에는 없다고 답했지만 statistics.winsorized_mean에는 기능 설명을 붙였고, 이때 사고 토큰은 0이었습니다. 표본이 하나뿐이라 Carbon이 API를 지어낸다고 일반화할 수는 없습니다. AA의 사실 문답 평가 AA-Omniscience v1.1에서는 오히려 Carbon high가 54, Sol max가 42로 Carbon이 높습니다. 다만 어느 모델이든 처음 보는 라이브러리 함수는 공식 문서나 테스트로 확인하는 편이 안전합니다.
이 실측의 한계도 분명합니다. Sol과 Carbon은 다른 날 측정했고, 칸마다 표본은 하나이며, 문제가 작고 명확해서 두 모델 모두 거의 다 통과합니다. 그러니 이 표는 어느 모델이 더 똑똑한지가 아니라 같은 정답에 이르기까지의 비용, 출력량, 대기 시간을 비교한 것입니다. X에서도 같은 방향의 개인 테스트가 보입니다. 사용자 notjazii는 같은 프롬프트를 두 모델의 최고 추론 단계로 돌려 Sol 30분·약 $1.4, Carbon 40분·약 $2.9를 보고했고, EnvolDev는 Carbon $8.83·2시간 39분, Sol $3.11·54분을 올렸습니다. 둘 다 테스트로 채점하지 않은 3D 생성 과제 한 번씩이라 참고 이상으로 쓰기는 어렵습니다.
긴 로그 한 건 실측: 기본 설정은 둘 다 정답, Sol이 더 빠르고 쌉니다
146KB, 1,500줄짜리 애플리케이션 로그를 통째로 넣고 숫자 7개를 묻는 문제에서도 두 모델의 기본 설정은 모두 정답을 냈고, 차이는 시간과 비용에서 났습니다. 질문은 다섯 가지 오류 코드 각각의 횟수, E503이 난 서로 다른 사용자 수, 재시도가 가장 많은 요청 ID였습니다. Carbon은 2026년 11월 11일, Sol은 11월 16일에 같은 로그와 같은 질문으로 LaoZhang 게이트웨이를 거쳐 한 번씩 풀었습니다.
| 같은 로그, 숫자 7개 | 결과 | 걸린 시간 | 출력 토큰 (그중 사고) | 비용 추정 |
|---|---|---|---|---|
| GPT-6.1 Sol 기본 | 7개 모두 정답 | 45.7초 | 2,576 (2,527) | $0.1654 |
| GPT-6.1 Sol high | 7개 모두 정답 | 87.7초 | 5,866 (5,817) | $0.1983 |
| Gemini 4 Carbon 기본 | 7개 모두 정답 | 213.9초 | 26,952 (26,867) | $0.4281 |
| Gemini 4 Carbon high | 답 없음 (출력 한도 도달, 2회) | 507.6초 (두 번째 시도) | 65,533 사고 토큰 (두 번째 시도) | $0.4863 + $0.8140 |
Carbon 기본 설정은 Sol 기본보다 비용이 2.59배($0.4281 ÷ $0.1654), 시간이 4.68배였습니다. Carbon high는 첫 시도에서 사고 토큰 32,765개 지점에서 멈췄고, 출력 상한을 65,536토큰으로 올린 두 번째 시도도 사고 토큰만 65,533개를 쓰고 답 없이 끝났습니다. 답을 못 받아도 쓴 토큰 값은 나갑니다.
같은 로그를 Carbon은 입력 79,312토큰, Sol은 55,843토큰으로 셌습니다. 두 회사의 토큰 분할 방식이 달라 같은 글도 Carbon 쪽이 1.42배 많게 잡힌 것이고, 단가가 같아도 입력 비용이 같지 않은 이유 중 하나입니다. Sol의 사용량 기록에는 입력 55,840토큰이 캐시 쓰기로 잡혀 있어 표의 금액은 캐시 쓰기 단가($2.50)로 계산한 값입니다. 일반 입력 단가 $2.00으로 계산하면 Sol 기본은 $0.1375입니다.
입력이 272K 토큰을 넘으면 계산이 달라지지만, 이 로그는 그 근처에도 가지 않았기 때문에 그 구간에 대해서는 아무것도 보여 주지 않습니다. GPT-6.1 Sol은 입력이 272K 토큰을 넘으면 그 요청 전체가 입력·캐시 2배, 출력 1.5배(입력 $4, 출력 $15)로 계산되고, Gemini 4 Carbon에는 긴 컨텍스트 할증이 없습니다. 예를 들어 입력이 30만 토큰인 요청이라면 입력 비용만 Sol은 0.3 × $4 = $1.20, Carbon은 11월 30일까지 0.3 × $2 = $0.60입니다. 12월 1일부터는 Carbon도 0.3 × $4 = $1.20이 되고, 출력 단가는 11월의 Carbon $10, Sol $15에서 Carbon $20, Sol $15로 뒤집힙니다. 큰 코드베이스를 한 번에 넣는 작업이라면 이 단가 차이에 더해 위처럼 사고 토큰 차이까지 직접 재 봐야 합니다.
AA 코딩 점수: Carbon은 터미널 작업에서 앞서고 FrontierCode는 동점
벤치마크로 보면 Carbon이 앞서는 곳은 터미널 명령을 다루는 작업이고, 코드 작성 평가 FrontierCode에서는 두 모델의 최고 설정이 같습니다. 아래는 2026년 11월 16일 기준 Artificial Analysis의 Gemini 4 Carbon과 GPT-6.1 Sol 비교 페이지(Intelligence Index v5.0.1)의 전체 설정입니다.
| 모델과 설정 | 지수 점수 | 작업당 비용 | 작업당 시간 | Terminal-Bench 4.0 | FrontierCode-AA 2.0 |
|---|---|---|---|---|---|
| Carbon high | 60 | $5.48 | 32.1분 | 65.2% | 40.6% |
| Carbon medium | 58 | $4.68 | 28.0분 | 60.6% | 39.5% |
| Carbon low | 54 | $5.22 | 25.9분 | 62.6% | 29.6% |
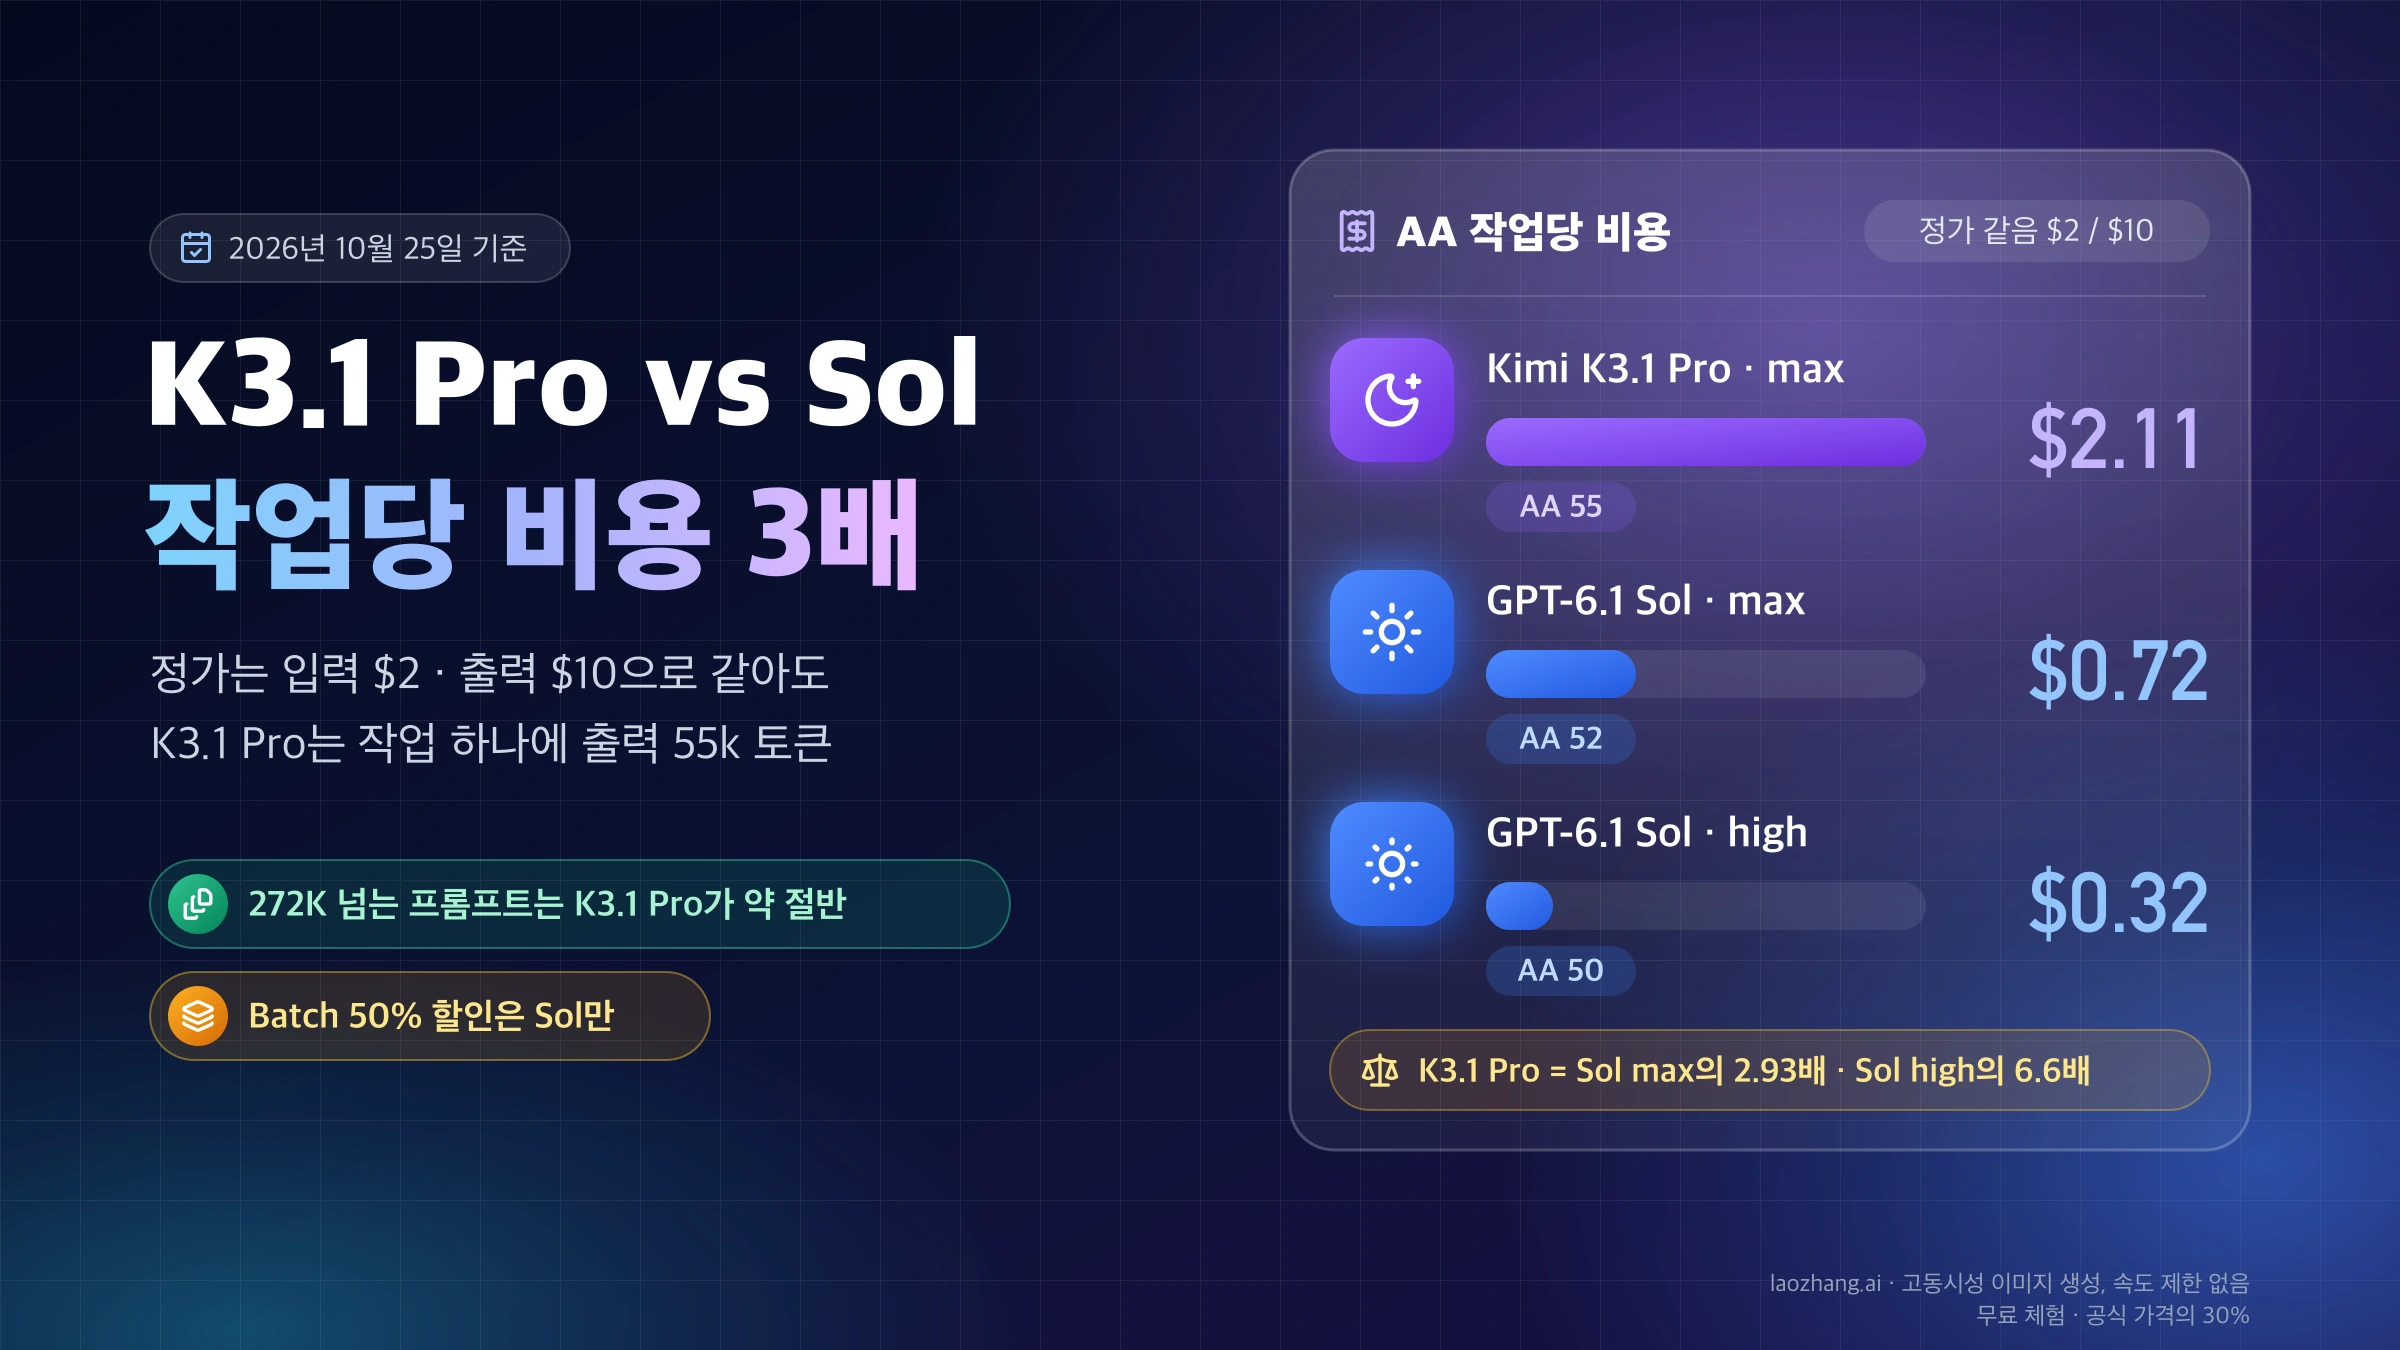
| Sol max | 55 | $1.27 | 22.7분 | 56.1% | 40.6% |
| Sol xhigh | 52 | $0.76 | 9.8분 | 54.0% | 38.5% |
| Sol high | 50 | $0.59 | 7.6분 | 51.5% | 36.7% |
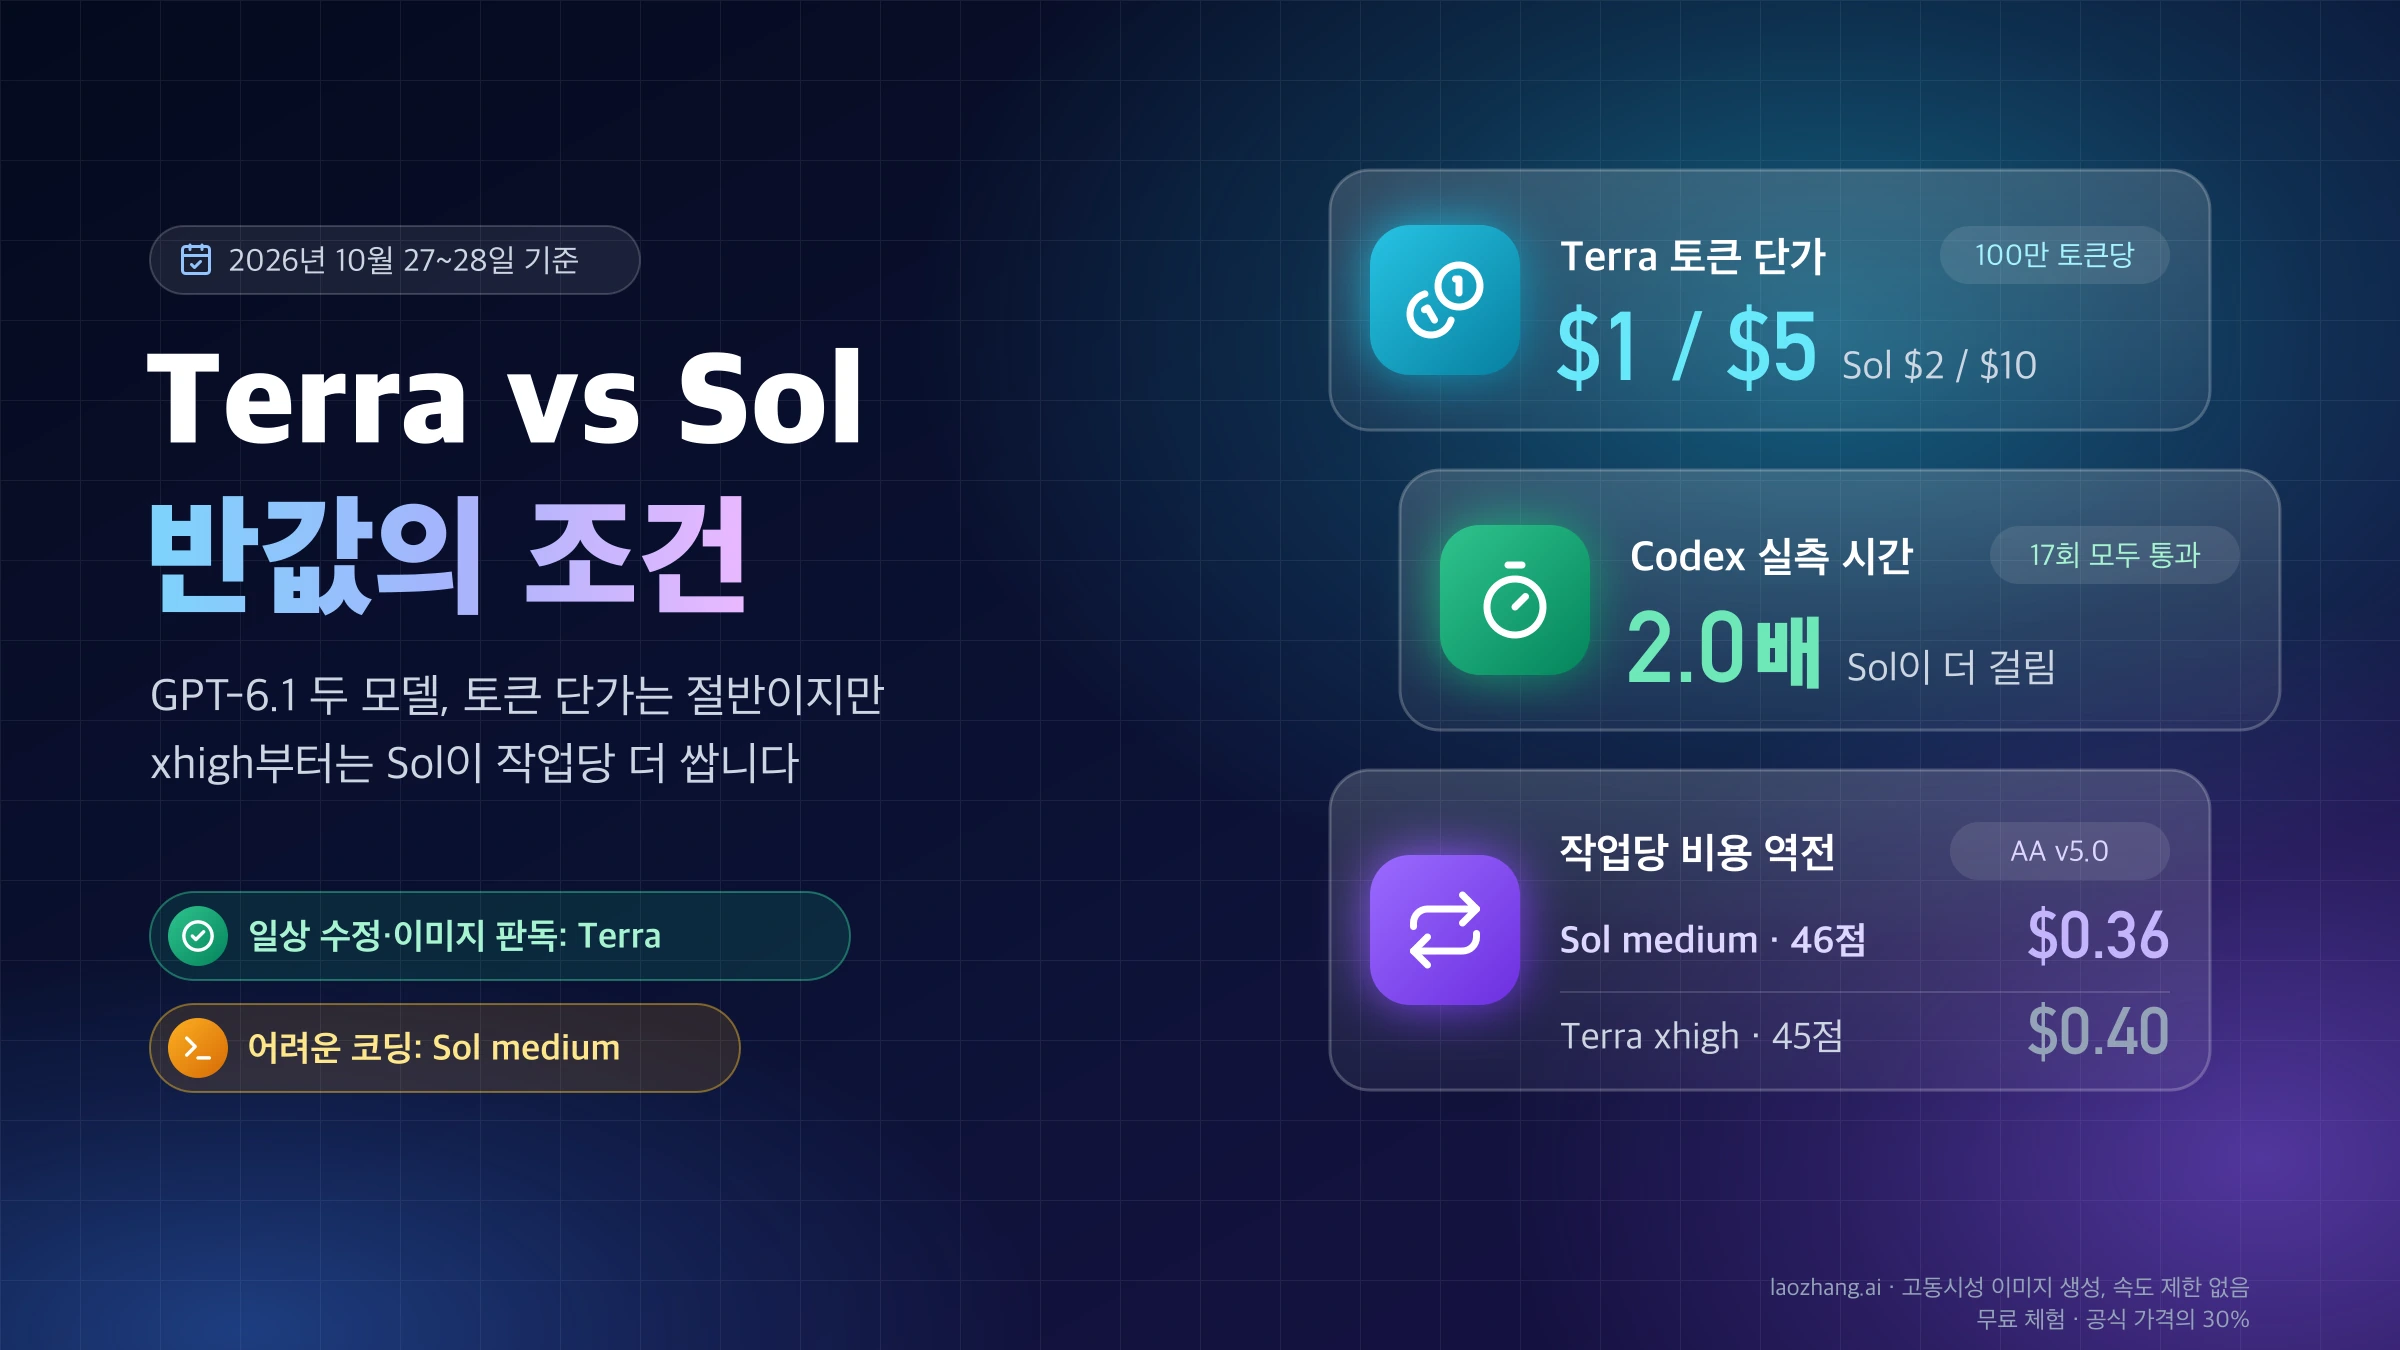
| Sol medium | 46 | $0.36 | 4.4분 | 48.0% | 33.4% |
| Sol low | 35 | $0.16 | 1.9분 | 30.8% | 20.2% |
Terminal-Bench 4.0에서는 Carbon의 세 설정이 모두 Sol max보다 높습니다. 같은 페이지의 Terminal-Bench-Science 0.1(Carbon high 64.8% 대 Sol max 58.1%)과 Engineering 점수(65 대 59)도 같은 방향입니다. 반대로 FrontierCode-AA 2.0은 Carbon high와 Sol max가 40.6%로 같고, Carbon low는 29.6%로 Sol medium(33.4%)보다 낮습니다. Carbon medium(58점)과 high(60점)는 Sol이 어떤 설정으로도 닿지 않는 점수라는 점이 Carbon을 남겨 둘 근거입니다.
점수가 가장 가까운 짝으로 비용을 맞춰 보면 Carbon low(54점)의 작업당 비용 $5.22는 Sol max(55점) $1.27의 약 4.1배($5.22 ÷ $1.27)입니다. 여기서 작업당 비용은 AA 평가 세트 한 문제에 든 평균 비용이지 독자의 요청 한 번 값이 아니며, AA는 두 모델 모두 입력 $2, 출력 $10으로 계산했습니다. AA가 표시하는 Carbon 작업당 비용은 11월 11일 기준 $7.76 / $6.59 / $7.19였다가 다시 계산돼 위 값으로 내려왔으므로, 이전 수치를 인용한 자료와 비교할 때는 날짜를 확인하세요. 12월 1일 단가가 두 배가 되면 캐시 비율이 같다는 전제에서 Carbon high·medium·low는 대략 $10.96 / $9.36 / $10.44가 될 것으로 추정됩니다.
Codex와 Antigravity에서 쓸 때: 에이전트 지수 55.5 대 52.2
코딩 에이전트 안에서 비교하면 Carbon 쪽 점수가 조금 높지만, 이 수치는 모델만 바꾼 비교가 아니라 "모델 + 그 회사의 에이전트" 두 제품의 비교입니다. 2026년 11월 16일 기준 AA Coding Agent Index v2.1에서 Antigravity CLI + Gemini 4 Carbon(high)은 55.5점, 작업당 $7.13, 33.6분, 평균 186단계였고, Codex + GPT-6.1 Sol(max)은 52.2점, $1.51, 21.9분, 평균 43단계였습니다. 점수는 3.3점 차이지만 작업당 비용은 Carbon 쪽이 약 4.7배($7.13 ÷ $1.51)이고, 단계 수가 네 배를 넘습니다.
이 지수는 FrontierCode-AA 2.0(132문제), Terminal-Bench 4.1(66문제), SWE-Atlas-QnA-AA(124문제)를 문제마다 세 번씩 돌려 같은 비중으로 합칩니다. 세부 통과 수를 보면 Terminal-Bench는 Carbon이 198번 중 129번, Sol이 107번 통과해 Carbon이 앞서고, FrontierCode는 396번 중 Sol 183번, Carbon 166번으로 Sol이 앞섭니다. 셸 명령과 환경 조작이 많은 작업이라면 Carbon을, 코드 작성 자체가 중심인 작업이라면 Sol을 먼저 보는 근거가 됩니다. 다만 Carbon을 Codex에 넣거나 Sol을 Antigravity에 넣은 결과는 없고, Sol은 max 한 설정만 측정됐으며, $7.13은 11월 단가 기준입니다.
쓸 수 있는 경로도 다릅니다. 제미나이 앱과 Antigravity에서 Gemini 4 Carbon을 쓰려면 Google AI Ultra 구독이 필요하고 사용 한도는 공개되지 않았습니다. 요금제별 제공 범위는 Gemini 4 Carbon 출시일: 11월 10일 정식 출시, 유료 API·Ultra부터에 정리돼 있습니다. GPT-6.1 Sol은 Codex와 ChatGPT Work에서 기본 컨텍스트가 500K이고, 구독 사용량 안에서는 긴 컨텍스트 할증이 붙지 않습니다.
추론 강도: Sol은 medium에서 올리고, Carbon은 medium을 유지
두 모델은 추론 단계의 눈금이 다르기 때문에 같은 이름의 단계를 같은 수준으로 보면 안 됩니다. Gemini 4 Carbon의 thinking level은 low / medium / high 세 단계(기본 medium)이고, GPT-6.1 Sol의 reasoning effort는 low / medium / high / xhigh / max 다섯 단계(기본 medium)입니다. Carbon high와 Sol high는 이름만 같을 뿐 대응하는 단계가 아닙니다.
Sol은 단계를 올리고 내리는 효과가 큽니다. AA에서 low부터 max까지 작업당 비용은 $0.16에서 $1.27로 약 8배, 시간은 1.9분에서 22.7분으로 늘어납니다. 위 실측에서는 기본 medium으로도 7문제와 긴 로그를 모두 맞혔고, high는 7문제 기준 비용 1.75배($0.0859 ÷ $0.0490), 시간 1.78배를 더 썼습니다. 그러니 medium으로 시작해 테스트를 통과하지 못하는 작업만 high나 xhigh로 올리는 편이 낫습니다. AA 점수로는 xhigh(52점, $0.76, 9.8분)에서 max(55점, $1.27, 22.7분)로 가는 구간이 시간이 가장 많이 늘어나는 구간입니다. Sol이 느려서 고민이라면 GPT-6.1 Sol 느림 원인과 해결: effort·Fast 설정과 10월 26일 실측에서 설정별 대기 시간을 볼 수 있습니다.
Carbon은 단계를 낮춰도 돈이 거의 줄지 않습니다. AA 작업당 비용이 high $5.48, medium $4.68, low $5.22로 low가 오히려 medium보다 비싸고, low는 FrontierCode가 29.6%로 떨어집니다. high는 위 5문제에서 기본 설정보다 비용 6.07배($0.6121 ÷ $0.1009), 시간 3.62배를 쓰고도 정답 수는 같았고, 긴 로그에서는 두 번 모두 답을 내지 못했습니다. 그래서 Carbon은 기본 medium을 유지하고, high는 medium이 실패한 문제에만 출력 상한을 넉넉히 잡아 쓰는 편이 안전합니다. medium에서도 사고 토큰이 문제마다 0개에서 22,138개까지 달라졌으므로, 비용 상한은 평균이 아니라 가장 오래 생각한 문제를 기준으로 잡아야 합니다.
Carbon 가격과 사용 경로: 12월 1일부터 입력·출력 단가가 두 배
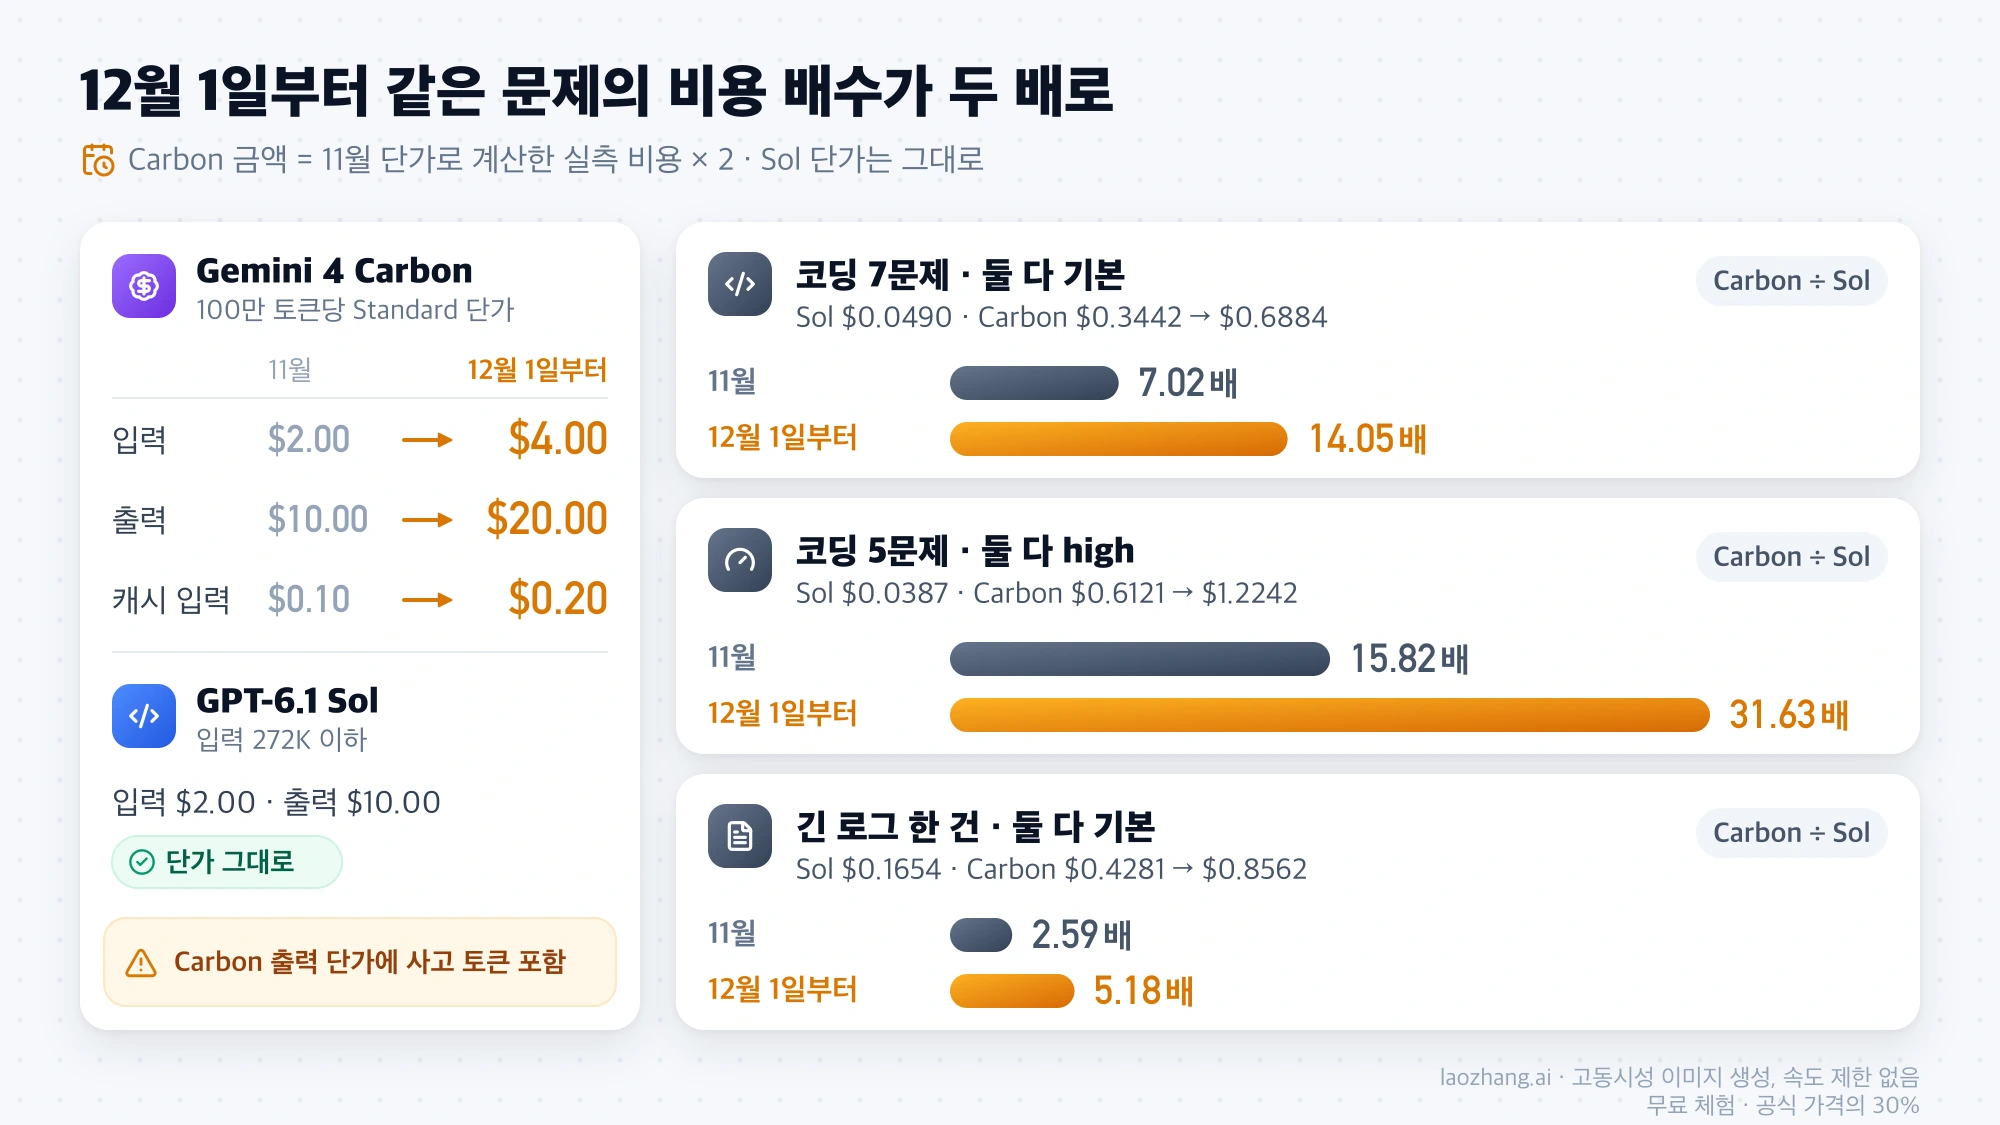
Gemini 4 Carbon은 2026년 11월 10일부터 제미나이 API 유료 등급에서 정식으로 쓸 수 있고, 가격도 공개돼 있습니다. 무료 등급은 없으며, 11월 30일까지는 GPT-6.1 Sol과 같은 단가였다가 12월 1일부터 입력·출력·캐시 단가가 모두 두 배가 됩니다. 아래는 100만 토큰당 Standard 단가입니다(제미나이 API 가격 페이지의 Gemini 4 Carbon 항목, OpenAI의 GPT-6.1 Sol 모델 페이지, 2026년 11월 16일 기준).
| 모델과 조건 | 입력 | 출력 | 캐시 입력 |
|---|---|---|---|
| Gemini 4 Carbon, 11월 30일까지 | $2.00 | $10.00 | $0.10 |
| Gemini 4 Carbon, 12월 1일부터 | $4.00 | $20.00 | $0.20 |
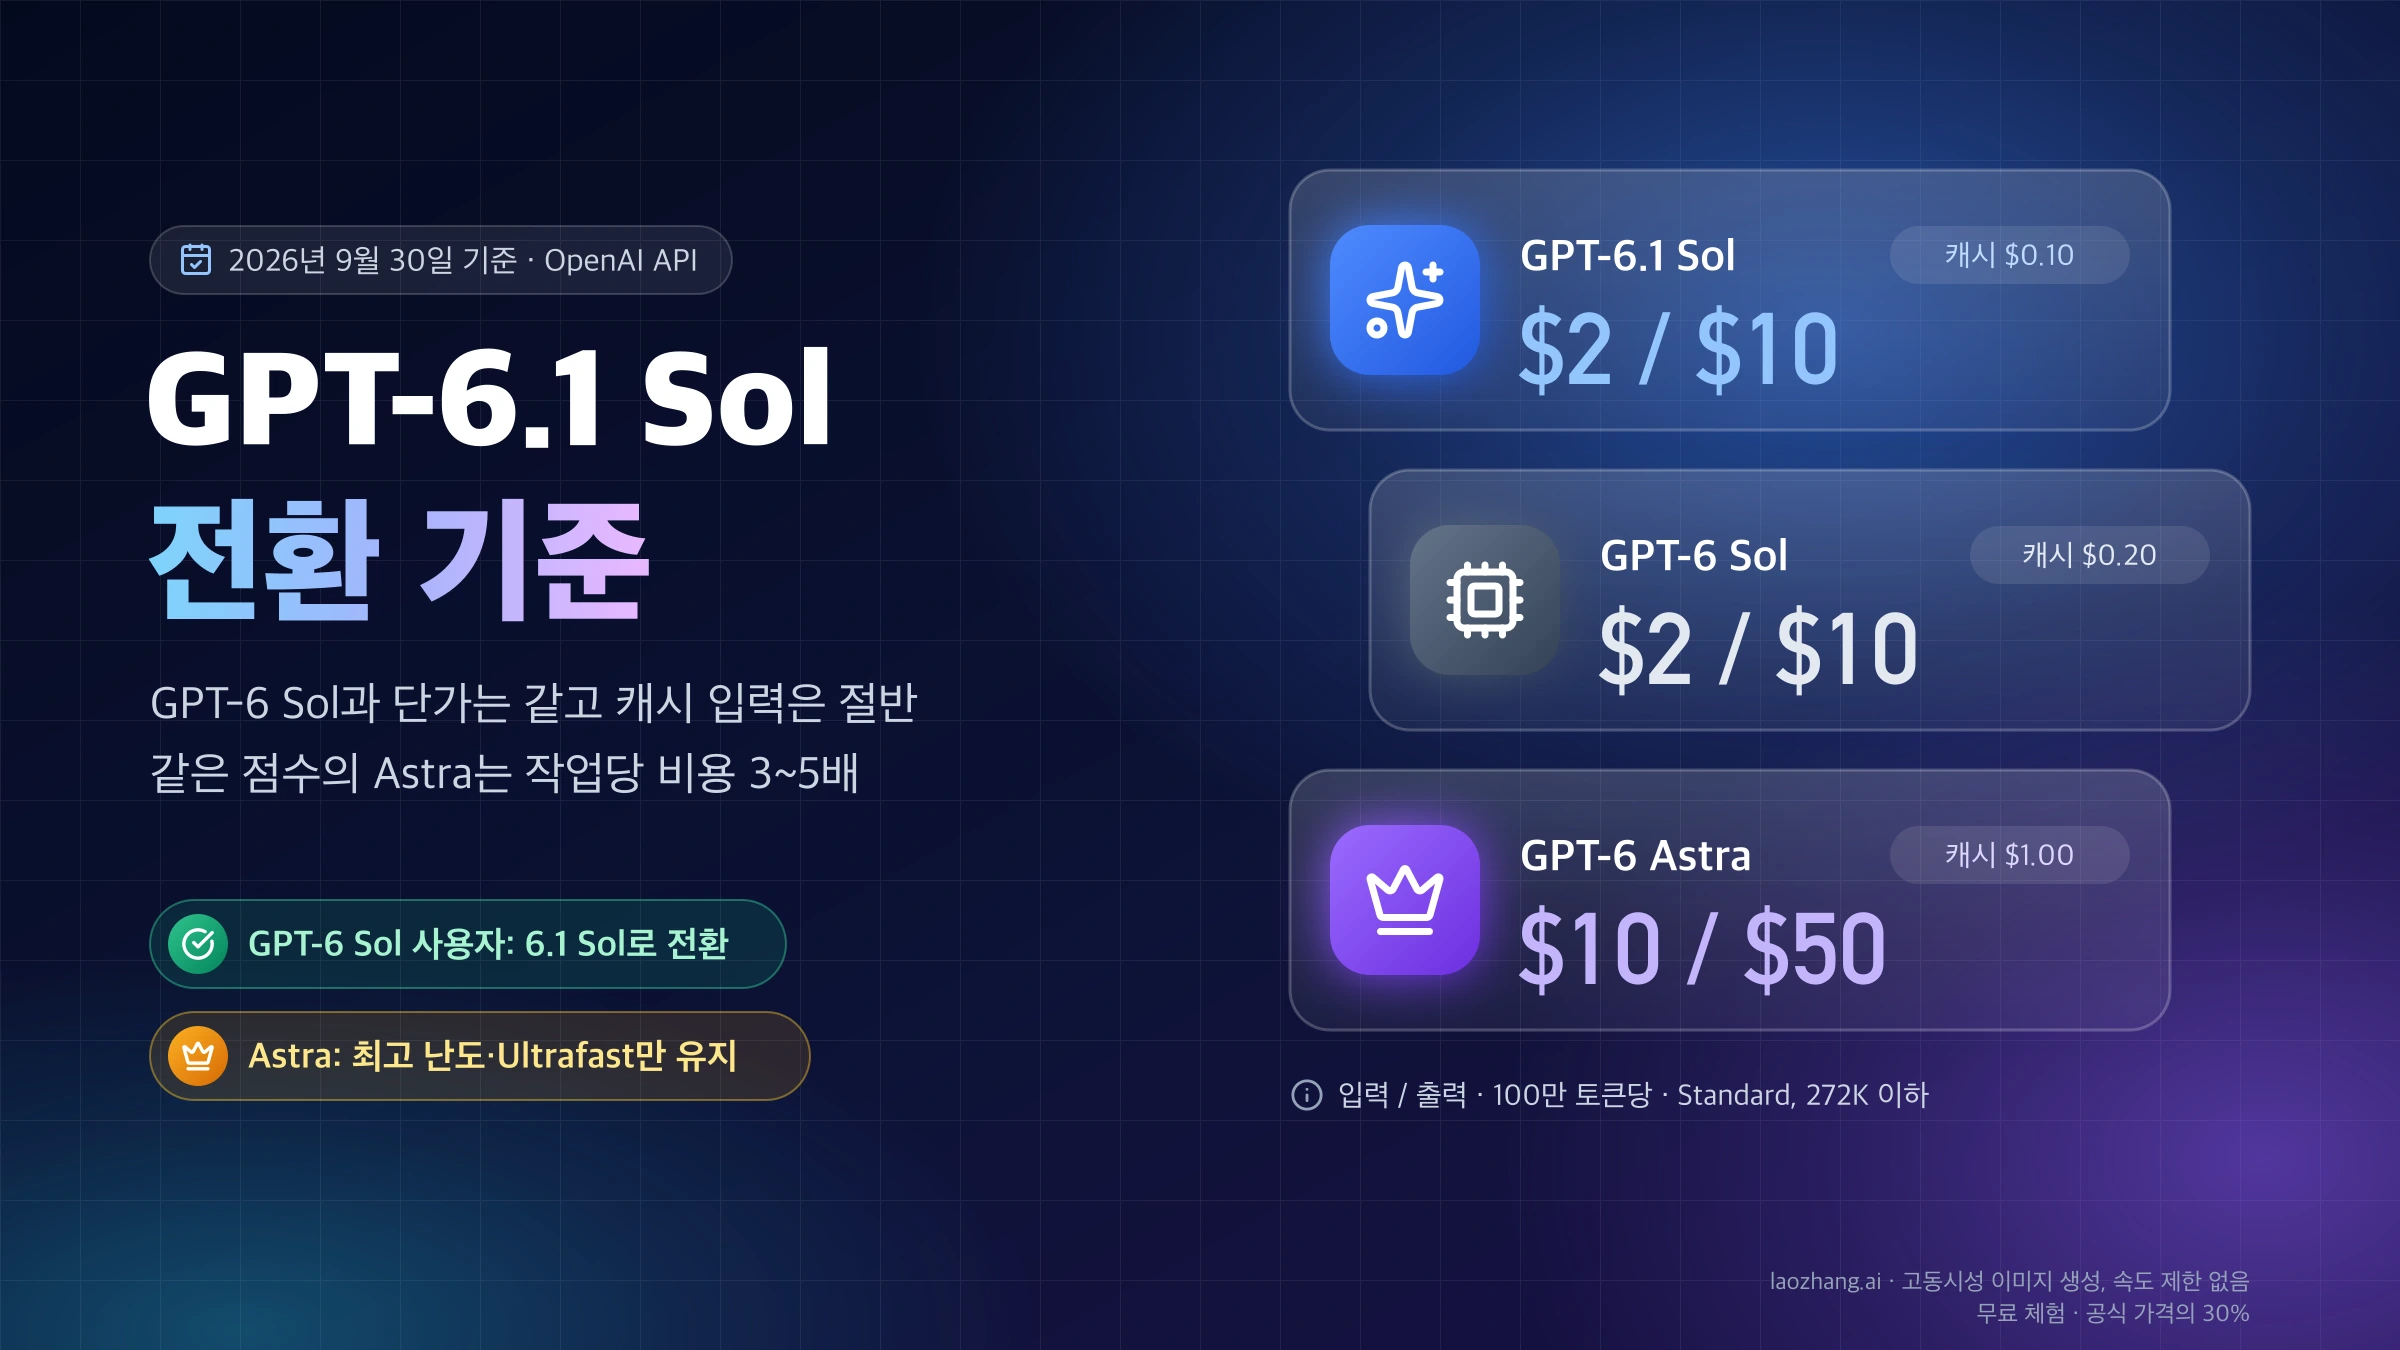
| GPT-6.1 Sol, 입력 272K 이하 | $2.00 | $10.00 | $0.10 |
| GPT-6.1 Sol, 입력 272K 초과 (요청 전체) | $4.00 | $15.00 | $0.20 |
Carbon의 출력 단가에는 사고 토큰이 포함되므로, 위 실측처럼 사고 토큰을 많이 쓰는 문제일수록 12월 인상의 영향이 커집니다. 두 모델 모두 Batch는 절반 가격이고, Sol은 Flex도 절반, Fast는 두 배입니다. 사양에서는 Carbon의 컨텍스트가 1,048,576토큰(입출력 합계), 동기 요청의 최대 출력이 65,536토큰이고, Sol은 컨텍스트 1,050,000토큰, 최대 출력 128,000토큰입니다.
같은 문제의 비용을 12월 1일 단가로 다시 계산하면 Carbon 쪽 금액만 두 배가 됩니다. Sol 단가는 그대로이므로 배수도 두 배가 됩니다.
| 같은 문제 묶음 | GPT-6.1 Sol | Gemini 4 Carbon (12월 1일부터) | 배수 |
|---|---|---|---|
| 코딩 7문제, 둘 다 기본 | $0.0490 | $0.6884 | 14.05배 |
| 전체 11문제, 둘 다 기본 | $0.0897 | $0.8842 | 9.86배 |
| 코딩 5문제, 둘 다 high | $0.0387 | $1.2242 | 31.63배 |
| 긴 로그, 둘 다 기본 | $0.1654 | $0.8562 | 5.18배 |
Carbon 금액은 11월 단가로 계산한 실측 비용에 2를 곱한 값입니다(예: $0.3442 × 2 = $0.6884). 문제가 작아 절대 금액은 몇십 센트 수준이지만, 같은 패턴의 요청을 하루 수천 번 보내는 서비스라면 이 배수가 그대로 청구액 차이가 됩니다.
공식 경로는 Gemini 4 Carbon이 제미나이 API 유료 등급, GPT-6.1 Sol이 OpenAI API입니다. Sol에서 도구 호출을 쓰려면 Chat Completions가 아니라 Responses API가 필요합니다. 두 모델을 자기 작업으로 나란히 돌려 보고 싶다면 LaoZhang API 키 하나로 gemini-4-carbon과 gpt-6.1-sol을 모두 호출할 수 있고, 위 실측 호출도 모두 이 방식이었습니다. 어느 경로든 자기 코드베이스의 대표 작업 몇 개를 두 모델 기본 설정으로 돌려 정답 여부, 걸린 시간, 응답의 토큰 사용량을 함께 기록하면 판단이 빨라집니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
GPT-6.1 Sol과 Gemini 4 Carbon 사이에서 더 묻는 질문
GPT-6.1 Sol 비용이 부담되면 Terra나 Argon으로 내려도 되나요?
Sol보다 싼 같은 OpenAI 모델을 찾는다면 GPT-6.1 Terra vs GPT-6.1 Sol 비교: 가격 절반, Codex 실측 2배 빠름에서 단가가 절반인 Terra로 내려도 되는 작업을 확인할 수 있습니다. Google 쪽 대안인 Gemini 4 Argon과 Claude Opus 5.5까지 같은 과제로 비교한 결과는 Gemini 4 Argon·Opus 5.5·GPT-6.1 Sol 비교: 같은 과제 실측과 12월 비용에 있습니다.
다른 모델에서 GPT-6.1 Sol로 옮길 때 모델 ID만 바꾸면 되나요?
도구를 쓰지 않는 단순 요청은 모델 ID를 gpt-6.1-sol로 바꾸면 되지만, 함수나 도구 호출을 쓰고 있다면 2026년 11월 16일 기준 OpenAI 모델 페이지대로 Responses API로 옮겨야 합니다. 요청을 어떻게 고치는지는 GPT-6.1 Sol 가격과 사용법: 모델 ID만 바꾸면 안 되는 이유에서 단계별로 볼 수 있습니다.
Claude Sonnet 5.5와 GPT-6.1 Sol은 어떻게 다른가요?
두 모델도 100만 토큰당 단가가 같아서 Carbon과 비슷한 질문이 생깁니다. AA 점수를 맞췄을 때의 작업당 비용 차이는 Claude Sonnet 5.5 vs GPT-6.1 Sol 비교: 같은 단가, 같은 점수면 7~8배에서 비교할 수 있습니다.
참고 자료4
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 16일.
참고 자료4
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 16일.
- 1.Artificial Analysis의 Gemini 4 Carbon과 GPT-6.1 Sol 비교 페이지artificialanalysis.ai/models/releases/comparisons/gemini-4-carbon-vs-gpt-6-1-sol
- 2.AA Coding Agent Index v2.1artificialanalysis.ai/agents/coding-agents
- 3.제미나이 API 가격 페이지의 Gemini 4 Carbon 항목aistudio.google.com/docs/pricing
- 4.OpenAI의 GPT-6.1 Sol 모델 페이지developers.openai.com/api/docs/models/gpt-6.1-sol