로컬 LLM 코딩용 16GB GPU 선택: 속도보다 작업 통과율
RTX 5070 Ti는 새 16GB GPU 중 가장 균형 잡힌 후보지만, 실제로 살 카드는 목표 컨텍스트에서 테스트를 통과한 작업을 충분히 빠르게 만드는 모델입니다.
목차
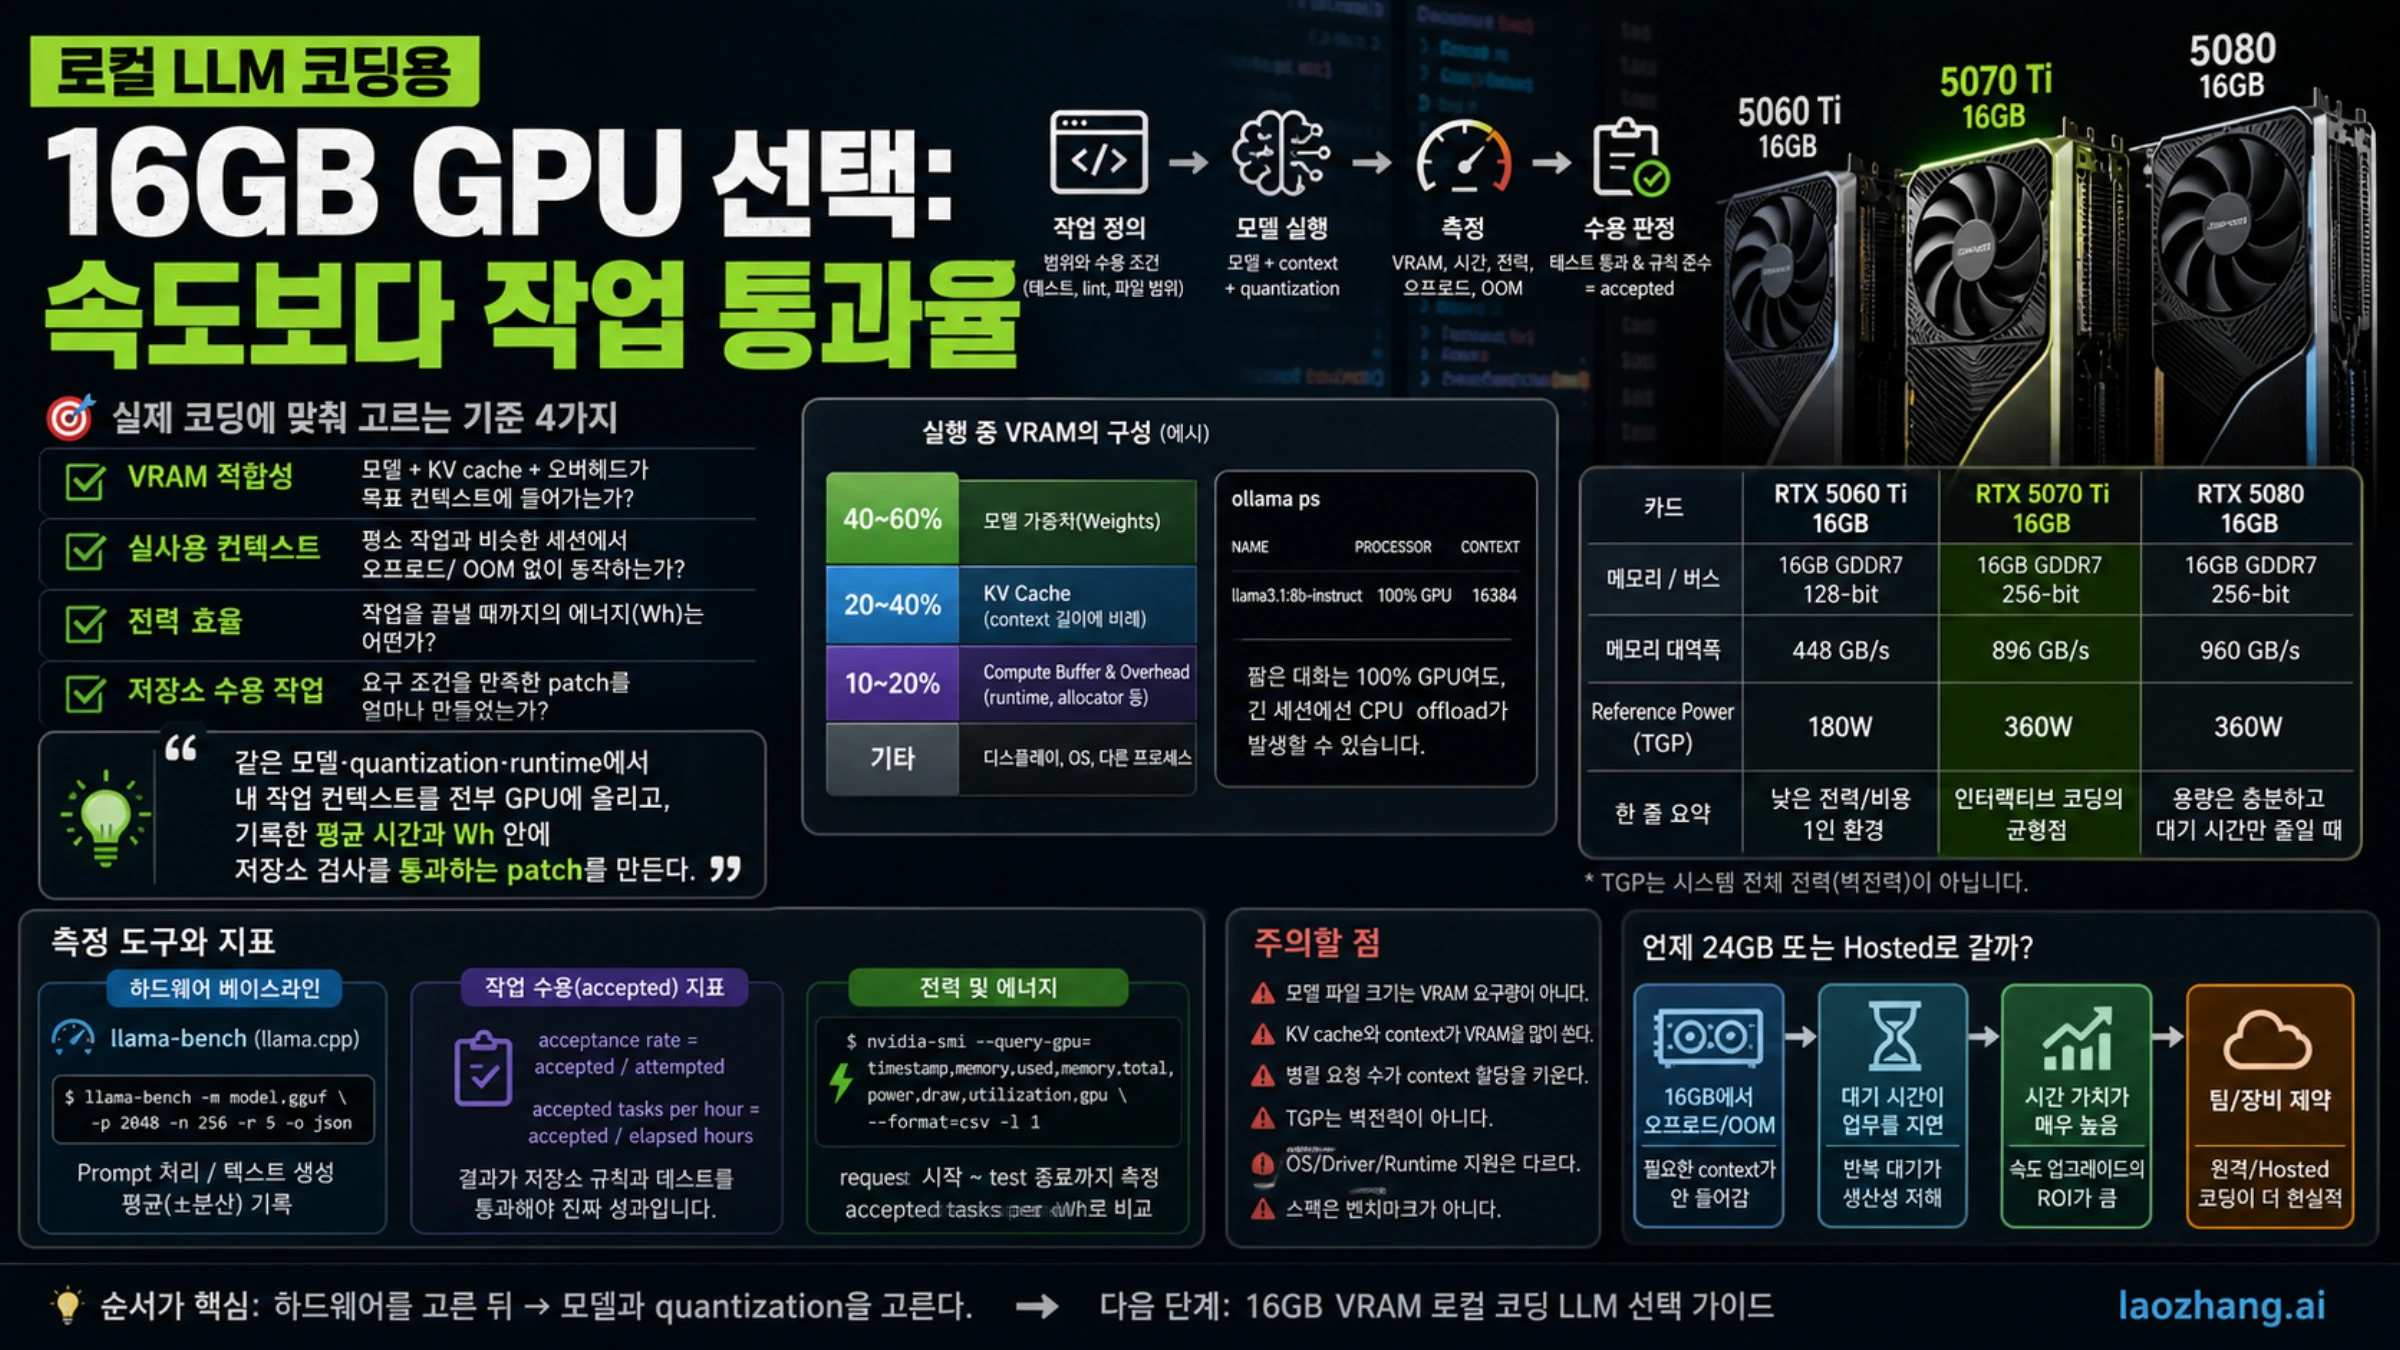
새 16GB GPU만 놓고 보면 GeForce RTX 5070 Ti가 로컬 LLM 코딩의 균형점이다. NVIDIA가 공개한 사양은 16GB GDDR7, 256-bit, 896 GB/s, TGP 300W다. RTX 5080의 960 GB/s에 근접하면서도 전력 등급은 360W보다 낮다.
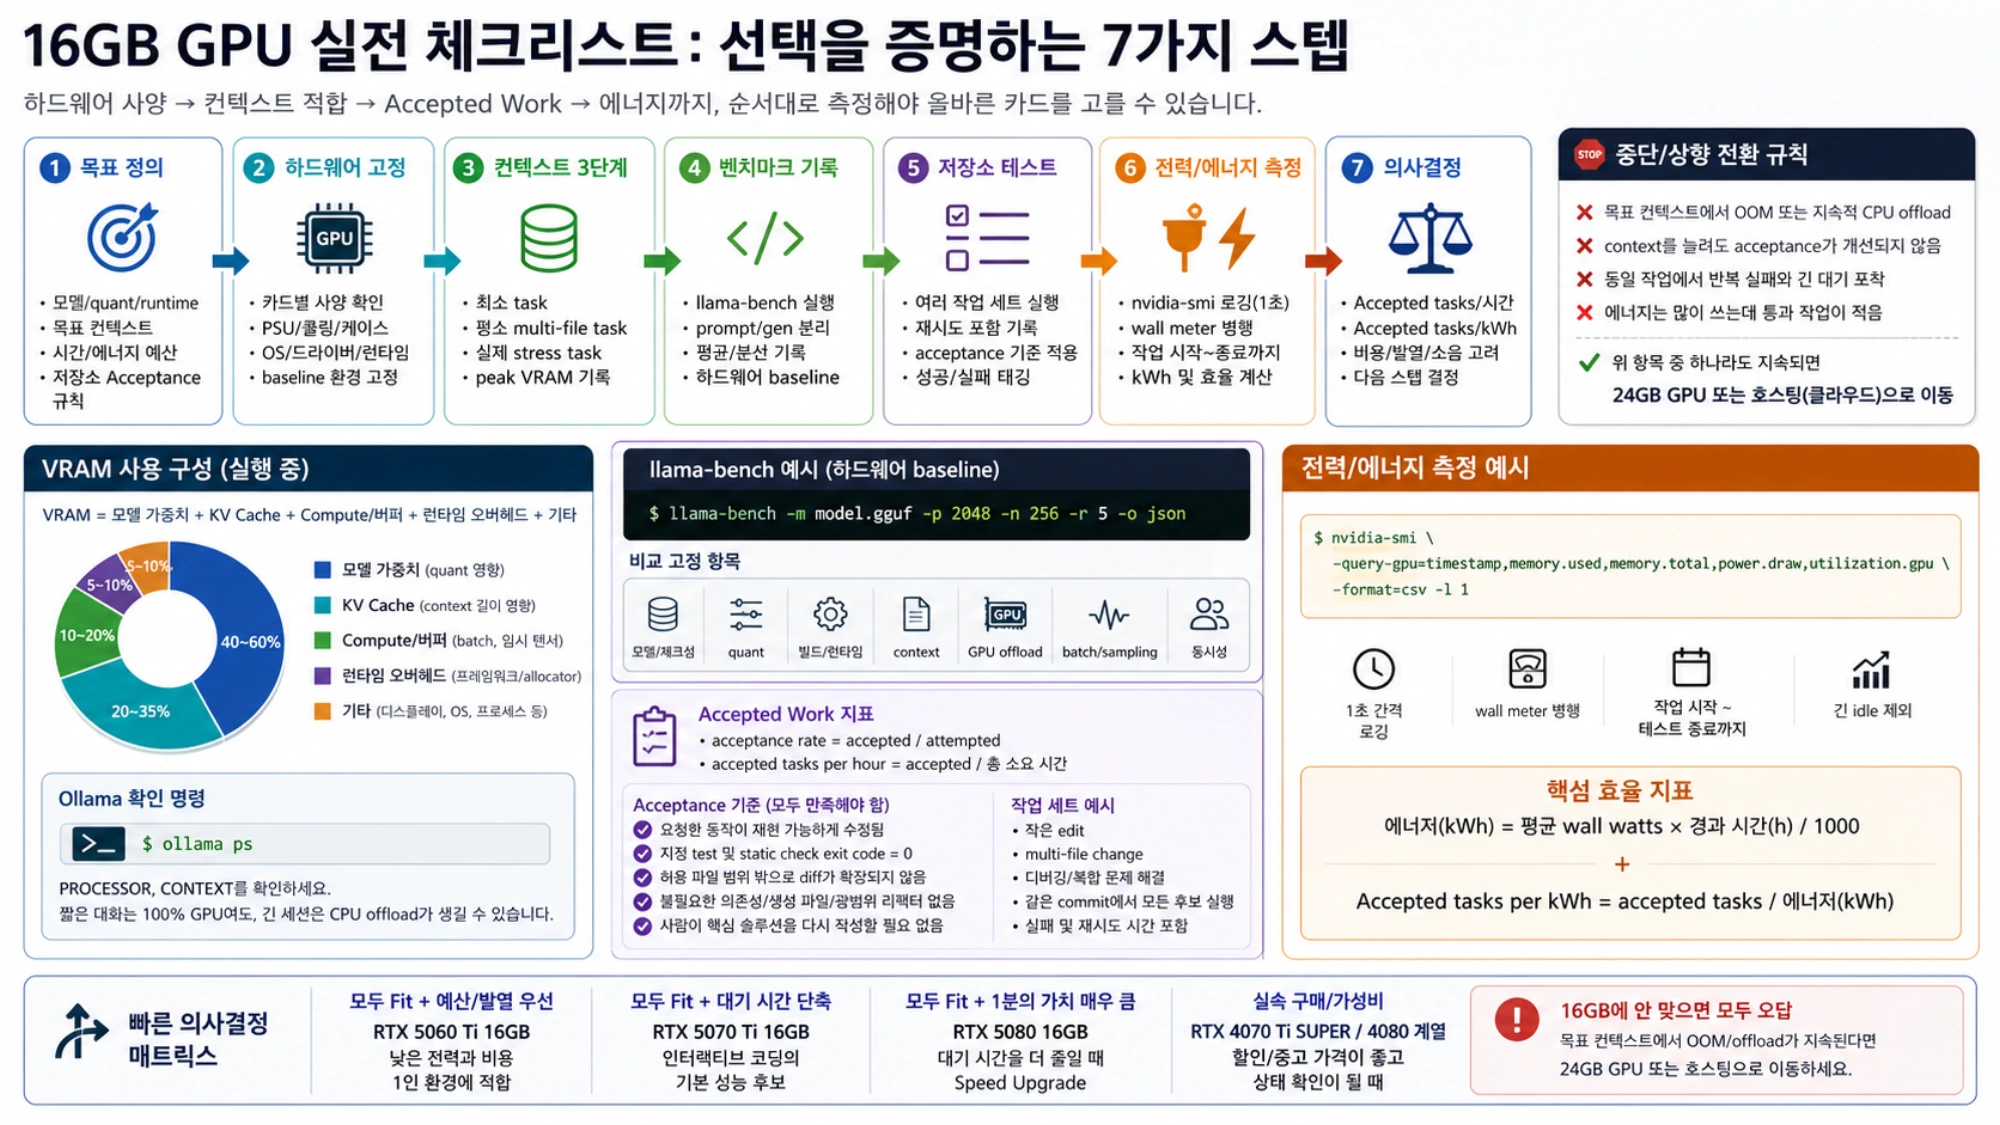
실제로 시험할 후보는 예산과 작업에 따라 달라진다. 예산과 발열이 먼저라면 RTX 5060 Ti 16GB, 같은 16GB에서 대기를 줄이고 싶다면 RTX 5070 Ti, 필요한 모델과 컨텍스트가 모두 들어가며 추가 시간 절약의 가치가 크다면 RTX 5080을 비교해 볼 만하다. 모델과 필요한 컨텍스트가 16GB에 안 들어가면 이 셋 모두 오답이며 24GB 또는 호스팅 코딩 서비스를 봐야 한다.
16GB 후보를 한 문장으로 거르는 법
구매 전에 다음 문장을 실제 숫자로 완성한다.
이 GPU는 같은 모델·양자화·실행 환경에서 내 작업 컨텍스트를 전부 GPU에 올리고, 저장소 검사를 통과하는 코드를 만드는 데 평균적으로 일정 시간과 전력량(Wh)을 사용한다.
빈칸을 채울 수 없다면 게임 벤치마크나 AI TOPS만으로는 로컬 코딩용 구매를 결정할 수 없다.
NVIDIA의 현재 GeForce 사양표에서 확인되는 경계는 다음과 같다.
| 카드 | 공개된 메모리 사양 | 기준 소비 전력 | 의미 |
|---|---|---|---|
| RTX 5060 Ti 16GB | 128-bit, 448 GB/s | 180W TGP | 낮은 전력과 비용이 중요한 1인 환경 |
| RTX 5070 Ti 16GB | 256-bit, 896 GB/s | 300W TGP | 인터랙티브 코딩의 기본 성능 후보 |
| RTX 5080 16GB | 256-bit, 960 GB/s | 360W TGP | 용량은 충분하고 대기 시간 개선을 시험할 때 |
| RTX 4070 Ti SUPER | 256-bit, 16GB GDDR6X | 285W TGP | 할인/중고 가격이 좋고 상태 확인이 될 때 |
| RTX 4080 계열 | 256-bit, 16GB GDDR6X | 320W TGP | 새 세대 인접 카드보다 충분히 저렴할 때 |
5060 Ti에서 5070 Ti로 가면 공개 대역폭이 크게 늘지만 VRAM은 그대로다. 5070 Ti에서 5080으로 가도 16GB다. 따라서 추가 비용을 판단할 때는 더 큰 모델을 실행할 수 있는지가 아니라 입력 처리와 생성 시간이 실제로 줄어드는지를 측정해야 한다.
모델 파일 크기는 VRAM 요구량이 아니다
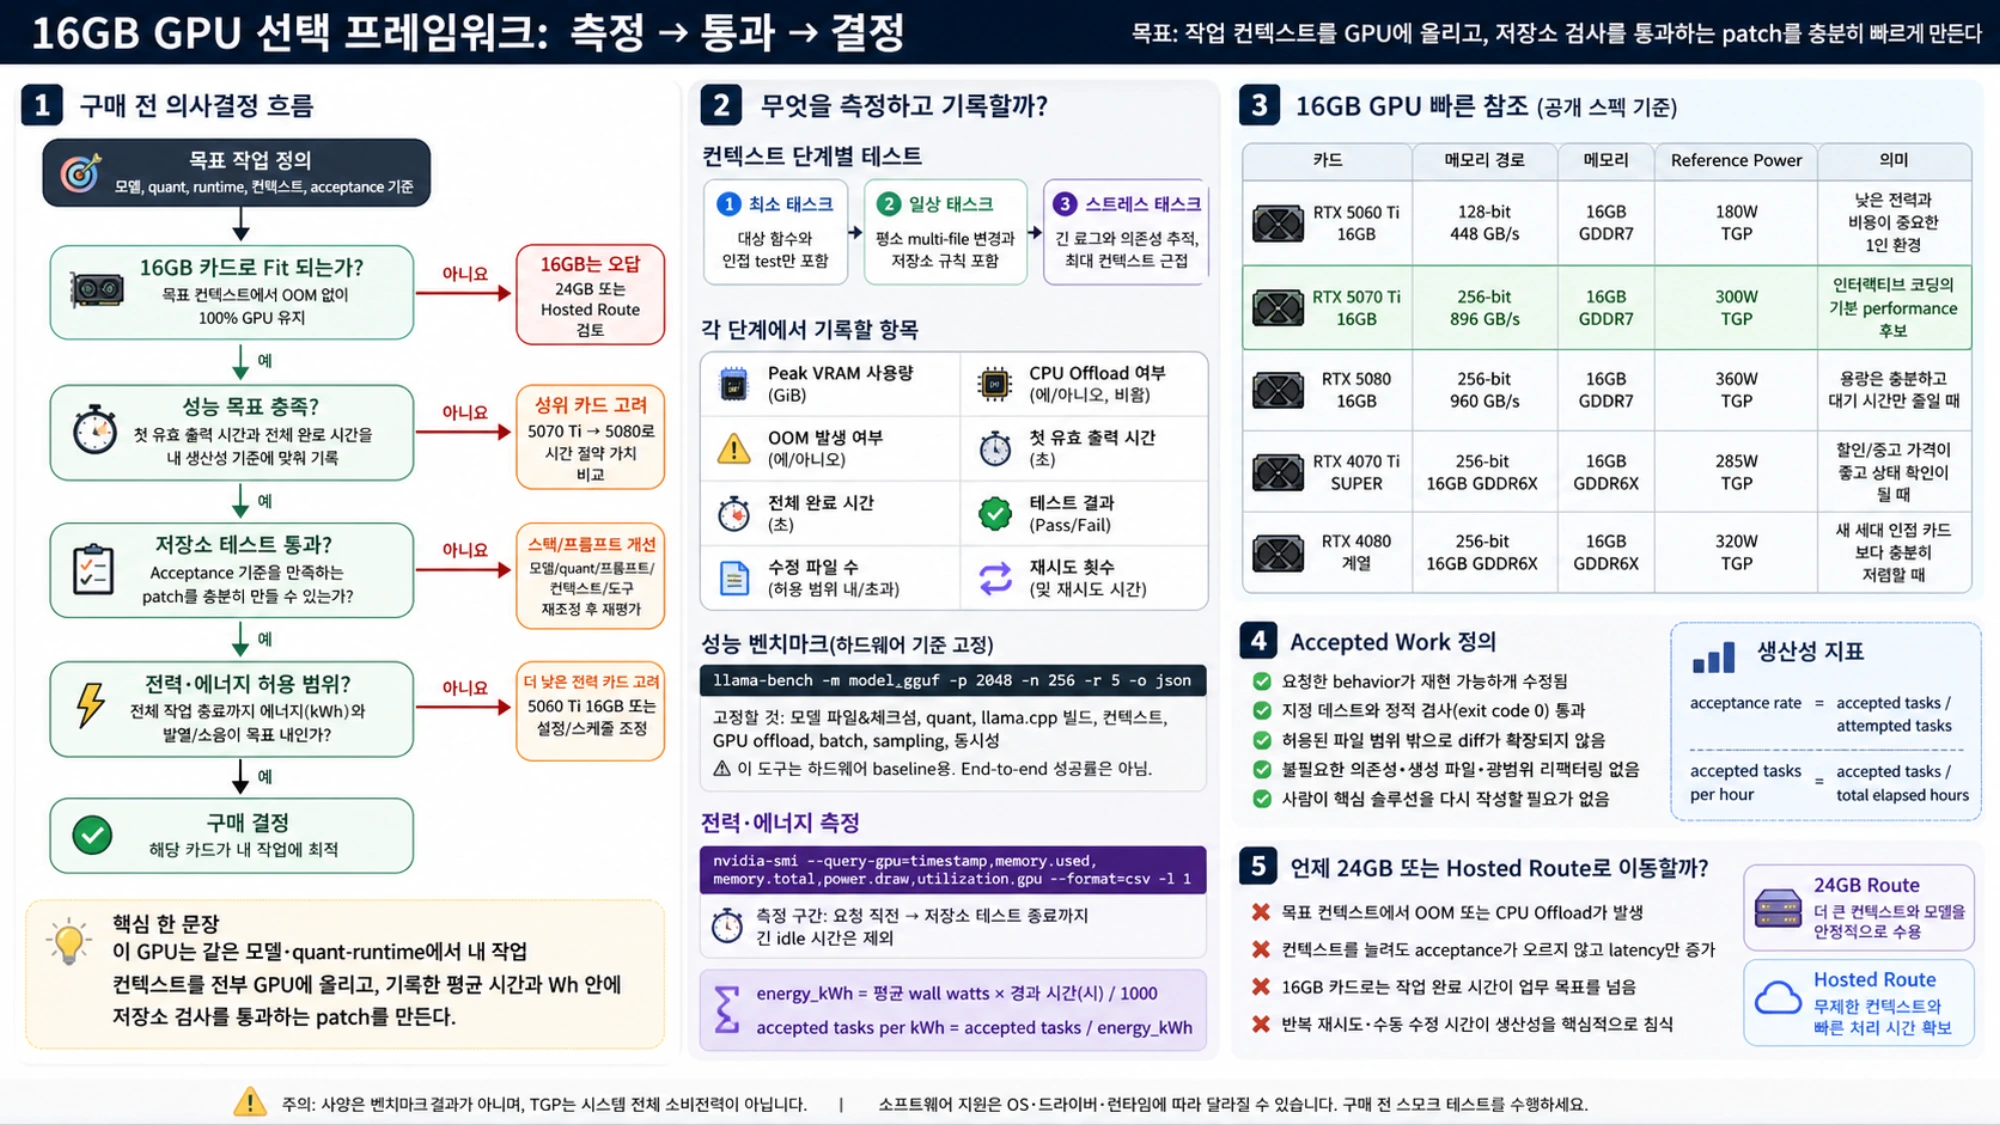
실행 중 VRAM에는 가중치뿐 아니라 KV 캐시, 연산 버퍼, 실행 환경의 추가 메모리와 화면 출력 데이터도 들어간다. 다른 프로세스도 같은 공간을 쓸 수 있다. 양자화는 가중치 크기를 줄이지만 모델 구조와 컨텍스트 길이는 캐시 크기를 바꾸고, 배치와 병렬 요청은 메모리 할당량을 늘린다.
Ollama의 현재 컨텍스트 문서는 24 GiB 미만 VRAM에서 기본 컨텍스트를 4K로 두며, 컨텍스트를 늘리면 메모리가 더 필요하다고 설명한다. 코딩 세션이 실제로 동작할 때 아래를 확인한다.
ollama psPROCESSOR와 CONTEXT가 핵심이다. 짧은 대화에서 100% GPU라고 표시되어도 여러 파일, 도구 출력, 테스트 로그를 넣은 세션에서는 CPU 오프로딩이 생길 수 있다. 후자가 구매 판단에 사용할 상태다.
컨텍스트는 세 단계로 올린다.
- 대상 함수와 인접 테스트만 포함한 최소 작업
- 평소의 여러 파일 수정과 저장소 규칙을 포함한 작업
- 긴 로그와 의존성을 추적해야 하는 실제 고부하 작업
각 단계에서 최대 VRAM, 오프로딩/OOM, 첫 유효 출력 시간, 전체 완료 시간, 테스트 통과 여부를 기록한다. 16K에서 32K로 늘려도 합격률이 오르지 않고 지연 시간만 커지면 32K는 낭비다. 16K에서 필요한 호출 코드를 놓치고 32K에서만 테스트를 통과한다면 그때 컨텍스트 증가가 실무 가치다.
Ollama FAQ는 병렬 요청 수가 컨텍스트 할당량을 키운다는 점도 명시한다. 개인 편집기용 단일 세션 결과로 팀 서버의 VRAM을 계산하면 안 된다.
먼저 하드웨어 성능 기준을 고정한다
llama.cpp의 llama-bench는 입력 처리와 텍스트 생성을 나눠 반복 측정할 수 있다.
llama-bench -m model.gguf -p 2048 -n 256 -r 5 -o json비교할 때는 모델 파일과 체크섬, 양자화, llama.cpp 빌드, 컨텍스트, GPU 적재, 배치, 샘플링, 동시 요청 수를 고정한다. 평균뿐 아니라 분산도 남긴다. 이 도구는 토큰화와 샘플링 시간을 포함하지 않으므로 전체 코딩 작업 성공률이 아니라 하드웨어 성능 기준으로만 쓴다.
한 카드에서만 다른 양자화를 쓰거나 컨텍스트를 줄이면 카드가 아니라 실행 구성을 비교한 것이다.
작업의 합격 여부는 모델이 아니라 저장소가 결정한다
모델에게 작업을 주기 전에 합격 조건을 정한다. 예를 들어 “고정한 커밋에서 파서 오류 한 건을 수정한다. 파서 모듈과 해당 테스트만 변경하고 지정한 단위 테스트와 린트를 통과해야 한다”처럼 범위를 명시한다.
다음 조건을 모두 만족해야 합격으로 센다.
- 요청한 동작이 재현 가능하게 수정됨
- 지정 테스트와 정적 검사의 종료 코드가 0
- 허용 파일 밖으로 변경이 확장되지 않음
- 설명되지 않은 의존성, 생성 파일, 광범위한 재작성이 없음
- 사람이 핵심 해결 코드를 다시 작성할 필요가 없음
작은 수정, 여러 파일 수정, 디버깅 작업을 같은 커밋에서 모든 후보에 준다. 실패 시도와 재시도 시간도 포함한다.
acceptance rate = accepted tasks / attempted tasks
accepted tasks per hour = accepted tasks / total elapsed hours
Tok/s가 높아도 컨텍스트를 잃어 코드 변경을 두 번 버리면 하루 생산성은 낮다. 시간당 합격 작업 수를 보면 모델 품질, 필요한 문맥을 담을 수 있는지, 하드웨어의 대기 시간이 실제 작업에 미치는 영향을 함께 비교할 수 있다.
전력은 테스트가 끝날 때까지 잰다
TGP는 전원 공급 장치와 냉각 성능을 고를 때 참고하는 그래픽카드 전력 수치이며, 컴퓨터 전체가 콘센트에서 소비하는 전력은 아니다. CPU 오프로딩은 GPU 전력을 낮게 보이게 하면서 전체 작업을 오래 끌 수 있다.
NVIDIA에서는 작업 실행 중 다음 측정값을 1초 간격으로 남길 수 있다.
nvidia-smi \
  --query-gpu=timestamp,memory.used,memory.total,power.draw,utilization.gpu \
  --format=csv -l 1
전기요금, 방열, PSU 부하가 중요하면 콘센트 전력계를 더한다. 요청 직전부터 저장소 테스트 종료까지 측정하고 긴 유휴 시간은 제외한다.
energy_kWh = average wall watts × elapsed hours / 1000
accepted tasks per kWh = accepted tasks / energy_kWh
같은 작업을 끝낸 에너지로 비교해야 한다. 순간 최대 전력만 비교하면 빠르게 끝나는 카드와 오래 도는 저전력 카드를 공정하게 볼 수 없다.
AMD 16GB는 OS와 실행 환경이 먼저다
AMD의 Radeon RX 9060 XT 16GB 공개 사양은 16GB GDDR6, 320 GB/s, 일반적인 그래픽카드 소비 전력 160W다. 메모리 용량과 전력 관점에서는 매력적이지만, 이 숫자는 CUDA와 같은 애플리케이션 호환성을 보장하지 않는다.
Ollama의 현재 GPU 지원 페이지는 Linux ROCm 목록에 RX 9060 XT를 포함하지만 Windows 직접 실행 목록과 드라이버 조건은 다르다. AMD Radeon ROCm 지원 표도 Linux와 WSL, 프레임워크 버전을 구분한다. 구매 전 정확한 운영체제, 드라이버, 실행 환경 빌드, 모델 형식, 컨텍스트, 편집기 연동으로 간단한 시험 작업을 통과시킨다. CPU 대체 실행이 필요한 구성은 낮은 GPU 가격으로 보상되지 않을 수 있다.
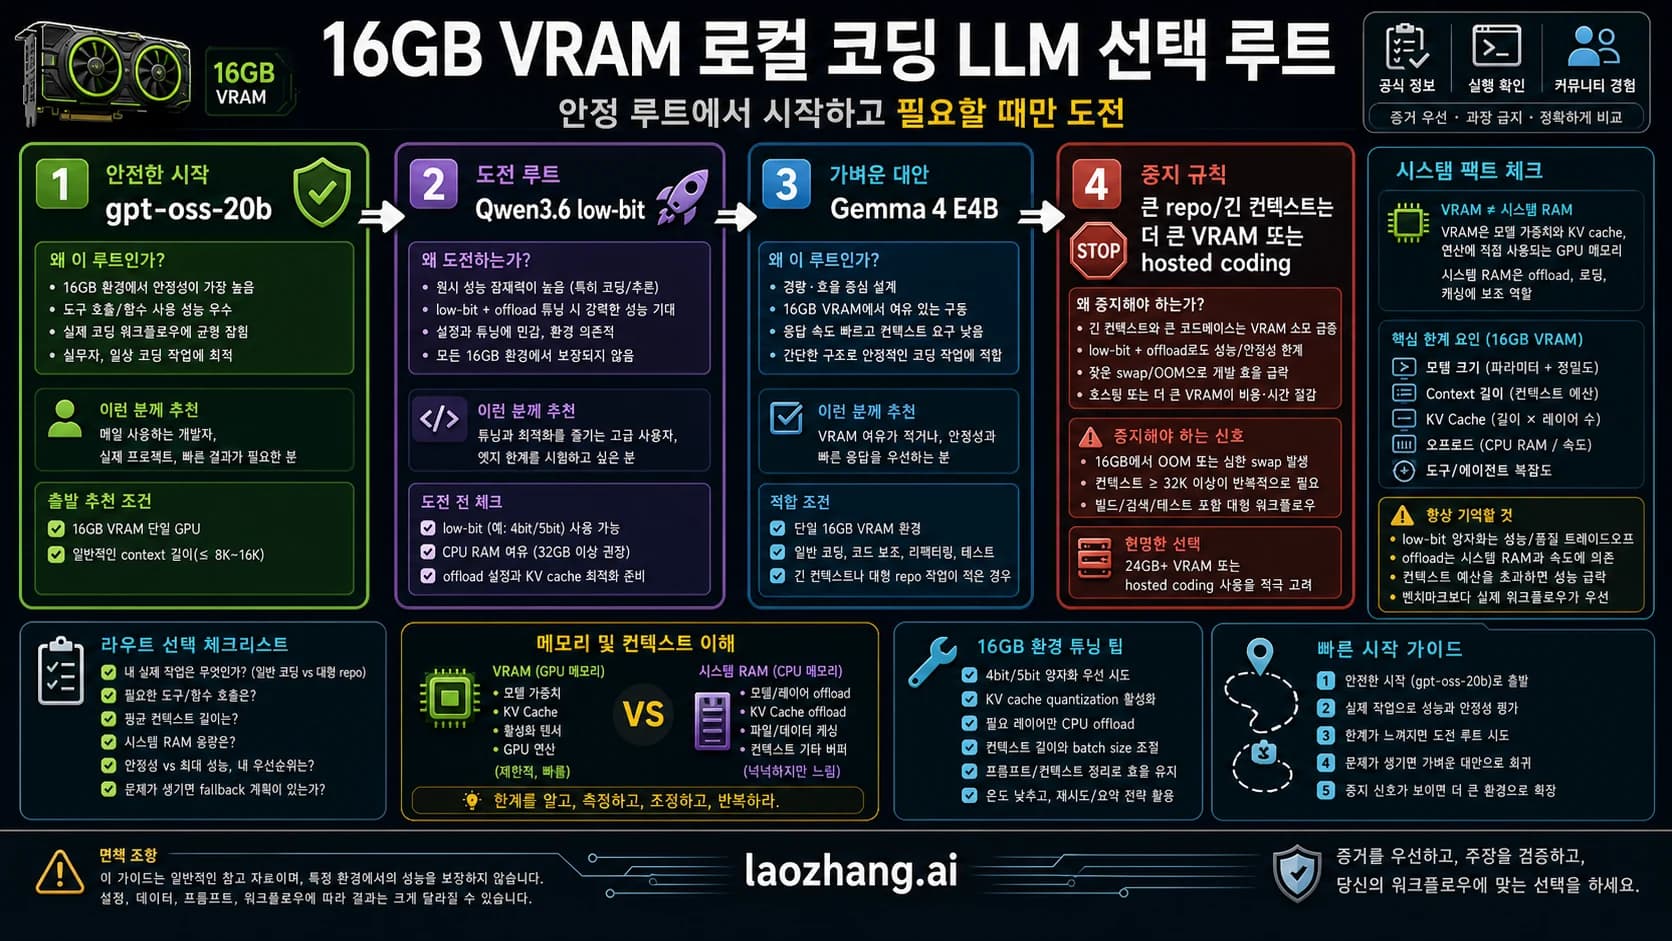
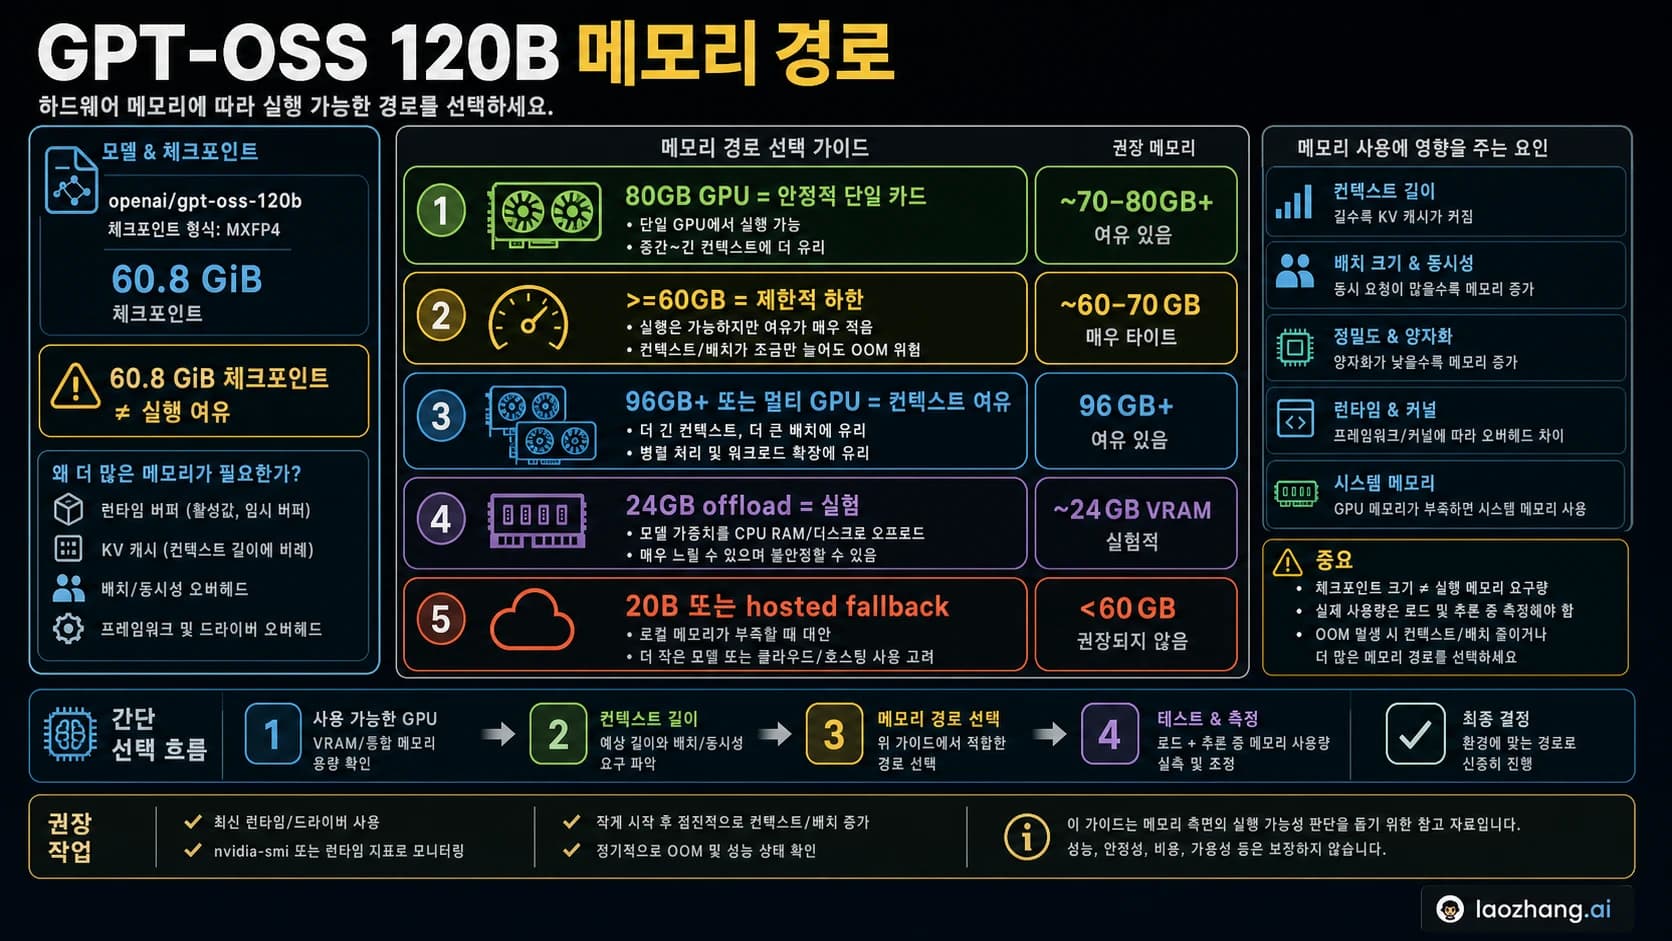
24GB로 넘어갈 때를 미리 정한다
NVIDIA 사양상 RTX 3090은 24GB GDDR6X, 그래픽카드 전력 350W다. 중고 매물이 빠른 16GB 카드와 비슷한 가격이면 메모리 용량 대안이지만, 메모리 상태, 냉각, PSU, 보증 위험을 함께 본다.
- 5060 Ti 16GB에서 작업 데이터가 전부 들어가고 시간 목표를 만족하면 더 저렴한 카드를 선택한다.
- 메모리는 충분하지만 반복되는 대기가 업무를 막으면 5070 Ti에서 늘어나는 시간당 합격 작업 수를 가격 차이와 비교한다.
- 모델과 컨텍스트가 메모리에 충분히 들어가고 시간 가치가 매우 높을 때만 5080을 속도 개선 후보로 본다.
- 필요한 컨텍스트에서 모든 16GB가 오프로딩/OOM이면 24GB 또는 호스팅 서비스로 이동한다.
하드웨어 용량을 정한 뒤 모델과 양자화를 선택한다. 그다음 단계는 16GB VRAM 로컬 코딩 LLM 선택 가이드에서 설명한다. GPU 메모리 용량과 모델 품질을 분리해야 “더 빠른 16GB”를 메모리 부족의 해결책으로 사는 실수를 피할 수 있다.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 8월 29일.
참고 자료7
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 8월 29일.
- 1.GeForce 사양표nvidia.com/en-us/geforce/graphics-cards/compare
- 2.컨텍스트 문서docs.ollama.com/context-length
- 3.Ollama FAQdocs.ollama.com/faq
- 4.llama-benchgithub.com/ggml-org/llama.cpp/blob/master/tools/llama-bench/README.md
- 5.Radeon RX 9060 XT 16GBamd.com/en/products/graphics/desktops/radeon/9000-series/amd-radeon-rx-9060xt.html
- 6.GPU 지원 페이지docs.ollama.com/gpu
- 7.Radeon ROCm 지원 표rocm.docs.amd.com/_/downloads/radeon/en/latest/pdf