OpenClaw 모델 설정: 클라우드 API와 Ollama·LM Studio 연동하기
OpenClaw 모델 설정은 제공업체 인증, 정확한 모델 선택, 실제 동작 확인 순서로 진행합니다. Ollama는 네이티브 API를, LM Studio와 vLLM은 호환 API를 사용합니다. 모델 목록 표시만으로 설정을 끝내지 말고 짧은 응답과 파일 읽기까지 확인하세요.
목차
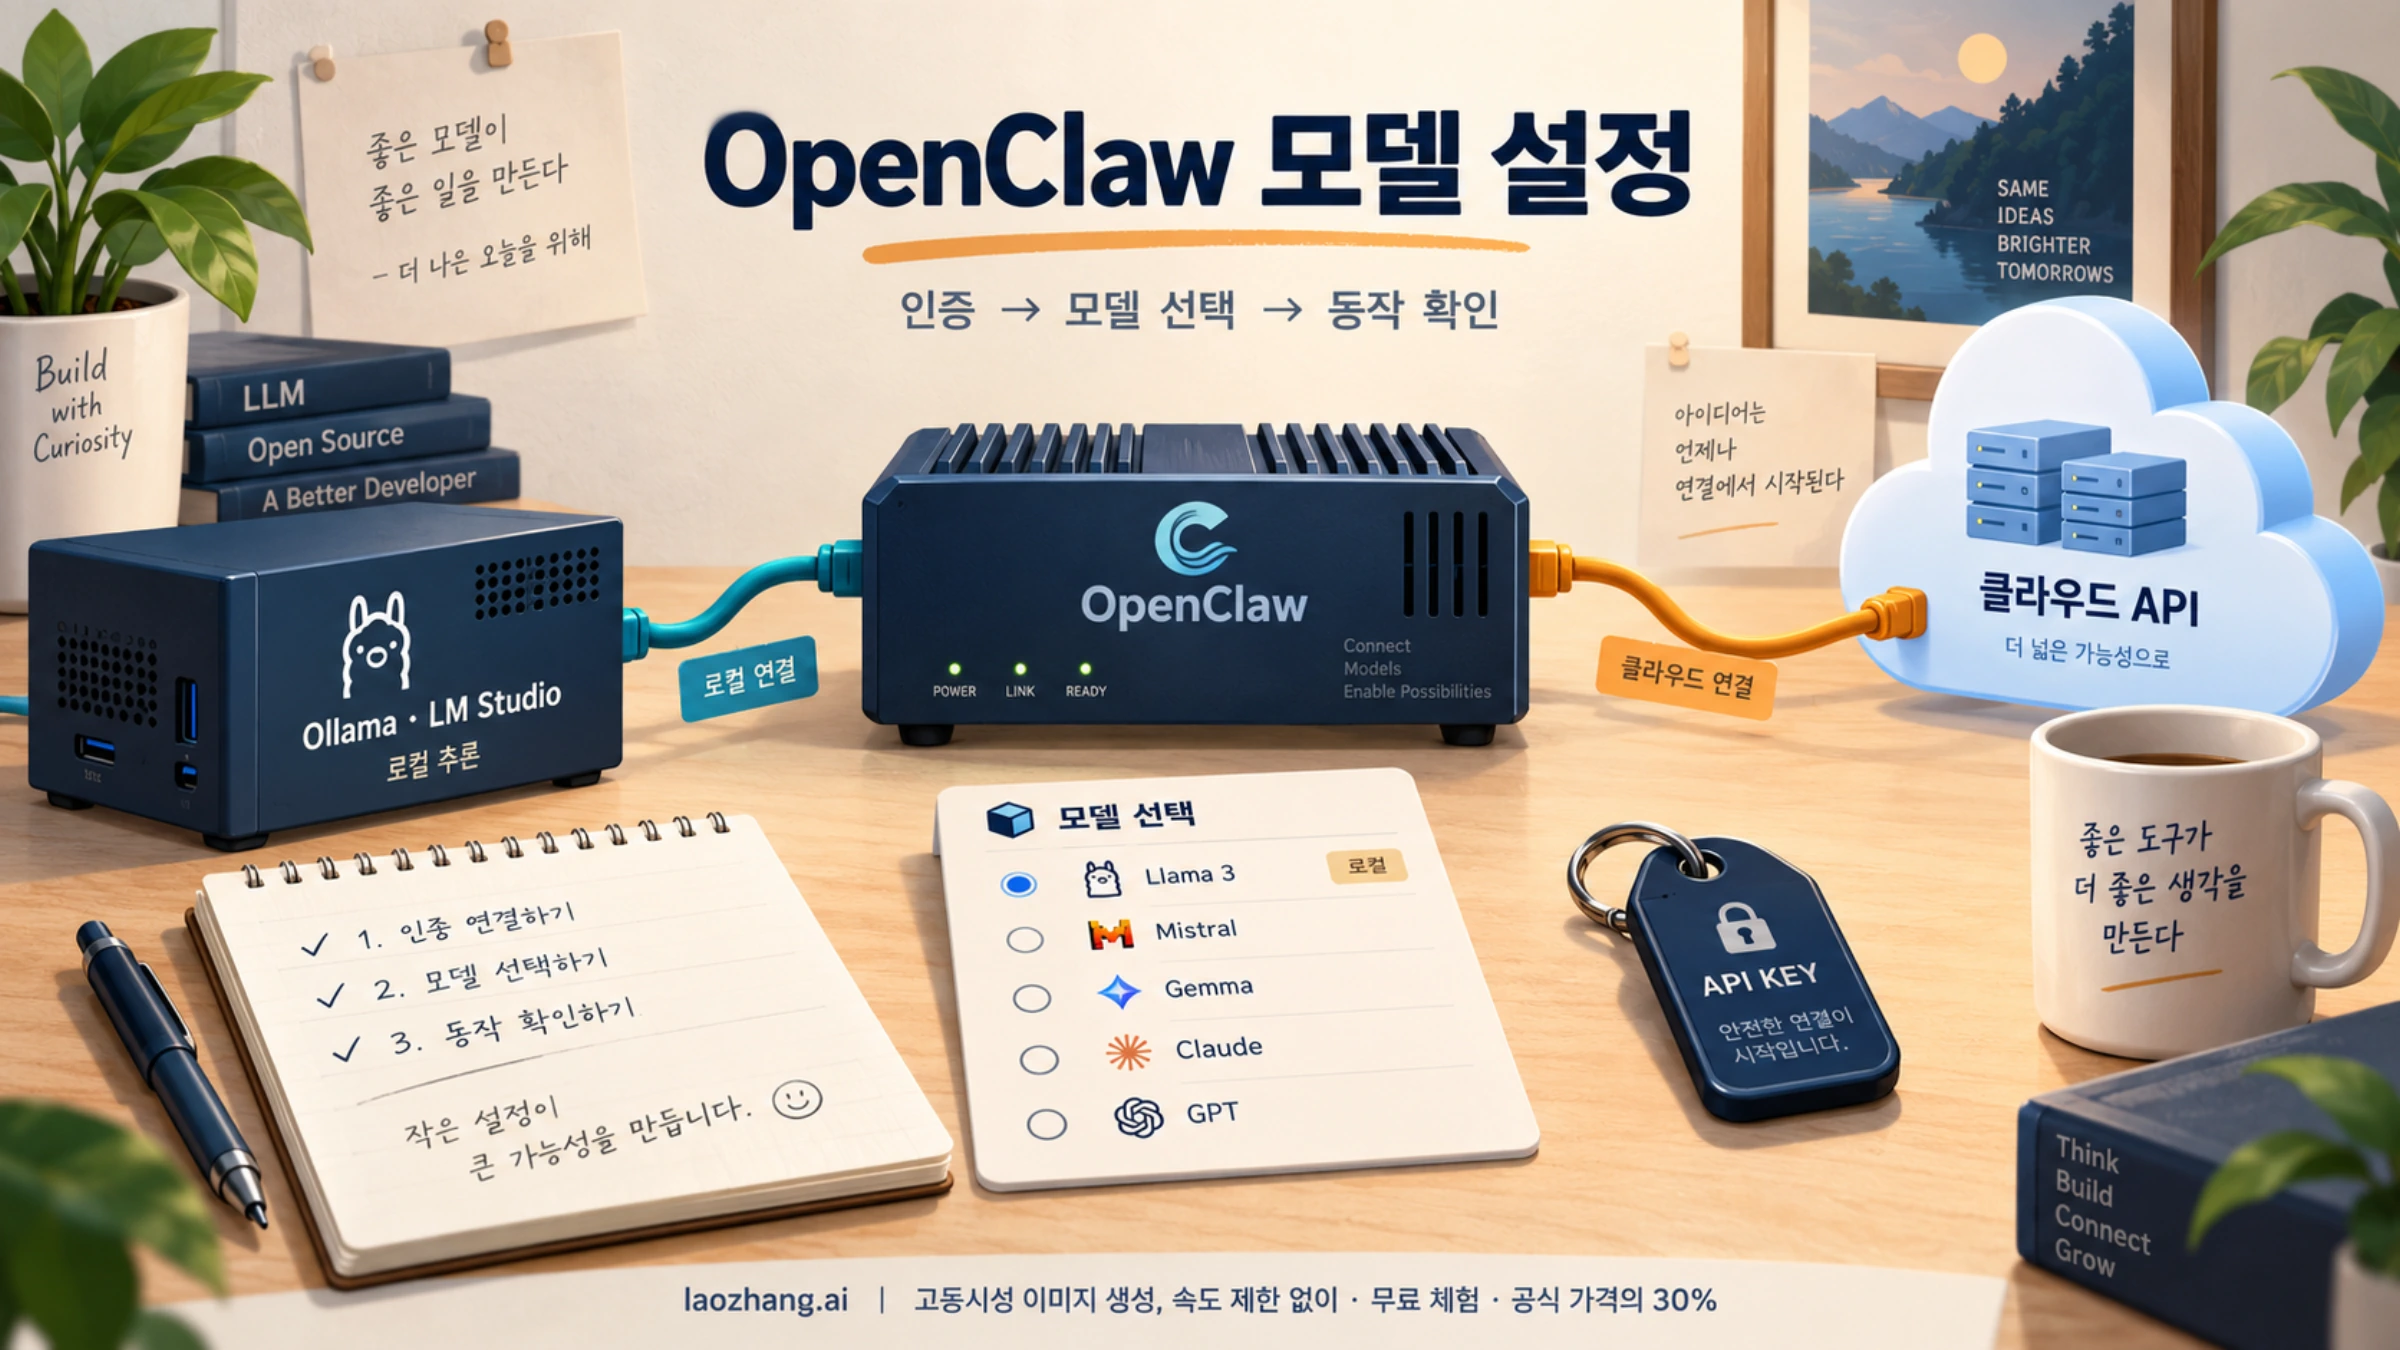
OpenClaw에 LLM을 연결하려면 Gateway가 실행되는 컴퓨터에서 제공업체를 인증하고, provider/model 형식의 정확한 모델을 선택한 뒤, 짧은 응답과 도구 실행을 확인하면 됩니다. 클라우드 API는 제공업체의 계정과 키를, 로컬 모델은 실행 중인 추론 서버와 그 서버가 제공하는 모델을 먼저 준비합니다.
처음 설정한다면 openclaw onboard의 대화형 안내를 사용하는 편이 간단합니다. Ollama를 연결할 때는 네이티브 API인 /api/chat을 사용하므로 기본 주소에 /v1을 붙이지 않습니다. 반면 LM Studio와 vLLM의 OpenAI 호환 추론 주소에는 /v1이 필요합니다. 모델 이름이 같아도 이 연결 방식이 다르면 동작 결과가 달라질 수 있습니다.
아래 절차는 2026년 10월 4일 확인한 공식 문서를 기준으로 합니다. 실제 계정 인증, 유료 모델 호출, GPU 성능 측정을 수행한 결과는 아닙니다. OpenClaw가 설치되어 있고, 사용할 Gateway와 작업용 agent를 정한 상태에서 진행합니다.
먼저 Gateway의 위치와 사용할 연결을 정하세요
브라우저가 열린 컴퓨터와 모델을 호출하는 컴퓨터는 다를 수 있습니다. 원격 서버의 Gateway를 사용한다면 키와 추론 서버 접속 설정도 그 서버를 기준으로 해야 합니다. 컨테이너 안에서 실행하는 Gateway에는 컨테이너 자체가 별도의 네트워크 환경입니다.
Gateway 호스트의 터미널에서 현재 상태를 확인합니다.
openclaw --version
openclaw gateway status
openclaw doctor| 사용할 연결 | 먼저 준비할 것 | 설정 시 선택 |
|---|---|---|
| OpenAI·Anthropic·Google 등의 클라우드 API | 해당 제공업체의 사용 가능한 계정과 API 키 | 대화형 온보딩의 해당 제공업체 |
| ChatGPT/Codex 인증을 사용하는 OpenAI 연결 | 현재 계정에서 지원되는 로그인과 모델 | OpenAI 로그인 방식 |
| 같은 컴퓨터의 Ollama | 실행 중인 Ollama와 설치된 채팅 모델 | Ollama → Local only |
| Ollama의 로컬·클라우드 혼합 사용 | 접근 가능한 Ollama 호스트와 그 호스트의 클라우드 로그인 | Ollama → Cloud + Local |
| LM Studio | 데스크톱 앱 또는 llmster, 실행 중인 서버와 모델 | LM Studio |
| 기존 vLLM 서버 | 호환 API 주소, 정확한 모델 ID, 필요한 서버 인증 | vllm 제공업체 설정 |
상시 실행하는 서버에는 API 키가 관리하기 쉬운 선택입니다. 공식 인증 안내는 Gateway 호스트에 인증을 구성하도록 안내합니다. systemd나 launchd 서비스는 터미널에서 설정한 환경 변수를 그대로 받지 않을 수 있으므로, 온보딩으로 저장하거나 서비스가 읽는 ~/.openclaw/.env 등 지원되는 방법을 사용합니다.
클라우드 모델: 인증한 다음 기본 모델을 직접 확인하세요
온보딩을 실행하고 사용할 제공업체와 인증 방식을 고릅니다. API 키는 해당 제공업체의 보호된 입력에 넣으며, Gateway 접속 토큰과 혼동하지 않습니다.
openclaw onboard인증이 끝나면 제공업체별 목록을 확인합니다. 아래는 OpenAI를 선택한 경우입니다.
openclaw models list --provider openai
openclaw models status
목록에서 실제 계정으로 사용할 모델을 고른 다음 기본 모델을 지정합니다. 예를 들어 openai/gpt-6-astra가 사용 가능한 경우에는 다음과 같이 설정합니다. 이 ID가 계정에서 지원되지 않으면 목록에 있는 정확한 ID를 사용해야 합니다.
openclaw models set openai/gpt-6-astra
openclaw models status
인증을 추가했다고 기존 기본 모델까지 바뀌는 것은 아닙니다. 현재 openclaw configure와 일반적인 models auth login은 기존 agents.defaults.model.primary를 보존합니다. 의도적으로 바꾸려면 models set을 사용하거나 로그인 시 --set-default를 지정합니다. 기본 모델 보존 규칙
모델 이름, 실행 방식, 계정은 따로 확인해야 합니다
openai/는 OpenAI 제공업체를 가리킵니다. 이 접두어 하나로 Codex 실행 여부나 구독 청구 여부를 판단할 수는 없습니다. 현재 OpenClaw는 공식 HTTPS 연결과 실행 정책 등의 조건에 따라 Codex를 선택할 수 있고, 직접 API 키와 ChatGPT/Codex 로그인은 별개의 인증입니다. OpenAI 설정 문서에서 자신의 인증 방식과 모델 접근 권한을 함께 확인하세요.
Anthropic API 키와 네이티브 Claude CLI 로그인도 서로 다릅니다. Claude CLI를 선택한다면 Gateway의 실행 사용자에게 CLI 로그인과 실행 파일이 있어야 합니다. Anthropic 연결 안내에 따르면 CLI에서 API 키 계정을 명시적으로 선택하면 API 청구가 적용됩니다.
Gemini의 표준 모델 참조는 google/이며, AI Studio API 키 연결과 로컬 Gemini CLI 실행 정책은 별개입니다. 현재 Google 설정 안내는 신규 Gemini CLI·Antigravity OAuth 설정을 제공하지 않습니다. Bedrock에서 Claude를 사용한다면 AWS 인증·리전·모델 접근 권한을 준비해야 하며 Anthropic API 키로 대체하지 않습니다.
Ollama: 같은 컴퓨터에서 로컬 모델을 연결하는 순서
Ollama가 Gateway와 같은 컴퓨터에서 실행되는 가장 단순한 경우부터 시작합니다. Ollama를 설치하고 앱 또는 서비스로 서버를 실행하세요. 서버가 아직 실행되지 않았다면 터미널에서 ollama serve를 실행합니다. 이미 실행 중인 서버를 중복으로 시작할 필요는 없습니다.
다음은 공식 설정 문서에서 사용하는 gemma4 예시입니다. 다운로드 크기와 필요한 메모리를 먼저 확인하고, 자신의 컴퓨터에서 사용할 수 있는 도구 지원 모델을 선택합니다. 모델 이름은 성능 추천이나 하드웨어 적합성 보장이 아닙니다.
ollama pull gemma4
ollama list
ollama run gemma4
ollama run에서 짧은 질문을 보내 모델이 로드되고 응답하는지 확인합니다. 입력 화면을 종료한 뒤 다음을 확인합니다.
ollama ps
ollama show gemma4
openclaw onboard
온보딩에서는 Ollama → Local only를 선택하고 같은 컴퓨터의 기본 연결을 사용합니다. 현재 새 안내식 설정의 자동 후보는 /api/ps에 나타나는 이미 로드된 모델 중 /api/show에서 도구 지원과 최소 16K 컨텍스트가 확인된 모델입니다. 디스크에 설치만 되어 있고 로드되지 않은 모델은 자동 후보가 아닙니다. 선택한 연결은 실제 응답 확인을 거쳐 저장됩니다. 현재 Ollama 온보딩 조건
데스크톱 Model Setup에서 설치된 모델이 자동으로 제안되지 않으면 Ollama 카드의 Choose connection을 누르고 Local only로 진행할 수 있습니다. 이 명시적 경로는 적합한 설치 모델을 실제 확인을 위해 준비할 수 있습니다. 자동 발견 자체가 사용하지 않는 모델을 다운로드하거나 로드하는 것은 아닙니다. 필요한 모델을 가져오겠다는 안내가 나오면 용량과 모델을 확인한 뒤 결정합니다.
설정 후에는 목록과 기본값을 다시 확인합니다.
openclaw models list --provider ollama
openclaw models set ollama/gemma4
openclaw models status
실제 목록이 다른 태그를 표시하면 그 이름에 맞춰 선택하세요. 일반 모델 목록 발견은 /api/tags와 /api/show를 사용합니다. 이는 새 온보딩의 이미 로드된 모델 자동 선택 조건과 다른 절차입니다. models.providers.ollama.models에 비어 있지 않은 목록을 직접 작성하면 자동 발견을 건너뛰므로, 목록에 없다는 이유만으로 모델을 다시 다운로드하기 전에 수동 설정 여부를 확인합니다. 모델 발견 규칙
로컬 전용과 클라우드 혼합을 구분하세요
로컬·사설 LAN Ollama 호스트에는 OpenClaw가 ollama-local이라는 비밀값이 아닌 인증 표시를 사용합니다. 공개 원격 호스트나 https://ollama.com에는 실제 인증이 필요합니다. 직접 호스팅된 Ollama Cloud만 사용하려면 별도의 ollama-cloud 제공업체를 선택할 수 있습니다.
Cloud + Local에서는 접근 가능한 Ollama 호스트의 ollama signin 상태를 사용하며, :cloud 모델의 추론은 원격에서 수행됩니다. 로컬 서버를 경유한다고 로컬 추론으로 바뀌지는 않습니다. 또한 Local only는 이 모델 연결의 모드입니다. 외부 검색 도구, 플러그인, 메모리 임베딩, 보조 모델이나 클라우드 대체 모델까지 모두 로컬로 제한한다는 뜻은 아닙니다. 외부 전송을 제한해야 한다면 각각의 설정과 실제 요청을 확인하세요. Ollama 모드와 인증
다른 컴퓨터의 Ollama와 LM Studio는 주소를 다르게 설정합니다
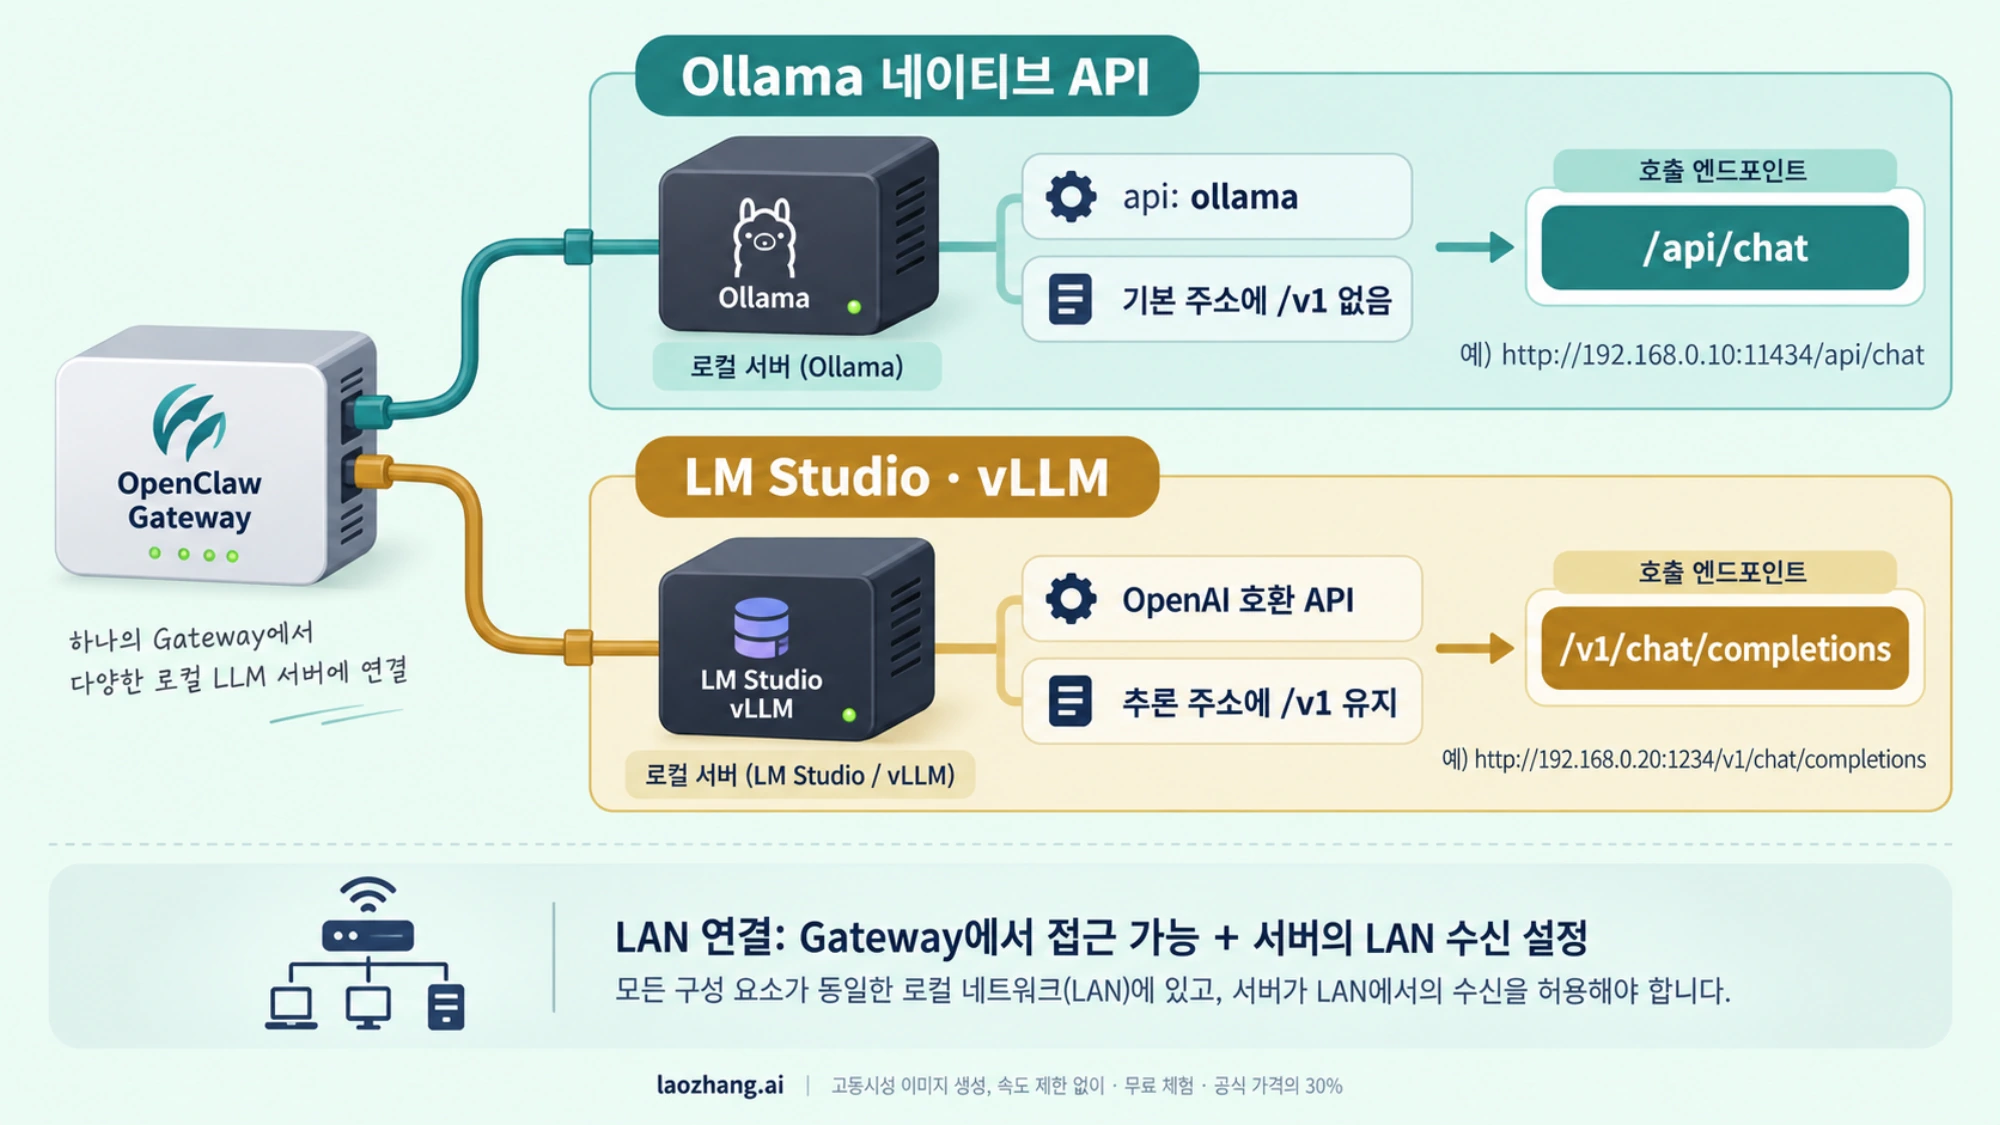
추론 서버가 별도의 GPU 컴퓨터에 있다면 Gateway에서 실제로 접속할 수 있는 주소를 사용합니다. 아래 gpu-box.local은 Gateway 호스트에서 이름이 해석되고 서버가 LAN 인터페이스에서 수신하는 경우에만 사용할 수 있는 예시입니다. 실제 호스트 이름으로 바꾸고 방화벽과 서버의 바인딩을 확인하세요. 같은 컴퓨터에서만 수신하는 서버에 호스트 이름만 바꿔 넣어도 LAN 연결이 생기지는 않습니다.
| 서버 | 모델 추론 연결 | 모델 목록 확인 |
|---|---|---|
| 네이티브 Ollama | api: "ollama", 기본 주소에 /v1 없음 | /api/tags, 능력 확인은 /api/show |
| LM Studio | api: "openai-completions", 추론 주소에 /v1 유지 | 네이티브 /api/v1/models |
| vLLM | api: "openai-completions", /v1 유지 | /v1/models |
이 구분은 각 제공업체의 연결 방식입니다. Ollama 구성, LM Studio, vLLM에서 현재 조건을 확인할 수 있습니다.
LAN Ollama의 수동 구성 예시
먼저 Gateway 컴퓨터에서 서버 목록을 확인합니다.
curl http://gpu-box.local:11434/api/tags다음은 기존 OpenClaw 설정에 합칠 제공업체와 기본 모델의 예시입니다. 서버에 qwen3.5:9b가 실제로 설치되어 있고 도구 지원과 실행 가능 여부를 확인한 경우에 사용합니다. 다른 모델이라면 id, name, primary를 함께 바꿉니다.
{
  models: {
    providers: {
      ollama: {
        baseUrl: "http://gpu-box.local:11434",
        apiKey: "ollama-local",
        api: "ollama",
        models: [
          { id: "qwen3.5:9b", name: "qwen3.5:9b" }
        ]
      }
    }
  },
  agents: {
    defaults: {
      model: { primary: "ollama/qwen3.5:9b" }
    }
  }
}
기존 설정 전체를 이 코드로 덮어쓰지 말고 해당 항목을 반영한 뒤 openclaw config validate로 확인합니다. 이 예시는 수동 모델 목록이므로 자동 발견을 사용하지 않습니다. 네이티브 Ollama는 스트리밍과 도구 호출을 함께 지원합니다. 예전 /v1 호환 방식의 제한을 해결하려고 모든 Ollama 연결에서 스트리밍을 끌 필요는 없습니다. 네이티브 API와 호환 방식의 차이
LM Studio를 사용하는 경우
LM Studio 앱 또는 headless llmster를 준비하고 서버를 시작합니다.
lms server start --port 1234
openclaw onboard
온보딩에서 LM Studio를 선택하고 서버 주소와 정확한 모델을 고릅니다. 인증을 끈 서버는 키 입력을 비워 두며, 인증을 켰다면 서버에서 설정한 LM_API_TOKEN을 사용합니다. 새 안내식 설정은 도구 학습 정보와 최소 16K의 유효 컨텍스트를 확인하고 실제 응답을 검증합니다. 이미 로드된 모델은 광고된 최대치보다 로드된 인스턴스의 컨텍스트가 우선합니다. LM Studio 온보딩
LAN 서버라면 먼저 서버가 외부 인터페이스에서 수신하도록 설정합니다. 인증을 사용하지 않는 접근 가능한 예시 서버의 목록은 다음처럼 확인합니다.
curl http://gpu-box.local:1234/api/v1/models응답의 key가 qwen/qwen3.5-9b라면 OpenClaw 참조는 lmstudio/qwen/qwen3.5-9b입니다. 수동 추론 설정의 baseUrl은 http://gpu-box.local:1234/v1처럼 /v1을 유지합니다. Ollama의 주소 규칙을 그대로 적용하면 안 됩니다. 인증 서버에서는 적절한 인증 없이 위 목록 요청도 성공하지 않을 수 있습니다.
vLLM·사용자 지정 API는 모델 ID와 도구 지원까지 맞춰야 합니다
이미 vLLM을 운영한다면 /v1/models에 나오는 ID를 vllm/ 뒤에 붙입니다. 인증 없는 서버의 VLLM_API_KEY에는 비밀값이 아닌 표시를 사용할 수 있지만, 인증을 켠 서버에는 실제 서버 키가 필요합니다.
도구 호출이 JSON이나 XML 텍스트로만 출력된다면 모델에 맞는 tool-call parser와 chat template부터 확인합니다. 텍스트 안에 함수 이름이 보이는 것은 도구 실행이 아닙니다. tool_choice: "required"는 특정 조합에서만 검토할 우회 설정이며 모든 요청의 도구 호출을 강제하므로 전체 vLLM 모델의 기본값으로 사용하지 않습니다. vLLM 도구 호출 문제 해결
다른 중계·호환 API를 연결할 때 필요한 항목도 비슷합니다. models.providers의 제공업체 ID, baseUrl, api, 서버가 받는 정확한 모델 ID를 한 묶음으로 맞춰야 합니다. agents.defaults.models에 별칭을 추가하는 것만으로 새 서버 모델이 등록되지는 않습니다. 사용자 지정 제공업체 규칙
| 설정 | 의미 |
|---|---|
contextWindow | 모델의 네이티브 컨텍스트 용량에 대한 정보 |
contextTokens | OpenClaw가 활성 입력에 사용하는 상한 |
maxTokens | 출력 토큰 용량 또는 해당 제공업체의 출력 기본값 |
Ollama의 params.num_ctx | 네이티브 요청에서 Ollama에 전달할 컨텍스트 설정 |
이 값은 서버가 실제 지원하는 범위와 호스트의 메모리에 맞춰야 합니다. 숫자를 크게 적는다고 모델 용량이나 하드웨어가 커지지는 않습니다. 구성의 cost: 0도 청구서가 아닙니다. 가중치, 양자화, 컨텍스트 길이, 실행 엔진에 따라 메모리와 속도가 달라지므로 모델 크기만으로 필요한 RAM이나 초당 토큰 수를 단정하지 않습니다.
기본 모델, 대화별 고정 선택, 대체 모델을 구분하세요
openclaw models set은 전역 기본값을 바꿉니다. 이미 대화에서 다른 모델을 선택했다면 그 대화의 고정 선택은 그대로 남을 수 있습니다. 해당 대화에서 다음을 확인하세요.
/model status
/model default
/model default는 대화의 모델 고정을 해제하고 설정된 기본값을 사용하도록 합니다. 여러 agent를 사용한다면 agent별 기본 모델이 전역 기본값을 덮어쓰는지도 확인해야 합니다. 모델 선택 규칙
대체 모델은 기본 모델이 실패했을 때 사용할 순서입니다. 먼저 각각의 연결과 인증을 확인한 후 추가합니다. 아래는 Anthropic 모델이 실제로 사용 가능한 환경에서만 적용할 예시입니다.
openclaw models fallbacks add anthropic/claude-opus-5
openclaw models fallbacks list
현재 실패 복구 규칙에 따르면 적합한 일시 오류의 같은 모델 복구와 제공업체 내 인증 전환을 거친 뒤 대체 모델로 진행합니다. 설정된 기본 모델은 대체 목록을 사용하지만, /model ollama/gemma4처럼 사용자가 특정 모델을 선택한 대화는 엄격한 선택입니다. 그 모델이 실패하면 관련 없는 모델로 조용히 답하지 않습니다. 개별 agent의 기본 모델도 해당 agent에 대체 목록을 명시해야 대체를 사용하며, fallbacks: []는 대체를 끕니다.
현재 대체 실행은 해당 턴에만 적용됩니다. /status에서 선택된 모델과 실제 답한 대체 모델을 구분할 수 있습니다. 오래된 2026.4.26–2026.6.0의 저장된 자동 선택 상태는 별도 호환 처리가 있으므로 구버전 설명을 현재 기본 동작으로 적용하지 않습니다. 대체는 작업별 저렴한 모델을 자동 배정하는 기능도, 중단 없는 운영 보장도 아닙니다. 로컬 데이터만 처리하려면 클라우드 대체 모델을 추가하기 전에 외부 전송 조건을 검토하세요.
설정 완료는 짧은 응답과 실제 파일 읽기로 확인합니다
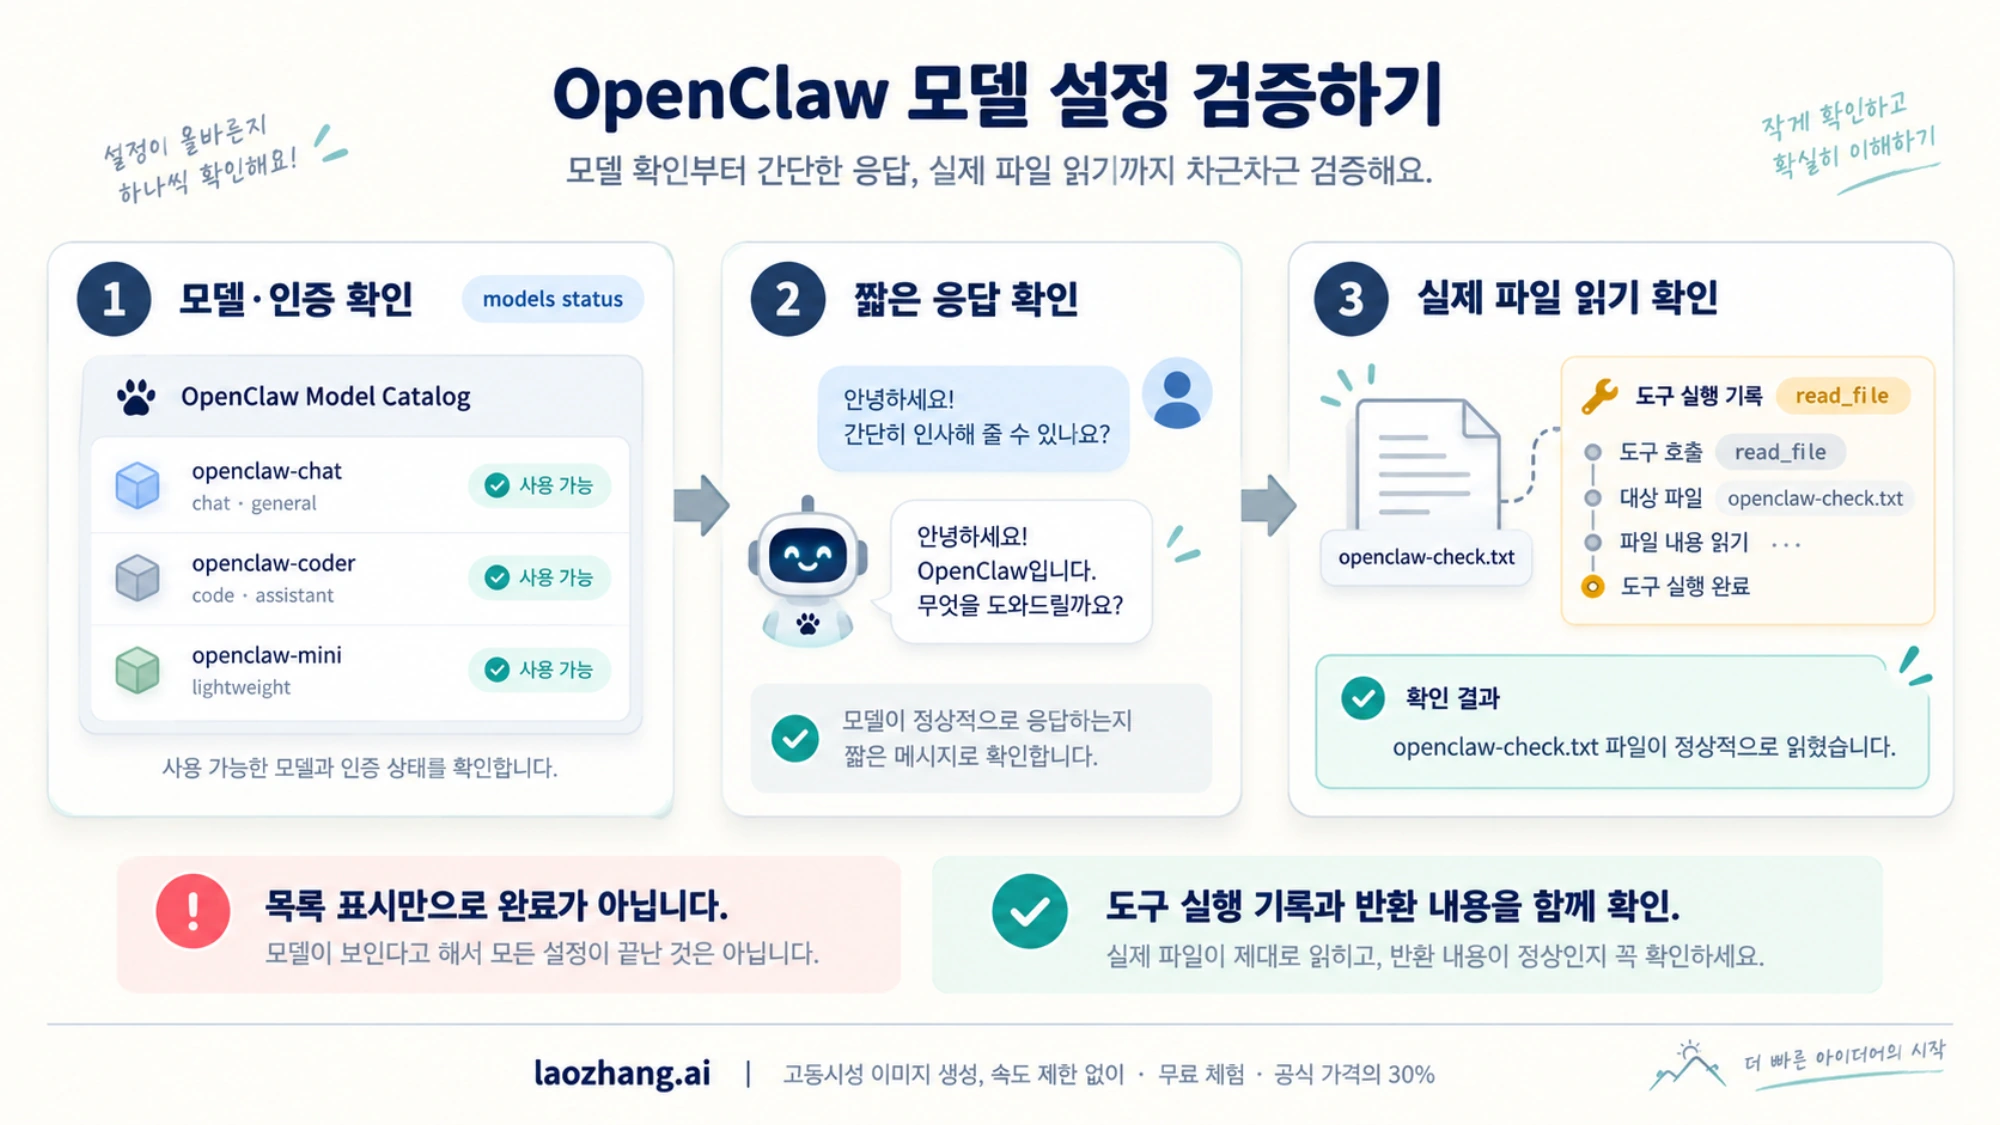
세 단계로 확인하면 문제 범위를 좁힐 수 있습니다. 아래는 main이 실제 설정된 agent인 경우의 예시입니다. 다른 agent를 사용한다면 ID를 바꿉니다.
openclaw models list --agent main
openclaw models status --agent main
openclaw models status --agent main --json --check
첫째, 목록에는 의도한 제공업체와 정확한 모델이 있어야 합니다. 상태에서는 인증과 실행 환경을 확인합니다. indeterminate는 이 명령에서 사용 가능 여부를 확정하지 못했다는 뜻이며 키가 틀렸다는 판정은 아닙니다. --check의 종료 코드 0도 실제 모델 요청 성공을 보장하지 않습니다. CLI 상태의 확인 범위
둘째, 사용할 대화에서 /model status로 모델과 계정을 확인한 뒤 “한 문장으로 인사해 주세요”처럼 짧은 요청을 보냅니다. 선택한 모델이 정상 응답하고 해당 요청에 인증·연결 오류가 없어야 합니다. Ollama의 연결만 따로 검사하려면 다음처럼 좁은 텍스트 검사를 사용할 수 있습니다. 모델 ID는 실제 설치 모델에 맞춥니다.
openclaw infer model run --local --model ollama/gemma4 --prompt "Reply with exactly: pong" --json이 명령은 채팅 도구·메모리·세션 문맥을 불러오지 않습니다. 성공해도 agent의 도구 사용까지 확인한 것은 아닙니다. Ollama의 좁은 모델 검사
셋째, 해당 agent의 작업 폴더에 민감하지 않은 새 텍스트 파일을 직접 만들고 자신만 아는 짧은 확인 문자열을 넣습니다. 대화에는 문자열을 붙여 넣지 않은 상태에서 “작업 폴더의 openclaw-check.txt를 읽고 첫 줄을 알려 주세요. 파일은 수정하지 마세요”라고 요청합니다. 파일 읽기가 허용된 도구 정책과 작업 폴더여야 합니다.
실제 파일 읽기 도구의 실행 기록과 반환된 첫 줄이 모두 맞아야 이 작업의 성공입니다. 모델이 읽겠다고 말하거나 함수 형태의 텍스트를 출력하는 것만으로는 통과하지 않습니다. 일반 응답은 되는데 파일 읽기만 실패하면 모델·서버의 도구 지원, 실행 방식, 작업 폴더와 도구 권한을 확인합니다. 이 한 번의 성공은 다른 도구나 모든 작업의 신뢰성을 보장하지 않습니다.
추가로 models status --probe를 사용할 경우에는 현재 CLI 설명의 실행 조건을 지켜야 합니다. 직접 probe는 상태 디렉터리를 독점하므로 실행 중인 Gateway를 먼저 중지하고, 명령 결과가 나온 뒤에도 작업과 정리가 끝날 때까지 기다린 후 다시 시작합니다. 실제 호출에 토큰 사용과 비용이 발생할 수 있습니다. 운영 Gateway를 계속 켜 두어야 한다면 위의 짧은 대화 확인을 선택합니다.
문제가 남으면 실패한 단계에 맞춰 고치세요
| 증상 | 먼저 확인할 것 |
|---|---|
| 모델 목록이 비어 있음 | 서버 실행, Gateway에서의 접속, 실제 설치·로드 상태, 수동 목록 여부 |
Unknown model | 정확한 제공업체와 태그, LM Studio의 key, vLLM의 모델 ID |
Model is not allowed | 별칭이 아닌 modelPolicy.allow 및 agent별 선택 정책 |
| 모델은 보이지만 요청이 401 | 선택된 계정·인증, Gateway 실행 사용자와 환경 |
| 기본값을 바꿨지만 대화가 이전 모델을 사용 | 해당 대화의 /model status와 고정 선택 |
| 첫 응답이 느리거나 메모리가 부족 | 모델 로딩, 양자화, 입력 컨텍스트, 호스트 메모리 |
| 답변에 도구 JSON만 출력 | 실제 도구 호출 지원, API 어댑터, parser와 template |
401이 지속되면 OpenClaw 401 인증 오류를 구분해 복구하는 방법으로 넘어가세요. Gateway 접속 토큰, 모델 API 키, CLI 로그인과 agent별 인증 선택을 구분해 다룹니다.
느린 로컬 모델에서는 로딩 시간과 생성 시간을 따로 관찰하세요. Ollama의 모델별 keep_alive나 제공업체별 timeoutSeconds를 조정할 수 있지만, 메모리 부족이나 잘못된 연결을 대기 시간 증가로 해결할 수는 없습니다. 다른 모델로 바꿀 때도 같은 짧은 응답과 파일 읽기를 반복해 실제 용도에 맞는지 판단합니다. Ollama 실행 조정 예시
자주 묻는 질문
OpenClaw에 로컬 모델을 연결하면 API 키가 필요 없나요?
같은 컴퓨터나 사설 LAN의 Ollama에는 실제 클라우드 키가 필요하지 않고 ollama-local 표시를 사용합니다. 공개 원격 서버와 Ollama Cloud에는 실제 인증이 필요합니다. LM Studio와 vLLM은 서버에서 인증을 켰는지에 따라 달라집니다. Ollama 인증 조건
Ollama 모델을 설치했는데 왜 설정 화면에 안 나오나요?
새 안내식 설정의 자동 후보는 이미 로드된 모델 중 도구 지원과 최소 16K 컨텍스트가 확인된 모델입니다. 설치만 한 모델은 자동 후보가 아닙니다. ollama ps로 로드 상태를 확인하거나 Choose connection → Local only의 명시적 설정 경로를 사용하세요. 현재 온보딩 조건
OpenClaw 기본 모델을 바꿨는데 기존 대화는 왜 그대로인가요?
기존 대화가 특정 모델에 고정되어 있을 수 있습니다. 해당 대화에서 /model status로 확인하고 기본값을 사용하려면 /model default를 실행합니다. agent별 기본 모델도 전역 설정과 다를 수 있습니다. 모델 선택 설명
작은 로컬 모델로 시작해도 되나요?
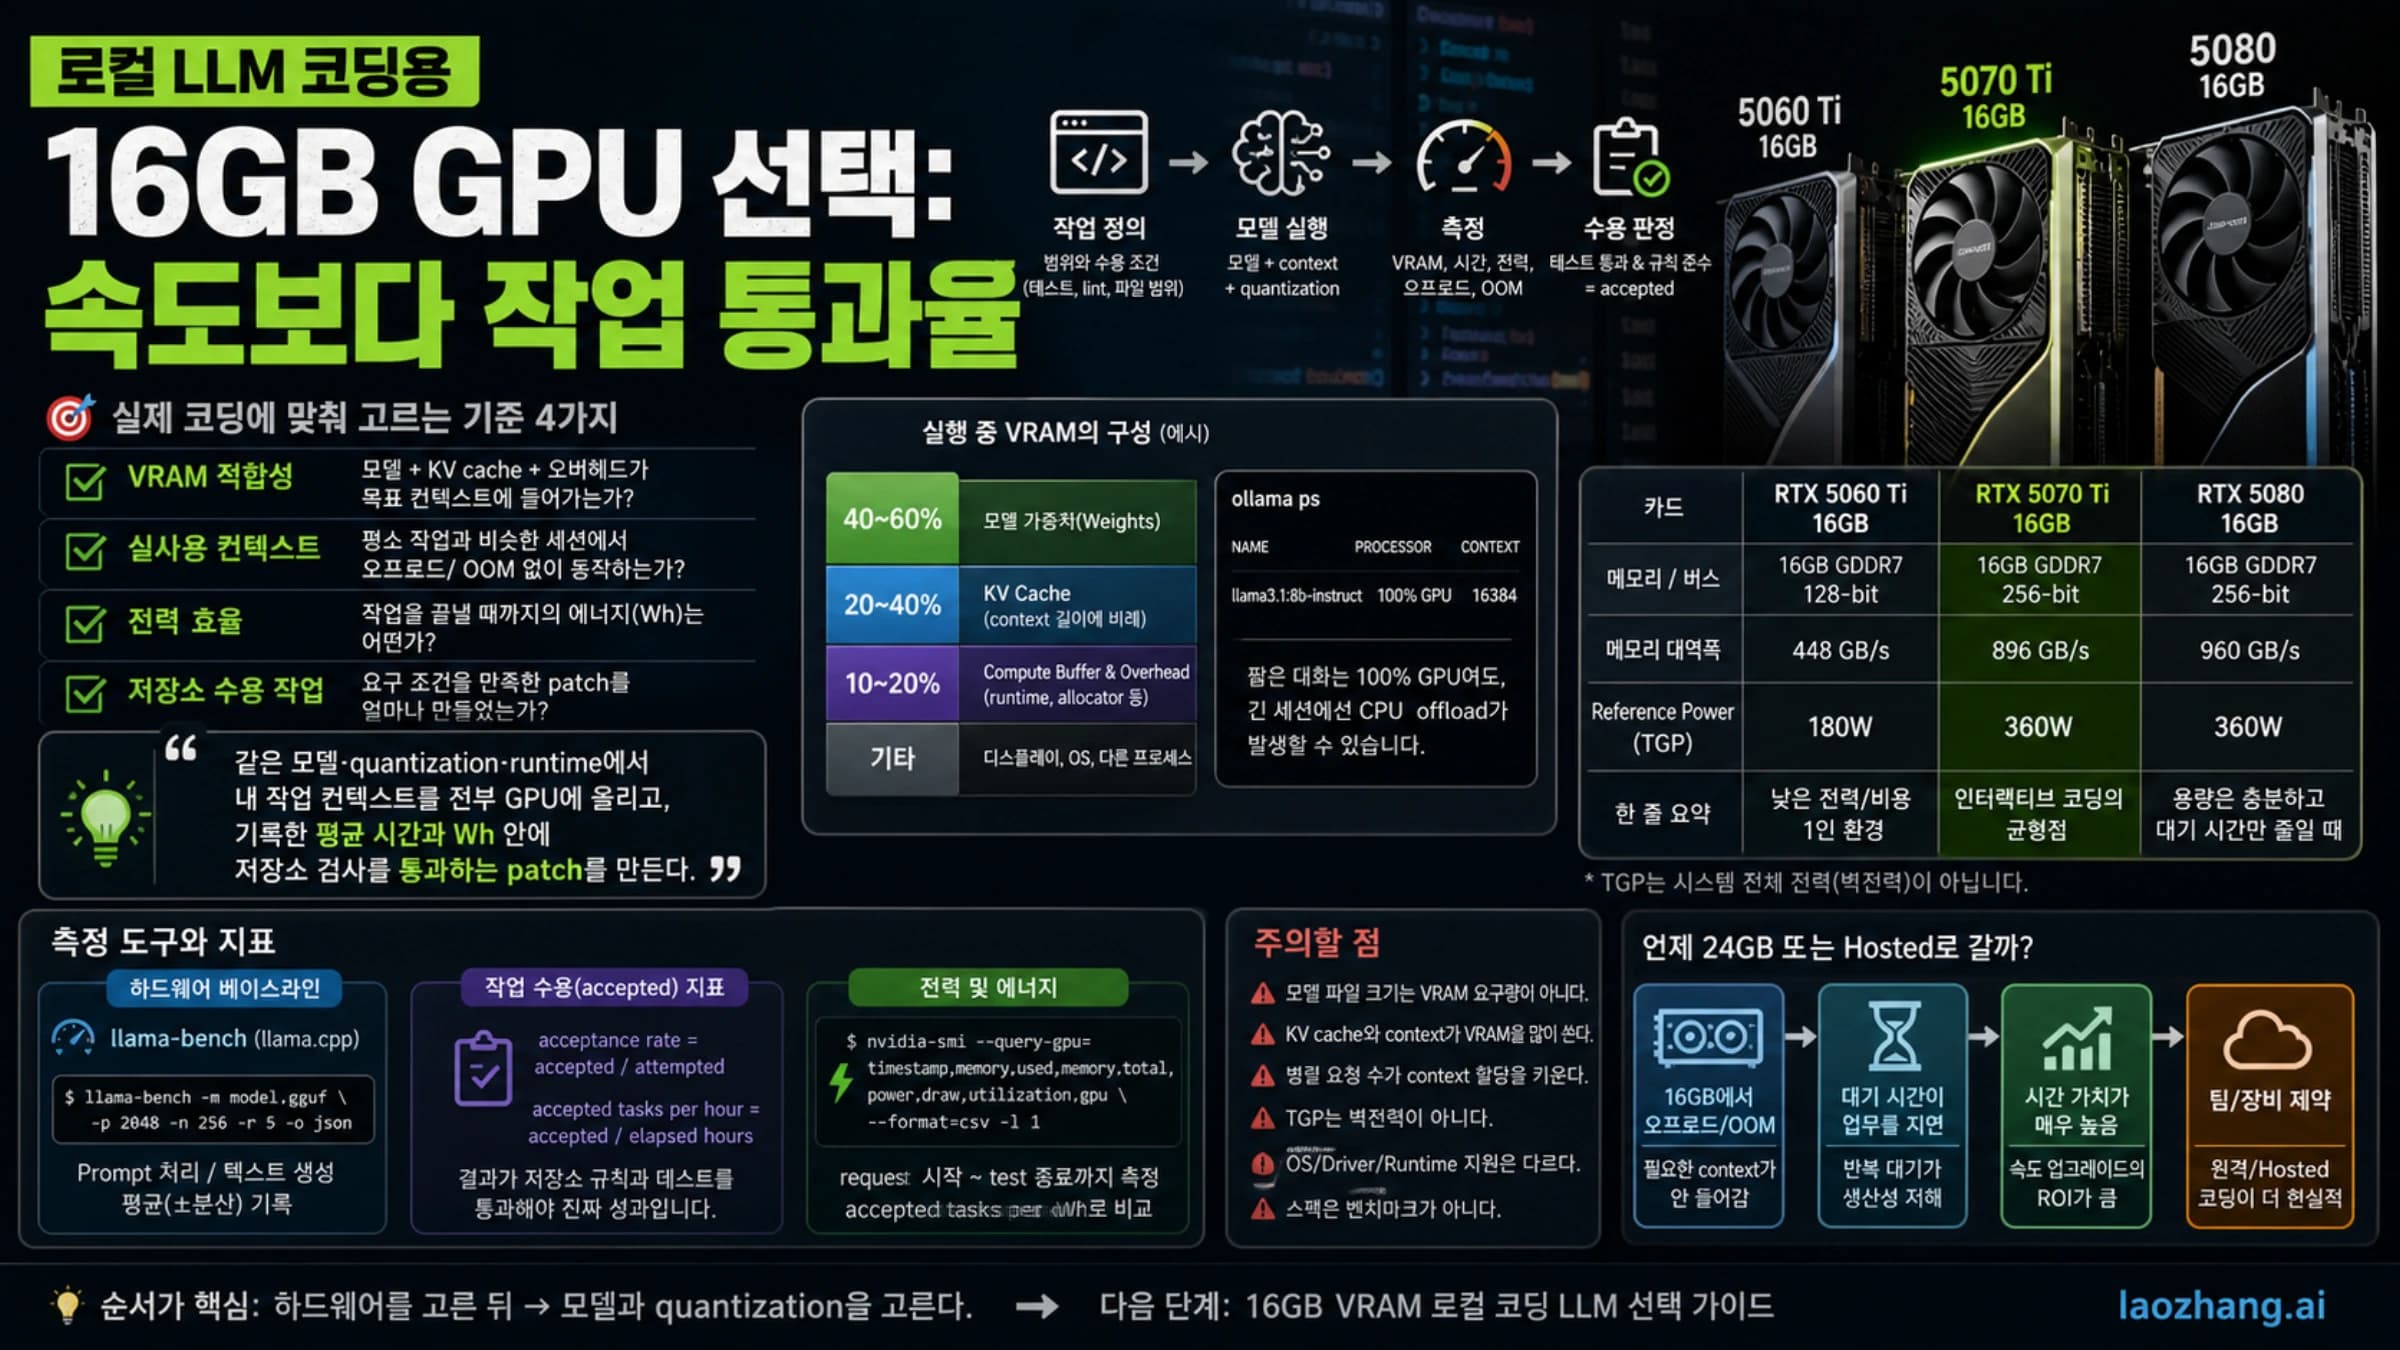
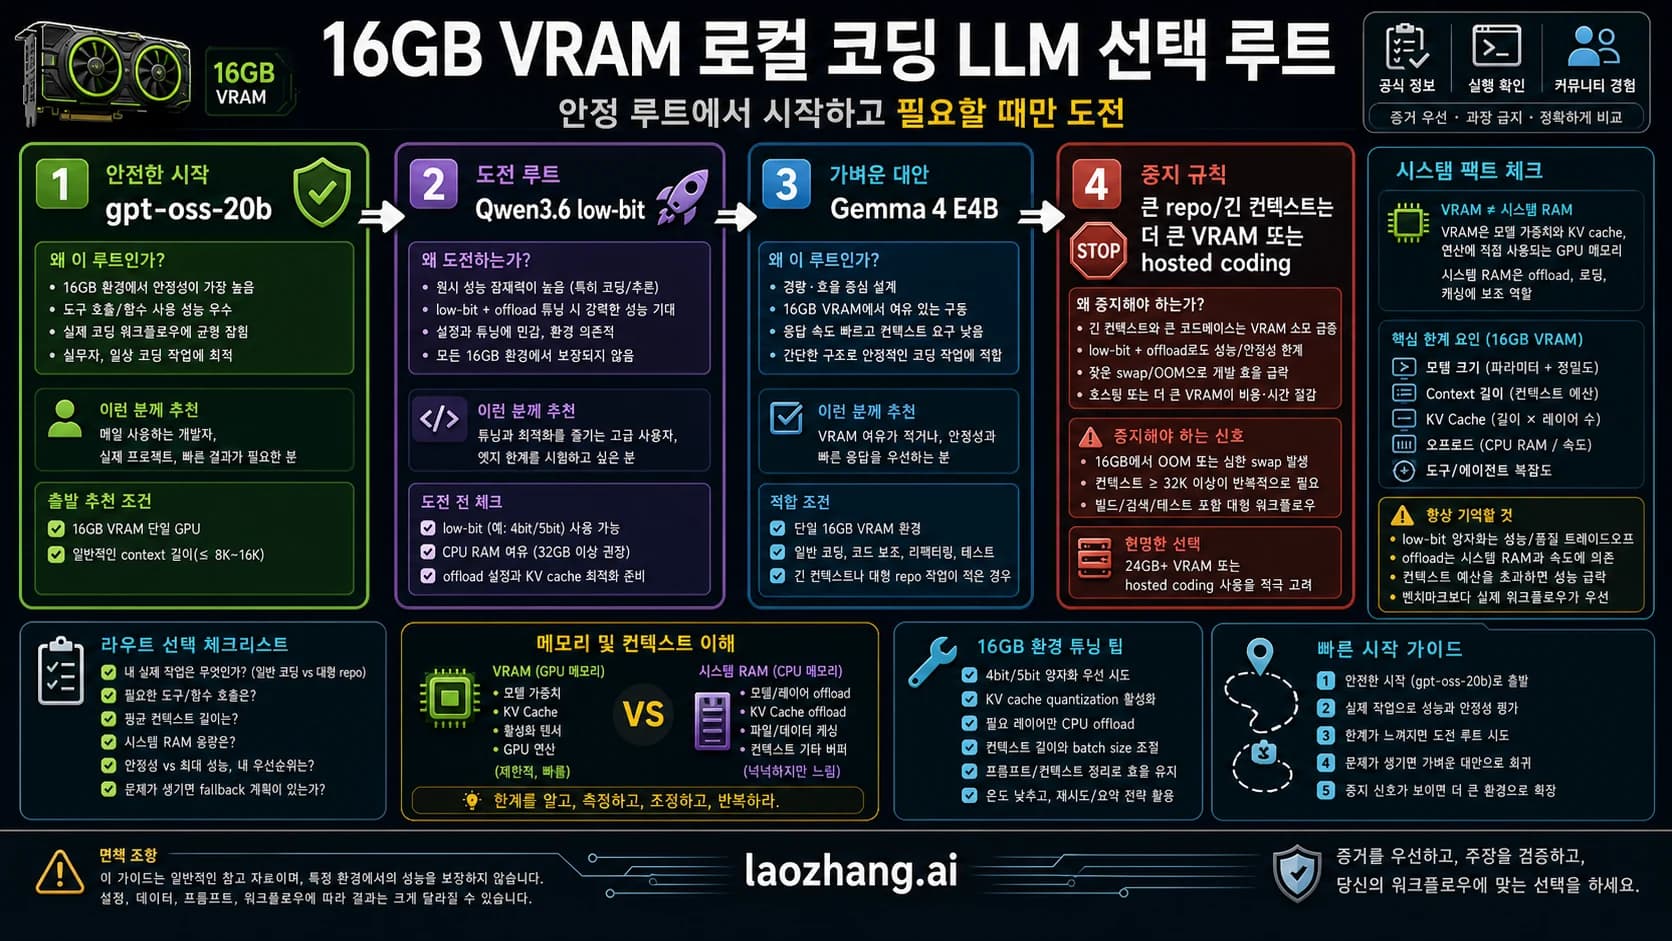
자신의 호스트에서 실행되고 실제 필요한 도구 작업을 수행하는 모델이라면 시작할 수 있습니다. 다만 파라미터 수만으로 RAM, 속도나 도구 신뢰성을 판단하지 않습니다. 양자화와 컨텍스트를 포함한 실제 설정에서 짧은 응답과 파일 읽기를 확인하고, 실패하면 연결·도구 지원·권한 중 어느 단계의 문제인지 먼저 구분하세요.