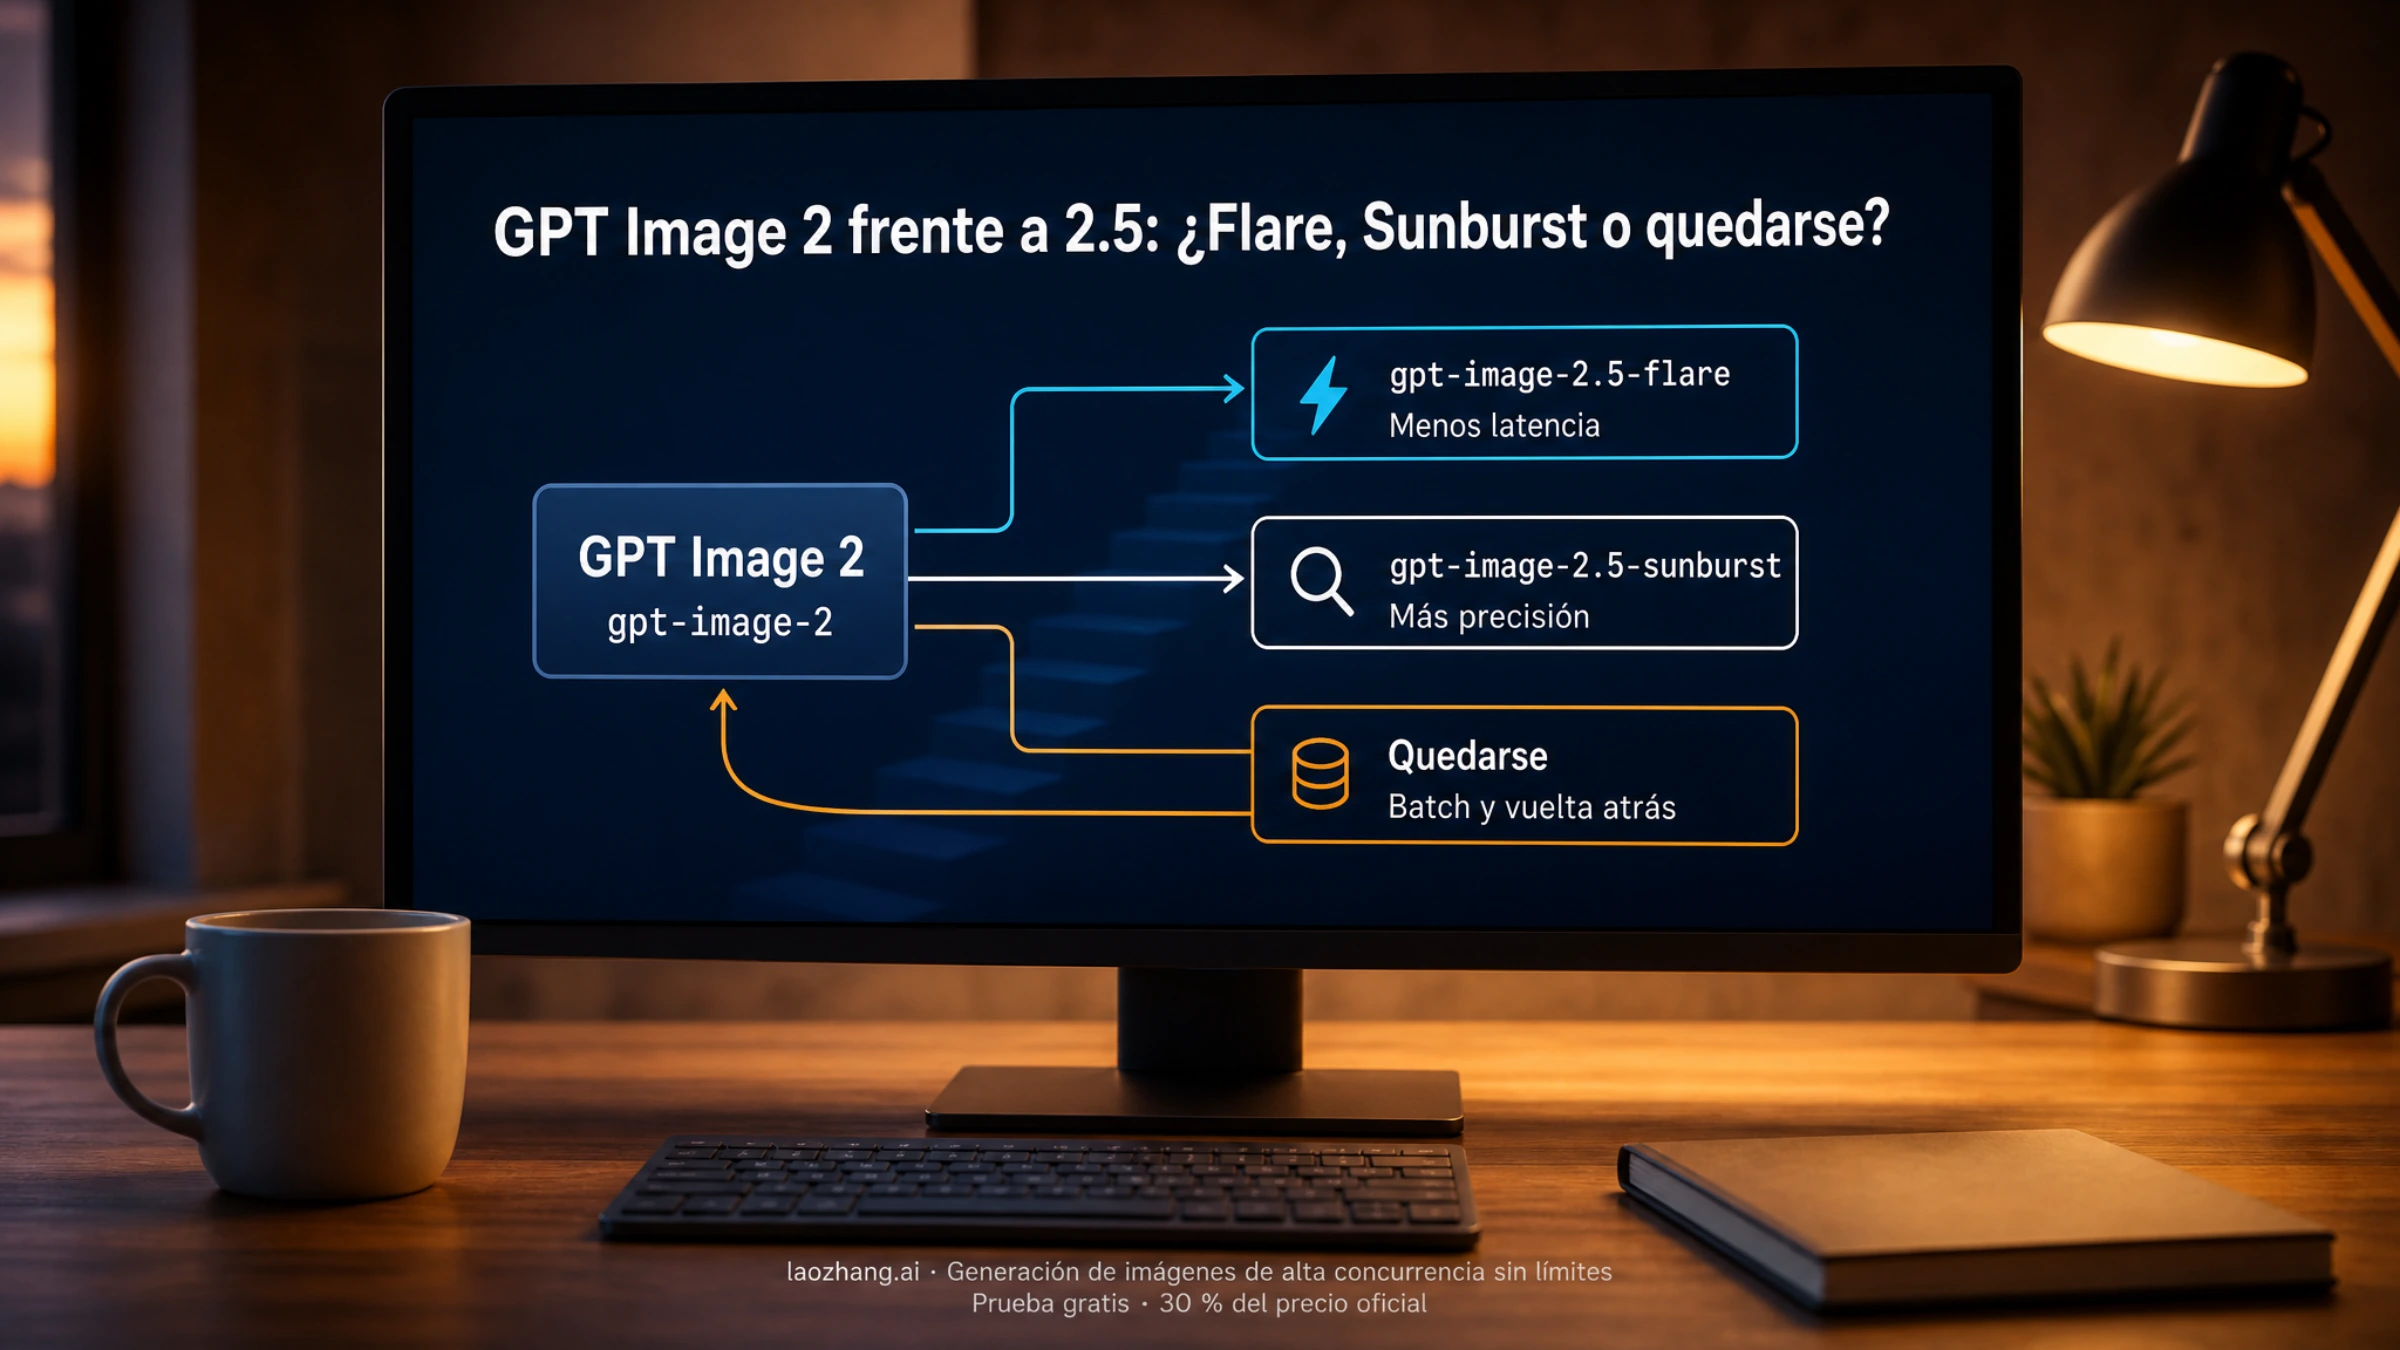
Si tu flujo con gpt-image-2 ya entrega la calidad que necesitas, prueba primero gpt-image-2.5-flare con las mismas entradas y busca solo un tiempo de respuesta menor. Si GPT Image 2 se queda corto en un encargo complejo, empieza por gpt-image-2.5-sunburst y, solo cuando cumpla, repite la prueba con Flare. Si dependes de la API Batch, quédate por ahora en GPT Image 2: es el único de los tres que aparece hoy en esa pestaña de precios. Ese es el orden que recomienda OpenAI en su guía de prompting de GPT Image 2.5, y coincide con lo que de verdad cambia entre generaciones: velocidad, dos niveles de calidad nuevos y la cantidad de tokens que consume cada etiqueta.
Lo que no cambia importa igual para decidir. Los tres modelos comparten las tarifas estándar por token, los mismos endpoints de imagen y los mismos límites de tamaño; GPT Image 2 no tiene fecha de retirada y es el reemplazo recomendado para los modelos que sí desaparecen este año. Todo lo que sigue procede de la documentación de OpenAI, de dos clasificaciones públicas y de una prueba ajena con condiciones declaradas, comprobadas el 22 de septiembre de 2026. No hemos ejecutado una comparativa de pago propia: cada cifra de velocidad o calidad lleva su origen al lado.
Si tu duda no es «¿salgo de GPT Image 2?» sino «¿Flare o Sunburst?», la comparativa entre Flare y Sunburst resuelve esa elección con más detalle; aquí la resumimos solo donde afecta a la migración.
La decisión según tu situación
| Tu situación | Empieza por | Qué tiene que ocurrir para cambiar | Qué mantener |
|---|---|---|---|
| GPT Image 2 ya cumple tus criterios de aceptación | Flare, con el mismo prompt, referencias, tamaño y un presupuesto de tokens igualado | Que la calidad siga siendo aceptable y baje el tiempo de respuesta en tu carga real | gpt-image-2 disponible para vuelta atrás mientras siga soportado |
| GPT Image 2 falla en identidad, texto exacto, geometría de producto o ediciones encadenadas | Sunburst, para establecer primero que alcanza la calidad | Si Sunburst cumple, probar Flare con las mismas entradas; cambiar a Flare solo si también cumple y es más rápido | Sunburst cuando su ventaja de calidad sea necesaria |
Generas por lotes con v1/batch a tarifa reducida | GPT Image 2 | Que OpenAI liste los modelos 2.5 en Batch; hoy no aparecen | Tu flujo actual, revisando la pestaña Batch de precios en cada ciclo |
| Integración nueva sin flujo previo | Flare si prima la velocidad; Sunburst si el encargo es exigente | Una vez cumpla, bajar el nivel de calidad hasta donde la salida siga sirviendo | Un conjunto de prompts de referencia para repetir la prueba |
Las dos primeras filas son la tabla oficial de OpenAI con nuestras condiciones añadidas; la tercera sale de la página de precios; la cuarta, de la orientación para flujos nuevos en la misma guía.
Qué ha cambiado entre GPT Image 2 y GPT Image 2.5
GPT Image 2.5 no es un único modelo. Son dos identificadores con fecha, presentados el 8 de septiembre de 2026, que conviven con el anterior. Las fichas oficiales los describen así:
gpt-image-2 | gpt-image-2.5-flare | gpt-image-2.5-sunburst | |
|---|---|---|---|
| Snapshot vigente | gpt-image-2-2026-04-21 | gpt-image-2.5-flare-2026-09-08 | gpt-image-2.5-sunburst-2026-09-08 |
| Posicionamiento de OpenAI | Rendimiento «Higher», velocidad «Medium» | «Very fast»; «nuestro modelo más rápido para generación cotidiana de alta calidad» | Rendimiento «Highest»; «nuestro modelo más capaz para generar y editar imágenes» |
Niveles de quality | low, medium, high, auto | añade xhigh y max | añade xhigh y max |
| Entrada y salida | texto e imagen de entrada; imagen de salida; generación, edición e inpainting | igual | igual |
| Endpoints de imagen | v1/images/generations, v1/images/edits, herramienta de imagen en Responses | igual | igual |
Batch (v1/batch) | soportado, con tarifas reducidas | no aparece como soportado hoy | no aparece como soportado hoy |
| Límites de tamaño | múltiplos de 16, ratio máximo 3:1, entre 655.360 y 8.294.400 píxeles, lado máximo 3.840 | iguales | iguales |
Fuentes: fichas de GPT Image 2, Flare y Sunburst, y la guía de generación de imágenes. El identificador gpt-image-2.5 sin sufijo no existe en las fichas; Tosea.ai informa de que la API lo rechaza con un error «does not exist».
Sobre calidad y velocidad, OpenAI usa dos formulaciones que conviene citar tal cual. La guía de prompting describe Flare como «el modelo pequeño, optimizado para velocidad, con calidad de imagen comparable a GPT Image 2» y Sunburst como «el modelo base, optimizado para calidad, con calidad de imagen superior a GPT Image 2»; añade que ambos «mejoran la edición precisa y la conservación del sujeto». El anuncio de lanzamiento, en cambio, dice que Flare «entrega imágenes de mayor calidad que GPT‑Image‑2 con un 50 % menos de latencia» y que Sunburst «ofrece un nivel extra de precisión para trabajo creativo detallado con tiempos de generación más largos». «Comparable» y «mayor calidad» no son lo mismo; la propia guía cierra la discusión con una frase que vale como método: mide en tu carga, porque «una mejora de velocidad en un flujo no establece una mejora fija en otro».
GPT Image 2 sigue vigente y es el destino de los modelos antiguos
La página de obsolescencias no contiene ninguna entrada para gpt-image-2 ni para los dos modelos 2.5. Sí contiene el calendario contrario: gpt-image-1 se apaga el 23 de octubre de 2026, y gpt-image-1.5, gpt-image-1-mini y chatgpt-image-latest el 1 de diciembre de 2026, todos con gpt-image-2 como reemplazo recomendado. DALL·E 2 y 3 ya se retiraron el 12 de mayo de 2026.
Para quien viene de GPT Image 1 o 1.5, esto significa que la migración natural hoy es a GPT Image 2, no directamente a 2.5, salvo que necesites xhigh, max o la latencia de Flare. Para quien ya usa GPT Image 2, significa que no hay prisa impuesta por OpenAI: la ausencia de aviso no es una promesa de permanencia, pero la guía pide mantener el modelo anterior para vuelta atrás «mientras siga soportado», y hoy lo está.
Mismas tarifas por token, pero la misma etiqueta no gasta lo mismo
La página de precios lista tarifas estándar idénticas para los tres modelos: 5 USD por millón de tokens de texto de entrada (1,25 USD en caché), 8 USD por millón de tokens de imagen de entrada (2 USD en caché) y 30 USD por millón de tokens de imagen de salida; la salida de texto no se factura. Las fichas de Flare y Sunburst lo confirman con la frase «Token rates match GPT Image 2».
Que la tarifa sea la misma no significa que la imagen cueste lo mismo. El precio por imagen depende de cuántos tokens de salida consume cada modelo en cada nivel de calidad, y ahí está el cambio que más sorprende al migrar. La guía lo advierte sin rodeos: «la misma etiqueta de calidad no implica la misma calidad de imagen ni el mismo tiempo de respuesta entre modelos». La calculadora oficial de tokens de salida, leída en vivo el 22 de septiembre de 2026, lo cuantifica. Para 1024×1024:
Etiqueta quality | GPT Image 2 (tokens de salida, coste estimado) | GPT Image 2.5, Flare y Sunburst (tokens de salida, coste estimado) |
|---|---|---|
low | 196 (0,0059 USD) | 196 (0,0059 USD) |
medium | 1.756 (0,0527 USD) | 439 (0,0132 USD) |
high | 7.024 (0,2107 USD) | 1.756 (0,0527 USD) |
xhigh | no existe | 3.122 (0,0937 USD) |
max | no existe | 7.024 (0,2107 USD) |
La lectura es directa: high en 2.5 usa el presupuesto de medium en GPT Image 2, y max en 2.5 usa el de high en GPT Image 2; low coincide en ambas generaciones y medium y xhigh de 2.5 quedan en escalones intermedios. La calculadora agrupa Sunburst y Flare en una sola opción, excluye los tokens de entrada y las imágenes parciales del streaming (100 tokens de salida cada una) y no puede estimar auto. A 2048×1152 la escalera se repite con otros números: 157 / 1.413 / 5.650 para GPT Image 2 y 157 / 367 / 1.413 / 2.511 / 5.650 para 2.5.
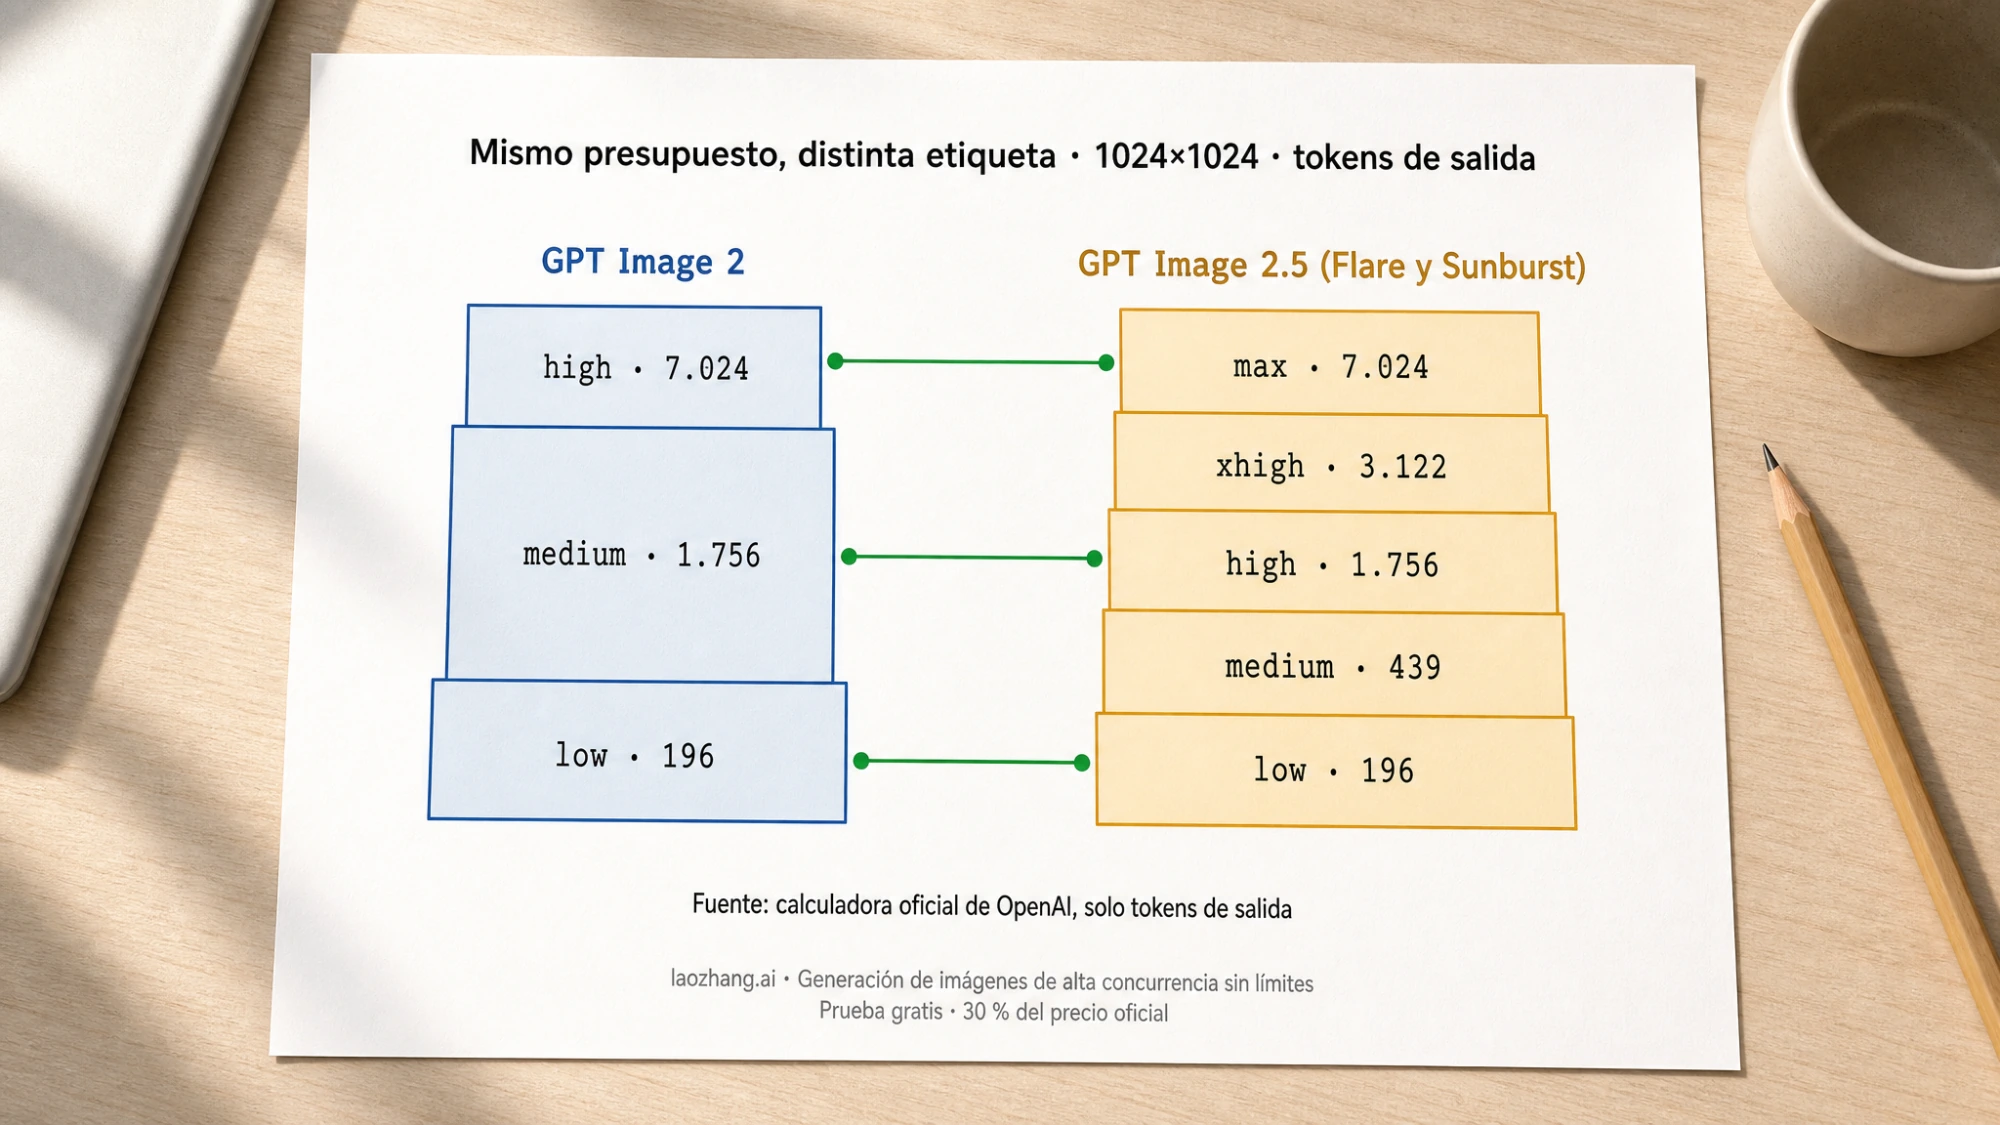
La consecuencia práctica: si solo sustituyes la cadena del modelo y dejas quality: "medium", una imagen que antes salía con 1.756 tokens pasará a salir con 439. La factura de salida bajará a una cuarta parte y el resultado será distinto, pero no porque el modelo nuevo sea peor, sino porque le has dado menos presupuesto. Tosea.ai, que hizo esa prueba a 2048×1152, describe el mismo efecto: de 1.413 a 367 tokens, composición más simple y una factura que se reduce aproximadamente a la mitad. La comparación justa se hace a presupuesto igualado, no a etiqueta igualada.
De aquí sale también la afirmación, repetida en varias comparativas en español e inglés, de que «GPT Image 2.5 cuesta el doble» o «GPT Image 2 cuesta la mitad». Las cifras que citan (2,50 USD por texto, 4 USD por imagen de entrada, 15 USD por imagen de salida) son exactamente las de la pestaña Batch de GPT Image 2, que es la mitad de la tarifa estándar. En la pestaña estándar los tres modelos cuestan lo mismo. Batch existe solo para gpt-image-2; las fichas de los dos modelos 2.5 muestran v1/batch como no soportado. Si tu ahorro actual viene de Batch, migrar a 2.5 sí te sale más caro por token, pero por perder Batch, no porque 2.5 tenga otra tarifa. La guía de precios de GPT Image 2 desarrolla el cálculo con Batch, y la guía de precios de GPT Image 2.5 el presupuesto por nivel en los modelos nuevos.
Qué miden las clasificaciones y la única prueba con presupuesto igualado
Como OpenAI no publica mediciones, las cifras independientes disponibles son de dos tipos: votos ciegos y una prueba ajena con sus condiciones.
En Arena, con la página indicando «última actualización 7 de septiembre de 2026», la clasificación de texto a imagen sitúa a Sunburst en el primer puesto con 1421 ±13 (3.149 votos, marcado «Preliminary»), Flare en el segundo con 1399 ±13 (2.856 votos, «Preliminary») y GPT Image 2 en calidad medium en el tercero con 1381 ±4 (78.731 votos). En edición de imagen el orden es el mismo: 1520, 1491 y 1461. Los intervalos de los modelos 2.5 son tres veces más anchos que el de GPT Image 2 porque tienen unas veinticinco veces menos votos; los 18 puntos que separan a Flare de GPT Image 2 apenas superan la suma de esas dos incertidumbres.
En Artificial Analysis la clasificación compara Sunburst en max (1197 ±9, 13.401 comparaciones), Flare en max (1190 ±9, 12.778) y GPT Image 2 en high (1171 ±9, 15.176). Esa pareja max frente a high es coherente con la calculadora: los dos niveles consumen 7.024 tokens a 1024×1024, y el precio por mil imágenes que Artificial Analysis lista para cada entrada es casi idéntico (210,7 frente a 211,0 USD). Ninguna de las dos clasificaciones mide velocidad ni coste por imagen aceptada.
La única fuente leída que comparó los tres a presupuesto igualado es la prueba propia de Tosea.ai del 9 de septiembre de 2026: 41 llamadas al endpoint oficial images/edits con un prompt de guion y una a tres referencias de plantilla, diapositivas de empresa densas a 2048×1152, una sola pasada sin reintentos y medias de cinco páginas. Con 1.413 tokens de salida en los tres (medium en GPT Image 2, high en los 2.5), GPT Image 2 tardó 37,3 s de media, Sunburst 27,7 s y Flare 19,7 s; es decir, Flare un 47 % más rápido y Sunburst un 26 %, con unos 0,059 USD por página en los tres. En 5.650 tokens: 82,9, 59,8 y 33,7 s. En deriva tras una, dos y tres ediciones encadenadas, los píxeles cambiados fueron 5,6 / 8,1 / 11,4 % en GPT Image 2, 4,1 / 6,8 / 9,9 % en Sunburst y 3,8 / 6,7 / 9,2 % en Flare. Los textos y cifras salieron correctos en las 15 diapositivas con los tres modelos.
Ese resultado apoya la afirmación de latencia de OpenAI en un flujo concreto y sugiere que ambos 2.5 conservan algo mejor entre ediciones. No dice nada de retratos, conservación de personas a partir de fotos, fondos transparentes ni inpainting con máscara, que el autor no probó, ni de p95, porque no hubo repeticiones por página. Si tu flujo es alguno de esos, la prueba de Tosea te sirve de guion, no de veredicto.
Cómo migrar sin cambiar el presupuesto ni el coste sin querer
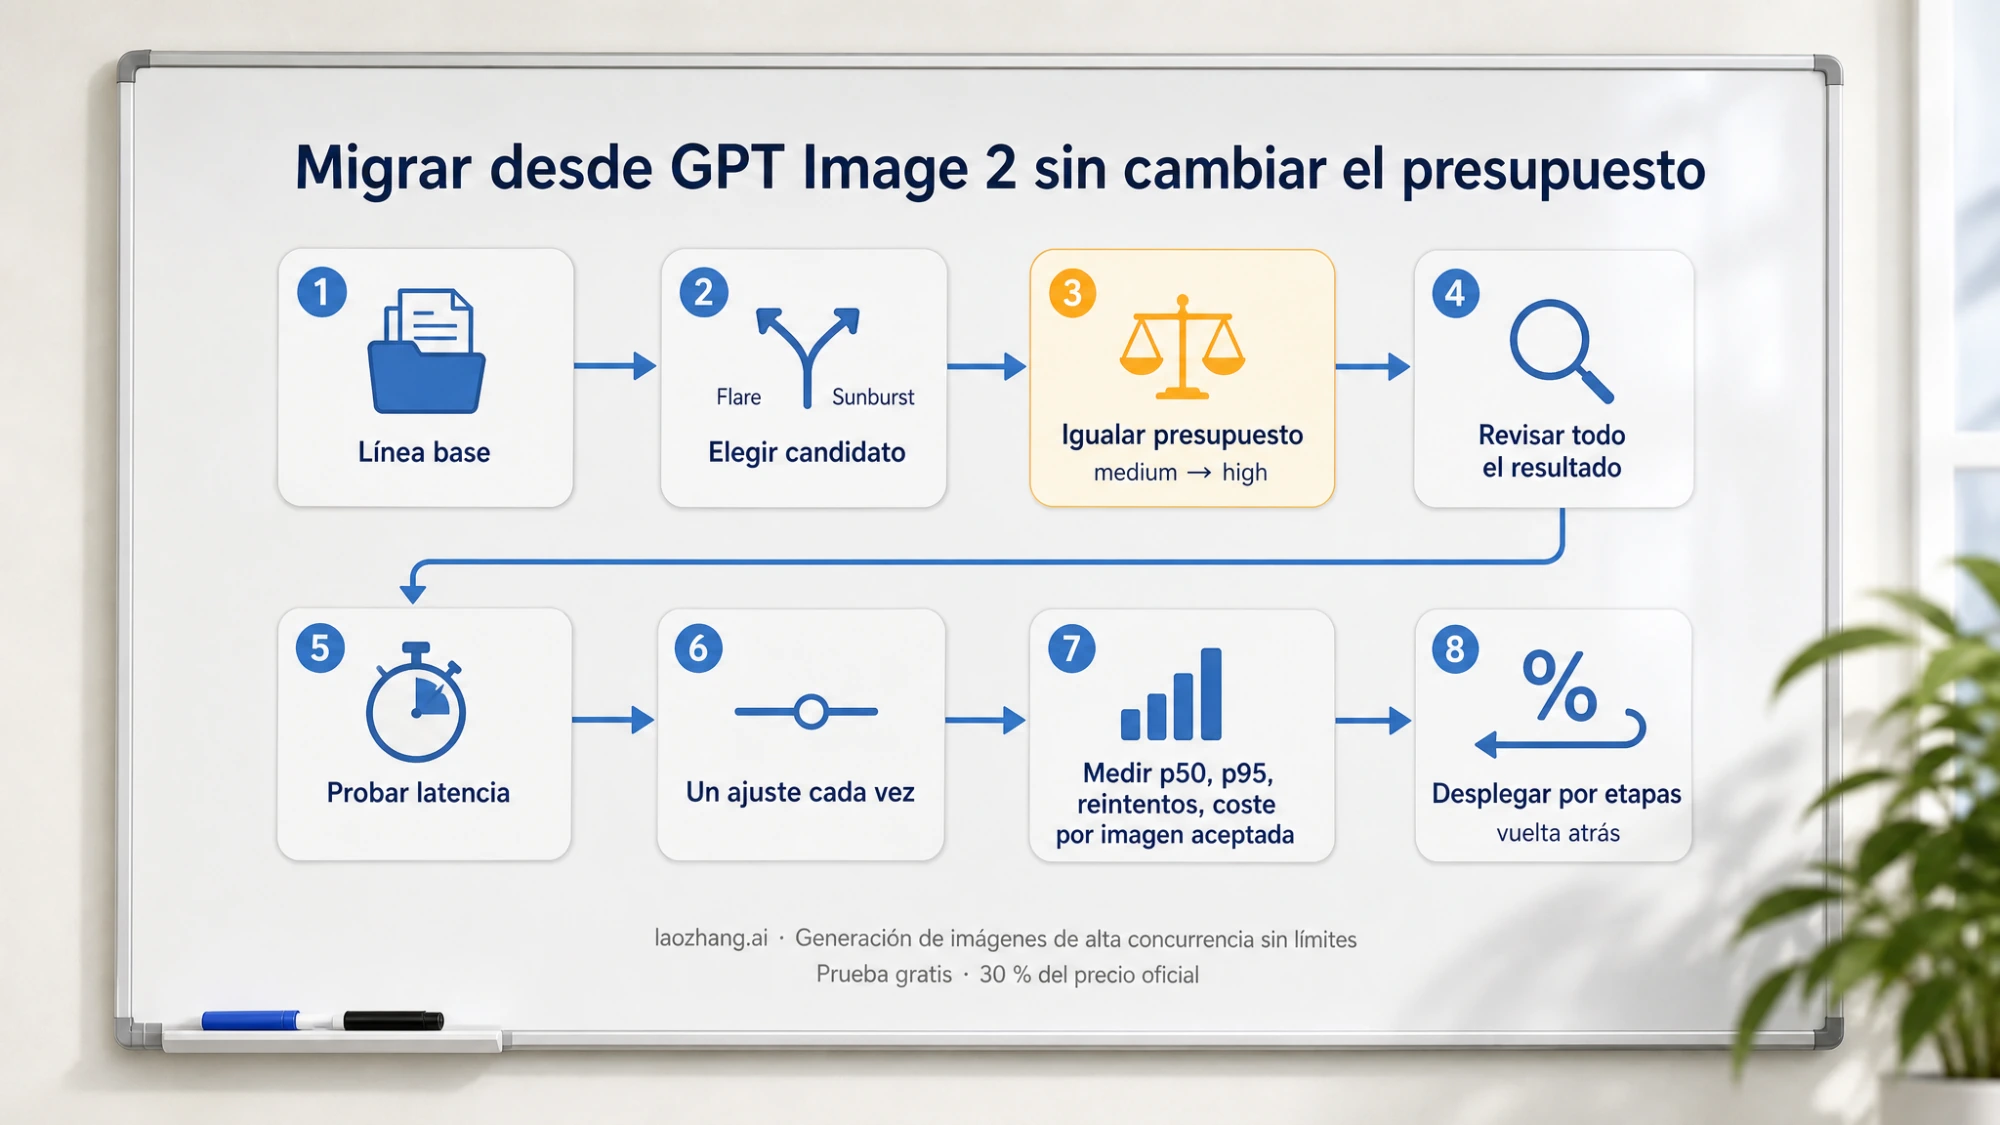
La guía oficial describe una migración por etapas; lo que sigue la ordena para que el cambio de presupuesto no se cuele entre la primera y la última.
-
Guarda una línea base con GPT Image 2. Reúne prompts de producción representativos, incluidas las ediciones difíciles, el texto que debe salir exacto, caras, geometría de producto y recursos con transparencia. Anota el modelo, los ajustes de cada petición y, sobre todo, el campo
usagede las respuestas: es el consumo real facturado, no una estimación. Entre 20 y 50 peticiones es la muestra que suelen proponer las guías de migración de terceros y basta para ver la dispersión entre repeticiones. -
Elige el primer candidato según tu situación, con la tabla del principio: Flare si GPT Image 2 ya cumple, Sunburst si no. Para la primera comparación conserva el prompt, las referencias, las dimensiones y el formato de salida.
-
Iguala el presupuesto, no la etiqueta. Si tu línea base usa
mediumen GPT Image 2, la etiqueta equivalente en 2.5 eshigh; si usahigh, la equivalente esmax;lowse mantiene. Cambiar solo el modelo y dejar la etiqueta convierte la prueba en una comparación entre presupuestos distintos.
bash# Línea base: GPT Image 2, medium = 1.756 tokens de salida a 1024x1024
curl https://api.openai.com/v1/images/generations \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2",
    "prompt": "Fotografía de producto de una botella de aceite de oliva sobre mármol claro, luz lateral suave",
    "quality": "medium",
    "size": "1024x1024"
  }'

# Candidato con el mismo presupuesto: Flare, high = 1.756 tokens de salida
curl https://api.openai.com/v1/images/generations \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.5-flare",
    "prompt": "Fotografía de producto de una botella de aceite de oliva sobre mármol claro, luz lateral suave",
    "quality": "high",
    "size": "1024x1024"
  }'
Compara después el usage.output_tokens de ambas respuestas; si no coinciden con la calculadora, el propio usage manda. Con auto no hay equivalencia garantizada: en la prueba de Tosea, los 2.5 en auto cayeron en el escalón de 1.413 tokens cuatro de cinco veces y una vez en 628.
-
Revisa el resultado completo, no solo la zona pedida. Seguimiento de instrucciones, conservación de identidad y producto, exactitud del texto, cambios no solicitados y canal alfa en los recursos transparentes. Repite las peticiones para medir consistencia y, en flujos de edición, prueba la secuencia entera además de cada paso. Si un recurso sale con fondo transparente, la guía de PNG transparentes explica qué comprobar en bordes, cristal y sombras.
-
Busca la ganancia de latencia solo cuando la calidad ya pasa. Si empezaste por Sunburst y cumple, evalúa Flare con las mismas exigencias; cambia solo si la calidad se mantiene y baja el tiempo. Si no, quédate en Sunburst.
-
Ajusta un parámetro cada vez. Compara niveles de calidad antes de reescribir el prompt. No cambies la calidad, el prompt y el modelo a la vez: no sabrás a qué atribuir la diferencia.
-
Mide lo que decide el presupuesto real: respuesta típica y lenta (p50 y p95), fallos, reintentos y coste por imagen aceptada. La guía lo dice literalmente: «confirma el precio vigente en lugar de asumir que el modelo más rápido cuesta menos».
-
Despliega por flujo y conserva la vuelta atrás. Mueve una parte pequeña del tráfico al modelo nuevo, vigila las mismas métricas y amplía gradualmente. Fija el snapshot
gpt-image-2-2026-04-21en tu configuración de reserva mientras siga soportado.
El coste por imagen aceptada es la cifra que resume todo lo anterior: intentos facturados (entrada, salida, parciales y reintentos) dividido entre salidas aceptadas. Un ejemplo hipotético, solo con tokens de salida y solo para ver la mecánica: 100 peticiones a 1024×1024 con 1.756 tokens cuestan 5,27 USD de salida en cualquiera de los tres modelos. Si aceptas 80, cada imagen aceptada sale a 0,066 USD; si aceptas 90, a 0,059 USD. Un modelo que acepta un 10 % más de resultados es más barato aunque cobre exactamente lo mismo por token, y uno que obliga a repetir el 30 % de las peticiones es más caro aunque parezca igual de barato en la tabla de precios. Si en algún flujo no aceptas ninguna imagen, el coste por imagen aceptada no está definido y la comparación de precios deja de tener sentido: primero hay que resolver la calidad.
Preguntas que surgen al cambiar el identificador
¿Puedo seguir llamando a gpt-image-2 y probar 2.5 en paralelo? Sí. Los tres modelos se seleccionan directamente en v1/images/generations y v1/images/edits, y las fichas de los 2.5 indican que también funcionan como modelo de la herramienta image_generation de la API Responses, donde se factura además el modelo principal. La guía de GPT-Image-2 API muestra ambas vías de integración para el modelo actual; el parámetro model es lo único que cambia.
¿Merece la pena migrar si mis prompts ajustados en GPT Image 2 ya pasan? Solo si la latencia te cuesta algo medible. En esa situación, el candidato oficial es Flare con presupuesto igualado; la calidad, según OpenAI, es «comparable» (guía) o «mayor» (anuncio), y la ganancia de tiempo declarada es de un 50 % menos, con un 47 % en la única prueba ajena a presupuesto igual. Si tu cola de generación no bloquea a nadie y tus prompts están afinados, GPT Image 2 sigue siendo una elección válida y soportada.
¿Cuándo usar xhigh o max? Solo cuando un requisito de calidad no se cumple en high y te cabe en el presupuesto de latencia; max cuesta lo mismo que high de GPT Image 2 y xhigh queda a medio camino. La guía avisa de que un nivel más alto no garantiza un mejor resultado para cada prompt. Si al subir el nivel aparecen grano o patrones, la guía sobre ruido en GPT Image 2.5 explica dónde buscar la causa antes de retocar.
¿Qué hago si genero por lotes? Mantener GPT Image 2 en Batch, que hoy tiene tarifas a la mitad de las estándar, y comprobar la pestaña Batch de la página de precios en cada revisión: los modelos 2.5 no aparecen hoy, lo que no es una promesa en ningún sentido. Si tus lotes no son sensibles al tiempo y aceptan casi todo, Batch en GPT Image 2 puede seguir siendo más barato por imagen aceptada que cualquier 2.5 estándar.
¿Y si vengo de GPT Image 1 o 1.5? Migra primero a GPT Image 2, que es el reemplazo recomendado antes de los apagados del 23 de octubre y del 1 de diciembre de 2026, y usa las pestañas de referencia de cada modelo para revisar los parámetros que cambian en lugar de copiar los ajustes antiguos. Desde ahí, la decisión de 2.5 es la misma que la de este artículo.
La decisión, en resumen: GPT Image 2 se queda para quien no gana nada con la migración y para quien usa Batch; Flare es el primer candidato cuando el flujo ya funciona y quieres tiempo; Sunburst es el primer candidato cuando el flujo no funciona. En los tres casos, cambia la etiqueta de calidad junto con el modelo y compara el usage antes de creerte cualquier cifra de coste, incluidas las de este artículo.