Gemini 3.5 Flash: capacidades, funciones y cómo usar su API hoy
Gemini 3.5 Flash sirve para código, documentos y herramientas, pero su ID en Developer API responde ahora con 3.6. Aprende qué admite y cómo adaptar la integración.
En esta página
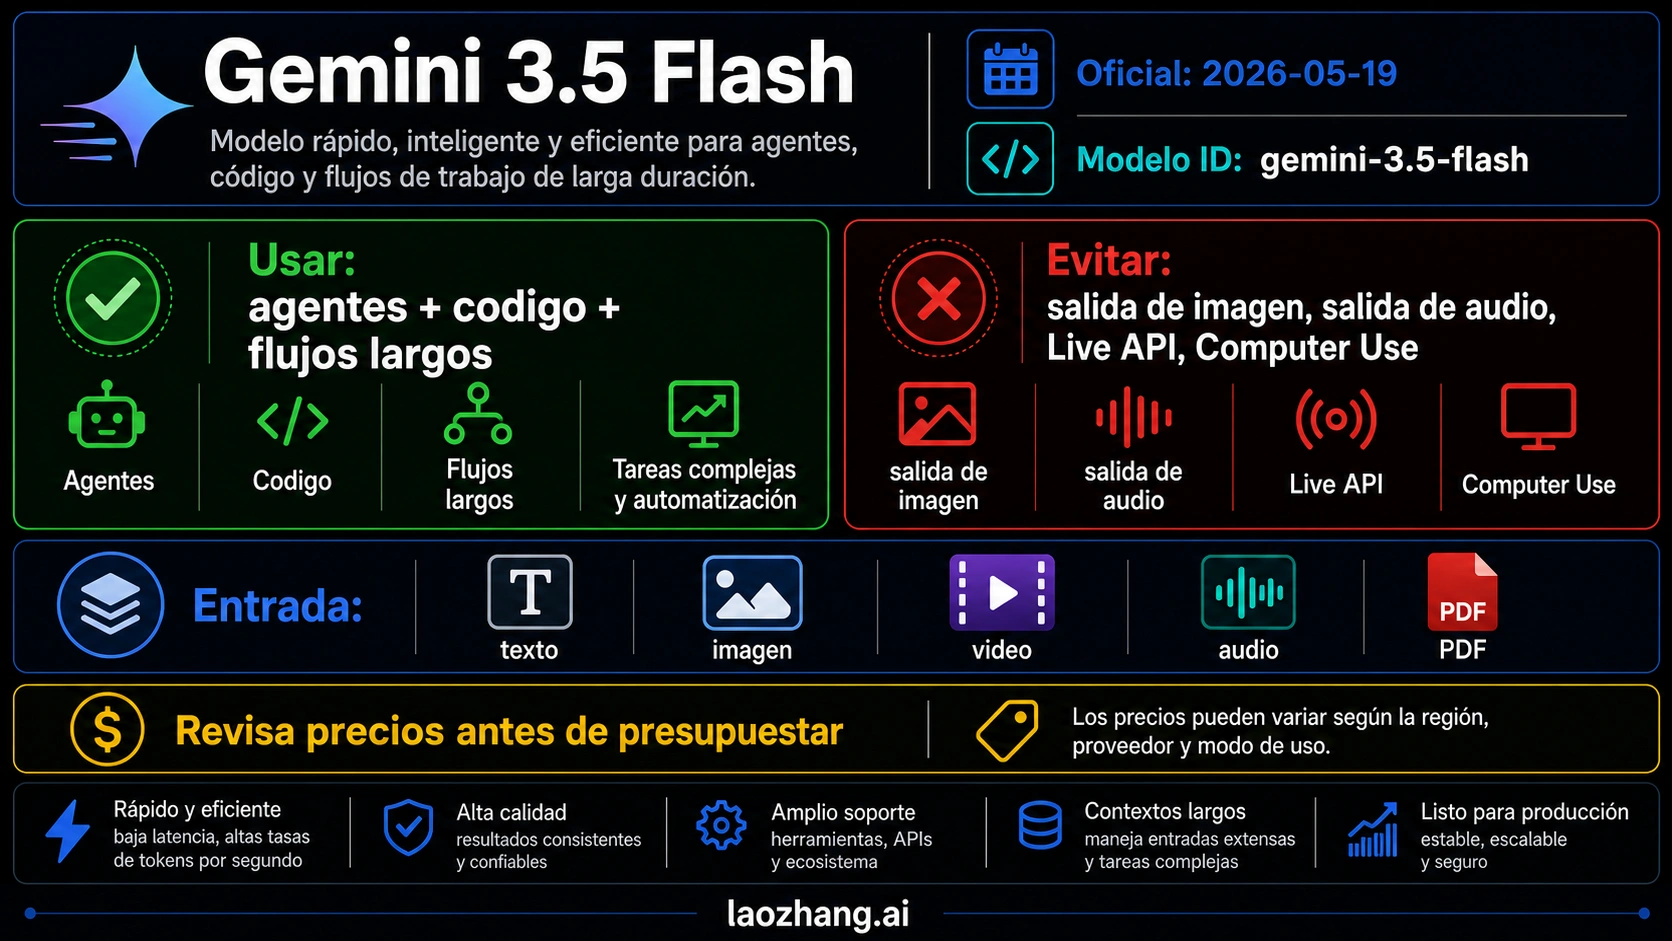
Gemini 3.5 Flash puede analizar texto, imágenes, vídeo, audio y PDF, producir texto y participar en flujos de programación y herramientas. Si lo utilizas mediante Gemini Developer API, hay un cambio esencial: las solicitudes a gemini-3.5-flash se dirigen automáticamente a gemini-3.6-flash. Para una integración nueva o mantenida, usa el ID explícito gemini-3.6-flash y revisa los parámetros heredados. La ficha oficial de 3.5 Flash explica esta sustitución.
La capacidad del modelo sigue siendo una pregunta útil: sirve para revisar código con contexto, extraer información de documentos y decidir qué función necesita una aplicación. No genera imágenes ni audio y no admite Live API. Además, que sugiera una acción no implica que tu aplicación ya la haya ejecutado. Estas diferencias determinan si encaja en tu producto antes de comparar velocidad o coste.
La información que sigue corresponde a la documentación consultada el 14 de octubre de 2026. El servicio de Google Cloud y la aplicación de Gemini tienen condiciones propias; el nombre del modelo por sí solo no identifica la API que estás usando.
Qué ocurre ahora al llamar a gemini-3.5-flash
Google anunció la sustitución en Developer API el 8 de octubre de 2026. El modelo original ya no se puede seleccionar en AI Studio, pero el endpoint antiguo no se está cerrando: conserva las solicitudes y las dirige a 3.6 Flash. La fila específica del calendario de retirada lo dice expresamente; no conviene interpretar la palabra «obsoleto» como un fallo inmediato de conexión. La fecha del cambio está en el registro oficial.
Esto tiene dos consecuencias prácticas. Primero, dejar el ID antiguo en tu configuración no conserva el comportamiento del modelo de mayo. Segundo, comparar hoy gemini-3.5-flash con gemini-3.6-flash en Developer API no equivale a comparar dos modelos independientes. Cambia el ID para que la configuración exprese tu elección y registra el campo modelVersion de la respuesta, que identifica la versión utilizada según la referencia de la API.
En Google Cloud el ciclo de vida es distinto. La ficha de Gemini Enterprise Agent Platform mantiene gemini-3.5-flash como GA y sitúa su retirada el 19 de mayo de 2027 o después. Admite GenerateContent y Chat Completions, pero no Interactions ni Live. Esa ficha separa explícitamente el soporte de Cloud del de Gemini API. Por tanto, una fecha de Cloud no invalida la redirección de Developer API ni demuestra que tu proyecto tenga acceso efectivo al modelo. Consulta la ficha de Cloud; si necesitas elegir plataforma por autenticación o controles empresariales, continúa con Gemini API o Vertex AI.
Capacidades: qué entra, qué sale y qué puedes construir
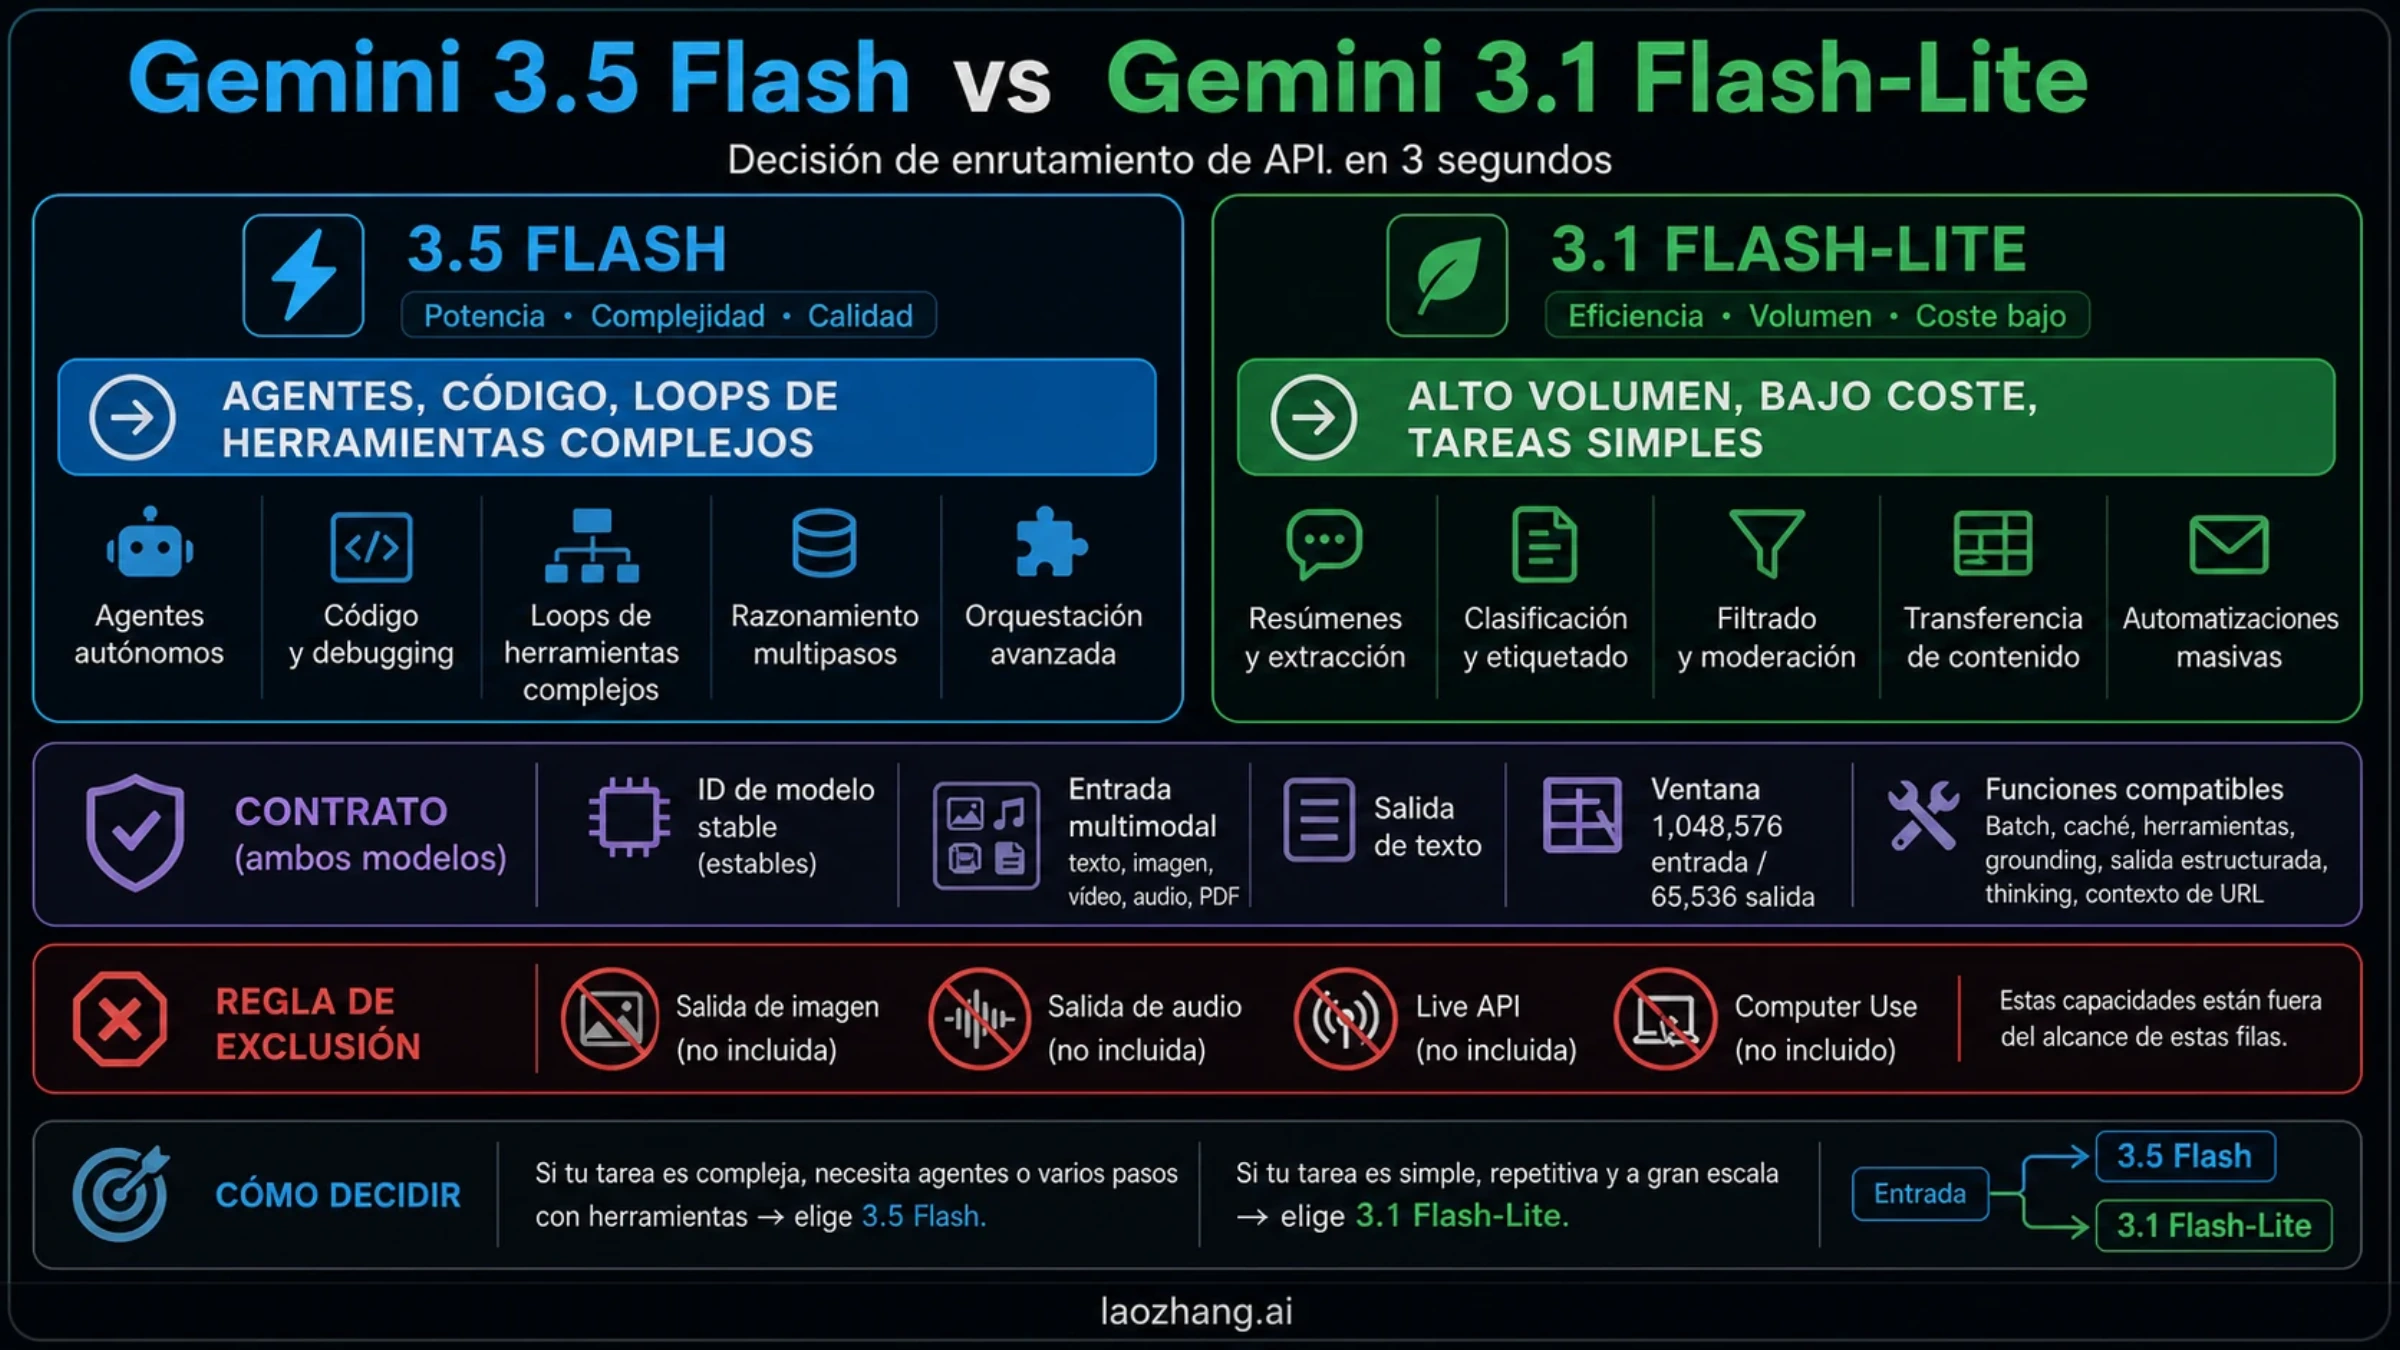
Las fichas de 3.5 Flash y de su sustituto 3.6 Flash indican 1.048.576 tokens de entrada y hasta 65.536 tokens de salida, con entrada multimodal y salida de texto. No significa que pueda devolver un millón de tokens ni que recuerde con precisión todos los detalles de un documento extenso.
| Necesidad | Capacidad relevante | Cómo aprovecharla |
|---|---|---|
| Entender una incidencia con capturas y registros | Texto e imágenes como entrada | Adjunta el material y pide una explicación que cite los detalles utilizados. |
| Revisar documentos | PDF, contexto amplio y búsqueda de archivos | Pide campos o conclusiones concretas y comprueba su correspondencia con el documento. |
| Analizar grabaciones | Audio y vídeo como entrada | Solicita una transcripción, un resumen o una descripción en texto; no una pista de audio nueva. |
| Integrarlo en un proceso empresarial | Llamadas a funciones y salida estructurada | Define funciones y un esquema; valida los argumentos y la respuesta antes de usarlos. |
| Responder con información externa | Búsqueda de Google, Maps y contexto de URL | Habilita la herramienta apropiada y conserva las fuentes que respaldan la respuesta. |
| Reutilizar contexto o procesar trabajos diferidos | Caché, Batch, Flex y Priority | Elige según el plazo de respuesta y el coste, no solo por el nombre Flash. |
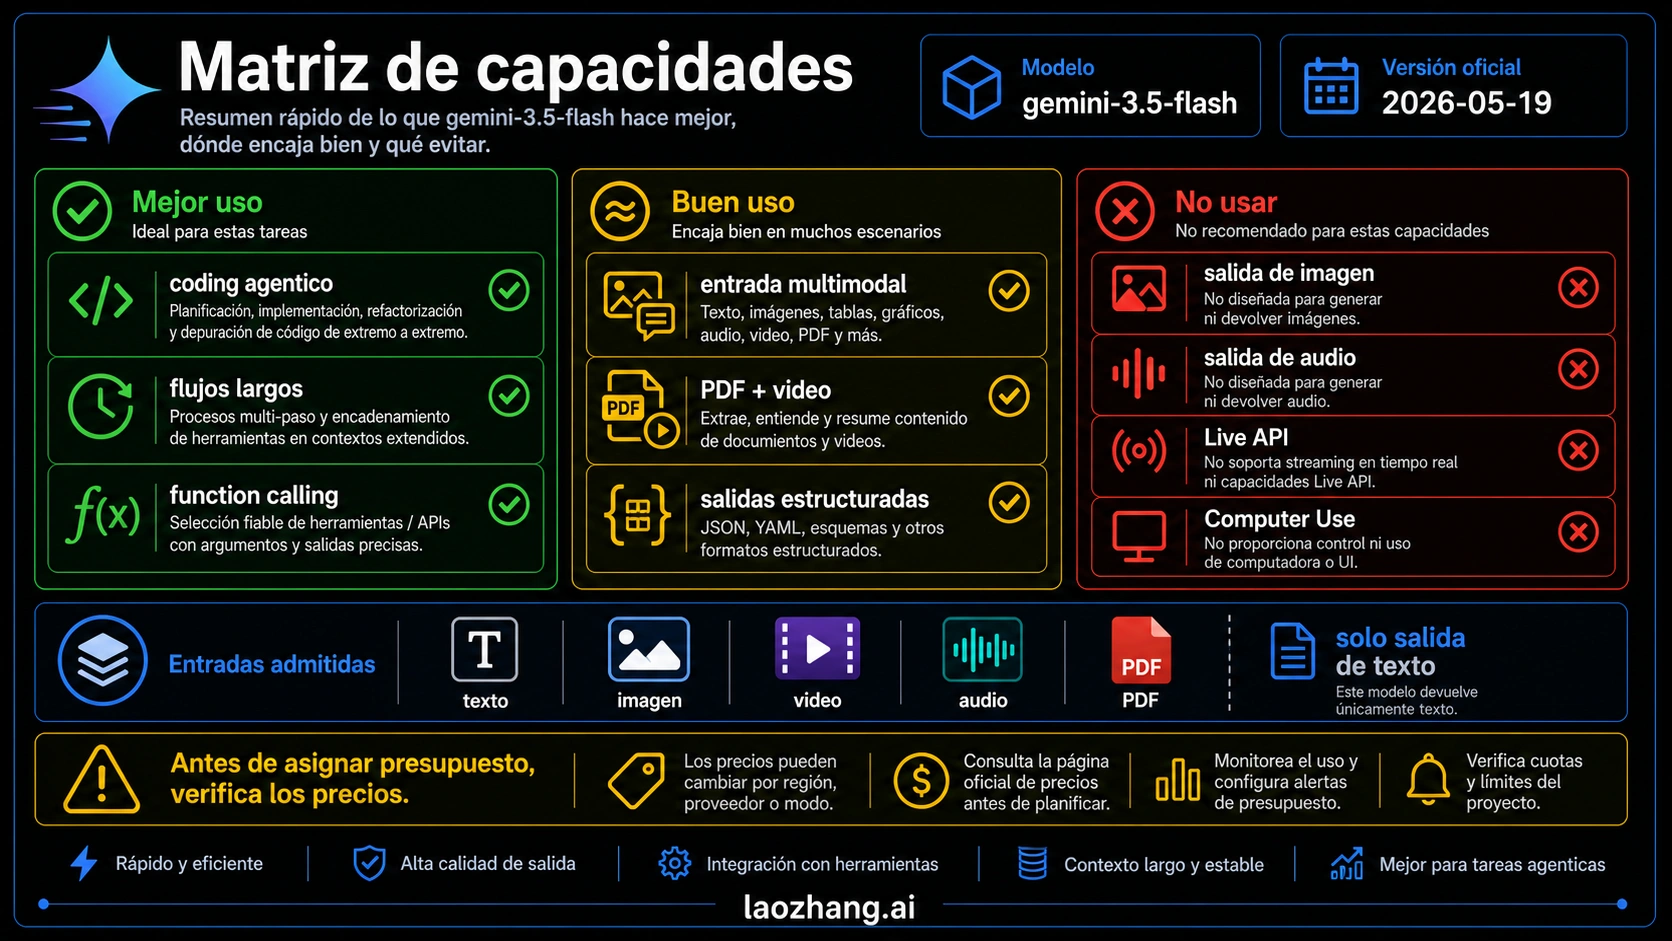
Ilustración del lanzamiento de mayo de 2026. Para Computer Use y el modelo que responde hoy, aplica las condiciones actuales de esta guía.
Para programación, pide una corrección comprobable
El modelo puede trabajar con varios archivos, proponer cambios y participar en un ciclo de diagnóstico, ejecución de herramientas y revisión. Google atribuye a 3.6 una reducción de pasos, llamadas y cambios no deseados respecto a 3.5, según su guía de novedades. Esa descripción justifica evaluarlo para estas tareas; no demuestra que todos tus proyectos necesiten menos tiempo o que el código generado sea correcto.
Una instrucción útil delimita el fallo, los archivos modificables y la condición de éxito. Por ejemplo: «El total de un pedido pierde los céntimos al aplicar un cupón. Revisa la función de cálculo y la prueba asociada. Propón el cambio mínimo, explica qué caso lo verifica y no modifiques el formato de la interfaz». Así puedes comprobar un resultado concreto y detectar modificaciones que no pediste. Si importa el diseño visual, añade las reglas de diseño: la misma guía señala que los evaluadores humanos prefirieron modelos anteriores en ciertos aspectos de estilo.
Para documentos y funciones, separa respuesta de acción
Un PDF de instrucciones puede convertirse en una lista de requisitos o en datos estructurados, pero la aplicación debe verificar que los campos obligatorios estén presentes y que los valores tengan sentido. Una respuesta con forma de JSON no es automáticamente una decisión válida. La ficha también admite ejecución de código como herramienta: hay que habilitarla y procesar su resultado; describir código en texto no equivale a haberlo ejecutado.
En una llamada a funciones, el modelo propone una función y sus argumentos. Tu aplicación comprueba permisos, ejecuta la función autorizada y devuelve su resultado. En los flujos Gemini 3.x, cada respuesta debe conservar el id y el name de la llamada correspondiente, con una respuesta por cada llamada. Los contenidos multimodales deben ir dentro de la respuesta de la función. Son requisitos documentados en la guía de 3.5, que 3.6 mantiene como base de migración.
Computer Use está en Preview; la llamada de texto no controla el ordenador
La ficha actual de 3.5 y la de 3.6 marcan Computer Use como compatible en Preview. Por eso ya no es correcto repetir la afirmación del lanzamiento de que no lo admiten. Sin embargo, la guía actual de Computer Use recomienda 3.8 Flash y su lista de versiones no incluye 3.6. La ficha y la guía tienen alcances distintos; no hemos comprobado una solicitud de Computer Use con 3.6.
Para crear un agente que maneje una interfaz, el cliente tiene que cerrar este ciclo:
- Enviar la tarea, la herramienta, el entorno y una captura de la pantalla.
- Recibir la acción propuesta y su decisión de seguridad.
- Ejecutarla solo si está permitida o si el usuario confirma cuando se exige confirmación; detenerse ante una acción bloqueada.
- Capturar el nuevo estado y devolverlo como resultado de la función para continuar.
El entorno de ejecución, la captura y el manejo de acciones son trabajo de tu aplicación. Un entorno aislado con permisos limitados y supervisión es especialmente importante porque se trata de una función Preview. Para empezar una implementación nueva de control de navegador, sigue el modelo y el proceso de la guía actual, sin trasladar automáticamente un ejemplo de texto a un agente de ordenador.
Si tu producto requiere generar imágenes, generar audio o mantener conversación de voz mediante Live API, las fichas de 3.5 y 3.6 indican que esas capacidades no están soportadas. Aceptar una imagen o una grabación como entrada no cambia el tipo de salida.
Cómo conectar una aplicación a la API nativa
El siguiente ejemplo utiliza generateContent de Gemini Developer API, con el modelo explícito 3.6. Necesitas una clave válida de un proyecto con acceso y cuota, curl y una variable GEMINI_API_KEY ya configurada en tu entorno. Mantén la clave en el servidor; no la incorpores al código del navegador. Es un ejemplo documental, sin llamada realizada para este artículo.
curl -sS \
  -o respuesta.json \
  -w 'HTTP %{http_code}\n' \
  -X POST \
  'https://generativelanguage.googleapis.com/v1beta/models/gemini-3.6-flash:generateContent' \
  -H "x-goog-api-key: ${GEMINI_API_KEY}" \
  -H 'Content-Type: application/json' \
  --data-binary @- <<'JSON'
{
  "contents": [{
    "role": "user",
    "parts": [{
      "text": "Un servicio responde 200 al guardar un pedido, pero el pedido no aparece al recargar. Los registros muestran que la lectura ocurre antes del commit de la transacción. Explica la causa probable, el cambio mínimo y una prueba que distinga ese fallo de un problema de caché."
    }]
  }],
  "generationConfig": {
    "maxOutputTokens": 8192,
    "thinkingConfig": {"thinkingLevel": "MEDIUM"}
  }
}
JSON
La referencia de GenerateContent documenta el endpoint, contents y generationConfig. En un resultado HTTP 200, abre respuesta.json: el texto está en las partes de candidates[].content.parts[] que contienen text. Revisa también finishReason, modelVersion, responseId y usageMetadata. El éxito útil es una explicación completa que responda al caso y pueda verificarse, no solo un 200. Si no hay candidatos, comprueba promptFeedback; si hay un error HTTP, lee el objeto de error antes de tratar el archivo como respuesta generada.
Ajusta el razonamiento sin mezclar formatos de API
3.6 admite MINIMAL, LOW, MEDIUM y HIGH en el campo REST generationConfig.thinkingConfig.thinkingLevel; MEDIUM es el valor por defecto. Empieza con él en diagnósticos o flujos con varios pasos, baja a LOW para una tarea acotada si conserva el resultado y prueba HIGH cuando el problema necesite más razonamiento. Son opciones para evaluar, no una garantía de calidad ni un número fijo de tokens. MINIMAL tampoco garantiza ausencia total de razonamiento. La guía de pensamiento recoge los niveles por modelo.
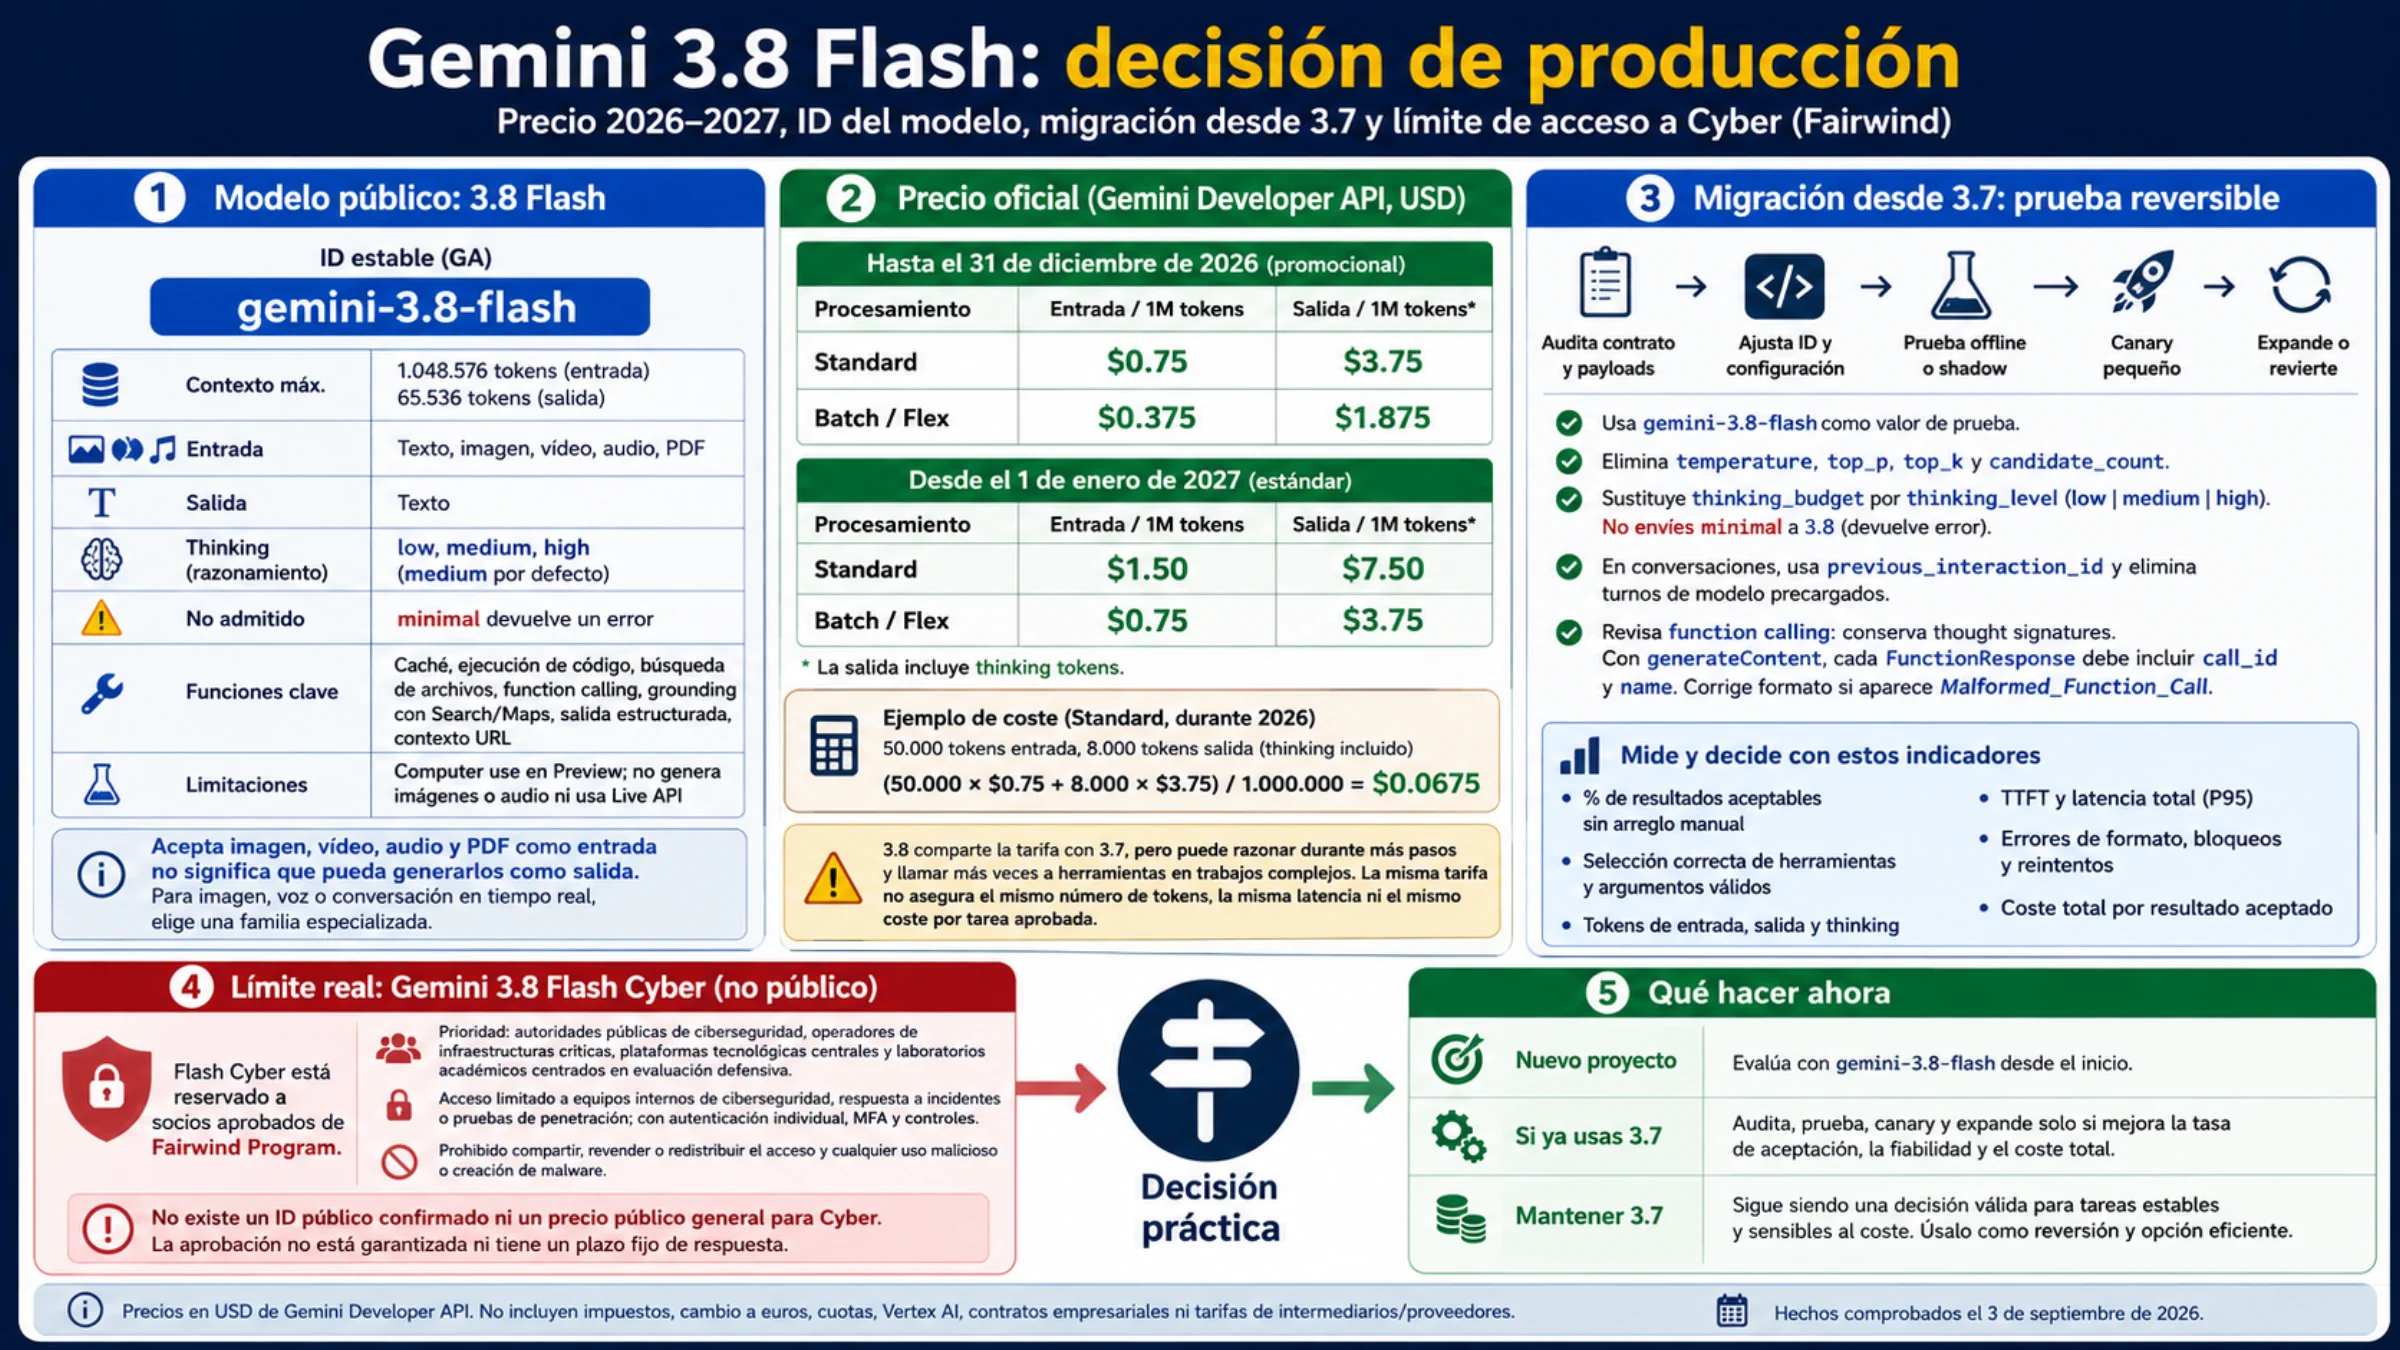
Si decides pasar a 3.8 Flash, conserva LOW, MEDIUM o HIGH: MINIMAL no está soportado y devuelve un error, según su ficha.
Interactions es otra API: emplea /v1beta/interactions, model, input y generation_config, con nombres como thinking_level en minúsculas. No pegues esos campos dentro de generationConfig. En su modo con estado, store: true y previous_interaction_id permiten conservar el estado en el servidor; en modo sin estado debes reenviar los bloques de pensamiento sin modificarlos. En GenerateContent, envía el historial completo y sin alterar, incluidas las firmas de pensamiento, en contents. Esta distinción está en las guías de pensamiento y de comportamiento de 3.5.
Qué revisar al actualizar una integración antigua
Cambiar el nombre del modelo ayuda a mantener una configuración clara, pero no arregla todos los supuestos del cliente. La guía de migración a 3.6 señala estos cambios:
| Configuración heredada | Adaptación necesaria |
|---|---|
temperature, topP y topK en REST | Elimínalos: 3.6 los ignora y futuras generaciones pueden rechazarlos. Expresa las reglas de formato en las instrucciones o en el esquema. |
candidateCount | Elimínalo; no está soportado en Gemini 3 y posteriores. |
| Presupuesto numérico de pensamiento | Sustitúyelo por el nivel de razonamiento; no envíes ambos controles. |
Último turno no vacío con role: "model" para completar una respuesta iniciada | Elimina ese relleno: provoca un 400. Utiliza instrucciones o salida estructurada. |
| Historial reconstruido solo con texto visible | Conserva las partes originales y las firmas; revisa la correspondencia de llamadas y respuestas de funciones. |
Al evaluar el cambio, conserva los documentos, instrucciones y herramientas de una tarea representativa. Comprueba la corrección final, las llamadas válidas, los reintentos, los tokens y el tiempo de revisión que requiere la respuesta. Compara modelos que sigan siendo elecciones distintas; el antiguo ID 3.5 redirigido no sirve como referencia independiente ni como retorno al modelo original. Guarda una configuración alternativa que esté realmente disponible, en lugar de prometer una vuelta a 3.5 mediante ese alias.
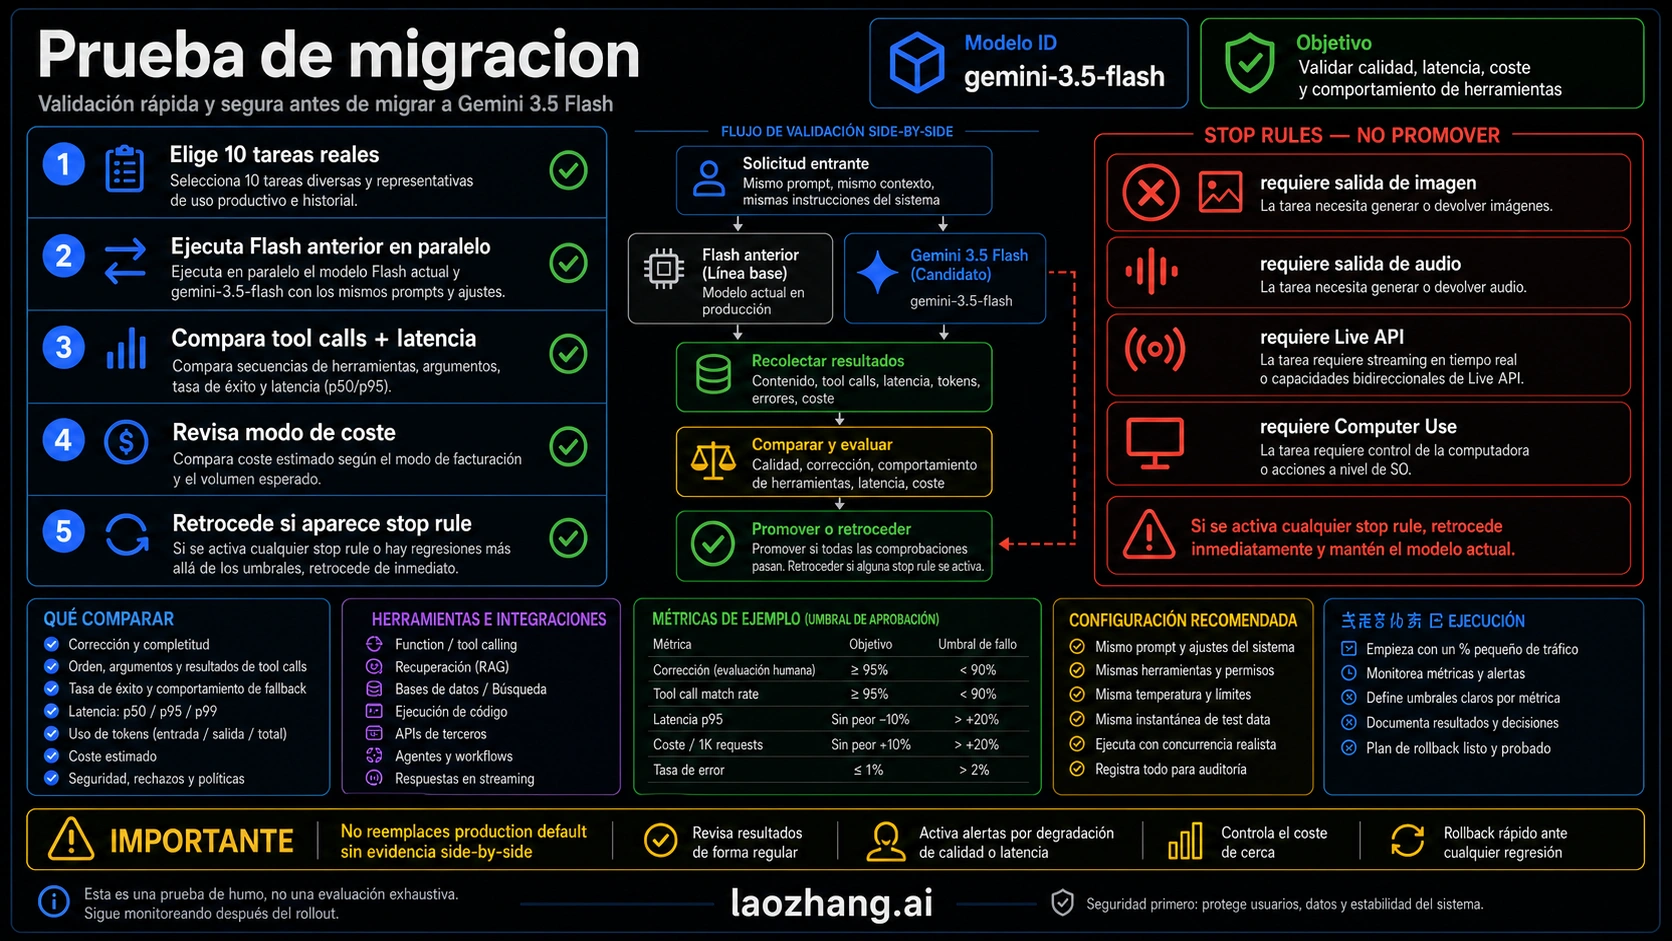
La ilustración conserva el proceso de evaluación del lanzamiento. La comparación actual necesita modelos independientes; el alias 3.5 no permite volver al modelo original.
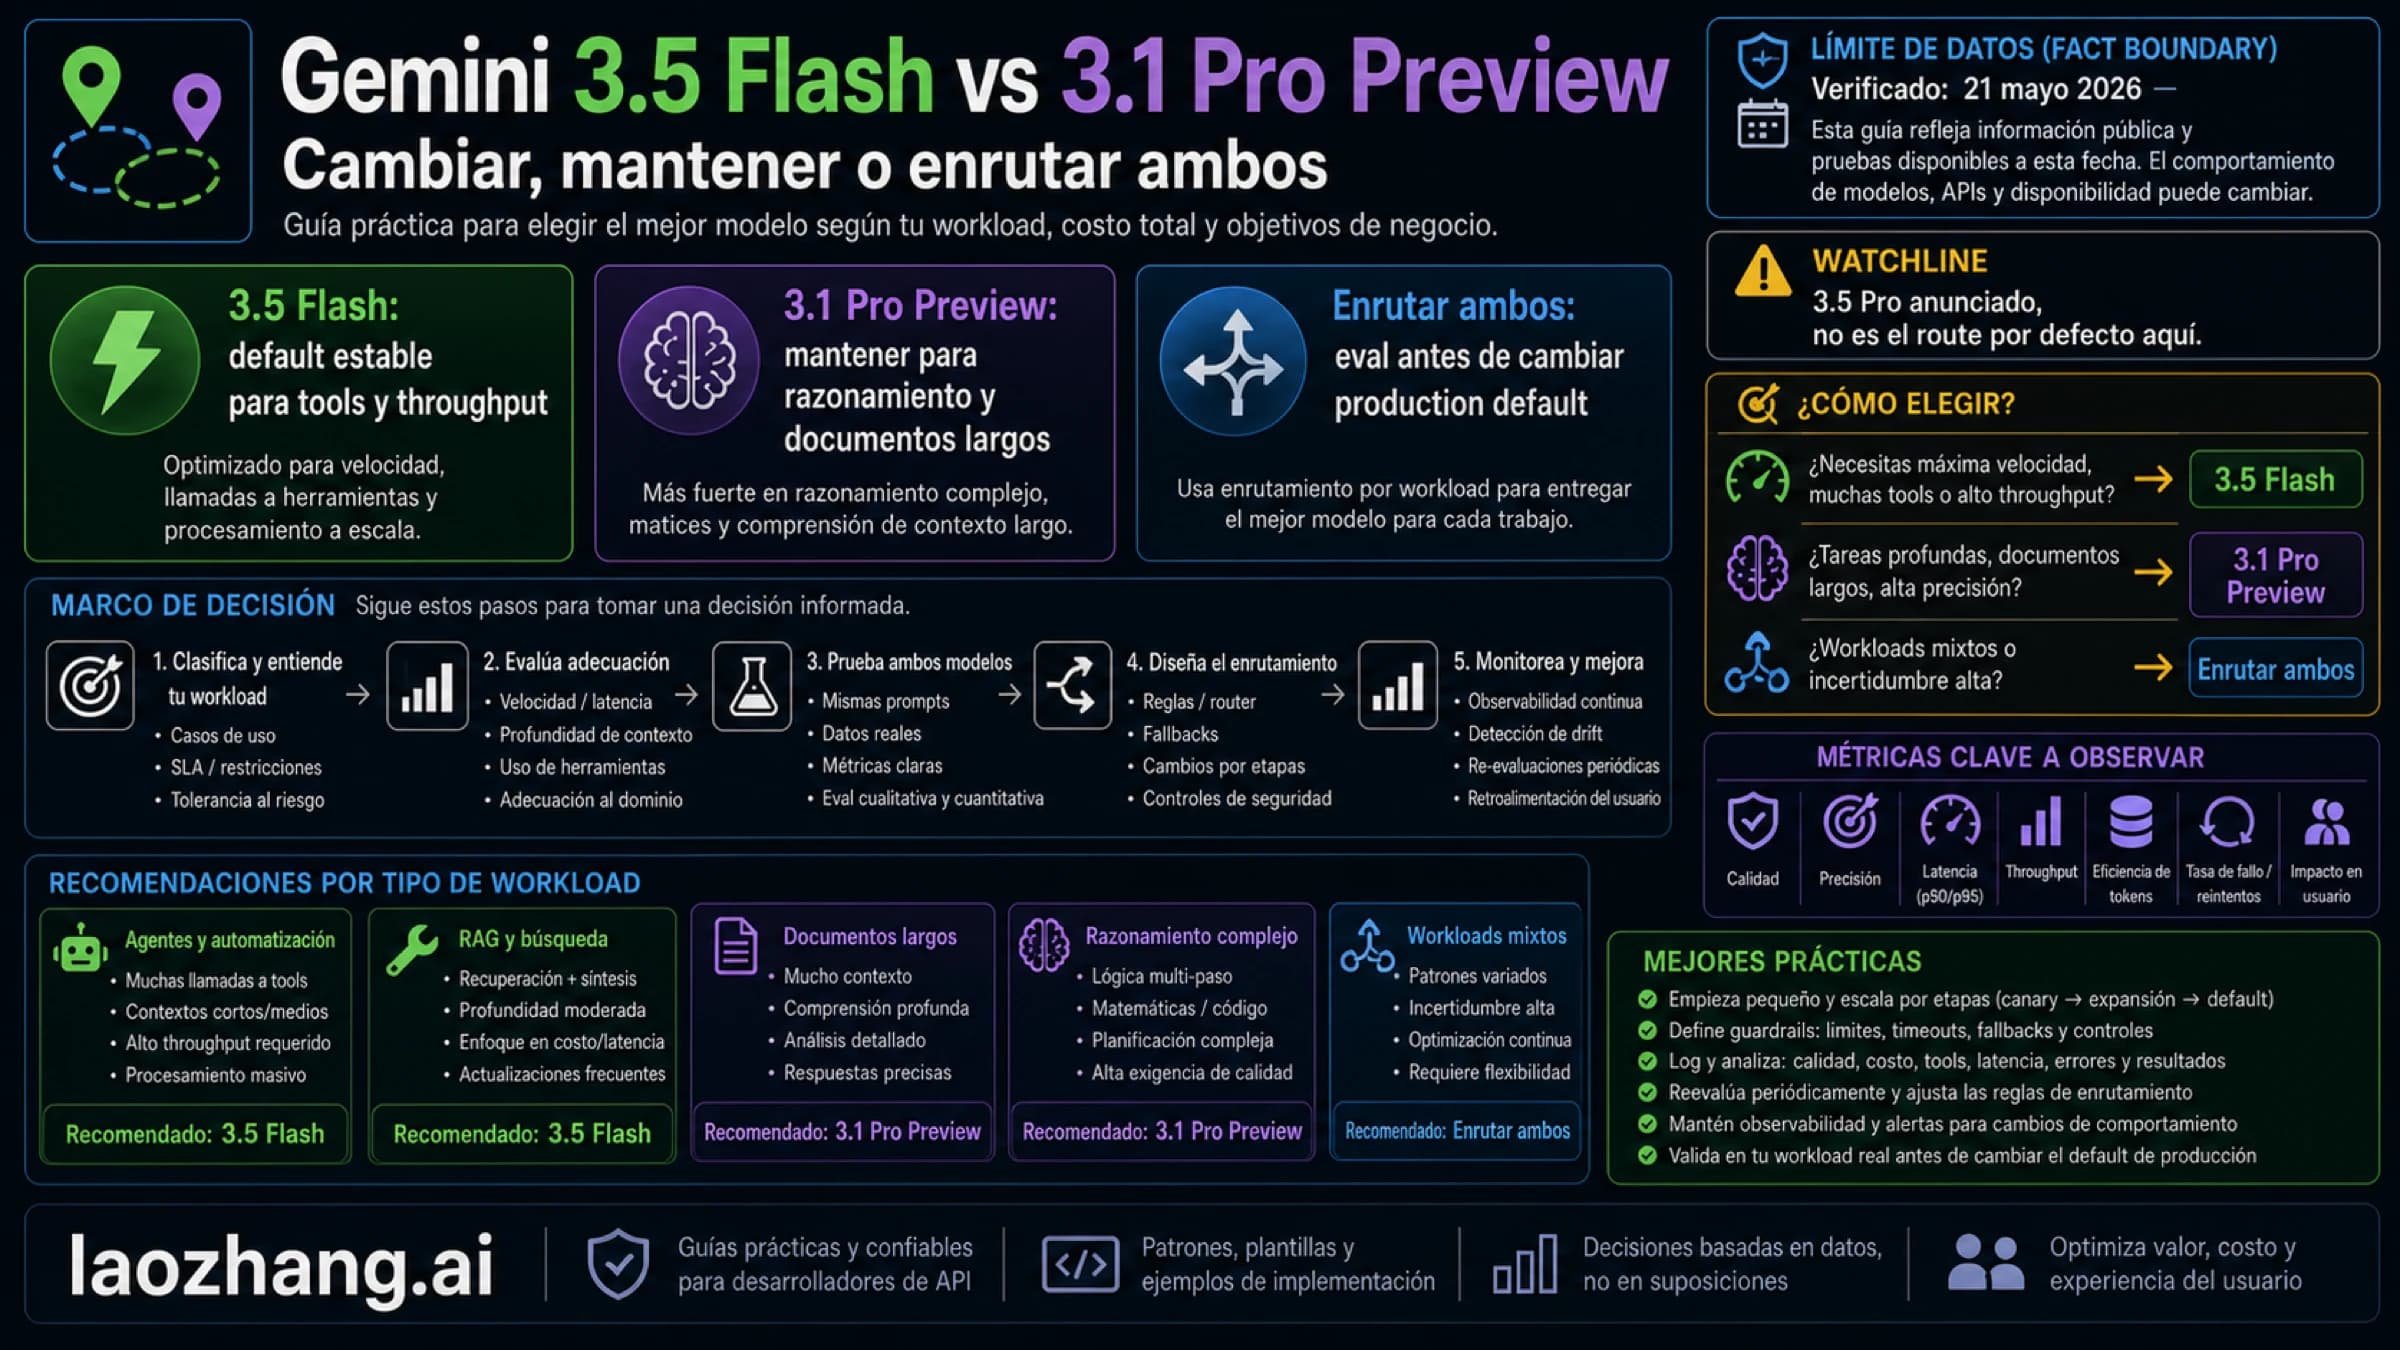
Para tareas de código y herramientas, 3.6 es la sustitución directa documentada de 3.5. Para trabajo de programación prolongado, Google presenta 3.8 Flash como el Flash más reciente. Si la tarea es clasificación, traducción corta o extracción sencilla a gran escala, compara el coste y la calidad con Lite; la comparación entre Flash y Flash-Lite aborda esa decisión. 3.5 Flash-Lite es otro modelo, no el nombre nuevo de 3.5 Flash.
Cuánto cuesta la ruta actual
Para presupuestar 3.6, utiliza la tabla vigente de Developer API. A 14 de octubre de 2026, 3.6 y 3.8 comparten las siguientes tarifas de pago; la salida incluye los tokens de pensamiento. La página oficial de precios separa la promoción hasta el 31 de diciembre de 2026 de los importes desde el 1 de enero de 2027.
| Modo | Entrada/salida hasta el 31 de diciembre de 2026 | Entrada/salida desde el 1 de enero de 2027 |
|---|---|---|
| Standard | 0,75 / 3,75 USD | 1,50 / 7,50 USD |
| Batch | 0,375 / 1,875 USD | 0,75 / 3,75 USD |
| Flex | 0,375 / 1,875 USD | 0,75 / 3,75 USD |
| Priority | 1,35 / 6,75 USD | 2,70 / 13,50 USD |
Todos los importes son por un millón de tokens, en el orden entrada/salida, para esos modelos y modos. No son precios de Cloud ni de un intermediario. La guía de 3.6 también menciona el precio base 1,50/7,50 USD sin el periodo promocional; para una estimación fechada prevalece la tabla que indica su vigencia. La página actual no tiene una sección independiente de precios de 3.5 Flash, y aquí no se ha observado una factura de su alias.
Por ejemplo, un lote hipotético de 800 solicitudes Standard con 6.000 tokens de entrada y 1.200 tokens generados por solicitud —incluido el pensamiento— suma 4,8 millones de entrada y 0,96 millones de salida. A la tarifa de 2026 cuesta 4,8 × 0,75 + 0,96 × 3,75 = 7,20 USD. Desde enero de 2027, con los mismos supuestos, serían 14,40 USD. Es una estimación sin caché, herramientas, reintentos ni impuestos, no una factura ni un resultado medido.
Para ajustar tu cálculo, promptTokenCount incluye el contexto cacheado; cachedContentTokenCount es una parte de ese total, no una entrada adicional que debas volver a sumar. candidatesTokenCount y thoughtsTokenCount distinguen respuesta y pensamiento. No multipliques totalTokenCount por la tarifa de salida: también incluye entrada y otros componentes. La referencia de consumo define esos campos.
La caché Standard tiene lectura y almacenamiento separados: hasta diciembre, 0,075 USD por millón de tokens cacheados y 0,50 USD por millón de tokens y hora almacenados; desde enero, 0,15 y 1,00 USD respectivamente. Búsqueda y Maps pueden añadir cargos: hay un tramo de 5.000 solicitudes mensuales compartido entre modelos Gemini 3 y posteriores, seguido de 14 USD por 1.000 según la unidad indicada en la tabla. En Search, una solicitud del cliente puede provocar varias consultas facturables. Revisa la tabla y sus notas cuando actives estas herramientas.
Cuotas y condiciones para una aplicación en España
El nivel gratuito de Standard figura en la tabla de precios de 3.6, pero no aporta una cuota universal. Los límites de solicitudes por minuto, tokens de entrada por minuto y solicitudes por día dependen del proyecto y del modelo. Se consultan en AI Studio, se comparten entre las claves del proyecto y el límite diario se reinicia a medianoche del Pacífico. Crear más claves no aumenta la capacidad. Un 429 RESOURCE_EXHAUSTED puede responder a esas dimensiones o a un límite de gasto por periodos móviles de diez minutos cuando se aplique a tu cuenta; revisa el error y los límites oficiales antes de aumentar concurrencia.
España está en la lista de regiones admitidas, pero el acceso también requiere cumplir las condiciones de edad y cuenta. Desde el 28 de mayo de 2026 las claves nuevas de AI Studio son claves de autorización; la API rechaza las claves estándar sin restricciones, mientras que las estándar con restricciones explícitas siguen funcionando. Una clave antigua y un problema de cuota son diagnósticos distintos. Véase la guía de claves.
Si ofreces un cliente de API a usuarios del EEE —incluida España—, Suiza o Reino Unido, los términos exigen utilizar Paid Services. Para Gemini API, eso significa acceder mediante un proyecto con una cuenta de facturación activa. La existencia de tokens gratuitos no sustituye esta condición. Los términos vigentes desde el 23 de marzo de 2026 también establecen una excepción regional de datos: en el EEE, Suiza y Reino Unido se aplican las cláusulas de datos de Paid Services incluso a AI Studio y a la cuota no pagada.
Fuera de esa excepción, los servicios no pagados pueden usar entradas y respuestas para mejorar productos y someterlas a revisión humana. En Paid Services Google indica que no las usa para esa mejora, aunque registra contenido durante un periodo limitado para seguridad y obligaciones legales. Eso no equivale a retención cero ni a una garantía general de privacidad. Ten presente esta condición antes de enviar documentos confidenciales de clientes.
Preguntas frecuentes
¿Puedo seguir usando el ID gemini-3.5-flash?
En Developer API el endpoint continúa, pero las solicitudes responden mediante 3.6 Flash; Google recomienda actualizar el ID. No conserva una versión independiente del modelo original. Cloud tiene su propio ciclo de vida. Consulta el calendario de Developer API.
¿Puede leer un PDF y devolver una imagen o una voz?
Puede recibir PDF, imágenes y audio, pero estas fichas Flash indican salida de texto y no admiten generación de imagen o audio ni Live API. Para una salida de ese tipo necesitas un modelo que la admita expresamente. Véase la ficha de 3.6.
¿Tengo que activar el razonamiento?
3.6 usa el nivel medio por defecto. Puedes elegir uno de los cuatro niveles admitidos para ajustar el esfuerzo según la tarea; el mínimo no garantiza que el razonamiento esté desactivado. Si cambias a 3.8, su lista excluye el mínimo. La guía de pensamiento permite comprobar cada modelo.
¿Gemini 3.5 Flash es mejor que Pro para todo?
No hay base para esa conclusión. Las capacidades lo hacen un candidato para programación, documentos y herramientas; una tarea de razonamiento difícil o con errores muy costosos exige comprobar su resultado frente a una alternativa disponible. Además, una comparación actual de Developer API debe considerar que el ID 3.5 ya dirige a 3.6, como indica la ficha oficial.
¿La cuota gratuita me permite lanzar una aplicación para usuarios españoles?
No basta por sí sola. Los términos exigen Paid Services para poner clientes de API a disposición de usuarios del EEE, y en Gemini API definen esa condición por el proyecto con facturación activa. La excepción regional sobre uso de datos es una cláusula distinta; no elimina ese requisito.
Fuentes17
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 14 oct 2026.
Fuentes17
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 14 oct 2026.
- 1.ficha oficial de 3.5 Flashai.google.dev/gemini-api/docs/models/gemini-3.5-flash
- 2.calendario de retiradaai.google.dev/gemini-api/docs/deprecations
- 3.registro oficialai.google.dev/gemini-api/docs/changelog
- 4.referencia de la APIai.google.dev/api/generate-content
- 5.ficha de Clouddocs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/3-5-flash
- 6.3.6 Flashai.google.dev/gemini-api/docs/models/gemini-3.6-flash
- 7.guía de novedadesai.google.dev/gemini-api/docs/whats-new-gemini-3.6
- 8.guía de 3.5ai.google.dev/gemini-api/docs/whats-new-gemini-3.5
- 9.guía actual de Computer Useai.google.dev/gemini-api/docs/computer-use
- 10.guía de pensamientoai.google.dev/gemini-api/docs/thinking
- 11.fichaai.google.dev/gemini-api/docs/models/gemini-3.8-flash
- 12.página oficial de preciosai.google.dev/gemini-api/docs/pricing
- 13.AI Studioaistudio.google.com/rate-limit
- 14.límites oficialesai.google.dev/gemini-api/docs/rate-limits
- 15.lista de regiones admitidasai.google.dev/gemini-api/docs/available-regions
- 16.guía de clavesai.google.dev/gemini-api/docs/api-key
- 17.términos vigentes desde el 23 de marzo de 2026ai.google.dev/gemini-api/terms