Gemini 4 Neon vs GPT-6.2 Sol vs Opus 5.5: coste y cuál usar
Con la misma nota, Gemini 4 Neon en high cuesta un 63 % menos que Opus 5.5 en max. GPT-6.2 Sol es mucho más barato, pero no pasa de 57 puntos; Neon high da 60.
En esta página
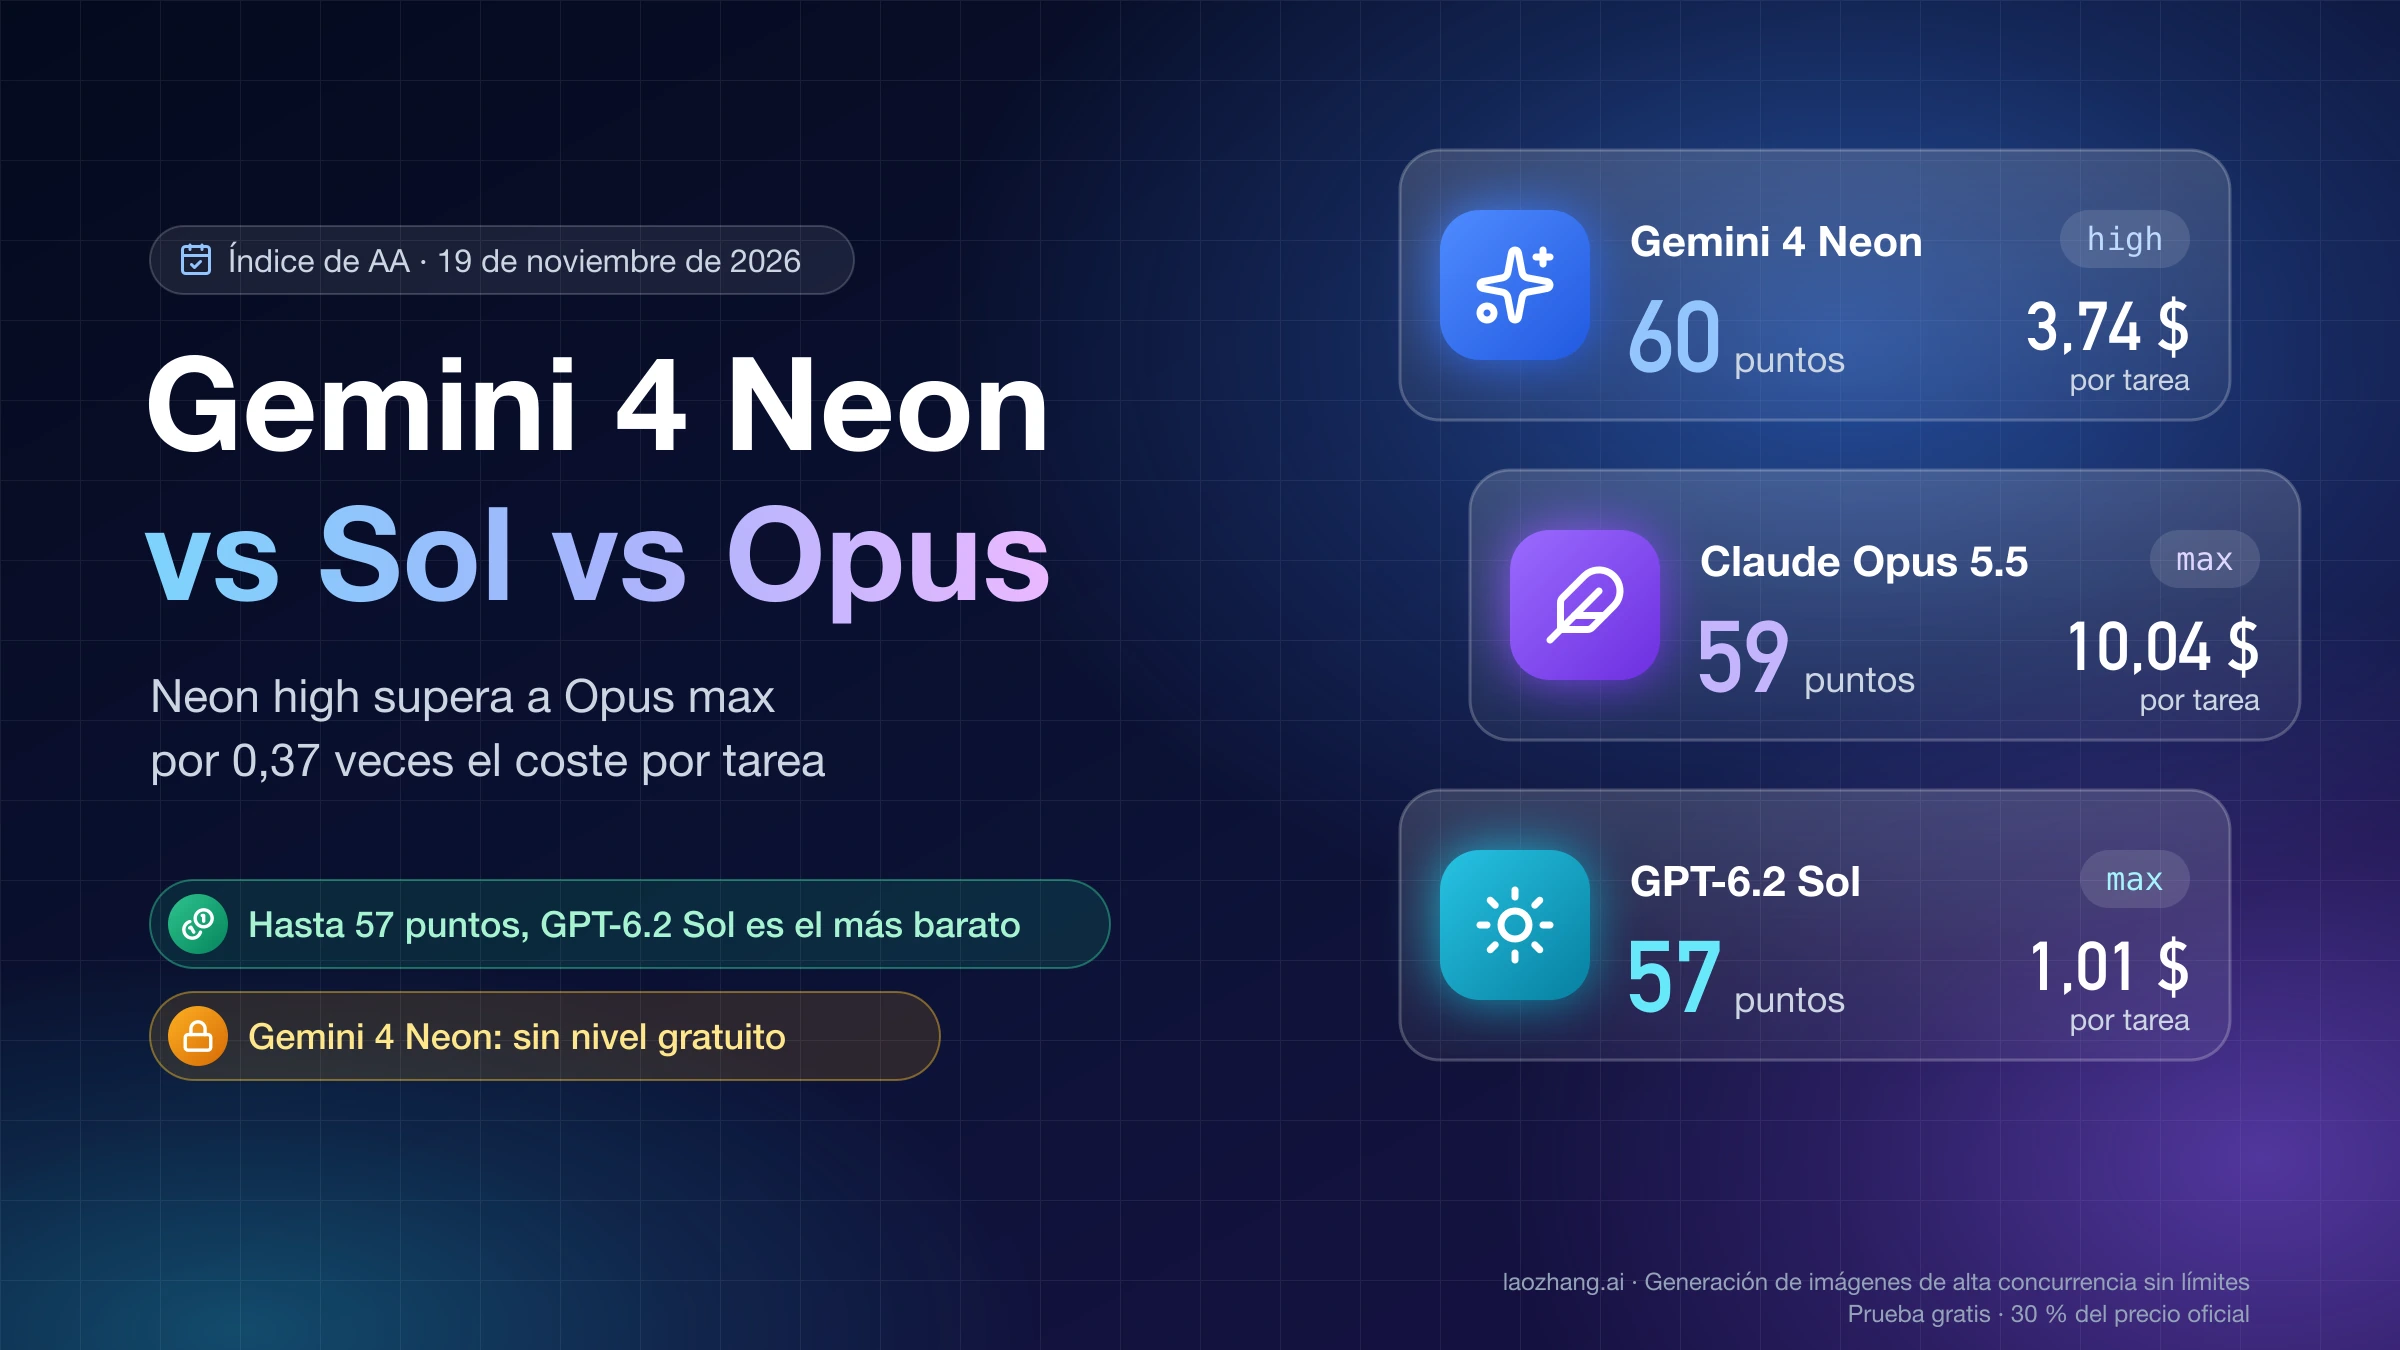
Si hoy pagas Claude Opus 5.5 en max o xhigh por la API, prueba gemini-4-neon en high, que es su nivel por defecto: en el índice de inteligencia de Artificial Analysis (AA) saca 60 puntos frente a 59 de Opus en max, por 3,74 $ por tarea en lugar de 10,04 $ y en 14,8 minutos en lugar de 24,6. Si te bastan entre 55 y 57 puntos, el más barato con diferencia es gpt-6.2-sol: en high llega a 55 puntos por 0,56 $ por tarea, mientras que Neon necesita medium y 1,90 $ para la misma nota. Google lanzó Gemini 4 Neon el 18 de noviembre de 2026, un día después de que OpenAI publicara GPT-6.2 Sol.
La promesa de «nivel Opus 5.5 y un 25 % más barato» es cierta, y en los niveles altos se queda corta. Por token, Neon cobra 3 $ de entrada y 15 $ de salida por millón, el 75 % de lo que cobra Opus (4 $ y 20 $), pero a igual puntuación Neon en high cuesta 0,37 veces lo que Opus en max. Frente a Sol no gana en precio en ningún nivel, porque Sol cobra 2 $ y 10 $ y además gasta menos tokens; lo que le falta a Sol es techo, ya que su mejor nota, 57 en max, queda por debajo de Neon en high. Y si usas Opus 5.5 en medium para el trabajo corriente, Sol en medium saca 53 puntos frente a 48 por la sexta parte del coste.
Antes de planear el cambio, comprueba si puedes usar Neon, porque no tiene nivel gratuito. En la API de Gemini solo funciona en el nivel de pago y en la app de Gemini aparece con Google AI Pro o Ultra, no con AI Plus. El 19 de noviembre de 2026, una cuenta gratuita de Google AI Studio lo mostraba bloqueado con el aviso «Gemini 4 Neon is only available with a Google AI plan, or pay per request with an API key».
Puntuación, coste y tiempo por tarea de los tres modelos en cada nivel
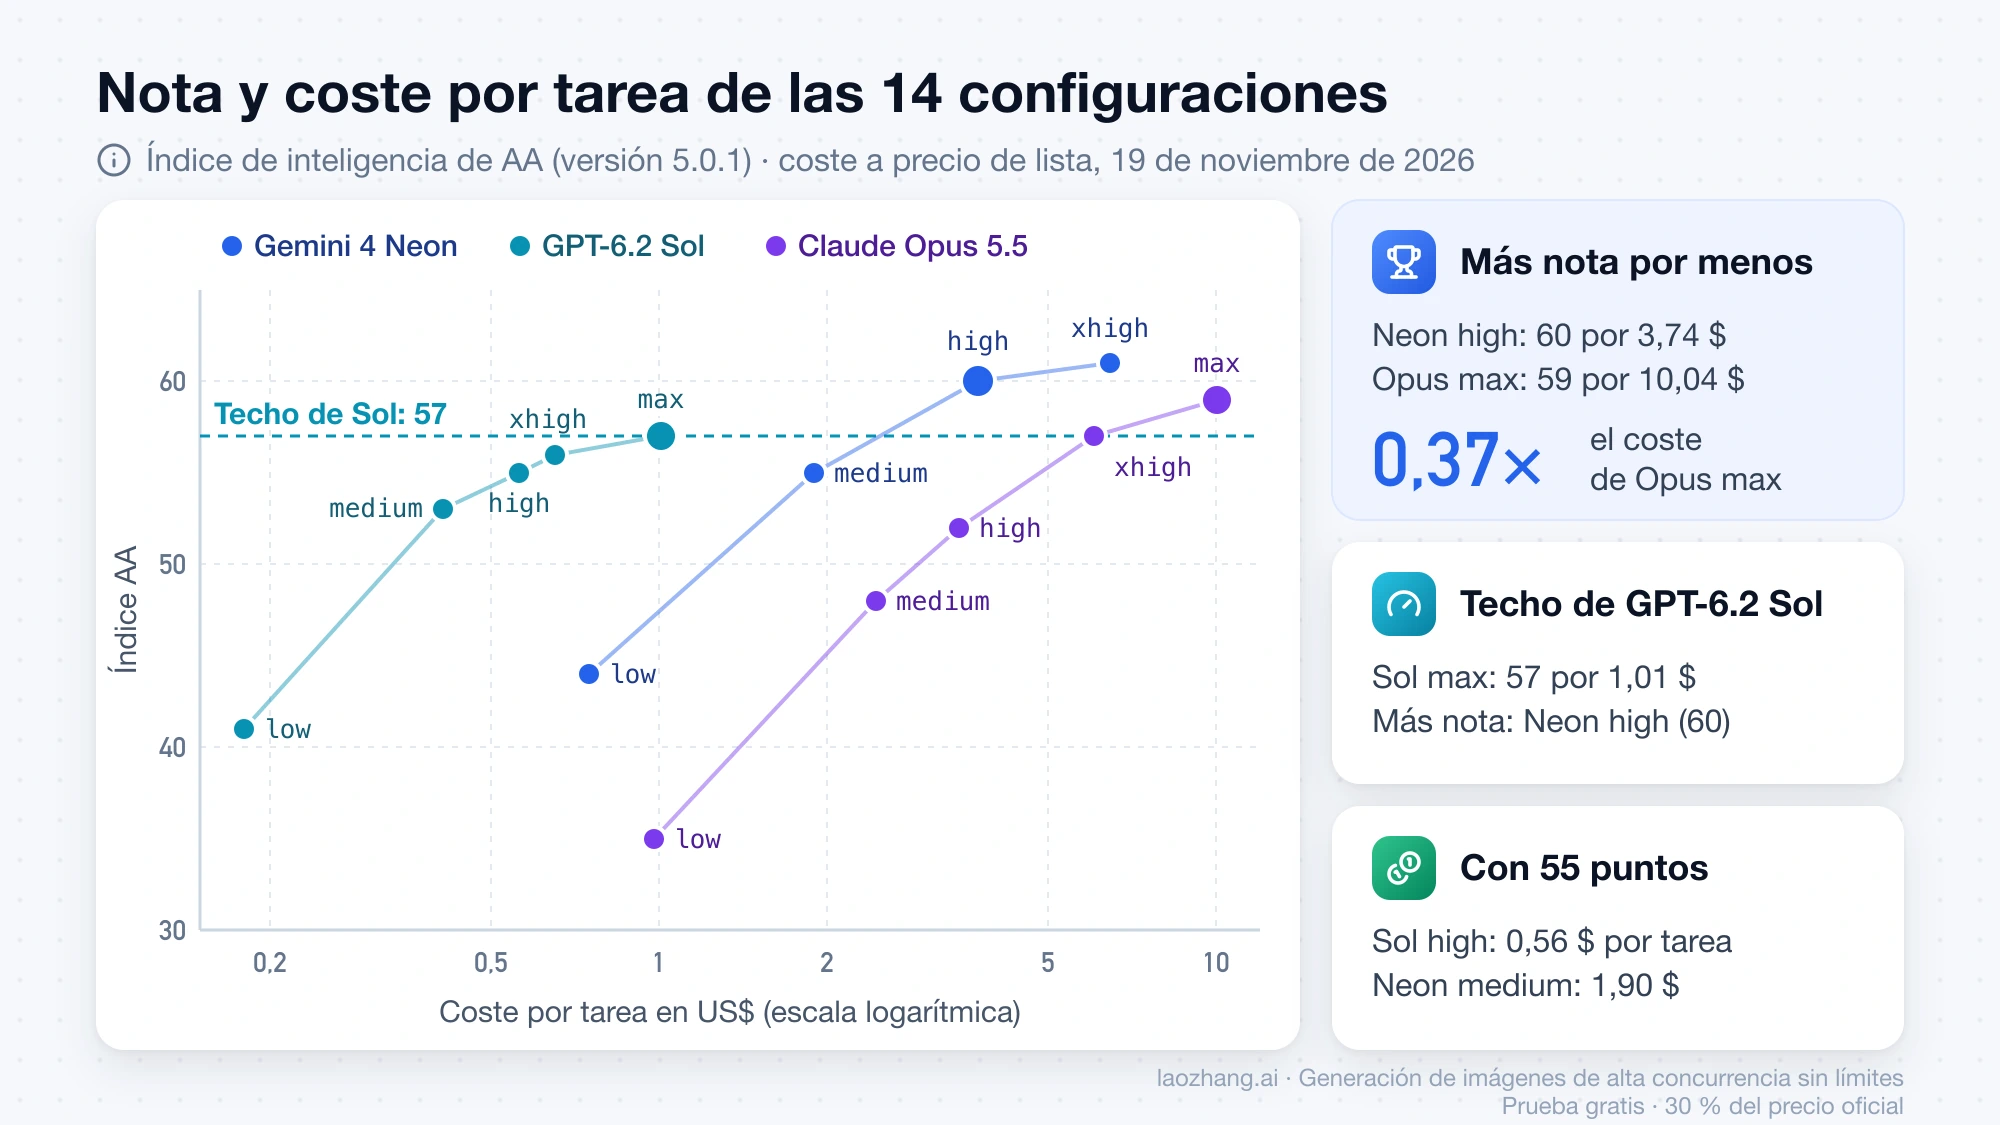
Comparar por nombre de nivel engaña, porque cada fabricante calibra sus niveles de razonamiento a su manera; lo útil es buscar la configuración más barata que alcanza la nota que necesitas. La tabla ordena por puntuación las 14 configuraciones de los tres modelos que mide el índice de inteligencia de Artificial Analysis, comparativa Gemini 4 Neon frente a Claude Opus 5.5 (versión 5.0.1, junto con la comparativa Gemini 4 Neon frente a GPT-6.2 Sol), con el coste y el tiempo medios por tarea del índice a 19 de noviembre de 2026.
| Modelo y nivel | Índice AA | Coste por tarea | Tiempo por tarea | Tokens de salida por tarea |
|---|---|---|---|---|
Gemini 4 Neon xhigh | 61 | 6,44 $ | 21,5 min | 141.631 |
Gemini 4 Neon high (por defecto) | 60 | 3,74 $ | 14,8 min | 90.188 |
Claude Opus 5.5 max | 59 | 10,04 $ | 24,6 min | 173.323 |
Claude Opus 5.5 xhigh | 57 | 6,05 $ | 15,9 min | 103.401 |
GPT-6.2 Sol max | 57 | 1,01 $ | 8,5 min | 40.360 |
GPT-6.2 Sol xhigh | 56 | 0,65 $ | 5,3 min | 24.323 |
GPT-6.2 Sol high | 55 | 0,56 $ | 4,6 min | 20.160 |
Gemini 4 Neon medium | 55 | 1,90 $ | 8,3 min | 50.000 |
GPT-6.2 Sol medium (por defecto) | 53 | 0,41 $ | 3,2 min | 13.651 |
Claude Opus 5.5 high | 52 | 3,46 $ | 9,3 min | 60.076 |
Claude Opus 5.5 medium | 48 | 2,45 $ | 6,9 min | 43.821 |
Gemini 4 Neon low | 44 | 0,75 $ | 3,7 min | 21.726 |
GPT-6.2 Sol low | 41 | 0,18 $ | 1,5 min | 5.980 |
Claude Opus 5.5 low | 35 | 0,98 $ | 3,1 min | 19.063 |
Los costes de AA se pueden comprobar. El 19 de noviembre de 2026 se recalcularon en un Mac a partir del desglose de tokens por tarea que AA publica para cada configuración, aplicando las tarifas oficiales de Google, OpenAI y Anthropic, y las 14 coinciden con AA al céntimo, así que AA usa precio de lista sin descuentos. La columna de tokens de salida sale de ese recálculo. Es un cálculo sobre los tokens que midió AA, no llamadas propias a los modelos, y vale para la mezcla de tareas del índice: si tus peticiones llevan mucha más entrada que salida, la diferencia entre modelos se acerca a la de su precio por token.
Fíjate también en qué nivel usas de verdad. Neon arranca en high en la API y en AI Studio, y Sol en medium, así que «por defecto contra por defecto» enfrenta 60 puntos a 3,74 $ con 53 puntos a 0,41 $, más de 9 veces el coste (3,74 / 0,41 = 9,1). En la app de Gemini pasa lo contrario: si eliges Neon a mano sin tocar el nivel de razonamiento, la app usa Low. AA etiqueta las filas de Opus como «Default Fallback»; es un nombre de su banco de pruebas, no un ajuste de Anthropic.
¿Neon supera a Opus 5.5 por menos dinero? A igual nota, cuesta 0,37 veces
Sí: en el índice de AA, Gemini 4 Neon saca más puntos que Opus 5.5 en cada nivel y, a igual nota, cuesta bastante menos. Neon en high (60) supera a Opus en max (59) con 0,37 veces el coste, 0,60 veces el tiempo y 0,52 veces los tokens de salida, y Neon en medium (55) supera a Opus en high (52) por 0,55 veces el coste. Incluso Neon en xhigh, con 61 puntos, cuesta 0,64 veces lo que Opus en max. Al mismo nombre de nivel, Neon en high y xhigh cuesta un 6–8 % más que Opus (3,74 $ frente a 3,46 $; 6,44 $ frente a 6,05 $), pero suma 8 y 4 puntos más.
Las cifras de Google van en la misma dirección. En el anuncio de Gemini 4 Neon en el blog de Google, la empresa dice que en high cuesta «aproximadamente entre un 50 % y un 80 % menos por tarea que los principales modelos de frontera de la competencia» y que en xhigh sigue costando «un 36 % menos o más» que esos modelos en su nivel más alto. Frente a Opus, la cuenta cae dentro: un 63 % menos en high contra max y un 36 % menos en xhigh contra max. Frente a Sol no se cumple en ningún nivel, así que esa «competencia» son los modelos más caros.
Opus conserva terreno en dos sitios. En la propia tabla de benchmarks de Google, Opus va ligeramente por delante en Terminal-Bench 4.1 (65,8 % frente a 65,2 %) y en FrontierCode 2.0 (47,3 % frente a 46,2 %), y en el índice de agentes de código de AA los dos quedan prácticamente empatados. Un usuario de X que lanzó el mismo prompt a los dos en su nivel más alto cuenta que Neon tardó 20 minutos y costó unos 3,5 $, Opus 18 minutos y unos 7,2 $, y que «opus still did way better»; es una sola ejecución de una persona, pero recuerda que el índice promedia muchas pruebas y tu tarea puede caer en otra parte de la curva.
También cuenta la forma de trabajar. AA describe a Neon en xhigh como «notably slow per task and very verbose»: gastó 283 millones de tokens de salida en el índice frente a una mediana de 65,1 millones. En high tarda de media 40,6 s en empezar a responder, frente a 21,3 s de Opus en high y 359,2 s de Opus en max. A cambio, Neon acepta vídeo, audio y PDF como entrada, y Opus y Sol solo texto e imagen. En los subíndices de AA de finanzas y contabilidad, estrategia y operaciones, y derecho, Neon en xhigh saca 65, 64 y 64 puntos, frente a 59, 61 y 58 de Opus en max.
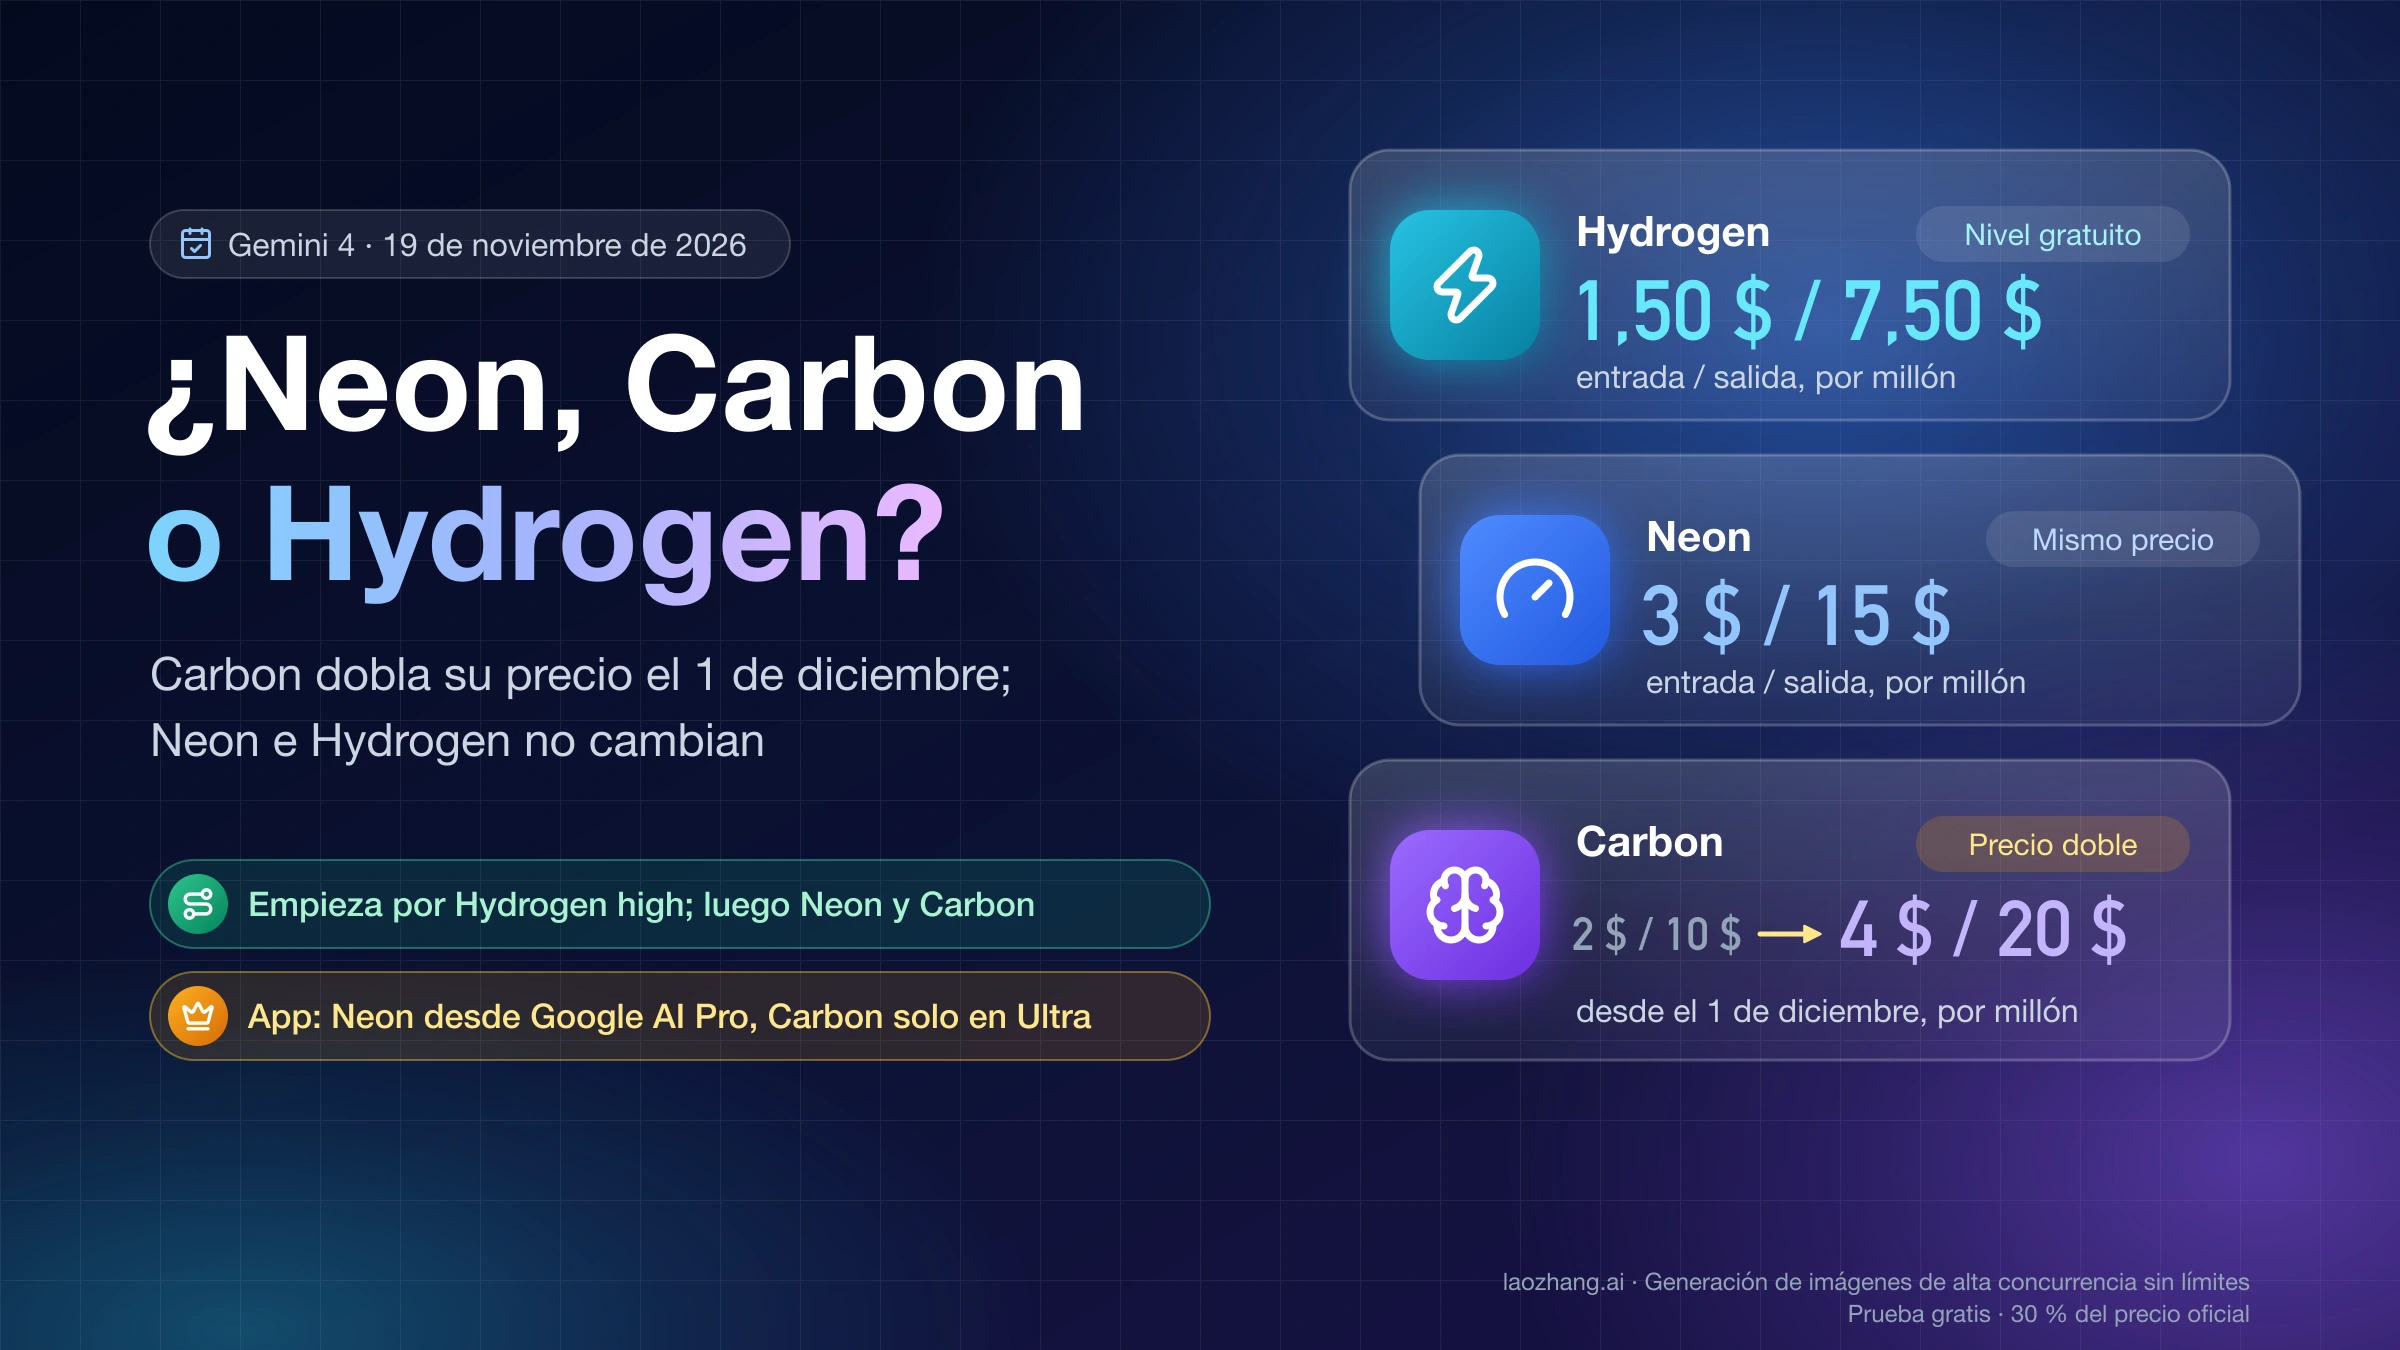
Si tu otra opción dentro de Google es Gemini 4 Carbon, su comparación con Opus está en Gemini 4 Carbon vs Opus 5.5: cuál usar para qué y cuánto cuesta; ten en cuenta que su tarifa de 2 $ y 10 $ solo vale hasta el 30 de noviembre de 2026. Para elegir entre Neon, Carbon e Hydrogen dentro de Google, mira Gemini 4 Neon vs Carbon vs Hydrogen: cuál usar hoy y en diciembre.
¿Sirve GPT-6.2 Sol en low o medium en lugar de Opus 5.5 en medium?
En medium sí, y en low no, al menos en el índice de AA. Sol en medium saca 53 puntos frente a 48 de Opus 5.5 en medium y cuesta 0,41 $ por tarea frente a 2,45 $, de modo que Opus sale 5,98 veces más caro y tarda 2,16 veces más. Sol en low se queda en 41 puntos, siete por debajo de Opus en medium, aunque cuesta 0,18 $, 0,07 veces lo que cuesta Opus; sirve para tareas sencillas y de mucho volumen, no como sustituto directo.
Arriba pasa lo mismo. Opus en xhigh y Sol en max empatan a 57 puntos, y Opus cuesta 5,99 veces más (6,05 $ frente a 1,01 $) y tarda 1,87 veces más. La prueba con 12 tareas reales que se describe más abajo da una proporción parecida: los dos acertaron todo y Opus costó unas cinco veces más. Los agentes de código son otra historia, aunque con otros niveles: en el índice de agentes de AA, Sol en xhigh, su mejor resultado, queda más de 8 puntos por debajo de Opus en max (49,8 frente a 58,2). AA no publica a Opus en medium como agente, así que esa cifra no dice nada del par medium contra medium, pero si tu caso son sesiones largas con herramientas en Claude Code o Codex y necesitas la nota más alta, Sol no llega.
¿Neon deja sin sentido a GPT-6.2 Sol? Solo si necesitas más de 57 puntos
No: hasta 57 puntos, GPT-6.2 Sol es la opción más barata de las tres, y Neon solo compensa cuando necesitas una nota que Sol no alcanza. Con 55 puntos empatan Neon en medium y Sol en high, y Neon cuesta 3,39 veces más (1,90 $ frente a 0,56 $), tarda 1,80 veces más y genera 2,48 veces más tokens de salida. Abajo la distancia crece: Neon en low (44 puntos) cuesta 4,17 veces lo que Sol en low (41). El techo de Sol es 57 puntos en max por 1,01 $ por tarea; para pasar de ahí, la opción más barata de las tres es Neon en high, con 60 puntos por 3,70 veces ese coste.
En dinero real, 1.000 tareas del tamaño de las del índice cuestan 410 $ con Sol en medium, 1.010 $ con Sol en max, 3.740 $ con Neon en high, 6.440 $ con Neon en xhigh y 10.040 $ con Opus en max, a precio de lista. Un matiz que cambia la cuenta con documentos muy largos: si una petición a Sol supera los 272.000 tokens de entrada, toda la petición pasa a 4 $ de entrada y 15 $ de salida por millón, mientras que Neon no tiene recargo por contexto largo. Por debajo de ese umbral, la ventaja de Sol se mantiene.
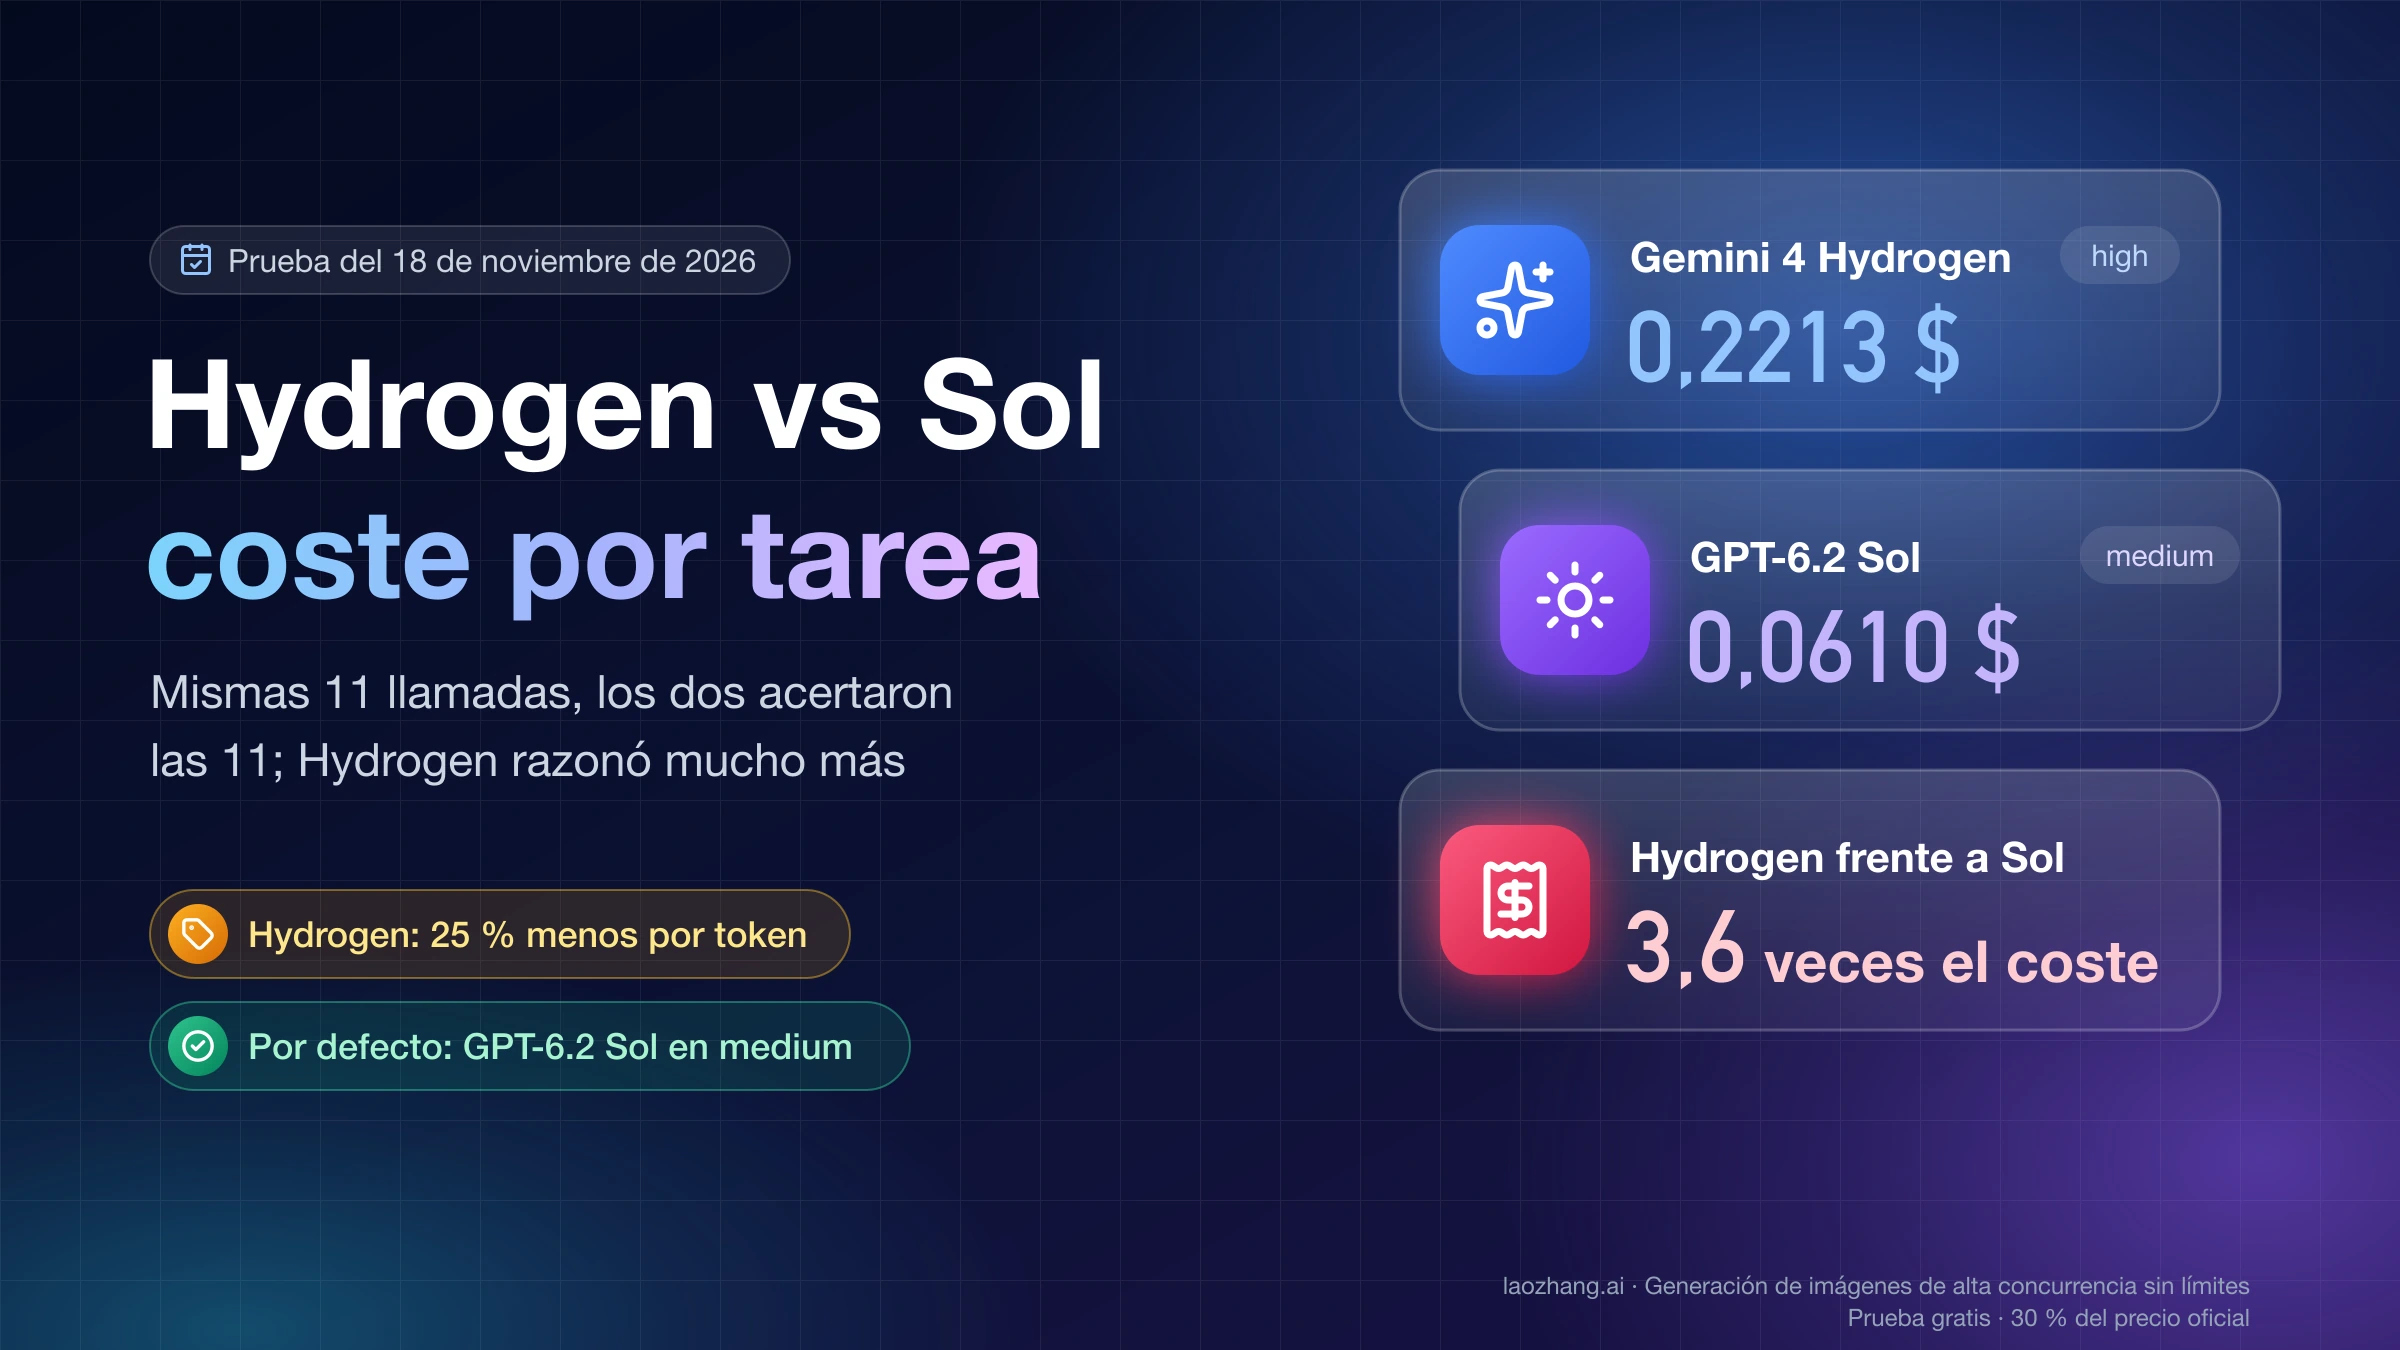
Si lo que buscas en Google es el precio más bajo y no la nota más alta, el modelo que compite con Sol es otro: Gemini 4 Hydrogen vs GPT-6.2 Sol: cuál elegir y coste por tarea.
Agentes de código: Neon y Opus empatan, Neon cuesta 6,86 $ y Opus 12,61 $
En el índice de agentes de código de Artificial Analysis (versión 2.1), que ejecuta cada modelo dentro de la herramienta de línea de comandos de su fabricante, Neon y Opus quedan prácticamente empatados y Neon cuesta algo más de la mitad. A 19 de noviembre de 2026, Neon en xhigh dentro de Antigravity CLI saca 58,6 puntos por 6,86 $ y 30,5 minutos por tarea, y Opus 5.5 en max dentro de Claude Code, 58,2 puntos por 12,61 $ y 65,3 minutos, es decir, 0,54 veces el coste y 0,47 veces el tiempo para Neon.
| Agente y modelo | Índice de agentes de código | Coste por tarea | Tiempo por tarea |
|---|---|---|---|
Antigravity CLI con Gemini 4 Neon xhigh | 58,6 | 6,86 $ | 30,5 min |
Claude Code con Claude Opus 5.5 max | 58,2 | 12,61 $ | 65,3 min |
Codex con GPT-6.2 Sol xhigh | 49,8 | 0,90 $ | 12,6 min |
Codex con GPT-6.2 Sol medium | 45,4 | 0,57 $ | 8,4 min |
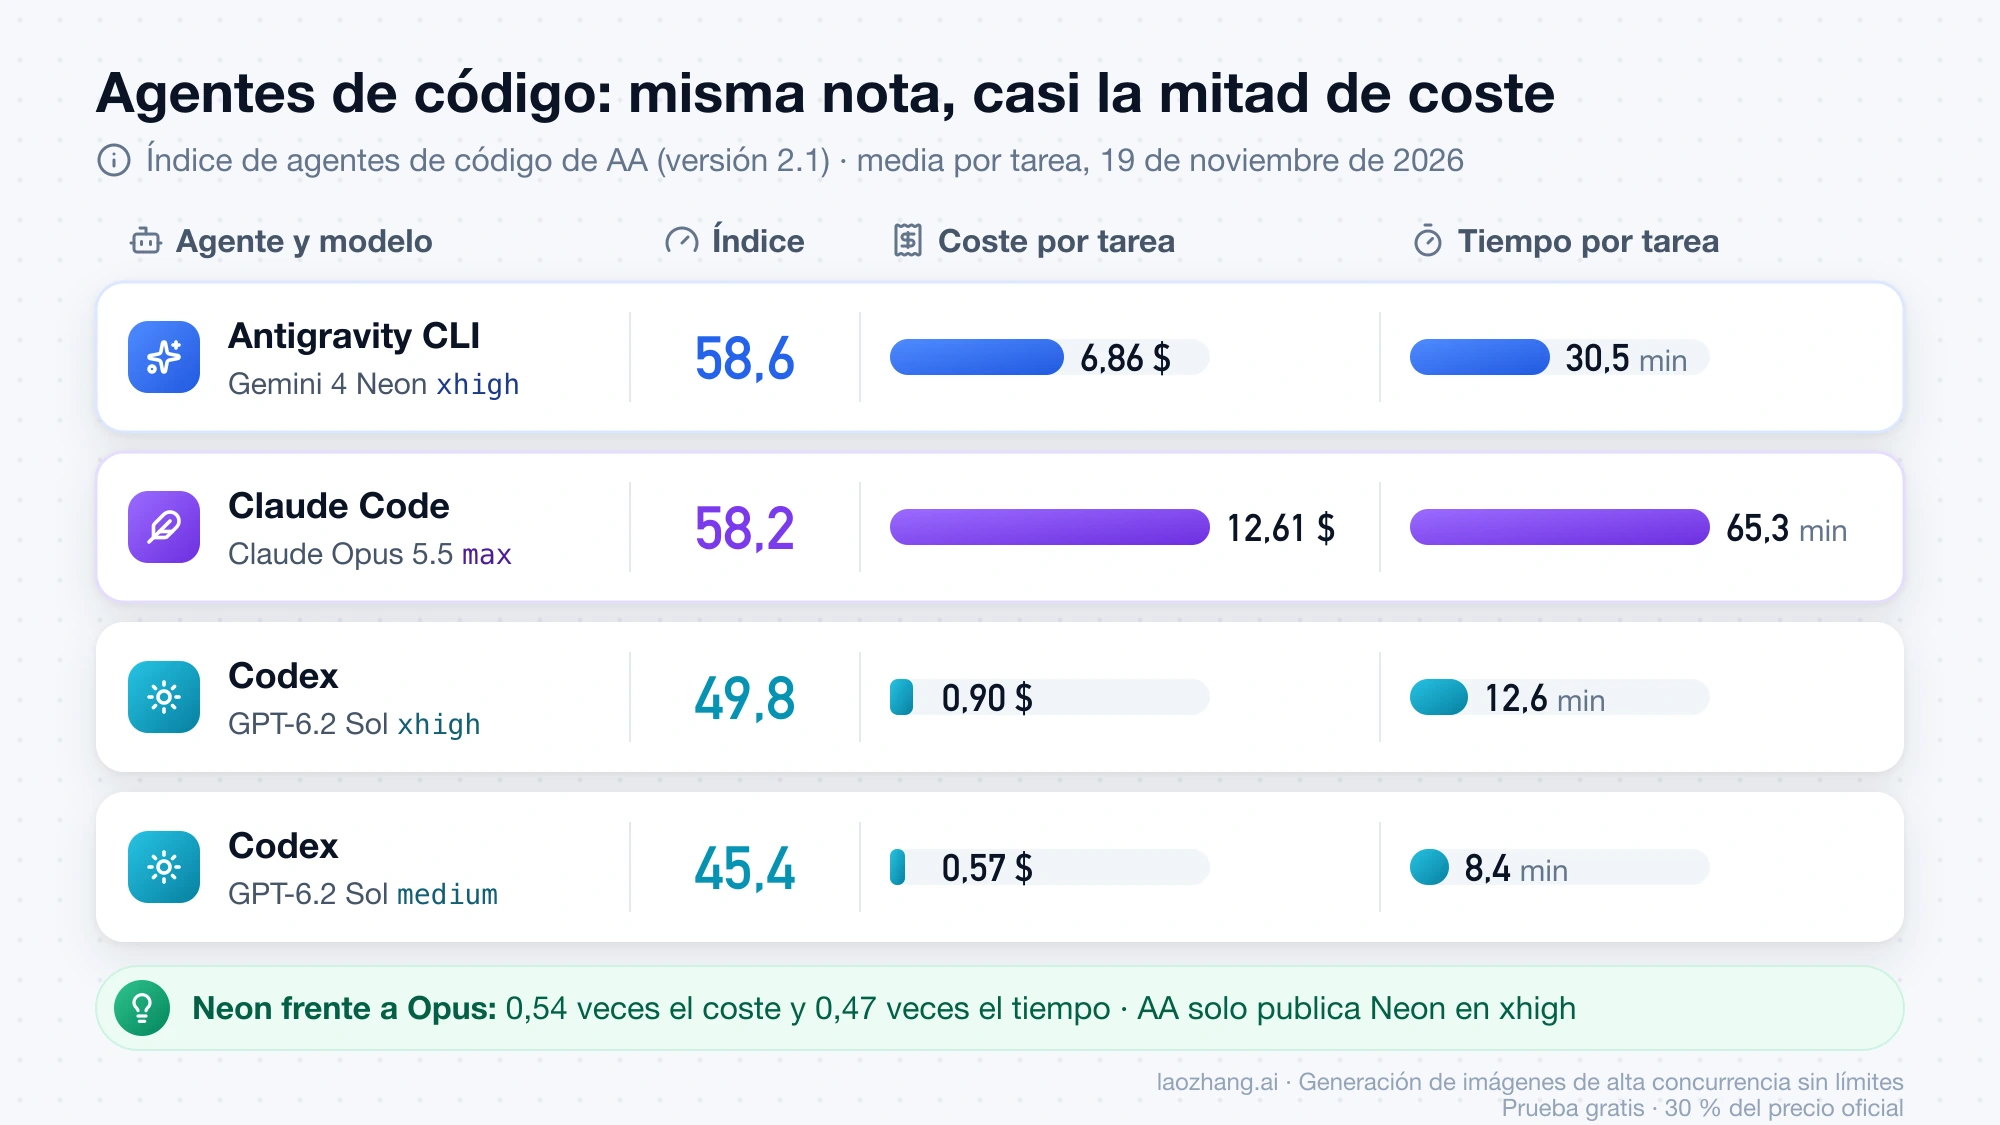
El índice combina FrontierCode-AA 2.0, Terminal-Bench 4.1 y SWE-Atlas-QnA-AA, con tres intentos por tarea, y mide al agente completo, no solo al modelo. AA solo ha publicado Neon en xhigh, así que no hay datos de Neon en high como agente. La mejor fila de Sol es xhigh: en max baja a 48,6 y cuesta 1,22 $. Con 59 puntos redondeados, Neon encabeza la clasificación por delante de Claude Fable 5.2 en xhigh (58). No mezcles los 6,86 $ de esta tabla con los 6,44 $ de Neon en xhigh del índice de inteligencia: son dos métricas distintas con tareas distintas.
Prueba del 18 de noviembre: Sol y Opus aciertan 12 de 12; Neon no se probó
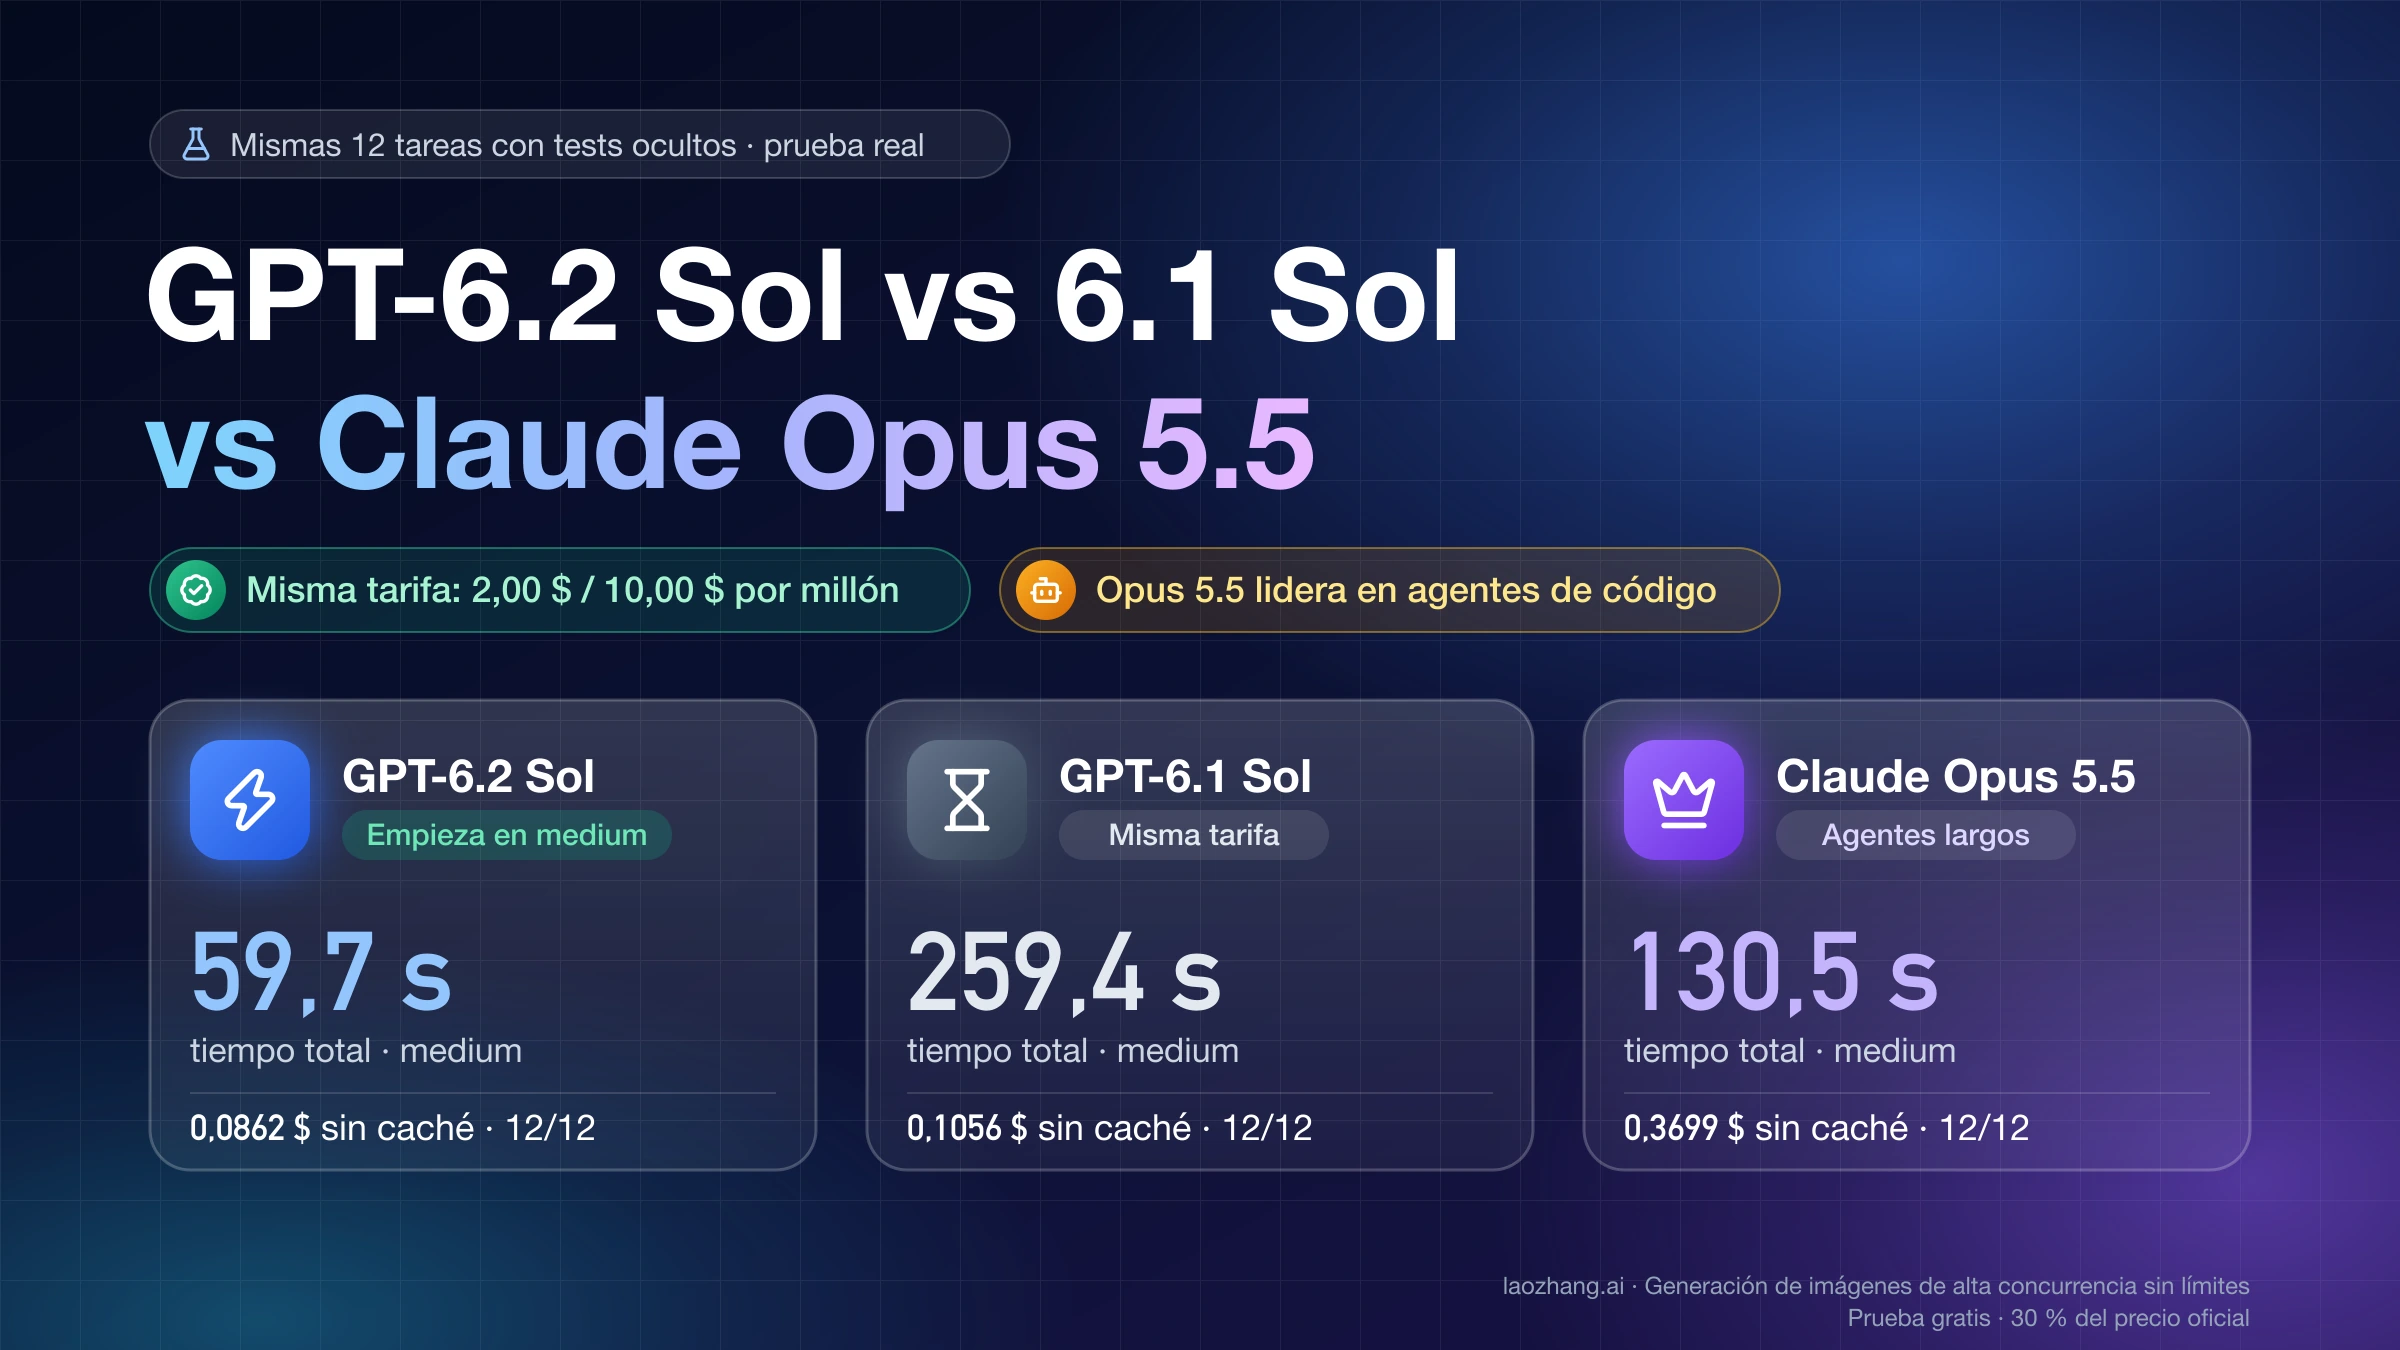
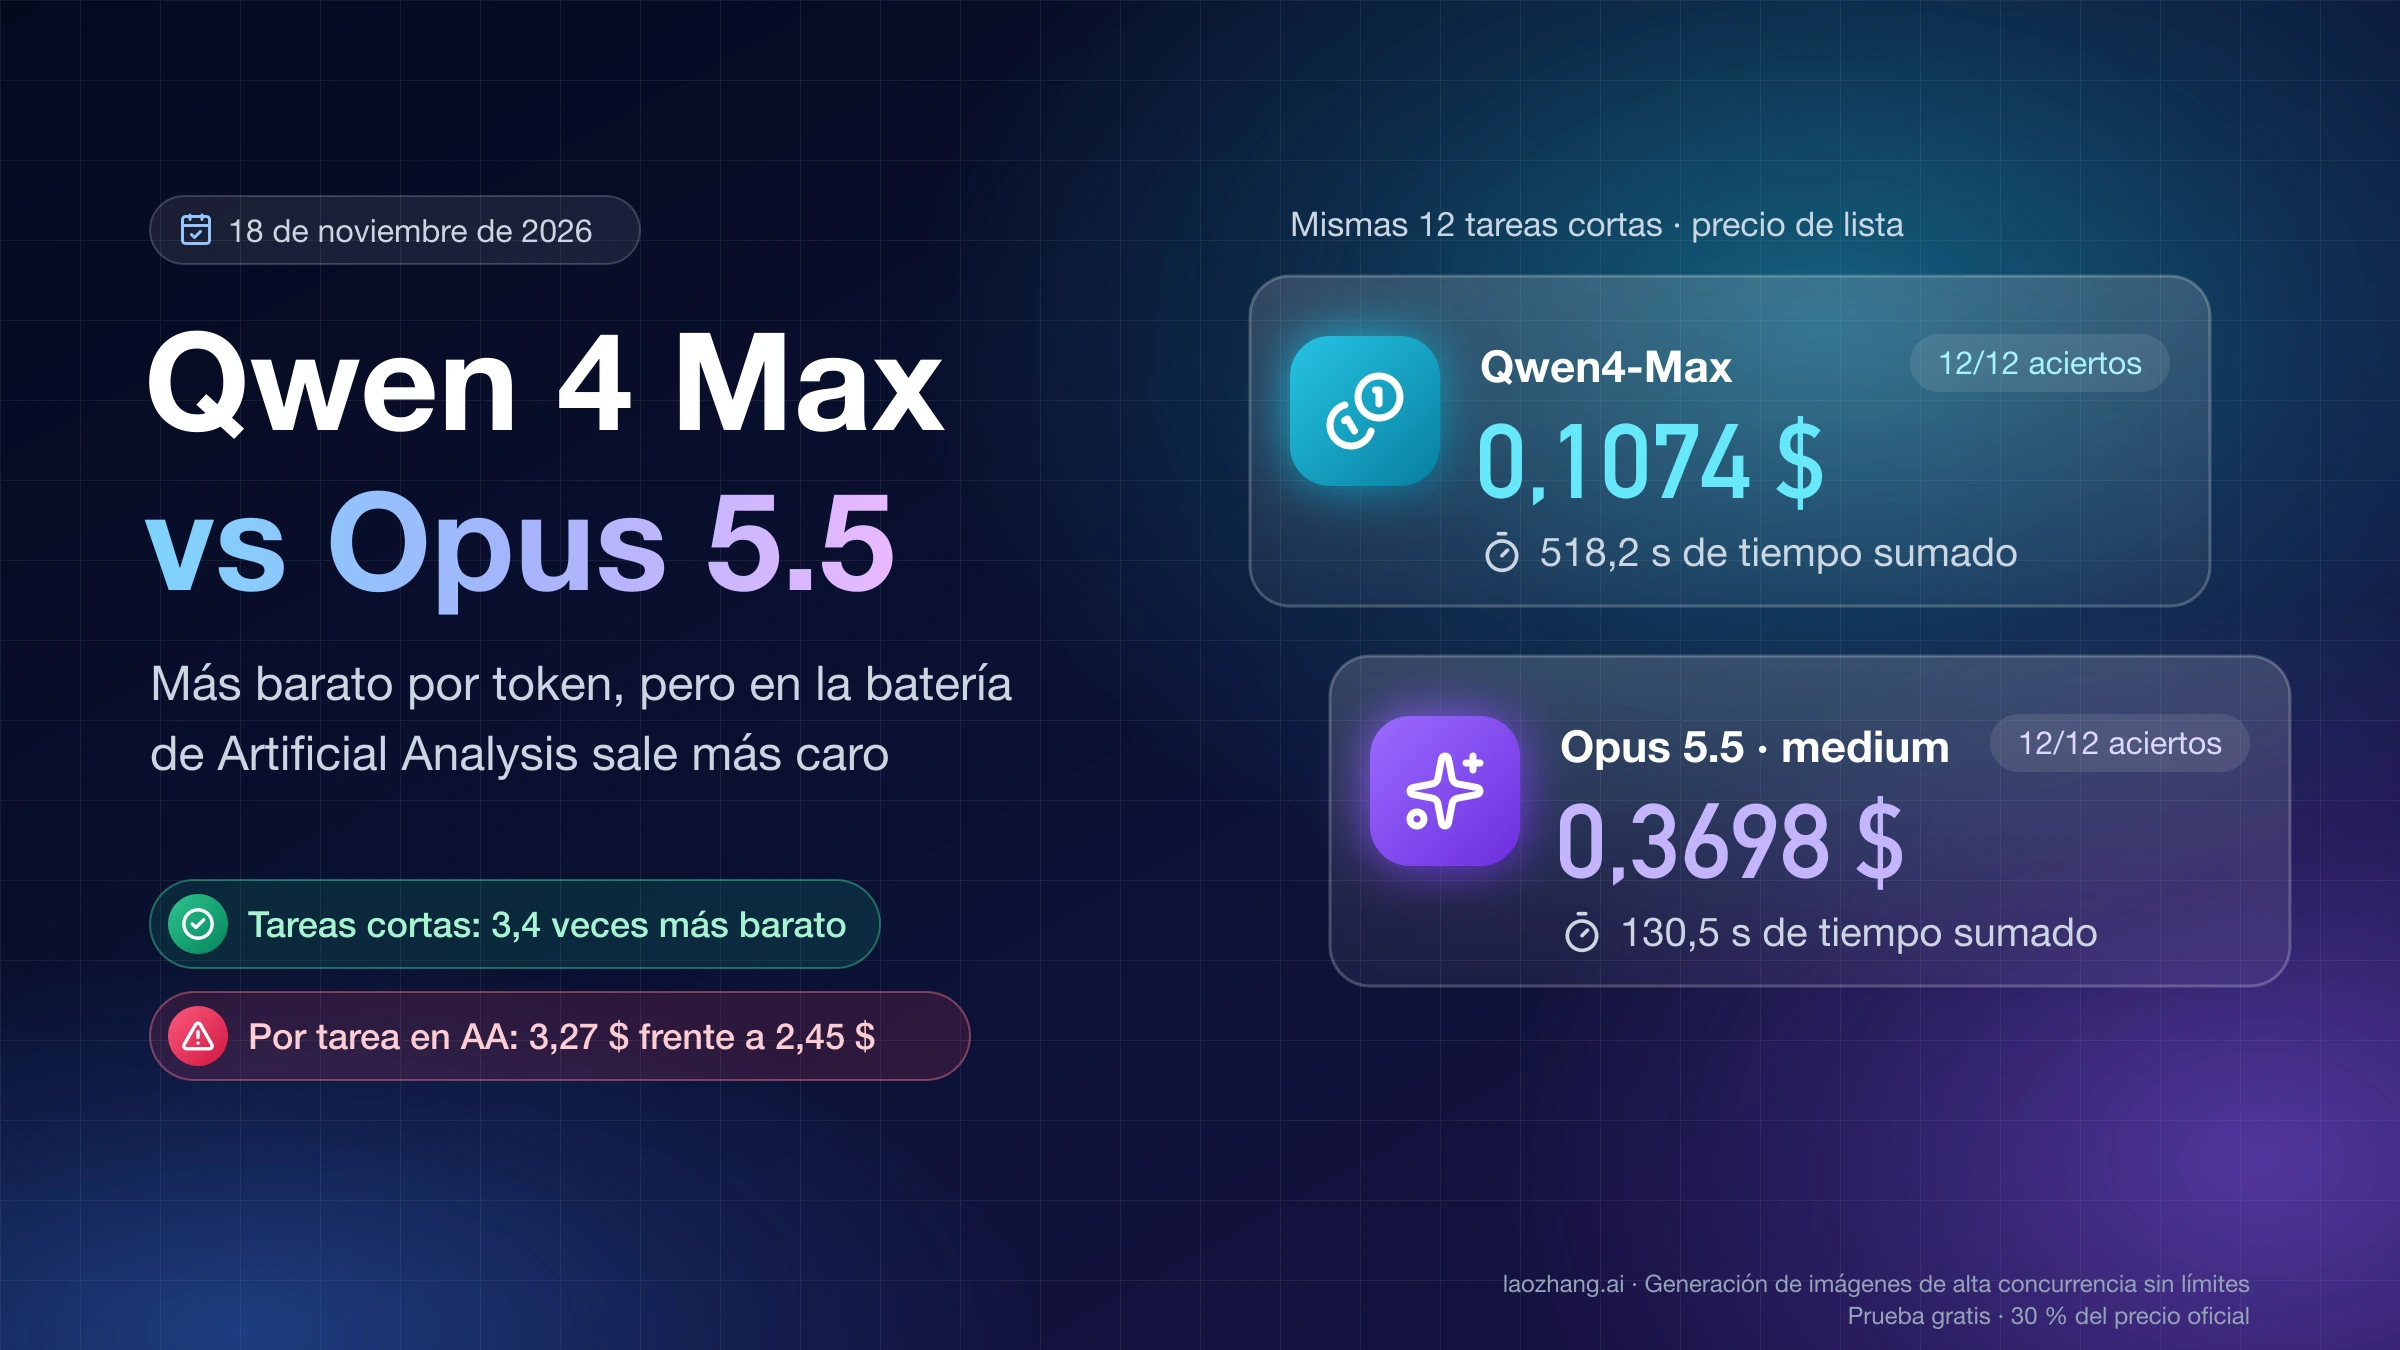
En 12 tareas cortas con respuesta comprobable, GPT-6.2 Sol y Claude Opus 5.5 acertaron todas, y Opus en medium costó 5,13 veces lo que Sol con su nivel por defecto. Eran tareas de un solo turno, funciones de programación evaluadas con tests ocultos y problemas con respuesta exacta, enviadas a través de la pasarela de laozhang.ai: Sol el 18 de noviembre de 2026 por /v1/chat/completions, y Opus por /v1/messages con razonamiento adaptativo y output_config.effort, 8 de sus tareas el 11 de noviembre y las otras 4 el 18. Gemini 4 Neon no entró en esta prueba: el 19 de noviembre todavía no estaba disponible en esa pasarela y la cuenta gratuita de AI Studio lo tenía bloqueado, así que todas sus cifras en este artículo vienen de Google y de AA.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Configuración | Aciertos | Tokens de salida | Tiempo total | Coste facturado |
|---|---|---|---|---|
GPT-6.2 Sol, por defecto (medium) | 12/12 | 4.220 | 59,7 s | 0,0721 $ |
GPT-6.2 Sol, high | 12/12 | 6.765 | 76,6 s | 0,1217 $ |
Claude Opus 5.5, medium | 12/12 | 11.833 | 130,5 s | 0,3699 $ |
Claude Opus 5.5, high | 12/12 | 13.674 | 159,3 s | 0,4067 $ |
Opus en medium frente a Sol por defecto: 5,13 veces el coste facturado (4,29 veces si se quita el descuento de caché que recibió Sol, cuyo coste sin caché sería 0,0862 $), 2,19 veces el tiempo y 2,80 veces los tokens de salida. En una segunda tarea, contar siete cifras exactas en un log de 146 KB, los dos acertaron todo: Sol por defecto tardó 13,6 s y costó 0,1581 $ el 18 de noviembre, y Opus en medium, 57,6 s y 0,4681 $ el 11 de noviembre. El mismo archivo ocupó 78.537 tokens de entrada en Opus y 55.843 en Sol, 1,41 veces más, así que con documentos largos Opus no solo cobra el doble por token, también cuenta más tokens.
Los límites pesan tanto como las cifras. Las tareas eran fáciles para los dos modelos, así que la prueba mide tiempo y dinero para un mismo resultado, no una diferencia de capacidad; cada combinación se ejecutó una sola vez, y los tiempos son de reloj a través de la pasarela, no la latencia del fabricante. La prueba completa, con GPT-6.1 Sol incluido, está en GPT-6.2 Sol vs 6.1 Sol vs Opus 5.5: prueba real y cuál usar.
Precio por millón de tokens: Neon 3/15 $, Opus 4/20 $, Sol 2/10 $
Por token, Gemini 4 Neon cuesta 0,75 veces lo que Claude Opus 5.5 y 1,5 veces lo que GPT-6.2 Sol, y Opus cuesta el doble que Sol. Estas son las tarifas Standard de cada API a 19 de noviembre de 2026, según la página de precios de la API de Gemini, la página de precios de la API de OpenAI y la página de precios de la API de Claude:
| Por millón de tokens | Gemini 4 Neon | GPT-6.2 Sol | Claude Opus 5.5 |
|---|---|---|---|
| Entrada | 3,00 $ | 2,00 $ | 4,00 $ |
| Entrada en caché (lectura) | 0,15 $ | 0,10 $ | 0,20 $ |
| Salida, razonamiento incluido | 15,00 $ | 10,00 $ | 20,00 $ |
| Contexto largo | Sin recargo | Más de 272.000 tokens de entrada: toda la petición a 4,00 $ / 15,00 $ | Sin recargo en todo el millón de tokens |
| Batch: entrada / salida | 1,50 $ / 7,50 $ | 50 % de la tarifa | 2,00 $ / 10,00 $ |
| Ventana de contexto | 1.048.576 tokens | 1.050.000 tokens | 1 millón de tokens |
| Entradas admitidas | Texto, imagen, vídeo, audio, PDF | Texto, imagen | Texto, imagen |
La diferencia por token se agranda por tarea porque cada modelo gasta un número distinto de tokens: en high, Neon genera 90.188 tokens de salida por tarea del índice y Sol 20.160, así que el 1,5× por token se convierte en 6,7× por tarea (3,74 $ / 0,56 $). En la caché también hay diferencias: Neon solo tiene caché implícita, sin caché explícita; Sol cobra 2,50 $ por millón al escribir en su caché de 30 minutos, y Opus 5 $ en la de 5 minutos y 8 $ en la de una hora. La ficha de Gemini 4 Neon en la documentación de Google no pone fecha final a esa tarifa, y Google no ha anunciado ninguna subida.
Benchmarks de Google: Neon lidera 16 de 19, salvo en tres
Según la tabla de benchmarks que publicó Google, recogida por OfficeChai en su resumen de benchmarks de Gemini 4 Neon, Neon queda primero en 16 de los 19 resultados frente a Opus 5.5 y GPT-6.2 Sol. Las mayores distancias están en GraphWalks con contextos de 256.000 a 1 millón de tokens (95,2 % frente a 66,8 % de Opus y 80,1 % de Sol), AutomationBench (56,3 % frente a 42,5 % y 41,3 %) y SWE-sweep (39,0 % frente a 10,1 % y 8,3 %), esta última con el entorno de cada proveedor, que en el caso de Neon es Antigravity. Los tres resultados que no lidera son Terminal-Bench 4.1 y FrontierCode 2.0, donde va Opus por delante, y Chartography, donde gana Sol (75,1 % frente a 73,5 %). Son cifras medidas por Google sobre sus propias pruebas, sin reproducción independiente.
¿Se puede probar Gemini 4 Neon gratis? No, ni en la API ni en la app
No hay forma gratuita de usar Gemini 4 Neon. La documentación de precios de Google dice que «Gemini 4 Neon is not available on the Free tier», así que en la API necesitas facturación activa, y en AI Studio el selector de modelos lo marca como «Paid»: el 19 de noviembre de 2026, al elegirlo con una cuenta gratuita, aparecía el aviso de que solo está disponible con un plan de Google AI o pagando por petición con una clave de API, con el nivel de razonamiento High preseleccionado. Un usuario del hilo de lanzamiento de Gemini 4 Neon en Hacker News lo resumía así: no vas a poder probarlo sin, como mínimo, una suscripción de unos 20 $.
En la app de Gemini, según la página de ayuda de Google sobre los modelos de cada plan, Google AI Pro incluye Auto, Hydrogen y Neon, Ultra añade Carbon, y AI Plus se queda en Auto e Hydrogen. La misma página avisa de que los modelos más avanzados y los niveles de razonamiento más altos consumen más de tu límite de uso. Neon también está en Antigravity para suscriptores de pago de Pro y Ultra; si pensabas conectarlo a otras herramientas a través de esa suscripción, otro usuario del mismo hilo señala que las preguntas frecuentes de Antigravity consideran una violación de sus términos acceder a Antigravity con software de terceros.
Google no ha dicho que Neon sustituya a Gemini 4 Argon. La página de ayuda de la app ya no menciona Argon (el 16 de noviembre todavía lo listaba para Pro y Ultra), pero en la API Argon sigue disponible y sin fecha de retirada. Si lo que necesitas es acceder a Opus 5.5, los planes y las formas de probarlo están en Cómo usar Claude Opus 5.5: qué plan pide y cómo probarlo gratis.
Cómo fijar el nivel de razonamiento en Gemini, OpenAI y Anthropic
Cada API usa un parámetro distinto y un valor por defecto distinto, así que al migrar fija el nivel de forma explícita en lugar de confiar en el que traiga el modelo:
- Gemini API:
thinking_level(en REST,generationConfig.thinkingConfig.thinkingLevel), conlow,medium,highyxhigh. Neon usahighsi no indicas nada; Google recomienda empezar ahí y reservarxhighpara problemas difíciles de varios pasos, porque en peticiones sencillas puede pensar de más o agotarmax_output_tokens. - OpenAI:
reasoning.efforten la Responses API yreasoning_efforten Chat Completions, conlow,medium(por defecto),high,xhighymax; GPT-6.2 Sol rechazanone. A través de laozhang.ai,maxfalla en Chat Completions, así que para ese nivel usa la Responses API. - Anthropic:
output_config.effortjunto conthinking: {"type": "adaptive"}. Declara los dos: a través de laozhang.ai, omitirthinkingdejó las respuestas sin bloques de razonamiento en una prueba con Sonnet 5.5 del 26 de octubre de 2026.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 19 nov 2026.
Fuentes11
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 19 nov 2026.
- 1.índice de inteligencia de Artificial Analysis, comparativa Gemini 4 Neon frente a Claude Opus 5.5artificialanalysis.ai/models/comparisons/gemini-4-neon-vs-claude-opus-5-5
- 2.comparativa Gemini 4 Neon frente a GPT-6.2 Solartificialanalysis.ai/models/comparisons/gemini-4-neon-vs-gpt-6-2-sol
- 3.anuncio de Gemini 4 Neon en el blog de Googleblog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon
- 4.índice de agentes de código de Artificial Analysisartificialanalysis.ai/agents/coding
- 5.página de precios de la API de Geminiaistudio.google.com/docs/pricing
- 6.página de precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing
- 7.página de precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 8.ficha de Gemini 4 Neon en la documentación de Googleaistudio.google.com/docs/models/gemini-4-neon
- 9.OfficeChai en su resumen de benchmarks de Gemini 4 Neonofficechai.com/ai/gemini-4-neon-benchmarks
- 10.hilo de lanzamiento de Gemini 4 Neon en Hacker Newsnews.ycombinator.com/item
- 11.página de ayuda de Google sobre los modelos de cada plansupport.google.com/gemini/answer/18648722