Gemini 4 Hydrogen vs GPT-6.2 Sol: cuál elegir y coste por tarea
Gemini 4 Hydrogen cobra un 25 % menos por token, pero en 11 llamadas iguales costó 3,6 veces lo de GPT-6.2 Sol. Sol por defecto; Hydrogen con presupuesto cero.
En esta página
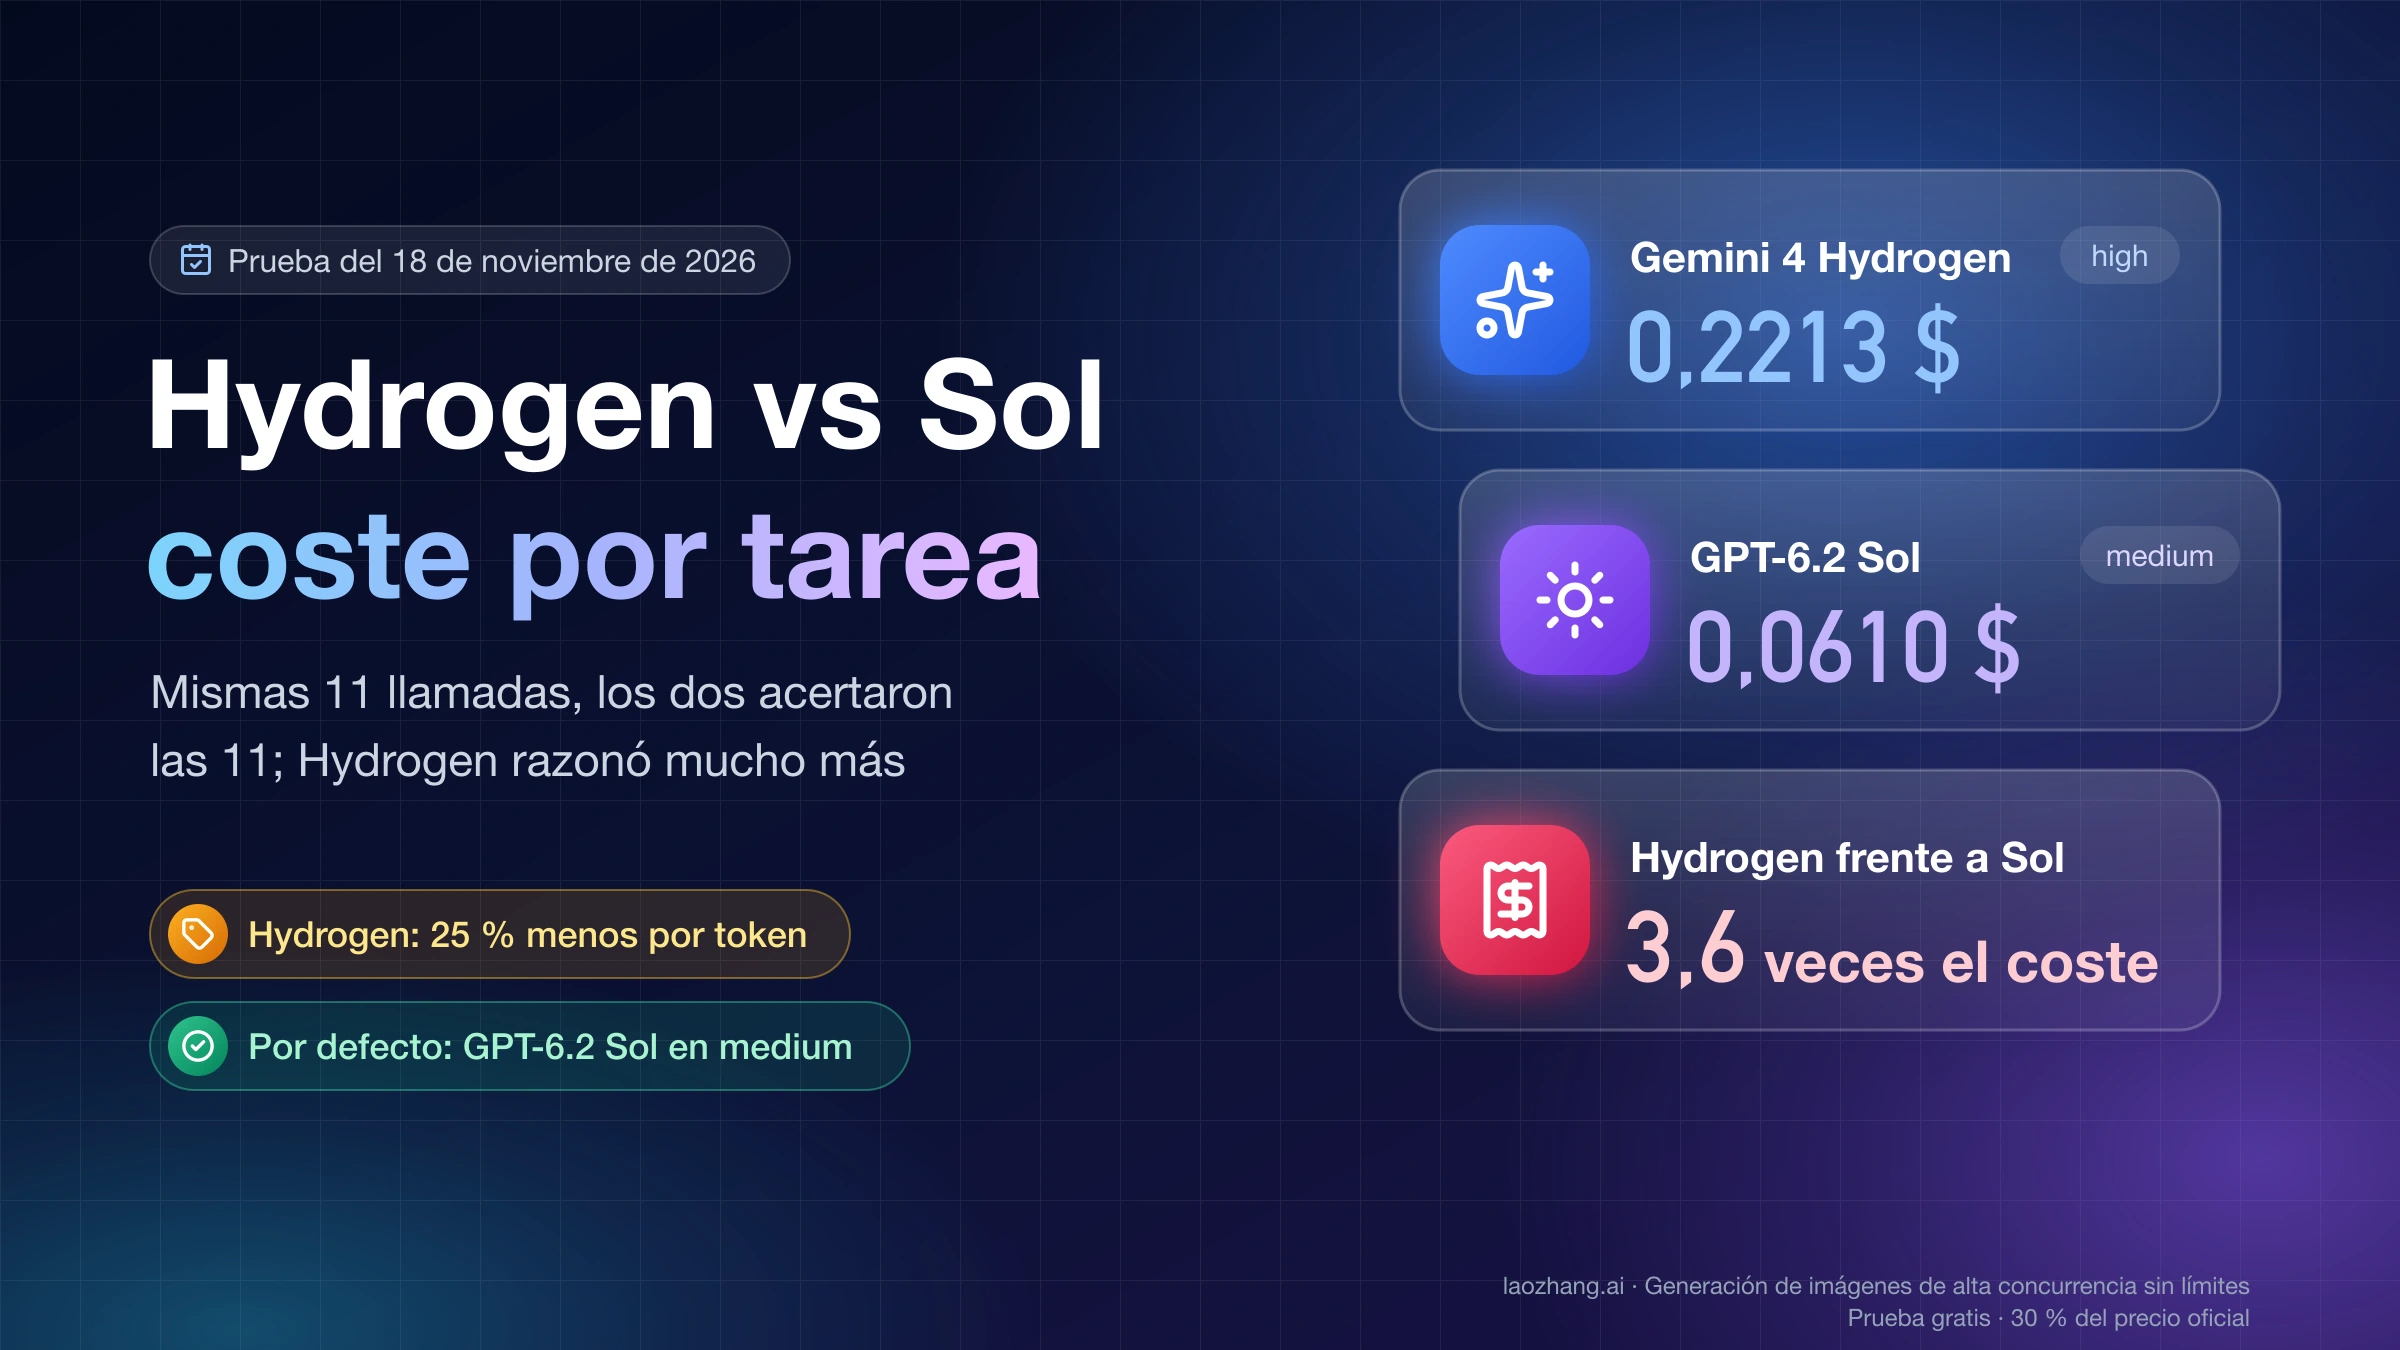
Si llamas a los modelos por la API o programas con Codex, deja gpt-6.2-sol en medium, su nivel por defecto, como modelo para el día a día. Gemini 4 Hydrogen cobra un 25 % menos por token, pero en su nivel por defecto, high, razona mucho antes de contestar, y esos tokens de razonamiento se pagan como salida. El 18 de noviembre de 2026 se enviaron las mismas 11 llamadas a los dos modelos, cada uno en su valor por defecto: ambos acertaron las 11, Hydrogen escribió 7 veces más tokens de salida, costó 0,2213 $ frente a 0,0610 $ (3,6 veces más) y tardó una mediana de 15,6 s por llamada frente a 5,0 s.
Hydrogen pasa a ser la mejor opción en cuatro casos. Si tu presupuesto es cero, porque la API de Gemini tiene un nivel gratuito y GPT-6.2 Sol no; si mandas vídeo, audio o PDF, que Sol no acepta; si tus peticiones superan los 272.000 tokens de entrada, porque a partir de ahí Sol factura la petición entera con recargo y Hydrogen mantiene su tarifa; y si el trabajo depende de recordar datos o de automatizar flujos, donde Hydrogen puntúa por delante en las pruebas de Artificial Analysis.
No intentes abaratar Hydrogen bajándolo a medium: en las mismas llamadas, el 16 de noviembre, seguía costando 3,16 veces lo que Sol por defecto, y su nota en el índice de Artificial Analysis cae de 51 a 41 puntos. Si Sol en medium falla una tarea, súbelo a high, que en la prueba costó 1,33 veces más y tardó casi lo mismo. GPT-6.2 Sol salió el 17 de noviembre de 2026 al mismo precio que GPT-6.1 Sol, y Gemini 4 Hydrogen está disponible de forma general desde el 12 de noviembre.
Qué modelo dejar por defecto según tu tipo de trabajo
Para peticiones sueltas a la API, código y agentes en Codex, el punto de partida es GPT-6.2 Sol en medium; Gemini 4 Hydrogen gana cuando cambian el presupuesto, el tipo de entrada o la longitud de la petición. La tabla resume en qué condición cambia la elección, y cada fila se apoya en una sección de más abajo.
| Si tu trabajo es… | Empieza con | Cuándo cambiar |
|---|---|---|
| Peticiones sueltas a la API: código, extracción, preguntas con respuesta exacta | gpt-6.2-sol en medium | Si falla una tarea comprobable, sube Sol a high antes de cambiar de modelo |
| Tareas largas de agente en terminal o sobre un repositorio | GPT-6.2 Sol en Codex, en medium o high | Hydrogen en xhigh dentro de Antigravity puntúa algo más, con muchos más pasos y coste |
| Prototipos sin presupuesto | Hydrogen en el nivel gratuito de la API de Gemini | Cuando pases a producción o manejes datos que no quieras ceder: los del nivel gratuito se usan para mejorar productos de Google |
| Entradas de vídeo, audio o PDF | Hydrogen | Sol solo acepta texto e imágenes |
| Peticiones de más de 272.000 tokens de entrada | Hydrogen, y mide con tus datos | Sol pasa a 4 $ y 15 $ por millón en toda la petición; no hay mediciones propias por encima de esa línea |
| Preguntas que dependen de lo que el modelo recuerda, flujos de automatización | Prueba Hydrogen en high | Compara el coste por respuesta correcta, no el precio por token |
El tipo de trabajo pesa más que la marca. Las peticiones cortas y bien especificadas son justo donde Hydrogen razona de más y Sol responde casi sin razonar, así que ahí la diferencia de coste es mayor; en documentos largos y en tareas sencillas de código se reduce mucho, aunque en la prueba nunca llegó a invertirse.
Prueba del 18 de noviembre: mismas 11 llamadas, 3,6 veces el coste
El 18 de noviembre de 2026, entre las 03:18 y las 03:20 UTC, se enviaron las mismas 11 llamadas a Gemini 4 Hydrogen y a GPT-6.2 Sol a través de la pasarela de laozhang.ai, cada modelo en su nivel por defecto de la API y Sol también en high. Las tres configuraciones acertaron las 11, así que lo que las separa es cuántos tokens gastan, cuánto cuestan y cuánto hacen esperar.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Configuración | Aciertos | Tokens de entrada | Tokens de salida (de ellos, razonamiento) | Coste a precio de lista | Segundos sumados | Mediana por llamada |
|---|---|---|---|---|---|---|
Gemini 4 Hydrogen, high (por defecto) | 11/11 | 12.712 | 26.966 (21.565) | 0,2213 $ | 206 s | 15,6 s |
GPT-6.2 Sol, medium (por defecto) | 11/11 | 11.407 | 3.820 (628) | 0,0610 $ | 56 s | 5,0 s |
GPT-6.2 Sol, high | 11/11 | 11.407 | 5.843 (2.610) | 0,0812 $ | 66 s | 5,0 s |
Hubo ocho tareas evaluadas con tests ocultos o respuesta exacta: un problema de enunciado, unir intervalos, interpretar una cadena de duración, contar las palabras más frecuentes y resumir en cinco puntos un documento de unos 11.000 tokens, con una muestra cada una; y un evaluador de expresiones, un separador de líneas CSV y un problema de razonamiento con sumas de dígitos, con dos muestras cada una. Hydrogen se llamó por su API nativa (generateContent) con thinkingLevel en high, el valor por defecto de Google; Sol, por Chat Completions sin enviar reasoning_effort, que en esta ruta queda en medium. Todas las llamadas fueron de un solo turno, sin streaming, sin instrucciones de sistema ni herramientas, cuatro en paralelo.
El coste sale de multiplicar los tokens por la tarifa de lista, con toda la entrada al precio sin caché y la salida con el razonamiento incluido. Hydrogen: 12.712 × 1,50 $ + 26.966 × 7,50 $ por millón = 0,0191 $ + 0,2022 $ = 0,2213 $. Sol en medium: 11.407 × 2,00 $ + 3.820 × 10,00 $ por millón = 0,0228 $ + 0,0382 $ = 0,0610 $. El cociente es 3,63 en coste, 7,06 en tokens de salida, 1,11 en tokens de entrada y 3,67 en segundos sumados. Frente a Sol en high, Hydrogen sigue costando 2,72 veces más y tarda 3,14 veces más.
Sol en medium fue más barato en las ocho tareas, pero la distancia varía mucho. Donde más se abre es en las tareas cortas que piden razonar: 8,96 veces en las sumas de dígitos, 5,47 en el separador CSV, 4,67 en la cadena de duración y 4,33 en el evaluador de expresiones. Donde casi desaparece es en unir intervalos (1,13 veces, porque ese día Hydrogen solo razonó 110 tokens, frente a 1.763 el 14 de noviembre) y en el resumen del documento largo (1,61 veces). Por grupos, las cinco tareas cortas suman 0,0638 $ frente a 0,0329 $ (1,94 veces) y las tres más difíciles 0,1575 $ frente a 0,0281 $ (5,60 veces).
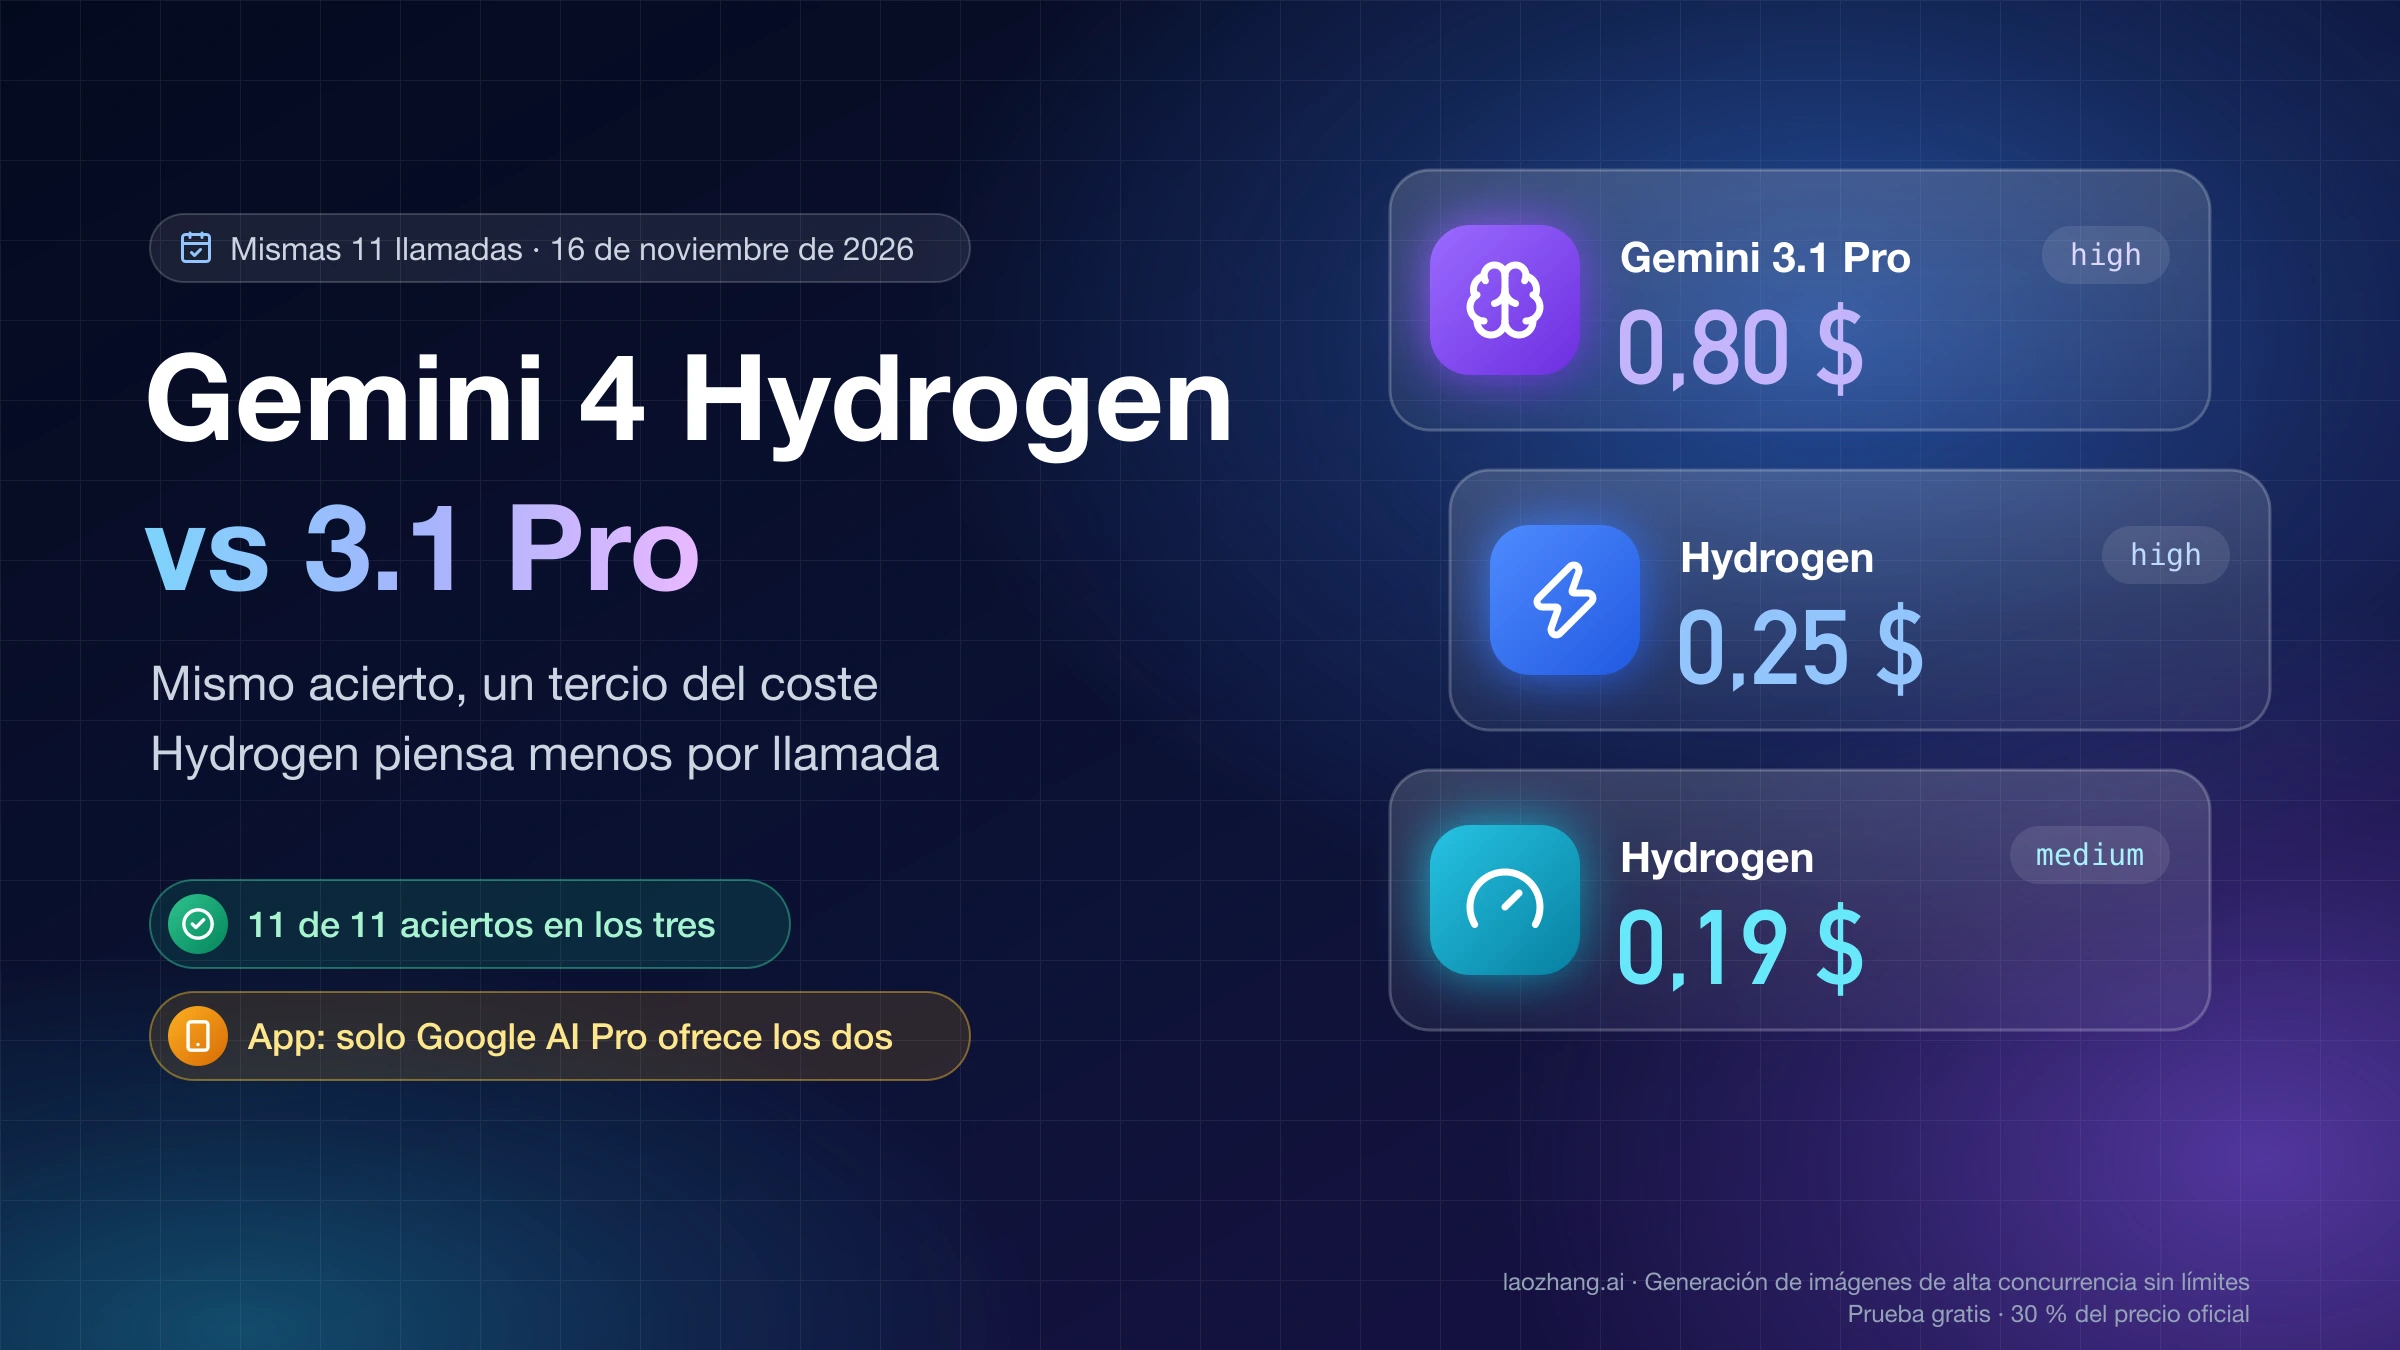
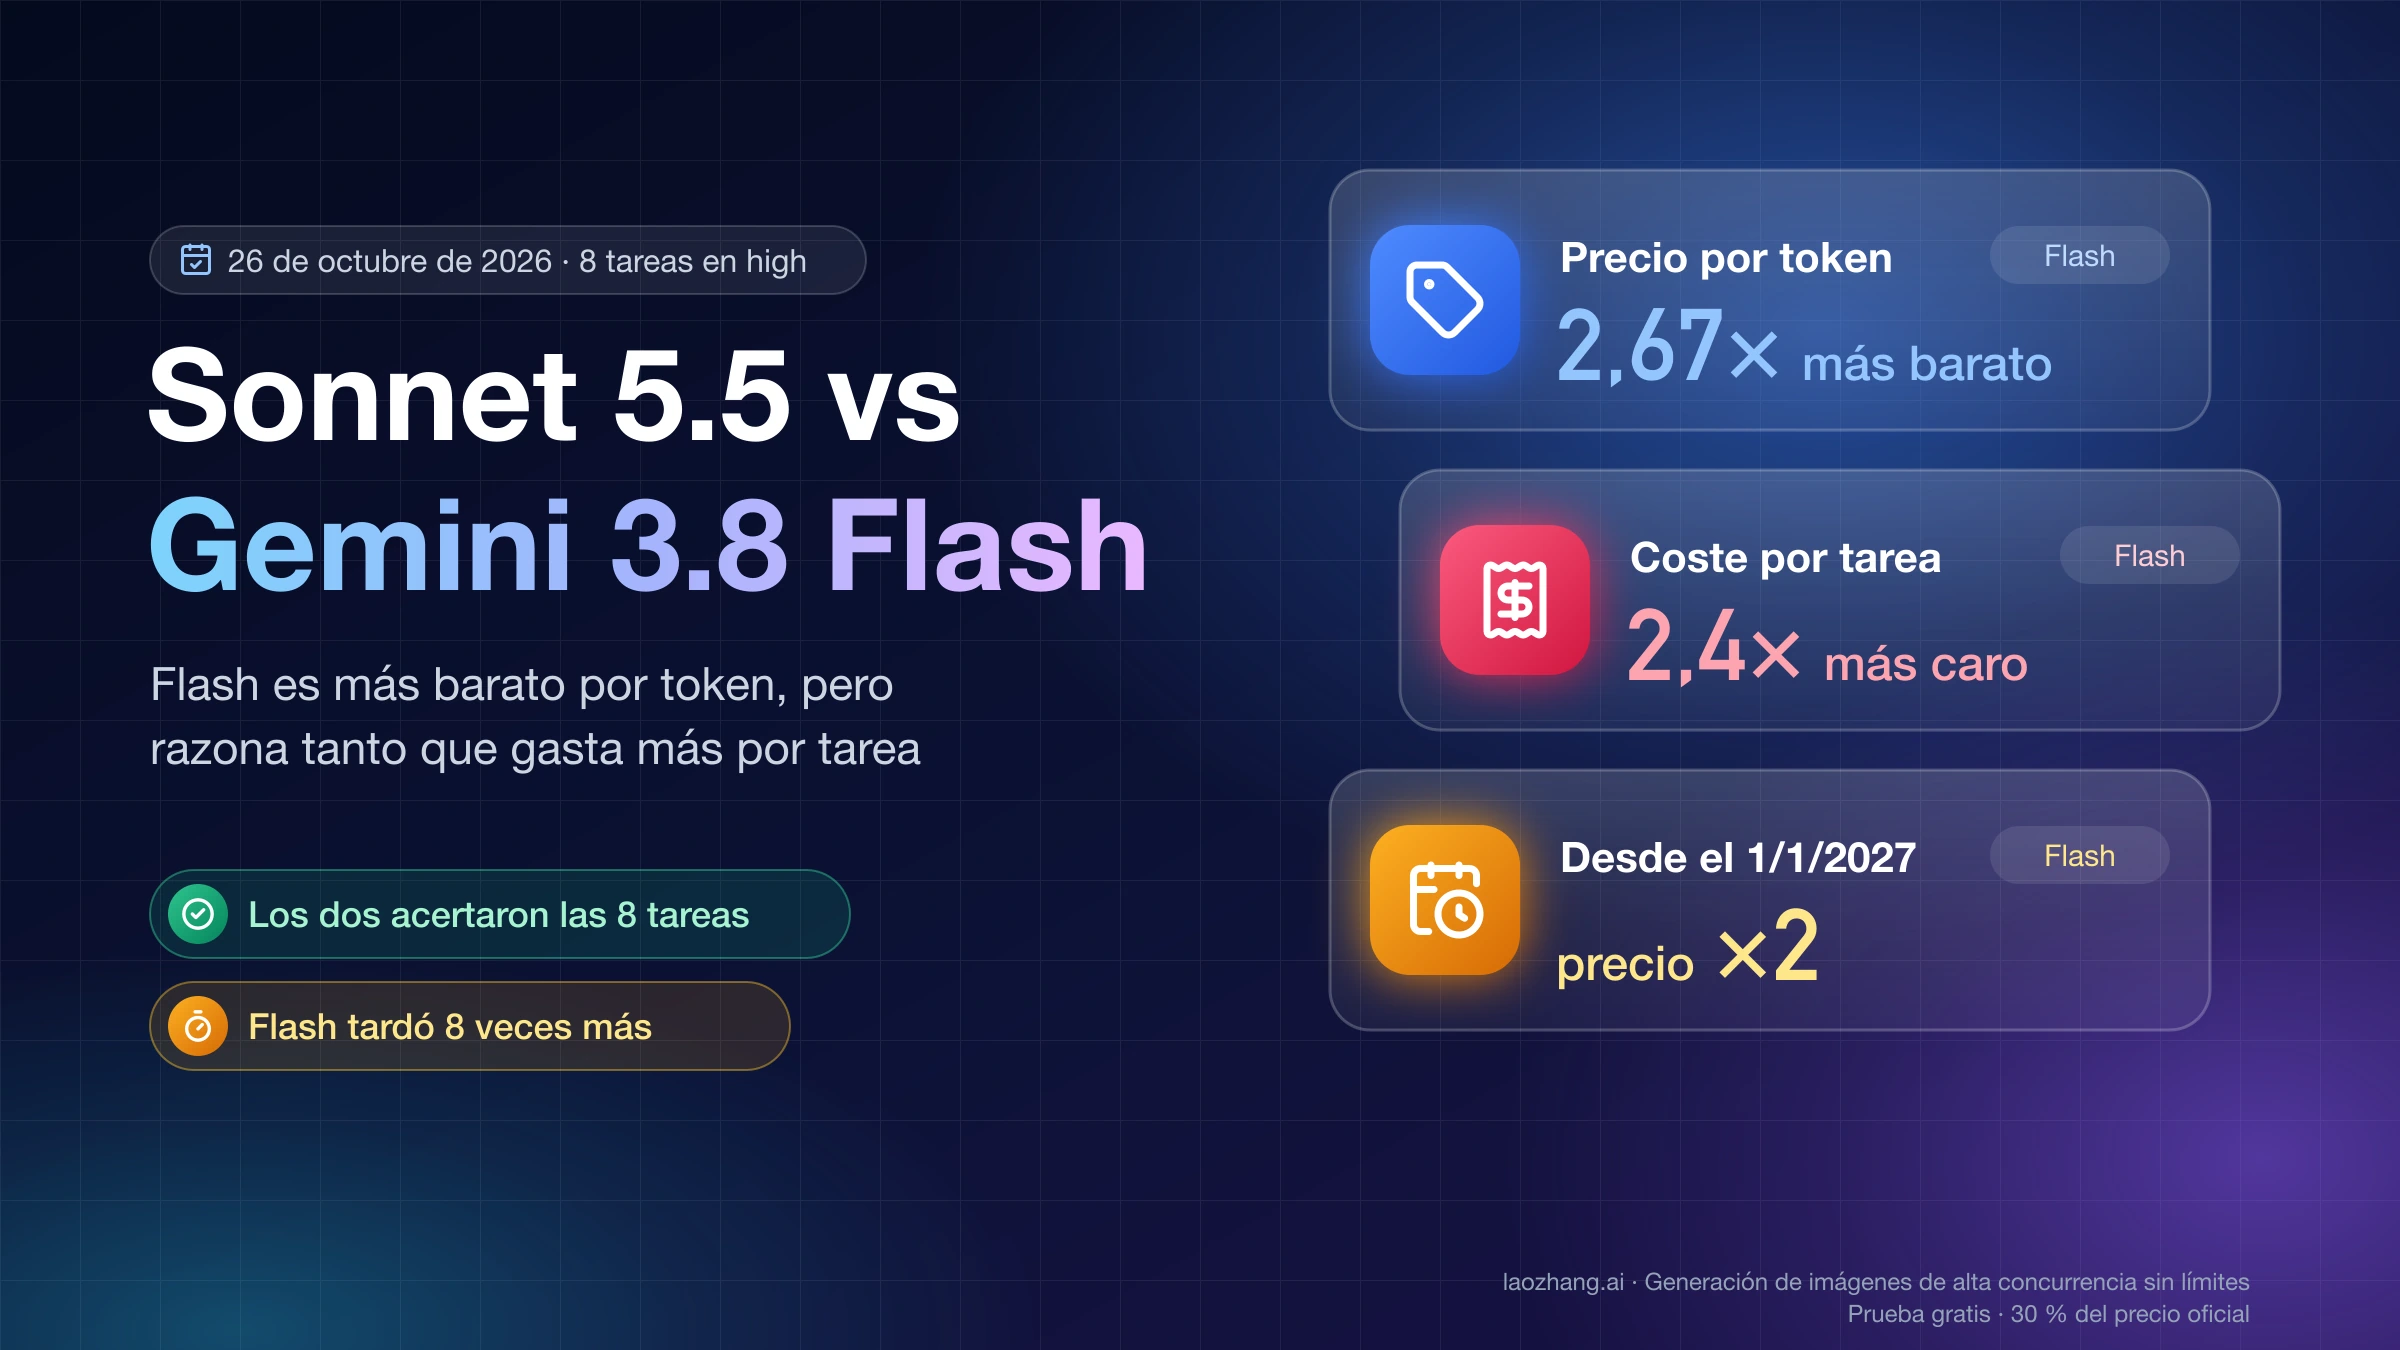
La prueba tiene límites claros. Es una muestra por tarea (dos en tres de ellas), con tareas pequeñas que los dos modelos resolvieron enteras, así que compara tokens, coste y espera, no cuál es más inteligente; para eso están las cifras de Artificial Analysis de más abajo. No incluye conversaciones de varios turnos, herramientas, agentes ni el modo Batch. Los segundos son el tiempo completo de cada llamada por esa pasarela y cambian con la ruta. En el documento largo, Sol devolvió 10.103 tokens de entrada en caché porque el mismo texto se había enviado minutos antes; con ese descuento, Sol en medium saldría a 0,0418 $, pero no es lo que pagarías en una primera llamada. La misma batería de tareas se usó en Gemini 4 Hydrogen vs 3.1 Pro: mismo acierto, un tercio del coste y en Claude Sonnet 5.5 vs Gemini 3.8 Flash y Hydrogen: coste por tarea, que dan 0,251 $ para Hydrogen en la ejecución del 14 de noviembre; la del 18 de noviembre salió en 0,2213 $, porque el volumen de razonamiento cambia de una ejecución a otra.
¿Por qué Hydrogen, más barato por token, sale más caro por trabajo?
Porque el precio por token y lo que cuesta terminar un trabajo son dos cifras distintas, y lo que las separa es el volumen de tokens de razonamiento. En la prueba del 18 de noviembre, 21.565 de los 26.966 tokens de salida de Hydrogen (el 80 %) fueron razonamiento, mientras que Sol en medium razonó 628 tokens de 3.820 y en 6 de las 11 llamadas no razonó nada. Un 25 % de descuento por token no compensa escribir 7 veces más tokens.
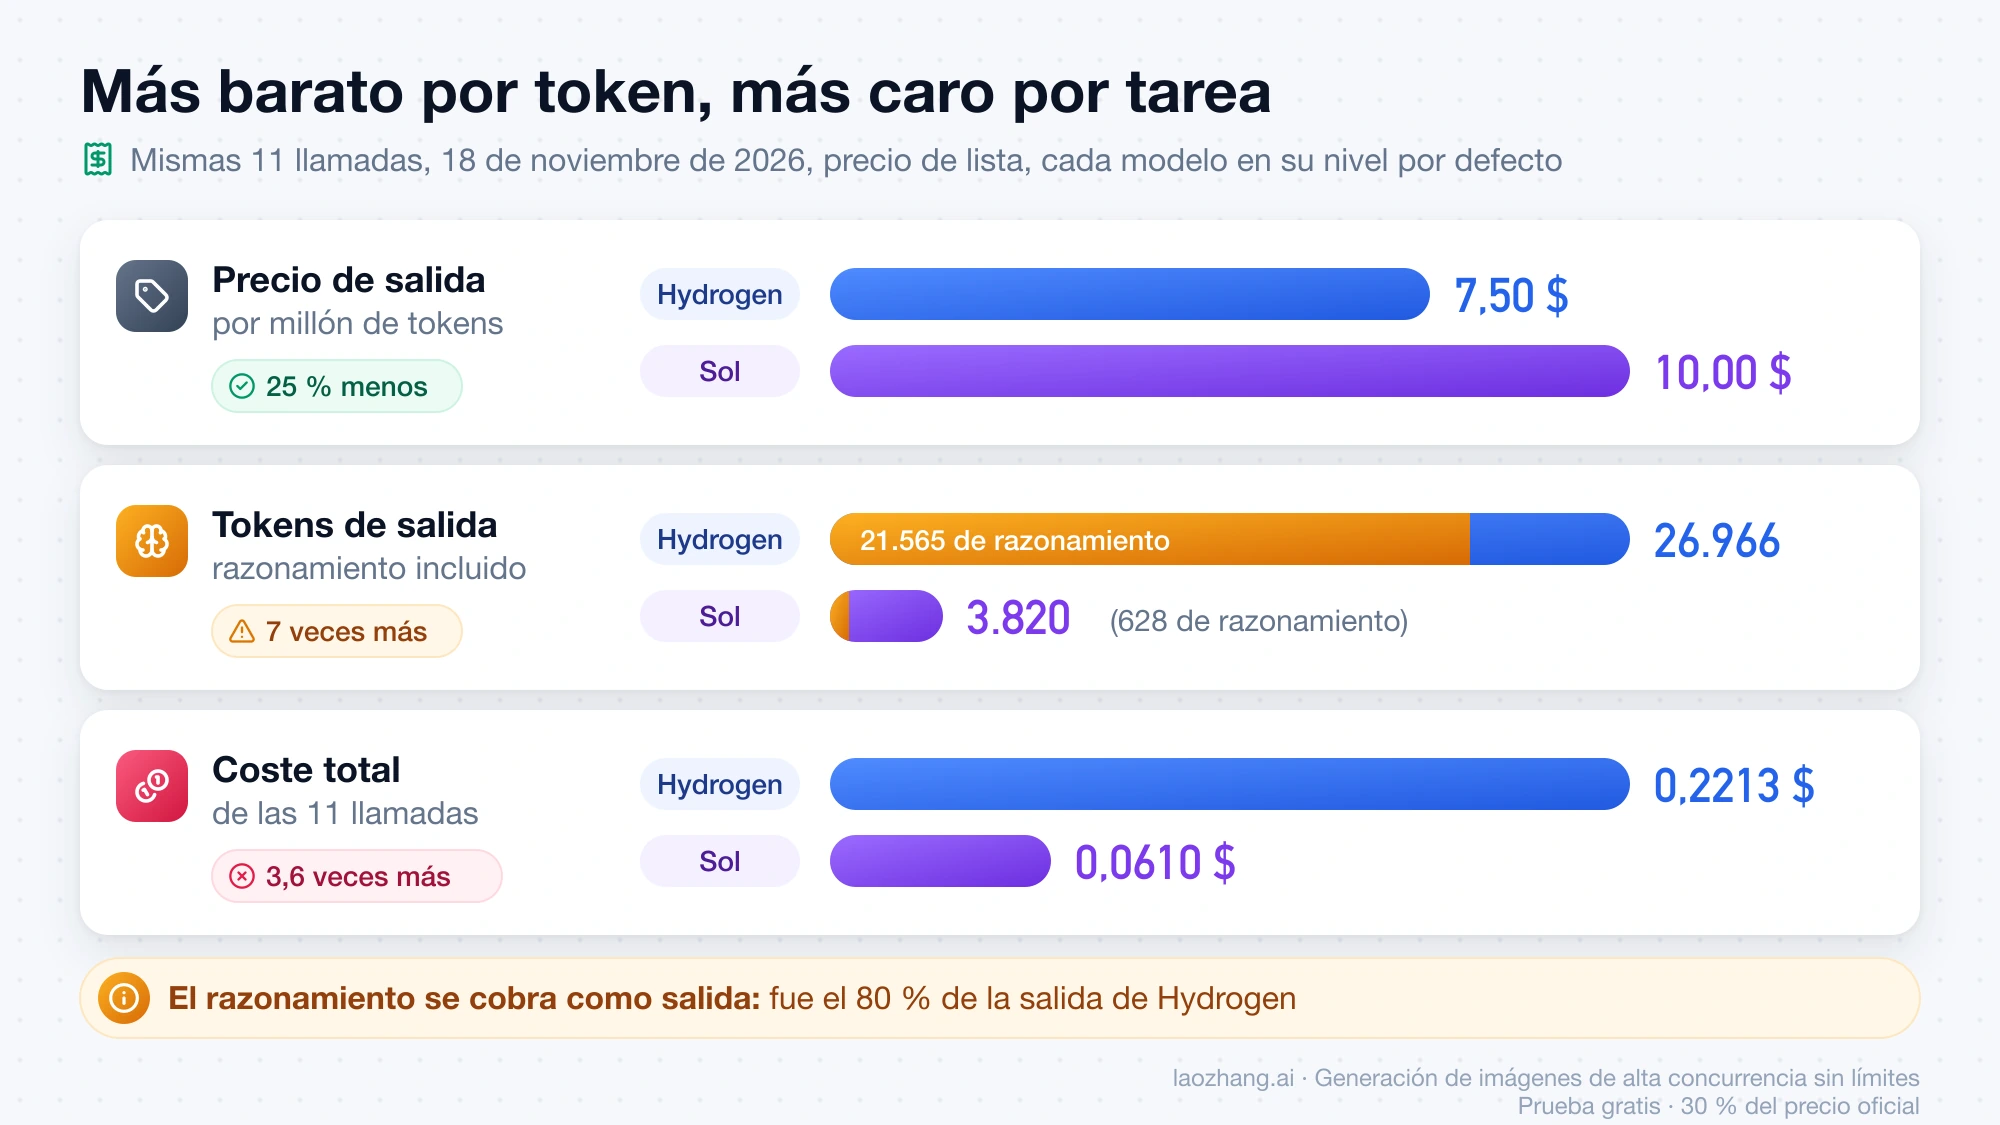
Google cobra los tokens de razonamiento (thinking tokens) al precio de salida, y OpenAI hace lo mismo con los suyos (reasoning tokens), así que la comparación justa es la salida total de cada modelo, razonamiento incluido. La entrada también cuenta distinto: el mismo documento ocupó 11.110 tokens en Hydrogen y 10.106 en Sol, un 10 % más, y en el registro largo de más abajo la diferencia llegó al 42 %. El coste por tarea que publica Artificial Analysis apunta en la misma dirección, con Hydrogen bastante más caro que Sol en el valor por defecto de cada uno.
Si has leído que Hydrogen gasta menos tokens que Sol, lo normal es que la prueba compare otra cosa: GPT-6.1 Sol en lugar de 6.2, dentro de un agente y contando los tokens de toda la sesión. Ese caso se explica en la sección sobre Antigravity y Codex, y no contradice lo medido aquí, porque son trabajos distintos. En un hilo de r/GeminiAI del 15 de noviembre, un usuario que lo comparaba con GPT-6.1 Sol lo resumía así: Hydrogen es mucho más rápido y gasta unas diez veces más tokens. Es una opinión, no una medición.
¿Cuál es más rápido? Hydrogen escribe el doble de rápido, Sol responde antes
Depende de lo que midas: Hydrogen genera más del doble de tokens por segundo, pero GPT-6.2 Sol empieza a contestar mucho antes y termina antes en peticiones cortas. Según Artificial Analysis, a 18 de noviembre de 2026, Hydrogen en high escribe 169 tokens por segundo y Sol en medium 74; en cambio, el primer token de la respuesta llega a los 17,39 s en Hydrogen y a los 2,81 s en Sol, porque Hydrogen dedica ese tiempo a razonar.
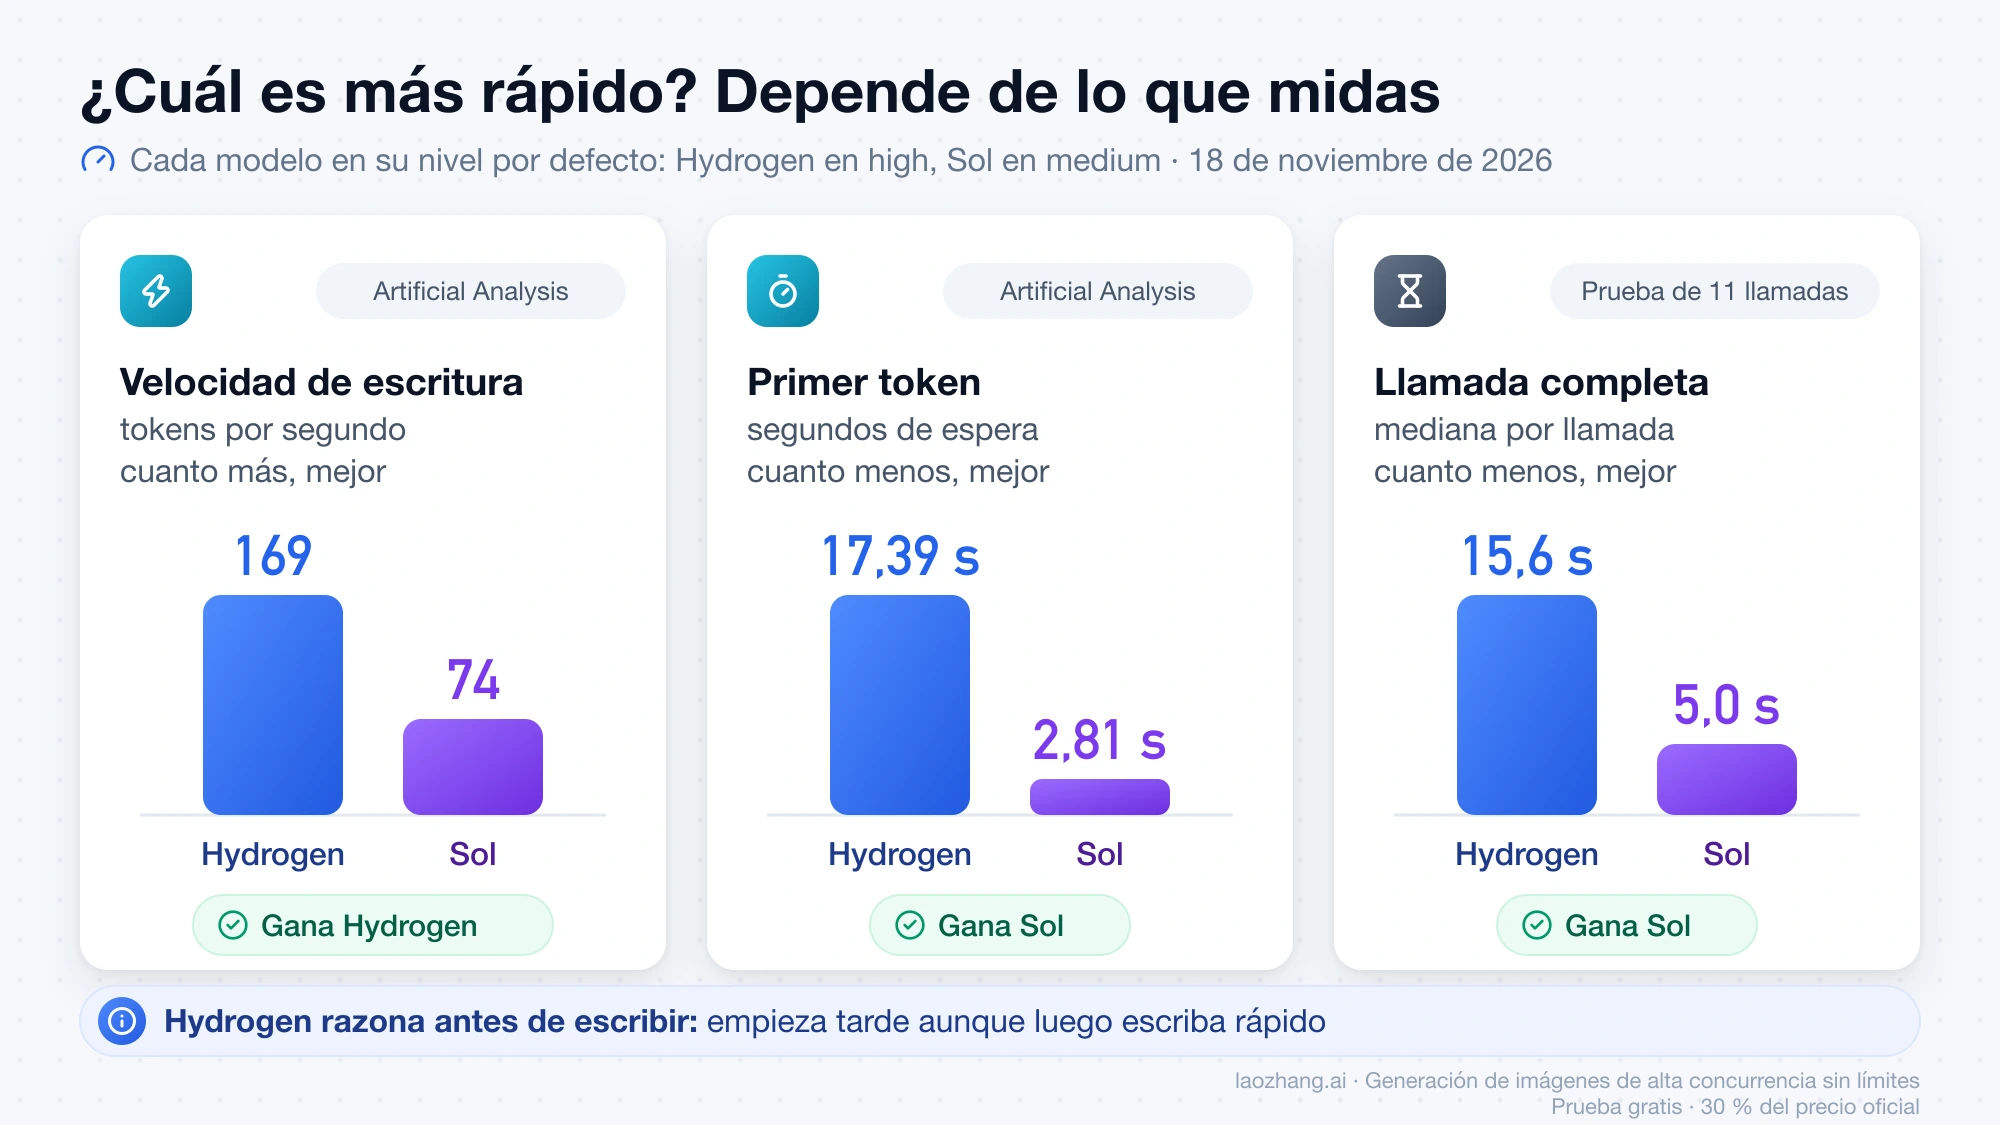
En la prueba del 18 de noviembre ganó la espera, no la velocidad de escritura: mediana de 15,6 s por llamada en Hydrogen frente a 5,0 s en Sol. En el registro largo de 146 KB la diferencia fue de 201,2 s frente a 13,6 s, porque Hydrogen razonó 32.948 tokens antes de escribir la respuesta. La velocidad de Hydrogen se nota cuando la respuesta es larga y el razonamiento corto, por ejemplo al generar mucho código o texto a partir de instrucciones claras; si lo que te importa es cuánto tardas en tener el resultado de una petición corta, Sol es el rápido. Hydrogen en low acorta el primer token a 6,11 s, pero sigue por encima de los 1,77 s de Sol en low.
Benchmarks de Artificial Analysis: Sol en medium iguala a Hydrogen en xhigh
En el índice de inteligencia de Artificial Analysis (v5.0.1), a 18 de noviembre de 2026, GPT-6.2 Sol en medium saca 53 puntos con 0,41 $ por tarea y Gemini 4 Hydrogen en high 51 con 1,87 $: en el valor por defecto de cada uno, Sol puntúa más y cuesta 4,6 veces menos. La tabla recoge todos los niveles de la comparativa de Artificial Analysis entre GPT-6.2 Sol y Gemini 4 Hydrogen, con Sol a 2 $ y 10 $ por millón y Hydrogen a 1,50 $ y 7,50 $.
| Modelo y nivel | Índice | Coste por tarea | Tiempo por tarea |
|---|---|---|---|
GPT-6.2 Sol max | 57 | 1,01 $ | 7,9 min |
GPT-6.2 Sol xhigh | 56 | 0,65 $ | 5,1 min |
GPT-6.2 Sol high | 55 | 0,56 $ | 4,2 min |
GPT-6.2 Sol medium (por defecto) | 53 | 0,41 $ | 3,1 min |
GPT-6.2 Sol low | 41 | 0,18 $ | 1,4 min |
Gemini 4 Hydrogen xhigh | 54 | 3,16 $ | 14,8 min |
Gemini 4 Hydrogen high (por defecto) | 51 | 1,87 $ | 8,4 min |
Gemini 4 Hydrogen medium | 41 | 0,80 $ | 4,0 min |
Gemini 4 Hydrogen low | 27 | 0,29 $ | 1,5 min |
La comparación útil es a igual puntuación, porque los nombres de nivel no significan lo mismo en los dos modelos. Para llegar a los 53–54 puntos, Sol en medium cuesta 0,41 $ y tarda 3,1 min por tarea, y Hydrogen necesita xhigh, con 3,16 $ y 14,8 min: 7,7 veces el coste y casi 5 veces el tiempo. A 41 puntos, Sol en low cuesta 0,18 $ y Hydrogen en medium 0,80 $, 4,4 veces más. Hydrogen no tiene ningún nivel que alcance los 55–57 puntos de Sol en high o superior. La cifra de 51 puntos en high y 54 en xhigh es también la que Google cita en su anuncio.
Ten en cuenta dos cosas al usar esta tabla. El coste por tarea es la media de lo que cuesta cada tarea de la batería propia de Artificial Analysis, no lo que te costará una petición tuya, y por eso no se puede sumar ni dividir con las cifras de la prueba de las 11 llamadas. Y las cifras son a 18 de noviembre, un día después del lanzamiento de Sol: Artificial Analysis recalcula sus cifras, y ya ha cambiado el coste de otros modelos en pocos días.
¿Cuál es mejor para programar? Sol en terminal, Hydrogen en conocimiento
Para programar, GPT-6.2 Sol va por delante en las pruebas de terminal y de cambios sobre bases de código reales, mientras que Gemini 4 Hydrogen gana en conocimiento factual y en automatización. Con cada modelo en su valor por defecto, según Artificial Analysis a 18 de noviembre de 2026, Sol en medium saca un 56,1 % en Terminal-Bench 4.0 frente al 54,0 % de Hydrogen en high, un 41,4 % frente a un 36,3 % en FrontierCode-AA 2.0 y un 60,5 % frente a un 41,4 % en Terminal-Bench-Science 0.1, que mide tareas científicas resueltas con código. Si bajas Hydrogen a medium, su Terminal-Bench 4.0 cae al 29,3 %.
Hydrogen va por delante cuando la tarea depende de lo que el modelo sabe o de encadenar pasos de un flujo. En AA-Omniscience 1.1, que mide conocimiento factual y penaliza las alucinaciones, Hydrogen en high saca 44 puntos y Sol no pasa de 40 ni siquiera en max; en AutomationBench-AA, Hydrogen en high llega al 74,4 % y el mejor nivel de Sol al 71,3 %. En las puntuaciones de derecho y de finanzas y contabilidad, Hydrogen en high también supera a Sol en medium (55 frente a 49 y 56 frente a 52), aunque Sol en max lo iguala.
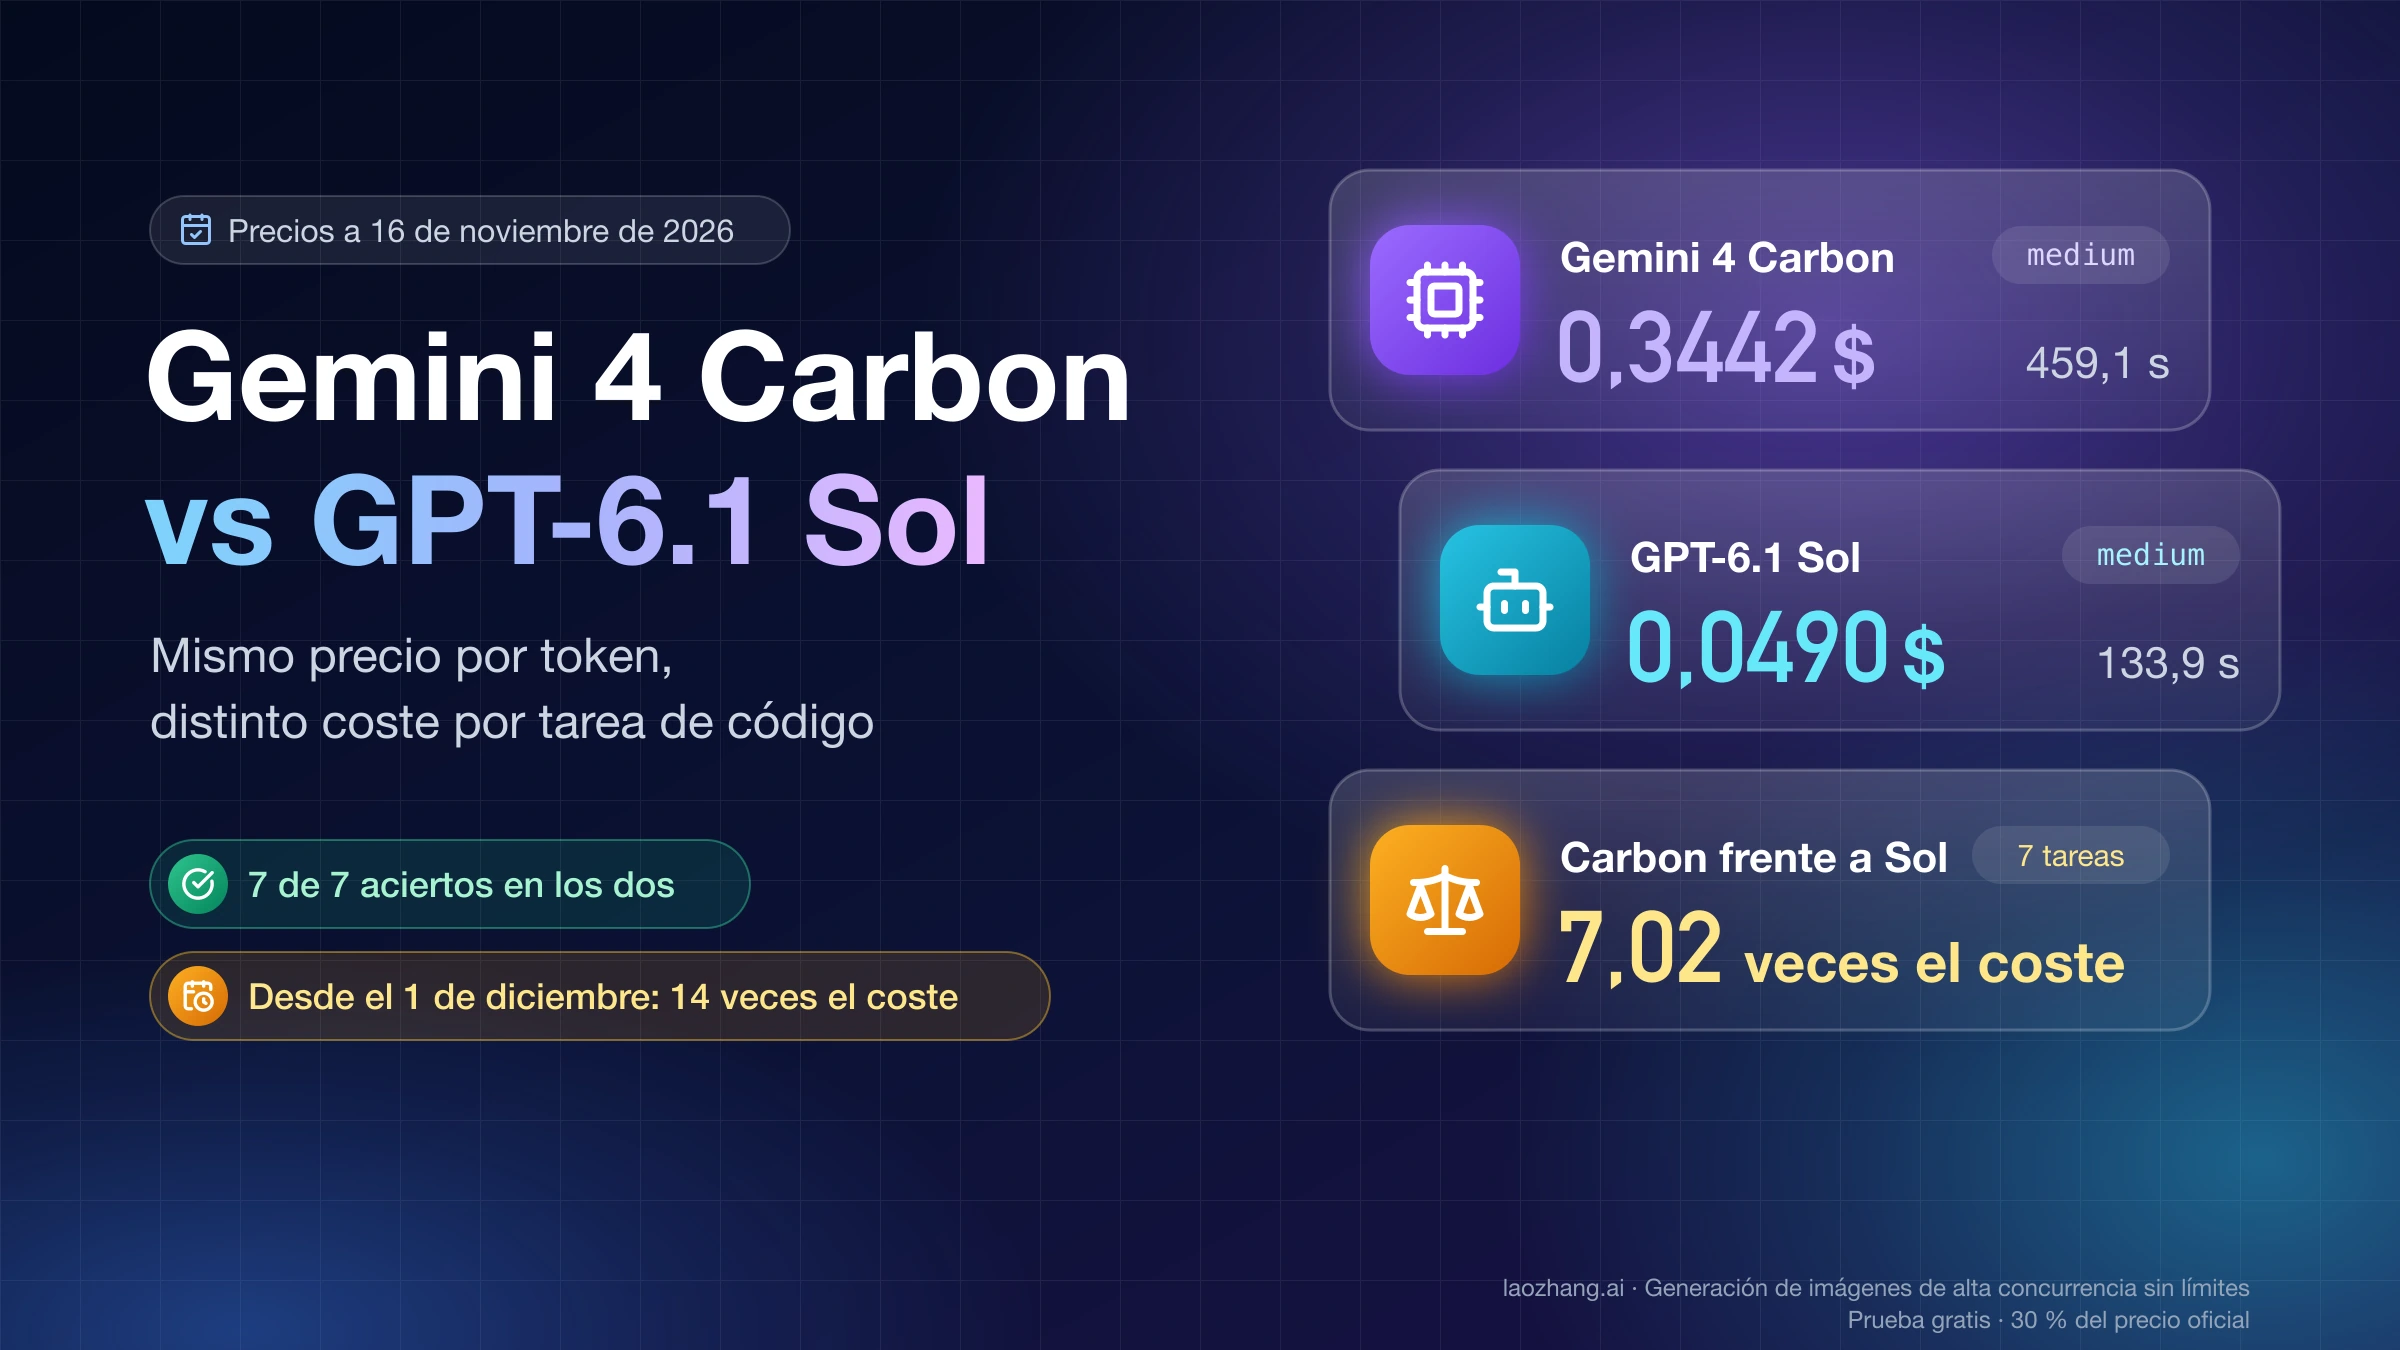
Los propios fabricantes añaden datos que no son pruebas independientes. OpenAI dice que en FrontierCode 2.0 Sol casi iguala a GPT-6.2 Astra en cambios listos para fusionar en código real por una quinta parte del coste, y GitHub dice que en sus primeras pruebas de revisión de código encontró casi el doble de problemas reales que GPT-6.1 Sol. En sentido contrario, The Decoder señala que, dentro de Codex en max, GPT-6.2 Sol cae 14 puntos frente a 6.1 Sol en SWE-Atlas-QnA-AA, que mide respuestas a preguntas sobre bases de código, porque omite datos clave más a menudo. Si buscas cuál es el mejor modelo de Gemini para programar y no solo este par, el modelo superior de Google se compara en Gemini 4 Carbon vs GPT-6.1 Sol para programar: coste por tarea.
Hydrogen en Antigravity frente a Sol en Codex: más nota, más pasos
Dentro de los agentes de programación de cada fabricante, Hydrogen puede puntuar más, pero a un coste y una duración mucho mayores. En el índice de agentes de programación de Artificial Analysis (Coding Agent Index, que combina FrontierCode 2.0, Terminal-Bench y SWE-Atlas-QnA-AA a partes iguales), a 18 de noviembre de 2026, Antigravity CLI con Hydrogen en xhigh saca 52,3 puntos, por encima de Codex con GPT-6.2 Sol en cualquier nivel: 49,8 en xhigh, 48,6 en max, 47,5 en high y 45,4 en medium.
La evaluación completa costó 1.482 $ con Hydrogen en xhigh, frente a 237 $ con Sol en high y 176 $ con Sol en medium: 6,3 y 8,4 veces más. Hydrogen tardó de media 32,1 min por tarea y dio 405 pasos, frente a 10,6 min y 42 pasos de Sol en high. El índice no tiene fila de Hydrogen en su nivel por defecto, y lo que compara es cada modelo dentro del agente de su fabricante, no los dos modelos en el mismo agente. Si usas Codex a diario, GPT-6.2 Sol en high queda unos 5 puntos por debajo con una sexta parte del coste y una décima parte de los pasos.
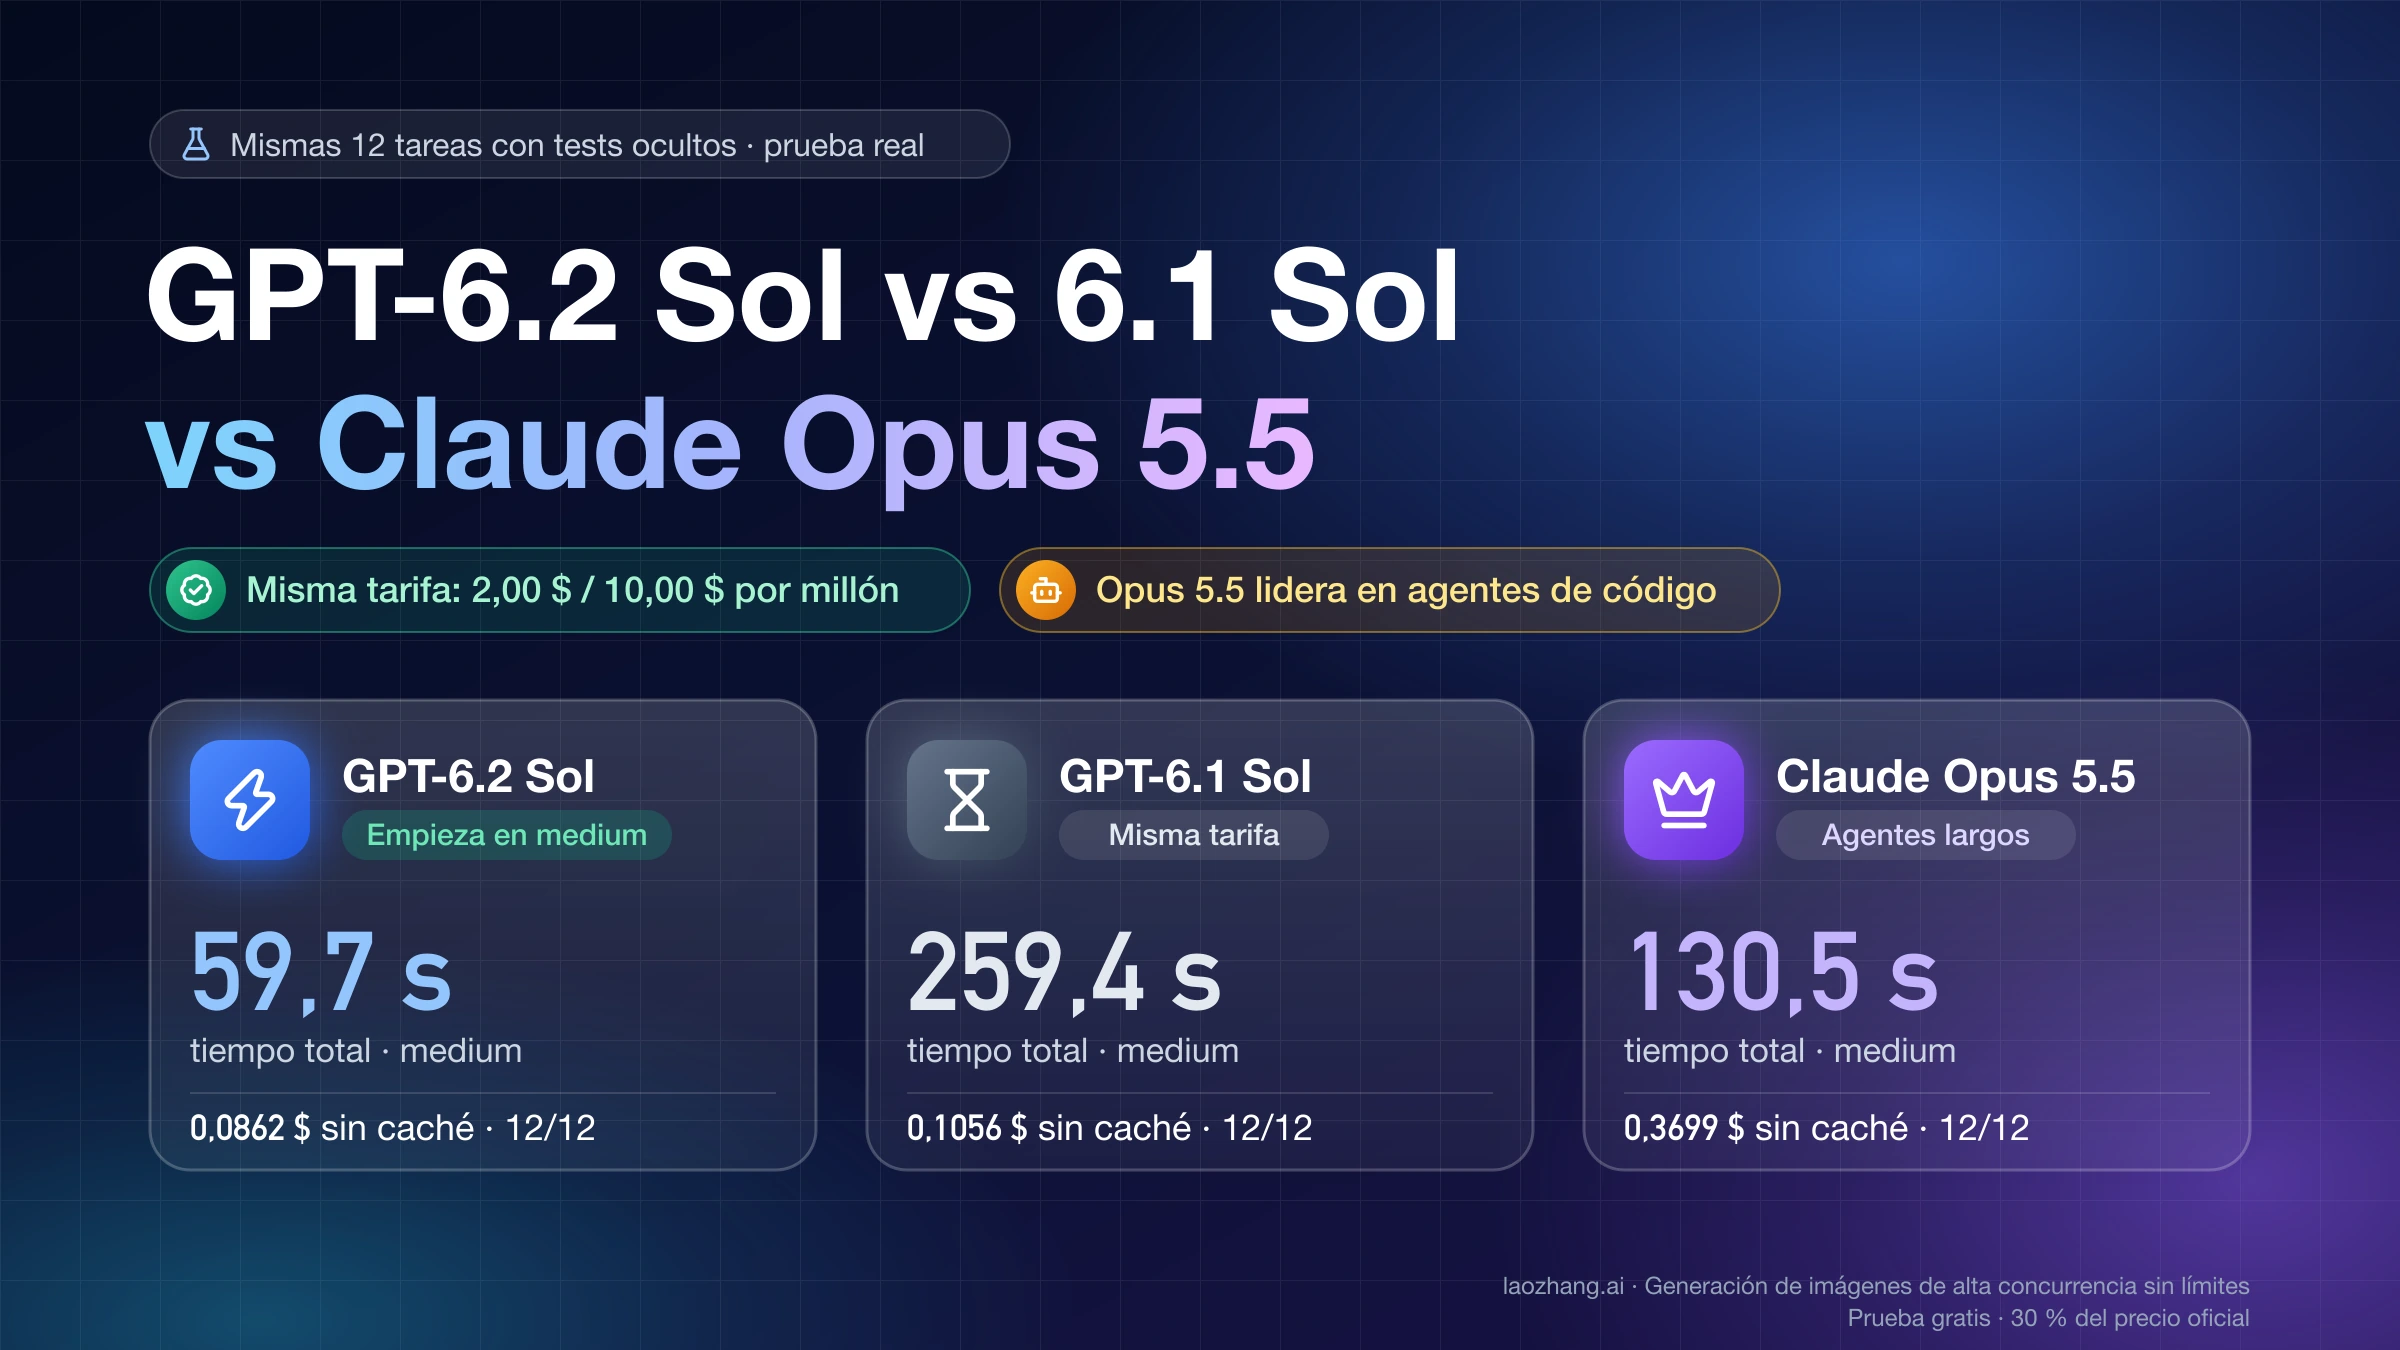
Algunas pruebas personales apuntan en otra dirección, y conviene leer bien qué comparan. Un autor de la comunidad de desarrolladores de Alibaba Cloud generó páginas web completas dentro de un agente de programación el 13 de noviembre: una calculadora para dividir la cuenta a partir de la foto de un tique le llevó a Hydrogen 110 s y 56.500 tokens, frente a 136 s y 113.000 tokens de GPT-6.1 Sol, y un globo terráqueo 3D en un solo archivo, 207 s y 113.000 tokens frente a 298 s y 495.000. Son ejecuciones únicas, con GPT-6.1 Sol y no 6.2, contando los tokens de toda la sesión y sin indicar el nivel de razonamiento de Sol. GPT-6.2 Sol gasta menos que su predecesor: el 18 de noviembre, en otras 12 tareas de un solo turno, escribió 0,68 veces los tokens de salida de 6.1 Sol y tardó 59,7 s frente a 259,4 s. Usuarios de X han publicado también pruebas sueltas de escenas 3D, una con Hydrogen terminando en 3 minutos y una versión previa de 6.2 Sol en 11, y otra en la que ambos tardaron casi lo mismo. Ninguno de esos resultados se traslada a peticiones sueltas a la API, ni al revés.
Registros largos y entradas de más de 272.000 tokens
Por debajo de 272.000 tokens de entrada, GPT-6.2 Sol siguió siendo más barato y mucho más rápido en un registro largo; por encima de esa línea su tarifa sube y la ventaja de precio pasa a Hydrogen, aunque esa zona no se ha medido. El 18 de noviembre de 2026 se pasó un mismo registro de aplicación de 146 KB y 1.500 líneas a los dos modelos, con siete preguntas de respuesta numérica exacta, en un solo turno y sin herramientas. Los dos acertaron las siete.
Hydrogen en high (una sola muestra, con streaming y maxOutputTokens en 65.536) contó 79.312 tokens de entrada, razonó 32.948 tokens, tardó 201,2 s y costó 0,3667 $. Sol en medium, en una prueba del mismo día sobre el mismo registro y las mismas preguntas, contó 55.843 tokens de entrada, escribió 1.845 de salida, tardó 13,6 s y costó 0,1581 $, porque la pasarela facturó la entrada como escritura en caché a 2,50 $; con toda la entrada a 2,00 $ habrían sido 0,1301 $. Hydrogen salió 2,32 veces más caro (2,82 frente a la cifra sin caché), 14,8 veces más lento y leyó el mismo texto como un 42 % más de tokens. Sol en high también acertó, en 17,3 s y por 0,1668 $.
Ese registro ocupa entre 56.000 y 79.000 tokens, muy por debajo de la línea de 272.000, así que no dice nada de lo que pasa por encima. Ahí Sol cobra 4 $ por millón de entrada y 15 $ de salida en toda la petición, y Hydrogen mantiene 1,50 $ y 7,50 $ en todo su contexto. Como estimación no medida: una petición de 300.000 tokens contados por Sol, con la misma salida que en el registro, costaría en Sol 300.000 × 4 $ + 1.845 × 15 $ por millón ≈ 1,23 $; en Hydrogen, contando un 42 % más de entrada, 426.000 × 1,50 $ + 33.029 × 7,50 $ por millón ≈ 0,89 $. Con entradas tan largas pesa más la entrada que el razonamiento, así que si trabajas con repositorios enteros o lotes de documentos por encima de esa línea, Hydrogen merece una prueba con tus propios datos. El límite técnico tampoco es el mismo: Sol admite como mucho 922.000 tokens de entrada y Hydrogen 1.048.576 de contexto total.
Qué nivel de razonamiento poner en cada uno
Empieza con Hydrogen en high y Sol en medium, que son sus valores por defecto, y no compares high con high: Hydrogen usa la escala thinking level (low, medium, high, xhigh) y Sol la de reasoning effort (low, medium, high, xhigh, max), y cada una está calibrada para su modelo. La forma de comparar es a igual resultado, como en la tabla de Artificial Analysis.
En Hydrogen, bajar a medium ahorra poco y cuesta nota. En las mismas 11 llamadas, Hydrogen en medium costó 0,1927 $ el 16 de noviembre (11/11 aciertos, 23.144 tokens de salida y una mediana de 10,2 s), es decir, 3,16 veces lo que Sol por defecto el 18 de noviembre, mientras su índice de Artificial Analysis baja de 51 a 41 y su Terminal-Bench 4.0 del 54,0 % al 29,3 %. Esas tareas eran demasiado fáciles para mostrar la pérdida, pero en trabajo difícil se nota. low solo tiene sentido para tareas triviales (27 puntos) y xhigh para cuando high no basta y aceptas pagar 3,16 $ por tarea del índice. Hydrogen no admite minimal.
En Sol, medium es el punto de equilibrio y high el primer escalón si algo falla: en la prueba del 18 de noviembre costó 1,33 veces más y tardó 1,17 veces más, y en Artificial Analysis añade 2 puntos. xhigh y max son para tareas difíciles que puedes comprobar, porque el tiempo por tarea del índice pasa de 3,1 a 5,1 y 7,9 minutos. Sol no acepta none, y bajar a low lo deja en 41 puntos, el nivel de Hydrogen en medium. El detalle de lo que cuesta cada nivel de Hydrogen por llamada está en Gemini 4 Hydrogen: precio de la API y coste real por llamada.
Precio, nivel gratuito y dónde usar Gemini 4 Hydrogen y GPT-6.2 Sol
Por token, Gemini 4 Hydrogen es un 25 % más barato que GPT-6.2 Sol en todas las columnas que comparten, no tiene recargo por contexto largo y es el único de los dos con nivel gratuito en la API. Estas son las tarifas Standard por millón de tokens de la página de precios de la API de Gemini y la página de precios de la API de OpenAI, a 18 de noviembre de 2026:
| Por millón de tokens | Gemini 4 Hydrogen | GPT-6.2 Sol |
|---|---|---|
| Entrada (Sol: hasta 272.000 tokens) | 1,50 $ | 2,00 $ |
| Entrada en caché | 0,075 $ (solo caché implícita) | 0,10 $ |
| Salida, con razonamiento incluido | 7,50 $ | 10,00 $ |
| Más de 272.000 tokens de entrada: entrada / salida | 1,50 $ / 7,50 $ | 4,00 $ / 15,00 $ en toda la petición |
| Batch: entrada / salida | 0,75 $ / 3,75 $ | 1,00 $ / 5,00 $ |
| Nivel gratuito de la API | Sí | No |
Sol cobra además la escritura en caché: 2,50 $ por millón con retención de 30 minutos y 5,00 $ con 12 horas. Hydrogen solo tiene caché implícita, sin caché explícita. En el nivel gratuito de la API de Gemini la entrada y la salida no se cobran, pero Google usa esos datos para mejorar sus productos, cosa que no hace con los del nivel de pago; si tu presupuesto es cero, ese es el primer sitio donde probar. Si quieres repetir la comparación con tus propias peticiones y una sola clave, laozhang.ai sirve gemini-4-hydrogen y gpt-6.2-sol a los precios de lista de cada proveedor, y por esa vía se hicieron las pruebas del 18 de noviembre.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Fuera de la API, cada modelo está en sitios distintos, según los anuncios de lanzamiento y la ayuda de cada producto:
| Dónde | Gemini 4 Hydrogen | GPT-6.2 Sol |
|---|---|---|
| API | API de Gemini, niveles gratuito y de pago; Google AI Studio | API de OpenAI (Responses y Chat Completions), solo de pago |
| App de chat | App de Gemini; según la ayuda, seleccionable desde Google AI Plus | ChatGPT Work con Plus, Pro, Enterprise y Edu |
| Agente de programación | Antigravity con AI Pro y Ultra | Codex con Plus, Pro, Enterprise y Edu |
| Otros | Búsqueda de Google, Gemini para empresas | GitHub Copilot Pro+, Max, Business y Enterprise, con despliegue gradual |
ChatGPT Free y Go no aparecen entre los planes del anuncio de OpenAI. En la app de Gemini hay dos versiones: el anuncio de Google habla de todos los usuarios, mientras que la página de ayuda dice que sin plan solo hay «Auto» o Flash-Lite (Auto envía algunas peticiones a Hydrogen); el 16 de noviembre, una cuenta personal sin plan sí mostraba «4 Hydrogen» en el selector de la versión web.
Qué cambiar al mover una integración entre Hydrogen y GPT-6.2 Sol
Además del ID del modelo, cambian el parámetro de razonamiento, la API que necesitas para usar herramientas y los tipos de entrada que puedes enviar. Lo siguiente es lo que hay que revisar, según la documentación de cada fabricante y lo observado en la pasarela de laozhang.ai el 18 de noviembre de 2026:
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
| Qué revisar | Gemini 4 Hydrogen | GPT-6.2 Sol |
|---|---|---|
| ID del modelo | gemini-4-hydrogen | gpt-6.2-sol |
| Parámetro de razonamiento y valor por defecto | thinkingLevel, high | reasoning_effort en Chat Completions, medium |
| Valores no admitidos | minimal | none (error HTTP 400) |
| Entradas | Texto, imagen, vídeo, audio y PDF | Texto e imagen |
| Salida máxima por petición | 65.536 tokens en modo síncrono | 128.000 tokens |
En Sol, las llamadas a herramientas exigen la API Responses; por Chat Completions no podrás usarlas. Si pasas de Hydrogen a Sol y tu código enviaba none o un nivel mínimo, Sol responde con Unsupported value: 'none' is not supported with the 'gpt-6.2-sol' model. Supported values are: 'low', 'medium', 'high', 'xhigh', and 'max'.; usa low. En la pasarela, Chat Completions aceptó low, medium, high y xhigh, y max requirió la API Responses. Por Chat Completions, el campo model de la respuesta llega como gpt-6.2-sol-2026-11-17, y por Responses como gpt-6.2-sol; la página oficial del modelo solo publica gpt-6.2-sol, así que si tu código compara ese campo de forma literal, acepta los dos.
¿GPT-6.2 Sol es mejor que GPT-6.1 Sol? Más nota al mismo precio
En el índice de Artificial Analysis, GPT-6.2 Sol saca entre 2 y 7 puntos más que GPT-6.1 Sol en cada nivel, con un coste por tarea parecido (0,41 $ frente a 0,36 $ en medium) y menos tiempo por tarea (3,1 frente a 4,4 minutos en medium), con las cifras de 6.1 Sol a 16 de noviembre de 2026 y las de 6.2 a 18 de noviembre. La prueba de los dos modelos en las mismas tareas, junto con Claude Opus 5.5, está en GPT-6.2 Sol vs 6.1 Sol vs Opus 5.5: prueba real y cuál usar.
Fuentes3
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 18 nov 2026.
Fuentes3
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 18 nov 2026.
- 1.comparativa de Artificial Analysis entre GPT-6.2 Sol y Gemini 4 Hydrogenartificialanalysis.ai/models/comparisons/gpt-6-2-sol-vs-gemini-4-hydrogen
- 2.página de precios de la API de Geminiai.google.dev/gemini-api/docs/pricing
- 3.página de precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing