Gemini 3.8 Flash TTS API: modelo, coste por minuto y migración
Flash-Lite TTS por defecto y Flash TTS para narración actuada o dos voces: USD 0,54 o 0,81 por hora de audio en 2026, el doble desde 2027, con nivel gratuito.
En esta página
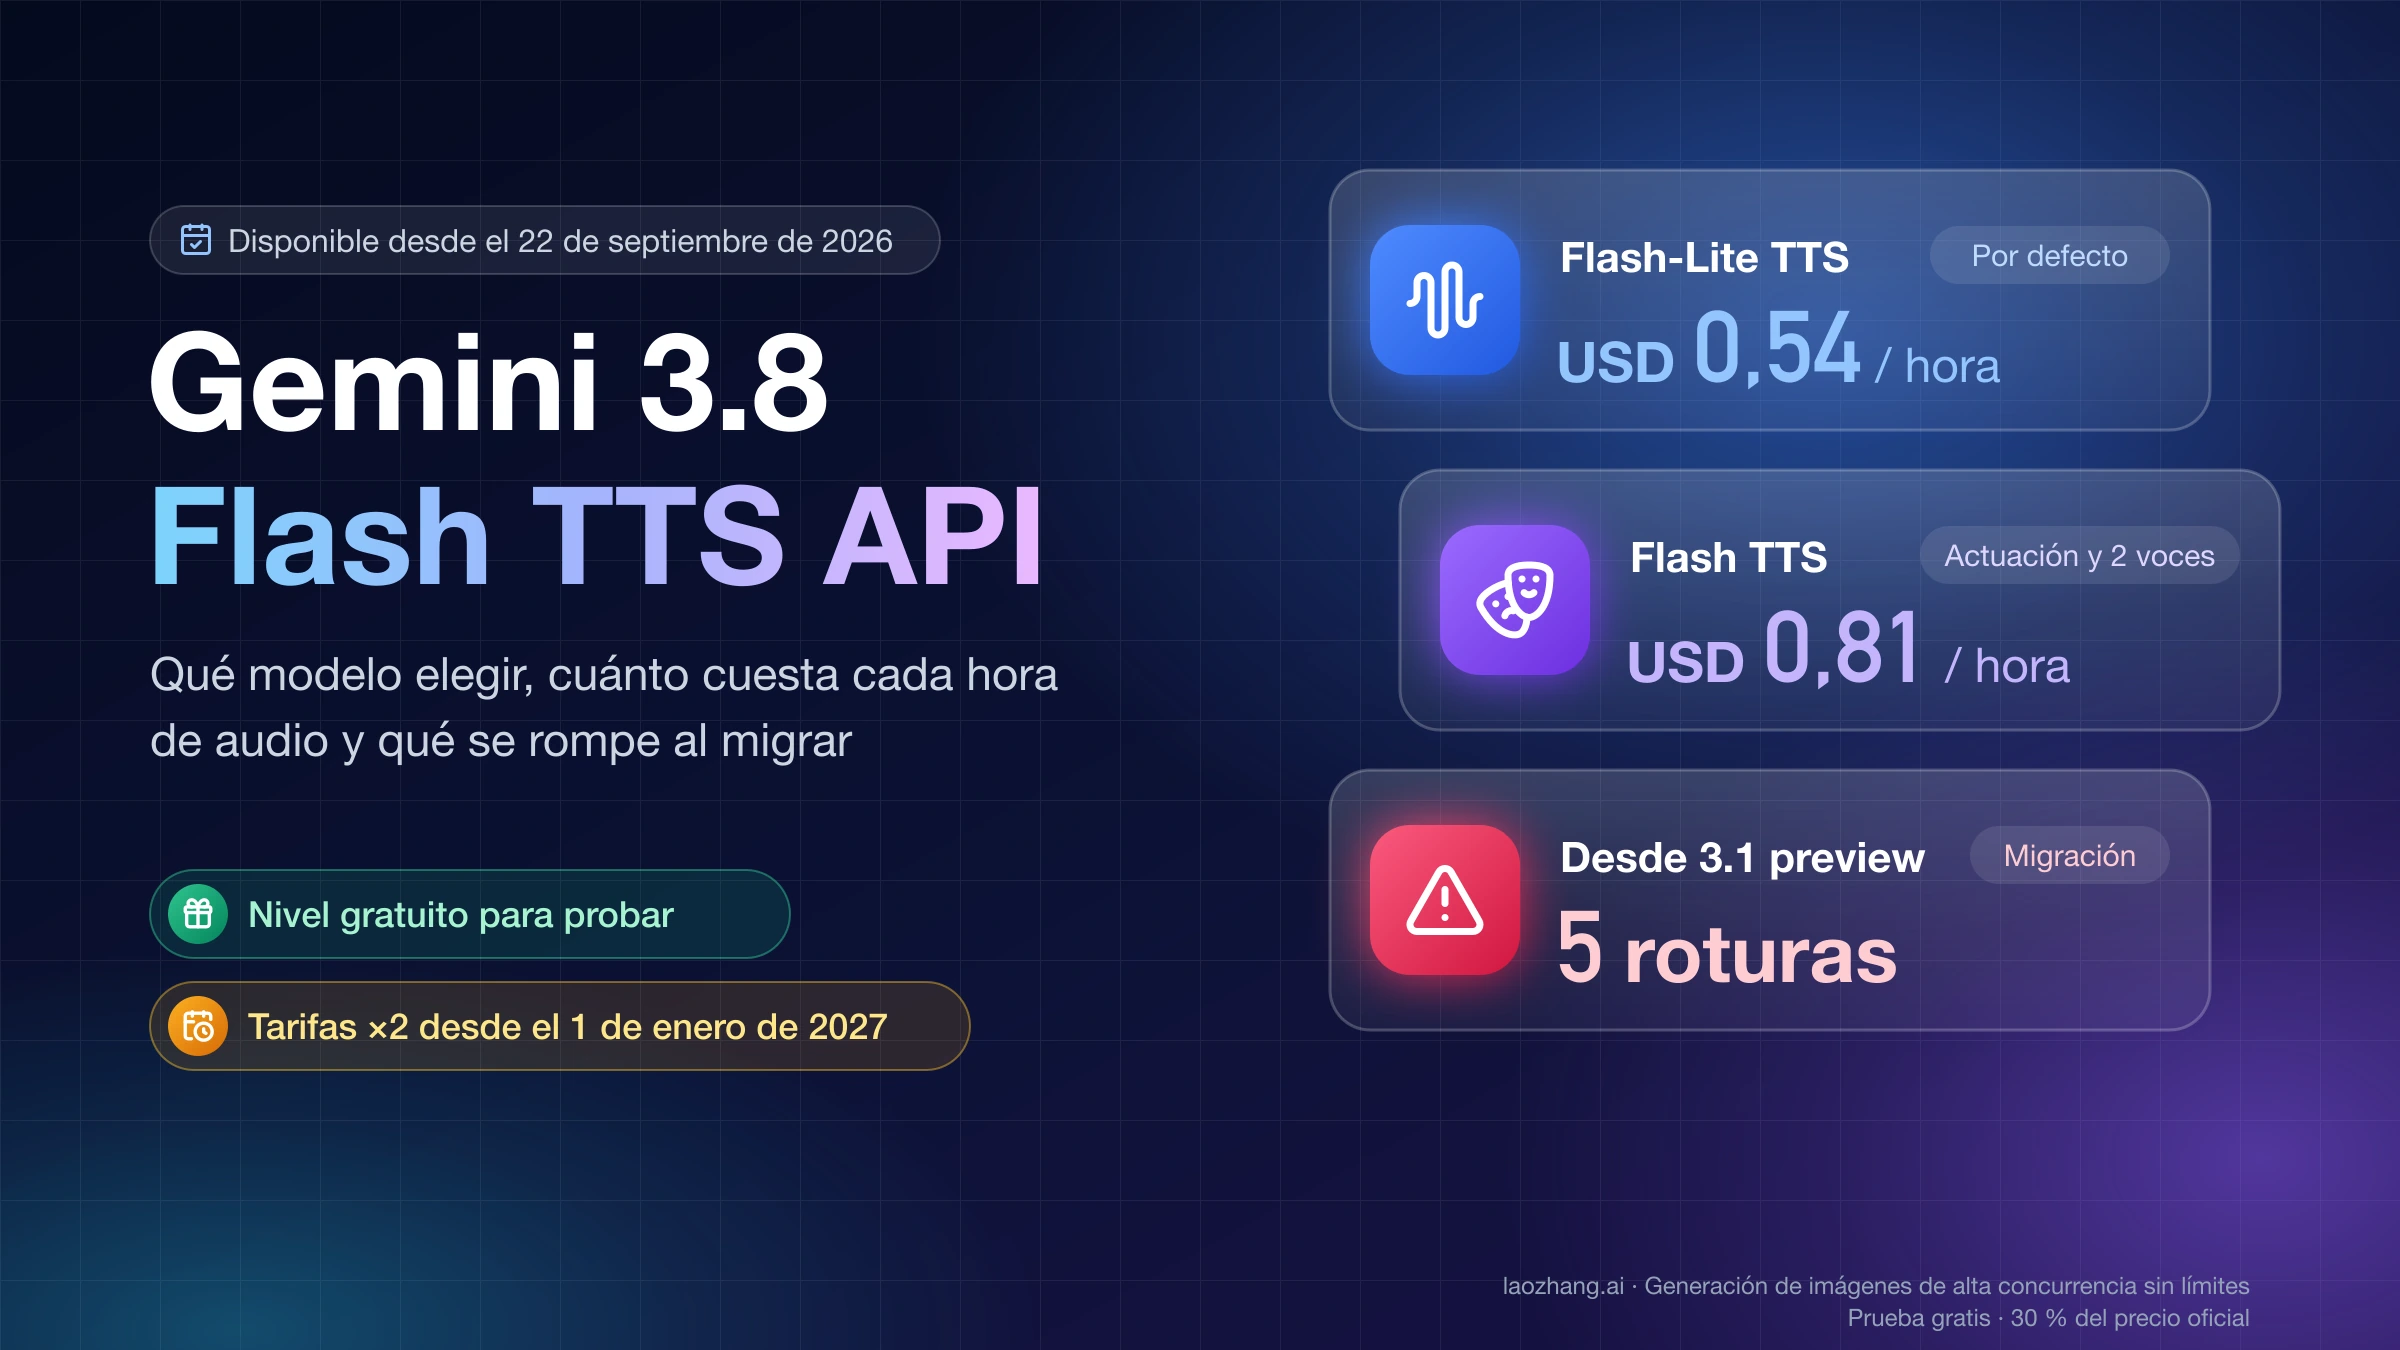
Si vas a conectar texto a voz de Google en tu código esta semana, la respuesta corta es: usa gemini-3.8-flash-lite-tts salvo que necesites actuación, dialectos o un diálogo a dos voces con reacciones superpuestas, casos en los que pasas a gemini-3.8-flash-tts cambiando solo el nombre del modelo. Los dos comparten esquema de petición, devuelven WAV de 24 kHz listo para guardar y cuestan, en la modalidad estándar de 2026, USD 0,54 y USD 0,81 por hora de audio generado; ambas tarifas se duplican el 1 de enero de 2027. El nivel gratuito de la Gemini API cubre los dos modelos, así que puedes probar antes de activar la facturación, y España está en la lista oficial de países donde la API está disponible.
Los dos modelos pasaron a disponibilidad general el 22 de septiembre de 2026 según el registro de cambios de la Gemini API (el anuncio en blog.google lleva fecha del 23), junto con el endpoint de voces /v1beta/voices para diseñar voces, replicarlas y consultar la biblioteca extendida. Flash-Lite TTS es el reemplazo oficial de gemini-3.1-flash-tts-preview, no una versión recortada; Flash TTS es el nuevo nivel creativo. Lo que sigue va en el orden en que lo necesitas: elegir modelo, lanzar la primera petición, calcular el coste por minuto, migrar sin las cinco roturas documentadas y conocer los límites antes de chocar con ellos. El código sigue la forma de los ejemplos oficiales de la guía de generación de voz (actualizada el 24 de septiembre de 2026) y no incluye medidas de latencia ni de calidad.
Qué modelo elegir: Flash, Flash-Lite o la Live API
Los dos modelos aceptan solo texto y devuelven solo audio, admiten un hablante, dos hablantes, diseño de voz y replicación de voz, y detectan el idioma de entrada automáticamente; el español aparece como compatible en los dos. La diferencia está en la prioridad de cada uno, que Google resume en las fichas de modelo:
| Carga de trabajo | Modelo recomendado | Por qué |
|---|---|---|
| Lectura en voz alta, agentes de voz, doblaje masivo, locución de un solo hablante, replicación de voz | gemini-3.8-flash-lite-tts | Optimizado para alto rendimiento, baja latencia y coste; 101 idiomas; reemplazo directo de 3.1 preview |
| Audiolibros y narración de estudio, diálogo complejo a dos voces, muchas reacciones vocales, pronunciaciones difíciles, acentos regionales | gemini-3.8-flash-tts | Máxima fidelidad y matiz actoral; más de 130 idiomas; las reacciones superpuestas entre barras funcionan mejor aquí |
| Conversación bidireccional en tiempo real, donde el usuario habla y el modelo escucha e interrumpe | Live API, no TTS | Los modelos TTS marcan la Live API como no compatible; están pensados para recitar un texto exacto con control fino de estilo |
La regla práctica que da la propia guía para desarrolladores de AI Studio es empezar con Flash-Lite como sustituto de 3.1 preview y subir a Flash cuando el proyecto pida actuación de estudio, diálogo con reacciones o estabilidad en narraciones largas. Como la petición es idéntica, puedes generar el mismo guion con los dos, escuchar la diferencia y decidir con tu propio material.
El tercer caso merece un aviso porque es donde más gente se equivoca: si construyes un asistente que escucha micrófono y responde con voz, la cascada de texto a voz con gemini-3.8-flash-lite-tts (una llamada por turno) sigue siendo válida para la parte de salida, pero la entrada de audio y la gestión de interrupciones son cosa de la Gemini 3.1 Flash Live API. Para el camino inverso, de audio a texto, la ruta es la Gemini 3.5 Transcribe API.
Primera petición: un hablante, dos hablantes y streaming
Necesitas una clave de la Gemini API en la variable GEMINI_API_KEY; si aún no la tienes, sigue los pasos de Clave API de Google AI Studio: crear, proteger y probar la primera llamada. En Python el SDK es google-genai (2.25.0 o superior si vas a usar el endpoint de voces) y en Node @google/genai (2.24.0 o superior). Las peticiones van a la Interactions API, POST https://generativelanguage.googleapis.com/v1beta/interactions, con la cabecera x-goog-api-key.
Un hablante en Python
El texto del campo text se lee tal cual. Las indicaciones de dirección van en la anotación speech_metadata, y la voz en generation_config.speech_config:
import base64
from google import genai

client = genai.Client()  # lee GEMINI_API_KEY del entorno

interaction = client.interactions.create(
    model="gemini-3.8-flash-lite-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Bienvenido al episodio de hoy. Vamos a hablar de lo que cambia al pasar de 3.1 a 3.8.",
            "annotations": [{
                "type": "speech_metadata",
                "style": "warm and conversational",
            }],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": [
            {"voice": "Kore"},
        ]
    },
)

with open("salida.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))
interaction.output_audio.data es el audio en base64; una vez decodificado son bytes WAV completos con cabecera RIFF (24 kHz, mono, PCM de 16 bits little-endian), así que se escriben directamente a un .wav sin añadir nada. En JavaScript la forma es la misma: client.interactions.create({...}) y Buffer.from(interaction.output_audio.data, 'base64') a fs.writeFileSync.
La misma petición en REST
En la respuesta JSON cruda el audio está en steps[].content[].data; el filtro de jq se queda con el último bloque de audio y lo decodifica:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-3.8-flash-lite-tts",
    "input": [{
      "type": "user_input",
      "content": [{
        "type": "text",
        "text": "Bienvenido al episodio de hoy.",
        "annotations": [{
          "type": "speech_metadata",
          "style": "warm and conversational"
        }]
      }]
    }],
    "response_format": { "type": "audio" },
    "generation_config": {
      "speech_config": [ { "voice": "Kore" } ]
    }
  }' | jq -r '[.steps[] | select(.type=="model_output") | .content[] | select(.type=="audio")] | last | .data' | base64 --decode > salida.wav
Dos hablantes en modo conversational
Para un pódcast o una escena, cada turno es un elemento de content con su speaker, y speech_config pasa a ser un objeto con mode: "conversational" y la lista de hablantes. El nombre de speaker en cada turno tiene que coincidir con uno de los configurados:
interaction = client.interactions.create(
    model="gemini-3.8-flash-tts",
    input=[{
        "type": "user_input",
        "content": [
            {
                "type": "text",
                "text": "¿Has probado ya las voces nuevas, Marta?",
                "annotations": [{
                    "type": "speech_metadata",
                    "speaker": "Pablo",
                    "style": "curious, leaning in",
                }],
            },
            {
                "type": "text",
                "text": "Esta mañana. <laugh> Todavía no me creo lo bien que hace las pausas.",
                "annotations": [{
                    "type": "speech_metadata",
                    "speaker": "Marta",
                    "style": "amused",
                }],
            },
        ],
    }],
    response_format={"type": "audio"},
    generation_config={
        "speech_config": {
            "mode": "conversational",
            "speakers": [
                {"speaker": "Pablo", "voice": "Puck"},
                {"speaker": "Marta", "voice": "Kore"},
            ],
        }
    },
)
Una petición admite como máximo dos hablantes y solo con voces predefinidas. Si quieres una escena con voces diseñadas o replicadas, o con tres personajes, sintetizas cada turno por separado y los concatenas; la sección de límites explica el detalle de la cabecera WAV que hay que quitar.
Streaming para agentes de voz
Con stream=True recibes eventos step.delta cuyo delta.type es "audio". Aquí cambia el formato: los fragmentos llegan como PCM crudo sin cabecera (audio/l16, 24 kHz, mono, 16 bits), precisamente para que puedas enviarlos a un reproductor o concatenarlos sin que cada trozo traiga su propio encabezado:
stream = client.interactions.create(
    model="gemini-3.8-flash-lite-tts",
    input=[{
        "type": "user_input",
        "content": [{
            "type": "text",
            "text": "Claro, te lo explico en un momento.",
            "annotations": [{"type": "speech_metadata", "style": ""}],
        }],
    }],
    response_format={"type": "audio"},
    generation_config={"speech_config": [{"voice": "Kore"}]},
    stream=True,
)

with open("salida.pcm", "wb") as f:
    for event in stream:
        if event.event_type == "step.delta" and event.delta.type == "audio":
            f.write(base64.b64decode(event.delta.data))
Para reproducir salida.pcm con ffplay tendrás que indicarle el formato (-f s16le -ar 24000 -ac 1), o pedir directamente otro formato con response_format.mime_type y sample_rate:
| Formato | mime_type | Cuándo lo usarías |
|---|---|---|
| WAV con cabecera RIFF (por defecto en peticiones normales) | audio/wav | Guardar a archivo, subir a un editor, entregar a un cliente |
| PCM crudo de 16 bits (por defecto en streaming) | audio/l16 | Reproducción continua, concatenar turnos, pipelines propios |
| G.711 mu-law de 8 bits | audio/mulaw | Telefonía e IVR en Norteamérica y Japón |
| G.711 A-law de 8 bits | audio/alaw | Telefonía europea, incluidas centralitas en España |
sample_rate acepta valores como 24000, 16000 u 8000, el último típico en telefonía.
Cuánto cuesta: de tokens a minutos y horas de audio
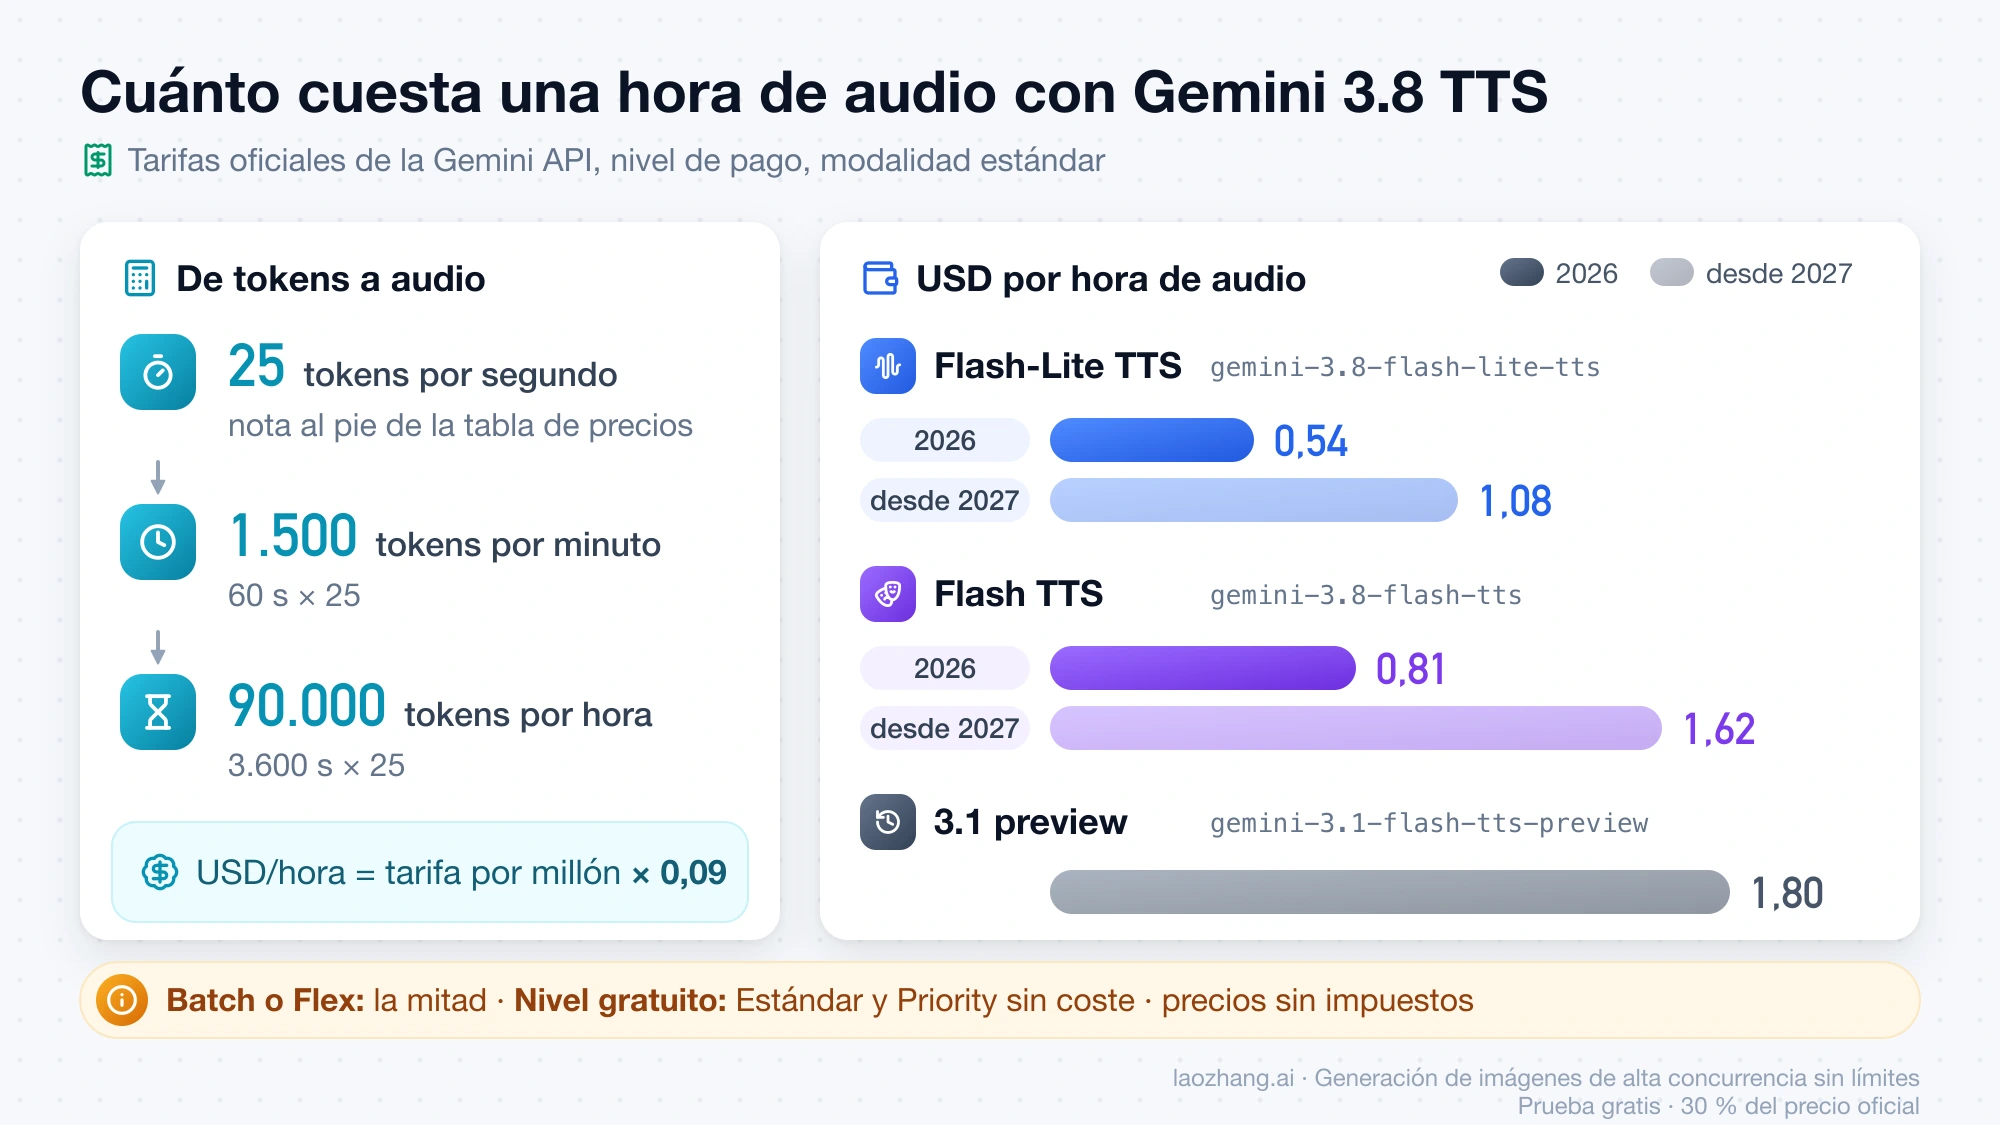
La tabla de precios cobra tokens de salida de audio y trae la conversión en su nota al pie: 25 tokens por segundo de audio. De ahí salen las dos cifras que necesitas para presupuestar:
1 minuto de audio = 60 s x 25 = 1.500 tokens de salida
1 hora de audio   = 3.600 s x 25 = 90.000 tokens de salida
coste por hora    = precio por millón de tokens x 0,09
Aplicando esa fórmula a las tarifas oficiales del nivel de pago (USD por millón de tokens de audio; la entrada de texto se trata más abajo):
| Modalidad | Modelo | Tarifa 2026 | Por minuto | Por hora | Tarifa desde 2027-01-01 | Por hora en 2027 |
|---|---|---|---|---|---|---|
| Estándar | gemini-3.8-flash-tts | USD 9,00 | USD 0,0135 | USD 0,81 | USD 18,00 | USD 1,62 |
| Estándar | gemini-3.8-flash-lite-tts | USD 6,00 | USD 0,009 | USD 0,54 | USD 12,00 | USD 1,08 |
| Batch o Flex | gemini-3.8-flash-tts | USD 4,50 | USD 0,00675 | USD 0,405 | USD 9,00 | USD 0,81 |
| Batch o Flex | gemini-3.8-flash-lite-tts | USD 3,00 | USD 0,0045 | USD 0,27 | USD 6,00 | USD 0,54 |
| Priority | gemini-3.8-flash-tts | USD 16,20 | USD 0,0243 | USD 1,458 | USD 32,40 | USD 2,916 |
| Priority | gemini-3.8-flash-lite-tts | USD 10,80 | USD 0,0162 | USD 0,972 | USD 21,60 | USD 1,944 |
Las cifras por minuto y por hora son un cálculo a partir de la tarifa publicada, no una factura: la duración real del audio depende del ritmo con el que el modelo lea tu texto, y no incluyen reintentos, generaciones descartadas ni el almacenamiento de caché de contexto (USD 0,50 por millón de tokens y hora en 2026, USD 1,00 en 2027). Los precios excluyen impuestos y comisiones de tarjeta o cambio; cómo se factura en euros desde España lo cubre Comprar una clave de API de Gemini en España.
Para situarlo frente a lo que ya usabas: gemini-3.1-flash-tts-preview cobra USD 20,00 por millón (USD 1,80 por hora), gemini-2.5-flash-preview-tts USD 10,00 (USD 0,90 por hora) y gemini-2.5-pro-preview-tts USD 20,00. Es decir, Flash TTS estándar cuesta menos de la mitad que 3.1 preview en 2026 y, aun después de la subida de 2027, se queda por debajo.
La entrada de texto es casi despreciable: a USD 0,50 por millón de tokens de texto, un guion leído a unas 150 palabras por minuto (del orden de 200 tokens) añade alrededor de USD 0,0001 por minuto de audio. Un audiolibro de 10 horas con Flash TTS en modalidad estándar sale, redondeando, en USD 8,10 de audio en 2026 y USD 16,20 en 2027; con Flash-Lite, USD 5,40 y USD 10,80. Si el plazo no importa, Batch o Flex lo dejan en la mitad.
Nivel gratuito y límites de tasa
En la tabla de precios, las modalidades Estándar y Priority de los dos modelos figuran como «sin coste» en el nivel gratuito, con la condición habitual de que en ese nivel Google usa los datos para mejorar sus productos (en el nivel de pago, no). Batch y Flex no existen en el nivel gratuito. Eso responde a la duda de si puedes probar sin tarjeta: sí, en Estándar.
Lo que no está publicado es cuántas peticiones o tokens por minuto admite cada modelo TTS: la página de límites de tasa no lista filas para 3.8 TTS y remite a la vista de límites activos de AI Studio, que es donde debes mirar tu cupo real antes de planificar volumen. Los topes de gasto por proyecto sí son públicos: no aplican al nivel gratuito, y son USD 10 cada 10 minutos en el nivel 1, USD 50 en el nivel 2 y USD 200 en el nivel 3; superarlos devuelve un 429 RESOURCE_EXHAUSTED. Qué modelos siguen siendo gratuitos y por qué varias claves comparten un solo cupo lo explica el artículo sobre los límites del free tier de Gemini API.
Migrar desde 3.1 preview o 2.5 TTS: las cinco roturas
Las páginas de modelo documentan cinco cambios de comportamiento. Cada uno tiene un síntoma reconocible en producción.
1. El texto es un guion literal. En 3.1 preview era habitual escribir «Say cheerfully: ¡Hola!» o «Speaker 1: ...» dentro del texto. En 3.8 el modelo puede leer esas instrucciones en voz alta. El estilo va a style y la etiqueta de hablante a speaker, los dos dentro de la anotación speech_metadata:
// Antes (3.1 preview): dirección mezclada con el guion
{ "type": "text", "text": "Say cheerfully: ¡Feliz cumpleaños!" }

// Ahora (3.8): guion limpio y dirección aparte
{
  "type": "text",
  "text": "¡Feliz cumpleaños!",
  "annotations": [{ "type": "speech_metadata", "style": "cheerful" }]
}
Si usas la ruta GenerateContent en lugar de Interactions, el equivalente es un objeto speech_metadata con speaker y style en cada part.
2. Las etiquetas entre ángulos son solo para eventos puntuales. Risas, suspiros, toses, respiraciones y pausas van inline en el momento exacto en que ocurren. Estilos sostenidos como susurrar van a style, y las etiquetas de efectos de sonido (aplausos, golpes) no son vocalizaciones humanas y no deberías usarlas.
3. Todo turno de una petición a dos voces lleva speaker. Un turno sin speaker que coincida con un hablante configurado ya no se resuelve por orden.
4. Los bloques «Audio Profile» y «Director's Notes» sobran. Los párrafos largos de persona que se copiaban en cada petición son, según Google, la causa más común de deriva de voz en 3.8. Crea la voz una vez con diseño de voz (Voice design), guarda el voice_... que te devuelve y pásalo como voice con un style corto o vacío.
5. Las peticiones normales devuelven WAV, no PCM. 3.1 preview y 2.5 devolvían PCM sin cabecera por defecto y casi todo el mundo tenía un envoltorio con el módulo wave de Python o ffmpeg. Si lo mantienes, el archivo lleva dos cabeceras y los 44 bytes de la segunda se reproducen como un clic al inicio. Quita el envoltorio o pide explícitamente audio/l16.
# Antes (3.1 preview / 2.5): envolver PCM crudo
import wave
with wave.open("salida.wav", "wb") as wf:
    wf.setnchannels(1); wf.setsampwidth(2); wf.setframerate(24000)
    wf.writeframes(pcm_bytes)

# Ahora (3.8, petición normal): ya es WAV
with open("salida.wav", "wb") as f:
    f.write(base64.b64decode(interaction.output_audio.data))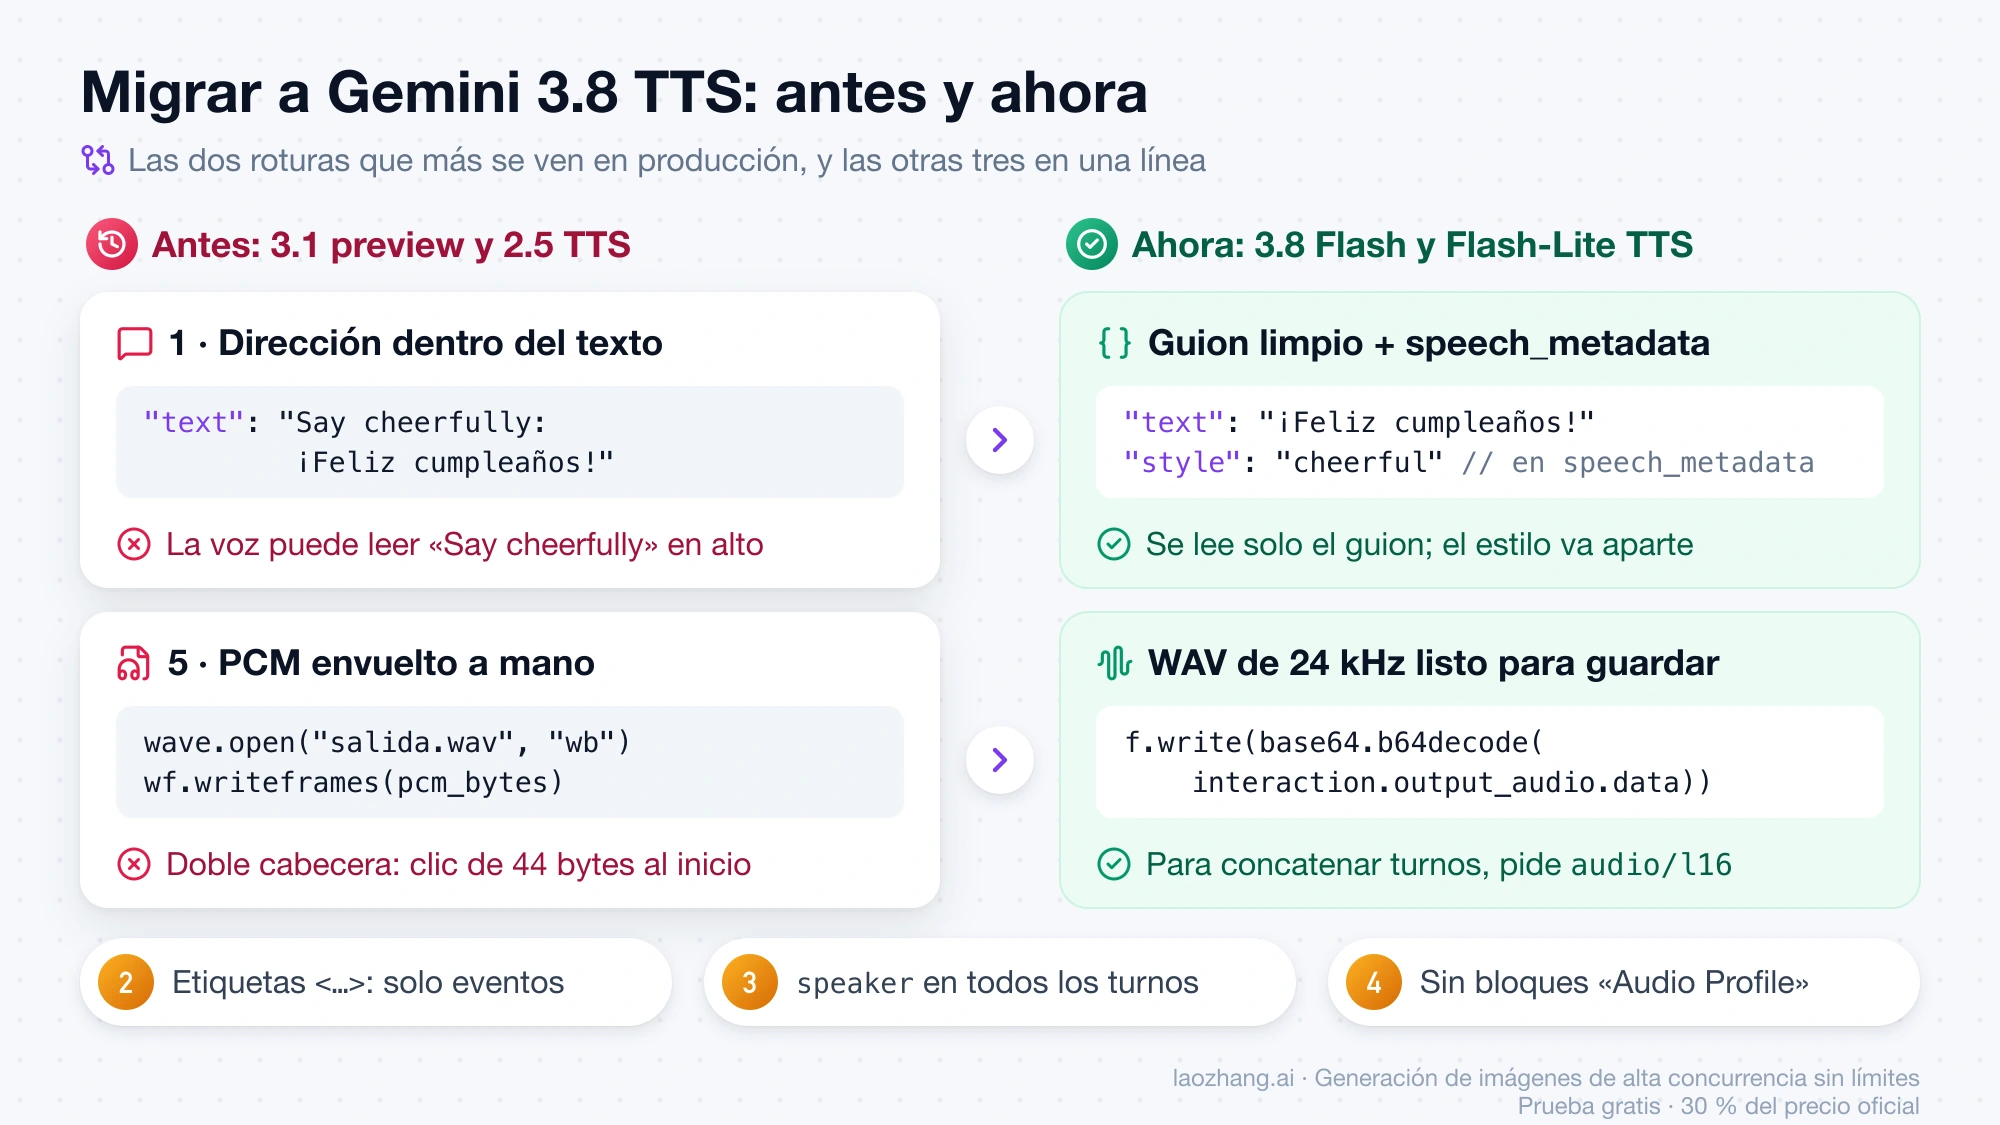
Dos notas para quien migra. Si sigues en gemini-2.5-flash-preview-tts o gemini-2.5-pro-preview-tts, desde el 18 de septiembre de 2026 Google limita el acceso a los modelos 2.5 a usuarios que ya los usaban; no están retirados, pero un proyecto nuevo no debería contar con ellos. Y si trabajas en Go, el ejemplo oficial de esa pestaña sigue en gemini-3.1-flash-tts-preview con prompts inline y envoltorio WAV manual; adapta la forma JSON de la petición REST de arriba en lugar de copiarlo.
Para quien depende de Vertex AI o de la API de Cloud Text-to-Speech: a 30 de septiembre de 2026 la página de Gemini-TTS de Cloud lista gemini-3.1-flash-tts-preview y la serie 2.5, sin entrada para 3.8, y el anuncio sitúa el acceso empresarial como «próximamente» en Gemini Enterprise. Hoy la ruta con 3.8 es la Gemini API con clave de AI Studio.
Dirigir la voz en español: estilo, etiquetas y pausas
La guía de prompting separa dos ámbitos. Lo que dura todo el turno (emoción, ritmo, volumen, «whispering», «sarcastic», «speaking slowly») va en style. Lo que ocurre en un instante va inline entre ángulos. Aunque tu guion esté en español, Google indica que las etiquetas se mantengan en inglés, y aconseja probar primero con style vacío porque la mayoría de peticiones no necesitan dirección: el modelo ya lee la puntuación y el contexto.
Etiquetas recomendadas (siempre en inglés, también con texto en español):
Respiración : <breath> <heavy breath> <exhales> <pant> <sigh>
Risa        : <laugh> <chuckle> <giggle> <snicker> <cackle>
Reacciones  : <gasp> <cough> <sneeze> <throat-clearing> <snort> <tsk> <argh>
Sonidos     : <sob> <cry> <whimper> <groan> <yawn> <scream> <shout>
Pausas      : <short pause> <long pause>

Ejemplo de guion:
"Espera... <short pause> ¿has oído eso? <sigh> Da igual, sigamos.
Esto es MUY importante <breath> y no lo voy a repetir."
Tres recursos más del mismo documento:
- Pausas en tres niveles: comas, guiones dobles y puntos suspensivos para vacilaciones naturales; las etiquetas de pausa para silencios en un punto exacto; y
style: "speaking slowly"para todo el turno. - Énfasis escribiendo la palabra en MAYÚSCULAS, combinado con puntuación.
- Pronunciación de nombres propios o siglas difíciles con el alfabeto fonético internacional entre barras,
/niːv/, según la guía para desarrolladores de AI Studio.
En diálogo a dos voces puedes meter reacciones del oyente sin cortar el turno: una o tres palabras entre barras verticales dentro del texto del hablante A (|ajá|, |¿en serio?|) las dice el hablante B por encima mientras A sigue hablando. Google señala que esta superposición funciona mejor con gemini-3.8-flash-tts.
Lo que no debes hacer, también documentado: no cambies edad, género, nombre o acento permanente desde style (para eso eliges otra voz de la biblioteca o diseñas una), y no añadas frases del tipo «mantén la misma voz» o «no cambies de timbre», porque ese texto extra aumenta la deriva en lugar de reducirla. Para agentes de voz, una llamada por turno, la voz configurada como identidad y un style vacío o una cadena corta constante para toda la conversación.
Voces: predefinidas, biblioteca extendida, diseño y replicación
speech_config.voice acepta cualquiera de estas cosas: el nombre de una de las 30 voces predefinidas de estudio (Zephyr, Puck, Charon, Kore, Fenrir, Leda, Orus, Aoede y el resto de la tabla oficial), el identificador de una voz de la biblioteca extendida, un voice_... creado por diseño o replicación, o una voicekey_... sin estado.
La biblioteca extendida se consulta con client.voices.list() o GET /v1beta/voices, con filtros por language_code, region_code, accent, gender, pitch, persona, contexts, type (prebuilt, prompted, replicated), search y page_size (50 por defecto, 1.000 como máximo). El anuncio menciona expresamente variantes regionales como el español de México; el registro de cambios habla de más de 150 voces consultables y el blog de más de 2.000, así que trata el tamaño exacto como algo que cambia y filtra por lo que necesites:
response = client.voices.list(
    language_code=["es-ES"],
    gender=["female"],
    contexts=["Audiobook"],
    type_=["prebuilt"],
    page_size=50,
)
for voice in response.voices or []:
    print(voice.id, voice.display_name, voice.language_code, voice.accent, voice.pitch)
Diseño de voz (Voice design)
client.voices.create con type: "prompted" genera una voz persistente a partir de una descripción y devuelve un voice_... y una muestra sample_audio en WAV. La descripción debe decir quién habla (edad, timbre, tono, acento, cadencia), no qué emoción tiene en ese momento:
created_voice = client.voices.create(
    store=True,
    voice={
        "model": "gemini-3.8-flash-tts",
        "type": "prompted",
        "display_name": "Narradora documental",
        "gender": "female",
        "language_code": "es-ES",
        "prompted": {
            "input": (
                "A calm documentary narrator in her 40s, Castilian Spanish accent, "
                "low warm register, unhurried cadence."
            )
        },
    },
)
print(created_voice.id)  # voice_... para usar en speech_config
Replicación de voz (Voice replication)
La replicación, que la comunidad suele llamar clonación de voz, usa type: "replicated" con dos audios del mismo adulto grabados con el mismo micrófono en la misma sala: source_audio de 10 a 30 segundos de habla limpia y consent_audio, donde esa persona recita literalmente la frase de consentimiento de uno de los 30 locales admitidos. Para español hay dos, es-ES y es-US, con el mismo texto:
Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice para crear un modelo de voz sintética.Google recomienda WAV mono de 24 kHz y 16 bits, comprueba que el hablante de ambos audios coincide, marca todo el audio generado con SynthID y añade credenciales C2PA. Con store=True obtienes un voice_... persistente; con store=False, una voicekey_... que gestionas tú.
Aquí está el punto que afecta a quien trabaja desde España. La nota al pie del anuncio dice que la replicación de voz a través de AI Studio no está disponible en el Espacio Económico Europeo (España incluida), Reino Unido, Suiza, India, Illinois y Texas. La nota nombra solo la interfaz de AI Studio; sobre la ruta por API desde esos territorios la documentación pública no dice nada, ni que funcione ni que esté bloqueada. Si tu producto depende de replicar voces, compruébalo con tu propia clave antes de comprometerte, y ten en cuenta que el diseño de voz por descripción no aparece en esa restricción.
Límites y fronteras de fallo
| Límite | Valor | Consecuencia práctica |
|---|---|---|
| Tokens de entrada por petición | 8.192 | Un guion largo se trocea; a unos 200 tokens por minuto hablado son del orden de 40 minutos de texto |
| Tokens de salida por petición | 16.384 (límite de servicio de la Gemini API) | A 25 tokens por segundo equivale a unos 10,9 minutos de audio; este tope se alcanza antes que el de entrada, así que el corte natural para un audiolibro son bloques de menos de 10 minutos |
| Hablantes por petición | 2, solo con voces predefinidas | Voces diseñadas o replicadas en diálogo y escenas de tres o más personajes: un turno por petición y concatenación |
Voces personalizadas con estado (voice_..., diseñadas o replicadas) | 200 por proyecto, 1 año de vida | Compartido entre diseño y replicación; borra las que no uses |
Claves de voz sin estado (voicekey_...) | 7 días de vida | Solo replicación; las guardas y regeneras tú |
| Entrada y salida | Solo texto, solo audio | Sin llamadas a funciones, salida estructurada, búsqueda, ejecución de código, pensamiento ni Live API |
| Límites de tasa por modelo | No publicados para 3.8 TTS | Consulta los límites activos en AI Studio; topes de gasto por nivel de USD 10 a 200 cada 10 minutos |
Sobre la concatenación de turnos: como una petición normal devuelve WAV con cabecera RIFF de 44 bytes, si vas a unir varios turnos generados por separado pide audio/l16 en response_format o recorta esos 44 bytes de cada respuesta antes de encadenar los fotogramas PCM de 24 kHz; si no, oirás un chasquido en cada unión.
Y un resumen de síntomas para diagnosticar rápido:
| Lo que oyes o ves | Causa probable | Arreglo |
|---|---|---|
| La voz lee «Say cheerfully» o «Speaker 1» | Dirección dentro de text | Mover a style y speaker en speech_metadata |
| El WAV no se abre o empieza con un clic | Doble cabecera por envoltorio antiguo | Escribir los bytes tal cual o pedir audio/l16 |
| Error en petición a dos voces | Un turno sin speaker o con nombre que no coincide | speaker en todos los turnos, igual que en speakers |
| La voz cambia de timbre a mitad de narración | Bloques de persona largos o meta-instrucciones en style | Voz diseñada con voice_... y style corto o vacío |
| Se oye una etiqueta como palabra | Etiqueta inventada o en español | Usar solo las etiquetas recomendadas, en inglés |
| No puedes crear más voces | 200 voces con estado por proyecto | Borrar voces antiguas o usar voicekey_... |
429 RESOURCE_EXHAUSTED | Tope de gasto de 10 minutos o cupo del nivel | Esperar, reducir ritmo o solicitar subida de límite |
Preguntas frecuentes
¿Puedo usar Gemini 3.8 Flash TTS gratis? Sí, en las modalidades Estándar y Priority ambos modelos figuran sin coste en el nivel gratuito, con tus datos usados para mejorar productos de Google. Batch y Flex requieren nivel de pago. El cupo exacto de peticiones no está publicado para estos modelos; míralo en AI Studio.
¿Cuánto cuesta una hora de audio?
En modalidad estándar y tarifa 2026, USD 0,81 con gemini-3.8-flash-tts y USD 0,54 con gemini-3.8-flash-lite-tts (90.000 tokens de salida por hora a USD 9,00 y USD 6,00 por millón). Desde el 1 de enero de 2027 pasan a USD 1,62 y USD 1,08. Batch y Flex cuestan la mitad.
¿Qué devuelve la API, WAV o PCM?
Una petición normal devuelve WAV con cabecera (24 kHz, mono, 16 bits) que guardas directamente; una petición con stream: true devuelve trozos de PCM crudo audio/l16. Puedes forzar cualquiera de los dos, o mu-law y A-law para telefonía, con response_format.mime_type.
¿Es Gemini 3.8 Flash TTS lo mismo que Gemini 3.8 Flash?
No. gemini-3.8-flash-tts solo convierte texto en audio. El modelo de texto multimodal, con su precio y su migración desde 3.7, se trata en Gemini 3.8 Flash: precio, ID y migración segura desde 3.7.
¿Puedo replicar mi propia voz desde España?
A través de la interfaz de AI Studio, no: el anuncio excluye al Espacio Económico Europeo, Reino Unido y Suiza. Sobre la llamada directa a /v1beta/voices desde esos países la documentación no se pronuncia; pruébalo con tu clave. La replicación exige el audio de consentimiento con la frase oficial en es-ES o es-US, y todo el audio generado lleva marca de agua SynthID.
¿Está disponible en Vertex AI? A 30 de septiembre de 2026 la página de Gemini-TTS de Google Cloud no lista los modelos 3.8 y el acceso empresarial se anuncia como próximo en Gemini Enterprise. Por ahora, la Gemini API con clave de AI Studio es la vía.