Claude Fable 5.2 vs GPT-6.2 Sol: 4 veces por token, 12 por tarea
GPT-6.2 Sol cobra la cuarta parte por token y unas 12 veces menos por tarea. Pásale el trabajo comprobable: ningún nivel de Sol iguala a Fable 5.2 en high.
En esta página
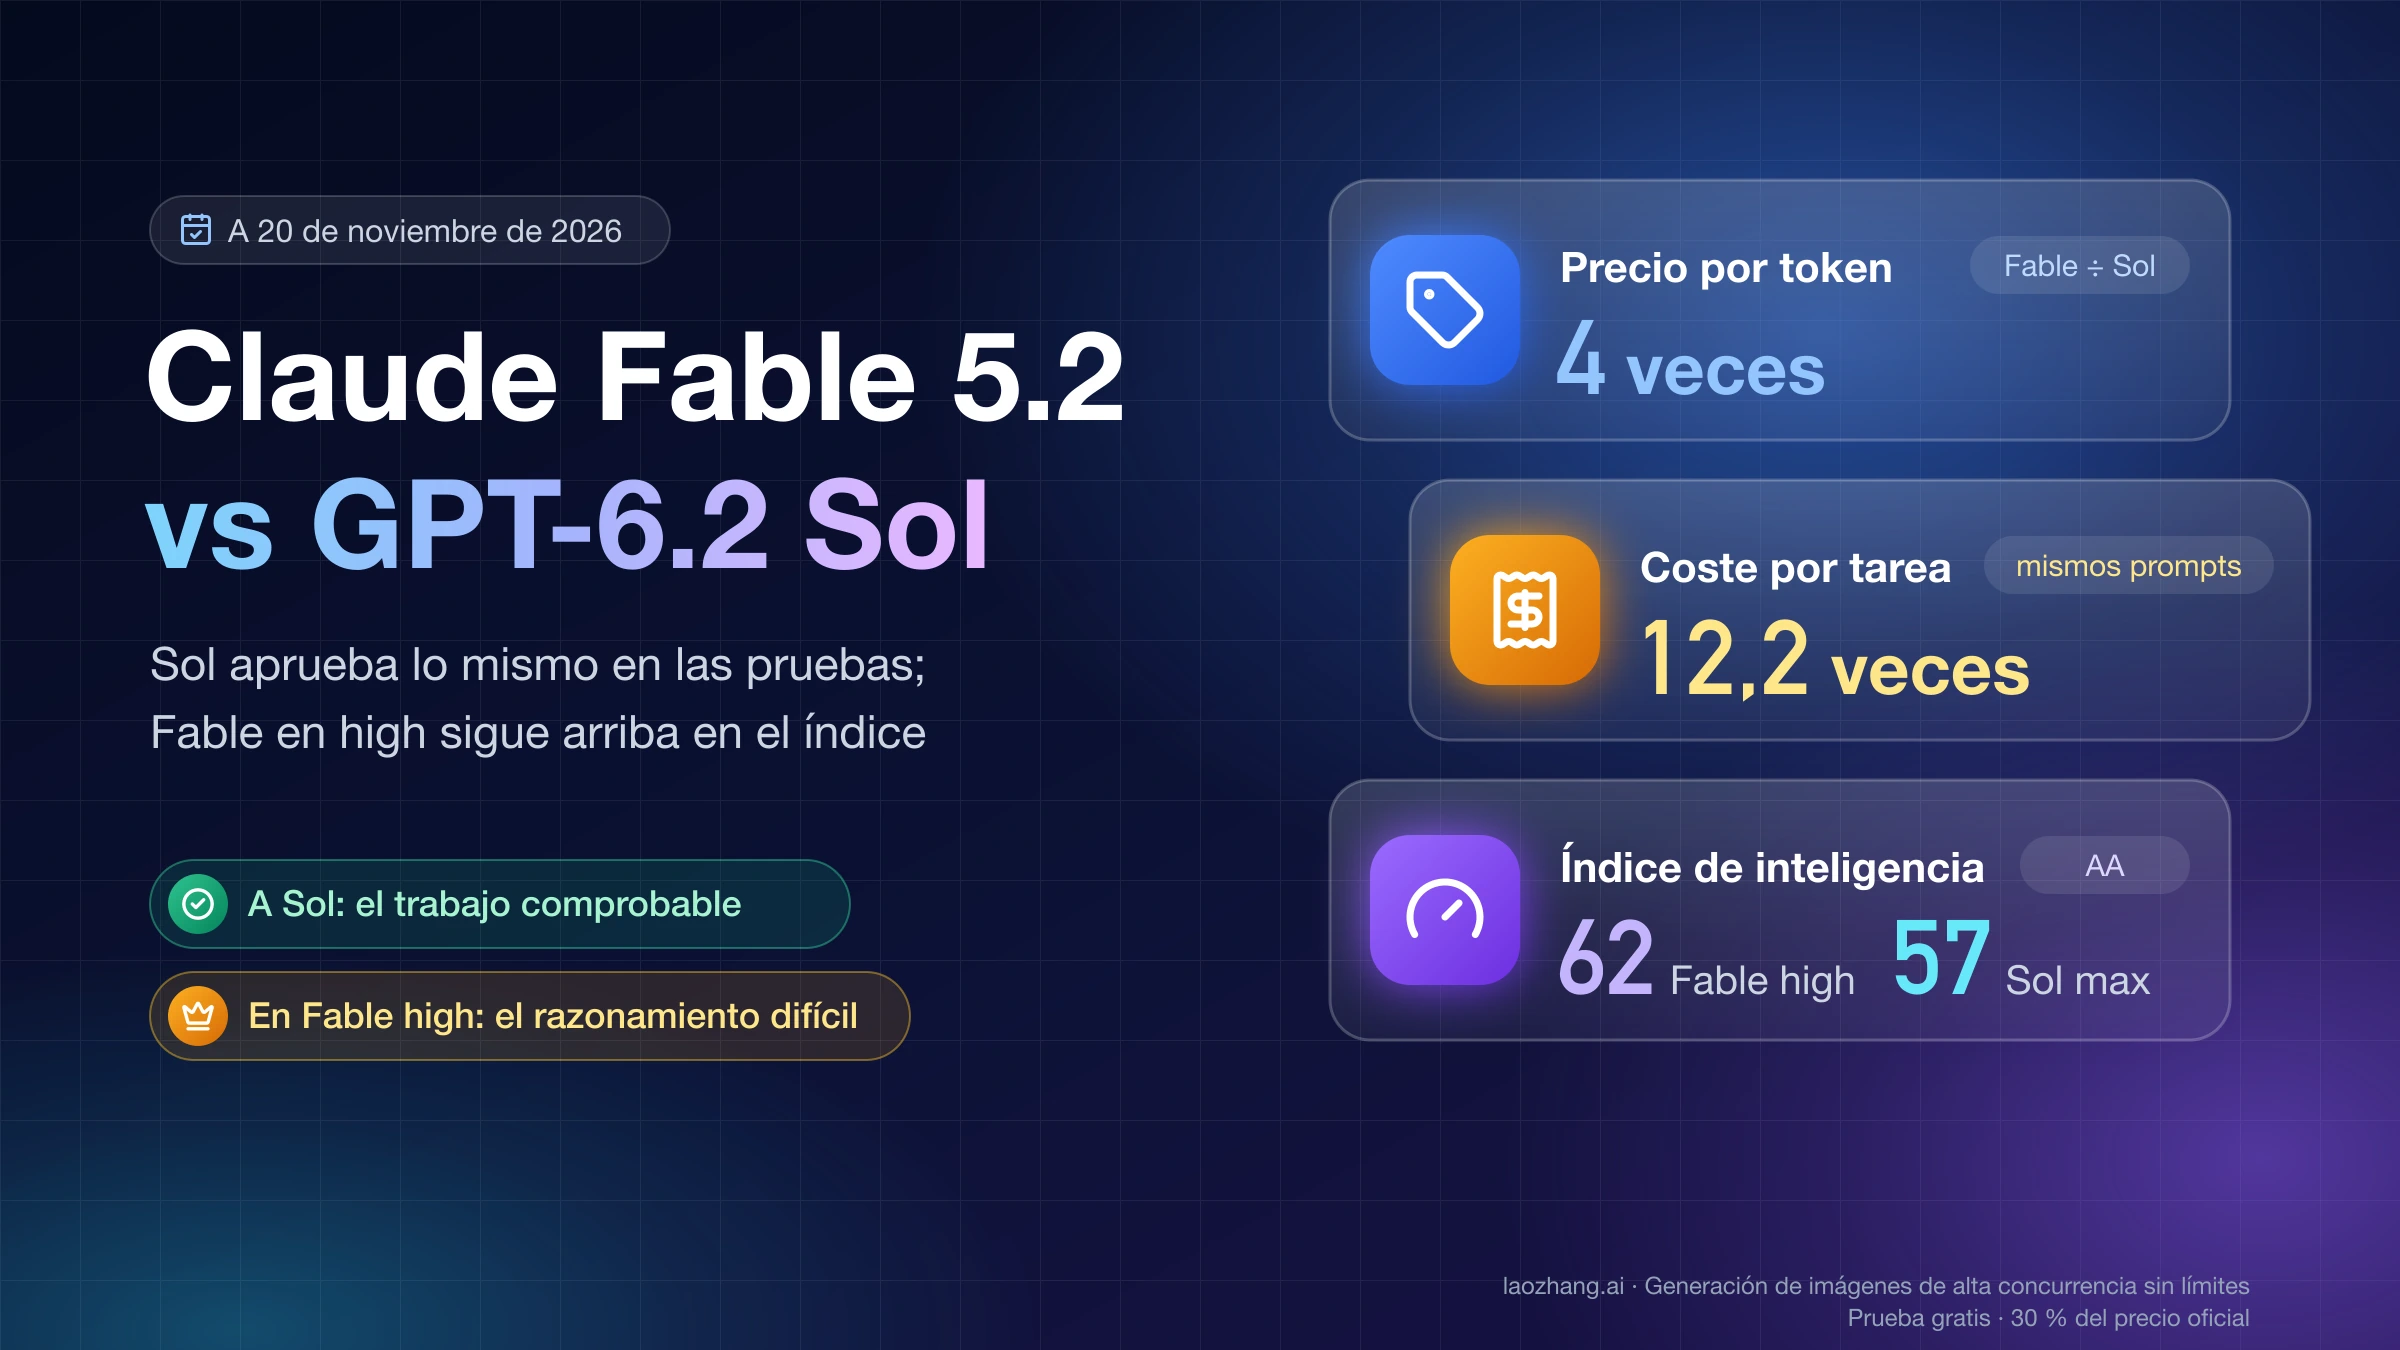
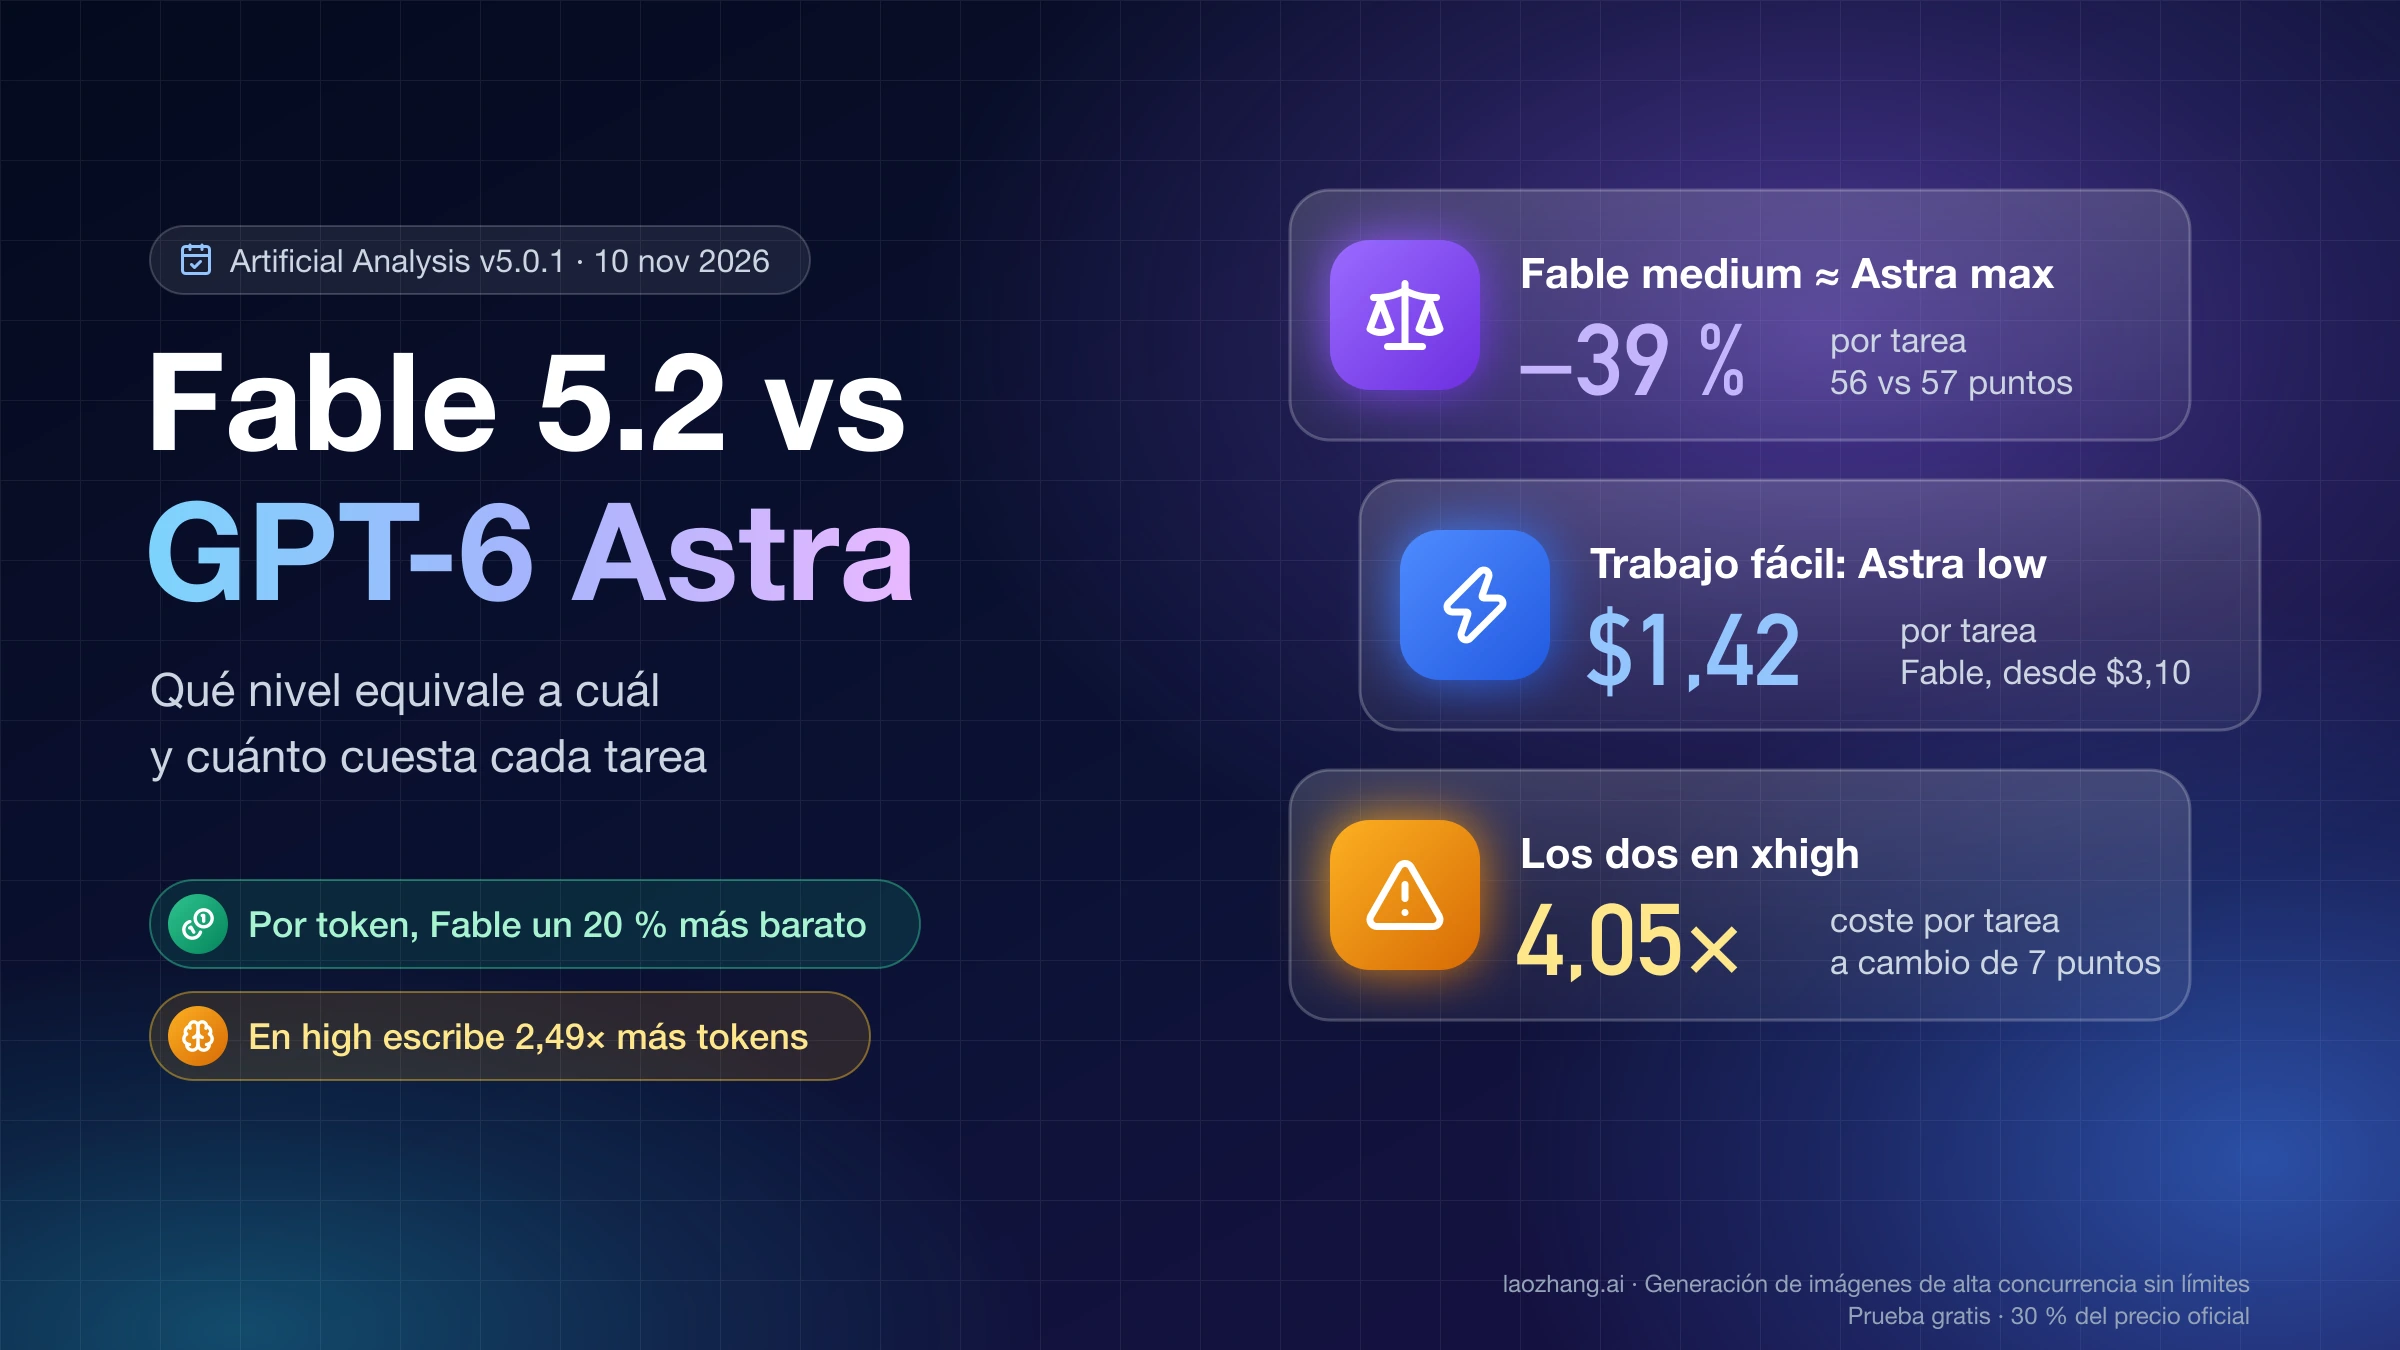
Si ya pagas Claude Fable 5.2 y quieres saber si GPT-6.2 Sol puede quedarse con parte de ese trabajo, la respuesta es sí para la programación y las tareas de agente que puedes comprobar, y no para el trabajo en el que necesitas la nota de Fable en high. Pasa a gpt-6.2-sol en su nivel por defecto (medium) el código con tests, la corrección de errores acotados, la extracción de datos y las tareas de agente bien especificadas, y sube a high o xhigh antes de volver a Fable. Deja Claude Fable 5.2 en high para el razonamiento más difícil: en el índice de Artificial Analysis, a 20 de noviembre de 2026, ningún nivel de Sol llega a los 62 puntos de Fable en high, y el techo de Sol (max, 57 puntos) equivale a Fable en medium.
La diferencia de precio es bastante mayor de lo que dice la tarifa. Por token, Fable cuesta 4 veces lo que Sol (8 $ y 40 $ por millón de entrada y salida, frente a 2 $ y 10 $), pero por tarea la distancia crece porque Fable escribe más tokens para llegar a la misma respuesta y cuenta el mismo texto como más tokens. Con los mismos prompts y la misma pasarela de API, Fable en su nivel por defecto costó 12,2 veces lo que Sol en el suyo en 8 tareas corrientes (0,7436 $ frente a 0,0610 $; Fable medido el 11 de noviembre, Sol el 18) y otra vez 12,2 veces en 8 tareas difíciles del 20 de noviembre (3,61 $ frente a 0,30 $). En todas esas pruebas los dos modelos aprobaron todas las respuestas, así que lo medido es coste, tokens y tiempo; la ventaja de calidad de Fable sale solo de Artificial Analysis y de las gráficas que publicó OpenAI.
Antes de mirar la calidad, comprueba si algo descarta a uno de los dos. Fable 5.2 exige retención de datos de 30 días y rechaza con un error 400 el tool_choice forzado; GPT-6.2 Sol sube de precio en toda la petición cuando la entrada pasa de 272.000 tokens, no acepta el nivel none y en ChatGPT solo está en Work y en Codex, no en el chat normal. Si nada de eso te bloquea, lanza tus propias tareas en los dos modelos y compara el coste por resultado aceptado, no el precio por token.
Qué trabajo pasar a GPT-6.2 Sol y con qué effort
Pasa a Sol todo lo que se pueda verificar automáticamente y que hoy Fable resuelve sin problemas, empezando en medium, y reserva Fable 5.2 en high para el trabajo en el que necesitas una puntuación que Sol no alcanza en ningún nivel. La regla sale de juntar dos fuentes que apuntan en sentidos distintos: en las pruebas con los mismos prompts, Sol en medium aprobó lo mismo que Fable por una fracción del coste, y en el índice de Artificial Analysis Fable mantiene 5 puntos de ventaja sobre el mejor Sol. Los nombres de nivel no son comparables entre fabricantes, así que «high en Sol» no equivale a «high en Fable».
| Si tu trabajo es… | Empieza con | Cuándo quedarte en Fable 5.2 |
|---|---|---|
| Código con tests, funciones acotadas, corrección de errores, recuentos exactos sobre un log | Sol en medium | Solo si Sol en xhigh sigue fallando en tareas que puedes comprobar |
| Tareas de agente bien especificadas en la CLI (Codex frente a Claude Code) | Sol en medium o high en Codex | Si las sesiones son largas, de varios archivos y con decisiones ambiguas, que es lo que no se ha medido |
Trabajo en el que te basta el nivel de Fable en medium | Sol en xhigh o max | Si te importa el tiempo: Sol en max tarda más por tarea que Fable en medium |
| Razonamiento difícil, ciencia, finanzas, derecho o salud, donde necesitas el máximo | Fable en high | Ningún nivel de Sol llega a su puntuación |
| Mucho volumen y respuesta rápida | Sol en medium | Evita Sol en low, que cae 12 puntos en el índice respecto a medium |
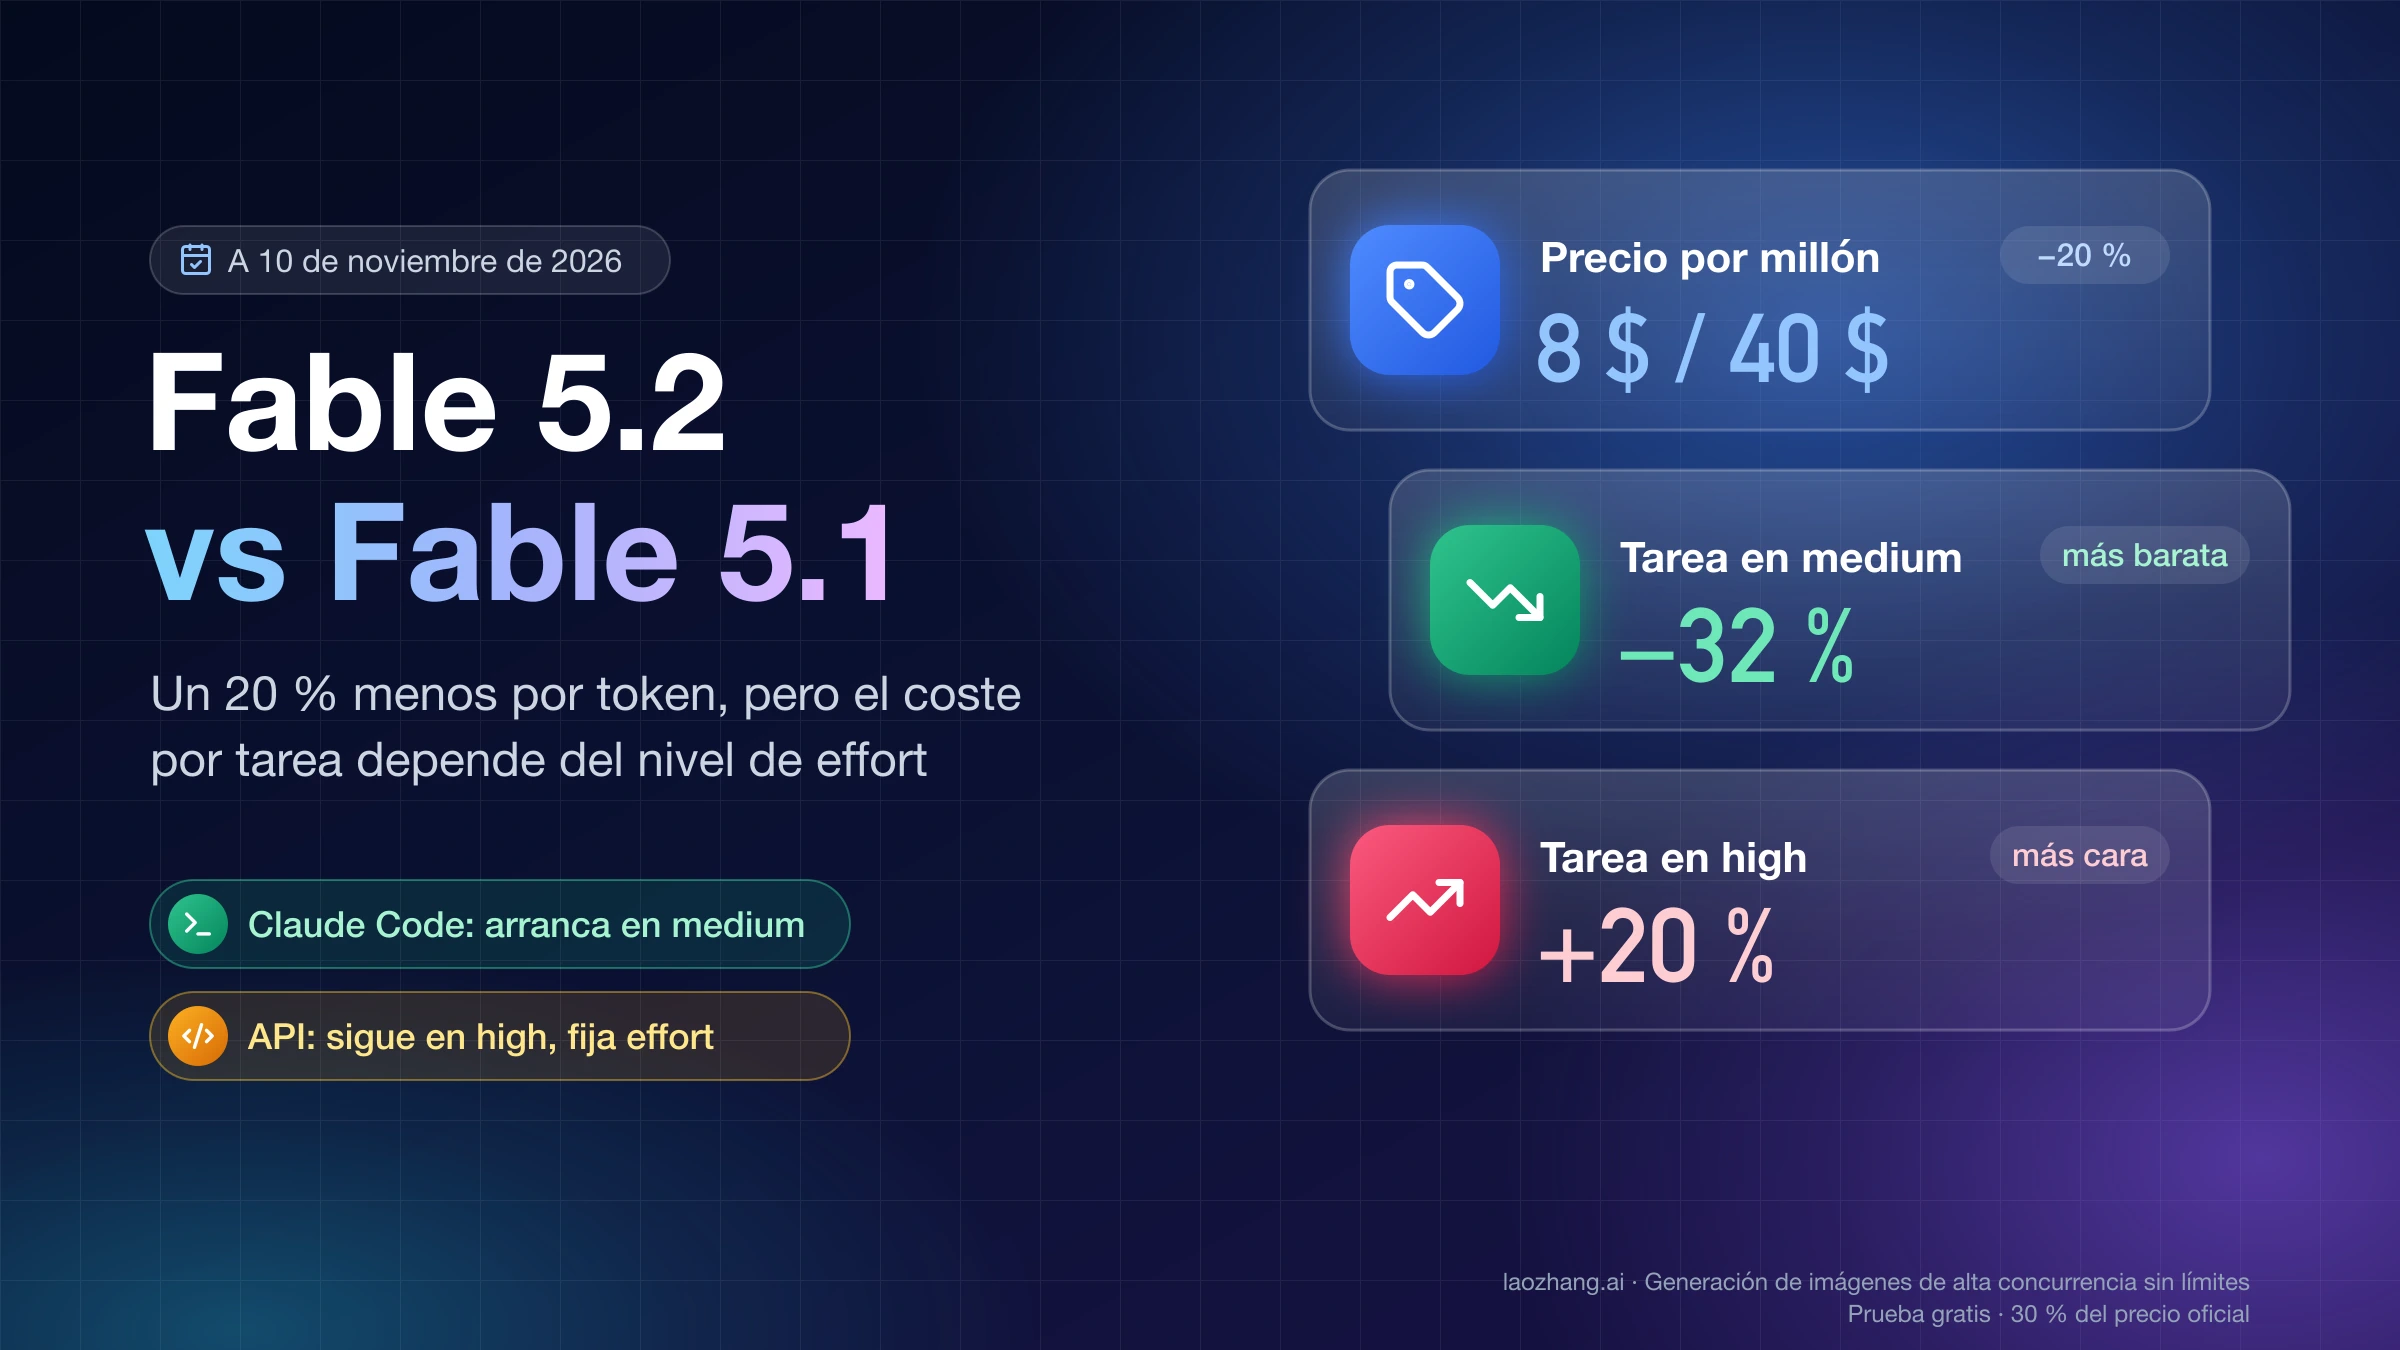
Ojo con lo que significa «por defecto» en cada sitio. En la API de Claude, Fable 5.2 trabaja en high si no indicas nada, pero en las apps de Claude y en Claude Code su nivel por defecto es medium; GPT-6.2 Sol usa medium tanto en la API como en Codex. Si ahora mismo usas Fable en Claude Code sin tocar el nivel, tu referencia es Fable en medium, y el Sol que la iguala en el índice es xhigh.
Precio por token: Fable 5.2 cuesta 4 veces lo que GPT-6.2 Sol
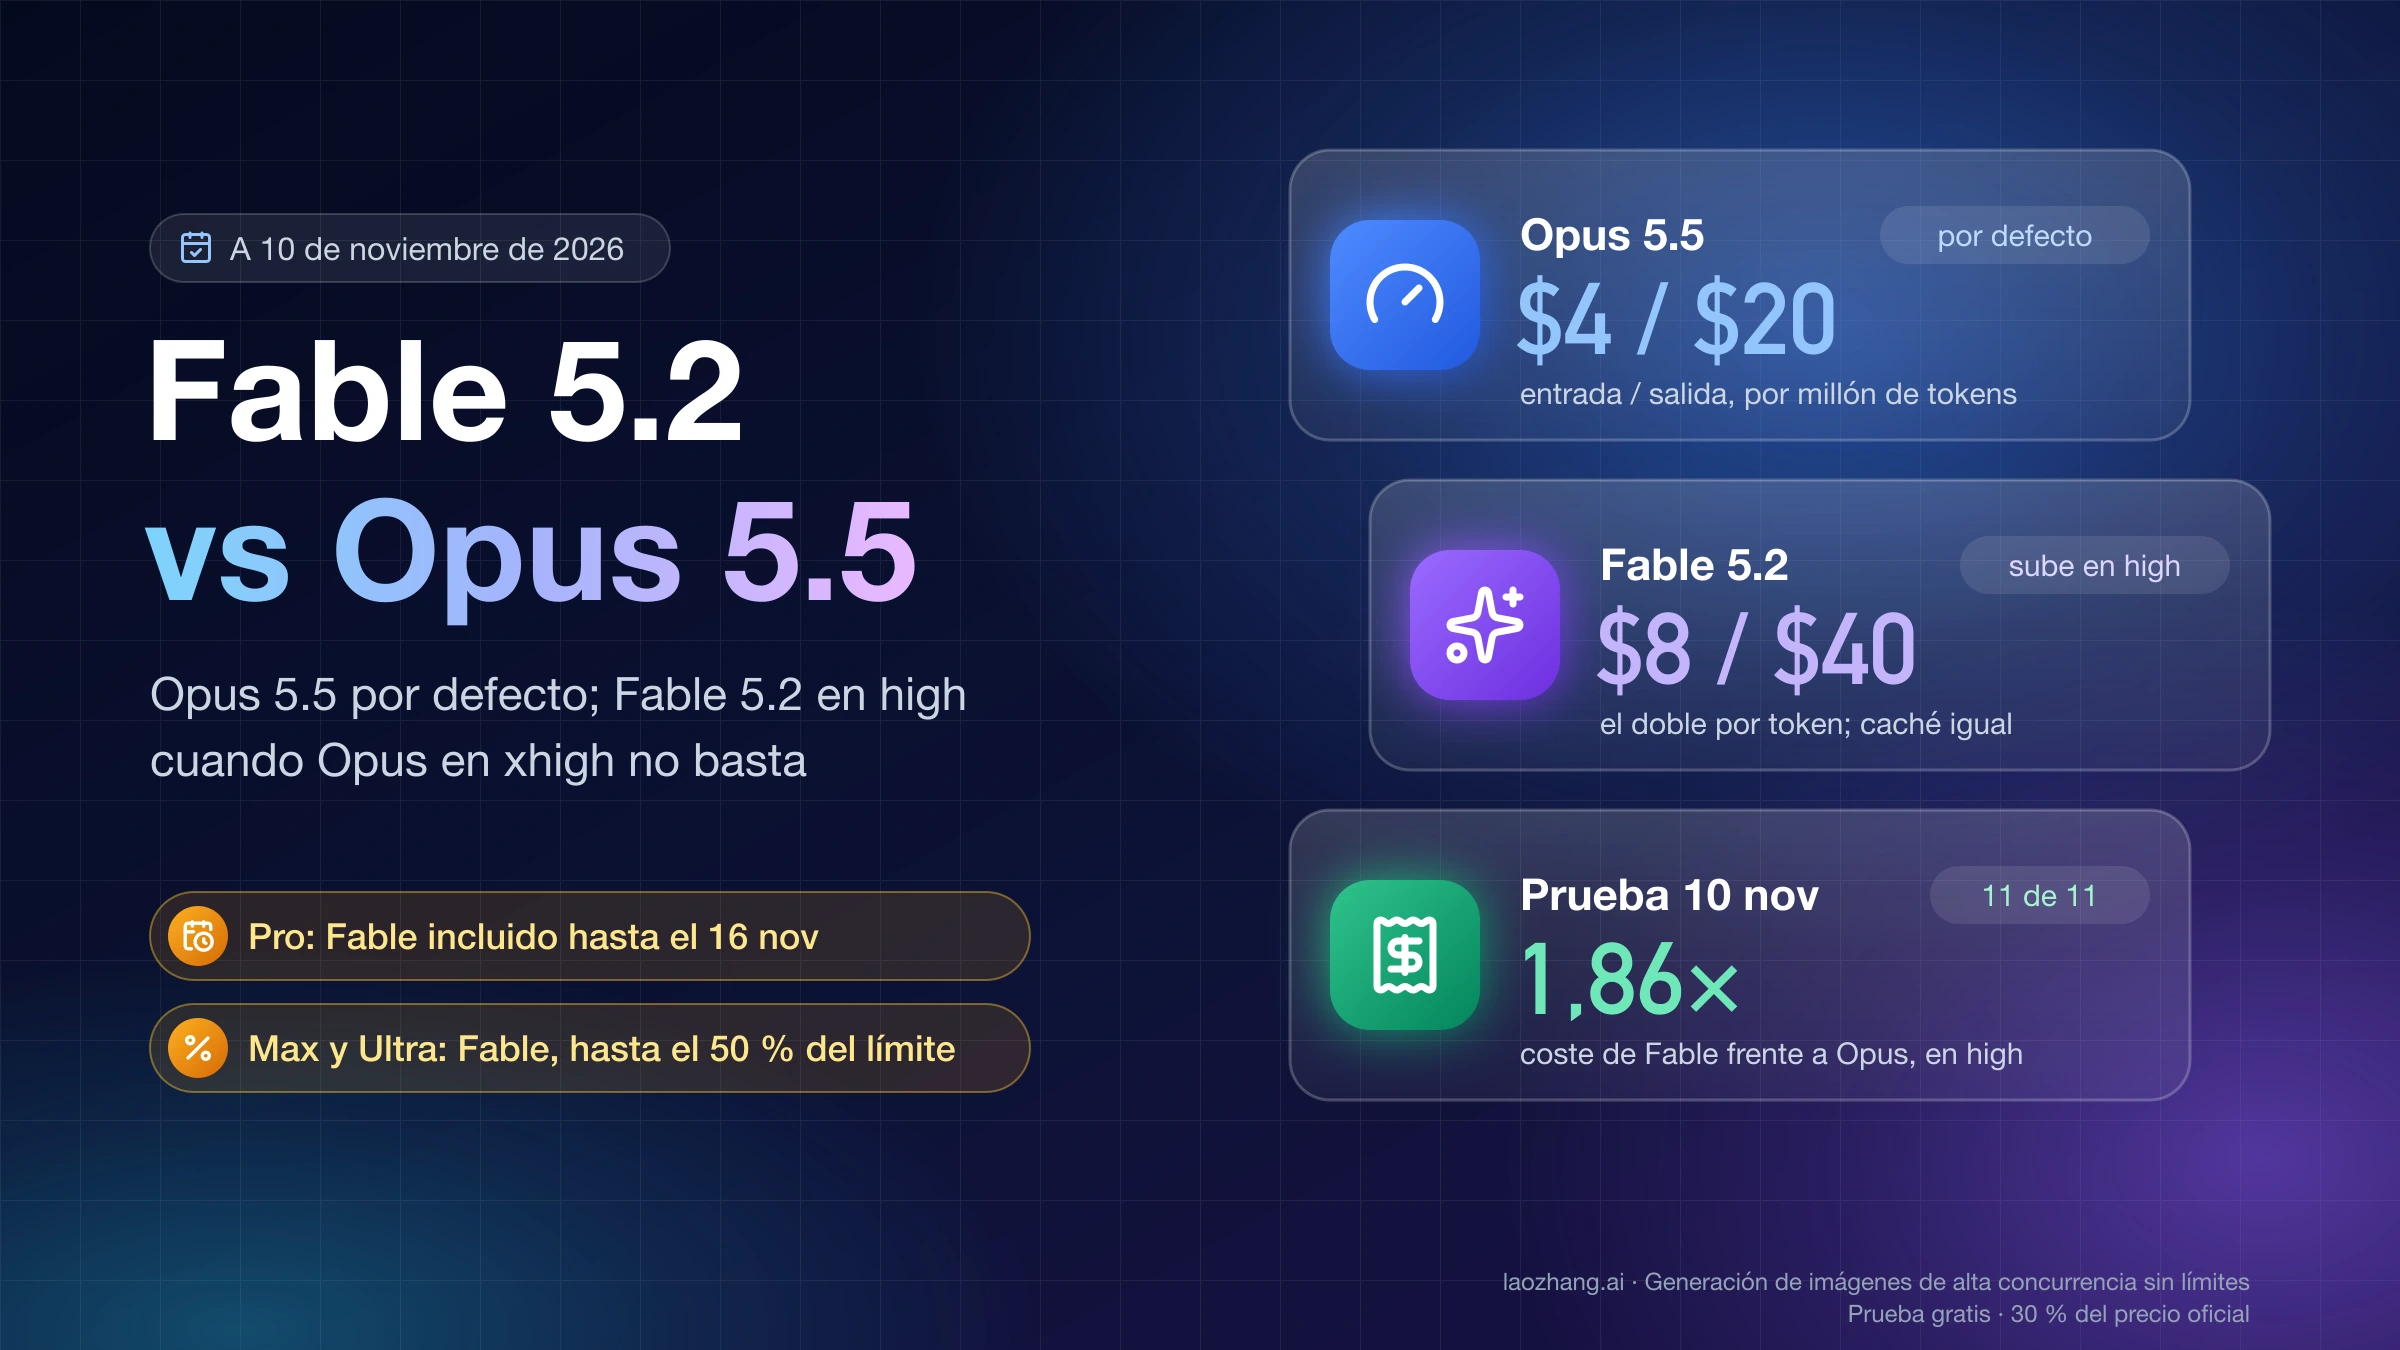
En la API directa de cada fabricante, Claude Fable 5.2 cuesta exactamente 4 veces lo que GPT-6.2 Sol en entrada, salida, Batch y modo rápido, y el doble en lectura de caché. Estos son los precios de lista en dólares por millón de tokens según la página de precios de la API de OpenAI y la página de precios de la API de Claude, a 18 de noviembre de 2026:
| Por millón de tokens | Claude Fable 5.2 | GPT-6.2 Sol | Fable ÷ Sol |
|---|---|---|---|
| Entrada | 8 $ | 2 $ | 4 |
| Salida | 40 $ | 10 $ | 4 |
| Lectura de caché | 0,20 $ | 0,10 $ | 2 |
| Escritura de caché | 10 $ (5 minutos), 16 $ (1 hora) | 2,50 $ (30 minutos), 5 $ (12 horas) | — |
| Más de 272.000 tokens de entrada | Sin recargo: todo el millón de contexto a tarifa normal | Toda la petición a 4 $ de entrada y 15 $ de salida | 2 en entrada, 2,67 en salida |
| Batch (entrada / salida) | 4 $ / 20 $ | 1 $ / 5 $ (50 % de descuento) | 4 |
| Modo rápido (entrada / salida) | 16 $ / 80 $ | Fast 4 $ / 20 $; Ultrafast 6 $ / 30 $ hasta el 28 de febrero de 2027, después 6 veces la tarifa | 4 frente a Fast |
Ese 4 tampoco es la diferencia por tarea: en la práctica crece por dos motivos. El primero es la salida: con los mismos prompts, Fable escribió entre 3 y 4 veces más tokens de salida que Sol en su nivel por defecto (3,97 veces en las 8 tareas corrientes, 3,13 en las difíciles), y cada uno de esos tokens cuesta 4 veces más. El segundo es la forma de contar: un mismo texto se convierte en más tokens en Fable que en Sol. En un recuento del 18 de noviembre de 2026 con un pasaje por idioma, Fable contó el texto en español 1,88 veces más largo que GPT-6.2 Astra, y Sol dio exactamente el mismo total de entrada que Astra en 11 prompts, así que se puede suponer que cuenta igual que Astra. Con esa suposición, la entrada de un mismo prompt en español cuesta en Fable unas 7,5 veces más que en Sol (4 × 1,88); en inglés la proporción fue 1,45 y la entrada sale unas 5,8 veces más cara.
Si mueves a Sol prompts de sistema largos, hay un detalle que cambia la factura de caché. Según la guía de migración de OpenAI, a partir de GPT-6.2 la Responses API añade las instrucciones de nivel superior después de la entrada, así que para que unas instrucciones reutilizables entren en la caché hay que ponerlas en un mensaje de desarrollador como primer elemento de input. Si no lo haces, pagas a 2 $ lo que podría costarte 0,10 $.
¿Qué nivel de Sol equivale a Fable 5.2? Ninguno llega a high
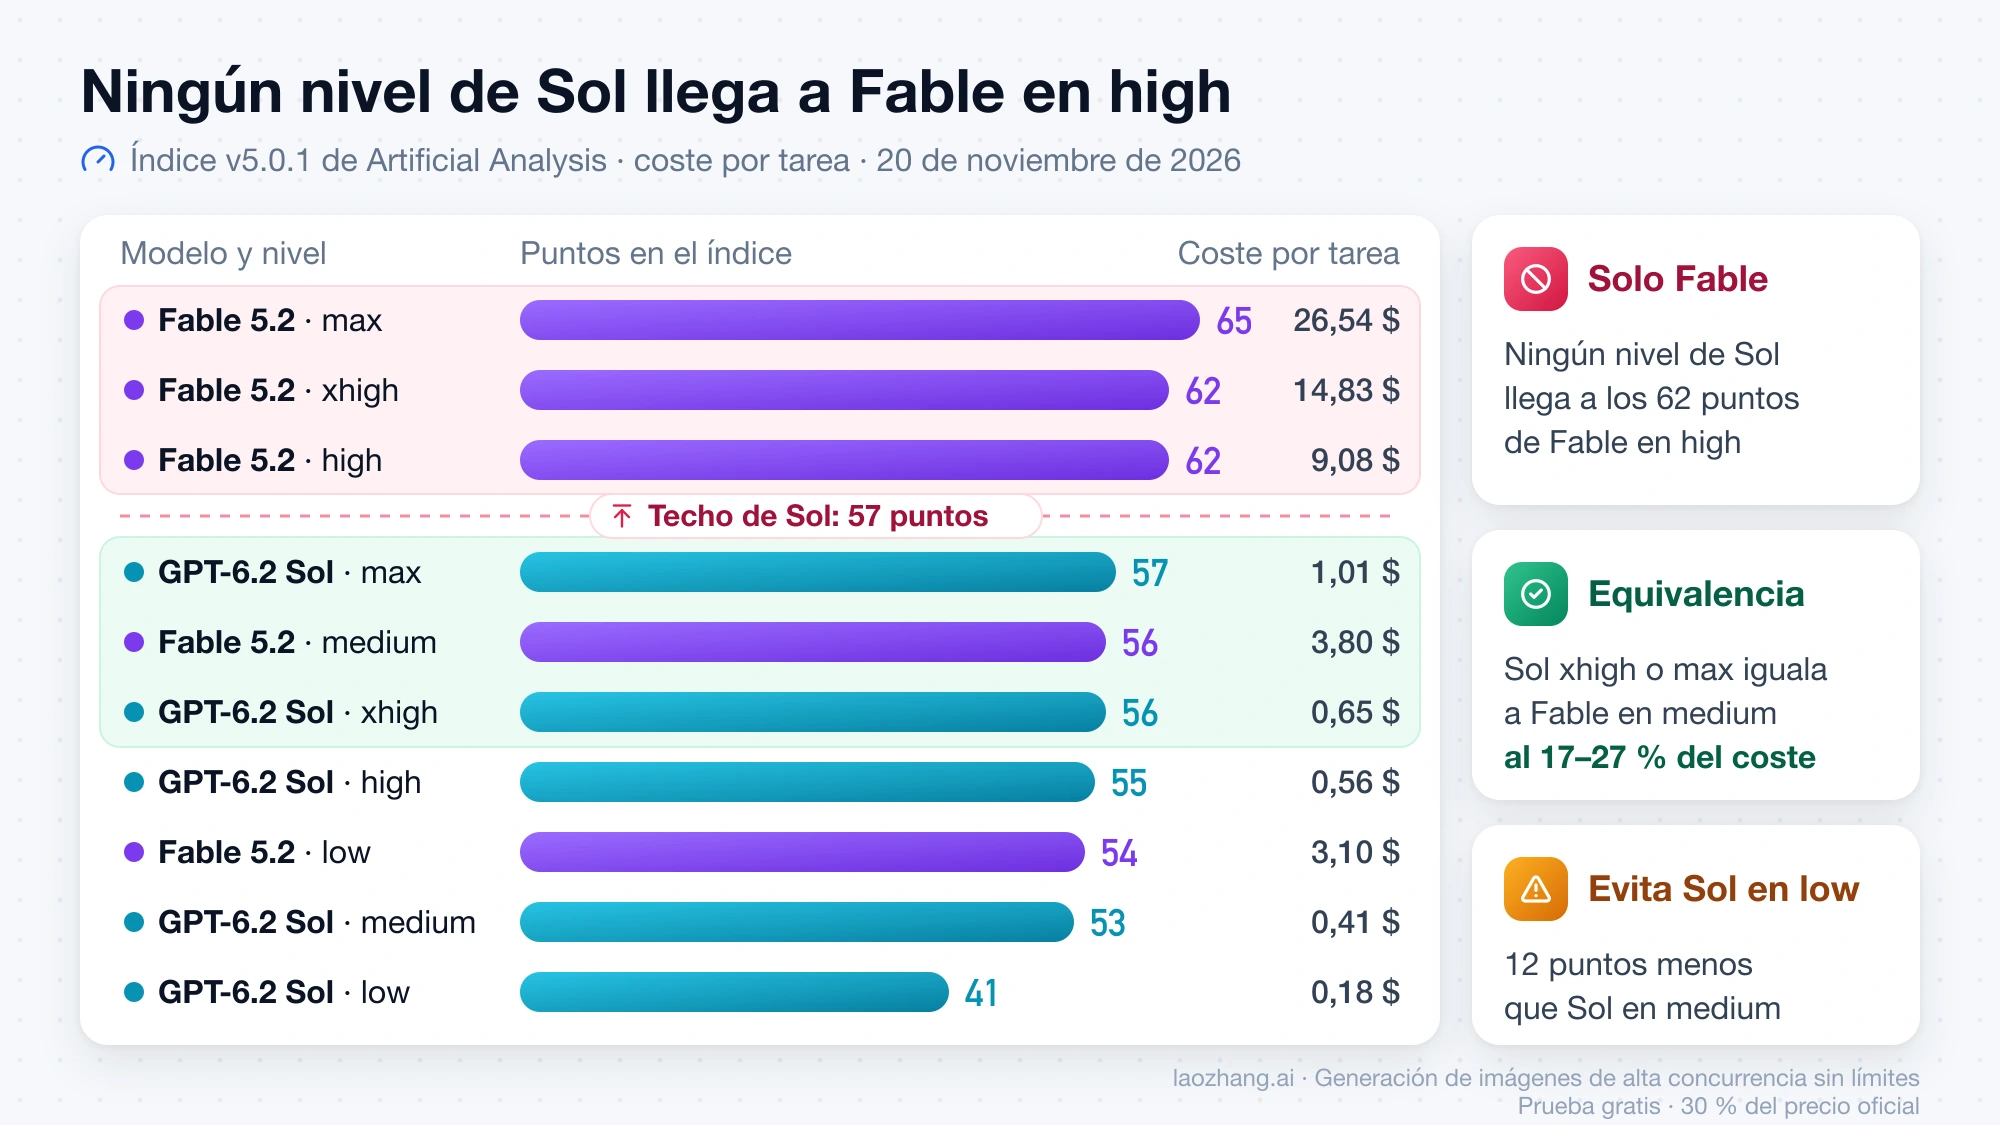
A igual puntuación en el índice de inteligencia v5.0.1 de Artificial Analysis, el mejor GPT-6.2 Sol (max, 57) queda a la altura de Fable 5.2 en medium (56) y 5 puntos por debajo de Fable en high (62). La tabla empareja cada nivel de Fable con el de Sol más próximo según la comparativa de Artificial Analysis entre Claude Fable 5.2 y GPT-6.2 Sol, con el coste por tarea del índice a precio de lista y los minutos por tarea, a 20 de noviembre de 2026:
| Fable 5.2 (índice · coste · minutos) | GPT-6.2 Sol más próximo | Cómo leerlo |
|---|---|---|
max: 65 · 26,54 $ · 42,0 | Ninguno | 8 puntos por encima del techo de Sol |
xhigh: 62 · 14,83 $ · 24,5 | Ninguno | Misma nota que Fable en high por un 63 % más |
high: 62 · 9,08 $ · 15,2 | Ninguno; Sol en max se queda en 57 | Es el escalón que Sol no cubre |
medium: 56 · 3,80 $ · 6,5 | max: 57 · 1,01 $ · 9,6; xhigh: 56 · 0,65 $ · 5,9 | Sol iguala o supera por un punto al 17–27 % del coste |
low: 54 · 3,10 $ · 5,5 | high: 55 · 0,56 $ · 5,0 | Sol saca un punto más por el 18 % del coste |
| — | medium: 53 · 0,41 $ · 3,5 | Un punto menos que Fable en low por el 13 % de su coste |
| — | low: 41 · 0,18 $ · 1,6 | El nivel más barato, con una caída fuerte |
Los porcentajes salen de dividir el coste de Sol entre el de Fable en cada fila (1,01 / 3,80 = 0,27; 0,65 / 3,80 = 0,17; 0,56 / 3,10 = 0,18). Comparando el mismo nombre de nivel, en cambio, Fable cuesta entre 9,3 veces (medium: 3,80 / 0,41) y 26,3 veces (max: 26,54 / 1,01) lo que Sol por tarea del índice: 16,2 veces en high, 22,8 en xhigh y 17,2 en low. Esa horquilla de 9 a 26 veces es la versión de Artificial Analysis del «12 veces» de las pruebas con los mismos prompts.
Los índices por área profesional del mismo informe van en la misma dirección. Con el mejor nivel de cada modelo, Fable 5.2 saca 65 frente a 57 en finanzas y contabilidad, 67 frente a 59 en estrategia y operaciones, 63 frente a 55 en derecho y 65 frente a 53 en salud. Si tu trabajo se parece a eso y necesitas la última respuesta buena, no a una suficiente, Fable en high sigue siendo la opción. Ten en cuenta que es un índice que promedia muchas evaluaciones, que recoge los tres primeros días de Sol en el mercado y que Artificial Analysis revisa sus cifras sin aviso: sirve para decidir qué configuraciones probar, no para saltarte la prueba.
Pruebas del 10 al 20 de noviembre: todo aprobado, 6,5–12 veces el coste
En cuatro pruebas con los mismos prompts, GPT-6.2 Sol y Claude Fable 5.2 aprobaron todas las respuestas, y Fable costó entre 6,5 y 12,2 veces más. Ninguna de ellas encontró una diferencia de calidad, así que lo que cuentan es cuánto cuesta y cuánto tarda cada modelo en el trabajo que los dos resuelven. Tres se lanzaron por la pasarela de API laozhang.ai (Messages API para Fable, Chat Completions para Sol) y la cuarta en la CLI de programación de cada fabricante. Salvo en el conjunto difícil, las columnas de Fable son anteriores al lanzamiento de Sol del 17 de noviembre y no se repitieron; el precio de Fable no cambió entre una fecha y otra.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
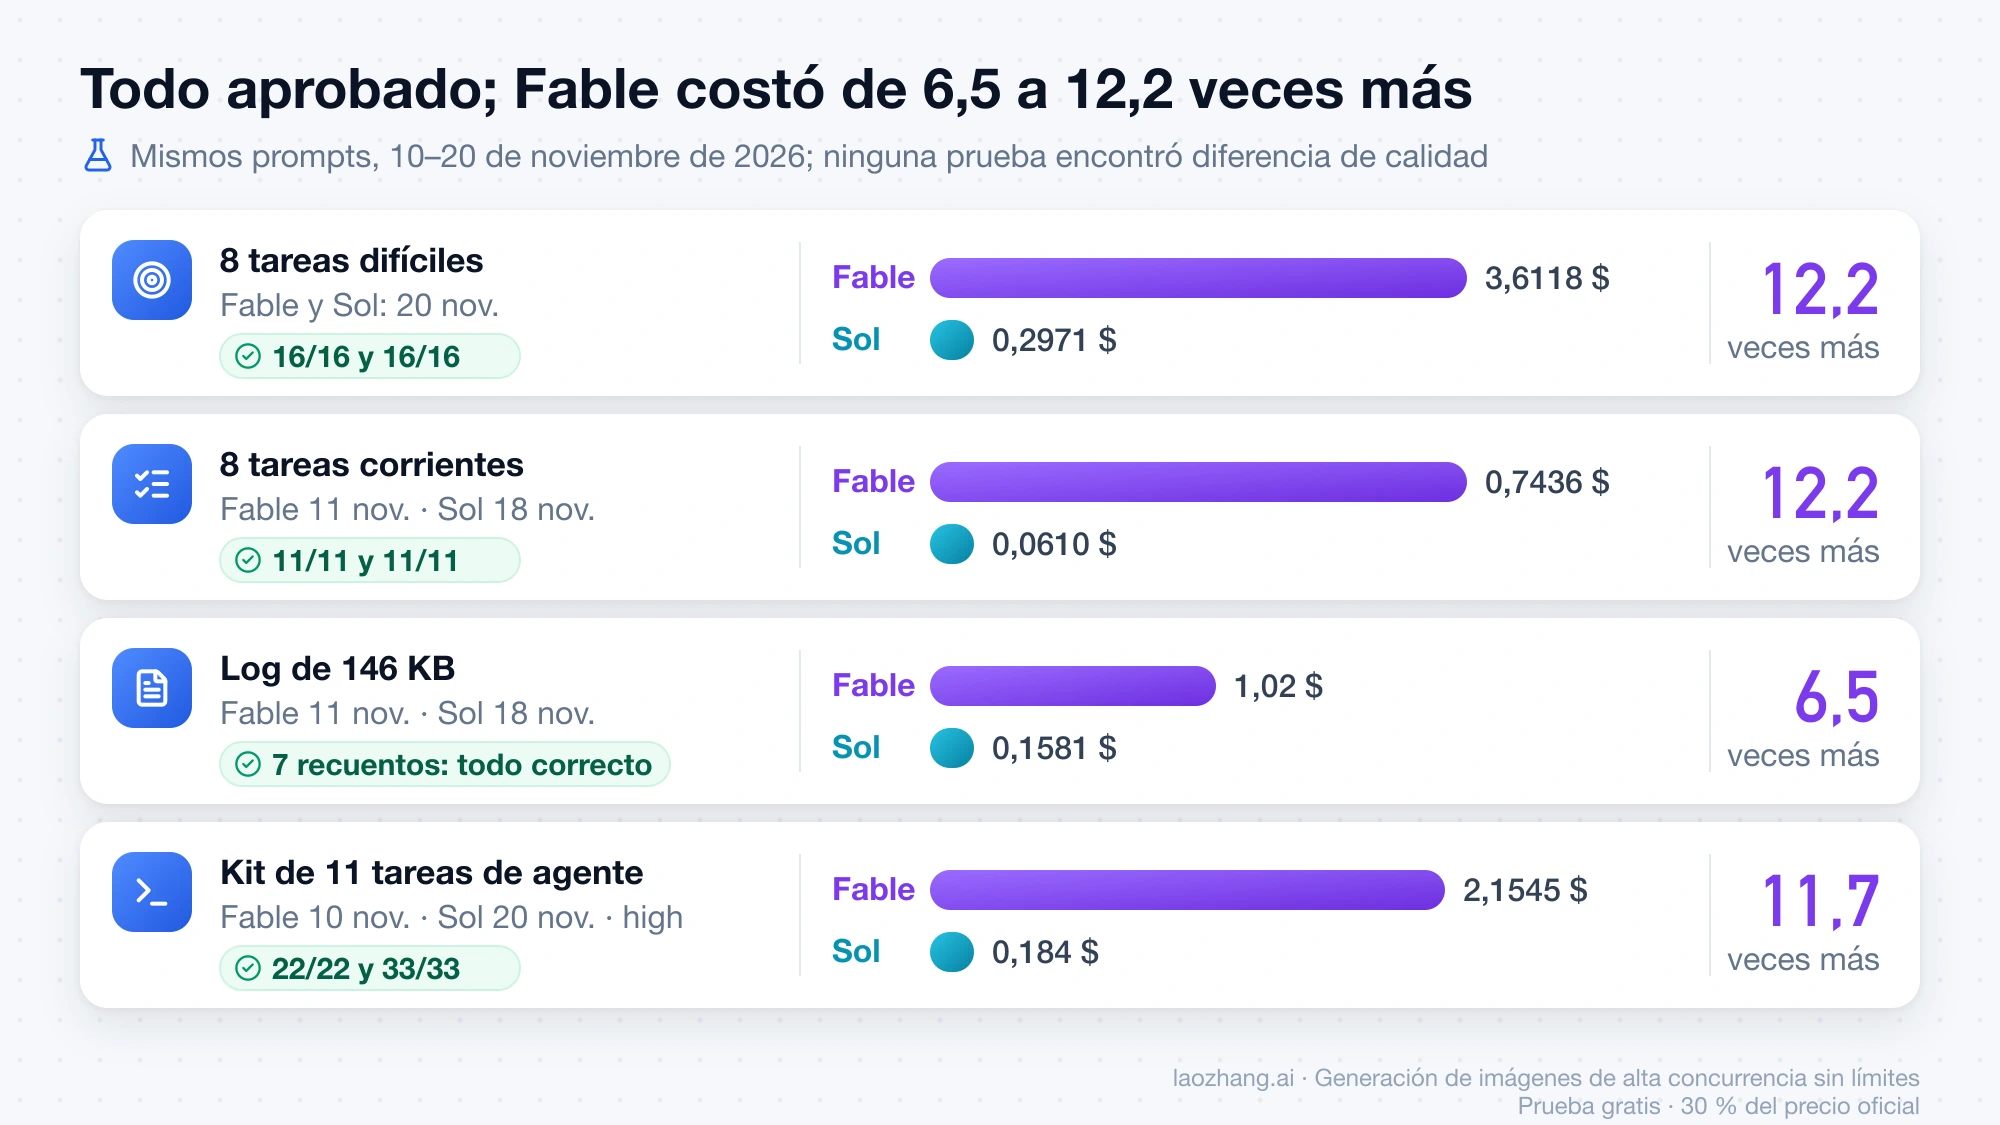
| Prueba (nivel por defecto salvo indicación) | Fecha Fable / Sol | Aprobadas | Fable 5.2 | GPT-6.2 Sol | Fable ÷ Sol (coste · tiempo) |
|---|---|---|---|---|---|
| 8 tareas difíciles, 16 respuestas por modelo | 20 nov. / 20 nov. | 16/16 y 16/16 | 3,6118 $ · 868,4 s | 0,2971 $ · 265,9 s | 12,2 · 3,3 |
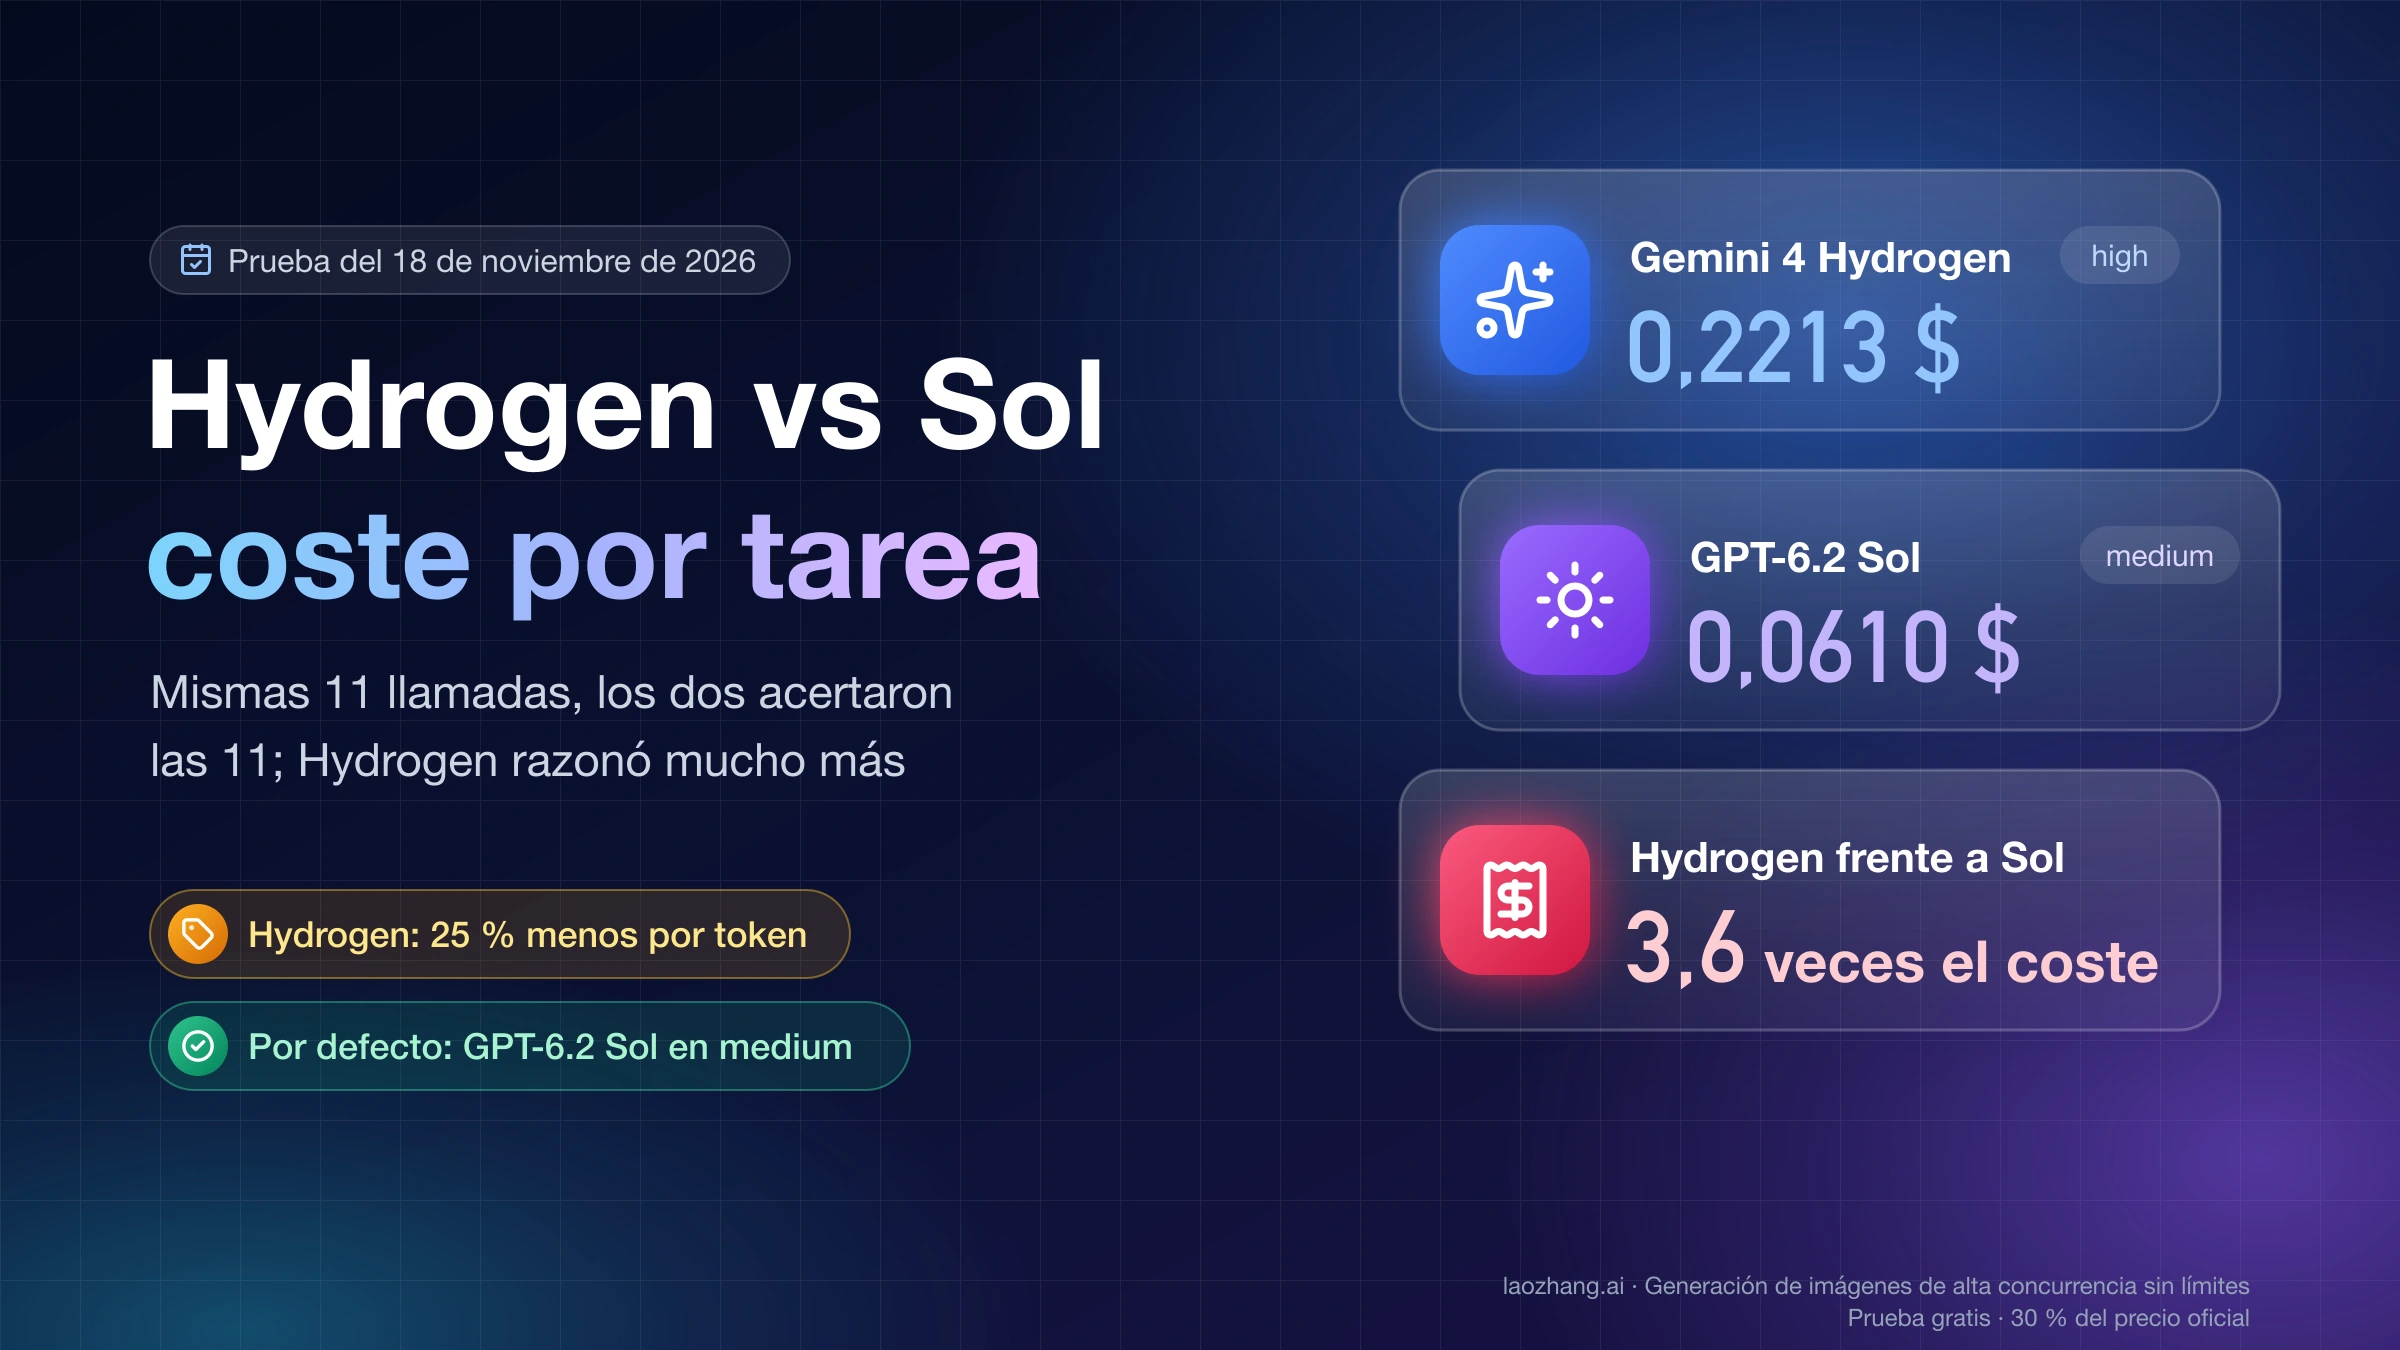
| 8 tareas corrientes, 11 respuestas | 11 nov. / 18 nov. | 11/11 y 11/11 | 0,7436 $ · 173,2 s | 0,0610 $ · 56 s | 12,2 · 3,1 |
| Log de 146 KB con 7 recuentos exactos | 11 nov. / 18 nov. | Todo correcto | 1,02 $ · 73,7 s | 0,1581 $ · 13,6 s | 6,5 · 5,4 |
Kit de 11 tareas de agente en high, Claude Code frente a Codex CLI | 10 nov. / 20 nov. | 22/22 y 33/33 | 2,1545 $ · 221,8 s | 0,184 $ · 195 s | 11,7 · 1,1 |
El conjunto difícil se preparó precisamente para que los modelos pudieran fallar, y es la única de las cuatro pruebas que podía mostrar una diferencia de calidad. El 20 de noviembre de 2026 se congelaron antes de la primera llamada los enunciados y los tests ocultos de 8 tareas: un buscador de huecos de reunión (37 comprobaciones ocultas), un pequeño lenguaje de expresiones enteras con precedencia, menos unario, operadores perezosos y excepciones, un planificador con cambios de horario (huecos, horas ambiguas, el cambio de 30 minutos de Lord Howe y el día que Samoa se saltó en 2011), un comparador de patrones glob con llaves y **, encontrar y corregir dos errores en una caché LRU/TTL de 83 líneas, un plan en JSON con 8 reglas entrelazadas y dos problemas de cálculo sin código con respuesta exacta (6503 y 130,10 $). Cada configuración respondió dos veces a cada tarea, con un solo mensaje, sin prompt de sistema ni herramientas. Fable aprobó 16 de 16 en su nivel por defecto (high) y en medium; Sol, 16 de 16 en medium, high y xhigh.
El detalle por tarea muestra que Sol salió más barato en las 8, entre 9,2 veces (el plan en JSON) y 19,7 veces (el lenguaje de expresiones). Fable usó 1,41 veces más tokens de entrada para los mismos enunciados y 3,13 veces más de salida; por llamada tardó una mediana de 25,8 s frente a 7,3 s de Sol. Subir Sol de medium a xhigh casi cuadruplicó sus tokens de razonamiento (de 14.502 a 55.000) sin cambiar ningún resultado, y aun así Fable en medium (1,7857 $) costó 2,55 veces lo que Sol en xhigh (0,7008 $). Hubo un único ajuste del corrector después de la ejecución, registrado: un test oculto de la tarea glob comprobaba una regla que el enunciado no decía, todas las respuestas de los dos modelos fallaban solo ese test y se excluyó; con él dentro, la tarea queda en 0 de 10 para todas las configuraciones por igual y la comparación no cambia.
Las 8 tareas corrientes y el log repiten el patrón con trabajo más habitual. Lo útil de esas filas es que ni bajando Fable de nivel se acerca: en las 8 tareas corrientes, Fable en low costó 0,4201 $, todavía 6,9 veces lo que Sol en medium, y en el log Fable en medium costó 0,9545 $ frente a 0,1668 $ de Sol en high. El log de 146 KB tampoco llega a los 272.000 tokens de entrada, así que el recargo de contexto largo de Sol no entró en juego.
El kit de agente mide otra cosa: dos modelos dentro de dos herramientas distintas. Sol se ejecutó el 20 de noviembre en Codex CLI 0.166.0 con una suscripción de ChatGPT, tres veces por nivel en un directorio vacío nuevo; Fable, el 10 de noviembre en Claude Code en high, dos veces. Los importes son el equivalente a precio de lista de la API de los tokens usados, no una factura. Fable escribió 3,10 veces más tokens de salida (24.052 frente a 7.755 por ejecución) y costó 11,7 veces más. En Codex el coste de Sol lo domina el contexto (unos 300.000 tokens de entrada por ejecución, cerca del 88 % leídos de caché a 0,10 $), por eso Sol en medium (0,176 $) costó casi lo mismo que en high.
Lo que estas pruebas no cubren es justo donde podría estar la diferencia: sesiones de agente largas, cambios en varios archivos y decisiones con información incompleta. No se probaron Fable en xhigh o max, Sol en max o en modo pro, ni peticiones de más de 272.000 tokens. En X, el usuario kunchenguid escribió el 19 de noviembre, tras un día con proyectos reales, que Astra y Sol «no son un sustituto directo» de Fable 5.2 y Opus 5.5, sobre todo al decidir cuándo preguntar y cuándo seguir; es una impresión personal, no una medición, pero señala el tipo de tarea que conviene probar.
¿Dónde gana Sol a Fable en las gráficas de OpenAI?
En las gráficas del anuncio de GPT-6.2, GPT-6.2 Sol empata con Fable 5.2 en una prueba de agentes y le gana a Fable en high en una de diseño CAD, pero comparando el nivel más alto de cada uno, Fable va por delante en cuatro de las cinco pruebas. Son cifras del fabricante, con el entorno de pruebas y la selección de OpenAI, leídas de las etiquetas de datos de las gráficas del anuncio de GPT-6.2 Astra y GPT-6.2 Sol a 20 de noviembre de 2026, con el coste por tarea entre paréntesis:
| Prueba | Mejor Fable 5.2 | Mejor GPT-6.2 Sol | Cómo leerlo |
|---|---|---|---|
| Agents' Last Exam v1.1 | 72,8 % en max (60,05 $), único punto | 73,0 % en max (1,32 $); 72,0 % en high (0,69 $) | Empate práctico; a Fable le faltan 9 tareas que usaron otro modelo |
| BenchCAD 2.1 Core | 83,5 % en max (50,77 $); high 61,0 % (9,99 $) | 73,1 % en max (1,60 $); high 64,0 % (0,75 $) | Sol supera a Fable en high; Fable en xhigh y max va por delante |
| Terminal-Bench-Science 0.1 | 73,3 % en max (45,21 $); high 70,0 % | 68,0 % en max (2,21 $); medium 63,1 % | Sol en medium supera a Fable en medium (60,5 %); desde high, Fable |
| Vals Science Index v1 | 63,7 % (8,79 $), único punto | 58,5 % (0,71 $), el mejor de cinco | Fable por delante |
| AutomationBench 1.0.6 | 51,4 % en max (4,64 $); high 44,3 % | 41,2 % en high (0,21 $) | Sol en medium iguala a Fable en medium (40,2 %); de ahí arriba, Fable |
Hay salvedades que cambian la lectura. La diferencia de 0,2 puntos en Agents' Last Exam no es una victoria de calidad, y la propia página aclara que el resultado de Fable excluye nueve tareas resueltas con un modelo de respaldo. En Terminal-Bench-Science, Fable lo ejecutó Artificial Analysis con el entorno mini-swe-agent, y Anthropic publica un 74,6 % para Fable en Claude Code en max. Lo que estas gráficas sí muestran sin discusión es el coste: en todas, cualquier nivel de Sol cuesta por tarea una pequeña parte de lo que cuesta Fable en el suyo.
¿Cuál es más rápido? Sol por nivel, no siempre a igual puntuación
Al mismo nombre de nivel, GPT-6.2 Sol es claramente más rápido que Fable 5.2, pero cuando se compara a igual puntuación la ventaja se reduce o se invierte. En Artificial Analysis, a 20 de noviembre de 2026, Sol en high tarda 5,0 minutos por tarea del índice frente a 15,2 de Fable en high, y Sol en medium da la primera respuesta en 3,6 s frente a 11,2 s de Fable en medium. Para igualar a Fable en medium (6,5 minutos), en cambio, Sol necesita xhigh (5,9 minutos, más o menos lo mismo) o max, que tarda 9,6 minutos y 83,9 s hasta el primer token de respuesta. Los minutos de Fable ya cambiaron entre lecturas anteriores de Artificial Analysis, así que tómalos con su fecha.
En las pruebas de un solo turno, Sol en su nivel por defecto terminó entre 3,1 y 5,4 veces antes que Fable en el suyo. En la CLI la diferencia casi desaparece: Sol en high en Codex tardó una mediana de 195 s por ejecución del kit y Fable en Claude Code 221,8 s, porque ahí pesan las órdenes que ejecuta el agente y la herramienta, no solo el modelo.
Qué descarta Fable 5.2 o GPT-6.2 Sol antes de mirar la calidad
Algunas condiciones deciden por sí solas, con independencia de cuál responda mejor. Repásalas antes de montar la prueba con tus tareas, según la documentación de modelos de Claude y la ficha de gpt-6.2-sol en la documentación de OpenAI a 18 de noviembre de 2026:
- Si tu organización de la API de Claude tiene retención de datos cero, Fable 5.2 responde con un error 400 salvo autorización expresa, porque exige retención de 30 días.
- Si tu código fuerza el uso de una herramienta con
tool_choiceenanyotool, Fable 5.2 devuelve 400; tendrías que dejar que el modelo elija o usar Sol. - Si trabajas en ciberseguridad de alto riesgo o en investigación biológica, los clasificadores de Fable 5.2 desvían esas peticiones a un modelo anterior, así que no obtienes Fable aunque lo pagues.
- Si envías PDF como documentos, Fable 5.2 los acepta directamente; GPT-6.2 Sol solo recibe texto e imagen.
- Si tus peticiones pasan de 272.000 tokens de entrada, Sol cobra la petición completa a 4 $ y 15 $ por millón; Fable cobra su millón de contexto a la tarifa normal, aunque sigue saliendo 2 y 2,67 veces más caro por token.
- Si tu integración usa el nivel
none, Sol no lo acepta. El 18 de noviembre de 2026, a través de la pasarela, la petición devolvió 400 con el textoUnsupported value: 'none' is not supported with the 'gpt-6.2-sol' model; el mínimo eslow.
Dos detalles más pesan menos, pero conviene tenerlos presentes. Si llamas a Sol por Chat Completions, reasoning_effort funciona de low a xhigh, y para max necesitas la Responses API; y si dependes de mucha cuota por minuto, Fable 5.2 tiene límites de velocidad más bajos que Opus 5.5 en la API de Claude.
Si la retención de datos o el tool_choice te descartan Fable pero quieres seguir en Claude, la alternativa natural es Opus 5.5; la comparación está en Claude Fable 5.2 vs Opus 5.5: cuál es mejor y con qué effort.
Fable 5.2 y GPT-6.2 Sol en ChatGPT y en los planes de Claude
En las suscripciones, cada modelo tiene una condición que pesa más que su calidad. GPT-6.2 Sol llegó el 17 de noviembre de 2026 a ChatGPT Work y a Codex para los planes Plus, Pro, Enterprise y Edu, y el centro de ayuda de OpenAI aclara que no se añade al chat normal de ChatGPT; OpenAI no publica cuántos mensajes da cada plan con Sol, y el modo Ultrafast solo está en Pro de 200 $ y de 500 $. Claude Fable 5.2 entra en el límite semanal de Max, Ultra y los puestos premium de Team y Enterprise, pero como mucho la mitad de ese límite puede ir a Fable; en Pro y en los puestos estándar de Team se paga con créditos de uso desde el 17 de noviembre, porque la inclusión de la semana de lanzamiento terminó el 16. Así que, con suscripción, la comparación práctica es Codex con Sol frente a Claude Code con Fable, y en Claude Code recuerda que Fable trabaja en medium salvo que cambies el nivel.
Cómo comprobar con tus tareas si Sol puede sustituir a Fable
La forma fiable de decidir es repetir la comparación con tu propio trabajo y dividir el gasto total entre los resultados que aceptarías, no comparar precios por token. Con diez o veinte tareas reales basta para ver hacia dónde se inclina la balanza:
- Elige tareas que ya hayas hecho con Fable y cuyo resultado puedas comprobar: tests que pasan, cifras que cuadran, un documento que revisarías igual. Incluye las más difíciles, porque son las únicas que pueden separar a los dos modelos, y escribe los prompts en el idioma en que trabajas, ya que en español Fable cuenta muchos más tokens.
- Ejecuta cada tarea en Sol en
mediumy enxhigh, y en Fable enmediumy enhigh, cada configuración en una sesión nueva. Indica el nivel de forma explícita en las cuatro, porque el valor por defecto cambia entre la API y Claude Code. Si aún no llamas a Fable por la API, Claude Fable 5.2 API key: cómo usarla con una clave normal explica el acceso y la primera llamada. - Suma todos los intentos, también los fallidos, y divide entre las tareas aprobadas. En la API, toma los tokens del campo de uso de cada respuesta; en Sol, comprueba además si alguna petición pasó de 272.000 tokens de entrada, porque cambia la tarifa de toda la petición.
- Quédate con la configuración más barata que apruebe lo que necesitas. Si Sol en
xhighaprueba lo mismo que Fable enhigh, la diferencia es dinero perdido; si hay un tipo de tarea que solo aprueba Fable, esa es tu regla para mantenerlo, y el resto puede ir a Sol con los fallos reenviados a Fable.
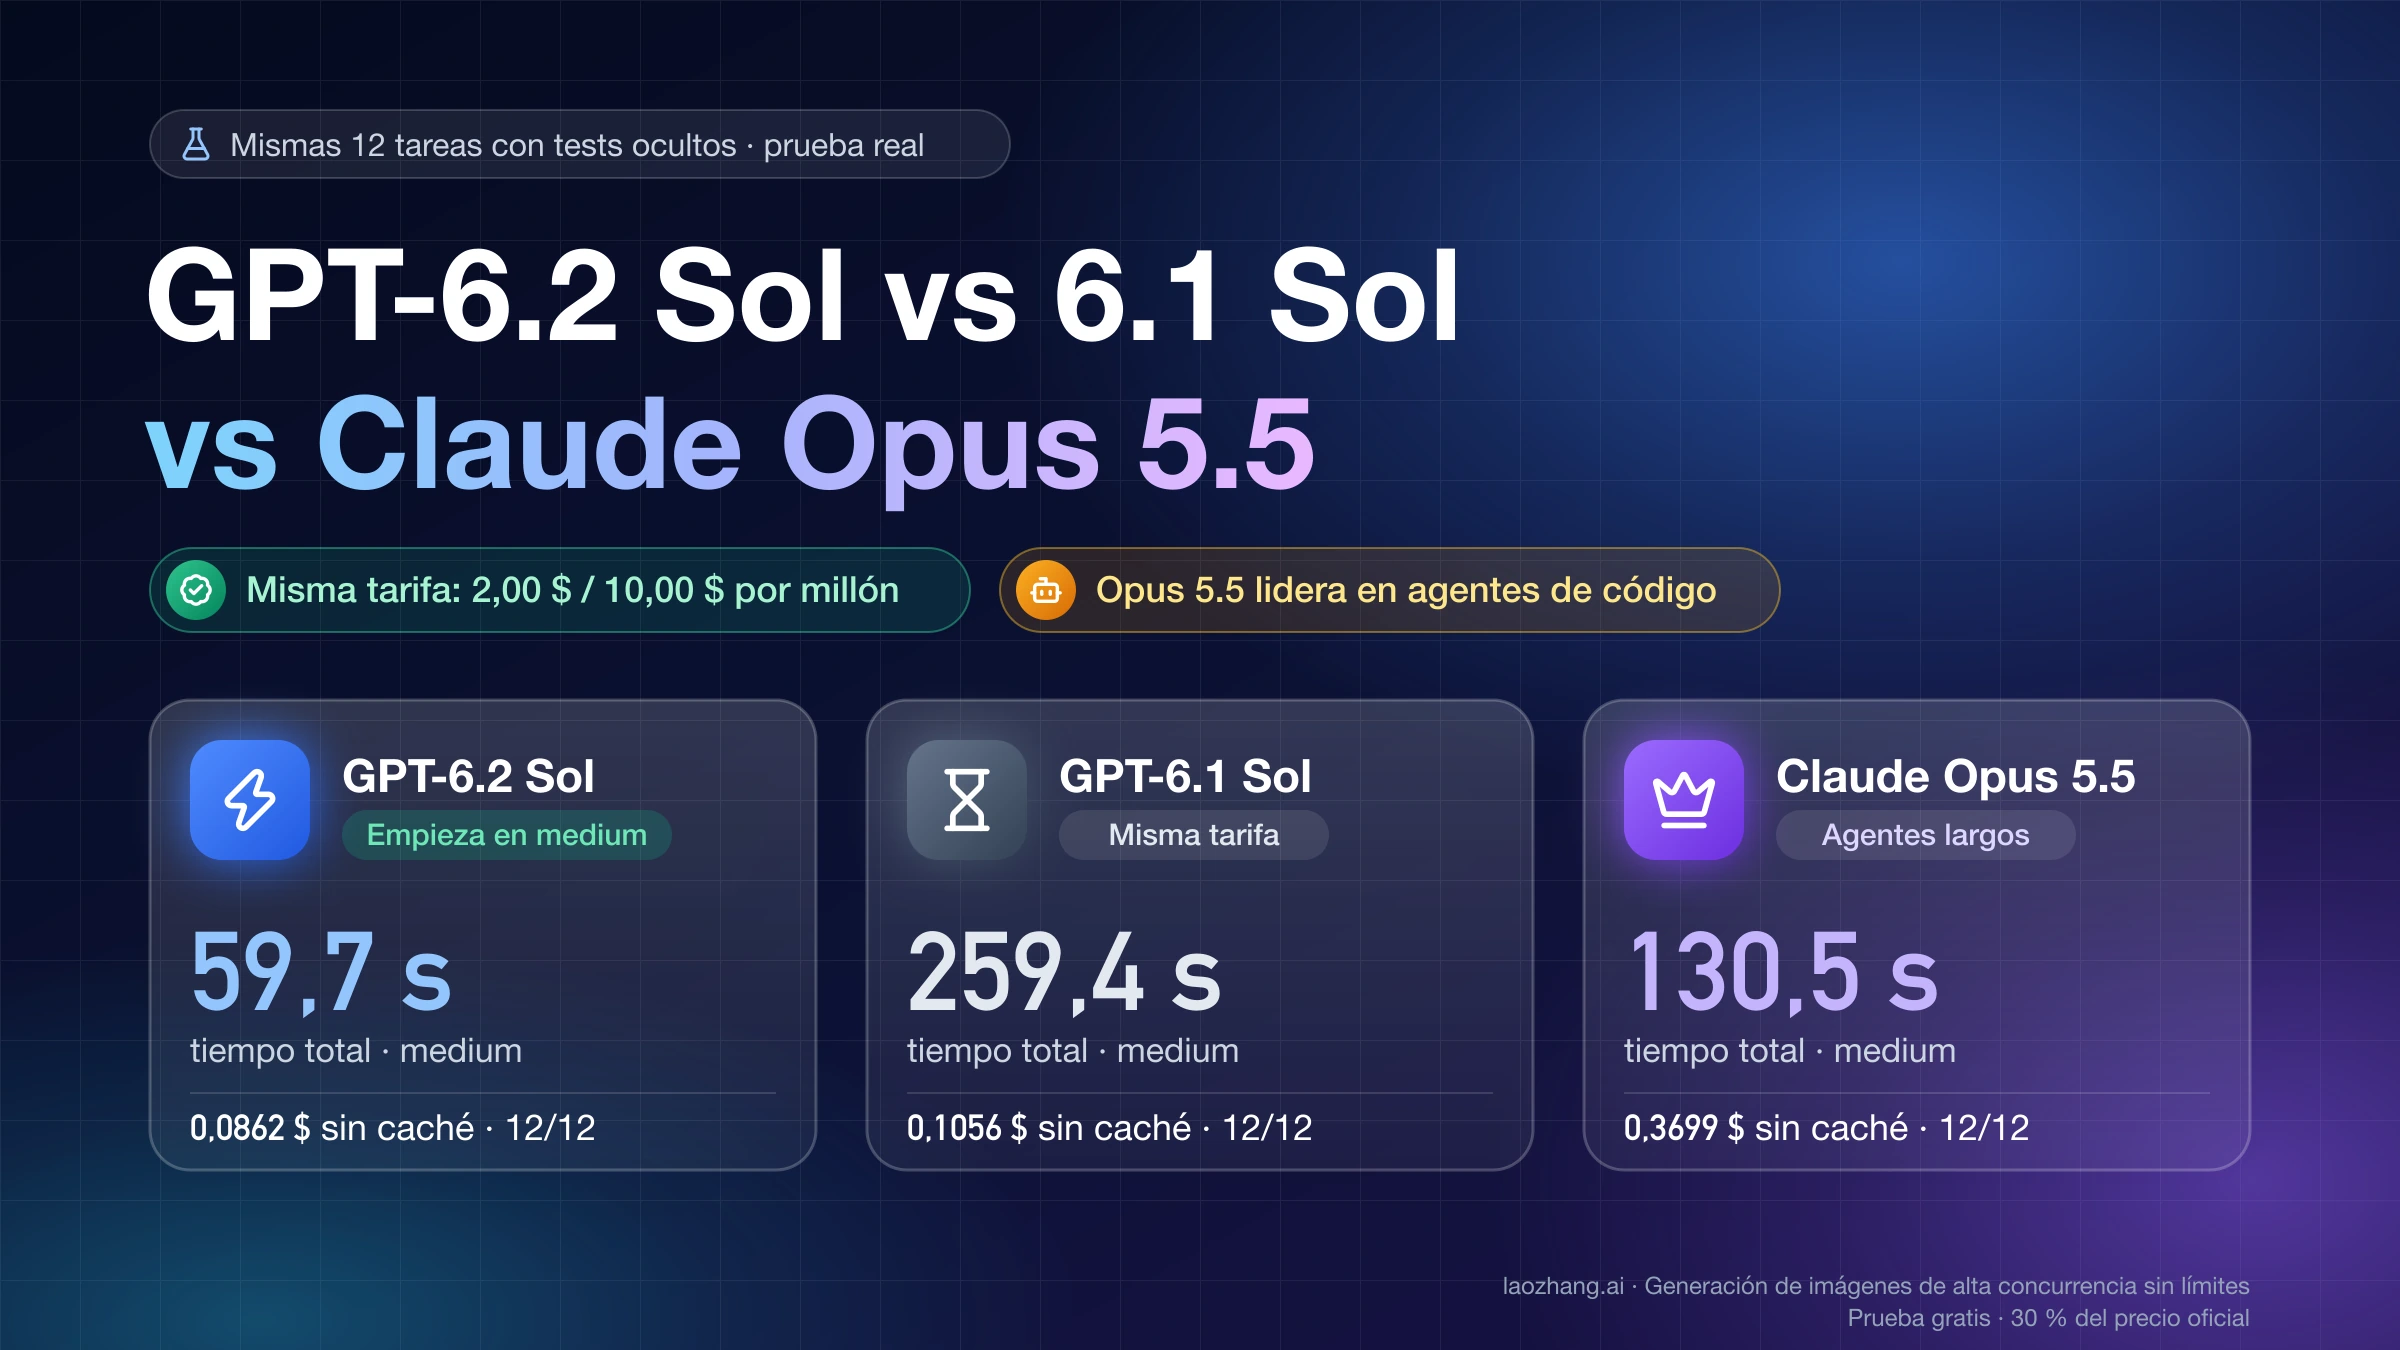
Si también estás mirando el modelo económico de Google, o quieres saber qué cambió en Sol desde la versión 6.1 y cómo queda frente a Opus 5.5, hay dos comparaciones al lado: Gemini 4 Hydrogen vs GPT-6.2 Sol: cuál elegir y coste por tarea y GPT-6.2 Sol vs 6.1 Sol vs Opus 5.5: prueba real y cuál usar.
Preguntas frecuentes sobre Fable 5.2, GPT-6.2 Sol y Sol Pro
¿Qué es GPT-6.2 Sol Pro?
GPT-6.2 Sol Pro no es otro modelo, sino gpt-6.2-sol con reasoning.mode en pro en la Responses API. Según la guía de razonamiento de OpenAI, a 20 de noviembre de 2026, el modo pro hace que el modelo dedique más cálculo a tareas difíciles a cambio de más latencia y más tokens, y es independiente del nivel de effort. La página de GPT-6.2 Sol Pro en OpenRouter lo lista al mismo precio por token que Sol y avisa de que una petición típica cuesta varias veces más y tarda mucho más; OpenAI no tiene una fila de precio aparte para él. Las cifras de Artificial Analysis citadas más arriba son de Sol en modo estándar.
¿GPT-6.2 Astra es mejor que Fable 5.2?
GPT-6.2 Astra, y no Sol, es el modelo que OpenAI enfrenta a Fable 5.2 en su anuncio, y cobra lo mismo que Fable por token, así que entre esos dos la decisión se toma por coste por tarea y no por tarifa. El análisis completo, con el GPT-6 Astra anterior incluido, está en Fable 5.2 vs GPT-6 Astra y GPT-6.2 Astra: precio igual, coste no.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 21 nov 2026.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 21 nov 2026.
- 1.página de precios de la API de OpenAIdevelopers.openai.com/api/docs/pricing
- 2.página de precios de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 3.comparativa de Artificial Analysis entre Claude Fable 5.2 y GPT-6.2 Solartificialanalysis.ai/models/comparisons/claude-fable-5-2-vs-gpt-6-2-sol
- 4.anuncio de GPT-6.2 Astra y GPT-6.2 Solopenai.com/index/introducing-gpt-6-2-astra-sol
- 5.documentación de modelos de Claudeplatform.claude.com/docs/en/about-claude/models/overview
- 6.ficha de gpt-6.2-sol en la documentación de OpenAIdevelopers.openai.com/api/docs/models/gpt-6.2-sol
- 7.guía de razonamiento de OpenAIdevelopers.openai.com/api/docs/guides/reasoning
- 8.página de GPT-6.2 Sol Pro en OpenRouteropenrouter.ai/openai/gpt-6.2-sol-pro