大模型 API 数据保留 vs 零数据保留:上线前怎么核验
标准有限保留是否可用,先看业务允许的用途、期限和保存位置;要求零数据保留时,再核对当前合同及具体组织、端点、模型、功能和日志。ZDR 还可能允许客户受控存储,不能直接等同于整条链路不落盘。
文章目录
大模型 API 的标准保留并非一概不能用;零数据保留(ZDR)也不是给某个品牌贴上标签就能成立。 如果业务允许服务商为明确用途保留内容,且期限、保存位置和访问权限符合内部政策,可以选择有限保留的普通 API。若组织要求服务商不持久保存请求和响应,就需要覆盖当前调用链的 ZDR 证据;若要求任何位置都不能保存内容,还要检查自己的数据库、监控和客户控制的存储。
例如,公开文档摘要可以按已批准的普通保留策略处理;客户工单若允许规定期限内的受控保留,也不必仅因含有内部信息就强制 ZDR。私有源码若受“供应商不得留存内容”的内部政策约束,则必须核验具体组织、端点、模型和功能。数据类别只是判断起点,实际准入条件由业务与安全负责人确定,不能从“机密”或“个人信息”两个词直接得出通用法律结论。
上线前要交付的是一份有值、有证据、能随变更失效的记录,以及一条执行规则:只允许已批准的完整调用链;备用供应商、模型或功能未经批准时拒绝切换。 下文按 2026 年 10 月 6 日核对的官方资料说明边界,并给出可复制的填写模板和纯离线检查示例。
ZDR 是什么,和“不训练”“store=false”有什么区别?
ZDR 是 Zero Data Retention,即零数据保留。在大模型 API 场景里,它通常描述供应商对请求和响应内容的特定保留控制,适用范围由合同、账户设置以及端点和功能资格共同决定。
三种承诺回答的是不同问题:
| 承诺或设置 | 能回答什么 | 仍需要核验什么 |
|---|---|---|
| 不用于训练 | 内容是否用于改进或训练模型 | 风控、故障排查、应用状态、文件和日志是否保存 |
store=false | 某个请求是否保存对应应用对象或产品日志 | 滥用监控、其他功能、网关和本方日志 |
| 已批准的 ZDR | 合同和配置所覆盖的内容保留范围 | 是否适用于当前组织、模型、端点、功能,以及例外和下游 |
例如,OpenAI 数据控制文档说明,API 数据默认不用于训练,普通滥用监控日志仍可能包含客户内容,通常最多保留 30 天,特定法律或安全情形可延长。获批 ZDR 会排除这些日志中的客户内容,并把 Responses、Chat Completions 的 store 视为 false,但不代表所有端点均具备资格。
因此,“付费”“加密”“不训练”和请求成功都不是完整的准入证明。应分别问:谁保存什么、保存在哪、最长多久、谁能访问、什么情况下例外、当前账号是否真的受该控制覆盖?
先决定普通保留是否足够,再选择 ZDR
先写清楚业务条件,能避免两种浪费:把所有公开数据都按最严格条件采购,或先接入便宜的模型后才发现敏感流量无法使用。
| 业务已经批准的条件 | 可以采用的路径 | 需要取得的证据 |
|---|---|---|
| 允许供应商按限定用途、有限期限保留内容 | 标准有限保留 | 训练用途、最长窗口及例外、功能存储、合同和本方日志均符合条件 |
| 不允许供应商持久保留内容,但允许客户在自己控制的存储中保存 | 核验具体 ZDR 方案;单列客户存储 | 供应商内容留存控制,客户存储期限、权限和密钥管理边界 |
| 不允许调用链中任何位置持久保存内容 | 仅选择满足该严格条件的调用链 | 除供应商外,还须排除客户内容存储、APM 请求体、队列持久化和工具保存 |
| 保存位置、期限或实际备用路径尚不明确 | 先使用合成数据验证流程 | 补齐证据后再按业务条件批准真实数据 |
“最长保留 30 天”还需要回答为何保存、从何时起算、是否存在延长期限或另一个更长的功能窗口。如果企业只允许 7 天,30 天普通策略就不满足;如果允许 30 天,但启用了永久保存的数据集,也不能按 30 天放行。可以关闭超范围功能、缩减输入或改用另一条已获批路径,而不是只剩“全部发送”与“全部禁止”两个选项。
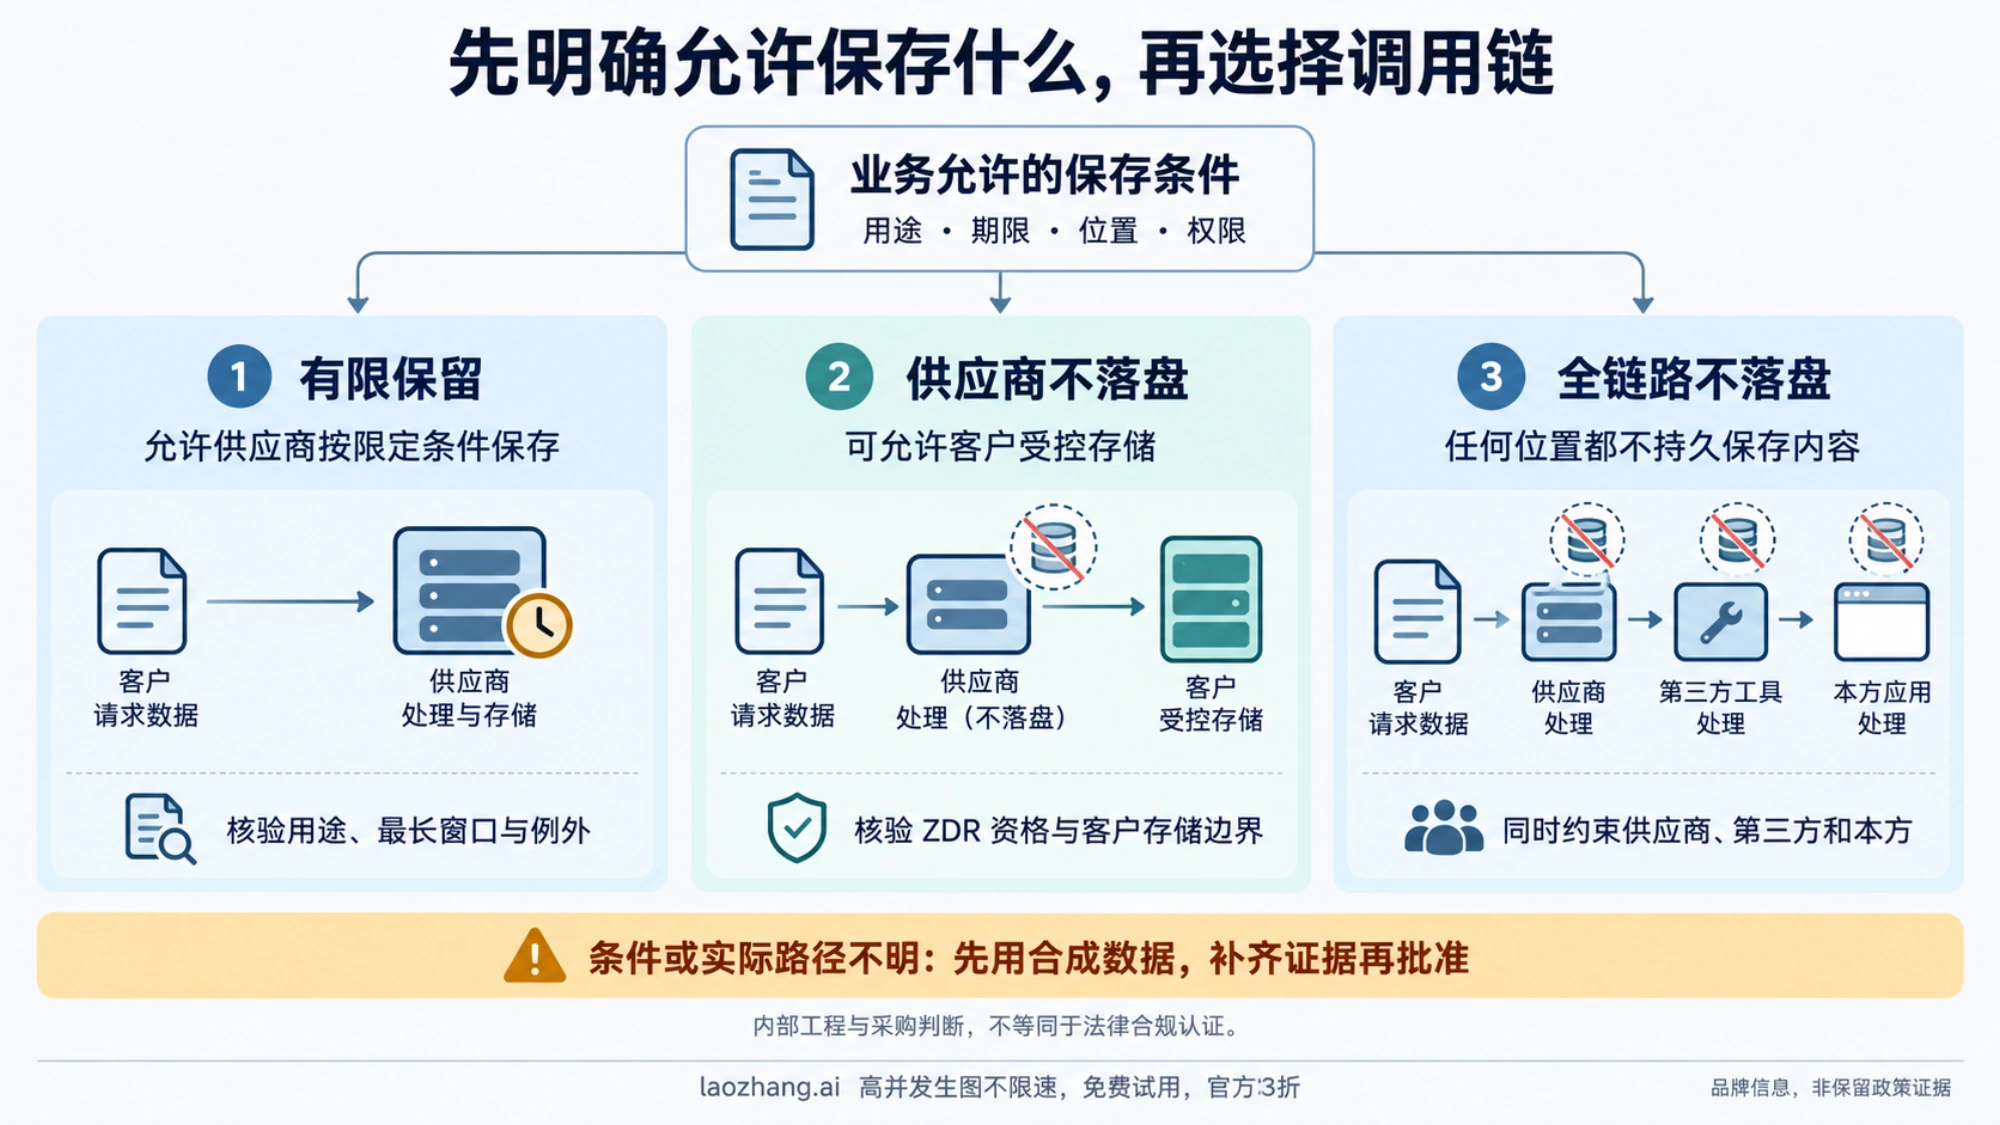
这里的批准是组织内部的工程和采购判断,不等同于法律合规认证。涉及个人信息、跨境或行业要求时,应把相应合同和处理链交给负责人员评审。
同一个品牌,不同产品和功能会改变结论
比较时不要只填“OpenAI / Claude / Google / AWS”。至少要定位到服务提供主体、产品入口、组织或项目、实际端点、模型及区域。下面的区别直接影响能否选择某条调用链。
OpenAI:普通保留、ZDR 与 PSP 要分开
OpenAI 的 ZDR、Modified Abuse Monitoring 需要批准,并有组织与项目层的配置。项目可以继承,也可以覆盖组织控制,不能只看组织截图。当前端点表中,Files、Conversations、Threads、vector stores、batch 等不能沿用普通生成端点的 ZDR 结论;Responses 的 background、音频输出、托管容器和缓存也要按实际选项核验。第三方 MCP 或网络工具另有保留政策,图像与文件还存在安全审查例外。
尤其要区分 ZDR with Private Safety Processing(PSP) 与 Private Retention with PSP。前者会把选定交互的双重加密记录及详细安全结果保存在客户控制的云存储中,期限为 30 天;OpenAI 保留运行索引和有限安全信号等信息。后者的加密内容位于 OpenAI 管理的存储中。PSP 官方架构说明了这些位置和控制边界。
所以,允许客户受控保存、禁止供应商保存内容的政策,和“任何位置都不得落盘”的政策,可能对同一个 PSP 方案给出不同结果。记录中要写客户存储、期限、访问和密钥授权;撤销密钥权限不等于删除已保存记录,也不撤销已完成的处理。
Claude:组织获批后,也要自己拦住不合格功能
Claude API 保留文档按组织、模型与功能限定 ZDR。新组织不会自动继承;当前部分模型有 30 天保留要求,除非 Anthropic 明确授权。为了使用某个模型把工作区改成 30 天保留,相当于退出该工作区的 ZDR 条件。
更容易漏掉的是:标为不支持 ZDR 的功能,未必会被 API 拒绝。 Files、batch、代码执行和有状态 Agent 等仍可按各自策略保存,调用成功不能作为准入信号。应用应在发送前核对已批准功能。
合格功能也有细节:结构化输出或 strict 模式中的 schema 可在最后使用后保留最多 24 小时,不宜在字段名、枚举或常量中放客户姓名等敏感实体;提示缓存和缓存诊断有各自技术数据边界。法律及安全例外也需保留在评审记录中。
普通保留不要写成全 Claude 统一的“默认 0 天”或“默认 7 天”。商业数据保留说明给出 API 后端通常在 30 天内删除输入输出的窗口,并列出合同、功能与安全等例外;功能文档则区分无需存储的对话、模型及持久化功能。最大删除窗口不等于每次请求都会完整保存那么久,应按实际合同、模型和功能确认。
Gemini Developer API 与 Vertex / Google Cloud 分别核验
Gemini Developer API 当前 ZDR 指南已明确:需要有保证的 ZDR 或企业 DPA 时,使用 Vertex AI。付费 Developer API 不将输入输出用于产品改进,不能据此承诺已获得 ZDR。Developer 的 Google Search / Maps grounding 保留窗口为 30 天且不能关闭;Interactions 默认保存状态,Live 会话恢复、Files 和显式缓存也有独立期限。
还有一层是项目日志与数据集:Generate Content 默认不保存产品日志,Interactions 默认保存,项目或请求设置可改变行为。启用日志后的默认窗口为 55 天,可选 7、14、28、55 天;保存进数据集后不会自动到期。不要把这些窗口当成所有请求的滥用日志期限。
转到 Vertex / Google Cloud 也不能自动给所有功能盖章。对应 Cloud 平台的零保留文档说明,适用 Google 模型的滥用日志可申请例外,但 Advanced AI 模型或功能可能受额外安全条件限制,需要账号级确认。该 Cloud 路径的 Google Search grounding 派生查询与上下文最长保留 3 天,Maps 为 30 天;这与 Developer 的 Search 30 天不同。Interactions、开启后的请求响应日志和有状态 Agent 仍要另列;文档把特定内存缓存视为 ZDR 兼容,也不等于政策要求的“任何技术数据都不存在”。
Azure:看销售主体、资源和实际配置值
Microsoft Foundry 数据隐私说明覆盖由 Azure 销售的模型路径,不能直接套用于同名平台上的所有提供商安排。获批修改后滥用监控的资源,可用 ContentLogging=false 作为内容日志已关闭的配置信号;该字段缺失不能当成 false。
有状态 Responses、Threads、Files 等仍可能保存于客户 Azure 资源。自动安全检查、资源诊断日志以及 Global / DataZone 的处理位置,也要和静态存储地区分别核对。一个 ContentLogging=false 不证明全部应用日志为零。
Bedrock:保留模式、模型允许值与区域必须一致
Bedrock 当前数据保留规则区分 none、aws_review 等模式。none 不进行持久存储或向模型提供商共享内容;在相应 Responses 路径中,store=true 会被拒绝,也不能使用 background。普通模式里的 store=false 只说明响应不可检索,不能当成 ZDR。
适用 mantle 路径按项目、区域账户、模型默认值的顺序,取第一个非 inherit 的保留设置;runtime 路径没有同样的项目概念。模型的 allowed_modes、获批例外及跨区域目的地都应写入记录。数据保护说明中“模型提供商无法访问”也不等于 AWS 或客户账户完全不保存。
若目标模型不允许 none,选择已批准的其他模型、取得明确例外或停止该流量。不要把启用 aws_review 当成 ZDR 工作负载的例行修复;那会改变原先批准的保留条件。
网关:推理路由过滤不能覆盖整个处理链
OpenRouter 的 ZDR 控制可在账户、模型组、guardrail 或请求层限制推理端点。但工具和插件不自动继承;BYOK 或 Private Deployment 的部分声明属于客户自我确认,不是独立核验。网关本身的日志、实际上游、备用端点和第三方工具仍需分别查证。
对任何聚合服务,都要取得同样的证据。本轮没有覆盖 laozhang.ai 必须 ZDR 工作负载的当前合同和完整处理链证明,因此不把它推荐为这类数据的入口。价格低、模型同名或兼容 OpenAI 请求格式,都不能替代保留条件。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
填一份能在变更时使用的上线证据单
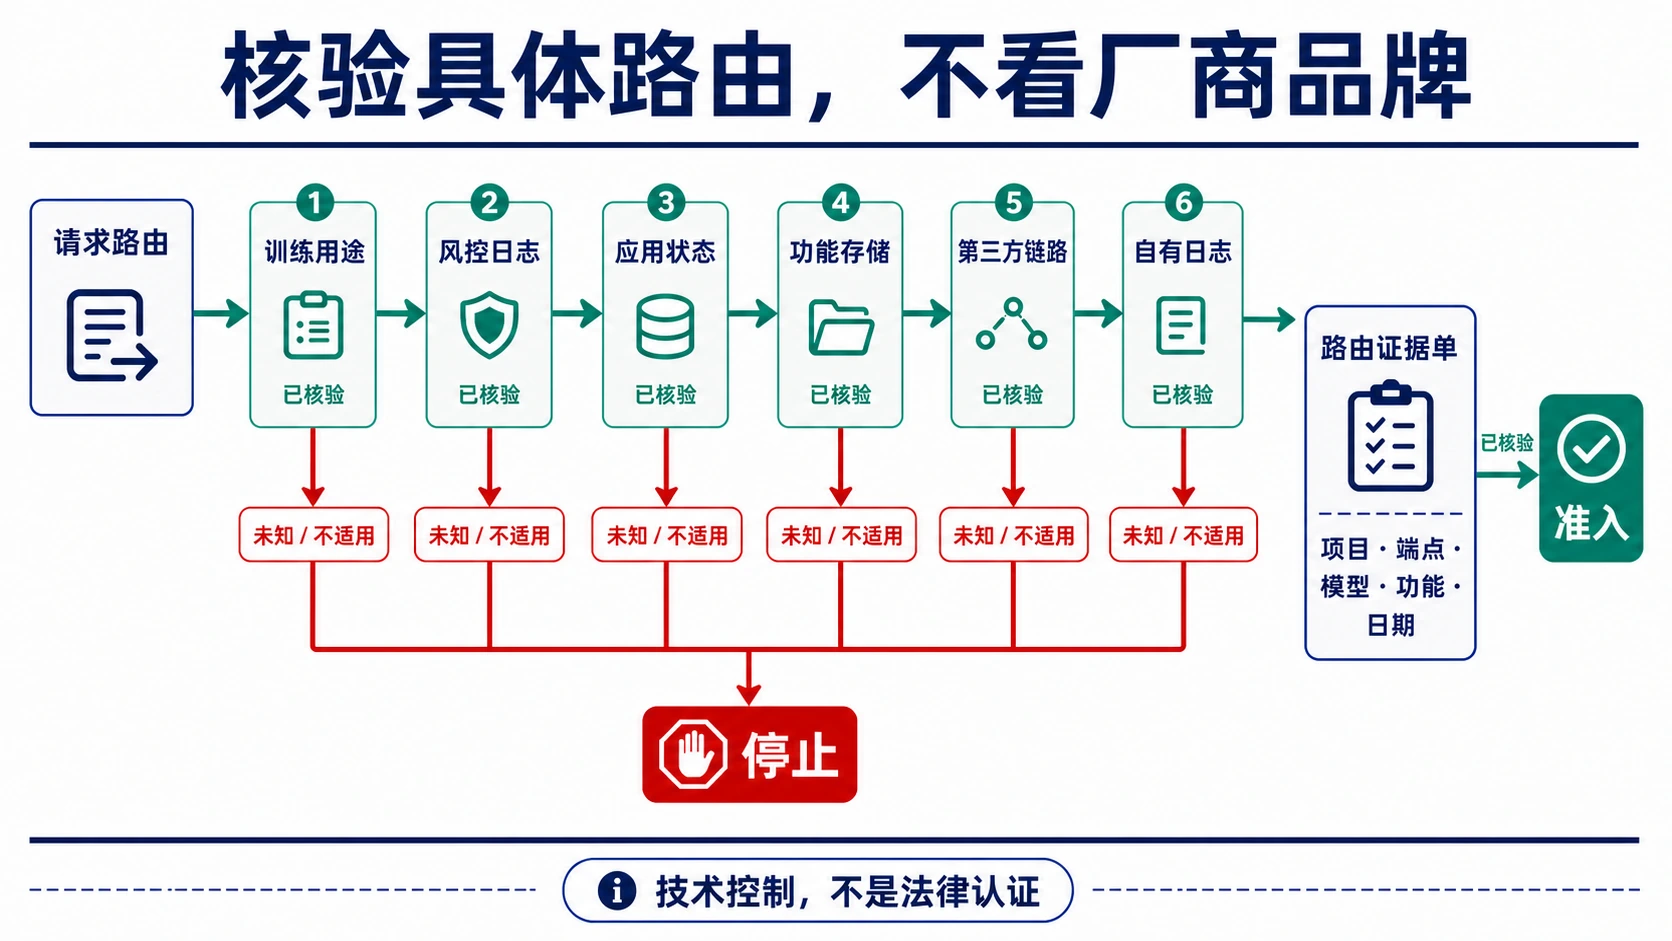
可以从六个方面整理证据:训练用途、风控日志、供应商应用状态、功能存储、第三方处理、本方日志。它们是整理证据的方法,不是认证标准,也不是六个依次经过的服务器。
复制下面的模板,每一行填写实际值。供应商网页证明产品政策;合同、批准记录和配置证明你的使用范围;两者缺一项,就保留为未知。
工作负载 / 业务负责人 / 安全负责人:
允许的数据 / 禁止发送的字段:
政策:有限保留 / 供应商不落盘且允许客户存储 / 全链路不落盘
允许的最长期限、用途、位置及例外:

服务提供主体 / 合同版本 / 组织批准编号:
产品入口与 API base URL:
组织 / 项目 / 云账号 / 工作区:
端点 / 完整模型 ID / 区域 / 跨区域目的地:
功能及实际参数:store、background、search、files、cache、tools……
主路径与每条备用路径:网关 → 上游 → 下游工具

训练用途:值;来源;适用范围
风控日志:内容或元数据;最长期限;例外;配置证据
应用状态:对象;是否保存;删除或到期规则
功能存储:逐功能的内容、期限、资格
第三方:处理者;用途;条款;日志
本方保存:APM、错误追踪、队列、数据库、备份、客户安全存储
本方访问与清理:负责人;权限;期限;实际核验记录

未解决项 / 批准的数据范围 / 禁止的备用路径:
核验日期 / 到期复核日 / 批准人:
触发失效的变更:账户、模型、区域、功能、合同、日志或备用路径
填写时避免只写“已检查”。例如,“生产项目继承 ZDR”需要附具体项目与有效配置;“无日志”需要说明禁用的是哪种内容采集,哪些运行元数据仍存在;“30 天”需要指明是风控、Files、项目日志还是客户安全存储。保存期限与证据复核日期是两个不同字段。
有现成资料时,最短核验顺序是:
- 业务负责人给出允许的保留条件和输入字段,工程人员画出主路径及备用路径。
- 核对当前官方资格与合同,把组织、模型、端点、区域和功能逐一匹配。
- 读取获准查看的实际配置,记录值和范围;没有账号或权限就标未知,不能用文档替代。
- 用合成内容验证应用是否按记录发起调用、是否采集请求体、是否能拒绝越界备用路径。实际平台检查应另行获得授权。
- 只批准证据覆盖的组合,并把记录绑定到发布变更。
离线检查示例:允许原路径,拒绝未批准的 fallback
下面是一个自定的部署检查示例,用于发现配置变更,不验证供应商删除行为,也不代表任何真实账号已经获批。它只使用 Python 标准库读取本地 JSON;示例身份、合同编号和域名均为合成值,不调用模型、管理 API 或云平台。
先把证据单中已批准的组合整理为 approval.json。本例选择“供应商不落盘,但允许客户受控保存”,故客户 30 天存储不会自动导致拒绝;它不是某个 PSP 账号的配置教程。
{
  "policy": "provider_zdr_customer_storage_allowed",
  "valid_until": "2026-10-20",
  "max_customer_days": 30,
  "evidence": {
    "contract": "SYNTHETIC-CONTRACT-01",
    "account_scope": "SYNTHETIC-APPROVAL-01",
    "configuration": "synthetic-config-snapshot",
    "features": "synthetic-feature-review",
    "downstream_and_logs": "synthetic-chain-review"
  },
  "unresolved": [],
  "routes": [{
    "url": "https://example.invalid/v1",
    "organization": "org-demo",
    "project": "project-demo",
    "endpoint": "/responses",
    "model": "approved-model-demo",
    "regions": ["region-demo"],
    "retention_mode": "approved-mode-demo",
    "features": [],
    "parameters": {"store": false, "background": false},
    "processors": ["example-provider"],
    "logs": {"capture_body": false, "customer_days": 30},
    "provider_zdr_verified": true,
    "max_provider_days": 0
  }]
}
再把本次部署计划写入 deployment.json,格式为 {"routes": [...]};数组同时列主路径与全部备用路径。首次演示可复制上述 routes 内容。列表顺序按一致约定填写;示例采用完整对象相等,字段变化或遗漏都会拒绝,避免自动补出未经批准的默认值。
将以下代码保存为 check_retention.py,在放有两个 JSON 的目录运行 python3 check_retention.py:
import json
from datetime import date
from pathlib import Path


def check(approval, deployment, today):
    policies = {
        "bounded_retention",
        "provider_zdr_customer_storage_allowed",
        "no_content_at_rest",
    }
    policy = approval.get("policy")
    if policy not in policies:
        raise ValueError("未知保留政策")
    if date.fromisoformat(approval["valid_until"]) < today:
        raise ValueError("批准记录已过期")
    required = {
        "contract", "account_scope", "configuration",
        "features", "downstream_and_logs",
    }
    evidence = approval.get("evidence", {})
    if any(not evidence.get(key) for key in required):
        raise ValueError("缺少适用证据")
    if "unresolved" not in approval or approval["unresolved"]:
        raise ValueError("存在未解决项或缺少核验状态")
    routes = deployment.get("routes")
    if not isinstance(routes, list) or not routes:
        raise ValueError("未列出实际主路径和备用路径")
    for route in routes:
        if route not in approval.get("routes", []):
            raise ValueError("主路径或备用路径超出批准组合")
        provider_days = route["max_provider_days"]
        customer_days = route["logs"]["customer_days"]
        if any(type(days) is not int or days < 0
               for days in (provider_days, customer_days)):
            raise ValueError("保留期限必须是非负整数")
        if route["logs"]["capture_body"] is not False:
            raise ValueError("发现未经允许的请求体日志")
        if policy == "bounded_retention":
            if provider_days > approval["max_provider_days"]:
                raise ValueError("供应商保留期限超出政策")
        elif route["provider_zdr_verified"] is not True or provider_days != 0:
            raise ValueError("要求 ZDR 的路径未满足供应商条件")
        customer_limit = approval["max_customer_days"]
        if policy == "no_content_at_rest":
            customer_limit = 0
        if customer_days > customer_limit:
            raise ValueError("客户内容保存期限超出政策")
    return "通过:本次配置属于已批准组合"


if __name__ == "__main__":
    try:
        approval = json.loads(Path("approval.json").read_text())
        deployment = json.loads(Path("deployment.json").read_text())
        print(check(approval, deployment, date.today()))
    except (ValueError, KeyError, TypeError, OSError) as error:
        raise SystemExit("拒绝:" + str(error))
bounded_retention 还需在批准文件填写 max_provider_days;max_customer_days 是所有本方内容保存的已核验最长窗口,不能只填写 APM 而遗漏数据库、备份或客户安全存储。示例统一禁止请求体日志,是本例的自主政策;允许受控内容日志的业务应由负责人另外定义,而非悄悄放宽这个检查。
本地合成检查应至少区分这些结果:
| 变更 | 示例结果 | 原因 |
|---|---|---|
| 使用原组合,无未解决项,证据未过期 | 通过 | 与已批准组合一致 |
| 新增另一供应商作为 fallback | 拒绝 | 备用路径不在批准列表 |
| 打开 Files、search 或换模型 ID | 拒绝 | 已核验范围发生变化 |
| 将政策改为全链路不落盘,仍保留客户内容 30 天 | 拒绝 | 客户存储也超出新政策 |
| 有限保留上限 30 天,已批准组合也是 30 天 | 通过 | 不要求供应商 ZDR,条件一致 |
| 缺证据、记录过期或内容日志开启 | 拒绝 | 无法满足本例的批准条件 |
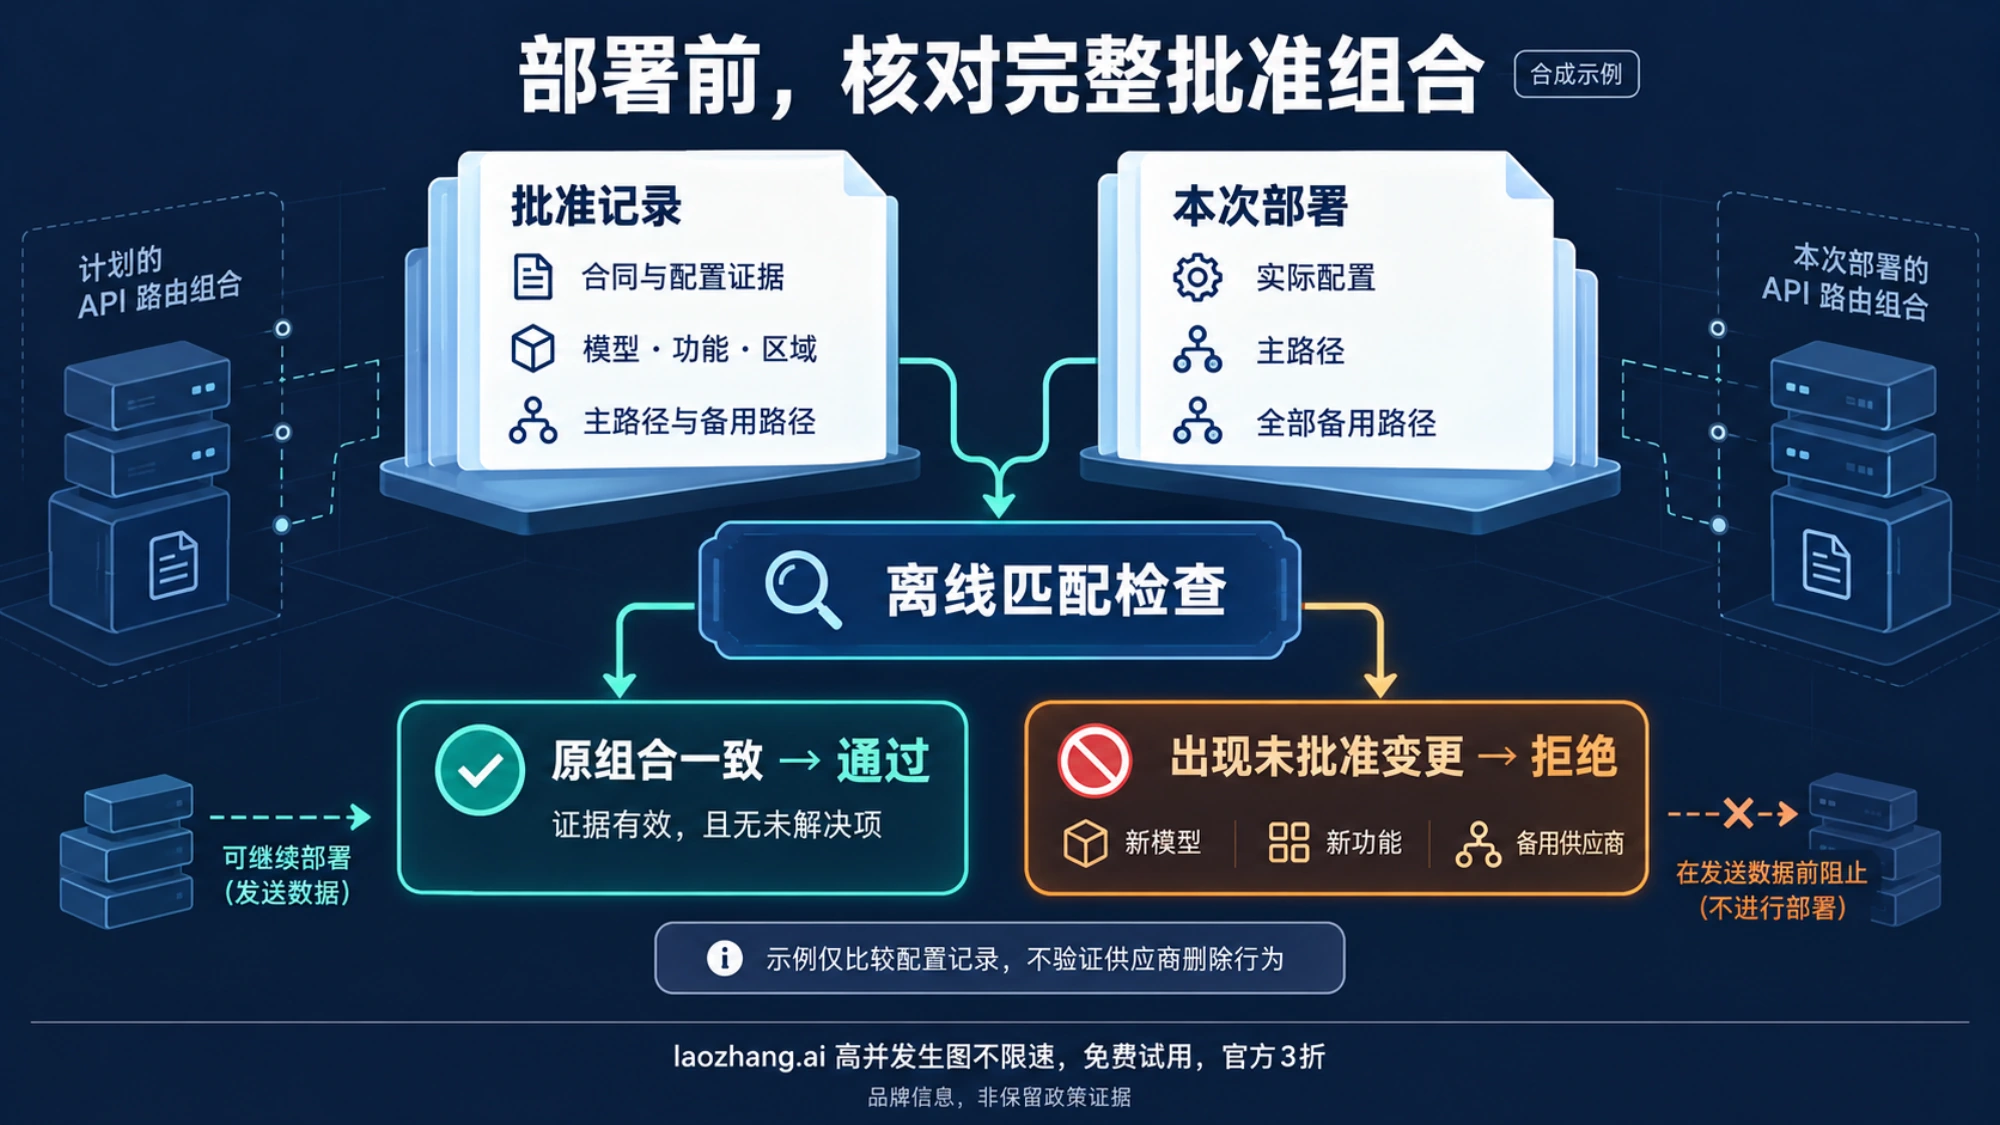
这些是离线配置判断,不是请求成功率、性能或真实删除测试。代码只能比较你输入的记录;还要确保运行时读取同一份配置,禁止自由添加 fallback,并用无敏感内容的记录标明实际所选组合。对 Claude 等可能接受不合格功能的 API,发送前的应用限制尤其重要。
哪些变化必须重新核验?
换模型、换项目或开新功能,应先让旧批准失效,再审查新组合。把变更限定在实际影响项:
- 服务主体、合同、API 地址、网关、组织、项目或工作区改变;
- 端点、模型、保留模式、区域或跨区域目的地改变;
- 开启搜索、Files、batch、缓存、会话恢复、Agent、MCP 或代码执行;
- 增加日志采集、数据集、队列、数据库、备份或处理者;
- 主路径、重试、备用供应商或灾备路径改变;
- 输入字段或允许处理的数据范围扩大,官方资格或合同条件变化。
只改显示名称、且底层组合未变,可以由现有变更流程确认;不要为了每次部署重填全部资料。相反,模型不可用时自动切到普通保留模式,是实质变化,必须挡在真实数据发送前。
常见问题
API 数据不用于训练,为什么还要检查保留?
不训练限制的是用途,保留限制的是生命周期。以 OpenAI API为例,普通滥用监控仍可能保存客户内容;Files、会话或工具还有独立状态。只有把这些位置与自己的日志一起核对,才能判断是否符合业务允许的期限。
标准保留 30 天,一定不能处理客户资料吗?
不能一概而论。如果组织允许对应用途、保存位置、访问控制和最长窗口,标准有限保留可能满足需求;如果政策禁止供应商保存,或功能实际保存更久,就不能按“30 天”直接放行。是否满足法律及行业要求需要专项评审,本文模板不作该认证。
ZDR 会关闭我自己的日志和客户存储吗?
不会自动关闭。APM、错误追踪、数据库和备份都由自己的配置决定;OpenAI ZDR with PSP还可能在客户控制的存储中保存加密记录 30 天。是否允许这种保存,应在业务政策中明确。
获批 ZDR 后,调用成功就表示功能合格吗?
不表示。Claude 功能文档明确存在不具备 ZDR 资格、但仍可调用并按功能策略保留的功能。应用应核对当前模型与功能名单,不把 HTTP 成功响应当成合格证明。
选择结果应落到具体值:普通保留就记录用途与最长期限;要求 ZDR 就记录当前批准范围及例外;要求全链路不落盘,就同时约束供应商、第三方和客户内容保存。证据单负责说明为什么可以发送,部署和运行时限制负责确保实际发送没有越界。
参考来源11
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月6日。
参考来源11
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月6日。
- 1.OpenAI 数据控制文档developers.openai.com/api/docs/guides/your-data
- 2.PSP 官方架构developers.openai.com/api/docs/guides/private-safety-processing
- 3.Claude API 保留文档platform.claude.com/docs/en/manage-claude/api-and-data-retention
- 4.商业数据保留说明privacy.claude.com/en/articles/7996866-how-long-do-you-store-my-organization-s-data
- 5.Gemini Developer API 当前 ZDR 指南ai.google.dev/gemini-api/docs/zdr
- 6.项目日志与数据集ai.google.dev/gemini-api/docs/logs-datasets
- 7.对应 Cloud 平台的零保留文档docs.cloud.google.com/gemini-enterprise-agent-platform/resources/zero-data-retention
- 8.Microsoft Foundry 数据隐私说明learn.microsoft.com/en-us/azure/foundry/responsible-ai/openai/data-privacy
- 9.Bedrock 当前数据保留规则docs.aws.amazon.com/bedrock/latest/userguide/data-retention.html
- 10.数据保护说明docs.aws.amazon.com/bedrock/latest/userguide/data-protection.html
- 11.OpenRouter 的 ZDR 控制openrouter.ai/docs/guides/features/zdr