Realtime API 与转录管道成本怎么比:按同一任务算完整预算
只交付文字时,先算转写和必要的后处理;需要语音回应时,再比较 Realtime、GPTLive 与 STT→LLM→TTS 的完整费用。通话分钟、双方音频分钟和会话活跃秒数不能混用,便宜与否要落到完成同一任务的总成本上。
文章目录
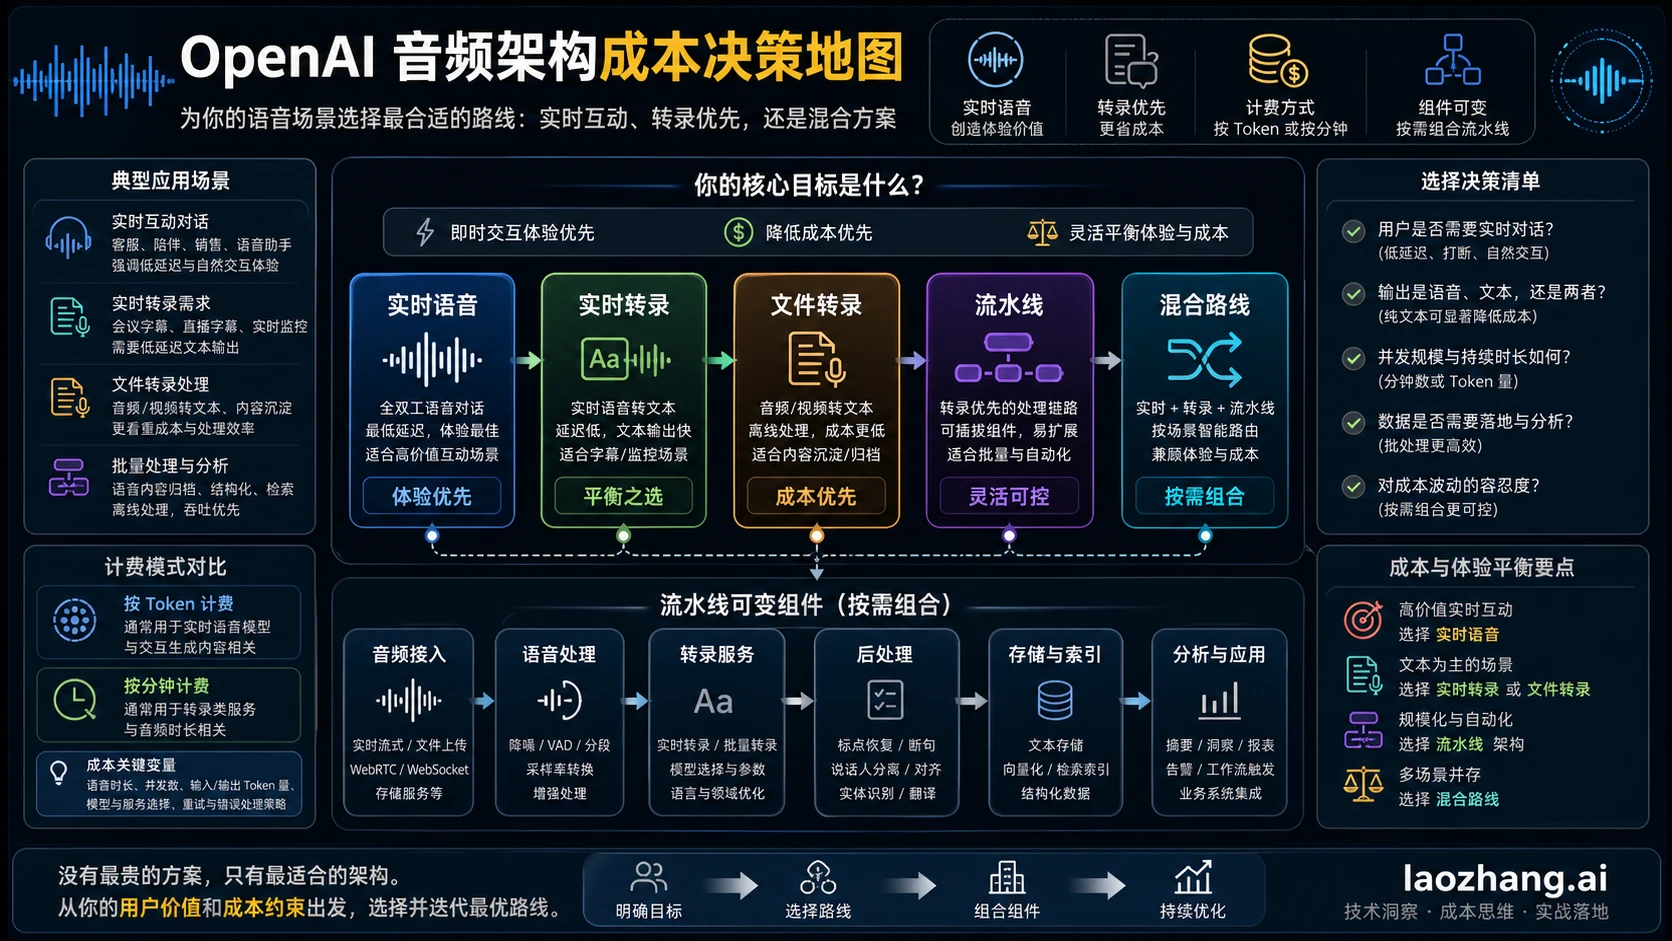
只需要字幕、录音文字或摘要,先从转写开始;需要助手开口回应、允许用户打断,并在对话中执行任务,才比较语音对话方案。 Realtime API、GPTLive 和 STT→LLM→TTS 都可以进入语音产品的预算,但不能拿一个转写价格直接替代完整语音助手的成本。
比较时先固定交付结果,再分别记录通话持续多久、用户说了多久、助手生成了多久的音频,以及后端做了什么。10 分钟通话不等于 10 分钟用户音频加 10 分钟助手音频;GPTLive 的 10 分钟活跃会话则还包含静音和等待后端的时间。
下面采用截至 2026 年 10 月 6 日核对的 OpenAI 官方直接调用费率。预算示例是离线算术演算,不是实际账单或音频测试;模型的识别准确率、打断体验和任务完成率,需要用你的场景另行评价。
先确定要交付文字,还是完成语音对话
如果用户录完一段话,只等着拿到文字和摘要,给它加入会说话的助手不会自动增加价值。如果用户在通话中查询订单、修改预约,要求助手及时回应并处理打断,那么单独完成转写也没有完成同一个任务。
| 要交付的结果 | 预算起点 | 还要加什么 |
|---|---|---|
| 已完成录音的文字 | 文件转写,当前推荐起点为 gpt-transcribe | 需要摘要、抽取、搜索时再加相应处理 |
| 人说话时持续出现文字 | 实时转写,当前推荐起点为 gpt-live-transcribe | 字幕展示、存储和需要的文本处理 |
| 助手通过语音完成交互任务 | gpt-realtime-2.1 / gpt-realtime-2.1-mini,或 GPTLive 前端加后端 | 工具、记录留存、输入转写及运营费用 |
| 希望分别选择识别、推理和发声组件 | STT→文本模型→可选 TTS | 组件编排、打断处理、重试和运维 |
| 现场对话加通话后质检、摘要或归档 | 现场语音方案加后台处理 | 明确是否复用已有转写,避免重复购买同一产物 |
转写的新推荐起点来自 OpenAI 转写工作流文档。其中还区分了两个容易混淆的“流式”:已完成文件可以在处理时流式返回文字,不必因此打开持续接收音频的 Realtime 连接。文件的 stream=true、TTS 分块播放和持续音频转写,分别解决不同问题。
已有 gpt-4o-transcribe、gpt-4o-mini-transcribe 或 gpt-realtime-whisper 集成可以按受支持的路线继续使用,但不宜把旧模型写成所有新项目的默认选择。需要说话人标签、逐词时间戳或字幕文件时,还应核对专门能力:当前文档把文件说话人标注交给 gpt-4o-transcribe-diarize,把逐词时间戳和 srt / vtt 交给 whisper-1,不能从“转写模型”四个字推定全部具备。
当前费率:先分清 token、音频分钟和活跃分钟
下表金额均为美元,来自 OpenAI 官方价格页,核对日期为 2026 年 10 月 6 日。它们是组件费率,尚未包含税费、运营商、第三方服务及人工成本。
| 模型或组件 | 计费单位 | 费率 |
|---|---|---|
gpt-transcribe 文件转写 | 音频分钟 | 0.0045 美元/分钟,即 0.27 美元/音频小时 |
gpt-live-transcribe 实时转写 | 音频分钟 | 0.017 美元/分钟,即 1.02 美元/音频小时 |
gpt-realtime-whisper 既有实时转写路线 | 音频分钟 | 0.017 美元/分钟 |
gpt-4o-transcribe / diarize 既有路线 | 每百万输入/输出 token | 2.50 / 10 美元;价格页估计为 0.006 美元/音频分钟 |
gpt-4o-mini-transcribe 既有路线 | 每百万输入/输出 token | 1.25 / 5 美元;价格页估计为 0.003 美元/音频分钟 |
gpt-live-1 语音前端 | 会话活跃秒数,按分钟费率折算 | 0.05 美元/活跃分钟;后端模型和工具另计 |
tts-1 / tts-1-hd 既有 TTS | 每百万字符 | 15 / 30 美元 |
gpt-4o-mini-tts | 每百万文本输入/音频输出 token | 0.60 / 12 美元 |
旧转写模型的“估计每分钟价格”是便于理解的估算,不应改写为固定分钟结算承诺。按字符计价的 TTS 也不能直接换成固定语音分钟价:语言、语速和输出文本长度都会影响换算。Realtime 的音频 token 换算规则不能直接借给另一种 TTS 模型。
Realtime 语音对话的费率要另看输入、缓存输入和输出:
| Realtime 模型 | 音频输入 / 缓存输入 / 输出 | 文本输入 / 缓存输入 / 输出 |
|---|---|---|
gpt-realtime-2.1 | 32 / 0.40 / 64 美元/百万 token | 4 / 0.40 / 24 美元/百万 token |
gpt-realtime-2 | 32 / 0.40 / 64 美元/百万 token | 4 / 0.40 / 24 美元/百万 token |
gpt-realtime-2.1-mini | 10 / 0.30 / 20 美元/百万 token | 0.60 / 0.06 / 2.40 美元/百万 token |
若使用图像,2.1 和 2 的图像输入/缓存输入为 5 / 0.50 美元/百万 token,2.1-mini 为 0.80 / 0.08。系统指令、工具定义和工具结果带来的文本也需要计入,不能因产品界面只有语音就忽略它们。
gpt-realtime-2 仍有当前官方模型页面和价格记录;它不是已经停用的模型。选择新路线时,应同时考虑当前 2.1 与 mini,而不是沿用旧文的单一报价。
对既有系统还要预留迁移预算。官方停用公告列出 tts-1、tts-1-hd 和两款指定的 mini TTS 快照将于 2027 年 1 月 6 日移除;whisper-1、4o 转写、mini 转写和 diarize 将于 2027 年 2 月 26 日移除。公告中的旧 Realtime 家族另有 2027 年 1 月 20 日期限,不能据此推断所有名字含 Realtime 的新模型都会同时停用。
Realtime 一小时多少钱?先算双方真正的音频量
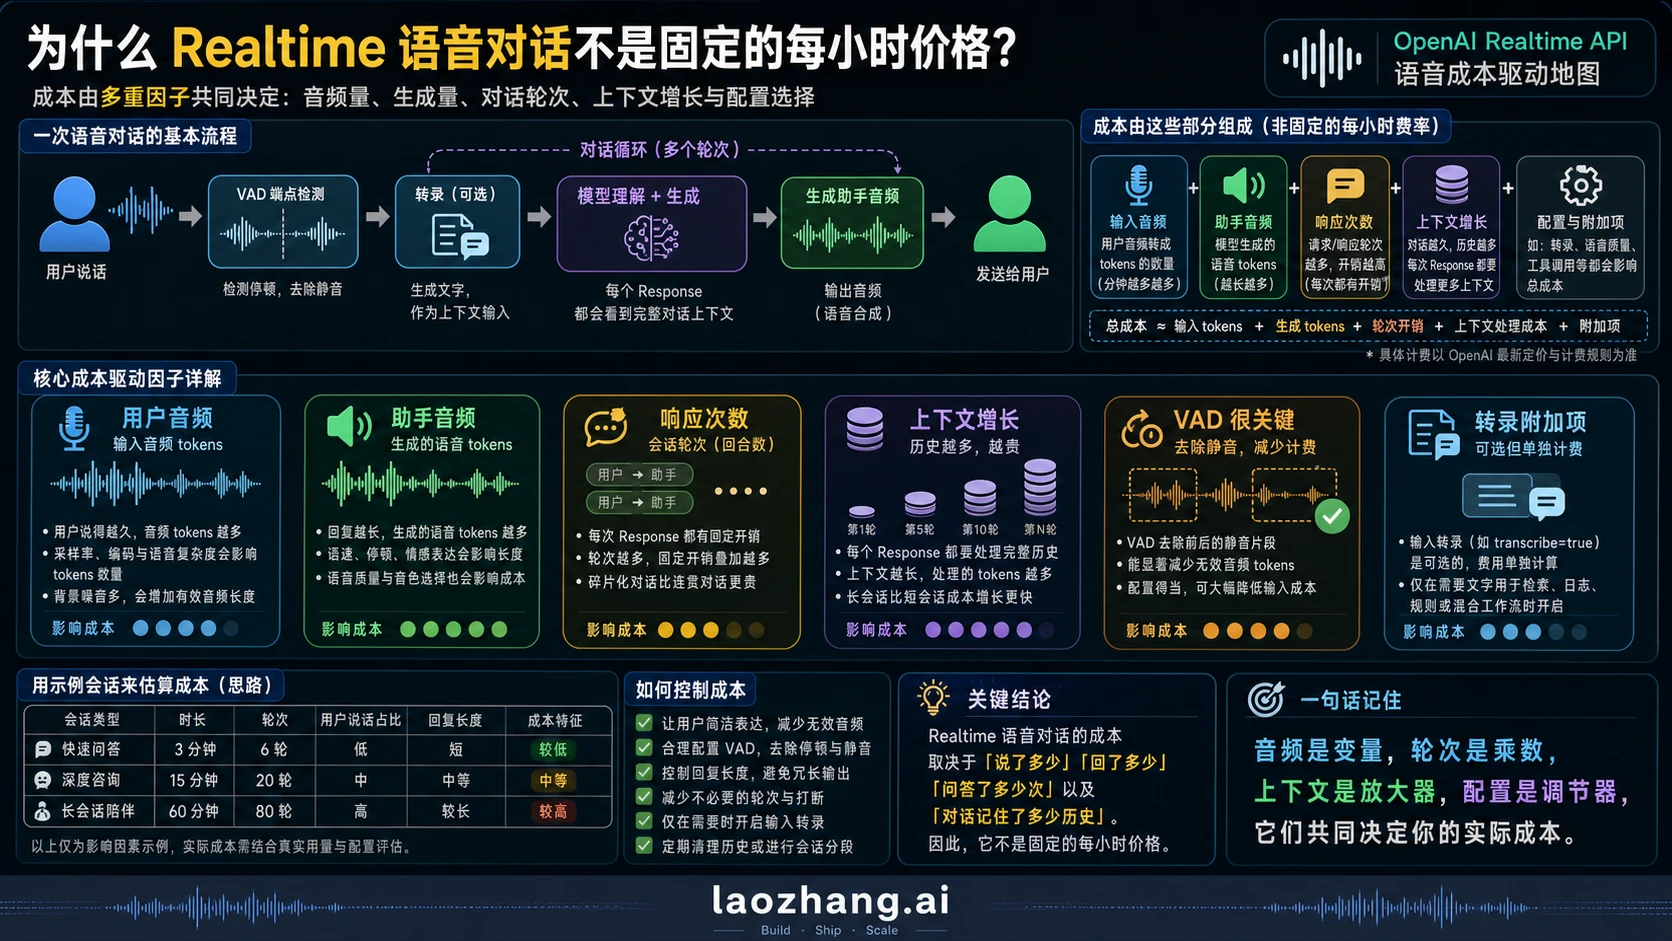
Realtime 成本说明给出的近似换算是:用户音频每 100 毫秒 1 个 token,助手音频每 50 毫秒 1 个 token。因此一分钟用户音频约 600 个 token,一分钟助手音频约 1,200 个 token;特殊 token 会带来小幅差异。
只计算新音频,不含历史、文本和其他组件时,可以这样估算:
2.1 / 2 新音频费用
= 用户音频分钟 × 600 × 32 ÷ 1,000,000
+ 助手音频分钟 × 1,200 × 64 ÷ 1,000,000
= 用户音频分钟 × 0.0192 + 助手音频分钟 × 0.0768

2.1-mini 新音频费用
= 用户音频分钟 × 0.006 + 助手音频分钟 × 0.024
假设实际经过的一分钟里,用户说 30 秒,助手生成 30 秒语音,则新音频费用约为 0.5 × 0.0192 + 0.5 × 0.0768 = 0.048 美元;mini 为 0.5 × 0.006 + 0.5 × 0.024 = 0.015 美元。两者都还不是整段对话的最终单价。
旧的 5.76 美元算法是 60 × 0.0192 + 60 × 0.0768,对应一小时未缓存用户音频输入,再加一小时生成的助手音频输出。它不是一小时通话的普遍底价,也不是任意说话比例下的每小时报价。若一小时通话只有 20 分钟用户音频和 15 分钟助手音频,这部分在 2.1 上是 20 × 0.0192 + 15 × 0.0768 = 1.536 美元;之后仍要继续加完整费用。
历史、缓存和额外转写怎样进入 Realtime 账本
Realtime 在创建 Response 时产生输入和输出 token 费用。当前说明不对连接和网络带宽收费;启用 VAD 时空音频会被过滤,但客户端手动把空音频加入会话输入,不能套用同一结论。会话历史会在下一次 Response 中再次成为输入,因此“新音频分钟 × 费率”不能解释多轮账单。来源:每次 Response 的费用。
正确计算缓存时,缓存 token 是输入的子集,先从该模态输入中扣除,再按缓存费率计算:
某模态输入费用
= [(输入 token − 其中缓存 token) × 普通输入费率
   + 其中缓存 token × 缓存输入费率] ÷ 1,000,000

输出费用 = 输出 token × 对应输出费率 ÷ 1,000,000
例如 mini 的音频输入共 11,400 token,其中缓存 6,000,费用为 (5,400 × 10 + 6,000 × 0.30) ÷ 1,000,000 = 0.0558 美元。不能把 11,400 全部按缓存价计,也不能把一个总缓存数同时从音频和文本两行各扣一次。
记录每个唯一 Response 的 response.done.usage,保留 input_token_details 中的音频、文本、图像及 cached_tokens_details,再记录输出音频和文本。total_tokens 是总量,不能在分项计费后再加收一次。缓存属于尽力而为的机制,不保证命中;修改历史、指令、工具定义或发生截断会影响命中,不能预设每个后续轮次都有同样折扣。
开启输入转写还会产生单独费用,对应 conversation.item.input_audio_transcription.completed 的转写用量和所选模型费率。它不能被当成 Realtime 音频输入已经包含的免费服务。对于没有收到最终用量、请求超时或播放被打断的情况,先记录待核对费用;“用户没听到”不能证明服务端没有生成或没有计费。
GPTLive 为什么还要记录静音和后端等待
GPTLive 将语音前端和执行推理、工具的后端分开。它的预算式是:
GPTLive 总费用
= 会话活跃秒数 ÷ 60 × 0.05 美元
+ 后端模型、工具及其他服务费用
活跃秒数包含用户说话、助手说话、双方静音以及后端工作的时间。静音麦克风不会关闭会话。比如 90 秒活跃会话,前端是 90 ÷ 60 × 0.05 = 0.075 美元;假设后端另花 0.02 美元,合计 0.095 美元。来源:GPTLive 用量与费用。
WebRTC 创建会话时计入的初始 15 秒,在会话开始运行后抵入持续时长。上面的 90 秒按 90 秒算,不是 105 秒。反复创建却未使用的会话仍需考虑初始化费用,不能因为一次启动超时就填零。
这里的优化重点是减少无用的会话占用。假设一个后端优化多花 0.015 美元,却让用户少等待 30 秒并更早关闭会话,前端节省 30 ÷ 60 × 0.05 = 0.025 美元,总费用减少 0.010 美元。若它只节省 10 秒,节省约 0.0083 美元,反而不足以覆盖增加的后端费用。这个临界点是 0.015 ÷ 0.05 × 60 = 18 秒,前提是任务结果不变、会话确实提前关闭。
用量记录也不同:session.usage.updated 的 usage.seconds 是累计快照,用新值替换旧值,不要逐条相加。关闭后记录 session.closed 的最终秒数一次。后端按唯一 response ID 归集嵌套 response.completed 用量,应用自行发起的调用也要加上;没有用上的提前查询或其他推测执行不能从成本中消失。
用一次 10 分钟语音任务复算三条路线
下面假设同一个客服任务持续 10 分钟:用户音频 4 分钟,助手语音 3 分钟,其余为静音或等待。各路线都要完成同一业务动作并提供所需回应;这里只假设交付要求相同,不代表模型已达到同等效果。
为了把预算填完整,进一步采用以下示例输入:
- Realtime:新用户音频 2,400 token,历史重复带入 9,000 音频 token,音频缓存总计 6,000 token;文本输入共 4,000 token,其中缓存 3,000;输出音频 3,600 token、文本 1,000 token,不使用图像或另付输入转写。
- 级联:只转写用户的 4 分钟分段音频,文本模型费用暂设 0.012 美元;TTS 使用既有
tts-1路线,实际提交文本假设为 1,800 字符。1,800 字符和 3 分钟输出是分别给定的假设,不是固定语速换算;该模型有前述停用期限。 - GPTLive:活跃时长完整计入 600 秒,后端费用暂设 0.012 美元。
- 每条路线另分摊采集、线路、存储和编排 0.020 美元,质检及运营 0.010 美元。这些是自设预算值,实际供应商和人工费用应替换;本例不含税费和额外失败重试。
先算 Realtime 的模型费用:
| 项目 | 2.1-mini 演算 | 2.1 / 2 演算 |
|---|---|---|
| 音频输入含重复历史 | (5,400×10 + 6,000×0.30)/1M = 0.0558 | (5,400×32 + 6,000×0.40)/1M = 0.1752 |
| 音频输出 | 3,600×20/1M = 0.072 | 3,600×64/1M = 0.2304 |
| 文本输入含缓存 | (1,000×0.60 + 3,000×0.06)/1M = 0.00078 | (1,000×4 + 3,000×0.40)/1M = 0.0052 |
| 文本输出 | 1,000×2.40/1M = 0.0024 | 1,000×24/1M = 0.024 |
| 模型费用合计 | 0.13098 美元 | 0.4348 美元 |
再把其他路线和共用预算放进同一张表:
| 路线 | 模型及语音组件费用 | 加 0.030 美元示例运营分摊后的总额 |
|---|---|---|
| Realtime mini | 0.13098 美元 | 0.16098 美元 |
Realtime 2.1 / 2 | 0.4348 美元 | 0.4648 美元 |
分段转写→文本模型→tts-1 | 4×0.0045 + 0.012 + 1,800×15/1M = 0.057 美元 | 0.087 美元 |
| GPTLive 前端加后端 | 600/60×0.05 + 0.012 = 0.512 美元 | 0.542 美元 |
这组数字显示的是指定输入下的费用关系。它没有证明级联一定更便宜:如果级联改用实时转写,仅 STT 就从 0.018 变为 4 × 0.017 = 0.068 美元,总额升至 0.137 美元;若较贵的 TTS、更多重试或额外编排再增加超过 0.02398 美元,便会越过本例 mini 的 0.16098 美元。不能拿一条路线的最低费率与另一条路线的完整费用比较。
音频范围也会改变答案。级联若提交的是完整 10 分钟录音,而不是 4 分钟用户片段,文件转写费用是 0.045 美元,该例总额变为 0.114 美元。实时字幕如果只要文字,本例 4 分钟实时音频的 0.068 美元无需再加助手 TTS;但它没有交付语音客服任务,应该单独评价。
转录管道和混合方案:把后台产物与重复费用拆开
转录优先的优势是可以分别选择和重跑组件,也容易围绕文字做摘要、抽取和质检。代价是你要负责识别、文本推理、语音播放和打断之间的衔接。各阶段可以流式处理,但“分块”本身不保证某个固定响应时间,也不证明级联体验与原生语音一致。
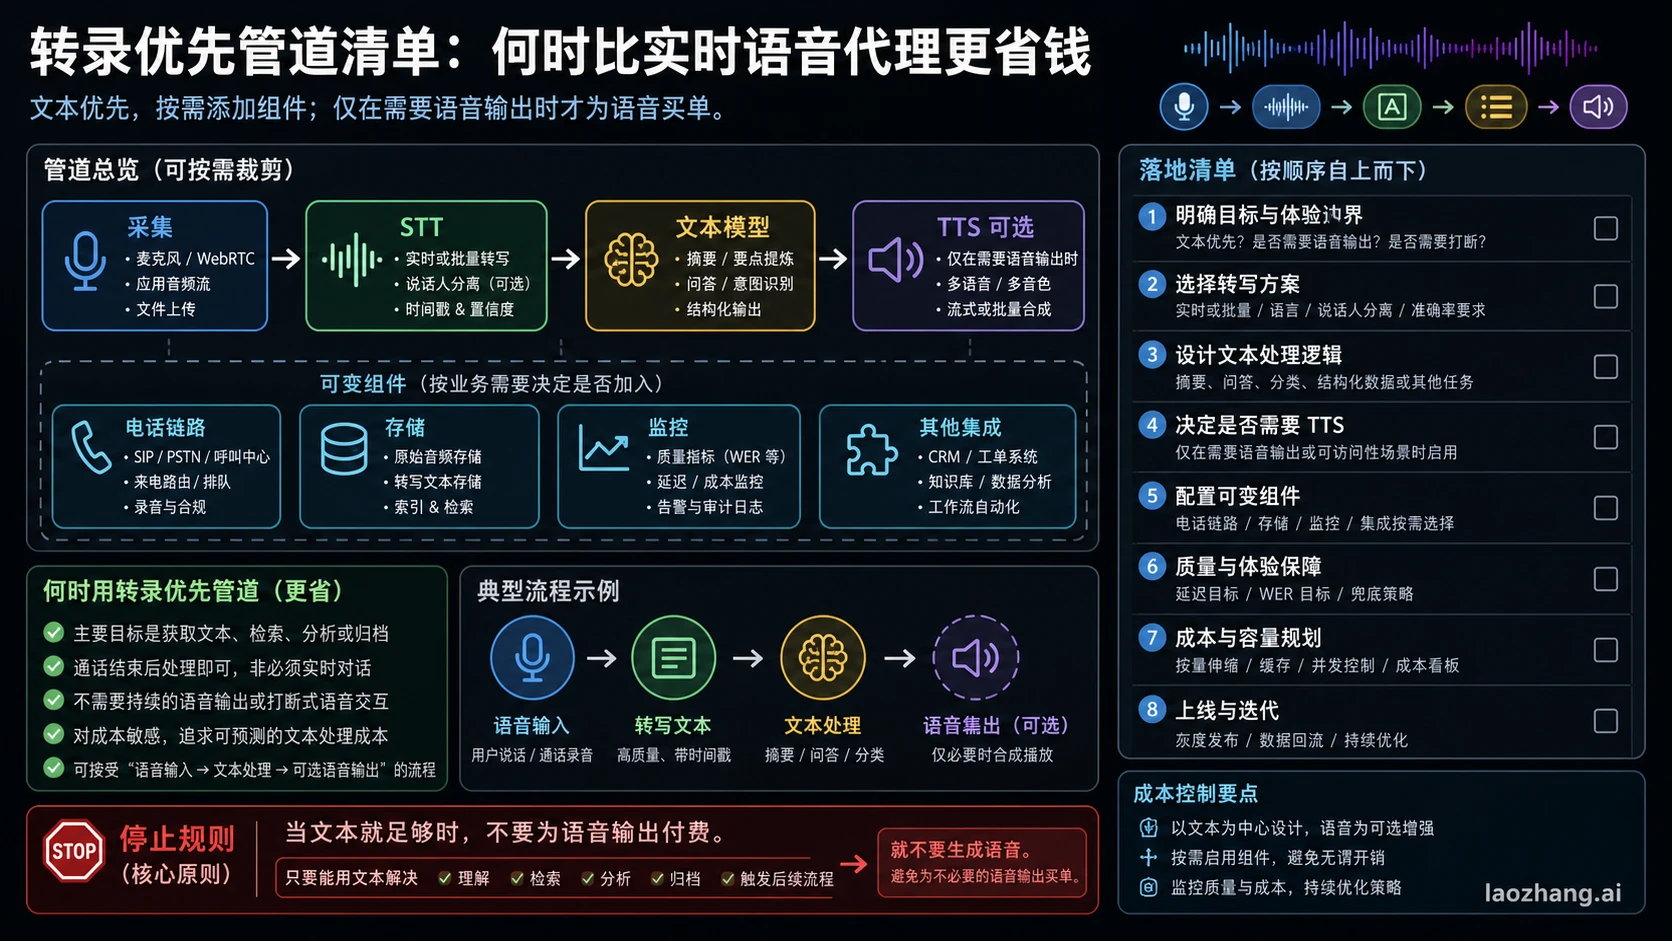
预算应逐项回答:STT 处理全部录音还是用户片段?文本模型重复读取多少历史?TTS 按字符还是 token?语音被打断后已生成多少输出?外部工具、电话线路和录音留存是否收费?哪些失败会重试,哪些任务转人工?费用未知时保留变量,不把空白单元格当作零。
混合方案则把现场和后台划出明确边界。例如现场用 mini 完成上面的语音任务,通话后再转写 4 分钟用户录音,并用假设 0.006 美元的文本处理生成质检记录:
混合任务总额
= 现场模型 0.13098
+ 后台文件转写 4 × 0.0045
+ 后台文本处理 0.006
+ 示例运营分摊 0.030
= 0.18498 美元
如果现场已经付费取得满足归档要求的转写,可复用它,后台就不必再加这笔 0.018 美元;但要把现场转写本身的费用计入。若最终交付要求包括双方完整记录、说话人标签或精确时间戳,只有用户片段的文字可能不够,应先确定可用产物,再决定是否重复转写。
对 GPTLive,现场互动结束后及时关闭前端,可以让独立后台继续做长任务。对 Realtime,控制不再有用的历史和冗长语音输出,可以降低相应 token 用量;压缩历史同时也可能丢失任务信息或影响缓存。优化的验收应同时看成本与任务结果,不能只看删掉了多少 token。
从单次估算做到月预算和每次可用任务成本
把工作表的输入列分成三类:当前费率、预计用量、完成结果。费率一变就换费率,用量靠自己的代表性样本更新,结果则保留完成标准,不用“返回了文本”替代“正确完成业务任务”。
| 工作表项 | 要填写的内容或公式 |
|---|---|
| 任务和输出 | 文字、语音回应、执行结果、归档要求;不能中途换比较目标 |
| 音频量与时钟 | 用户音频分钟、助手生成音频分钟、录音提交分钟、GPTLive 活跃秒数分别填 |
| Realtime 输入 | 逐 Response 的音频/文本/图像输入及各自缓存子集 |
| Realtime 输出 | 音频与文本输出分别乘对应模型费率 |
| 转写与 TTS | 转写独立用量;TTS 对应字符数或 token,不套用其他模型的换算 |
| 后端及运营 | 文本模型、工具、线路、存储、QA、人工兜底及运维分摊 |
| 尝试总费用 | 成功、失败、重试、重连和未使用但已执行的工作全部归集 |
| 可用任务数 | 达到同一完成标准且结果可用的任务数量 |
| 每次可用任务成本 | 尝试总费用 ÷ 可用任务数 |
按上面的固定用量做 1,000 次尝试,mini 示例预算为 160.98 美元,级联为 87 美元,GPTLive 为 542 美元,混合为 184.98 美元。如果各自只有 900 次达到完成标准,mini 的每次可用任务成本是 160.98 ÷ 900 ≈ 0.1789 美元,级联约 0.0967 美元。900 是演算假设,不是任何模型的实际完成率;真实比较应给每条路线分别填写自己的可用任务数。
固定金额预算也可以除以示例单次成本:100 美元除以 mini 的 0.16098,约相当于 621 次这种用量的尝试。它不是平台保证可用的次数;更长的回答、不同缓存、价格变化或未计费用都会改变结果。
上线规划时,用短、中、长会话分别填表,不只放一个平均数。重点观察助手发声量、Response 数、历史和缓存比例,以及 GPTLive 的后端等待时间;再看失败重试和人工转接是否使较低模型费率变成较高的完成成本。若需要在调用前控制总预算,可以继续看如何设置 API 花费熔断开关,将待核对费用和预留额度纳入放行判断。
常见问题
Realtime API 一定比 STT→LLM→TTS 贵吗?
不一定。先固定同一语音任务,再计算双方音频、历史、文本、TTS、重试和运营费用。gpt-realtime-2.1-mini 的费率改变了比较结果,使用贵 TTS 或实时 STT 的级联也可能超过它。低费率是否仍能完成任务,需要单独评价;价格页不能证明质量等价。
实时字幕需要会说话的 Realtime 助手吗?
通常只需要实时转写。当前官方工作流推荐以 gpt-live-transcribe 开始;已完成文件则以 gpt-transcribe 开始,文件也可以流式返回文字。若字幕需要逐词时间戳或说话人标签,须另查支持这些能力的路线,不能只按最低报价选择。
GPTLive 开着不说话,会继续收费吗?
会话仍活跃时,会。静音和等待后端包含在活跃时长中,关闭麦克风不等于关闭会话;按当前 0.05 美元/分钟的前端费率折算,后端费用另加。应收集关闭时的最终用量,累计快照不能相加。来源:GPTLive 计量说明。
Realtime 已经听懂音频,为什么文字转写还会收费?
语音理解和额外输出转写是不同工作。启用输入转写时,使用单独的转写模型并单独计量;应把相应事件的用量加入预算。需要留存文字时先确定产物要求,避免现场付费转写后又无必要地重复跑文件转写。来源:输入转写费用。
旧转写和 TTS 已被弃用,现在还能算进预算吗?
可以为仍受支持的既有集成估算当前费用,但应同时列出迁移期限和迁移工作。弃用不等于已经关闭;tts-1 等指定模型在 2027 年 1 月 6 日移除,4o 转写、mini、diarize 和 Whisper 在 2027 年 2 月 26 日移除。新项目应先查看推荐工作流,具体模型和快照以官方停用清单为准。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
- 1.OpenAI 转写工作流文档developers.openai.com/api/docs/guides/transcription
- 2.OpenAI 官方价格页developers.openai.com/api/docs/pricing
- 3.当前官方模型页面developers.openai.com/api/docs/models/gpt-realtime-2
- 4.官方停用公告developers.openai.com/api/docs/deprecations
- 5.Realtime 成本说明developers.openai.com/api/docs/guides/voice-latency-cost