最便宜的 LLM API 提供商:同一个模型去哪买更省
闭源模型官方直连基本就是底价;开源模型要逐个比,DeepSeek V4 Pro 空闲时段直连最省,高峰时段 DeepInfra 更低。聚合平台和中转另算手续费、倍率和版本。
文章目录
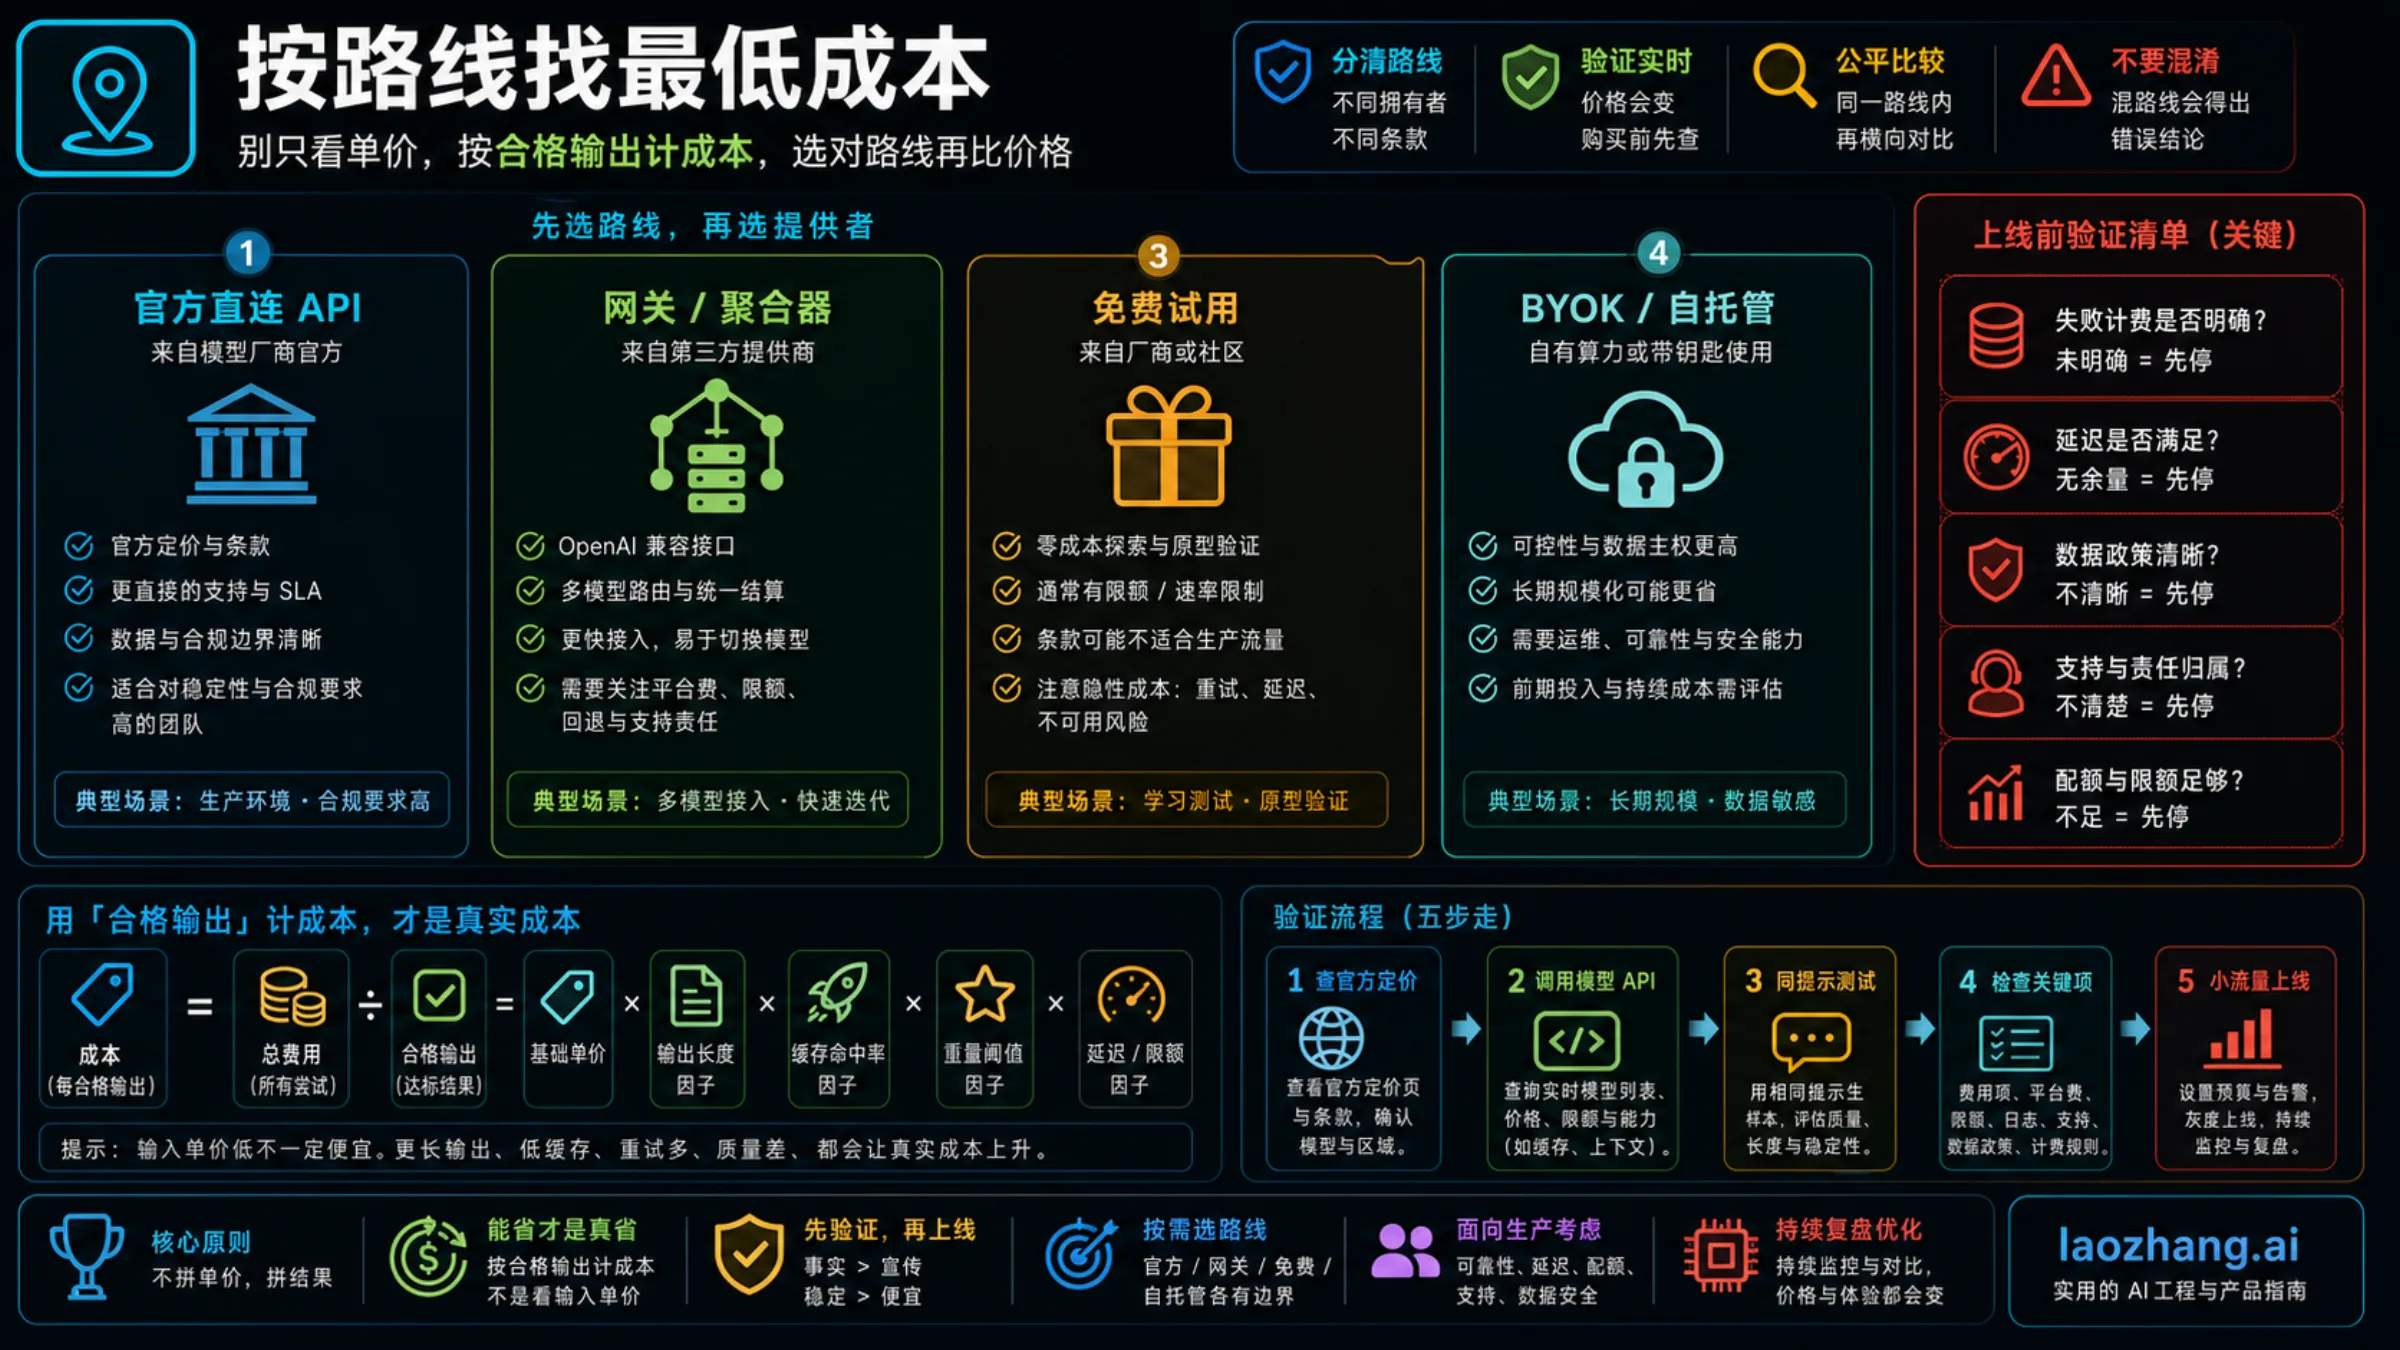
截至 2026 年 9 月 26 日,同一个模型去哪买最便宜,先看它是闭源还是开源权重。GPT-6、Claude、Gemini、Grok 这类闭源模型不公开权重,官方直连的标价基本就是底价:OpenRouter 这类聚合平台按原价透传,但买额度时另收 5.5%(Standard 方案),网关和中转则要看分组倍率。DeepSeek、Kimi、Qwen 这类开源权重模型有多家托管商在卖,价差可以很大,而且没有哪一家全线最低:DeepSeek V4 Pro 在空闲时段官方直连最便宜,工作日白天的高峰时段 DeepInfra 更低;Kimi K3 是 DeepInfra 比 Together 低 5%,Qwen3.7-Max 却是 Together 比 DeepInfra 低 40%。
所以"最便宜的提供商"只能按模型逐个算:同一个模型、同一个版本、同一份用量,把单价、充值手续费或倍率、峰谷和批处理折扣、缓存命中价都算进月账单,再用小流量确认合格率。还没决定用哪个模型,先看AI API 价格对比:国内外大模型谁最便宜、月费怎么算。
四类渠道,各自卖的是什么
| 渠道 | 例子 | 付钱买到的东西 | 价格由谁定 | 容易多花钱的地方 |
|---|---|---|---|---|
| 模型官方直连 | OpenAI、Anthropic、Google、xAI、DeepSeek | 原厂模型、最新版本和新功能,以及官方的批处理、峰谷折扣 | 模型厂商自己的价目表 | 要逐家开户、充值,处理支付和网络 |
| 开源权重托管商 | Together AI、DeepInfra、Fireworks | 托管商用自己的 GPU 运行开源权重模型 | 托管商自定,同一模型各家不同 | 版本不一定是官方最新,精度未必标明,折扣规则和官方不同 |
| 路由 / 聚合平台 | OpenRouter | 一把密钥、一个账单,调用多家上游 | 透传上游价格 | 购买额度的手续费,免费方案有次数限制 |
| 网关与中转 | laozhang.ai、各类国内中转 | 统一的兼容接口和预付余额 | 平台自己的价目页,常见分组倍率 | 倍率、按次计费,上游和版本是否透明 |
这张表决定了比价方向。闭源模型只有第一类是源头,其他渠道最多按原价转卖,再加手续费或倍率;只有官方开户、支付、接入或统一记账不方便时,换渠道才划算,那是为方便付费,不是在省 token 钱。开源权重模型不一样,托管商之间真的在比价格和速度,官方直连只是其中一个报价,所以下面的对比都放在开源模型上。
同一个模型比三家:以 DeepSeek 为例
DeepSeek V4 Pro
下表是每百万 tokens 的美元价,截至 2026 年 9 月 26 日。官方价来自 DeepSeek 模型与价格页,官方 deepseek-v4-pro 对应的版本是 DeepSeek-V4-Pro-0813;托管商价格来自 Together AI 与 DeepInfra 的公开价目页。
| 渠道与模型名 | 输入(未命中缓存) | 缓存命中输入 | 输出 |
|---|---|---|---|
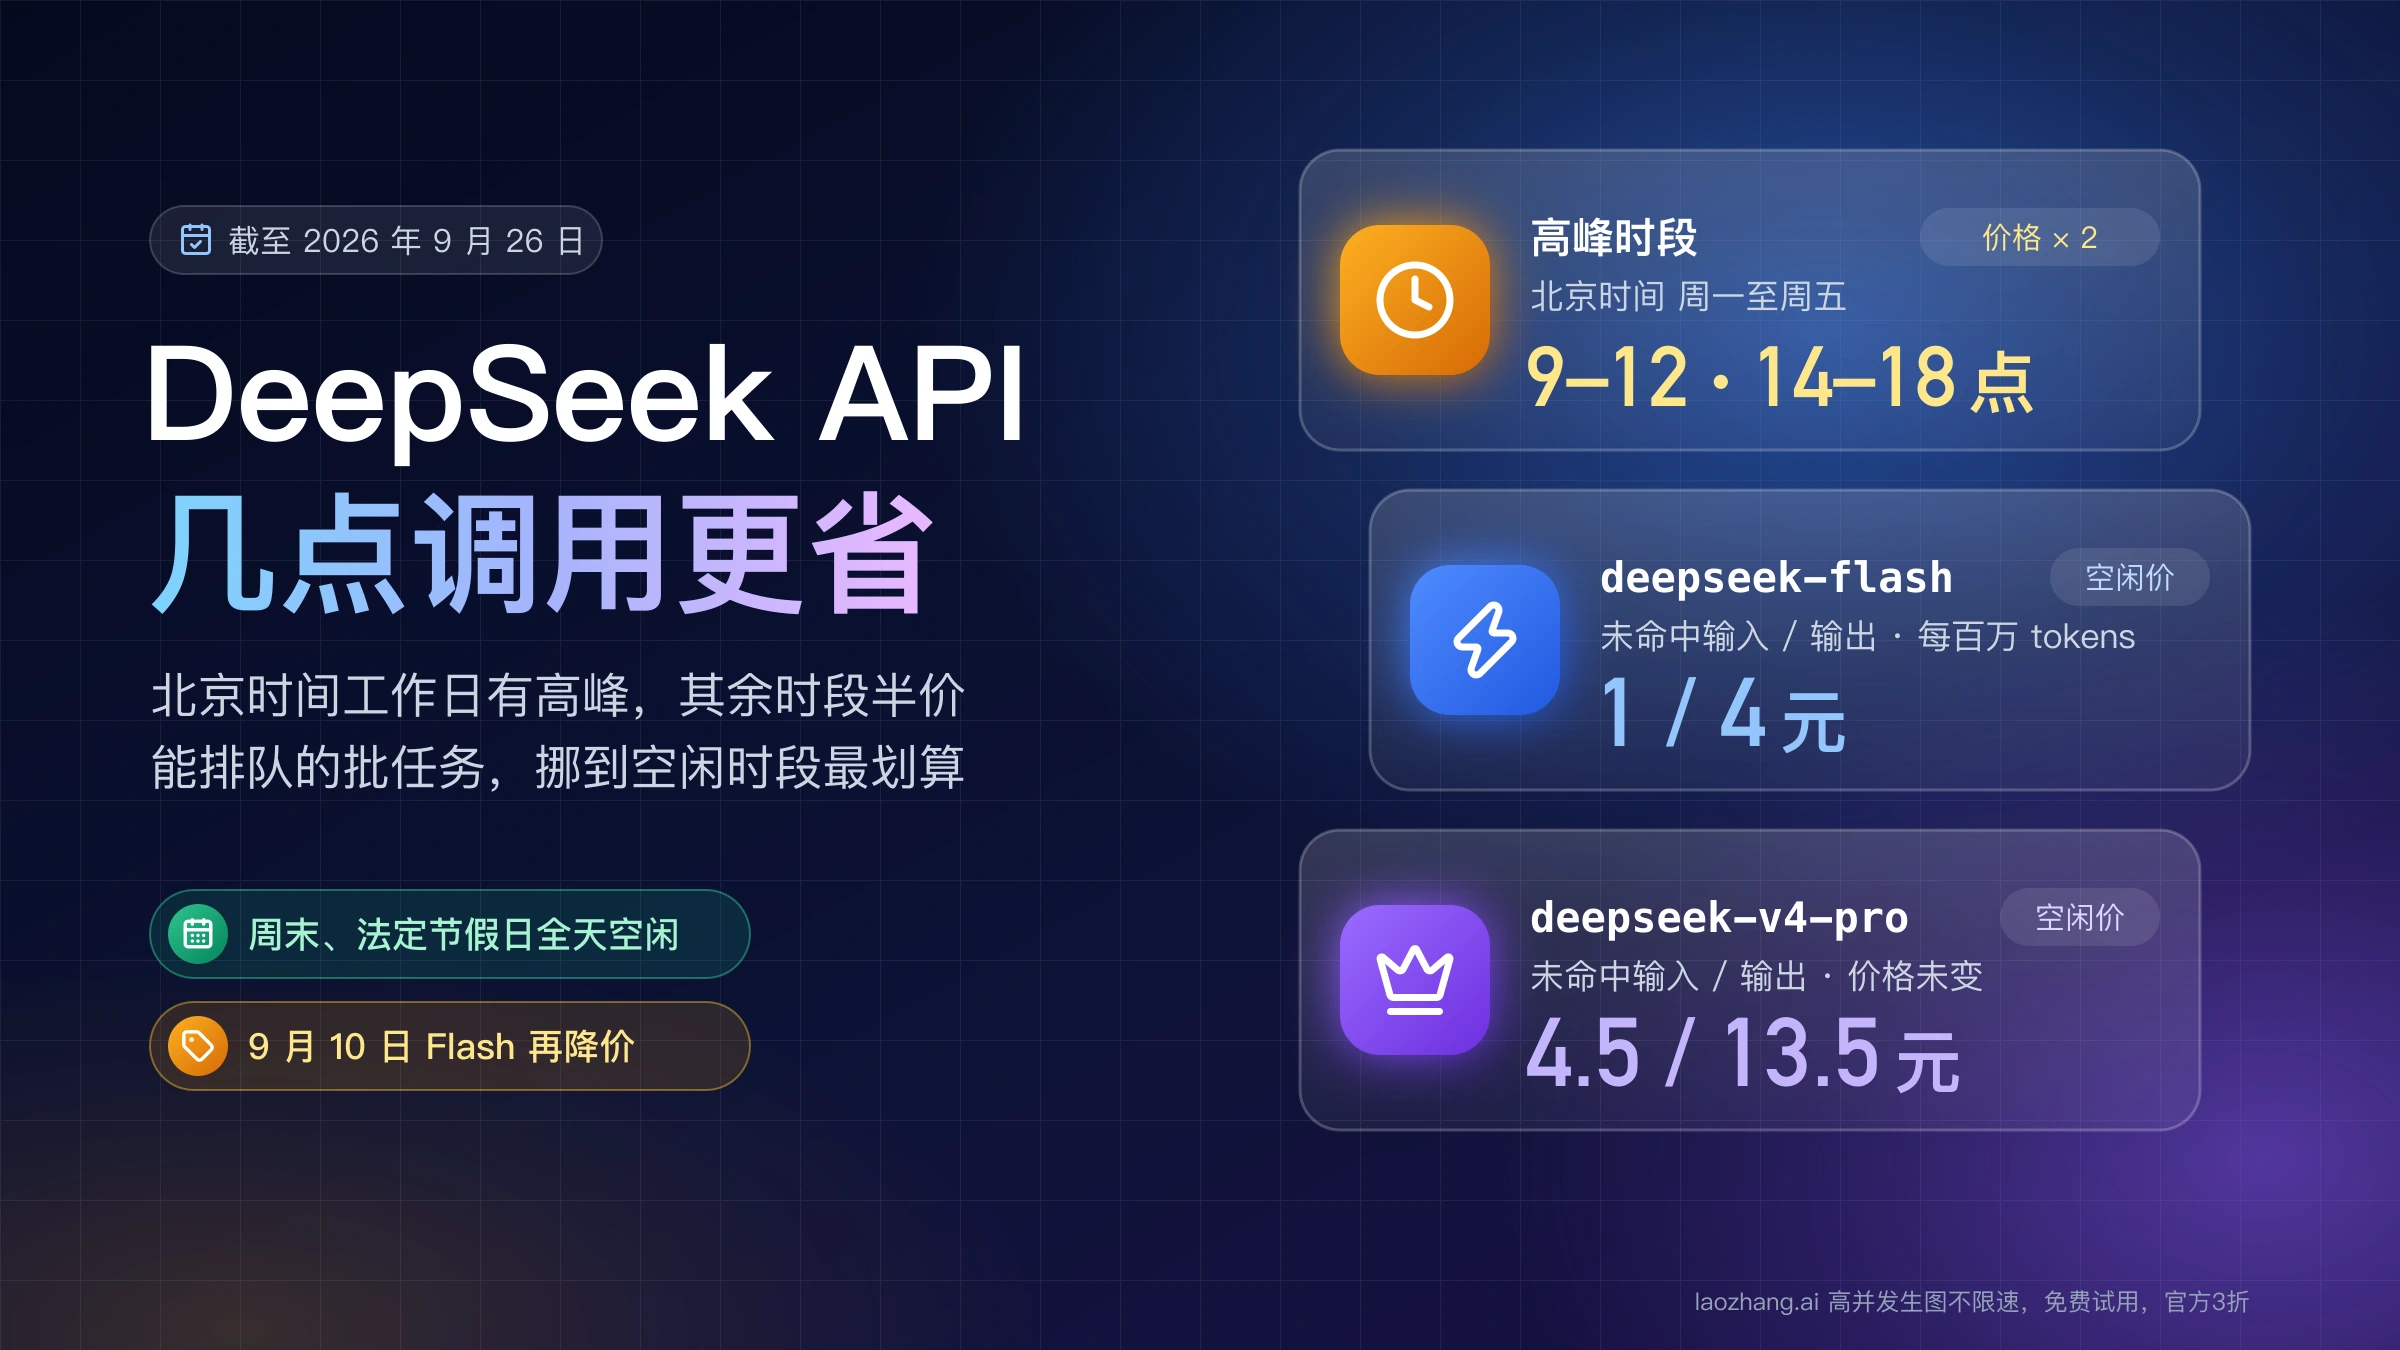
DeepSeek 官方 deepseek-v4-pro,空闲时段 | $0.66 | $0.022 | $1.98 |
DeepSeek 官方 deepseek-v4-pro,高峰时段 | $1.32 | $0.044 | $3.96 |
| Together AI「DeepSeek V4 Pro 0813」 | $1.32 | $0.13 | $3.96 |
| DeepInfra「DeepSeek-V4-Pro」 | $1.30 | $0.10 | $2.60 |
DeepSeek 的高峰时段是北京时间周一到周五 9:00–12:00、14:00–18:00(不含法定节假日),其余时间和周末全天都算空闲时段,空闲价正好是高峰价的一半。用人民币付费的账户另有人民币价目:V4 Pro 未命中缓存的输入空闲 4.5 元、高峰 9 元,输出 13.5 元、27 元。
Together 的价格和官方高峰价一模一样,但没有空闲折扣,缓存命中价 $0.13 也是官方高峰命中价的近三倍。DeepInfra 输入价和官方高峰基本持平,输出便宜三分之一左右。
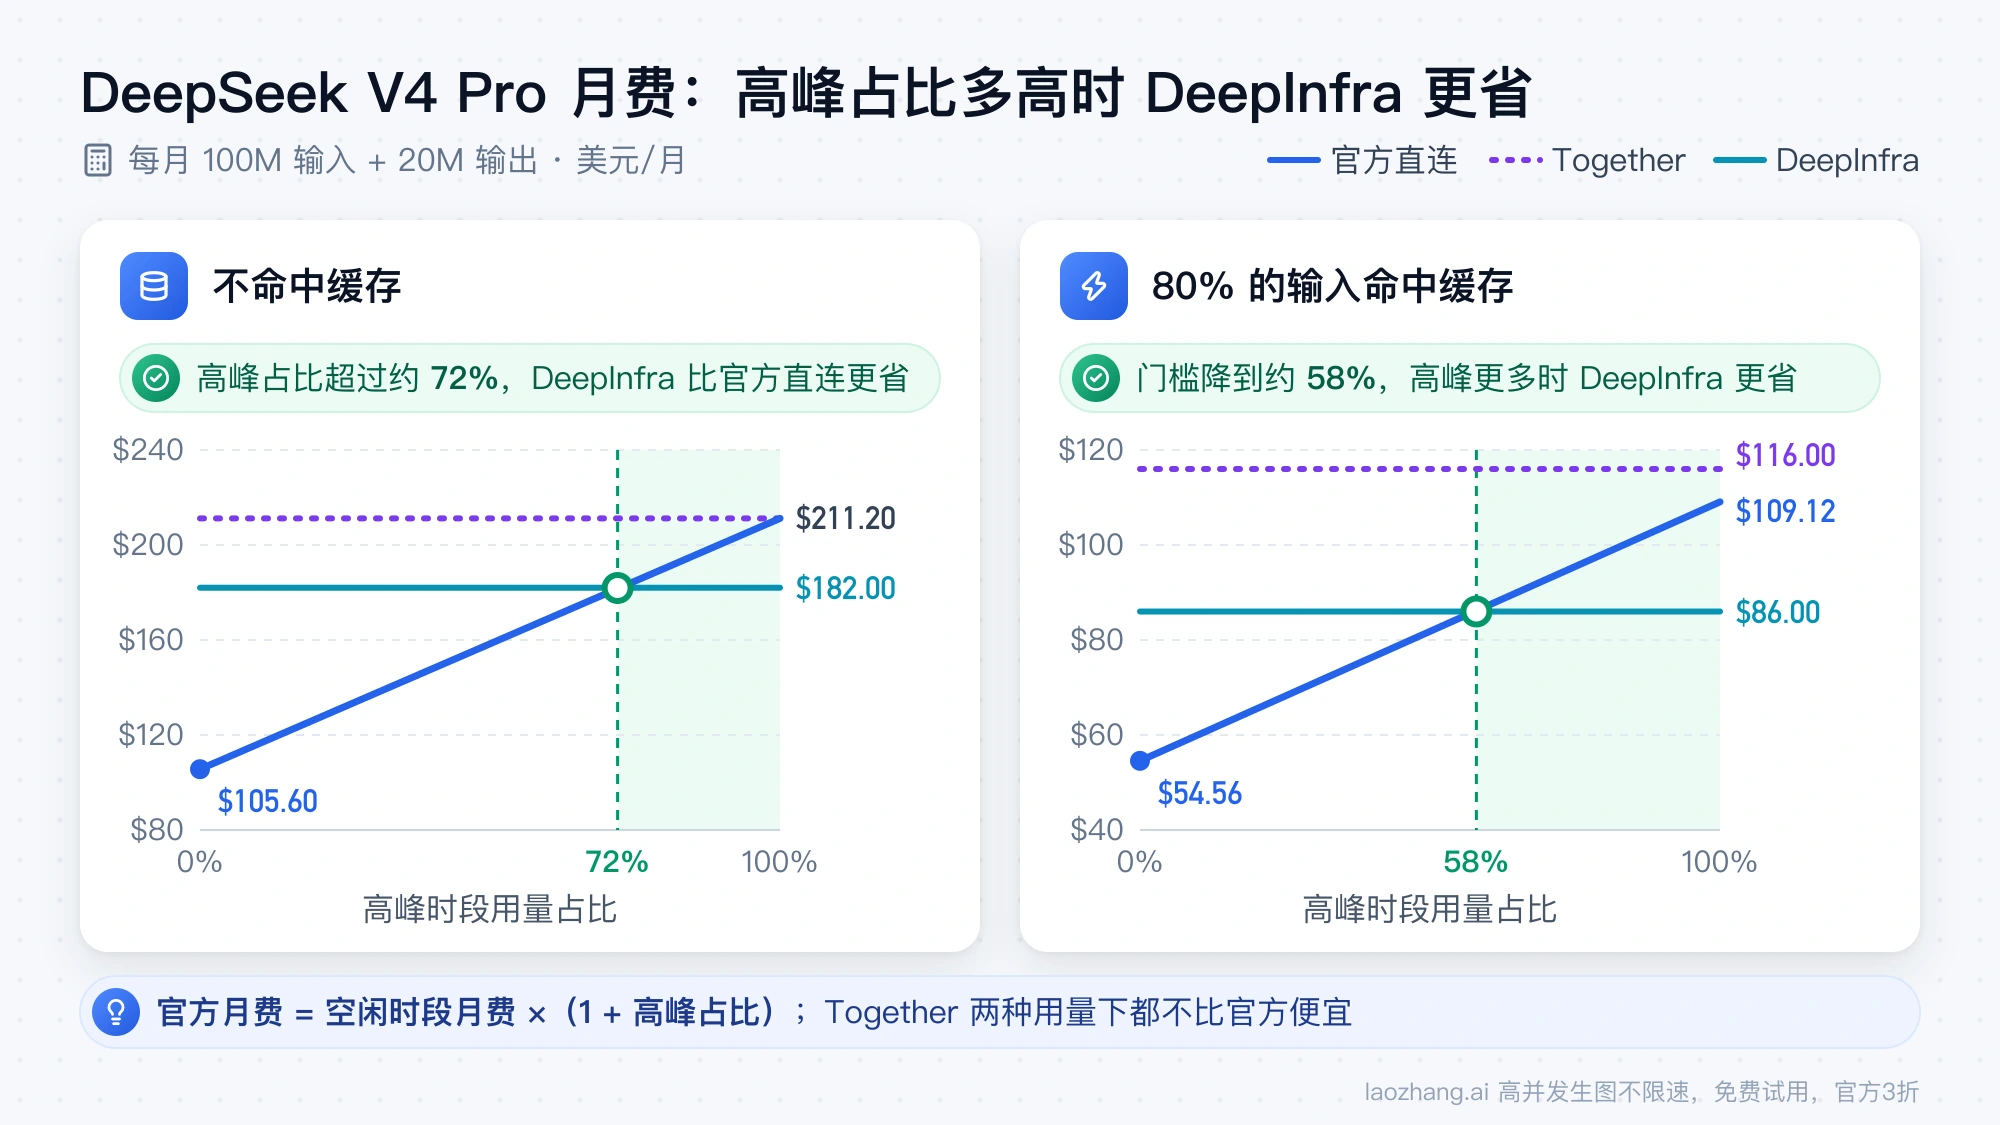
放进同一份用量看得更清楚。假设每月 100M 输入 tokens、20M 输出 tokens,月费 = 输入百万 tokens 数 × 输入单价 + 输出百万 tokens 数 × 输出单价;命中缓存的那部分输入改用缓存命中价。
| 渠道 | 不命中缓存 | 80% 的输入命中缓存 |
|---|---|---|
| 官方,全部在空闲时段 | $105.60 | $54.56 |
| 官方,全部在高峰时段 | $211.20 | $109.12 |
| Together AI | $211.20 | $116.00 |
| DeepInfra | $182.00 | $86.00 |
以官方空闲时段为例:不命中缓存时 100 × 0.66 + 20 × 1.98 = 105.60 美元;80% 命中时输入拆成 80M 命中、20M 未命中,80 × 0.022 + 20 × 0.66 + 20 × 1.98 = 54.56 美元。其他行照同一公式代入各自单价。
官方直连的实际月费落在两档之间:空闲时段月费 ×(1 + 高峰时段用量占比)。由此能算出 DeepInfra 什么时候更省。不命中缓存时,高峰占比要超过约 72%(182 ÷ 105.60 − 1);80% 命中缓存时,门槛降到约 58%(86 ÷ 54.56 − 1)。面向国内用户、白天在线的业务,流量大半压在工作日白天,DeepInfra 可能更便宜;夜间批处理、周末任务和能排队的离线作业放进空闲时段,官方直连便宜近一半。Together 在两种用量下都不比官方便宜。
这个结论有两个前提。第一,各家判定缓存命中的规则不同,表里假设命中率相同,实际要看各自账单。第二,DeepInfra 的模型名没有带日期后缀,接入前要确认它跑的是不是 0813 这一版。
托管商的价值有时不在价格。DeepSeek 官方价格页列出的并发上限是 V4 Pro 500、Flash 2,500,超过这个量级、或者需要别的地区与合同条款时,多付的那部分买的是容量和服务。峰谷时段怎么排任务,可以看DeepSeek V4 峰谷定价:什么时候调用更省钱,账单怎么算。
DeepSeek V4.1 Flash
官方的 deepseek-flash 由 DeepSeek-V4.1-Flash 提供服务:空闲时段输入 $0.15、缓存命中 $0.003、输出 $0.60,高峰时段翻倍为 $0.30、$0.006、$1.20。Together AI 的「DeepSeek V4.1 Flash」标价是输入 $0.30、缓存命中 $0.006、输出 $1.20,和官方高峰价完全相同。
同样按每月 100M 输入、20M 输出、不命中缓存计算,官方空闲时段 27 美元、高峰时段 54 美元,Together 54 美元。只要官方能正常开户付款,Together 在这个模型上就没有价格优势,选它的理由只能是接入、容量或条款。
托管商之间也没有全线最低的一家
换一个模型,赢家就可能换人。同样按每月 100M 输入、20M 输出、不命中缓存计算,截至 2026 年 9 月 26 日两家托管商的标价如下(每百万 tokens):
| 模型 | Together AI 输入 / 输出 | DeepInfra 输入 / 输出 | Together 月费 | DeepInfra 月费 |
|---|---|---|---|---|
| DeepSeek V4 Pro | $1.32 / $3.96 | $1.30 / $2.60 | $211.20 | $182.00 |
| Kimi K3 | $3.00 / $15.00 | $2.85 / $14.25 | $600.00 | $570.00 |
| Qwen3.7-Max | $1.50 / $4.50 | $2.50 / $7.50 | $240.00 | $400.00 |
DeepInfra 在 DeepSeek V4 Pro 和 Kimi K3 上更便宜,Qwen3.7-Max 却是 Together 低 40%。"哪家托管商最便宜"没有固定答案,每换一个模型都要重新比一次。Kimi 和 Qwen 的官方价要到各自开放平台看当日报价,再和托管价放在同一份用量里算。
看起来更便宜,其实不是同一样东西
名字相近的旧快照
DeepSeek 官方已经把旧模型名 deepseek-v4-flash 对应的模型下线,这个名字的请求现在由 V4.1-Flash 处理、按 Flash 价计费。托管商却还在卖更早的快照,价格也低得多:
| 渠道 | 模型名 | 输入 | 缓存命中输入 | 输出 | 100M 输入 + 20M 输出的月费 |
|---|---|---|---|---|---|
| Together AI | DeepSeek V4 Flash 0731 | $0.14 | $0.03 | $0.28 | $19.60 |
| DeepInfra | DeepSeek-V4-Flash-0731 | $0.06 | $0.015 | $0.18 | $9.60 |
| DeepInfra | DeepSeek-V4-Flash(未标日期) | $0.09 | $0.018 | $0.18 | $12.60 |
| DeepSeek 官方,空闲时段 | deepseek-flash(V4.1-Flash) | $0.15 | $0.003 | $0.60 | $27.00 |
这里有两个陷阱。同一个 0731 快照,两家托管商的月费相差一倍;而最便宜的几行都不是 V4.1-Flash,是更早的模型。看到"DeepSeek V4 Flash"低于官方价,先对版本号,别当成官方模型打折。
旧快照能不能用,只能拿你自己的任务测。按合格输出算,DeepInfra 的 0731 月费只有官方空闲价的 36%(9.60 ÷ 27),只要它的合格率不低于 V4.1-Flash 的 36%,每条合格输出就不会更贵。真正要算的是账单外的成本:返工、人工复核,以及托管商哪天停掉旧快照时的迁移工作。
精度和量化
开源模型换一家托管,推理精度未必相同。托管商的价目页不一定写明精度,写了的会把它放进模型名,例如 Together 列出的「Qwen3 235B A22B Instruct 2507 FP8 Throughput」。价格低不能说明降了精度,价格高也不能证明没降;能说明问题的只有同一批测试题在官方接口和托管接口上的结果对比。
厂商自己发的"最便宜"榜单
托管商和网关写的"最便宜 LLM API 提供商"榜单,常常把自己排在里面,列出的价格也不一定是同一模型、同一版本、同一计费方式。比价只用各家价目页上的原始数字自己算。
标价之外的钱:手续费、倍率和折扣
OpenRouter 的推理价格按上游原价透传、不加价,钱收在购买额度时:Standard 方案 5.5%,Business 方案 8%,Enterprise 可谈折扣。充值 500 美元,手续费就是 27.50 美元。沿用上面的 V4 Pro 例子,如果请求被路由到按官方高峰价计费的上游,实付约为 211.20 × 1.055 ≈ 222.82 美元,比直连高峰还多。
OpenRouter 还有两种情况要单独算。免费方案不收平台费,可以用 25 个以上的免费模型,但每天限 50 次请求,也不能自带上游密钥,只够试用。自带上游密钥(BYOK)时,Standard 和 Business 方案每月按标价计算的 25,000 美元推理额度内不收手续费,超出部分收 5%;限速和费用直接跟上游结算。已经有 DeepSeek 或其他厂商账号、又想用 OpenRouter 统一接口的团队,BYOK 比充值额度更省。
Fireworks 的无服务器推理按 token 计费、后付费,新账号送 1 美元额度;各模型的按量价单列在它的文档里,接入前按上面的公式代入。后付费不需要预存余额,也就没有充值手续费这一项。
网关和中转大多是预付余额,价目页上的单价再乘以令牌分组的倍率,有些模型按次而不是按 token 计费。算账时用"实际扣费 = 标价 × 倍率",按次计费的模型按"每月调用次数 × 单次价"单独算,不要和按 token 的价格混在一张表里比。
官方折扣也要确认能不能带过去。OpenAI 的 Batch 和 Flex、Gemini 的 Batch 都是半价,DeepSeek 有空闲时段半价;换成别的渠道,这些折扣只有在对方支持对应接口或时段规则时才存在。Together 的价目页另有一栏批处理价格,异步任务值得单独比一次。
闭源模型:以官方价为底线
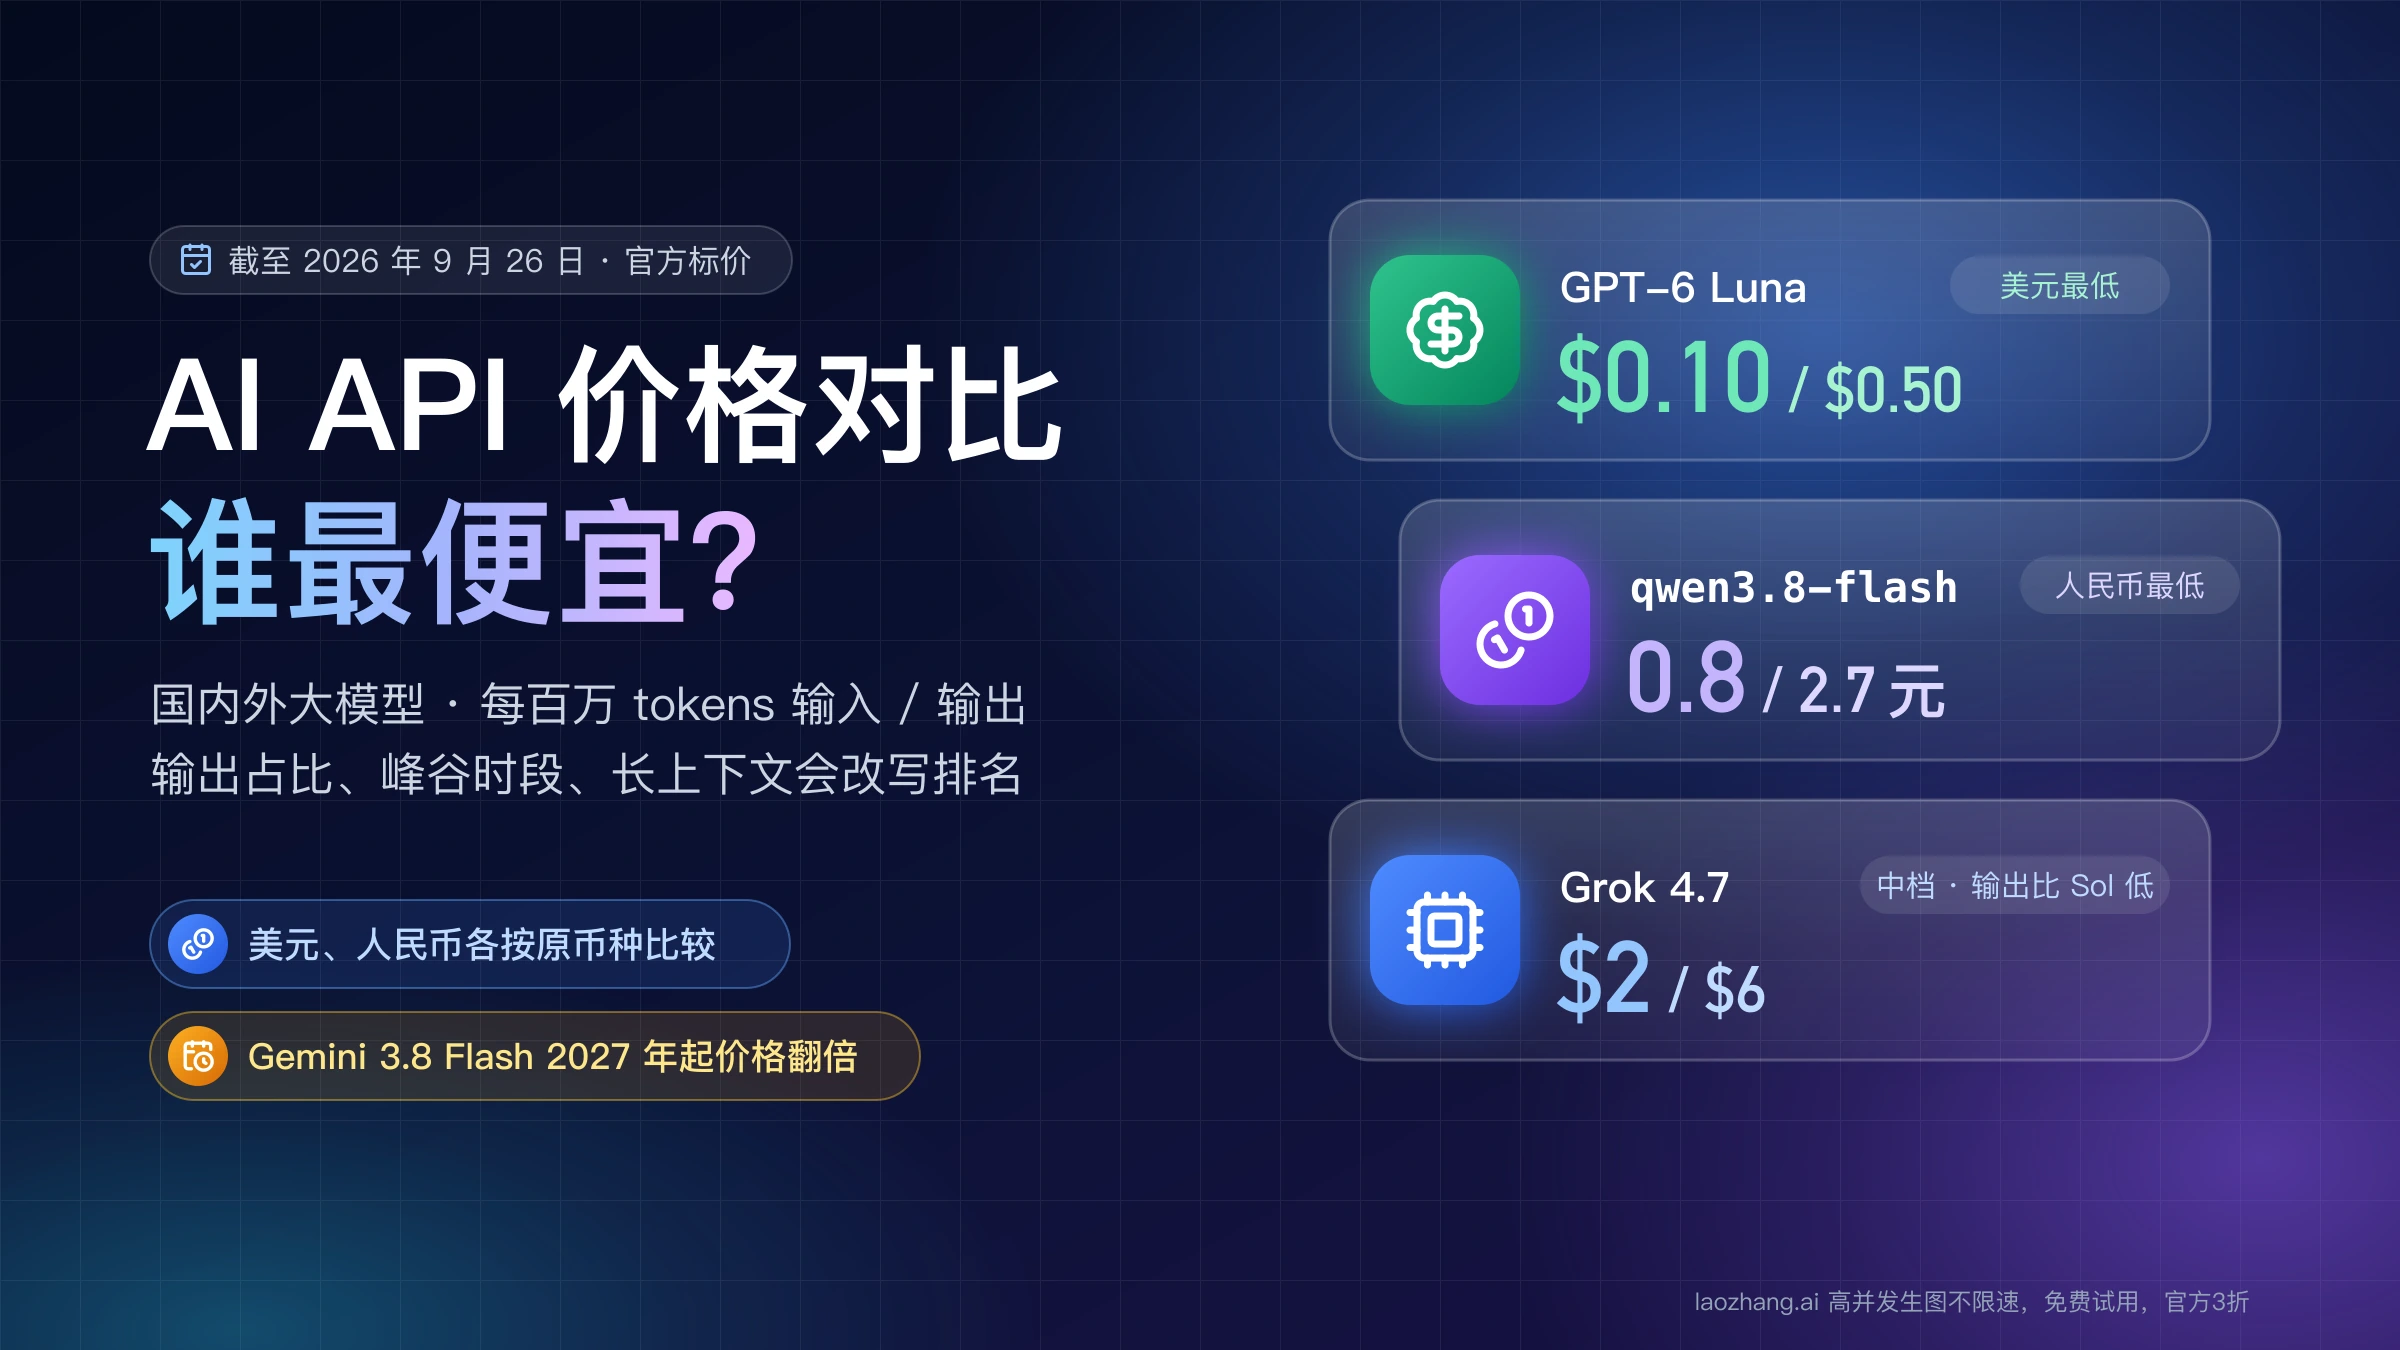
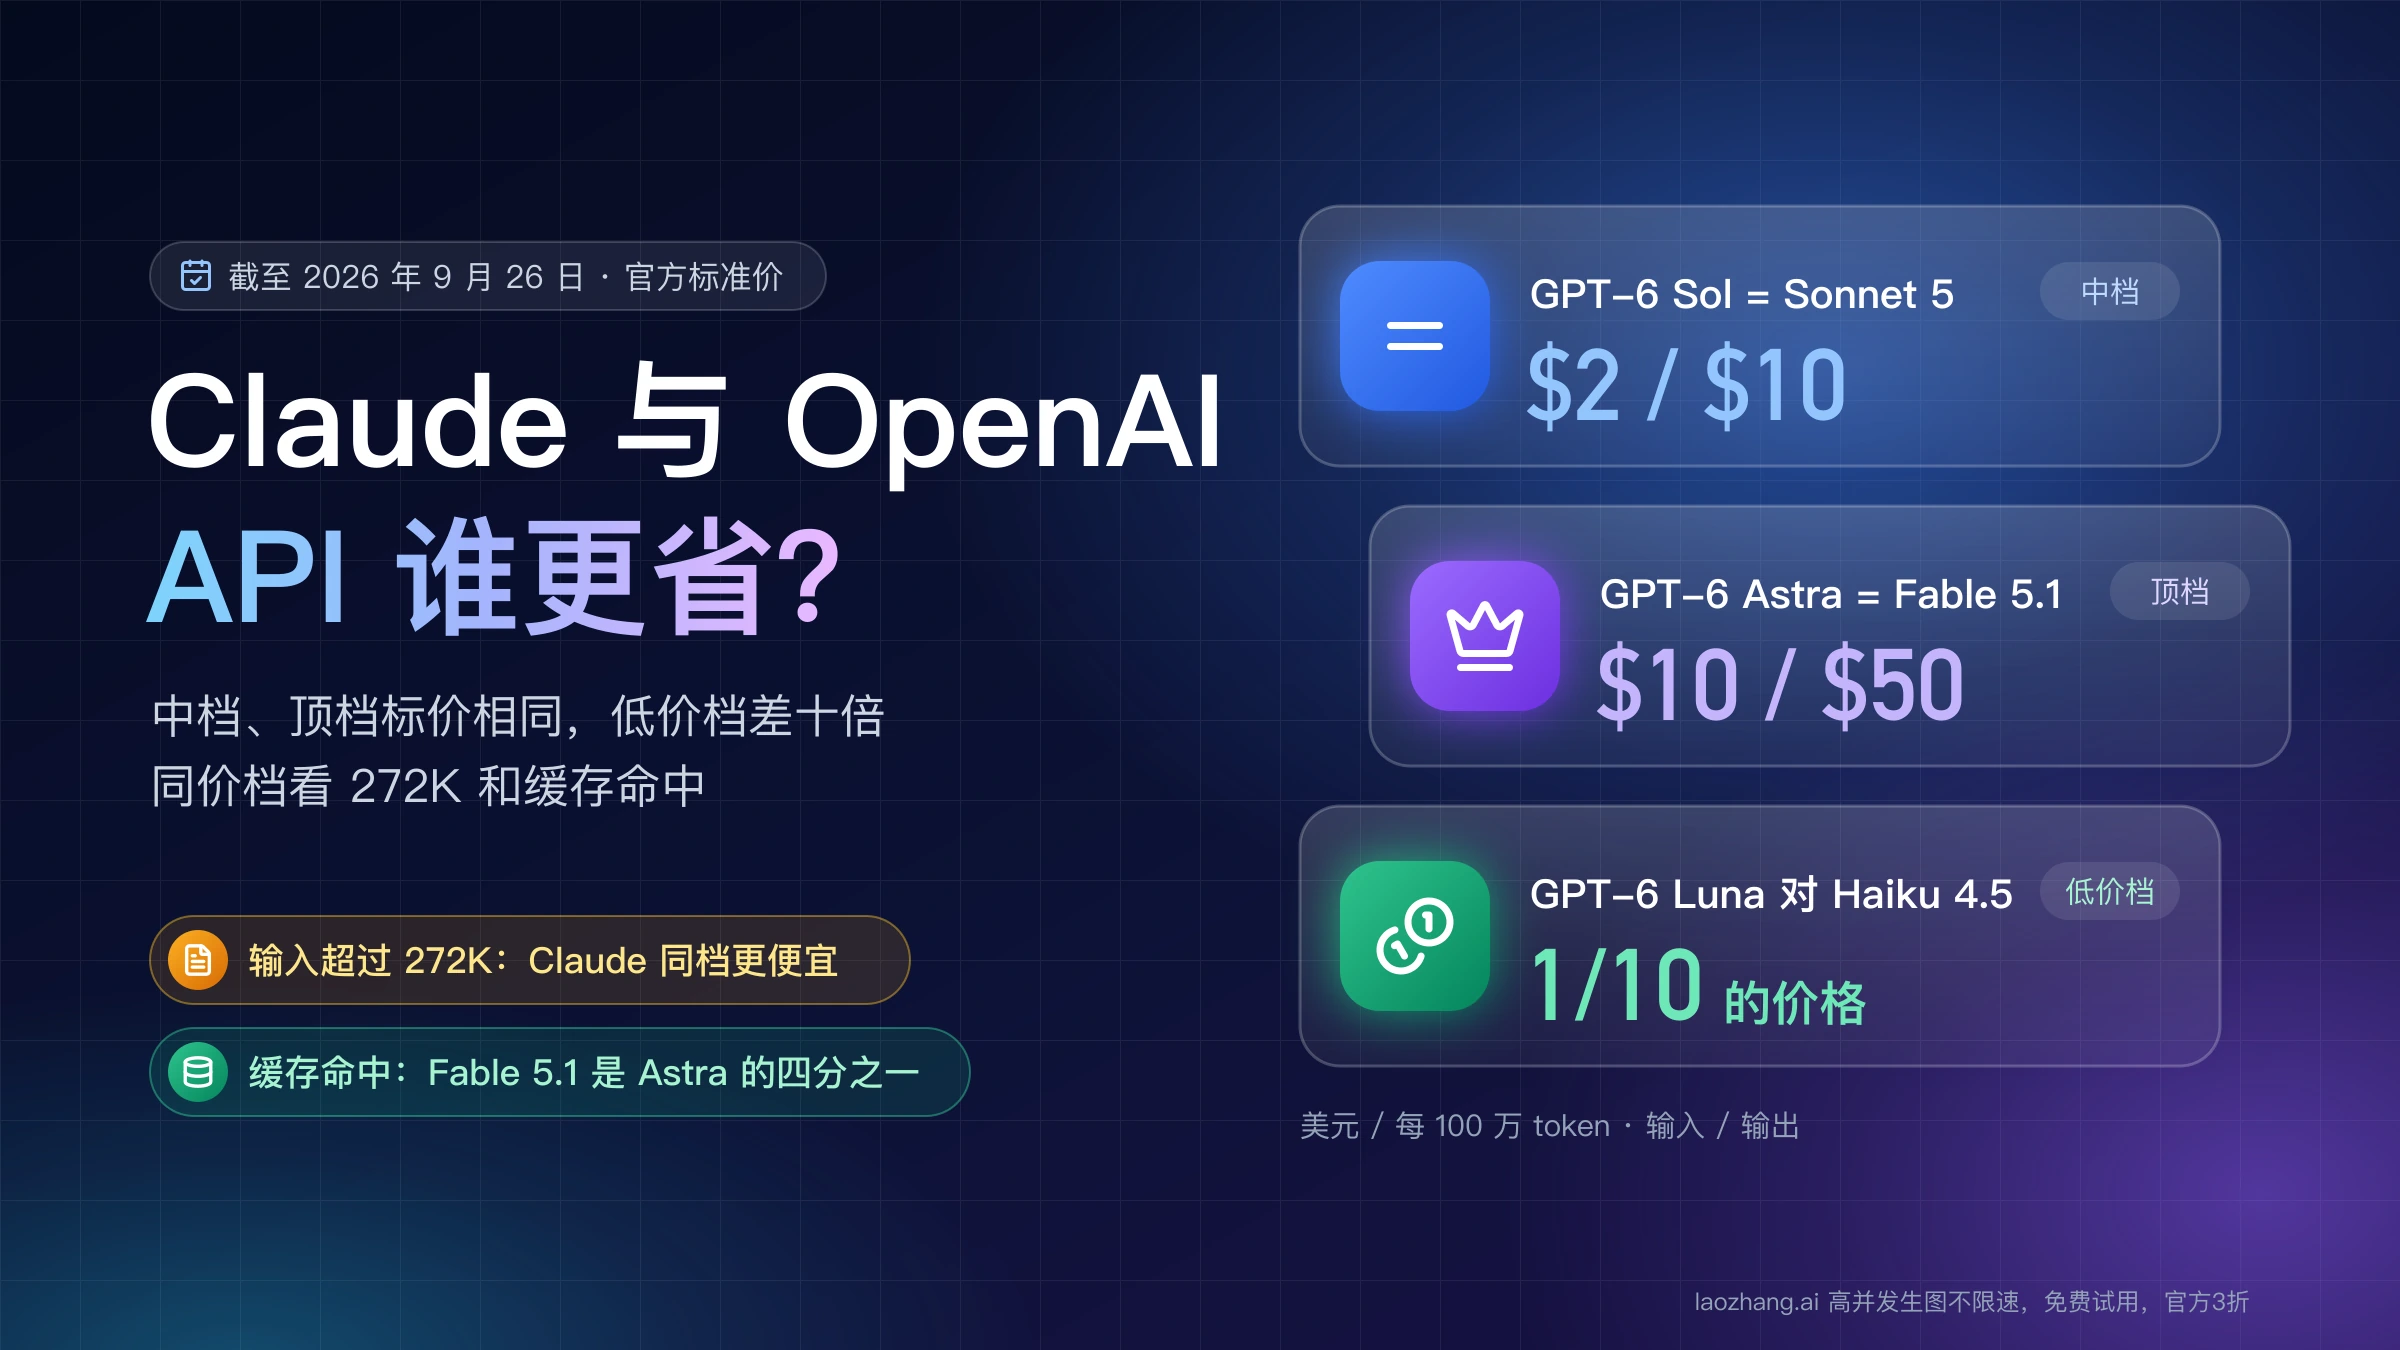
闭源模型不公开权重,托管商拿不到,其他渠道卖的是官方或其授权平台的接口,比价就以官方标价为底线。例如 OpenAI GPT-6 Luna 官方每百万 tokens 输入 $0.10、输出 $0.50,Claude Haiku 4.5 是 $1 和 $5,Gemini 3.8 Flash 在 2026 年 12 月 31 日前是 $0.75 和 $3.75、之后涨到 $1.50 和 $7.50,Grok 4.7 是 $2 和 $6。经 OpenRouter 充值调用,实付约为标价 × 1.055;经网关或中转,是标价 × 分组倍率。
如果某个渠道的闭源模型价格低于官方,先问清三件事:上游是谁,调用的是不是同一个模型 ID,计费口径是否一致。Claude 与 GPT 之间怎么选,看Claude 与 OpenAI API 价格对比:按任务算谁更省;Grok 的长上下文加价和月费算法,看Grok API 价格:每百万 token 多少钱、月费怎么算。
laozhang.ai 与国内中转:用同一套标准看
中转和网关在国内开发者里很常见,它们卖的主要是接入方便:一个兼容接口、一个余额、不用逐家开户。价格高低要看平台自己的价目页,检查项和其他渠道一样。
以 laozhang.ai 为例,它是 YingTu Technology Pte. Ltd.(新加坡)运营的 API 网关,公开文档里写明的情况如下:
- 接入:OpenAI SDK 用
https://api.laozhang.ai/v1一个地址,也支持 Anthropic Messages 格式(/v1/messages)和 Gemini 的generateContent;默认地址连不上时可换api2.laozhang.ai。 - 计费:预付余额;按模型不同,按 token 用量或按次计费;部分令牌分组有价格倍率。每个模型的价格、分组和端点列在"模型与价格"页,调用日志显示每次请求扣了多少。
- 身份:提供对第三方模型的技术接入和路由,不是这些模型的官方运营方。
- 数据:默认不存储、不查看提示词和回复内容,请求交给所选上游处理;计费、安全、限速和排障所需的元数据(时间、模型、用量、状态、延迟)会保留。
- 开户:注册需要 Gmail 邮箱,服务开通要经过白名单审核;支付走 Stripe。
适合它的情况:你要在一个 OpenAI 或 Anthropic 兼容端点里同时调用多家模型,希望用一个预付余额统一记账,直接开各家官方账号不方便。不适合的情况:你只用一个模型,而且能直接在官方付款,那官方直连最多和它一样便宜,还能拿到空闲时段或 Batch 折扣。具体价格以laozhang.ai 控制台和模型与价格页当日显示为准,接入细节见Claude 稳定接入怎么选:Anthropic 直连、云平台,还是 laozhang.ai 网关?。
其他中转按同样的问题过一遍:模型 ID 和版本与官方是否一致、倍率多少、按 token 还是按次、失败请求扣不扣费、余额能否退、内容存不存。说不清上游和版本的,再便宜也只适合测试。在客户端里配置中转的具体步骤,可以参考OpenClaw 国内使用完整指南:API 中转配置、模型选择与成本优化(2026)。
国内云平台与免费额度
阿里云百炼、百度千帆、火山引擎、硅基流动这类平台既卖自家模型,也托管开源模型,同样适用"同模型、同版本、同用量"的算法。它们给新用户的免费 tokens 适合试用,不是长期单价;额度多少、多久过期、用完后按什么价计费,见免费 AI API 推荐:国内外平台怎么选,额度用完会怎样。
按合格输出算账,再切流量
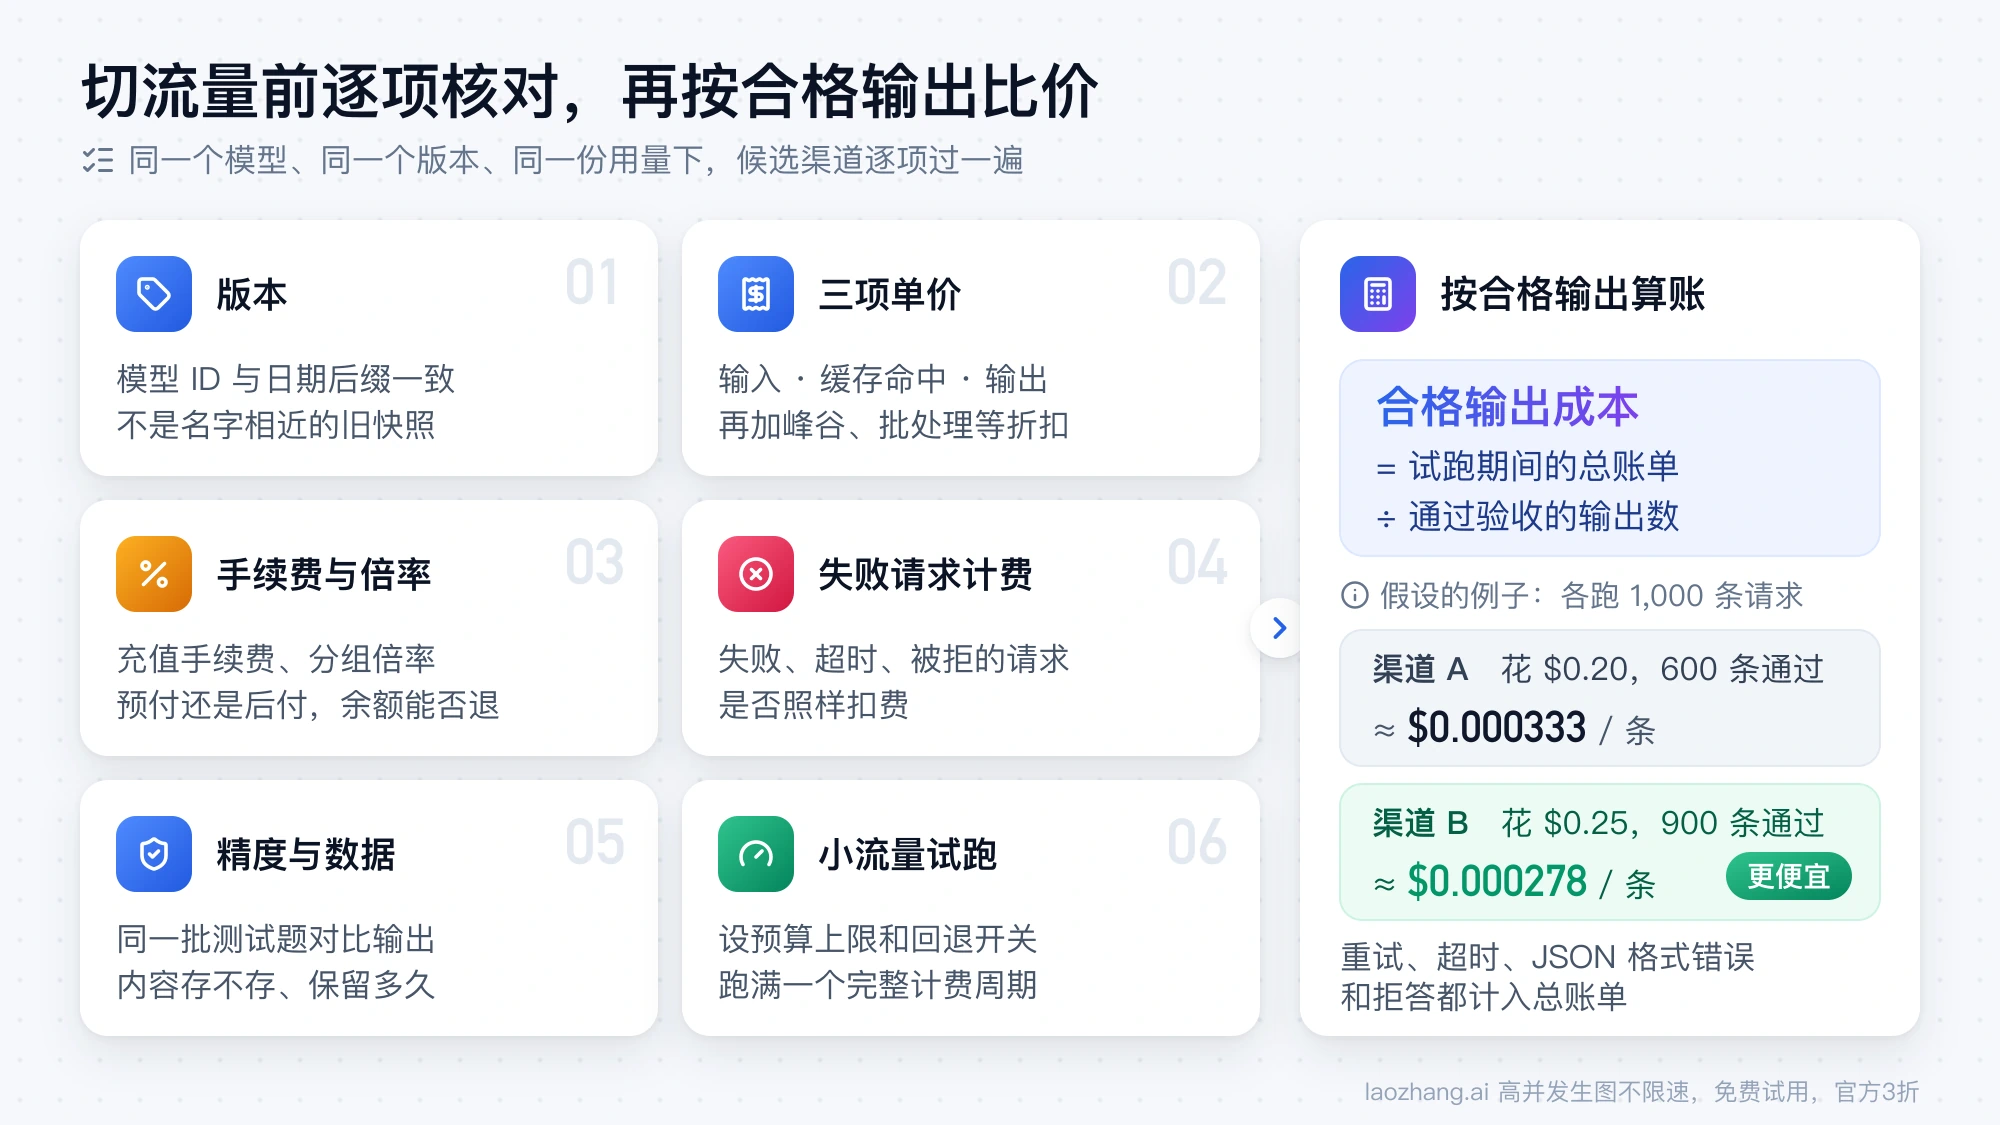
单价只决定每个 token 多少钱,真正要比的是每条合格输出多少钱:
合格输出成本 = 试跑期间的总账单 ÷ 通过验收的输出数
举个假设的例子:渠道 A 跑 1,000 条请求花 0.20 美元,600 条通过验收,每条合格输出约 0.000333 美元;渠道 B 花 0.25 美元,900 条通过,每条约 0.000278 美元。B 的单价更高,按合格输出反而更便宜。重试、超时、JSON 格式错误和拒答都要计入总账单,因为它们同样在扣费。
切流量前,把候选渠道逐项过一遍:
- 模型 ID 和版本(包括日期后缀)与你测试时用的一致,不是名字相近的旧快照。
- 输入、缓存命中输入、输出三项单价都记下来,再加上峰谷、批处理、长上下文等会改单价的条件。
- 缓存怎么判定命中,命中价是多少;缓存命中率高的任务,这一项可能决定胜负。
- 充值手续费、分组倍率、最低充值,预付还是后付,余额能否退。
- 失败、超时和被拒的请求是否计费。
- 并发和速率上限够不够你的高峰流量。
- 精度与上下文长度是否与官方一致,用同一批测试题对比输出。
- 内容是否存储、元数据保留多久;涉及密钥、个人信息或未公开代码的,先看大模型 API 数据保留 vs 零数据保留:上线前怎么核验。
- 先放一小部分流量,设好预算上限和回退到原渠道的开关,跑满一个完整的计费周期再看账单。
GLM 这类开源模型也按这个流程走。比如 GLM-5.3-Flash 在 Together 标价输入 $0.15、缓存命中 $0.03、输出 $0.50,官方价要到智谱开放平台看当日报价;模型本身的特点见GLM-5.3-Flash 选型指南:从 Ox Alpha 到 API 与本地部署。
常见问题
中转或聚合平台会比官方便宜吗?
闭源模型一般不会。OpenRouter 按原价透传,另收 5.5% 的充值手续费;网关和中转在标价上乘分组倍率。价格低于官方的渠道,要先确认上游、模型版本和计费口径是否与官方相同。开源模型则可能更便宜,因为托管商自己定价,DeepInfra 的 DeepSeek V4 Pro 输出价就比官方高峰价低三分之一左右。
DeepSeek 在哪买最便宜?
V4.1 Flash 在官方直连最便宜,Together 的价格等于官方高峰价。V4 Pro 看调用时段:空闲时段官方最省;不命中缓存时,高峰时段用量超过约 72%,DeepInfra 更省。比 DeepSeek 官方便宜很多的"V4 Flash",多半是 0731 等旧快照,不是官方现在的 V4.1-Flash。
托管商的开源模型会被量化吗?
有可能,而且价目页不一定写。有的托管商会把 FP8 之类的精度写进模型名,没写的要看模型详情页或直接问。判断质量是否下降,最可靠的办法是拿同一批测试题分别调用官方接口和托管接口,对比通过率。
免费额度能算最便宜的方案吗?
只能算试用。OpenRouter 免费方案每天限 50 次请求,国内云平台的免费额度有总量或每日上限,用完按正常价计费。长期成本仍按付费单价、手续费和合格率来算。