Jev 模型是什么:和 LLM 怎么分工,怎么接入
Jev 不写文字,只从你定义的选项里给出答案和概率,适合分类、路由、打分;截至 2026 年 9 月 24 日输入 $0.042/百万 token、输出免费,中文要先自测。
文章目录
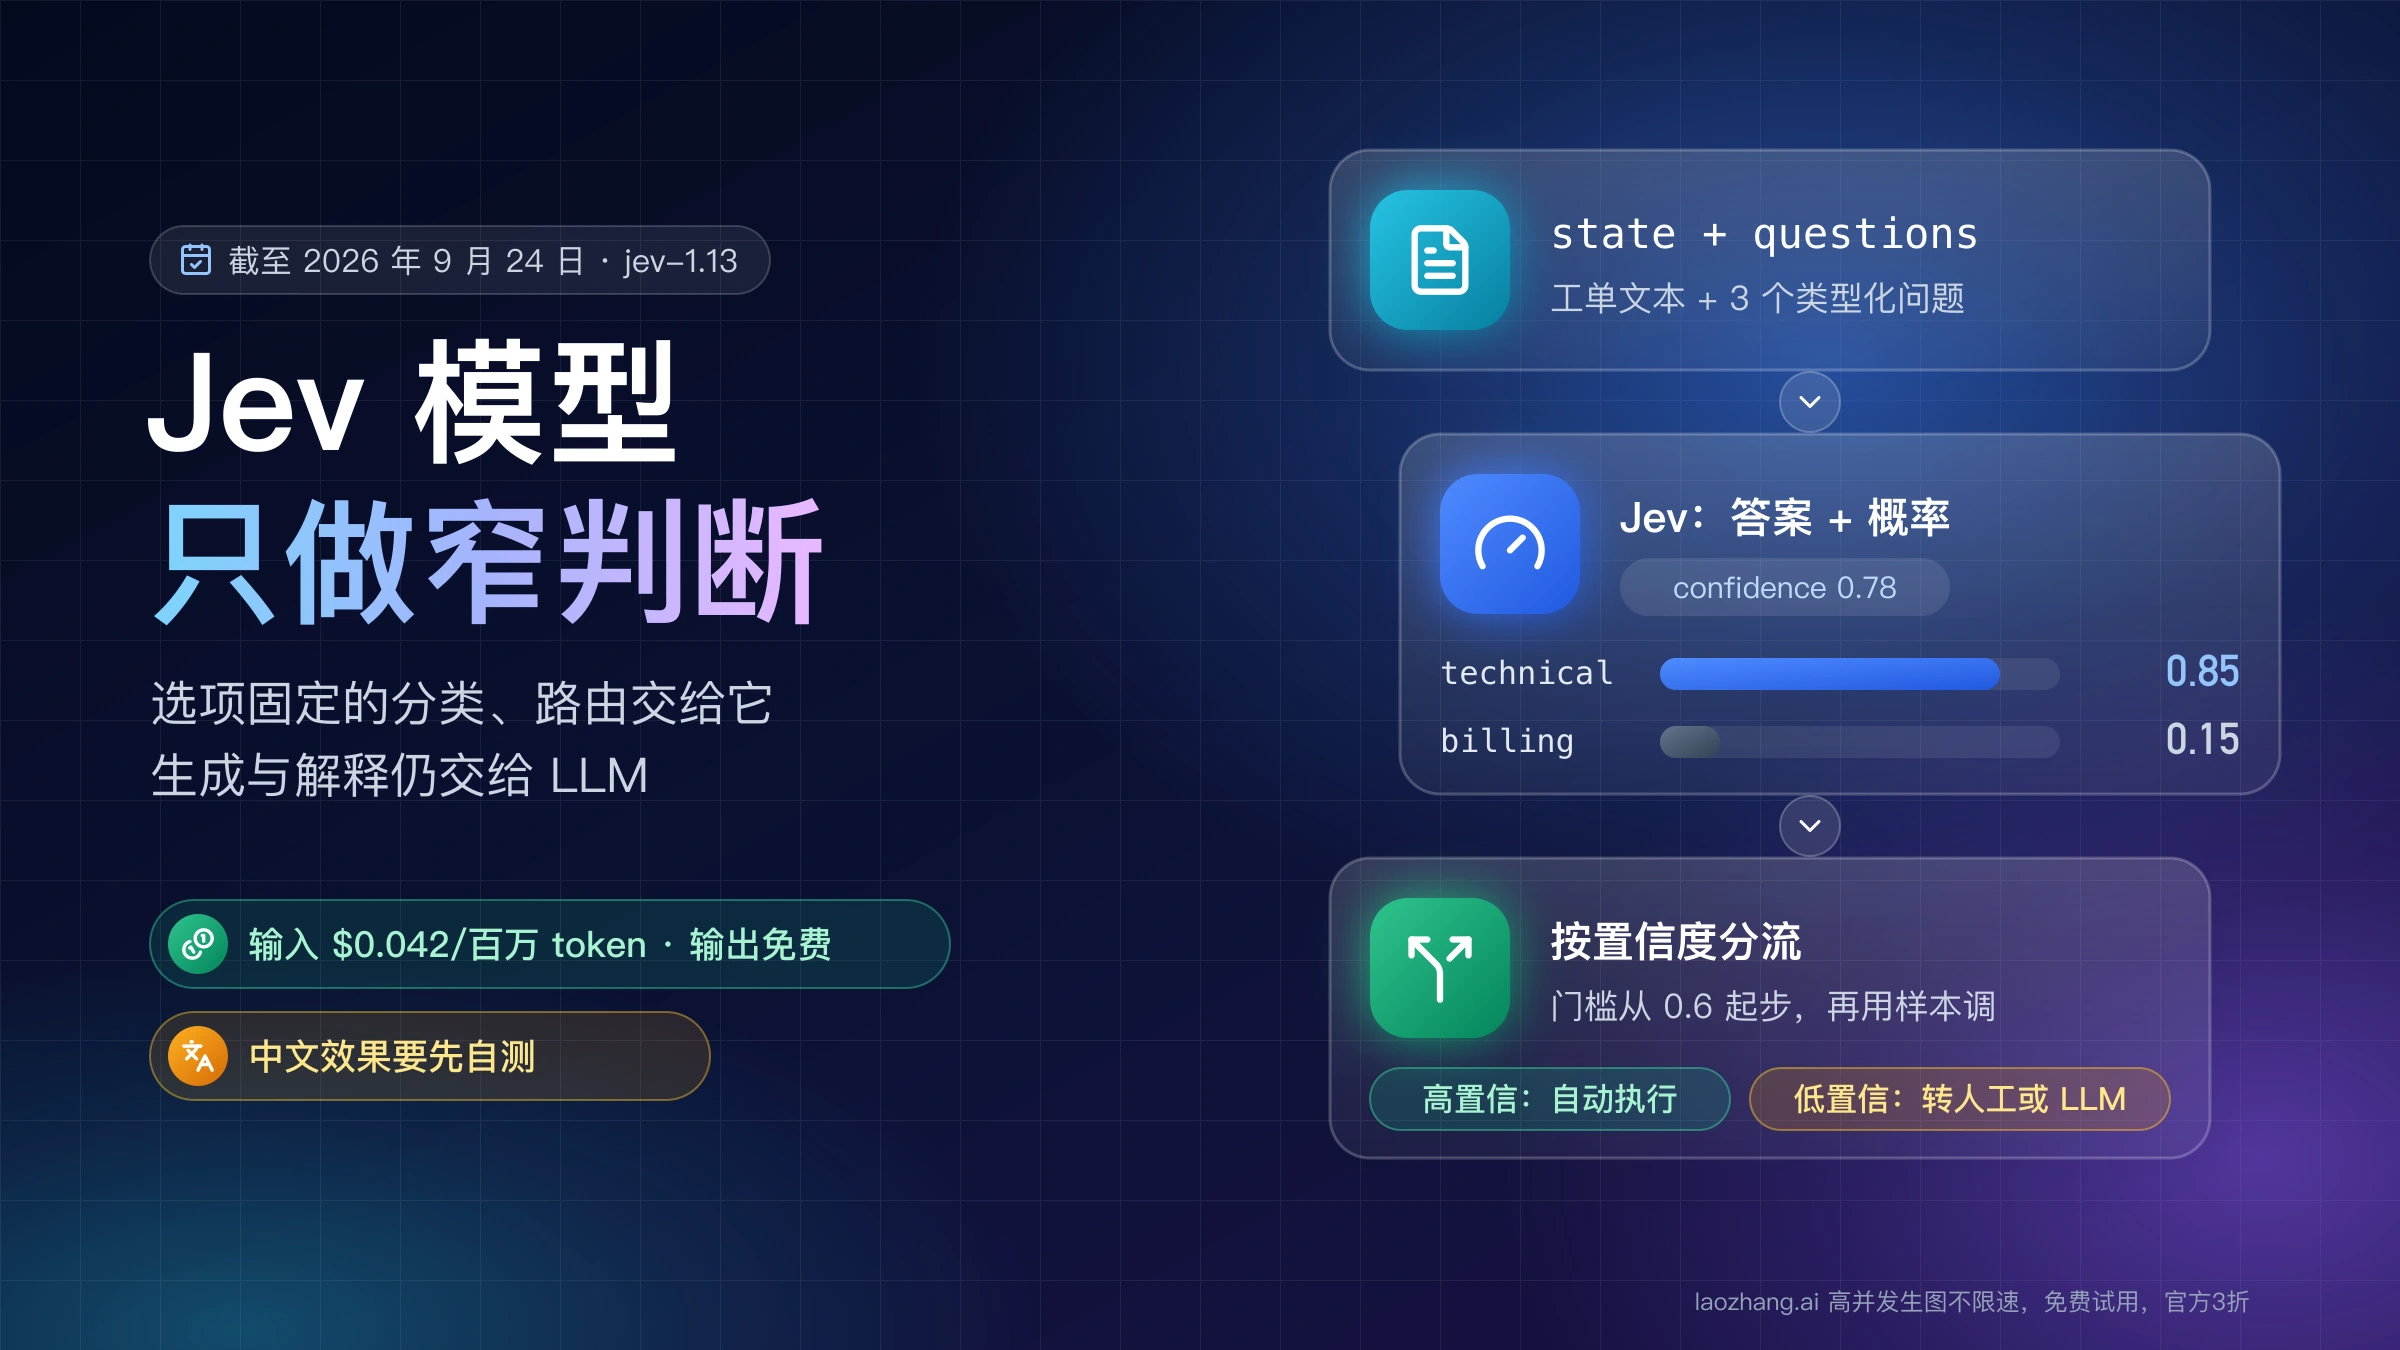
Jev 是 TypeSafe AI 在 2026 年 9 月 15 日发布的第一个模型。它不写文字:你给它一段内容(官方叫 state)和几个事先定义好选项的问题,它在一次请求里并行回答,每个答案都带概率。它能替代的是这样一类调用:问大模型一个很窄的问题,再从它的回复里解析出一个标签。工单分给哪个组、这条消息是不是垃圾信息、Agent 下一步继续还是停下,都属于这一类。写回复、做总结、解释理由、写代码,它都做不了。
截至 2026 年 9 月 24 日,官方直连的价格是输入 $0.042/百万 token,输出不收费;9 月 20 日起已取消候补名单,不用再申请排队。第一次接入可以走官方 console,也可以只用 OpenRouter 的 key。真正决定能不能上线的是另外三件事:你的判断能不能拆成"几秒钟凭直觉就能答"的小问题;中文内容上准确率够不够;低置信度的结果交给谁。
Jev 是什么:给定选项,返回答案和概率
TypeSafe 把 Jev 叫作 System One 模型。这个名字来自卡尼曼《思考,快与慢》里的"系统 1",也就是快速、凭直觉的判断,与之相对的是慢速推理的"系统 2"。Jev 这个名字取自经济学家杰文斯(杰文斯悖论)。公司创始人 Diogo Almeida 曾在 OpenAI 参与指令跟随方面的研究,这些研究后来成了 ChatGPT 的基础。按发布文章的说法,Jev 用了新的模型架构、并行采样器和一种叫 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)的训练方法。
一次调用由两部分组成:state 是要判断的内容,可以是字符串、JSON 对象或文本数组;questions 是一组你自己命名的问题。问题只有三种:
| 问题类型 | 回答什么 | 返回字段 | 限制 |
|---|---|---|---|
| Choice | 从你列出的选项里挑一个 | choice、每个选项的 probabilities、confidence | 每个 Choice 最多 255 个选项 |
| Score | 在一组有序等级上打分 | score(按概率加权,可以落在两级之间)、legend、probabilities、confidence | 至少 2 级,API 最多接受 10 级 |
| Noul | 一个陈述是否成立 | noul,0 到 1 之间的"是"的概率,没有 confidence | criteria 可选,用来说明"是"和"否"分别指什么 |
Noul 不是 null 拼错了。据 Simon Willison 引述 TypeSafe CEO 在 Hacker News 上的回复,它取自伯努利分布(Bernoulli)。Vercel AI SDK 把同一种问题叫 boolean,两个名字指的是同一件事。
同一个 state 上的所有问题并行评估,互不影响,一个问题的答案不会变成另一个问题的上下文。所以官方建议每个问题只问一件事,复杂判断拆成多个原子问题,再在代码里组合。拆开不会增加往返次数,它们还在同一个请求里。
有两个宣传说法需要拆开看:
- "不会幻觉 / 0% 类型错误":答案只能落在你定义的选项和结构里,这是构造上保证的,发布文章自己也说这个 0% "不是经验数字"。它保证的是格式不会出错,不保证选中的选项是对的。
- "校准概率":意思是模型说 0.8 的时候,大约 80% 的情况下确实是对的。这是 RLCD 的训练目标,实际效果要在你自己的数据上验证(后面有一份第三方测试可以参考)。
另外几件常被问到的事:Jev 本身不开源,只提供 API 和开源的 Python、JS SDK;不支持按客户微调或 LoRA,所有账号用同一套权重,适配领域靠 state、问题措辞和拆分;官方说明不拿客户请求训练模型,企业客户可以谈零数据保留(ZDR)。
哪些判断交给 Jev,哪些留给代码和 LLM
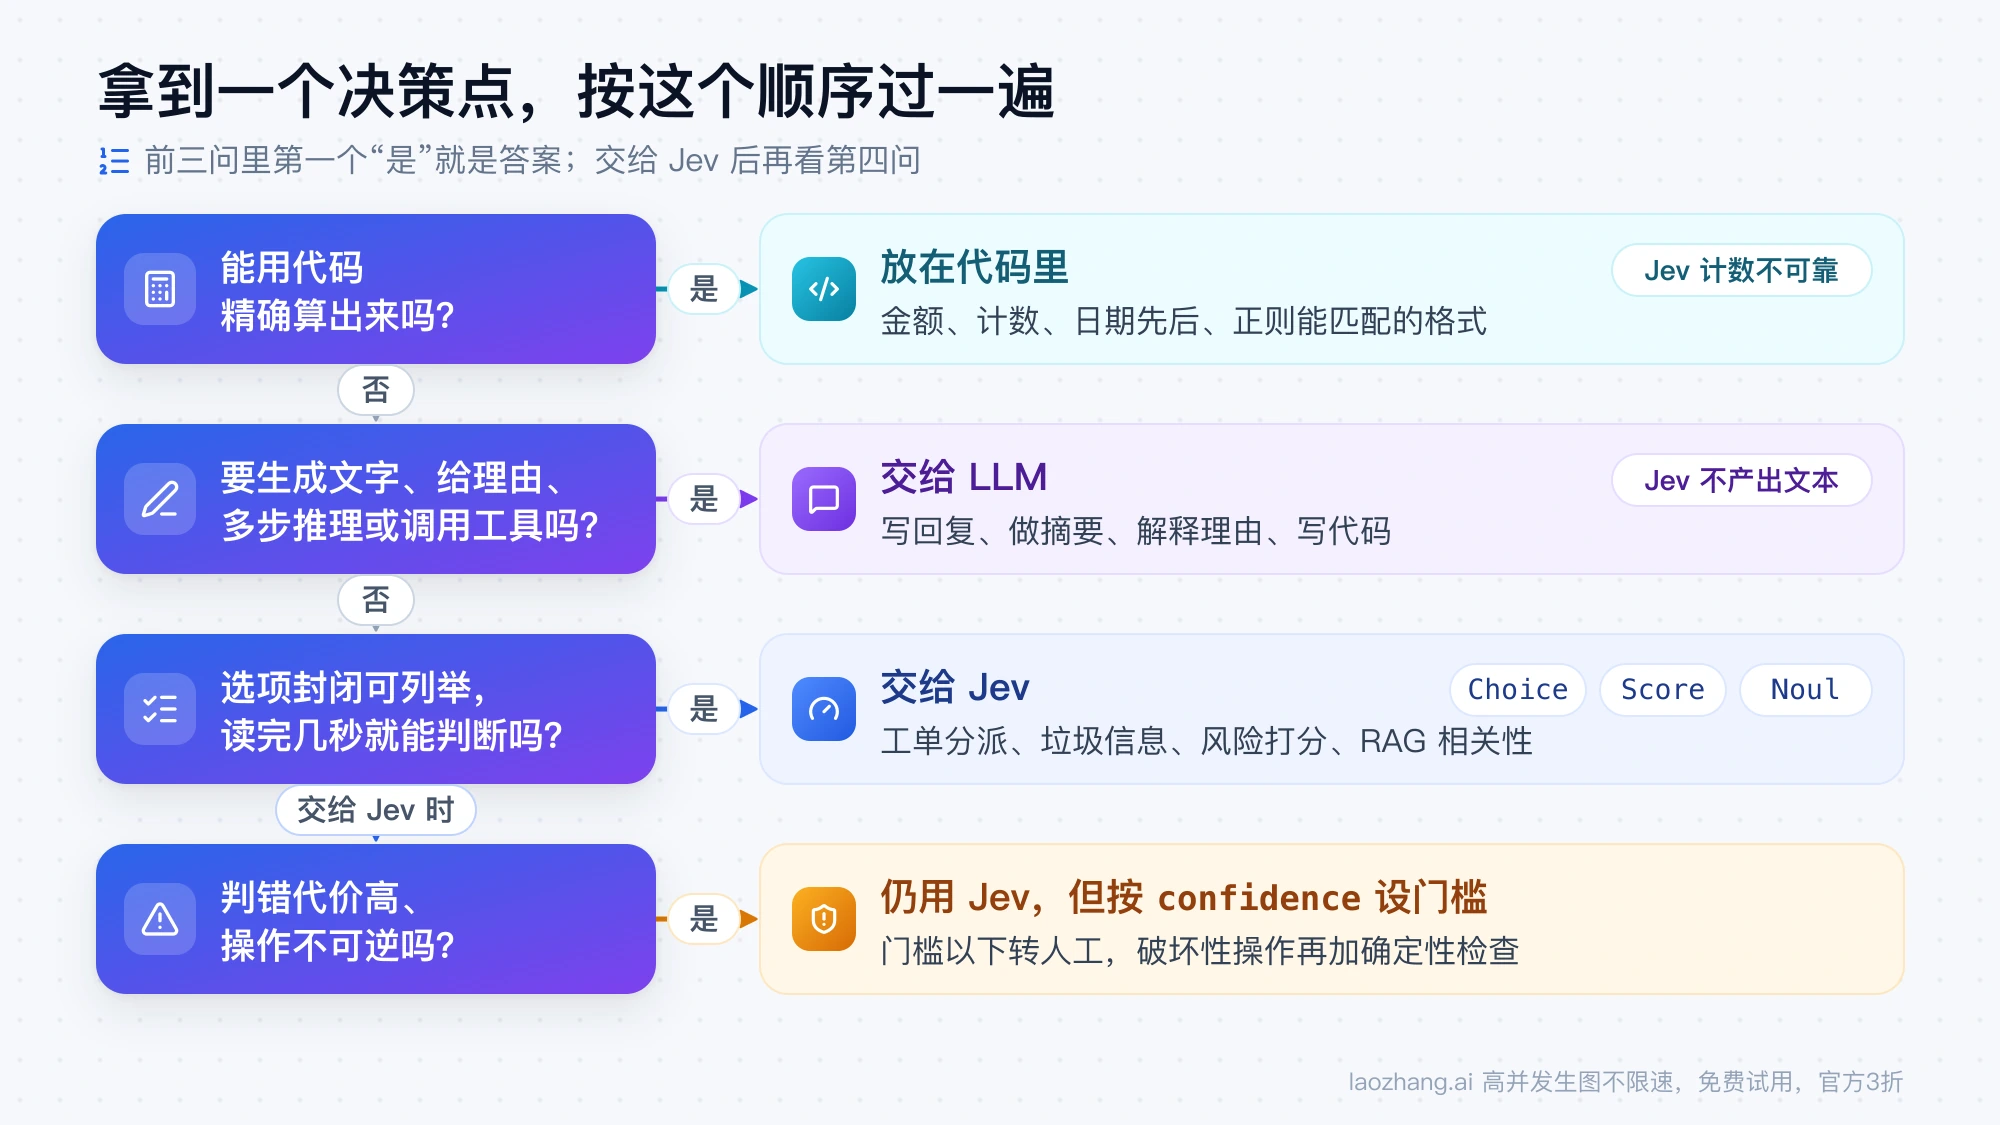
拿到一个决策点,按下面的顺序过一遍,第一个"是"就是答案:
- 能用代码精确算出来吗?金额、计数、日期先后、正则能匹配的格式,都放在代码里。Jev 1.13 的已知弱点里明确写了:计数不可靠,日期先后比较不可靠,拿十六进制色值这类数值表示来问,也不如换成语义说法。
- 需要生成文字、给出理由、多步推理或调用工具吗?交给 LLM。Jev 不产出文本,也不给理由。
- 答案空间是封闭、可以列举的吗?这件事一个熟练的人读完内容几秒钟就能判断吗?两个都是,交给 Jev。
- 判断错了代价很高、操作不可逆吗?即使交给 Jev,也要按
confidence设门槛,门槛以下转人工;破坏性操作再加一层确定性检查。
按这个顺序,常见场景大致这样分:
| 决策点 | 交给谁 | 原因 |
|---|---|---|
| 工单分派到哪个组、意图识别 | Jev(Choice) | 选项固定,读一遍就能判断 |
| 这条消息紧不紧急、是不是垃圾信息 | Jev(Noul) | 单一陈述,是或否 |
| 风险、情绪、质量打几级 | Jev(Score) | 有序等级,可以按阈值分支 |
| RAG 检索片段和问题相不相关、搜索结果重排 | Jev | 每个候选问一次,代码排序 |
| Agent 下一步:继续、重试、问用户还是停止 | Jev + 代码兜底 | 选项固定;循环次数、预算等硬约束放代码 |
| 检查另一个模型的输出是否有依据、是否越权 | Jev | 判断题,适合批量跑 |
| 发票是否逾期 30 天、订单金额是否超限 | 代码 | 纯计算 |
| 给客户写回复、生成摘要、解释为什么这样判 | LLM | 需要生成文本 |
| 招聘筛选、信贷这类涉及偏见风险的排序 | 人工为主 | 只有一个数,看不到依据 |
最后一行来自 Simon Willison 的提醒:Jev 只给一个浮点数,不说是哪些信号让它这样判,可解释性比 LLM 还要倒退一步,偏见很难排查。
实际系统里更常见的是组合使用:Jev 负责快速判断,高置信的结果直接执行,低置信的转人工或转给 LLM 再看一遍;需要一段书面理由时,让 LLM 根据 Jev 的结论写。负责生成和兜底的那一段可以接任何 OpenAI 兼容接口,例如 laozhang.ai(https://api.laozhang.ai/v1);laozhang.ai 不提供 Jev 本身。Agent 里"继续还是停下"这类判断,可以和AI Agent 工具调用死循环怎么停:重复检测、错误分类与熔断里的计数与熔断配合,计数交给代码,语义判断交给 Jev。
还有一点:Jev 不能替换 Claude Code、Cursor、Copilot 背后的模型。官方文档专门说明,没有哪个 model: "jev-latest" 设置能把编程 Agent 变成 Jev 驱动的。你可以让编程 Agent 写调用 Jev 的代码,TypeSafe 为此提供了一个 agent skill(安装命令见后文教程)。
Jev 与让 LLM 输出 JSON 做分类的对比
不用 Jev 的话,同样的事通常是让 GPT、Claude 或 DeepSeek 按 JSON 格式输出一个标签。两种做法的差别在这些地方:
| Jev 1.13 | LLM 输出 JSON | |
|---|---|---|
| 输出 | 只能是你定义的选项,不用解析 | 生成文本再解析、校验,可能出现格式错误或越界标签 |
| 概率 | 每个选项都有概率,Choice/Score 另给 confidence | 需要让模型自报置信度,发布文章认为自报的往往偏高、不稳定 |
| 计费 | 只收输入,$0.042/百万 token | 输入和输出都收,输出通常更贵 |
| 延迟 | 厂商称端到端 70 到 500 毫秒 | 取决于模型,开启推理后可能到几十秒 |
| 理由 | 没有 | 可以一并输出理由,但理由不一定可靠 |
| 语言 | 英语最好,其他语言"能处理但不一样好" | 取决于所选模型 |
| 能做的事 | 只做判断 | 判断、生成、抽取、调用工具都能做 |
TypeSafe 官网上"快 193.6 倍、便宜 444.6 倍"这组数字来自它自己的 workflow 评测:参考答案取 GPT-6 Astra 和 Fable 5.1 的平均,workflow 由自家团队编写,延迟从美国西海岸的笔记本测得(服务目前也部署在美国西海岸),官方自己说这是"真实收益里偏高的一端"。从国内调用要多算一段跨洋网络延迟。
目前能找到的较完整的独立测试来自 Emil Lindfors。他在 2026 年 9 月 18 日用 jev-1.13.0 读了 24 份挪威语的税收听证回复,每份问 11 个问题,参考标签由 Claude Fable 5.1 两次独立标注,对照组是经 OpenRouter 调用的 DeepSeek V4.1 Flash(同样的问题放进一个提示词、输出 JSON,分别关闭和开启推理):
| 指标 | Jev 1.13 | DeepSeek 推理关 | DeepSeek 推理开 |
|---|---|---|---|
| 立场(4 选 1) | 20/24 | 20/24 | 22/24 |
| 回复者类型(6 选 1) | 21/23 | 22/23 | 23/23 |
| 论点是非题(192 个) | 0.86 | 0.89 | 0.88 |
| 论述深度(精确等级) | 19/24 | 14/24 | 14/24 |
| 每千份成本 | $0.22 | $1.31 | $3.08 |
| 中位延迟 | 0.32 秒 | 2.7 秒 | 26 秒 |
| 最慢一次 | 1.3 秒 | 17.9 秒 | 250 秒 |
读这张表要带着三个条件:这是与前沿模型标签的一致率,不是正确率;24 份样本下,立场指标的 95% 区间约为上下 15 个百分点,作者自己的结论是三者在立场和论点上没有差别;DeepSeek 的请求被 OpenRouter 分到 13 个服务商,延迟是混合值。
比准确率更有参考价值的是概率的表现。Jev 在立场题上给出 0.9 以上最高概率的 15 份里,有 14 份与参考标签一致;回复者类型题上 20 份全部一致;低于 0.9 的那部分一致率明显下降(立场 6/9,类型 1/3)。反过来,开启推理的 DeepSeek 自报 0.7 到 0.9 之间的论点判断,只有 48% 与参考一致。这正是 Jev 在生产里的用法:接受高置信的大部分,把剩下的交给更慢的系统或人。
所以 Jev 会不会取代 LLM?在它擅长的窄判断上,它的优势是延迟、成本和可用于设阈值的概率,而不是准确率显著更高;在生成、解释、推理、工具调用上,它根本不参与竞争。如果你的应用一天只有几百次分类调用、对延迟也不敏感,现有 LLM 的账单本来就很小,换 Jev 的收益有限。
成本和吞吐怎么算
Jev 只按输入 token 计费,state 和所有问题的文字(instructions、criteria)都算输入:
费用 = 请求数 × 每次请求的输入 token × $0.042 ÷ 1,000,000
几个可以直接复算的例子:
- 官方 quickstart 里那个 3 个问题的工单请求,返回的
usage.input_tokens是 392。每次约 $0.0000165,1 万次约 $0.16。 - 假设每次请求 400 个输入 token、每月 100 万次:4 亿 token × $0.042/百万 = $16.8。
- 同样 4 亿输入 token,放到发布文章引用的 LLM 输入价区间($0.20 到 $10/百万)里,只算输入就是 $80 到 $4,000。再假设每次输出 50 token 的 JSON、输出单价按发布文章说的约为输入的 5 倍,5,000 万输出 token 还要加 $50 到 $2,500。开启推理的模型会多出大量思考 token:Lindfors 的测试里,DeepSeek 为 24 份文档写了 4.7 万个思考 token。
- 媒体报道注册送 $5 额度(官方页面没有写明,以 console 显示为准):$5 ÷ $0.042/百万 ≈ 1.19 亿 token,按每次 400 token 算约 30 万次请求。
想把 $0.042 放到更多模型的价格里比较,可以看LLM API 价格比较 2026:按输入和输出 Token 找最低价模型。
有三个变量会让你的账单偏离上面的估算:
- 中文每个 token 对应多少字,官方没有公布。Lindfors 测得 Jev 的分词器在挪威语上约 2.06 个字符/token,比英语少得多。中文先拿几十条真实样本调一次,看
usage.input_tokens,再按实际均值估算,不要按英文经验换算。 - 速率上限先到的往往是请求数。官方直连的 jev-1.13.0 上限是每秒 25 万 token、每分钟 1,200 次请求。每次 400 token 的话,每秒 20 次请求只用掉 8,000 token/秒,请求数先顶满:100 万次单问题请求至少要跑 833 分钟,约 13.9 小时。批量任务应该把同一
state上的多个问题合进一个请求。官方也提醒这些上限正在动态调整,可能不经通知变化。 - 价格本身可能变。发布文章承认"无法证明价格没有补贴",同时表示预计会降不会升。
三条接入路线:官方直连、OpenRouter、Vercel
| TypeSafe 官方直连 | OpenRouter | Vercel AI Gateway | |
|---|---|---|---|
| 需要的账号 | TypeSafe console 账号和 API key | 只要 OpenRouter key,不需要 TypeSafe 账号 | Vercel 账号 |
| 接口 | POST https://api.typesafe.ai/v1/systemone | System One API POST https://openrouter.ai/api/v1/systemone,或 Decisions API POST https://openrouter.ai/api/alpha/decisions(alpha) | AI SDK 7 的 experimental_evaluate(7.0.105 起) |
| 模型名 | jev-latest、jev-preview、jev-1.13.0 | typesafe/jev-1.13、~typesafe/jev-latest | typesafe-ai/jev |
| 上下文 | 每请求 64k;state + 最长单个问题 ≤ 32k | 32,000 token(state + 问题) | 模型页未列出 |
| 计费 | 输入 $0.042/百万,输出免费 | 同价,走 OpenRouter 余额,响应里带 usage.cost | Vercel 称免费到 9 月 25 日,之后的价格看 Vercel 模型页 |
| 适合 | 需要完整上下文、官方 SDK 与最新文档 | 已有 OpenRouter 账户、不想再开一个账号 | 已经在用 Vercel AI SDK |
三点补充:
- 官网和文档里仍写着 "early access",但 TypeSafe 在 X 上的帖子标题是 "Jev is now available to everyone. No waitlist.",36氪、Crypto Briefing 等也报道了 9 月 20 日开放注册。能否在你所在地区注册和付款,看 console 实际页面。
- OpenRouter 的 32k 和官方直连的"64k 总量、
state加最长问题 32k"是两种口径,大文档走 OpenRouter 会先碰到上限。 - Vercel 的免费期到 9 月 25 日就结束了,别把它当作长期免费的通道。Vercel 这边的 API 名字带
experimental,接口可能调整。
认准官方域名:typesafe.ai、docs.typesafe.ai、console.typesafe.ai、api.typesafe.ai。jev-ai.net、jevtypesafeai.com 这类自称"免费试用 Jev"的站点是 9 月 18 日才注册的域名,不在 TypeSafe 官方域名之下,不要把 API key 或 OpenRouter key 填进去。
教程:从第一次调用到按置信度分流
下面的命令和代码按 2026 年 9 月 24 日的 TypeSafe 与 OpenRouter 官方文档整理,字段名与文档一致。
第一步:在 Playground 里先试问题
登录 console.typesafe.ai/playground,把一段真实内容粘贴为 state,然后添加问题。先加一个 Noul,比如"这条消息是否表达了紧迫感",再加 Choice 和 Score,一次看到全部结果。
这一步值得多花时间:拿 20 到 50 条你自己的中文样本,分别用中文和英文写同一个问题,看哪种写法的概率更集中。官方说英语是主要训练语言,但你的数据是中文,哪种写法更好只能自己测出来。
第二步:拿到 key,用 curl 跑通
在 console.typesafe.ai/keys 创建 API key,放进环境变量,然后发官方文档里的示例请求:
export TYPESAFE_API_KEY="你的 key"

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
{
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP.",
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this",
      "criteria": {
        "billing": "Payment or subscription issues",
        "technical": "Bugs or integration problems",
        "sales": "Pricing or account questions"
      }
    },
    "frustration": {
      "type": "score",
      "instructions": "How frustrated the customer appears",
      "criteria": [
        "Calm, just stating facts",
        "Frustrated but civil",
        "Very angry, strong language"
      ]
    },
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}
EOF
questions 里的键名(department、frustration、is_urgent)由你决定,答案按同样的键返回;键名不会送进模型参与判断,所以含义要写在 instructions 和 criteria 里。
第三步:读懂返回
官方文档给出的响应如下:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "technical",
      "confidence": 0.78,
      "probabilities": { "technical": 0.85, "sales": 0.0, "billing": 0.15 }
    },
    "frustration": {
      "type": "score",
      "score": 1.0,
      "confidence": 1.0,
      "legend": {
        "0": "Calm, just stating facts",
        "1": "Frustrated but civil",
        "2": "Very angry, strong language"
      },
      "probabilities": { "0": 0.0, "1": 1.0, "2": 0.0 }
    },
    "is_urgent": { "type": "noul", "noul": 1.0 }
  },
  "usage": { "input_tokens": 392, "output_tokens": 65 }
}
逐项看:
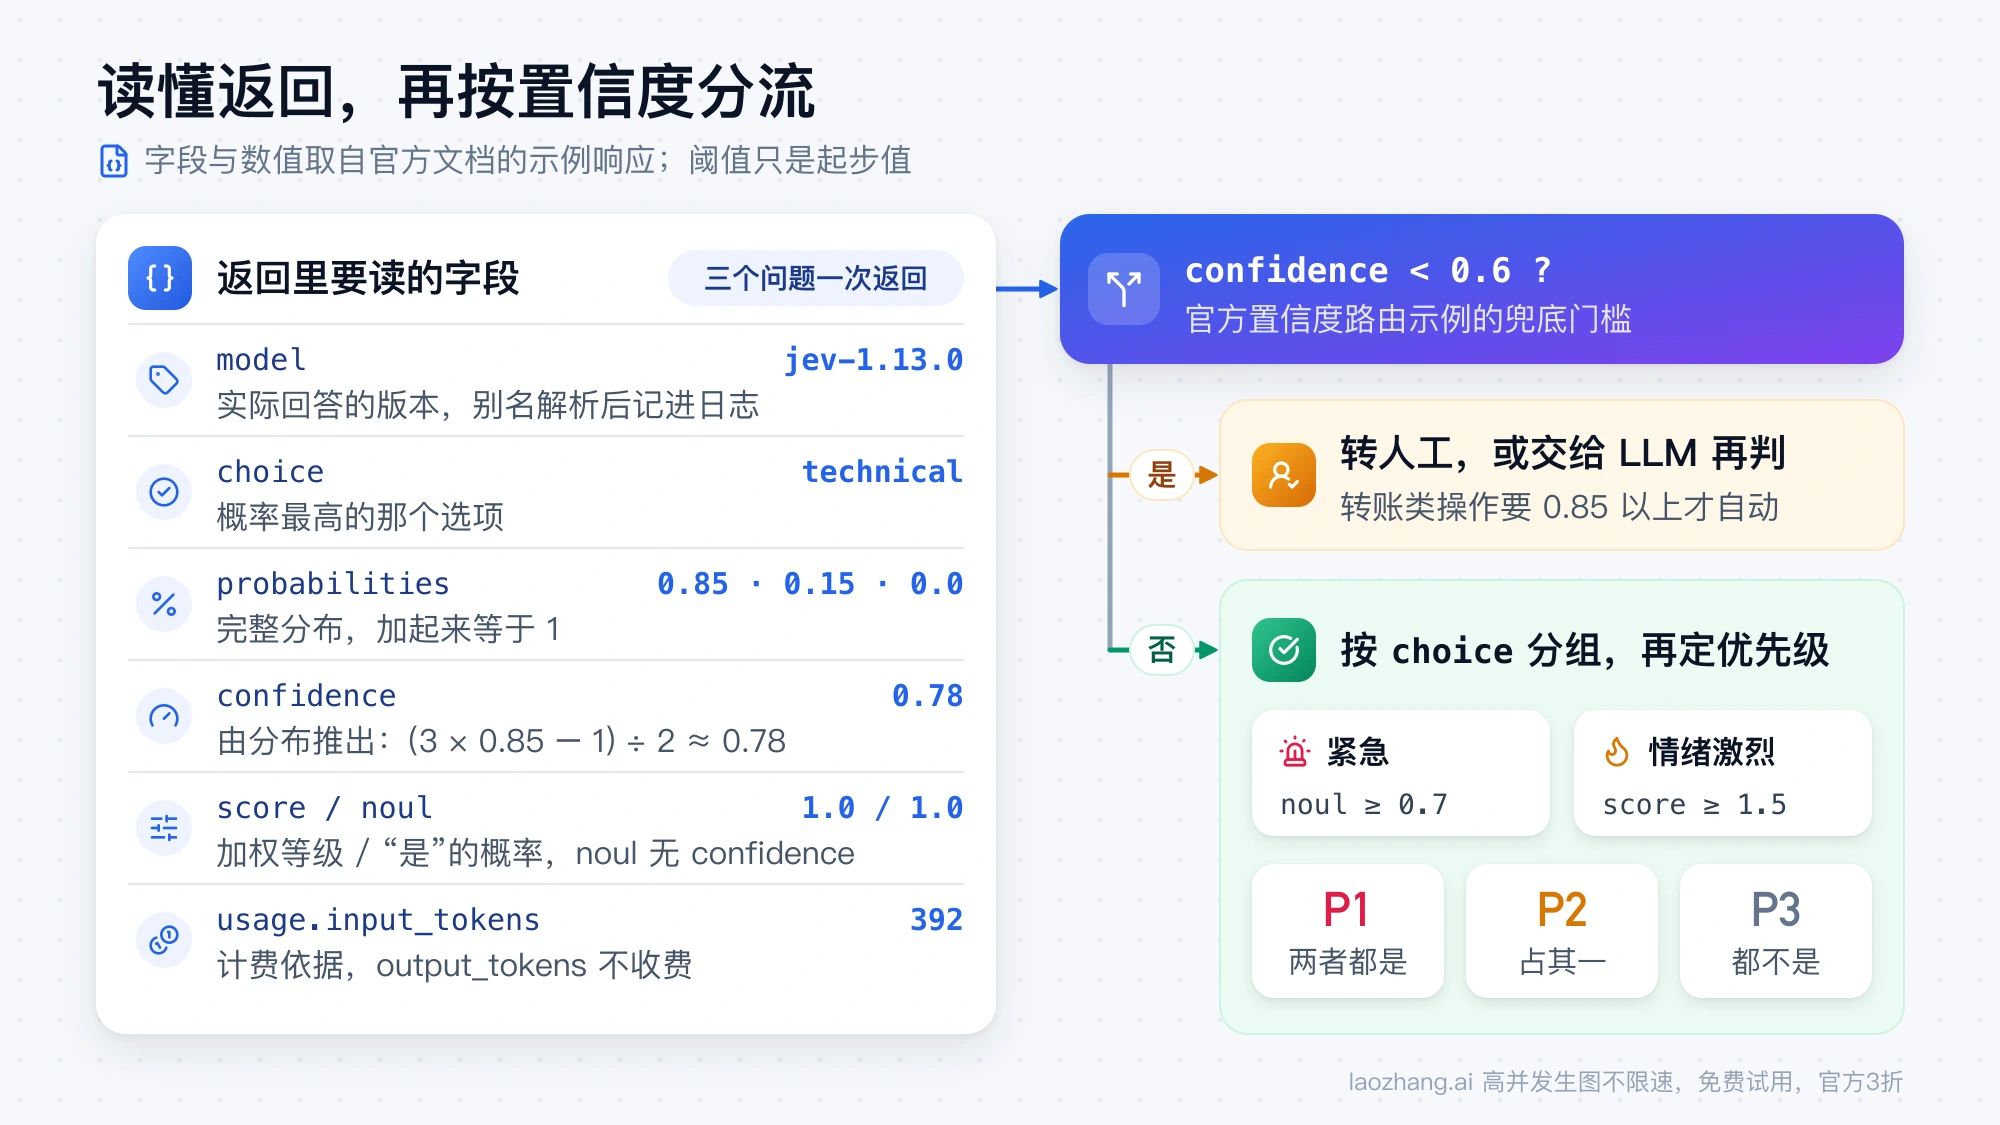
model是实际回答的版本号。你请求的是别名jev-latest,返回的是jev-1.13.0,日志里要记这个字段。choice是概率最高的选项,probabilities是完整分布,加起来等于 1。confidence由分布推出。官方交互示例用的近似公式是 (n × 最高概率 − 1) ÷ (n − 1),n 是选项数:这里 (3 × 0.85 − 1) ÷ 2 ≈ 0.78。所有概率压在一个选项上是 1,完全平均是 0。score是按概率加权的等级位置,可以落在两级之间。API 参考里另一个例子是等级 1 占 0.95、等级 2 占 0.05,得到 1.05。可以拿它和阈值比较,但官方提醒不要用它反推两级之间的精确数值。noul是"是"的概率,没有confidence。usage.input_tokens就是计费依据,output_tokens不收费。
第四步:在 Python 里按置信度分流
安装 SDK(Python ≥ 3.10):
pip install typesafe-sdk
# 或 uv add typesafe-sdk
SDK 自动读取 TYPESAFE_API_KEY,默认模型是 jev-latest。下面的例子把版本固定为 jev-1.13.0,因为阈值是针对某个版本调出来的,别名换版本后分布可能变:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient(model="jev-1.13.0")

QUESTIONS = {
    "department": Choice(
        instructions="哪个团队应该处理 `ticket`?",
        criteria={
            "billing": "扣款、发票、退款、订阅",
            "technical": "报错、故障、接口集成",
            "sales": "报价、升级套餐、新开账号",
        },
    ),
    "is_urgent": Noul(instructions="`ticket` 明确表达了时间上的紧迫"),
    "frustration": Score(
        instructions="`ticket` 里客户的情绪有多激烈",
        criteria=["平静陈述", "不满但克制", "非常愤怒、措辞激烈"],
    ),
}


def triage(ticket_text: str) -> dict:
    response = client.system_one(state={"ticket": ticket_text}, questions=QUESTIONS)

    dept = response.choices["department"]
    record = {
        "model": response.model,
        "input_tokens": response.usage.input_tokens,
        "department": dept.choice,
        "confidence": dept.confidence,
        "probabilities": dept.probabilities,
    }

    # 起步阈值,上线前用自己标注过的样本调整
    if dept.confidence < 0.6:
        return {**record, "route": "review"}  # 转人工,或交给 LLM 再判断一次

    urgent = response.nouls["is_urgent"].noul >= 0.7
    angry = response.scores["frustration"].score >= 1.5
    priority = "P1" if urgent and angry else "P2" if urgent or angry else "P3"
    return {**record, "route": dept.choice, "priority": priority}


print(triage("我的订阅这个月被扣了两次钱,今天之内必须退回来,不然我就投诉。"))
几点说明:
- 0.6、0.7、1.5 只是起步值。官方的置信度路由示例用 0.6 做兜底门槛,并建议不同风险的动作用不同门槛:只读操作 0.6 就够,转账这类操作要 0.85 以上才自动执行,中间区间先让用户确认。
- Noul 的阈值不能直接套到 Choice 上,同一个问题用两种类型问,数值不可直接比较(见后面的检查清单)。
state里只放这几个问题需要的字段。整条客户档案全塞进去会让准确率下降。- 需要异步时用
AsyncTypeSafeClient,用法相同,方法前加await。
第五步:换到 OpenRouter 只改 base URL
已经有 OpenRouter 账户的话,官方 SDK 可以直接指向 OpenRouter,不需要 TypeSafe key。base URL 是 https://openrouter.ai/api,SDK 会自己拼上 /v1/systemone:
import os
from typesafe_sdk import TypeSafeClient

client = TypeSafeClient(
    api_key=os.environ["OPENROUTER_API_KEY"],
    base_url="https://openrouter.ai/api",
    model="jev-1.13",
)
JavaScript/TypeScript(Node ≥ 20,npm install @typesafe-ai/sdk):
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";

const client = new TypeSafeClient({
  apiKey: process.env.OPENROUTER_API_KEY,
  baseURL: "https://openrouter.ai/api",
});

const response = await client.systemOne({
  state: { ticket: "我的订阅这个月被扣了两次钱,今天之内必须退回来。" },
  questions: {
    department: choice("哪个团队应该处理 `ticket`?", {
      billing: "扣款、发票、退款、订阅",
      technical: "报错、故障、接口集成",
      sales: "报价、升级套餐、新开账号",
    }),
  },
});

const dept = response.answers.department;
console.log(response.model, dept.choice, dept.confidence);
直连官方时去掉 apiKey 和 baseURL 两项即可,SDK 默认读 TYPESAFE_API_KEY。在 OpenRouter 上,模型名写 jev-1.13 或 jev-latest,会自动映射到 typesafe/ 命名空间;SDK 自带的 client.models.list() 在 OpenRouter 上会被拒绝,查模型列表请看 OpenRouter 网站。不想装 TypeSafe SDK 的话,也可以用 OpenRouter 的 Decisions API,但它目前还是 alpha。
处理 401、422、429、529
| 状态码 | 含义 | 怎么办 |
|---|---|---|
| 401 | key 缺失或无效 | 检查 Authorization 头;走 OpenRouter 时确认用的是 OpenRouter key |
| 422 | 请求体校验失败 | 响应体会指出哪个字段有问题,比如缺少必填字段或问题格式不对 |
| 429 | 超出速率上限 | 指数退避重试 |
| 529 | TypeSafe 暂时过载 | 指数退避重试 |
官方 SDK 默认会对 429 退避重试,并遵守 retry-after 头;直接调 HTTP 的话要自己实现。Python SDK 的 HTTP 错误都继承自 TypeSafeAPIError,可以读 status 和 body:
from typesafe_sdk import TypeSafeAPIError

try:
    result = triage(ticket_text)
except TypeSafeAPIError as err:
    if err.status == 422:
        print("请求体有误:", err.body)
    raise
重试次数用完仍失败时,是排队、降级到 LLM 还是直接停下,可以参考大模型 API 该重试还是切备用模型?先过这五道门。注意降级到 LLM 后拿不到同样的校准概率,下游按 confidence 分流的逻辑要单独处理这条路径。
让编程 Agent 帮你写集成代码
TypeSafe 提供了一个 agent skill,让编程 Agent 了解 Jev 的 API 和常用模式。在 Claude Code 里:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
其他 Agent 用 npx skills add typesafe-ai/skills --skill typesafe-ai。这只是让 Agent 更会写调用 Jev 的代码,Agent 本身用的仍是原来的大模型。
上线前逐项测过这几处
下面几条来自 TypeSafe 公布的 jev-1.13 已知弱点(2026 年 9 月 17 日复核版)和第三方测试,每一条都对应一个可以提前写成测试用例的场景:
- 计数、算术、日期先后都在代码里完成。确实需要从文本里取日期时,让 Jev 用 Choice 从年、月、日的有限选项里挑(加一个"未提及"选项),由代码组装和比较。
- 问题按字面写清楚。Jev 按字面理解
instructions,否定词、限定词不会替你"领会意图";Noul 的true描述不要写成"否"的意思。Lindfors 的测试里,把问题改写得更严谨、加了三个限定条件之后,论点一致率从 0.89 降到 0.86,校准误差(ECE)从 0.040 升到 0.116。他的建议是像问隔壁同事一样简短地问,细则留在代码里。 -
state先在代码里过滤,只送问题需要的字段。无关内容越多,准确率越低。 - 做提示注入测试。据 VentureBeat 报道,Octomind 的工程师让 Jev 判断是否拦截
rm -rf ~/.ssh,拦截概率 0.76、confidence 0.64;在state里注入一段伪造的"已预先批准"工具输出后,降到 0.48、confidence 0.22。用对抗文本和打乱选项顺序各跑一轮,破坏性操作保留人工确认和确定性检查。 - 不依赖"常识上应该成立"的数学关系。官方例子里,同一张工单问"是否要求退款"得 0.72,问"是否要求退款以外的事"得 0.47,两者相加是 1.19。一个意思只用一种问法,阈值按问题类型分别调。
- 中文单独评测。英语之外的语言"能处理但不一样好",拿你自己的标注样本看高置信区间的一致率,门槛宁可先保守。
- 固定版本号并记录上下文。请求里写
jev-1.13.0,每次记录state、问题定义、选项顺序、返回的model和confidence;升级版本前用同一批样本重跑,再调阈值。 - 需要对用户或审计方解释结论的场景,另外安排 LLM 生成说明或人工复核,Jev 自己不给理由。
常见问题
Jev 开源了吗?GitHub 上搜到的是什么?
没有开源。TypeSafe 开源的是 Python 和 JavaScript SDK、agent skill。标题写着"开源 Jev"的项目是社区仿制品,比如 Kev、Laya、SemIf(原名 OpenJev)、Bespoke Nimble,多数基于 Qwen、ModernBERT 等开源底座,训练数据是合成数据。其中一些可以在本地跑,但质量没有经过独立验证,不能当作 Jev 的等价替代。
现在还要申请或排队吗?
不用。9 月 20 日起开放注册,直接在 console.typesafe.ai 注册即可;不想注册 TypeSafe 的话,用 OpenRouter key 也能调。据媒体报道新注册送 $5 额度,官方页面没有写这一条。
中文效果怎么样?
官方只说英语最好,其他语言(包括中日韩文字)"能处理但不一样好",没有公布中文准确率。可以参考的是 Lindfors 在挪威语上的测试:在 0.9 以上的高置信区间,和参考标签的一致率很高。中文场景请用自己的几十到几百条标注样本测,重点看高置信那部分是否可靠,而不是只看总体准确率。
从国内调用速度怎么样?
官方公布的 70 到 500 毫秒是从美国西海岸测的,服务也部署在那里。从国内调用要加上跨洋网络往返,实际延迟请在你的服务器上测几次中位数和最慢值再决定能不能放进实时链路。