AI Agent 工具调用死循环怎么停:重复检测、错误分类与熔断
先阻止下一次不安全工具调用,再用执行上限、真实进展、操作台账和不可自行重开的终态收口;响应丢失时先核对业务结果,再决定恢复。
文章目录
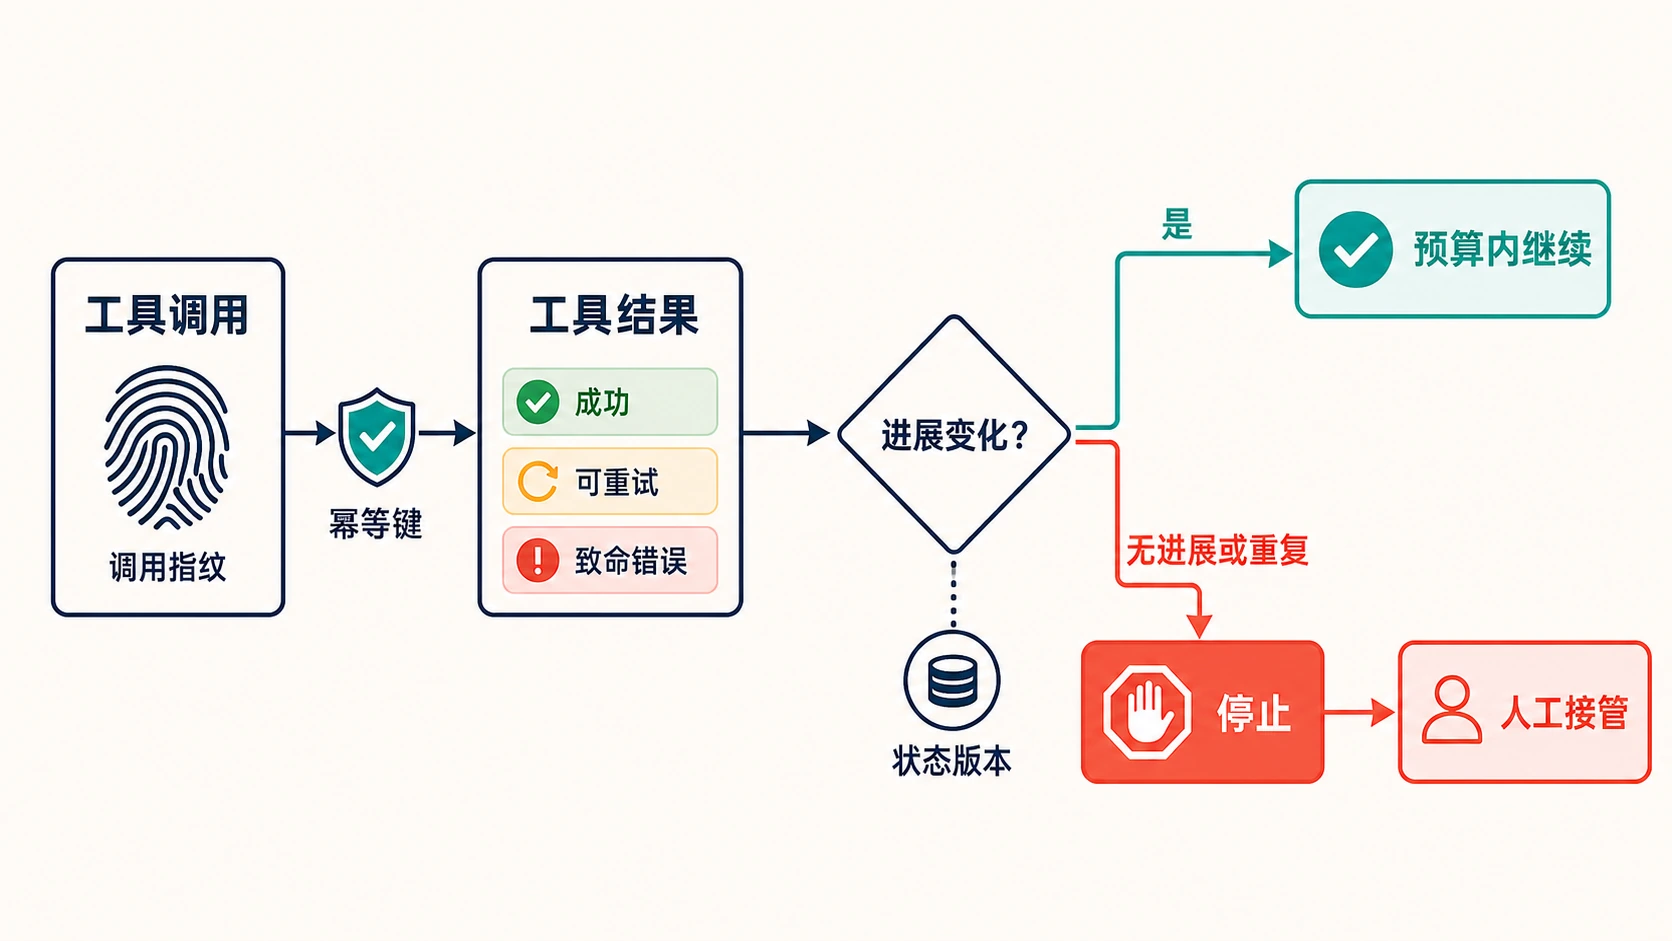
AI Agent 反复调用同一个工具时,先关闭执行入口,再排查模型为什么继续调用。把当前任务标记为停止,暂停自动重试和新工具派发,保存最近的调用轨迹、业务状态与已提交操作。调用方必须直接返回停止报告,不能把“已被拦截”当作普通工具报错,再交给模型无限重试。
如果涉及发消息、写库或付款,还要单独核对正在执行的操作。停止 Agent 不会撤销已经提交的结果;超时、断流或取消后没收到响应,也不能直接认定操作失败。先按稳定的业务操作标识查结果,确认后再恢复。
已经陷入循环,先做这几步
在应用的任务控制器和工具执行器上处置,而不是只关闭聊天窗口:
- 阻断后续派发。 将任务置为停止状态,关闭自动重试、队列续跑和子任务派发;停止判断要覆盖真正执行工具的入口。
- 保留已经做过的事。 保存检查点、工具结果、操作标识和剩余预算。不要为了清空循环把成功记录一起删掉。
- 处理在途操作。 只读任务可按运行环境支持的方式取消;写操作若提交状态未知,标记为待核对,禁止同一业务操作再次提交。
- 给用户返回可用结果。 说明已经完成的内容、停止原因、尚未确定的结果,以及继续所需的具体条件。停止状态一旦写入,模型下一轮不能自行解除。
成功信号是“执行器没有收到下一次被禁止的调用,调用方也不再启动规划”,而不是页面停止刷新。对于已经派发的请求,要另外观察工作进程和外部操作状态。用 Promise.race 先返回超时,只能停止等待,不能证明底层请求已取消或写入未提交。
如使用 AWS AgentCore,当前有专门的 StopRuntimeSession API,需要对应运行时、会话标识和调用权限。停止请求的幂等令牌用于避免重复发送停止请求,不是支付或写库操作的回滚凭证。
先从 trace 判断是哪一种循环
至少关联任务 ID、模型轮次、工具调用 ID、工具名、有效参数摘要、结果类别、业务状态版本和停止原因。写工具再加业务操作键与提交状态。日志中的令牌、客户数据和完整请求体应脱敏;把参数变成哈希也不自动解决隐私问题。
| 轨迹中的现象 | 优先检查 | 下一动作 |
|---|---|---|
| 同一工具、相同有效参数反复执行 | 调用指纹与重复次数 | 在下一次执行前拦截;检查为何没有使用已有结果 |
A → B → A → B,状态不变 | 短周期与未解决的前置条件 | 停止摇摆,交付已有结果或要求明确的新条件 |
| 每次参数略变,业务数据没有变化 | 无进展次数 | 以业务状态为准停止,不能用新措辞重置计数 |
| 工具返回成功,仍继续发消息或写入 | 操作台账与任务完成条件 | 返回已提交结果;确认整个任务是否完成 |
| 超时后又执行一次写操作 | 前次操作是否真的失败 | 先核对业务操作结果,未知状态禁止盲重试 |
| 查询同一个异步任务,结果仍为等待 | job ID、服务端等待要求、轮询预算 | 有界查询状态,不重新创建任务 |
| 看似每轮都调用工具,实际上是工作流反复启动 | 触发器与任务 ID 是否变化 | 排查外层触发回路,单轮工具上限覆盖不到它 |
参数归一化只处理没有业务差异的部分。例如对象字段顺序可以排序,页码、游标、资源版本和消息内容必须保留。不要一律去掉空白:有些字符串的空格本身就是内容。短窗口指纹能发现精确重复与简单振荡,不能证明所有语义相同的调用都被识别。
工具“成功”与任务“完成”也要分开。查到一页数据可以成功,但任务可能仍需后两页;更新客户记录已经提交,也不意味着后续报告写完了。n8n 社区的一则历史案例描述了 HubSpot 更新成功后仍被重复调用,作者反馈澄清工具使用条件有所改善。这支持检查提示中的完成条件,不能代替执行器的确定性停止规则。
先规定工具结果,再讨论重试
让工具适配器输出有限的结果类别,再由控制器决定下一步。模型生成的“成功”“已经完成”只是文本,不能直接写进提交台账。
| 类别 | 控制器该做什么 | 必须保留的条件 |
|---|---|---|
SUCCESS | 验证实际结果,记录进展;满足任务目标才结束 | 单个工具完成不等于整个任务完成 |
RETRYABLE | 仅在重试额度内按等待要求再试 | 超时写操作须先确认未提交;不能因通用 timeout 就重放 |
PENDING | 保留已有 job ID,等待后查询状态 | 等待时间不算业务进展,轮询也有总上限 |
PRECONDITION | 停止,说明缺失条件 | 条件未改变时原样重试没有意义 |
FATAL | 进入失败终态 | 权限拒绝、策略拒绝等不能靠不断重试解决 |
| 无结果或无法解析 | 保留现场,停止自动执行 | 写操作提交状态未知时必须先核对 |
错误分类应依据当前工具与服务的契约。不能把所有 4xx 都当永久错误,也不能把所有 5xx 都当可安全重放;关键是请求是否被接受、是否产生副作用、是否有明确的重试条件。
还要统计所有重试层。当前 LangChain JavaScript 工具重试中间件默认 maxRetries: 2,即首次执行后最多再试两次;默认 onFailure: "continue" 会把失败结果交回模型。模型随后重新提出调用,可能再进入一轮重试。中间件内部重试和模型重新调用都必须消耗同一任务的总预算,不能各自计数后相互放大。
一个框架无关的 LoopGuard
下面是可离线运行的 JavaScript 串行原型。它把模型轮次、工具请求次数和实际执行次数分开计数:已提交结果被复用时没有新增执行,但仍消耗模型与请求预算。停止结果保持不变,再次调用 run() 也不会重新开始规划。
此原型仅支持会返回的同步假执行器,用于验证控制逻辑;它不是可直接接入异步生产工具的 SDK 封装。inspect 必须由应用实现,根据可信结果和业务记录核验状态,不能把模型自报的进展数字直接传进去。内存台账只用于单进程串行示例,不具备跨重启或多工作进程的原子性。
把下面代码保存为 guard.mjs。示例中的阈值是演示参数,应按自己的任务选择;调大阈值不能替代修复根因。
export function canonical(x) {
  if (Array.isArray(x)) return x.map(canonical);
  if (x && typeof x === 'object') {
    return Object.fromEntries(Object.keys(x).sort().map(k => [k, canonical(x[k])]));
  }
  return x;
}

export class Guard {
  constructor({ now, wait, limits, revision = 0 }) {
    this.now = now;
    this.wait = wait;
    this.limits = limits;
    this.deadline = now() + limits.ms;
    this.revision = revision;
    this.models = 0;
    this.requests = 0;
    this.executions = 0;
    this.stagnant = 0;
    this.history = [];
    this.operations = new Map();
    this.terminal = null;
  }
  stop(state, reason) {
    this.terminal ??= {
      state, reason, models: this.models,
      requests: this.requests, executions: this.executions,
      revision: this.revision,
      operations: [...this.operations.entries()].map(([key, v]) => ({ key, ...v }))
    };
    return this.terminal;
  }
  run(plan, execute, inspect) {
    let observation = null;
    while (!this.terminal) {
      if (this.now() >= this.deadline) return this.stop('PARTIAL', 'deadline');
      if (this.models >= this.limits.models) return this.stop('PARTIAL', 'model_budget');
      this.models++;
      let call;
      try { call = plan(observation); }
      catch { return this.stop('FAILED', 'planner_error'); }
      if (call?.type === 'finish') {
        let done = false;
        try { done = inspect(null, call).done === true; } catch {}
        return this.stop(done ? 'COMPLETED' : 'PARTIAL', done ? 'goal_met' : 'goal_unverified');
      }
      if (!call || typeof call.tool !== 'string' || !call.args ||
          !['read', 'write'].includes(call.effect)) return this.stop('FAILED', 'bad_call');
      if (this.now() >= this.deadline) return this.stop('PARTIAL', 'deadline');
      if (this.requests >= this.limits.requests) return this.stop('PARTIAL', 'request_budget');
      this.requests++;
      let fp;
      try { fp = call.tool + ':' + JSON.stringify(canonical(call.args)); }
      catch { return this.stop('FAILED', 'bad_args'); }
      const key = call.operationKey;
      if (call.effect === 'write' && (typeof key !== 'string' || !key)) {
        return this.stop('NEEDS_HUMAN', 'missing_operation_key');
      }
      const old = call.effect === 'write' ? this.operations.get(key) : null;
      if (old && old.fp !== fp) return this.stop('NEEDS_HUMAN', 'operation_conflict');
      if (old && old.state !== 'COMMITTED') return this.stop('NEEDS_HUMAN', 'unknown_commit');
      if (this.history.filter(x => x === fp).length >= this.limits.same) {
        return this.stop('PARTIAL', 'same_call');
      }
      const h = this.history.slice(-3);
      if (h.length === 3 && h[0] !== h[1] && h[0] === h[2] && h[1] === fp) {
        return this.stop('PARTIAL', 'short_cycle');
      }
      let result;
      if (old) result = old.result;
      else {
        if (this.executions >= this.limits.executions) return this.stop('PARTIAL', 'execution_budget');
        if (call.effect === 'write') this.operations.set(key, { state: 'UNKNOWN', fp });
        this.executions++;
        try { result = execute(call); }
        catch { return this.stop(call.effect === 'write' ? 'NEEDS_HUMAN' : 'FAILED', 'executor_error'); }
      }
      if (!result || !['SUCCESS', 'RETRYABLE', 'PENDING', 'PRECONDITION', 'FATAL'].includes(result.kind)) {
        return this.stop(call.effect === 'write' ? 'NEEDS_HUMAN' : 'FAILED', 'bad_result');
      }
      let verified;
      try { verified = inspect(result, call); }
      catch { return this.stop(call.effect === 'write' ? 'NEEDS_HUMAN' : 'FAILED', 'invalid_evidence'); }
      if (!verified || !Number.isSafeInteger(verified.revision) ||
          verified.revision < this.revision || typeof verified.done !== 'boolean') {
        return this.stop(call.effect === 'write' ? 'NEEDS_HUMAN' : 'FAILED', 'invalid_evidence');
      }
      if (call.effect === 'write') {
        if (result.kind !== 'SUCCESS' || verified.committed !== true) {
          return this.stop('NEEDS_HUMAN', 'unknown_commit');
        }
        this.operations.set(key, { state: 'COMMITTED', fp, result });
      }
      if (result.kind === 'FATAL') return this.stop('FAILED', 'fatal');
      if (result.kind === 'PRECONDITION') return this.stop('NEEDS_HUMAN', 'precondition');
      if (verified.revision > this.revision) {
        this.revision = verified.revision;
        this.stagnant = 0;
        this.history = [];
      } else this.stagnant++;
      this.history.push(fp);
      if (verified.done) return this.stop('COMPLETED', 'goal_met');
      if (this.stagnant >= this.limits.stagnant) return this.stop('PARTIAL', 'no_progress');
      if (['RETRYABLE', 'PENDING'].includes(result.kind)) {
        if (!Number.isFinite(result.waitMs) || result.waitMs <= 0) return this.stop('FAILED', 'invalid_wait');
        if (this.now() + result.waitMs >= this.deadline) return this.stop('PARTIAL', 'deadline');
        this.wait(result.waitMs);
      }
      observation = result;
    }
    return this.terminal;
  }
}
plan 表示规划一步,execute 表示真正执行一步,inspect 表示应用核对结果。调用方取得 run() 返回的报告后应直接结束本次规划;不能捕获停止结果,再创建一个新的 Guard 接着调用。真实系统还要让工具内部重试、子任务与工作流新轮次共同使用持久化的任务预算。
写工具必须提供 operationKey,其身份应是“这次业务动作”,例如某个事件的首次通知,而不是每次模型请求生成的 call ID。相同操作键却换了输入,原型返回 operation_conflict;写操作异常、结果缺失或提交未经确认时保留 UNKNOWN,进入 NEEDS_HUMAN。真实适配器可以在得到可信的“确定未提交”证据后开放有界重试,但不能仅凭没有响应做这个判断。
什么才算有进展:用正常分页验证守卫
业务进展是已确认的状态变化,例如已验证且未重复的数据页、已完成的子目标或外部操作记录。时间过去了、日志增加了、参数变了、模型说“接近完成”,都不能单独算进展。同一个工具可以反复使用,只要业务状态确实推进;同一个 job ID 也可以有界轮询,但等待本身不能让总预算恢复。
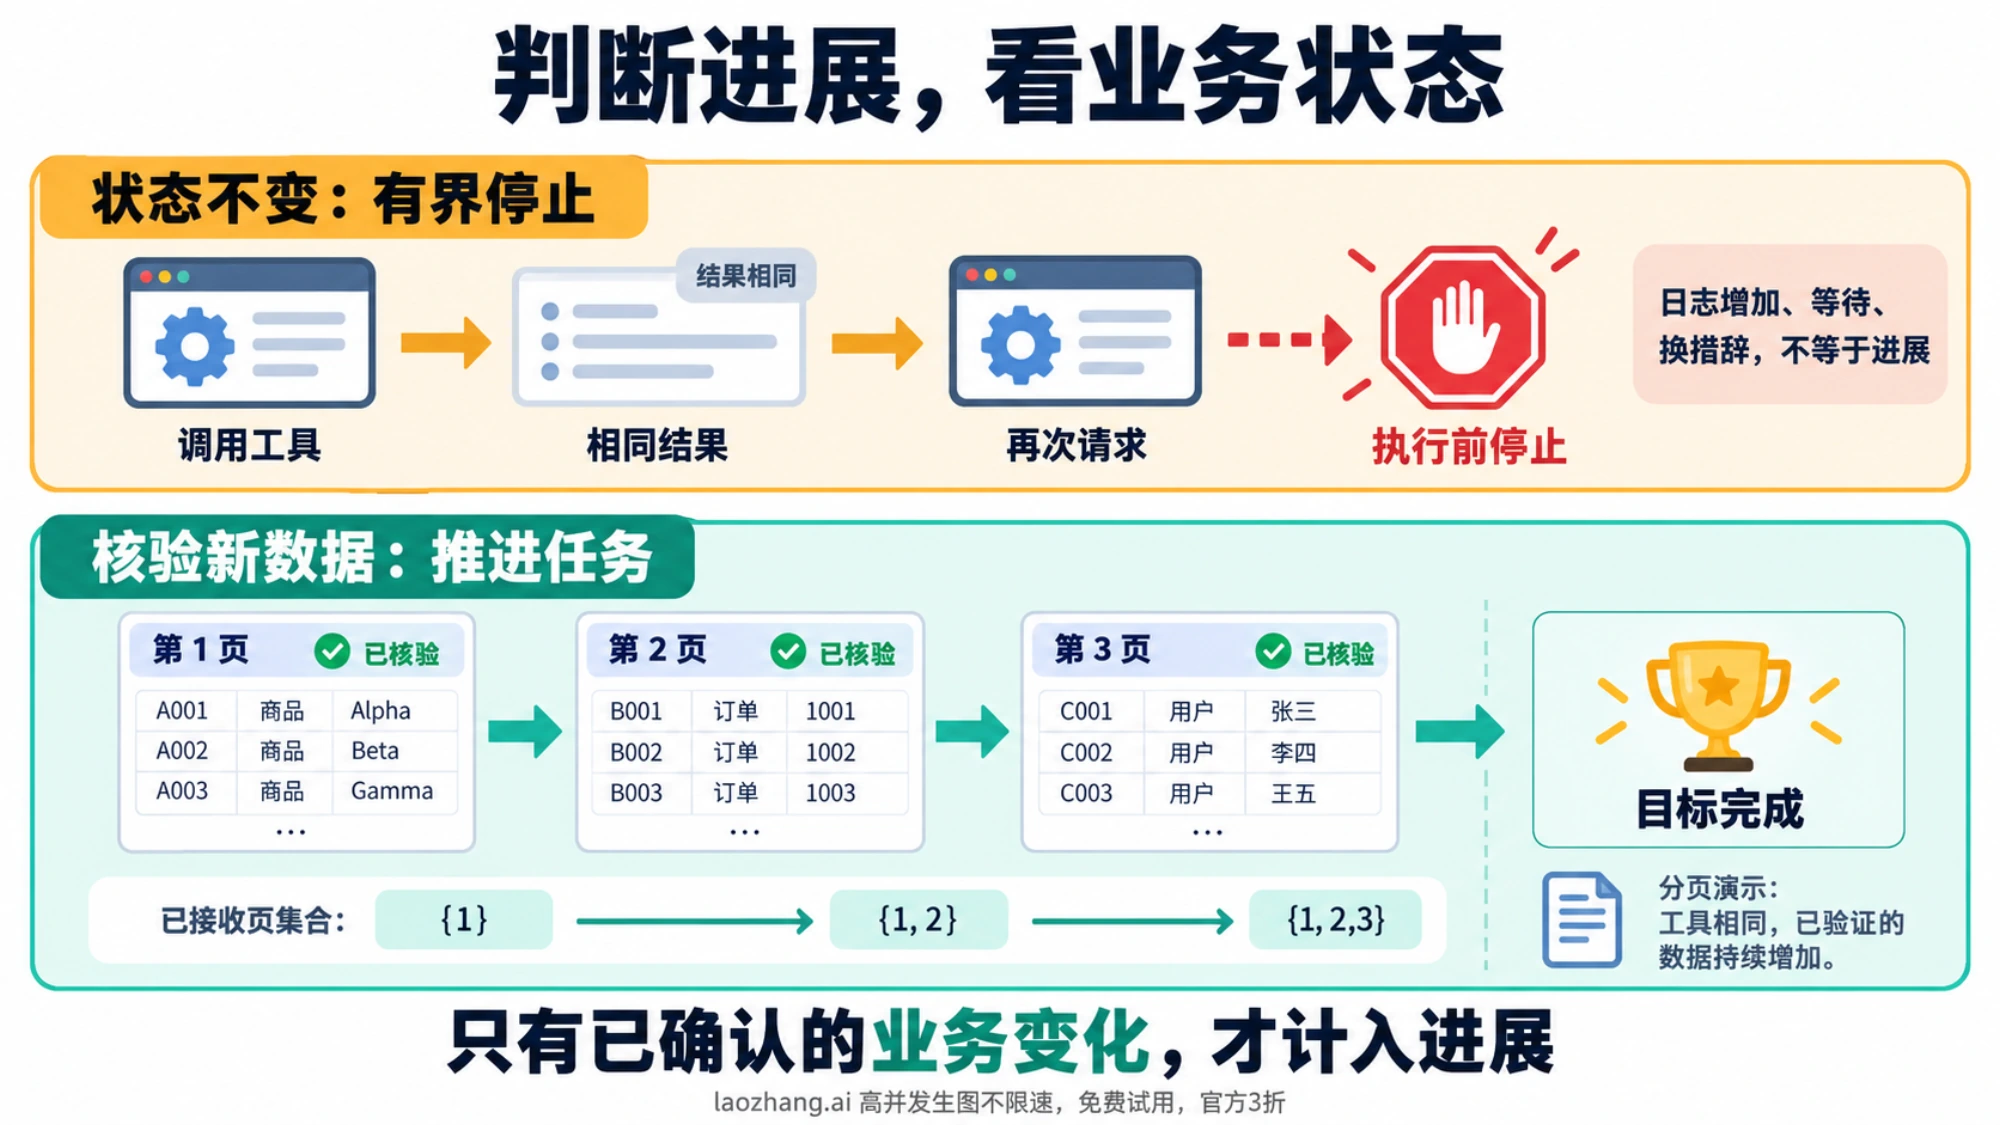
把这段演示接在 guard.mjs 末尾,再执行 node guard.mjs。它不调用模型或任何服务,假执行器只生成三页固定数据。检查函数核对页码与预期数据,再推进已接收页集合;目标是收到全部三页。
let time = 0;
const accepted = new Set();
const guard = new Guard({
  now: () => time, wait: ms => { time += ms; },
  limits: { ms: 1000, models: 8, requests: 8, executions: 6, same: 2, stagnant: 3 }
});
const report = guard.run(
  () => ({ tool: 'read_page', args: { page: accepted.size + 1 }, effect: 'read' }),
  call => ({ kind: 'SUCCESS', page: call.args.page, ids: [`item-${call.args.page}`] }),
  (result, call) => {
    if (result) {
      if (call.tool !== 'read_page' || result.page !== call.args.page ||
          result.page !== accepted.size + 1 || result.page > 3 ||
          JSON.stringify(result.ids) !== JSON.stringify([`item-${result.page}`])) {
        throw new Error('invalid page');
      }
      accepted.add(result.page);
    }
    return { revision: accepted.size, done: accepted.size === 3 };
  }
);
console.log(report.state, report.executions, report.revision);
输出为 COMPLETED 3 3:任务完成,实际执行三次,已验证进展版本为三。示例每页使用同一个工具,只有页码变化,因此不会把正常分页误判为“工具名重复”。实际分页适配器还应核验来源、游标是否合法、数据是否重复以及任务范围是否覆盖,不能把服务器给出的任意版本号都当作目标进展。
我们对上面的原型运行了串行离线回放,使用假时钟、假执行器和合成结果;没有运行真实 Agent SDK、模型或业务接口。关键结果如下,计数来自假执行器实际进入次数:
| 回放情形 | 实际执行与返回结果 |
|---|---|
| 相同只读请求不断返回可重试错误 | 执行 2 次后,下一次以 same_call 拦截 |
| 只读请求 A、B 交替且没有进展 | 执行 3 次后,以 short_cycle 拦截下一次 |
| 三页有效数据按序返回 | 执行 3 次,COMPLETED |
| 参数变化、时钟前进,但只带模型自报进展 | 执行 3 次,no_progress;进展版本仍为 0 |
| 已提交写操作反复被请求 | 工具仅执行 1 次,后续复用结果;无进展后返回 PARTIAL |
| 模拟写入已提交但响应丢失 | 工具执行 1 次,台账保留 UNKNOWN,返回 NEEDS_HUMAN |
| 相同业务操作键带入不同输入 | 首次执行后停止,不执行冲突输入 |
| 永久错误或前置条件缺失 | 执行 1 次后分别返回 FAILED 或 NEEDS_HUMAN |
| 等待时间到达截止点 | 不再轮询,以 deadline 返回部分结果 |
| 模型预算或执行预算耗尽 | 下一次对应工作在进入前被拦截 |
| 未知结果类别或模型自行宣告完成 | 停止;未经核验的完成声明不会变成 COMPLETED |
每种停止情形还再次调用了同一个 run(),确认没有新增规划和工具执行。这些回放证明有限输入下原型的分支与计数行为,不代表真实模型会收敛,也没有验证生产环境的并发、持久化或取消机制。
幂等闸门要挡在副作用之前
重复检测保护运行过程,幂等保护同一业务动作不被重复提交。一次付款可能在第二次调用就造成损失,不能等到总步数上限才处理。
生产台账至少需要保存业务操作键、输入指纹、提交状态和可核对的结果。应在工具执行前原子取得操作资格,并通过服务端幂等协议、事务或等价机制关联业务提交。“先查询台账,再写入”不是原子操作:两个工作进程可能同时查不到记录,然后都执行;内存 Map 在重启后也会丢失。
对不同状态采取不同动作:
COMMITTED:核对输入一致后返回已提交结果,不再次执行。IN_FLIGHT:观察原操作,避免并行提交同一动作。UNKNOWN:按业务操作键查询外部记录,确认已提交、未提交或仍不确定。- 明确未提交:满足重试条件且预算仍有余量时,才允许按原业务操作键重试。
如果服务没有可用的幂等或结果查询机制,就不能声称实现了跨超时与重启的“恰好执行一次”。高风险动作应保留人工核对路径。即使已经停止,也不能把旧台账删掉后用新键重新付款或发信;新业务动作需要真实的新意图与授权。
框架上限负责兜底,业务语义仍归应用
选上限前先问计量单位是什么。一次模型轮次可能提出多个工具调用,工具一次执行内部也可能重试;工作流新一轮运行又可能重置本轮计数。把这些都叫“步数”,很容易以为限制已生效。
| 当前文档中的控制 | 实际范围与使用要点 |
|---|---|
| OpenAI Agents 运行上限与中断处理 | 运行指南说明上限失败、最终输出和可恢复中断;历史或 session 负责上下文延续,不等于外部操作台账。运行指南 |
LangChain modelCallLimitMiddleware | runLimit 与 threadLimit 限制模型调用;线程维度需要 checkpointer。不要把模型次数当作工具执行次数。官方说明 |
LangChain toolCallLimitMiddleware | 可限制指定工具或所有工具;默认 exitBehavior: "continue" 拦住超额工具,模型及其他允许的工具仍可继续。error 会抛错,end 受待执行工具数量等条件约束。官方说明 |
| n8n Tools Agent 的 Max Iterations | 当前默认 10,统计为回答而运行模型的次数,不能当作 10 次独立工具操作,也不限制外层工作流重复启动。节点选项 |
| Google ADK 的旧版 LoopAgent 模板 | max_iterations 限制循环周期,子 Agent 可发出退出信号;ADK 2.0 的 Python/Go 工作流已转向更灵活的控制方式,接入时要核对版本。Loop agents 文档 |
线程限制也有身份边界。换 thread ID、新开任务或丢失检查点可能绕过原线程计数,所以整个用户任务的总预算与已提交台账必须另行保存。恢复允许继续未完成工作,不能抹掉已消耗额度。
若工具已完成,模型却仍必须选工具,再检查请求驱动方式。OpenAI 的 tool_choice 中,required 要求调用一个或多个工具,强制某个函数则要求调用该函数。若每轮都这样设置,正常的最终答案可能没有出口。应按实际任务状态允许结束,但不要在业务目标尚未满足时强行关闭所有工具。这是特定配置的诊断方向,不是所有死循环的共同原因。
停止后怎样恢复,而不是重新开一个循环
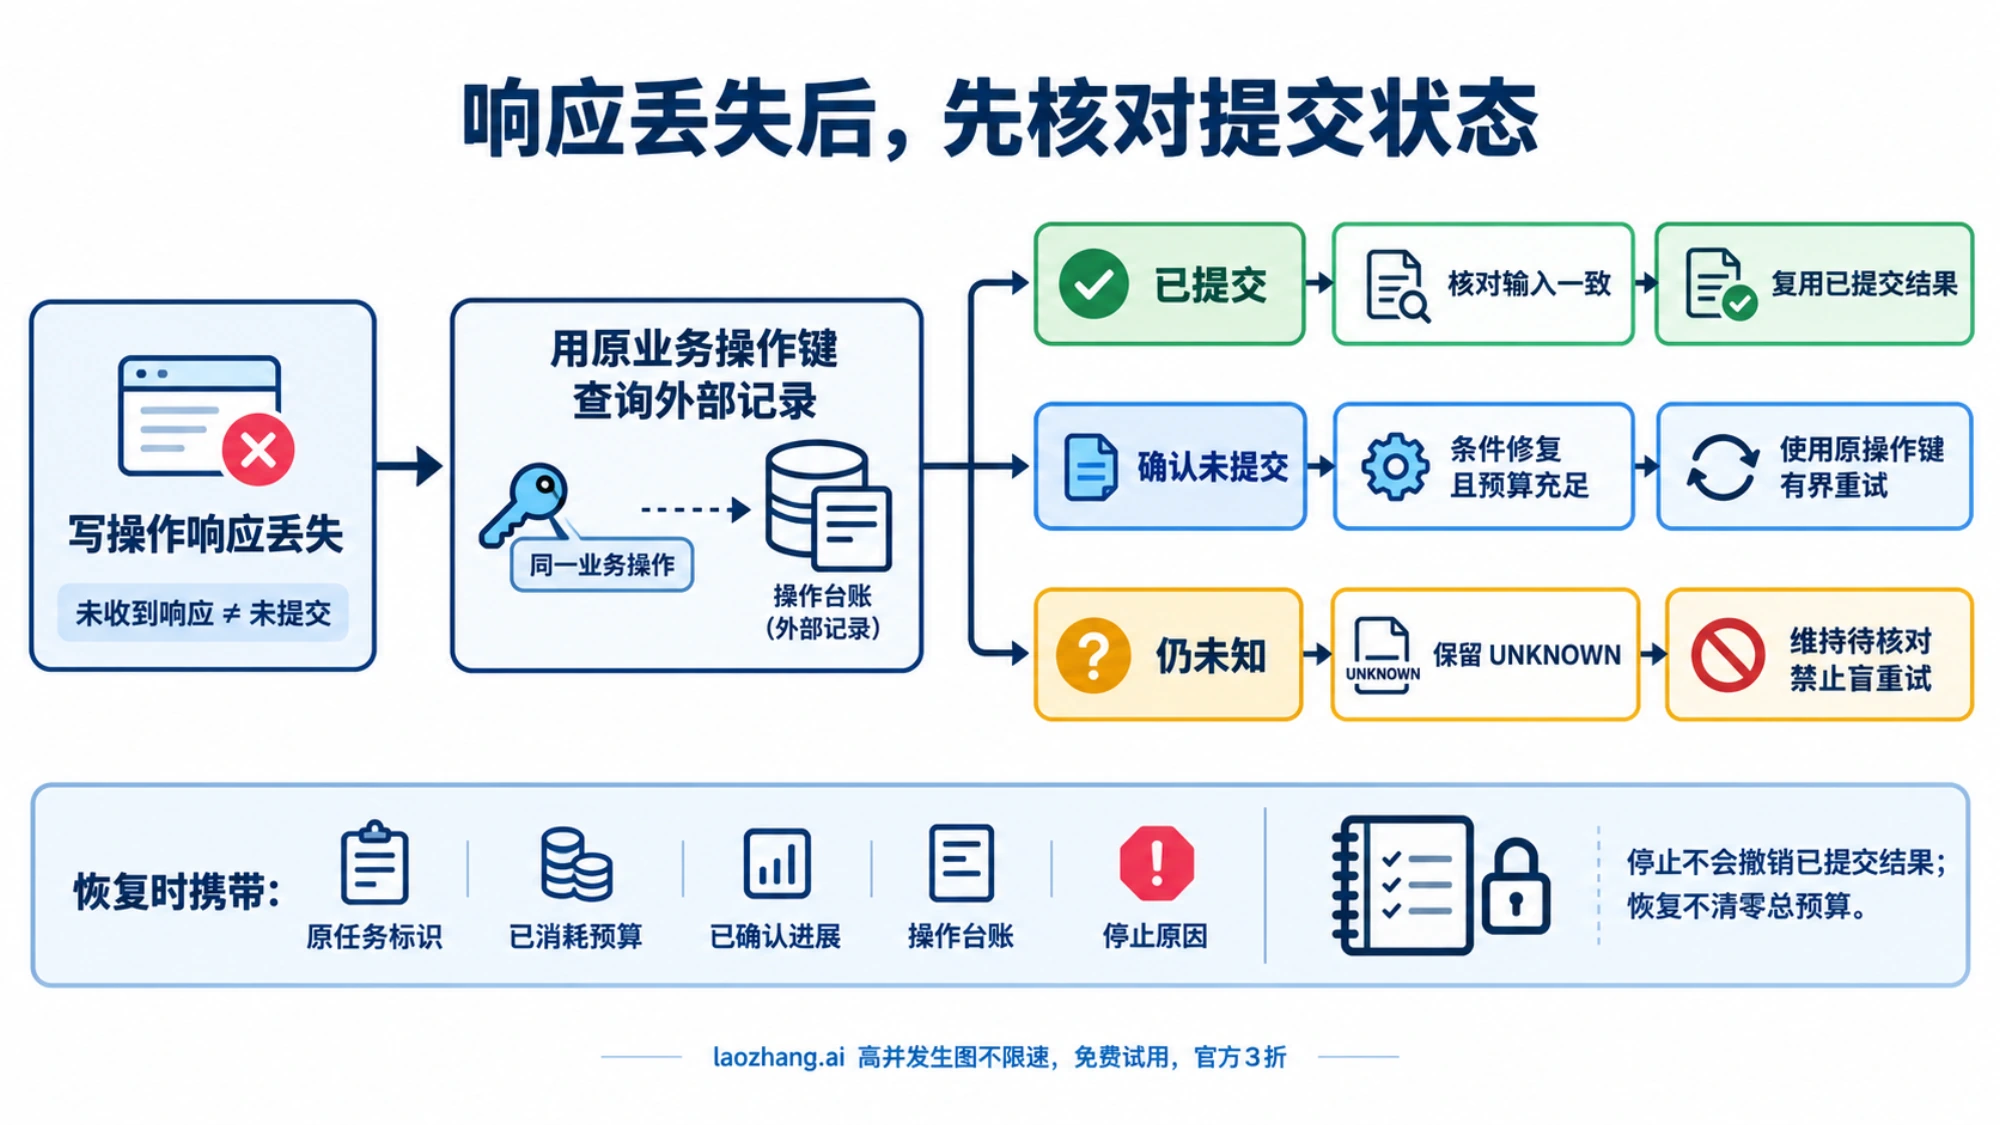
停止报告要让下一位操作者知道还缺什么。比如通知发送后响应丢失,报告可以这样表达;这是结构示例,不是真实业务记录:
{
  "state": "NEEDS_HUMAN",
  "reason": "unknown_commit",
  "completed": ["incident_loaded", "recipient_validated"],
  "operation_key": "incident-42-first-notice",
  "operation_state": "UNKNOWN",
  "remaining_budget": { "model_calls": 4, "tool_executions": 2 },
  "resume_condition": "核对该业务操作是否已提交,再处理未完成步骤"
}
恢复前先核对外部事实,再做三项决定:已提交则复用结果;明确未提交且条件修复则允许有界重试;仍不确定则维持待核对状态。权限、输入或策略发生变化,应记录是什么改变,并确认它确实解决原停止原因。对只读查询,如果预算已耗尽,可用此前核验过的结果交付部分答案,或明确缺失信息,不能偷偷重置计数再读。
检查点恢复还应携带原任务标识、已消耗预算、已确认进展、操作台账和原停止原因。正常授权的恢复可以建立新的执行阶段,但总任务预算继续累计;原型本身没有持久化恢复接口,不能靠重新构造对象获得生产恢复保证。
如果还要拦住下一次付费模型请求,需另设金额预算与调用前预留机制,可继续阅读 LLM Agent API 花费熔断开关。工具循环守卫与花费闸门分别控制行为和金额,模型轮次上限不能精确替代成本上限。
常见问题
工具已经返回成功,为什么 Agent 还会继续调用?
因为工具完成、整个任务完成和模型允许结束是三件事。先查业务目标是否满足、成功结果是否被传回规划器,再查提示是否仍要求补充某项信息,以及 tool_choice 是否强制继续选工具。对于已提交的写操作,用稳定业务操作键返回原结果;无论提示怎样写,都不应允许重复提交。
加一句“不要重复调用工具”能解决吗?
可以帮助澄清行为,但不能作为停止保证。提示之外还需要执行前上限、可信进展判断、写操作幂等和调用方终态。模型说“已完成”只有经过应用核验才能结束业务任务。
正常轮询也会被重复检测拦住,怎么办?
将“创建任务”和“查询任务状态”分开。查询保留同一个 job ID,遵守等待要求和独立轮询预算;只有经核验的业务状态变化才算进展。等待过久可以返回部分结果或待处理状态,不要为了绕过限制每次重新创建任务、换参数或清空历史。
点停止后,还会发出消息或产生扣费吗?
可能会。界面停止输出不证明后台停止;已经派发的请求可能继续完成,已提交的操作不会自动撤销。需要在后台阻止新派发,并核对在途操作及业务记录。金额风险还要用付费请求进入供应商之前的预算闸门处理。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月6日。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月6日。
- 1.StopRuntimeSession APIdocs.aws.amazon.com/bedrock-agentcore/latest/APIReference/API_StopRuntimeSession.html
- 2.n8n 社区的一则历史案例community.n8n.io/t/agent-goes-into-infinite-tool-call-loop/174472
- 3.LangChain JavaScript 工具重试中间件docs.langchain.com/oss/javascript/langchain/middleware/built-in
- 4.运行指南developers.openai.com/api/docs/guides/agents/running-agents
- 5.节点选项docs.n8n.io/integrations/builtin/cluster-nodes/root-nodes/n8n-nodes-langchain.agent/tools-agent
- 6.Loop agents 文档adk.dev/agents/workflow-agents/loop-agents
- 7.tool_choicedevelopers.openai.com/api/docs/guides/function-calling