n8n 接入 GPT Image 2.5:原生节点够不够用
n8n 的 OpenAI 节点能调用 GPT Image 2.5,但质量只到 high、尺寸仅三种;要 4K、透明背景、记录用量或接口返回链接,改用 HTTP Request。
文章目录
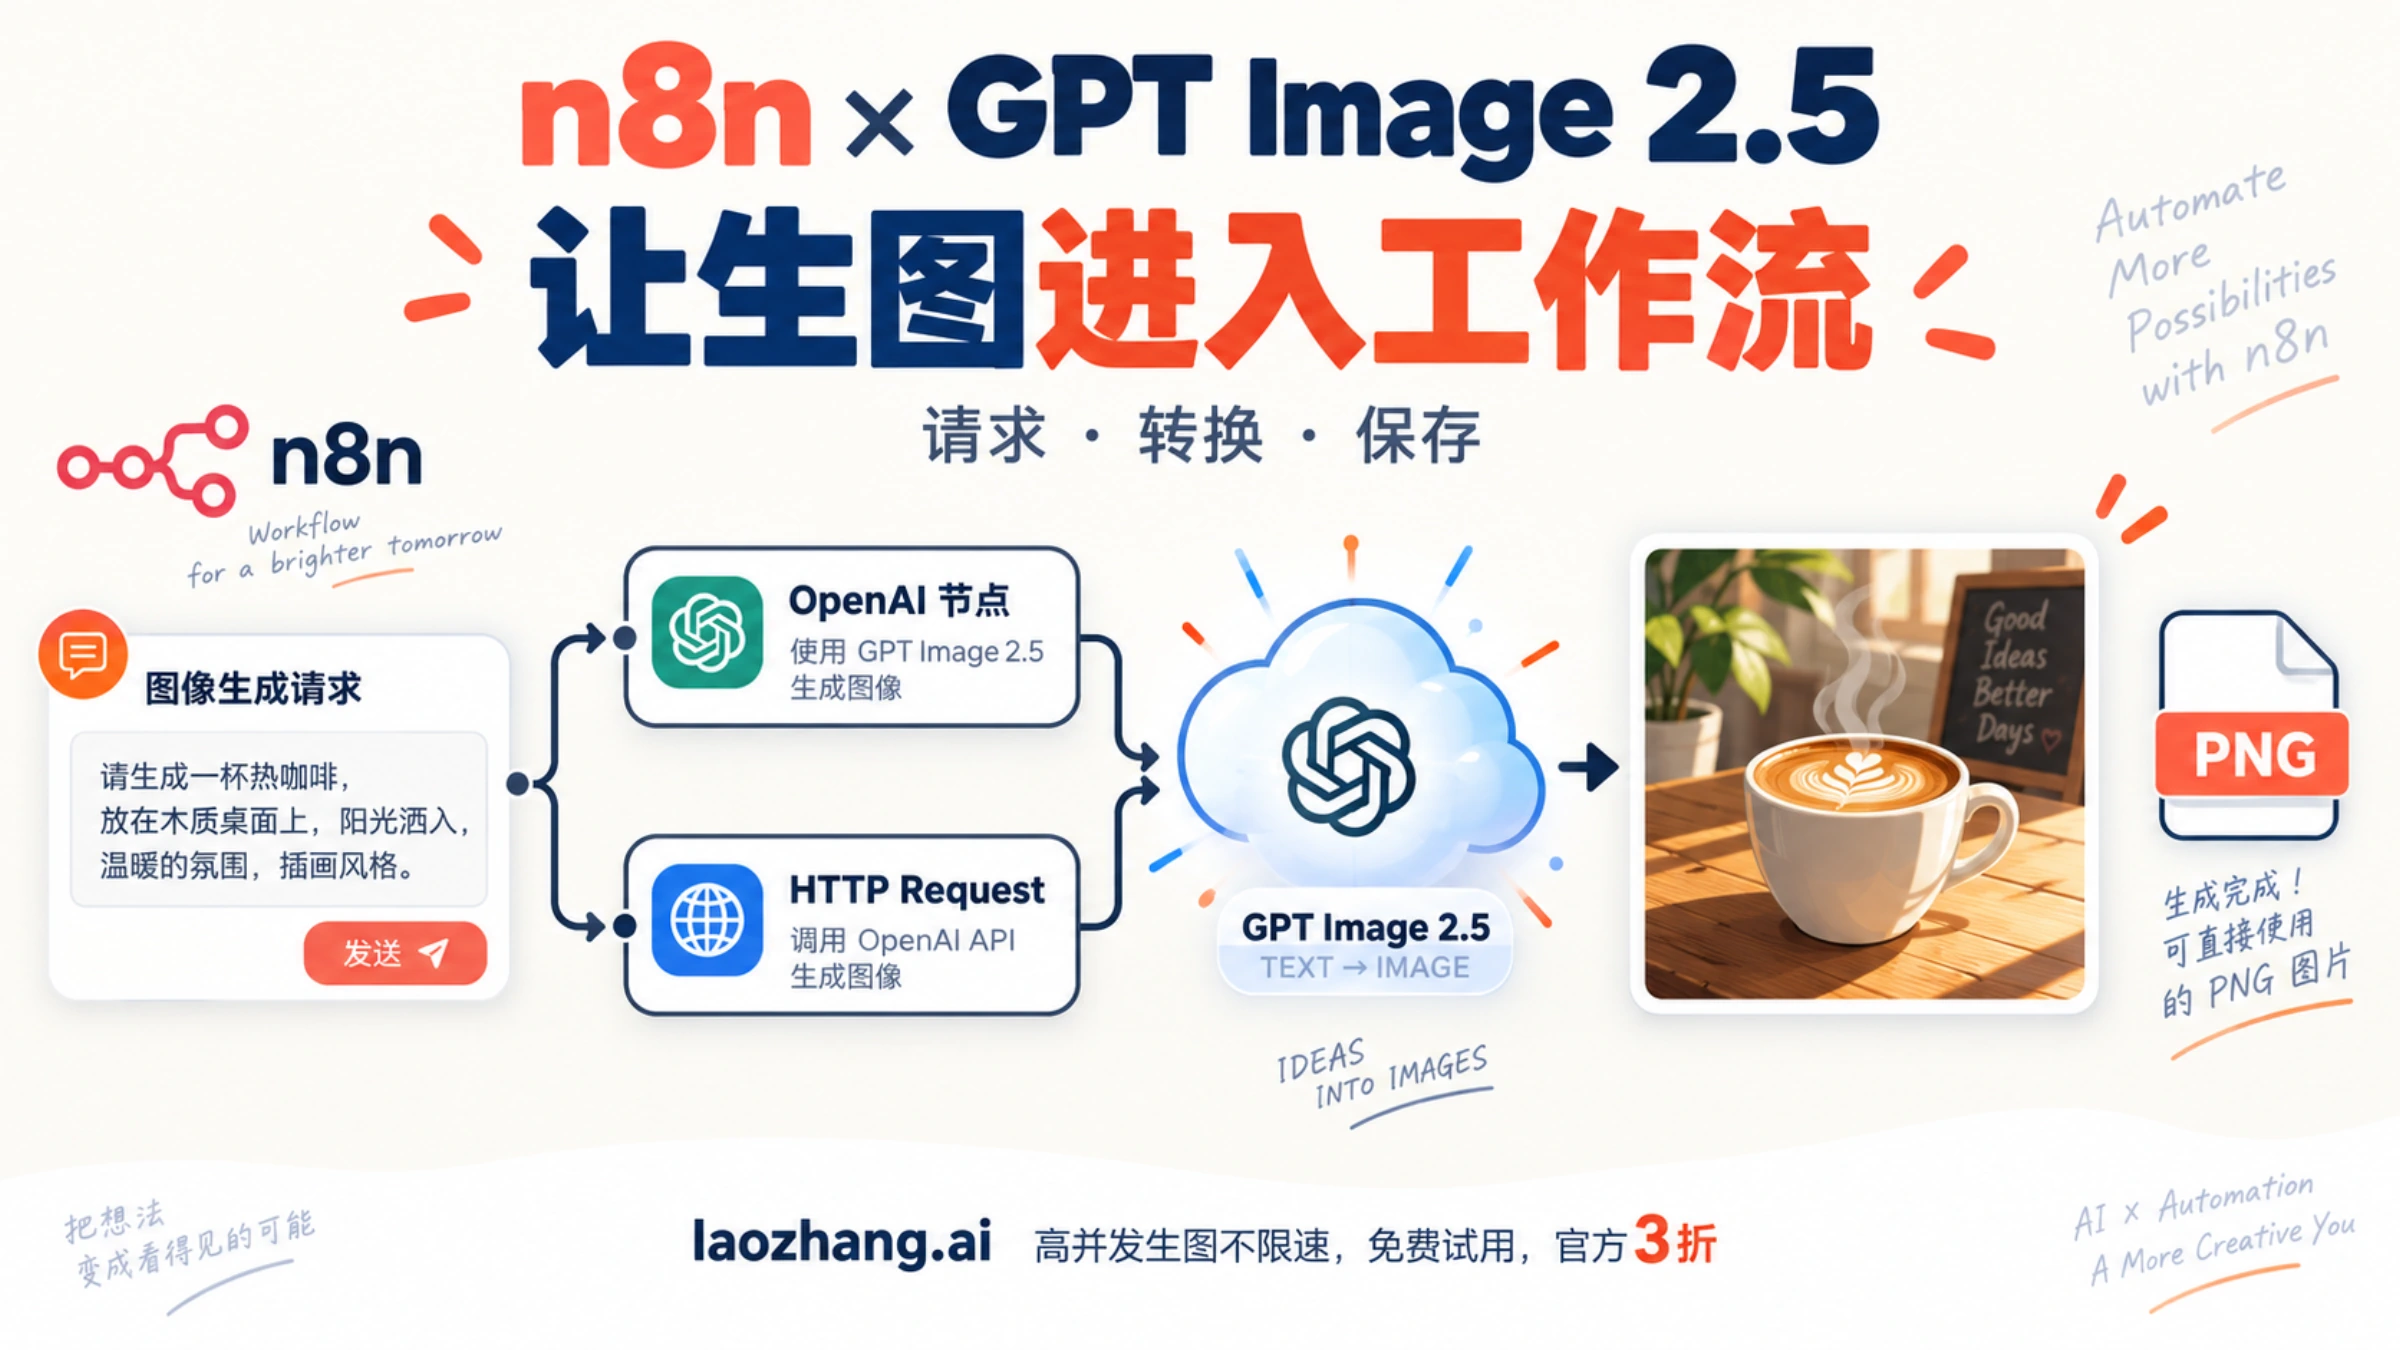
n8n 自带的 OpenAI 节点(Resource 选 Image)可以调用 GPT Image 2.5:在 Model 里从列表选,或切到 ID 手填 gpt-image-2.5-flare、gpt-image-2.5-sunburst。能不能只靠它,取决于两件事:你要的参数节点里有没有,你的接口返回的又是什么。
- 原生 Generate an Image 对 GPT Image 系列只给 High、Medium、Low 三档质量和
1024x1024、1024x1536、1536x1024三种尺寸,没有透明背景和输出格式;Edit an Image 多了背景、格式和蒙版,但质量同样最高到 high。两个操作都不把响应里的usage交给下游。 - 需要
xhigh、max、2K/4K 或自定义尺寸,要生成透明背景图,要按请求记录用量,或者接口返回的是图片链接、任务编号,就改用 HTTP Request 发请求,再用 Convert to File 把结果变成文件。
这些结论依据截至 2026 年 9 月 25 日 n8n 在 GitHub 上 master 分支的公开源码(已安装的版本可能有差异),下面的配置没有在运行中的实例上逐项实测;打开自己节点的 Options 就能对照。
先认准模型 ID 和节点版本
GPT Image 2.5 在 API 里是两个模型,请求里要写完整 ID,没有单独的 gpt-image-2.5:
| 模型 ID | OpenAI 的定位 | 当前默认快照 |
|---|---|---|
gpt-image-2.5-flare | 快速、高质量的日常生成 | gpt-image-2.5-flare-2026-09-08 |
gpt-image-2.5-sunburst | 能力最强,适合最看重编辑精度的流程 | gpt-image-2.5-sunburst-2026-09-08 |
两款都走 /v1/images/generations(生成)和 /v1/images/edits(编辑),token 单价相同,但同一质量设置下消耗的 token 可能不同,单张成本要看响应里的 usage。两款怎么选,见 GPT Image 2.5 Flare 与 Sunburst 对比:速度、编辑精度与 API 成本。
节点能不能选到 2.5,看的是节点版本(typeVersion),不是 n8n 的应用版本号。同一个 n8n 里,旧工作流中的节点可能还停在旧版本:
- Generate an Image:typeVersion 2.2 起,Model 字段可以在 From list 和 ID 之间切换;更早的节点只有 DALL·E 2、DALL·E 3、GPT Image 1 三个固定选项。
- Edit an Image:typeVersion 2.3 起才有可切换的模型列表;更早的只有 DALL·E 2 和 GPT Image 1。
如果 Model 只有固定下拉项,说明节点太旧,从节点面板重新拖一个 OpenAI 节点进来即可。From list 里的模型来自凭据 Base URL 下的 /models 接口,只列出 ID 含 dall-e 或 gpt-image 的模型;列表里没有 2.5(比如网关的 /models 没返回它),切到 ID 手填就行。
请求返回 403、提示无权使用该模型时,OpenAI 可能要求先完成组织验证(API Organization Verification),并非每个组织都需要。凭据里的 Organization ID 要不要填,见 OpenAI API Key 和 Organization ID:2026 年到底需要什么。
原生节点与 HTTP Request 各能设置什么
下表左列是 OpenAI 文档里 GPT Image 2.5 支持的能力,右边三列是 n8n 里各自能不能设置到(原生节点按 Generate typeVersion ≥ 2.2、Edit typeVersion ≥ 2.3 计):
| GPT Image 2.5 的能力 | Generate an Image | Edit an Image | HTTP Request |
|---|---|---|---|
| 质量 low / medium / high | 可以,默认 medium | 可以 | 可以 |
| 质量 auto | 没有这一项 | 可以,默认 auto | 可以,不传时 API 默认 auto |
| 质量 xhigh / max | 不行 | 不行 | 可以 |
| 尺寸 1024x1024 / 1024x1536 / 1536x1024 | 可以 | 可以,另有 auto | 可以 |
| 2K、4K 或自定义宽高 | 不行 | 不行 | 可以 |
透明背景 background | 不行 | 可以 | 可以 |
| 输出格式 jpeg / webp | 不行,只能拿到默认的 PNG | 可以,另有压缩率 | 可以 |
审核强度 moderation | 不行 | 不行 | 可以 |
| 多张参考图 | 不适用 | 可以,按 image[] 重复发送 | 可以 |
蒙版 mask | 不适用 | 可以,选项 Image Mask | 可以 |
响应里的 usage | 丢弃 | 丢弃 | 完整保留 |
| 接口返回图片链接或任务编号 | 无法处理 | 无法处理 | 可以接后续节点 |
按表做决定:
- 固定尺寸、质量不超过 high、要 PNG、不需要按请求算账:原生 Generate 就够。它把每张图直接放进 Binary 字段
data(Options 里的 Put Output in Field 可以改名),上传节点直接接上即可。 - 改图、换背景、多图合成,质量到 high 就够:原生 Edit。Options 里的 Input Fidelity 保持不设:OpenAI 只在旧模型下说明这个参数,GPT Image 2 明确不允许修改,2.5 的文档里没有它。
- 其余情况用 HTTP Request。按量付费、需要控制成本的流程尤其如此,因为原生节点连
usage都拿不到。
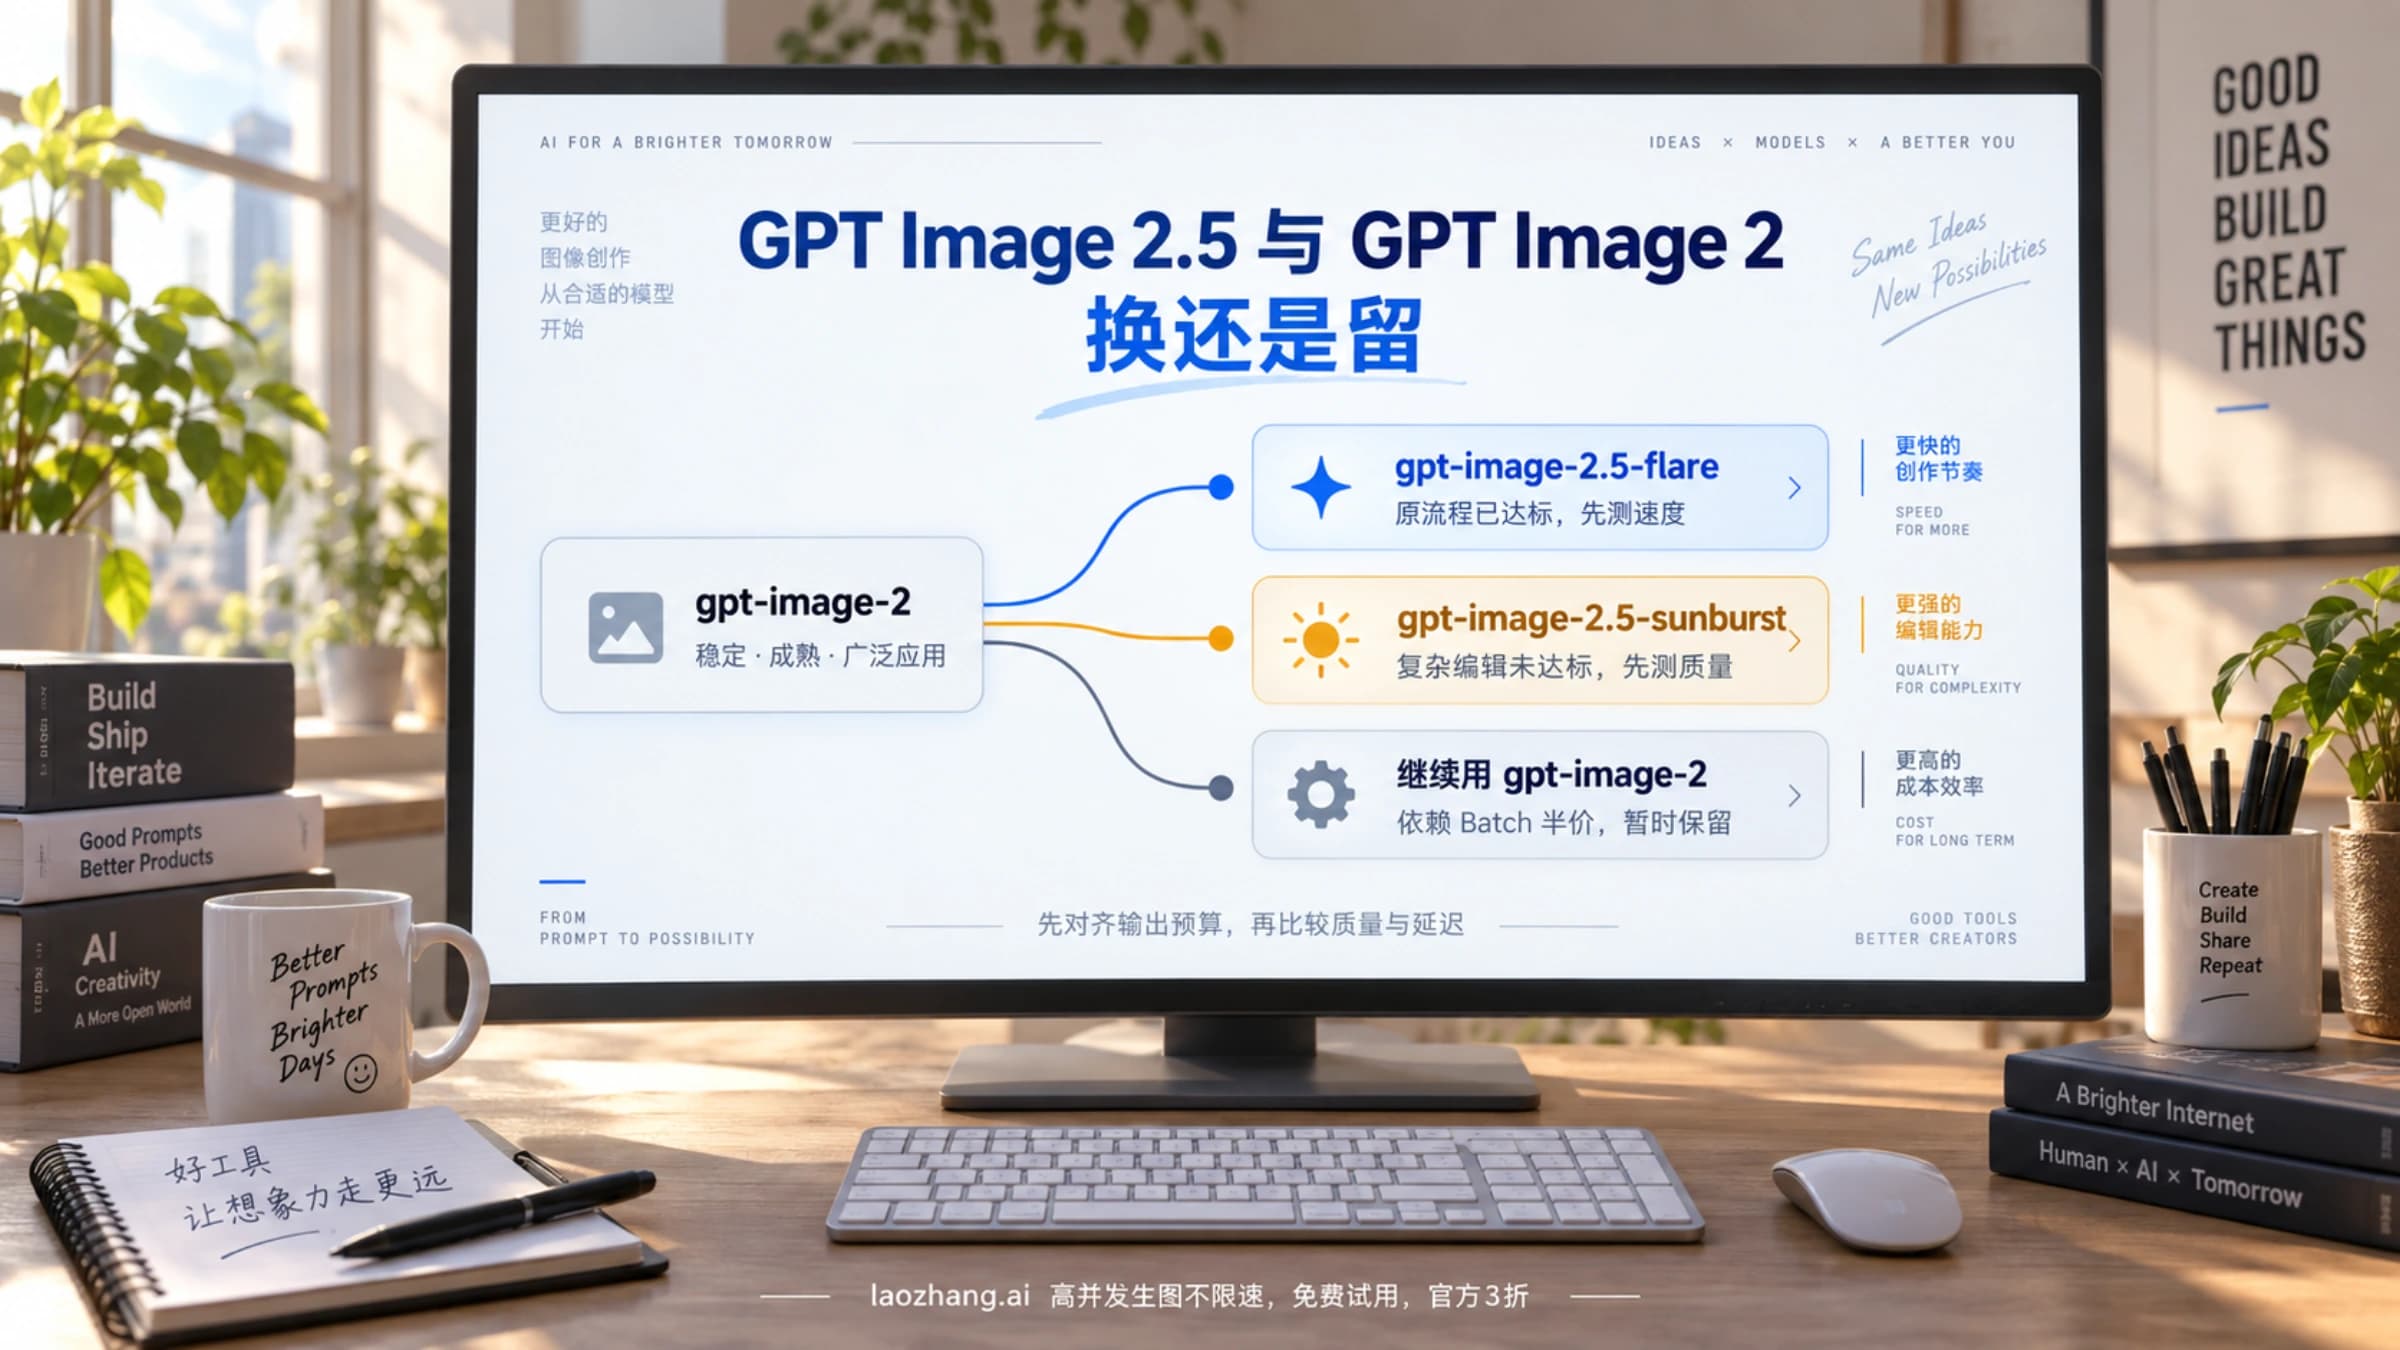
在自己的节点上确认很简单:Generate 的 Options → Add Option → Quality,下拉里如果只有 High、Medium、Low,就是上表的情况。原来跑 GPT Image 2 的工作流只把模型 ID 换成 2.5 时,同名 quality 的输出 token 可能变化,差异见 GPT Image 2.5 与 GPT Image 2:换还是留。
先看你的接口返回什么
同样标着 GPT Image 2.5,不同接口给回的东西可能完全不同,这决定了 n8n 里要接哪些节点:
| 返回形态 | 常见于 | n8n 里怎么接 |
|---|---|---|
data[0].b64_json,纯 Base64 字符串 | OpenAI 直连 | 原生节点直接出文件;或 HTTP Request 后接 Convert to File |
b64_json 带 data:image/png;base64, 前缀,或末尾缺 = | 部分网关 | HTTP Request → 清理字符串 → Convert to File |
data[0].url,链接会过期 | 部分网关 | HTTP Request → 第二个 HTTP Request 立即下载 |
| 先返回任务编号,再查询结果 | 异步任务型网关 | 提交 → Wait → 查询,拿到图片地址后再下载 |
原生 OpenAI 节点只会把 b64_json 解码成文件。拿到 url 时它没有可解码的内容,拿到任务编号更无从处理,这两种都要走 HTTP Request。
异步任务型的例子是 HiAPI 的 n8n 工作流:它用自家的 https://api.hiapi.ai/v1/tasks/ 接口,提交后拿到任务编号,模板每 5 秒查询一次、最多 36 次,最后得到 resultUrl;把图片存下来要另外接节点。不确定自己的接口属于哪种时,用 HTTP Request 发一次最小请求,在输出面板里看 data 下面是 b64_json、url 还是只有任务信息。
用中转 API:只改 Base URL 够不够
n8n 的 OpenAI 凭据有四项:API Key、Organization ID (optional)、Base URL(默认 https://api.openai.com/v1)和 Add Custom Header。原生节点把请求发到「Base URL + /images/generations」,所以把 Base URL 改成网关地址,原生节点就会走网关。这样做要同时满足三个条件:
- 网关提供同样路径的
/images/generations和/images/edits; - 模型 ID 与 OpenAI 一致,或者你在 ID 模式里手填网关要求的 ID;
- 返回的是干净的
b64_json。
有一条不满足,就按网关文档在 HTTP Request 里发请求。网关的参数范围、计费和限速按它自己的规则,不能套用 OpenAI 的用量等级。
以 LaoZhang API 为例
LaoZhang API 的 Base URL 是 https://api.laozhang.ai/v1,GPT Image 2.5 分三条线路,截至 2026 年 9 月 24 日的公开价格如下:
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 线路 | 模型 ID | 计费 | 在 n8n 里要注意 |
|---|---|---|---|
| 官方 API 转发(文档简称「官转」) | gpt-image-2.5-flare、gpt-image-2.5-sunburst | 按 token;Sora2Official 分组与 OpenAI 同价,GPTImage2 Sora2 Enterprise 分组加价 20% | 参数规则同 OpenAI,不要传 response_format |
| VIP 按次 | gpt-image-2.5-flare-vip、gpt-image-2.5-sunburst-vip | 每次 $0.03,与质量档位无关 | 支持 low 到 max 五档和自定义尺寸,不支持 mask |
| 网页版 | gpt-image-2.5-web | 按次计费,单价与 VIP 相同 | 不能指定 Flare 或 Sunburst |
分组在创建令牌时选,不写进 model。VIP 两款模型 2026 年 9 月 16 日曾停用,9 月 22 日起已恢复。它的文档写明 data[] 里可能是带前缀或缺 = 的 b64_json,也可能是会过期的 url,所以在 n8n 里更稳的做法是 HTTP Request 加下一节的清理步骤;原生节点只在返回干净 b64_json 时可用。按 token 和按次哪个划算,见 GPT Image 2.5 Sunburst 价格:官方单图费用与按次计费怎么选。
用 HTTP Request 生成并存成图片文件
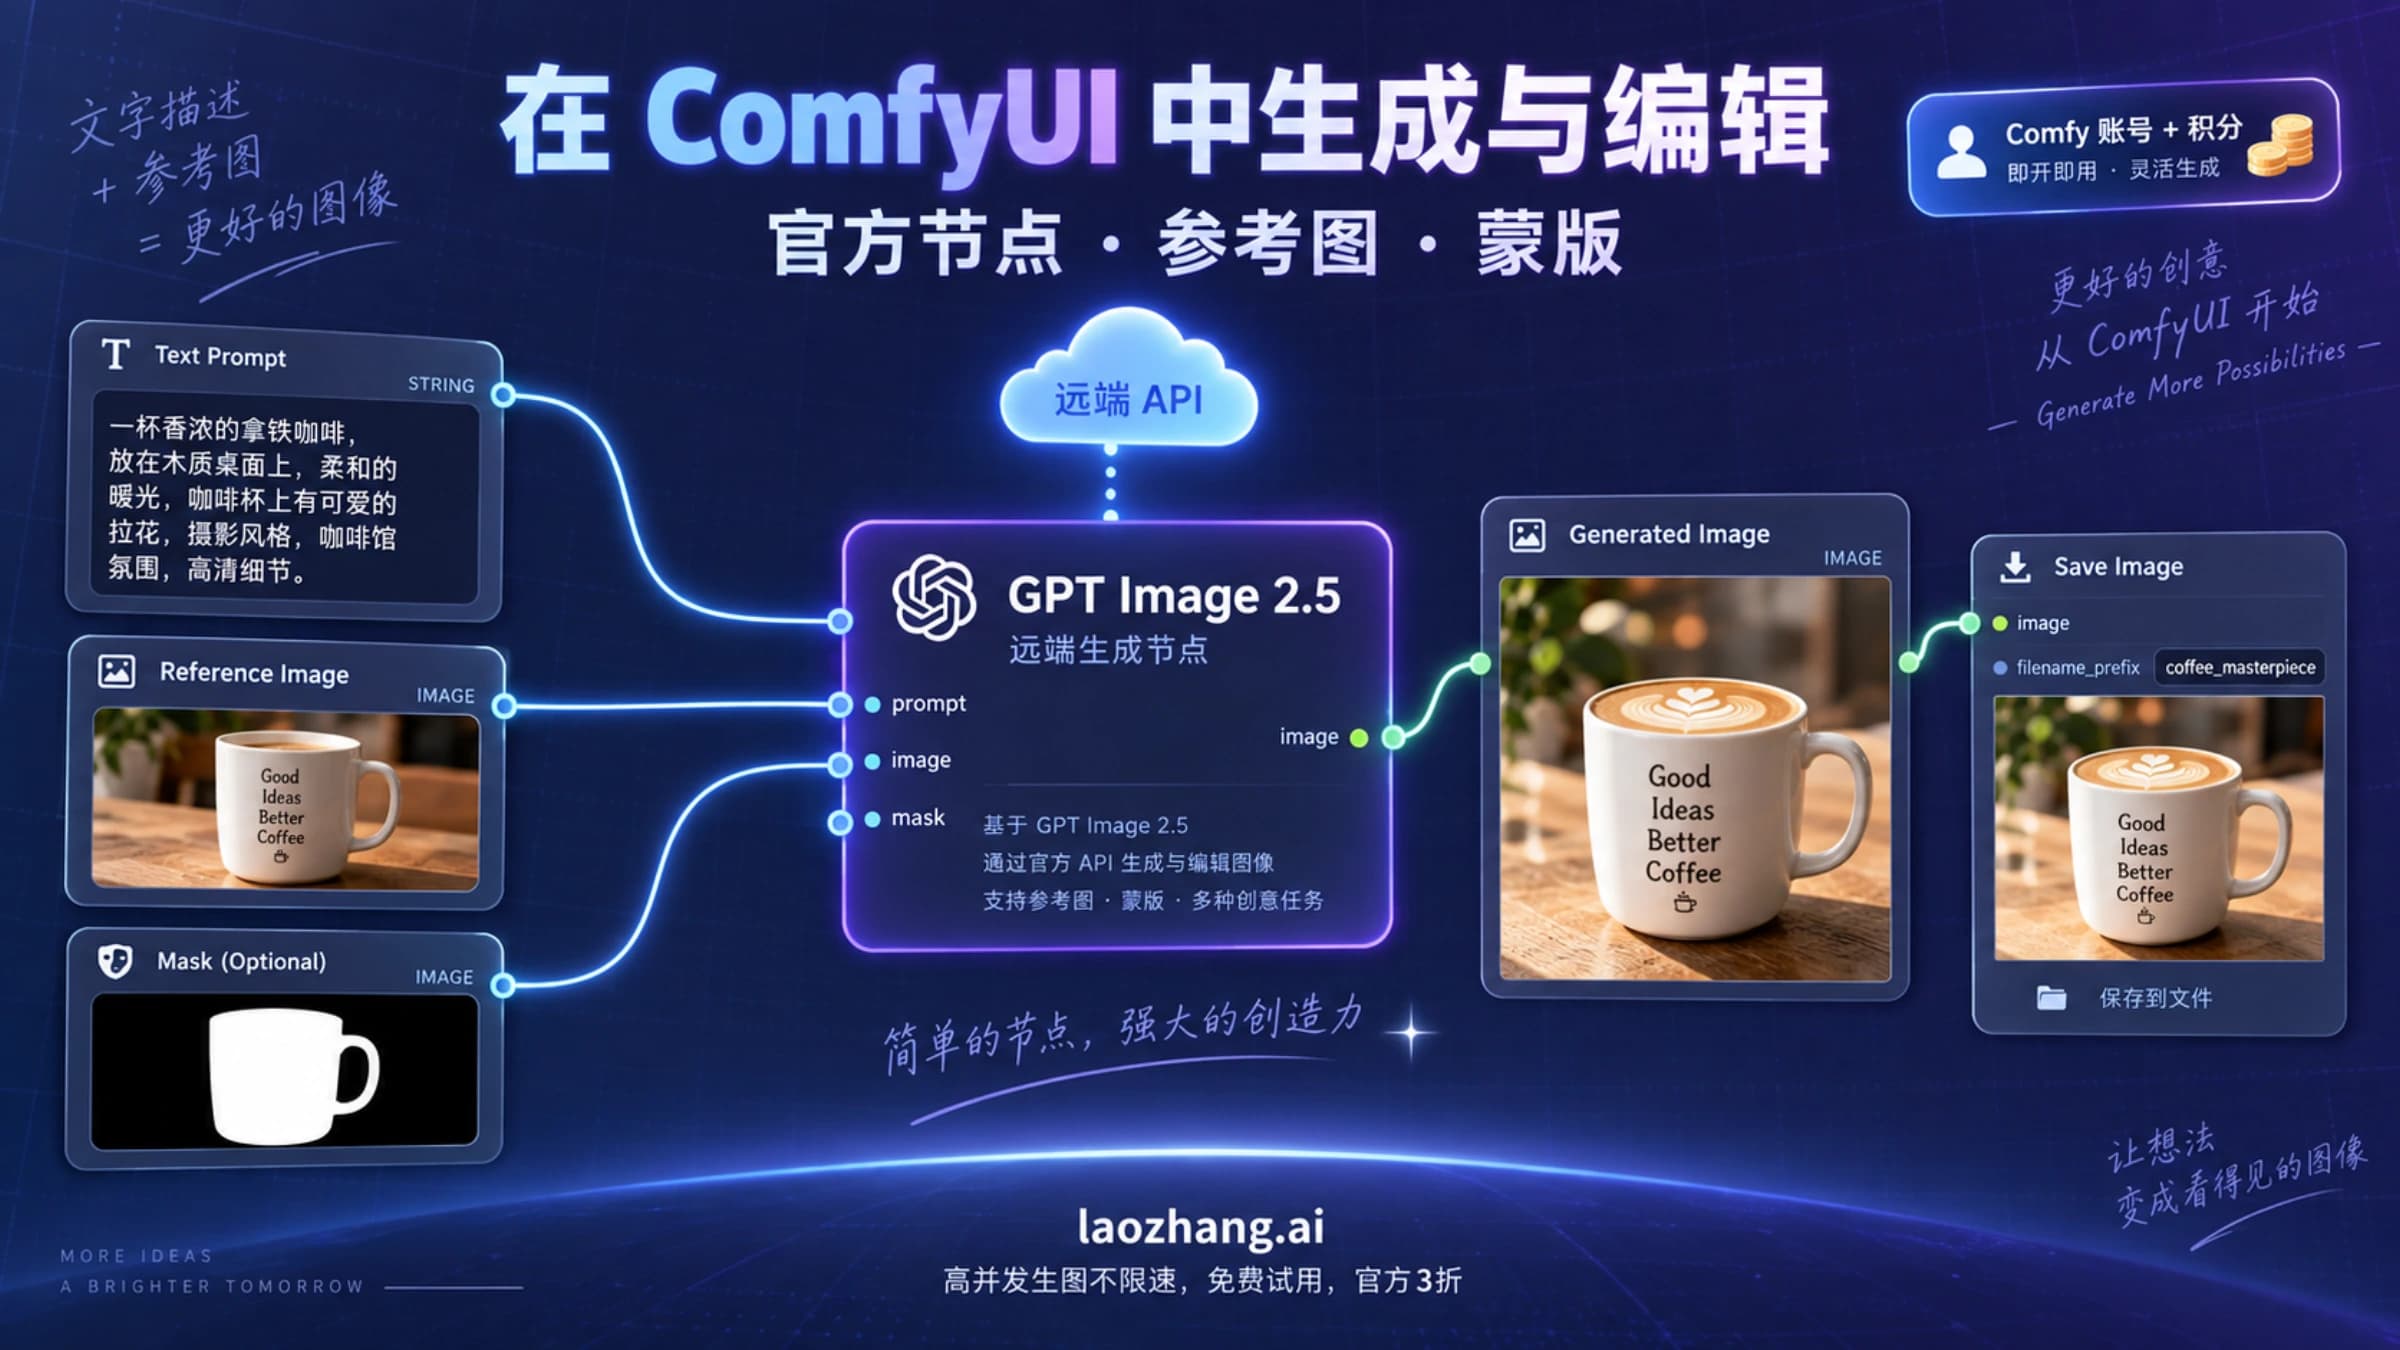
整条链路是:触发 → HTTP Request 发请求 → 一路记录用量、一路取出 Base64 → Convert to File → 上传或保存。
1. HTTP Request 发请求。 Method 选 POST,URL 填 https://api.openai.com/v1/images/generations(网关则是它的 Base URL 加 /images/generations)。Authentication 可以选 Predefined Credential Type 并选用已建好的 OpenAI 凭据,也可以用 Generic 的 Header Auth,Name 填 Authorization,Value 填 Bearer 加你的 Key。打开 Send Body,Body Content Type 选 JSON,Specify Body 选 Using JSON,并把这个字段切到 Expression:
{
  "model": "gpt-image-2.5-flare",
  "prompt": {{ JSON.stringify($json.prompt) }},
  "size": "2048x1152",
  "quality": "high",
  "output_format": "png"
}
JSON.stringify 负责给上游传来的提示词加引号并转义换行,提示词里有双引号也不会把 JSON 弄坏。几个参数的取值依据:
size自定义时,宽高都要是 16 的倍数,宽高比在 1:3 到 3:1 之间,任一边不超过 3840 像素,总像素在 655,360 到 8,294,400 之间。2048x1152是 16:9、约 236 万像素;超过2560x1440的分辨率 OpenAI 标为实验性。- 要透明背景,加
"background": "transparent",output_format用png或webp。 - 不在意透明度、想快一些,可以用
jpeg并设output_compression(0–100),OpenAI 说明 jpeg 比 png 快。 - 不要加
response_format。GPT Image 系列固定返回 Base64,n8n 原生节点对它也不发送这个参数;LaoZhang 的官转线路收到它可能直接报参数错误。
在 Options 里再加两项:Timeout 填 180000(毫秒);批量跑时加 Batching,数值见下一节。OpenAI 说明复杂提示可能要 2 分钟才处理完,而 n8n 的 Timeout 只管「等到服务器开始返回」这一段,超过就中断,所以要留出余量。Response 下的 Include Response Headers and Status 先不开,开了以后所有字段会挪到 body. 下面,后面的路径都要跟着改。
2. 分两路。 把 HTTP Request 的输出同时连到两个节点。Convert to File 输出的条目 JSON 是空的,上游的 usage 过了这一步就没了,所以用量必须在转换之前记下来:一路接 Google Sheets、Data Table 之类的记录节点,写入 {{ $json.usage.input_tokens }}、{{ $json.usage.output_tokens }}、{{ $json.usage.total_tokens }};另一路接 Edit Fields,新建字段 image_base64,值为 {{ $json.data[0].b64_json }}。
3. Convert to File。 Operation 选 Move Base64 String to File,Base64 Input Field 填 image_base64。这里填的是字段名,不是 Base64 内容本身,别把一长串编码粘进去。Put Output File in Field 保持 data,Options 里加 File Name(如 cafe-menu.png)和 MIME Type(image/png,与请求的 output_format 一致)。
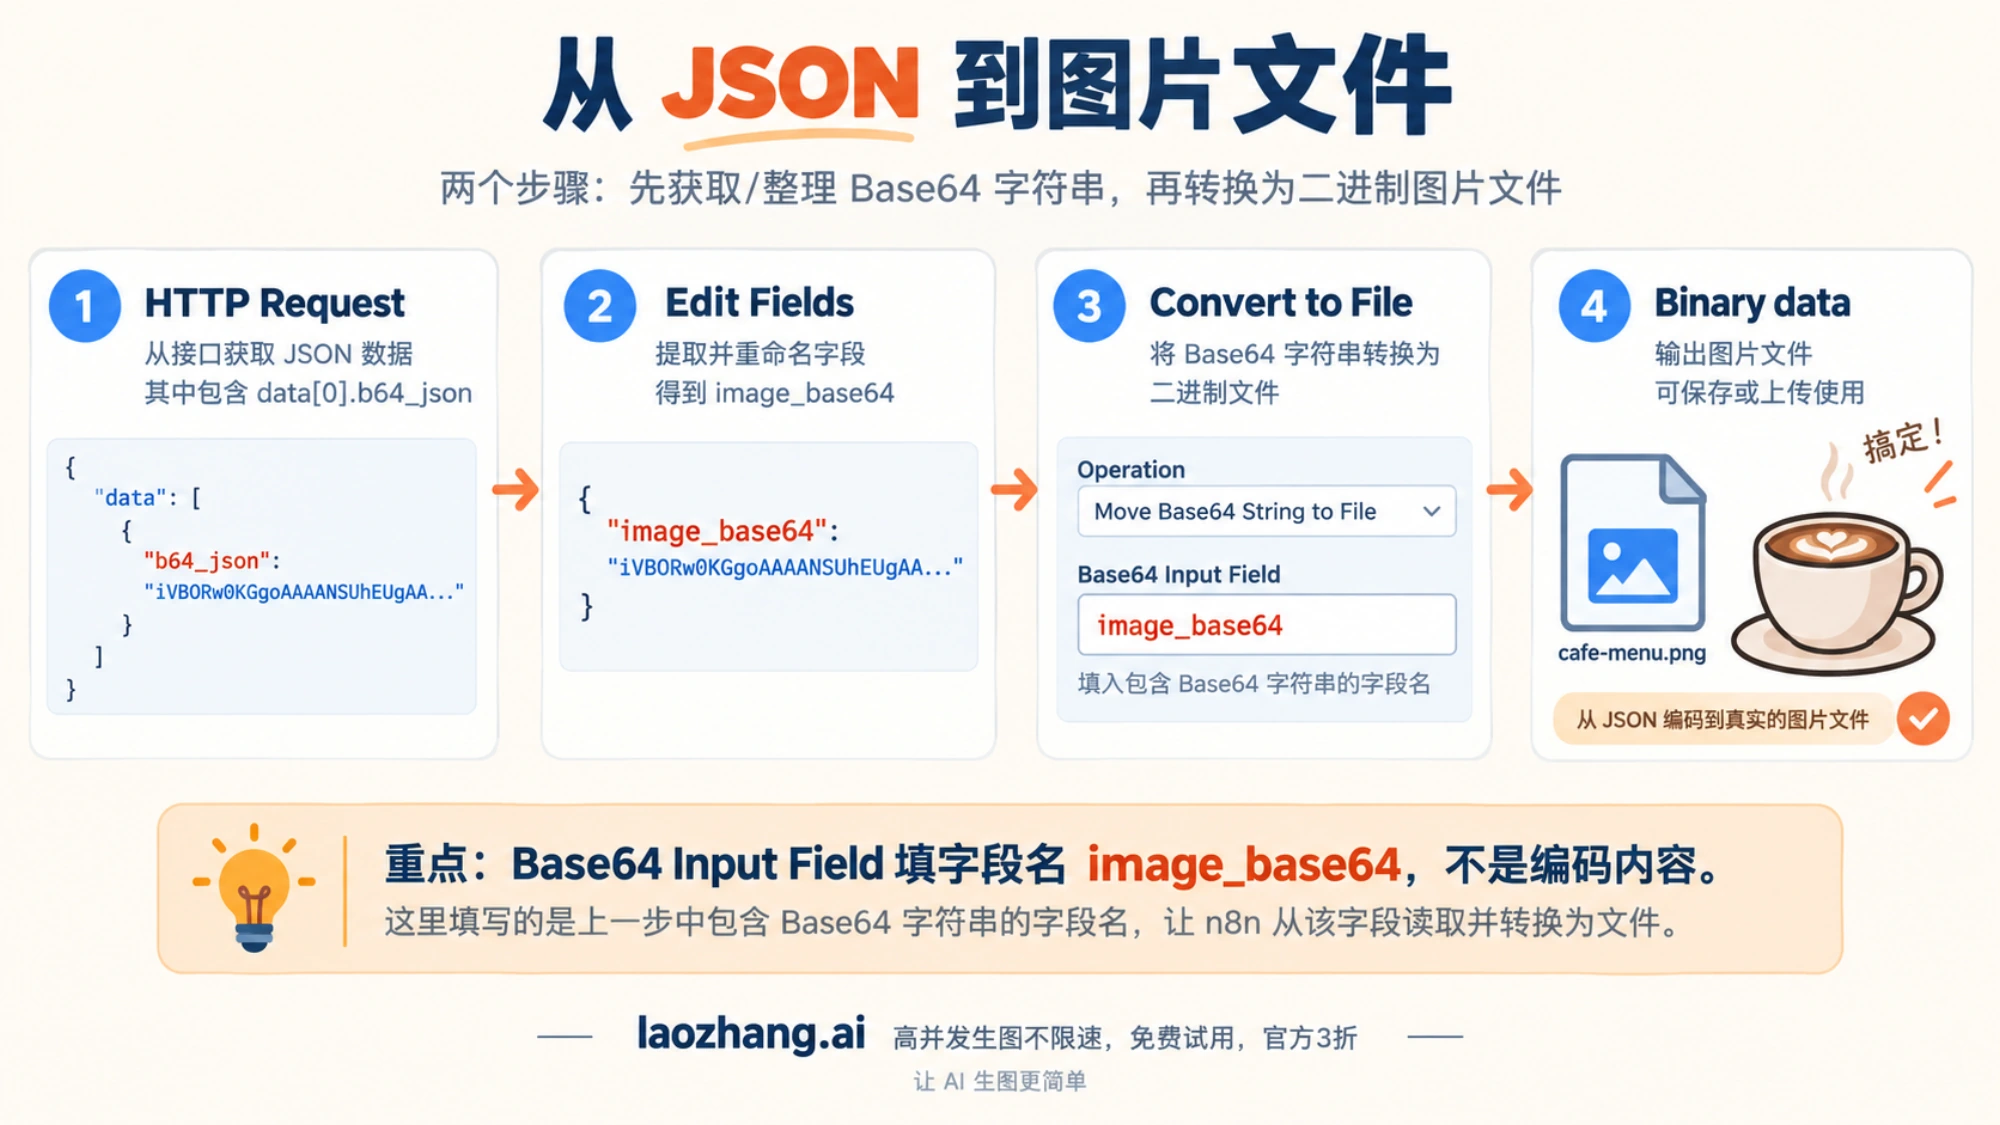
4. 交付。 Google Drive、S3、Read/Write Files from Disk 等节点里,要上传的 Binary 字段填 data,和上一步的 Put Output File in Field 对上。
网关返回带前缀的 Base64 或链接时
用 Code 节点(Mode 选 Run Once for Each Item)代替第 2 步里的 Edit Fields,一次把前缀、空白和缺失的 = 处理掉,同时把链接和用量带出来:
const item = $json.data?.[0] ?? {};
let b64 = item.b64_json ?? '';
b64 = b64.replace(/^data:[^,]+,/, '').replace(/\s/g, '');
if (b64) b64 += '='.repeat((4 - (b64.length % 4)) % 4);

return {
  json: {
    image_base64: b64,
    image_url: item.url ?? null,
    usage: $json.usage ?? null,
  },
};
image_base64 有值就照常接 Convert to File。只拿到 image_url 时,接一个 HTTP Request,Method GET,URL 填 {{ $json.image_url }},Options → Response → Response Format 选 File,Put Output in Field 填 data,下载到的就是 Binary 文件。链接会过期,下载要紧跟在生成之后,不要等人工审核完再取。
用 HTTP Request 编辑:多张参考图与蒙版
编辑请求发到 /v1/images/edits,Body Content Type 选 Form-Data。参考图和蒙版要先以 Binary 字段的形式出现在同一个条目里,比如 product、logo、mask 三个字段,然后按下表添加参数:
| Parameter Type | Name | 值 / Input Data Field Name |
|---|---|---|
| Form Data | model | gpt-image-2.5-sunburst |
| Form Data | prompt | 把第二张图里的标志印到第一张图的杯身上,其余保持不变 |
| Form Data | quality | xhigh |
| Form Data | size | 1536x1024 |
| n8n Binary File | image[] | product |
| n8n Binary File | image[] | logo |
| n8n Binary File | mask | mask |
多张参考图就是重复添加名为 image[] 的参数。n8n 节点说明和 LaoZhang 文档都写最多 16 张,参考图按图片输入 token 计费,张数越多输入费用越高。蒙版的规则:
- 有多张图时,mask 只作用于第一张(上表里的
product); - mask 要和这张图格式相同、尺寸相同,并带 alpha 通道,完全透明的区域是要修改的部分;
- 蒙版只是引导,OpenAI 说明模型不一定严格沿着它的形状修改,上线前先用几次请求确认效果;
- 大小上限各处写法不一:OpenAI 指南写图片和蒙版小于 50 MB,n8n 节点说明和 LaoZhang 文档写蒙版 PNG 小于 4 MB。把蒙版控制在 4 MB 以内,两边都不会出问题。
响应和生成请求一样,后面照搬上一节的记录用量、Convert to File 和交付步骤。
批量生成:按用量等级设间隔和超时
OpenAI 对两款 2.5 模型按组织的用量等级限制每分钟图片数(IPM)。要让逐张请求不超限,请求间隔至少是:
最小间隔(毫秒)= 60,000 ÷ IPM
| 用量等级 | TPM | IPM | 最小间隔 |
|---|---|---|---|
| Tier 1 | 100,000 | 5 | 12,000 ms |
| Tier 2 | 250,000 | 20 | 3,000 ms |
| Tier 3 | 800,000 | 50 | 1,200 ms |
| Tier 4 | 3,000,000 | 150 | 400 ms |
| Tier 5 | 8,000,000 | 250 | 240 ms |
这个换算假设每次请求只出一张图,同一组织下没有别的流量在用额度;一次请求出多张图时每张是否都计入 IPM,官方文档没有写明。在 HTTP Request 的 Options → Batching 里,Items per Batch 填 1,Batch Interval 填不小于表中数值的毫秒数。例如 Tier 1 的账号跑 30 条提示词,至少需要 30 × 12 秒 = 6 分钟,再加上每张图本身的生成时间。等级会随累计消费提高,以控制台显示的当前等级为准;用网关时按网关自己的限速来设。
Timeout 与间隔无关,按单张最长耗时设:前面给的 180000 毫秒对应 OpenAI 说的最长约 2 分钟再留一分钟余量。质量调到 xhigh、max 或尺寸接近 4K 时耗时更长,发现频繁超时再往上调。
请求成功之后:核对用量、文件和交付
节点变绿只说明拿到了响应,还要确认两件事:转出来的文件能打开,目标位置真的收到了。
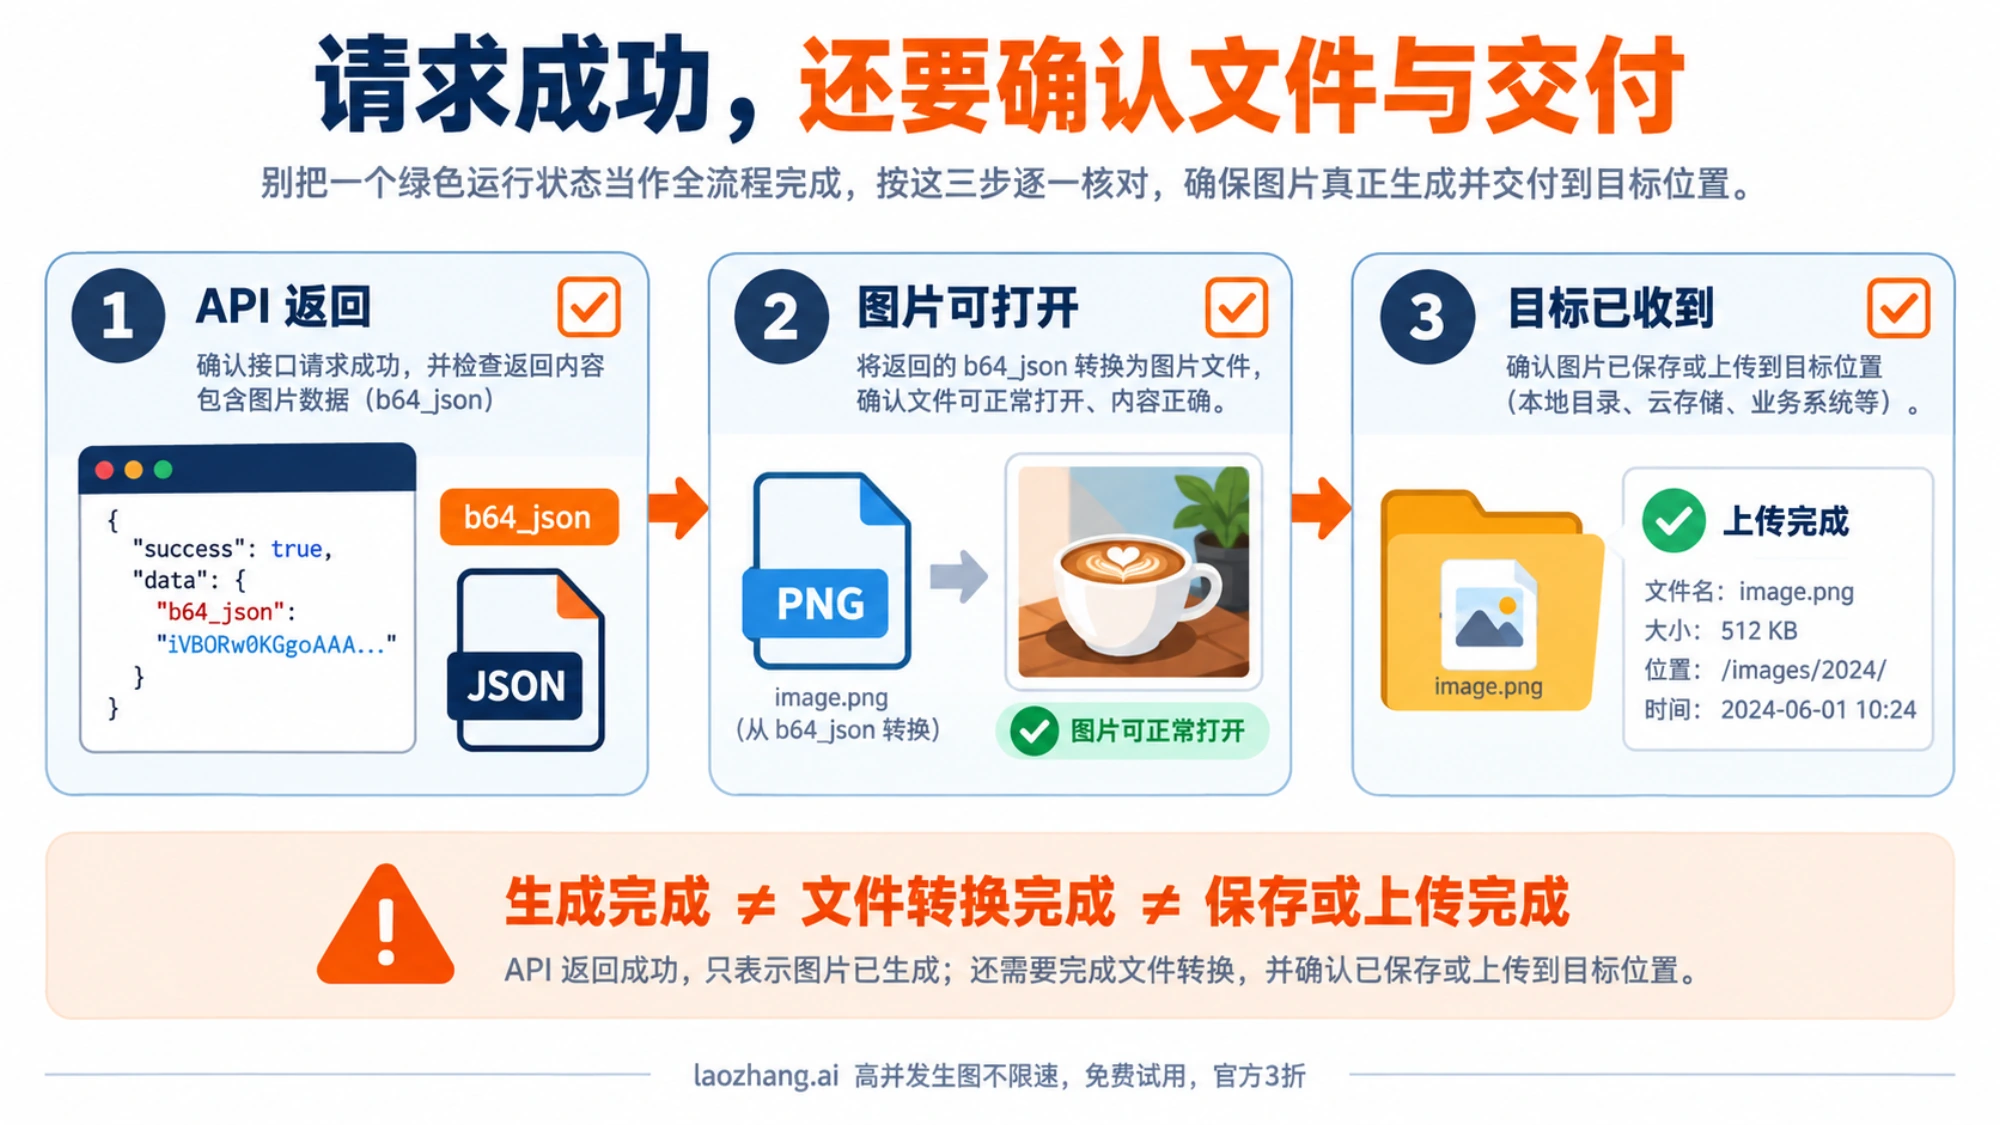
按现象排查:
节点报错。 想在工作流里按错误分流,可以在 Response 选项里同时打开 Never Error 和 Include Response Headers and Status,再用 IF 节点判断 statusCode(此时正文字段在 body. 下面)。按错误类型处理:
- 429 限流或 5xx 服务端错误:可以重试,每次间隔逐步拉长;
- 额度不足一类错误:不要自动重试,先处理账户额度;
error.type为image_generation_user_error,例如error.code为moderation_blocked:不改提示词或输入图就不要重试,moderation_details.moderation_stage会告诉你拦截发生在输入还是输出;- 403 或无权使用模型:先看上文的组织验证;
- 400 参数错误:检查自定义尺寸是否满足约束、是否多传了
response_format、质量档位是否被当前线路支持。
节点绿了,后面没有文件。 依次看:Convert to File 的 Base64 Input Field 是不是填成了编码内容;开了 Include Response Headers and Status 之后路径有没有改成 body.data[0].b64_json;返回里到底是 b64_json、url 还是只有任务编号(后两种要按上文接下载或查询)。
有文件但打不开。 多半是 Base64 带了 data:image/png;base64, 前缀或缺少末尾的 =,用上面的 Code 节点清理;再看 MIME Type 和文件扩展名是否与 output_format 一致。文件能打开但画面颗粒重、发脏,按 GPT Image 2.5 噪点、颗粒感:找到变脏的那一步再修 排查。
文件正常,目标位置没收到。 上传节点里的 Binary 字段名要和 Convert to File 的 Put Output File in Field 一致(默认都是 data);中间如果插了别的节点,在它的输出面板里确认 Binary 数据还在。
统计里看不到用量。 原生 OpenAI 节点的图片操作都不上报 token 用量。GitHub issue #38482 的报告者在 n8n 2.38.6、节点 typeVersion 2.3 上用 gpt-image-2.5-flare 复现了这个问题,并指出表达式和 Code 节点都取不回来;截至 2026 年 9 月 25 日这个 issue 仍未关闭。看不到用量不等于没花钱,要按请求记账就用 HTTP Request,在 Convert to File 之前把 usage 写下来。
请求超时。 超时不能说明服务端没有生成。LaoZhang 的文档写明,客户端超时或断开不会取消服务端生成,生成完成后照常扣费;OpenAI 的公开文档里没有这方面的说明。所以超时后别急着让整批重跑,先去控制台的调用日志或用量页面确认上一次请求的状态。
常见问题
n8n 官方文档只写了 DALL·E 和 gpt-image-1,是不是还不支持 2.5?
文档没跟上,不代表节点不能用。n8n 的 OpenAI 图片操作文档目前只写到 DALL·E 2/3 和 gpt-image-1,但节点源码里的模型字段已经是可手填 ID 的形式,typeVersion 2.2 以上的 Generate 和 2.3 以上的 Edit 都能填 gpt-image-2.5-flare 或 gpt-image-2.5-sunburst。限制在于能设置的参数,见上面的对照表。
能在 AI Agent 或 Message a Model 里直接选 GPT Image 2.5 吗?
不能把它当对话模型用。OpenAI 的模型页写明,2.5 不能作为 /v1/responses 的顶层模型,只支持 Images API 的生成和编辑接口(或作为 Responses 图片生成工具背后的模型)。在 n8n 里要用 OpenAI 节点的 Image 资源,或者 HTTP Request 直接调用 /v1/images/generations、/v1/images/edits。
一张图多少钱?
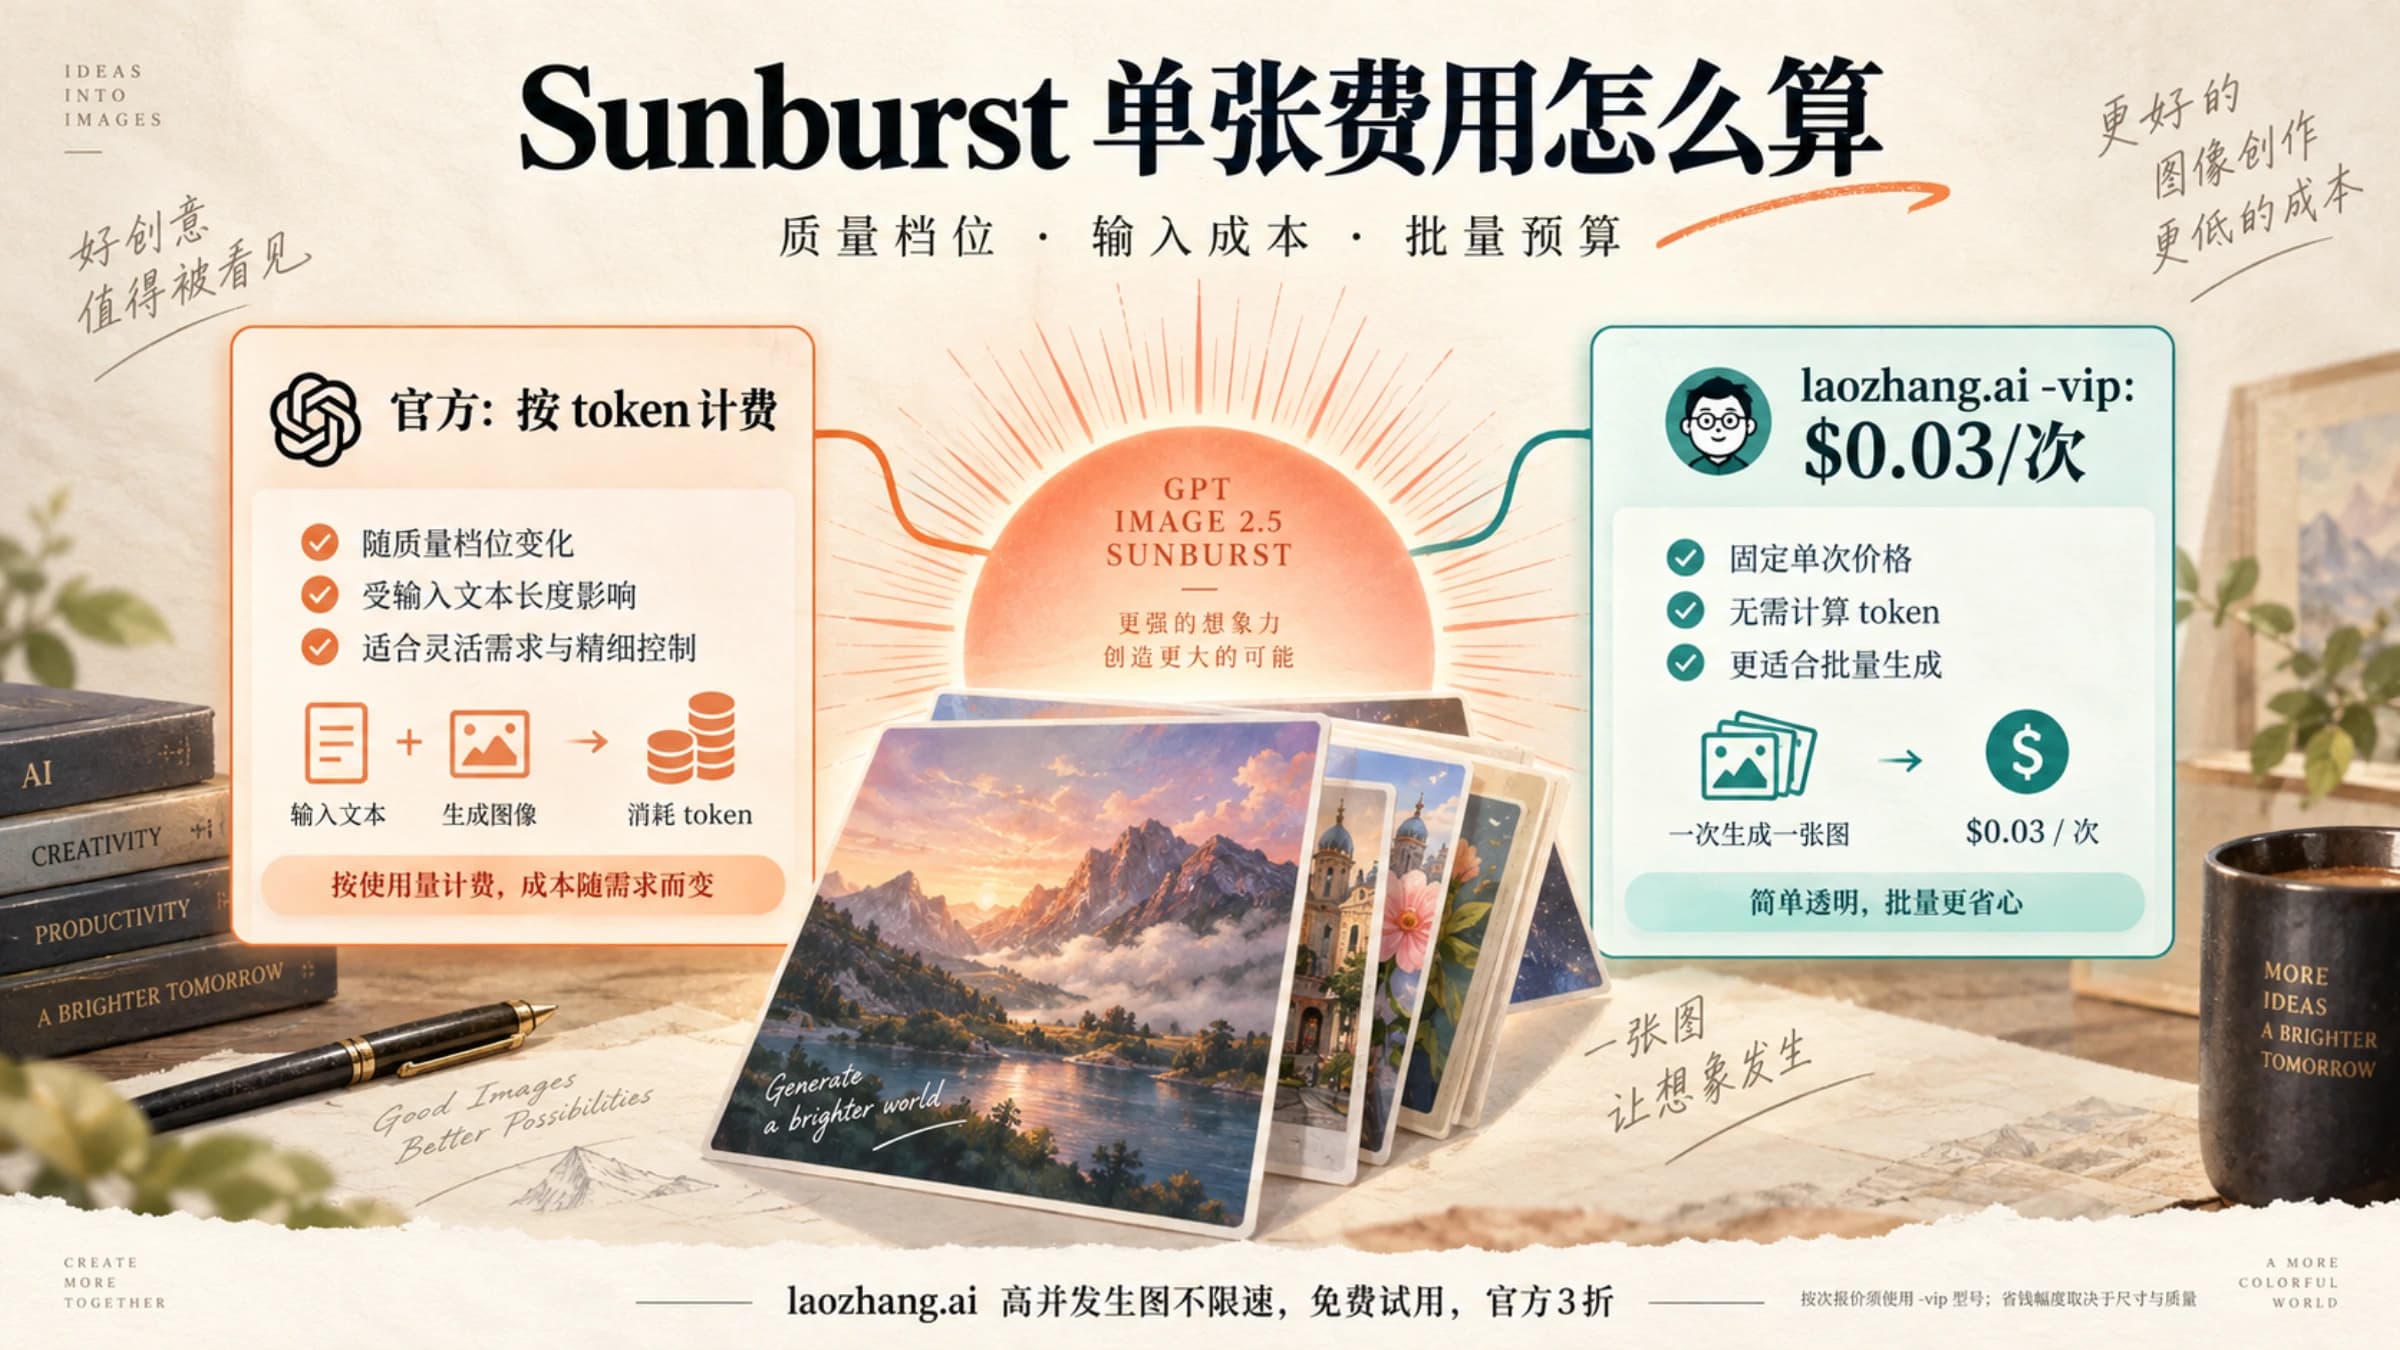
GPT Image 2.5 按 token 计费,没有官方固定的单张价格。Flare 和 Sunburst 的 token 单价相同,但尺寸、质量和参考图数量都会改变用量,quality 不传或传 auto 时,同一请求两次的花费也可能不同。想稳定预算就显式写 size 和 quality,用几次代表性请求的 usage 估算。各档位的估算和按次计费的对比见 GPT Image 2.5 Sunburst 价格:官方单图费用与按次计费怎么选。
官方文档
接入参数、价格与扣费规则以老张API开发文档为准:GPT Image 2.5 API 文档。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
参考来源2
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月25日。
参考来源2
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年9月25日。