Gemini 4 Hydrogen API 价格:实测四档思考,单次花费差近 10 倍
Gemini 4 Hydrogen 每百万 token 输入 $1.50、输出 $7.50,输出含思考 token。实测四档思考,同一道题单次花费差 9–10 倍。
文章目录
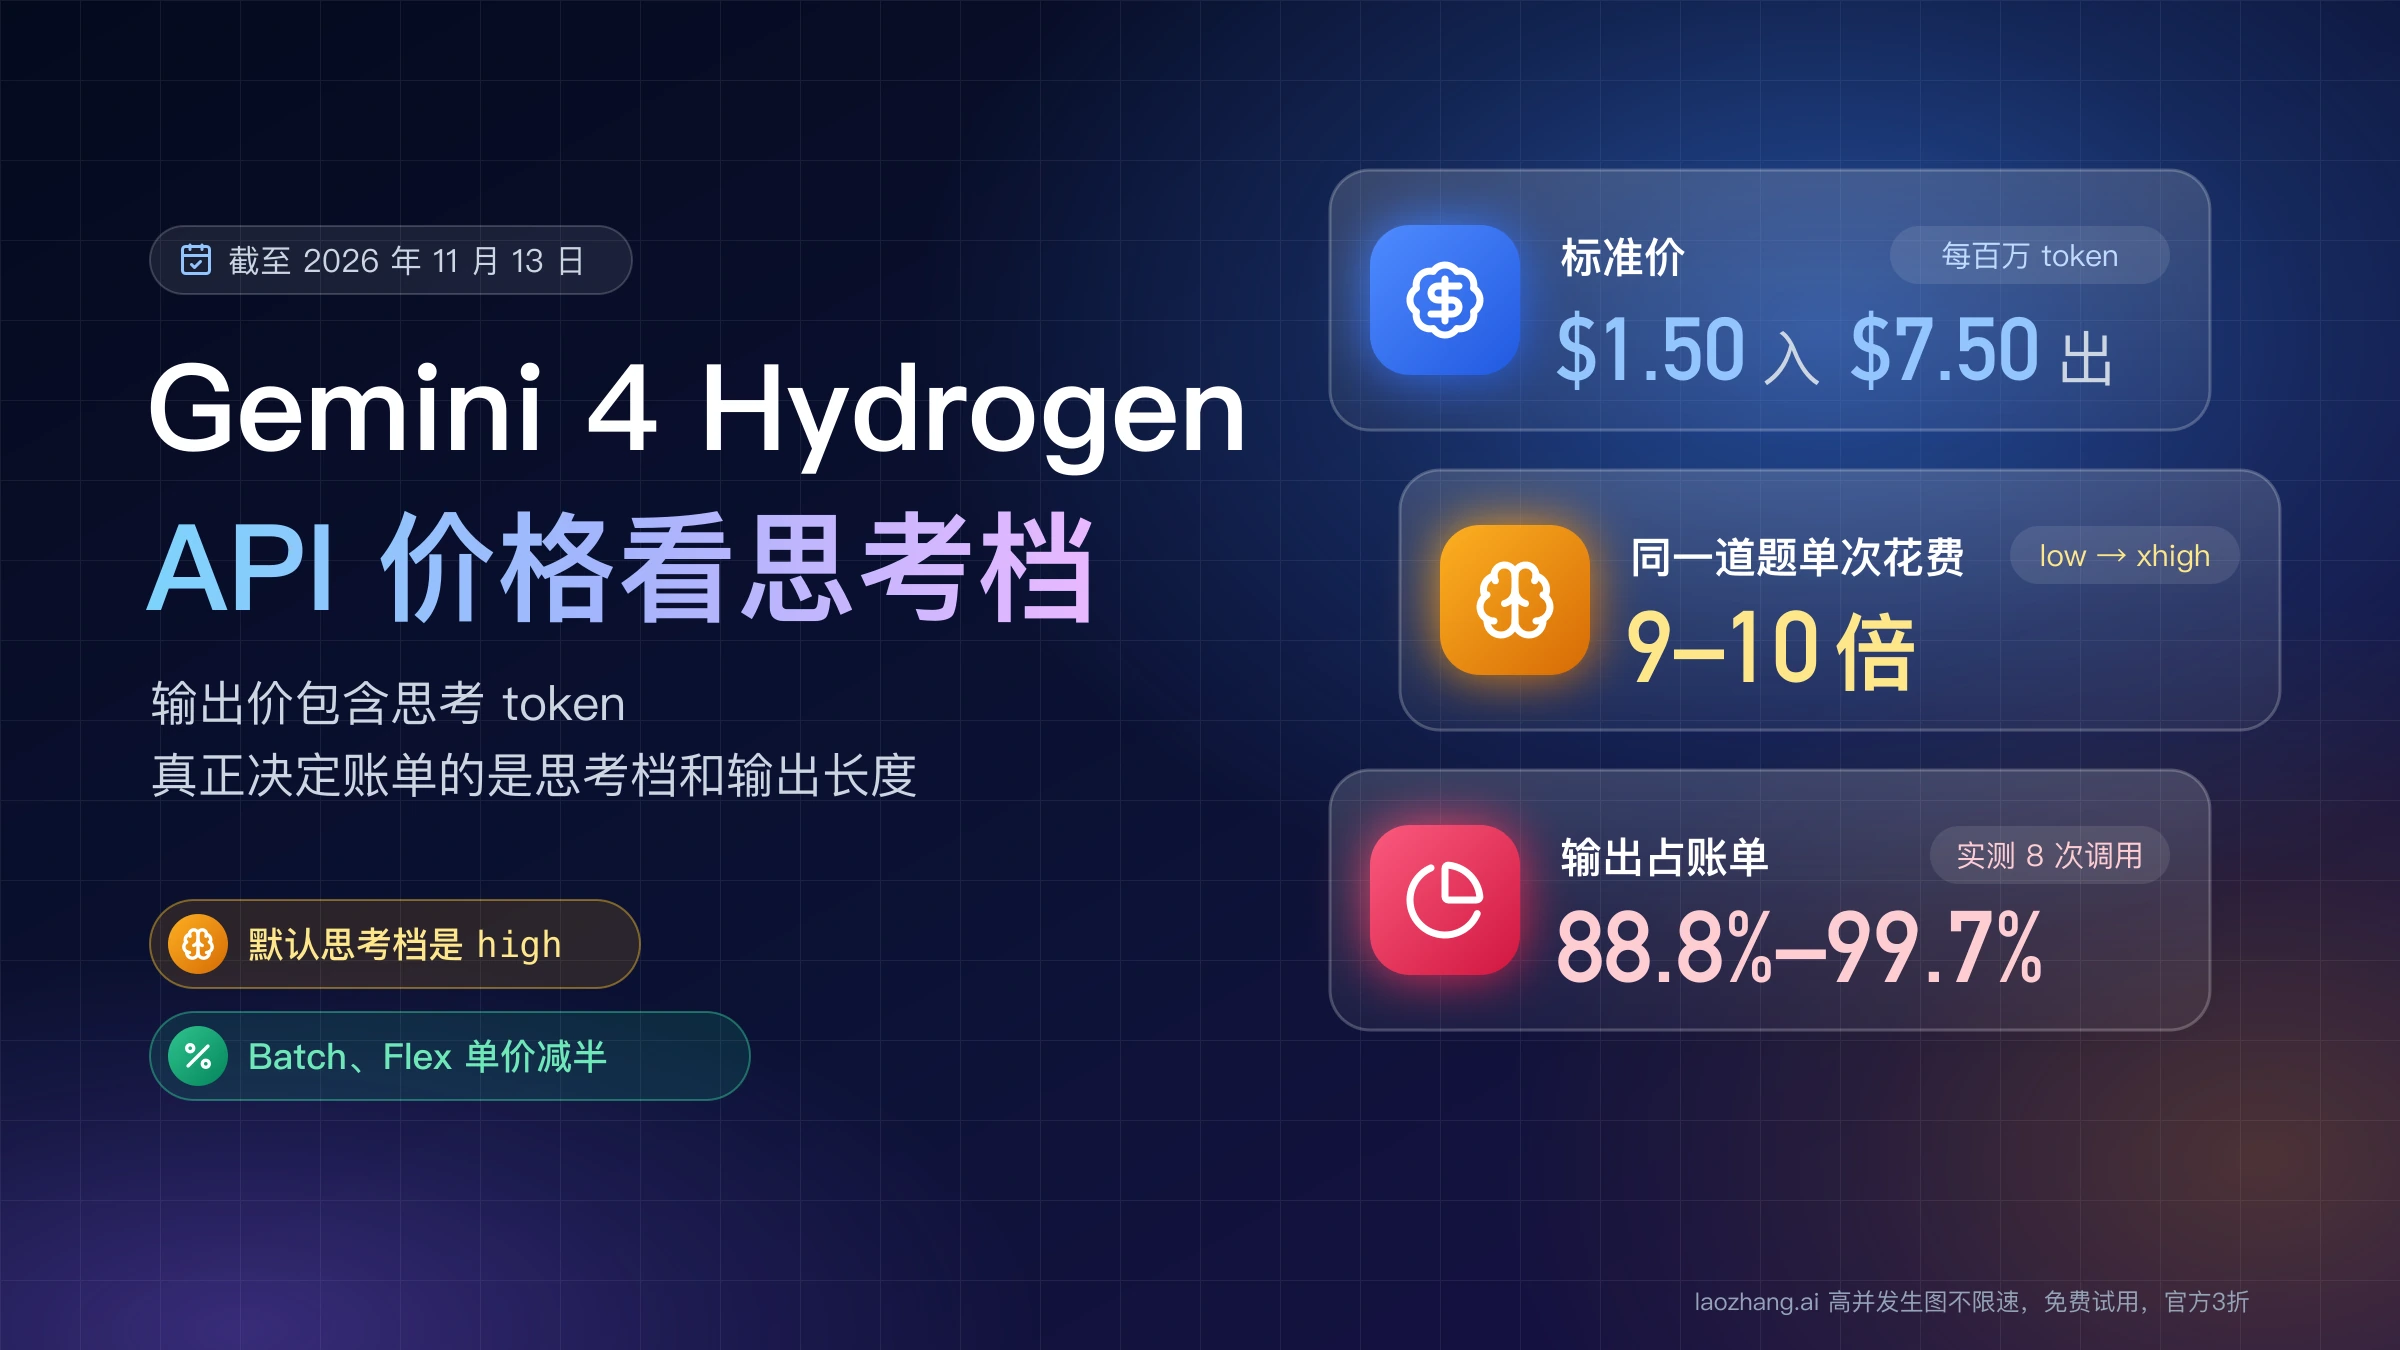
截至 2026 年 11 月 13 日,Gemini 4 Hydrogen(模型 ID gemini-4-hydrogen,11 月 12 日正式发布)在 Gemini API 付费层的标准价是每百万 token 输入 $1.50、输出 $7.50,整个 1M 上下文都是这一个价,没有超过 200K 加价的档位;免费层也能用,不收费。要注意的是,Gemini API 价格页写明输出价包含思考 token,而 Hydrogen 默认的思考档是 high,所以真正决定账单的是思考档和输出长度,单价表只是起点。
2026 年 11 月 13 日在 Google AI Studio 免费层用两道短题各跑了四个思考档,按标准价换算:一道代码题的单次花费从 low 档的 $0.0056 涨到 xhigh 档的 $0.0495,差近 9 倍;一道算账题从 $0.0016 涨到 $0.0156,差近 10 倍。八次调用里,输出(含思考)占账单的 88.8% 到 99.7%,输入几乎可以忽略。
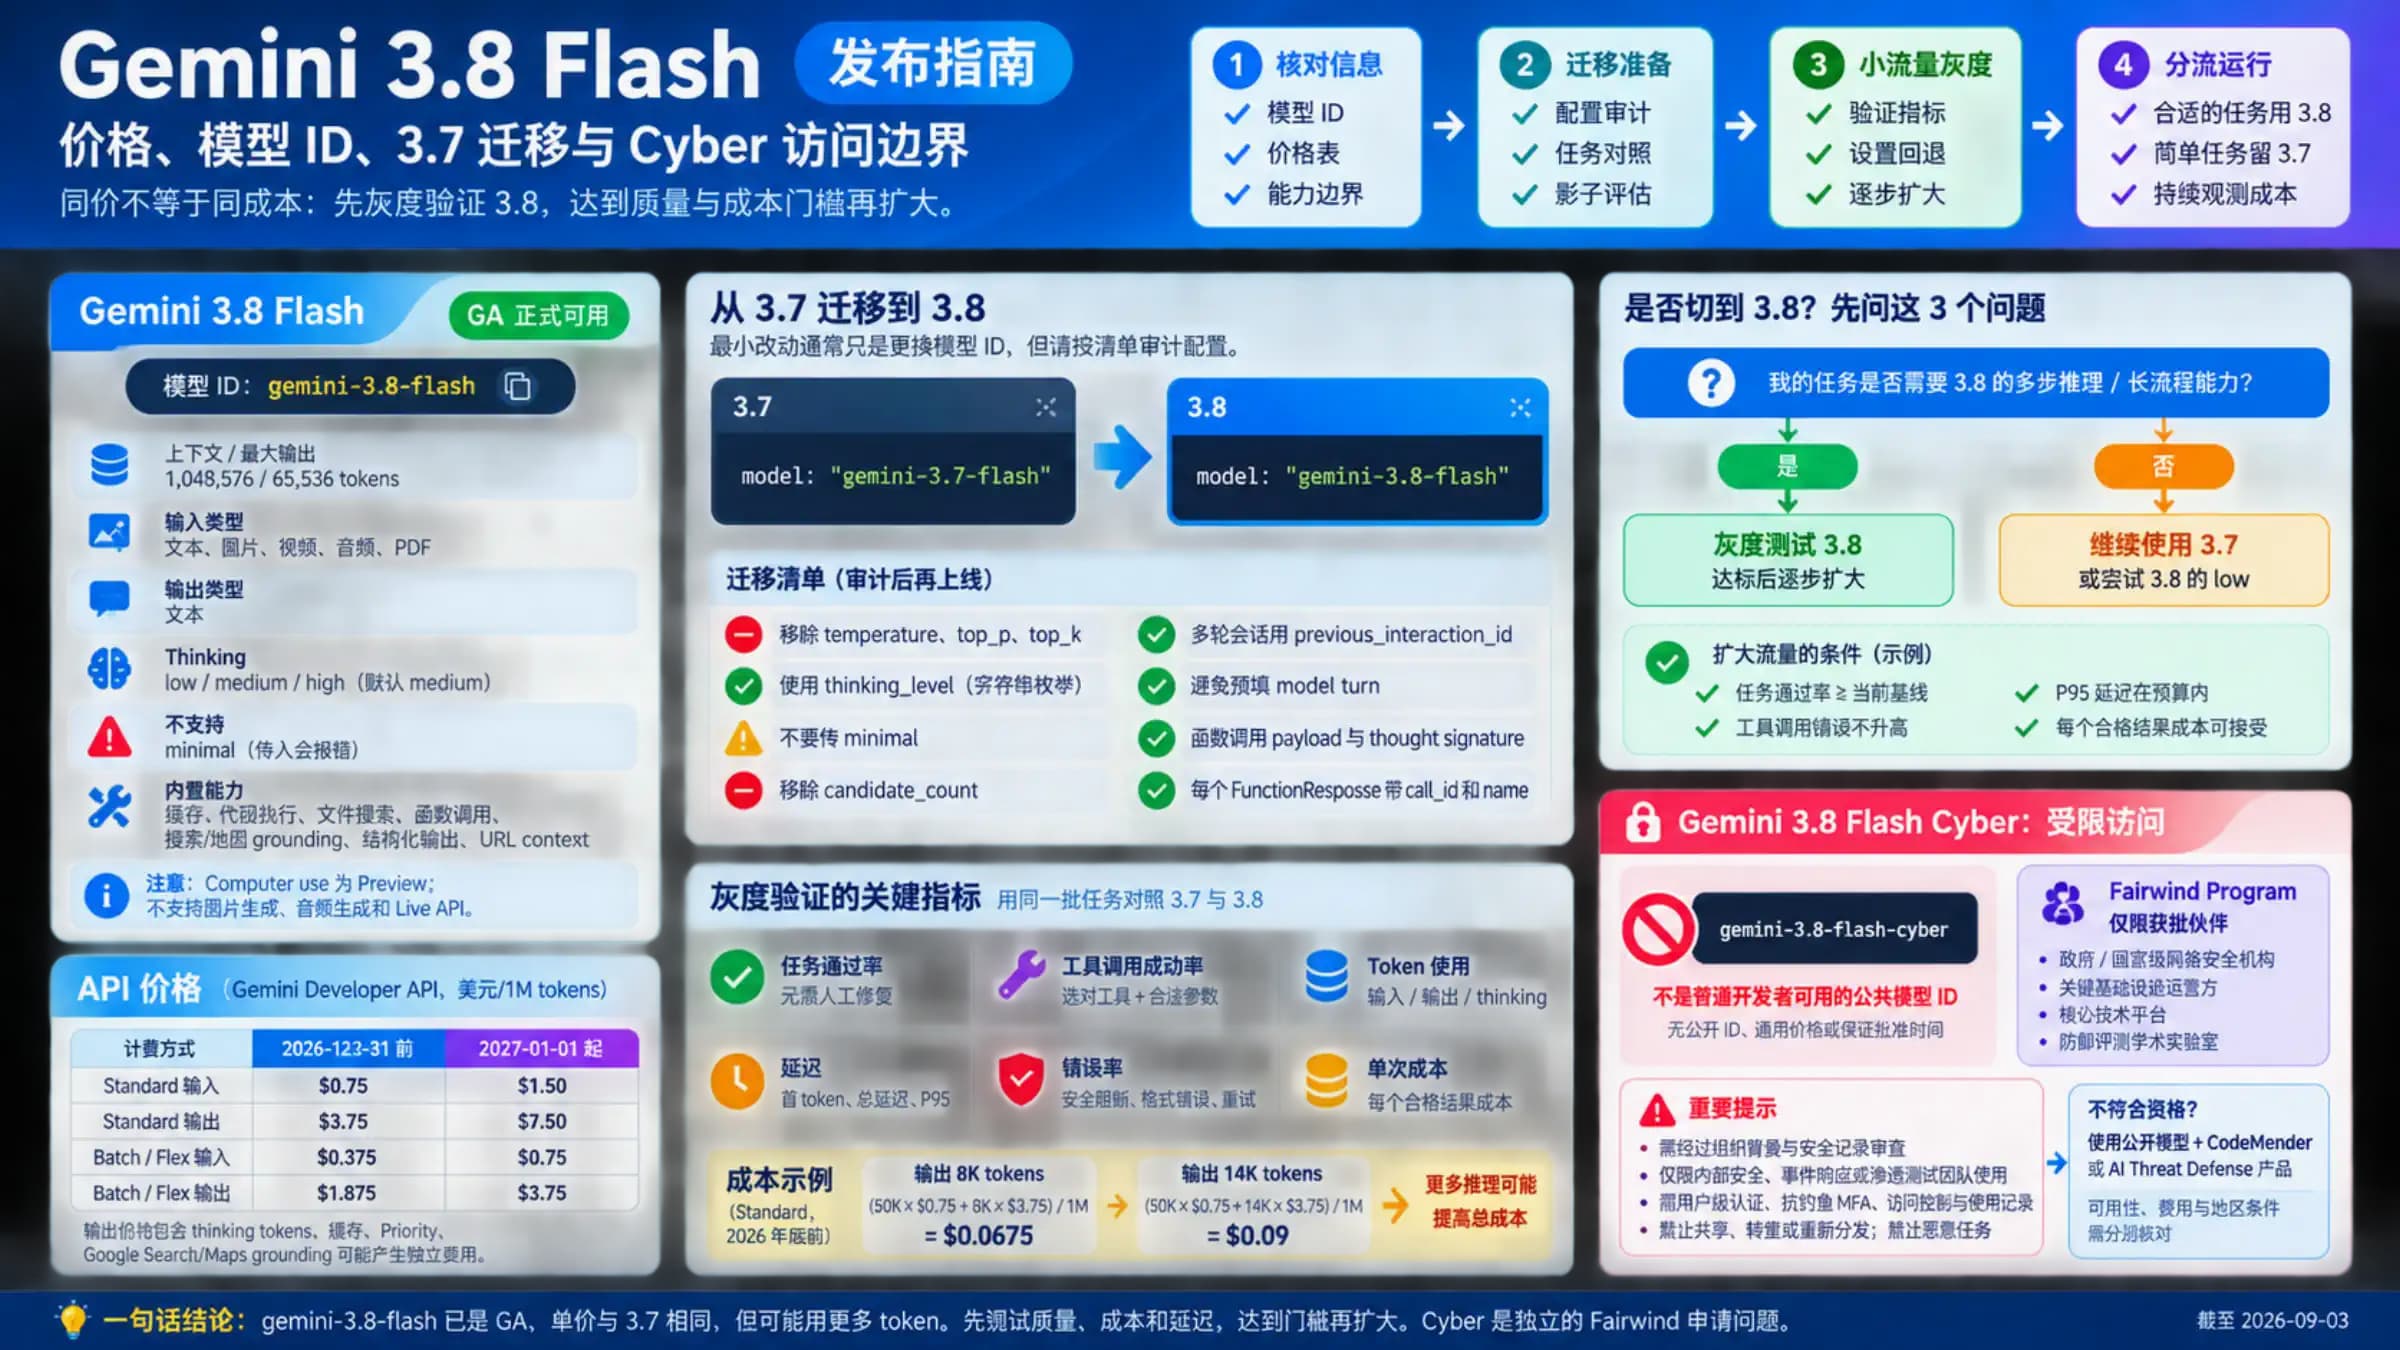
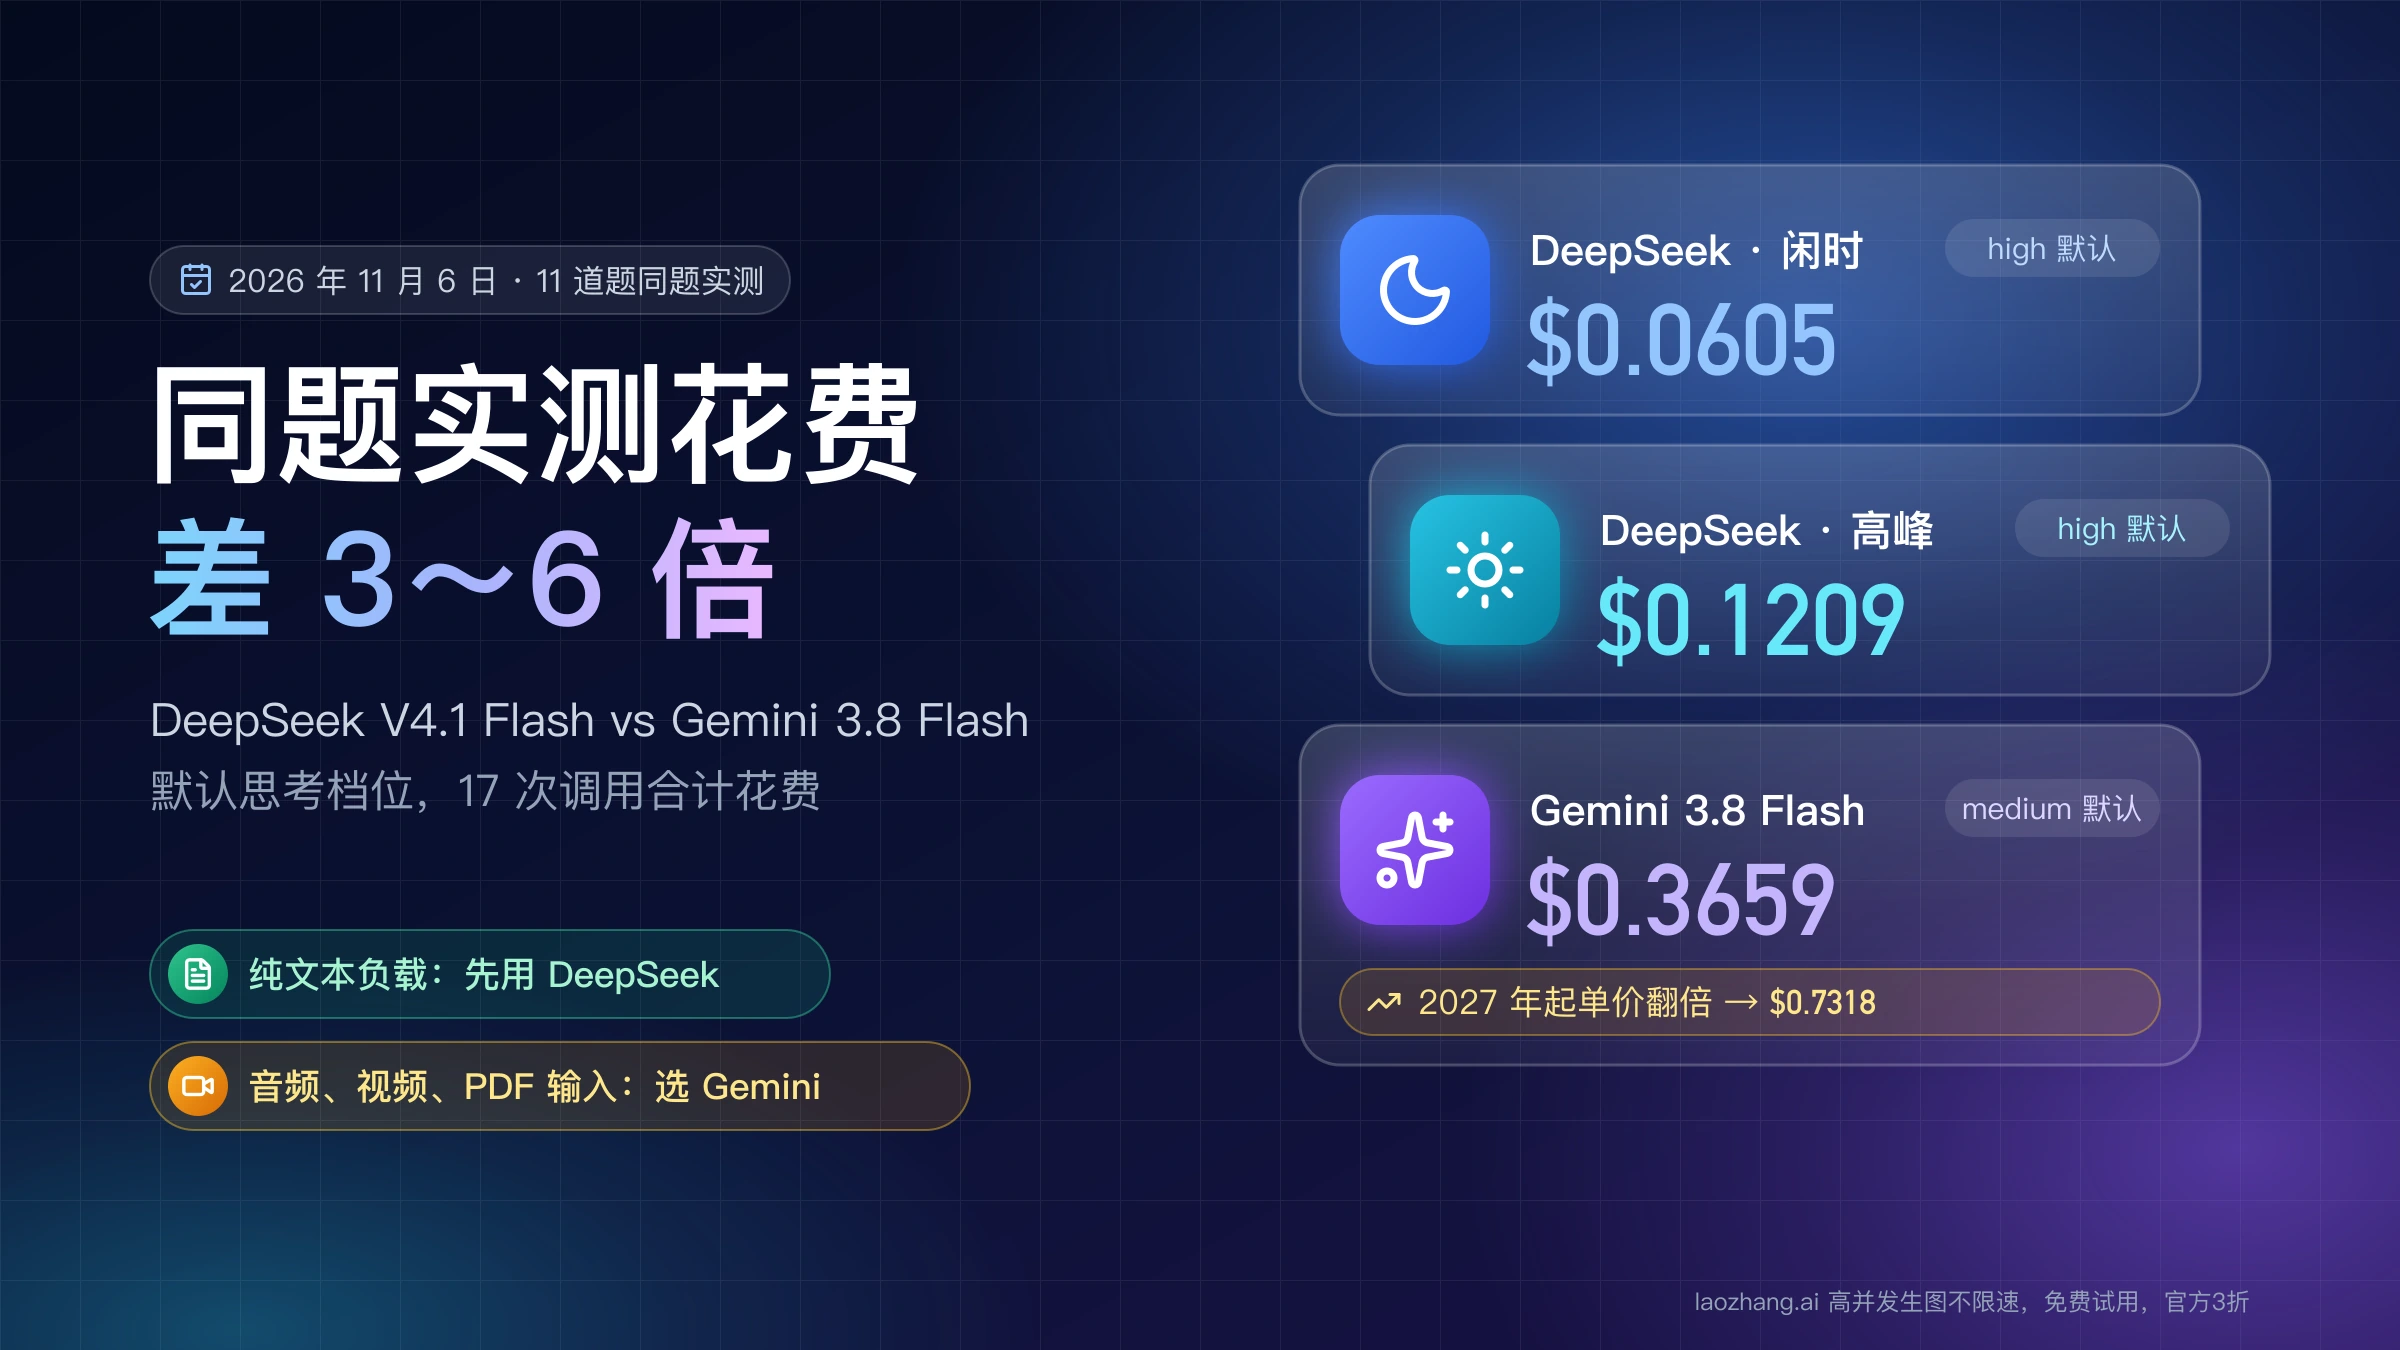
所以做预算要先定 thinking_level:在自己的真实请求上从 low 往上试,用能达到质量要求的最低档,而不是留着默认的 high;不需要实时返回的任务改走 Batch 或 Flex,单价减半。和其他模型比,Hydrogen 今天的单价是 Gemini 3.8 Flash 的 2 倍,2027 年 1 月 1 日 Flash 涨价后两者同价;Gemini 4 Argon 和 Carbon 在 12 月 1 日涨价后,Hydrogen 的单价只有它们的 37.5%。
Gemini 4 Hydrogen 各计费方式价格:标准、Batch、Priority 与 Vertex
同一个模型按调用方式有几种价:Batch 和 Flex 是标准价的一半,Priority 是标准价的 1.8 倍;走 Google Cloud 的 Vertex AI 时,选 Global 端点和 Gemini API 同价,选非 Global 的区域端点贵 10%。下表为每百万 token 的美元价格,截至 2026 年 11 月 13 日,来自 Gemini API 价格页和 Vertex AI 生成式 AI 价格页。
| 调用方式 | 输入 | 输出(含思考) | 缓存命中的输入 | 什么时候用 |
|---|---|---|---|---|
| 免费层(Gemini API、AI Studio) | 免费 | 免费 | 免费 | 有速率限制,数据会用于改进 Google 产品 |
| 标准(Standard) | $1.50 | $7.50 | $0.075 | 默认的实时调用 |
| Batch、Flex | $0.75 | $3.75 | $0.0375 | 只限付费层,能接受延迟的任务 |
| Priority | $2.70 | $13.50 | $0.135 | 高峰期也要优先处理的请求 |
| Vertex AI 标准,Global 端点 | $1.50 | $7.50 | $0.075 | 走 Google Cloud 结算 |
| Vertex AI 标准,非 Global 区域端点 | $1.65 | $8.25 | $0.0825 | 需要指定数据处理区域时 |
Vertex AI 上其他方式也按同一规则加价:非 Global 端点的 Priority 是 $2.97 / $14.85,Batch 和 Flex 是 $0.825 / $4.125。发布前在 X 上流传的“输入 $0.75、输出 $3.75”不是 Hydrogen 的标准价,而是它的 Batch/Flex 价格。
缓存这一列只对隐式缓存有效。Hydrogen 不支持显式缓存(cachedContents、caches.create),提示词达到 4,096 token 时才会自动尝试缓存,命中部分按输入原价的 5% 收,也就是便宜 95%;提示词更短或没有命中,就按 $1.50 原价算。其他 Gemini 模型的价目和 API Key 怎么买,见 Gemini API Key 购买前先看:价格、免费额度与 2027 年 Flash 涨价。
一次调用实际花多少:四档思考实测,单次 $0.0016 到 $0.0495
短任务单次调用大约在 0.2 到 5 美分之间,xhigh 档的输出量约是 high 档的 3 到 4 倍。这组数字来自 2026 年 11 月 13 日上午的一次实测:在 Chrome 里用一个个人 Google 账号打开 AI Studio 免费层,模型选 gemini-4-hydrogen,两道固定题在 Low、Medium、High、Extra High(即 API 里的 xhigh)四档下各跑一次,每次新开对话,读取界面 Token Usage 提示里的输入和输出 token 数。
A 题要求写一个 Python 函数 parse_duration,只返回代码;B 题是一道月账单算术题,条件是 12,000 个用户、每人每月 40 次请求、每次输入 1,800 token、可见输出 450 token,按 $1.50 / $7.50 计价,要求 5 行以内作答。单次花费 = 输入 token × 1.50 ÷ 1,000,000 + 输出 token × 7.50 ÷ 1,000,000(美元),输出 token 已包含思考。
| 题目 | 思考档 | 输入 token | 输出 token(含思考) | 单次花费 | 每 1,000 次 |
|---|---|---|---|---|---|
| A 代码题 | low | 85 | 732 | $0.0056 | $5.62 |
| A 代码题 | medium | 85 | 1,169 | $0.0089 | $8.89 |
| A 代码题 | high(默认) | 85 | 1,588 | $0.0120 | $12.04 |
| A 代码题 | xhigh | 85 | 6,586 | $0.0495 | $49.52 |
| B 算账题 | low | 118 | 187 | $0.0016 | $1.58 |
| B 算账题 | medium | 118 | 906 | $0.0070 | $6.97 |
| B 算账题 | high(默认) | 118 | 651 | $0.0051 | $5.06 |
| B 算账题 | xhigh | 118 | 2,053 | $0.0156 | $15.57 |
多花的 token 没有换来明显不同的答案。B 题四档都算出了正确的 $2,916,low 档连思考过程(Thoughts)区块都没有出现;A 题四档给出的都是基于正则表达式的解析函数(只在界面上读过,没有运行),xhigh 档用了 high 档 4.15 倍的输出 token,代码上的区别只是把 \d 换成 [0-9]、预先编译了正则。B 题 xhigh 的输出是 high 的 3.15 倍。
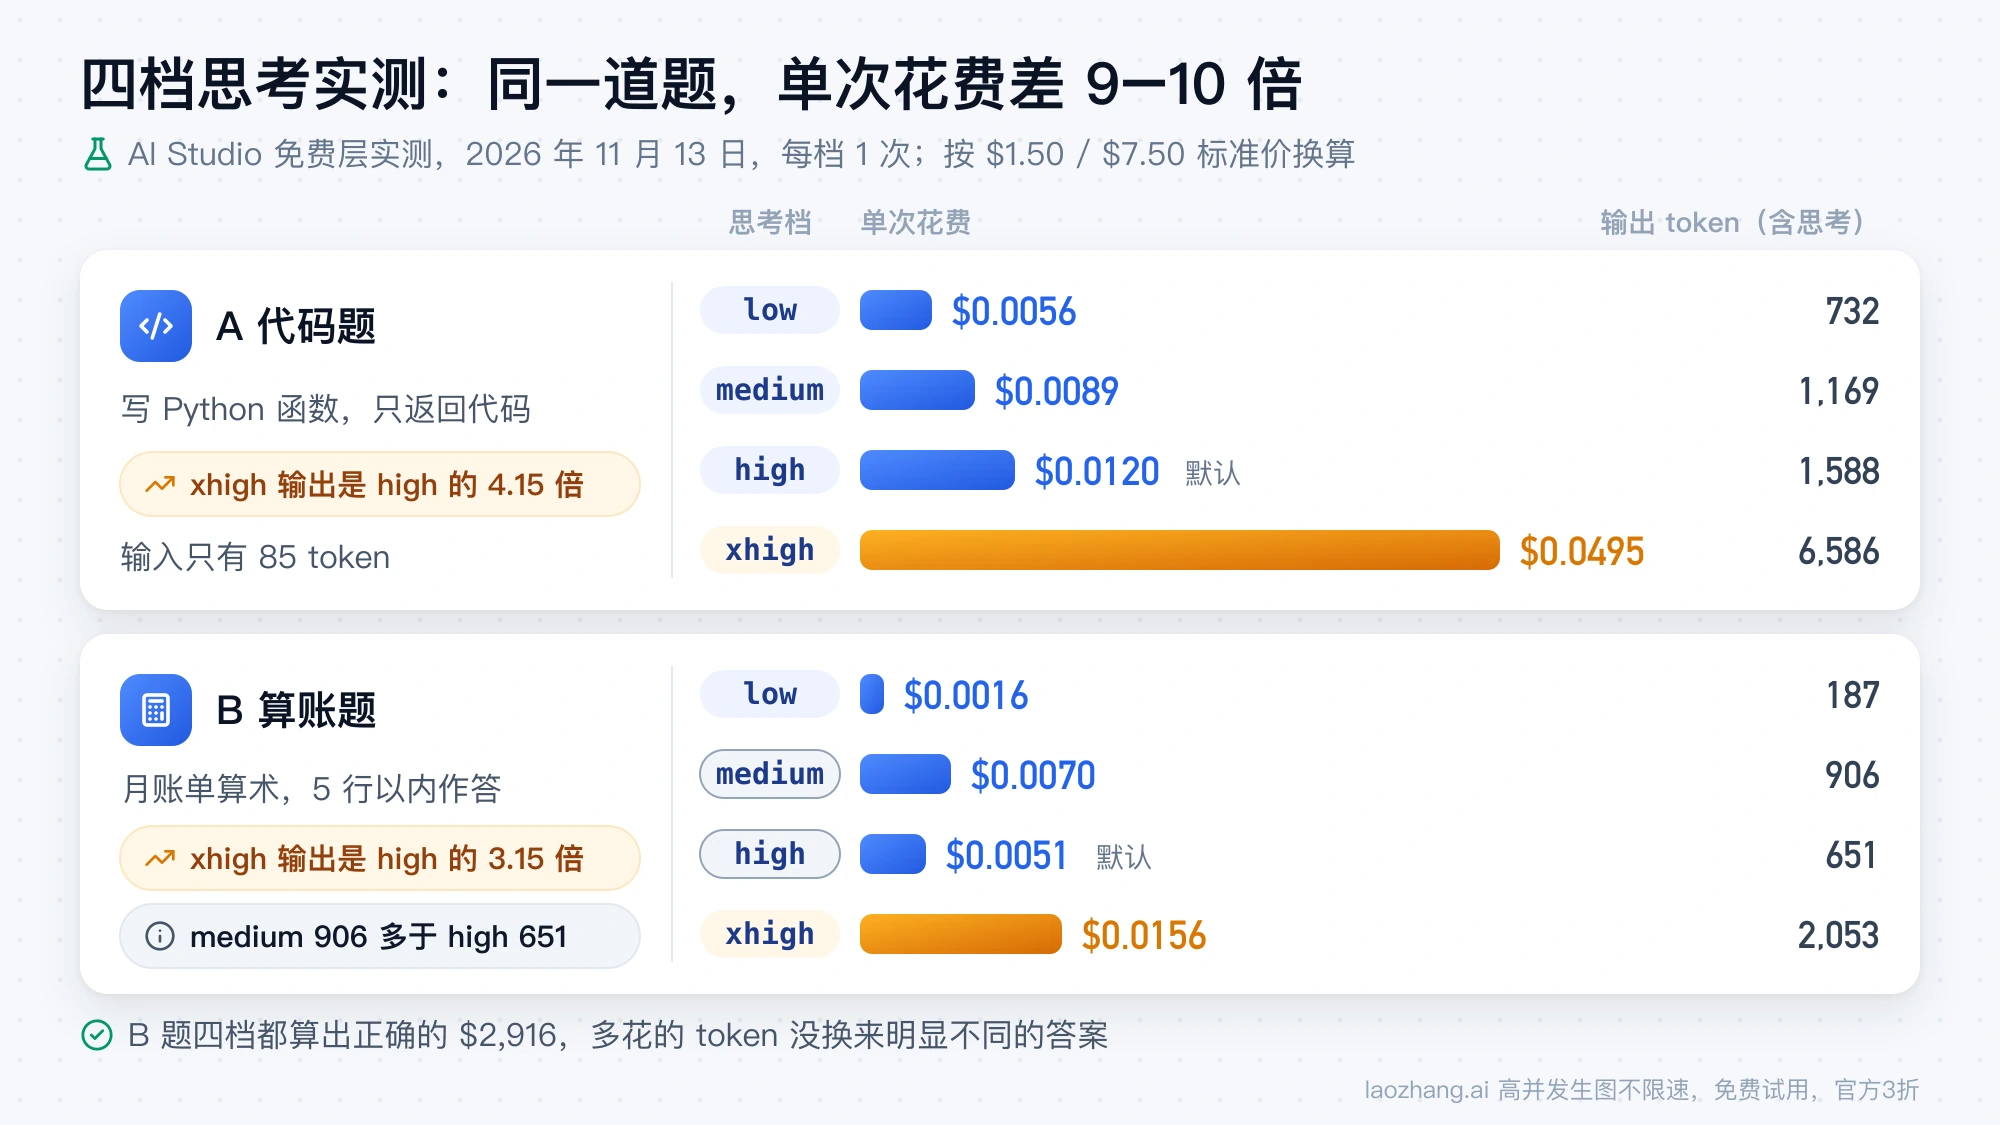
这组数字有几处边界。每格只有一个样本,B 题 medium 的 906 个 token 反而多于 high 的 651 个,说明单次调用不会严格按档位递增,预算要用自己任务的平均值。AI Studio 的读数不是 API 账单,不过 Google 价格页写明付费层对处理的每个 token(含思考)计费,按同样的 token 数估算付费账单是合理推断。这 8 次在免费层花费为 $0;两道题都远短于 4,096 token,隐式缓存没有测到。
每月账单怎么估:可见输出 $2,916,每次多 500 思考 token 多 $1,800
月费 = 月请求数 ×(平均输入 token × 1.50 + 平均输出 token × 7.50)÷ 1,000,000,单位美元,其中输出 token 必须把思考算进去;只按用户看到的回答长度估,账单会被明显低估。
拿 B 题的设定算一遍:12,000 个用户每月各 40 次,共 480,000 次请求。输入 1,800 × 480,000 = 8.64 亿 token,费用 $1,296;可见输出 450 × 480,000 = 2.16 亿 token,费用 $1,620,合计每月 $2,916。如果每次请求再多 500 个思考 token,输出多出 2.4 亿 token,月费多 $1,800,变成 $4,716;每次多 2,000 个思考 token,月费是 $10,116。同样的量如果能全部走 Batch 或 Flex,$4,716 会降到 $2,358。
套用到自己的业务时,先拿一批真实请求按准备上线的思考档跑一遍,从每次响应返回的用量里取输入和输出 token 的平均值,再代入公式。这个例子里每次输入只有 1,800 token,达不到隐式缓存的 4,096 门槛,缓存省不了钱;只有每次都带一段 4,096 token 以上的相同前缀(例如很长的系统指令或固定文档),命中的那部分才会降到 $0.075。
哪个思考档最省:先试 low 和 medium,high 留给复杂编码和智能体
Google 在 Gemini 4 Hydrogen 新功能说明里给的做法是:在评测集上四档都跑一遍,选达到质量线的最低档;想少用 token 就降思考档,不要把 max_output_tokens 压低。这个上限同时限制思考和回答,压得太低会把答案截断,Google 建议保留 65,536 的默认值。
第三方 Artificial Analysis 的数据能看出每档的性价比。按它的 Hydrogen 与 3.8 Flash 对比页(Intelligence Index v5.0.1,截至 2026 年 11 月 13 日),Hydrogen 在 low、medium、high、xhigh 四档的得分是 27、41、51、54,平均每个评测任务花费 $0.29、$0.80、$1.87、$3.16。从 medium 升到 high,花费是 2.3 倍,换来 10 分;从 high 升到 xhigh,花费多 69%,只多 3 分。
按任务分:抽取、分类、改格式、简单计算这类答案短、步骤少的任务,从 low 试起,B 题在 low 档用 187 个输出 token 就算对了;交互式编码、实时对话和对延迟敏感的工具调用试 medium;复杂编码、多步工具调用和智能体任务留在默认的 high;xhigh 只给 high 确实做不出来的难题,Google 也提醒它在简单问题上会过度思考,A 题 xhigh 多用的 4 倍 token 就没有换来明显不同的代码。
比 3.8 Flash、Argon、Carbon 便宜吗:12 月 1 日和 1 月 1 日后会变
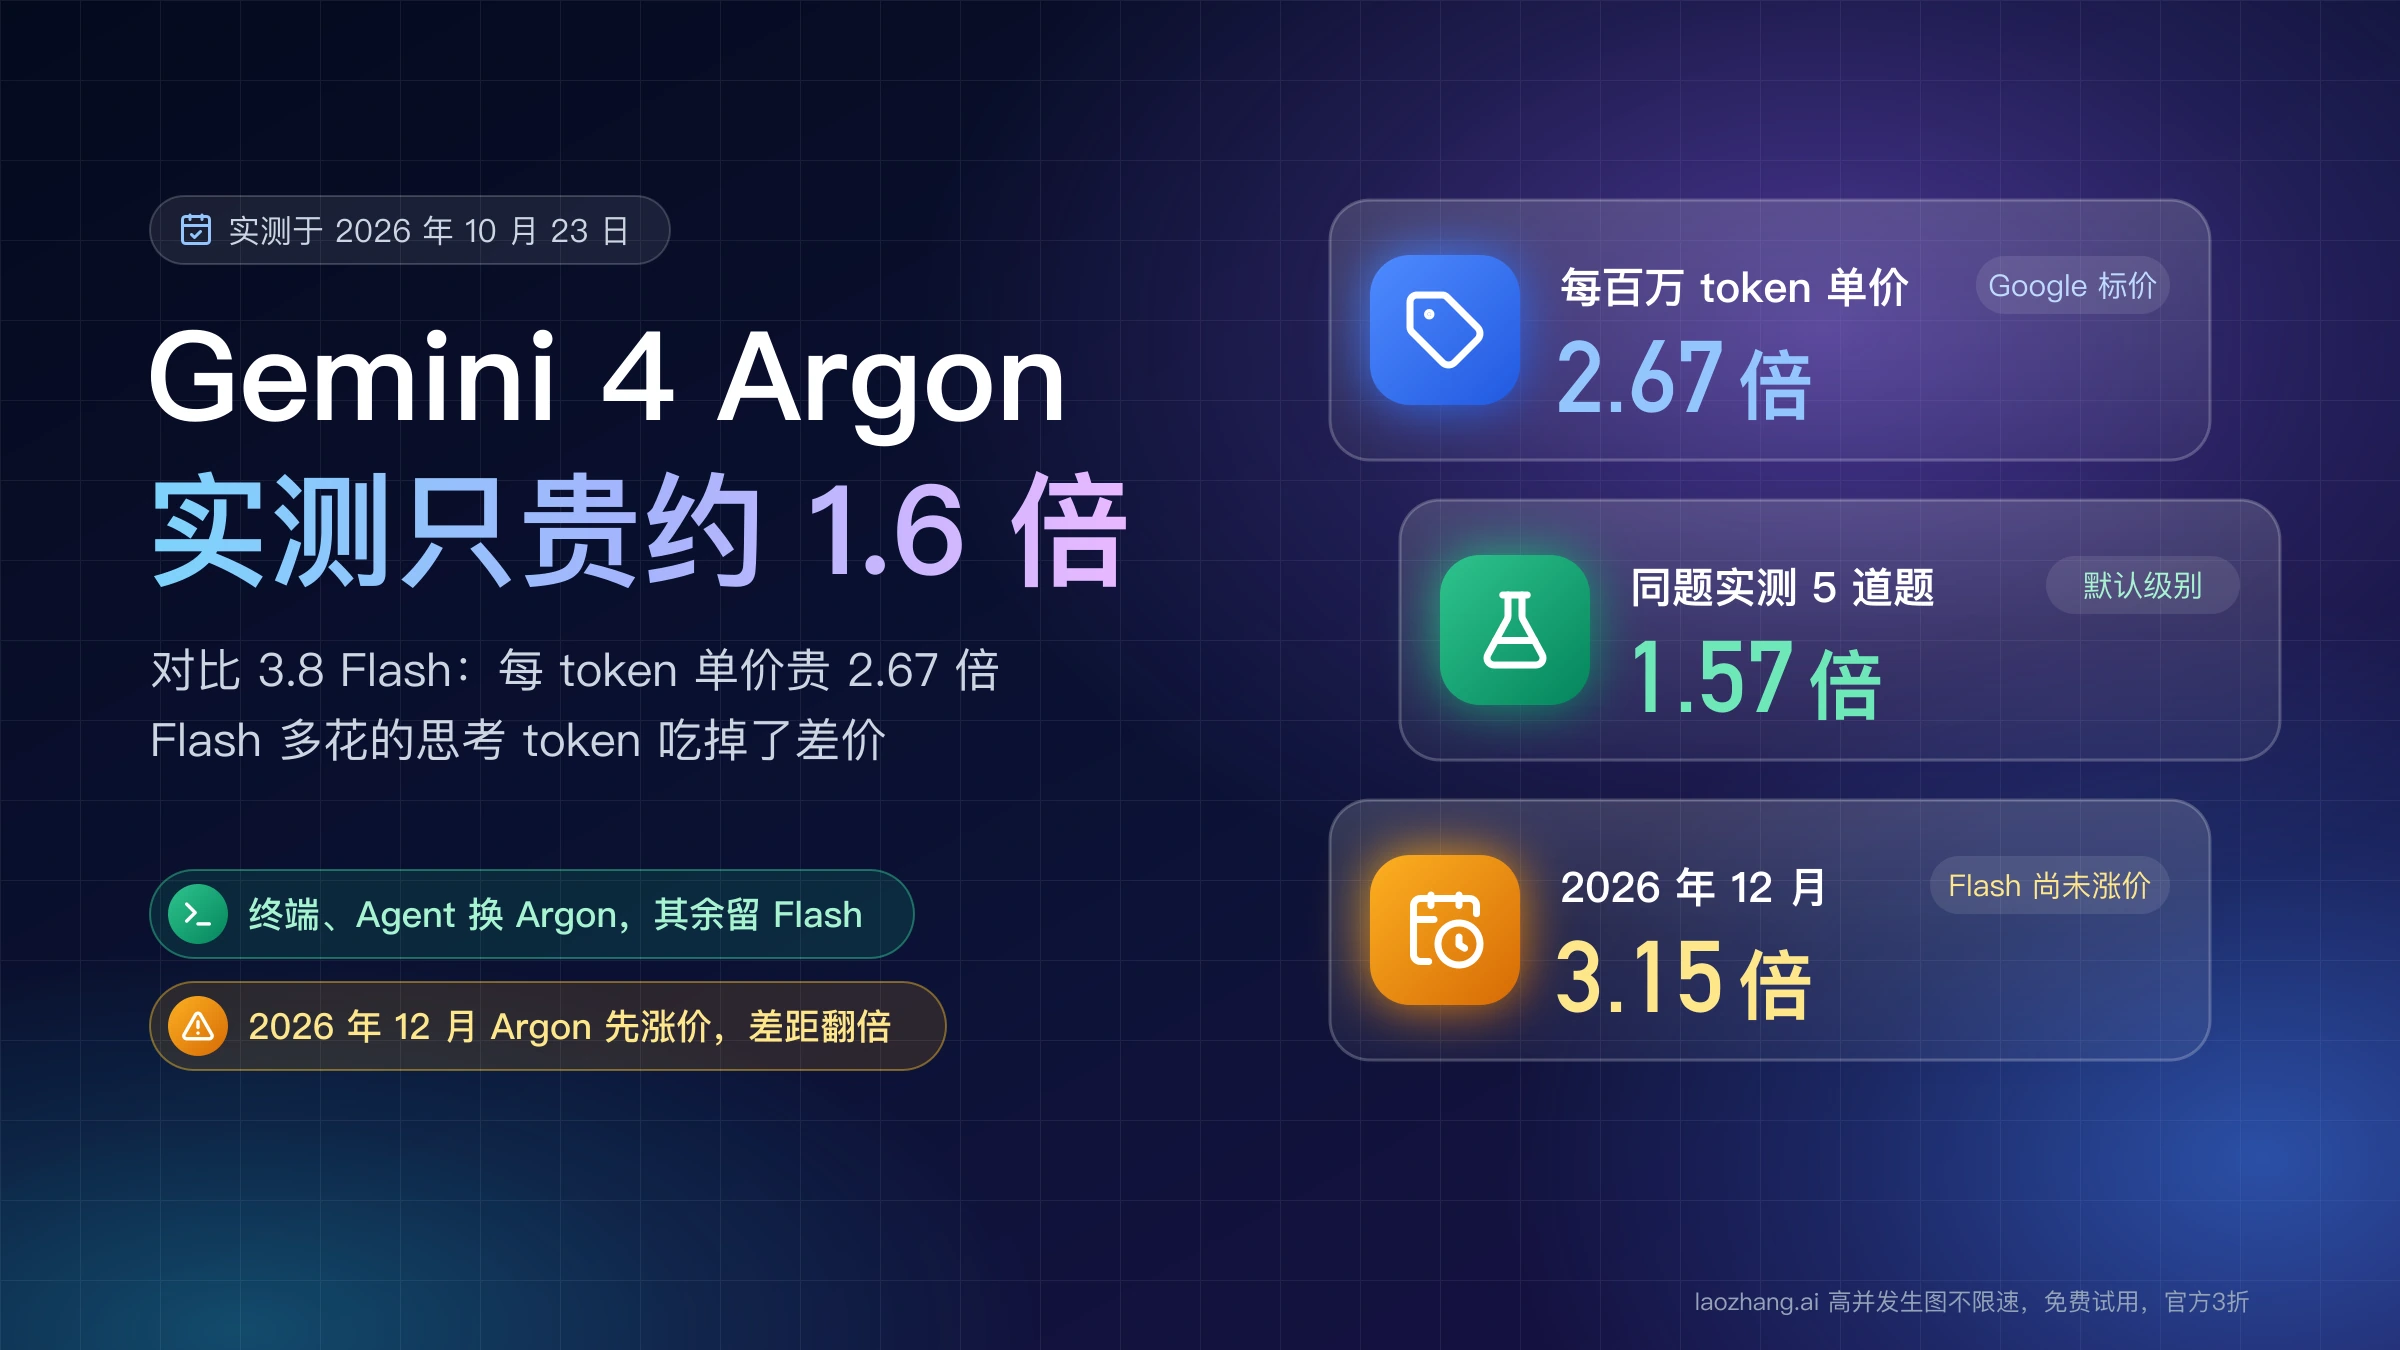
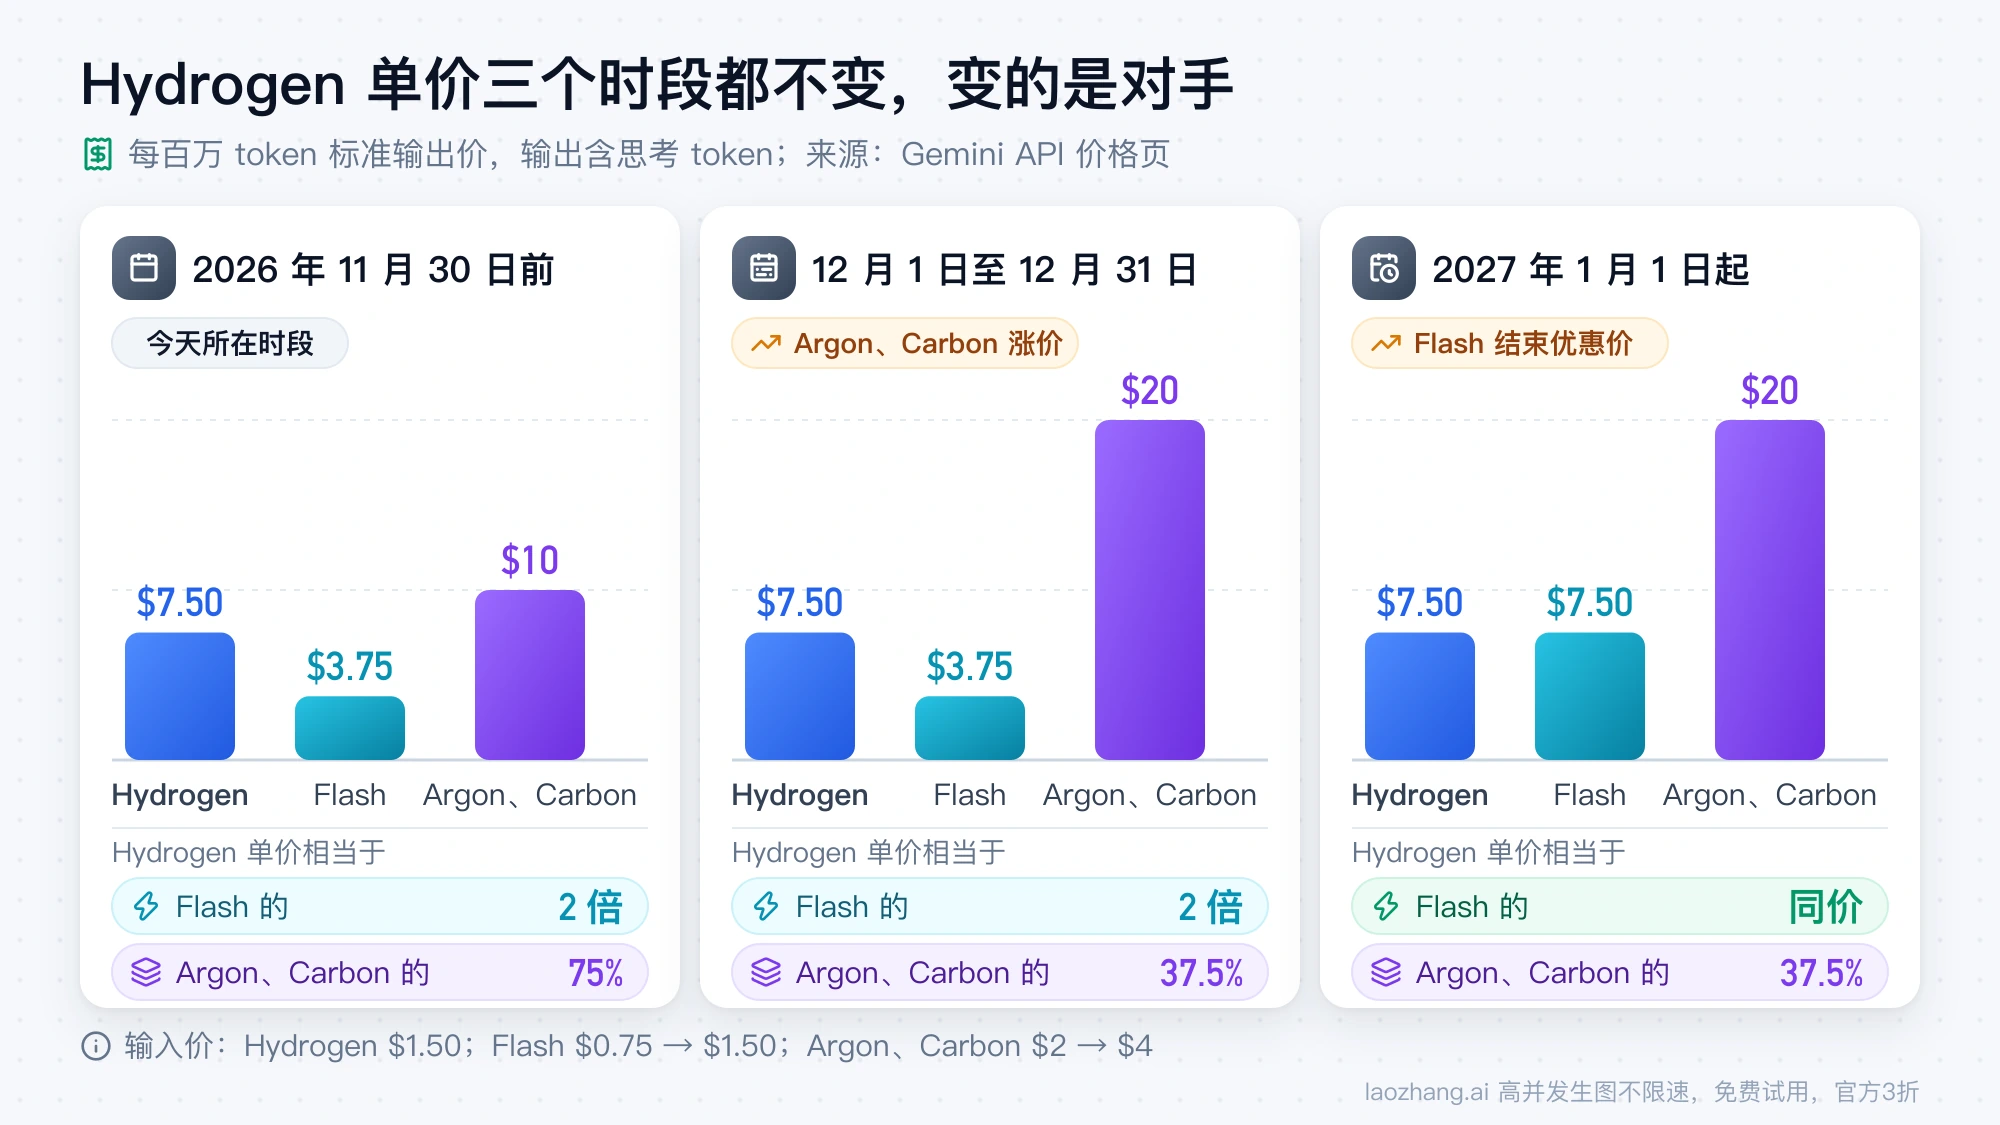
按单价算,Hydrogen 现在比 Gemini 3.8 Flash 贵一倍,比 Gemini 4 Argon 和 Carbon 便宜 25%;12 月 1 日 Argon 和 Carbon 涨价后差距拉大,2027 年 1 月 1 日 Flash 结束优惠价,和 Hydrogen 同价。Hydrogen 自己在这三个时段都不变。下表为每百万 token 标准价(输入 / 输出),来源同上方的 Gemini API 价格页。
| 对比项 | 2026 年 11 月 30 日前 | 12 月 1 日至 12 月 31 日 | 2027 年 1 月 1 日起 |
|---|---|---|---|
| Gemini 3.8 Flash 单价 | $0.75 / $3.75 | $0.75 / $3.75 | $1.50 / $7.50 |
| Gemini 4 Argon、Carbon 单价 | $2 / $10 | $4 / $20 | $4 / $20 |
| Hydrogen 单价相当于 Flash 的 | 2 倍 | 2 倍 | 相同 |
| Hydrogen 单价相当于 Argon、Carbon 的 | 75% | 37.5% | 37.5% |
把 A 题 high 档的 token 量(输入 85、输出 1,588)原样套到别的价目上:Hydrogen 是 $0.0120;Flash 现在是 $0.0060,2027 年起是 $0.0120;Argon、Carbon 在 11 月 30 日前是 $0.0161,12 月 1 日起是 $0.0321。这只说明价目表本身的差别,因为别的模型做同一道题不会输出同样多的 token。
把 token 用量算进去,结论可能反过来。同一份 Artificial Analysis 数据里,high 档每个评测任务 Hydrogen 花 $1.87、得 51 分,3.8 Flash 花 $7.77、得 31 分:Flash 单价便宜一半,但每个任务用掉的 token 多得多,每任务花费约是 Hydrogen 的 4 倍,而且这是按 Flash 现在的优惠价算的,2027 年恢复原价后还要再翻倍。往上比,Google 在 Hydrogen 发布博客里称 Hydrogen 默认 high 档在这个指数上得 51 分,略高于 Argon 的 50 分;从 Argon 换下来之前,先用自己的评测集比较两者在同一思考档下的 token 用量和结果。Argon 与 Flash 的分档实测见 Gemini 4 Argon 和 3.8 Flash 区别:实测成本差多少,哪些任务该换,Carbon 与 Argon 见 Gemini 4 Carbon vs Argon 测评与价格:同价,小任务实测花费约 3 倍。
从 3.8 Flash 换到 Hydrogen,账单会在哪几处变
Google 把 Hydrogen 定为 3.8 Flash 的推荐升级,但照搬旧代码,账单会在三处变化。第一是默认思考档从 Flash 的 medium 变成 high,不显式设置 thinking_level 的请求会多出思考 token;从 3.6 Flash、3.5 Flash-Lite 等更早的模型迁过来、还在用 minimal 压成本的代码会直接报错(3.8 Flash 本来就不支持这一档),要改成 low。第二是显式缓存没有了,请求里的 cached_content 字段要删掉,原来靠显式缓存反复复用的长上下文,现在只能等隐式缓存命中,不再有保证;相应地,Flash 显式缓存每百万 token 每小时的存储费也不用再付。第三是 Hydrogen 的输入、思考、输出共用一个 1,048,576 token 的窗口,Google 建议把写死的低 max_output_tokens(如 8,192)提到 65,536,想控制花费就降思考档。
另外,temperature、top_p、top_k 在 Hydrogen 上会被忽略,调这几个参数不影响输出长度,也就不影响花费。迁移清单的完整内容见 Gemini 4 Hydrogen 新功能说明的迁移部分。
Gemini 4 Hydrogen 有免费额度吗:有,限额按项目在 AI Studio 查
有。Gemini API 免费层和 AI Studio 里调用 Hydrogen 的输入、输出都不收费,但免费层的请求数据会被用于改进 Google 产品(付费层不会),也不能用 Google 搜索依据、Batch 和 Flex。Google 没有公布 Hydrogen 免费层的每分钟请求数(RPM)和每日请求数(RPD),限额按项目而不是按 API Key 计算,要在 AI Studio 的速率限制页按项目查看,网上流传的 Flash 免费层数字不能套用。免费层包含哪些模型,见 Gemini API Key 免费额度与速率限制 2026:哪些还免费、去哪看限额;层级与 429 的对应关系见 Gemini API 速率限制 2026:按项目计算,429 对应哪种限额、怎么提额。
免费层和付费层都只能在 Google 公布的Gemini API 可用地区列表里使用,截至 2026 年 11 月 13 日这份列表不包括中国大陆。Gemini 应用里的模型选择器也向所有用户开放了 Hydrogen,但 Google AI Plus 这类订阅和 API 用量层级是两套体系,不影响 API 账单。
Gemini 4 Hydrogen 账单容易漏算的四项
除了思考 token,还有四项费用不在每百万 token 单价里直接体现,其中两项只在 Vertex AI 上有,截至 2026 年 11 月 13 日:
- 在 Vertex AI 上,Gemini 4 模型的输出超过 32K token 时,从 2026 年 11 月 13 日起,即使请求最后因客户端或服务器超时而失败,也按可取回的 token 计费;其他情况只对成功返回的响应收费,所以长输出要把客户端超时设得足够长。
- Vertex AI 的缓存写入从 2027 年 1 月 12 日起收费,Global 端点每百万 token $1.875,非 Global $2.0625;Gemini API 价格页目前没有缓存写入这一项。
- 使用 Google 搜索建立依据按实际搜索查询次数收费,一个请求可能触发多次查询;付费层每月 5,000 次免费额度由所有 Gemini 3 及更新的模型共享,用完后每 1,000 次 $14。
- 启用搜索依据时,Google 内部附加的工具系统指令和你声明的函数定义也计入计费 token,提示词看起来很短,实际输入可能更长。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月13日。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月13日。
- 1.Gemini API 价格页ai.google.dev/gemini-api/docs/pricing
- 2.Vertex AI 生成式 AI 价格页cloud.google.com/vertex-ai/generative-ai/pricing
- 3.Gemini 4 Hydrogen 新功能说明ai.google.dev/gemini-api/docs/whats-new-gemini-4-hydrogen
- 4.Hydrogen 与 3.8 Flash 对比页artificialanalysis.ai/models/releases/comparisons/gemini-4-hydrogen-vs-gemini-3-8-flash
- 5.Hydrogen 发布博客blog.google/intl/es-419/noticias-de-la-empresa/tecnologia/introducing-gemini-4-hydrogen
- 6.AI Studio 的速率限制页aistudio.google.com/rate-limit
- 7.Gemini API 可用地区列表ai.google.dev/gemini-api/docs/available-regions