Gemini 3.1 Pro 思考级别:LOW/MEDIUM/HIGH 区别与 Gemini 4 默认值
Gemini 3.1 Pro 只有 low、medium、high 三档,API 默认 high;Gemini 4 Argon 默认 medium,Gemini 应用默认低。
文章目录
Gemini 3.1 Pro 思考级别是什么,为什么它如此重要
思考级别控制 Gemini 在给出回答前最多推理多深。API 里的参数叫 thinking_level(REST 的 generateContent 写作 thinkingLevel),Google 简体中文文档也译作“思考等级”,Gemini 应用的繁体中文帮助页把它叫作“低、中、高三種難度”。
截至 2026 年 10 月 22 日,Gemini 3.1 Pro(模型 ID gemini-3.1-pro-preview)只有 low、medium、high 三档,不支持 minimal;API 请求里不写这个参数时默认 high,并且是动态思考,模型会在这一档的上限内按题目难度决定想多少。这一点来自 Google 的 Gemini 3 开发者指南和 Gemini 思考文档。换成别的模型或别的入口,默认值就不一样了:
| 你在用的入口 | 在哪里设 | Gemini 3.1 Pro 默认 | Gemini 4 Argon 默认 |
|---|---|---|---|
| Gemini API:generateContent | generationConfig.thinkingConfig.thinkingLevel | high | medium |
| Gemini API:Interactions API | generation_config.thinking_level | high | medium |
| OpenAI 兼容接口 | reasoning_effort | 模型默认,即 high | medium |
| Google AI Studio | 右侧 Run settings → Thinking level | High | Medium |
| Gemini 应用 | 输入框下方的模型菜单 → 低/中/高 | 应用里已不列 3.1 Pro;其他模型不选档位时为低 | 应用里已不列 Argon;其他模型不选档位时为低 |
| Antigravity | 输入框下方的模型选择器 | High,只有 Low/High 两档 | High |
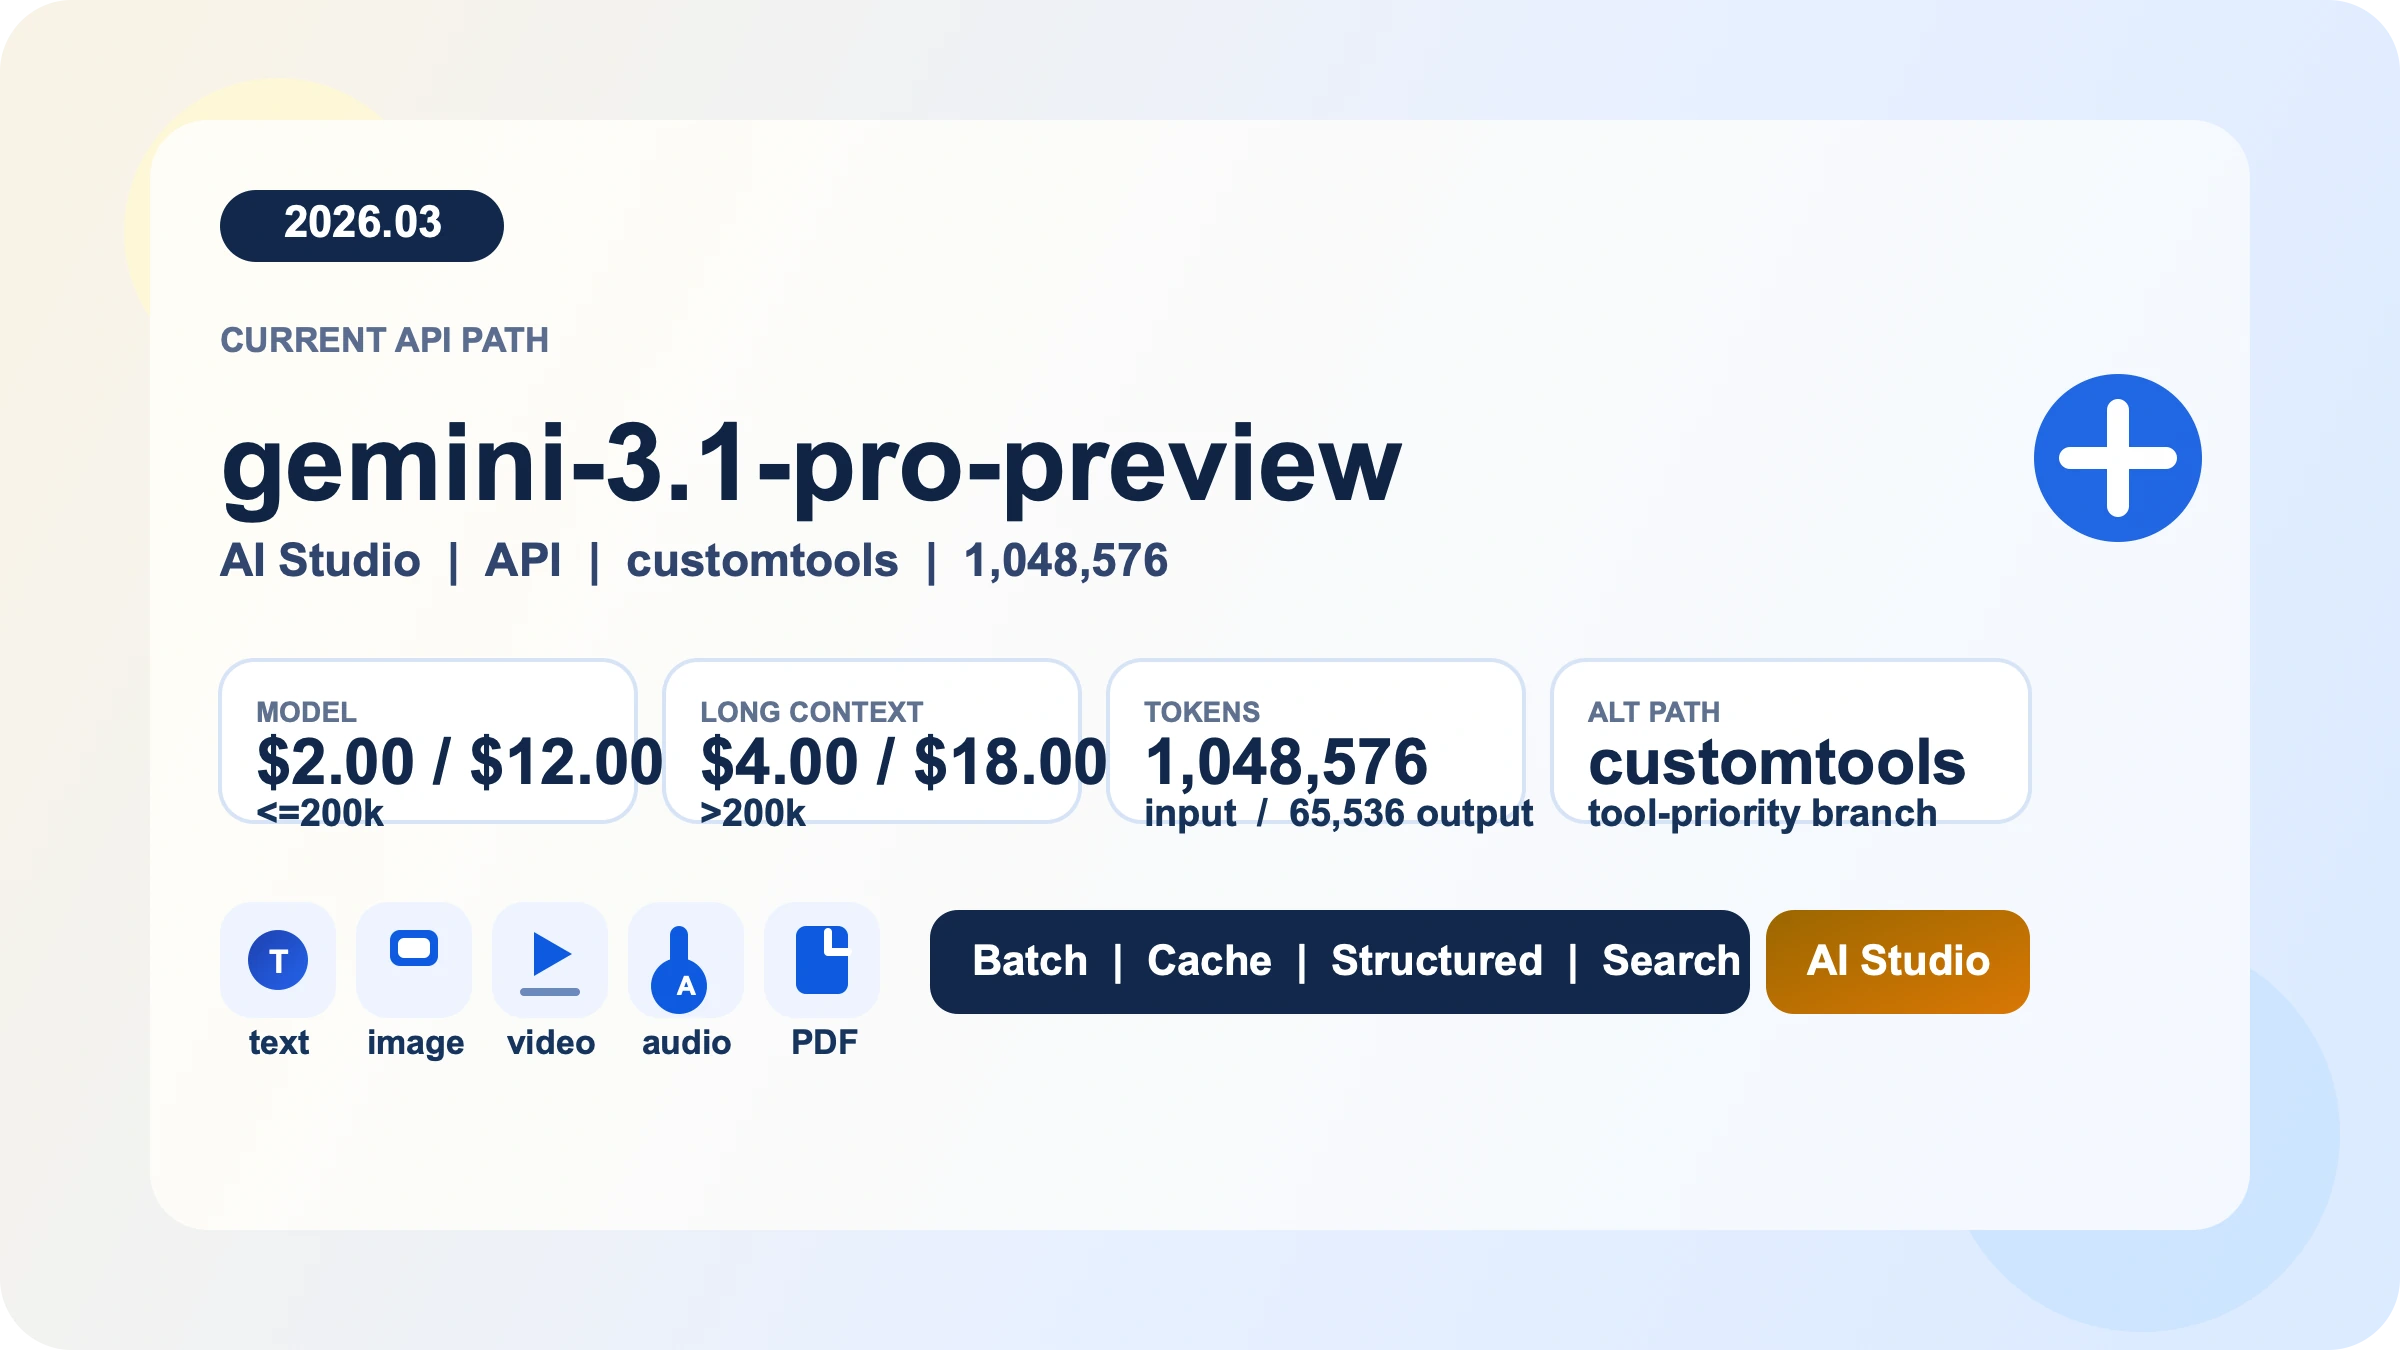
为什么要关心这个参数:思考 token 按输出价计费,Gemini 3.1 Pro 在提示不超过 20 万 token 时的输出价是每百万 token $12(Gemini API 价格页)。默认 high 意味着你不设置时,模型可以在每个请求上用到最深的推理。不过 Google 也写明,这几档是“相对额度,不是严格的 token 保证”。在 2026 年 10 月 22 日的一次单题测试里,3.1 Pro 的 low 和 high 只差约 300 个思考 token(995 对 1,297,见下文实测)。所以档位是控制成本和延迟的一个手段,但不是唯一的手段,题目难度和模型选择的影响往往更大。
还有一个流传很广的说法需要先纠正:把 3.1 Pro 设成 HIGH 并不会“激活 Deep Think Mini”。Google 没有叫这个名字的模式,API 里也没有这个取值,详见下文 Deep Think Mini 一节。
详解 LOW、MEDIUM 和 HIGH:每个级别到底做了什么
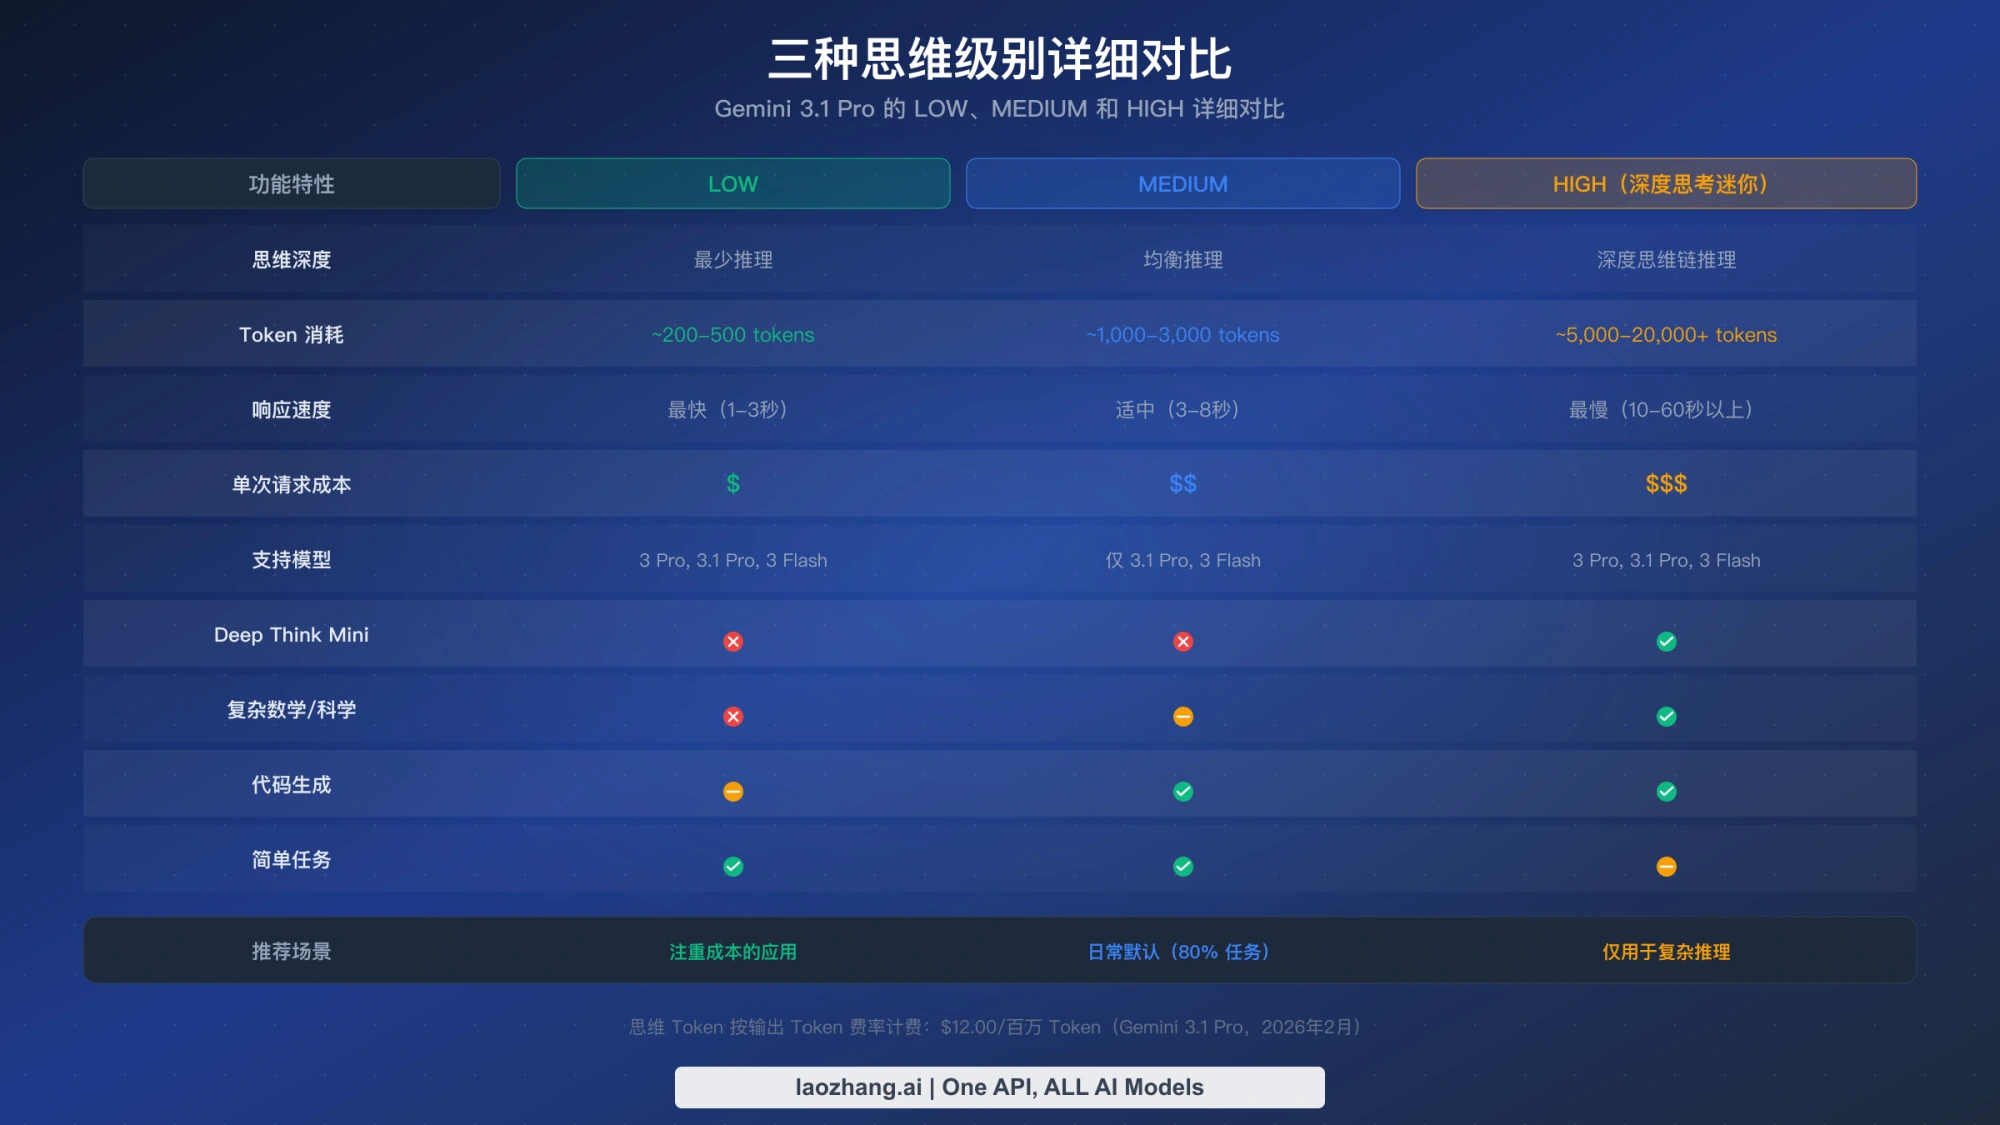
图为 2026 年 2 月版本,图中“HIGH 即 Deep Think Mini”、各档 token 区间和延迟区间已不成立,以正文为准。
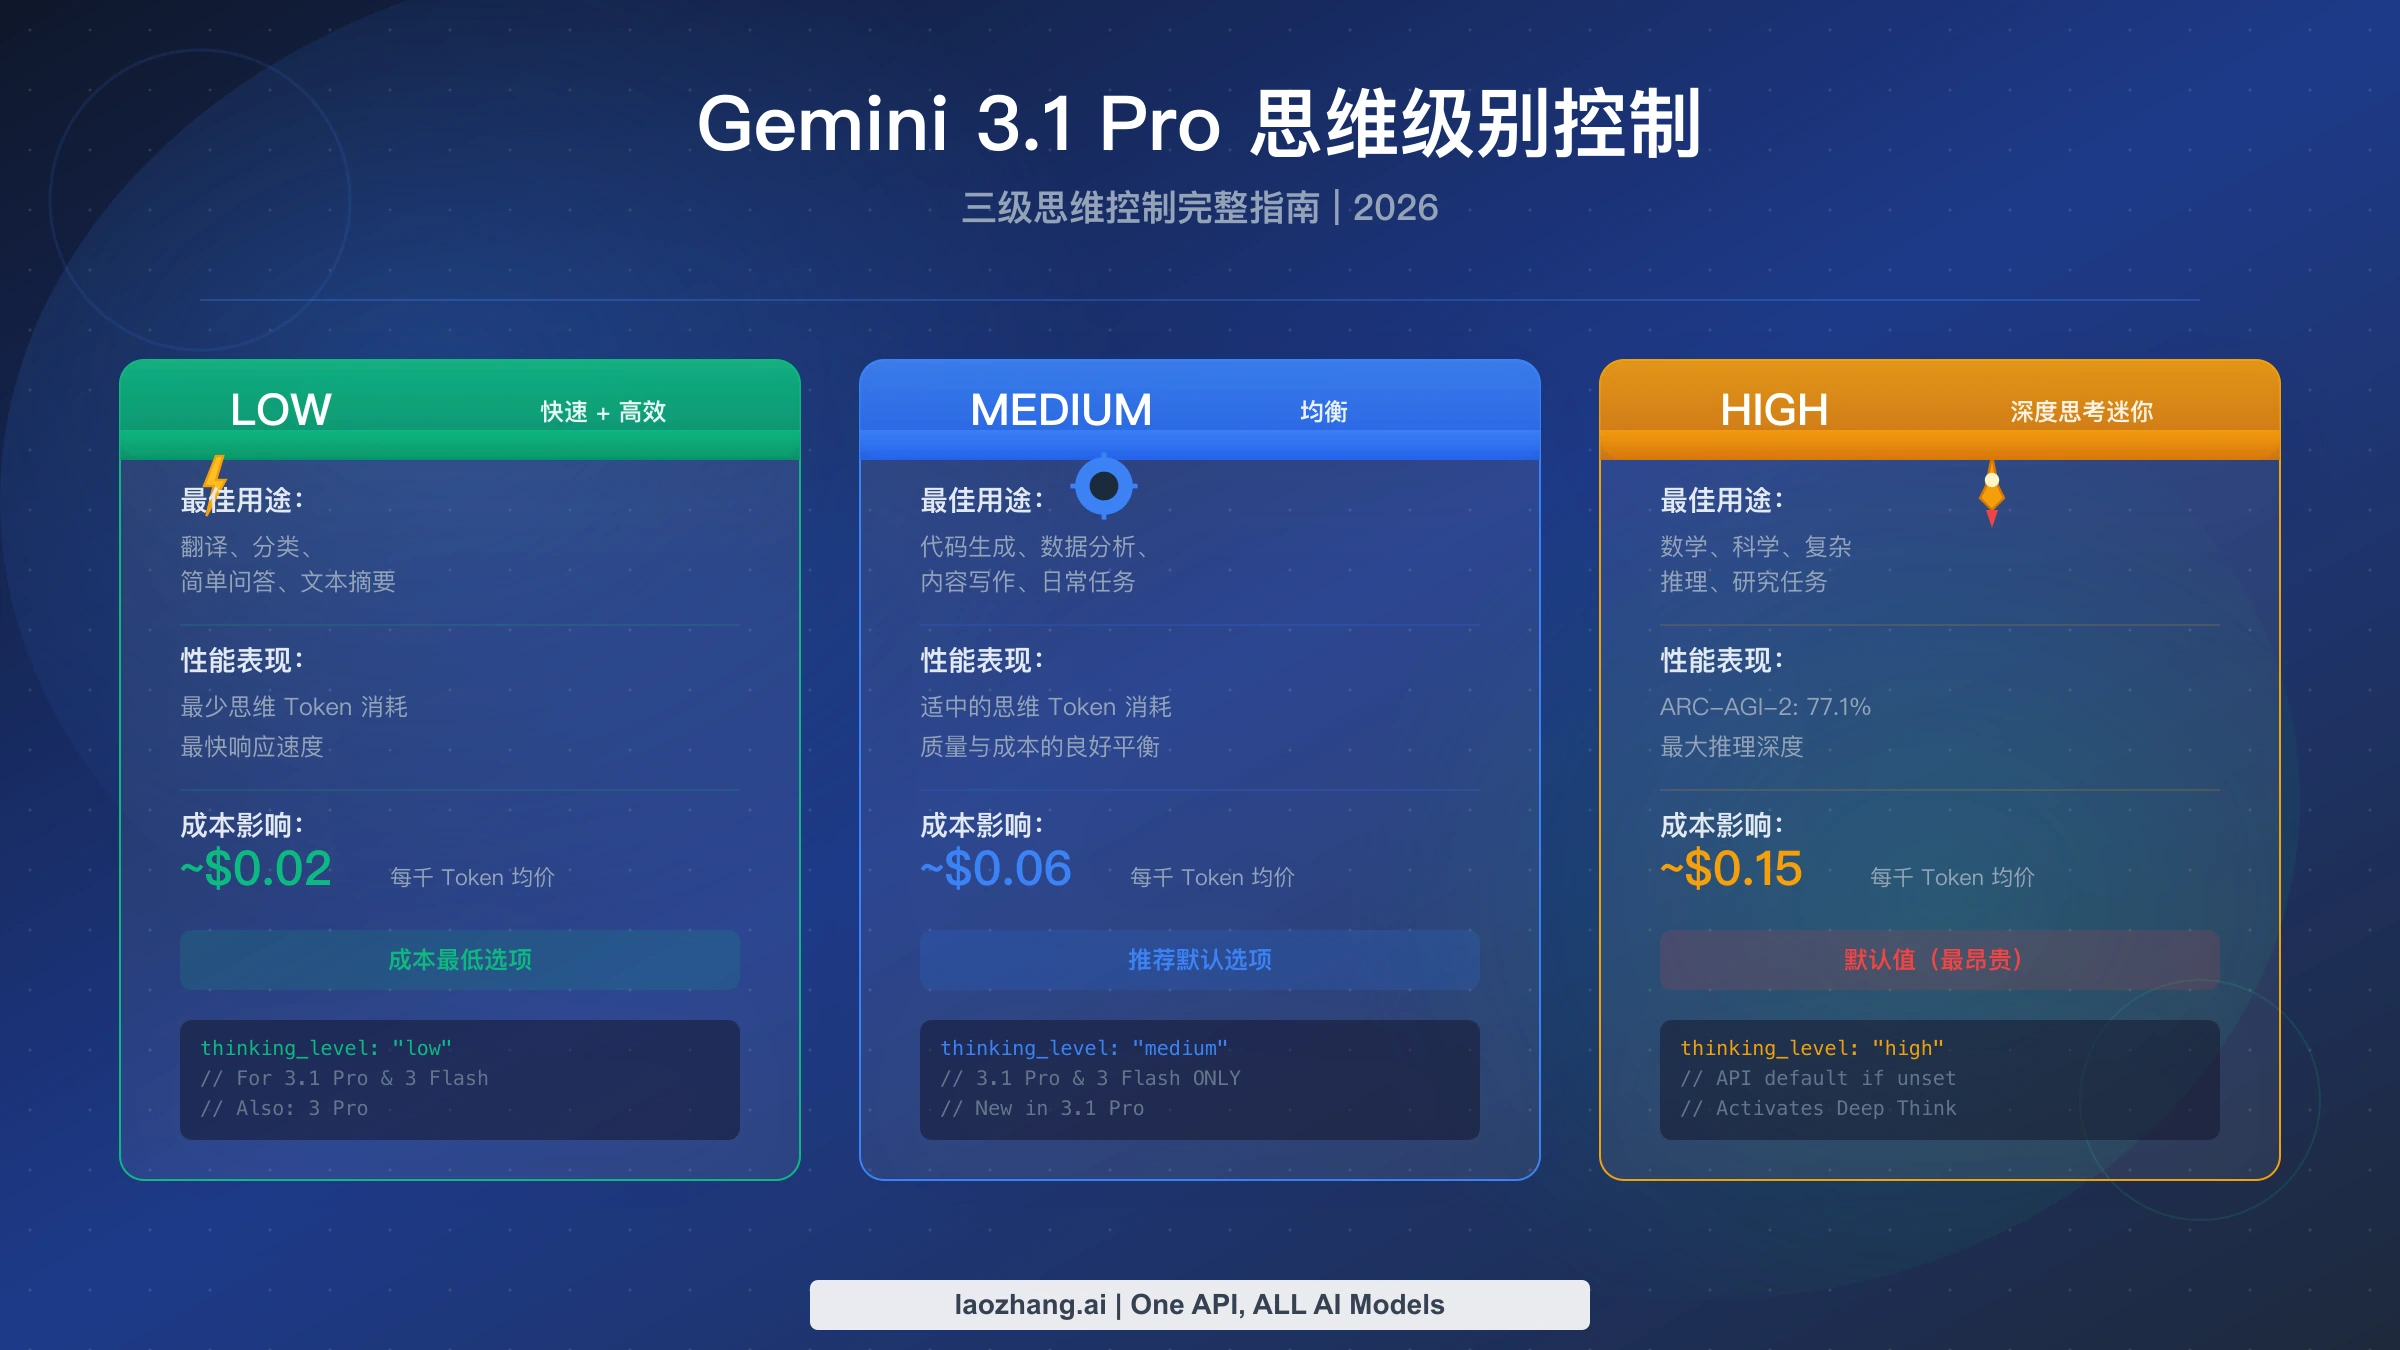
三档的区别是推理深度的上限,而不是三种不同的推理系统。Google 思考文档对每一档的描述是:
- low:尽量降低延迟和成本,适合简单的指令遵循、聊天和高吞吐场景。
- medium:大多数任务的均衡思考。
- high:最大化推理深度。模型给出第一个非思考输出 token 的时间可能明显变长,但回答会推理得更仔细。
- minimal:大多数查询相当于“不思考”,但不保证完全关闭思考。Gemini 3.1 Pro、Gemini 4 Argon 和 3.8 Flash 都不支持这一档,3.6 Flash、Flash-Lite 和 3 Flash 可用。
low 不等于不思考。3.1 Pro 在 low 档仍然会产生思考 token:同一道买笔的应用题,low 用了 995 个,high 用了 1,297 个;更早一轮 12 道题的测试里,3.1 Pro 每次调用都有思考 token,low 档也在 410 到 1,620 之间。题目越复杂,high 留给模型的余地越大,各档差距才会拉开。
Google 没有公布各档的固定延迟或思考 token 区间,“LOW 1 到 3 秒、HIGH 要 5,000 到 20,000+ 个思考 token”这类数字没有官方出处。延迟和 token 数取决于题目、模型和调用线路,只能用你自己的请求测。
Google 公布的 3.1 Pro 成绩都标注为“Thinking (High)”,也就是 high 档,没有给出 low、medium 的对应成绩:
| 基准测试 | Gemini 3.1 Pro Thinking (High) | 测试条件 |
|---|---|---|
| ARC-AGI-2 | 77.1% | ARC Prize Verified |
| GPQA Diamond | 94.3% | — |
| SWE-Bench Verified | 80.6% | 单次尝试 |
| Humanity's Last Exam | 44.4%/51.4% | 无工具/搜索加代码执行 |
数据来源:Google DeepMind 的 Gemini Pro 模型页,截至 2026 年 10 月 22 日。
各模型的思考级别:默认值、可选值和会报错的值
只看 3.1 Pro 不够。很多代码会在几个 Gemini 模型之间切换,同一个 thinking_level 值在一个模型上能用,换个模型就可能报错。下表按 Google 思考文档(页面更新于 2026 年 10 月 14 日)整理:
| 模型 ID | 不指定时的默认 | 可选值 | 会报错或要注意的地方 |
|---|---|---|---|
gemini-3.1-pro-preview | high(动态) | low、medium、high | minimal 报错,实测返回 400;思考不能关闭 |
gemini-4-argon | medium | low、medium、high | minimal 报错;思考不能关闭;thinkingBudget 已弃用 |
gemini-3.8-flash | medium | low、medium、high | minimal 报错 |
gemini-3.6-flash | medium | minimal、low、medium、high | — |
gemini-3.5-flash-lite、gemini-3.1-flash-lite | minimal | minimal、low、medium、high | minimal 也不保证完全不思考 |
gemini-3-flash-preview | high | minimal、low、medium、high | 不支持完全关闭思考 |
gemini-3-pro-preview | — | 原为 low、high | 2026 年 3 月 9 日已下线,改用 3.1 Pro |
gemini-2.5-pro | 动态思考 | generateContent 用 thinkingBudget:128 到 32,768 | 不能关闭思考 |
gemini-2.5-flash | 动态思考 | thinkingBudget:0 到 24,576 | 设为 0 即关闭思考 |
gemini-2.5-flash-lite | 默认不思考 | thinkingBudget:512 到 24,576 | — |
几条容易踩的边界:
- 没有 max 档。 文档里的取值只有 minimal、low、medium、high 四个,不同模型支持其中一部分。看到“Max 档”的说法可以直接忽略。
- 2.5 系列要按 API 分开看。 generateContent 的文档写明 2.5 系列不支持
thinkingLevel,要用thinkingBudget;Interactions API 的表格则给 2.5 系列列出了 low、medium、high。走 generateContent 的旧代码,2.5 继续用 budget 最稳。 - “关掉思考”只在部分模型上成立。 3.1 Pro 和 Argon 都不能关;Flash、Flash-Lite 的 minimal 只是接近不思考;真正能关的是 2.5 Flash 的
thinkingBudget: 0。 - 大小写。 文档示例一律用小写
"low",JS SDK 提供ThinkingLevel.LOW枚举。实测中 3.1 Pro 也接受大写"LOW",但新代码按文档写小写即可。
Gemini 3.1 Pro 目前没有公布下线日期(Google 弃用页,截至 2026 年 10 月 20 日),AI Studio 已把它标为“上一代 Pro 模型”。接入、价格和迁移的细节见 Gemini 3.1 Pro API 价格与接入指南。
Gemini 4 Argon 的思考级别:默认 MEDIUM,思考不能关
Gemini 4 Argon 同样只有 low、medium、high 三档,但默认是 medium,不是 3.1 Pro 的 high。代码里如果只把模型 ID 从 gemini-3.1-pro-preview 换成 gemini-4-argon、没有写思考级别,推理深度的上限会跟着降一档。需要 Argon 想得更深,就要显式传 "high"。
和 3.1 Pro 相比,Argon 有四处不同:
- minimal 会报错,思考不能关闭。 Google 的 generateContent 思考文档写明“You cannot disable thinking for Gemini 4 Argon”。
thinkingBudget已弃用。 单独传 budget 时,Argon 会把它映射到最接近的思考级别并返回警告;和thinkingLevel一起传则返回 400。- 单次输出上限按 API 区分。 generateContent 非流式每个请求最多返回 32,768 个 token,流式最多 65,536 个;Interactions API 在
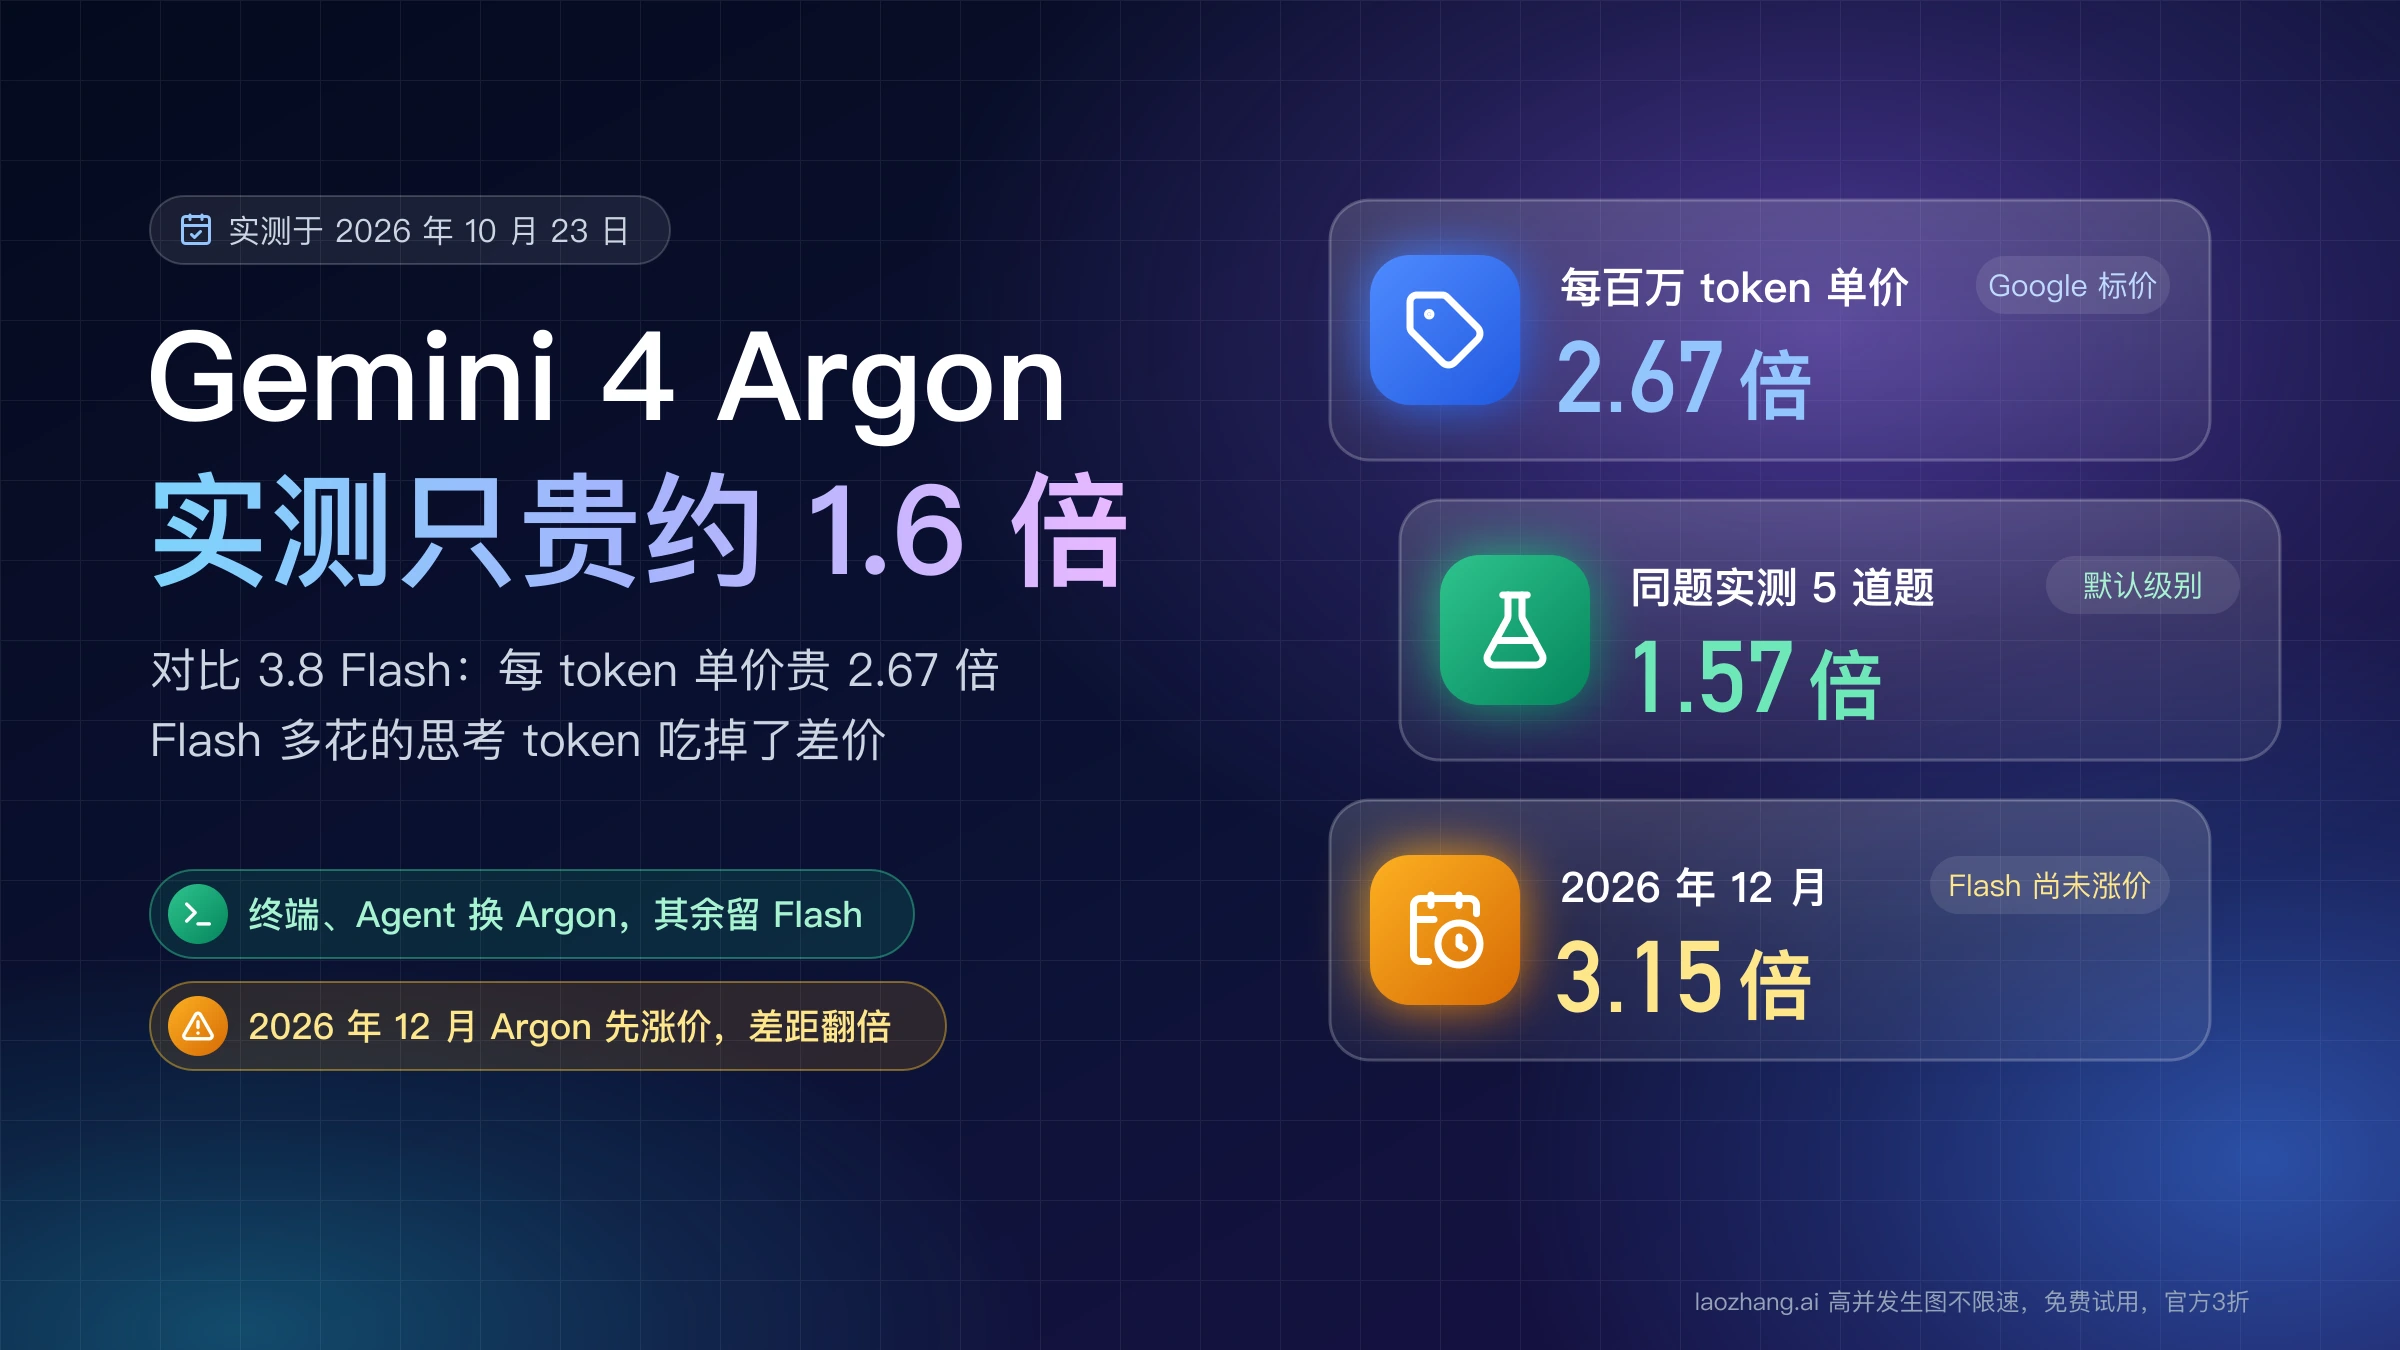
background=False时上限是 65,536,设得更大会返回 400。这个上限包含思考 token。要生成更长的内容,需要用长输出模式(最长 1,048,576 个 token)。 - 价格会变。 输出价(含思考 token)到 2026 年 11 月 30 日是每百万 token $10,12 月 1 日起是 $20;输入价同步从 $2 变为 $4(Gemini API 价格页)。同样的思考 token 数,11 月底前 Argon 比 3.1 Pro 便宜,12 月起反而更贵。
同一道题的单次测试里,Argon 默认档用了 316 个思考 token,medium 用了 384 个,high 用了 916 个,high 约为 medium 的 2.4 倍。Argon 的档位差距比 3.1 Pro 明显,所以在 Argon 上选档对账单的影响更大。
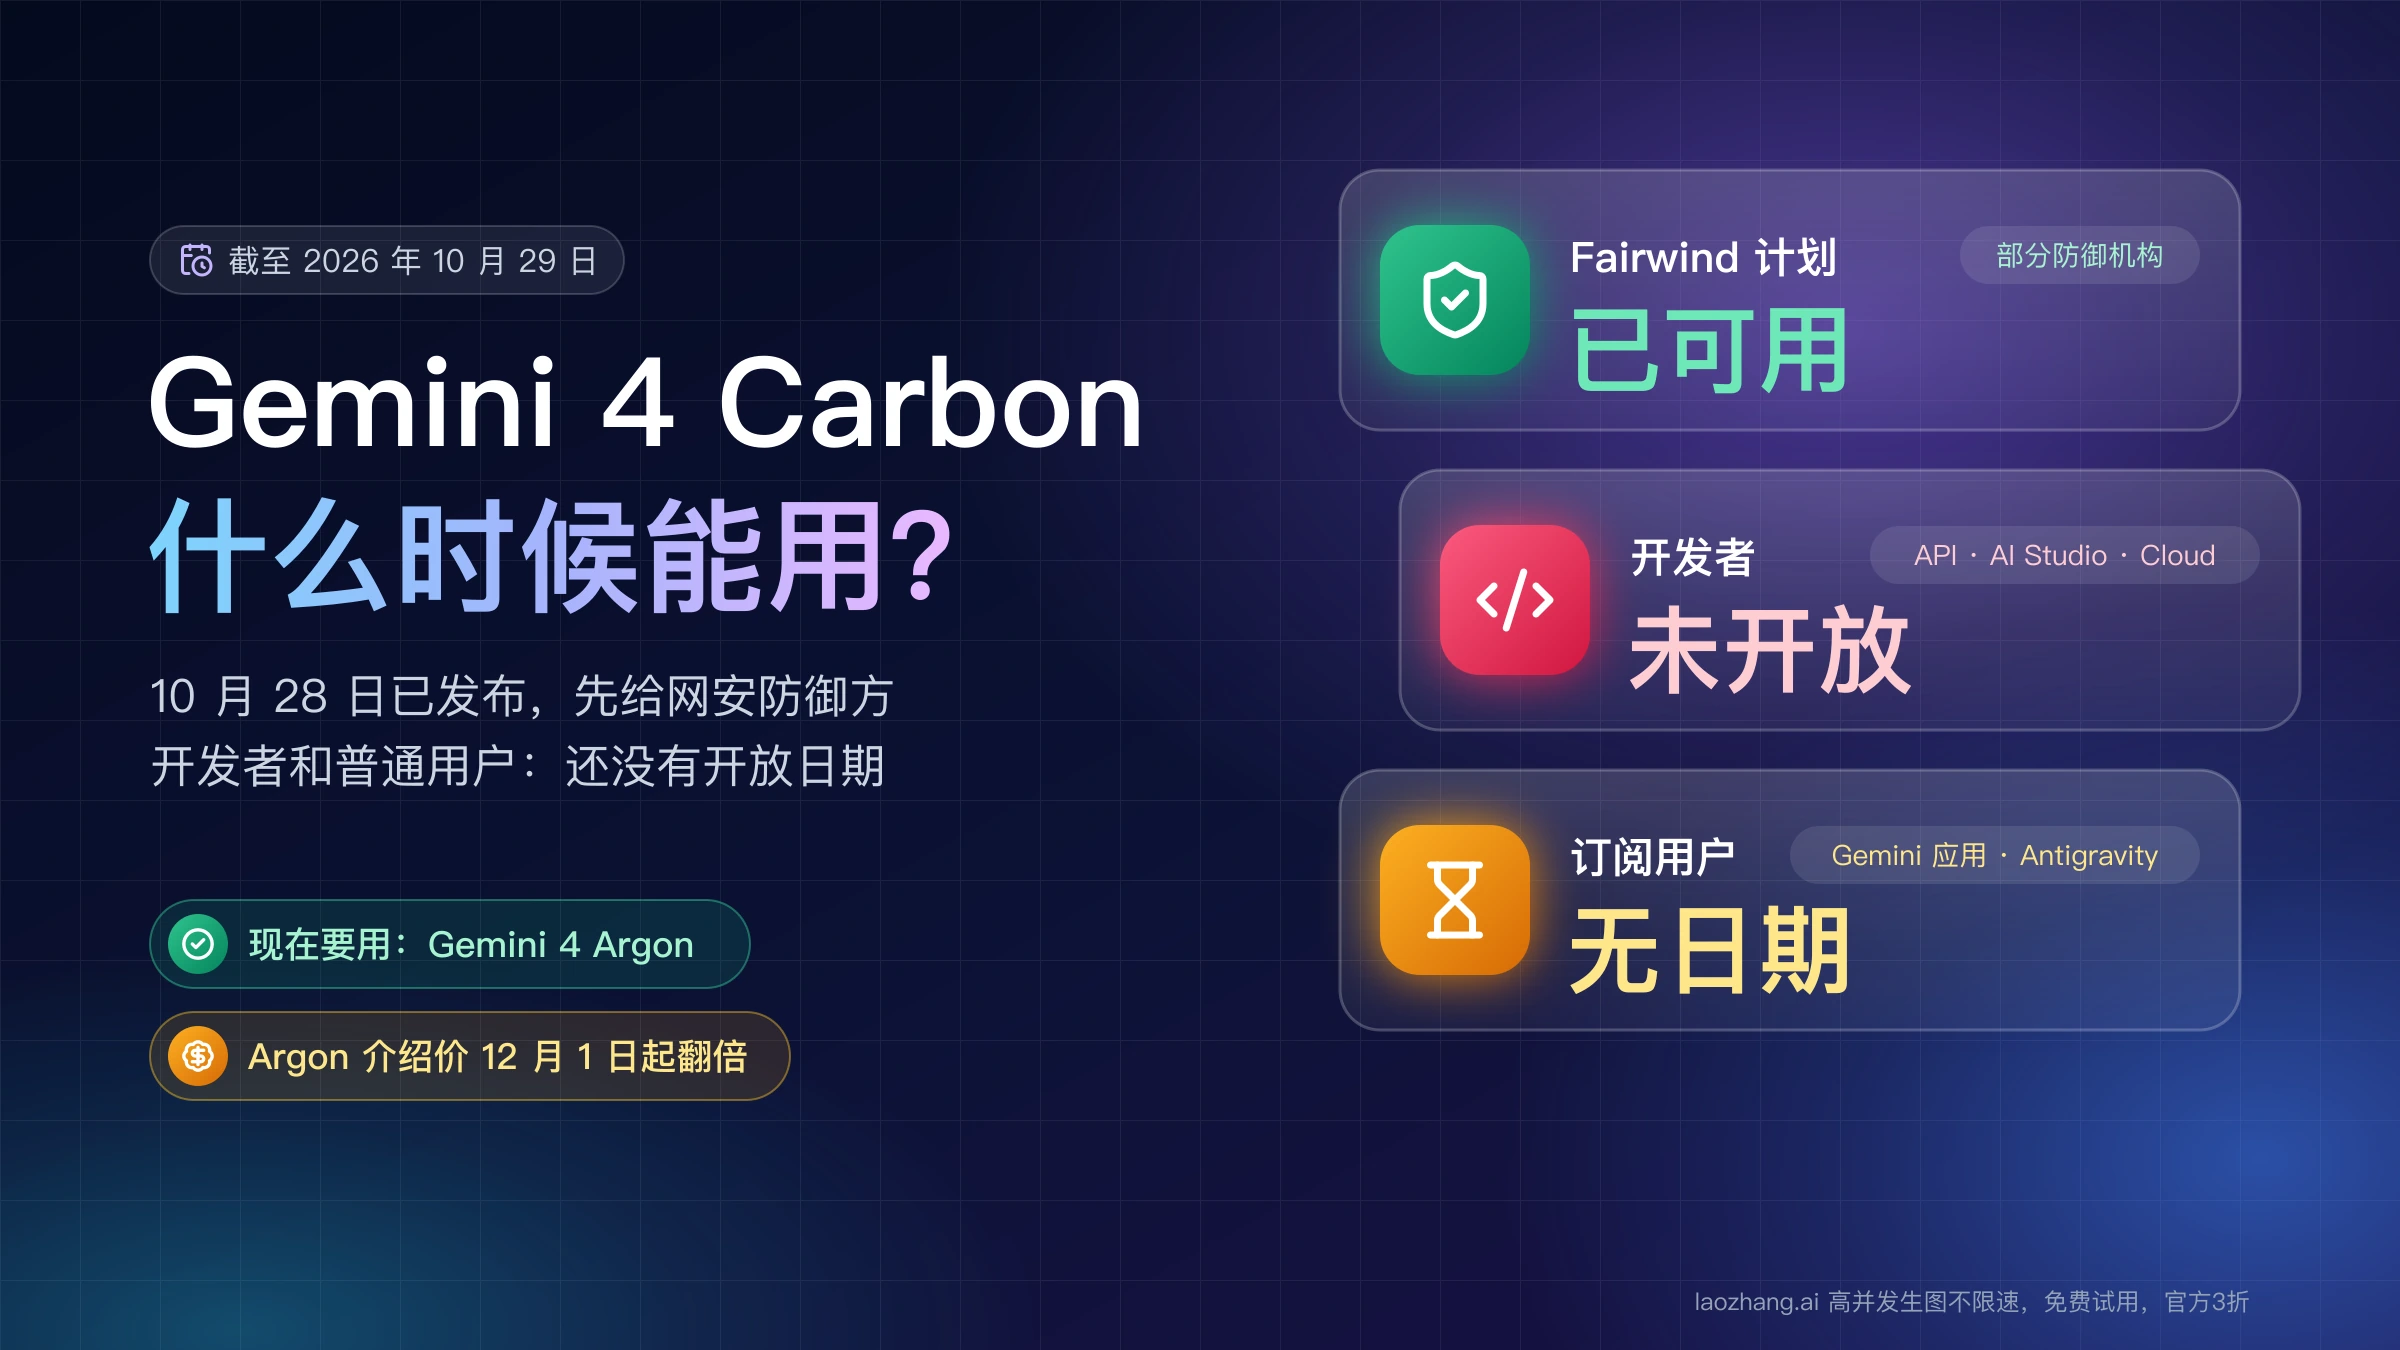
Argon 不在 Gemini API 免费层里。在 AI Studio 里用它需要 Google AI 方案或付费 API key。Gemini 应用里已经选不到 Argon:截至 2026 年 11 月 19 日,英文帮助页的模型表里 Google AI Pro 是 Hydrogen 和 Neon,Ultra 再加 Carbon;Antigravity 里 Pro 和 Ultra 仍能用 Argon。Argon 与 Opus 5.5、GPT-6.1 Sol 的价格和可用性对比见 Gemini 4 Argon、Opus 5.5、GPT-6.1 Sol 对比。
在 AI Studio、Gemini 应用和 Antigravity 里设置思考级别
这三个界面都用 Low、Medium、High 这组名字,但默认值不同,可选的档位也不完全一样。
Google AI Studio:右侧 Run settings 里的 Thinking level
在 AI Studio 选好模型后,右侧 Run settings 面板里有一个“Thinking level”下拉框。截至 2026 年 10 月 22 日,选 Gemini 4 Argon 时默认 Medium,可选 Low、Medium、High,面板里不显示 Temperature 滑块;选 Gemini 3.1 Pro Preview 时默认 High,Temperature 滑块停在 1。AI Studio 里的设置只影响你在网页里试的这次对话,不会改变你代码里 API 请求的默认值。
Gemini 应用:低、中、高三档,不选时默认低
Gemini 应用(网页版和手机 App)从 2026 年 10 月起,每个模型都可以选低(Low)、中(Medium)、高(High)三档。路径是:点输入框下方当前的模型名,选一个模型,再选思考级别。Google 帮助页写明三件事:
- 不选时默认低。 “If you don't select a thinking level, it will default to Low.” 这和 API 里 3.1 Pro 默认 high 正好相反。
- 档位越高,用掉的额度越多。 更强的模型和更高的思考级别都会消耗更多使用额度;有付费方案的用户用完额度后,对话会转到 Flash-Lite 继续。
- Auto 会同时选模型和档位。 打开自动选择后,Gemini 按提问把请求分给它认为最合适的模型和思考级别。想知道这次回答用了哪个模型,可以在“更多”(More)里打开“显示思考步骤”(Show thinking steps),模型名在最底部。选好的模型和档位在当前对话里会一直保留。
搜索里常见的“低點、中等、高點”“思考程度”“effort level”,说的就是这一组选项:繁体中文帮助页写作“每個可用模型均可選取低、中、高三種難度”,英文帮助页写作“effort level from low, medium, and high”。
这一组选项是 2026 年 10 月才统一的。据 9to5Google 报道,5 月 17 日应用里先出现了“Thinking level”菜单,只有 Standard 和 Extended(延长思考)两档,而且只给 Fast(Gemini 3 Flash)和 Gemini 3.1 Pro;10 月 9 日 Low/Medium/High 取代了 Extended,和 AI Studio、Antigravity 的叫法对齐。所以以前“快速、思考、Pro”或“标准、延长思考”的选择,现在对应的是“选哪个模型”加“选哪一档”两步。
各方案能用哪些模型(Google Gemini 应用英文帮助页,截至 2026 年 11 月 19 日;中文帮助页当天还是旧表):
| 方案 | 可选模型 | 思考级别 |
|---|---|---|
| 无方案 | Auto | 低、中、高 |
| Google AI Plus | Auto、Gemini 4 Hydrogen | 低、中、高 |
| Google AI Pro | Auto、Hydrogen、Gemini 4 Neon | 低、中、高 |
| Google AI Ultra | Auto、Hydrogen、Neon、Gemini 4 Carbon | 低、中、高 |
Auto 会在 Hydrogen 和一个快速轻量模型之间自动选。10 月 22 日的旧表里 Pro 和 Ultra 还能选 Argon 和 Pro 模型,11 月 18 日 Neon 上线后,Gemini 4 Argon 和 Gemini 3.1 Pro 已不在任何一档里。要给 Argon 设思考级别,得去 API、AI Studio 或 Antigravity;3.1 Pro 则只剩 API 和 AI Studio,个人方案的 Antigravity 里已经没有它。应用里 Hydrogen、Neon、Carbon 怎么选,见 Gemini 4 Neon、Carbon、Hydrogen 区别:12 月起 Neon 比 Carbon 省;买哪个方案更划算,见 稳定且低价的 Gemini Pro 升级:价格、套餐与官方省钱路线。
Antigravity:gemini-3.1-pro-high 和 gemini-3.1-pro-low 是什么
“Gemini 3.1 Pro (High)”“gemini-3.1-pro-low”这类写法,来自 Antigravity 的模型选择器:它把模型名和思考档位显示在一起。它们不是 API 里的模型 ID。在 Gemini API 里,3.1 Pro 只有 gemini-3.1-pro-preview 这一个 ID,档位另用 thinking_level 传。
Antigravity 官方文档里的选项(截至 2026 年 10 月 22 日):
| 模型 | 默认 | 可选档位 | 哪些方案能用 |
|---|---|---|---|
| Gemini 4 Argon | High | Low、Medium、High | 付费 Google AI Pro 或随符合条件的高端设备附赠的 Pro 试用、Ultra、企业版;Antigravity IDE 里没有,App、CLI 和 IDE 扩展里有 |
| Gemini 3.8 Flash | Medium | Fast、Low、Medium、High | 所有方案 |
| Gemini 3.1 Pro | High | Low、High | 仅企业版 |
两点和 API 不同:Antigravity 里 3.1 Pro 没有 Medium;Argon 在 Antigravity 默认 High,而在 API 和 AI Studio 里默认 Medium。个人 Pro 或 Ultra 方案在 Antigravity 里已经用不了 Gemini 3.1 Pro。
如何为你的任务选择合适的思考级别
先按任务类型选一个起点,再用你自己的样本验证,不要凭感觉一律开到 high。Google 思考文档给出的分法是:简单任务(查事实、分类)用 minimal 或 low,中等任务(比较概念、创意推理)用默认档,复杂任务(高级编程、数学、多步规划)用最高档。
| 任务 | 3.1 Pro 起点 | Argon 起点 | 什么时候升一档 |
|---|---|---|---|
| 翻译、分类、抽取字段、格式转换、短问答 | low | low | 输出漏项、格式不稳定 |
| 聊天、客服、高并发接口 | low | low 或默认 medium | 用户追问率上升,答非所问 |
| 写代码、改代码、写文章、做摘要分析 | medium | 默认 medium | 代码跑不通、分析漏掉条件 |
| 数学证明、竞赛题、复杂调试、多步规划、Agent 任务 | high | high | 已在最高档:换更强的模型,或拆分任务 |
三条决策规则:
- 在 3.1 Pro 上,把 high 改成 low 省得不多时,就别为省钱牺牲质量。 单题测试里,3.1 Pro 的 high 比 low 每次贵约 $0.0037($0.0163 对 $0.0126)。对短题来说,换成 Flash 或批量处理省得更多。
- 在 Argon 上,档位是主要的成本开关。 high 的思考 token 约为 medium 的 2.4 倍,12 月 1 日涨价后,这个差距在账单上还会翻倍。
- 用 20 到 50 条真实请求做 A/B。 同一批请求分别跑两档,比较答对率和响应里的
thoughtsTokenCount(generateContent)或total_thought_tokens(Interactions),再定默认档。
只想让模型“想得更久”时,API 里把档位设成 high 即可;在 Gemini 应用里则手动选“高”,因为不选时默认是低。
完整代码示例:Python、JavaScript 和 REST API
以下示例都从环境变量 GEMINI_API_KEY 读取密钥,不要把 key 写进代码或 URL。参数名和取值以 Google 思考文档为准,截至 2026 年 10 月 22 日。
Python(Google Gen AI SDK)
from google import genai
from google.genai import types

client = genai.Client()  # 读取环境变量 GEMINI_API_KEY

response = client.models.generate_content(
    model="gemini-3.1-pro-preview",
    contents="从下面这段文字里提取所有邮箱地址:……",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(
            thinking_level="low",      # 3.1 Pro 可选 low / medium / high
            include_thoughts=True,     # 需要思考摘要时再打开
        )
    ),
)

for part in response.candidates[0].content.parts:
    if not part.text:
        continue
    print("思考摘要:" if part.thought else "回答:", part.text)

usage = response.usage_metadata
print("思考 token:", usage.thoughts_token_count)
print("输出 token:", usage.candidates_token_count)
include_thoughts=True 返回的是思考摘要,不是完整思考过程;思考级别作用于完整思考,计费也按完整思考算。
JavaScript(Google Gen AI SDK)
import { GoogleGenAI, ThinkingLevel } from "@google/genai";

const ai = new GoogleGenAI({}); // 读取环境变量 GEMINI_API_KEY

const response = await ai.models.generateContent({
  model: "gemini-3.1-pro-preview",
  contents: "比较 REST 和 GraphQL 的取舍,并给出代码示例。",
  config: {
    thinkingConfig: {
      thinkingLevel: ThinkingLevel.MEDIUM,
    },
  },
});

console.log(response.text);
console.log("思考 token:", response.usageMetadata.thoughtsTokenCount);
REST API(cURL)
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.1-pro-preview:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "证明素数有无穷多个。"}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "high"}
    }
  }'
响应的 usageMetadata.thoughtsTokenCount 就是这次的思考 token 数。
Interactions API:generation_config.thinking_level
Google 现在推荐新项目使用 Interactions API。参数放在 generation_config 里,思考摘要用 thinking_summaries 打开,用量字段叫 total_thought_tokens:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-argon",
    input="为一个 3 节点的消息队列设计故障转移方案,并列出边界情况。",
    generation_config={
        "thinking_level": "high",        # Argon 默认 medium,需要更深推理时显式写 high
        "thinking_summaries": "auto",
    },
)

print(interaction.output_text)
print("思考 token:", interaction.usage.total_thought_tokens)curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
-H "x-goog-api-key: $GEMINI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-pro-preview",
"input": "把这份需求拆成可以并行开发的任务。",
"generation_config": {"thinking_level": "medium"}
}'多轮对话时,Interactions API 的有状态模式(store: true 加 previous_interaction_id)会在服务端自动处理思考签名(thought signature)。自己管理对话历史时,要把模型返回的思考块和签名原样传回;用 generateContent 时,SDK 会自动处理,手写 REST 请求则要自己带上,函数调用场景下这是必需的。传回的签名会计入输入 token。
OpenAI 兼容接口:reasoning_effort
用 OpenAI SDK 调 Gemini 时,档位写在 reasoning_effort 里:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GEMINI_API_KEY"],
    base_url="https://generativelanguage.googleapis.com/v1beta/openai/",
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    reasoning_effort="high",
    messages=[{"role": "user", "content": "解释一下这段正则为什么会回溯爆炸:……"}],
)
print(response.choices[0].message.content)
Google 公布的映射:Argon 上 reasoning_effort 的 minimal 和 low 都对应 low,medium 对应 medium,high 对应 high;2.5 系列对应的 budget 是 1,024、1,024、8,192、24,576。这张表没有列出 3.1 Pro。reasoning_effort 不能和 thinking_level 或 thinking_budget 同时使用;"none" 只能关闭 2.5 系列(2.5 Pro 除外)的思考,Gemini 3 系列不能关。
实测:同一道题下各档思考 token 与单次成本
2026 年 10 月 22 日,用 laozhang.ai(与本博客同一团队运营)的 Gemini 原生接口(/v1beta/models/{model}:generateContent,请求转发到 Google 的模型)跑了一次小测试。题目是一道买笔应用题:6 支装 $4.50,10 支装 $7.00,至少买 58 支,最少花多少钱。所有档位都答对了:4 盒 10 支装加 3 盒 6 支装,共 $41.50。每格只有一次调用,成本按 Google 标价、用响应里的 token 数计算:
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
| 模型与档位 | 输入/思考/输出 token | 单次成本 |
|---|---|---|
| 3.1 Pro 默认(即 high) | 61/1,200/45 | $0.0151 |
| 3.1 Pro low | 61/995/45 | $0.0126 |
| 3.1 Pro medium | 61/1,120/48 | $0.0141 |
| 3.1 Pro high,打开思考摘要 | 61/1,297/48 | $0.0163 |
| Argon 默认(即 medium) | 92/316/57 | $0.0039 |
| Argon medium | 92/384/49 | $0.0045 |
| Argon high | 92/916/49 | $0.0098 |
| 3.8 Flash 默认(即 medium) | 315/1,058/46 | $0.0044 |
| 3.8 Flash low | 315/499/46 | $0.0023 |
计算方法:单次成本 = 输入 token × 输入价 +(思考 token + 输出 token)× 输出价。以 3.1 Pro high 为例:61 × $2 / 1,000,000 +(1,297 + 48)× $12 / 1,000,000 ≈ $0.0163。Argon 用首发价 $2/$10 计算;12 月 1 日起单价翻倍,Argon high 这一格会变成约 $0.0197。3.8 Flash 按 $0.75/$3.75 计算。
从这组数据能看出三件事:
- 3.1 Pro 在简单题上各档差距小。 low 到 high 只差 302 个思考 token,每 1,000 次调用约差 $3.7($0.0163 − $0.0126 = $0.0037)。3.1 Pro 三档的耗时都在 17 到 19 秒之间。
- Argon 和 3.8 Flash 的档位差距明显。 Argon high 是 medium 的 2.4 倍,3.8 Flash 的 low 约为默认档的一半。
- Argon 的低档思考量随题目变化。 2026 年 10 月 15 日同一线路的 12 题测试里,Argon 在默认、low、medium 下报告的思考 token 都是 0,只有 high 用了 646 到 1,461 个;这次 medium 用了 384 个。不能把 Argon 的 medium 当成“不思考”。
参数接受情况:3.1 Pro 传 "minimal" 返回 400;同一请求里同时放 thinkingLevel 和 thinkingBudget 返回 400,与文档一致。3.1 Pro 传 thinkingBudget: 0 返回 200,但仍有 124 个思考 token,说明思考并没有关掉;旧参数 thinkingBudget: 1024 仍可用。
这组测试的边界:每格只有一个样本,不是基准测试,只说明单道短题上的量级。延迟受转发线路影响。Argon 的 low 和 minimal 两格因为线路繁忙(429)没有测到。另外,这条线路对非法值 "max" 和 3.8 Flash 的 "minimal" 都返回了 200,但 Google 文档写明 3.8 Flash 不支持 minimal,所以不能据此认为 Google 会接受这些值,代码里应按文档的取值写。
Deep Think Mini:当你设置 HIGH 时到底发生了什么
把 3.1 Pro 设成 thinking_level: "high",做的事就是放开这个模型的推理深度上限:允许它在需要时用更多思考 token、花更长时间再输出第一个回答 token。它不会切换到另一个叫“Deep Think Mini”的系统。Google 的模型页、开发者文档和 API 参数表里都没有这个名字。
“Deep Think Mini”出自 2026 年 2 月 VentureBeat 对 3.1 Pro 的上手评测标题,作者用它来形容“可按需调节推理深度的 3.1 Pro”。这是评测者的比喻,不是 Google 的产品名,也不是可以传给 API 的值,所以“设成 HIGH 就会激活 Deep Think Mini”的说法不成立。
真正的 Deep Think 是另一回事:
- 它是 Gemini 应用里的一个模式,不是 API 参数。 需要 Google AI Ultra(或 Ultra for Business)方案、年满 18 岁;10 月 22 日时的路径是模型名 → Pro → 思考级别 → Deep Think,11 月 19 日的英文帮助页模型表里已经没有 Pro 模型,这条路径现在是否还在,本站没有重新核实。它仍是实验功能,一个回答可能要几分钟,Google 保留随时停用的权利。
- 10 月时 Google 说它会被 Gemini 4 Argon 取代。 当时的帮助页写明“Deep Think is being replaced by Gemini 4 Argon”,理由是 Argon 已经超过了 Deep Think 的能力;到 11 月 19 日,Argon 本身也不在应用的模型表里了。
- 成绩与 3.1 Pro high 分开公布。 Google DeepMind 介绍的 Gemini 3.1 Deep Think 建立在 3.1 Pro 之上,2026 年 2 月公布的成绩是 ARC-AGI-2 84.6%、Humanity's Last Exam 无工具 48.4%;3.1 Pro high 对应的是 77.1% 和 44.4%。
中文里常把 Deep Think 译成“深度思考”,容易和“高”档混为一谈。在 Gemini 应用里,“高”是每个模型都有的思考级别,Deep Think 是只有 Ultra 才有的独立模式;Deep Research 则是生成调研报告的另一个功能。三者不是一回事。
思考 Token 成本详解与支出优化策略
计费规则只有几条,但每条都会影响账单:
- 思考 token 按输出价计费。 Gemini API 价格页的输出价写的是“including thinking tokens”,一次响应的费用 = 输出 token + 思考 token。
- 只拿到摘要,也按完整思考计费。 打开
include_thoughts或thinking_summaries返回的是摘要,计费按模型实际生成的完整思考算。 max_output_tokens包含思考 token。 模型在推理途中撞到上限时,会返回截断或空的回答(generateContent 的finish_reason为MAX_TOKENS,Interactions 的状态为incomplete),已经生成的思考 token 照样计费。Google 建议降低思考级别,而不是把max_output_tokens设得很小。- 思考签名回传会增加输入 token。
价格(Gemini API 付费层,每百万 token,截至 2026 年 10 月 22 日):
| 模型 | 输入 | 输出(含思考) | 缓存读取 | 备注 |
|---|---|---|---|---|
| Gemini 3.1 Pro Preview,提示 ≤20 万 token | $2 | $12 | $0.20 | 缓存存储每百万 token 每小时 $4.50;无免费层 |
| Gemini 3.1 Pro Preview,提示 >20 万 token | $4 | $18 | $0.40 | — |
| Gemini 4 Argon,到 11 月 30 日 | $2 | $10 | $0.10 | 只有隐式缓存;无免费层 |
| Gemini 4 Argon,12 月 1 日起 | $4 | $20 | $0.20 | — |
| Gemini 3.8 Flash、3.6 Flash,到 12 月 31 日 | $0.75 | $3.75 | — | 2027 年 1 月 1 日起 $1.50/$7.50 |
换算成思考成本:每 1,000 个思考 token,3.1 Pro 是 $0.012,Argon 现在是 $0.010,12 月 1 日起是 $0.020。
除了选档,下面几个办法往往省得更多:
- 显式写档位。 3.1 Pro 不写就是 high;Argon 不写是 medium,换模型时别把默认值当成一样的。
- 简单任务换模型,而不只是降档。 同一道题,3.8 Flash low 的单次成本约为 3.1 Pro low 的五分之一($0.0023 对 $0.0126)。
- 不着急的请求走 Batch API。 3.1 Pro 批量价为 $1/$6(≤20 万 token),即标准价的一半;Argon 的批量价同样减半。
- 重复的长前缀用缓存。 3.1 Pro 缓存读取 $0.20,另按存储时长计费。
各模型的完整价格表见 Gemini API Key 购买前先看:价格、免费额度与 2027 年 Flash 涨价;免费层还剩哪些模型,见 Gemini API Key 免费额度与速率限制 2026。
从 thinking_budget 迁移到 thinking_level
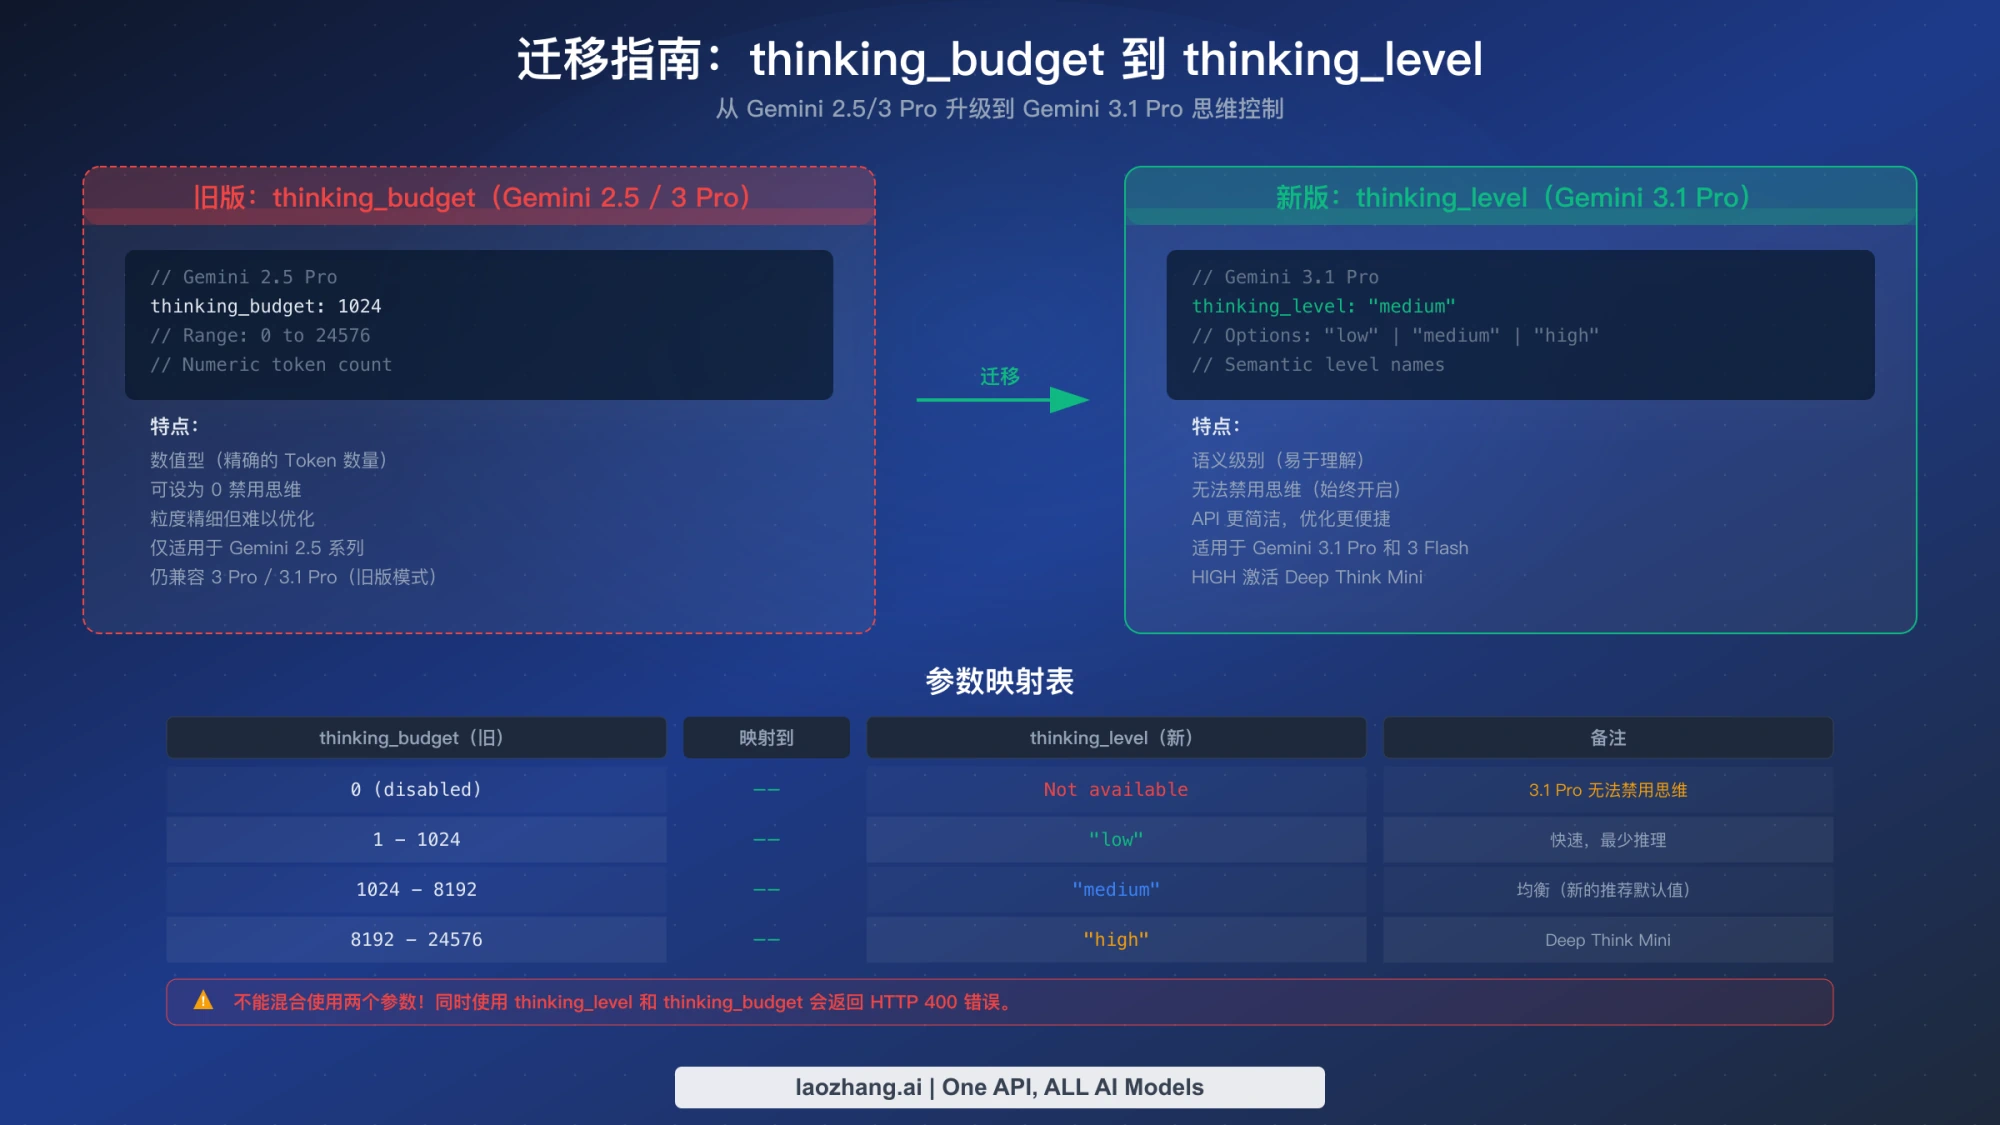
图为 2026 年 2 月版本,图中的 budget 区间与 level 对应关系不是 Google 公布的映射,以正文为准。
迁移只需记住三条:
- 两个参数不能同时传。 Gemini 3 和 Gemini 4 上,同一请求里同时有
thinking_level和thinking_budget会返回 400。 - Gemini 3 仍兼容旧的
thinking_budget,Gemini 4 已弃用。 3.1 Pro 收到 budget 仍会正常处理,Google 建议迁移;Argon 收到单独的 budget 会映射到最接近的档位并返回警告。 - 没有官方的 budget→level 换算表。 Google 公布的唯一对应关系在 OpenAI 兼容文档里:2.5 系列的 1,024、8,192、24,576 分别对应 low、medium、high。把任意 budget 数值按区间套到三档(例如“1 到 1,024 对应 low”)没有官方依据。
实际做法:先按上一节的任务表定档,再用你原来的 budget 设置跑同一批请求,对比答对率和思考 token。原来设成 thinking_budget: 0、想关掉思考的代码,在 3.1 Pro 上没有等价选项,改成 "low" 是最接近的做法;如果确实需要接近不思考,就换成支持 minimal 的 Flash 或 Flash-Lite。
from google import genai
from google.genai import types

client = genai.Client()

# 迁移前:Gemini 2.5 Pro 用 thinking_budget(范围 128 到 32,768,不能关闭)
old_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_budget=8192)
)

# 迁移后:Gemini 3.1 Pro 用 thinking_level,并删掉 thinking_budget
new_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium")
)

response = client.models.generate_content(
    model="gemini-3.1-pro-preview",
    contents="解这个方程组:……",
    config=new_config,
)
迁移时顺手删掉 temperature。Google 对所有 Gemini 3 模型的建议是保持默认值 1.0:调到 1.0 以下,可能出现循环输出或在数学、推理任务上表现变差。旧代码里为了“稳定输出”把 temperature 设成 0 或 0.2 的,迁移到 3.1 Pro 时应直接去掉这个参数。
常见错误与问题排查
账单比预期高。 最常见的原因是没写 thinking_level,3.1 Pro 按默认 high 运行。先在响应里看 thoughtsTokenCount 或 total_thought_tokens,确认思考 token 占了多少,再决定是降档、换模型还是走 Batch。
同时设置思考参数返回 400。 请求里同时出现了 thinking_level 和 thinking_budget,常见于迁移时新旧配置被合并。用 OpenAI 兼容接口时,reasoning_effort 和 extra_body 里的 thinking_level 也不能同时传。
minimal 返回 400 或报错。 3.1 Pro、Argon 和 3.8 Flash 都不支持 minimal。需要接近不思考时,换用 3.6 Flash、3.5 Flash-Lite 或 3.1 Flash-Lite。
gemini-3-pro-preview 调用失败。 这个模型已于 2026 年 3 月 9 日下线,替代模型是 gemini-3.1-pro-preview。旧代码里 Gemini 3 Pro “只支持 LOW 和 HIGH”的判断也可以一并删掉。
回答被截断或为空。 max_output_tokens 包含思考 token,high 档在长任务上可能先把额度用在思考上。把上限调大,或者降一档;3.1 Pro 单次最多输出约 64K token,Argon 在 generateContent 非流式下每个请求最多 32,768 个。
Argon 返回关于 thinkingBudget 的警告。 单独传了 budget,Argon 已把它映射到最接近的档位。改成 thinking_level 即可消除警告。
输出开始循环或推理变差。 检查是否把 temperature 调到了 1.0 以下,Gemini 3 系列建议保持 1.0。
多轮函数调用出错。 手写 REST 或自己拼接历史时,漏传了思考签名。把模型返回的完整内容原样放回下一轮,不要合并或改写带签名的部分。
2.5 模型上 thinkingLevel 不生效。 generateContent 的文档写明 2.5 系列不支持 thinkingLevel,改用 thinkingBudget。
每个模型可用的档位不同,可以在发请求前用一张表做检查(取值以 2026 年 10 月 14 日的 Google 思考文档为准):
ALLOWED_LEVELS = {
    "gemini-3.1-pro-preview": {"low", "medium", "high"},
    "gemini-4-argon": {"low", "medium", "high"},
    "gemini-3.8-flash": {"low", "medium", "high"},
    "gemini-3.6-flash": {"minimal", "low", "medium", "high"},
    "gemini-3.5-flash-lite": {"minimal", "low", "medium", "high"},
}

def thinking_config(model: str, level: str) -> dict:
    """只放 thinking_level,不放 thinking_budget,避免 400。"""
    if level not in ALLOWED_LEVELS.get(model, set()):
        raise ValueError(f"{model} 不支持 thinking_level={level!r}")
    return {"thinking_config": {"thinking_level": level}}
429 报错和思考级别无关,是速率或配额限制,排查方法见 Gemini API 速率限制 2026:按项目计算,429 对应哪种限额、怎么提额。
常见问题:Gemini 思考级别的 High、Low 与默认值
Gemini 3.1 Pro 的 High 和 Low 有什么区别?
High 允许模型推理得最深,首个回答 token 出来得更晚,思考 token 也可能更多;Low 尽量压低延迟和成本,但仍会思考。在简单题上两者差距不大,单题测试里只差约 300 个思考 token;在数学、复杂调试和多步规划上,High 的优势才明显。Google 公布的 3.1 Pro 成绩(如 ARC-AGI-2 77.1%)都是 High 档的成绩。
Gemini 的“低點、中等、高點”是什么意思?
指的是 Gemini 应用里每个模型可选的三档思考级别:低(Low)、中(Medium)、高(High)。繁体中文帮助页把它称为“三種難度”,英文叫 effort level 或 thinking level。档位越高,回答越仔细,也越耗额度;不选时默认低。
Gemini 3.1 Pro 默认思考级别是什么?
在 Gemini API(generateContent、Interactions 和 OpenAI 兼容接口)里默认 high,AI Studio 里默认 High,Antigravity 里默认 High。Gemini 应用 11 月 18 日起已不列 3.1 Pro,应用里的其他模型不选档位时默认低。Gemini 4 Argon 在 API 和 AI Studio 里默认 medium。
gemini-3.1-pro-high 和 gemini-3.1-pro-low 是不同的模型吗?
不是。它们是 Antigravity 选择器里“模型 + 档位”的显示名,背后是同一个 Gemini 3.1 Pro。Antigravity 里 3.1 Pro 只有 Low 和 High 两档,而且目前仅企业版可用。API 里的模型 ID 只有 gemini-3.1-pro-preview,档位用 thinking_level 传。
Gemini 能关掉思考吗?
Gemini 3.1 Pro、Gemini 4 Argon 和 2.5 Pro 都不能关。Flash 和 Flash-Lite 的 minimal 档在大多数查询上接近不思考,但不保证完全关闭;2.5 Flash 可以用 thinkingBudget: 0 关闭。在 3.1 Pro 上传 thinkingBudget: 0,实测仍产生了 124 个思考 token。
Gemini 的深度思考就是 High 吗?
不是。High 是每个模型都有的思考级别;Deep Think 是 Gemini 应用里只给 Google AI Ultra 用户的独立模式,回答可能要几分钟,10 月时 Google 说它会被 Gemini 4 Argon 取代,API 里没有对应的参数。“Deep Think Mini”则不是 Google 的产品名。
思考级别越高,Gemini 应用的额度用得越快吗?
是的。Google 帮助页写明,更强的模型和更高的思考级别都会消耗更多使用额度;有付费方案的用户用完额度后,对话会转到 Flash-Lite 继续。日常提问用低或中,只在难题上切到高,额度能撑得更久。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月19日。
参考来源5
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年11月19日。