Как настроить уровни мышления Gemini 3.1 Pro: LOW, MEDIUM, HIGH
В API у Gemini 3.1 Pro уровни low, medium и high, по умолчанию high, а minimal даёт ошибку 400. В приложении Gemini по умолчанию Low, у Gemini 4 Argon — medium.
Содержание
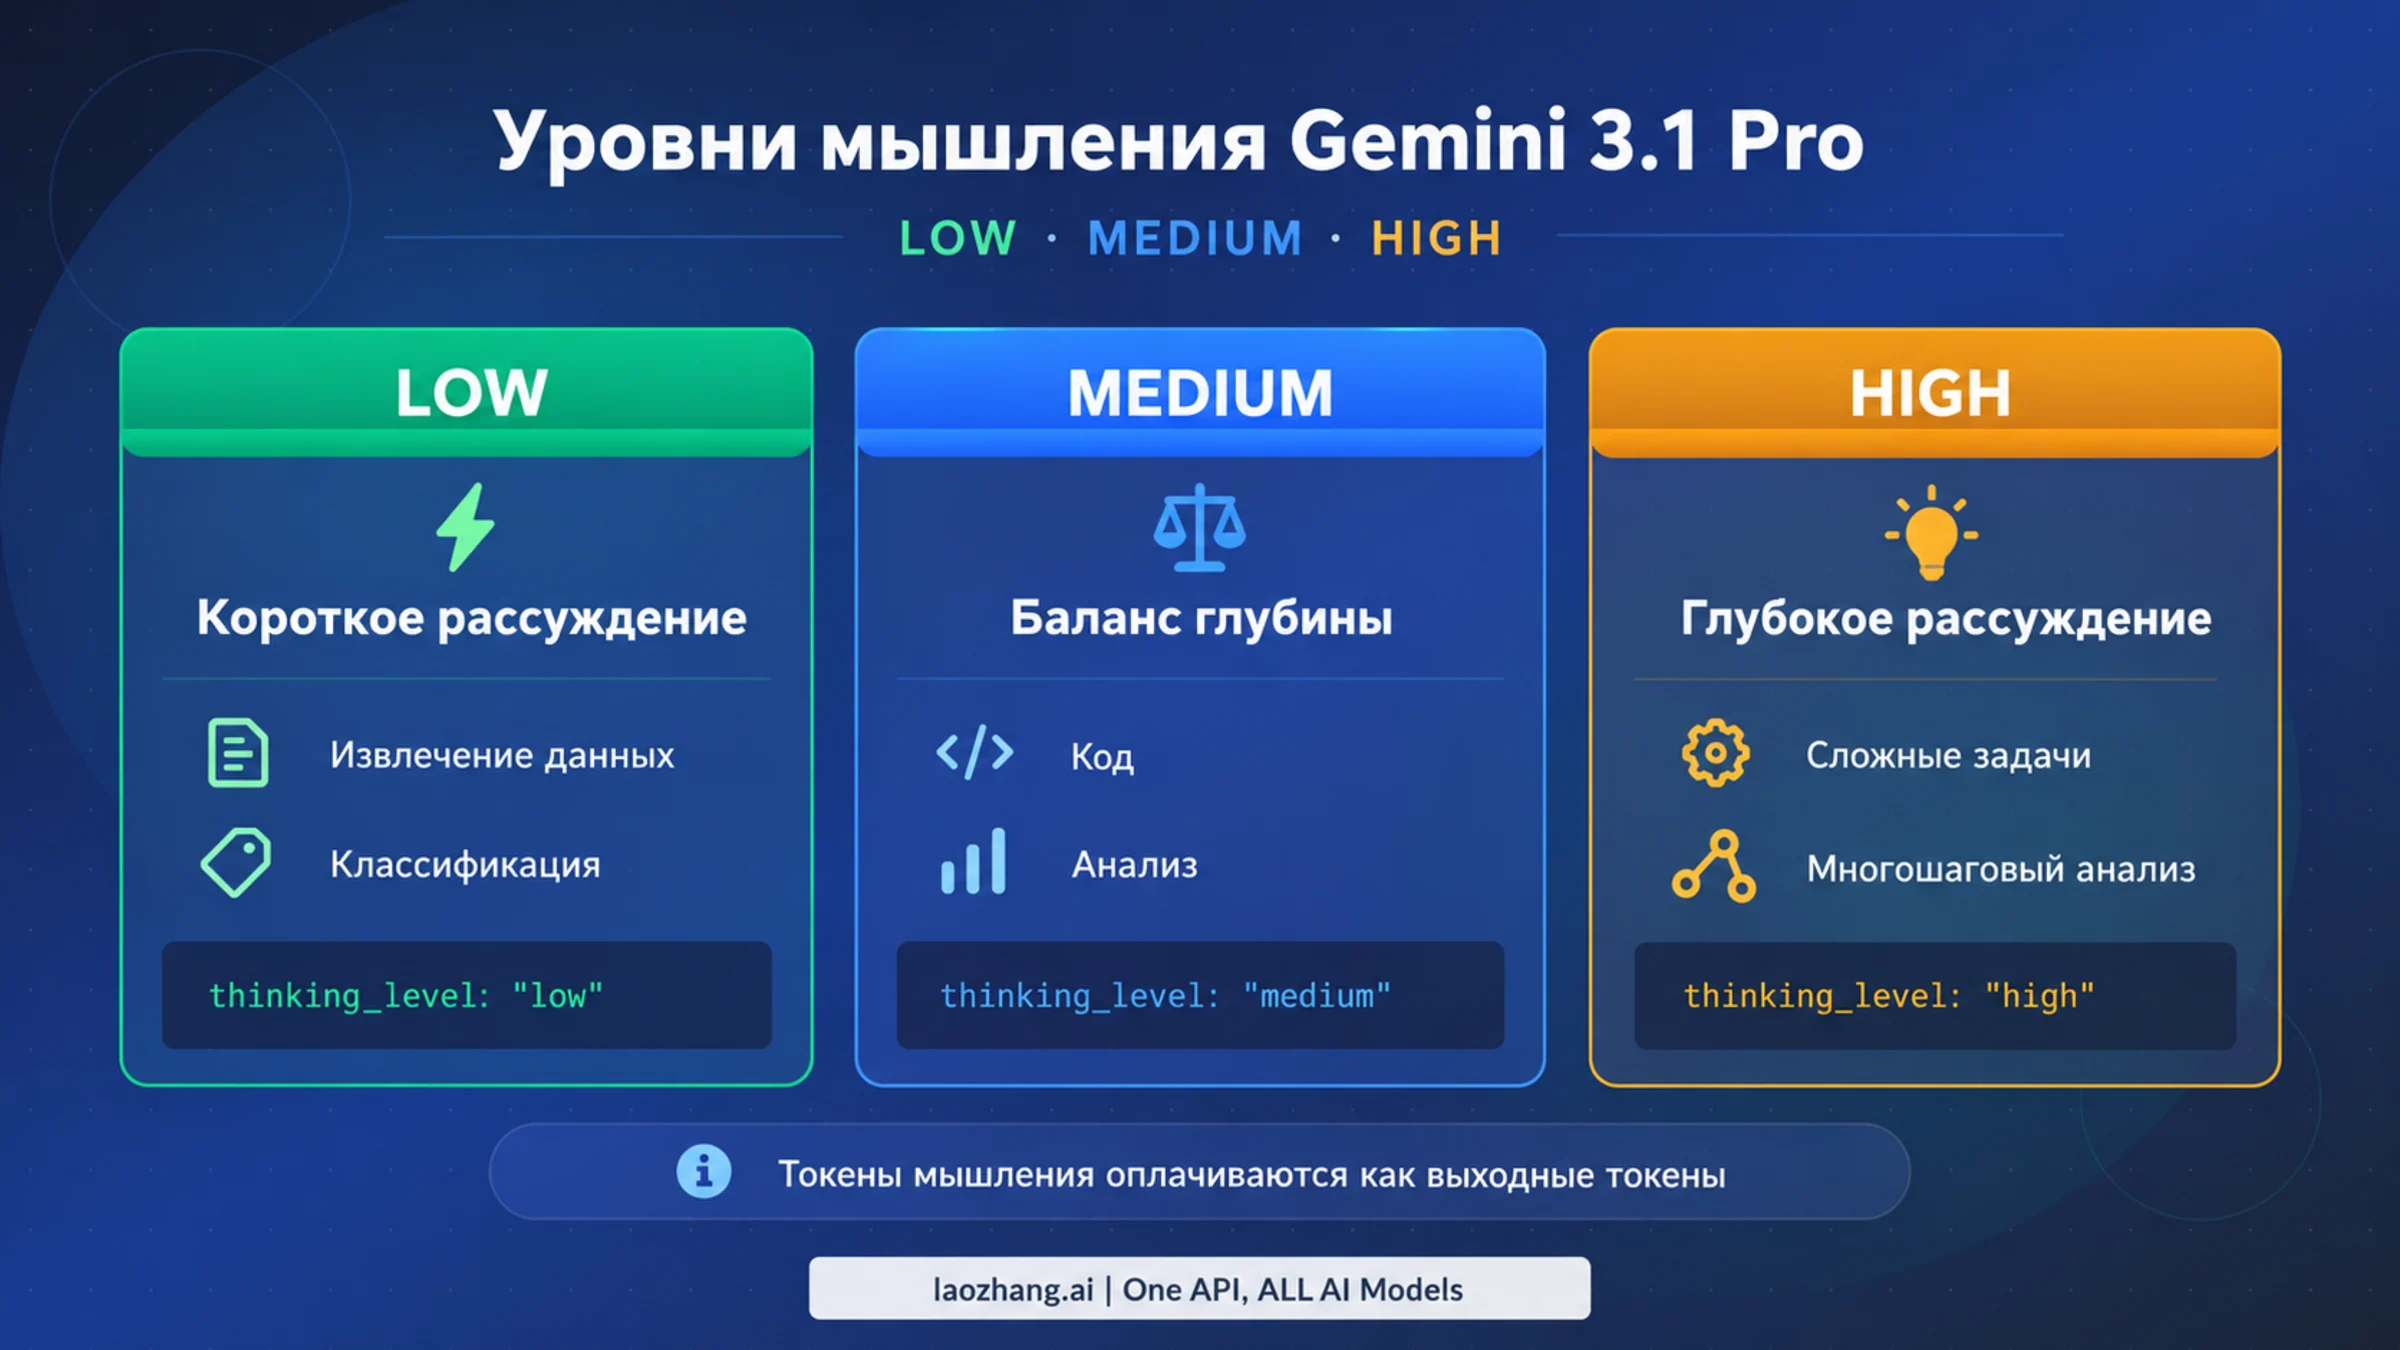
Уровень мышления Gemini 3.1 Pro задаётся параметром thinking_level (в generateContent через REST и JavaScript — thinkingLevel) и принимает три значения: low, medium и high. Если ничего не указать, модель работает на high, самом глубоком и самом дорогом уровне; значение minimal у 3.1 Pro не поддерживается и возвращает ошибку 400. У Gemini 4 Argon набор тот же, но по умолчанию стоит medium. В интерфейсах Google правила свои: в AI Studio у 3.1 Pro по умолчанию High, в приложении Gemini — Low, а в Antigravity для 3.1 Pro есть только Low и High, причём сама модель там сейчас доступна только на тарифе Enterprise. Уровень HIGH не включает никакой «Deep Think Mini»: такого режима у Google нет. Данные приведены по состоянию на 22 октября 2026 года.
Что такое уровни мышления Gemini 3.1 Pro и почему они важны
Уровень мышления ограничивает, насколько глубоко модель рассуждает про себя, прежде чем начать ответ. В руководстве Google по Gemini 3 уровни описаны как относительные лимиты на рассуждение, а не как гарантированное число токенов: модель на high думает динамически и на простом вопросе может потратить немного, а на low всё равно думает, только короче.
Выбор уровня меняет три вещи. Первая — счёт: токены мышления оплачиваются по цене выходных токенов, у 3.1 Pro это $12 за миллион при запросе до 200 тысяч токенов. Вторая — задержка: чем выше уровень, тем позже приходит первый токен ответа. Третья — качество на многошаговых задачах: математика, отладка, планирование выигрывают от high, извлечение данных и классификация обычно нет.
Отдельно стоит помнить про умолчание. Модель gemini-3.1-pro-preview без явного thinking_level работает на high, поэтому код, перенесённый со старых моделей без настройки мышления, платит за самый глубокий режим на каждом запросе. Бесплатного API-тарифа у 3.1 Pro нет (попробовать модель бесплатно можно только в AI Studio); подключение и тарифы разобраны в материале «Gemini 3.1 Pro API: настройка, тарифы, лимиты и миграция».
Подробный разбор LOW, MEDIUM и HIGH: что делает каждый уровень
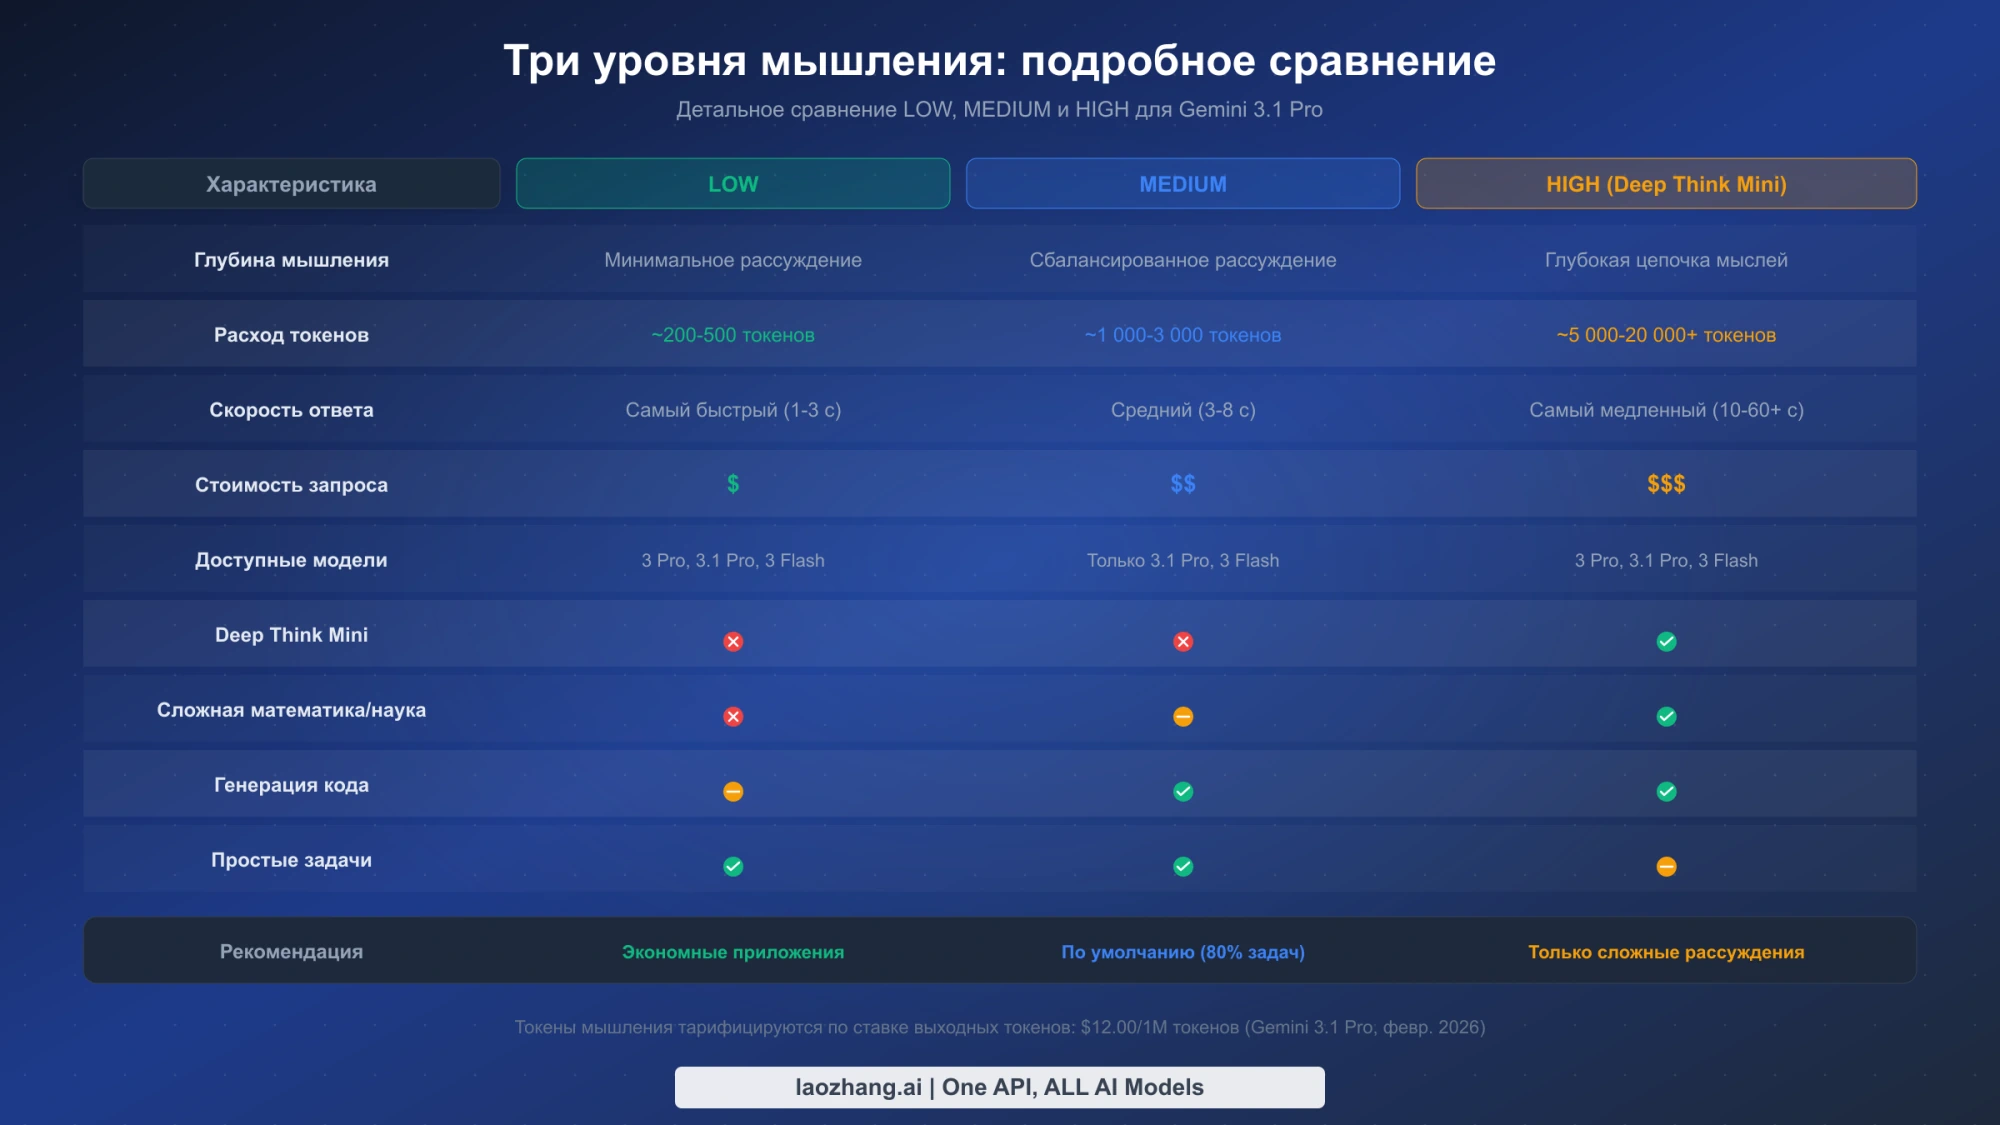
Схема составлена в феврале 2026 года: подпись «Deep Think Mini», диапазоны токенов и секунд и строка о доступных моделях устарели. Актуальные значения — в тексте и таблицах ниже.
Google описывает уровни так (страница Gemini thinking для generateContent):
| Значение | Что делает по описанию Google | Есть у Gemini 3.1 Pro |
|---|---|---|
minimal | Почти как «без мышления», но отключение не гарантирует | Нет, ошибка 400 |
low | Минимизирует задержку и стоимость | Да |
medium | Сбалансированное мышление для большинства задач | Да |
high | Максимальная глубина рассуждения, первый токен ответа может прийти заметно позже | Да, по умолчанию, динамический |
LOW подходит для коротких инструкций, чата, извлечения и классификации, где ответ не зависит от длинной цепочки выводов. Важная деталь: даже на low Gemini 3.1 Pro продолжает думать. Выключить мышление у 3.1 Pro нельзя вообще, и в тесте ниже low на задаче с подсчётом стоимости потратил 995 токенов мышления.
MEDIUM — промежуточный вариант для типичного кода, анализа и текстов средней сложности. У Gemini 3.1 Pro это не значение по умолчанию: умолчание остаётся high. Значением по умолчанию medium является у Gemini 4 Argon, Gemini 3.8 Flash и 3.6 Flash.
HIGH даёт модели наибольший запас на рассуждение. Именно на этом уровне Google публикует все результаты 3.1 Pro в бенчмарках (подробнее в разделе про Deep Think Mini ниже).
Кто из них сильнее? На сложных многошаговых задачах — High: у него самый большой бюджет на рассуждение, и официальные цифры качества у Google есть только для него; для Low и Medium Google отдельных бенчмарков не публикует. На простых задачах разница может почти не проявиться: в тесте 22 октября 2026 года все уровни решили одну и ту же задачу правильно, а high потратил лишь на 30 % больше токенов мышления, чем low (1 297 против 995). Поэтому High стоит включать там, где ошибка обходится дороже лишних секунд и центов, а Low — там, где важны скорость и объём.
Тест: сколько токенов мышления тратят low, medium и high
22 октября 2026 года одна задача отправлялась в Gemini 3.1 Pro, Gemini 4 Argon и Gemini 3.8 Flash на разных уровнях: «ручки продаются по 6 штук за $4,50 и по 10 штук за $7,00; как купить не меньше 58 ручек дешевле всего?» (правильный ответ — $41,50: четыре пачки по 10 и три по 6). Запросы шли к нативному эндпоинту Gemini (generateContent) через LaoZhang API (его ведёт та же команда, что и этот блог), по одному замеру на ячейку; стоимость пересчитана по прейскуранту Google на основе usageMetadata. Это не бенчмарк, а иллюстрация того, как ведут себя счётчики.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
| Модель и уровень | Токены мышления | Стоимость вызова по ценам Google |
|---|---|---|
Gemini 3.1 Pro, без thinking_level (= high) | 1 200 | $0,0151 |
Gemini 3.1 Pro, low | 995 | $0,0126 |
Gemini 3.1 Pro, medium | 1 120 | $0,0141 |
Gemini 3.1 Pro, high + сводка мыслей | 1 297 | $0,0163 |
Gemini 4 Argon, без thinking_level (= medium) | 316 | $0,0039 |
Gemini 4 Argon, medium | 384 | $0,0045 |
Gemini 4 Argon, high | 916 | $0,0098 |
Gemini 3.8 Flash, без thinking_level (= medium) | 1 058 | $0,0044 |
Gemini 3.8 Flash, low | 499 | $0,0023 |
Все ответы правильные. Argon на low измерить не удалось: шлюз возвращал 429 из-за перегрузки пула. Что видно по таблице:
- У 3.1 Pro разброс между уровнями на небольшой задаче невелик:
lowдумает почти столько же, сколькоhigh. Уровень ограничивает потолок, а не задаёт фиксированное число токенов. - У Argon
highтратит в 2,4 раза больше токенов мышления, чемmedium(916 против 384). Неделей раньше, 15 октября 2026 года, на 12 других задачах через тот же шлюз Argon наlowиmediumиногда не сообщал токенов мышления вообще, а наhighтратил от 646 до 1 461; у 3.1 Pro мышление было в каждом вызове, включаяlow(от 410 до 1 620). Сколько думает Argon на среднем уровне, сильно зависит от задачи. lowу 3.8 Flash вдвое сократил мышление по сравнению с умолчанием.
Проверка параметров через тот же шлюз дала следующее:
Запрос к gemini-3.1-pro-preview | Результат |
|---|---|
thinkingLevel: "minimal" | 400, как и сказано в документации |
thinkingLevel и thinkingBudget в одном запросе | 400, как и сказано в документации |
thinkingBudget: 0 | 200, но 124 токена мышления: мышление не выключилось |
thinkingBudget: 1024 (старый параметр) | 200, принят для обратной совместимости |
thinkingLevel: "LOW" (верхний регистр) | 200; в документации значения пишутся строчными |
Значения thinking_level по моделям: Argon, Flash, 3.1 Pro и 2.5
Ошибки с уровнями мышления чаще всего возникают, когда код написан под одну модель, а вызывается другая. Сводка по странице Google о thinking в Interactions API, странице для generateContent и списку устаревших моделей Gemini API:
| Модель (ID) | Допустимые уровни | По умолчанию в API | Ограничения |
|---|---|---|---|
Gemini 4 Argon (gemini-4-argon) | low, medium, high | medium | minimal — ошибка; мышление не отключается; thinkingBudget устарел |
Gemini 3.1 Pro (gemini-3.1-pro-preview) | low, medium, high | high, динамический | minimal — ошибка 400; мышление не отключается |
Gemini 3.8 Flash (gemini-3.8-flash) | low, medium, high | medium | minimal — «не поддерживается (ошибка)» |
Gemini 3.6 Flash (gemini-3.6-flash) | minimal, low, medium, high | medium | — |
Gemini 3.5 Flash-Lite (gemini-3.5-flash-lite) | minimal, low, medium, high | minimal | полностью мышление не отключается |
Gemini 3 Flash (gemini-3-flash-preview) | minimal, low, medium, high | high | полностью мышление не отключается |
Gemini 3 Pro (gemini-3-pro-preview) | — | — | отключена 9 марта 2026 года, замена — 3.1 Pro |
| Gemini 2.5 Pro и 2.5 Flash | в generateContent — thinkingBudget | динамический бюджет (-1) | 2.5 Pro: 128–32 768, отключить нельзя; 2.5 Flash: 0–24 576, 0 отключает |
Две оговорки к таблице. Во-первых, minimal даже там, где он разрешён, не гарантирует нулевое мышление: на сложной задаче модель может немного порассуждать. Во-вторых, документация расходится насчёт 2.5: страница generateContent прямо говорит, что 2.5 не поддерживает thinkingLevel и работает только с thinkingBudget, а таблица на странице Interactions API перечисляет для 2.5 уровни low, medium и high. Если вы сидите на 2.5 и generateContent, используйте бюджет. Новые пользователи 2.5 уже не получают: доступ к этим моделям сохраняется за теми, кто работал с ними раньше.
Параметр называется по-разному в зависимости от API:
| API | Где задаётся уровень | Где считать токены мышления | Как получить сводку рассуждений |
|---|---|---|---|
| Interactions API (Google его сейчас рекомендует) | generation_config.thinking_level | usage.total_thought_tokens | thinking_summaries: "auto" |
| generateContent (в документации помечен как Legacy) | generationConfig.thinkingConfig.thinkingLevel | usageMetadata.thoughtsTokenCount | includeThoughts: true |
| OpenAI-совместимый эндпоинт | reasoning_effort или extra_body.google.thinking_config | — | include_thoughts внутри thinking_config |
Для OpenAI-совместимого режима Google публикует таблицу соответствия: у Argon reasoning_effort minimal и low превращаются в low, medium — в medium, high — в high. Колонки для 3.1 Pro в этой таблице нет, поэтому для 3.1 Pro надёжнее не передавать minimal, а задавать low, medium или high. Использовать reasoning_effort и thinking_config одновременно нельзя (документация Google по OpenAI-совместимости).
Отдельный гид по Gemini 3.8 Flash — «Gemini 3.8 Flash: цена, ID модели и переход с 3.7 без риска».
Как включить уровень мышления: AI Studio, приложение и Antigravity
Переключатель уровня есть в четырёх местах, и в каждом своё значение по умолчанию.
Google AI Studio
Откройте модель, справа найдите панель Run settings и выпадающий список Thinking level. По состоянию на 22 октября 2026 года у Gemini 3.1 Pro Preview там по умолчанию стоит High, у Gemini 4 Argon — Medium (варианты Low, Medium, High). Для 3.1 Pro рядом остаётся ползунок Temperature со значением 1; для Argon ползунка нет. Argon в AI Studio работает только с подпиской Google AI или по запросам с API-ключом, без них интерфейс предлагает перейти на платный план.
Приложение Gemini
Нажмите на название текущей модели под полем ввода, выберите модель и, при желании, уровень Low, Medium или High. Если уровень не выбрать, приложение использует Low, то есть умолчание здесь противоположно API. Выбор сохраняется до конца разговора. Более высокий уровень расходует больше лимита подписки, а режим Auto сам подбирает и модель, и уровень; какая модель ответила, видно в меню More → Show thinking steps (справка Gemini о моделях и уровнях мышления).
Уровни Low, Medium и High появились в приложении 9 октября 2026 года и заменили прежний вариант Extended; с мая 2026 года меню называлось Thinking level и предлагало Standard и Extended (по данным 9to5Google). Набор моделей зависит от подписки: без плана — Auto или Flash-Lite, с Google AI Plus — Flash-Lite, Flash и Pro, с Pro и Ultra добавляется Argon. Google рассылает подписчикам Plus письма об изменениях, так что этот ряд может поменяться; какой план брать и как платить меньше, разобрано в материале «Как платить меньше за Google AI Pro: семейный доступ и продление».
Antigravity
В Antigravity уровень выбирается в том же меню, что и модель, под полем запроса, поэтому в интерфейсе и на форумах модели называют «Gemini 3.1 Pro (High)» и «Gemini 3.1 Pro (Low)», а в запросах встречается gemini-3.1-pro-low. Это не отдельные модели: в Gemini API у 3.1 Pro один ID, gemini-3.1-pro-preview (плюс вариант -customtools), а уровень передаётся параметром.
По документации Antigravity о моделях:
- Gemini 3.1 Pro: только Low и High, по умолчанию High. Сейчас модель доступна только на тарифе Enterprise; на Free, Plus, Pro и Ultra её в списке нет.
- Gemini 4 Argon: Low, Medium, High, по умолчанию High (в API у Argon по умолчанию medium). Доступен на платном Google AI Pro, в пробном Pro, полученном вместе с подходящим премиальным устройством, на Ultra и Enterprise; в Antigravity IDE его нет, только в приложении Antigravity, CLI и расширениях для IDE.
- Gemini 3.8, 3.7 и 3.6 Flash: Fast, Low, Medium, High, по умолчанию Medium.
API
В коде уровень включается одним полем — thinking_level в Interactions API или thinkingLevel внутри thinkingConfig в generateContent. Примеры для каждого варианта — в разделе с кодом ниже.
Как выбрать правильный уровень мышления для вашей задачи
У Google простое правило: для поиска фактов и классификации — minimal или low, для сравнения понятий и творческих задач — уровень по умолчанию, для сложного кода, математики и многошагового планирования — максимальный. Для Gemini 3.1 Pro его удобно разложить так:
| Задача | С чего начать на 3.1 Pro | Когда повышать |
|---|---|---|
| Перевод, классификация, извлечение полей, короткие ответы в чате | low | если модель пропускает условия из инструкции |
| Обычный код, рефакторинг, разбор логов, отчёты | medium | если ответы поверхностны или ломаются на краевых случаях |
| Математика, поиск сложных багов, архитектура, многошаговые агенты | high | — |
Начинайте с самого низкого уровня, который проходит ваши проверки, и поднимайте его, только если качество заметно не дотягивает. Сравнивайте на своих задачах: судя по тесту выше, на простых запросах low экономит меньше, чем можно ожидать, а на сложных разница в токенах растёт.
Ещё два решения влияют на итог сильнее, чем выбор между medium и high.
Модель. Gemini 4 Argon на том же тестовом запросе потратил меньше токенов мышления и стоил дешевле 3.1 Pro по нынешним ценам, но 1 декабря 2026 года его цена удваивается. Сравнение по цене и доступу — в материале «Gemini 4 Argon, Claude Opus 5.5 или GPT-6.1 Sol: что выбрать».
Temperature. Для всех моделей Gemini 3 Google настоятельно советует оставить temperature равной 1.0: значения ниже могут привести к зацикливанию и падению качества на математике и рассуждениях. Если в старом коде стоит temperature: 0.2 ради детерминированности, при переходе на 3.1 Pro этот параметр лучше убрать.
Полные примеры кода: Python, JavaScript и REST API
Во всех примерах ключ берётся из переменной окружения GEMINI_API_KEY: SDK читают её сами, а в REST ключ передаётся заголовком x-goog-api-key, а не в адресе запроса.
Python (Google Gen AI SDK)
from google import genai
from google.genai import types

client = genai.Client()  # ключ из переменной окружения GEMINI_API_KEY

response = client.models.generate_content(
    model="gemini-3.1-pro-preview",
    contents="Найди ошибку в этой функции и объясни, почему она возникает: ...",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(
            thinking_level="low",    # low | medium | high; minimal у 3.1 Pro даёт 400
            include_thoughts=True,   # вернуть краткую сводку рассуждений
        )
    ),
)

for part in response.candidates[0].content.parts:
    if not part.text:
        continue
    print("Сводка рассуждений:" if part.thought else "Ответ:", part.text)

print("Токены мышления:", response.usage_metadata.thoughts_token_count)
JavaScript (Google Gen AI SDK)
import { GoogleGenAI, ThinkingLevel } from "@google/genai";

const ai = new GoogleGenAI({}); // ключ из переменной окружения GEMINI_API_KEY

const response = await ai.models.generateContent({
  model: "gemini-3.1-pro-preview",
  contents: "Спроектируй схему кеширования для API с пиками в 10 000 запросов в минуту.",
  config: {
    thinkingConfig: {
      thinkingLevel: ThinkingLevel.HIGH, // то же, что строка "high"
    },
  },
});

console.log(response.text);
console.log("Токены мышления:", response.usageMetadata?.thoughtsTokenCount);
REST API (cURL)
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.1-pro-preview:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "Извлеки все адреса электронной почты из текста: ..."}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "medium"}
    }
  }'
Interactions API
Google сейчас рекомендует Interactions API. Здесь уровень лежит прямо в generation_config, а сводки рассуждений включаются отдельным полем:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Сравни два плана миграции базы данных и выбери более безопасный.",
    generation_config={
        "thinking_level": "high",
        "thinking_summaries": "auto",
    },
)

print(interaction.output_text)
print("Токены мышления:", interaction.usage.total_thought_tokens)
OpenAI-совместимый эндпоинт
Если приложение написано под SDK OpenAI, уровень задаётся через reasoning_effort:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GEMINI_API_KEY"],
    base_url="https://generativelanguage.googleapis.com/v1beta/openai/",
)

response = client.chat.completions.create(
    model="gemini-4-argon",
    reasoning_effort="medium",  # minimal и low у Argon превращаются в low
    messages=[{"role": "user", "content": "Объясни, как работает индекс B-tree."}],
)

print(response.choices[0].message.content)
Deep Think Mini: что происходит при установке HIGH
При thinking_level: "high" никакой Deep Think Mini не включается: такого режима, модели или значения параметра у Google нет. Название пошло из февральского заголовка VentureBeat, где Gemini 3.1 Pro на высоком уровне назвали «Deep Think Mini» с настраиваемым рассуждением. Это оценка обозревателя, а не термин Google: ни в документации Gemini API, ни на странице модели у DeepMind его нет.
На деле high у 3.1 Pro — это уровень по умолчанию с максимальной глубиной рассуждения, который Google называет динамическим: модель сама решает, сколько думать в пределах этого уровня. Отдельного «качественно иного» алгоритма за ним не описано.
Deep Think — другая вещь. Это экспериментальный режим приложения Gemini, а не API: Gemini 3.1 Deep Think построен поверх Gemini 3.1 Pro, доступен подписчикам Google AI Ultra старше 18 лет (путь: название модели → Pro → Thinking Level → Deep Think) и отвечает за несколько минут. Сейчас Google заменяет Deep Think на Gemini 4 Argon (справка Google о Deep Think в приложении Gemini). Параметра для Deep Think в документации Gemini API нет.
Разницу хорошо видно по цифрам Google (страница Gemini 3.1 Pro у Google DeepMind, страница Gemini 3.1 Deep Think):
| Бенчмарк | Gemini 3.1 Pro Thinking (High) | Gemini 3.1 Deep Think |
|---|---|---|
| ARC-AGI-2 (ARC Prize Verified) | 77,1 % | 84,6 % |
| Humanity's Last Exam, без инструментов | 44,4 % | 48,4 % |
| Humanity's Last Exam, с поиском и кодом | 51,4 % | — |
| GPQA Diamond | 94,3 % | — |
| SWE-Bench Verified, одна попытка | 80,6 % | — |
77,1 % на ARC-AGI-2 — результат обычного 3.1 Pro на high, именно его в феврале и приписывали «Deep Think Mini». Deep Think в той же таблице идёт отдельной строкой и набирает больше.
Стоимость токенов мышления и оптимизация расходов
Правила оплаты мышления в Gemini API одинаковы для всех моделей (таблица цен Gemini API и страница о thinking):
- Цена выходных токенов уже включает токены мышления; счёт за ответ — это ответ плюс мышление.
- Оплачивается всё мышление, даже если вы получаете только сводку рассуждений.
- Лимит
max_output_tokensвключает мышление. Если модель упрётся в него посреди рассуждения, ответ придёт обрезанным или пустым, но мышление всё равно будет оплачено. Google советует снижать уровень мышления, а не ставить маленькийmax_output_tokens.
Цены по состоянию на 22 октября 2026 года, за миллион токенов:
| Модель | Вход | Выход вместе с мышлением | Примечание |
|---|---|---|---|
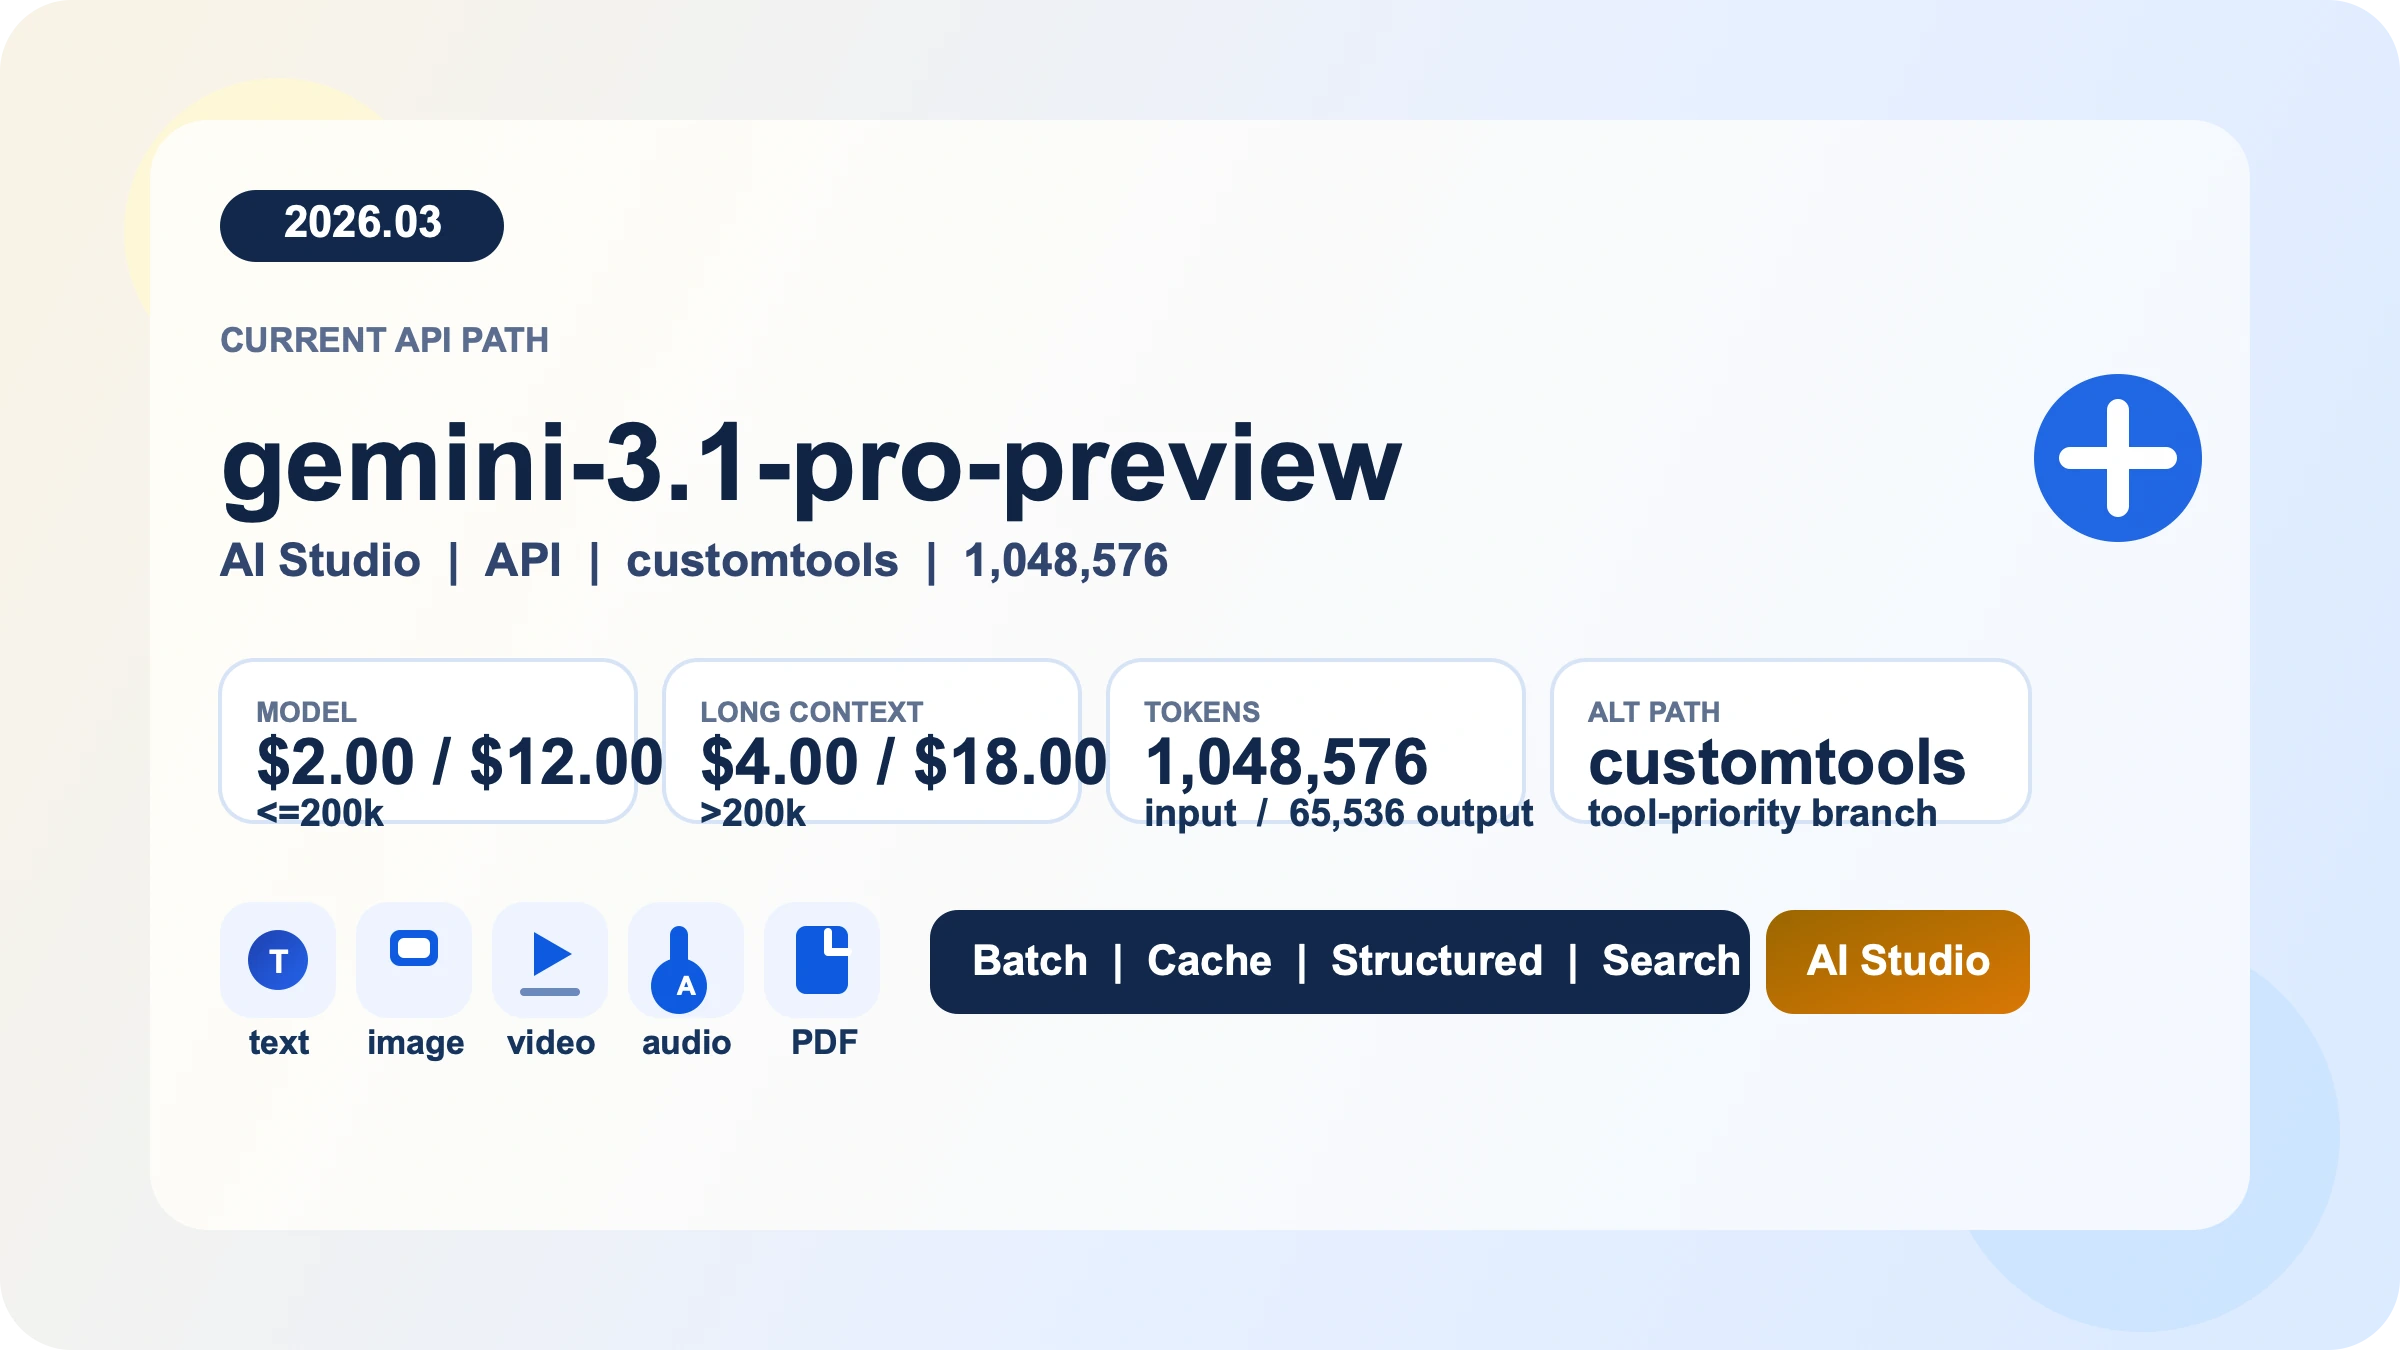
| Gemini 3.1 Pro, запрос до 200 тысяч токенов | $2,00 | $12,00 | кеш $0,20; Batch вдвое дешевле |
| Gemini 3.1 Pro, запрос больше 200 тысяч | $4,00 | $18,00 | кеш $0,40 |
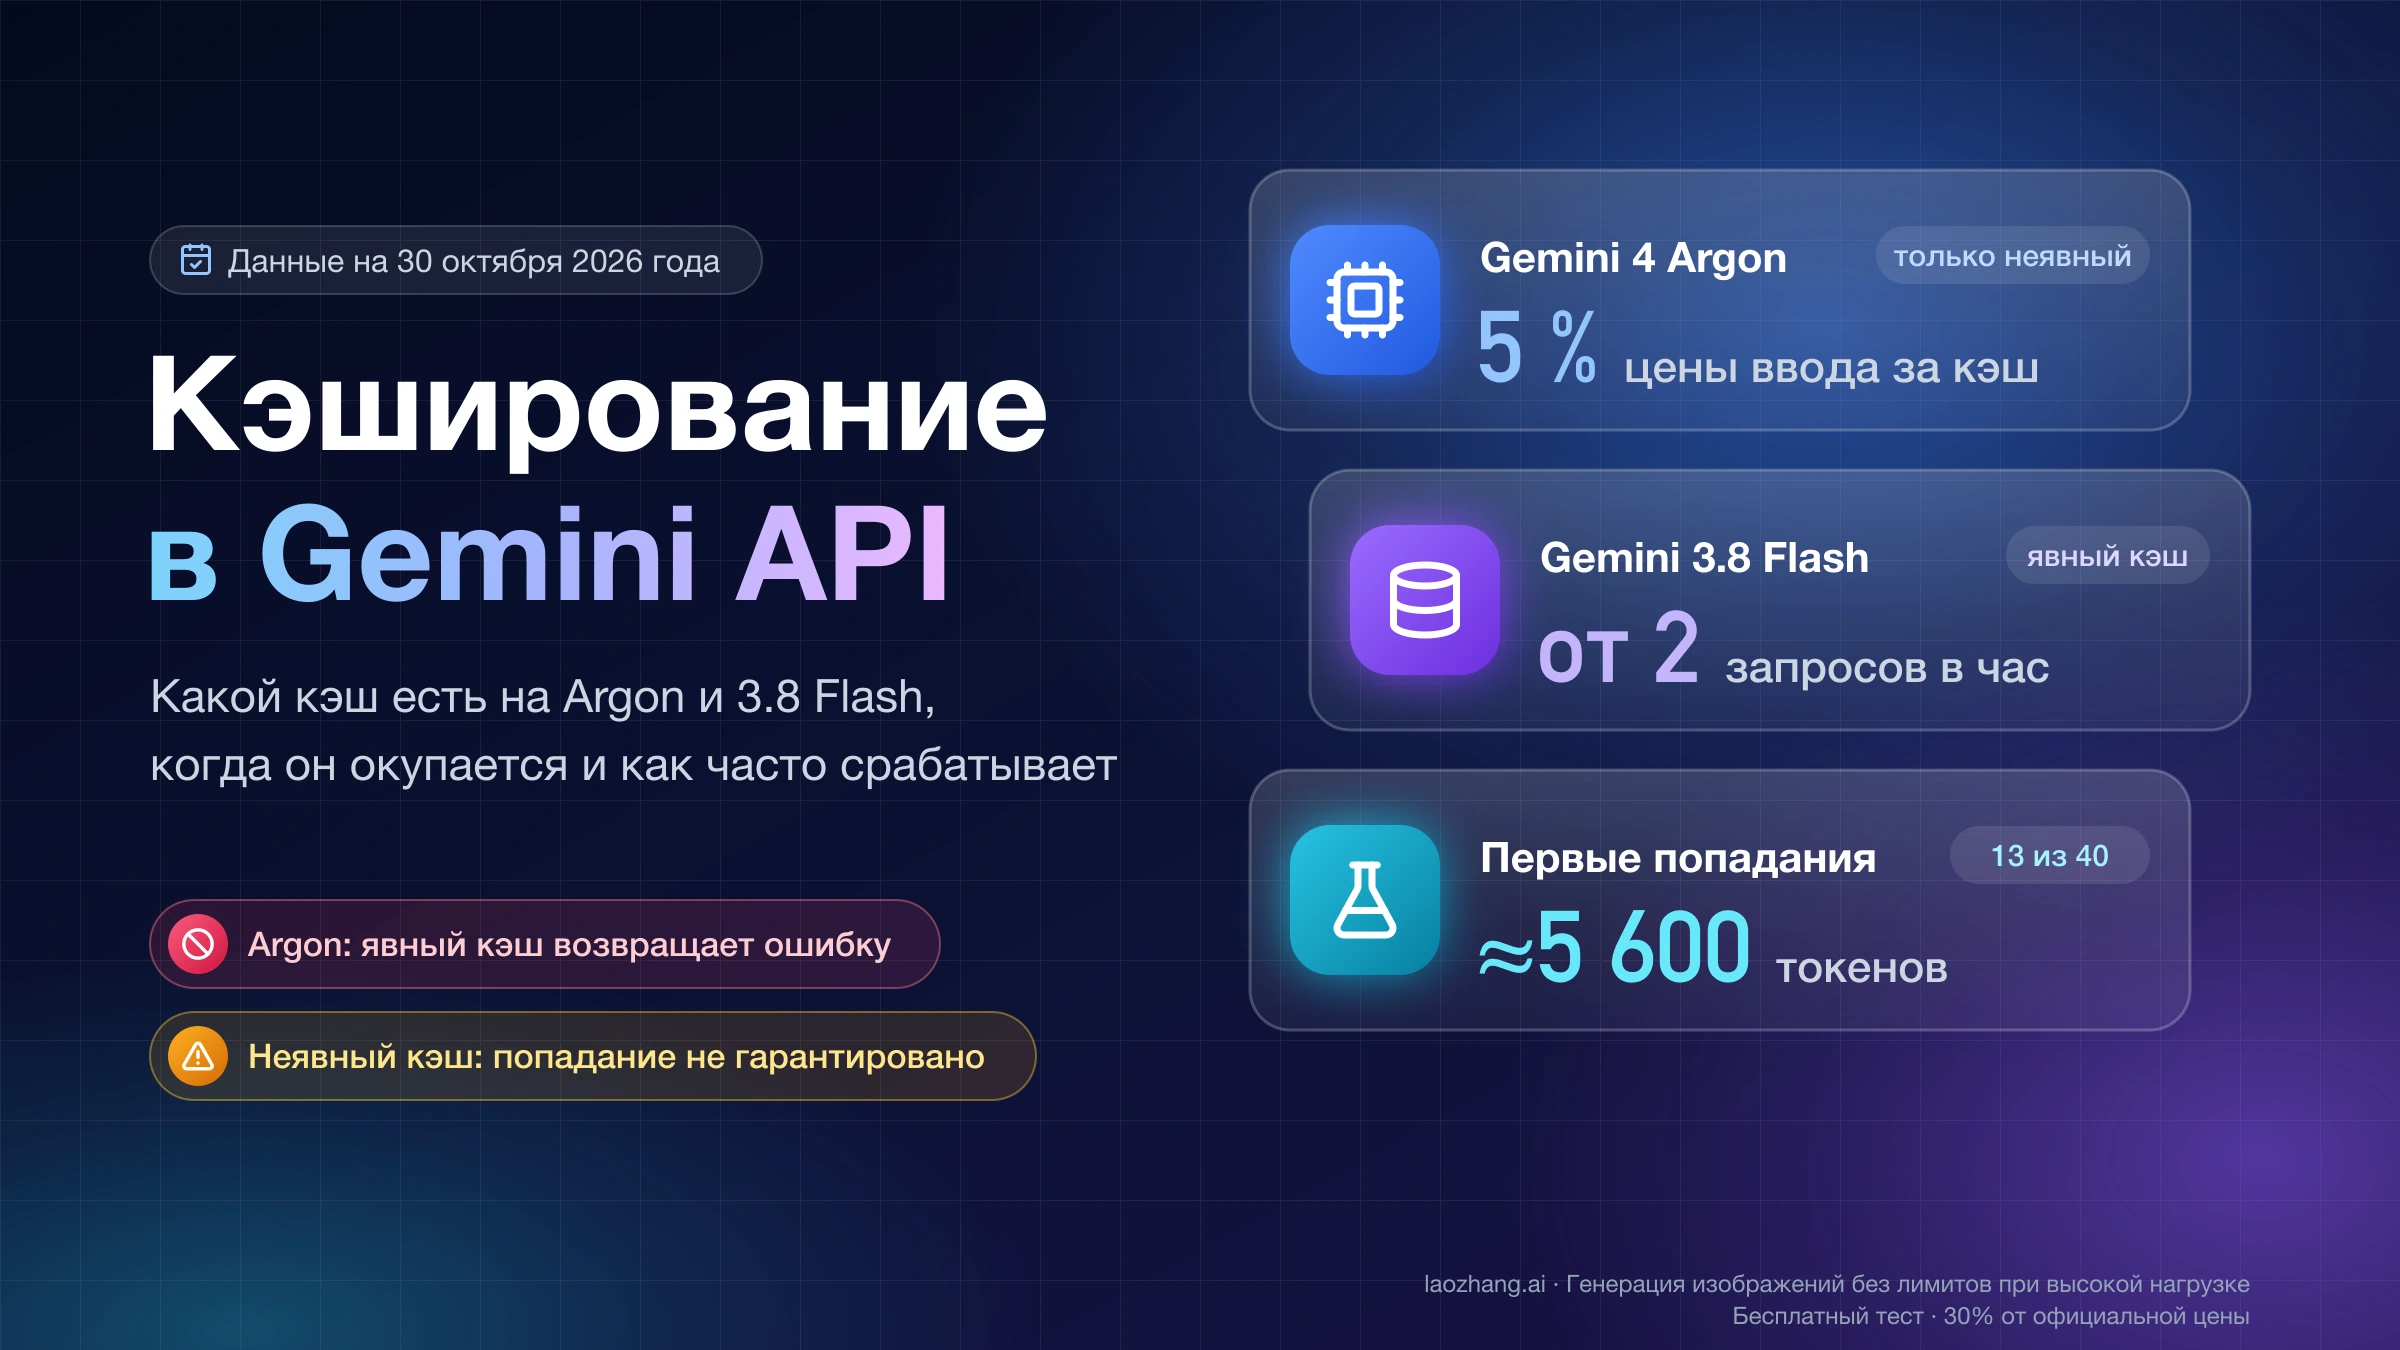
| Gemini 4 Argon до 30 ноября 2026 года | $2,00 | $10,00 | только неявное кеширование |
| Gemini 4 Argon с 1 декабря 2026 года | $4,00 | $20,00 | бесплатного уровня нет |
| Gemini 3.8 Flash и 3.6 Flash до конца 2026 года | $0,75 | $3,75 | с 1 января 2027 года $1,50 и $7,50 |
Стоимость вызова считается так: входные токены × цена входа + (токены мышления + токены ответа) × цена выхода. Для 3.1 Pro на high из теста выше: 61 × $2 / 1 000 000 + (1 297 + 48) × $12 / 1 000 000 ≈ $0,0163. На low получается $0,0126, то есть разница около $3,7 на тысячу таких вызовов. Тысяча токенов мышления у 3.1 Pro стоит $0,012, у Argon сейчас $0,010, а с 1 декабря 2026 года $0,020: тот же вызов Argon на high подорожает с $0,0098 до $0,0197, на medium — с $0,0045 до $0,0090.
Что реально снижает счёт:
- Явный уровень в каждом запросе. У 3.1 Pro умолчание —
high, поэтому безthinking_levelвы платите за максимальную глубину даже на простых задачах. - Маршрутизация по типу задачи. Простые запросы на
low, сложные наhigh; правило выбора — в разделе выше. - Batch API для задач, которым не нужен ответ сразу: вход и выход у 3.1 Pro вдвое дешевле.
- Кеширование контекста для повторяющихся системных промптов: у 3.1 Pro $0,20 за миллион кешированных токенов плюс $4,50 за миллион токенов в час хранения.
- Счётчик токенов мышления в мониторинге (
thoughtsTokenCountилиtotal_thought_tokens): по нему видно, какие запросы думают дольше, чем нужно.
Полная таблица цен по всем моделям и способы оплаты — в материале «Как купить доступ к Gemini API в России: ключ $0, цены 2026–2027», а что доступно бесплатно — в «Gemini API Free Tier 2026: ключ бесплатно, какие модели и лимиты».
Миграция с thinking_budget на thinking_level
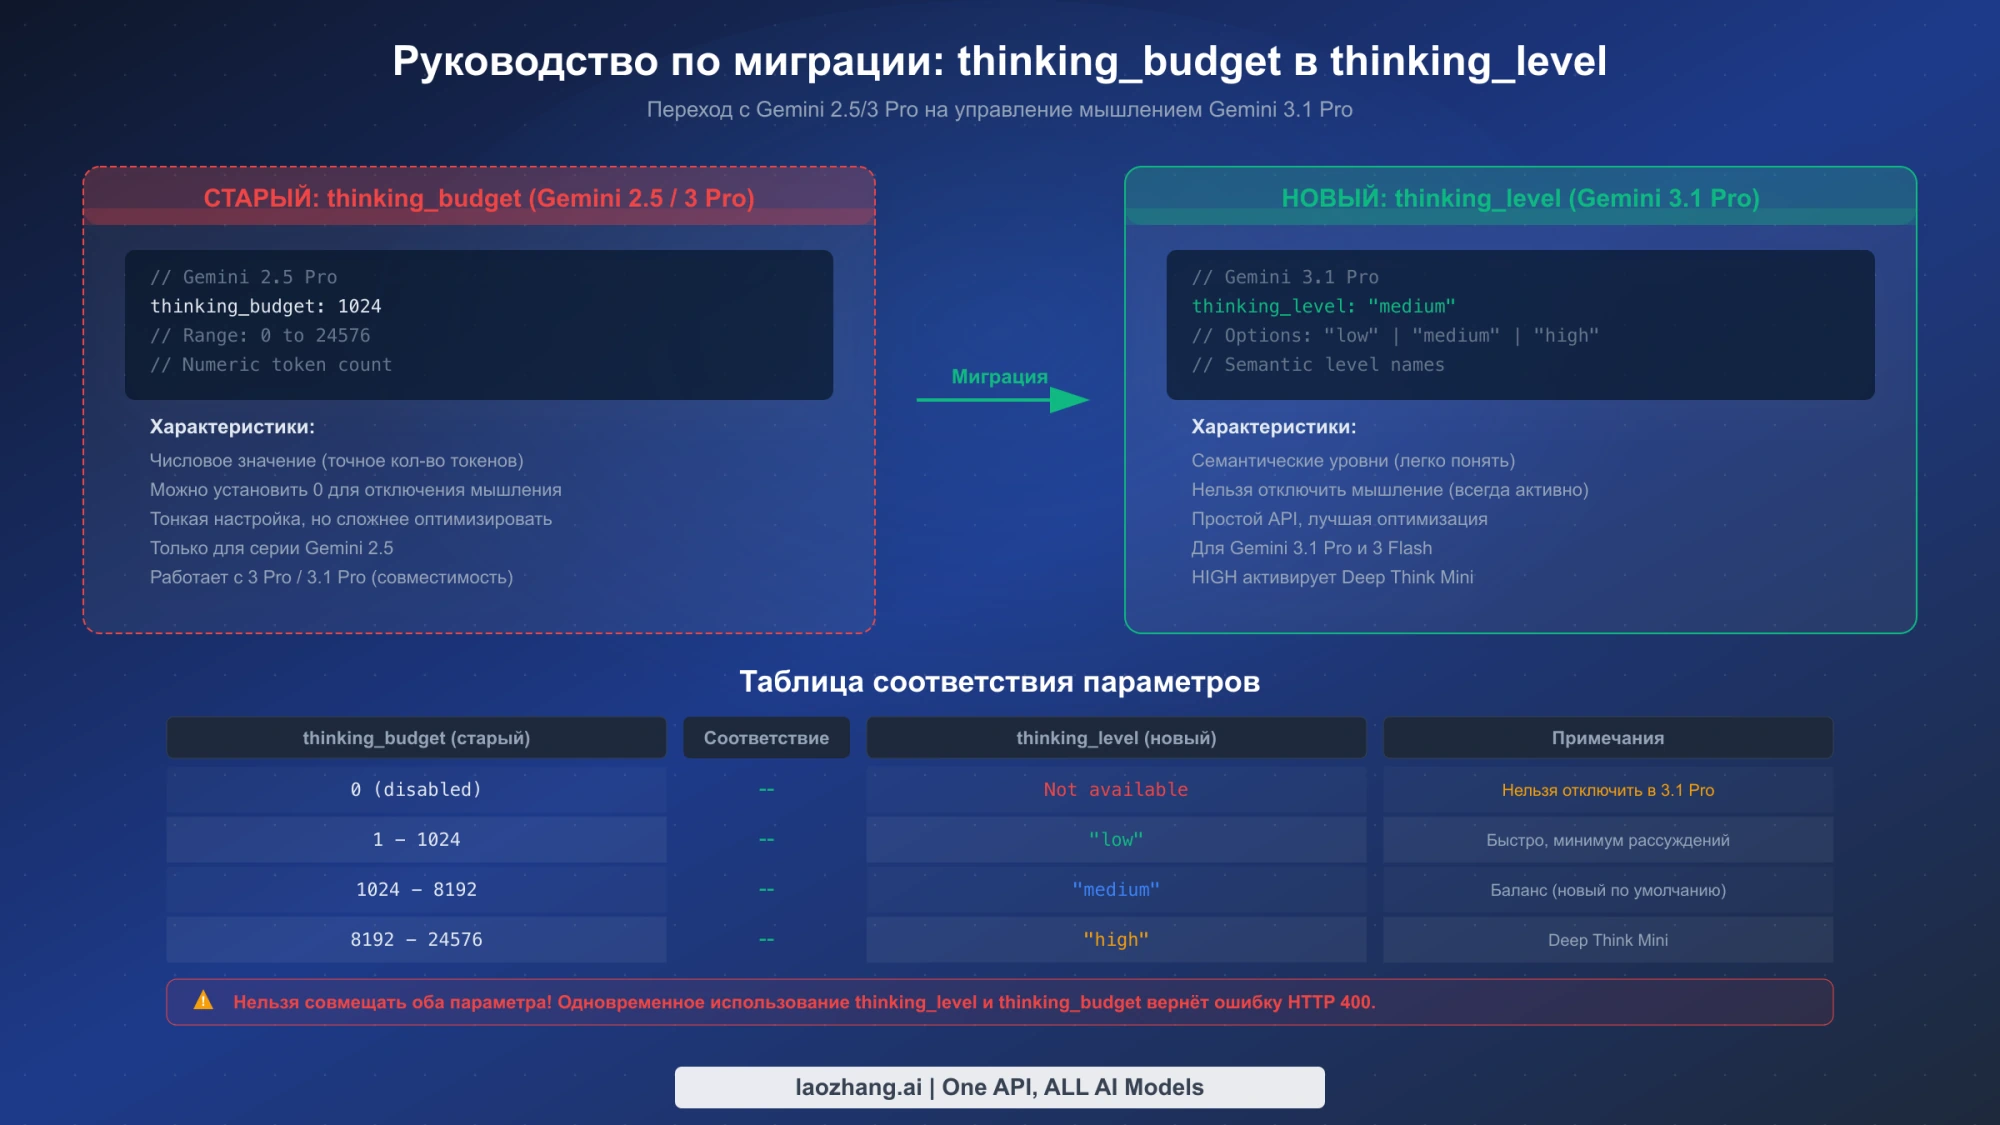
Схема составлена в феврале 2026 года: диапазоны в таблице соответствия, пометка «новый по умолчанию» у medium и строка про Deep Think Mini устарели. Актуальные правила — в тексте ниже.
thinking_budget задавал число токенов на мышление в серии 2.5, thinking_level задаёт уровень в Gemini 3 и Gemini 4. Что важно знать при переходе:
- Оба параметра в одном запросе — ошибка 400. Это касается и 3.1 Pro, и Argon.
- На 3.1 Pro старый бюджет пока работает для обратной совместимости, но Google рекомендует перейти на уровни. В тесте
thinkingBudget: 1024у 3.1 Pro прошёл без ошибки. thinkingBudget: 0не выключает мышление у 3.1 Pro: запрос принят, но модель всё равно потратила 124 токена мышления. Прямого аналога «мышление выключено» у 3.1 Pro нет, ближайший вариант —low.- У Gemini 4 Argon
thinkingBudgetустарел. Переданный в одиночку, он приводится к ближайшему уровню с предупреждением в ответе; вместе сthinkingLevel— 400. - Старые диапазоны 2.5 — 128–32 768 у 2.5 Pro (отключить нельзя) и 0–24 576 у 2.5 Flash.
Официальной таблицы «бюджет → уровень» для 3.1 Pro у Google нет. Единственное опубликованное соответствие — в OpenAI-совместимом режиме: там для 2.5 low равен бюджету 1 024, medium — 8 192, high — 24 576. Это разумная отправная точка для переноса настроек, но не гарантия одинакового поведения: после переключения сравните thoughtsTokenCount и качество на своих запросах.
from google.genai import types

# Было: Gemini 2.5 Pro, числовой бюджет
old_config = types.GenerateContentConfig(
    temperature=0.2,
    thinking_config=types.ThinkingConfig(thinking_budget=8192),
)

# Стало: Gemini 3.1 Pro, уровень вместо бюджета, temperature по умолчанию (1.0)
new_config = types.GenerateContentConfig(
    thinking_config=types.ThinkingConfig(thinking_level="medium"),
)
Если в коде бюджет подбирался под тип задачи, сохраните ту же логику, но возвращайте уровень. Заодно уберите явную temperature: Google просит оставлять для Gemini 3 значение 1.0.
Типичные ошибки и устранение проблем
Ошибка 400 при minimal. У Gemini 3.1 Pro, Gemini 4 Argon и Gemini 3.8 Flash уровня minimal нет. Он поддерживается только у 3.6 Flash, Flash-Lite и 3 Flash. Если одна функция обслуживает разные модели, проверяйте уровень перед отправкой:
ALLOWED_LEVELS = {
    "gemini-4-argon": {"low", "medium", "high"},
    "gemini-3.1-pro-preview": {"low", "medium", "high"},
    "gemini-3.8-flash": {"low", "medium", "high"},
    "gemini-3.6-flash": {"minimal", "low", "medium", "high"},
}

def thinking_config_for(model: str, level: str) -> dict:
    """Возвращает thinking_config только с уровнем, без thinking_budget."""
    if level not in ALLOWED_LEVELS.get(model, set()):
        raise ValueError(f"{model}: уровень {level!r} не поддерживается")
    return {"thinking_level": level}
Ошибка 400 из-за конфликта параметров. thinking_level и thinking_budget оказались в одном запросе, обычно после миграции, когда часть конфигурации собирается в другом месте. В OpenAI-совместимом режиме то же правило действует для reasoning_effort и thinking_config.
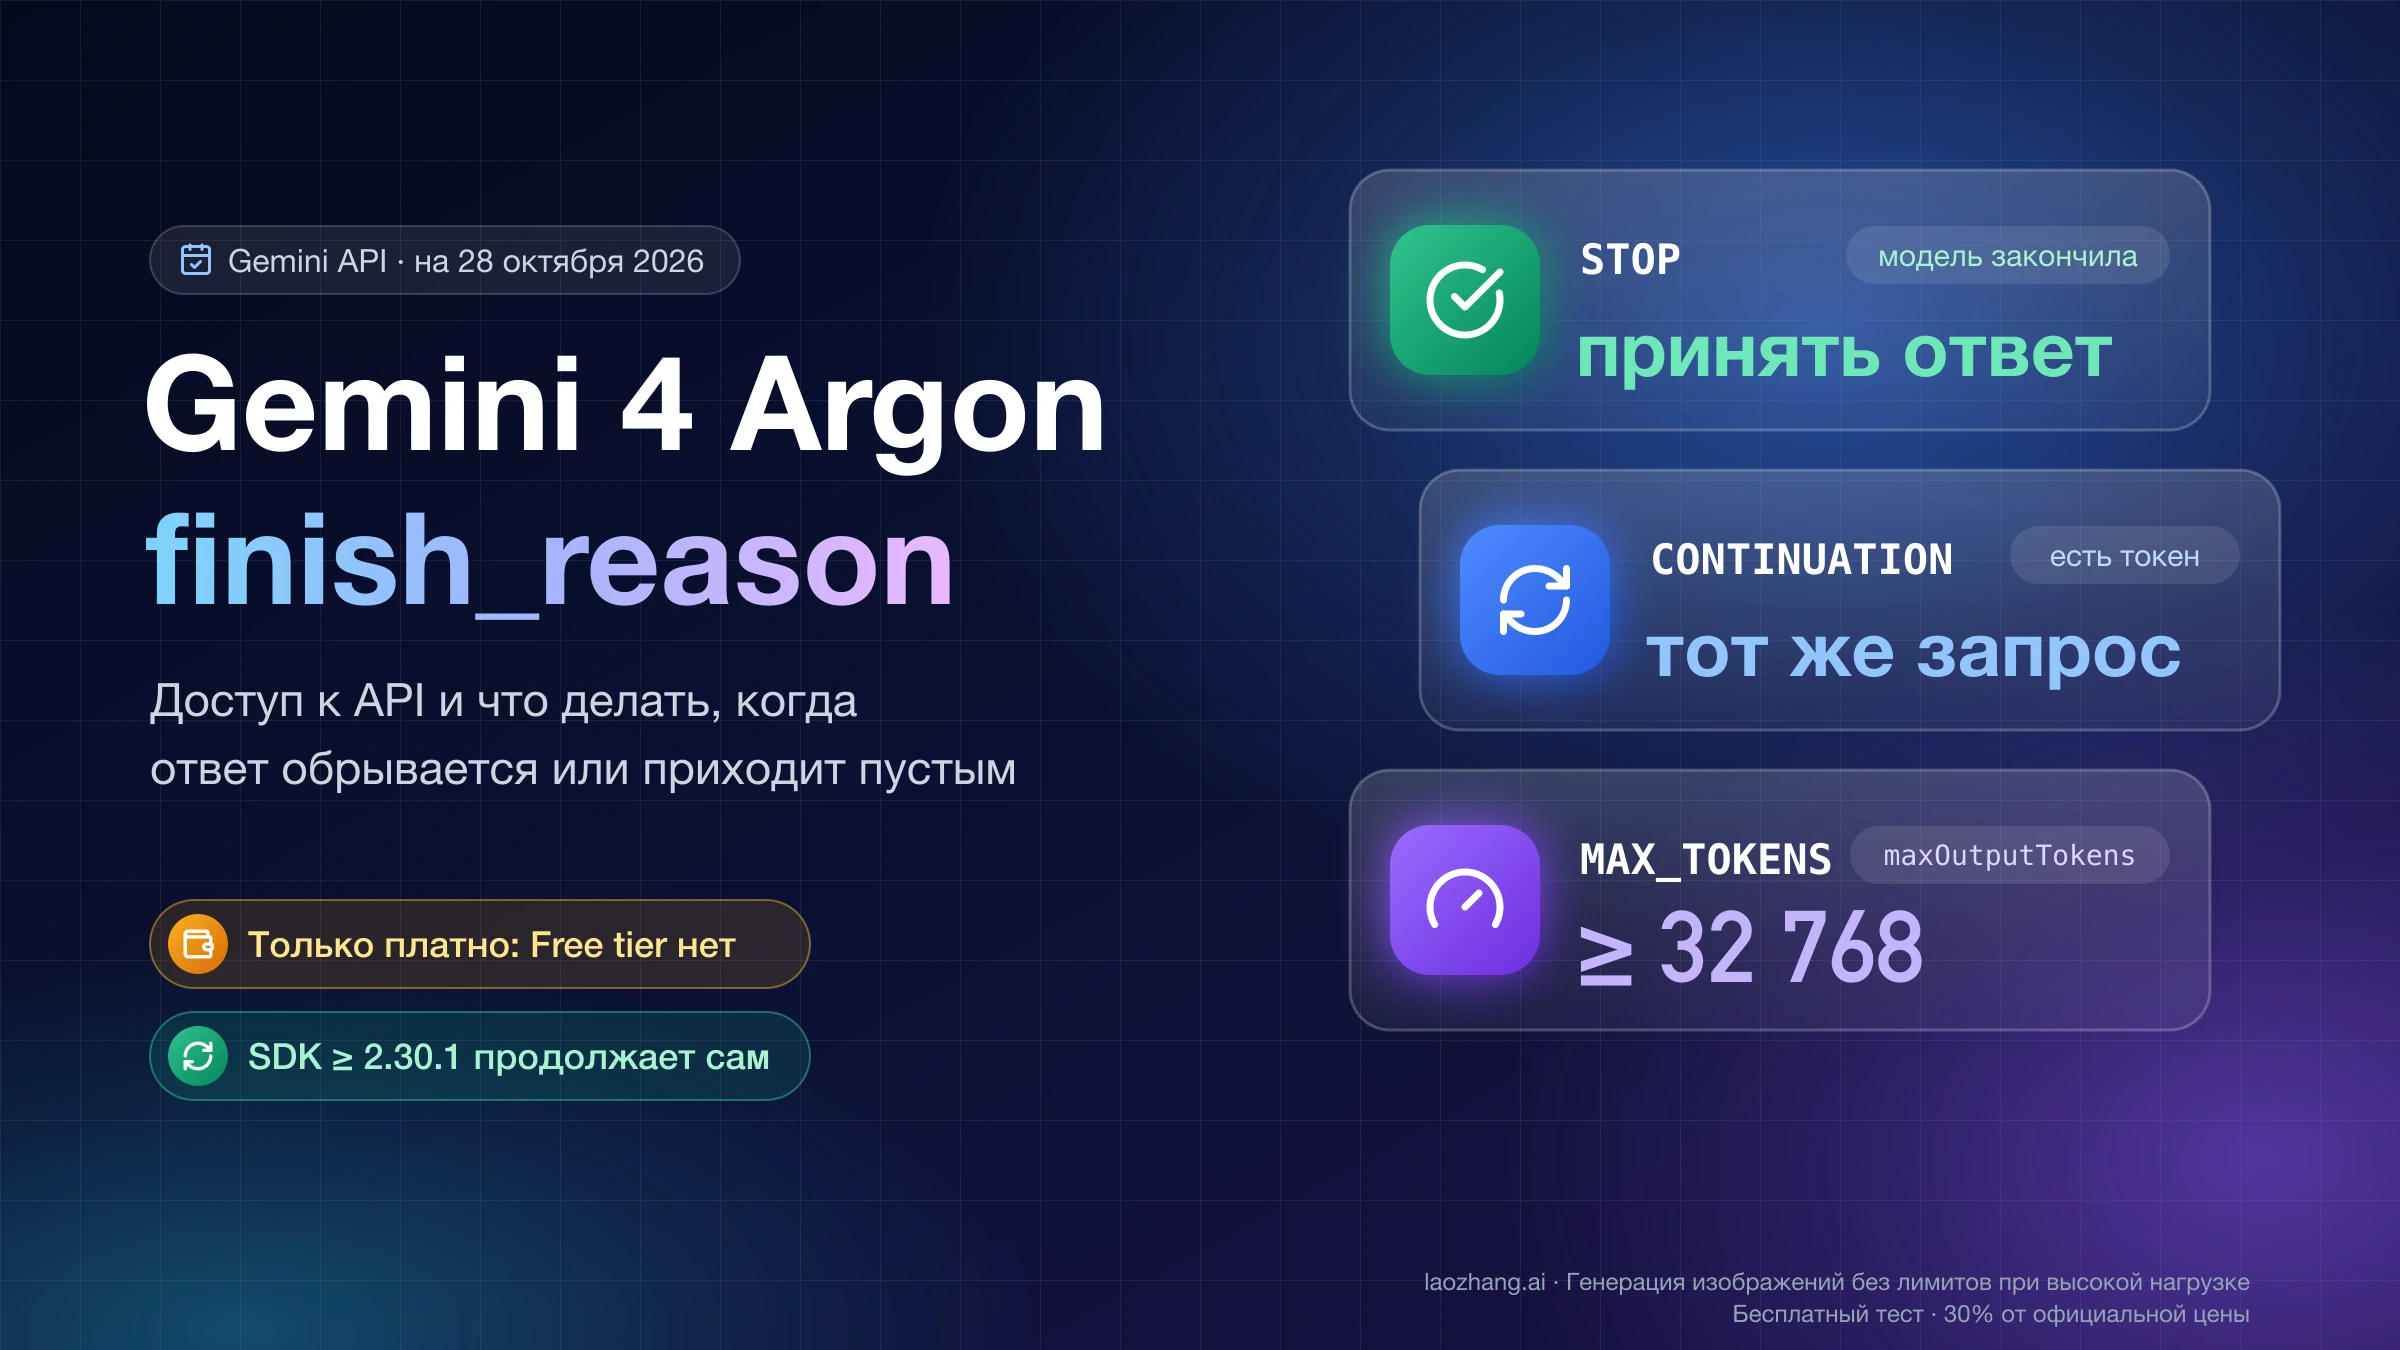
Пустой или обрезанный ответ. Модель исчерпала max_output_tokens на мышлении: в generateContent это finish_reason: MAX_TOKENS, в Interactions API статус incomplete. Мышление при этом оплачено. Снизьте уровень или увеличьте лимит. У 3.1 Pro потолок вывода — 64 тысячи токенов; у Argon в generateContent один запрос без потоковой передачи возвращает до 32 768 токенов, с потоковой — до 65 536, а в Interactions API синхронный запрос с max_output_tokens больше 65 536 даёт 400.
Счёт выше ожидаемого. Запросы к 3.1 Pro уходят без thinking_level и работают на high. Добавьте уровень явно и посмотрите на счётчик токенов мышления.
Зацикливание и странные ответы. В конфигурации осталась низкая temperature от старой модели. Для Gemini 3 верните 1.0.
Модель gemini-3-pro-preview не отвечает. Её отключили 9 марта 2026 года; замена — gemini-3.1-pro-preview. У 3.1 Pro дата отключения пока не объявлена.
В Antigravity нет Gemini 3.1 Pro. Модель там доступна только на тарифе Enterprise. На Pro и Ultra вместо неё есть Gemini 4 Argon.
Ошибки 429. Это лимиты частоты, а не уровни мышления: смена уровня их не снимает. Где смотреть лимиты и как их поднять, описано в материале «Лимиты Gemini API: где смотреть, уровни Tier 1–3 и ошибки 429».
Вопросы об уровнях мышления Gemini 3.1 Pro
Чем отличается Gemini 3.1 Pro High от Low?
High даёт модели самый большой запас на рассуждение и сильнее на многошаговых задачах; все опубликованные Google бенчмарки 3.1 Pro сняты именно на нём. Low быстрее и дешевле, но мышление не выключает: в тесте 22 октября 2026 года low потратил 995 токенов мышления против 1 297 на high, и оба уровня ответили правильно.
Как включить уровень мышления в Gemini?
В API — параметром thinking_level (thinkingLevel). В AI Studio — списком Thinking level в панели Run settings. В приложении Gemini — нажать на название модели под полем ввода и выбрать Low, Medium или High. В Antigravity — в меню выбора модели под полем запроса.
Какой уровень мышления у Gemini 3.1 Pro по умолчанию?
В API и AI Studio — high. В Antigravity — High. В приложении Gemini, если уровень не выбран, — Low. У Gemini 4 Argon в API и AI Studio по умолчанию medium, а в Antigravity — High.
Gemini 3.1 Pro (High) и gemini-3.1-pro-low — это разные модели?
Нет. Это одна модель с разными уровнями мышления: так её показывает меню выбора в Antigravity. В Gemini API модель называется gemini-3.1-pro-preview, а уровень передаётся отдельным параметром.
Есть ли у Gemini уровень max?
Нет. В документации Gemini API значения только minimal, low, medium и high, причём набор зависит от модели. Максимальный уровень у Gemini 3.1 Pro — high.
Нужно ли менять temperature вместе с thinking_level?
Нет, для Gemini 3 её лучше вообще не трогать. Google рекомендует значение по умолчанию 1.0: при более низком возможны зацикливание и падение качества на рассуждениях.
Источники11
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 22 окт. 2026 г..
Источники11
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 22 окт. 2026 г..
- 1.руководстве Google по Gemini 3ai.google.dev/gemini-api/docs/gemini-3
- 2.Gemini thinking для generateContentai.google.dev/gemini-api/docs/generate-content/thinking
- 3.странице Google о thinking в Interactions APIai.google.dev/gemini-api/docs/thinking
- 4.списку устаревших моделей Gemini APIai.google.dev/gemini-api/docs/deprecations
- 5.документация Google по OpenAI-совместимостиai.google.dev/gemini-api/docs/openai
- 6.справка Gemini о моделях и уровнях мышленияsupport.google.com/gemini/answer/18648722
- 7.документации Antigravity о моделяхantigravity.google/docs/models
- 8.справка Google о Deep Think в приложении Geminisupport.google.com/gemini/answer/16345172
- 9.страница Gemini 3.1 Pro у Google DeepMinddeepmind.google/models/gemini/pro
- 10.страница Gemini 3.1 Deep Thinkdeepmind.google/models/gemini/deep-think
- 11.таблица цен Gemini APIai.google.dev/gemini-api/docs/pricing