Seedream 5.0 Pro 레이어 분리 API 사용법: 14장 응답을 PSD로 만들기
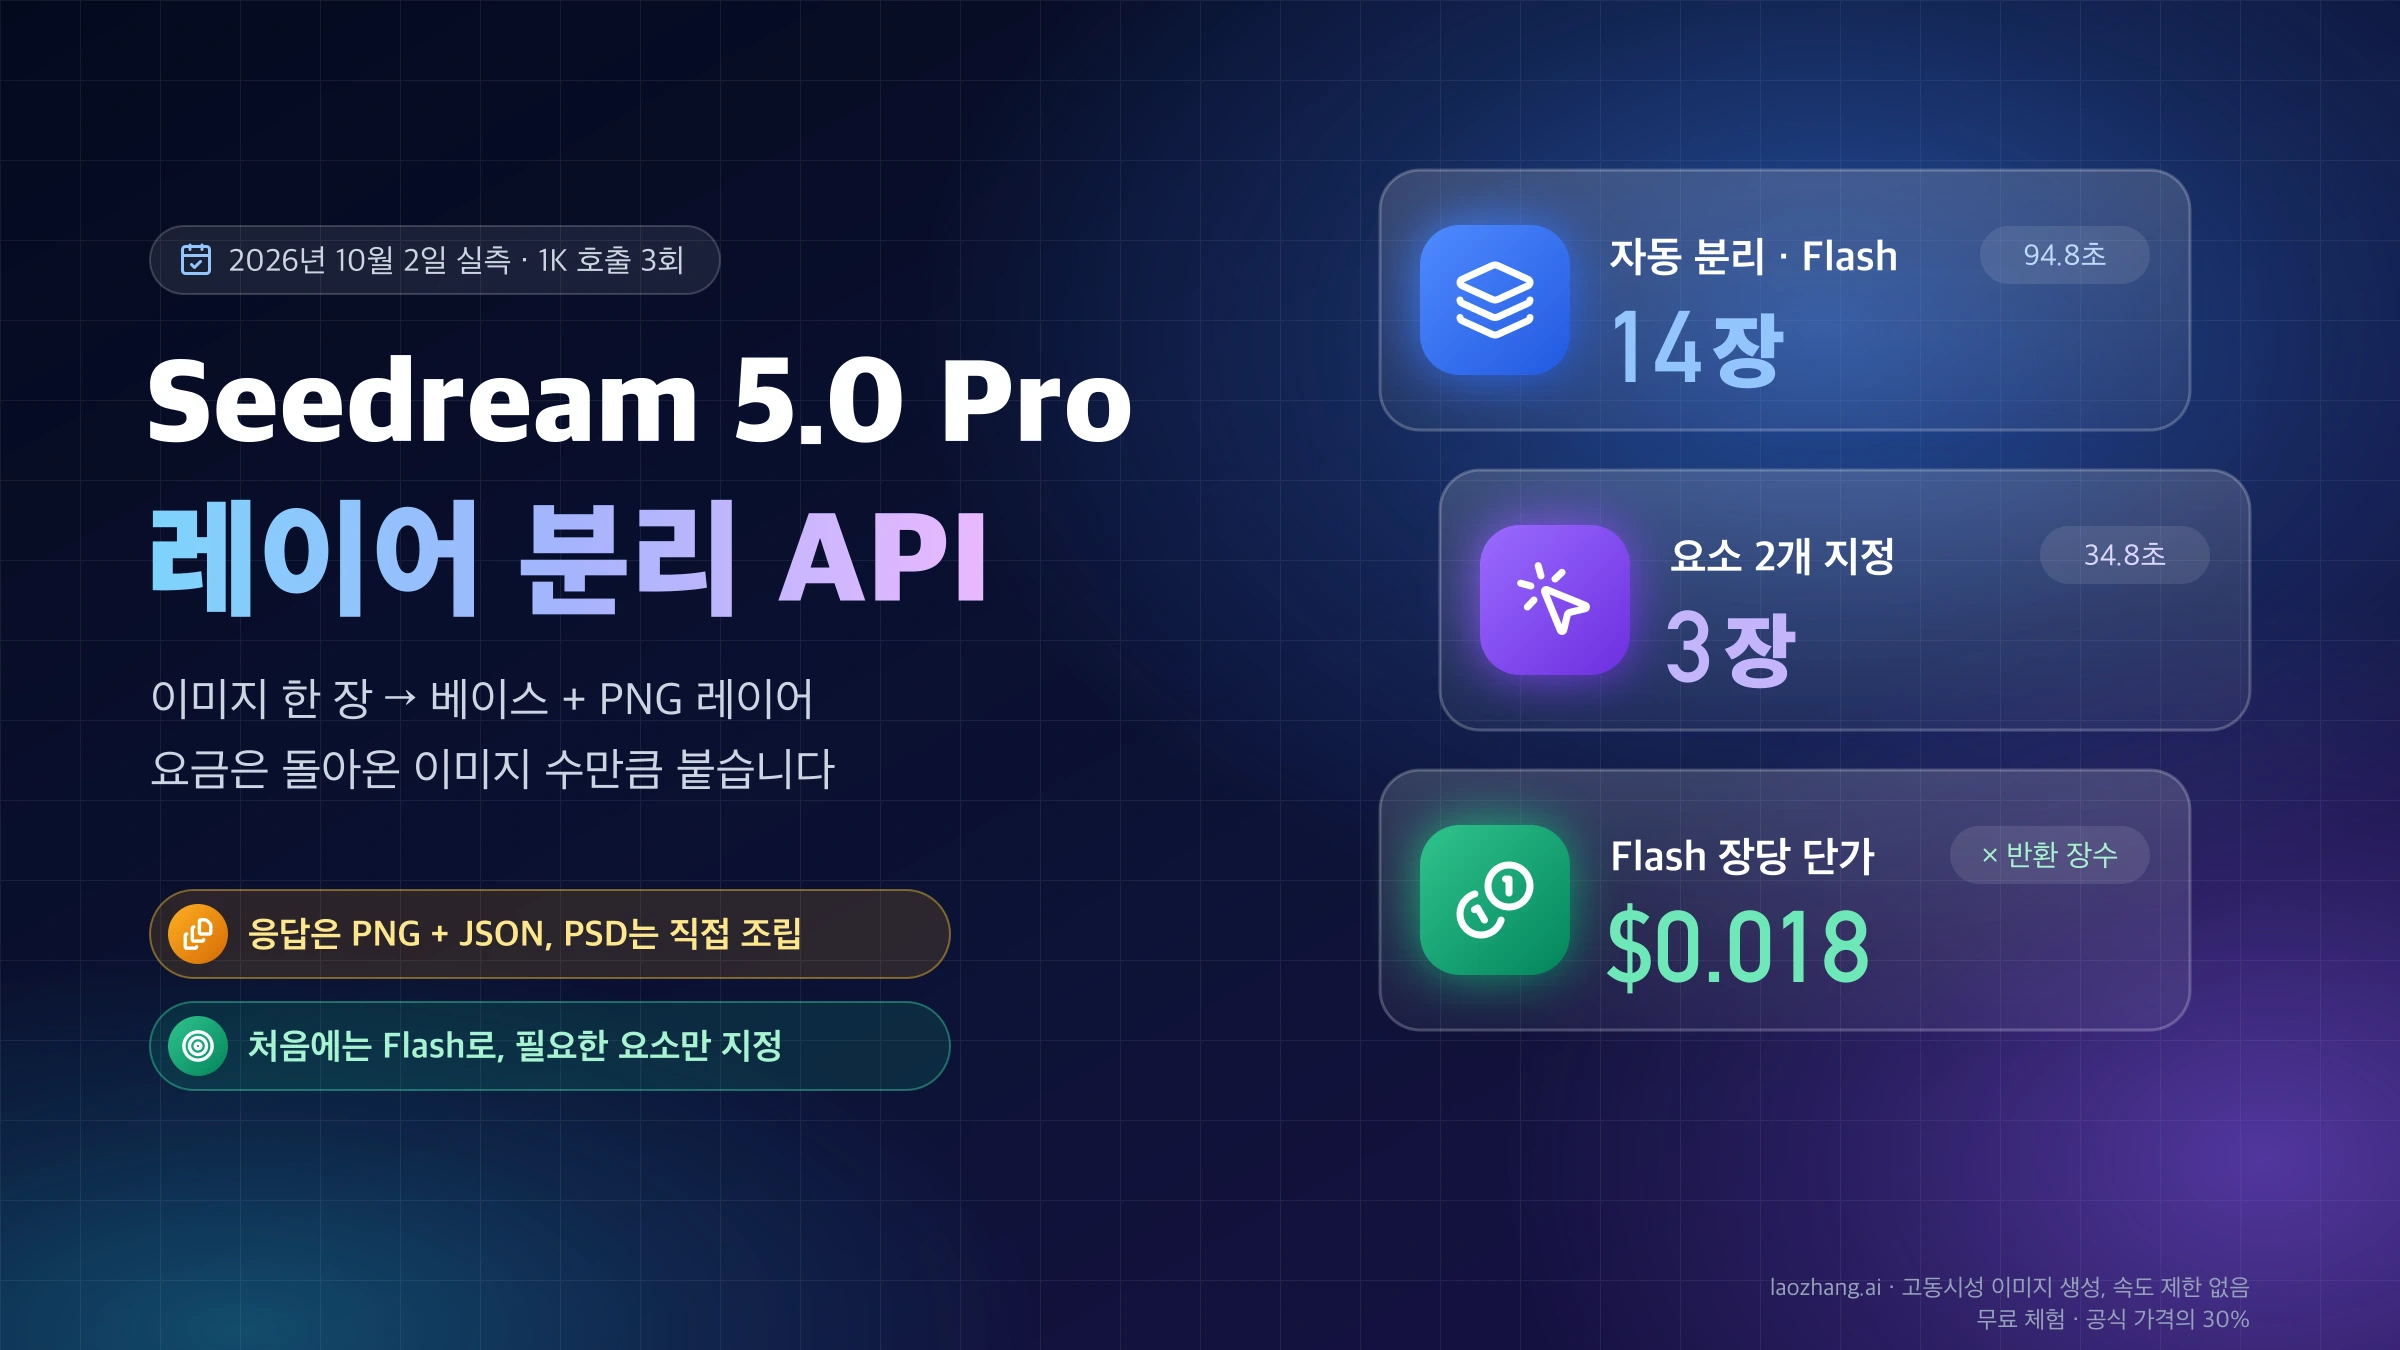
layer_decomposition: true와 이미지 한 장을 보내면 베이스 이미지와 PNG 레이어가 돌아옵니다. 1K 호출은 14장에 95초였고, 요금은 반환 장수만큼 붙습니다.
목차
아래 수치와 코드는 2026년 10월 2일에 실제로 돌린 호출에서 나왔습니다. 먼저 무엇을 실행했고 무엇을 실행하지 않았는지부터 적습니다.
- 실행한 것:
api.laozhang.ai를 거친 세 번의 호출입니다. 입력은 BytePlus 공식 튜토리얼의 샘플 이미지(2784×3441 PNG, 9.9MB, 글자가 없는 3D 일러스트) 한 장, 크기는 모두1K입니다. Flash 자동 분리, Pro 자동 분리, Flash에 요소 두 개를 지정한 분리를 각각 한 번씩 보냈고, 돌아온 응답을 PNG 레이어·재합성 미리보기·PSD로 바꾸는 Python 스크립트를 세 응답 모두에 돌렸습니다. - 실행하지 않은 것: BytePlus ModelArk 직접 호출,
1.5K·2K·auto크기, bbox 태그로 영역을 지정하는 방식, 글자가 많은 포스터, 잘못된 입력에 대한 오류 응답, 만들어진 PSD를 Photoshop에서 여는 일. 이 항목들은 아래에서 공식 문서의 내용으로만 다루고, 그렇게 표시합니다.
결과부터 말하면 이렇습니다. Seedream 5.0 Pro의 레이어 분리(공식 명칭은 layer decomposition, 레이어 분해라고도 부릅니다)는 별도 모델이 아니라 일반 이미지 생성 엔드포인트에 "layer_decomposition": true를 붙이는 모드입니다. 이미지 한 장을 보내면 가려진 부분까지 그려 넣은 투명 PNG 레이어들과, 그 요소들을 지운 베이스 이미지가 좌표와 함께 돌아옵니다. 자동 분리에서는 Flash와 Pro 모두 14장(베이스 1 + 레이어 13)이 왔고 각각 94.8초, 110.6초가 걸렸습니다. 떼어 낼 요소 두 개를 프롬프트에 적자 3장, 34.8초로 줄었습니다.
요금은 돌아온 이미지 수만큼 붙고, 그 수는 호출하는 쪽에서 고정할 수 없습니다. 그래서 처음에는 Flash로, 필요한 요소만 지정해 호출하는 편이 안전합니다. 레이어를 좌표대로 다시 쌓아도 원본과 픽셀 단위로 같아지지는 않는다는 점도 미리 알아 두어야 합니다. 이 샘플에서는 Flash 자동 분리의 재합성 결과가 원본과 30.2%의 픽셀에서 눈에 띄게 달랐습니다.
layer_decomposition: true 요청 보내기: 이미지는 정확히 한 장
필요한 것은 모델 ID, 이미지 한 장, layer_decomposition: true 세 가지입니다. BytePlus ModelArk의 Seedream 5.0 Pro 문서에 따르면 이 모드를 지원하는 모델은 Seedream 5.0 pro와 Seedream 5.0 flash 둘뿐이고, image는 필수이며 여러 장을 넣으면 오류가 납니다. prompt는 선택입니다.
모델 ID는 경로마다 다릅니다.
| 경로 | 엔드포인트 | Pro 모델 ID | Flash 모델 ID |
|---|---|---|---|
| BytePlus ModelArk | https://ark.ap-southeast.bytepluses.com/api/v3/images/generations | dola-seedream-5-0-pro-260628 | dola-seedream-5-0-flash-260915 |
| LaoZhang | https://api.laozhang.ai/v1/images/generations | seedream-5-0-pro-260628 | seedream-5-0-flash-260915 |
실제로 보낸 요청은 아래와 같습니다. 요청 본문·헤더·타임아웃은 테스트에 쓴 스크립트 그대로이고, 키를 환경 변수에서 읽는 부분과 응답을 response.json으로 저장하는 부분은 싣기 위해 간단히 고쳐 쓴 것이라 이 형태 그대로 실행한 코드는 아닙니다.
import json
import os
import time
from pathlib import Path

import requests

body = {
    "model": "seedream-5-0-flash-260915",
    "image": "https://arkdocs-en.tos-ap-southeast-1.volces.com/images/image-generation/layer_auto.png",
    "layer_decomposition": True,
    "size": "1K",
    "response_format": "url",
    "watermark": False,
}

start = time.time()
resp = requests.post(
    "https://api.laozhang.ai/v1/images/generations",
    headers={"Authorization": f"Bearer {os.environ['LAOZHANG_API_KEY']}"},
    json=body,
    timeout=420,
)
print("HTTP", resp.status_code, round(time.time() - start, 1), "s")
Path("response.json").write_text(json.dumps(resp.json(), indent=2, ensure_ascii=False))
타임아웃을 420초로 둔 데는 이유가 있습니다. 이 호출은 동기식이라 모든 레이어가 만들어질 때까지 연결이 열려 있고, LaoZhang 문서는 1K에서도 클라이언트 타임아웃을 300초 이상으로 잡으라고 안내합니다. HTTP 클라이언트의 기본값인 30초나 60초로는 응답을 받기 전에 끊깁니다.
BytePlus에 직접 보낼 때의 공식 cURL은 다음과 같습니다. 문서에 실린 그대로이며, 이 명령은 실행하지 않았습니다.
curl -X POST https://ark.ap-southeast.bytepluses.com/api/v3/images/generations \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $ARK_API_KEY" \
  -d '{
    "model": "dola-seedream-5-0-pro-260628",
    "image": "https://arkdocs-en.tos-ap-southeast-1.volces.com/images/image-generation/layer_auto.png",
    "size": "2K",
    "layer_decomposition": true,
    "watermark": false
  }'
파라미터별로 정해 둘 값
BytePlus 문서 기준으로 레이어 분리 모드에서 의미가 달라지는 파라미터는 다음과 같습니다.
| 파라미터 | 레이어 분리 모드에서의 규칙 |
|---|---|
image | 필수, 정확히 한 장. 접근 가능한 URL 또는 Base64 data URI(형식 이름은 소문자) |
size | 1K, 1.5K, 2K, auto만 가능하고 기본값은 auto. 가로×세로 직접 지정은 불가 |
output_format | png 또는 jpeg(기본값 jpeg). 베이스 이미지에만 적용되고 레이어는 항상 PNG |
response_format | url(기본값, 24시간 유지) 또는 b64_json |
watermark | 기본값 true. 켜 두면 오른쪽 아래에 "AI-generated" 표시가 들어감 |
prompt | 선택. 비우면 자동 분리, 적으면 지정한 요소만 분리 |
auto는 입력 이미지의 총 픽셀이 921,600~4,624,220 사이면 입력 크기 그대로, 그보다 작으면 1K, 크면 2K로 출력합니다. 기본값이 auto이므로 큰 이미지를 넣고 size를 생략하면 가장 비싼 구간으로 갈 수 있습니다. 출력 등급은 1K·1.5K·2K가 전부이고 4K 등급은 문서에 없습니다.
입력 이미지의 제한도 일반 생성보다 좁습니다. 형식은 PNG와 JPEG만 받고, 총 픽셀은 512×512(262,144)에서 6000×6000(36,000,000) 사이, 가로세로 비율은 1/16~16, 파일 크기는 30MB 이하입니다. WebP는 일반 생성에서는 받지만 이 모드의 지원 형식에는 없습니다.
떼어 낼 요소를 지정하는 세 가지 방법
prompt를 어떻게 쓰느냐에 따라 세 가지 방식이 있습니다.
- 자동:
prompt를 넣지 않습니다. 모델이 주요 시각 요소를 알아서 나눕니다. BytePlus 문서는 Python SDK와 OpenAI SDK가prompt를 필수로 요구하므로, SDK를 쓸 때는 "주요 시각 요소를 분리하라"는 일반적인 지시문을 넣으라고 안내합니다. - 자연어 지정: 떼어 낼 요소를 문장으로 적습니다. 공식 예시는 "Decompose the person, title text, and decorative icon in the lower-right corner"이고, 실제로 보낸 문장은 "Separate only the central toast lead singer with sunglasses and the toast-shaped electric guitar."였습니다. 입력 이미지 위에 직접 선이나 선택 영역을 그려 넣는 방법도 문서에 있습니다.
- 좌표 지정: 프롬프트 안에 bbox 태그로 영역을 적습니다. 좌표는 0~1000으로 정규화한 왼쪽·위·오른쪽·아래 순서입니다. 이 방식은 실행하지 않았고, 아래는 형식만 보여 주는 예시입니다.
Separate the element in <bbox>282 269 744 613</bbox> as one layer.빈 문자열을 넣는 것이 prompt를 생략한 것과 같은지는 자료마다 말이 다릅니다. LaoZhang 문서는 빈 문자열을 보내도 된다고 하고, 다른 게이트웨이인 EvoLink의 2026년 8월 15일 자 안내서는 빈 문자열이면 자동 감지가 동작하지 않는다고 적습니다. 어느 쪽도 실행해 보지 않았으므로, 자동 분리를 원한다면 키 자체를 본문에 넣지 않는 쪽이 안전합니다.
응답 읽기: z_index와 bounding_box로 레이어 다시 배치하기
응답의 data 배열에는 베이스 이미지와 모든 레이어가 함께 들어 있고, z_index가 0인 항목이 베이스 이미지입니다. 베이스에는 url, size, output_format, z_index만 있고, 레이어에는 여기에 bounding_box, name, description이 더해집니다. Flash 자동 분리 응답에서 베이스와 레이어 하나를 그대로 옮기면 다음과 같습니다(URL은 줄였습니다).
{
  "data": [
    {
      "url": "https://...",
      "size": "880x1088",
      "output_format": "jpeg",
      "z_index": 0
    },
    {
      "url": "https://...",
      "size": "271x1037",
      "output_format": "png",
      "z_index": 12,
      "bounding_box": {
        "absolute": [231, 503, 334, 897],
        "normalized": [263, 462, 378, 824]
      },
      "name": "Standing microphone stand",
      "description": "A black standing microphone stand including the microphone and base, positioned to the left of the central toast."
    }
  ],
  "usage": {
    "input_images": 1,
    "generated_images": 14,
    "output_tokens": 53663,
    "total_tokens": 53663
  }
}
필드의 의미는 BytePlus 문서에 이렇게 정의되어 있습니다.
z_index: 쌓는 순서입니다. 1부터 위로 올라가며, 세 번의 호출 모두 빠진 번호 없이 이어졌습니다.bounding_box.absolute: 베이스 이미지의 픽셀 좌표로[left, top, right, bottom]입니다.bounding_box.normalized: 같은 상자를 베이스의 가로·세로를 각각 0~1000으로 본 좌표입니다.usage.generated_images: 베이스를 포함한 반환 이미지 수입니다. 과금의 기준이 되는 숫자이므로 호출할 때마다 기록해 두는 것이 좋습니다.
다시 합치는 순서는 문서에 나온 그대로입니다. 베이스를 배경으로 깔고, 레이어를 z_index 오름차순으로 정렬한 뒤, 각 레이어를 w = right - left, h = bottom - top 크기로 맞춰 (left, top)에 올립니다.
여기서 빠뜨리기 쉬운 것이 크기 조정입니다. 레이어 PNG는 자기 상자보다 큽니다. 위 마이크 스탠드는 파일이 271×1037인데 상자는 103×394이고, 접이식 의자는 파일 660×940에 상자 118×169였습니다. 파일을 원래 크기 그대로 좌표에 붙이면 요소가 몇 배로 커져서 화면을 덮습니다. 반드시 상자 크기로 줄인 다음 올려야 합니다.
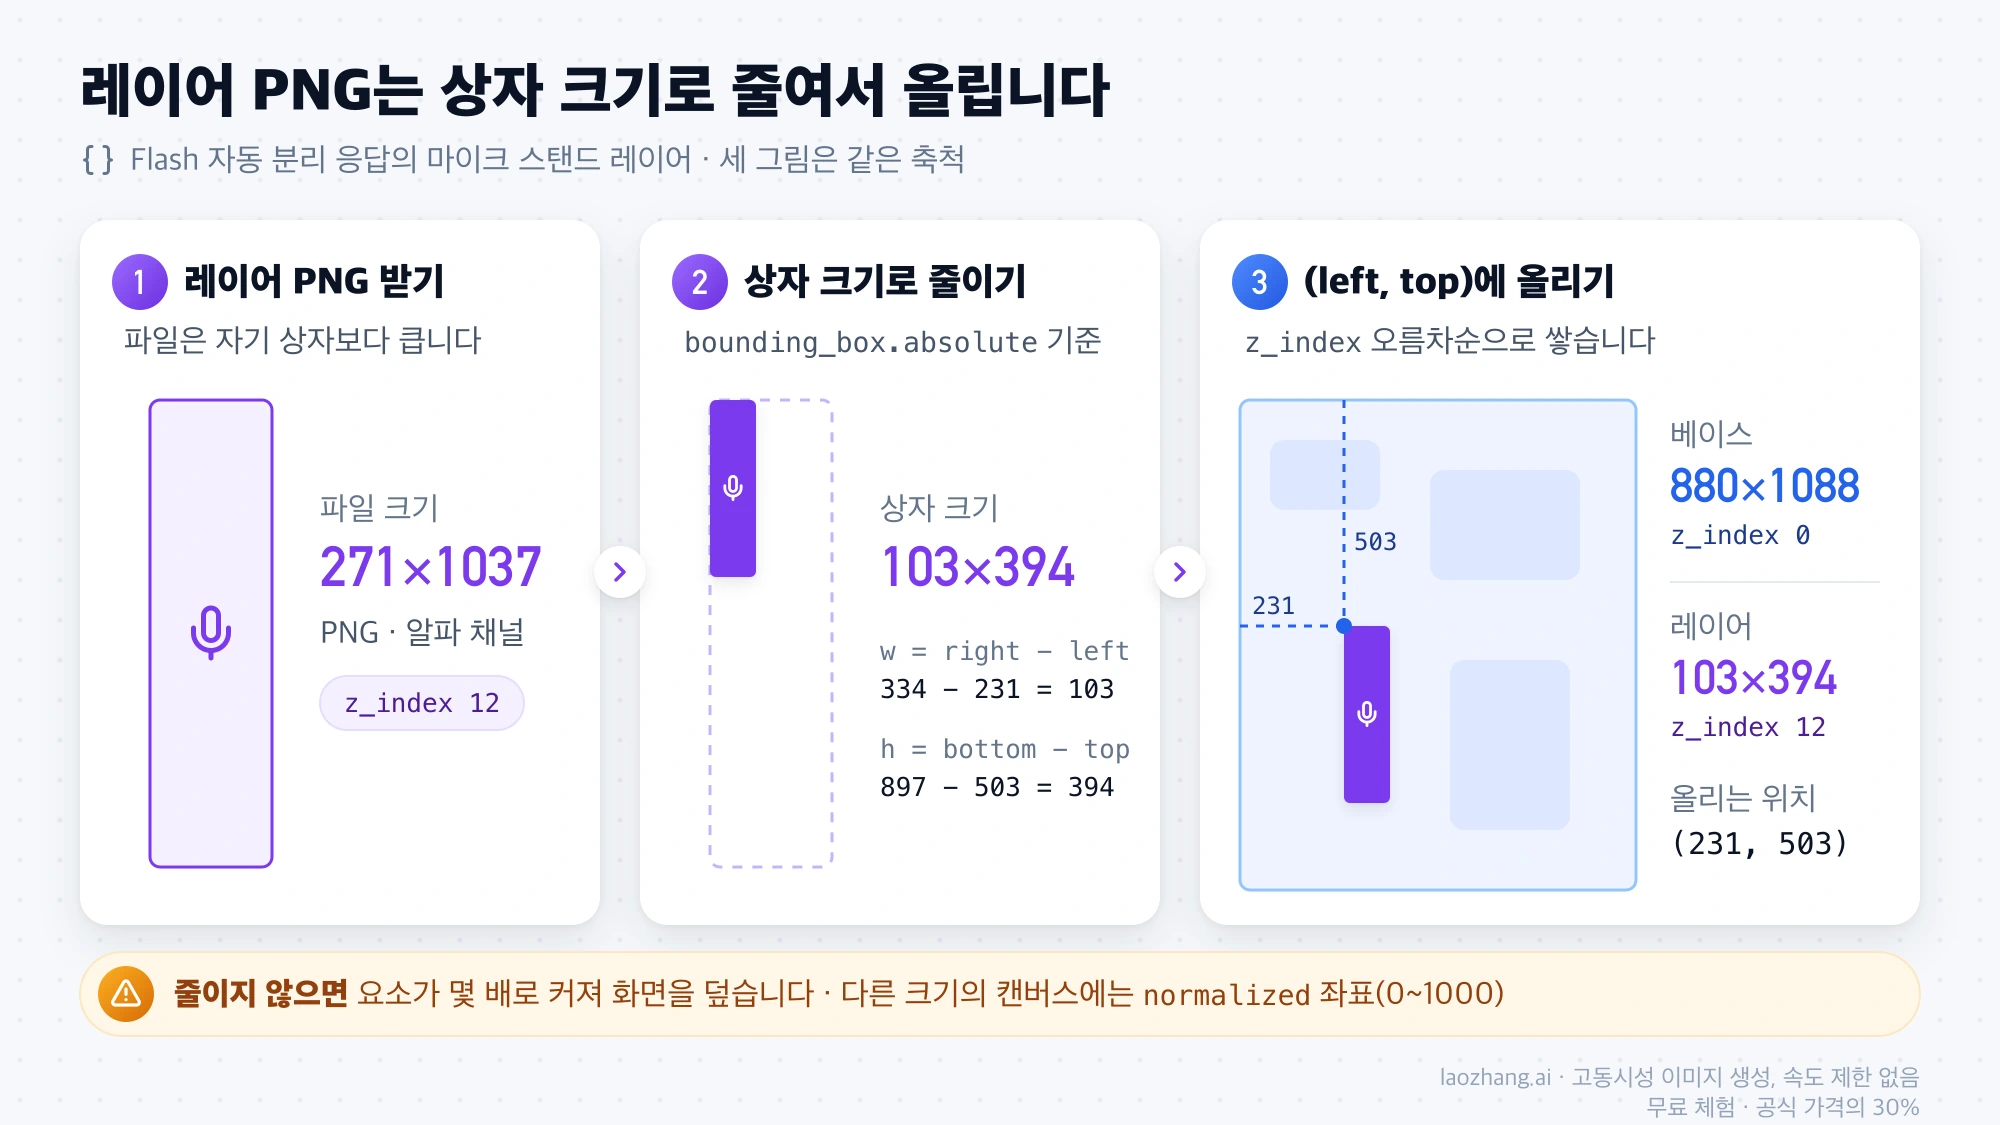
베이스와 다른 크기의 캔버스에 올릴 때는 normalized를 씁니다. 캔버스가 W×H라면 x = left / 1000 × W, y = top / 1000 × H, w = (right - left) / 1000 × W, h = (bottom - top) / 1000 × H입니다. 문서는 정규화 좌표가 정수라서 변환 과정에서 반올림 오차가 생길 수 있다고 덧붙입니다.
레이어 파일이 상자보다 크다는 것은 1K 베이스보다 큰 캔버스에도 어느 정도 선명하게 올릴 수 있다는 뜻이지만, 여유는 레이어마다 다릅니다. 원본 크기인 2784×3441 캔버스로 계산하면 접이식 의자는 약 370×530이 필요해 660×940 파일로 충분하고, 마이크 스탠드는 약 320×1246이 필요해 271×1037 파일로는 확대해야 합니다. 큰 캔버스에 쓸 계획이라면 레이어마다 필요한 크기와 파일 크기를 비교해 보아야 합니다. 이 계산은 좌표와 파일 크기에서 나온 것이고, 큰 캔버스에 실제로 합성해 본 결과는 아닙니다.
1K 실측: 자동 분리 14장에 95~111초, 요소 지정은 3장에 35초
같은 이미지로 한 세 번의 호출 결과입니다. 구성마다 한 번씩만 보낸 값이므로 평균이나 보장 수치로 읽으면 안 됩니다.
| 호출 | 모델 | prompt | 소요 시간 | 반환 이미지 | 베이스 크기 | output_tokens |
|---|---|---|---|---|---|---|
| 자동 분리 | seedream-5-0-flash-260915 | 없음 | 94.8초 | 14장 (베이스 + 13) | 880×1088 JPEG | 53,663 |
| 자동 분리 | seedream-5-0-pro-260628 | 없음 | 110.6초 | 14장 (베이스 + 13) | 880×1088 JPEG | 53,111 |
| 요소 지정 | seedream-5-0-flash-260915 | 보컬과 기타만 분리 | 34.8초 | 3장 (베이스 + 2) | 880×1088 JPEG | 11,924 |
세 호출 모두 HTTP 200이었습니다. 여기서 읽을 수 있는 것은 세 가지입니다.
첫째, 1K는 "긴 변 1024"가 아닙니다. 2784×3441 입력에 대해 베이스는 880×1088로, 원본 비율을 유지한 채 총 픽셀이 약 96만이 되도록 나왔습니다.
둘째, 두 모델이 같은 수의 레이어를 찾았지만 나눈 방식은 달랐습니다. Flash는 나무 무대를 레이어로 떼어 냈고, Pro는 무대를 베이스에 남기고 우쿨렐레를 따로 떼어 냈습니다. 같은 요소의 이름도 "Light green minivan"과 "Light green minibus"처럼 달랐습니다. 레이어 이름이나 개수를 코드에서 고정값으로 가정하면 안 되고, LaoZhang 문서도 같은 이미지에서 호출마다 장수가 달라질 수 있다고 적고 있습니다.
셋째, 요소를 두 개로 좁히자 이미지 수가 14장에서 3장으로, 시간이 94.8초에서 34.8초로 줄었습니다. 소요 시간이 만들어야 할 이미지 수와 함께 움직인 셈입니다. 이때 베이스에는 나머지 요소가 모두 남고, 보컬이 서 있던 자리의 밴 앞유리와 그릴이 새로 그려졌습니다.
다시 합치면 원본과 같은가: 다른 픽셀이 4.0~30.2%
같지 않습니다. 레이어를 absolute 좌표와 z_index 순서대로 쌓은 결과를, 같은 크기로 줄인 원본과 픽셀 단위로 비교했습니다. 기준은 어느 한 색상 채널에서라도 차이가 255 중 32를 넘는 픽셀의 비율입니다.
| 호출 | 차이가 큰 픽셀 비율 | 평균 절대 차이 |
|---|---|---|
| Flash 자동 분리 (13 레이어) | 30.2% | 20.6 |
| Pro 자동 분리 (13 레이어) | 12.6% | 13.6 |
| Flash 요소 지정 (2 레이어) | 4.0% | 6.7 |
이유는 파일을 열어 보면 보입니다. 각 레이어는 원본에서 오려 낸 조각이 아니라 가려진 부분까지 그려 넣은 완성된 사물이고, 베이스도 요소가 빠진 자리를 새로 칠한 그림입니다. 레이어를 옮기거나 지워도 구멍이 나지 않는 것은 이 덕분이지만, 그만큼 원본에 없던 픽셀이 들어갑니다. 그래서 이 기능을 누끼 따기나 세그멘테이션 마스크처럼 원본 픽셀을 보존하는 도구로 생각하면 결과가 어긋납니다.
Flash 자동 분리 결과에서는 차이가 눈으로도 보였습니다. 원본에서 초점이 나가 있던 전경의 두 캐릭터가 선명하고 모양이 다른 사물로 돌아왔고, 왼쪽 연주자는 더 큰 완성형 캐릭터로 다시 그려졌으며, 무대는 원본에서 보이던 잔디를 덮는 온전한 원판이 되었고, 떠다니던 비눗방울은 베이스와 레이어 어디에도 남지 않았습니다. Pro는 전경의 흐림과 비눗방울을 베이스에 그대로 두어 원본과 눈으로 보기에 가까웠고, 차이는 주로 가장자리에 있었습니다.
EvoLink의 안내서는 z_index로 정렬해 absolute 상자에 합성하면 원본이 정확히 재현된다고 적고 있지만, 이 샘플에서는 그렇지 않았습니다. 다만 위 수치는 스타일이 강한 3D 일러스트 한 장에서 모델당 한 번 잰 값이고, 사진이나 평면 그래픽에서 같은 비율이 나온다고 볼 근거는 없습니다. 실무에서 쓸 수 있는 결론은 방향입니다. 원본과의 일치가 중요하면 떼어 내는 요소를 줄이고, 자동 분리가 필요하면 Pro 쪽이 이 샘플에서는 원본에 더 가까웠습니다.
응답을 PNG 레이어·미리보기·PSD로 저장하는 Python 스크립트
API는 PSD를 돌려주지 않습니다. 돌아오는 것은 PNG 레이어와 JSON이고, PSD는 직접 조립해야 합니다. 아래 스크립트는 저장해 둔 응답 JSON을 읽어 모든 이미지를 내려받고, layer-NN-이름.png 파일들, 다시 합친 recomposed.png, 레이어가 이름과 위치를 가진 layers.psd를 만듭니다. Python 3.12, Pillow 12.3.0, psd-tools 1.23.0에서 세 응답 모두에 실행한 코드이고, 테스트 기록을 풀어 읽던 한 줄만 뺐습니다.
python3 -m pip install pillow psd-tools
python3 layers_to_psd.py response.json out_dir"""Save every image of a Seedream layer-decomposition response, recompose a
flat preview, and write a layered PSD.
Usage: python3 layers_to_psd.py response.json out_dir
Needs: python3 -m pip install pillow psd-tools
"""
import base64
import json
import re
import sys
import urllib.request
from io import BytesIO
from pathlib import Path
from PIL import Image
from psd_tools import PSDImage
response = json.loads(Path(sys.argv[1]).read_text())
out = Path(sys.argv[2])
out.mkdir(parents=True, exist_ok=True)
def load(item):
if item.get("b64_json"):
value = item["b64_json"].split(",", 1)[-1]
return base64.b64decode(value + "=" * (-len(value) % 4))
with urllib.request.urlopen(item["url"], timeout=120) as download:
return download.read()
items = sorted(response["data"], key=lambda item: item["z_index"])
base_item, layer_items = items[0], items[1:]
assert base_item["z_index"] == 0 and "bounding_box" not in base_item
content = load(base_item)
ext = "png" if base_item.get("output_format") == "png" else "jpg"
(out / f"layer-00-base.{ext}").write_bytes(content)
base = Image.open(BytesIO(content)).convert("RGBA")
canvas = base.copy()
psd = PSDImage.new("RGBA", base.size)
psd.append(psd.create_pixel_layer(base, name="base", top=0, left=0))
for item in layer_items:
content = load(item)
slug = re.sub(r"[^a-z0-9]+", "-", item.get("name", "layer").lower()).strip("-") or "layer"
(out / f"layer-{item['z_index']:02d}-{slug}.png").write_bytes(content)
left, top, right, bottom = item["bounding_box"]["absolute"]
# The PNG is usually larger than its box: scale it to the box first.
layer = Image.open(BytesIO(content)).convert("RGBA").resize((right - left, bottom - top), Image.LANCZOS)
canvas.alpha_composite(layer, (left, top))
psd.append(psd.create_pixel_layer(layer, name=item.get("name", slug), top=top, left=left))
print(f"z={item['z_index']:>2} file={item['size']:>9} box={right - left}x{bottom - top} at ({left},{top}) {item.get('name')}")
canvas.save(out / "recomposed.png")
psd.save(out / "layers.psd")
print(f"Saved {len(layer_items)} layers + base, recomposed.png and layers.psd in {out}")실행 결과로 확인된 것은 다음까지입니다. PSD는 베이스와 같은 880×1088 크기로 저장되었고, 자동 분리 응답 두 개에서는 이름이 붙은 픽셀 레이어 14개, 요소 지정 응답에서는 3개가 각자의 absolute 위치에 들어갔습니다. 저장한 PSD를 psd-tools로 다시 열어 합성한 그림은 recomposed.png와 일치했습니다(평균 절대 차이 0.001 이하).
실행 범위는 여기까지입니다. 이 PSD를 Photoshop, Photopea, GIMP에서 여는 단계는 거치지 않았으므로, 편집기에서의 호환성은 직접 열어서 확인해야 합니다. 그리고 PSD 안의 레이어는 상자 크기로 줄인 픽셀 레이어라서, 원본 해상도의 레이어가 필요하면 함께 저장되는 layer-NN-이름.png 파일을 써야 합니다.
스크립트를 쓸 때 알아 둘 점이 두 가지 더 있습니다. BytePlus 문서에 따르면 결과 URL은 24시간 뒤에 만료되므로 응답을 받은 날 바로 내려받아야 합니다. 그리고 LaoZhang 문서는 결과 URL이 CORS 헤더를 보내지 않는다고 안내하므로, 브라우저에서 직접 이미지를 읽어야 한다면 response_format을 b64_json으로 바꿔야 합니다. 스크립트에는 b64_json을 읽는 분기가 있지만 이 분기는 실행해 보지 않았습니다.
코드를 쓰지 않고 레이어 PSD만 얻으려는 경우에는 브라우저 도구인 layerpsd.com이 있습니다. 이 블로그와 운영 주체가 같은 서비스이며, 사이트는 JPG·PNG·WebP를 레이어 PSD로 나누고 레이어당 $0.018부터, 구독 없이 쓸 수 있다고 안내합니다. 이 도구는 이번 테스트에 포함되지 않았습니다.
호출당 비용: 반환 장수 × 장당 단가, 14장이면 $0.252~$1.68
한 번 호출의 비용은 "장당 단가 × 돌아온 이미지 수"이고, 이미지 수는 베이스를 포함해 2장에서 17장 사이입니다. 2026년 10월 2일 기준 공시 단가는 다음과 같습니다.
- BytePlus 가격표: Pro의 레이어 분해 출력은 이미지당 261만 픽셀 이하(1.5K 이하)가 $0.0225, 초과가 $0.045입니다. Flash는 출력 한 장에 $0.018이고 레이어 분해용 별도 단가가 없습니다. 입력 이미지는 Pro의 첫 장과 Flash 모두 무료입니다.
- LaoZhang 문서(2026년 9월 25일 기준 가격): 반환 이미지 한 장당 Flash $0.018, Pro $0.12이며, 픽셀 구간 없이 고정이고 베이스도 장수에 포함됩니다.
이 단가에 실제로 돌아온 장수를 곱하면 아래 표가 됩니다.
| 경로·모델 | 장당 단가 | 3장 (요소 지정) | 14장 (자동 분리) | 17장 (최대) |
|---|---|---|---|---|
| BytePlus Flash | $0.018 | $0.054 | $0.252 | $0.306 |
| BytePlus Pro, 261만 픽셀 이하 | $0.0225 | $0.0675 | $0.315 | $0.3825 |
| BytePlus Pro, 261만 픽셀 초과 | $0.045 | $0.135 | $0.63 | $0.765 |
| LaoZhang Flash | $0.018 | $0.054 | $0.252 | $0.306 |
| LaoZhang Pro | $0.12 | $0.36 | $1.68 | $2.04 |
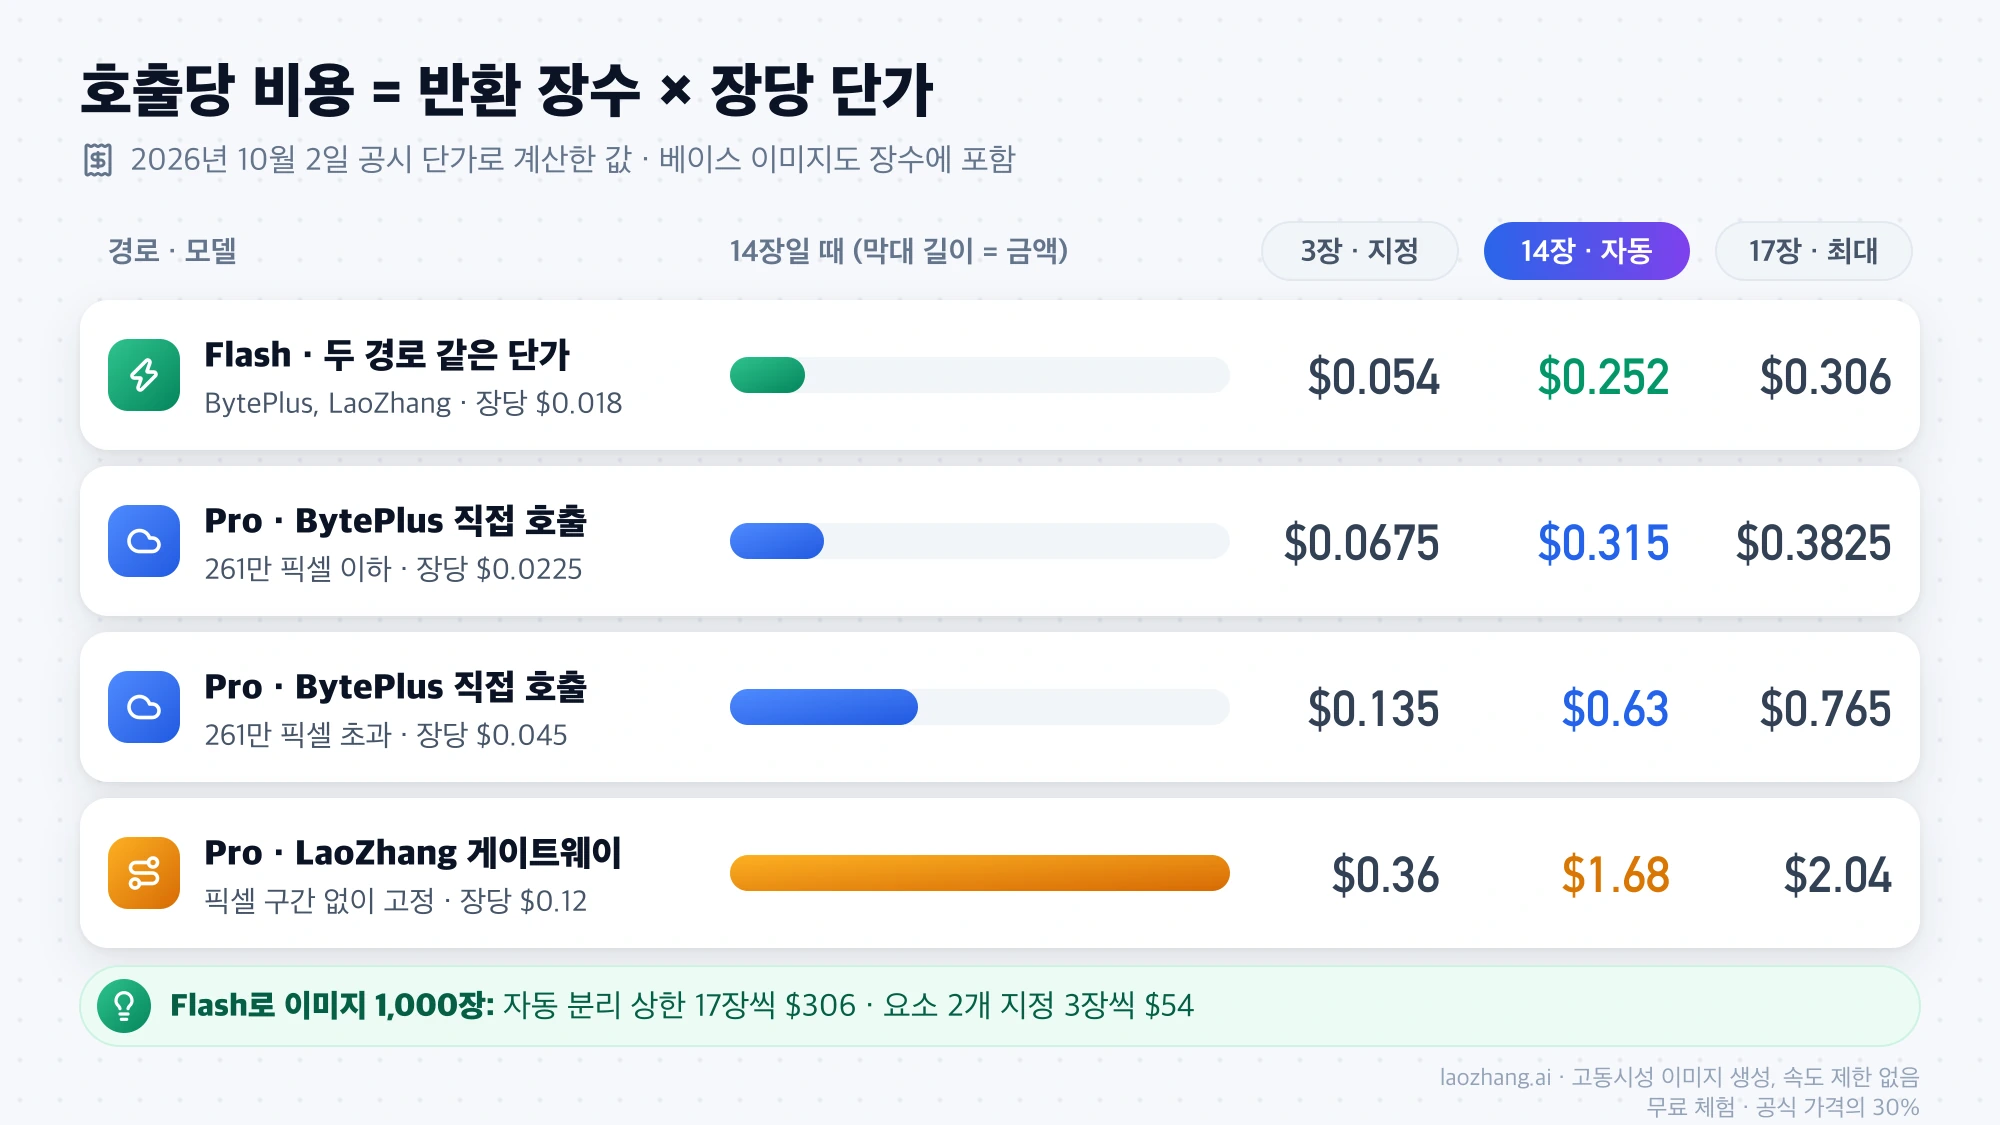
표를 읽을 때의 전제는 세 가지입니다.
- 실제로 호출한 것은 LaoZhang의 두 행뿐이고, 금액은 공시 단가에
usage.generated_images를 곱한 값입니다. 콘솔의 청구 내역과 대조하지는 않았습니다. - BytePlus 행은 베이스 이미지도 레이어와 같은 단가로 과금된다고 가정했습니다. 가격표에 이 점이 명시되어 있지는 않지만, 공식 응답 예시의
generated_images가 베이스를 포함한 숫자이고 문서가 "성공적으로 생성된 이미지 수로만 과금한다"고 적고 있어 이렇게 계산했습니다. - BytePlus Pro는 레이어마다 실제 픽셀 구간으로 따로 과금됩니다. 한 응답 안에 두 구간이 섞일 수 있으므로 실제 금액은 두 Pro 행 사이에 놓입니다. 1K 호출에서는 가장 큰 파일도 1038×377이어서 모두 낮은 구간에 들어가지만, 2K로 올리면 베이스(예: 2048×2048 = 약 419만 픽셀)부터 높은 구간이 됩니다.
배치를 돌리기 전의 추정은 최악의 경우부터 잡는 편이 맞습니다. 이미지 1,000장을 자동 분리한다면 상한은 17장 × 단가 × 1,000이고, Flash로는 $306입니다. 요소를 두 개로 지정해 3장씩 받는다면 같은 계산이 $54가 됩니다. 장수를 줄이는 것이 단가를 고르는 것보다 비용에 더 크게 작용합니다.
모더레이션 등으로 생성되지 못한 출력은 BytePlus에서 과금되지 않습니다. 반대로 LaoZhang 문서는 2K 요청이 오래 걸릴 수 있고 클라이언트가 먼저 연결을 끊어도 과금된다고 적고 있으므로, 타임아웃을 짧게 잡아 재시도하는 구성은 같은 이미지에 요금을 두 번 내게 만들 수 있습니다.
Pro와 Flash, BytePlus와 게이트웨이 중 어디로 호출할까
모델과 경로는 따로 정해야 합니다. 단가 관계가 모델마다 반대이기 때문입니다.
- Flash는 어느 경로든 단가가 같습니다. LaoZhang의 Flash 단가는 BytePlus 정가와 같은 $0.018입니다. BytePlus 계정을 따로 만들지 않고 시작하려면 게이트웨이를 써도 추가 비용이 없습니다.
- Pro는 BytePlus 직접 호출이 훨씬 쌉니다. 장당 $0.0225 대 $0.12로 낮은 구간에서 약 5.3배, $0.045 대 $0.12로 높은 구간에서 약 2.7배 차이입니다. Pro로 레이어 분리를 꾸준히 돌릴 계획이라면 BytePlus 계정을 여는 쪽이 맞고, 게이트웨이의 Pro는 계정 없이 몇 장을 시험해 보는 용도에 그칩니다.
- 모델은 Flash로 시작합니다. 같은 이미지에서 두 모델이 찾은 레이어 수는 13개로 같았고, 차이는 재합성 결과가 원본에 얼마나 가까운가에 있었습니다(Pro 12.6%, Flash 30.2%). 레이어를 떼어 내 다른 배경에 쓰는 용도라면 Flash로 충분한지 먼저 보고, 원래 구도 그대로 다시 쌓아 편집해야 하는데 Flash 결과가 눈에 띄게 달라졌을 때 Pro로 올리는 순서가 비용 면에서 합리적입니다.
BytePlus를 고를 때는 리전도 확인해야 합니다. 모델 목록에 따르면 Seedream 5.0 pro와 flash는 ap-southeast-1에서만 제공되고 EU 엔드포인트가 없습니다. 중국 본토용 Volcengine Ark는 모델 ID가 doubao-로 시작하고 위안화로 과금되는 별도 경로입니다.
레이어 분리 말고 일반 생성까지 포함해 Seedream 5.0 Pro를 다른 모델과 견주고 있다면 나노 바나나 프로 vs Seedream 5.0 Pro: 무엇부터 쓸까에 작업별 선택 기준과 공식 가격이 정리되어 있습니다.
400 오류와 속도 제한: 요청 하나가 IPM 17을 먼저 차감
오류 응답은 직접 유발해 보지 않았으므로 이 절의 내용은 모두 BytePlus와 LaoZhang 문서의 기재 사항입니다.
요청이 거절되는 조건은 다음과 같습니다.
image에 두 장 이상을 넣은 경우, 또는 형식·픽셀 수·비율·용량이 앞에서 본 입력 제한을 벗어난 경우.- LaoZhang 경로에서 본문에
sequential_image_generation이나stream이 들어 있는 경우 HTTP 400이 납니다. Seedream 5.0 pro와 flash는 BytePlus에서도 스트리밍을 지원하지 않습니다. - 이전 모델(
seedream-5-0-260128,seedream-4-5-251128)에layer_decomposition을 보내면 LaoZhang은 HTTP 400InvalidParameter를 돌려줍니다. - 분리할 수 없는 이미지는 LaoZhang에서 HTTP 400으로 끝나고 과금되지 않습니다.
- LaoZhang 키는 건당 과금이 가능한 방식("Usage first" 또는 "Per-call")이어야 합니다.
부분 성공은 없습니다. BytePlus 문서는 레이어 하나라도 생성에 실패하면 요청 전체가 실패한다고 적고 있습니다. 또 프롬프트로 상한(16개)보다 많은 레이어를 요구하면 일부 레이어 정보가 사라질 수 있습니다. 요소가 많은 이미지는 한 번에 전부 나누려 하지 말고 요소 묶음별로 호출을 나누는 편이 안전합니다.
속도 제한은 두 모델 모두 계정당 500 IPM(분당 이미지 수)인데, 레이어 분리는 계산 방식이 다릅니다. 요청 하나가 시작될 때 베이스 1장과 레이어 16장 몫인 17 IPM을 먼저 차감하고, 생성이 끝난 뒤 실제 장수를 넘는 몫을 돌려줍니다. 따라서 여유가 가득한 상태에서 1분 안에 시작할 수 있는 레이어 분리 요청은 500 ÷ 17 = 29건(29 × 17 = 493)입니다. 3장만 돌아오는 요청도 끝나기 전까지는 17을 잡고 있고, 한 요청이 35~110초 걸렸으므로 환급은 그만큼 늦게 옵니다. 일반 생성과 같은 감각으로 동시 실행 수를 잡으면 한도에 먼저 닿습니다. 이 수치는 BytePlus 직접 계정의 기본 한도이고, 게이트웨이의 한도는 별개입니다.
레이어 분리 API가 맞지 않는 경우
이 API는 "움직일 수 있는 사물 단위의 래스터 레이어"를 만드는 도구이고, 다음 작업에는 맞지 않습니다.
- 원본 픽셀을 그대로 보존해야 할 때: 레이어와 베이스 모두 다시 그려진 그림입니다. 제품 사진의 색이나 로고 형태가 한 픽셀도 달라지면 안 되는 작업에는 마스크 기반 도구가 맞습니다.
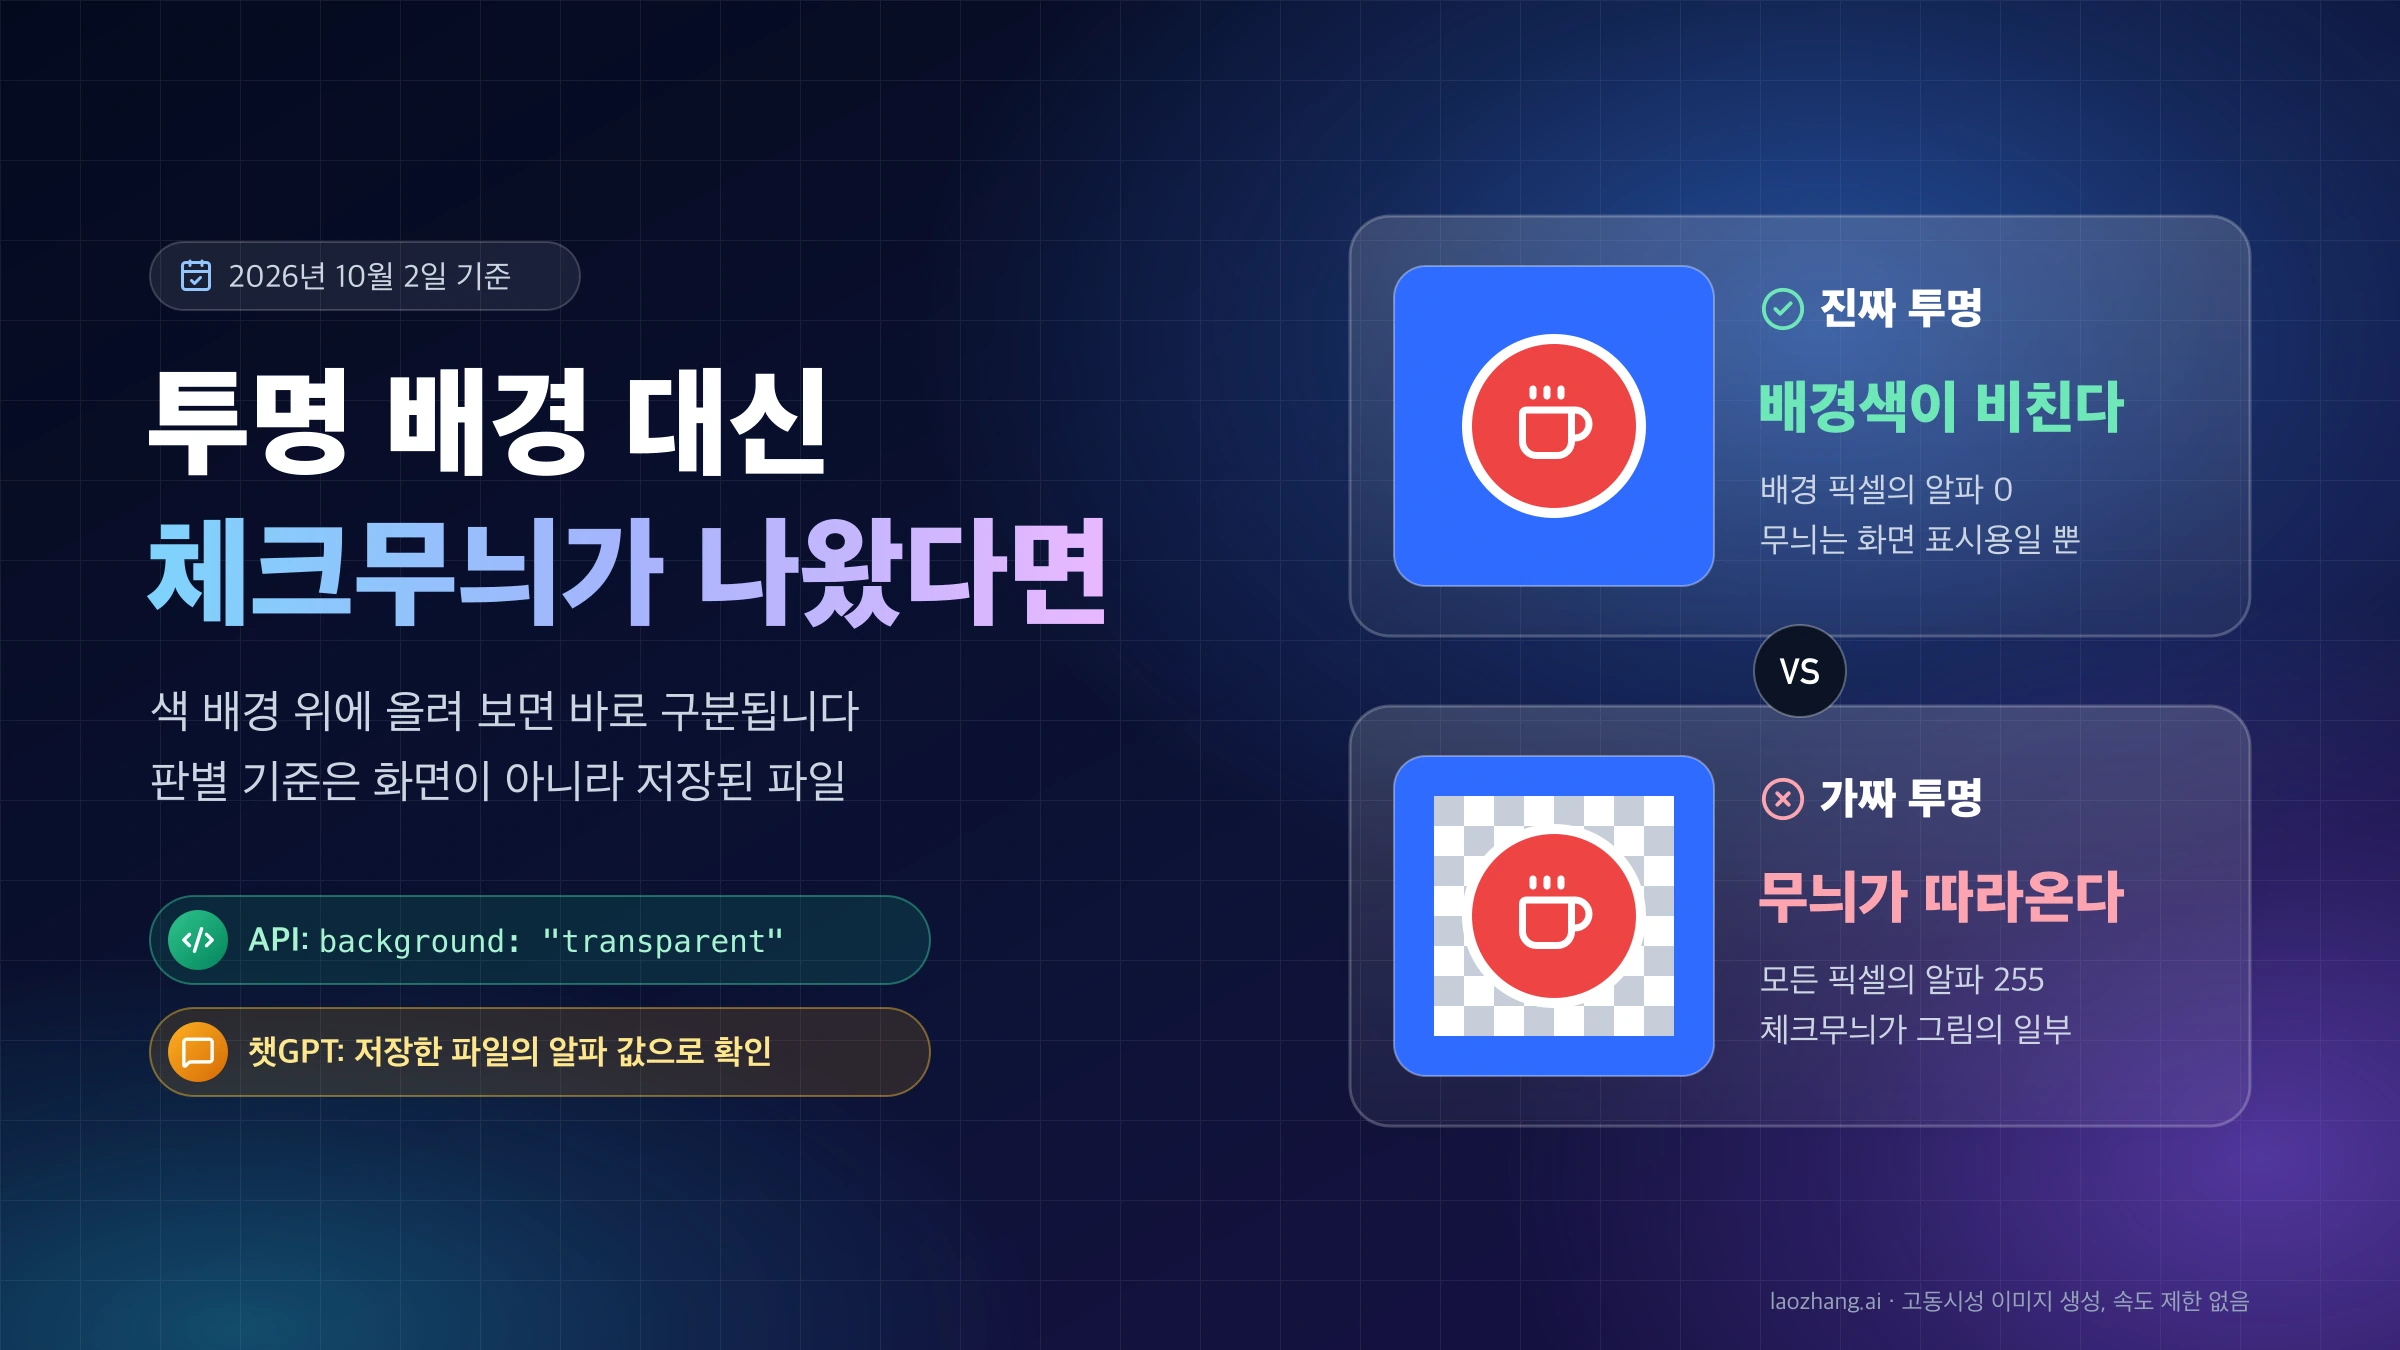
- 배경만 투명하게 만들면 될 때: 요소 하나에 최소 2장분 요금과 수십 초를 쓸 이유가 없습니다. 이미지 배경 투명하게 만들기: 방법 고르기와 투명 PNG 확인에 투명 배경 한 장을 만드는 더 가벼운 방법들이 있습니다.
- 편집 가능한 글자 레이어가 필요할 때: 응답에는 텍스트 객체가 없고 모든 레이어가 PNG입니다. 공식 예시는 글자 묶음을 레이어로 떼어 내지만, 그 레이어도 글자 모양의 그림입니다. 글자가 많은 이미지는 이번 호출에 포함되지 않았습니다.
- 2K보다 큰 결과물이 필요할 때: 출력 등급이 1K·1.5K·2K뿐입니다.
- 요소가 16개를 넘는 복잡한 이미지를 한 번에 나눠야 할 때: 상한을 넘는 요소는 빠질 수 있습니다.
- EU 리전에서 처리해야 하는 데이터: BytePlus에서 이 두 모델은
ap-southeast-1에만 있습니다.
반대로 떼어 낸 레이어를 고쳐 쓰는 작업에는 이어지는 경로가 있습니다. BytePlus 문서에 따르면 돌아온 레이어 PNG 한 장을 일반 Seedream 요청의 입력으로 넣고 "background": "transparent"와 PNG 출력을 지정하면, 투명도를 유지한 채 색이나 스타일을 바꿀 수 있습니다. 입력이 알파 채널을 가진 이미지 한 장이어야 하고 JPEG 입력이나 output_format: jpeg는 오류가 됩니다. 이 요청은 실행하지 않았습니다.
자주 생기는 질문
Seedream 5.0 Pro 레이어 분리 결과를 PSD로 바로 받을 수 있나요?
받을 수 없습니다. API가 돌려주는 것은 베이스 이미지 1장, 알파 채널이 있는 PNG 레이어들, 그리고 각 레이어의 z_index와 bounding_box가 담긴 JSON입니다. PSD는 위의 Python 스크립트처럼 psd-tools 같은 라이브러리로 직접 조립해야 합니다.
레이어 분리는 Seedream 5.0 Flash에서도 되나요?
됩니다. BytePlus 문서 기준으로 layer_decomposition을 지원하는 모델은 Seedream 5.0 pro와 Seedream 5.0 flash 두 개이고, 요청과 응답 형식이 같습니다. 같은 샘플 이미지에서 두 모델 모두 레이어 13개를 돌려주었고, 장당 공시 단가는 Flash가 $0.018로 더 낮습니다.
Seedream 레이어 분리 API는 왜 한 번에 1~2분씩 걸리나요?
한 번의 요청이 이미지를 여러 장 만들기 때문입니다. 1K 기준으로 14장이 돌아온 호출은 94.8초와 110.6초, 3장이 돌아온 호출은 34.8초가 걸렸습니다. 동기식 호출이라 그동안 연결을 유지해야 하므로 클라이언트 타임아웃을 300초 이상으로 두고, 필요한 요소만 지정해 장수를 줄이는 것이 시간을 줄이는 방법입니다.