Qwen-Image-2.1은 2026년 9월 20일 공개된 오픈 가중치 이미지 모델로, 텍스트→이미지 생성과 이미지 편집을 하나의 모델로 처리하고 알파 채널이 있는 투명 이미지를 바로 만들어 냅니다. 로컬에서 돌리는 가장 짧은 길은 최신 ComfyUI(nightly)에 공식 int8 파일 세 개(합계 약 17.3GB)를 넣고 공식 템플릿을 여는 것입니다. 공식 문서 어디에도 최소 VRAM 수치는 없지만, 제3자 보고를 종합하면 24GB 카드는 bf16까지 여유가 있고, 16GB 카드는 int8 조합으로 1024² 생성이 약 13.9GB 안에서 돌았고, 4비트 양자화로 최대 약 7GB까지 내려간 사례도 있으며, 8~12GB 카드용 GGUF 변환본이 이미 나와 있습니다. 다만 8GB에서는 참조 이미지를 넣는 순간 메모리가 튀어 튕겼다는 보고도 있으므로, 이 글은 각 수치의 출처와 조건을 그대로 붙여 두었습니다.
이 글은 2026년 9월 22일 기준 Qwen 공식 저장소, ComfyUI 공식 튜토리얼, Hugging Face 파일 목록, 그리고 조건이 명시된 제3자 실측만을 근거로 합니다. 본 블로그가 직접 측정한 수치는 없습니다.
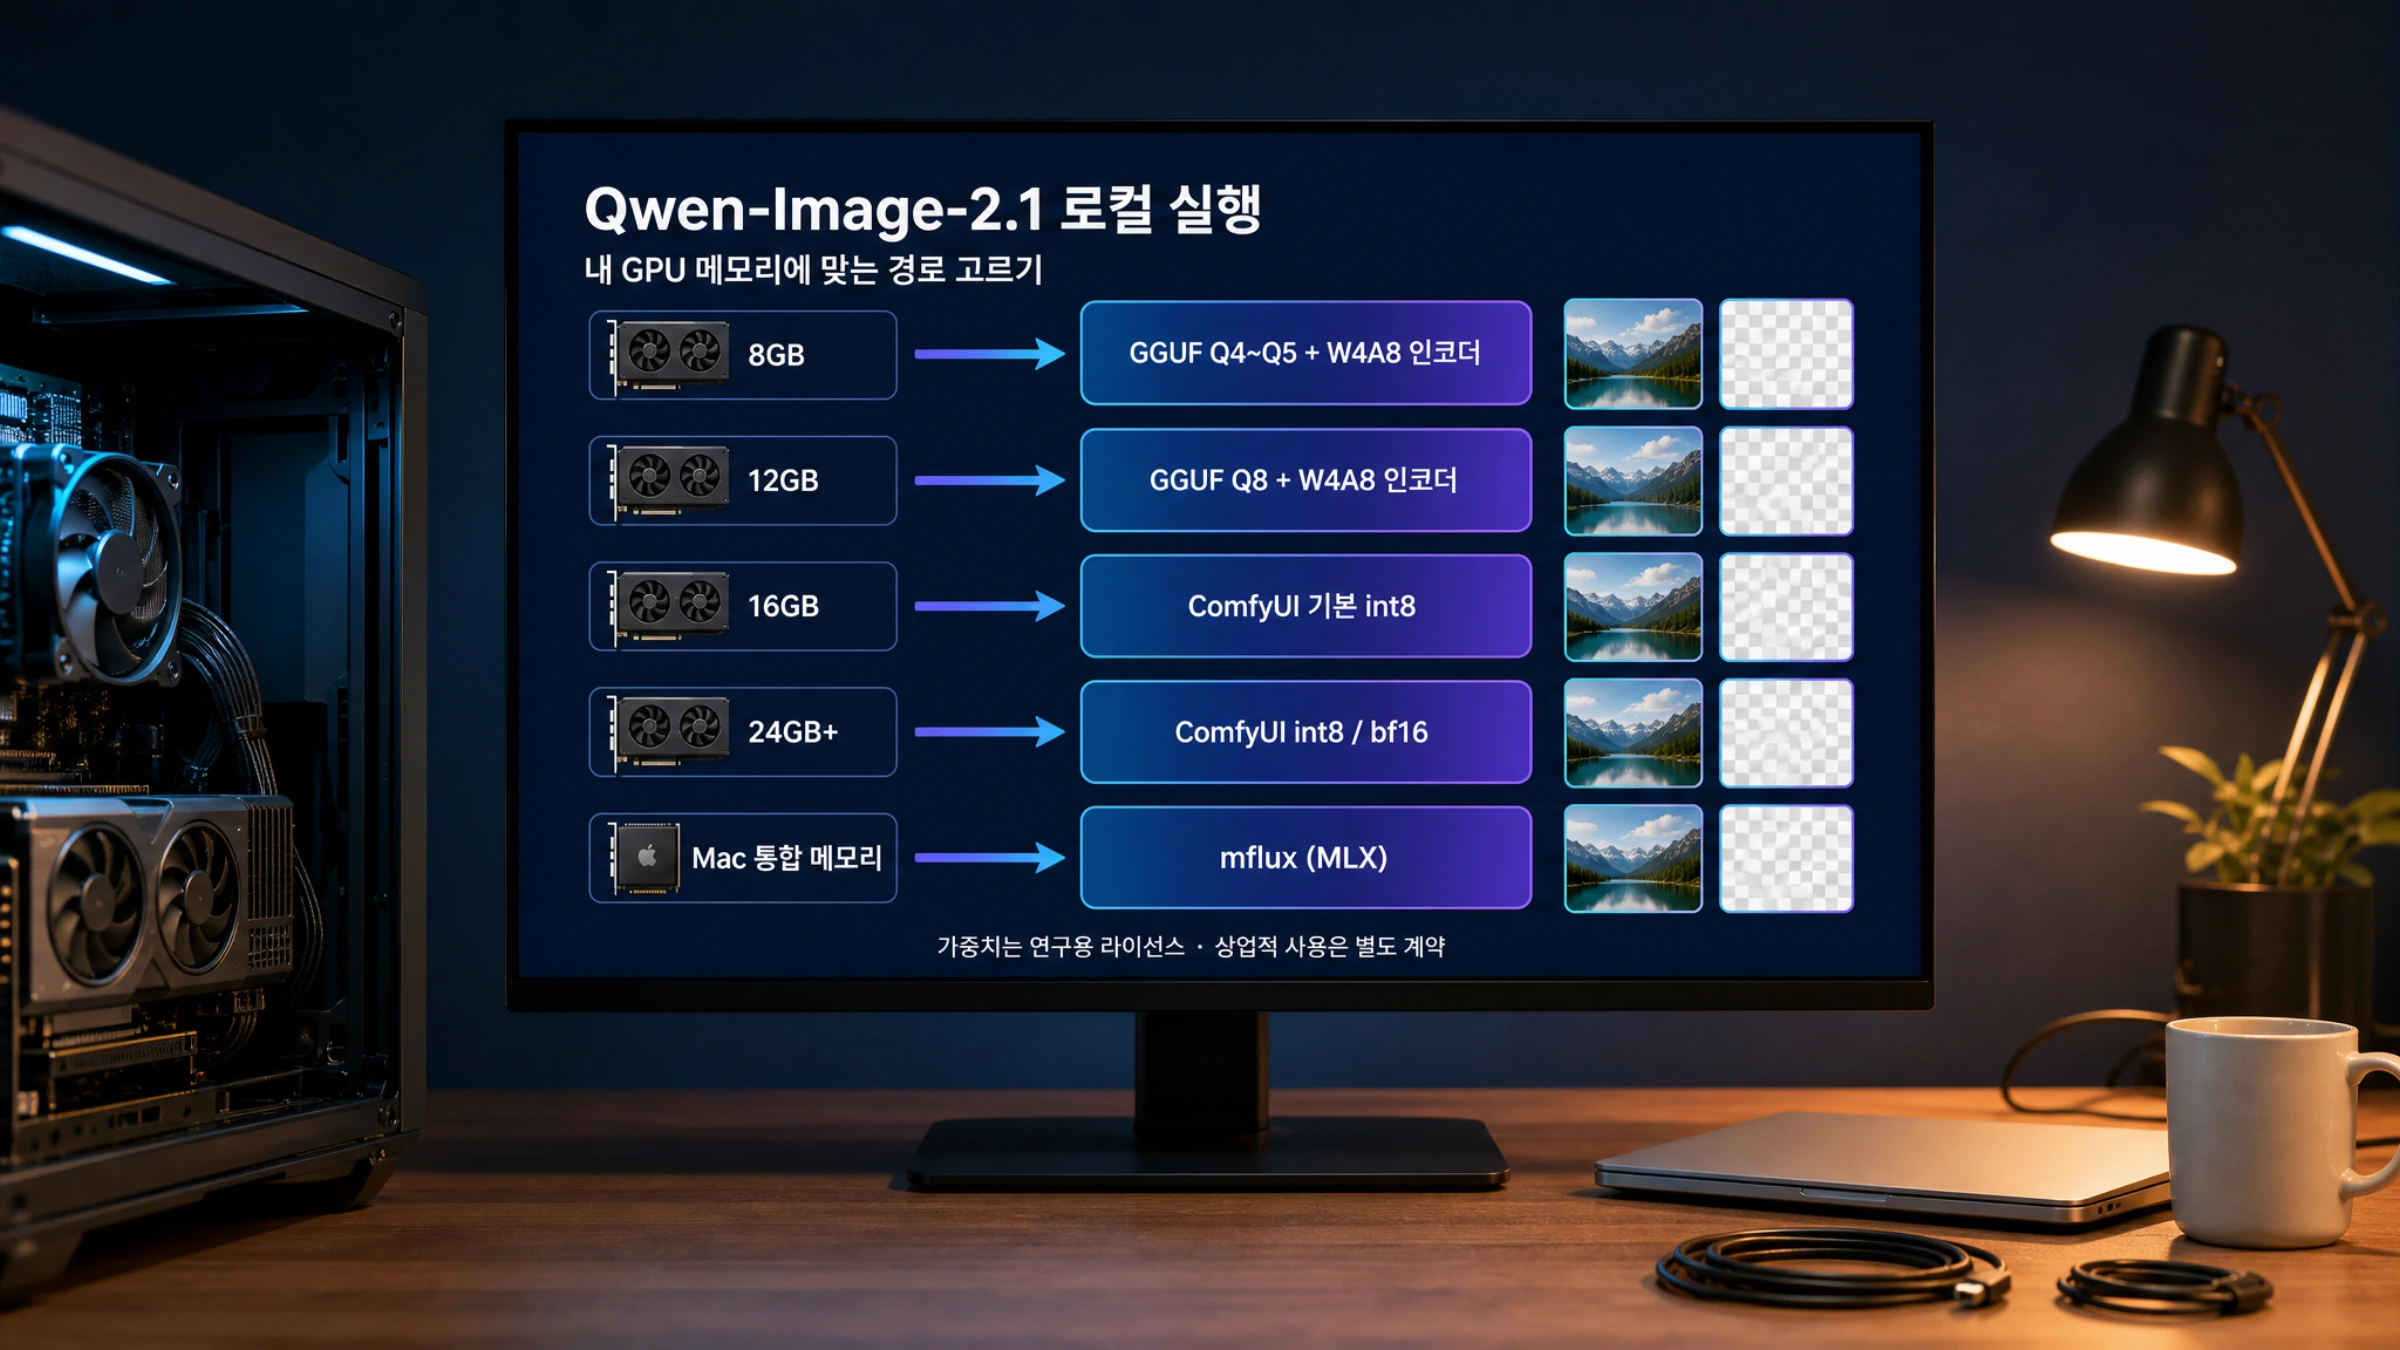
먼저 결론: 내 메모리에 맞는 경로
VRAM(또는 Mac 통합 메모리)만 알면 아래 표에서 시작점을 고를 수 있습니다. 파일 크기는 Hugging Face API가 알려 주는 디스크 용량(십진 GB)이며, 실행 중 VRAM과는 다릅니다.
| 내 하드웨어 | 권장 경로 | 받을 파일 조합 | 다운로드 용량 | 다른 사람들의 관찰 |
|---|---|---|---|---|
| NVIDIA 24GB 이상 (RTX 3090/4090/5090) | ComfyUI 기본 int8, 필요하면 bf16 | int8 DiT + int8 인코더 + VAE, 또는 bf16 DiT | 17.3GB (int8) / 24.3GB (bf16 DiT + int8 인코더) | RTX 4090 bf16 상주 약 30.2GB(시스템 합계), 1024² 약 21초 AIReiter 수집 보고 |
| NVIDIA 16GB (RTX 4060 Ti 16GB / 4070 Ti Super / 5070 Ti) | ComfyUI 기본 int8 | int8 DiT + int8 인코더 + VAE | 17.3GB | RTX 5070 Ti, 1024², 20스텝, 약 25초, 최대 약 13.9GB(양자화 미기재) 같은 출처 |
| NVIDIA 12GB (RTX 3060 12GB / 4070) | ComfyUI + GGUF Q8_0 또는 Q6_K, W4A8 인코더 | GGUF DiT + w4a8 인코더 + VAE | 약 12.8~14.6GB | 업로더 권장 구간이며 실측 아님 AlperKTS GGUF 카드 |
| NVIDIA 8GB (RTX 3050/4060 8GB) | ComfyUI + GGUF Q4_K_M~Q5_K_M, W4A8 인코더, 낮은 해상도 | GGUF DiT + w4a8 인코더 + VAE | 약 11.6~11.9GB | 4비트 nf4로 약 7GB 성공 사례와 Q4_K_M이 이미지 입력 시 튕긴 사례가 함께 있음 (아래 조건 비교) |
| Apple Silicon 64GB 이상 | mflux bf16 또는 -q 8 | mflux가 변환하는 가중치 (용량 미확인) | - | M5 Max, 1024², 40스텝: bf16 최대 약 46GB·약 78초, -q 8 약 30.7GB mflux PR #736 |
| Apple Silicon 32GB 이하 | mflux -q 4 또는 커뮤니티 MLX q4 팩, 기대치 낮추기 | DiT 4.00GB + 인코더 6.02GB + VAE 0.68GB | 약 10.7GB | 32GB 모델은 실사용 가능 메모리가 약 20GB라며 64GB를 권한 일본 가이드 있음 negi-lab |
| 상업적 사용이 목적 | 로컬 실행과 별개로 라이선스 확인 | - | - | 가중치는 연구용 라이선스이며 상업적 사용에는 별도 계약 필요 (마지막 절) |
VRAM이 16GB 이상이고 ComfyUI를 쓸 줄 안다면 바로 "ComfyUI 기본 경로" 절로 가면 됩니다. 8~12GB라면 "GGUF" 절을, 코드로 파이프라인을 제어하고 싶다면 "Diffusers" 절을, Mac이라면 "Apple Silicon" 절을 읽으세요.
메모리를 먹는 것은 생성부보다 텍스트 인코더입니다
경로를 고르기 전에 모델 구성을 알아 두면 왜 어떤 파일이 크고 어떤 최적화가 효과적인지 이해할 수 있습니다. Qwen-Image-2.1은 세 부분으로 나뉩니다.
- 시각 생성부(DiT): 7B 파라미터, 32개의 Single-Stream DiT 레이어. bf16 파일이 14.23GB, int8이 7.26GB입니다.
- 텍스트 인코더: Qwen3-VL 8B. bf16이 17.53GB로 생성부보다 큽니다. 프롬프트와 참조 이미지를 이 인코더가 읽습니다.
- VAE: 64채널 RGBA 오토인코더로 알파 채널을 직접 다룹니다. 0.68GB입니다.
즉 "7B 모델이니 가볍겠다"는 기대는 절반만 맞습니다. 8B 인코더가 함께 올라가야 하므로, 이 인코더를 어떻게 다루느냐가 VRAM을 좌우합니다. vLLM-Omni 팀의 데이터센터 측정에서는 1024², 40스텝 기준 bf16 최대 34.0GB가 인코더만 FP8로 바꾸면 27.5~28.1GB로 약 6GB 줄었지만, DiT를 FP8로 바꿔서는 약 2GB밖에 줄지 않았습니다. vLLM-Omni 레시피 소비자용 카드에서도 같은 원리가 적용됩니다. ComfyUI가 기본으로 int8 인코더(9.35GB)와 더 작은 W4A8 인코더(6.31GB)를 따로 배포하는 이유, GGUF 가이드가 인코더를 시스템 RAM으로 내리라고 권하는 이유가 여기 있습니다.
또 하나 알아 둘 특징은 프리픽스 KV 캐시입니다. 조건 이미지와 지시문은 첫 스텝에서 한 번만 인코딩되고 이후 스텝에서 재사용됩니다(causal_condition: true 기본값). 편집 작업에서 참조 이미지를 여러 장 넣어도 매 스텝 다시 읽지 않으므로 속도에 유리하지만, 첫 스텝의 메모리 피크는 참조 이미지 수와 크기에 따라 올라갑니다. 8GB 카드에서 "생성은 되는데 편집에서 튕긴다"는 보고는 이 구조와 맞물립니다.
ComfyUI 기본 경로: 파일 세 개와 공식 템플릿
Comfy-Org가 배포하는 공식 가중치를 그대로 쓰는 경로입니다. 저장소 전체(74GB 이상)를 받을 필요 없이 생성부 하나 + 텍스트 인코더 하나 + VAE 하나만 고르면 됩니다. 크기는 2026년 9월 22일 Hugging Face API 기준입니다. Comfy-Org/Qwen-Image-2.1
| 폴더 | 파일 | 크기 | 비고 |
|---|---|---|---|
ComfyUI/models/diffusion_models/ | qwen_image_2.1_int8_convrot.safetensors | 7.26GB | 템플릿 기본값 |
ComfyUI/models/diffusion_models/ | qwen_image_2.1_bf16.safetensors | 14.23GB | 공식 문서 표현으로 "더 많은 VRAM 필요" |
ComfyUI/models/text_encoders/ | qwen3vl_8b_int8_convrot.safetensors | 9.35GB | 템플릿 기본값 |
ComfyUI/models/text_encoders/ | qwen3vl_8b_w4a8.safetensors | 6.31GB | 공식 배포 중 가장 작은 인코더 |
ComfyUI/models/text_encoders/ | qwen3vl_8b_bf16.safetensors | 17.53GB | 전체 정밀도 |
ComfyUI/models/text_encoders/ | qwen3.5_9b_qwen_image_2.1_pe_t2i.int8_convrot.safetensors | 9.47GB | 선택, 프롬프트 재작성용으로 추정 |
ComfyUI/models/text_encoders/ | qwen3.5_9b_qwen_image_2.1_pe_i2i.int8_convrot.safetensors | 9.47GB | 선택, 편집 프롬프트용으로 추정 |
ComfyUI/models/vae/ | qwen_image_2.1_vae_bf16.safetensors | 0.68GB | 필수, 하나뿐 |
기본 조합(int8 DiT + int8 인코더 + VAE)은 7.26 + 9.35 + 0.68 = 약 17.3GB, 가장 작은 공식 조합(int8 DiT + W4A8 인코더 + VAE)은 약 14.3GB입니다. PE 파일 두 개는 이름으로 보아 프롬프트 재작성 모델의 ComfyUI 버전이지만, 공식 튜토리얼에 그 역할이 설명돼 있지 않으므로 처음에는 받지 않아도 됩니다.
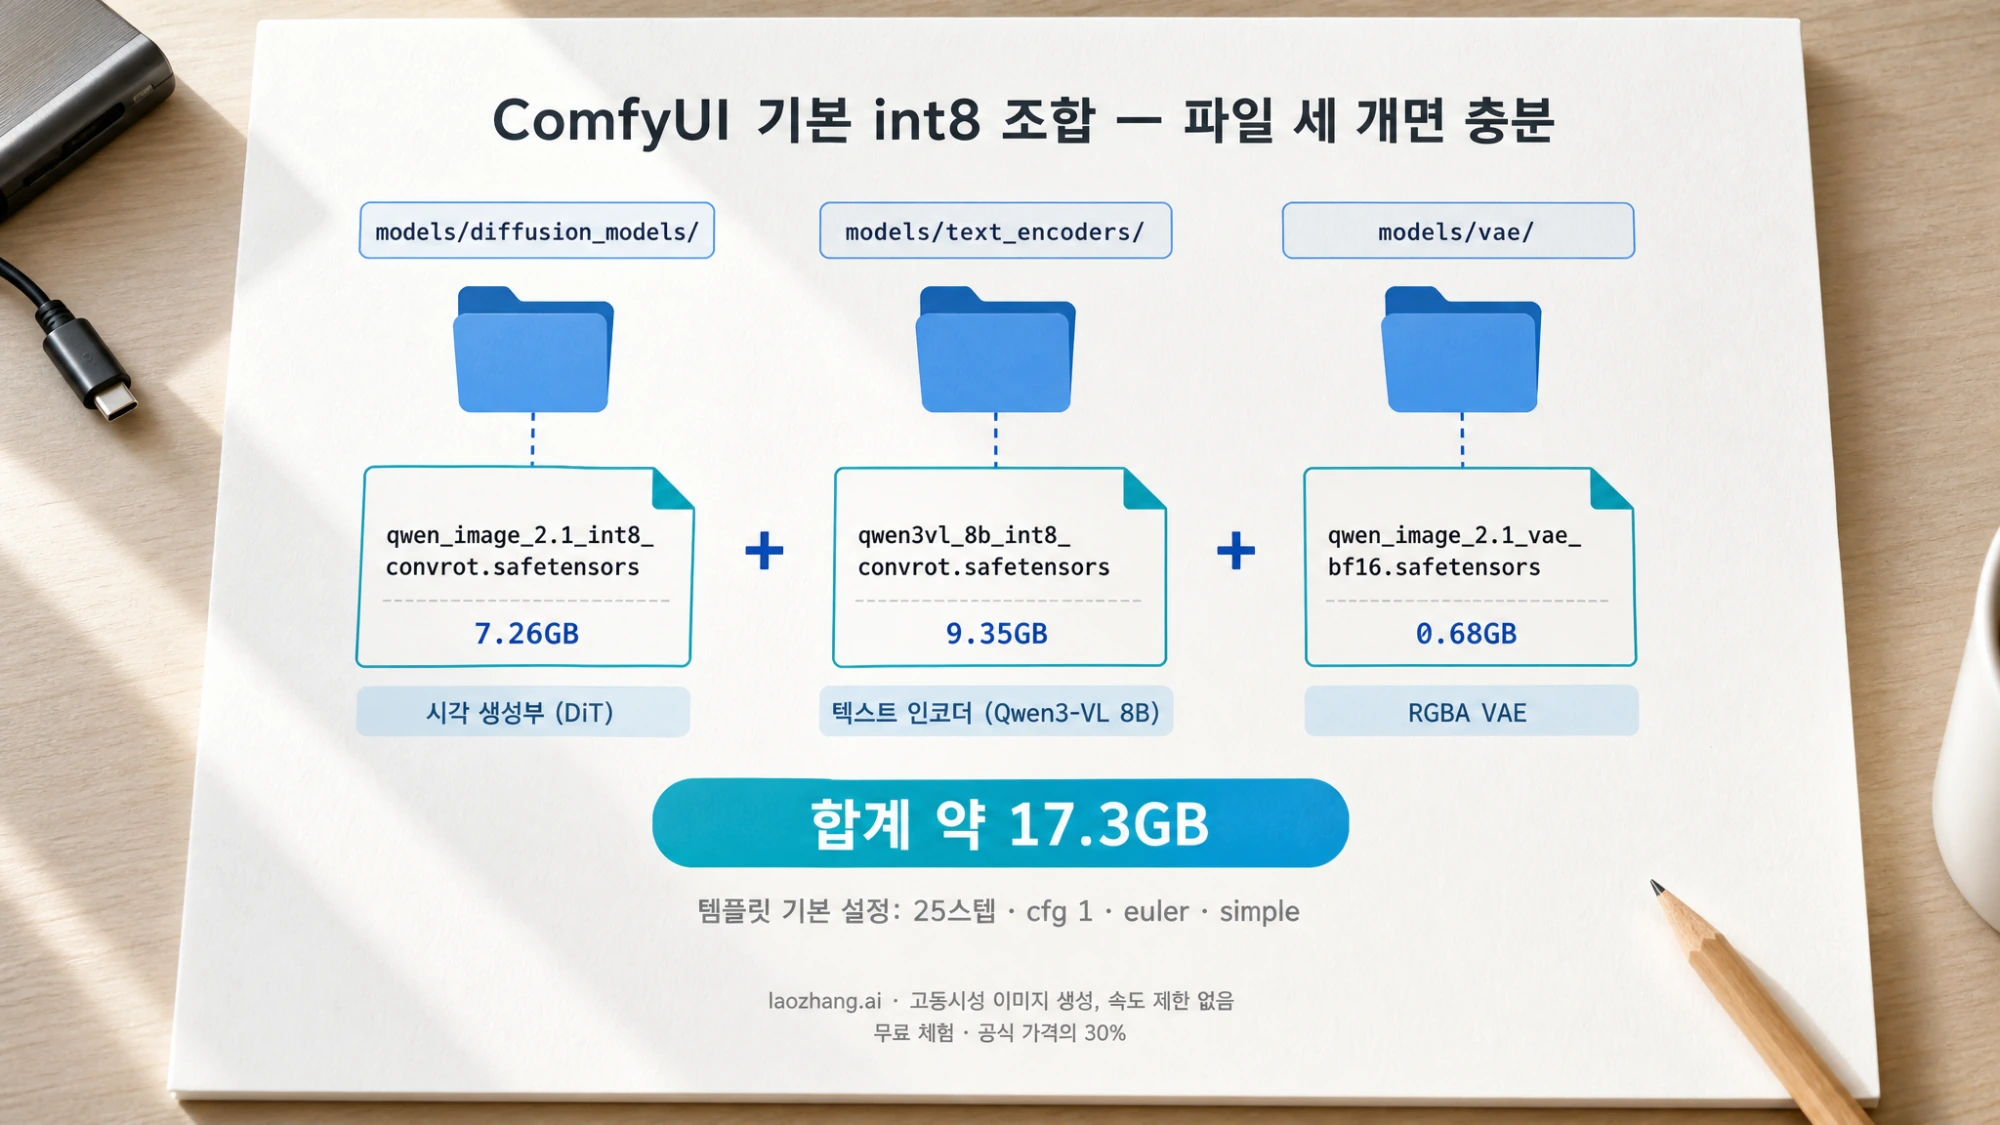
설치와 실행 순서는 다음과 같습니다. ComfyUI 공식 튜토리얼
- ComfyUI를 최신 nightly로 업데이트합니다. 템플릿이 새 코어 노드(
Text Encode Qwen Image 2.1,Qwen Image 2.1 Cache)를 쓰기 때문에 안정판 릴리스에서는 노드가 빨간색으로 뜰 수 있습니다. - 위 표에서 고른 파일 세 개를 각 폴더에 넣습니다.
- 템플릿 라이브러리에서
Qwen-Image-2.1 Text to Image를 엽니다. 편집은Qwen Image 2.1 Image Edit, 배경 제거는Remove Background: Qwen Image 2.1입니다. - 로더 노드에서 파일 이름이 방금 받은 파일과 일치하는지 확인하고 실행합니다.
세 템플릿 모두 25스텝, cfg 1, 샘플러 euler, 스케줄러 simple로 설정돼 있습니다. cfg 1은 이 모델의 의도된 설정이므로 SDXL 습관대로 7로 올리지 마세요. 텍스트→이미지 템플릿은 종횡비와 메가픽셀 목표를 고르게 돼 있고 기본은 2048×2048 근처(약 4.0MP)입니다. 16GB 카드에서 첫 실행이 느리거나 메모리가 빠듯하면 메가픽셀 목표를 1~2MP로 낮춰 보세요. 위 표의 5070 Ti 약 13.9GB 보고도 1024² 조건입니다.
편집 템플릿에서는 참조 이미지를 슬롯 순서대로 넣고 프롬프트에서 <image1>, <image2>처럼 번호로 지목합니다. 모델은 최대 10장의 참조 이미지를 받습니다. 수정 부위는 원본에 원이나 색으로 표시하거나, 원본과 별도 마스크를 두 입력으로 넣는 방식 모두 지원됩니다. Qwen-Image-2.1 README
배경 제거 템플릿은 별도의 매팅 노드 없이 편집 지시문 Remove the background, and output a PNG image만으로 알파 채널이 있는 결과를 냅니다. VAE가 4채널이라 가능한 것이므로, 다른 VAE 파일을 잘못 연결하면 투명 출력이 되지 않습니다.
GGUF 경로: 8~12GB 카드에서 돌리기
공식 int8 조합이 부담스러운 카드는 커뮤니티가 변환한 GGUF 생성부를 씁니다. 주의할 점은 GGUF는 생성부(DiT)만 바꾼다는 것입니다. 텍스트 인코더와 VAE는 여전히 위 표의 safetensors 파일이 필요하므로, 총 다운로드는 GGUF 크기 + 인코더 + 0.68GB입니다.
2026년 9월 22일 기준 확인된 변환본 두 곳의 크기입니다. 둘 다 Qwen이나 Comfy-Org의 공식 배포가 아닙니다.
| 저장소 | Q4_0 | Q4_K_M | Q5_K_M | Q6_K | Q8_0 |
|---|---|---|---|---|---|
| AlperKTS/Qwen-Image-2.1-GGUF (9월 20일) | - | - | 4.89GB | 5.84GB | 7.62GB |
| JohnsonHsu/Qwen-Image-2.1-GGUF (9월 22일) | 4.05GB | 4.60GB | 5.22GB | 5.88GB | 7.59GB |
AlperKTS 카드는 12GB 이상에 Q8_0, 8~12GB에 Q6_K, 8GB에 Q5_K_M을 제안하지만 이는 업로더의 권장 구간이지 측정치가 아닙니다. Q4 계열은 업로더 스스로 품질 저하를 언급하므로, 12GB 카드라면 Q8_0부터 시도하고 내려오는 편이 낫습니다. 가장 가벼운 조합인 Q4_K_M + W4A8 인코더 + VAE는 4.60 + 6.31 + 0.68 = 약 11.6GB 다운로드입니다.
로더 설정은 다음과 같습니다.
ComfyUI/custom_nodes/에 ComfyUI-GGUF를 클론하고pip install --upgrade gguf를 실행합니다. city96/ComfyUI-GGUF- GGUF 파일을
ComfyUI/models/unet/(또는diffusion_models/)에 넣습니다. - 공식 텍스트→이미지 템플릿에서 생성부 로더를
Unet Loader (GGUF)로 바꾸고, 인코더와 VAE 로더는 그대로 둡니다.
실행 시 Unknown model architecture! 오류가 나면 ComfyUI-GGUF 노드가 Qwen-Image-2.1 아키텍처를 아직 모르는 오래된 버전입니다. 노드를 최신으로 업데이트하거나, 한 가이드가 안내하듯 leejet 포크를 대신 쓰면 해결됐다고 보고됐습니다. Local Model Watch 안내 같은 가이드는 텍스트 인코딩이 프롬프트당 한 번만 일어나므로 인코더를 시스템 RAM으로 내려도 생성 속도에 거의 영향이 없다고 설명합니다. 8GB 카드라면 이 방식이 가장 먼저 시도할 옵션입니다.
8GB에 대한 보고는 서로 엇갈리므로 조건을 나란히 두겠습니다.
- Google Colab에서 Diffusers + bitsandbytes 4비트(nf4)를 생성부와 인코더에 모두 적용했을 때 최대 약 7GB로 텍스트→이미지가 성공했습니다. Zenn kun432 실측 이 경우는 참조 이미지 없이 생성만 한 조건입니다.
- 일본 가이드 저자는 Q4_K_M이 8GB에서 "이론상 뜨지만" 이미지를 입력하는 순간 VRAM이 튀어 튕겼다고 썼습니다. negi-lab 편집 작업에서 참조 이미지가 인코더를 통과하며 피크가 올라가는 조건입니다.
정리하면 8GB 카드에서 생성은 낮은 해상도와 4비트 조합으로 가능성이 있고, 참조 이미지를 넣는 편집은 인코더 오프로드와 작은 입력 이미지 없이는 실패할 가능성이 높다고 보는 것이 안전합니다.
Diffusers 경로: 코드로 제어하고 메모리 옵션을 직접 켜기
파이프라인을 스크립트에 넣거나 배치 생성을 하려면 Diffusers가 맞습니다. 대신 이 경로는 bf16 전체 가중치 약 33.1GB(인코더 4샤드 17.5GB + 생성부 2샤드 14.2GB + VAE 1.35GB)를 내려받습니다. Qwen/Qwen-Image-2.1
공식 README의 설치와 기본 생성 코드입니다.
bashpip install "torch>=2.4.0" "transformers>=5.17" accelerate pillow
pip install git+https://github.com/huggingface/diffusers
pythonimport torch
from diffusers import QwenImage21Pipeline

pipe = QwenImage21Pipeline.from_pretrained(
    "Qwen/Qwen-Image-2.1", torch_dtype=torch.bfloat16
)
pipe.enable_model_cpu_offload()  # VRAM이 부족한 GPU용, .to("cuda") 대신

image = pipe(
    prompt="A ceramic mug on a wooden desk, morning light",
    width=1024, height=1024,
    num_inference_steps=40,
).images[0]
image.save("output.png")
두 가지 기본값이 ComfyUI와 다릅니다. Diffusers 기본 스텝은 40이고 기본 해상도는 2048×2048입니다. 파이프라인이 다르므로 충돌이 아니라 각자의 기본값이며, 소비자용 카드에서는 width/height를 명시해 1024²부터 시작하는 편이 안전합니다. 공식 프리셋 해상도는 1:1 2048×2048, 4:3 2400×1792, 3:2 2528×1696, 16:9 2752×1536(세로 비율은 그 반대)입니다.
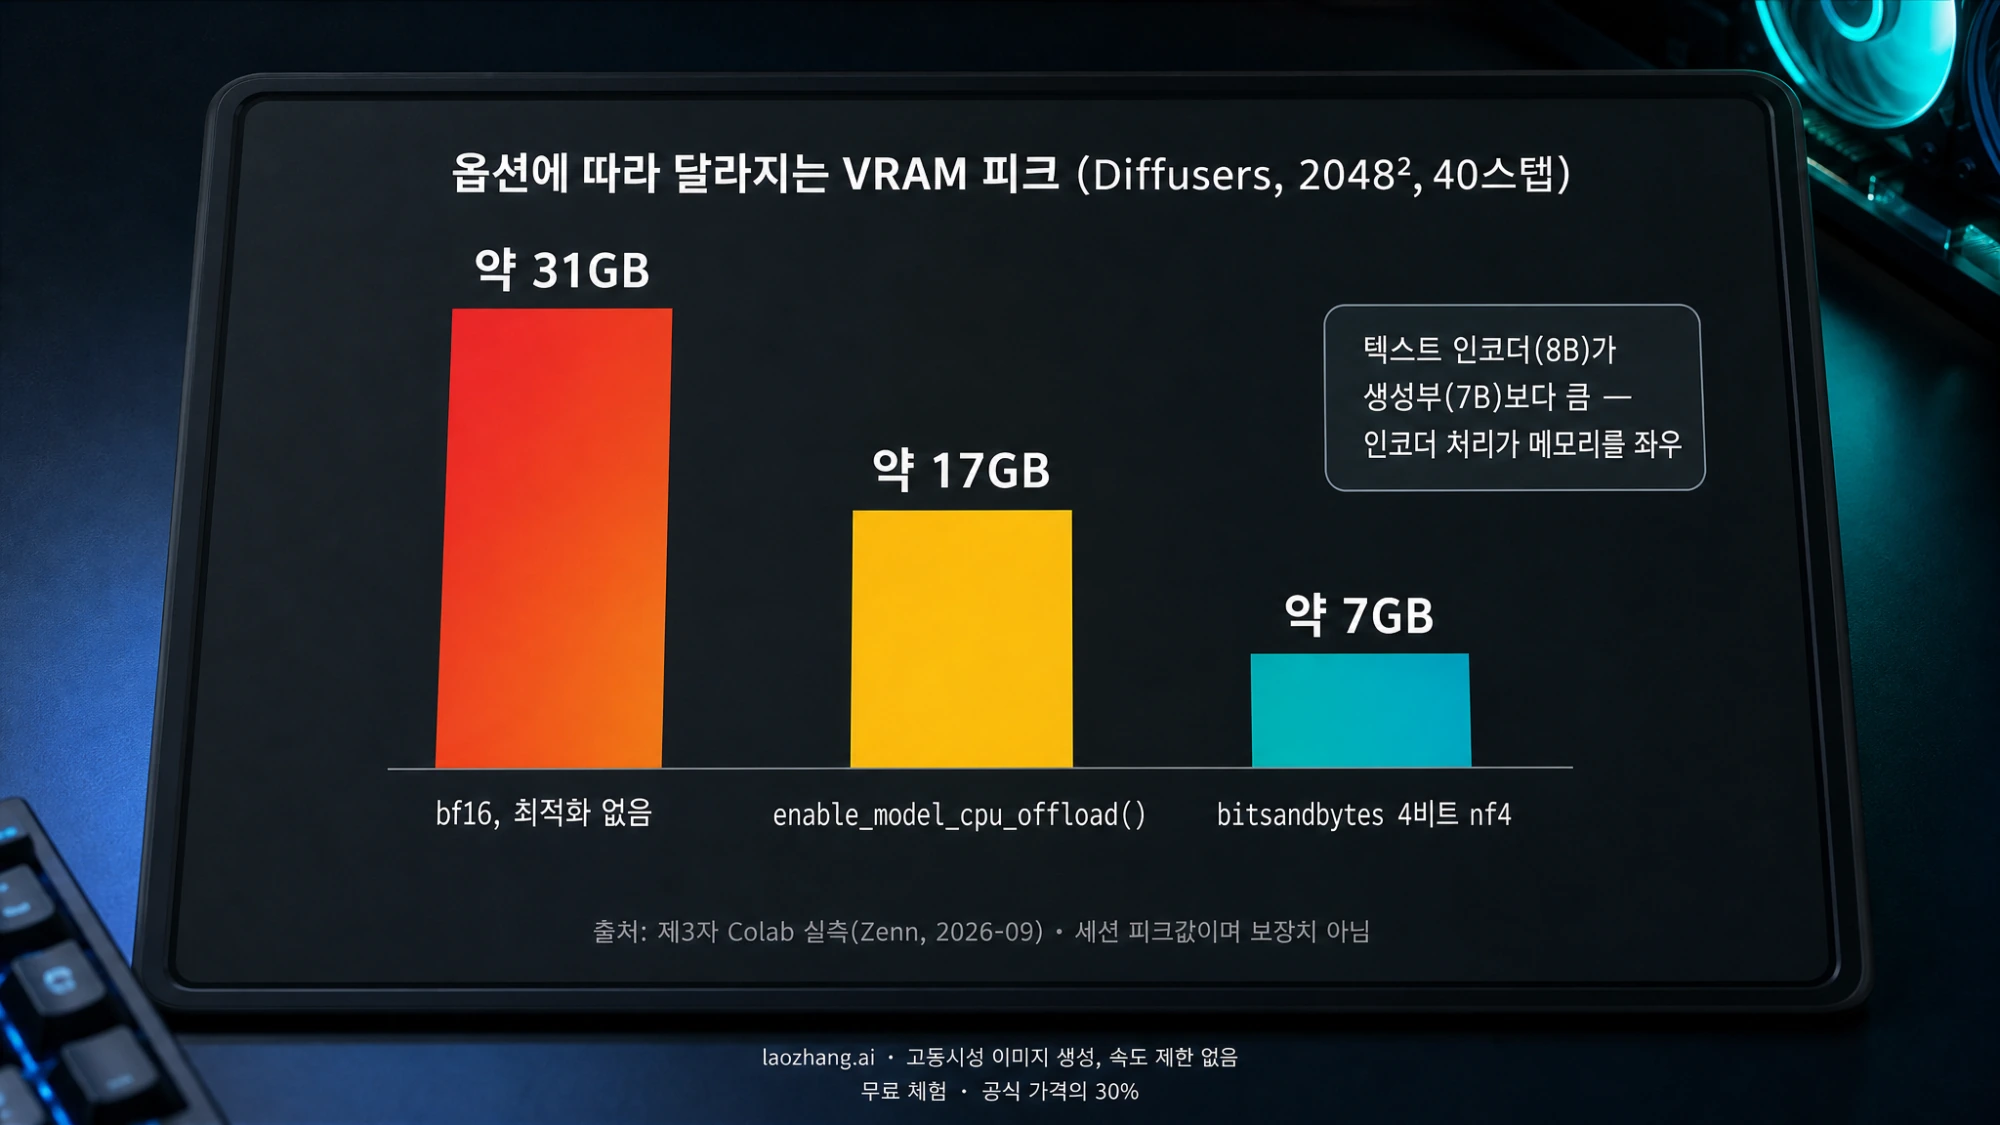
메모리 단계는 Colab에서의 한 실측이 가장 잘 보여 줍니다. 모두 2048×2048, 40스텝 조건이며 한 명의 테스터가 클라우드 GPU에서 얻은 그 세션의 피크값입니다. Zenn kun432 실측
| 설정 | 최대 VRAM | 비고 |
|---|---|---|
| bf16, 최적화 없음 (A100 80GB) | 약 31GB | .to("cuda") 그대로 |
enable_model_cpu_offload() | 약 17GB | 시스템 RAM으로 모듈 단위 오프로드 |
| bitsandbytes nf4, 생성부 + 인코더 | 약 7GB | 특정 레이어 제외 없이 성공 |
| L4 24GB + 오프로드 | OOM | vae.enable_tiling()을 켜야 통과했으나 세로 줄무늬 발생 |
마지막 행은 중요합니다. 2048²에서는 VAE 디코딩 자체가 큰 메모리를 요구해 24GB L4에서도 오프로드만으로는 부족했고, VAE 타일링은 통과시켜 주지만 결과물에 세로 줄 아티팩트가 생겼습니다. 소비자용 카드에서 2048²가 꼭 필요하지 않다면 해상도를 낮추는 것이 타일링보다 나은 해법입니다. 최적화 없는 A100에서는 같은 조건(2048², 40스텝)에 약 1분이 걸렸고, V100은 오프로드·타일링 실험에만 쓰여 별도 시간 측정이 없습니다.
편집은 같은 파이프라인에 image=로 PIL 이미지 하나 또는 최대 10장의 리스트를 넘기면 됩니다. 투명 이미지는 프롬프트 템플릿을 지켜야 합니다.
textThis is an RGBA image with transparency. <설명>. The image has alpha channel and the background is transparent.
결과는 반드시 PNG로 저장해야 알파가 남습니다. JPEG로 저장하면 투명도가 사라집니다.
프롬프트 재작성 모델 Qwen/Qwen-Image-2.1-PE-T2I와 -PE-I2I는 짧은 프롬프트를 상세 사양으로 확장해 주는 별도 LLM으로, vLLM이나 저장소의 prompt_rewrite/ 스크립트로 돌립니다. PE-I2I는 bf16 4샤드 약 18.8GB이므로 두 번째 모델을 올릴 메모리가 필요합니다. 위 Colab 실측자는 PE 모델을 거치자 특히 영어가 아닌 프롬프트의 해석이 눈에 띄게 좋아졌다고 썼습니다. 한국어로 짧게 쓰는 편이라면 첫 결과가 기대에 못 미칠 때 PE 모델을 붙이는 것이 다음 단계입니다.
Apple Silicon 경로: mflux와 통합 메모리 기대치
Mac에서는 Diffusers의 .to("cuda") 경로를 그대로 쓸 수 없습니다. 공식 README는 MPS를 언급하지 않으며, 현재 실질적인 경로는 MLX 기반의 mflux입니다. 2026년 9월 21일 병합된 PR #736이 mflux-generate-qwen-2.1 명령을 추가했고, 텍스트→이미지와 이미지→이미지, 양자화 옵션 -q 8 / -q 4를 지원합니다. 텍스트 인코더는 양자화 옵션과 무관하게 bf16으로 남습니다. mflux PR #736
PR 작성자와 리뷰어가 보고한 수치입니다. 모두 1024², 40스텝이며 통합 메모리 기준입니다.
| 기기 | 설정 | 스텝당 | 전체 | 최대 메모리 |
|---|---|---|---|---|
| M5 Max | bf16 | 약 1.5초 | 약 78초 | 약 46GB |
| M5 Max | -q 8 | - | - | 약 30.7GB |
| M3 Ultra | bf16 | 약 2.95초 | 약 2분 | - |
이 수치가 말해 주는 것은 명확합니다. bf16은 64GB 이상, -q 8은 48GB급에서 여유가 있으며, 32GB Mac은 -q 4나 커뮤니티 MLX q4 팩이 현실적인 선택입니다. 커뮤니티 팩 toxicdog/Qwen-Image-2.1-MLX는 DiT 4.00GB + 인코더 6.02GB + VAE 0.68GB로 약 10.7GB이지만, 이 팩의 실행 메모리나 품질은 확인된 실측이 없습니다. 일본 가이드 저자는 32GB 모델에서 OS를 빼면 실사용 가능 메모리가 약 20GB라며 64GB를 권했는데, 이는 저자의 경험에 기반한 의견입니다. negi-lab
병합 시점의 PR에서 편집(지시문) 변형, LoRA, 프리픽스 KV 캐시는 보류됐습니다. 이후 PR #741 제목이 참조 편집·RGBA·프리픽스 캐시 추가를 언급하지만 이 글에서 내용을 직접 확인하지는 못했으므로, Mac에서 참조 이미지 편집이나 투명 출력이 필요하다면 설치 전에 mflux 릴리스 노트를 확인하세요. Draw Things의 2.1 지원 여부도 확인되지 않았습니다.
다른 사람들이 측정한 VRAM과 속도 한눈에
위 절들에 흩어진 수치를 한 표로 모았습니다. 모두 제3자 보고이며 조건이 다르므로 서로 직접 비교하지 말고, 자기 카드와 가장 가까운 행을 참고하세요.
| 하드웨어 | 경로 / 정밀도 | 해상도 · 스텝 | VRAM 또는 메모리 | 시간 | 출처 |
|---|---|---|---|---|---|
| RTX 5090 32GB | SGLang-Diffusion, 인코더 스트리밍 | 1024px · 40 | - | 14.12초 | SGLang 쿡북 |
| RTX 4090 24GB | bf16 | 1024² / 1536² · 스텝 미기재 | 약 30.2GB (시스템 합계) | 약 21초 / 약 56초 | AIReiter 수집 |
| RTX 5070 Ti 16GB | 양자화 미기재 | 1024² · 20 | 최대 약 13.9GB | 약 25초 | 같은 출처, X 사용자 보고 |
| A100 80GB (Colab) | Diffusers bf16 → 오프로드 → nf4 | 2048² · 40 | 약 31GB → 약 17GB → 약 7GB | A100 무최적화 기준 약 1분 | Zenn kun432 |
| M5 Max | mflux bf16 / -q 8 | 1024² · 40 | 약 46GB / 약 30.7GB | 약 78초 | mflux PR #736 |
| GB200/GB300 | vLLM-Omni bf16 / 인코더 FP8 | 1024² · 40 | 34.0GB / 27.5~28.1GB | 3.3~4.5초 | vLLM-Omni 레시피 |
RTX 4090을 서버 방식으로 돌리려면 SGLang 쿡북이 --performance-mode manual --dit-layerwise-offload true --text-encoder-cpu-offload true 플래그를, 5090에는 --component-residency text_encoder=layerwise-offload를 권합니다. 5090 측정에서 인코더를 스트리밍한 쪽(14.12초)이 DiT를 스트리밍한 쪽(19.95초)보다 빨랐다는 점은, 앞서 말한 "인코더를 어떻게 다루느냐"가 속도에도 영향을 준다는 방증입니다.
24GB 카드가 없고 새로 살 계획이라면, 위 표에서 16GB 카드가 int8 조합으로 실용 범위에 든다는 점을 참고하세요. 16GB급 GPU 선택 기준은 로컬 LLM 코딩용 16GB GPU 선택에서 LLM 관점으로 정리한 내용과 겹치는 부분이 많습니다.
라이선스: 상업적 사용 전에 반드시 확인할 것
Qwen-Image-2.1 가중치는 Qwen Research License Agreement로 배포됩니다. 이전 세대 Qwen-Image-2512가 Apache 2.0이었기 때문에 같은 조건으로 오해하기 쉽지만, 2.1은 다릅니다. LICENSE 원문
- 사용·복제·배포·수정은 비상업적 목적(연구 또는 평가)에 한해 허용됩니다.
- 상업적 목적으로 쓰려면 별도의 상업 라이선스가 필요하며, 연락처는
model-business@notice.qwencloud.com입니다. - 재배포(GGUF·MLX 변환본 포함)는 계약서를 함께 넣고, 수정 파일을 표시하고, "Built with Qwen" 또는 "Improved using Qwen"을 표기해야 하며, 파생물의 주 이름으로 "Qwen"을 쓸 수 없습니다.
- 라이선스 본문에는 생성된 이미지(출력물)에 대한 명시적 조항이 없습니다.
출력물에 대해서는 Qwen 개발팀이 2026년 9월 21일 X에 "출력물은 라이선스 대상 자료가 아니며 사용자가 생성 이미지의 권리를 보유한다"는 취지로 밝혔다고 전해집니다. 다만 이 글에서는 해당 게시글을 직접 확인하지 못했고(검색 요약으로만 확인), Hugging Face 토론에서는 소셜 게시글이 LICENSE 파일을 대체할 수 없다는 반론이 나왔습니다. Hugging Face 토론 #6 취미 목적의 개인 사용이 "연구 또는 평가"에 해당하는지도 그 토론에서 결론 나지 않았습니다.
실무적으로는 이렇게 나뉩니다. 개인적으로 시험하고 결과를 SNS에 올리는 정도라면 연구·평가 범위로 보는 사람이 많지만, 모델을 돌려 고객에게 이미지를 납품하거나 서비스에 넣는 것은 별도 라이선스 없이는 계약 위반 위험이 있습니다. 이 글은 법률 자문이 아니므로, 수익이 걸린 용도라면 위 연락처로 문의하거나 법률 검토를 받으세요.
상업적 사용이 목적이거나 하드웨어가 모자란다면 로컬 실행을 고집할 이유가 없습니다. 참고로 laozhang.ai 모델 카탈로그에는 2026년 9월 22일 기준 Qwen 이미지 모델이 없으며, 대신 gemini-3.1-flash-image(호출당 $0.055), flux-2-pro(호출당 $0.03), gpt-image-2.5-flare(입력 100만 토큰당 $5, 출력 100만 토큰당 $30) 같은 상업 이용 가능한 호스팅 모델이 Images와 Chat Completions 엔드포인트로 제공됩니다. laozhang.ai 모델 목록 가격은 수시로 바뀌므로 결제 전에 카탈로그를 다시 확인하세요. ComfyUI 워크플로 안에서 호스팅 모델을 쓰는 방법은 ComfyUI에서 GPT Image 2.5 쓰기에 정리돼 있고, 편집 중심 작업이라면 작업별 이미지 편집 AI 선택 가이드에서 오픈 가중치 경로와 호스팅 경로를 함께 비교할 수 있습니다.
자주 묻는 질문
llama-server처럼 명령 한 줄로 띄우는 방법이 있나요?
단일 바이너리 형태의 공식 서버는 없습니다. 가장 가까운 것은 SGLang-Diffusion(--num-inference-steps 40 --guidance-scale 1 기본, /v1/images/edits로 PNG 업로드 편집, "background": "transparent"로 RGBA 요청)과 vLLM-Omni인데, 둘 다 NVIDIA 전용이며 24GB 이상 카드에서 오프로드 플래그를 붙여야 합니다. GUI 없이 가볍게 시험만 하려면 Diffusers 스크립트가, 설치 없이 결과만 보려면 공식 Hugging Face Space Qwen/Qwen-Image-2.1이 더 빠릅니다.
LoRA 학습은 어디서 할 수 있나요?
공식 README가 LoRA 학습을 명시한 곳은 ModelScope의 DiffSynth-Studio뿐입니다. 다른 학습 도구의 2.1 지원은 2026년 9월 22일 기준 확인되지 않았고, mflux는 병합 시점에 LoRA를 보류했습니다. 커뮤니티 LoRA가 나오더라도 가중치 파생물이므로 연구용 라이선스가 그대로 적용됩니다.
디스크는 얼마나 비워 둬야 하나요?
가중치만 계산하면 Diffusers bf16 약 33GB, ComfyUI 기본 int8 조합 약 17.3GB, 가장 작은 공식 조합 약 14.3GB, GGUF Q4_K_M + W4A8 인코더 + VAE 약 11.6GB, MLX q4 팩 약 10.7GB입니다. PE 프롬프트 모델은 ComfyUI int8 버전이 각 약 9.5GB, Hugging Face bf16 버전이 약 18.8GB 추가됩니다. 캐시·가상환경·출력물은 별도이므로 여유를 두세요.
투명 PNG는 ComfyUI와 Diffusers 중 어디가 쉽나요?
ComfyUI가 쉽습니다. Remove Background: Qwen Image 2.1 템플릿을 열고 이미지를 넣으면 지시문이 이미 들어 있고, 4채널 VAE가 알파를 그대로 내보냅니다. Diffusers에서는 RGBA 프롬프트 템플릿 문장을 지키고 PNG로 저장해야 하며, 편집으로 배경을 지울 때도 같은 문장을 붙입니다.
텍스트 인코더를 int8이나 W4A8로 바꾸면 결과가 나빠지나요?
공식 튜토리얼은 int8을 기본값으로 삼고 bf16을 "더 많은 VRAM이 필요한" 선택지로 두고 있어, int8은 품질 손실보다 메모리 절약이 우선인 표준 설정으로 볼 수 있습니다. W4A8은 더 공격적인 양자화라 프롬프트 해석이 미묘하게 달라질 수 있지만, 이를 정량 비교한 공개 자료는 확인하지 못했습니다. 8~12GB 카드에서 W4A8로 시작해 결과가 아쉬우면 인코더만 int8로 올리고 시스템 RAM 오프로드로 버티는 것이 순서입니다.