Error 429 de Gemini en imágenes: qué límite saltó y qué hacer
Si el 429 llega en ráfagas, reintenta con espera exponencial. Si no cede, es cuota diaria, tope de gasto o un proyecto sin facturación, y reintentar no sirve.
En esta página
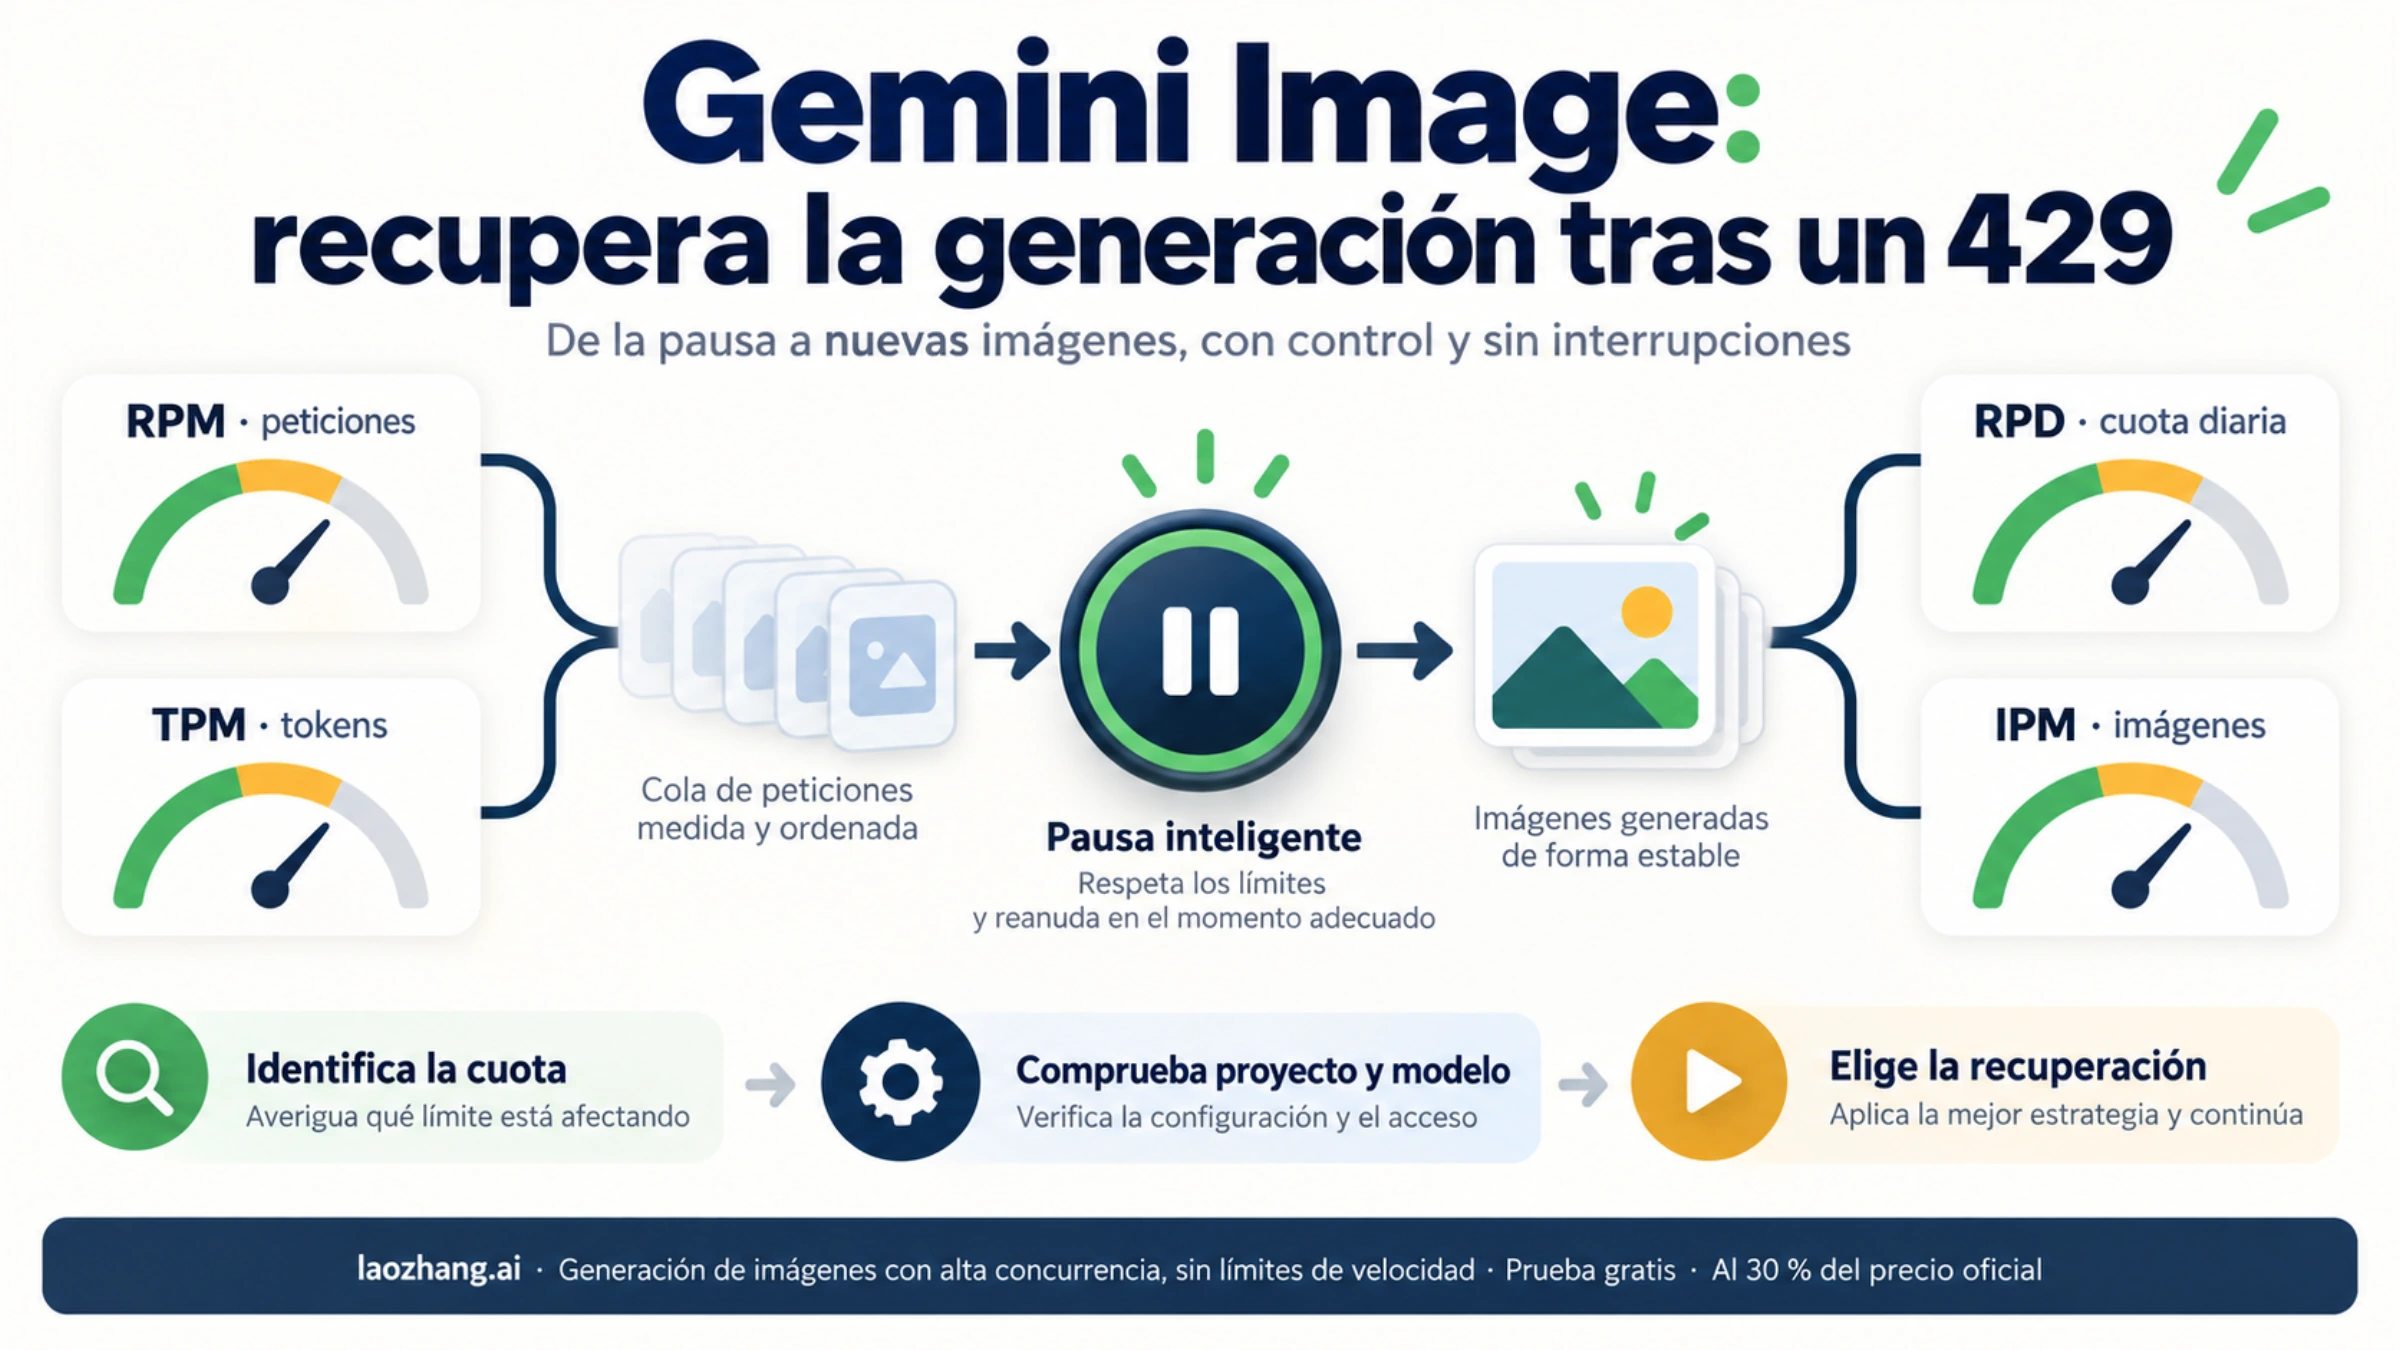
Un 429 (RESOURCE_EXHAUSTED) en Nano Banana 2 Lite, Nano Banana 2 o Nano Banana Pro significa que tu proyecto ha chocado con un límite, no que la imagen esté mal pedida. Lo que cambia es cuál: si el error aparece en ráfagas y desaparece en segundos, es un límite por minuto y basta con reintentar con espera exponencial; si persiste tras varios reintentos, es la cuota diaria, el tope de gasto de 10 minutos o un proyecto que no tiene acceso de pago a imágenes, y reintentar solo acumula fallos. La tabla siguiente te dice cuál es por el síntoma.
Qué 429 tienes: diagnóstico por síntoma
La página de errores de la API de Gemini separa tres variantes del HTTP 429: rate_limit_exceeded (límite de peticiones o tokens por minuto o por segundo), quota_exceeded (cuota diaria) y too_many_requests (demasiadas peticiones en poco tiempo). Con generateContent las verás todas como 429 RESOURCE_EXHAUSTED, así que el patrón temporal y el texto del mensaje son lo que más ayuda.
| Síntoma | Causa probable | Qué hacer | Cuándo vuelve a funcionar |
|---|---|---|---|
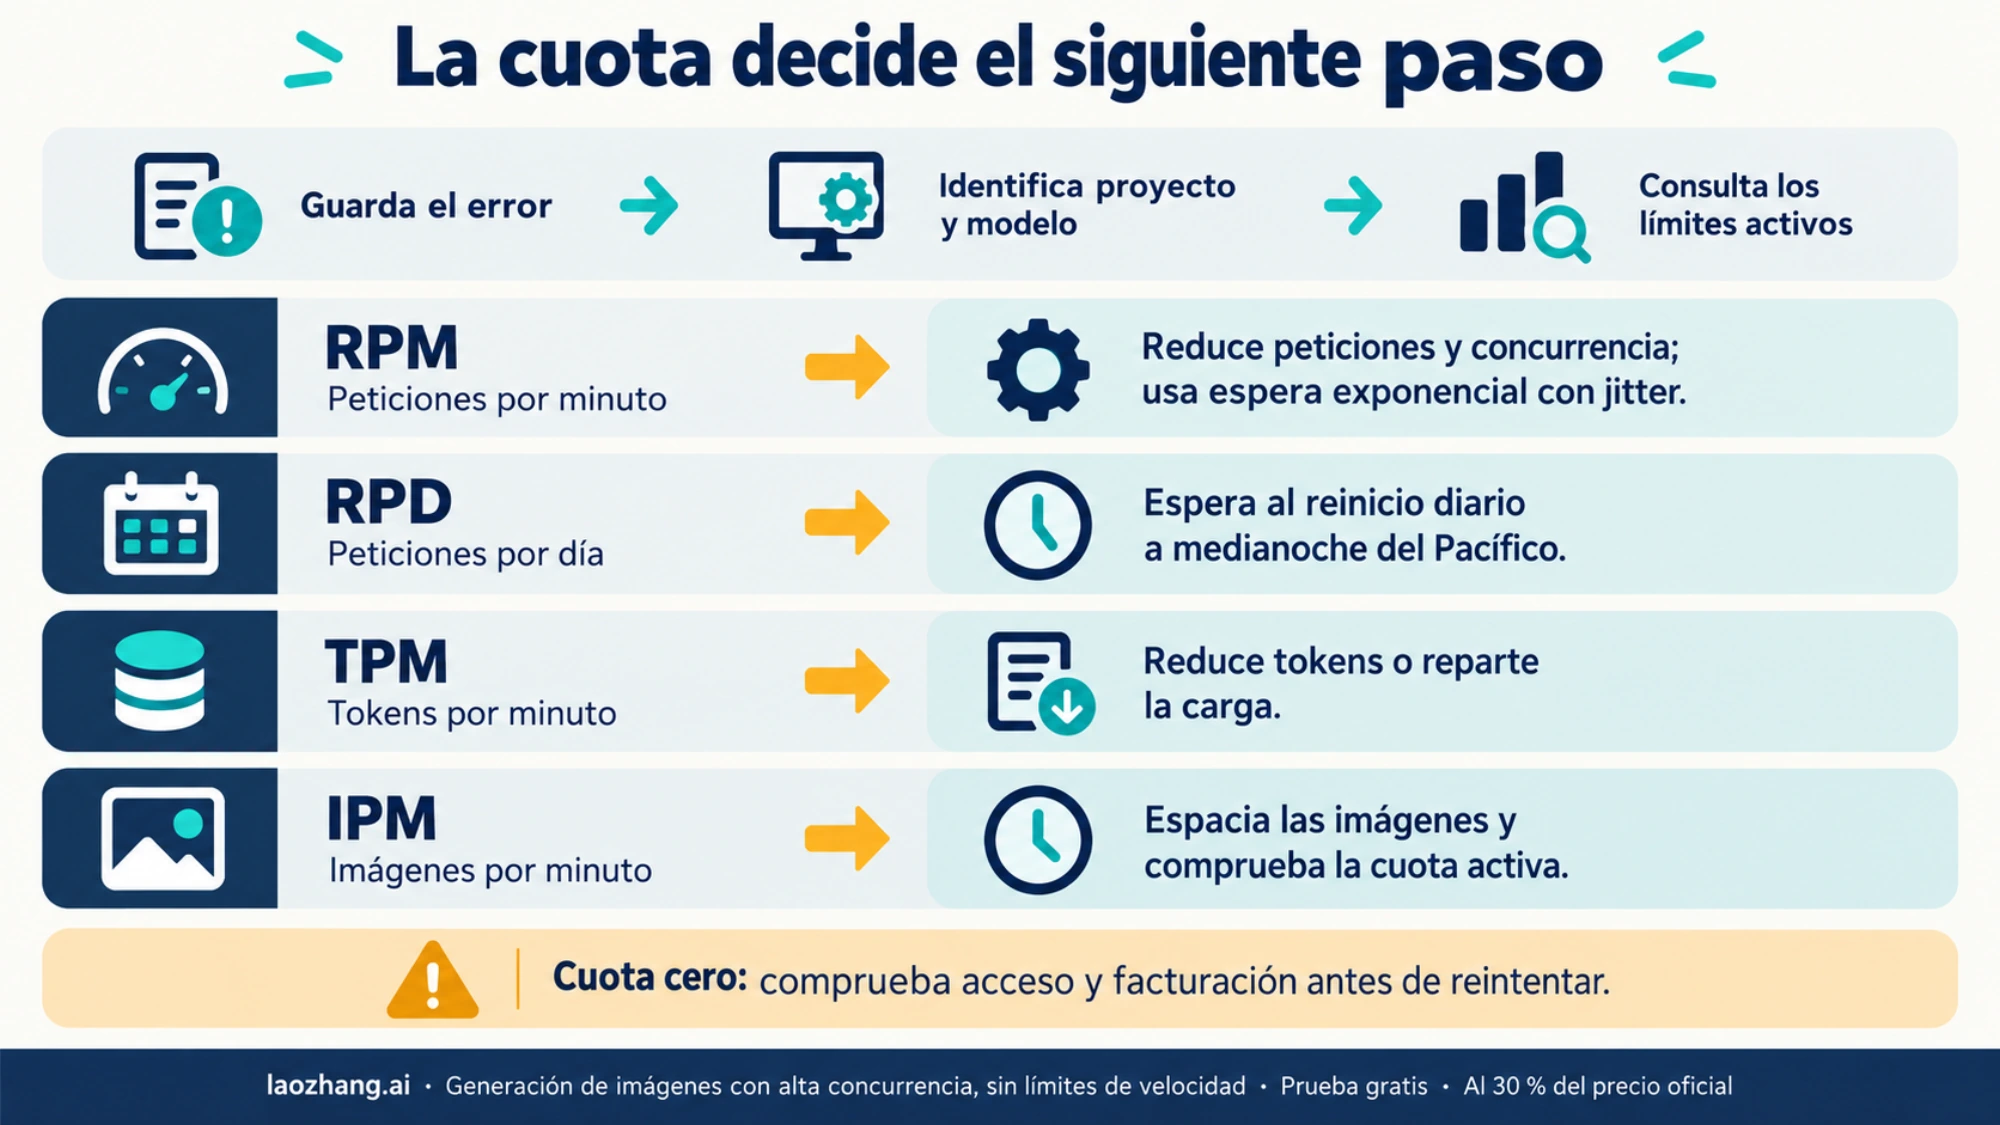
| Falla en ráfagas y la misma petición pasa al cabo de unos segundos | Límite por minuto: RPM, IPM o TPM | Espera exponencial con jitter; bajar concurrencia | En segundos o en el minuto siguiente |
| Funciona por la mañana y falla durante el resto del día | Cuota diaria (RPD) | Esperar al reinicio o pedir más cuota | A medianoche del Pacífico, las 9:00 en la España peninsular |
| Falla tras una tanda de imágenes caras (Pro, 4K) aunque el RPM vaya bajo | Tope de gasto de 10 minutos | Esperar unos minutos y abaratar cada petición | Cuando el gasto de los últimos 10 minutos baja del tope |
Falla desde la primera imagen y el mensaje cita free_tier_requests o limit: 0 | Proyecto en el nivel gratuito, sin salida de imagen | Vincular facturación o usar la clave del proyecto de pago | Al corregir el proyecto, no esperando |
| Funciona en AI Studio pero no en tu servidor, o el texto funciona y las imágenes no | Clave de otro proyecto o modelo distinto | Comprobar qué proyecto usa la clave del proceso que falla | Al usar la clave y el modelo correctos |
| HTTP 402 en lugar de 429 | Saldo Prepay agotado | Recargar saldo; no reintentar | Al añadir crédito |
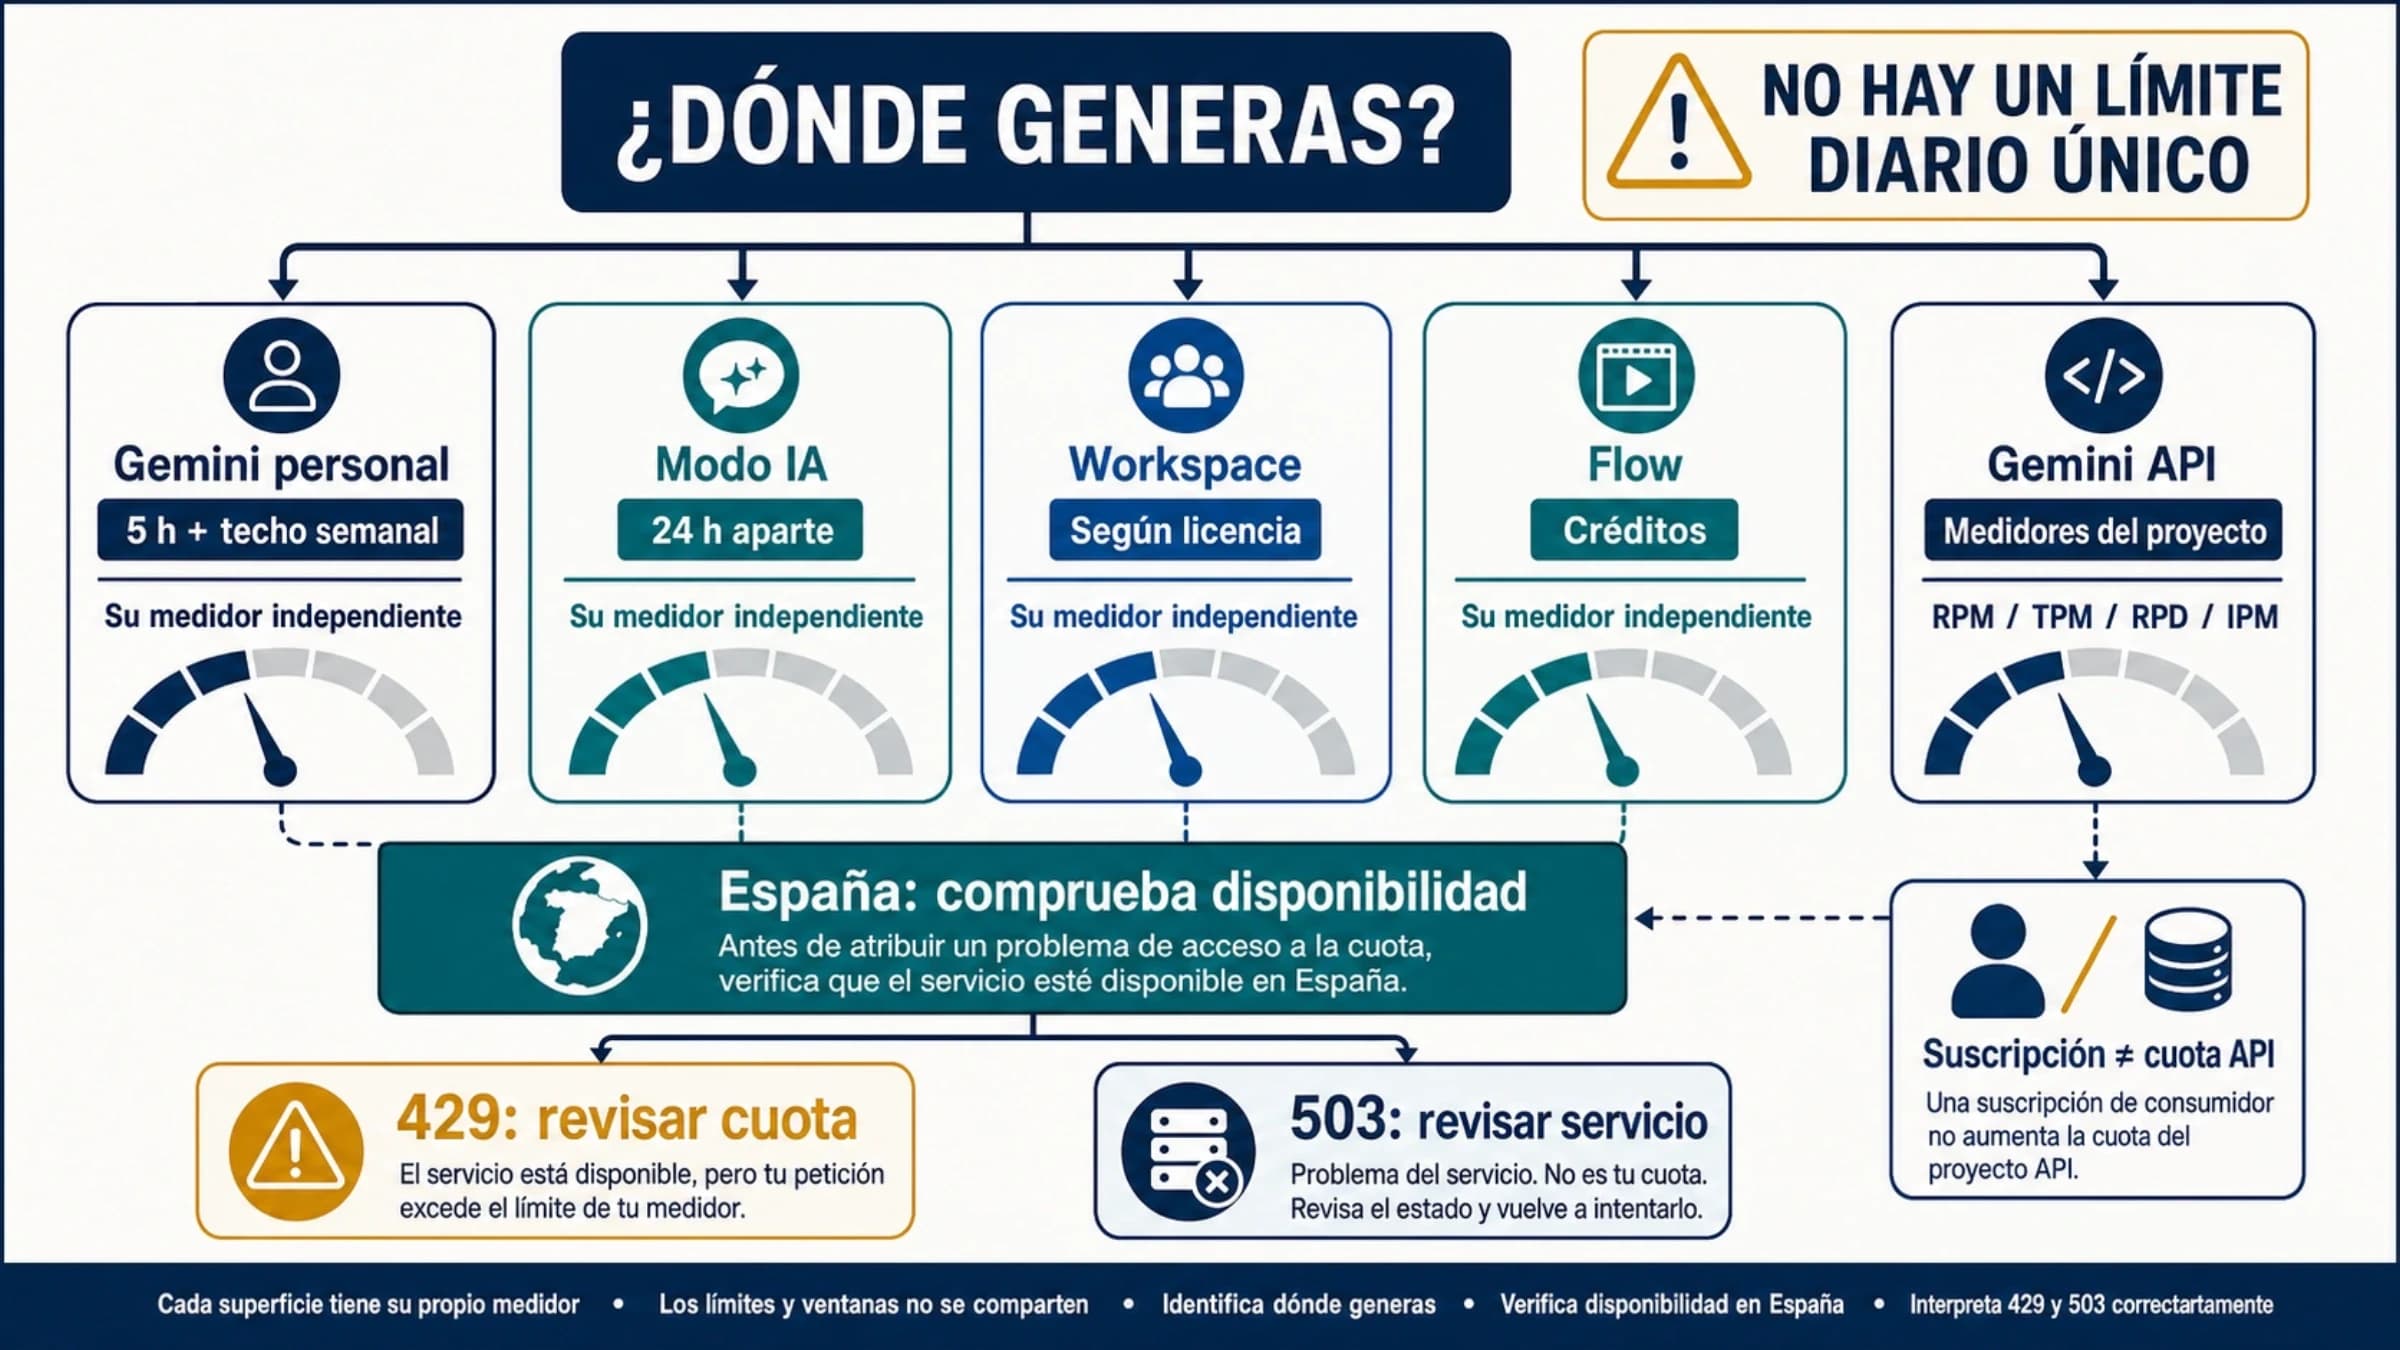
| HTTP 503 o mensaje de alta demanda | Saturación del servicio, no tu cuota | Reintentar más tarde | Cuando baja la carga en Google |
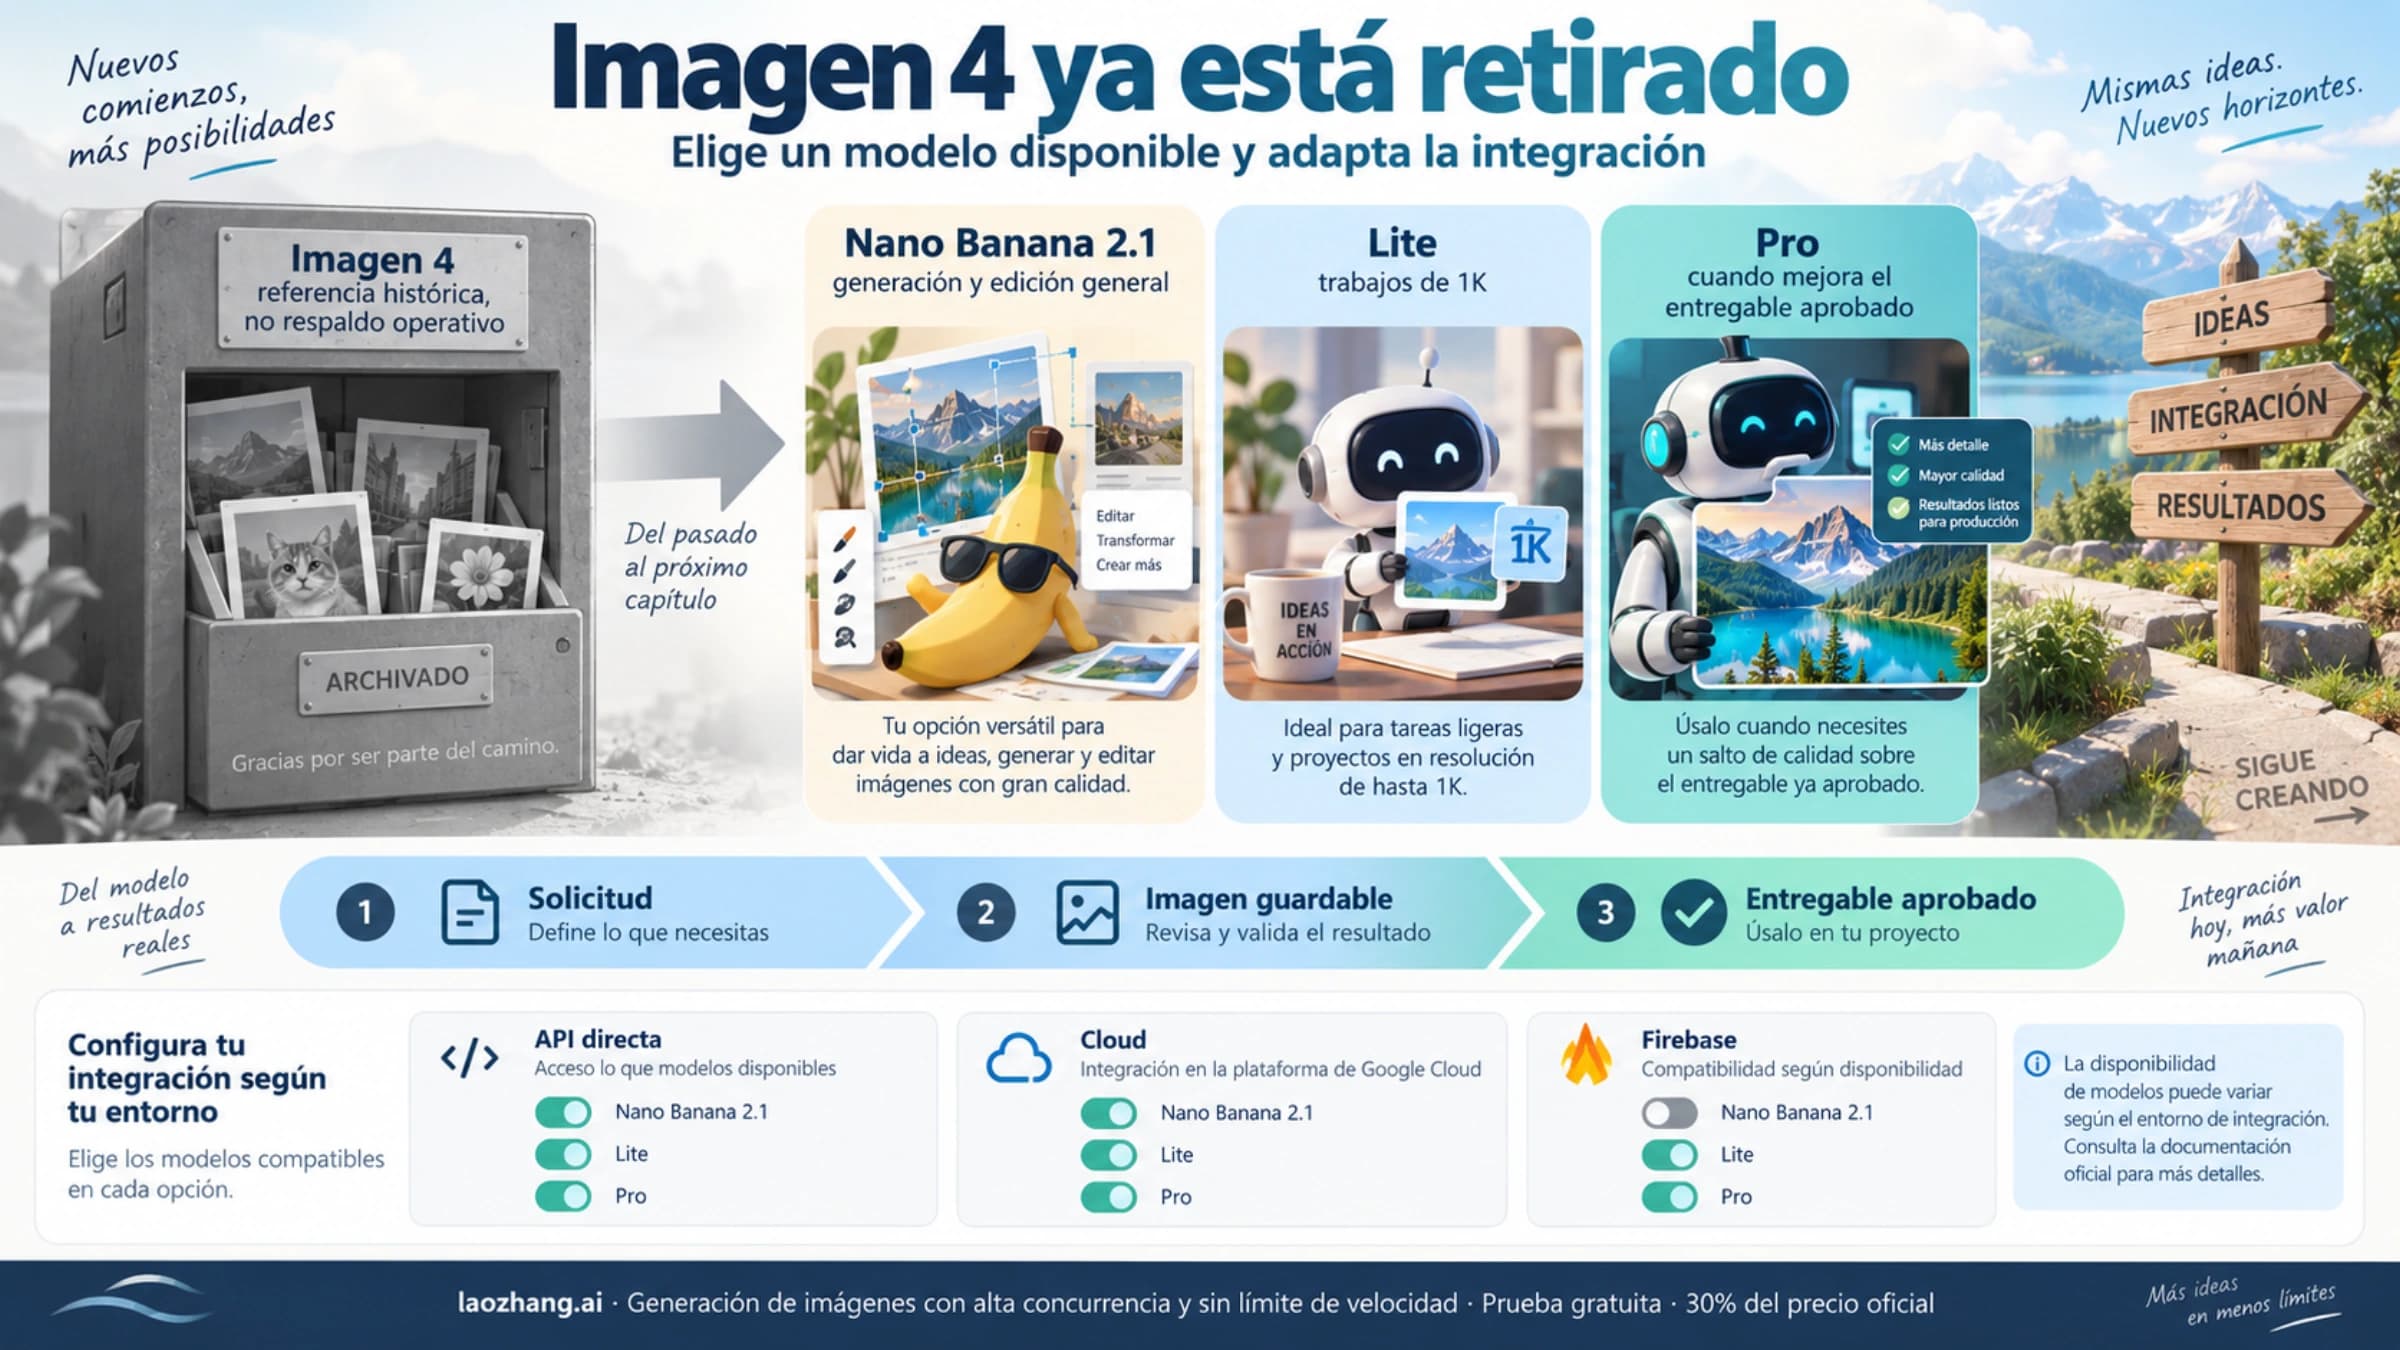
Antes de seguir, revisa el ID del modelo. Los modelos de imagen vigentes son gemini-3.1-flash-lite-image (Nano Banana 2 Lite), gemini-3.1-flash-image (Nano Banana 2) y gemini-3-pro-image (Nano Banana Pro). Según la página de retiradas de Google, gemini-3-pro-image-preview y gemini-3.1-flash-image-preview se apagaron el 25 de junio de 2026, y gemini-2.5-flash-image el 2 de octubre de 2026. Un código copiado de un tutorial antiguo puede estar fallando por eso y no por la cuota.
Límite por minuto: RPM, IPM y espera exponencial
El límite por minuto es el 429 bueno: se va solo. Google mide las peticiones por minuto (RPM), los tokens de entrada por minuto (TPM) y las peticiones por día (RPD), y los modelos de imagen tienen además imágenes por minuto (IPM). Superar cualquiera de ellos devuelve 429 aunque los demás tengan margen. Todo esto consta en la página de límites de Google, actualizada el 2 de septiembre de 2026.
Dos detalles que cambian la estrategia:
- Los límites son por proyecto, no por clave. Crear cinco claves en el mismo proyecto no te da cinco veces más IPM: todas consumen el mismo cupo.
- Las cifras de tu proyecto solo se ven en AI Studio. La página de límites no publica RPM ni IPM para los modelos de imagen actuales; cualquier tabla con números fijos por nivel que encuentres en otra parte no describe tu proyecto.
El SDK de Python no reintenta si no se lo pides
La guía de solución de problemas de Google dice que el SDK de Python reintenta por defecto los errores transitorios hasta cuatro veces, con una espera inicial de alrededor de 1 segundo y un máximo de 60. En google-genai 2.28.0 no es así: a 5 de octubre de 2026, contra un servidor local que responde siempre 429, un genai.Client() sin opciones envía una sola petición de generate_content y lanza la excepción. En cambio, client.interactions.create de la misma versión sí reintenta el 429 por su cuenta (cuatro peticiones en unos 3 segundos). Solo reintenta si activas HttpRetryOptions; con los valores por defecto hace 5 peticiones en total, empezando con una espera de alrededor de 1 segundo y con un tope de 60. Es lo primero que conviene configurar:
from google import genai
from google.genai import types

client = genai.Client(
    http_options=types.HttpOptions(
        retry_options=types.HttpRetryOptions(),  # 5 intentos, ~1 s inicial, 60 s máx.
    )
)

respuesta = client.models.generate_content(
    model="gemini-3.1-flash-image",
    contents="Un plátano de cerámica sobre una mesa de mármol, luz de ventana",
)
Si llamas a la API REST o quieres controlar qué se reintenta, el bucle mínimo es este. No lo combines con retry_options en el mismo cliente: multiplicarías los intentos.
import random
import time

from google import genai
from google.genai import errors

client = genai.Client()  # sin retry_options: el SDK no reintenta


def generar_con_backoff(prompt, intentos=5, base=1.0, tope=60.0):
    for n in range(intentos):
        try:
            return client.models.generate_content(
                model="gemini-3.1-flash-image",
                contents=prompt,
            )
        except errors.APIError as e:
            # 400, 402 y 403 no se arreglan reintentando
            if e.code not in (429, 503) or n == intentos - 1:
                raise
            espera = min(tope, base * 2 ** n) + random.uniform(0, 1)
            time.sleep(espera)
En la misma prueba local, con intentos=4, el bucle hizo 4 peticiones separadas por 1,6, 2,7 y 4,3 segundos y luego lanzó la excepción 429; ninguna llamada llegó a los servidores de Google. El jitter (random.uniform) evita que varios procesos reintenten a la vez y vuelvan a chocar con el mismo límite. Siguiendo la guía de Google, reintenta solo 429, 408 y 5xx; nunca 400, 402 ni 403.
Si después de un ciclo completo de reintentos el 429 sigue ahí, ya no es un límite por minuto: vuelve a la tabla de diagnóstico y descarta las demás causas.
Cuota diaria (RPD): se reinicia a las 9:00 en España
La cuota de peticiones por día se reinicia a medianoche, hora del Pacífico. En la España peninsular eso son las 9:00 casi todo el año (las 8:00 en Canarias). En las semanas de marzo y de finales de octubre en que Estados Unidos y Europa no han cambiado aún de hora a la vez, el reinicio llega una hora antes. Un 429 que empieza a media tarde y no cede con reintentos suele ser esto: el bucle de espera exponencial no sirve, porque ninguna espera de 60 segundos llega a la mañana siguiente.
Tienes dos salidas: esperar al reinicio o pedir más cuota con el formulario «Request paid tier rate limit increase» que enlaza la página de límites. Google no garantiza el aumento; solo se compromete a revisarlo. Si el volumen diario es estable y no necesitas la imagen al momento, Batch (más abajo) usa una cuota aparte.
Tope de gasto de 10 minutos: 10 $ en Tier 1 son unas 74 imágenes Pro
Además de RPM y RPD, Google aplica límites por gasto en una ventana móvil de 10 minutos: no se aplican en el nivel gratuito; son 10 $ en Tier 1, 50 $ en Tier 2 y 200 $ en Tier 3. Al superarlos, la API devuelve 429 RESOURCE_EXHAUSTED. La página de límites aclara que se aplican o no según el historial de facturación y el estado de la cuenta, de modo que no todos los proyectos los tienen.
Para saber si es tu caso, convierte el tope en imágenes. Con los precios de salida estándar a 4 de octubre de 2026 (precios de Google), la cuenta es tope ÷ precio por imagen, redondeado hacia abajo:
| Modelo y resolución | Precio por imagen | Tier 1 (10 $) | Tier 2 (50 $) | Tier 3 (200 $) |
|---|---|---|---|---|
| Nano Banana Pro 1K/2K | 0,134 $ | 10 / 0,134 = 74 | 50 / 0,134 = 373 | 200 / 0,134 = 1.492 |
| Nano Banana Pro 4K | 0,24 $ | 10 / 0,24 = 41 | 50 / 0,24 = 208 | 200 / 0,24 = 833 |
| Nano Banana 2 1K | 0,0672 $ | 10 / 0,0672 = 148 | 50 / 0,0672 = 744 | 200 / 0,0672 = 2.976 |
| Nano Banana 2 Lite 1K | 0,0336 $ | 10 / 0,0336 = 297 | 50 / 0,0336 = 1.488 | 200 / 0,0336 = 5.952 |
El precio de Nano Banana 2 1K sale de 1.120 tokens de imagen × 60 $ por millón = 0,0672 $; Google lo muestra redondeado como 0,067 $. El de Lite, de los mismos 1.120 tokens × 30 $ por millón. La tabla solo cuenta la salida de imagen: los tokens del prompt, de las imágenes de referencia y del razonamiento también suman gasto, así que el número real de imágenes antes del corte es algo menor.
Leído al revés: un proyecto en Tier 1 que genera Nano Banana Pro a 1K o 2K de forma sostenida no pasa de unas 7 imágenes por minuto de media (74 / 10 = 7,4) si le aplica este tope. Si tu 429 aparece justo cuando el gasto de los últimos 10 minutos ronda esa cifra, es esto. Google propone esperar un poco y reintentar, abaratar cada petición (en imágenes: bajar de 4K a 2K, o pasar de Pro a Nano Banana 2) y pedir un aumento si el tope te frena con uso normal.
Cambiar a inferencia Priority no te da más margen: sus límites por defecto son 0,3 veces los estándar de cada modelo y nivel, y en Nano Banana Pro cada imagen 1K/2K cuesta unos 0,24 $ en lugar de 0,134 $.
limit: 0 en un modelo de imagen: el proyecto no tiene acceso de pago
Ningún modelo de imagen actual tiene salida gratuita: en la página de precios, la salida de imagen figura como «Not available» en el nivel gratuito para Nano Banana 2 Lite, Nano Banana 2 y Nano Banana Pro. Una petición de imagen desde un proyecto del nivel gratuito falla por cuota desde la primera llamada. En los informes de desarrolladores, el mensaje suele citar una métrica free_tier_requests con limit: 0.
Ese 429 no se pasa esperando. Comprueba tres cosas:
- Que el proyecto tenga facturación vinculada. Pasar de Free a Tier 1 exige configurar facturación en AI Studio; las cuentas nuevas quedan en Prepay y deben cargar al menos 5 $.
- Que la clave del proceso que falla sea de ese proyecto. Es habitual pagar en un proyecto y desplegar con una clave de otro creado antes.
- Que el modelo sea uno de imagen vigente, no un ID preview ya apagado.
Si ya pagas y sigue saliendo limit: 0, el caso tiene su propia guía: qué revisar cuando una cuenta de pago recibe free_tier_requests limit 0. Y si lo que ves es un HTTP 402, no es cuota: el saldo Prepay llegó a cero y la petición no pasará hasta que recargues.
Dónde ver tus límites y cómo subir de Tier 1 a Tier 3
Las cifras reales de RPM, IPM y RPD de tu proyecto están en la página de límites de AI Studio, y el nivel actual de cada proyecto, en la página Projects. Los niveles se asignan solos cuando el proyecto cumple las condiciones, según la página de límites de Google a 5 de octubre de 2026:
| Nivel | Cómo se alcanza | Tope de gasto cada 10 minutos | Tope de facturación del nivel |
|---|---|---|---|
| Free | Proyecto activo o prueba gratuita | No aplica | No aplica |
| Tier 1 | Vincular una cuenta de facturación activa | 10 $ | 250 $ |
| Tier 2 | 100 $ pagados y 3 días desde el primer pago correcto | 50 $ | 2.000 $ |
| Tier 3 | 1.000 $ pagados y 30 días desde el primer pago correcto | 200 $ | De 20.000 $ a más de 100.000 $ |
Para Tier 2 y Tier 3 cuenta el gasto total en Google Cloud de la cuenta de facturación vinculada, no solo el de Gemini API. El paso de Free a Tier 1 suele ser inmediato y los siguientes tardan hasta 10 minutos. Google advierte que, en casos raros, puede denegar una subida aunque se cumplan los requisitos, y que los límites indicados no garantizan capacidad.
Esperar, Batch o una ruta de pago aparte: cómo elegir
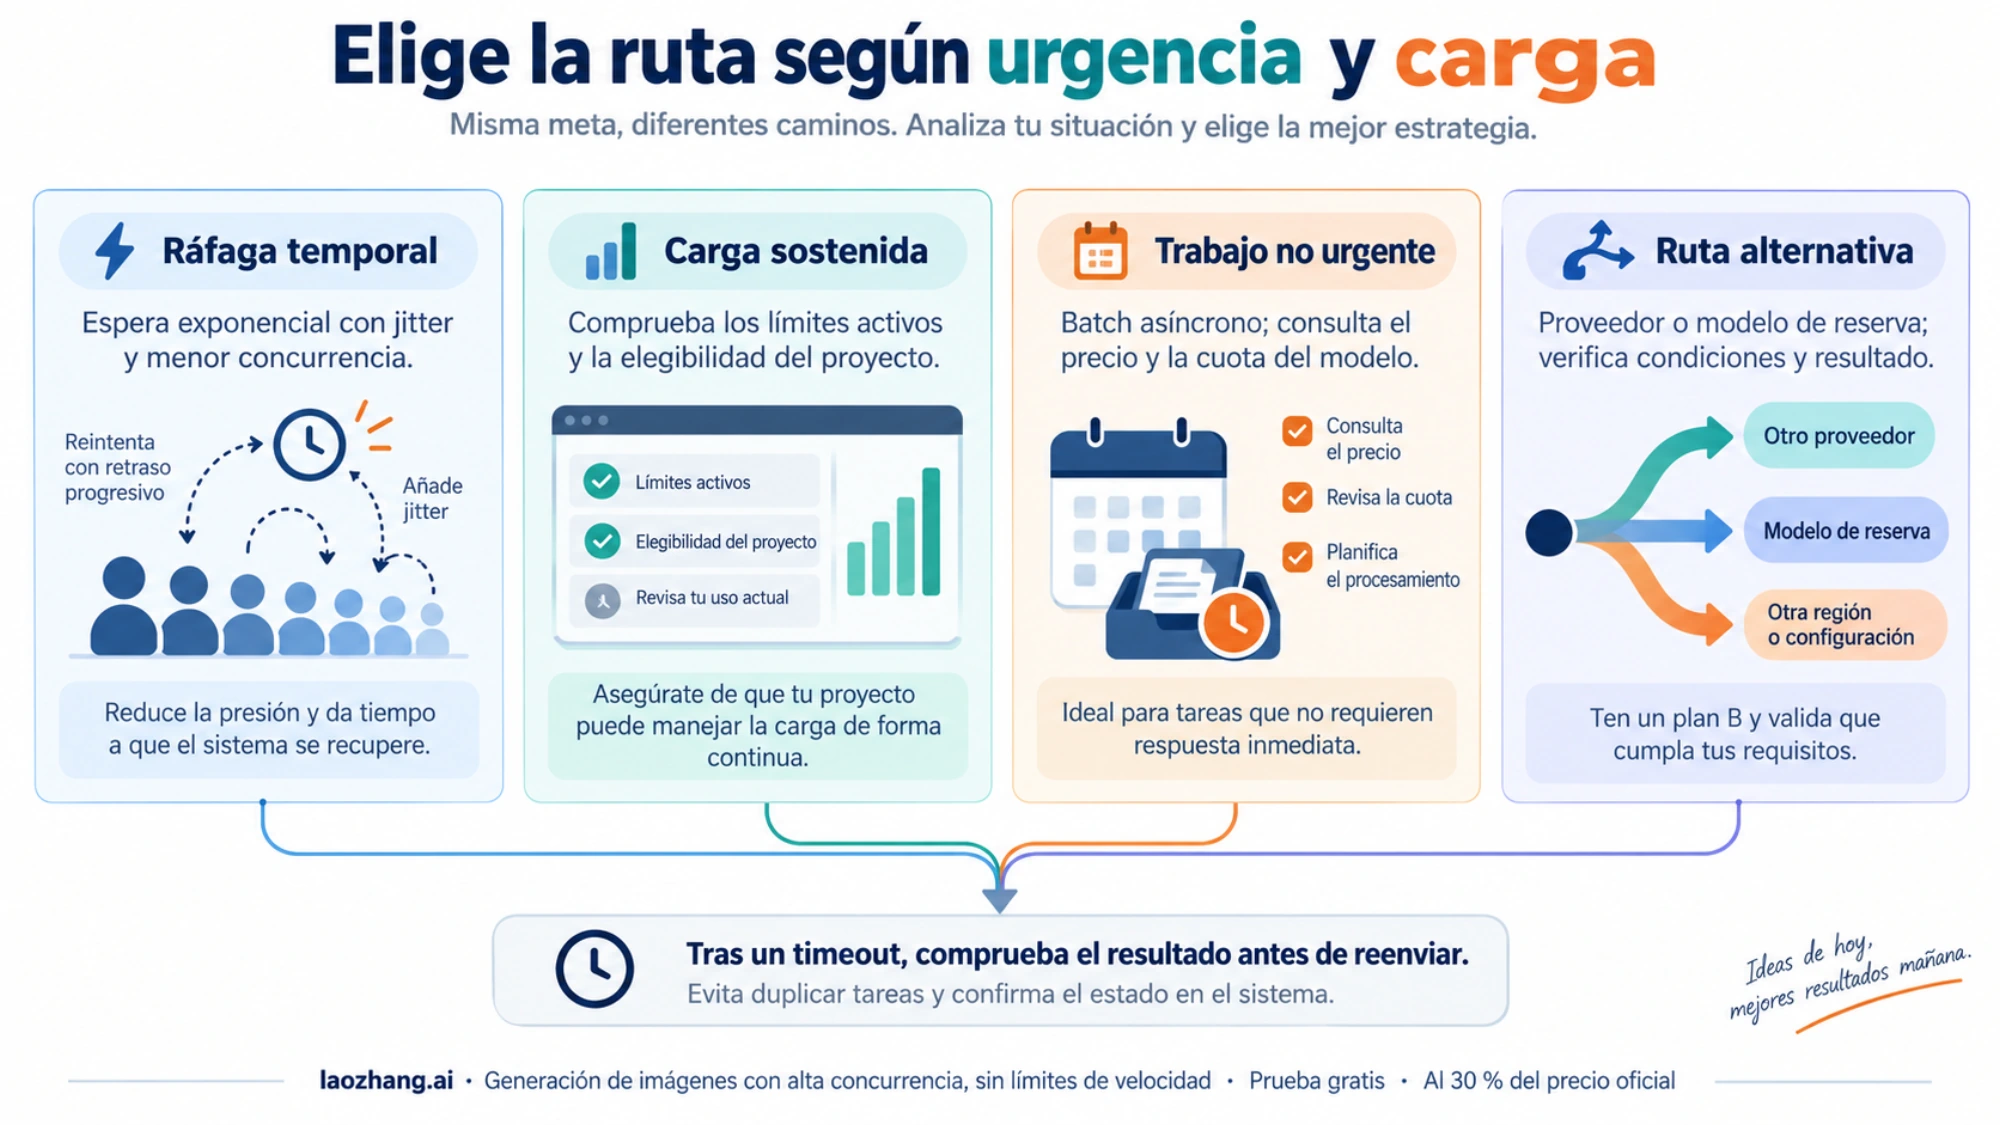
Una vez sabes qué límite es, la decisión depende de si la imagen hace falta ya y de si el volumen es puntual o constante:
- Pico puntual con imágenes urgentes: espera exponencial y menos concurrencia. Es el caso que resuelve el SDK con
HttpRetryOptions. - Volumen constante que choca con RPD o con el tope de gasto: sube de nivel cuando cumplas los requisitos o pide aumento de cuota. Mientras tanto, reparte la carga a lo largo del día.
- Muchas imágenes que pueden esperar horas: Batch. Según la documentación de Batch API, las peticiones por lotes tienen límites propios, separados de las llamadas normales, cuestan el 50 % del precio estándar y el objetivo de entrega es de 24 horas. Nano Banana Pro baja a 0,067 $ por imagen 1K/2K y a 0,12 $ en 4K. Los cálculos de cuándo compensa están en el coste de Nano Banana Pro con Batch API.
- Necesitas imágenes ya y tu proyecto no puede subir de nivel a tiempo: una pasarela de pago es otro contrato, con sus propios límites y condiciones. Por ejemplo, la documentación de laozhang.ai publica 0,09 $ por llamada para
gemini-3-pro-imageen 1K, 2K o 4K y 0,055 $ paragemini-3.1-flash-image(precio público a 24 de septiembre de 2026). Una respuesta HTTP 200 sin imagen también se cobra como llamada, y los filtros de seguridad de Google siguen aplicándose. En 1K y 2K, Batch de Google sale más barato si puedes esperar.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Vertex AI: el 429 suele ser capacidad compartida
Si llamas a los modelos de imagen desde Vertex AI (ahora Gemini Enterprise Agent Platform) en pago por uso, sin Provisioned Throughput, el 429 con el mensaje «Resource exhausted, please try again later.» indica que la capacidad compartida no tiene recursos para tu petición en ese momento; no hay capacidad reservada para ti. La página del código de error 429 de Google Cloud, actualizada el 1 de octubre de 2026, recomienda usar el endpoint global en lugar de uno regional, reintentar con espera exponencial truncada, subir el tráfico de forma gradual para no chocar con los límites de aceleración y, si necesitas un servicio constante, contratar Provisioned Throughput. Los niveles Tier 1–3 y las cifras de AI Studio pertenecen a la API de Gemini y no se aplican ahí.
¿Está fallando Gemini hoy? 429 frente a 503 y los códigos de la app
Un 429 casi siempre habla de tu proyecto; un 503 (service_unavailable) indica que el modelo está saturado o caído para todos. Si recibes 503 o un aviso de alta demanda, consulta la página de estado de AI Studio y estas guías: errores 503 de Nano Banana Pro y el error de alta demanda de Gemini.
En la app de Gemini, no en la API, aparecen códigos como 1185, 1152 o 13. Google no publica qué significa cada uno, y ningún límite de la API explica esos números. Para los fallos de imagen en la app y en la API que no son 429, sigue con los errores de generación de imágenes en Gemini.
Preguntas frecuentes sobre el error 429 de Gemini
¿Cuánto dura el error 429 de Gemini?
Depende del límite. El límite por minuto se libera en segundos o en el minuto siguiente. La cuota diaria se reinicia a medianoche del Pacífico, las 9:00 en la España peninsular la mayor parte del año. El tope de gasto se libera cuando el gasto de los últimos 10 minutos baja del umbral. Un 429 por limit: 0 no caduca: dura hasta que corriges el proyecto o la facturación.
¿Cómo quito el error 429 si tengo varias claves API?
Varias claves del mismo proyecto no suman cuota, porque los límites son por proyecto. Repartir peticiones entre claves de un mismo proyecto no evita el 429. Lo que funciona es bajar el ritmo, subir de nivel, pedir más cuota o mover a Batch el trabajo que puede esperar.
¿Qué hago si el 429 de imágenes persiste con cuota disponible?
Si AI Studio muestra margen y el 429 sigue, comprueba que el proceso use una clave del proyecto que estás mirando y un modelo de imagen vigente. Después, calcula el gasto de los últimos 10 minutos con la tabla del tope de gasto. Para recuperar una cola de imágenes interrumpida sin repetir trabajos, consulta qué hacer con RESOURCE_EXHAUSTED en Nano Banana Pro.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 5 oct 2026.
Fuentes8
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 5 oct 2026.
- 1.página de errores de la API de Geminiai.google.dev/gemini-api/docs/api-errors
- 2.página de retiradas de Googleai.google.dev/gemini-api/docs/deprecations
- 3.página de límites de Googleai.google.dev/gemini-api/docs/rate-limits
- 4.guía de solución de problemas de Googleai.google.dev/gemini-api/docs/troubleshooting
- 5.precios de Googleai.google.dev/gemini-api/docs/pricing
- 6.documentación de Batch APIai.google.dev/gemini-api/docs/batch-api
- 7.página del código de error 429 de Google Clouddocs.cloud.google.com/gemini-enterprise-agent-platform/models/deploy/error-code-429
- 8.página de estado de AI Studioaistudio.google.com/status