Gemini 3.8 Flash o Claude Fable 5.1: cuál probar primero
Gemini 3.8 Flash es el primer candidato más económico para muchas cargas; Fable 5.1 merece una prueba cuando el trabajo difícil, la salida larga o el ahorro de correcciones pueden justificar su coste.
En esta página
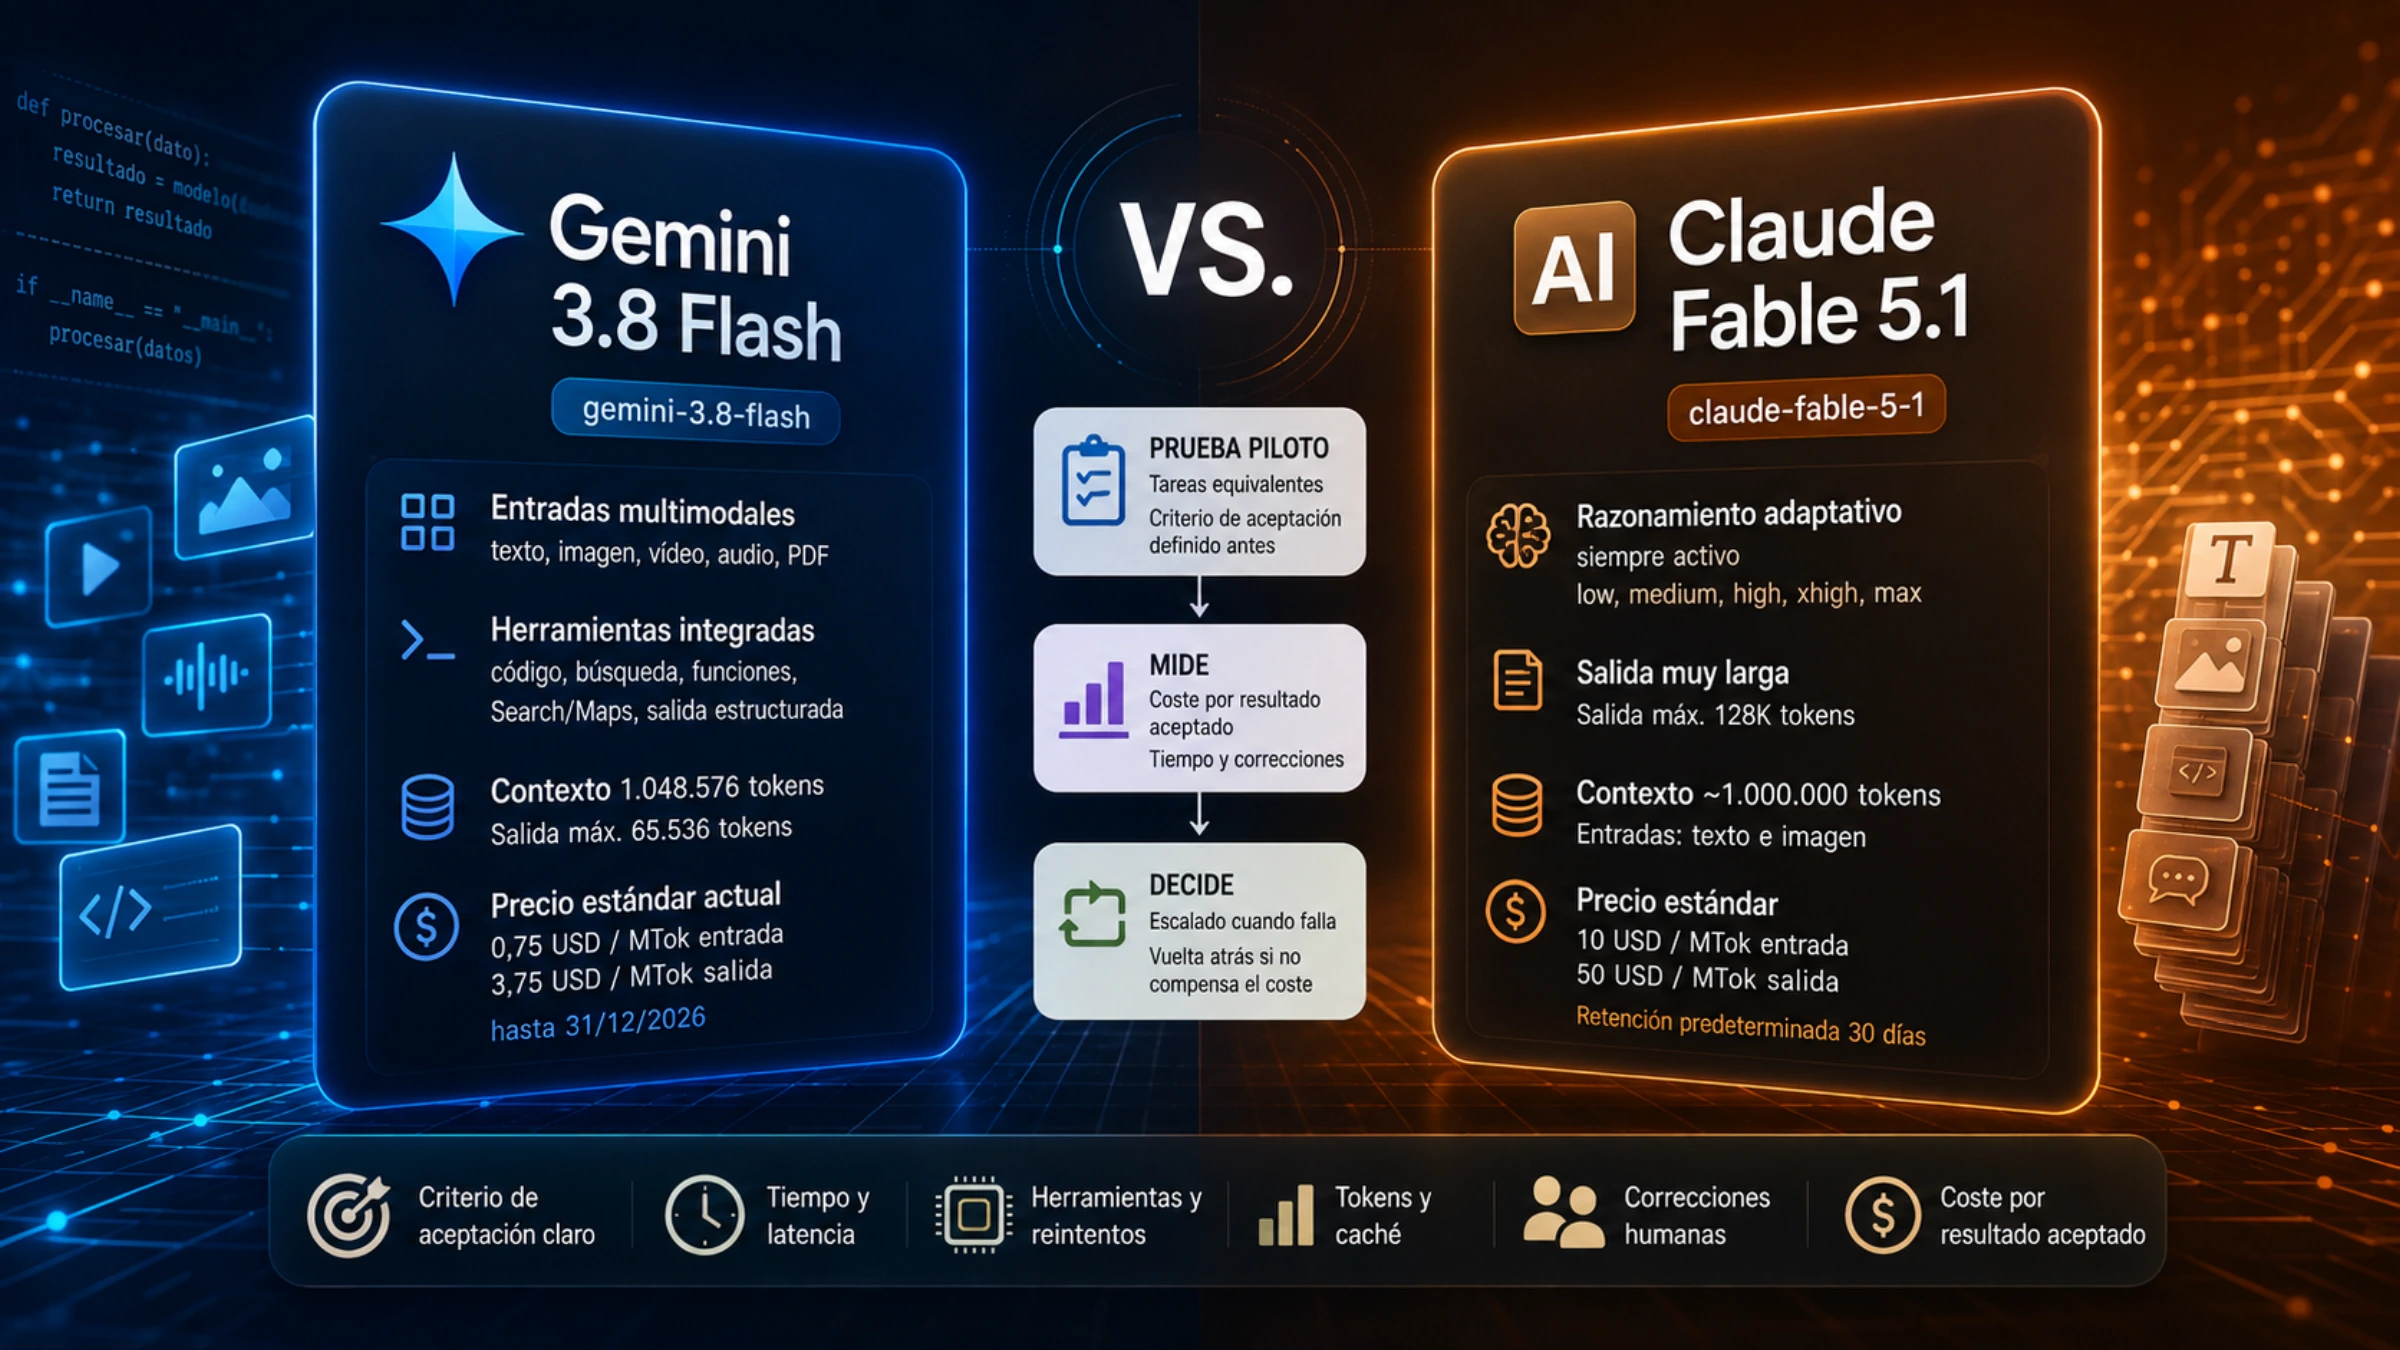
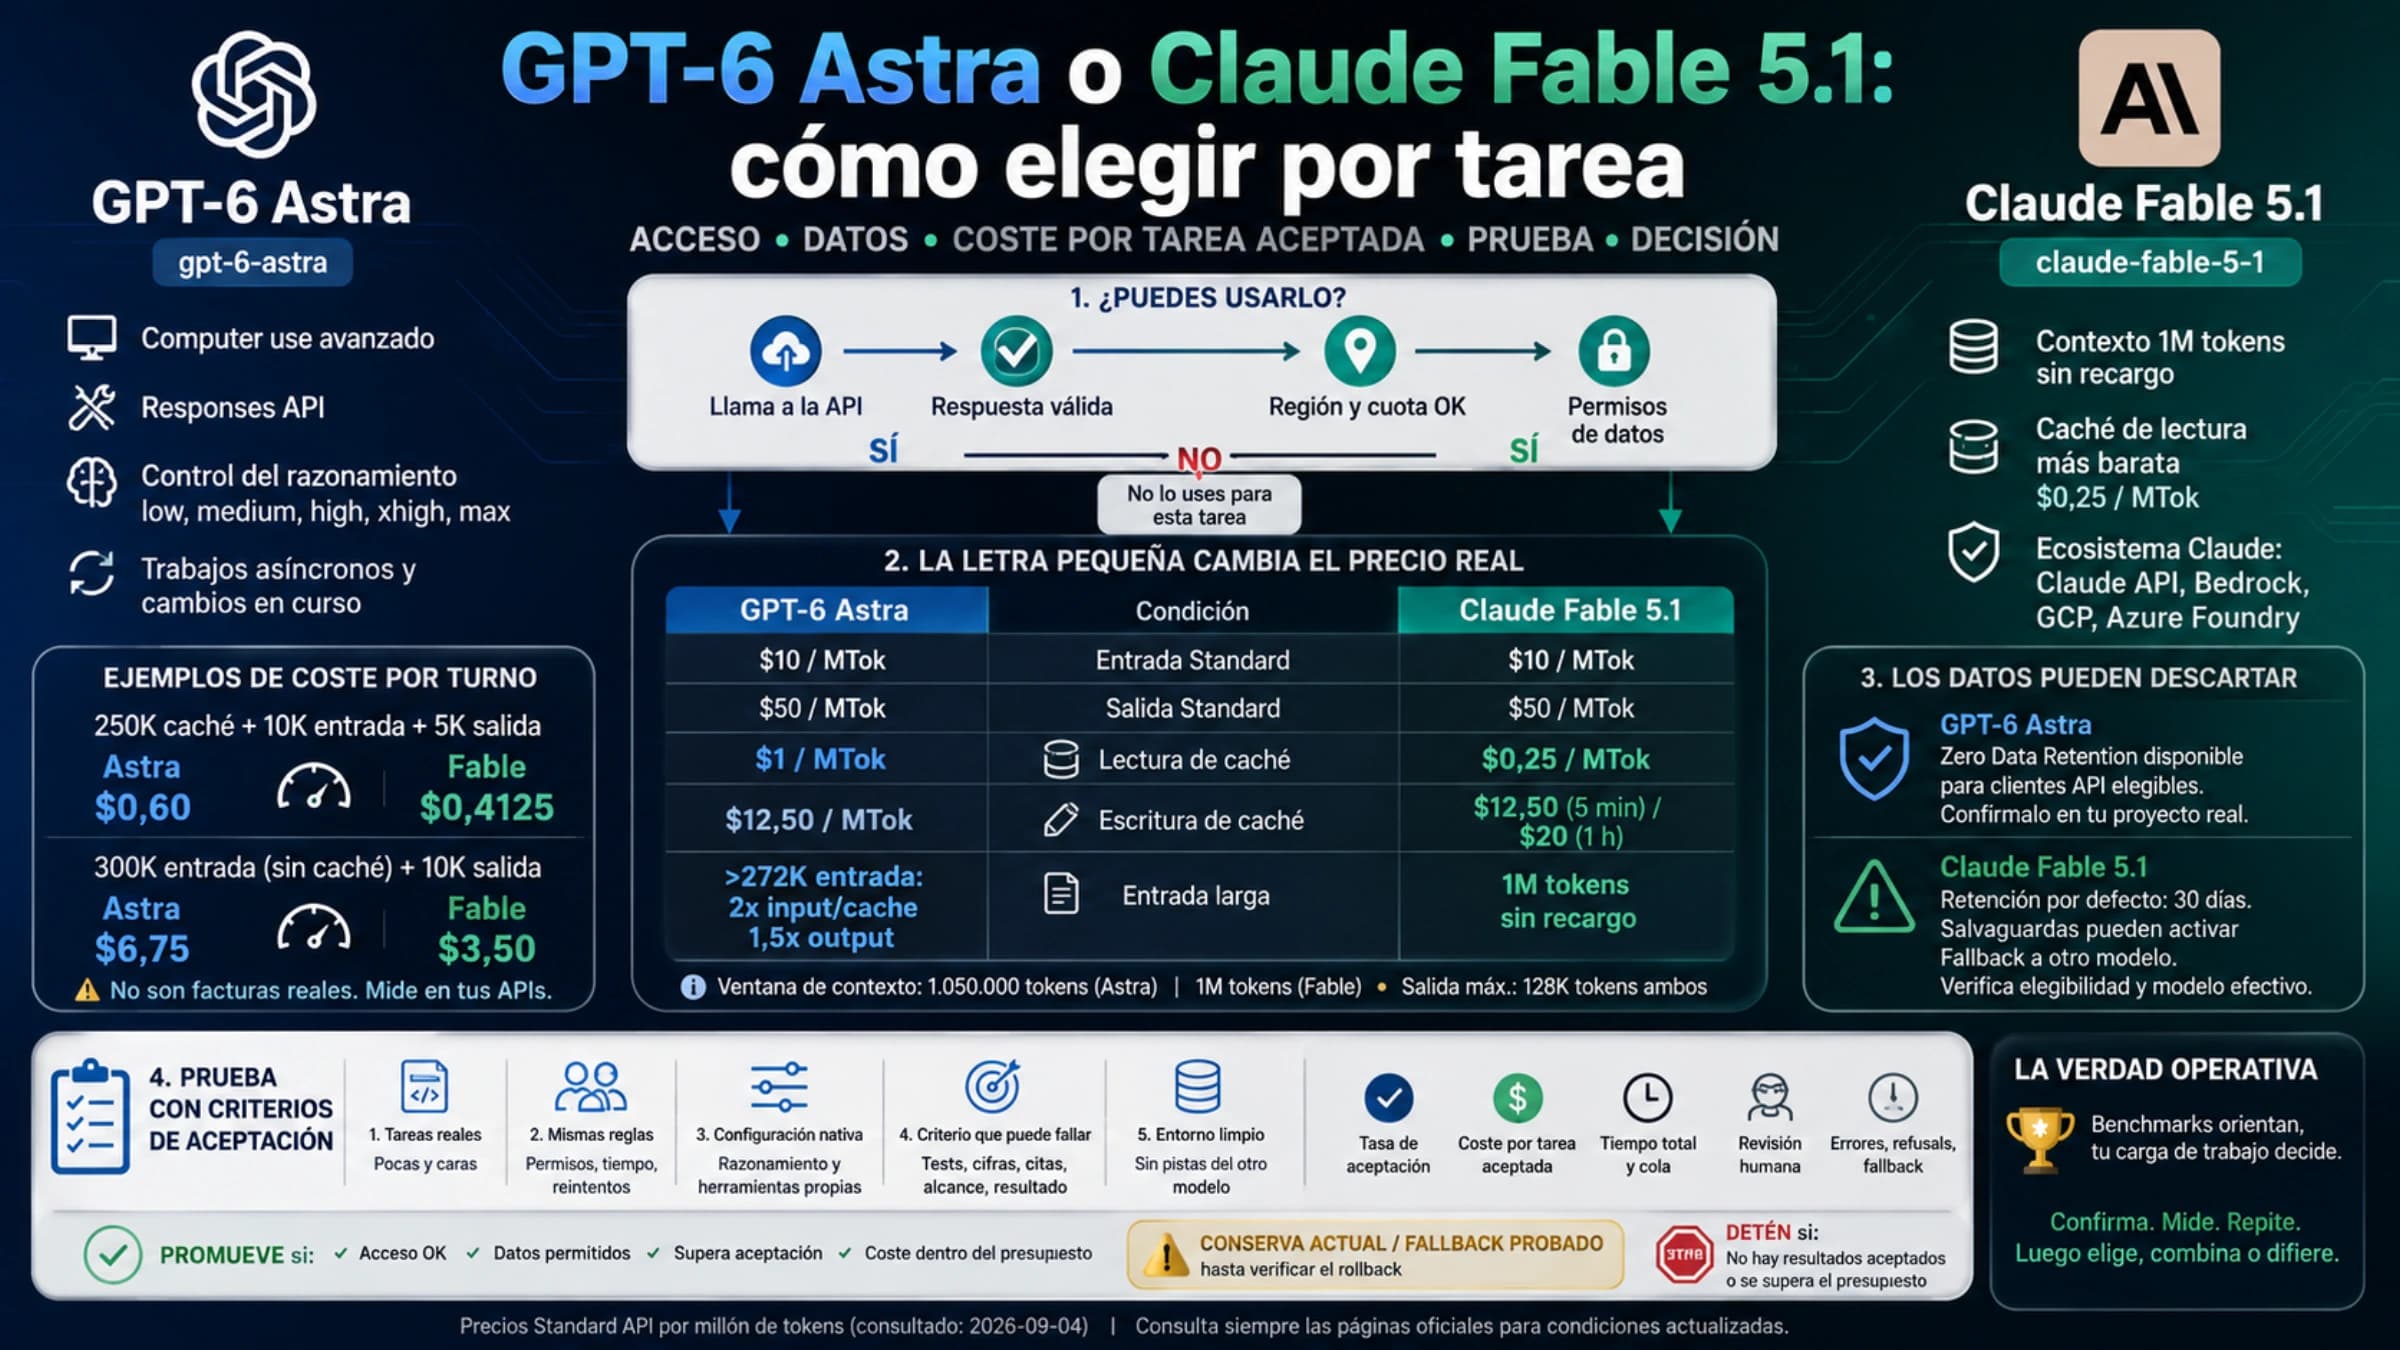
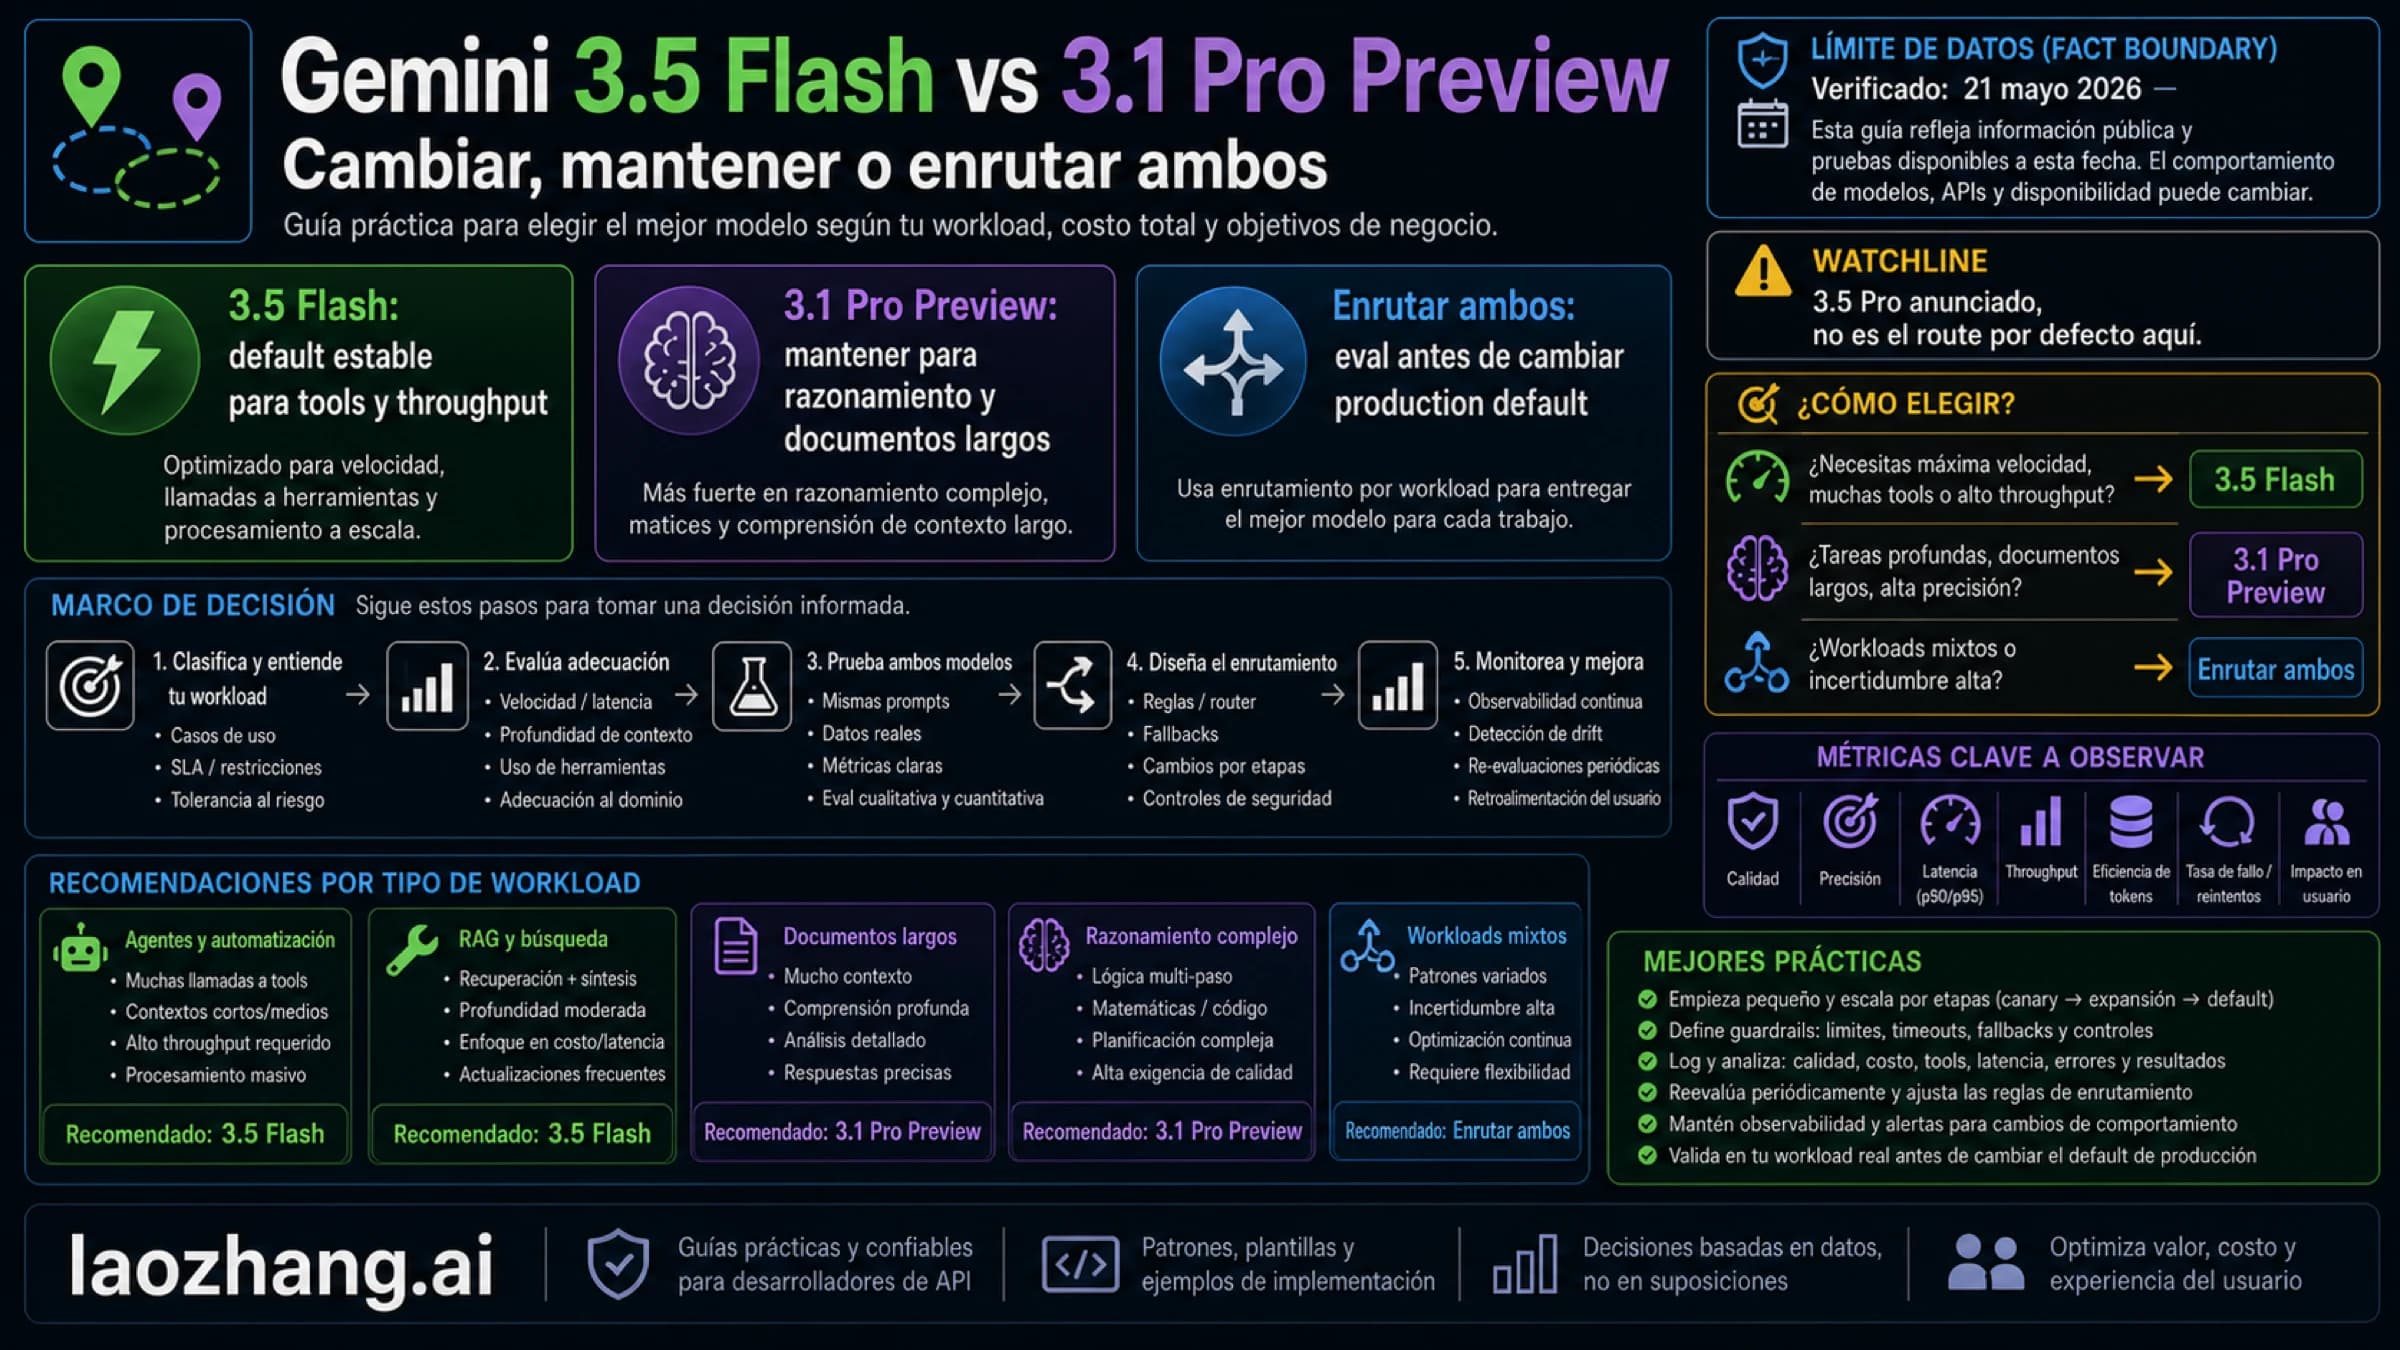
Para la mayoría de equipos, Gemini 3.8 Flash es el candidato que conviene probar primero. Es un modelo estable, admite entradas multimodales y, hasta el 31 de diciembre de 2026, sus tarifas base de entrada y salida son aproximadamente una decimotercera parte de las de Claude Fable 5.1. Esa diferencia permite probar más tareas y reservar presupuesto para los casos realmente difíciles.
Claude Fable 5.1 no es el segundo paso automático. Anthropic lo presenta como un modelo para razonamiento exigente y trabajo de larga duración con agentes, pero también recomienda comenzar la mayoría de las cargas con Opus 5 y pasar a Fable cuando las evaluaciones aún se queden cortas. Dentro de esta comparación concreta, Fable tiene sentido como candidato directo cuando necesitas hasta 128K tokens de salida, o como escalado cuando Gemini no alcanza un criterio de aceptación que has definido de antemano.
La elección no puede cerrarse con una tabla de especificaciones. No existe una prueba pública e independiente que haya ejecutado ambos modelos con las mismas tareas, herramientas, permisos, límites y condiciones de éxito. La respuesta útil, por tanto, es una política comprobable: empieza por el modelo compatible más barato, escala solo ante un fallo definido y vuelve atrás si la mejora no compensa el coste total.
Los datos de este artículo se comprobaron el 4 de septiembre de 2026 en documentación oficial de Google y Anthropic.
Tres filtros pueden resolver la elección antes de comparar calidad
Hay decisiones que no necesitan una prueba de rendimiento. Si una ruta no admite tus datos, tu tipo de entrada o tu forma de integración, queda descartada aunque produzca respuestas excelentes en una demostración.
Primero, revisa la retención de datos. Anthropic clasifica Fable 5.1 como Covered Model y documenta una retención predeterminada de 30 días. Trabajar sin retención de datos requiere una autorización expresa, no una opción que deba darse por disponible en cualquier cuenta. Si tu contrato, política interna o categoría de datos exige retención cero y no tienes esa aprobación, Fable no es una ruta válida para esa carga. La política de retención de la API de Claude debe revisarse junto con tus condiciones contractuales; no basta con leer el nombre del modelo.
Después, comprueba la entrada y la salida. La ficha de Gemini 3.8 Flash publica entradas de texto, imagen, vídeo, audio y PDF, con salida de texto y un máximo de 65.536 tokens generados. La ficha de Claude Fable 5.1 admite texto e imagen como entrada, genera texto y eleva la salida máxima a 128K tokens. Si necesitas analizar audio, vídeo o PDF directamente con el modelo, Gemini parte con una ventaja funcional. Si una sola respuesta debe superar de verdad el límite de Gemini, Fable merece una prueba, aunque también conviene comprobar si dividir la salida es una solución más barata y fiable.
Por último, valida la integración. Gemini y Fable ofrecen aproximadamente un millón de tokens de contexto de entrada, pero no controlan el razonamiento ni las herramientas de la misma manera. Un cambio de identificador puede parecer trivial y aun así romper historiales, selección de herramientas o presupuestos. Si tu aplicación no puede absorber esas diferencias, todavía no tienes dos candidatos comparables.
Lo que las especificaciones sí permiten concluir
Los dos modelos son ofertas activas para desarrolladores, pero ocupan posiciones económicas y operativas muy distintas.
| Dato comprobado | Gemini 3.8 Flash | Claude Fable 5.1 |
|---|---|---|
| Identificador de API | gemini-3.8-flash | claude-fable-5-1 |
| Estado y fecha | GA/Stable; publicado el 2 de septiembre de 2026 | Active (latest); publicado el 1 de septiembre de 2026 |
| Contexto de entrada | 1.048.576 tokens | 1 millón de tokens |
| Salida máxima | 65.536 tokens | 128K tokens |
| Modalidades de entrada | Texto, imagen, vídeo, audio y PDF | Texto e imagen |
| Salida | Texto | Texto |
| Control de razonamiento | low, medium, high; valor predeterminado medium | Razonamiento adaptativo siempre activo; low, medium, high, xhigh, max; valor predeterminado high |
| Precio estándar actual por millón de tokens | 0,75 USD entrada / 3,75 USD salida | 10 USD entrada / 50 USD salida |
La tabla no demuestra que Gemini responda trece veces peor ni que Fable sea trece veces mejor. Solo establece la tarifa aplicada a la misma cantidad facturable. Tampoco convierte “Flash” en una medición de velocidad: las fuentes consultadas no aportan una comparación cruzada de latencia p50 o p95 bajo las mismas condiciones.
Gemini documenta además caché, ejecución de código, búsqueda de archivos, llamadas a funciones, salida estructurada, contexto de URL y conexión con Google Search y Maps para fundamentar respuestas. Computer Use figura como Preview; la generación de imagen o audio y Live API no están admitidas en este modelo. Fable se apoya en razonamiento adaptativo siempre activo y Anthropic lo orienta a problemas muy exigentes y agentes de larga duración. Son capacidades y posicionamientos de cada proveedor, no resultados de una carrera común.
Hay otra diferencia temporal importante. La página de precios de Gemini fija 0,75/3,75 USD hasta el 31 de diciembre de 2026 y anuncia 1,50/7,50 USD desde el 1 de enero de 2027. Batch y Flex cuestan la mitad de las tarifas estándar correspondientes. La página de precios de Claude fija para Fable 10/50 USD, con escrituras de caché de cinco minutos a 12,50 USD, escrituras de una hora a 20 USD y lecturas a 0,25 USD por millón de tokens; Batch reduce a la mitad la entrada y la salida base. Impuestos, plataformas asociadas, uso de fuentes externas, almacenamiento de caché y acuerdos privados pueden cambiar la factura final.
La ventaja de precio es enorme, pero no es el coste de terminar el trabajo
La comparación base se puede reproducir sin una calculadora especial:
coste base = entrada facturable × tarifa de entrada + salida facturable × tarifa de salida
Supón una tarea hipotética con un millón de tokens de entrada y 100.000 tokens de salida, sin caché ni cargos adicionales. Con las tarifas vigentes hasta final de 2026:
- Gemini:
1 × 0,75 + 0,1 × 3,75 = 1,125 USD. - Fable:
1 × 10 + 0,1 × 50 = 15 USD.
Con exactamente esas cantidades, Fable cuesta 13,33 veces más. Cuando entren en vigor las tarifas anunciadas para Gemini en 2027, el mismo cálculo daría 2,25 USD y la relación bajaría a 6,67 veces. Es un ejemplo aritmético, no una ejecución realizada ni una predicción de consumo.
En producción, las cantidades casi nunca permanecen iguales. Google avisa en su guía del modelo más reciente de que las tareas complejas pueden emplear más pasos de razonamiento y más llamadas a herramientas; los tokens de razonamiento se facturan como salida. Fable también puede dedicar distinto esfuerzo, recorrer más herramientas o producir respuestas mucho más largas. Los proveedores no usan necesariamente el mismo tokenizador, y sus categorías de caché tampoco son intercambiables.
Por eso la métrica que importa no es el precio de una solicitud, sino el coste por resultado aceptado:
coste API por resultado aceptado = gasto total de API / número de tareas aceptadas
Si quieres incorporar el tiempo del equipo:
coste operativo por resultado aceptado = (gasto de API + coste del trabajo correctivo humano) / tareas aceptadas
Esta segunda cifra evita dos errores habituales. El primero es elegir un modelo barato que obliga a repetir cada tarea. El segundo es pagar un modelo caro porque su respuesta parece más elaborada, aunque no reduzca fallos, reintentos ni revisión humana.
Qué modelo probar primero según el cuello de botella
Empieza por Gemini 3.8 Flash cuando la carga es frecuente, sensible al presupuesto o depende de entradas de audio, vídeo o PDF. También es el punto de partida lógico para extracción, clasificación, síntesis con mucho contexto, asistencia de programación acotada y agentes cuyo éxito se pueda verificar automáticamente. Su precio deja un margen amplio para reintentos y para comparar configuraciones antes de comprometer más presupuesto.
Prueba Fable 5.1 desde el principio cuando una sola salida puede necesitar más de 65.536 tokens, la carga encaja con el trabajo prolongado y exigente que describe Anthropic, y un fallo tiene un coste humano o empresarial muy superior a la factura de tokens. Esa decisión solo es razonable si la retención de 30 días y las condiciones de acceso son compatibles con los datos.
Usa Fable como escalado cuando Gemini falla de una forma repetible: no supera una prueba del repositorio, abandona una investigación larga, pierde coherencia tras varias llamadas a herramientas o necesita tanta reparación que desaparece su ventaja económica. “La tarea es importante” no basta como condición. Debe existir una señal que la aplicación pueda registrar o que un revisor pueda aplicar de forma consistente.
No uses ninguno como única ruta todavía si dependes de una capacidad no verificada, si necesitas retención cero en Fable sin aprobación, o si no puedes conservar una alternativa durante el despliegue. Mantener una ruta de vuelta atrás suele aportar más seguridad que intentar adivinar un ganador permanente durante la semana de lanzamiento.
Una comparación justa necesita dos carriles, no ajustes idénticos
Configurar ambos modelos con la misma palabra de esfuerzo no crea igualdad. Gemini usa medium de forma predeterminada y admite low, medium y high; minimal se rechaza. Fable mantiene el razonamiento adaptativo activo, parte de high y añade xhigh y max. Un high de un proveedor no representa el mismo presupuesto interno que un high del otro.
Una evaluación útil puede separar dos carriles:
- Valores predeterminados del proveedor. Ejecuta Gemini en
mediumy Fable enhigh. Este carril responde a una pregunta operativa real: qué ocurre si integras cada modelo como recomienda su propia configuración inicial. - Límite de servicio equivalente. Fija para ambos el mismo tiempo máximo, número de llamadas a herramientas, permisos, requisito de salida y condición de parada. Ajusta el esfuerzo dentro de lo que admite cada API, pero registra la configuración en vez de fingir que es idéntica.
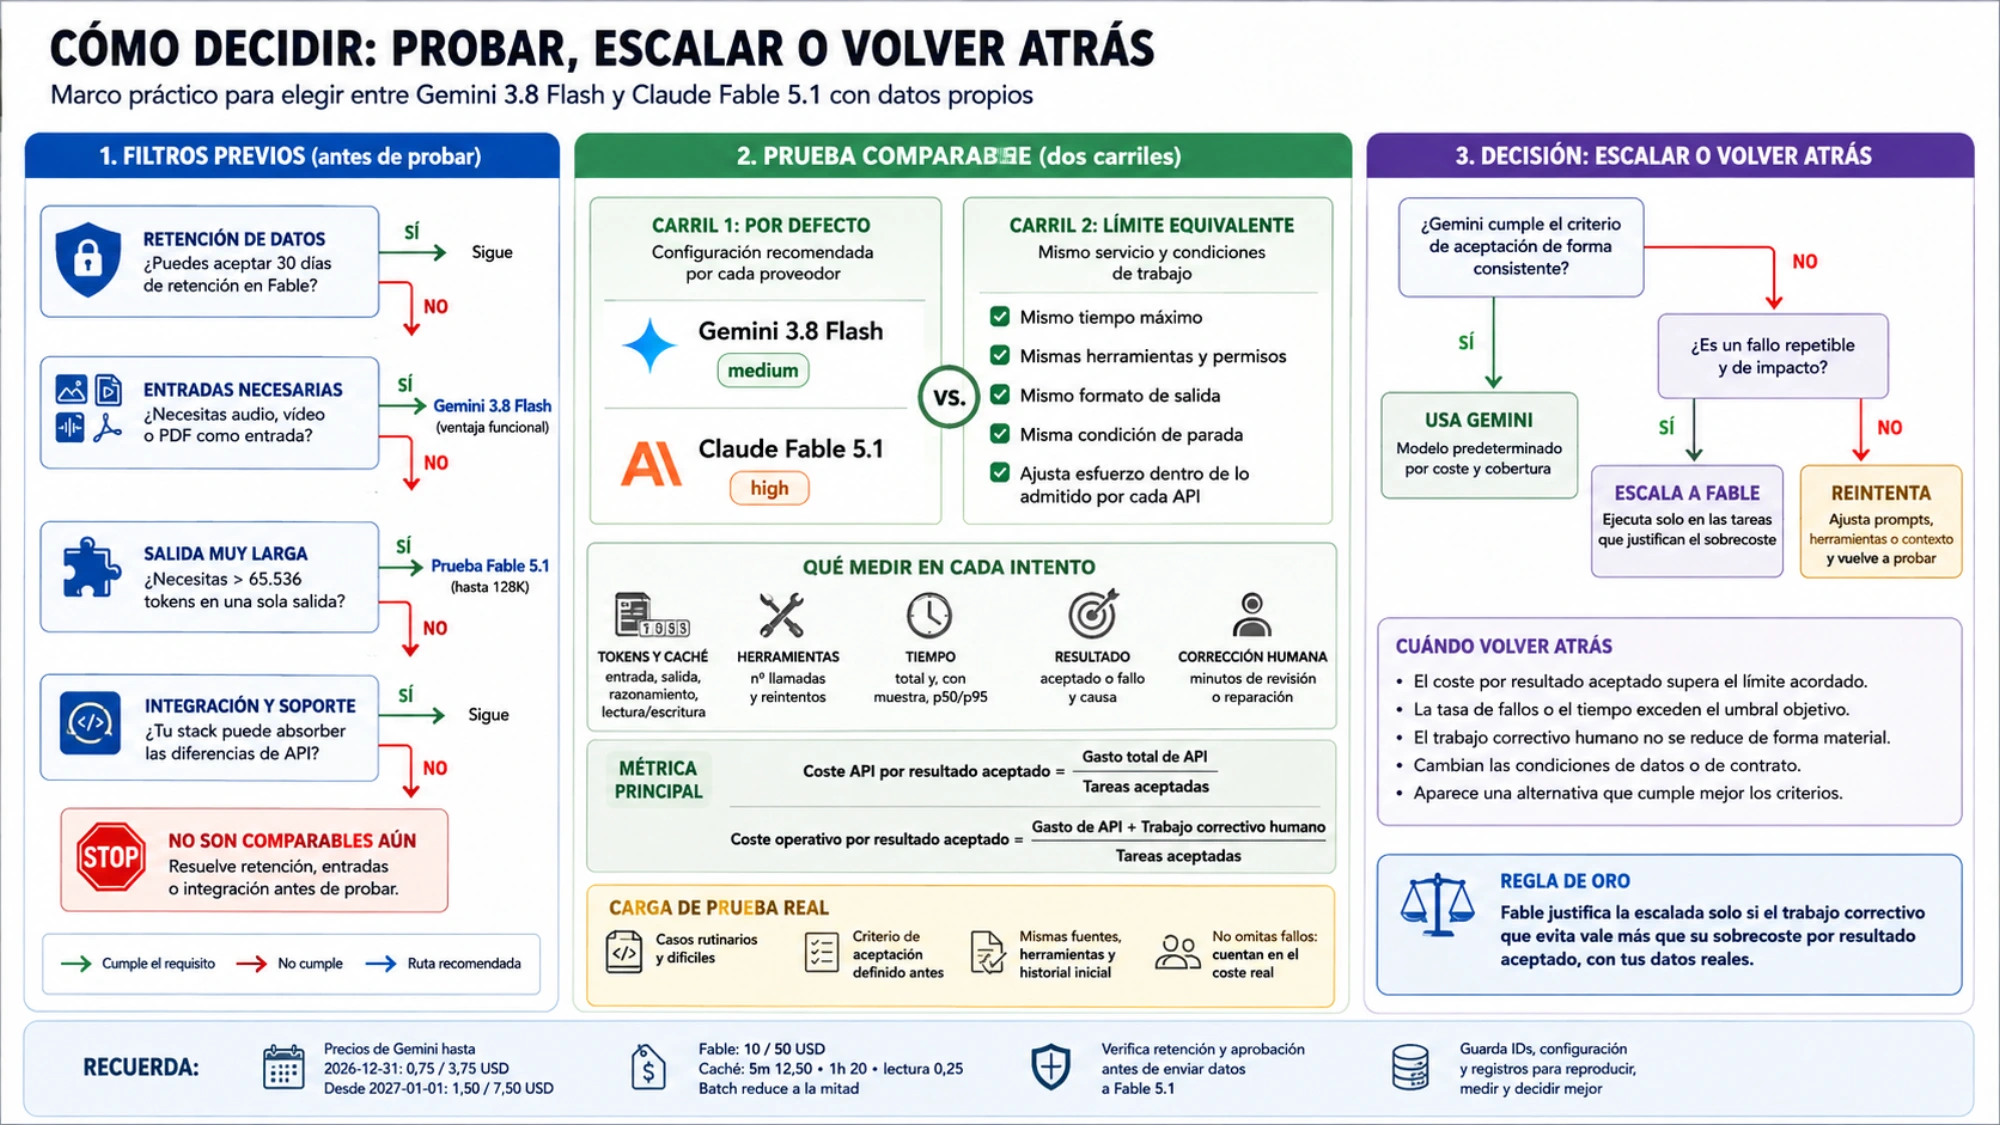
El conjunto de tareas debe proceder del trabajo que vas a desplegar. Incluye casos rutinarios y difíciles, además de ejemplos que suelan fallar. Para programación, conserva el mismo commit inicial, pruebas y definición de terminado. Para investigación, entrega las mismas fuentes y exige las mismas citas comprobables. Para agentes, usa el mismo esquema de herramientas y la misma autorización. Para gran volumen, mide una muestra que represente la distribución real de tamaños, no solo el caso más vistoso.
Antes de ejecutar, fija qué significa “aceptado”. Puede ser que pasen las pruebas, que todos los campos de una extracción sean correctos, que las citas respalden las afirmaciones o que una persona apruebe el resultado sin cambios materiales. La regla debe existir antes de ver qué modelo produjo la respuesta.
Registra al menos estos datos por intento:
| Campo | Para qué sirve |
|---|---|
| Tarea y versión del conjunto | Evita comparar entradas distintas |
| Modelo, nivel de esfuerzo y ruta | Permite reproducir la configuración |
| Tokens de entrada, salida, razonamiento y caché | Reconstruye la factura según cada proveedor |
| Llamadas a herramientas y reintentos | Muestra cuánto trabajo necesitó el modelo |
| Tiempo total y, con suficiente muestra, p50/p95 | Separa velocidad percibida de latencia medida |
| Resultado aceptado y causa del fallo | Convierte calidad en una condición observable |
| Minutos de corrección humana | Captura el coste que no aparece en la API |
No promedies solo los intentos que terminaron bien. El gasto y el tiempo de los fallos forman parte del coste de obtener un resultado aceptado.
Los detalles de migración pueden invalidar una prueba de Fable
La guía de migración de Fable 5.1 describe cambios que deben resolverse antes de atribuir un fallo a la capacidad del modelo. El razonamiento está siempre activo y ya no se controla con budget_tokens. El prellenado de mensajes del asistente produce error. Los tipos any y herramienta con nombre en tool_choice devuelven un 400. Además, modelos anteriores no pueden consumir sus bloques de razonamiento, y cambiar partes previas del historial puede invalidarlos.
Si el adaptador oculta uno de estos errores y luego cuenta el intento como “Fable falló”, la comparación queda contaminada. Conserva la respuesta completa, el código de estado, la selección efectiva de modelo y las llamadas a herramientas. Una respuesta HTTP correcta tampoco prueba por sí sola que la tarea haya terminado conforme al criterio de aceptación.
En Gemini, comprueba que thinking_level usa un valor admitido y no copies minimal desde otra familia. Verifica también que la capacidad que necesitas pertenece a esta superficie concreta: disponer de entradas multimodales no significa que el modelo genere audio o imágenes, y Computer Use sigue marcado como Preview.
Si ya tienes una integración con Gemini 3.7, no hace falta sustituirla a ciegas. Google mantiene ese modelo y advierte de que 3.8 puede consumir más razonamiento y herramientas en problemas complejos. La guía española de migración a Gemini 3.8 Flash explica cómo introducirlo como candidato reversible. Para entender por separado las categorías de caché y el lugar de Fable dentro de Claude, consulta la comparación española de Fable 5.1 y Opus 5.
Convierte los resultados en una política de escalado y vuelta atrás
Una política inicial razonable puede usar Gemini como modelo predeterminado y Fable como alternativa controlada, pero debe cambiar cuando tus datos lo indiquen.
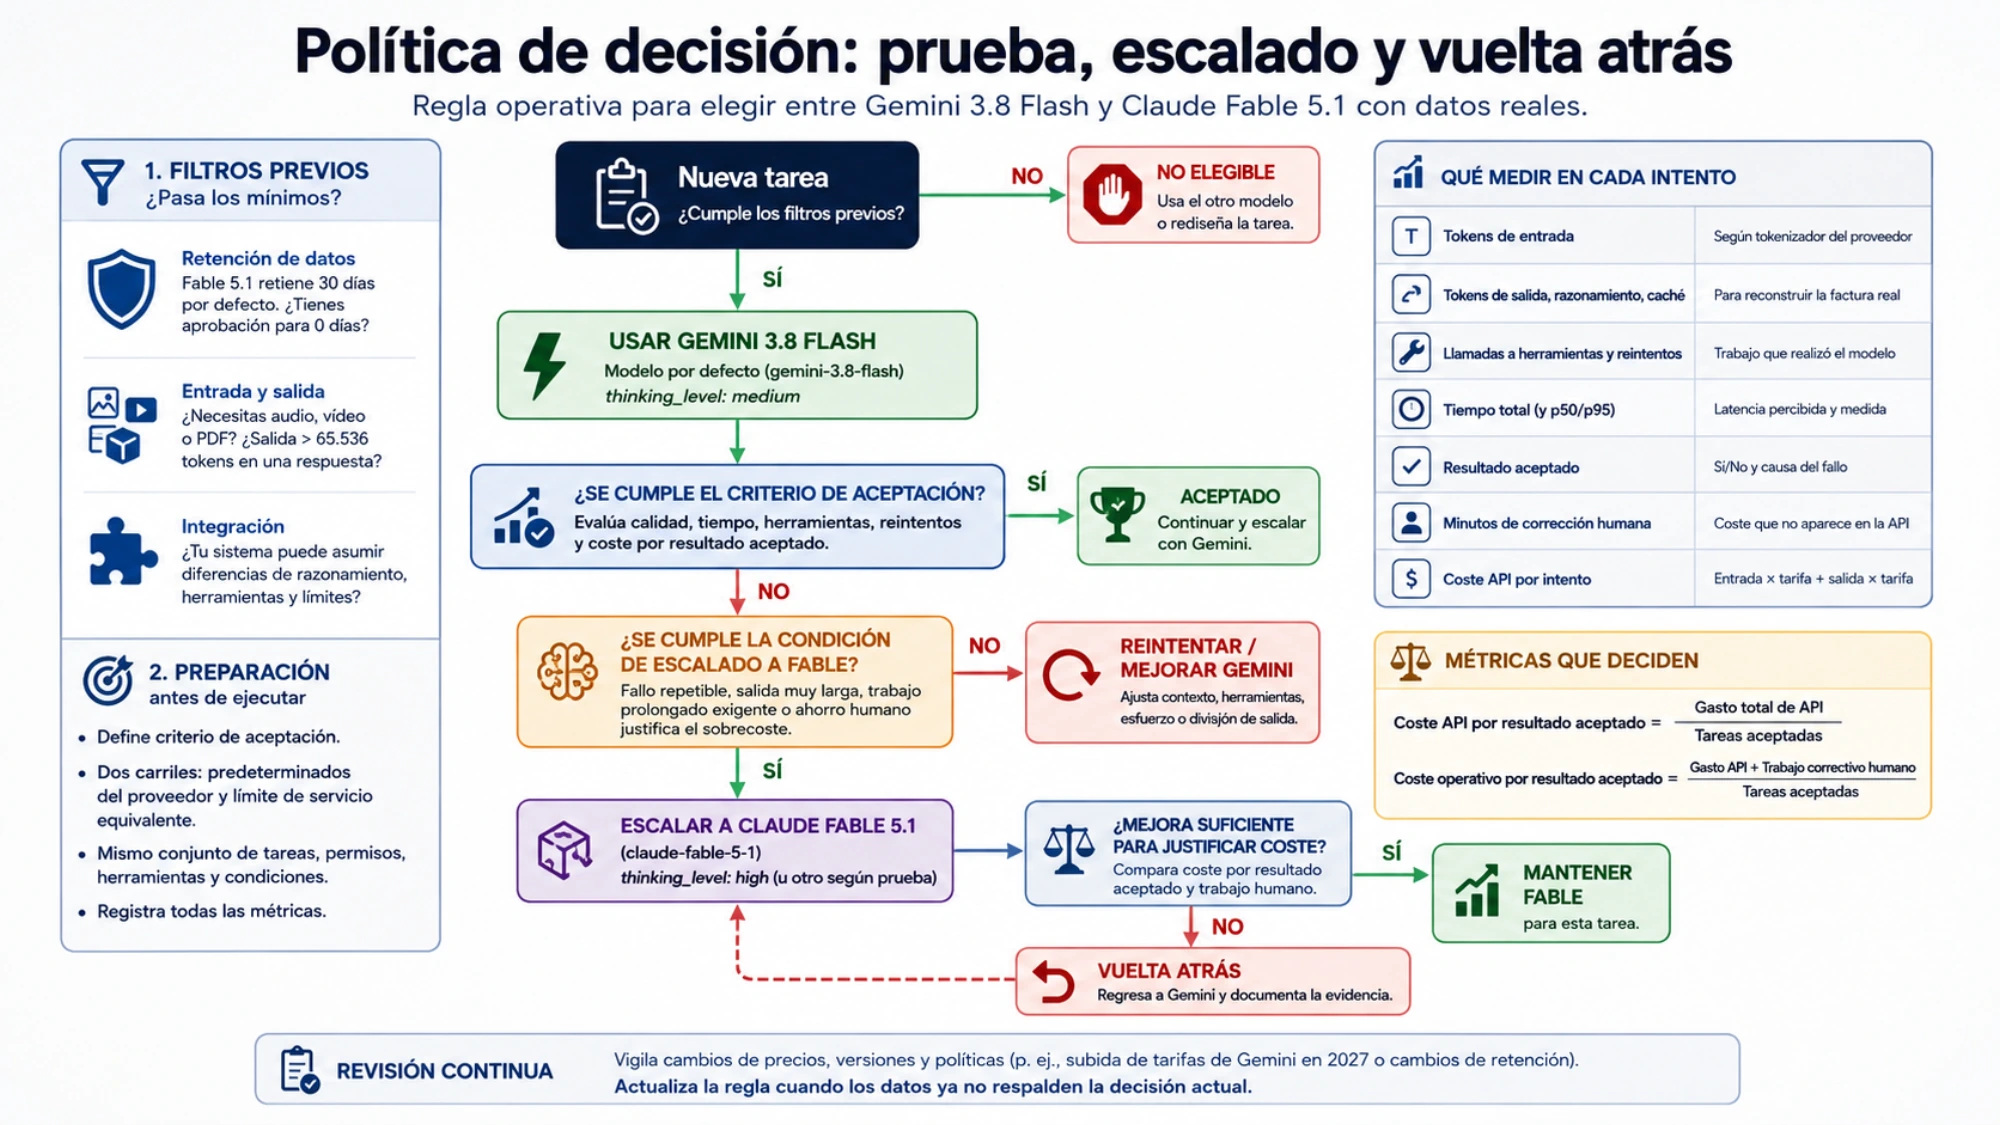
Define antes de la prueba:
- el presupuesto máximo por tarea aceptada;
- el tiempo máximo hasta obtener un resultado;
- los fallos que permiten un reintento en Gemini;
- los fallos que justifican escalar a Fable;
- el nivel de corrección humana que hace que un resultado deje de ser rentable;
- las condiciones de datos que prohíben enviar una tarea a Fable;
- el punto en el que se vuelve al modelo anterior o se detiene el despliegue.
Después, compara el ahorro humano con el sobrecoste real:
Fable justifica la escalada si el trabajo correctivo que evita vale más que su sobrecoste por resultado aceptado
No presupongas que esto ocurrirá. Si Fable mejora una prueba de referencia pero no aumenta la tasa de aceptación, no reduce los reintentos o no ahorra tiempo de revisión, su precio adicional no ha comprado una ventaja operativa. Si Gemini cuesta menos pero incumple de forma recurrente una condición importante, su tarifa baja tampoco lo convierte en el modelo adecuado.
La vuelta atrás debe ser tan concreta como la escalada. Conserva el identificador anterior, una configuración compatible y un porcentaje de tráfico que permita comparar sin bloquear a todos los usuarios. Detén o revierte el cambio cuando el coste, la tasa de fallos, la latencia o el trabajo correctivo superen los límites acordados. Una retirada rápida no es una derrota: es la función que mantiene honesta la prueba.
Fechas, conocimiento y nombres parecidos que no debes mezclar
La ficha técnica de Google sitúa el corte de conocimiento de Gemini 3.8 Flash en marzo de 2026, con la salvedad de que algunos dominios pueden permanecer en enero de 2025. Esa excepción impide presentar “marzo de 2026” como una garantía uniforme. Para información posterior, aporta fuentes desde la aplicación o usa una herramienta adecuada para fundamentar la respuesta y comprueba la cita; no atribuyas actualidad al nombre del modelo. La precisión sobre el corte procede de la ficha de modelo de DeepMind.
La vida útil también es asimétrica. La página de retiradas de Gemini no anuncia actualmente una fecha de cierre para gemini-3.8-flash; eso no garantiza que vaya a durar indefinidamente. La política de retiradas de Claude indica que Fable 5.1 no se retirará antes del 1 de septiembre de 2027. Conviene guardar el ID efectivo y revisar estos documentos antes de una migración relevante.
Por último, no confundas las variantes restringidas con las ofertas públicas. Gemini 3.8 Flash Cyber se distribuye mediante el programa Fairwind y no es otro nombre para gemini-3.8-flash; la explicación española de Fairwind cubre esa vía separada. Claude Mythos 5.1 pertenece a Project Glasswing y tampoco representa el acceso ordinario a Fable. No hay base pública para inventarles un ID, un precio o una aprobación general.
La decisión duradera es una regla medible
Gemini 3.8 Flash ofrece la mejor primera prueba para gran parte del trabajo cotidiano y de alto volumen porque combina una tarifa muy inferior, estado estable, contexto amplio y más modalidades de entrada. Claude Fable 5.1 merece entrar cuando el trabajo prolongado y difícil, la salida muy larga o el coste de un fallo hacen plausible que una mejora de aceptación compense su precio y sus restricciones.
Eso sigue siendo una hipótesis hasta que ambos recorren tu conjunto de tareas. El resultado final no debería ser “Gemini gana” o “Fable gana”, sino una regla que tu sistema pueda aplicar: qué modelo recibe cada tarea, qué señal activa el escalado, cuánto cuesta un resultado aceptado y qué umbral obliga a volver atrás. Cuando esa regla se apoya en tus propios fallos, tiempos y costes, puede sobrevivir al siguiente cambio de precios o de versión.