Claude Batch API: precio al 50 % y cuándo el caché ahorra más
A 30 de octubre de 2026, la Batch API de Claude cobra la mitad, pero si tu prompt repite un prefijo largo, las llamadas normales con caché pueden costar menos.
En esta página

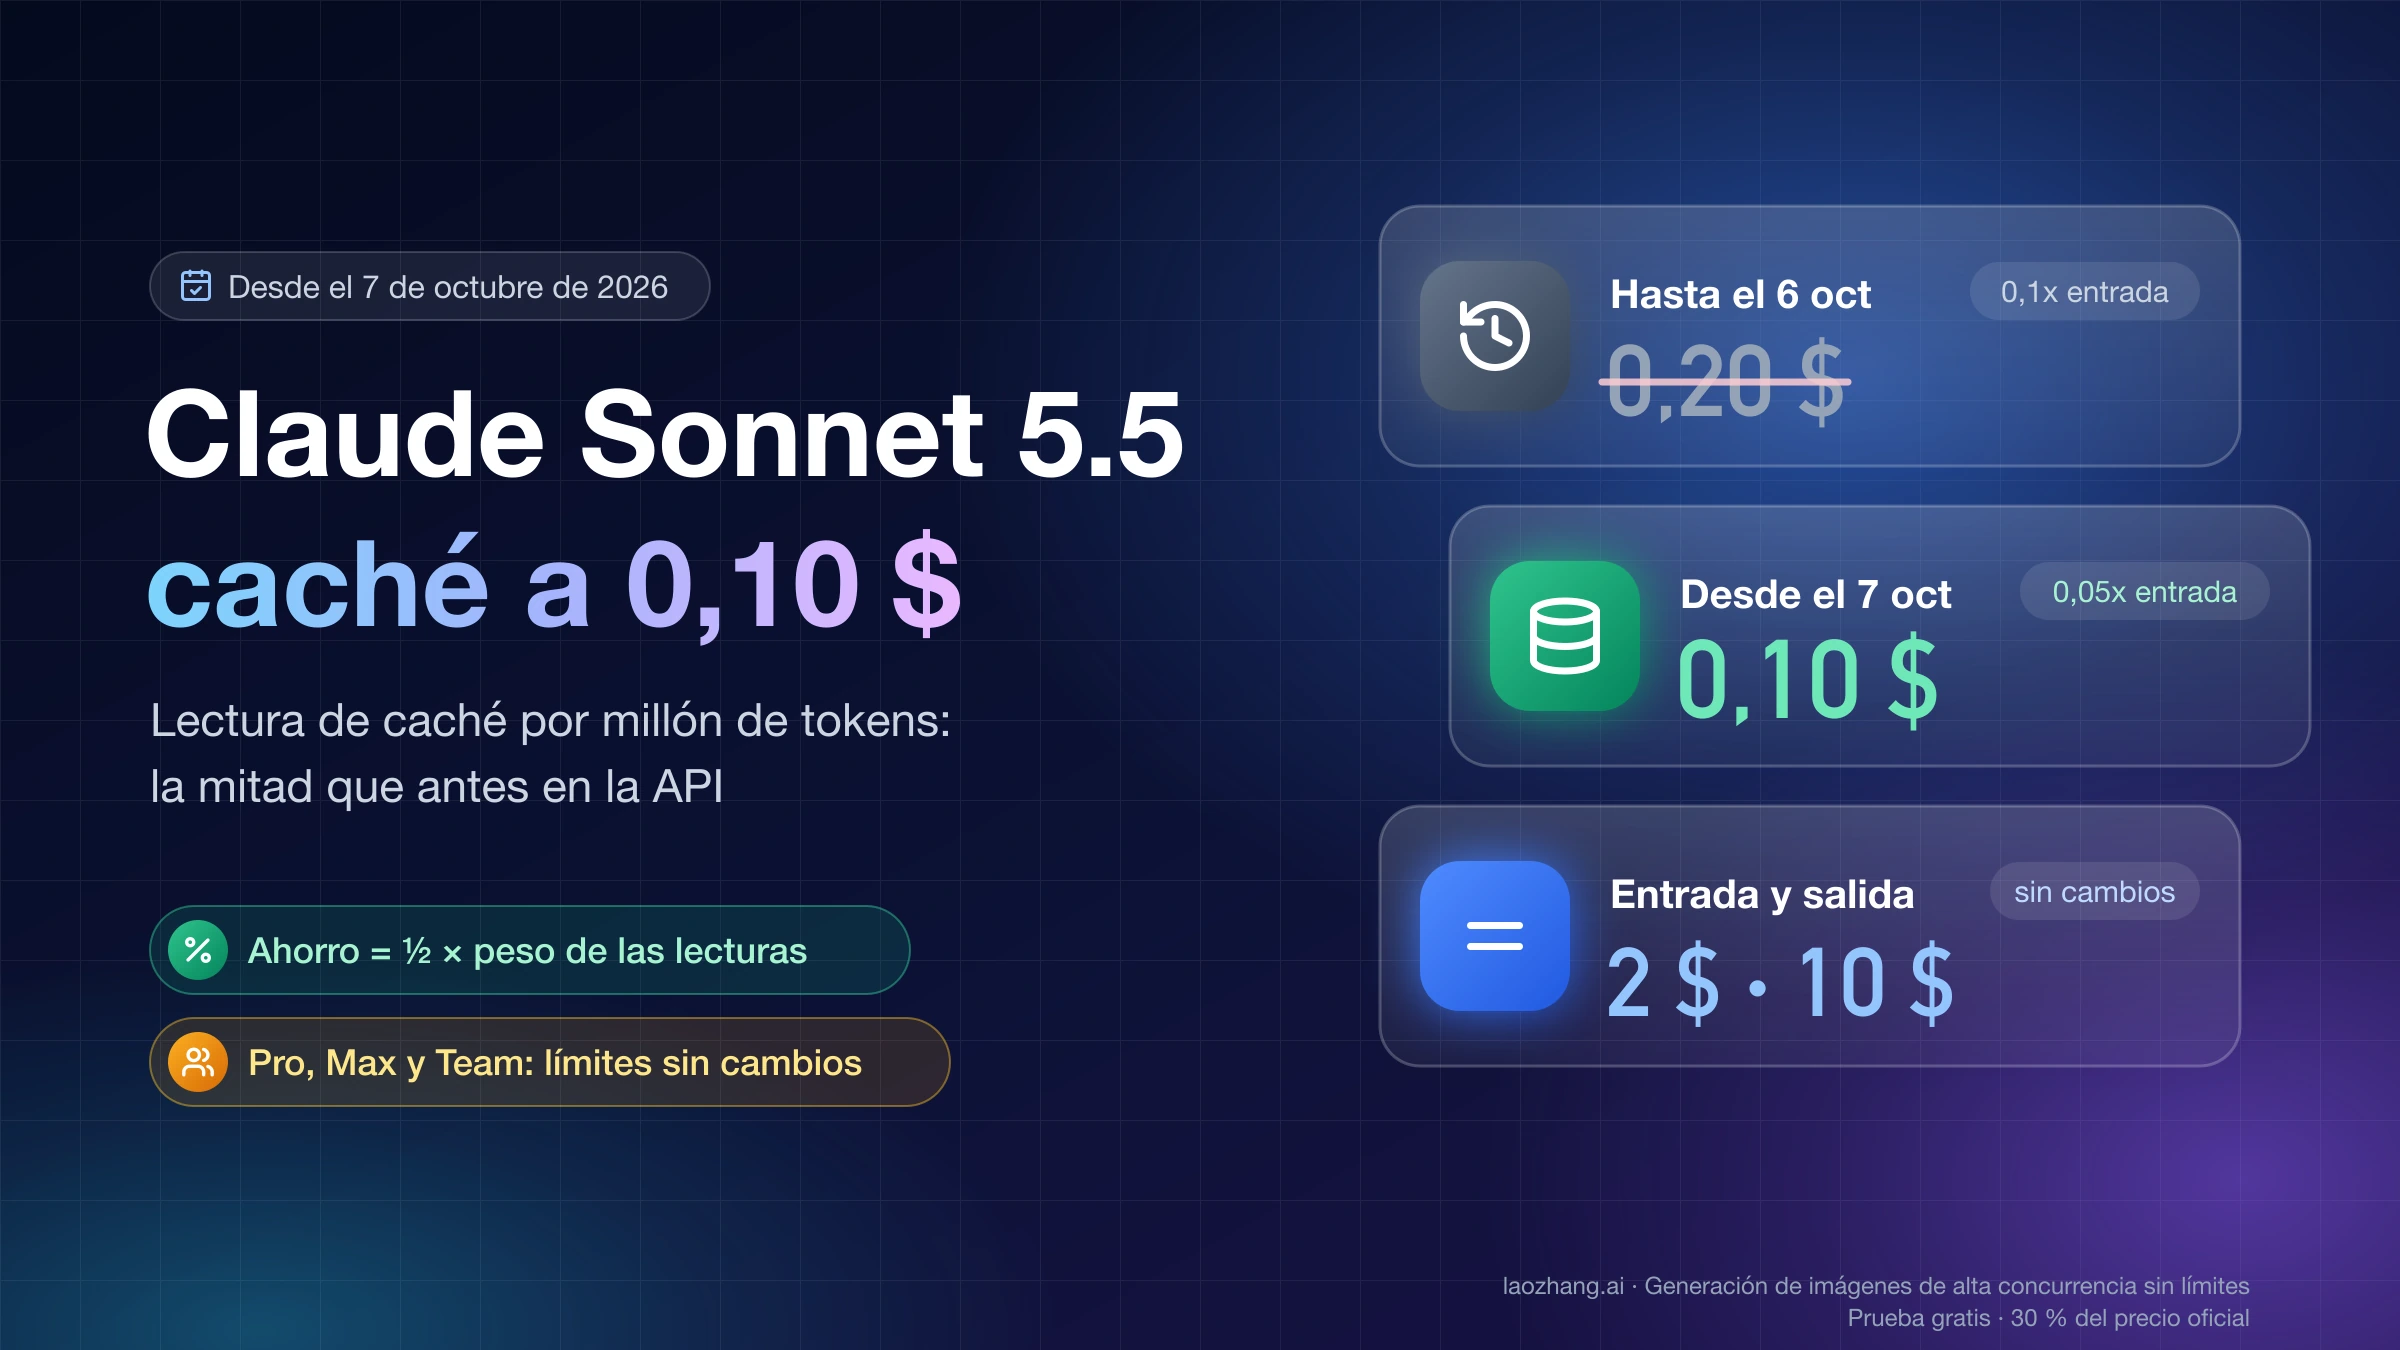
La Claude Batch API, cuyo nombre oficial es Message Batches API, procesa solicitudes de la Messages API de forma asíncrona y cobra el 50 % de la tarifa estándar en tokens de entrada, de salida y especiales. A 30 de octubre de 2026, Claude Sonnet 5.5 pasa así de 2 $ / 10 $ a 1 $ / 5 $ por millón de tokens, y Opus 5.5 de 4 $ / 20 $ a 2 $ / 10 $, según la documentación de procesamiento por lotes de Anthropic. A cambio, esperas: la mayoría de los lotes termina en menos de una hora, pero el plazo máximo es de 24 horas y lo que no se procesa en ese tiempo caduca.
Que tu factura baje a la mitad o más depende de cuánto pesa el prefijo que repiten todas tus solicitudes, porque el lote rebaja todo a la mitad y el caché de prompts solo toca ese prefijo, aunque lo deja en 0,05× en Sonnet y Opus 5.5. Con las tarifas de lista a 30 de octubre de 2026 y 10.000 solicitudes en Sonnet 5.5 (prefijo común de 3.000 tokens, 800 tokens propios y 250 de salida cada una), las llamadas normales sin caché cuestan 101 $, un lote sin caché 50,50 $, las llamadas normales con caché casi siempre acertado 44 $ y un lote con caché al 98 % de aciertos 22,72 $. Si tu carga se parece a esa y ya usas caché enviando las solicitudes seguidas, pasar a un lote sin caché te saldría más caro: pon el mismo bloque cache_control en cada solicitud del lote, que con el TTL de 5 minutos compensa a partir de un 21 % de aciertos.
El lote se envía con POST /v1/messages/batches: cada solicitud lleva un custom_id y sus params, consultas processing_status hasta que valga ended y emparejas los resultados por custom_id, porque no llegan en orden. El descuento existe en la API de Claude, en Claude Platform on AWS y en Claude en Google Cloud gestionado por Anthropic; Amazon Bedrock y Vertex AI tienen sus propios productos por lotes con otras condiciones. No lo confundas con /batch de Claude Code, que reparte un cambio de código entre varios subagentes en paralelo y no tiene relación con esta API ni con su precio.
¿Cuánto ahorra la Claude Batch API? La misma carga en cuatro modelos
En esta carga, el lote solo gana a las llamadas normales con caché cuando también lleva caché dentro. La tabla aplica las tarifas de la API de Claude a 30 de octubre de 2026 a 10.000 solicitudes con 3.000 tokens de prefijo compartido, 800 tokens propios y 250 de salida cada una, con enrutamiento global. La columna «normal + caché» supone que casi todas las solicitudes aciertan, lo que exige enviarlas seguidas para que la entrada de 5 minutos no caduque. En el lote, cada fallo vuelve a escribir el prefijo a 1,25×, y el 30 % y el 98 % de aciertos son los extremos del rango que Anthropic describe como habitual dentro de un lote.
| Modelo | Tarifa de lote por MTok (entrada / salida) | Normal sin caché | Normal + caché | Lote sin caché | Lote + caché, 30 % aciertos | Lote + caché, 98 % aciertos |
|---|---|---|---|---|---|---|
| Haiku 5.5 (prompt hasta 100.000 tokens) | 0,05 $ / 0,25 $ | 5,05 $ | 2,35 $ | 2,52 $ | 2,38 $ | 1,21 $ |
| Sonnet 5.5 | 1 $ / 5 $ | 101,00 $ | 44,00 $ | 50,50 $ | 47,20 $ | 22,72 $ |
| Opus 5.5 | 2 $ / 10 $ | 202,00 $ | 88,00 $ | 101,00 $ | 94,40 $ | 45,44 $ |
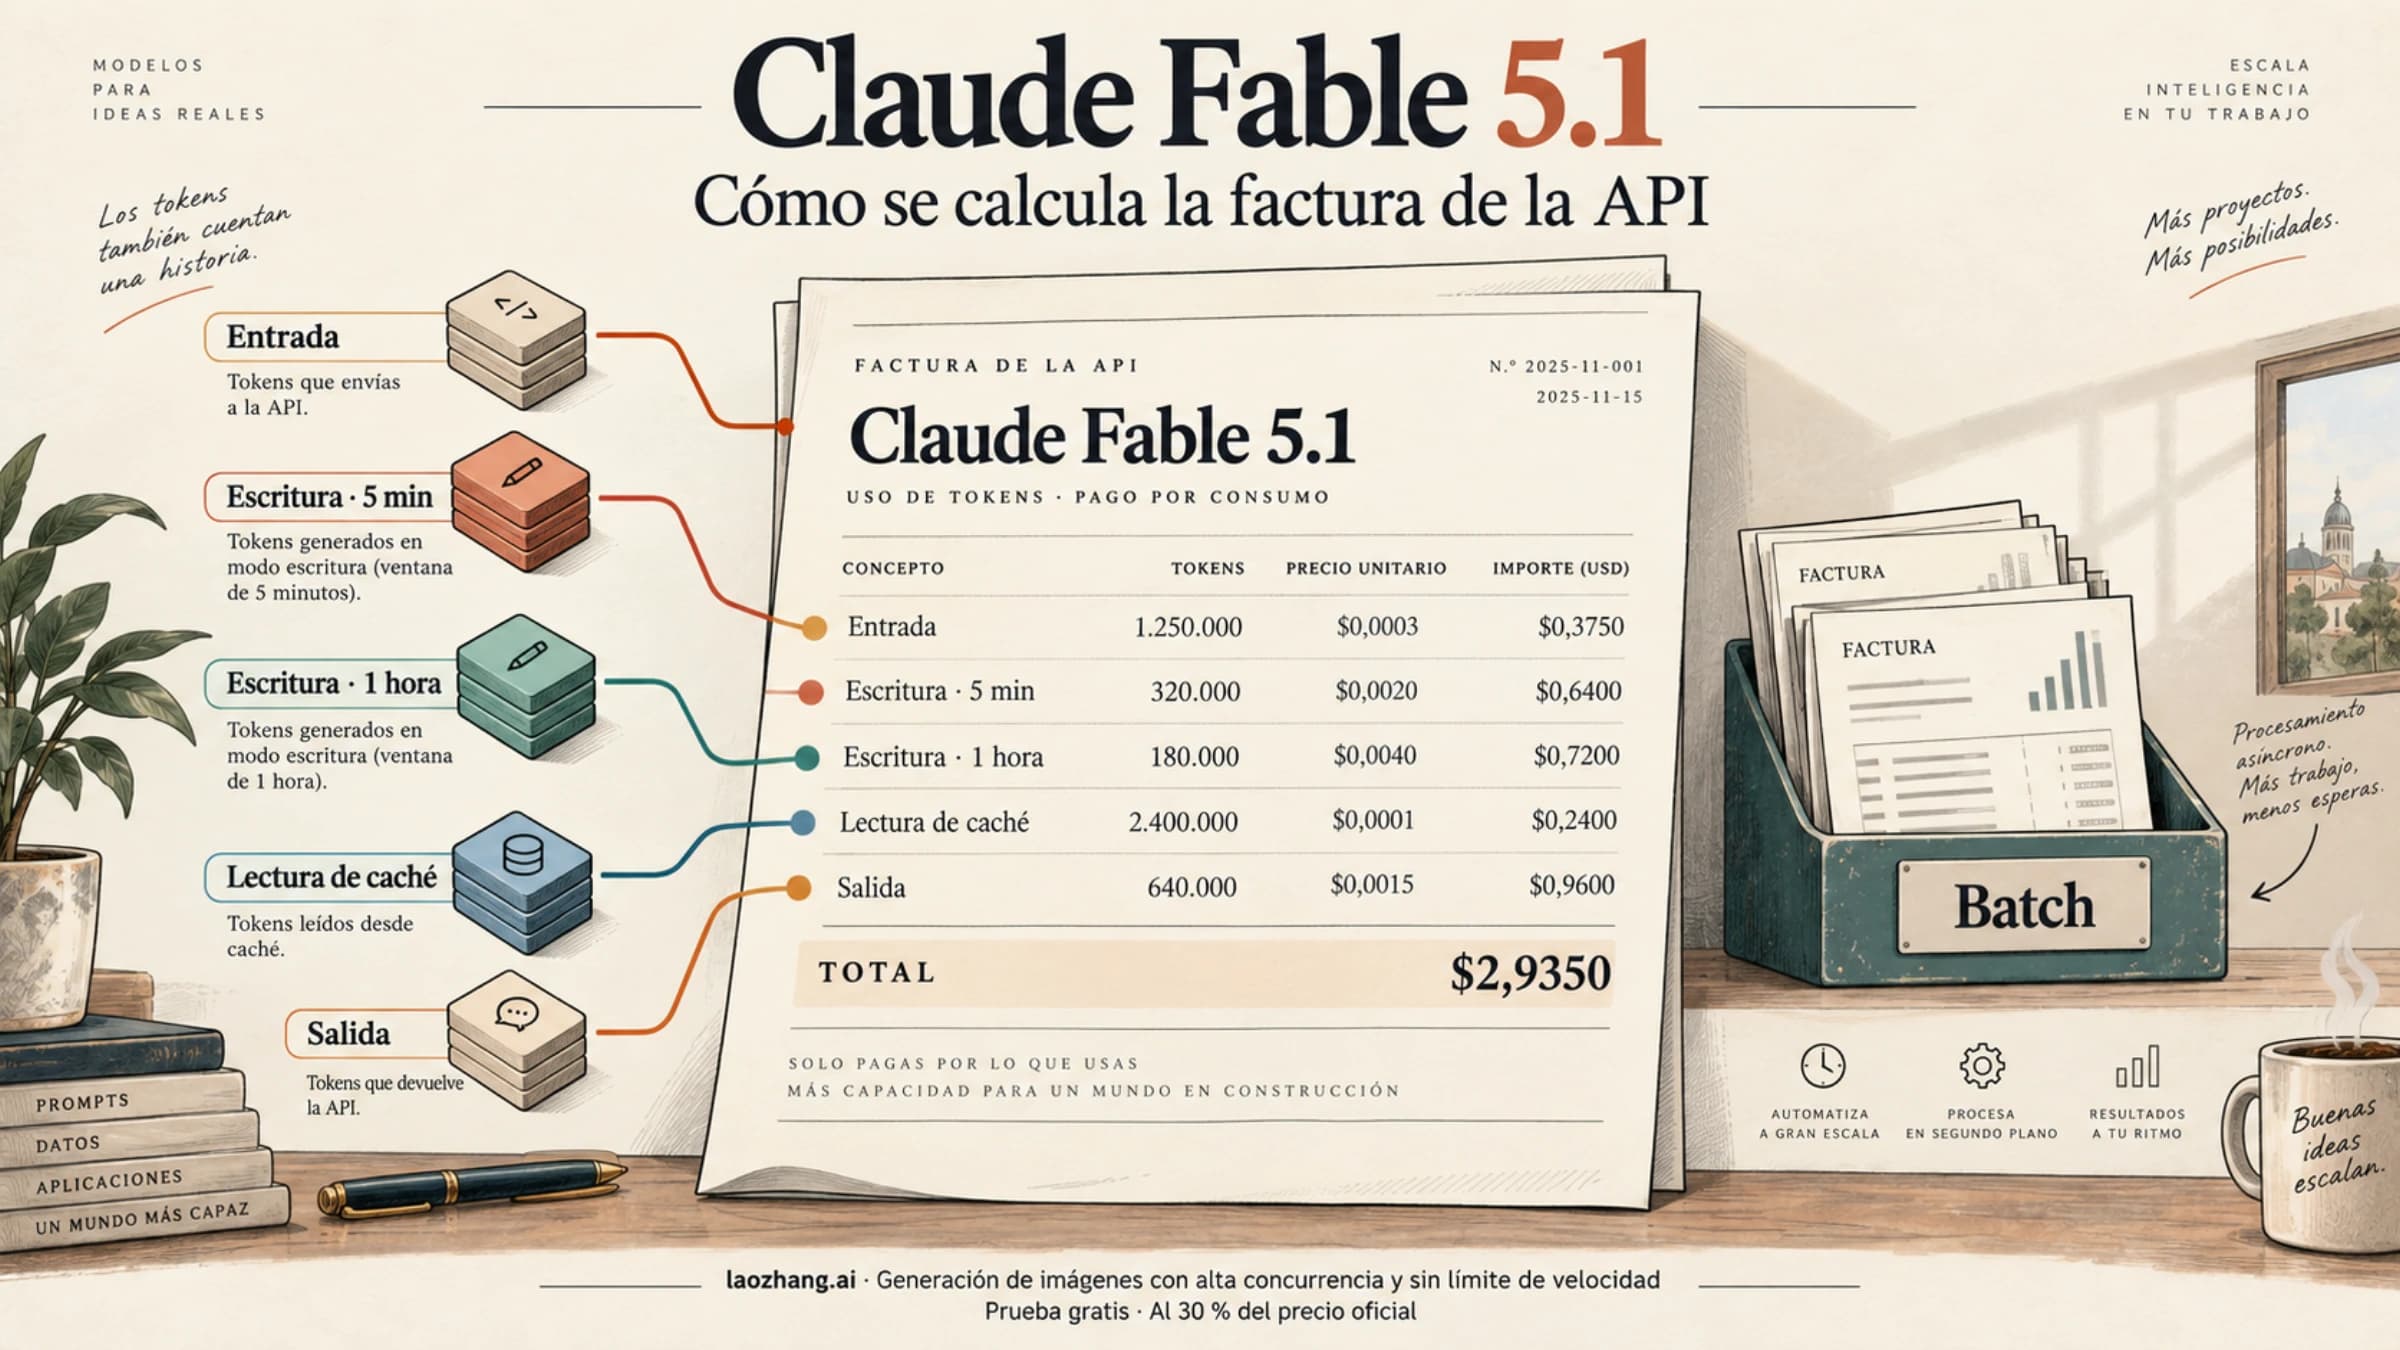
| Fable 5.1 | 5 $ / 25 $ | 505,00 $ | 212,50 $ | 252,50 $ | 234,88 $ | 109,92 $ |
La explicación está en el reparto de la factura. Sin caché, en Sonnet 5.5 cada solicitud cuesta 3.800 × 2 $ + 250 × 10 $ por millón de tokens, es decir, 0,0101 $: el prefijo compartido es el 59 % de ese importe, la parte propia el 16 % y la salida el 24,8 %. El caché recorta el 95 % de ese 59 % y deja intacto lo demás, mientras que el lote recorta todo a la mitad, incluida la salida, que el caché nunca abarata. Como regla, las llamadas normales con caché salen más baratas que un lote sin caché cuando el prefijo cacheable supera 1 / (2 × (1 − r)) de la factura sin caché, siendo r el multiplicador de lectura: el 52,6 % en Sonnet y Opus 5.5 (0,05×), el 55,6 % en Haiku 5.5 (0,1×) y el 51,3 % en Fable 5.1 (0,025×). Si tu carga va al revés, con prompts casi únicos o salidas largas como reescrituras e informes, el caché tiene poco que recortar y el lote es la palanca principal.

La misma tabla sirve para otros modelos con sus propias tarifas de lote: Opus 5, 4.8, 4.7, 4.6 y 4.5 cuestan 2,50 $ / 12,50 $, Sonnet 4.6 y 4.5 cuestan 1,50 $ / 7,50 $ y Haiku 4.5, 0,50 $ / 2,50 $; Haiku 5.5 sube a 0,25 $ / 1,25 $ cuando el prompt pasa de 100.000 tokens. El recargo de residencia de datos (inference_geo: "us", 1,1×) se suma al descuento, y en los modelos 4.6 o posteriores, salvo Haiku 5.5, el contexto de 1 millón de tokens se factura a tarifa estándar, así que el 50 % se aplica a toda la ventana. El detalle por modelo está en Precio de la API de Claude Fable 5.1 y cuánto baja tu factura y, para la bajada de la lectura en caché, en Claude Sonnet 5.5: precio de caché a 0,10 $ y cuánto ahorras.
Caché dentro del lote: compensa por encima del 21 % de aciertos
Activar el caché de prompts dentro de un lote compensa, con el TTL de 5 minutos, si aciertan más del 20,8 % de las solicitudes en Sonnet y Opus 5.5, el 21,7 % en Haiku 5.5 y el 20,4 % en Fable 5.1. Con el TTL de 1 hora los umbrales suben al 51,3 %, el 52,6 % y el 50,6 %. Por debajo de esa tasa, las escrituras que paga cada fallo cuestan más de lo que ahorran las lecturas. El umbral sale de comparar el coste del prefijo con caché, aciertos × r + fallos × w, con el prefijo sin caché: compensa si aciertos > (w − 1) / (w − r), con w = 1,25 para 5 minutos o 2 para 1 hora y r = 0,05, 0,1 o 0,025 según el modelo. Esos multiplicadores, según la página de precios de Anthropic, se acumulan con el descuento del lote.
Anthropic indica que en los lotes la tasa de aciertos suele ir del 30 % al 98 %, porque las solicitudes se procesan a la vez y en cualquier orden y el caché funciona como mejor esfuerzo. Con 5 minutos, incluso el extremo bajo supera el umbral: en Sonnet 5.5 el lote pasa de 50,50 $ a 47,20 $ con un 30 % de aciertos y a 22,72 $ con un 98 %. El TTL de 1 hora es otra apuesta. Anthropic lo sugiere para lotes con contexto compartido porque un lote puede tardar más de 5 minutos, pero con un 30 % de aciertos el mismo lote en Sonnet 5.5 cuesta 62,95 $, más que sin caché. Solo compensa si la hora de vida sube tus aciertos por encima del 51 %, algo que no sabrás hasta ver los tokens leídos de caché en el usage de los resultados de un primer lote.
Para acercarte al extremo alto, Anthropic recomienda poner bloques cache_control idénticos en todas las solicitudes, compartir en el prefijo todo el contenido posible y mantener un flujo constante de solicitudes para que las entradas de 5 minutos no caduquen. Precalentar el caché con max_tokens: 0 no está permitido dentro de un lote. Cómo se activa el caché, qué TTL elegir y cuánto cuesta leerlo en cada modelo lo explica Claude prompt caching: cómo activarlo, precio y cuándo sale caro.
Cómo enviar un lote, consultar su estado y recoger los resultados
Un lote es una lista de solicitudes normales de la Messages API, cada una con un custom_id propio, que envías de una vez y recoges cuando termina el lote entero. Necesitas una clave de la Claude Console con saldo (cómo conseguirla está en Claude API key gratis: crédito de prueba, Max y cómo comprar) y el SDK oficial: el de Python anthropic 2.3.0 y el de TypeScript @anthropic-ai/sdk 1.3.0, ambos del 23 de octubre de 2026, incluyen messages.batches.create, retrieve, list, cancel, delete y results.
- Prueba una solicitud con la misma forma en la Messages API normal. Los parámetros del lote se validan de forma asíncrona y los errores solo aparecen cuando ha terminado el lote completo, así que un fallo de formato puede costarte horas de espera.
- Construye cada solicitud con un
custom_idúnico dentro del lote, de 1 a 64 caracteres (letras, dígitos,-y_), y enparamslos mismos campos que usarías en una llamada normal, conmax_tokensde al menos 1. - Envía la lista con
client.messages.batches.create(requests=...), que llama aPOST /v1/messages/batches, y guarda elidque devuelve. - Consulta el lote cada minuto o así con
retrievehasta queprocessing_statuspase dein_progressaended. No hay webhook documentado, y enrequest_countstodo figura comoprocessinghasta el final. - Recorre
results()en streaming y guarda cada resultado bajo sucustom_id, porque el orden del archivo.jsonlno coincide con el de envío. - Reenvía en un lote nuevo las solicitudes caducadas y las que fallaron por error del servidor; las que devolvieron
invalid_request_errorse corrigen antes de reenviarlas.

import time
import anthropic

client = anthropic.Anthropic()  # lee ANTHROPIC_API_KEY

def make_request(custom_id: str, text: str) -> dict:
    return {
        "custom_id": custom_id,  # 1-64 caracteres: letras, dígitos, - y _
        "params": {
            "model": "claude-haiku-5-5",
            "max_tokens": 300,
            "messages": [{"role": "user", "content": text}],
        },
    }

def run_batch(requests: list[dict], poll_seconds: int = 60) -> tuple[dict, list[str], list[str]]:
    batch = client.messages.batches.create(requests=requests)
    print("creado", batch.id, batch.processing_status)
    while batch.processing_status != "ended":
        time.sleep(poll_seconds)
        batch = client.messages.batches.retrieve(batch.id)
        print("estado", batch.processing_status, batch.request_counts)
    done, retry, fix = {}, [], []
    for item in client.messages.batches.results(batch.id):  # el orden no está garantizado
        r = item.result
        if r.type == "succeeded":
            done[item.custom_id] = r.message.content[0].text
        elif r.type == "expired":
            retry.append(item.custom_id)          # no llegó al modelo, no se cobra
        elif r.type == "errored" and r.error.error.type == "invalid_request_error":
            fix.append(item.custom_id)            # reenviar el mismo cuerpo volvería a fallar
        elif r.type == "errored":
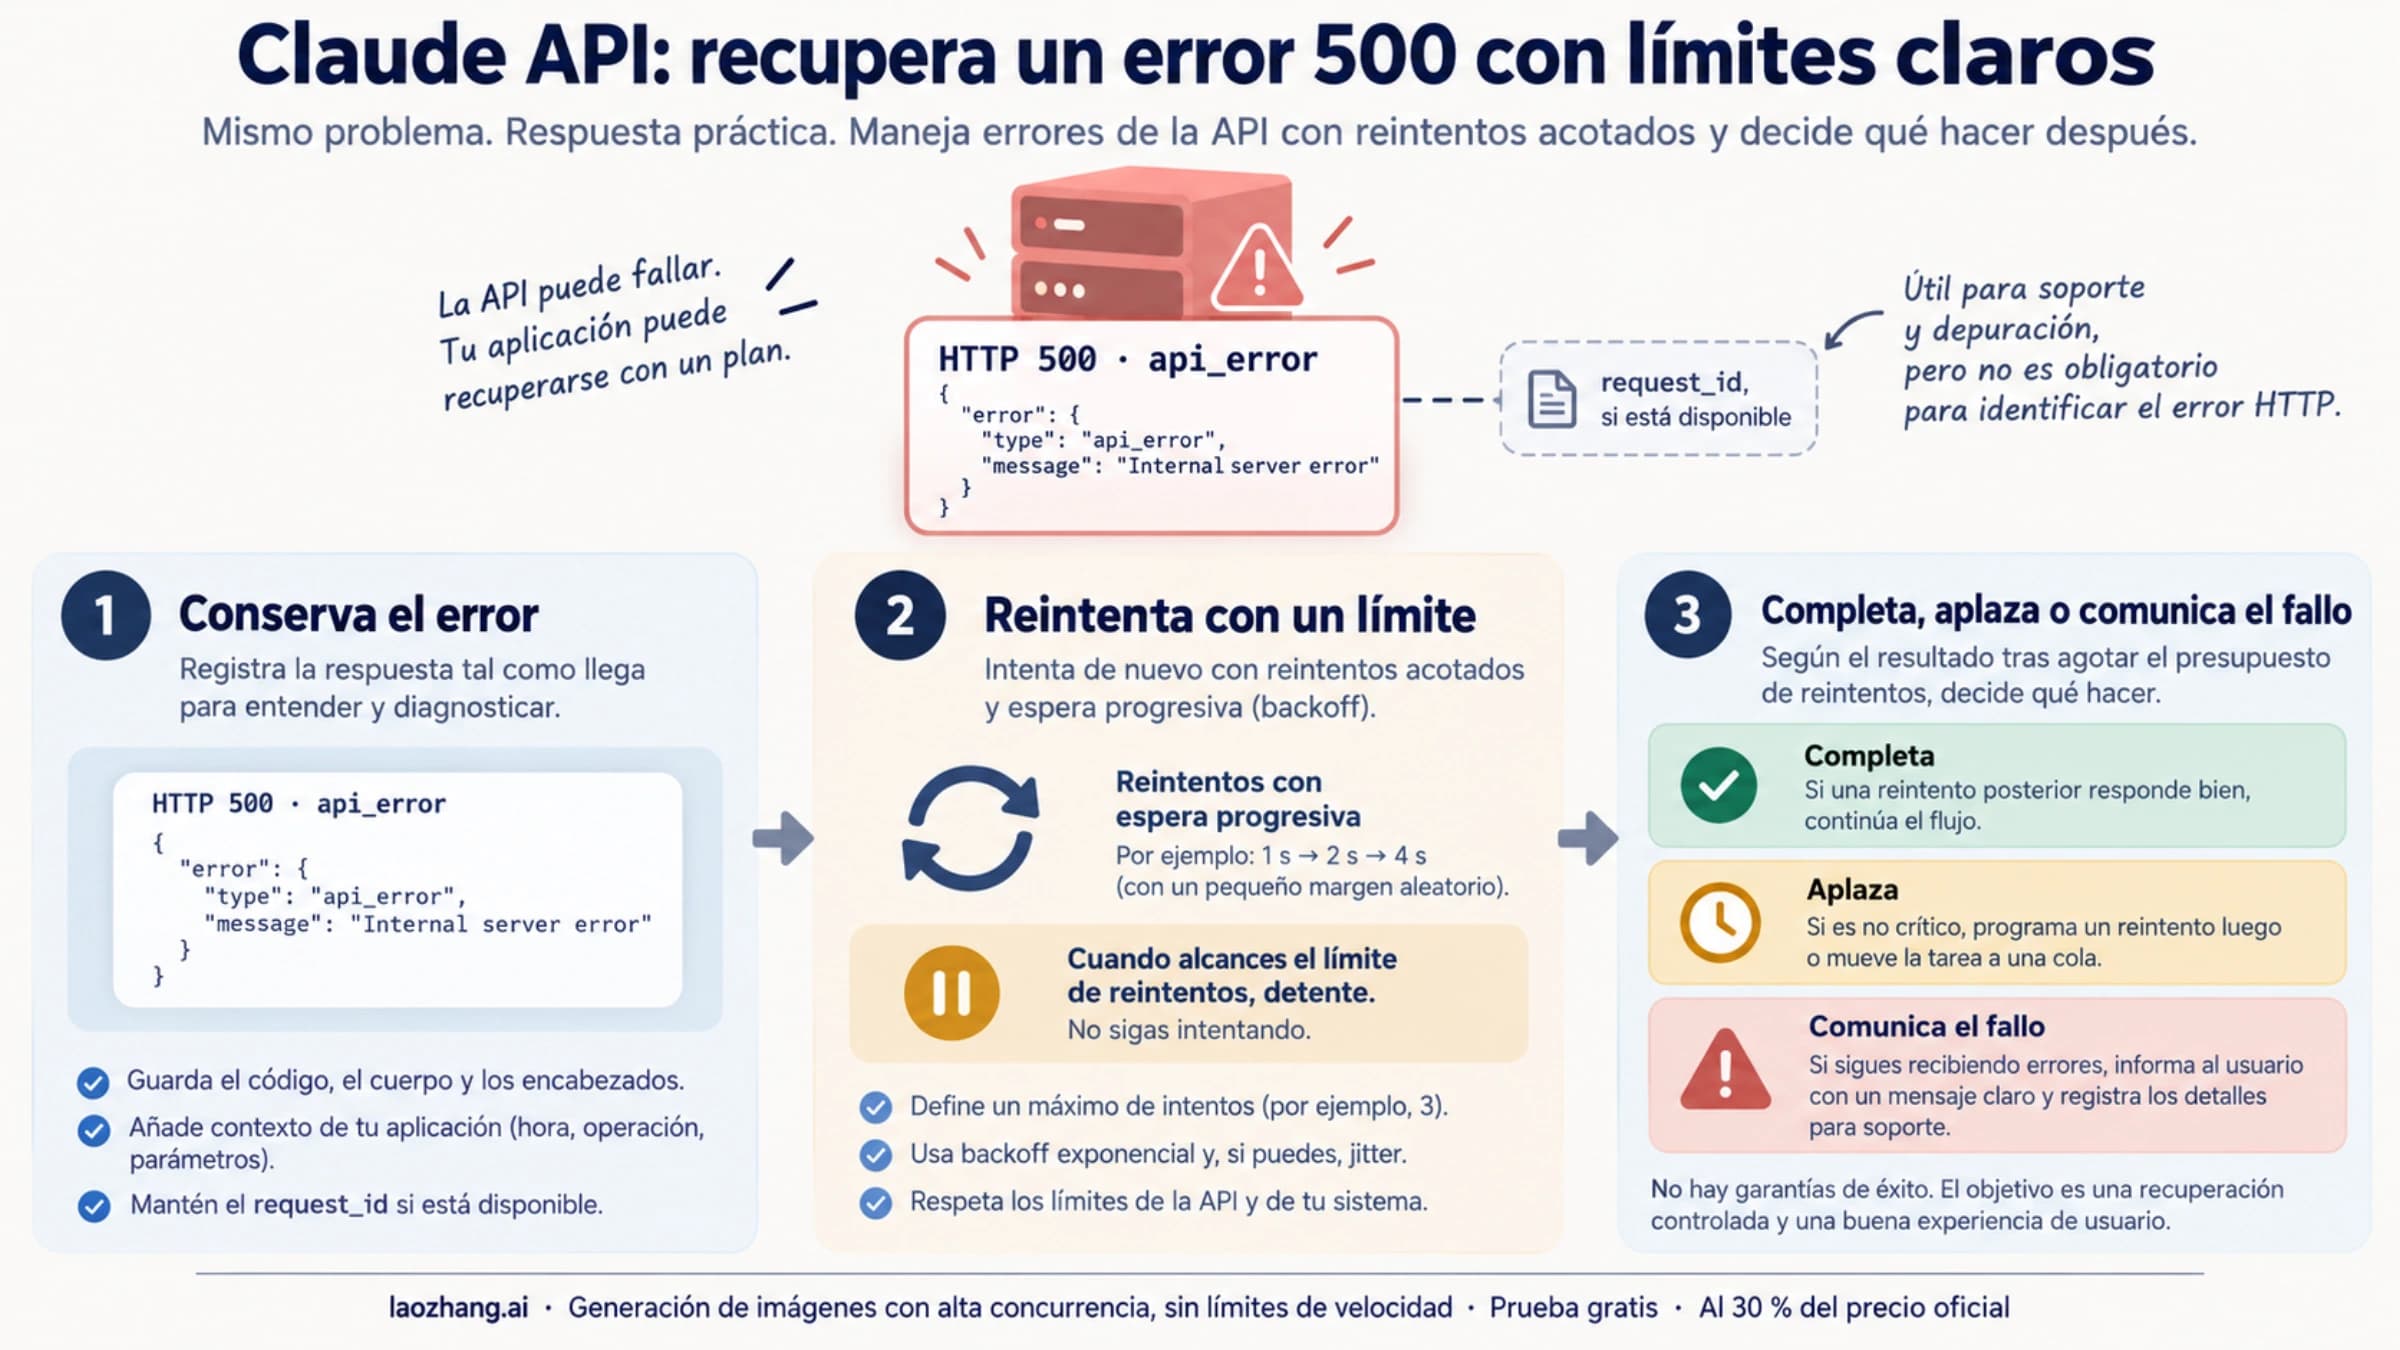
            retry.append(item.custom_id)          # error del servidor, se puede reenviar
    return done, retry, fix

if __name__ == "__main__":
    texts = {
        "doc-001": "Resume: las facturas vencen a 30 días.",
        "doc-002": "Resume: el envío tarda 5 días.",
        "doc-003": "Resume: se aceptan devoluciones durante 14 días.",
    }
    done, retry, fix = run_batch([make_request(c, t) for c, t in texts.items()])
    if retry:  # segunda ronda, solo con lo reintentable
        done2, retry2, fix2 = run_batch([make_request(c, texts[c]) for c in retry])
        done.update(done2)
        fix += fix2
    print("terminadas:", sorted(done), "por corregir:", sorted(fix))
El 30 de octubre de 2026, este flujo se ejecutó de principio a fin con el SDK de Python anthropic 2.3.0 contra un servidor simulado local que reproduce los endpoints y las respuestas documentadas por Anthropic, no contra los servidores de Anthropic. De cinco solicitudes, dos terminaron en succeeded, una en errored con api_error, una en expired y una en errored con invalid_request_error. Mientras duró el lote, request_counts mostró processing=5 y el resto a cero; los resultados llegaron en orden inverso y se emparejaron bien por custom_id. La solicitud con error del servidor y la caducada se reenviaron en un segundo lote y terminaron bien, y la inválida quedó apartada para corregirla. Esa prueba demuestra la lógica del código y el manejo de cada resultado; no dice nada del tiempo real de proceso, los mensajes de validación reales ni la facturación de Anthropic.
succeeded, errored, canceled y expired: qué reenviar y qué se cobra
De los cuatro tipos de resultado, solo succeeded se cobra, a tarifa de lote. Que una solicitud falle no afecta a las demás del mismo lote, así que lo normal es terminar con una mezcla y tratar cada tipo por separado, según la documentación de procesamiento por lotes:
| Resultado | Qué significa | ¿Se cobra? | Qué hacer |
|---|---|---|---|
succeeded | La solicitud terminó; el mensaje está en result.message | Sí, al 50 % | Guardarlo por custom_id; si stop_reason es pause_turn, continuar reenviando el contenido del asistente |
errored con invalid_request_error | El cuerpo de la solicitud no es válido | No | Corregir los params antes de reenviar; el mismo cuerpo volvería a fallar |
errored con otro tipo de error | Error interno del servidor | No | Reenviar la solicitud tal cual en un lote nuevo |
canceled | Cancelaste el lote antes de que se procesara esta solicitud | No | Reenviarla si todavía la necesitas |
expired | No se procesó dentro de las 24 horas | No | Reenviarla en un lote nuevo |
Un lote enviado no se puede modificar. Si te equivocaste, cancélalo con POST /v1/messages/batches/{id}/cancel: pasa a canceling y luego a ended, puede traer resultados parciales de lo ya procesado y la cancelación no siempre es inmediata. Después lo vuelves a enviar corregido. Cuando un lote ha terminado, puedes borrarlo con DELETE /v1/messages/batches/{id}; si sigue en proceso, primero hay que cancelarlo.
Límites del lote: 100.000 solicitudes, 256 MB, 24 horas y 29 días
Un lote admite hasta 100.000 solicitudes o 256 MB, lo que se alcance antes, y tiene 24 horas para procesarse. Las cifras de 10.000 solicitudes por lote que aún circulan son de la época del lanzamiento. A 30 de octubre de 2026, la documentación de Anthropic fija estos límites:
| Límite | Valor | Qué pasa si lo superas |
|---|---|---|
| Tamaño del lote | 100.000 solicitudes o 256 MB, lo primero que se alcance | Error 413 request_too_large; divide el trabajo en varios lotes |
| Tiempo de proceso | 24 horas desde la creación (expires_at) | Lo no procesado vuelve como expired |
| Descarga de resultados | Cuando terminan todas las solicitudes o a las 24 horas, lo que ocurra antes | results_url no existe hasta que el lote acaba |
| Disponibilidad de resultados | 29 días contados desde created_at, no desde el final | Pasado ese plazo ya no puedes descargarlos |
| Ámbito | El workspace de la Claude Console que creó el lote | Desde otro workspace no lo ves |
| Límite de gasto del workspace | Puede superarse ligeramente por la concurrencia | Deja margen si tu límite es ajustado |
| Retención de datos | 29 días; el lote no es apto para retención cero de datos (ZDR) | Si tu contrato exige ZDR, el lote no encaja |
Además, cada organización tiene límites propios para lotes, compartidos entre todos los modelos e independientes de los de la Messages API, según la página de límites de la API de Claude. En el nivel Start son 1.000 solicitudes por minuto a la API de lotes y 200.000 solicitudes en cola de proceso; en Build, 2.000 y 300.000; en Scale, 4.000 y 500.000, siempre con el máximo de 100.000 por lote. Las organizaciones nuevas pueden empezar en un nivel Evaluation más bajo, cuyos números no se publican. Si el error aparece en llamadas normales, el diagnóstico está en Claude API Rate Limit Reached: encuentra el límite correcto antes de reintentar y en Error 529 en Claude API: configura reintentos y controla la sobrecarga.
¿Por qué tarda o caduca un lote de Claude?
Un lote no tiene tiempo garantizado: Anthropic dice que la mayoría termina en menos de una hora, y avisa de que el proceso puede ralentizarse según la demanda del momento y el volumen que envíes, de modo que más solicitudes pueden caducar al llegar a las 24 horas. Las pocas mediciones públicas son pequeñas. En Hacker News, el usuario erans contó el 27 de abril de 2026 que, al pasar cada turno de un agente por la Batch API, un lote de una sola solicitud solía tardar entre 90 y 120 segundos y que los de Haiku le parecían más lentos que los de Sonnet u Opus, aunque él mismo dijo que no era una medición rigurosa. Developers Digest, en una guía actualizada el 18 de octubre de 2026, da una mediana de 5 a 30 minutos en sus propias pruebas.
La página de estado de Claude no registra incidentes de lotes en 2025 ni en 2026; los únicos son del 4 de noviembre de 2024 (errores elevados) y del 6 y 7 de noviembre de 2024 (retrasos de proceso). Eso no descarta ralentizaciones por demanda, que la documentación da por posibles sin publicar cifras. Las salidas largas también alargan el lote: una generación de 300.000 tokens con la beta de salida extendida puede pasar de una hora.
En la práctica, diseña el trabajo para que 24 horas sean aceptables y no cuentes con la hora habitual para nada que tenga fecha de entrega. Si te vuelven solicitudes expired, no se cobran y basta con reenviarlas; si caducan muchas, repartir el trabajo en lotes más pequeños es una opción razonable, ya que Anthropic vincula la lentitud también a tu volumen. Para un agente que espera respuesta en cada turno, 90 segundos o más por paso suelen ser demasiado, y ahí las llamadas normales con caché son la opción barata.
Qué funciones admite un lote y cuáles dan error de validación
Casi todo lo que funciona en la Messages API funciona en un lote, y en el mismo lote puedes mezclar tipos de solicitud distintos. Lo que no entra son las opciones pensadas para respuesta inmediata:
| Función | ¿En lote? | Detalle |
|---|---|---|
| Visión, mensajes de sistema, conversaciones de varios turnos, pensamiento extendido | Sí | Igual que en la Messages API |
| Herramientas definidas por ti | Sí | La solicitud termina en tool_use; el resultado de tu herramienta va en otra solicitud |
| Herramientas de servidor (búsqueda web, web fetch, ejecución de código, conectores MCP, advisor, tool search) | Sí | Puede devolver pause_turn; la búsqueda web se limita por organización y se reintenta sola |
| Caché de prompts | Sí | Mejor esfuerzo, con aciertos habituales del 30 % al 98 % |
Salida extendida hasta 300.000 tokens (beta output-300k-2026-03-24) | Solo en lotes | Opus 5.5, Opus 5, Opus 4.8, 4.7 y 4.6, Sonnet 5.5, Sonnet 5, Sonnet 4.6 y Haiku 5.5, en la API de Claude y Claude Platform on AWS |
stream: true | No | Error de validación |
speed (modo rápido) | No | Error de validación; el modo rápido no existe en lotes |
fallbacks (respaldo en servidor) | No | Error de validación |
max_tokens: 0 | No | Error de validación; max_tokens debe ser al menos 1 |
Varios turnos y uso de herramientas sí entran en un lote. Lo que un lote no hace es esperar dentro de una solicitud a que tu código ejecute una herramienta local: cada solicitud es una sola llamada a la Messages API, así que un bucle de agente con herramientas propias necesita un lote, o una llamada, por cada vuelta. Las herramientas de servidor no tienen ese problema porque las ejecuta Anthropic, y el trabajador de lotes puede encadenar más iteraciones por turno que una llamada normal antes de devolver pause_turn.
¿Hay descuento por lotes en Bedrock, Vertex AI o una pasarela?
La Message Batches API con su 50 % está disponible de forma general en la API de Claude, en Claude Platform on AWS y en Claude en Google Cloud gestionado por Anthropic. Amazon Bedrock y Vertex AI, gestionados por Amazon y Google, no exponen ese endpoint: tienen su propio producto por lotes, con otro formato, otros límites y su propia tabla de precios.
En Amazon Bedrock, AWS anuncia que algunos modelos de Anthropic y de otros proveedores tienen inferencia por lotes con un precio un 50 % inferior al de bajo demanda. La entrada es un archivo JSONL en S3 con una línea {"recordId", "modelInput"} por solicitud, con un mínimo de 100 registros por trabajo en los modelos Claude y un máximo de 100.000 registros y 5 GB. A 30 de octubre de 2026, su lista de modelos compatibles con lotes llega hasta Opus 5, Opus 4.6, Sonnet 4.6 y Haiku 4.5, sin ningún modelo 5.5 ni Fable, y con el formato Converse no puedes usar herramientas en un lote. Bedrock no es lo mismo que Claude Platform on AWS.
La predicción por lotes de Claude en Vertex AI lee de una tabla de BigQuery o de un JSONL en Cloud Storage, no admite el endpoint global y permite por defecto 4 trabajos por lotes simultáneos por proyecto. Su página, actualizada el 28 de octubre de 2026, incluye Sonnet 5.5, Opus 5.5, Haiku 5.5, Fable 5.1 y Fable 5. El precio por lotes de cada modelo lo marca la página de precios de Vertex AI, así que compruébalo ahí antes de dar por hecho el mismo 50 %.
Una pasarela compatible con la API de Anthropic solo ofrece lotes si implementa /v1/messages/batches. El 30 de octubre de 2026, las tres rutas de lotes de laozhang.ai (listar, crear y consultar un lote) respondieron HTTP 404 con el mensaje Invalid URL, sin cobro; por esa pasarela solo funcionan llamadas normales.
Aviso: laozhang.ai es un servicio propio. Sus precios son nuestra tarifa, no una comparación independiente.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.
Fuentes5
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 30 oct 2026.
- 1.documentación de procesamiento por lotes de Anthropicplatform.claude.com/docs/en/build-with-claude/batch-processing
- 2.tarifas de la API de Claudeplatform.claude.com/docs/en/about-claude/pricing
- 3.página de límites de la API de Claudeplatform.claude.com/docs/en/api/rate-limits
- 4.Amazon Bedrockaws.amazon.com/bedrock/pricing
- 5.predicción por lotes de Claude en Vertex AIdocs.cloud.google.com/vertex-ai/generative-ai/docs/partner-models/claude/batch