Seedream 5.0 Pro 图层拆分 API 教程:实测一次 14 张,按张计费
给图片接口加 layer_decomposition: true,返回底图和最多 16 个透明图层,按张计费;1K 实测自动全拆 14 张,点名两个元素只有 3 张。
文章目录
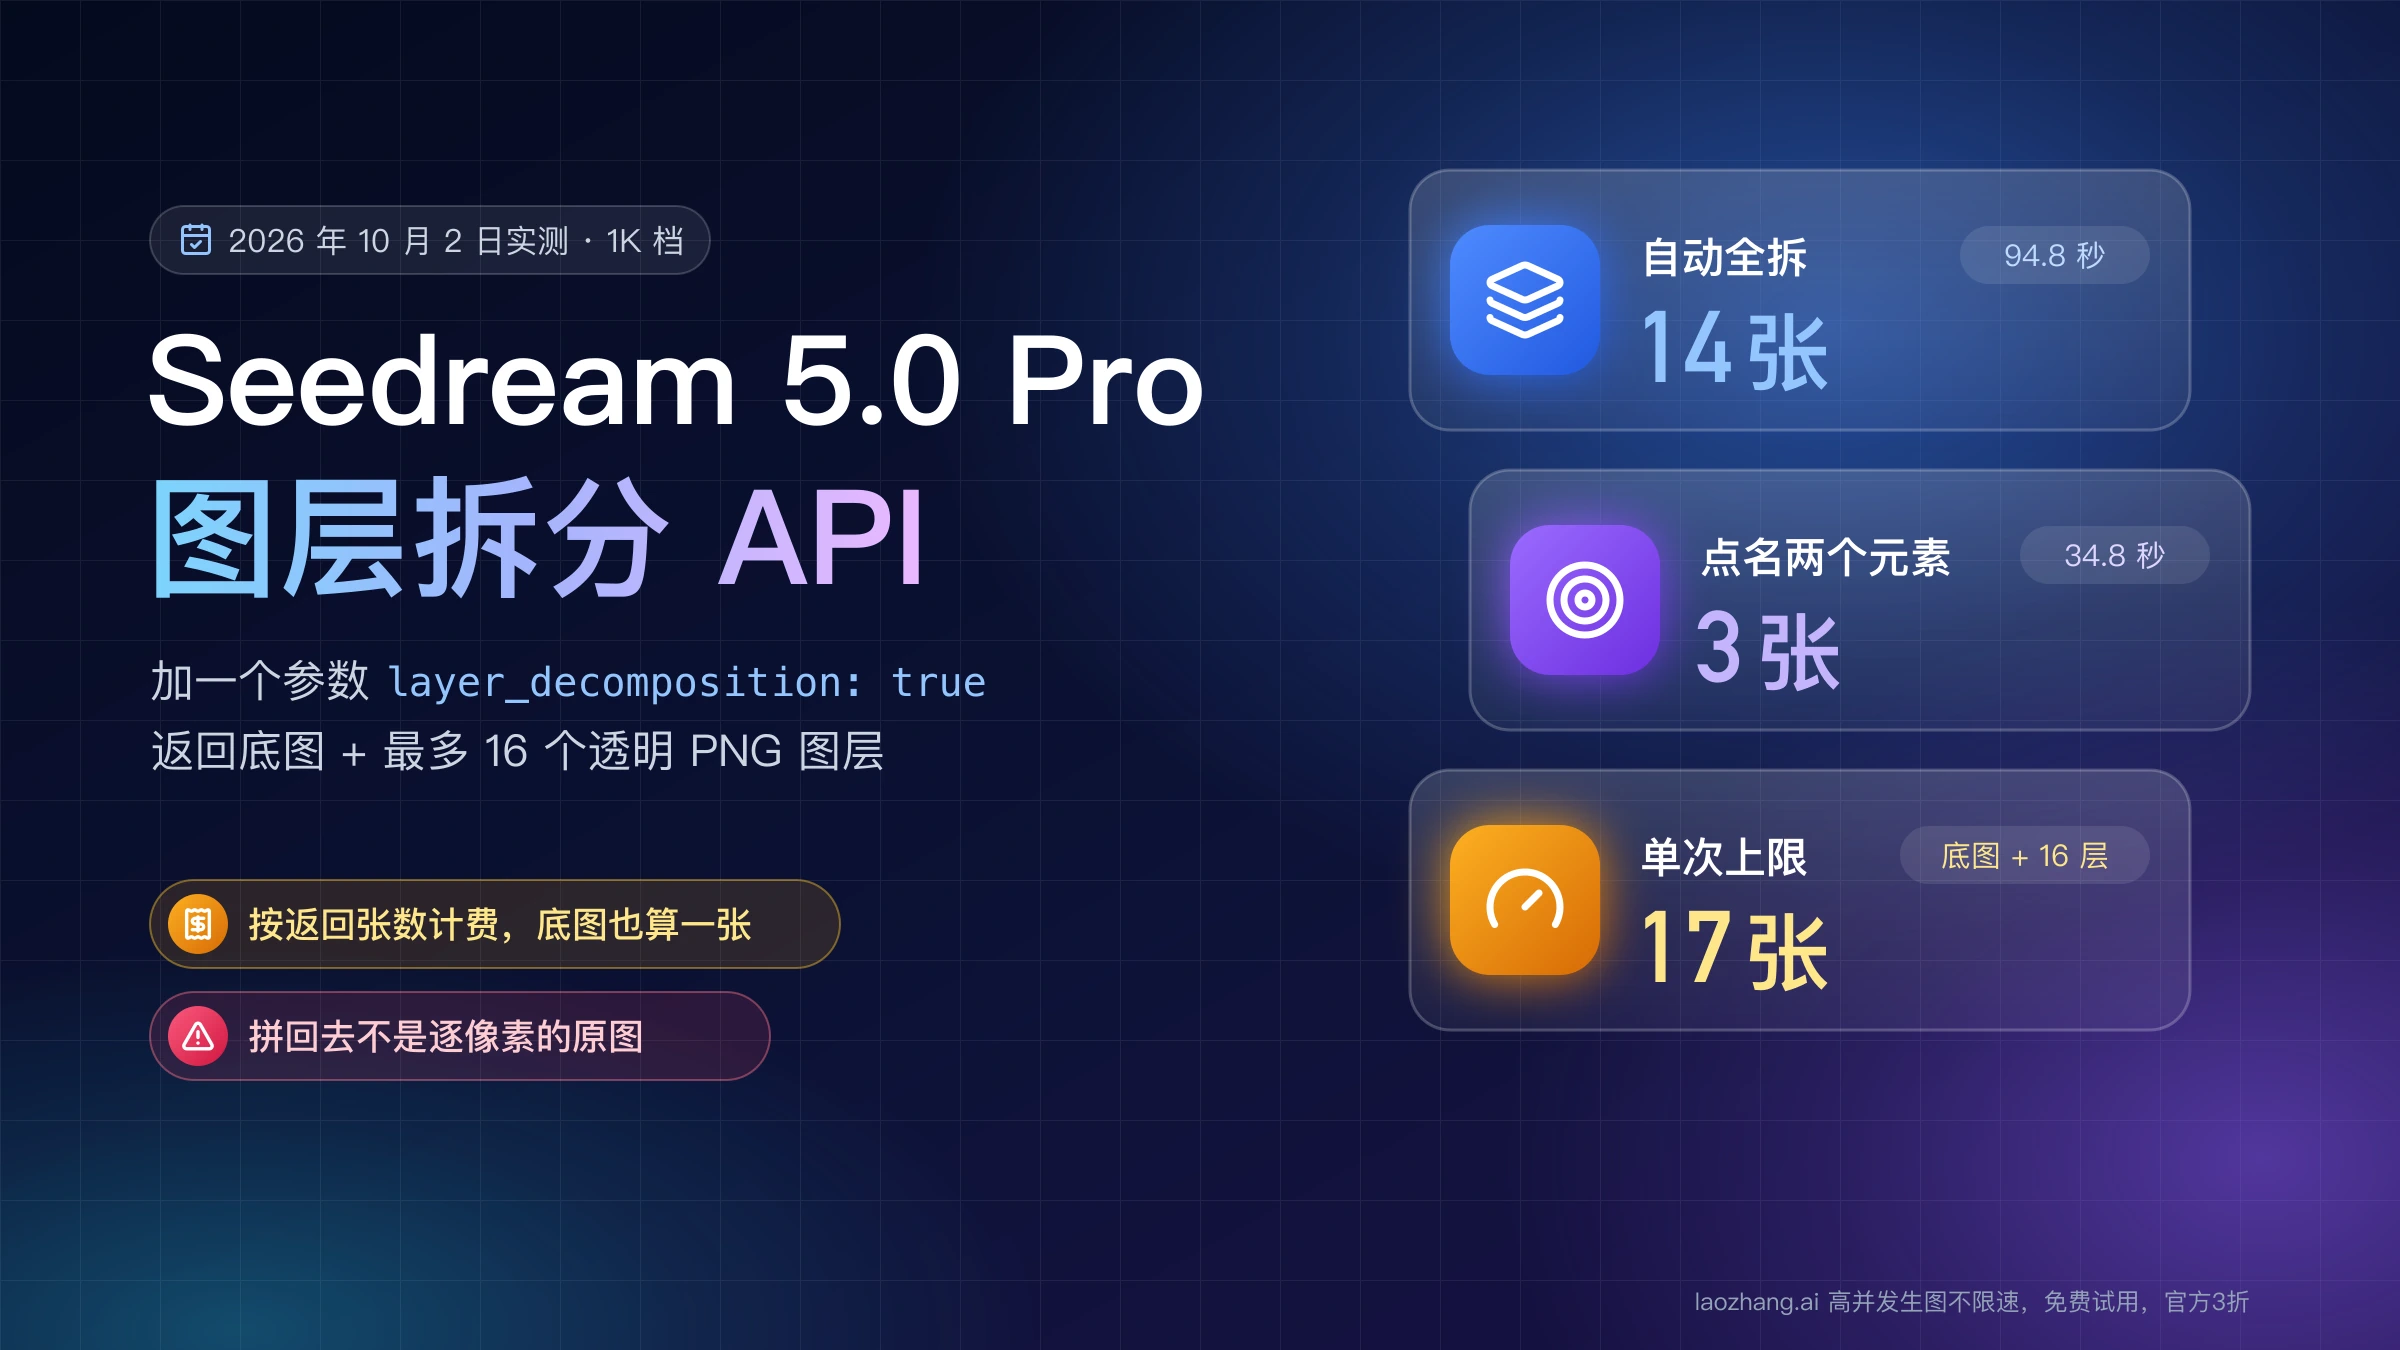
Seedream 5.0 Pro 的图层拆分(也有人叫图层分离、分层)不是单独的模型,也没有单独的接口:往普通的图片生成接口发一张图,请求体里加上 "layer_decomposition": true,返回的 data 数组就是 1 张底图加最多 16 个带透明通道的 PNG 图层,每个图层带名称、层级和坐标。Seedream 5.0 Flash 也支持同一个参数。费用按返回的张数算,底图也算一张;而张数由模型决定,不由你设定,所以先用 1K 档拆一张,看清张数再谈批量。
下面的实测数字来自 2026 年 10 月 2 日的三次真实调用和一次脚本运行,范围如下。
| 内容 | |
|---|---|
| 跑过 | 经 api.laozhang.ai 调用三次,都是 1K 档,输入是 BytePlus 官方教程的示例图(2784×3441 的 PNG,一张没有文字的 3D 插画):Flash 自动全拆、Pro 自动全拆、Flash 只拆指定的两个元素。每种配置各一次 |
| 跑过 | 用文中的 Python 脚本把三次返回存成 PNG 图层、拼回的预览图和 PSD,并用 psd-tools 重新打开 PSD 核对 |
| 没跑过 | 火山方舟和 BytePlus 直连;1.5K、2K、auto 三种尺寸;bbox 坐标标签;文字密集的海报;各种报错场景;在 Photoshop、Photopea 或 GIMP 里打开生成的 PSD |
没跑过的部分,下文只写官方文档怎么规定,并逐处标明。每种配置只有一次调用,耗时和张数是这张图上的观察值,不是普遍规律。
发出第一个图层拆分请求:只传一张图,加 layer_decomposition
接口是各路线的 /images/generations,区别只在域名和模型 ID。三条路线的模型 ID 前缀各不相同,不能混写。
| 路线 | 接口地址 | Pro 的模型 ID | Flash 的模型 ID |
|---|---|---|---|
| 火山方舟(人民币结算) | https://ark.cn-beijing.volces.com/api/v3/images/generations | doubao-seedream-5-0-pro-260628 | doubao-seedream-5-0-flash-260915 |
| BytePlus ModelArk(美元结算) | https://ark.ap-southeast.bytepluses.com/api/v3/images/generations | dola-seedream-5-0-pro-260628 | dola-seedream-5-0-flash-260915 |
| LaoZhang 网关(美元结算) | https://api.laozhang.ai/v1/images/generations | seedream-5-0-pro-260628 | seedream-5-0-flash-260915 |
火山方舟上的写法如下。请求体的形态来自官方教程的自动拆分示例,size 换成了 1K;这条命令没有实际执行过。
curl -X POST https://ark.cn-beijing.volces.com/api/v3/images/generations \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $ARK_API_KEY" \
  --max-time 420 \
  -o response.json \
  -d '{
    "model": "doubao-seedream-5-0-pro-260628",
    "image": "https://arkdocs-en.tos-ap-southeast-1.volces.com/images/image-generation/layer_auto.png",
    "layer_decomposition": true,
    "size": "1K",
    "watermark": false
  }'
实际发出并拿到 HTTP 200 的是下面这个请求,走 LaoZhang 网关,用 Python 的 requests,超时设为 420 秒。请求体与实测时逐字段相同;这一版去掉了测试时读密钥文件、保存测试记录的外壳,精简后只做过语法检查,没有再次付费调用。
"""经 api.laozhang.ai 调一次图层拆分,把返回原样存成 response.json。

用法:LAOZHANG_API_KEY=... python3 call_layers.py
依赖:python3 -m pip install requests
"""
import json
import os
import time
from pathlib import Path

import requests

body = {
    "model": "seedream-5-0-flash-260915",
    "image": "https://arkdocs-en.tos-ap-southeast-1.volces.com/images/image-generation/layer_auto.png",
    "layer_decomposition": True,
    "size": "1K",
    "response_format": "url",
    "watermark": False,
}

start = time.time()
resp = requests.post(
    "https://api.laozhang.ai/v1/images/generations",
    headers={"Authorization": f"Bearer {os.environ['LAOZHANG_API_KEY']}"},
    json=body,
    timeout=420,
)
print("HTTP", resp.status_code, "耗时", round(time.time() - start, 1), "秒")
data = resp.json()
Path("response.json").write_text(json.dumps(data, indent=2, ensure_ascii=False))
print("usage", data.get("usage"))
请求体里每个字段在图层拆分模式下的规则,按 BytePlus 的教程(2026 年 9 月 28 日更新)整理如下,火山方舟的参数和限制与之相同。
| 字段 | 图层拆分模式下的规则 |
|---|---|
image | 必填,只能是一张,传多张直接报错。格式只收 PNG 和 JPEG;总像素 512×512 到 6000×6000,宽高比 1/16 到 16,不超过 30 MB。可以是能公开访问的 URL,也可以是 Base64 的 data URL |
layer_decomposition | true 打开图层拆分。只有 5.0 Pro 和 5.0 Flash 支持 |
size | 只能是 1K、1.5K、2K、auto,不能写具体的宽乘高;默认 auto |
prompt | 可选。不带就是自动全拆;带上就按你点名的元素拆 |
output_format | png 或 jpeg,默认 jpeg,只影响底图;图层一律是 PNG |
response_format | url(默认,链接保留 24 小时)或 b64_json |
watermark | 默认 true,会在右下角打上“AI 生成”水印;做素材要显式传 false |
两个容易漏掉的细节。auto 的行为是:输入在 921,600 到 4,624,220 像素之间时按输入尺寸输出,更小的按 1K,更大的按 2K;输入超过 261 万像素又不写 size,底图就按输入尺寸输出,在 Pro 上落进下文价格表里的高价档。另一个是 SDK:官方说明用 cURL、Java、Go 可以不带 prompt,但 Python SDK 和 OpenAI SDK 要求必须有 prompt,这时写一句“拆分画面里的主要视觉元素”一类的通用指令。上面的 Python 示例用的是 requests 直接发 HTTP,不受这个限制。
返回的 data 数组:底图 z_index 为 0,图层带 bounding_box
Flash 自动全拆的那次调用在 94.8 秒后返回 HTTP 200,data 里有 14 个对象:1 张底图加 13 个图层。下面是返回的节选,链接做了截断,中间 12 个图层省略:
{
  "model": "dola-seedream-5-0-flash-260915",
  "created": 1790953682,
  "data": [
    {
      "url": "https://ark-acg-ap-southeast-1.tos-ap-southeast-1.volces.com/...",
      "size": "880x1088",
      "output_format": "jpeg",
      "z_index": 0
    },
    {
      "url": "https://ark-acg-ap-southeast-1.tos-ap-southeast-1.volces.com/...",
      "size": "759x627",
      "output_format": "png",
      "z_index": 10,
      "bounding_box": {
        "absolute": [305, 528, 695, 851],
        "normalized": [347, 485, 789, 781]
      },
      "name": "Light green minivan",
      "description": "The main body of the light green minivan, which acts as the base supporting the central toast, excluding the toast above and the guitar in front."
    }
  ],
  "usage": {
    "input_images": 1,
    "generated_images": 14,
    "output_tokens": 53663,
    "total_tokens": 53663
  }
}
逐个字段看:
- 底图是
z_index为 0 的那个对象,只有url、size、output_format三项,没有名称和坐标。它不是原图,而是把所有被拆走的元素抹掉、把空出来的地方重新画上的背景。 - 图层的
z_index从 1 开始,数字越大越靠上。三次返回里层级都是连续的,没有跳号。 bounding_box.absolute是[左, 上, 右, 下],单位是底图上的像素。bounding_box.normalized是同一个框换算到 0–1000 的刻度,以底图的宽和高为基准,用来把图层摆到别的尺寸的画布上。name和description是模型给图层起的英文名和说明。名字不稳定:同一辆车,Flash 叫 "Light green minivan",Pro 叫 "Light green minibus",不要拿它当程序里的键。usage.generated_images是计费用的张数,包含底图。14 就是 1 加 13。output_tokens是所有输出图的宽乘高之和除以 256,按张计费时用不上。
经网关返回的 model 字段是 BytePlus 的模型 ID,字段和语义与 BytePlus 文档里的返回示例一致。
“1K”不等于 1024 像素宽:输入是 2784×3441,底图是 880×1088,宽高比保持不变(0.8091 对 0.8088),总像素约 96 万。
把图层摆回画布:先缩放到框的大小,再按 z_index 叠放
图层文件的尺寸不等于它在画布上占的大小,直接按文件尺寸贴上去会全部错位。这是三次返回里最容易踩的一处:每一个图层 PNG 都比它的框大。
| 图层 | 文件尺寸 | 框的尺寸 | 左上角位置 |
|---|---|---|---|
| 麦克风架 | 271×1037 | 103×394 | (231, 503) |
| 折叠躺椅 | 660×940 | 118×169 | (9, 785) |
| 面包车 | 759×627 | 390×323 | (305, 528) |
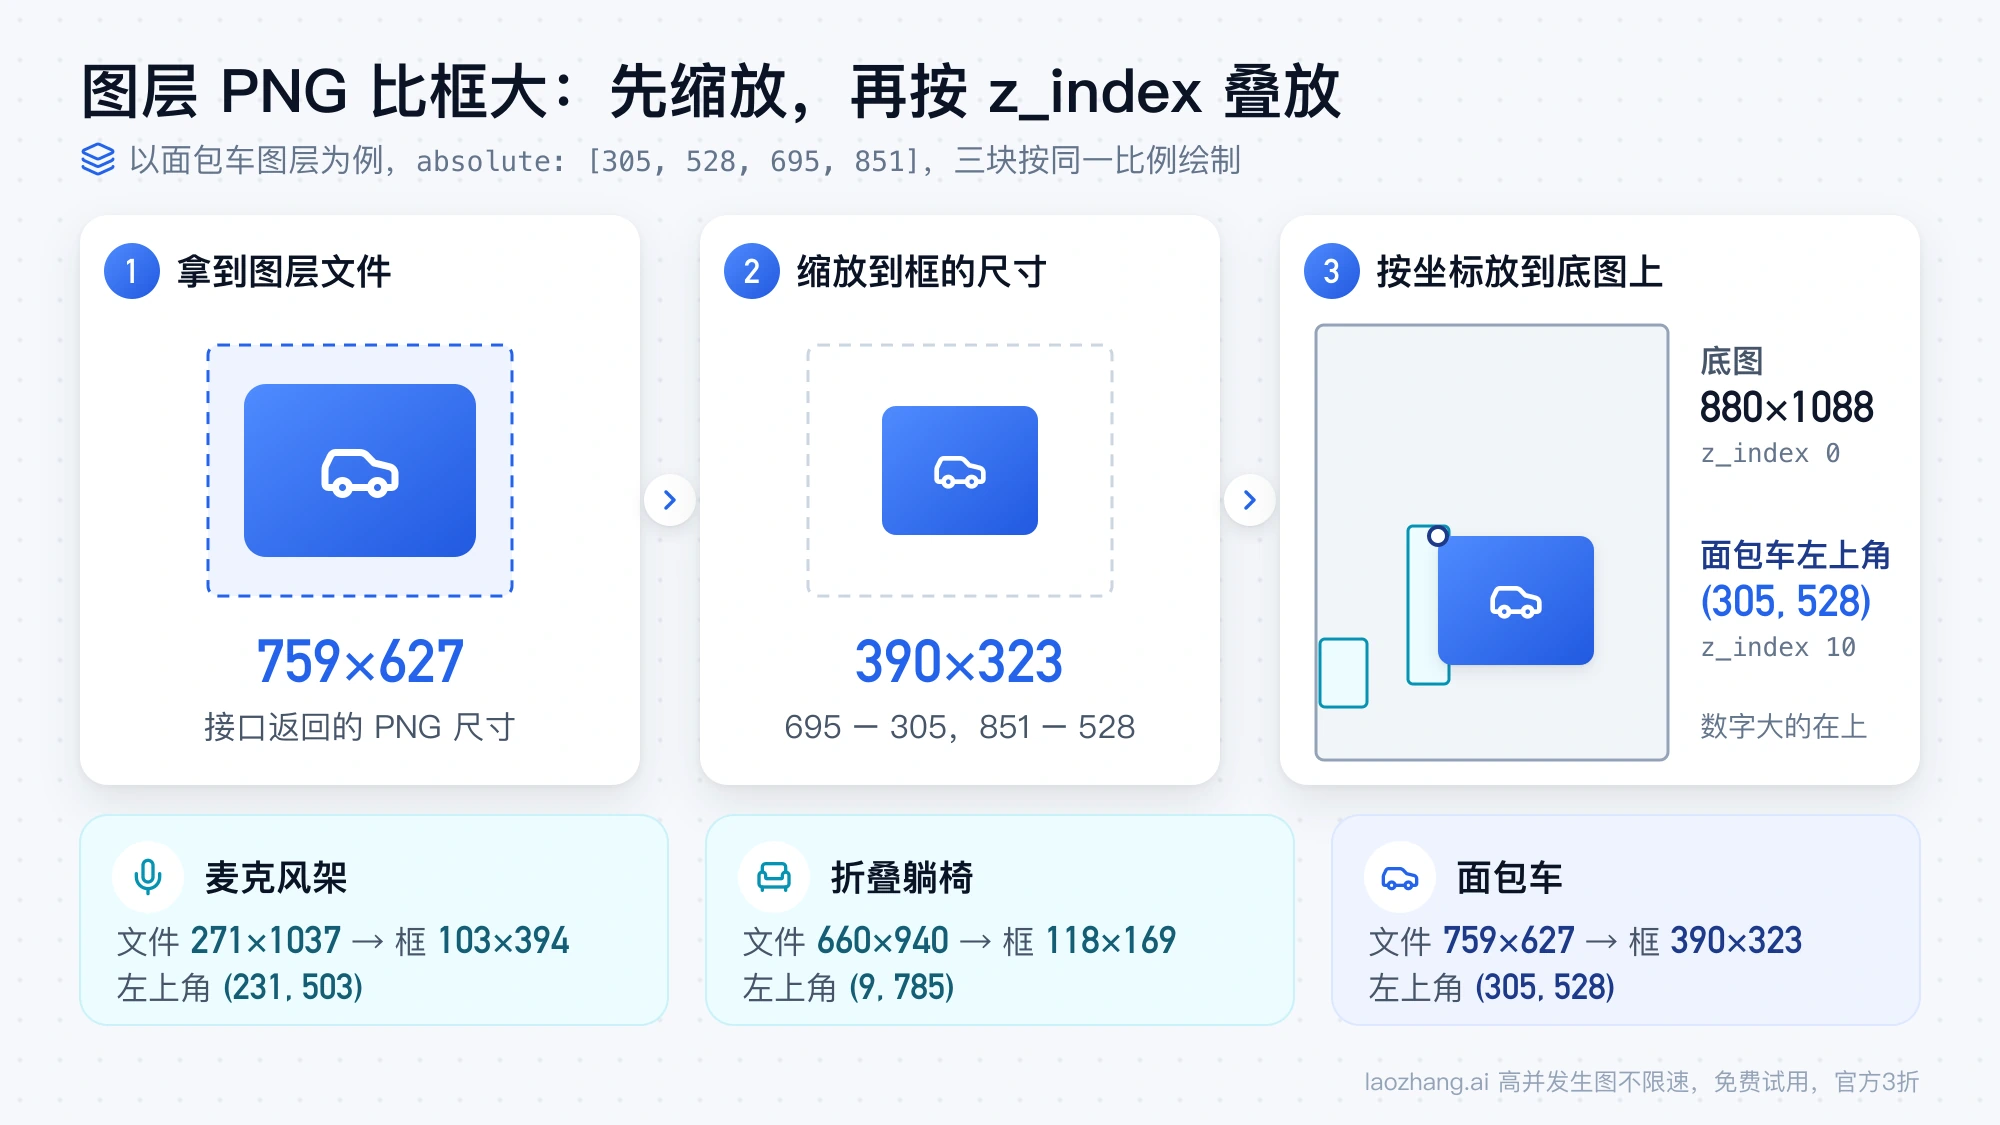
官方给的还原步骤是:以底图为背景;图层按 z_index 从小到大排序;对每个图层取 x = 左、y = 上、w = 右 − 左、h = 下 − 上,把图层缩放到 w×h,再放到 (x, y)。面包车的 absolute 是 [305, 528, 695, 851],所以缩放到 390×323,放在 (305, 528)。
画布不是底图尺寸时用 normalized。画布宽 W、高 H:
x = 左 / 1000 × W
y = 上 / 1000 × H
w = (右 − 左) / 1000 × W
h = (下 − 上) / 1000 × H
归一化坐标是整数,换算会带来一两个像素的舍入误差,官方文档也提了这一点;要求严丝合缝的地方用 absolute。
图层文件比框大还有一个用处:把图层放到更大的画布上时,有一段余量不需要放大插值。余量因图层而异,躺椅的文件边长约是框的 5.6 倍,面包车只有 1.9 倍左右。这是按尺寸推出来的,放大后的观感没有检验过。
导出 PNG 图层、预览图和 PSD:一个 Python 脚本
接口返回的是 PNG 图层加一段 JSON,没有 PSD;想在设计软件里按层打开,要自己拼。下面的脚本读上一步存下的 response.json,做三件事:把每个图层存成 layer-NN-名称.png,按上一节的规则拼出 recomposed.png,再写一个每层都在正确位置的 layers.psd。返回是 url 还是 b64_json 都能处理。
python3 -m pip install pillow psd-tools
python3 layers_to_psd.py response.json out_dir"""把 Seedream 图层拆分的返回存成文件:每个图层一张 PNG、一张拼回的预览图、
一个分层 PSD。
用法:python3 layers_to_psd.py response.json out_dir
依赖:python3 -m pip install pillow psd-tools
"""
import base64
import json
import re
import sys
import urllib.request
from io import BytesIO
from pathlib import Path
from PIL import Image
from psd_tools import PSDImage
response = json.loads(Path(sys.argv[1]).read_text())
out = Path(sys.argv[2])
out.mkdir(parents=True, exist_ok=True)
def load(item):
if item.get("b64_json"):
value = item["b64_json"].split(",", 1)[-1]
return base64.b64decode(value + "=" * (-len(value) % 4))
with urllib.request.urlopen(item["url"], timeout=120) as download:
return download.read()
items = sorted(response["data"], key=lambda item: item["z_index"])
base_item, layer_items = items[0], items[1:]
assert base_item["z_index"] == 0 and "bounding_box" not in base_item
content = load(base_item)
ext = "png" if base_item.get("output_format") == "png" else "jpg"
(out / f"layer-00-base.{ext}").write_bytes(content)
base = Image.open(BytesIO(content)).convert("RGBA")
canvas = base.copy()
psd = PSDImage.new("RGBA", base.size)
psd.append(psd.create_pixel_layer(base, name="base", top=0, left=0))
for item in layer_items:
content = load(item)
slug = re.sub(r"[^a-z0-9]+", "-", item.get("name", "layer").lower()).strip("-") or "layer"
(out / f"layer-{item['z_index']:02d}-{slug}.png").write_bytes(content)
left, top, right, bottom = item["bounding_box"]["absolute"]
# 图层 PNG 通常比它的框大:先缩放到框的尺寸。
layer = Image.open(BytesIO(content)).convert("RGBA").resize((right - left, bottom - top), Image.LANCZOS)
canvas.alpha_composite(layer, (left, top))
psd.append(psd.create_pixel_layer(layer, name=item.get("name", slug), top=top, left=left))
print(f"z={item['z_index']:>2} file={item['size']:>9} box={right - left}x{bottom - top} at ({left},{top}) {item.get('name')}")
canvas.save(out / "recomposed.png")
psd.save(out / "layers.psd")
print(f"Saved {len(layer_items)} layers + base, recomposed.png and layers.psd in {out}")运行环境是 Python 3.12、Pillow 12.3.0、psd-tools 1.23.0。对只拆两个元素的那次返回,输出是这样:
z= 1 file=  764x698 box=256x235 at (356,585)  toast-shaped electric guitar
z= 2 file=  774x710 box=409x375 at (248,293)  central toast lead singer with sunglasses
Saved 2 layers + base, recomposed.png and layers.psd in out_dir
三次返回都生成了 880×1088 的 PSD,两次自动全拆各 14 个带名称的像素图层,指定元素那次 3 个。用 psd-tools 重新打开 PSD 再合成,与 recomposed.png 的平均绝对差不超过 0.001,说明图层的位置和顺序写对了。
两条限制要知道。第一,这个 PSD 没有在 Photoshop、Photopea 或 GIMP 里打开过,验证只做到 psd-tools 能读回并合成一致。第二,所有图层都是像素图层,返回里没有任何可编辑的文字对象;海报上的标题被拆出来也只是一张带透明底的图,改字要重新排版或交给模型重画。
返回的链接只保留 24 小时,脚本要在当天跑;要长期留档就把 response.json 和下载下来的文件一起存。
拼回去是不是原图:Flash 30.2% 的像素变了,Pro 12.6%
不是。把图层按坐标和层级叠回底图,得到的是一张和原图相似、但被重画过的图,差多少取决于模型和被拆走的元素有多少。
把拼回的图和缩小到同尺寸的输入逐像素比较,统计任一颜色通道相差超过 32(满值 255)的像素占比:
| 调用 | 返回张数 | 明显变化的像素占比 | 平均绝对差 |
|---|---|---|---|
| Flash 自动全拆 | 14 | 30.2% | 20.6 |
| Pro 自动全拆 | 14 | 12.6% | 13.6 |
| Flash 只拆两个元素 | 3 | 4.0% | 6.7 |
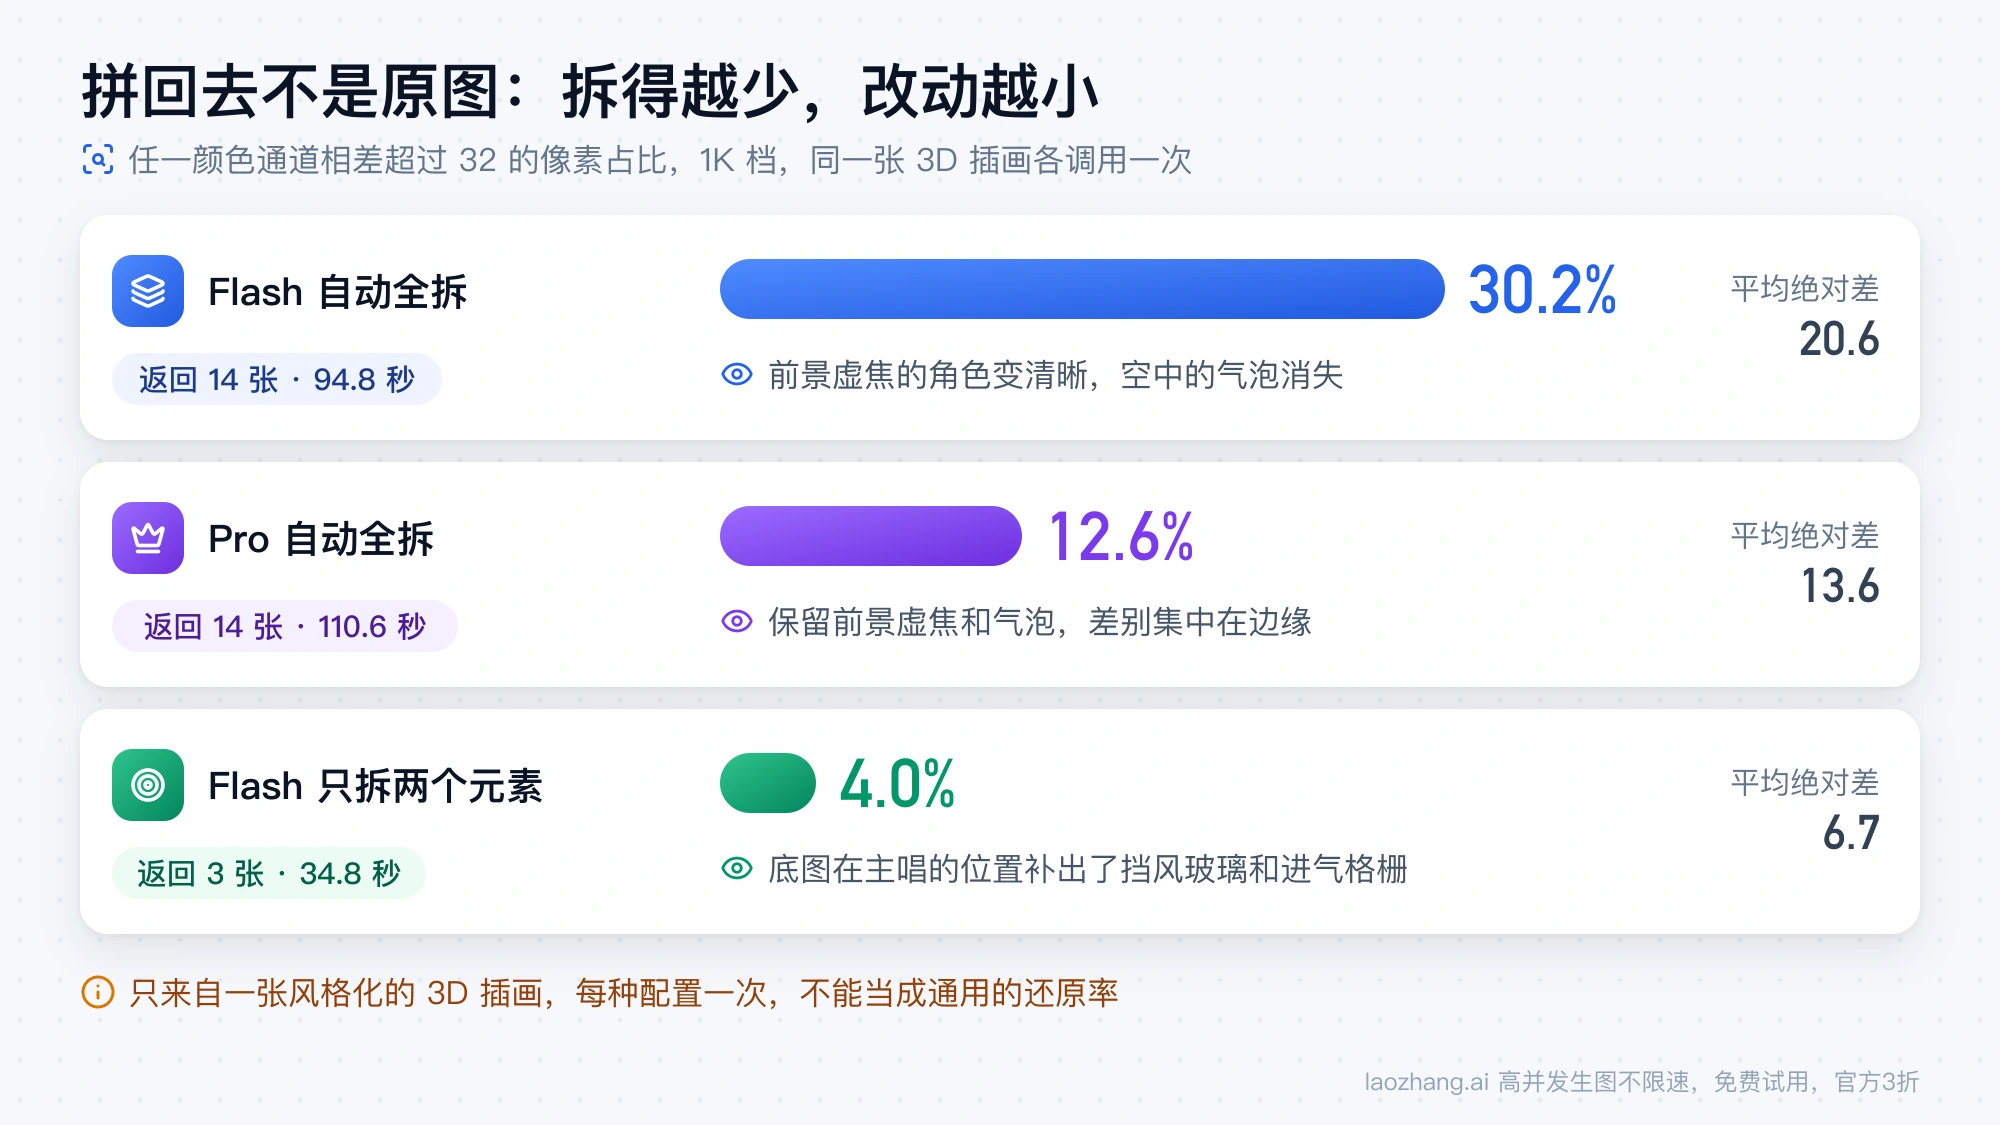
数字背后是看得见的差别。Flash 自动全拆的结果里,原图前景两个虚焦的角色变成了清晰的、形状也不一样的角色;左侧的乐手被画成了一个完整而且更大的角色;舞台成了一个完整的圆盘,盖住了原图里露出来的草地;飘在空中的气泡在底图和图层里都找不到了。Pro 保留了前景的虚焦和气泡,肉眼看和原图接近,差别集中在边缘。
原因写在文件里:每个图层都是一个补全了的物体,被别的东西挡住的部分由模型画出来,底图上被拆走元素的位置也是重画的。只拆两个元素那次,底图在主唱原来站的位置补出了面包车的挡风玻璃和进气格栅。正因为补全了,图层才能随便挪动而不露出窟窿;代价是叠回去不再是逐像素的原图。它和抠图、分割蒙版不是一回事,蒙版只裁出看得见的部分。
这组数字只来自一张风格化的 3D 插画,每个模型一次,不能当成通用的还原率。能带走的结论有两条:需要保持原图观感时,拆得越少越接近原图;把拼回的图当成原图交付之前,要自己对比一遍。
只拆指定元素:点名两个,14 张降到 3 张
在 prompt 里用自然语言点名要拆的元素,模型就只拆这些,其余留在底图里。同一张图、同样用 Flash,加上这一句之后:
{
  "model": "seedream-5-0-flash-260915",
  "image": "https://arkdocs-en.tos-ap-southeast-1.volces.com/images/image-generation/layer_auto.png",
  "prompt": "Separate only the central toast lead singer with sunglasses and the toast-shaped electric guitar.",
  "layer_decomposition": true,
  "size": "1K",
  "response_format": "url",
  "watermark": false
}| 自动全拆 | 点名两个元素 | |
|---|---|---|
| 返回张数 | 14(底图加 13 个图层) | 3(底图加 2 个图层) |
| 耗时 | 94.8 秒 | 34.8 秒 |
| 按 Flash 每张 $0.018 计 | $0.252 | $0.054 |
张数少了,耗时、费用和对原图的改动一起降下来。这里有一个实用的顺序:先自动全拆一次,看模型把画面分成了哪些元素、各叫什么名字,再用这些名字点名重跑。上面那句提示词里的两个名字,就是照着第一次返回的 name 写的。
官方文档列了三种指定方式:
- 不带
prompt,自动识别主体、文字、背景和装饰元素。 - 自然语言点名,例如“拆分人物、标题文字和右下角的装饰图标”;也可以先在输入图上涂鸦或圈选,帮模型定位。
- bbox 坐标标签,在提示词里用归一化坐标框出要拆的区域,四个数依次是左、上、右、下,刻度 0–1000。下面照官方示例的写法缩短成三个框:
Perform precise layer separation on the image. The text regions to separate are at <bbox>180 64 812 198</bbox>, <bbox>757 210 939 280</bbox>; the parrot is at <bbox>347 305 642 997</bbox>.第三种没有实测过。它的坐标刻度和返回里的 normalized 一致,所以第一次返回的框可以原样填回去。
两点注意。提示词要求的图层数超过 16 个时,官方说明是部分图层信息可能丢失,元素很多的画面要分批点名。另外,“传空字符串算不算自动全拆”有两种相反的说法:LaoZhang 的文档说不带或传空字符串都行,第三方网关 EvoLink 的教程说空字符串会失去自动识别。这一点没有测过,稳妥的做法是要自动全拆就整个不带 prompt 这个键。
拆一次多少钱:单价乘以返回张数,2 到 17 张
一次调用的费用等于每张单价乘以 usage.generated_images。返回至少 2 张(底图加 1 个图层),最多 17 张(底图加 16 个图层),输入图在图层拆分模式下不收费(只有一张,首张免费)。
截至 2026 年 10 月 2 日的公开价格:火山方舟和 BytePlus 的 Pro 按每张输出图的像素分两档,分界是 261 万像素;Flash 只有一个价。LaoZhang 不分像素档,每张一个价。
| 路线与模型 | 每张单价 | 3 张 | 14 张 | 17 张(上限) |
|---|---|---|---|---|
| 火山方舟 Flash | 0.12 元 | 0.36 元 | 1.68 元 | 2.04 元 |
| 火山方舟 Pro,261 万像素及以下 | 0.15 元 | 0.45 元 | 2.10 元 | 2.55 元 |
| 火山方舟 Pro,超过 261 万像素 | 0.30 元 | 0.90 元 | 4.20 元 | 5.10 元 |
| BytePlus Flash | $0.018 | $0.054 | $0.252 | $0.306 |
| BytePlus Pro,261 万像素及以下 | $0.0225 | $0.0675 | $0.315 | $0.3825 |
| BytePlus Pro,超过 261 万像素 | $0.045 | $0.135 | $0.63 | $0.765 |
| LaoZhang Flash | $0.018 | $0.054 | $0.252 | $0.306 |
| LaoZhang Pro | $0.12 | $0.36 | $1.68 | $2.04 |
3 张和 14 张对应的是实测里出现过的两种返回。几条口径:
- 火山方舟和 BytePlus 的数字假设底图和图层按同一个单价计费。官方没有逐字写明底图怎么算,但
generated_images把底图计在内,官方示例的 8 也是 1 加 7,所以按每张都计费估算。 - Pro 的两档是逐张判断的,同一次返回里的图可以落在不同档。1K 的底图 880×1088 约 96 万像素,实测里最大的图层文件也远低于 261 万,全部在低档。2K 的底图(例如 2048×2048,约 419 万像素)在高档。BytePlus 的文档说 1.5K 与 1K 同价、画质更好,这是它的说法,1.5K 没有实测过。
- 实测那两笔 LaoZhang 的费用,$0.252 和 $1.68,是公开单价乘以返回的张数算出来的,没有去控制台对过扣费记录。
- 被内容审核拦下等原因没有生成的图不计费,计费只看成功生成的张数。
批量之前的估算方法:从要处理的图里抽十来张有代表性的,用 1K 档各拆一次,记下每张的 generated_images,平均张数乘以单价再乘以总图数。LaoZhang 的文档提到,同一张图多次调用的张数也可能不同,要留出余量;按最坏情况做预算就用 17 张那一列。
用 Pro 还是 Flash,走哪条路线:先看你在哪里结算
模型和路线要一起定,因为 Pro 和 Flash 的价差在不同路线上完全不是一个量级。
直连火山方舟或 BytePlus 时,Pro 只贵一点。 低档每张 0.15 元对 0.12 元($0.0225 对 $0.018),14 张一次差 0.42 元。在实测的这张图上,两个模型都拆出 13 个图层,耗时接近(110.6 秒对 94.8 秒),但 Pro 拼回后更接近原图,保住了前景虚焦和气泡;两者的分法也不同,Flash 把木质舞台拆成了图层,Pro 把舞台留在底图里、把尤克里里单独拆了出来。要把拆完的图层重新组合成接近原图的画面,这个价差值得付。只是把元素取出来另作他用、不在乎底图还原度,Flash 够用。
走 LaoZhang 网关时,用 Flash。 它的 Flash 每张 $0.018,和 BytePlus 的标价相同,省掉的是开 BytePlus 账号这一步;实测的三次调用都走的这条路。它的 Pro 是每张 $0.12,而 BytePlus 的 Pro 图层拆分是 $0.0225 或 $0.045,直连便宜到约五分之一(0.12 ÷ 0.0225 ≈ 5.3 倍;高档是 2.7 倍)。量大又要用 Pro,就去开直连账号。用这条路线的前提是密钥支持按次计费的模型,文档里对应的计费模式是 "Usage first" 或 "Per-call"。
在中国大陆、要人民币结算,走火山方舟。 它是第一方路线,模型 ID 用 doubao- 开头的那一组。BytePlus 的 5.0 Pro 和 Flash 只部署在 ap-southeast-1,没有欧洲接入点,对数据驻留有要求的项目要先确认这一点。
这两个模型在图层拆分之外怎么选,取决于另一组条件;和 Google 的模型之间怎么分工,见 Nano Banana Pro 与 Seedream 5.0 Pro。
限流、超时和失败:每次请求先预扣 17 IPM
图层拆分比普通出图慢得多,并发能力也小得多,批量任务要按这三条来设计。
超时。 实测的三次调用用了 34.8 到 110.6 秒,都是 1K 档。LaoZhang 的文档建议 1K 档的客户端超时至少设 300 秒,并且提醒 2K 的请求可能跑很久,客户端断开后仍然计费。客户端超时不等于请求失败:超时设得比实际耗时短,你这边断开了,生成和扣费可能照常进行,事后要到调用日志里核对。火山方舟和 BytePlus 上这个接口是同步的,5.0 Pro 和 Flash 不支持流式输出;有的第三方网关把它包装成异步任务加轮询,接口形态以各家文档为准。
限流。 BytePlus 上两个模型的默认额度都是每个账号每分钟 500 张(IPM)。图层拆分的每次请求先预扣 17 张,为 1 张底图加 16 个图层的上限留出额度,生成结束后再把没用到的退回;火山方舟的文档同样写着“每次请求预扣减 17 IPM”。算下来,额度全空时一分钟内只能发起 500 ÷ 17 ≈ 29 个图层拆分请求(29 × 17 = 493),而普通出图是 500 个;而且额度要等请求结束才退,一次请求又要几十秒到近两分钟。并发数照这个算,别照普通出图的习惯开。这是直连账号的默认额度,网关可能另有自己的限制,以各家的说明为准。
失败。 官方的规定是全有或全无:任何一个图层生成失败,整个请求失败,不会返回一部分图层。LaoZhang 的文档说,图片无法拆分时返回 HTTP 400、不计费,可以重试。下面这些情况文档写明会被拒绝,具体的报错内容没有逐一触发过:
- 输入是 WebP、BMP、GIF 等格式(普通出图接受,图层拆分只收 PNG 和 JPEG)。
image传了多张图。- 用了不支持的模型:在 LaoZhang 上,
seedream-5-0-260128和seedream-4-5-251128带这个参数会返回 HTTP 400,错误码InvalidParameter。 - 请求体里带了
sequential_image_generation或stream:5.0 Pro 和 Flash 在 LaoZhang 上会返回 HTTP 400,哪怕值是关闭。
在浏览器里直接用返回的链接还有一个坑:LaoZhang 的文档说明这些链接不带 CORS 响应头,前端要读取像素就改用 response_format: "b64_json"。
改单个图层:把图层 PNG 再发一次,加 background: transparent
拆出来的图层可以单独交回模型修改,并且保持透明底。做法是把这个图层 PNG 作为唯一的输入图发一次普通的图生图请求,加上 "background": "transparent"。BytePlus 文档里的示例请求体:
{
  "model": "dola-seedream-5-0-pro-260628",
  "prompt": "Change the parrot in the image into a peacock.",
  "image": "https://arkdocs-en.tos-ap-southeast-1.volces.com/images/image-generation/Seedream50_layer_4.png",
  "size": "2K",
  "background": "transparent",
  "watermark": true
}
文档给的条件是:只能用于图生图,输入只能有一张,而且这张图本身要带透明通道;输出格式默认变成 PNG,把 output_format 设成 jpeg 或者输入是 JPEG 都会报错。这一步没有实测过。它是一次普通的图生图请求,价格表里对应的是普通出图那一行(BytePlus 的 Pro 每张 $0.045 或 $0.09),不是图层拆分的价格。
不适合用图层拆分接口的五种情况
下面这些需求,换一条路更省事,或者这个接口根本给不了。
- 只要一张透明底的图。 拆一次至少返回 2 张,还附带一张重画过的底图,为了一个主体付整套图层的钱不划算。按素材类型选去背景的办法并确认导出的文件真的透明,见透明底图片怎么做。
- 要求和原图逐像素一致。 图层和底图都经过重画,拼回去就不是原图。商标、包装上的小字、需要对版的印刷稿,先拿一张样图验证再决定。
- 要可编辑的文字图层。 返回的全是像素图层。接口也不产出 PSD,“直接得到 PSD”的说法指的是有人替你做了上面脚本做的事。
- 要 2K 以上的输出。
size最高到 2K,官方文档里没有 3K 或 4K 档。 - 不想写代码。 layerpsd.com 是一个浏览器工具,按它自己的介绍,上传 JPG、PNG 或 WebP 得到带可编辑文字的分层 PSD,每个图层 $0.018 起,不用订阅,用 Google 账号登录可以免费试一次,模型选项里是 Seedream 5.0 Flash。它与本博客属于同一运营方,上述说法来自它的页面,没有在这次实测里验证。
除此之外,只要输入是一张 PNG 或 JPEG、目标是把画面里的元素变成能单独移动和替换的素材,就照前面的顺序做:1K 档自动全拆一次,看张数和名称;点名重跑,把张数压到需要的那几个;用脚本落成文件;按张数和单价算清楚再放量。