OpenAI API 连接错误:先验证路由再修复 APIConnectionError
遇到 openai.APIConnectionError: Connection error,先在报错进程或容器里检查 DNS、TLS、代理和实际 API 地址,再按 Python、Node 的版本配置超时与客户端。用底层异常区分修复方向,用原业务请求确认恢复;没有 request ID 不代表请求未被处理。
文章目录
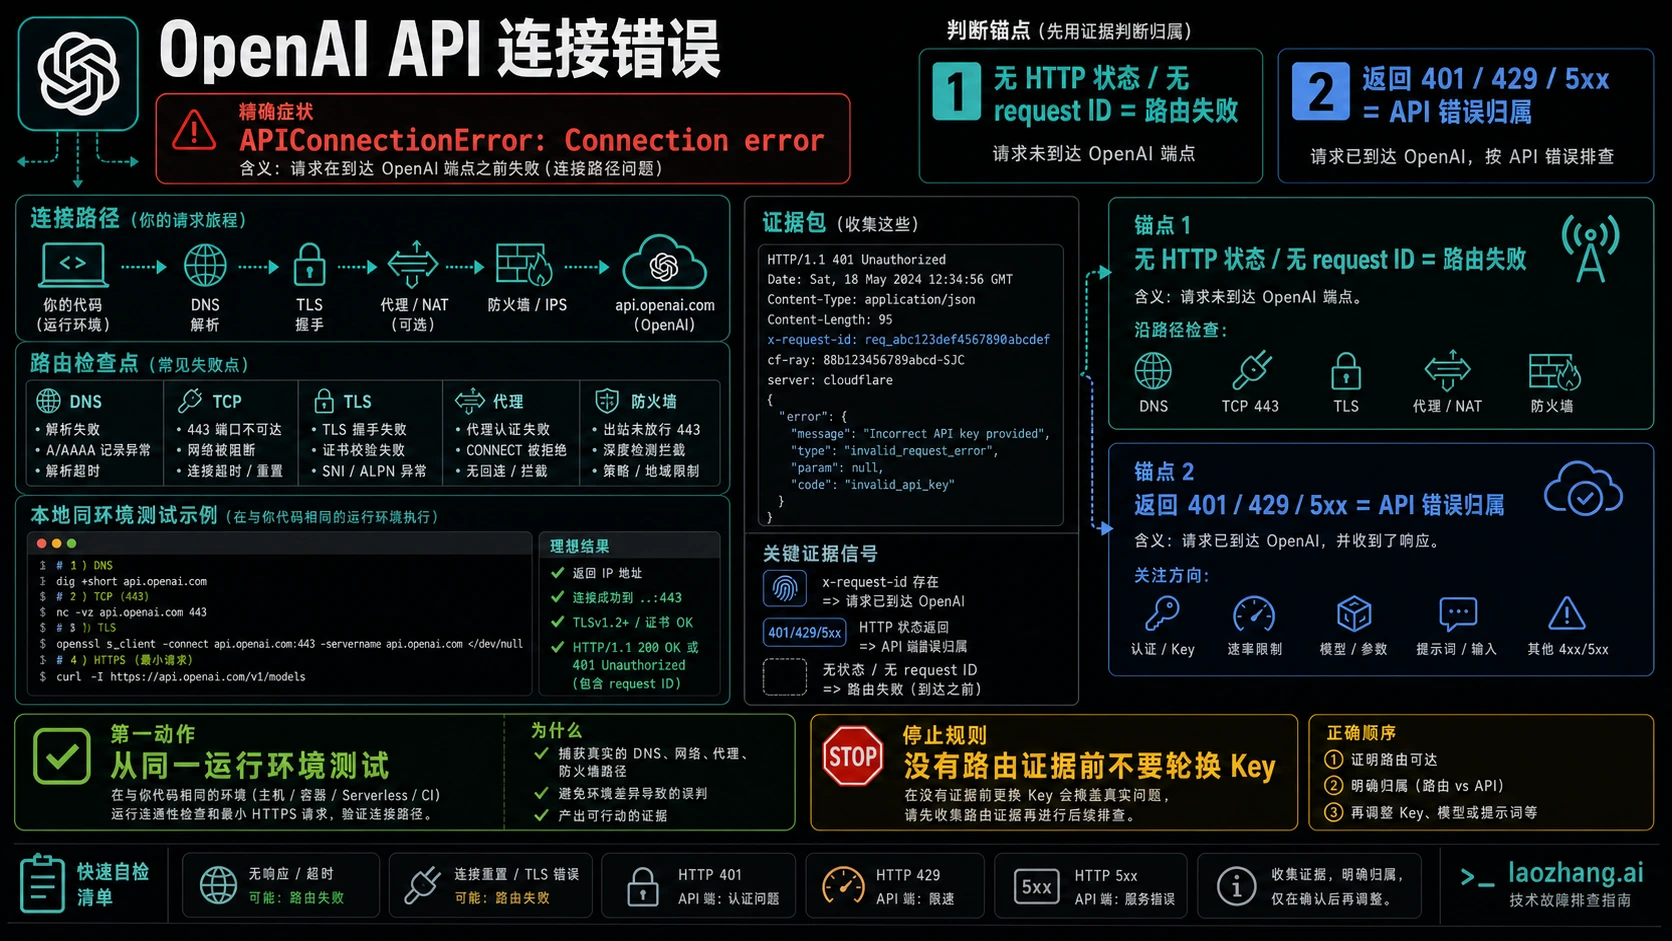
出现 openai.APIConnectionError: Connection error.,先看底层异常,再在报错的同一进程、容器或部署环境检查实际 API 地址、DNS、TLS 和代理。 如果是域名解析失败,就修解析或出网配置;如果是证书验证失败,就修受信证书链;如果是代理连接被拒绝,就核对代理地址、端口及容器可达性。单纯换 API key 或不断重试,无法修复这些故障。
连接错误表示 SDK 没能完成请求并取得正常可处理的结果,超时也属于相关异常类别。它不保证请求没有到达服务端:请求可能已经发送,返回途中断开,或流式输出只收到了一部分。因此,没有 HTTP 状态码或 request ID 是“缺少响应证据”,不能据此认定请求未处理、未计费或可以放心重复提交。官方错误码说明与 Python SDK 参考是以下排查的依据,SDK 配置按截至 2026 年 10 月 6 日的文档说明适用条件。
先分清:连接失败、超时,还是已经返回 API 错误?
先保留失败请求的异常类别、底层原因及实际返回的状态码。若框架只显示一行“Connection error”,查看它包装的原异常,不要先改模型或提示词。
| 实际证据 | 优先动作 | 什么结果会改变排查方向 |
|---|---|---|
| DNS 错误、连接被拒绝、代理或 TLS 异常 | 检查实际运行环境到目标主机的路径 | 出现目标服务的 HTTP 响应后,再检查 API 层 |
Python APITimeoutError 或 Node APIConnectionTimeoutError | 查看是哪一阶段超时、总预算及原请求是否仍在执行 | 连接阶段失败和已开始读响应后的超时需要分别处理 |
| 返回 401 | 核对实际服务商、认证方式及密钥所属项目 | 这是认证分支;继续改 DNS 不会解决错误凭据 |
| 返回 429 | 查看 error.code、message 与响应头 | 额度不足要恢复账户;请求或 Token 限流要降速等待 |
| 返回 500、503 | 保存请求 ID,查看服务状态,按预算有限重试 | 持续失败应提交证据,不能仅凭状态码断定本地网络坏了 |
Python SDK 通常用 APIStatusError 及子类表示已返回的失败 HTTP 状态,连接错误则用 APIConnectionError;Node SDK 也区分连接、超时和带状态码的 API 错误。Python、Node/TypeScript 文档都列出了这些接口。网关也可能返回自己的 401、429 或 503,要结合响应来源判断,不能只看 OpenAI 风格的 JSON。
如果已经确认是 insufficient_quota 或余额、支出上限相关代码,继续看 OpenAI API 额度不足与计费恢复。明确是 RPM、TPM 或请求增长过快时,转到 OpenAI API 429 限流与等待处理。本页重点是还没有取得完整响应,或 SDK 在请求、读取过程中连接失败的情况。
在报错环境做一次不带密钥的路径检查
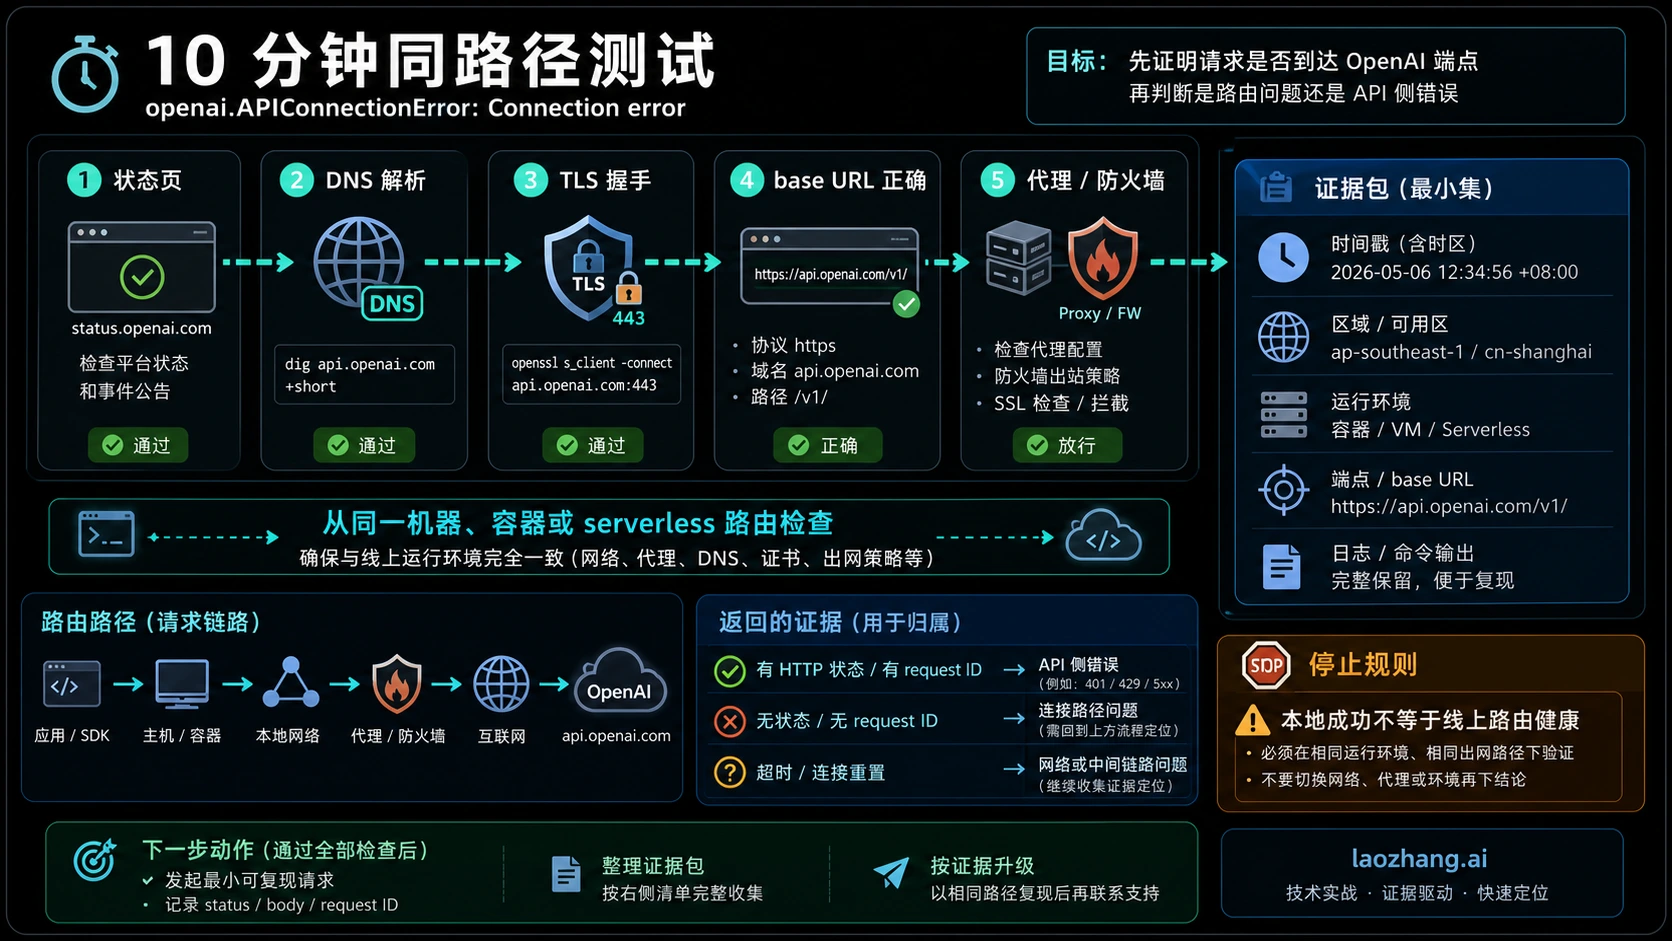
本机浏览器能打开网页,不代表容器、函数或工作进程走同一条网络路径。先记下应用实际生效的 API 主机和基础地址,再进入发生故障的容器、主机或运行实例检查。直连 OpenAI 通常使用 https://api.openai.com/v1;Azure 资源和兼容网关需要使用各自的实际地址,不要拿直连测试替代网关测试。
下面的命令只向 OpenAI 的模型列表路径发起不带认证的 GET,没有提交模型生成任务。使用其他服务商时,把地址替换为它允许检查的已知 HTTPS 路径;不要把密钥拼进 URL。它保留 TLS 验证,-q 必须放在 curl 的第一个参数位置,以忽略默认 curl 配置文件:
curl -q --connect-timeout 5 --max-time 15 \
  --silent --show-error --output /dev/null \
  --write-out 'http=%{http_code} dns=%{time_namelookup}s connect=%{time_connect}s tls=%{time_appconnect}s total=%{time_total}s\n' \
  'https://api.openai.com/v1/models'
curl_exit=$?
printf 'curl_exit=%s\n' "$curl_exit"这里的两个超时参数以秒为单位。--connect-timeout 限制包含 DNS、建立连接和 TLS 握手的连接阶段;--max-time 限制这次传输总时长。-q 不会取消代理环境变量,也不会把 curl 的网络配置变成 SDK 的网络配置。curl 手册解释了这些参数和退出码。
同时看 http 与 curl_exit,不要把它们当成同一个数字。 该命令没有使用 --fail,所以 HTTP 401 也可能对应 curl_exit=0。从已确认的目标服务收到 401,说明这次探测取得了 HTTP 响应;它不能证明业务密钥、模型访问权限或生成接口已经正常。企业代理若返回了自己的错误页,同样不能据此宣布目标 API 可达。
| curl 结果或底层原因 | 接下来查什么 | 条件明确的修复 |
|---|---|---|
| 退出码 5、6,或域名解析异常 | 代理主机或 API 主机在该实例中的 DNS | 修正拼错的主机名,恢复部署允许的 DNS 配置;仅容器失败时核对容器解析设置 |
| 退出码 7、连接被拒绝 | 目标端口、出网规则,代理进程是否监听 | 用实际服务地址和端口;按云平台规则开放获准的 HTTPS 出网 |
| 退出码 60、77,或 certificate verify failed | 系统/容器 CA、企业代理证书链、CA 文件路径 | 更新受信 CA 包,使用管理员提供的 CA;让客户端读取正确证书路径 |
| 退出码 35,TLS 握手失败 | 完整 TLS 错误、代理协议、服务端握手行为 | 对照 HTTPS 与代理协议配置;仍失败时让网络管理员查握手日志 |
| 退出码 97、代理握手失败 | 代理协议、认证及地址在本环境是否可用 | 使用获准代理的真实参数,不把 HTTP、HTTPS、SOCKS 地址混用 |
| 退出码 28,超时 | 哪个阶段未完成,SDK 是否使用不同代理或 CA | 连接超时先修路径;读取超时再检查请求耗时和时间预算 |
| 退出码 52、56,空回复或接收失败 | 代理、连接复用、远端断开及失败时间 | 对照原异常和代理日志定位断点,避免无上限重放请求 |
这些退出码是排查线索,不是一对一的根因证明。http=000 只表示本次探测没有获得可报告的 HTTP 状态码。若探测通过而应用仍失败,下一步比较同一进程的代理、CA、基础地址与客户端配置;如果所有同路径请求都失败,可同时查看 OpenAI 状态页,记录检查时间。状态页正常不能排除本地故障,也不能替代原请求验证。
Python:先捕获超时,再看原始原因
APITimeoutError 属于连接异常体系,捕获顺序应放在 APIConnectionError 前面,否则超时会被父类分支吞掉。底层网络库的错误通常保存在 __cause__ 中;已返回的失败响应则可从 APIStatusError 取得状态码和请求 ID。官方 Python 参考给出了这些属性。
下面是可以嵌入应用的函数片段:把现有客户端、实际模型名和一个小输入传入。它保留诊断字段并重新抛出异常,让调用方决定停止或重试;代码不会帮你恢复 DNS 或修代理。不要直接打印原异常全文,异常消息可能含内部地址或其他敏感信息。
import openai


def diagnose_response(client, model, text):
    try:
        result = client.responses.create(model=model, input=text)
    except openai.APITimeoutError as exc:
        cause = exc.__cause__
        print({"kind": "timeout", "cause_type": type(cause).__name__})
        raise
    except openai.APIConnectionError as exc:
        cause = exc.__cause__
        print({"kind": "connection", "cause_type": type(cause).__name__})
        raise
    except openai.APIStatusError as exc:
        print({"kind": "http", "status": exc.status_code,
               "request_id": exc.request_id})
        raise
    else:
        print({"kind": "ok", "request_id": result._request_id})
        return result
如果 cause_type 是解析、连接、证书或读取超时相关类型,继续在本地受控日志里查看脱敏后的具体原因。若应用自定义 transport 或 hook 自己抛出异常,SDK 不一定把它转换为以上三类;保留原异常链,核对那段自定义代码。
超时怎样设置,才不会把故障藏起来?
当前 Python 文档的默认超时为 10 分钟,数字 timeout 的单位是秒;符合条件的错误默认会再重试两次。排障时可以临时将 max_retries=0,让一次调用的实际失败更容易观察。比如 OpenAI(timeout=30.0, max_retries=0) 设置的是单次调用的超时配置,不是整个队列任务的绝对截止时间。Python SDK 参考还提供分阶段超时。
截至本轮文档,Python 客户端默认使用 HTTPX2。下面是已安装版本提供 DefaultHttpx2Client 和 httpx2 时的配置片段;创建的客户端还需接入你现有的调用与关闭流程。代理地址是示例,应替换为本环境真实、获准的 HTTP 代理地址:
import httpx2
from openai import OpenAI, DefaultHttpx2Client

client = OpenAI(
    max_retries=0,
    timeout=httpx2.Timeout(60.0, connect=5.0, read=30.0, write=10.0),
    http_client=DefaultHttpx2Client(
        proxy="http://proxy.example.com:8080"
    ),
)
这些数值只用于说明连接、读取和写入预算如何分开配置,不是所有业务都应该照抄的标准。连接阶段超时,增加读取时间通常没有作用;请求已经开始返回、长任务仍在处理中时,应结合业务允许等待多久设置读取和上层任务预算。
旧版项目可能使用 HTTPX 与 DefaultHttpxClient。先查看报错进程所用的 openai 版本及其对应文档,再选择匹配的客户端;如果缺少 DefaultHttpx2Client,不要仅为了复制本段代码就改安装目录里的 _base_client.py,也不要把两代客户端参数混用。升级需要核对依赖和原应用兼容性,不能用“升级一次必定修好”替代定位。
证书、代理和容器分别怎么修?
证书问题: 如果组织的 HTTPS 代理使用企业 CA,先取得管理员确认的 CA 文件,再为客户端设置受信证书上下文。当前 DefaultHttpx2Client 支持 verify=ssl_context;例如用 ssl.create_default_context(cafile="/etc/company/approved-ca.pem") 构建上下文,再传给客户端。文件必须存在于实际容器中。普通 API 的服务器证书验证,不要求额外申请 mTLS 客户端证书;不要混用 mTLS 专用端点或关闭验证。Python 客户端配置文档说明了 SSLContext 配置。
代理问题: localhost 或 127.0.0.1 指向当前运行环境自身。容器里写 http://127.0.0.1:7890,不代表会连到宿主机的代理;只有代理确实在该容器网络中监听这个地址和端口,配置才成立。代理运行在宿主机或其他服务时,使用该部署允许的、容器可访问的实际地址,并从容器内检查连通性。端口 7890 没有普遍适用性,不能作为固定修法。
部署问题: 把 CA 文件、代理地址和出网规则放进运行时配置,重新加载对应实例。构建时能下载依赖,不能证明运行中的函数允许外连。异步客户端应在事件循环结束前关闭;同步客户端可使用 with OpenAI(...) as client,长期服务则按应用生命周期复用和关闭连接池,不要每次请求都无序创建客户端。官方生命周期说明适用于这类资源管理。
Node:代理必须与实际 fetch 配套
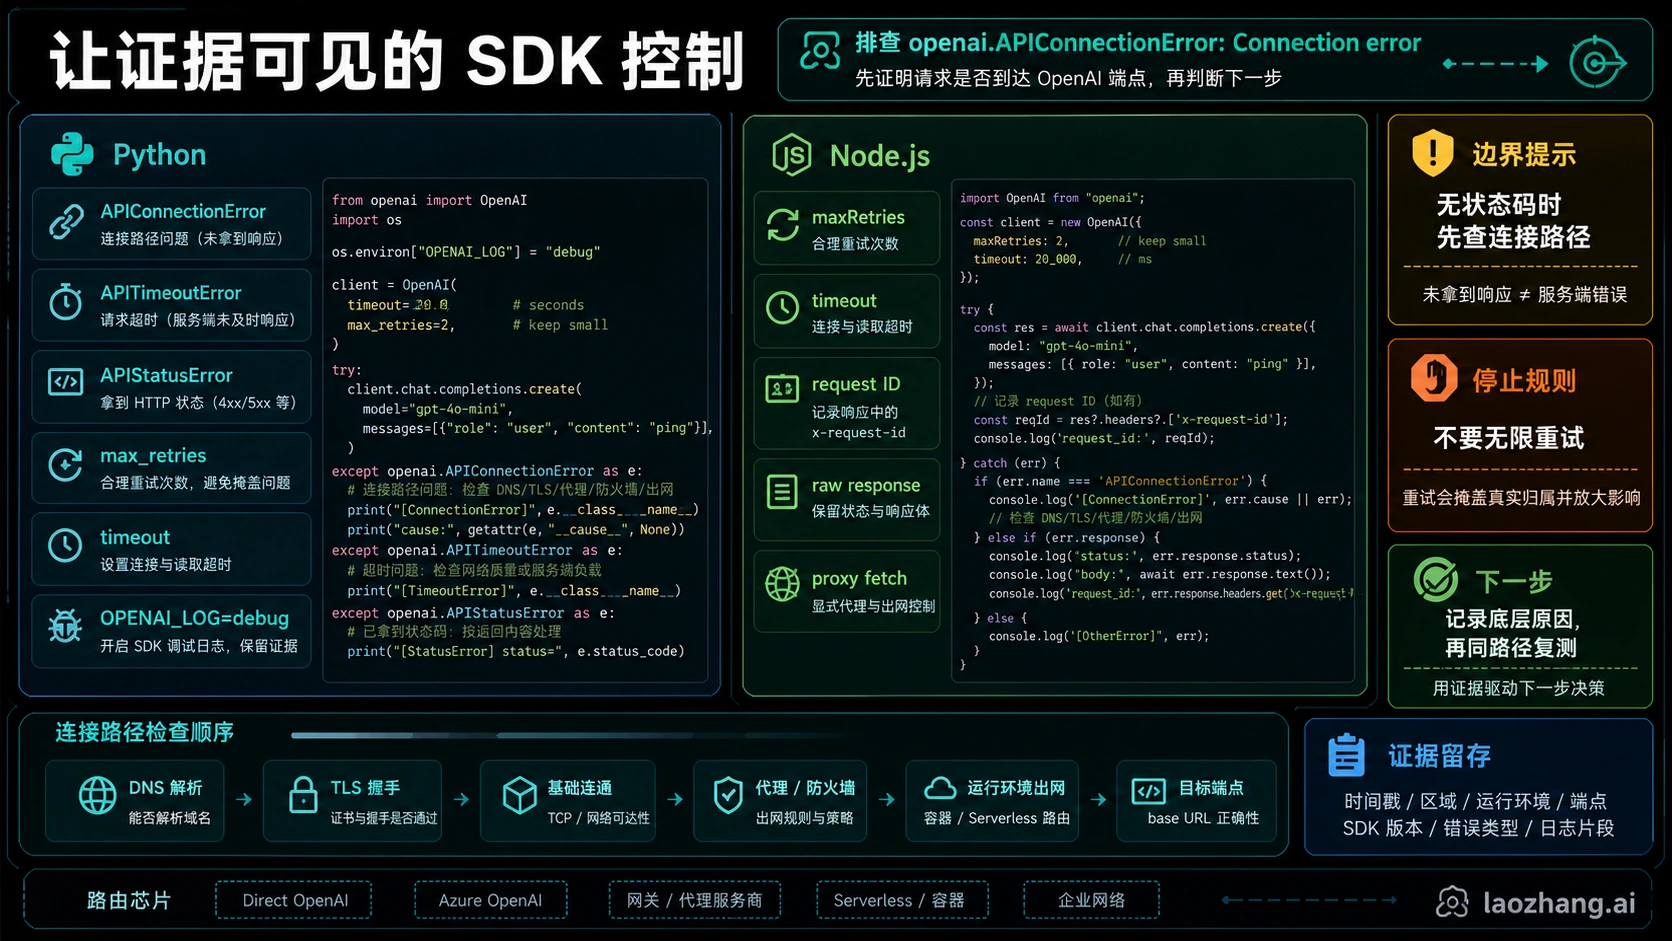
Node SDK 的 timeout 单位是毫秒,与 Python 不同。timeout: 30_000 才是 30 秒;maxRetries: 0 可暂时关闭 SDK 内部重试。当前默认超时同样是 10 分钟、默认重试两次;超时使用 APIConnectionTimeoutError。Node/TypeScript 参考同时说明了错误属性与代理配置。
不要假定 Node、Bun、Deno 都会按同一种方式继承代理环境变量。下面是 Node 的配置片段,需要已安装兼容的 openai 与 undici 包,并使用 ES module。ProxyAgent 的 dispatcher 与这里导入的 undici fetch 一起使用,不能把 dispatcher 随意传给另一种 fetch:
import OpenAI from 'openai';
import { fetch, ProxyAgent } from 'undici';

const proxy = new ProxyAgent('http://proxy.example.com:8080');
const client = new OpenAI({
  fetch,
  fetchOptions: { dispatcher: proxy },
  timeout: 30_000,
  maxRetries: 0,
});

export async function diagnoseResponse(model, text) {
  try {
    const result = await client.responses.create({ model, input: text });
    console.log({ kind: 'ok', request_id: result._request_id });
    return result;
  } catch (error) {
    if (error instanceof OpenAI.APIConnectionTimeoutError) {
      console.error({ kind: 'timeout', cause_type: error.cause?.name });
    } else if (error instanceof OpenAI.APIConnectionError) {
      console.error({ kind: 'connection', cause_type: error.cause?.name });
    } else if (error instanceof OpenAI.APIError) {
      console.error({ kind: 'http', status: error.status,
                      request_id: error.requestID });
    }
    throw error;
  }
}

export async function closeProxy() {
  await proxy.close();
}
用应用原有的凭据配置创建客户端,将函数接入原调用;应用退出前调用 closeProxy() 关闭该代理连接池。示例没有提供密钥或自动发起请求。Bun 的代理和 Deno 的 HTTP 客户端配置方式不同,应使用对应运行时的官方示例,不要把 Node 的 dispatcher 复制过去。旧版本的代理选项也要对照对应版本,而不能把旧教程中的 httpAgent 当成通用参数。
如果框架隐藏了 SDK 配置,先确认它实际创建了哪个客户端、用了哪个 fetch,代理选项是否被转发。curl 通而 SDK 不通时,这些差异比重新生成密钥更值得检查。
超时和流式断开,什么时候可以重试?
只有在确认错误适合重试、任务允许重复以及总预算足够时,才安排有限重试。当前 Python 与 Node SDK 会对符合条件的连接错误、408、409、429 和 5xx 进行内部重试;Python 还要求请求体可以安全重发。SDK、业务函数和队列都重试,会叠加实际请求次数,排障时应明确由哪一层负责。Python与 Node文档给出了默认行为。
流式读取已经开始后,不要把断流当作“从未请求过”。 当前 Python Stream、AsyncStream 的读取超时会表现为 APITimeoutError,其他 HTTP 读取故障可表现为 APIConnectionError;已经进入流消费后的失败不会自动重播整个流。保留已收到的事件、输出和业务执行状态,再决定是否新建请求。Assistants 或原始 with_streaming_response 接口仍有各自行为,不能一概套用同一恢复方法。Python 参考
调用方用超时或 AbortSignal 停止等待,也不能保证服务端立即停止处理,更不是撤销账单的证明。带工具执行、写入数据或付款等副作用的任务,应先检查业务结果,再重新提交;关联请求 ID 也不等于幂等机制。
如果只在高并发时失败,而单个请求稳定,检查连接池使用、工作进程数、代理连接容量与部署出网限制。先降低并发做对照,记录是否变化;在没有响应头或 HTTP 429 的情况下,不要直接把连接池等待称为 OpenAI 速率限制。
修复后,按原请求验证并保存可接手的证据
验证分两步。先重做不带认证的路径检查,确认原来的 DNS、TLS 或代理错误消失;再由有调用权限的人,在同一运行环境、基础地址、组织/项目、接口和模型发一个输入输出较小的有效业务请求。这一步可能产生 API 用量和费用,模型列表响应或另一台电脑的成功不能替代它。
小请求成功后,逐步恢复原业务的输入大小、流式模式和并发,观察最初失败的任务是否正常完成。若只换了网关、模型或区域,记录“另一条路径成功”,继续确认原路径;若仍是同一底层错误,停止增加重试次数,回到对应配置;若变成 401、429 或 503,按新证据分流。
向支持、云平台或代理管理员提交时,记录失败时间和时区、脱敏后的目标主机/路径、SDK 版本、运行环境与区域、异常类别及底层原因、超时与重试配置、收到的 HTTP 状态和请求 ID,以及每次修复前后的同路径结果。不要附 API key、Authorization 请求头、代理密码或客户原始输入。
拿不到服务端 x-request-id 时,OpenAI 支持的端点可在请求中显式加入唯一的 X-Client-Request-Id,供支持团队查找请求是否被接收。该值需要是 ASCII 且不超过 512 个字符,SDK 不会自动替你添加;在支持该功能的原调用中,通过 extra_headers(Python)或请求选项的 headers(Node)传入即可。它用于关联排查,不保证去重、退款或不计费,其他服务商也未必支持。官方请求 ID 说明
本文代码按文档接口做了离线语法与合成异常检查,没有执行真实 SDK 网络调用、验证账户或产生模型用量。实际恢复应以你原环境里的业务请求结果为准。
常见问题
没有 request ID,是不是请求根本没到 OpenAI?
不能这样判断。可能在连接阶段就失败,也可能请求已发出但响应丢失,或流式读取途中断开。没有 ID 只能说明你没有取得这个关联信息。对支持的 OpenAI 端点,可预先设置唯一 X-Client-Request-Id,再让支持查接收记录;它不是幂等或计费保证。官方说明
为什么浏览器能用,Python 或容器仍然 Connection error?
浏览器可能使用了不同代理、系统证书和网络路径;容器的 localhost 也属于容器自身。进入报错环境做不带认证的探测,再对照实际进程的代理、受信 CA 和 SDK 版本。浏览器能打开网页,只证明浏览器这条路径可用。
修改 _base_client.py 或固定设置 7890 能解决吗?
不应作为通用修法。安装目录修改可能被依赖更新覆盖,固定端口也不说明该环境真的有代理监听。使用当前安装版本支持的自定义 HTTP 客户端,并填写实际可达、获准的代理地址;旧 HTTPX 与当前 HTTPX2 示例需要分别匹配版本。Python 客户端参考
连接超时是不是把 timeout 调大就行?
先看超时阶段。域名解析、代理拒绝或 TLS 故障不会因多等一会儿而修好;业务请求已经开始、只是允许等待时间不足时,调整读取与上层任务预算才有意义。Python 的数字超时是秒,Node 是毫秒,重试还会增加总等待时间。Python、Node
APIConnectionError 能证明 OpenAI 宕机吗?
不能。它需要结合同运行环境的底层错误、目标服务的响应及状态页信息判断。直连 OpenAI、Azure 和第三方网关的故障归属不同;没有实际检查记录,就不能把连接错误写成当前服务宕机。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
参考来源6
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。