Gemini 3 Pro Image Batch API 五折:批量生图费用与 Python 实现
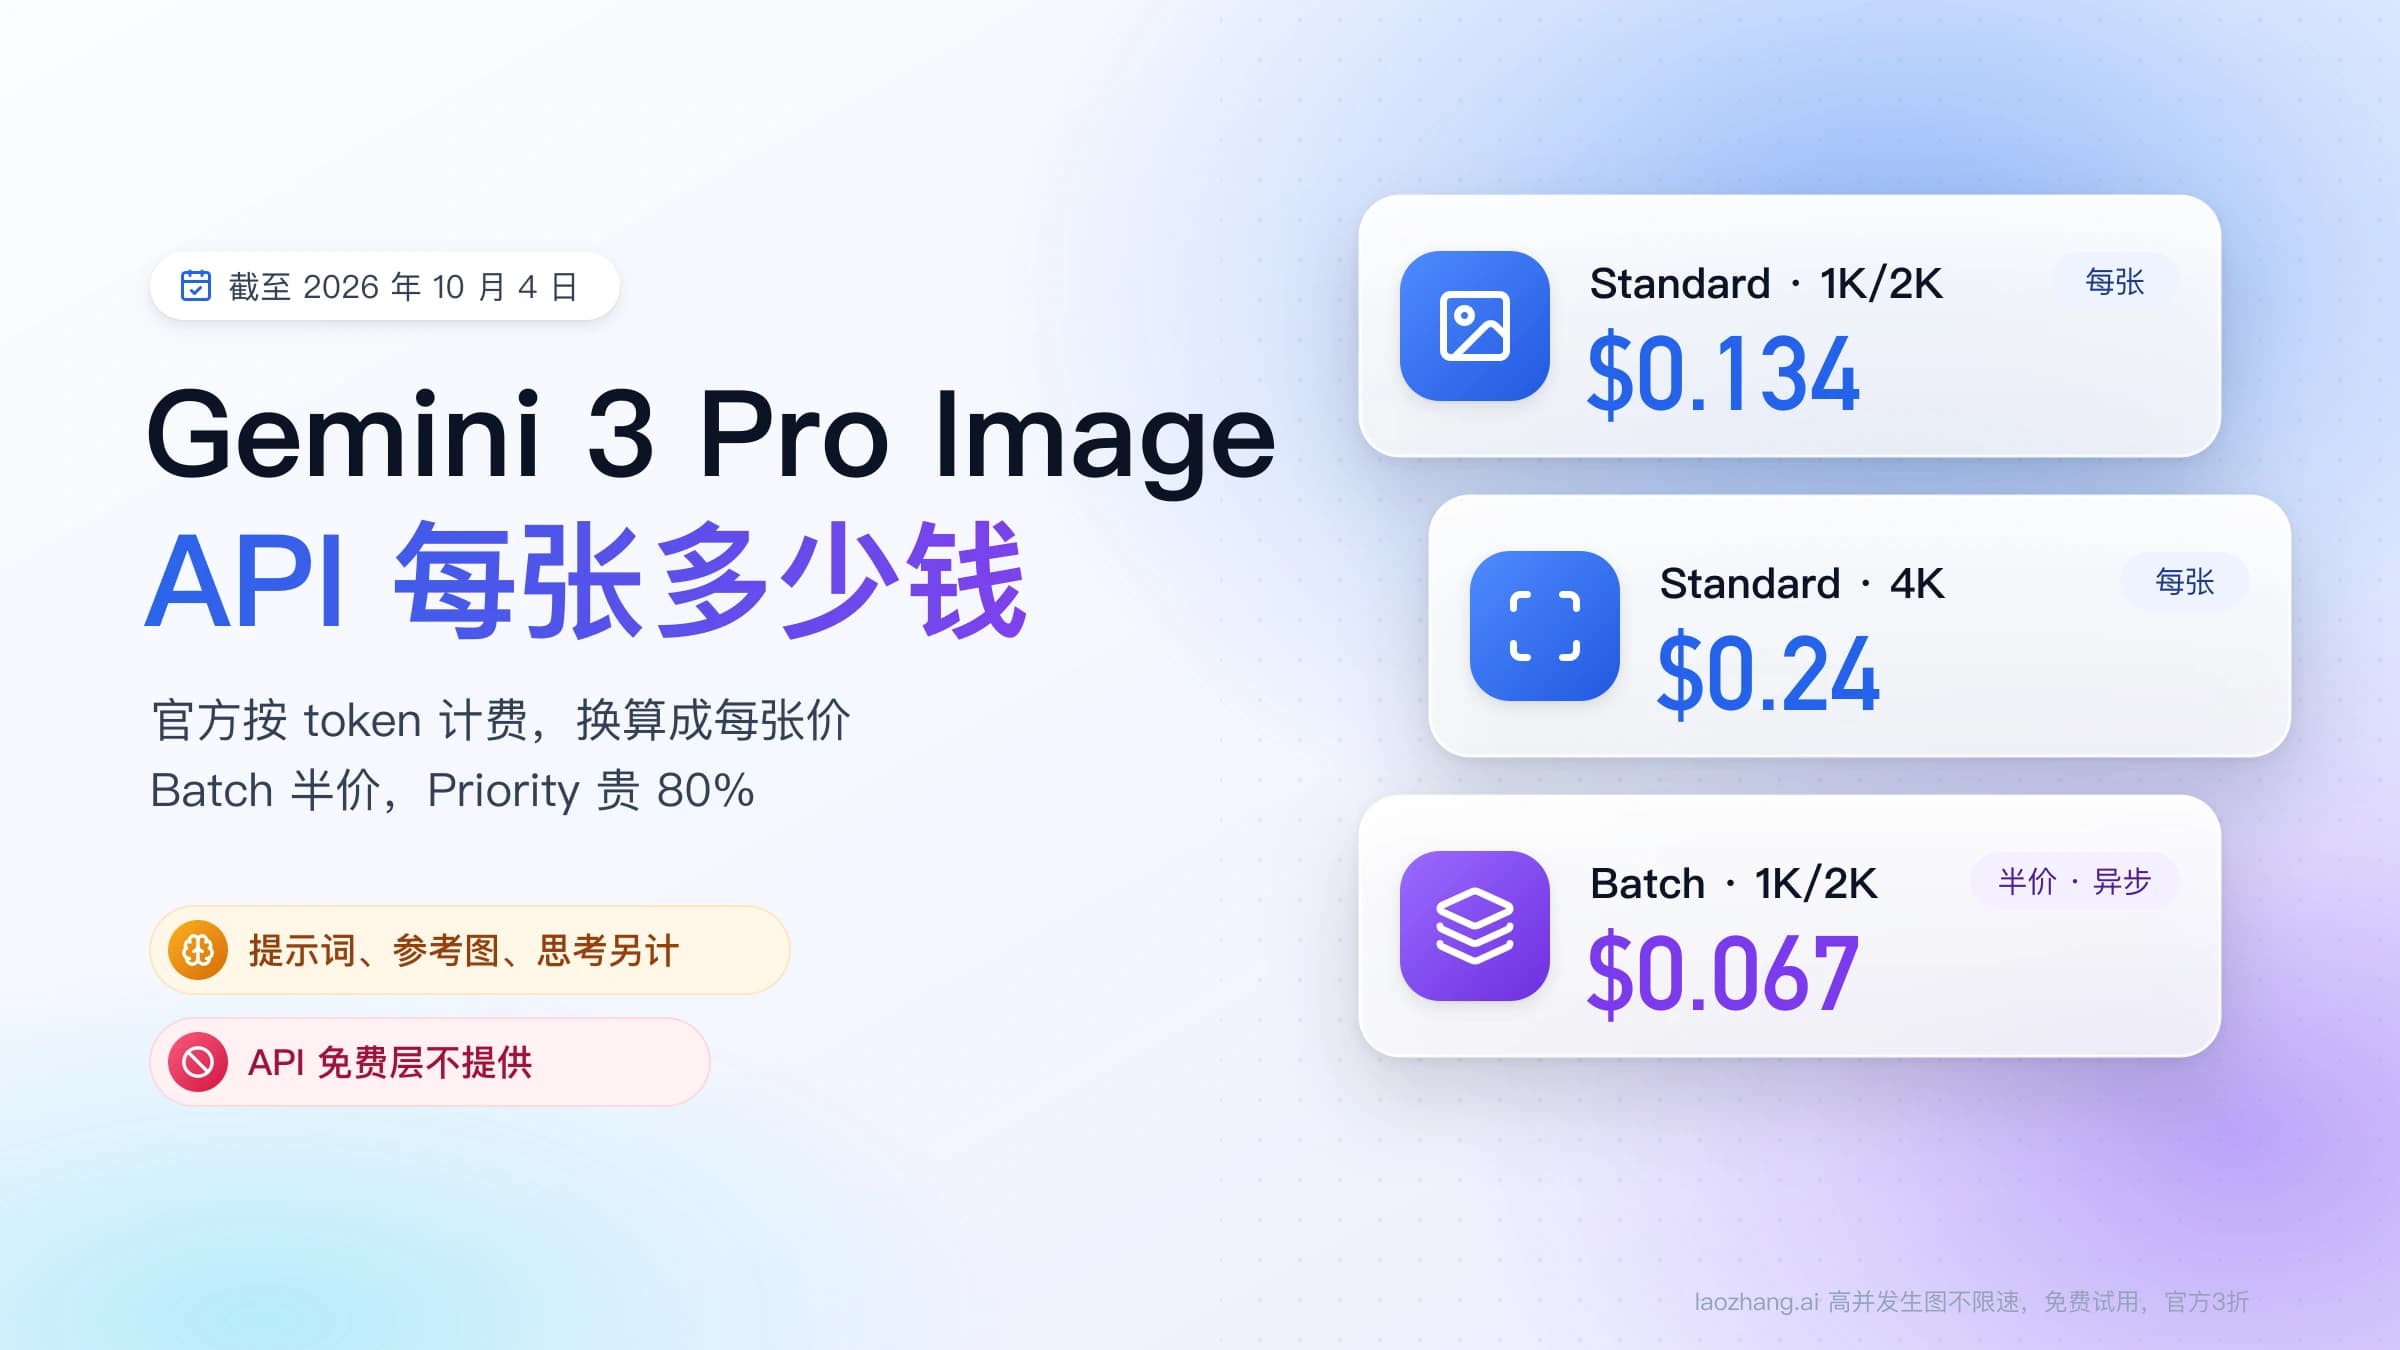
官方 Batch 把 Gemini 3 Pro Image 相应费率降为标准的一半,适合提前准备的图片任务。1K/2K 图片输出标价为 0.067 美元,但预算还需计入输入、思考与重试;提交后保存任务名,按请求键回收图片。
文章目录
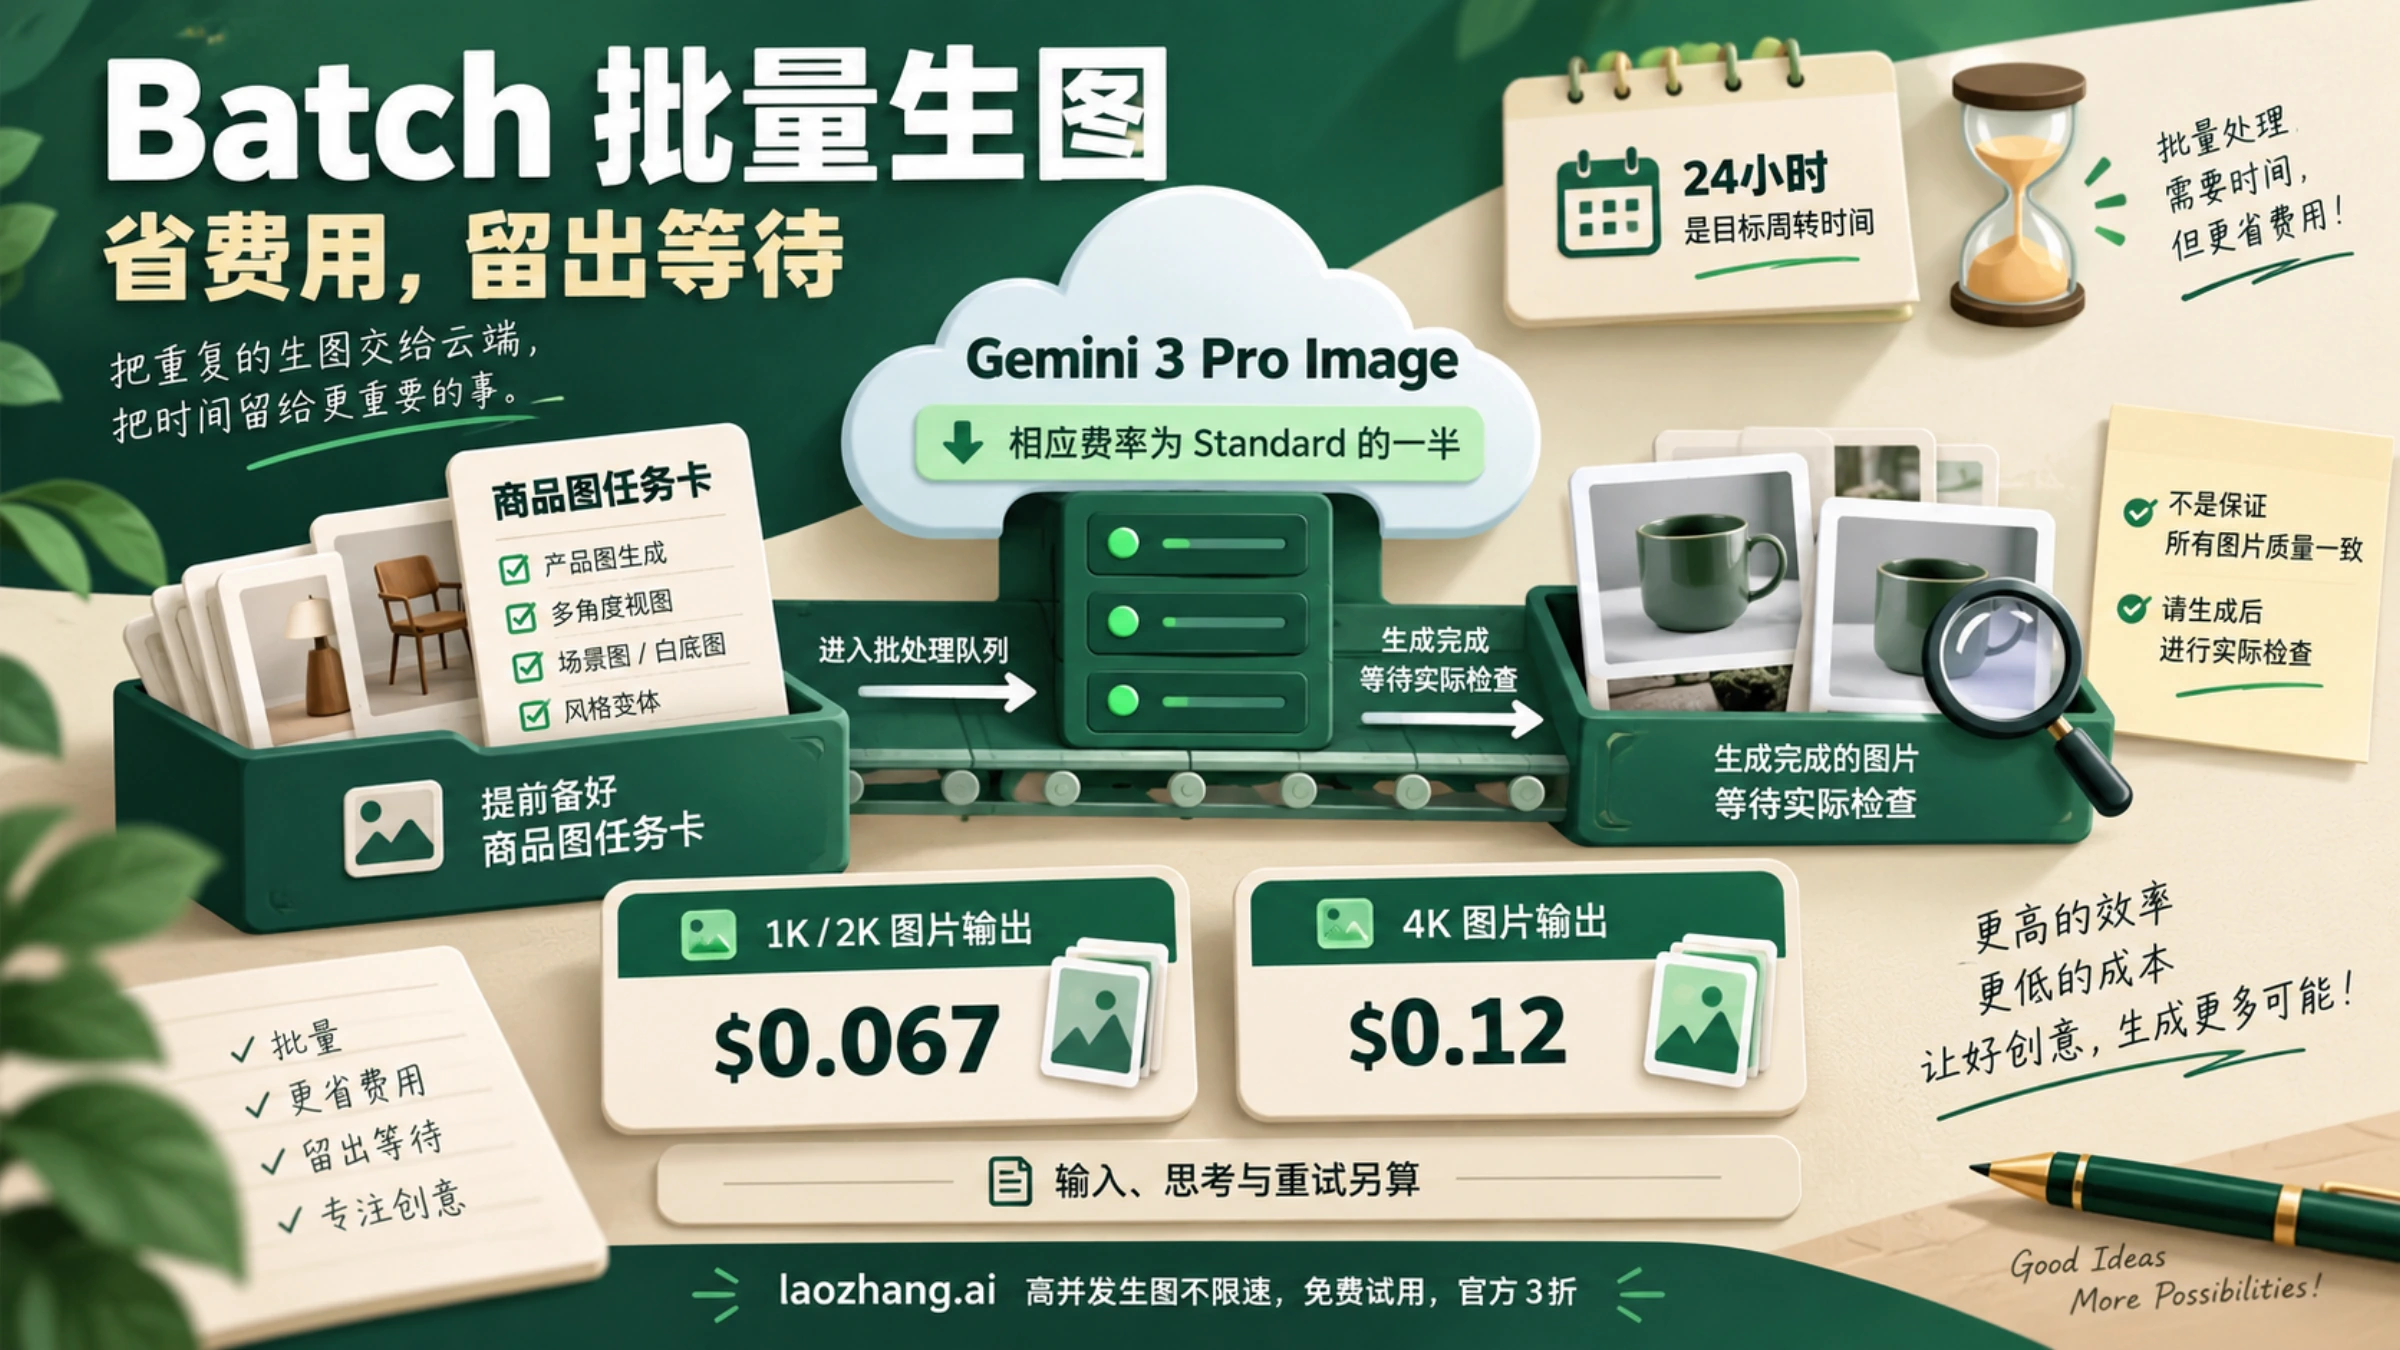
Gemini 3 Pro Image 可以通过官方 Batch API 批量生成图片,费用按相应标准费率的 50% 计算。当前价格表把 1K/2K 图片输出列为每张 0.067 美元,4K 为 0.12 美元;文本输入、参考图片输入以及文本和思考输出也有对应的 Batch 费率。这是 Google Gemini Developer API 的按量计费方式,适合预先制作商品图、活动素材和内容插图。官方价格表与批处理说明支持这一口径,核对日期为 2026 年 10 月 6 日。
判断是否采用 Batch,先看交付时间,再看预算。Google 的目标周转时间是 24 小时,实际会受系统负载和批次大小影响,不能当成次日准时出图的承诺。能提前生成并检查的任务可以用 Batch;用户正在等待图片,或必须在固定时刻交付的任务,应给同步生成或既有素材留出位置。
下面先算清五折省了哪些费用,再给出一条带请求键的 Python 文件批处理流程:生成输入、提交并保存任务名、恢复查询、下载图片、整理需要重试的条目。代码依据官方文档编写,本地检查仅覆盖语法、离线解析与算术,没有调用模型或验证真实账单、生成质量和完成时间。
五折对应哪些费用?单张图片标价不等于总成本
Gemini 3 Pro Image 的模型 ID 现在是 gemini-3-pro-image,也称 Nano Banana Pro。模型说明列出 Batch 支持;旧示例里的 gemini-3-pro-image-preview 不应被当成当前接入时必须使用的名称。
下表按美元计,适用于 Google Gemini Developer API 的这一模型,不适用于 Gemini 网页套餐或其他供应商。图片输出价格采用官方页面展示的舍入值;其余项目保留原来的计量单位。来源:Gemini 3 Pro Image 定价。
| 计费项目 | Standard | Batch | 预算时怎么用 |
|---|---|---|---|
| 文本输入 | 2 美元/百万 token | 1 美元/百万 token | 提示词、指令等输入累加 |
| 参考图片输入 | 约 0.0011 美元/张 | 约 0.0006 美元/张 | 页面展示值已舍入,每张按 560 token 计 |
| 文本和思考输出 | 12 美元/百万 token | 6 美元/百万 token | 无论是否显示思考内容,都要计入 |
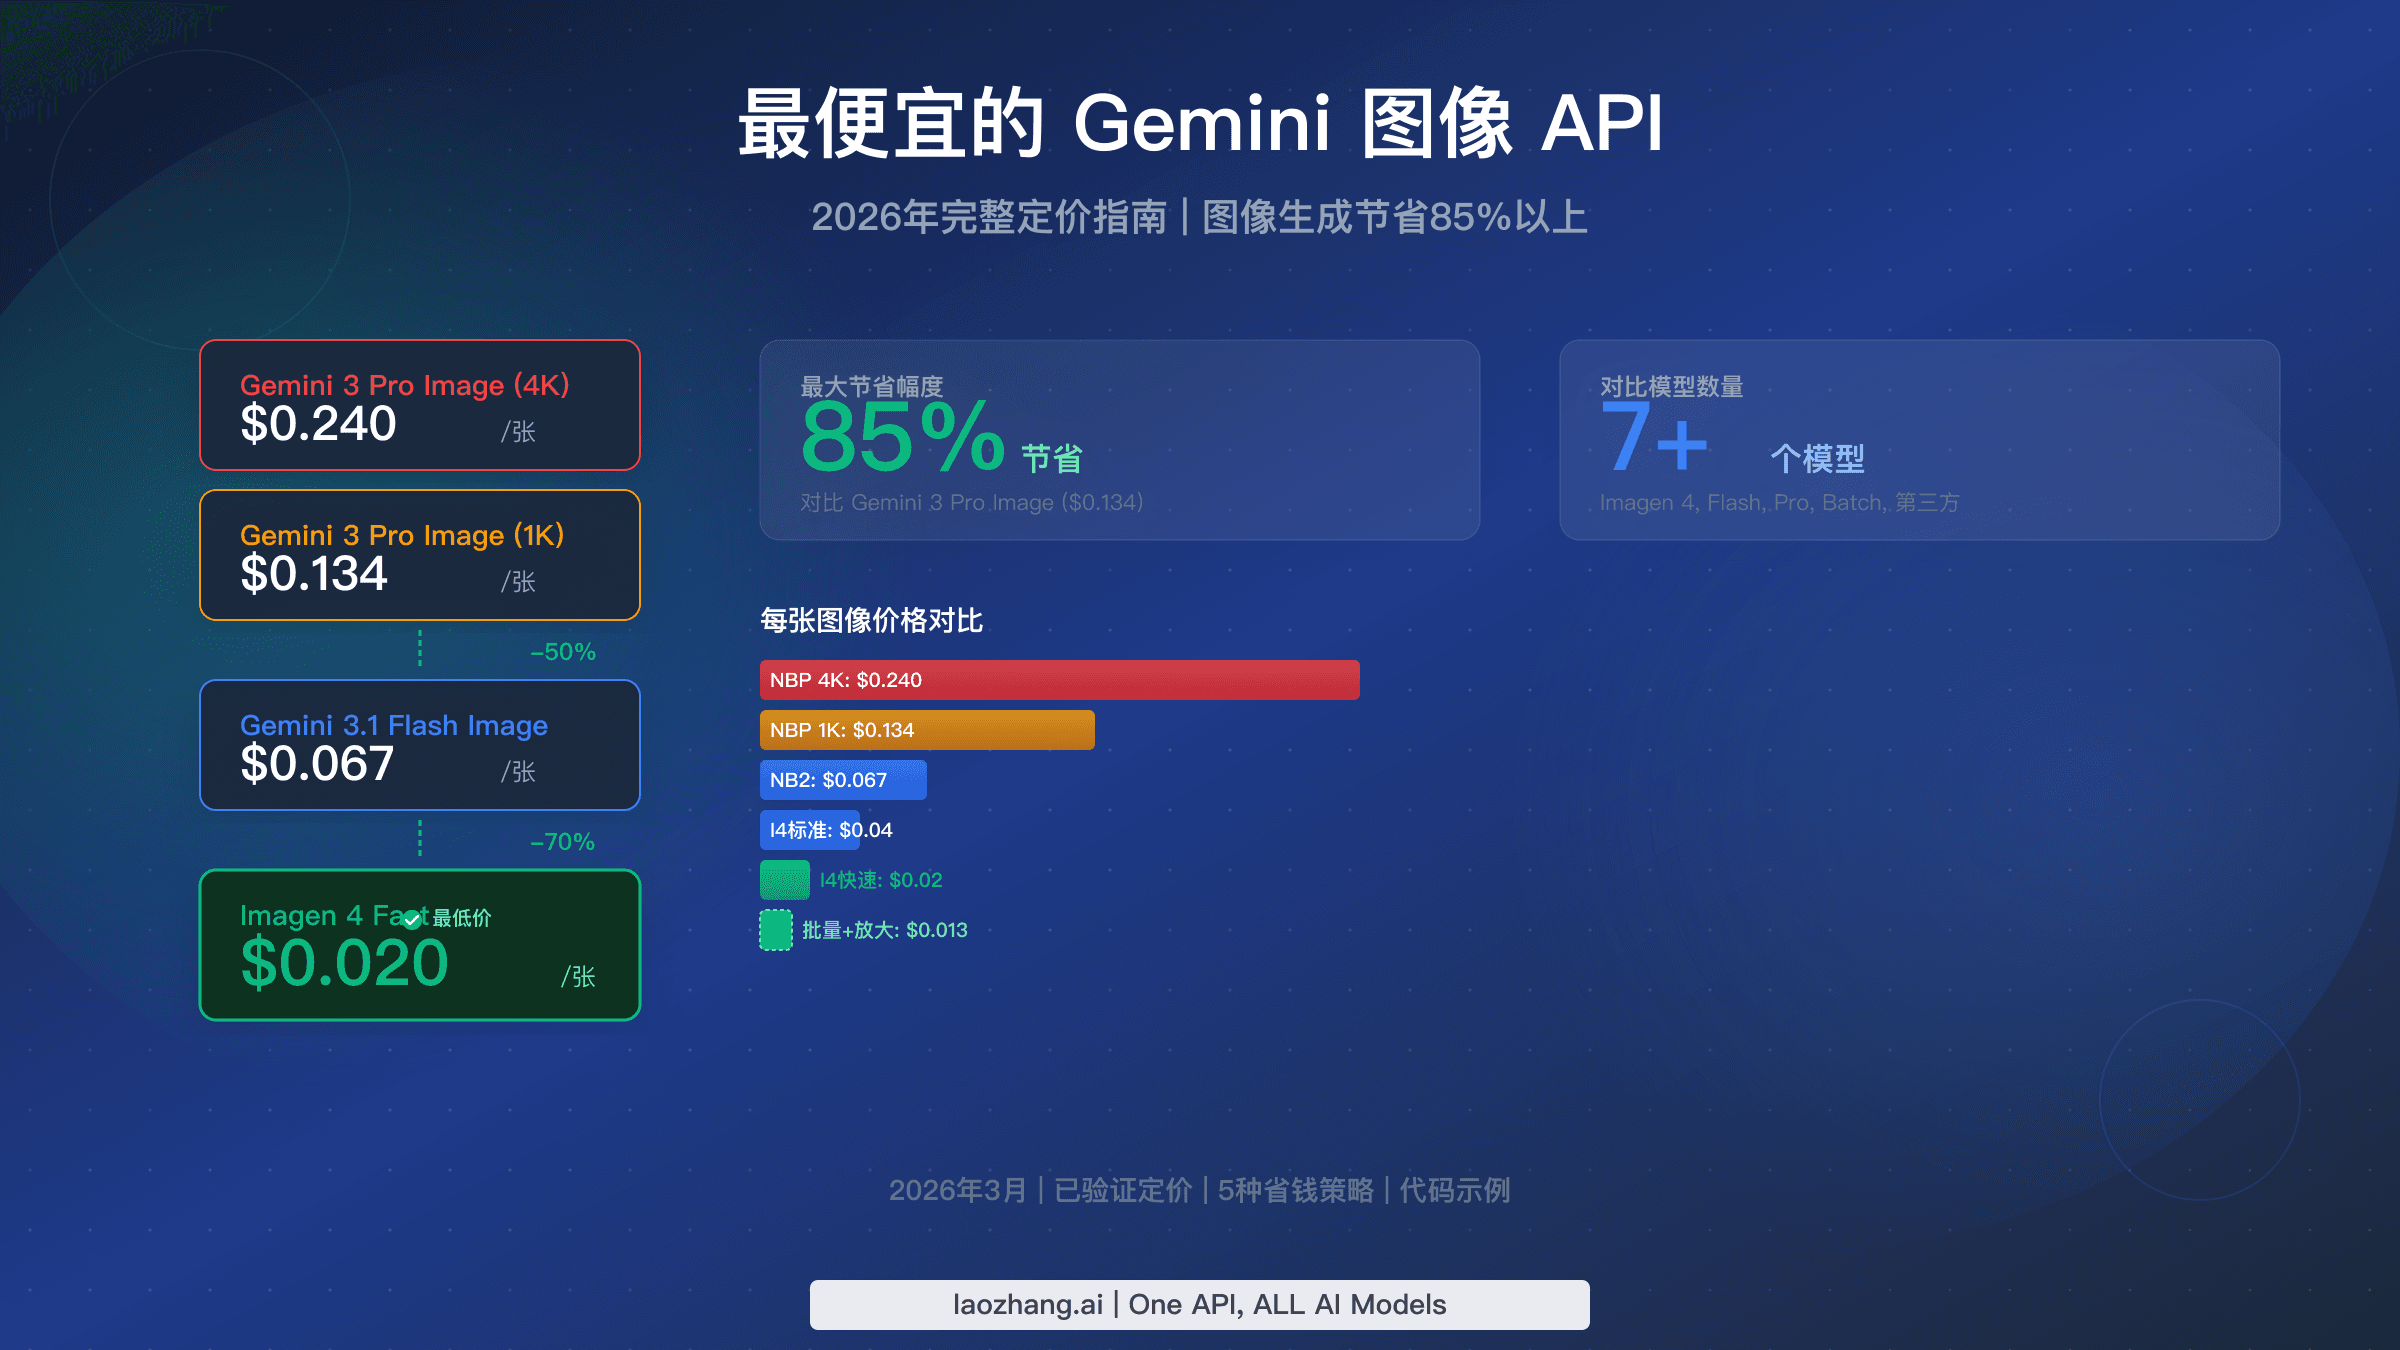
| 1K 图片输出 | 0.134 美元/张 | 0.067 美元/张 | 仅图片输出部分 |
| 2K 图片输出 | 0.134 美元/张 | 0.067 美元/张 | 降到 1K 不会再降低这项标价 |
| 4K 图片输出 | 0.24 美元/张 | 0.12 美元/张 | 按实际需要选择输出规格 |
舍入会影响大批量计算。官方脚注给出的 1K/2K 输出量是每张 1,120 个图片 token,标准图片费率为每百万 120 美元,因此精算值为 1,120 × 120 / 1,000,000 = 0.1344 美元,Batch 为 0.0672 美元。4K 按 2,000 个图片 token 计算,分别为 0.24 和 0.12 美元。参考图片的精算值则是标准 0.00112 美元、Batch 0.00056 美元。不能把表格的 0.067、精算的 0.0672 和实际账单混作同一种精度。
模型的思考过程始终启用,思考 token 是否展示不改变计费;不要照搬 Flash 的参数来宣称能关闭 Pro 的思考费用。图片生成说明说明了这一条件。若启用 Google Search 等工具,还需核对工具自身的适用计费规则;Batch 模型价格表未列出搜索费用,不能由此推断搜索也全部免费或统一五折。
另外,模型能力页目前标明不支持上下文缓存、Flex 和 Priority。即使通用价格页面显示这些列,也不应据此向这个模型传入对应功能,或把“缓存叠加 Batch”写进省钱方案。以模型能力说明为准。
生成 1,000 张、5,000 张图片,要准备多少预算?
先估图片输出,再加入输入、思考和重试。对于 2K 图片,下表使用上面的 token 精算值;假设每次请求产生一张最终图片,且尚未计入其他费用。
| 图片输出数量 | Standard 输出费(美元) | Batch 输出费(美元) | 仅此项节省(美元) |
|---|---|---|---|
| 100 张 | 13.44 | 6.72 | 6.72 |
| 1,000 张 | 134.40 | 67.20 | 67.20 |
| 5,000 张 | 672.00 | 336.00 | 336.00 |
| 10,000 张 | 1,344.00 | 672.00 | 672.00 |
| 50,000 张 | 6,720.00 | 3,360.00 | 3,360.00 |
这些数字是按官方费率复算的输出预算,不是最终账单。以每月 5,000 张 2K 图片为例,全年图片输出部分可从 8,064 美元降到 4,032 美元,节省 4,032 美元;前提是全年用量和相应费率保持不变。
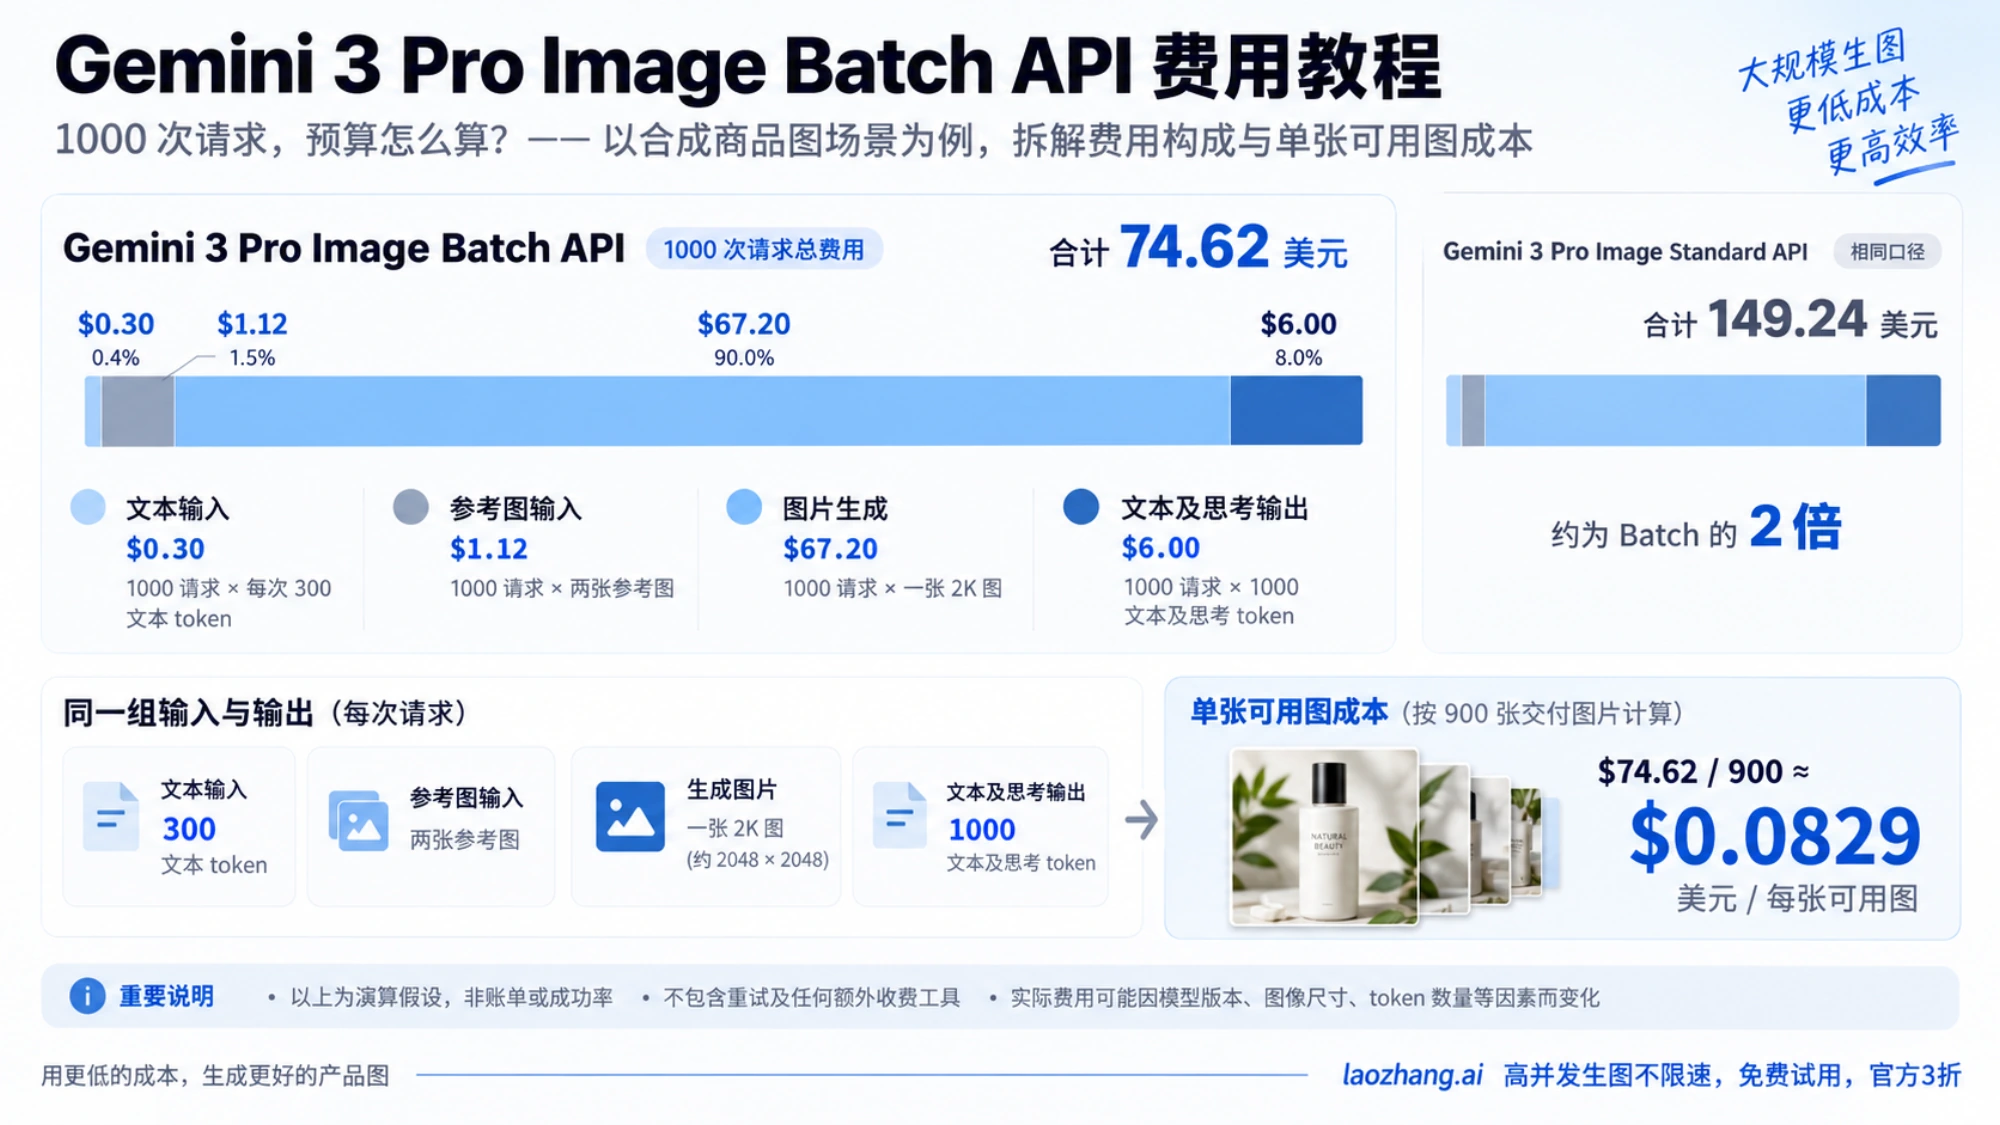
再看一个更接近商品图制作的假设:1,000 次请求,每次包含 300 个文本输入 token、两张参考图片,产生一张 2K 最终图片;另外假设每次共计 1,000 个文本和思考输出 token,不使用收费工具,也没有重试。Batch 预算为:
文本输入:1,000 × 300 × 1 / 1,000,000 = 0.30 美元
参考图片:1,000 × 2 × 560 × 1 / 1,000,000 = 1.12 美元
图片输出:1,000 × 0.0672 = 67.20 美元
文本及思考:1,000 × 1,000 × 6 / 1,000,000 = 6.00 美元
合计:74.62 美元
同样的计量假设下,Standard 为 149.24 美元。这里的五折比较成立,是因为两边使用相同输入、输出和费率口径;真实生成中的思考量、最终图片数和收费项目可能变化,应再用返回的用量与账单校正。
业务真正关心的是可用图片成本。若这次实际花费 74.62 美元,最终筛选出 900 张可交付图片,则可用图片均摊约为 74.62 / 900 = 0.0829 美元;分母不能仍写成 1,000。这个演算不代表模型有 90% 成功率,也不推定错误请求会收费或退费。后续重试产生多少新增费用,就把多少费用加入分子。
选择分辨率也能省钱,但要选对比较对象:同样走 Batch,4K 降到 2K 的图片输出费从 0.12 降为 0.0672 美元,减少 44%;若从标准 4K 改为 Batch 2K,这一项减少 72%。后者同时换了处理方式和输出规格,不能宣传成“同规格 Batch 折扣超过五折”。混用多个供应商同样只会得到相应费用的加权平均,不会自动叠出新的折扣。
先选批次大小和交付方式
Batch 适合把能够提前安排的任务集中提交。例如活动下周上线,现在生成素材,再留时间筛选;商品目录分批更新,先回收通过检查的图片,再补做少量缺项。对于“今晚提交、明早必须全量上线”的排期,仅靠 24 小时目标不足以保证交付。
官方提供两种输入形式:总请求体低于 20 MB 的小批次可以使用内嵌请求;大量图片任务推荐 JSONL 输入文件,文件上限为 2 GB。这里限制的是输入大小,不是保证每批能产出多少张图片。图片批处理说明。
Batch 还有单独的项目配额:最多 100 个并发批任务、文件存储总量 20 GB,以及按模型计算、跨所有活跃批任务累计的排队 token 限制。具体项目额度与账号层级相关,应查看自己项目的当前配额;旧配额表中预览模型的数字不能当成稳定 ID 的容量保证。多建 API 密钥也不会创建新的项目配额。官方 Batch 速率限制。
实践中可按素材用途和交付日期拆批,每批留下输入文件及请求键清单。这样一批出问题时,只需处理这一批;没有官方依据要求每批固定 1,000 或 5,000 张,也不必为了凑大批而错过检查窗口。
Python 文件批处理:从请求键到任务名
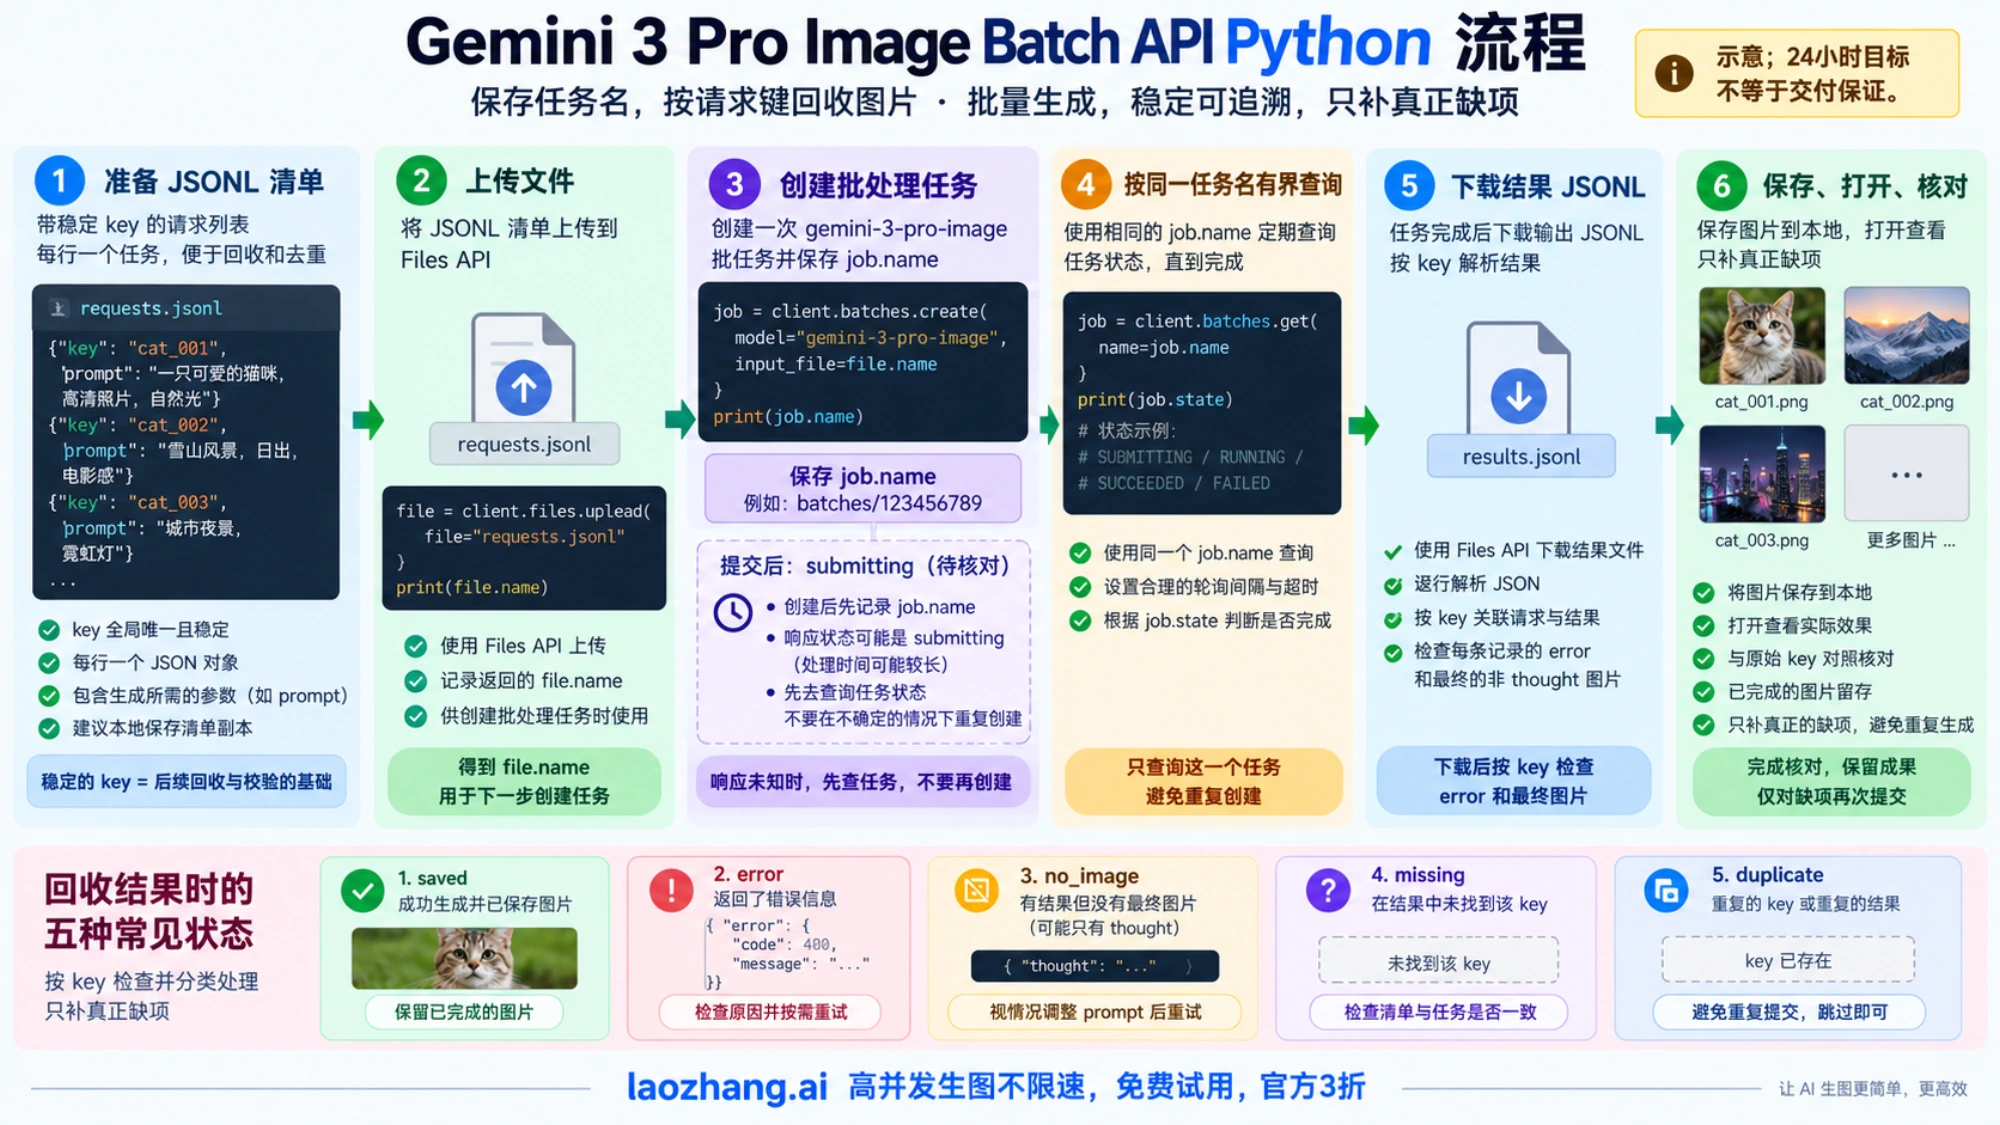
以下示例选 JSONL 文件方式,每条任务带一个稳定的 key,如 cup-main-v1。键标识业务请求,结果不依赖行顺序。重试时保留原业务映射,使用新的尝试标识,并记录与旧键的关系。
示例面向已经能够使用 Gemini Developer API、已配置付费项目和 google-genai Python SDK 的读者。把下面三个代码块分别保存为 submit_batch.py、recover_images.py、collect_batch.py,放在同一个任务目录。genai.Client() 使用你现有的凭据配置;代码不包含密钥,也不把 Gemini 网页免费使用机会折算成 API 免费额度。
1. 写入带键的 JSONL,只提交一次
文件中的每一行是 key 与 request 的组合,原始 JSON 请求使用 generationConfig.responseModalities 和 imageConfig。明确请求 TEXT、IMAGE,并选本模型支持的 1K、2K 或 4K;只配文本或没有请求图片,不能保证返回图片。GenerateContent 配置参考与文件批处理示例。
# submit_batch.py
import json
import os
from pathlib import Path
from google import genai
from google.genai import types

MODEL = "gemini-3-pro-image"
manifest = Path("batch-manifest.json")
input_path = Path("image-requests.jsonl")

def save_manifest(value):
    temporary = manifest.with_suffix(".tmp")
    with temporary.open("w", encoding="utf-8") as handle:
        json.dump(value, handle, ensure_ascii=False, indent=2)
        handle.flush()
        os.fsync(handle.fileno())
    os.replace(temporary, manifest)

if manifest.exists():
    saved = json.loads(manifest.read_text(encoding="utf-8"))
    raise SystemExit(
        "已有提交记录,请恢复或核对,勿重复创建:" + str(saved)
    )

prompts = {
    "cup-main-v1": "生成白色陶瓷杯的电商主图,浅灰背景,柔和自然光。",
    "cup-scene-v1": "生成白色陶瓷杯放在木质餐桌上的场景图,晨光。",
}
with input_path.open("w", encoding="utf-8") as handle:
    for key, prompt in prompts.items():
        row = {
            "key": key,
            "request": {
                "contents": [{
                    "role": "user", "parts": [{"text": prompt}]
                }],
                "generationConfig": {
                    "responseModalities": ["TEXT", "IMAGE"],
                    "imageConfig": {"imageSize": "2K", "aspectRatio": "1:1"},
                },
            },
        }
        handle.write(json.dumps(row, ensure_ascii=False) + "\n")

client = genai.Client()
uploaded = client.files.upload(
    file=str(input_path),
    config=types.UploadFileConfig(
        display_name="cup-images-input", mime_type="jsonl"
    ),
)
# 先记录提交意图;若创建结果不明,保留这份记录并人工核对。
record = {
    "phase": "submitting", "model": MODEL,
    "input_file": uploaded.name, "keys": list(prompts),
}
save_manifest(record)
job = client.batches.create(
    model=MODEL, src=uploaded.name,
    config={"display_name": "cup-images-v1"},
)
record.update(phase="submitted", job_name=job.name)
save_manifest(record)
print("已保存任务名:", job.name)
上传配置显式声明 jsonl,创建时的 src 传上传结果的 .name,而不是整个 File 对象。程序收到任务名就写入本地记录,随后使用该名字查询。官方文件输入流程。
创建批任务不具备幂等性,同一批输入创建两次就可能产生两个任务。上面的记录降低误点重复提交的风险,但不能把网络和文件写入变成一个原子事务:如果服务端已创建、客户端未收到响应,记录会停在 submitting;此时应结合项目中的任务列表、展示名、上传文件和提交时间核对,找到已创建任务后补入其名字。不要直接删除记录并重跑,也不要让两个进程同时执行提交脚本。官方最佳实践。
若选择内嵌方式,Python SDK 的单条请求形状有所不同:图片配置放在 config.response_modalities、config.image_config,业务键放在 metadata.key。不要把上述原始 JSONL 行直接当成 SDK 内嵌请求;两者的配置层和字段写法不能混用。
2. 按请求键回收最终图片,并记下缺项
结果文件是 UTF-8 JSONL,每行可能包含响应,也可能包含错误或状态。下面的解析器只处理原始 JSON,inlineData.data 在这里是 Base64 文本。它遍历候选内容,跳过标为 thought 的思考部分,把最终图片写入以键命名的文件,并保存每条结果的状态。对文字响应、空内容、无图片和解码错误,均保留原因;任务成功不能代替这些检查。官方图片结果示例。
# recover_images.py:纯本地 JSONL 解析,不调用 API
import base64
import json
import re
from pathlib import Path

EXTENSIONS = {"image/png": ".png", "image/jpeg": ".jpg", "image/webp": ".webp"}

def recover(raw_bytes, expected_keys, output_dir):
    expected = set(expected_keys)
    if len(expected) != len(expected_keys):
        raise ValueError("输入清单含重复键")
    if any(not re.fullmatch(r"[A-Za-z0-9_-]+", key) for key in expected):
        raise ValueError("本示例的键只允许字母、数字、下划线和连字符")
    output = Path(output_dir)
    output.mkdir(parents=True, exist_ok=True)
    rows, issues = {}, []
    for number, line in enumerate(raw_bytes.decode("utf-8").splitlines(), 1):
        if not line.strip():
            continue
        try:
            row = json.loads(line)
            if not isinstance(row, dict):
                raise ValueError("结果行不是对象")
            key = row.get("key")
            if not isinstance(key, str) or key not in expected:
                raise ValueError("结果键缺失或不在输入清单中")
            rows.setdefault(key, []).append(row)
        except (ValueError, TypeError) as error:
            issues.append({"line": number, "reason": str(error)})

    report = {}
    for key in sorted(expected):
        matching = rows.get(key, [])
        if len(matching) != 1:
            report[key] = {"state": "missing" if not matching else "duplicate"}
            continue
        row = matching[0]
        status = row.get("status") or {}
        if row.get("error") or status.get("code", 0) != 0:
            report[key] = {"state": "error", "detail": row.get("error") or status}
            continue
        response = row.get("response") or {}
        files, notes = [], []
        for candidate in response.get("candidates") or []:
            for part in (candidate.get("content") or {}).get("parts") or []:
                if part.get("thought"):
                    continue
                image = part.get("inlineData") or {}
                if not image:
                    continue
                extension = EXTENSIONS.get(image.get("mimeType"))
                if not extension:
                    notes.append("图片 MIME 类型未获本示例支持")
                    continue
                try:
                    data = base64.b64decode(image.get("data", ""), validate=True)
                    if not data:
                        raise ValueError("图片数据为空")
                    name = f"{key}-{len(files) + 1}{extension}"
                    (output / name).write_bytes(data)
                    files.append(name)
                except (ValueError, TypeError) as error:
                    notes.append(str(error))
        report[key] = {
            "state": "saved" if files else "no_image",
            "files": files, "notes": notes,
        }
    result = {"requests": report, "parse_issues": issues}
    (output / "report.json").write_text(
        json.dumps(result, ensure_ascii=False, indent=2), encoding="utf-8"
    )
    return result
saved 只表示存在已解码并保存的最终图片数据,还需实际打开文件,检查是否符合商品、版式和交付要求;它不代表图片一定可用。parse_issues 中的无效行也需要回查原始文件。示例不支持的 MIME 类型保留为待处理项,不擅自改扩展名。
这个 Base64 解码仅用于文件中的原始 JSON。如果走内嵌 SDK 结果,应读取 job.dest.inlined_responses,检查每项 response 或 error,再对图片 part 使用 SDK 的 part.as_image() 保存;不要对 SDK 已经转为二进制的数据再次 Base64 解码,也不要读取不存在的 job.results。
3. 从任务名恢复查询,下载后交给解析器
收集脚本独立于提交脚本。重启程序时读取已保存的 job_name,继续查询同一个任务,不重新创建。示例每 60 秒查询一次,本轮等待窗口为 30 分钟;这是客户端本轮查询安排,不是模型完成时间预测。
# collect_batch.py
import json
import time
from pathlib import Path
from google import genai
from recover_images import recover

saved = json.loads(Path("batch-manifest.json").read_text(encoding="utf-8"))
if not saved.get("job_name"):
    raise SystemExit("缺少任务名,请先核对提交结果,勿重新创建")
client = genai.Client()
terminal = {
    "JOB_STATE_SUCCEEDED", "JOB_STATE_FAILED",
    "JOB_STATE_CANCELLED", "JOB_STATE_EXPIRED",
}
deadline = time.monotonic() + 30 * 60
job = None
while time.monotonic() < deadline:
    job = client.batches.get(name=saved["job_name"])
    state = job.state.name
    print(saved["job_name"], state)
    if state in terminal:
        break
    remaining = deadline - time.monotonic()
    if remaining > 0:
        time.sleep(min(60, remaining))
else:
    raise SystemExit("本轮停止等待,稍后用原任务名继续查询")

if state != "JOB_STATE_SUCCEEDED":
    raise SystemExit(f"任务终止:{state};请保存错误与状态后检查")
if not job.dest or not job.dest.file_name:
    raise SystemExit("成功状态没有结果文件名,请保留任务名并核对响应")
raw = client.files.download(file=job.dest.file_name)
Path("batch-results.jsonl").write_bytes(raw)
result = recover(raw, saved["keys"], "images-output")
print(json.dumps(result, ensure_ascii=False, indent=2))
轮询接口和结果文件名采用 Python SDK 的 job.state.name、job.dest.file_name,下载返回值按字节保存,再按 UTF-8 解析。REST 示例的批任务状态外层结构不能直接套到 SDK 对象上;结果文件里单条 response 则仍按原始 JSON 字段解析。官方状态与结果流程。
本地等待期限在两次查询之间检查,单次网络调用的超时还需按应用的 SDK 配置处理。查询失败或本轮停止等待,都应保留任务名与已经下载的结果;不会自动取消云端任务,更不会证明没有产生费用。
任务完成后,怎样补做失败或无图的条目?
先保留成功结果,再按报告处理缺项。建议分别记录三种数量:提交请求数、保存了最终图片的请求数、检查后可交付的图片数。一个请求可能没有图片,也可能有多张图片,这三个数不能互相替代。
| 观察到的结果 | 下一步 |
|---|---|
saved,但图片不符合交付要求 | 留下图片与原请求,调整提示词后另建有预算的重试任务 |
error | 查看具体错误;参数或内容问题先修正,避免原样重复提交 |
no_image | 检查 responseModalities、候选内容与拦截信息,保留原始响应 |
missing、duplicate 或解析问题 | 核对输入键和完整结果文件,先排除回收问题 |
任务仍在 PENDING 或 RUNNING | 按原任务名继续查询,不重复创建 |
FAILED、CANCELLED、EXPIRED | 保存任务状态、错误及已有记录,再决定是否需要新任务 |
官方终态包括 SUCCEEDED、FAILED、CANCELLED 和 EXPIRED。保持待处理或运行状态超过 48 小时的任务会过期,并且没有可取结果;成功结果可下载六周,应及时落盘,不把云端任务当成长期图片库。状态说明与技术细节。
取消任务会停止处理新请求,但不能由取消动作推出已完成请求不收费,也不能把本地超时当成退款依据。官方取消说明。如果批量生图由自动化流程触发,应在提交新批次和重试之前检查剩余预算;超时任务的潜在花费仍需等待可靠结算,相关账户处理可继续看如何在供应商调用前设置 API 花费熔断开关。
常见问题
Batch API 的五折优惠是永久的吗?
当前官方文档按标准成本的 50% 提供 Batch,价格表也列出对应费率,但这不能证明未来永不调整。做长期预算时使用当前模型和计费路线,定期核对官方定价,不要把“当前费率”写成永久合同。
一张 2K 图片究竟是 0.067 还是 0.0672 美元?
官方页面展示的 Batch 图片输出价格是 0.067 美元;按每张 1,120 个图片 token 和五折费率复算为 0.0672 美元。本文大批量预算采用后者,且单独加输入、文本和思考费用。两者都只描述图片输出部分,并非最终可用图片的完整成本。官方价格及脚注。
可以保证 24 小时内完成全部图片吗?
不能。24 小时是官方目标周转时间,适合非紧急任务,不能作为硬交付承诺。预留生成、回收和筛选时间,并为固定日期上线准备替代素材;不要把未经验证的“两小时出图”用于排期。官方 Batch 说明。
Batch 生成的图片会和标准 API 逐像素一致吗?
没有这样的依据。Batch 调用的是同一个模型,折扣针对处理方式,但随机生成不等于相同输出,也没有本文的质量、成功率或延迟对照实验。应按自己的交付要求检查实际图片;不根据五折推导质量降低或逐像素一致。模型能力。
Gemini 网页或 AI Studio 的免费使用次数能抵扣 Batch 吗?
不能这样计算。Gemini 3 Pro Image 的 Developer API Standard 和 Batch 价格表均未提供免费层级;网页端使用资格不等于可抵扣批处理的免费 API 图片额度。官方价格表。
为什么任务成功了,仍然收不到可用图片?
任务成功表示批处理进入成功终态,不表示每行都产出最终图片。应按请求键检查错误、候选内容与 inlineData,排除思考部分,再打开文件检查;不要只看整批状态或按结果行号命名。回收失败时先重读已下载文件,确认确实需要新增生成后才提交重试。官方图片结果回收示例。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
参考来源7
本文引用的外部页面,按正文出现顺序排列。最后更新于 2026年10月7日。
- 1.官方价格表ai.google.dev/gemini-api/docs/pricing
- 2.批处理说明ai.google.dev/gemini-api/docs/batch-api
- 3.模型说明ai.google.dev/gemini-api/docs/models/gemini-3-pro-image
- 4.图片生成说明ai.google.dev/gemini-api/docs/image-generation
- 5.图片批处理说明ai.google.dev/gemini-api/docs/batch-api
- 6.官方 Batch 速率限制ai.google.dev/gemini-api/docs/rate-limits
- 7.GenerateContent 配置参考ai.google.dev/api/generate-content