GPT Image 2.6 提示词写法:文字加引号只出一次,编辑先传 size
GPT Image 2.6 提示词不需要特殊语法。2026 年 11 月 5 日实测:标语加引号并写明只出现一次,2 次都没多出文案;编辑不传 size,4:3 照片被改成方图。
文章目录
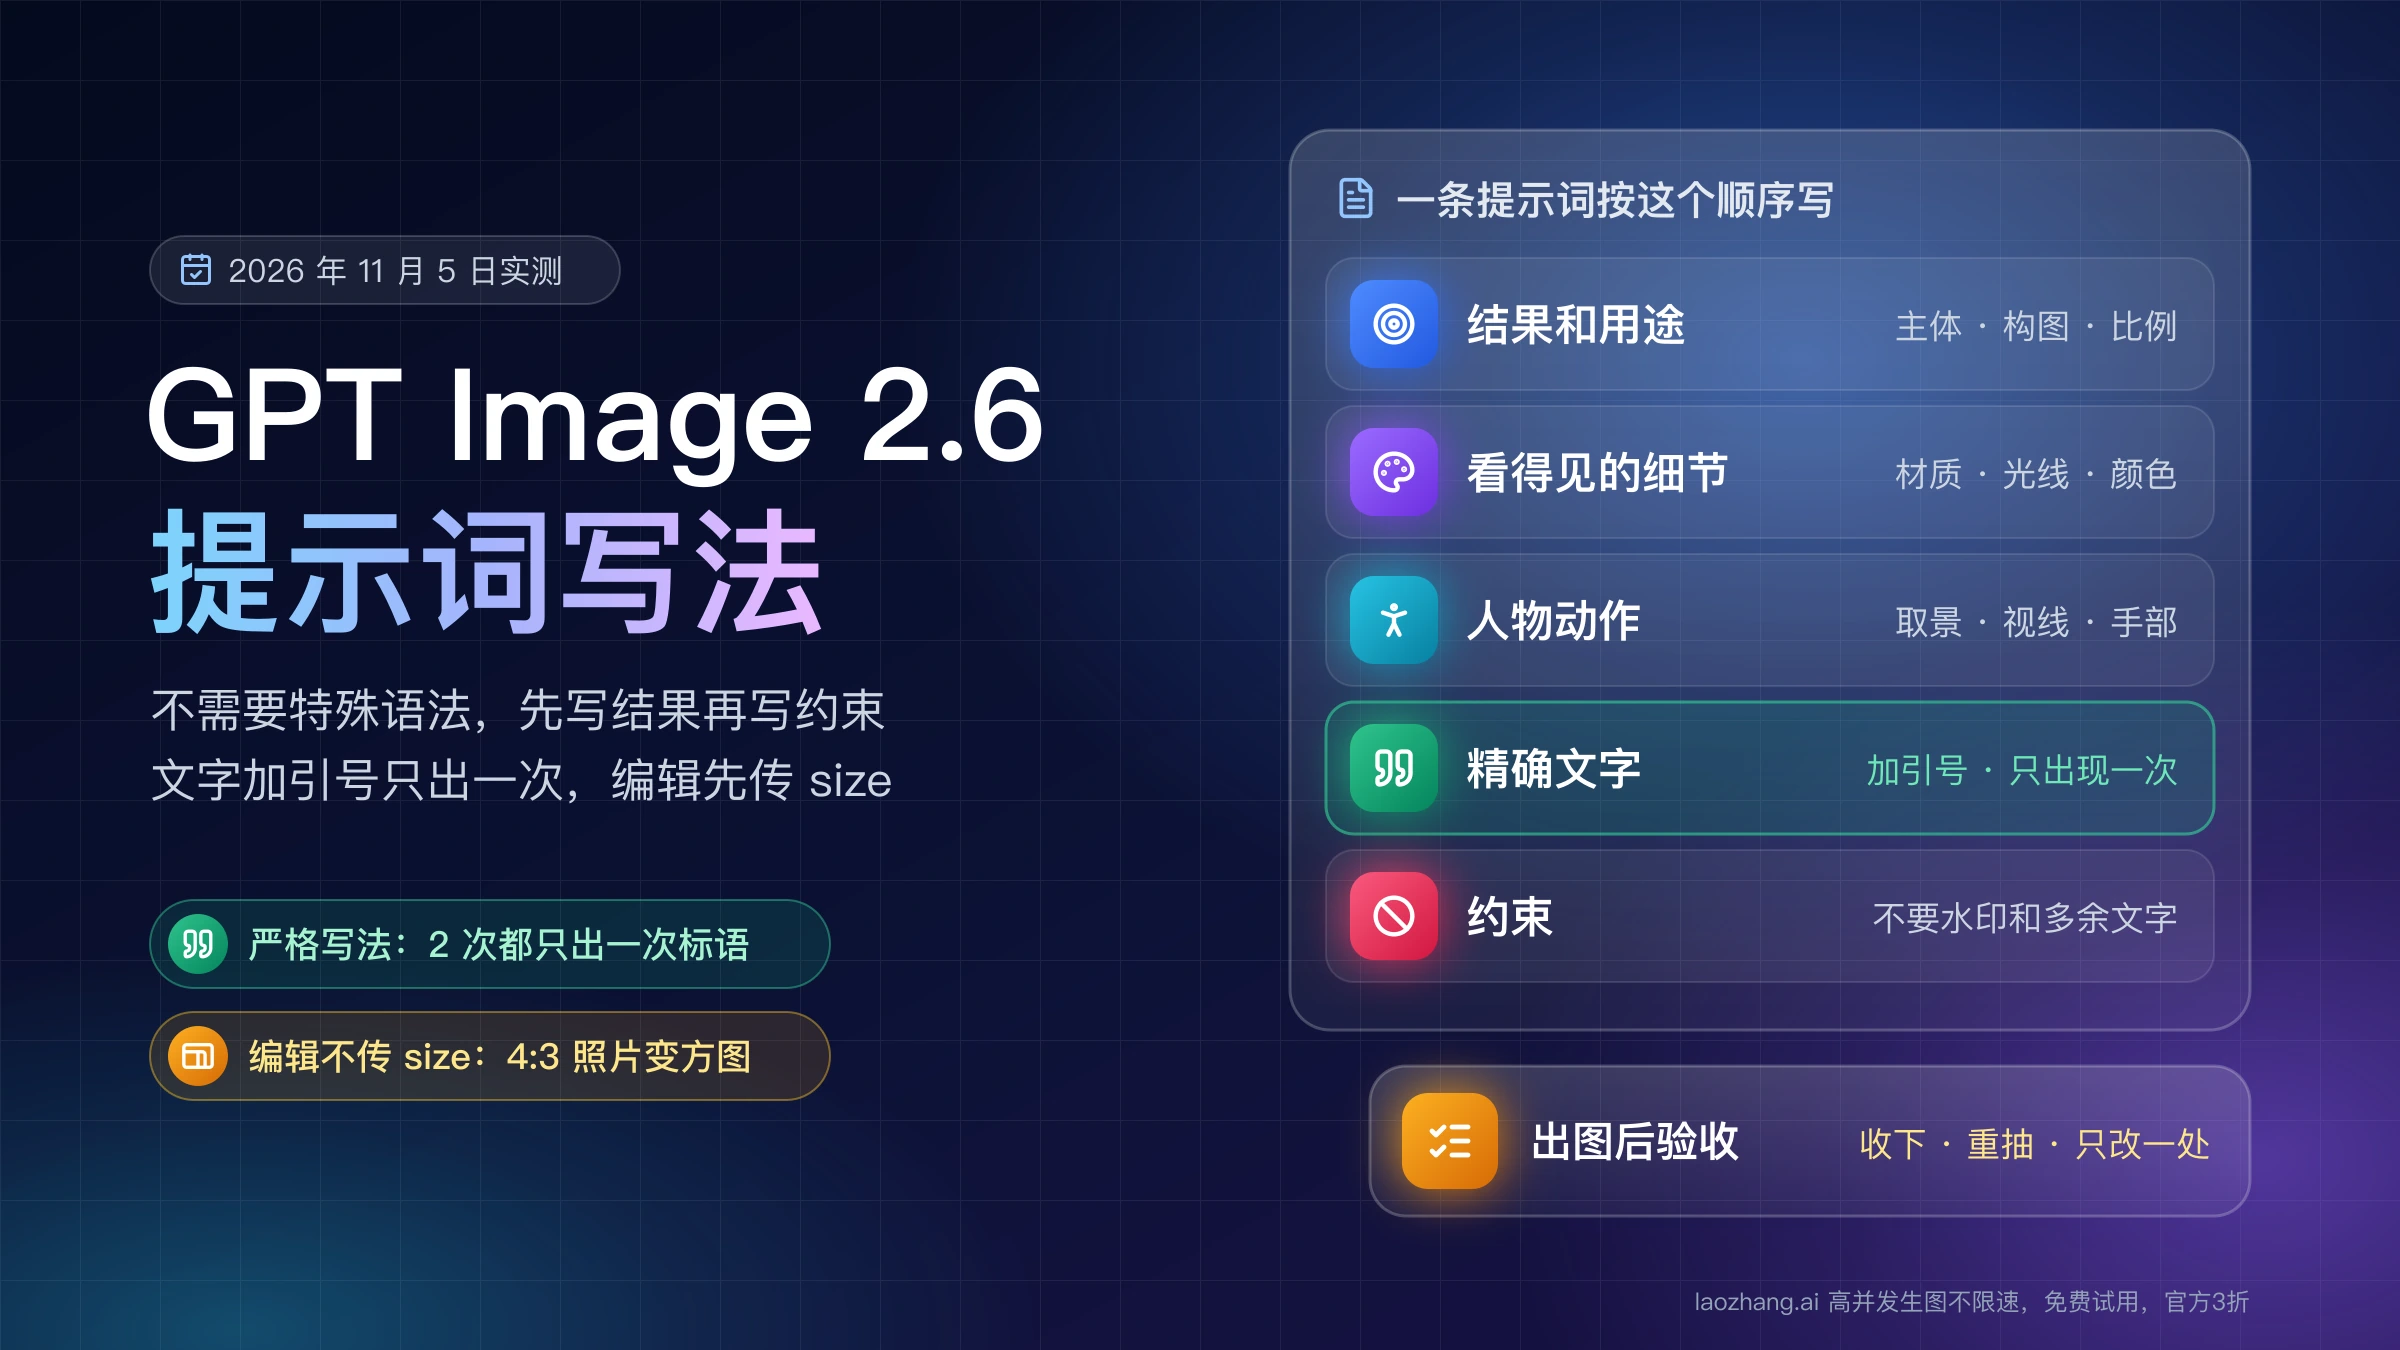
GPT Image 2.6 没有专用的提示词语法。OpenAI 在 2026 年 11 月 4 日随模型发布的 GPT Image 2.6 提示词指南(Image prompting)给出的方法是:先说这张图做什么用,再写清画面和构图、看得见的细节、人物的动作、必须一字不差的文字,最后写不能出现的东西。短句、段落、类 JSON 结构都可以,选一种你以后好改的格式就行;编辑已有图片时,写"只改 X",再列出要保留的内容。
真正决定能不能一次出对的,是几处容易省掉的细节。2026 年 11 月 5 日用 LaoZhang API 的 gpt-image-2.6-flare-vip 做了对照:把标语放进引号、写明"只出现一次"和"不要其他文字"的提示词,2 次出图都只有这一句标语;随口描述的版本 2 次都自己加了 "WEAR IT. MAKE IT YOURS." 这类没要求的文案。编辑时请求里要带一个和原图同比例的 size,比如 1200×900 的照片传 1536x1152,否则同一天的测试里,按次计费的 Sunburst 模型把照片重新构图成了方图。比较效果时固定 quality 和 size,一次只改一处。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
也有写对了也不保证的地方:按 OpenAI 写法写的循环动图,首尾仍有明显跳帧;按次计费的模型上,markup 圈选没有起作用。所以出图后按文末的验收清单逐项看,再决定收下、重抽,还是只改一处再试。
一条 GPT Image 2.6 提示词按这个顺序写
一条好用的提示词先写结果,再写细节,最后写约束。OpenAI 指南里的八条基本原则,落到一条生成请求上就是下面五步;顺序本身不影响模型,但按这个顺序写,你最不容易漏掉会导致重抽的那一项。
- 先写结果和用途:主体是什么、拿去做什么(产品图、广告、图解、海报),构图怎么排,画面比例是多少,哪些东西必须放在哪个位置。
- 再写看得见的细节,包括材质、光线、颜色、画面媒介(照片、扁平插画、剪纸)。要照片效果就直接写 "photorealistic" 或 "real photograph";广角、电影感、夜景、雨景、霓虹这类画面,写清尺度、空气感和颜色,只写"氛围感"之类的情绪词不够。
- 画面里有人物,就写动作:取景到哪里、人和物的比例、视线方向、手怎么和物体接触,例如 "full body visible, feet included"(全身入镜、脚也要在画面里)、"looking down at the open book"。
- 有必须出现的文字,就把它放进引号,说明位置和字体风格;生僻词或品牌名可以逐个字母拼出来;最后写一句不要其他文字。下一节专门讲这一步。
- 收尾写约束:不要水印、不要无关 logo、不要多余文字;编辑时还要列出必须保持不变的东西。
需求复杂时,OpenAI 建议把提示词分成场景、主体、细节、约束几段并加上标签,这样改其中一项时不用重写整条。下面是按这个结构写的一个例子,测试用的提示词都是英文,所以这里也用英文写,要出现在图里的中文直接放进引号:
Scene: A small coffee shop counter in the morning, warm side light from a window.
Subject: A poster for the shop's opening day, vertical 2:3, centered composition.
Details: Flat illustration, cream background, brown and orange palette,
  a latte cup and coffee beans in the lower half.
Text: The headline "欢迎光临" exactly once, top center, bold rounded lettering.
Constraints: No other text, no watermark, no unrelated logos.写完以后,size 和 quality 不要靠提示词表达:比例写在 size 里(这个例子是 1024x1536),细节档位写在 quality 里。提示词只负责描述画面本身。
让文字一字不差:引号、"只出现一次"、"不要其他文字"
要让图里的文字一字不差、也不多出别的字,提示词里要同时做三件事:把要出现的文字放进引号,写明它出现几次,再写一句不要其他文字。OpenAI 指南里的街头服装广告示例就是这样写的,2026 年 11 月 5 日在 gpt-image-2.6-flare-vip 上(1024x1536,quality 为 medium)把它和一条随口描述的版本各跑了 2 次,结果差别很清楚。
严格版按 OpenAI 的示例改短,去掉了中间两句风格描述,保留了引号和两条文字约束:
Give me a cool in culture ad / fashion shot for a brand called Thread. It's a hip young street brand. The ad shows a group of friends hanging out together with the tagline "Yours to Create." Render the tagline exactly once, clearly and legibly, integrated into the ad layout. No extra text, no watermarks, no unrelated logos.宽松版只描述了同一件事:
A cool fashion ad for a street brand called Thread, a group of friends hanging out, slogan yours to create严格版 2 次出图,"Yours to Create." 都只出现一次,除了衣服上小小的品牌名 "Thread",没有其他文字,每张耗时 29–49 秒。宽松版 2 次都加了没要求的文案:第一张有 "Thread ™ / STREETWEAR"、"YOURS TO CREATE"、"THREAD STREETWEAR EST. 2019" 和 "WEAR IT. MAKE IT YOURS.";第二张有 "Thread STREETWEAR"、"YOURS TO CREATE"、"WEAR IT / STYLE IT / MAKE IT YOURS" 和 "THREAD.CO"。注意宽松版里标语没有引号,模型还把它改成了全大写、去掉了句号。
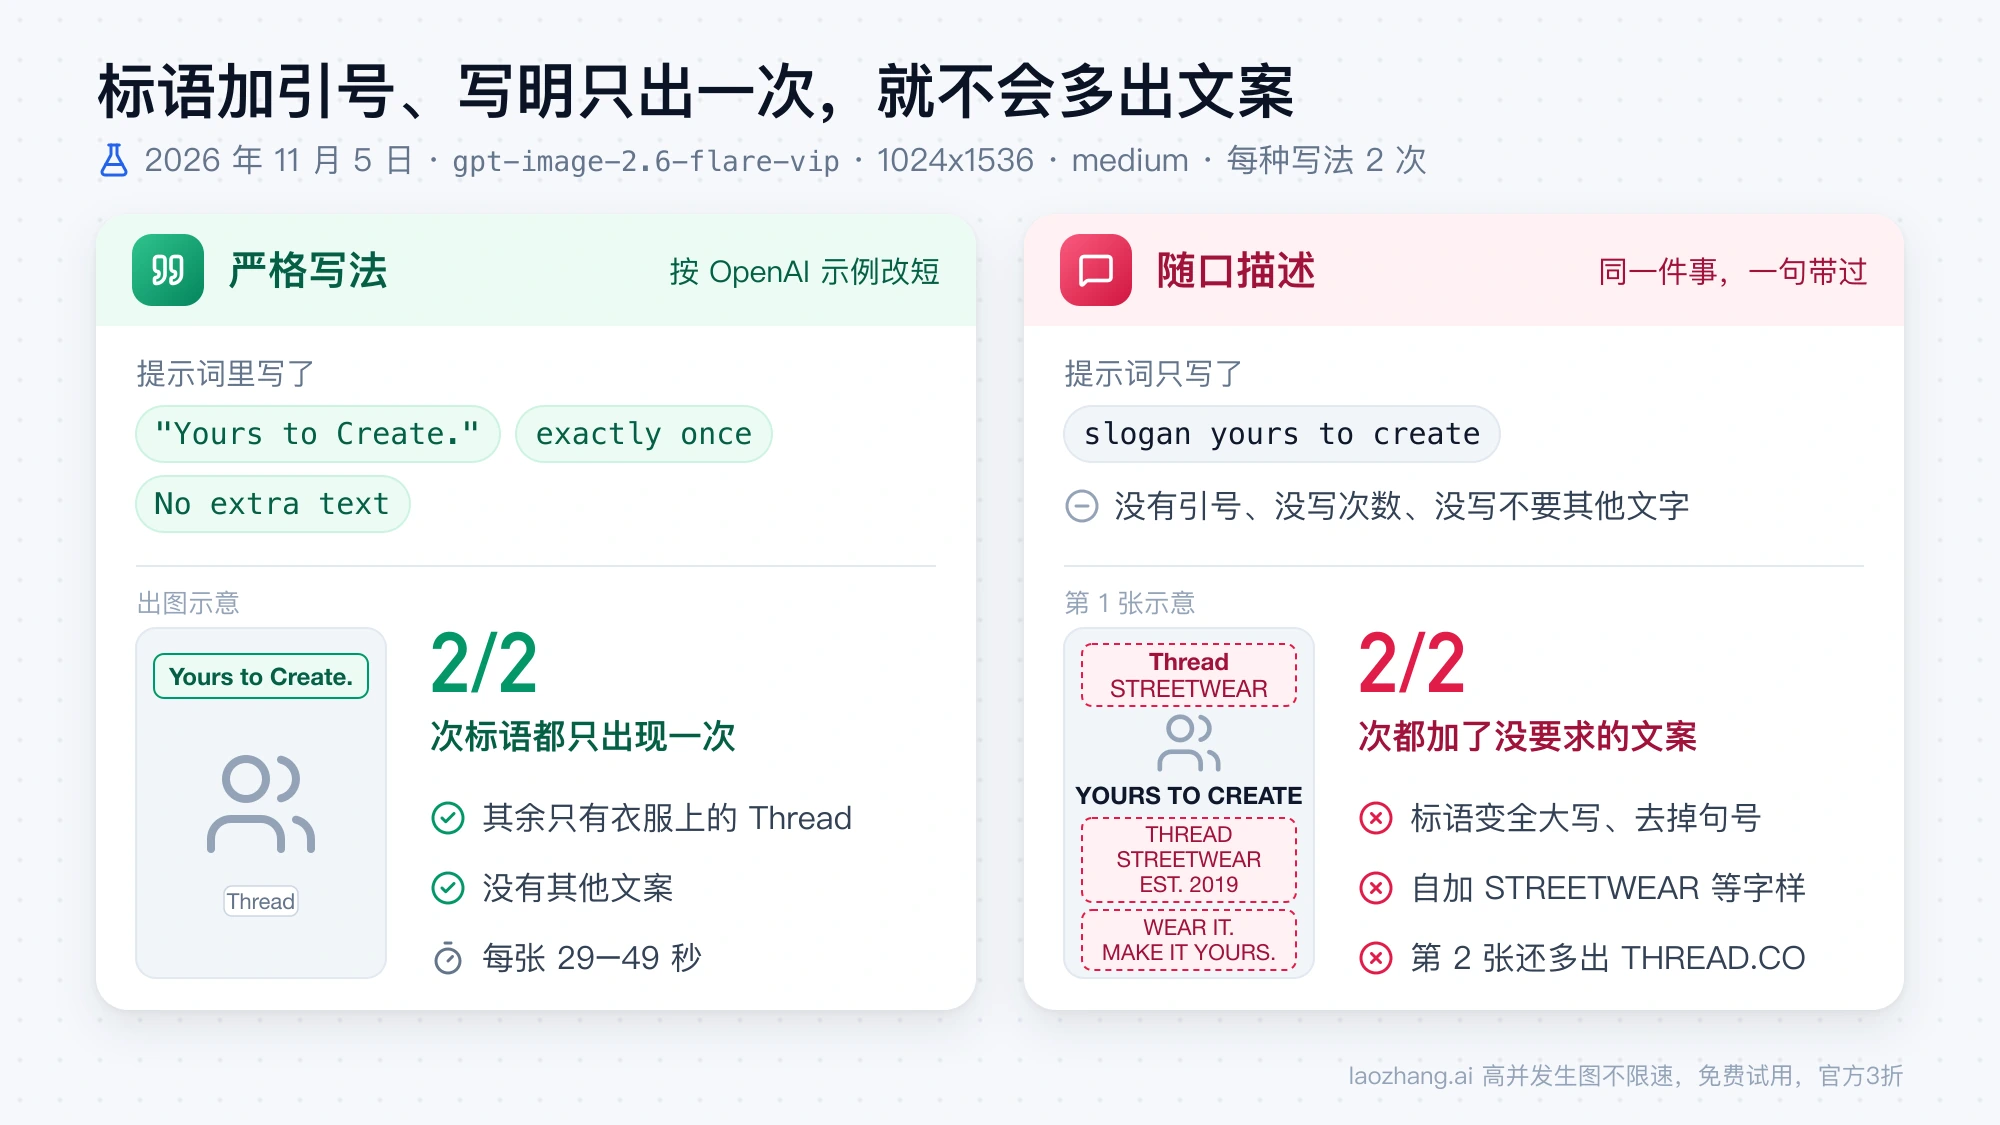
每种写法只跑了 2 次,这能说明这几条规则起了作用,不能当成功率看。另外两条规则没有在这次对照里单独测:小字、密集信息或多种字体同时出现时,OpenAI 建议在 medium 和 high 之间比较 quality;品牌名拼写特殊时,把它逐个字母写出来。
中文字能写对吗:五种文字的牌子一次全对,限于短语
短中文可以写对。2026 年 11 月 5 日在 gpt-image-2.6-flare-vip 上(1536x1024,quality 为 high)让模型画一面挂着五块牌子的墙,提示词要求每块牌子只写指定的文字:"欢迎光临"、"いらっしゃいませ"、"어서 오세요"、"Добро пожаловать"、"Bienvenidos",并且不要其他文字。一次出图,耗时 43.6 秒,五块牌子逐字正确,画面里没有多余文字。
A clean travel poster for a coffee shop. Show five small signs on a wall, each with exactly this text and nothing else: "欢迎光临" , "いらっしゃいませ" , "어서 오세요" , "Добро пожаловать" , "Bienvenidos". Flat illustration, warm colors, no other text.这个结果的边界要看清楚:只跑了一次,每块牌子都是四到十几个字符的短语,字号也大。它说明把中文放进引号、写明"exactly this text and nothing else"是可行的写法,不能推到整段中文、表格里的小字或密集排版上。这类图出完后要逐字核对,看不清时先在同一个 complexity 下把 quality 调高再比较。
quality、complexity、size 各管什么,对比时固定哪个
这三个参数各管一件事:quality 管画面能渲染多少细节,complexity 管模型出图前规划多少,size 管输出尺寸。比较提示词时,三个都要固定;要调参数时,一次只动一个。按 OpenAI 的参数说明,它们的区别如下:
| 参数 | 管什么 | 什么时候改 | 对比时怎么固定 |
|---|---|---|---|
quality | 能渲染多少视觉细节,比如纹理和小字;可选 auto、low、medium、high、xhigh、max | 布局已经对了,但小字看不清 | 每次请求都显式传;比较 complexity 时保持不变 |
complexity | 出图前规划多少,不是"画面有多复杂";可选 low、medium、high,不传时 Flare 和 Sunburst 都用 high | 提示词留了很多设计空间时用 high;只改一处的编辑从 low 开始 | 第一次对比保持默认;调它时 quality 不动 |
size | 输出像素尺寸;auto 或 1024x1024、1536x1024、1024x1536 等;自定义时两边都是 16 的倍数,比例在 1:3 到 3:1 之间 | 换用途、换比例时;编辑时按原图比例设 | 整组对比用同一个值,否则构图差异可能只是尺寸造成的 |
quality 一定要写。LaoZhang API 文档团队直连 OpenAI 的测试里,Flare 不传 quality 时会按提示词自己选档位,一条详细提示词出一张 1024 图用了约 5,800 个输出 token,3 次结果一致;同一份测试里另一条提示词在 high 档约用 1,756 个。不写这个参数,你既控制不了成本,也没法和别的结果公平比较。Sunburst 不传时默认 high。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
complexity 的作用要按 OpenAI 的说法理解。OpenAI 用同一条剪纸风足球庆祝提示词在 Sunburst 上各跑一次:low 给奖杯加了皇冠、medium 换成月桂花环并给球衣加了队徽,这两档都把大横幅放在球员前面;high 把 "CHAMPIONS" 牌子挪到了看台上,前景留给球员。提示词已经把版式、文字、风格都写死时,档位之间可能看不出差别;OpenAI 图片生成指南也提醒,更高的 complexity 会增加耗时,还可能带来你不想要的改动。调这个参数不单独收费。2026 年 11 月 5 日在 gpt-image-2.6-flare-vip 上用同一条剪纸提示词试了 low 和 high,两个值都被接受、没有报错,两张图也不同(low 的横幅在奖杯上方、球衣带号码,high 的横幅横在前景),但每档只有一张,分不清差别来自 complexity 还是两次出图本来的随机差异。
局部编辑怎么写,才不会整张图都变
局部编辑要同时管住两件事:请求里的输出尺寸,和提示词里"改什么、留什么"的边界。前者决定画面会不会被重新构图,后者决定模型改到哪里为止。按下面的顺序准备一次编辑请求:
- 按原图比例算出
size,宽和高都取 16 的倍数,比例和原图一致。1200×900 的照片是 4:3,可以传1536x1152(1536 = 16 × 96,1152 = 16 × 72,1536:1152 = 4:3)。 - 在提示词开头写"只改 X",点名要改的对象和改成什么样,例如 "Change only the striped vase on the dining table to solid cobalt blue ceramic."
- 接着列出要保留的东西:身份、形状、布局、光线、机位、颜色、文字标签,凡是不能动的都写出来;精细的局部编辑还要写饱和度、对比度和周围物体保持不变。
- 写上排除项,例如 "No new objects, no text",不要新加物体、文字、logo 或水印。
- 把
complexity设为low。OpenAI 在 Images 2.6 发布文章里建议大多数编辑用low,元素多、约束多的画面再试medium或high。 - 出图后对照原图检查:除了要改的地方,逐项看保留清单里的东西有没有变;连续多轮编辑时,每一步和最后一张都要看。如果某部分必须和原图像素级一致,把通过检查的改动合成回原图,不要指望模型原样保留。
用来测试的严格版编辑提示词是这样写的,可以照着换成你自己的对象:
Change only the striped vase on the dining table to solid cobalt blue ceramic. Keep its shape and the dried stems. Keep everything else exactly the same: the table, chairs, lighting, window, cabinets, camera angle and colors. No new objects, no text.想用画圈的方式指定改哪里,要用编辑请求的 markup 参数:一张和第一张输入图像素尺寸相同的透明 PNG 叠加层。2026 年 11 月 5 日在按次计费的 gpt-image-2.6-web 和 gpt-image-2.6-sunburst-vip 上,提示词只说"把红圈里的椅子改成芥末黄",四次请求(每个模型有无叠加层各一次)被圈的那把椅子一次都没变色,所以 markup 要走 OpenAI 官方转发的 gpt-image-2.6-flare / gpt-image-2.6-sunburst。叠加层怎么画、怎么传,见 GPT Image 2.6 API 用 markup 叠加层编辑图片;在 ChatGPT 应用里用 Markup 按钮是另一回事,见 ChatGPT 图片编辑怎么用:按钮会重新生成整张图,只改一处这样做。
编辑后变成 2048×2048 方图:请求里没传 size
编辑结果变成方图、整个画面被重新构图,原因多半是请求里没传 size。2026 年 11 月 5 日用 OpenAI 指南里那张 1200×900 的厨房照片测试,LaoZhang API 上的 gpt-image-2.6-sunburst-vip 在不传 size 时,每一次编辑都返回 2048×2048,4:3 的房间被重新排进了正方形;同一张图传 size: "1536x1152" 后,输出是 1536×1152,保持了 4:3。gpt-image-2.6-web 不传 size 时返回 1448×1086,和 OpenAI 指南里这张照片的示例输出尺寸相同。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
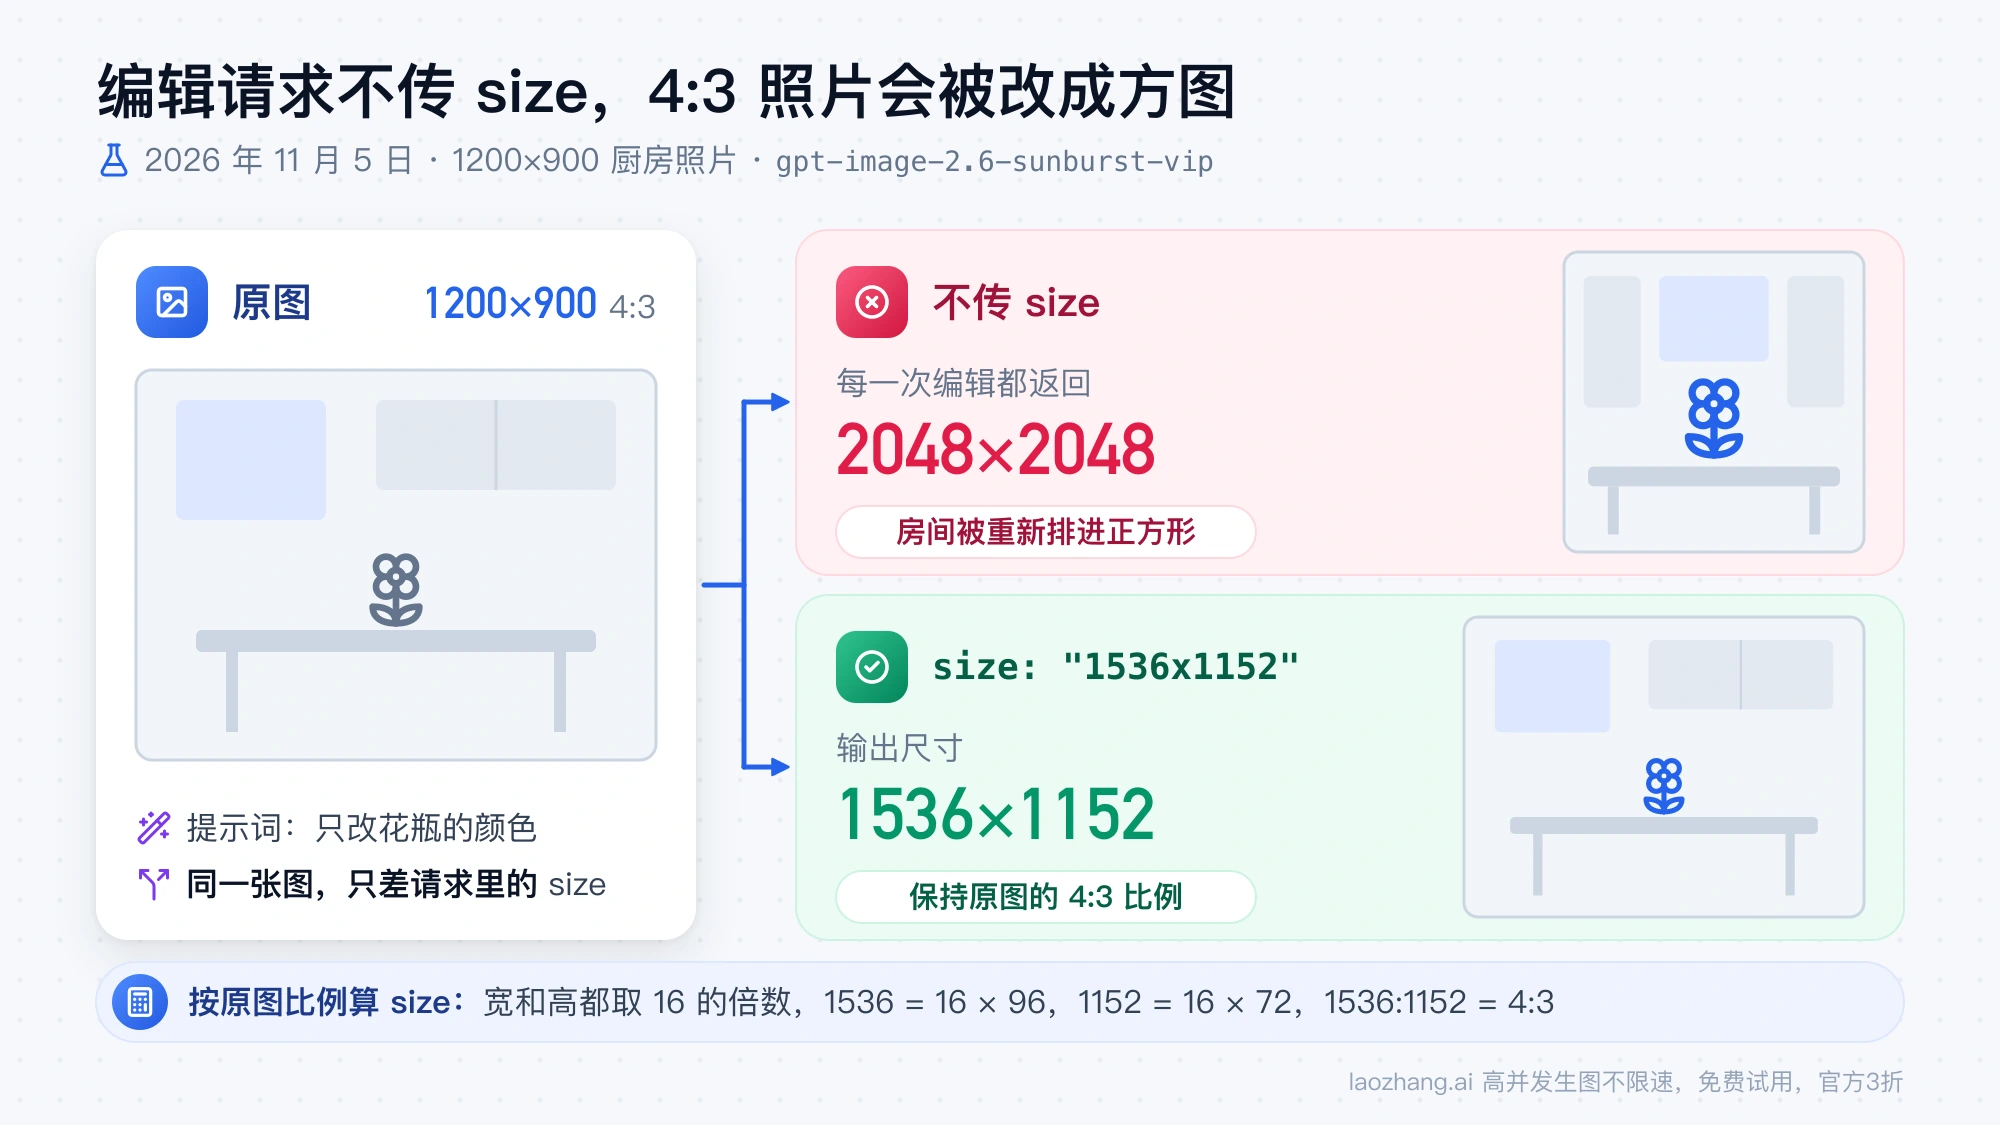
这组测试里还对比了严格版和一句 "Make the vase blue." 的模糊版,各跑一次,两条都把花瓶改成了蓝色。但两次都没传 size,整个房间都被重新构图,所以这次看不出"只改花瓶"的写法比模糊写法多保住了什么,能确定的结论只有一条:编辑请求先把 size 设对,再谈提示词写法。换别的模型或别的平台时,同样先用一张图看返回尺寸是否和原图比例一致。
参考图怎么分工:按编号说清每张图负责什么
传多张参考图时,按顺序给每张图编号,并说明它负责什么:主体、风格、服装还是背景,再写清它们怎么组合、哪个元素要移到哪里。OpenAI 指南里合成照片的示例把街景作为第 1 张、带狗的照片作为第 2 张,提示词是 "Place the dog from the second image into the setting of image 1, right next to the woman, use the same style of lighting, composition and background. Do not change anything else."
这句话里有三样东西缺一不可:从哪张图取什么(第 2 张的狗),放到哪张图的什么位置(第 1 张、女士旁边),以及其余部分保持不变。只写"把这两张图合在一起",模型就得自己决定谁是主体、谁是背景,结果很难复现。这条写法没有在 2026 年 11 月 5 日的测试里单独验证,依据是 OpenAI 指南里的示例;用它时,按下文的验收清单检查人物身份和参考细节有没有保留下来。
循环 GIF 提示词:写回到起始姿势,接缝还要自己看
想让动图首尾接得上,OpenAI 的建议是给主体一个起始姿势,让动作最后回到这个姿势,并写明镜头动不动。它的示例写的是:小猴子提着灯笼,慢慢举起、抬头眨眼,再放回 "its starting pose","Keep the lantern in its hands and the camera still. Make the motion loop smoothly."
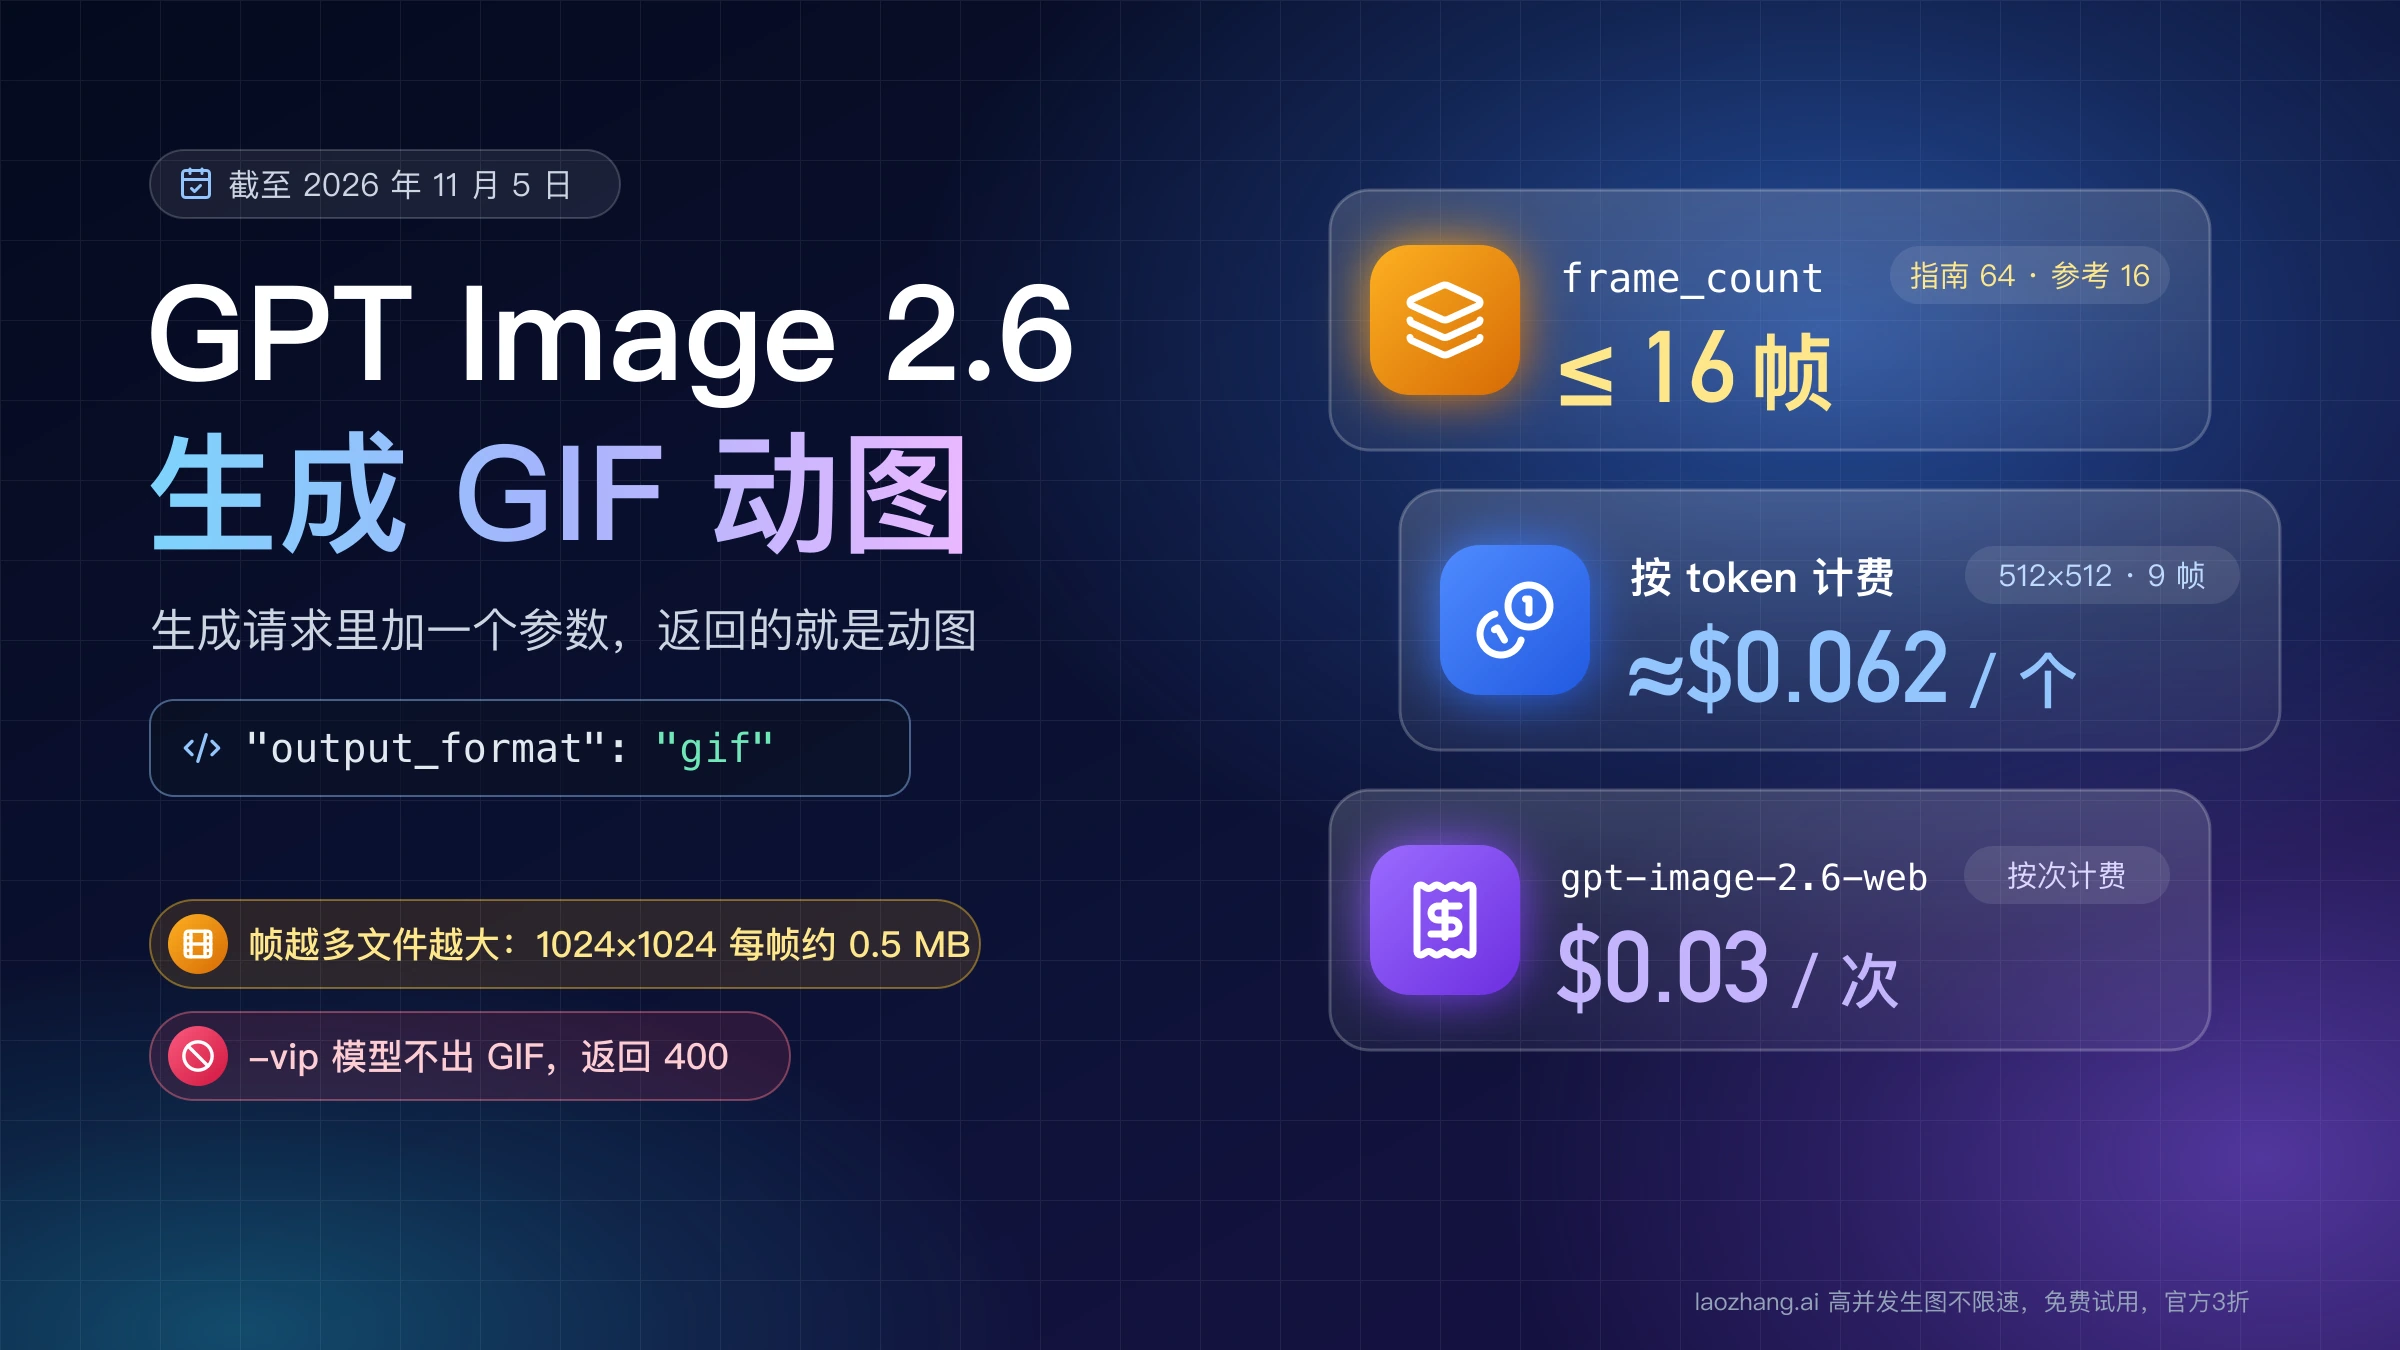
这种写法能把动作描述清楚,但不保证接缝干净。2026 年 11 月 5 日在 gpt-image-2.6-web 上(1024×1024,9 帧,每帧 200 毫秒)用 OpenAI 这条原句出了一张 GIF,最后一帧回到第一帧的画面变化是相邻帧平均变化的 1.38 倍,大于 1 就意味着回跳比正常的一步还大,肉眼能看到灯笼和姿势在跳;只写 "A cute monkey with a lantern in the snow, animated." 的模糊版反而是 1.08 倍。同一条 OpenAI 原句改成 4 帧和 16 帧时,这个比值是 0.72 和 0.93。每种设置只有一个样本,结论只能是:起始姿势这句话该写,但出图后要逐帧看首尾,跳得明显就重抽。
GIF 的请求参数、帧数和费用见 GPT Image 2.6 API 生成 GIF:参数、上限与成本;不写代码、只在 ChatGPT 里做动图,看 ChatGPT 生成 GIF 动图怎么做:帧越多画面越小,调速度不会重画。
SVG Logo 提示词:简单形状、扁平、不要渐变
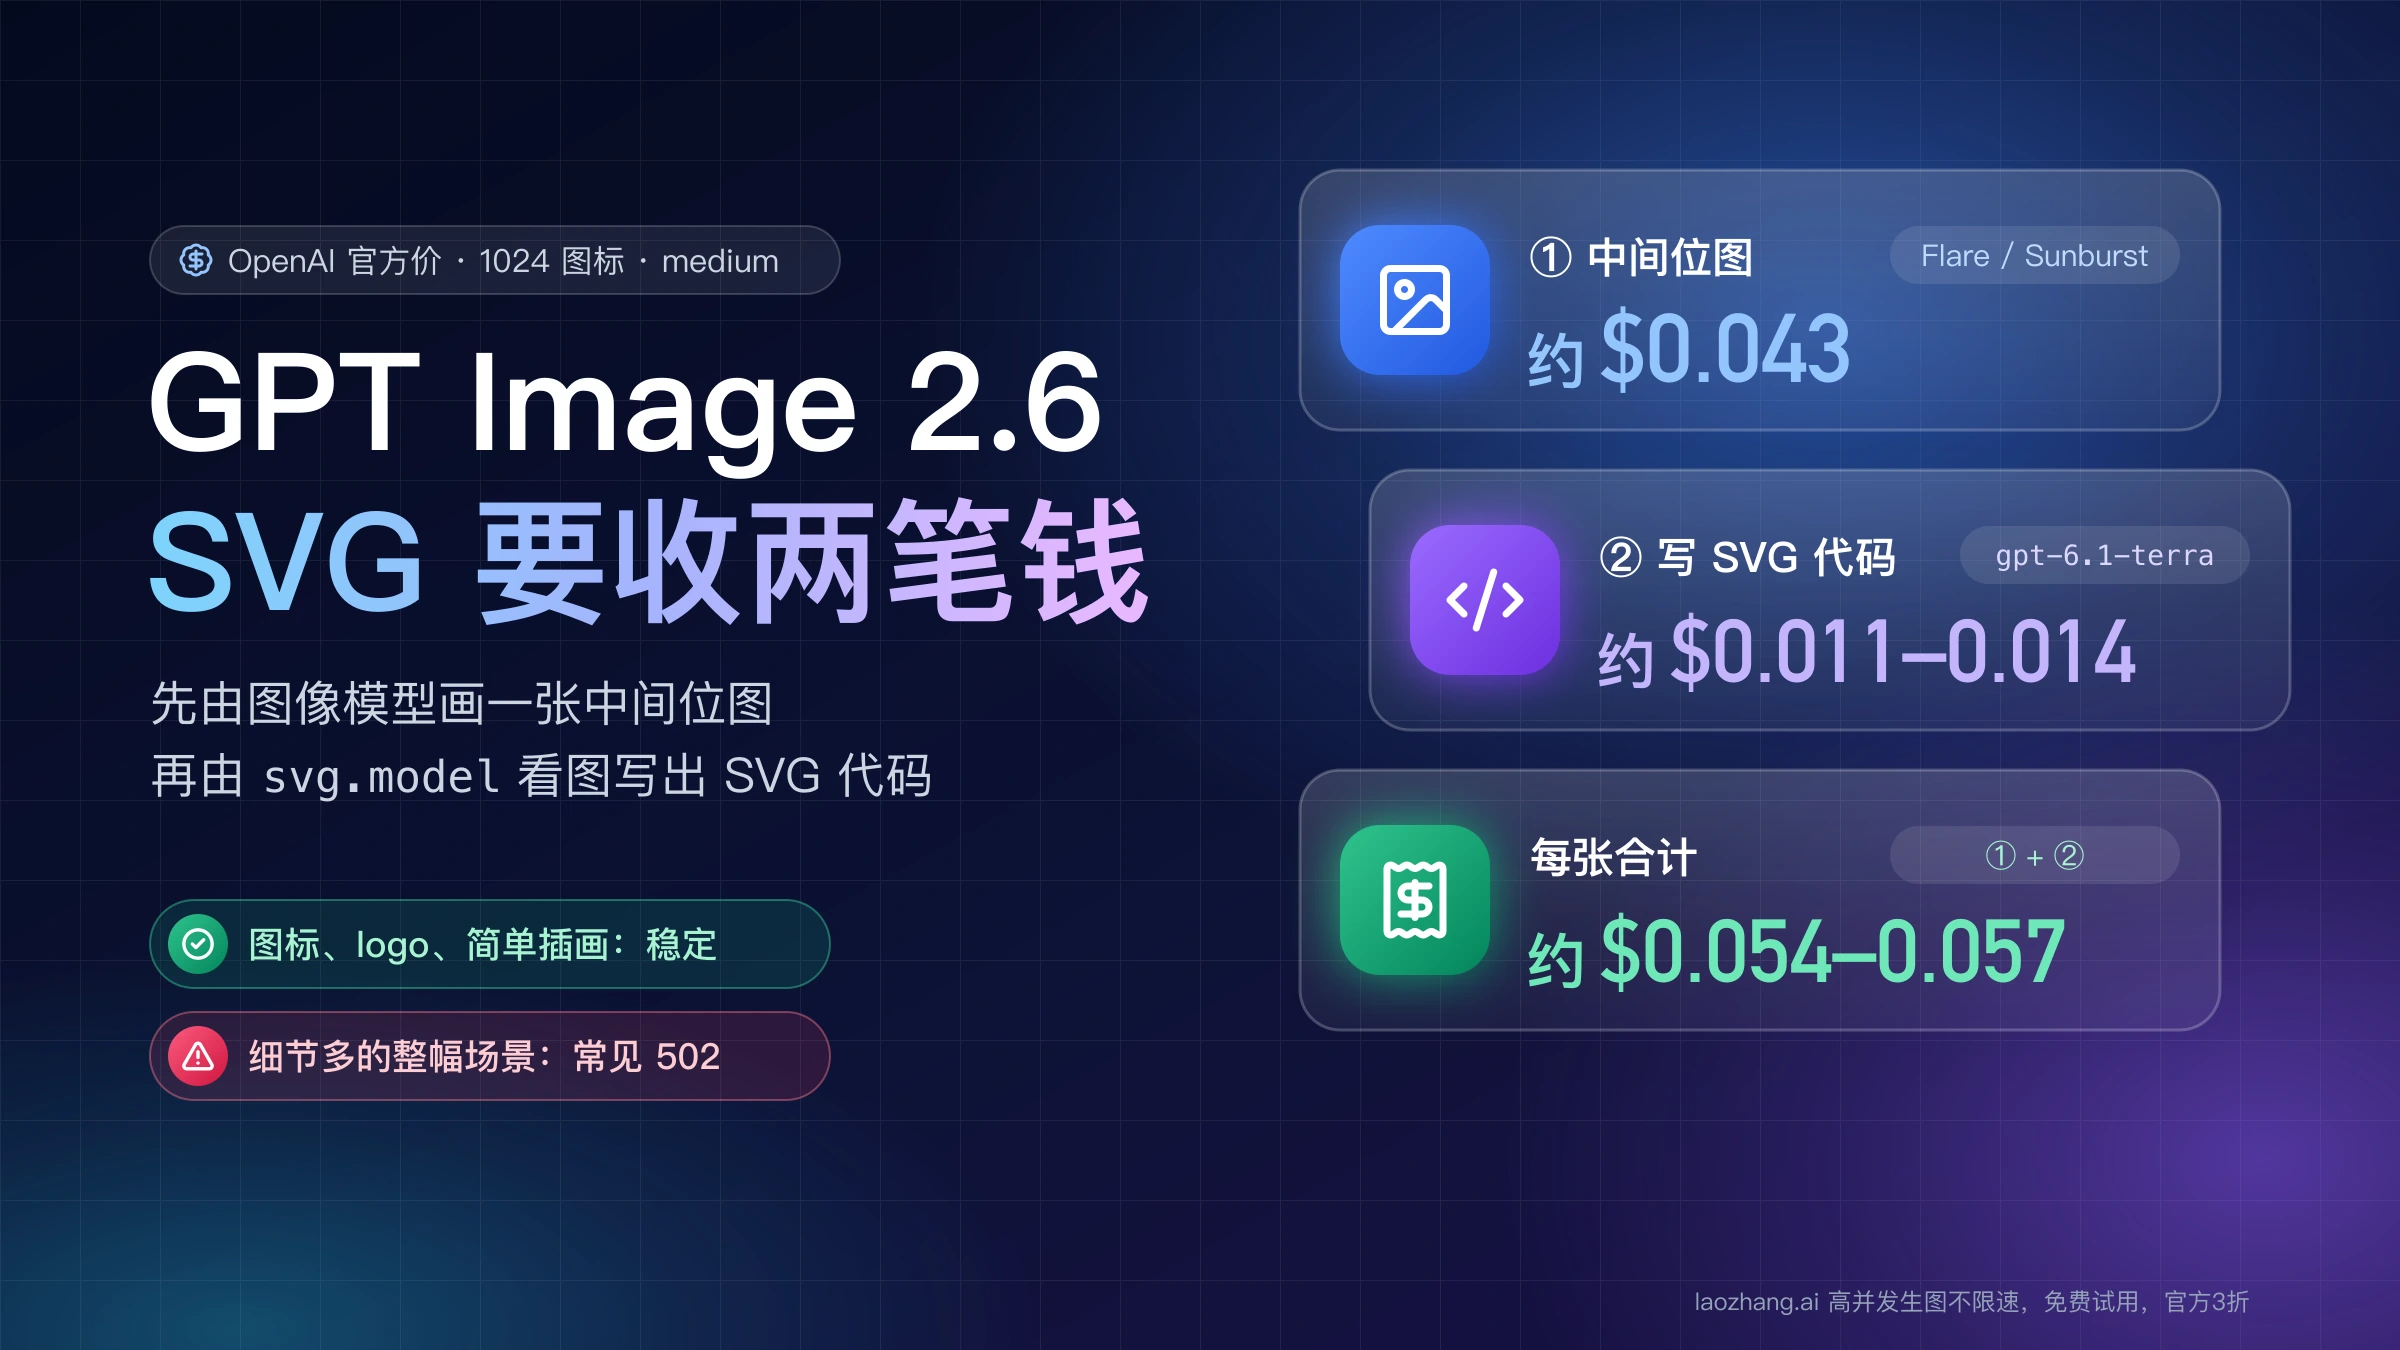
要模型直接输出可缩放、可改色的 SVG Logo,提示词要往简单的方向写:说出品牌名和定义这个标志的形状,要求干净的矢量感形状、清晰的轮廓和均衡的留白,扁平设计、少描边、非必要不用渐变,再要求透明背景、单个居中的 Logo、四周留足边距,不要背景、场景、棋盘格或水印。OpenAI 的面包店 Logo 示例就是这样写的,并强调要"简单优先于细节",这样在小标签和大招牌上都认得出。
这种写法适合图标、Logo 和简单图形。LaoZhang API 文档团队直连 OpenAI 测试时,简单图标和 Logo 能正常出 SVG,细节很多的整幅场景大多失败,等两三分钟后返回 OpenAI 的 502。所以想要一张完整插画时,先出 PNG,不要指望 SVG。请求里要设 output_format="svg" 和 n=1,按次计费的 -vip、-web 模型不支持 SVG;具体请求怎么写、怎么计费、拿到文件后检查什么,见 GPT Image 2.6 API 输出 SVG:svg.model、成本与文件检查。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
用 Flare 还是 Sunburst 试提示词
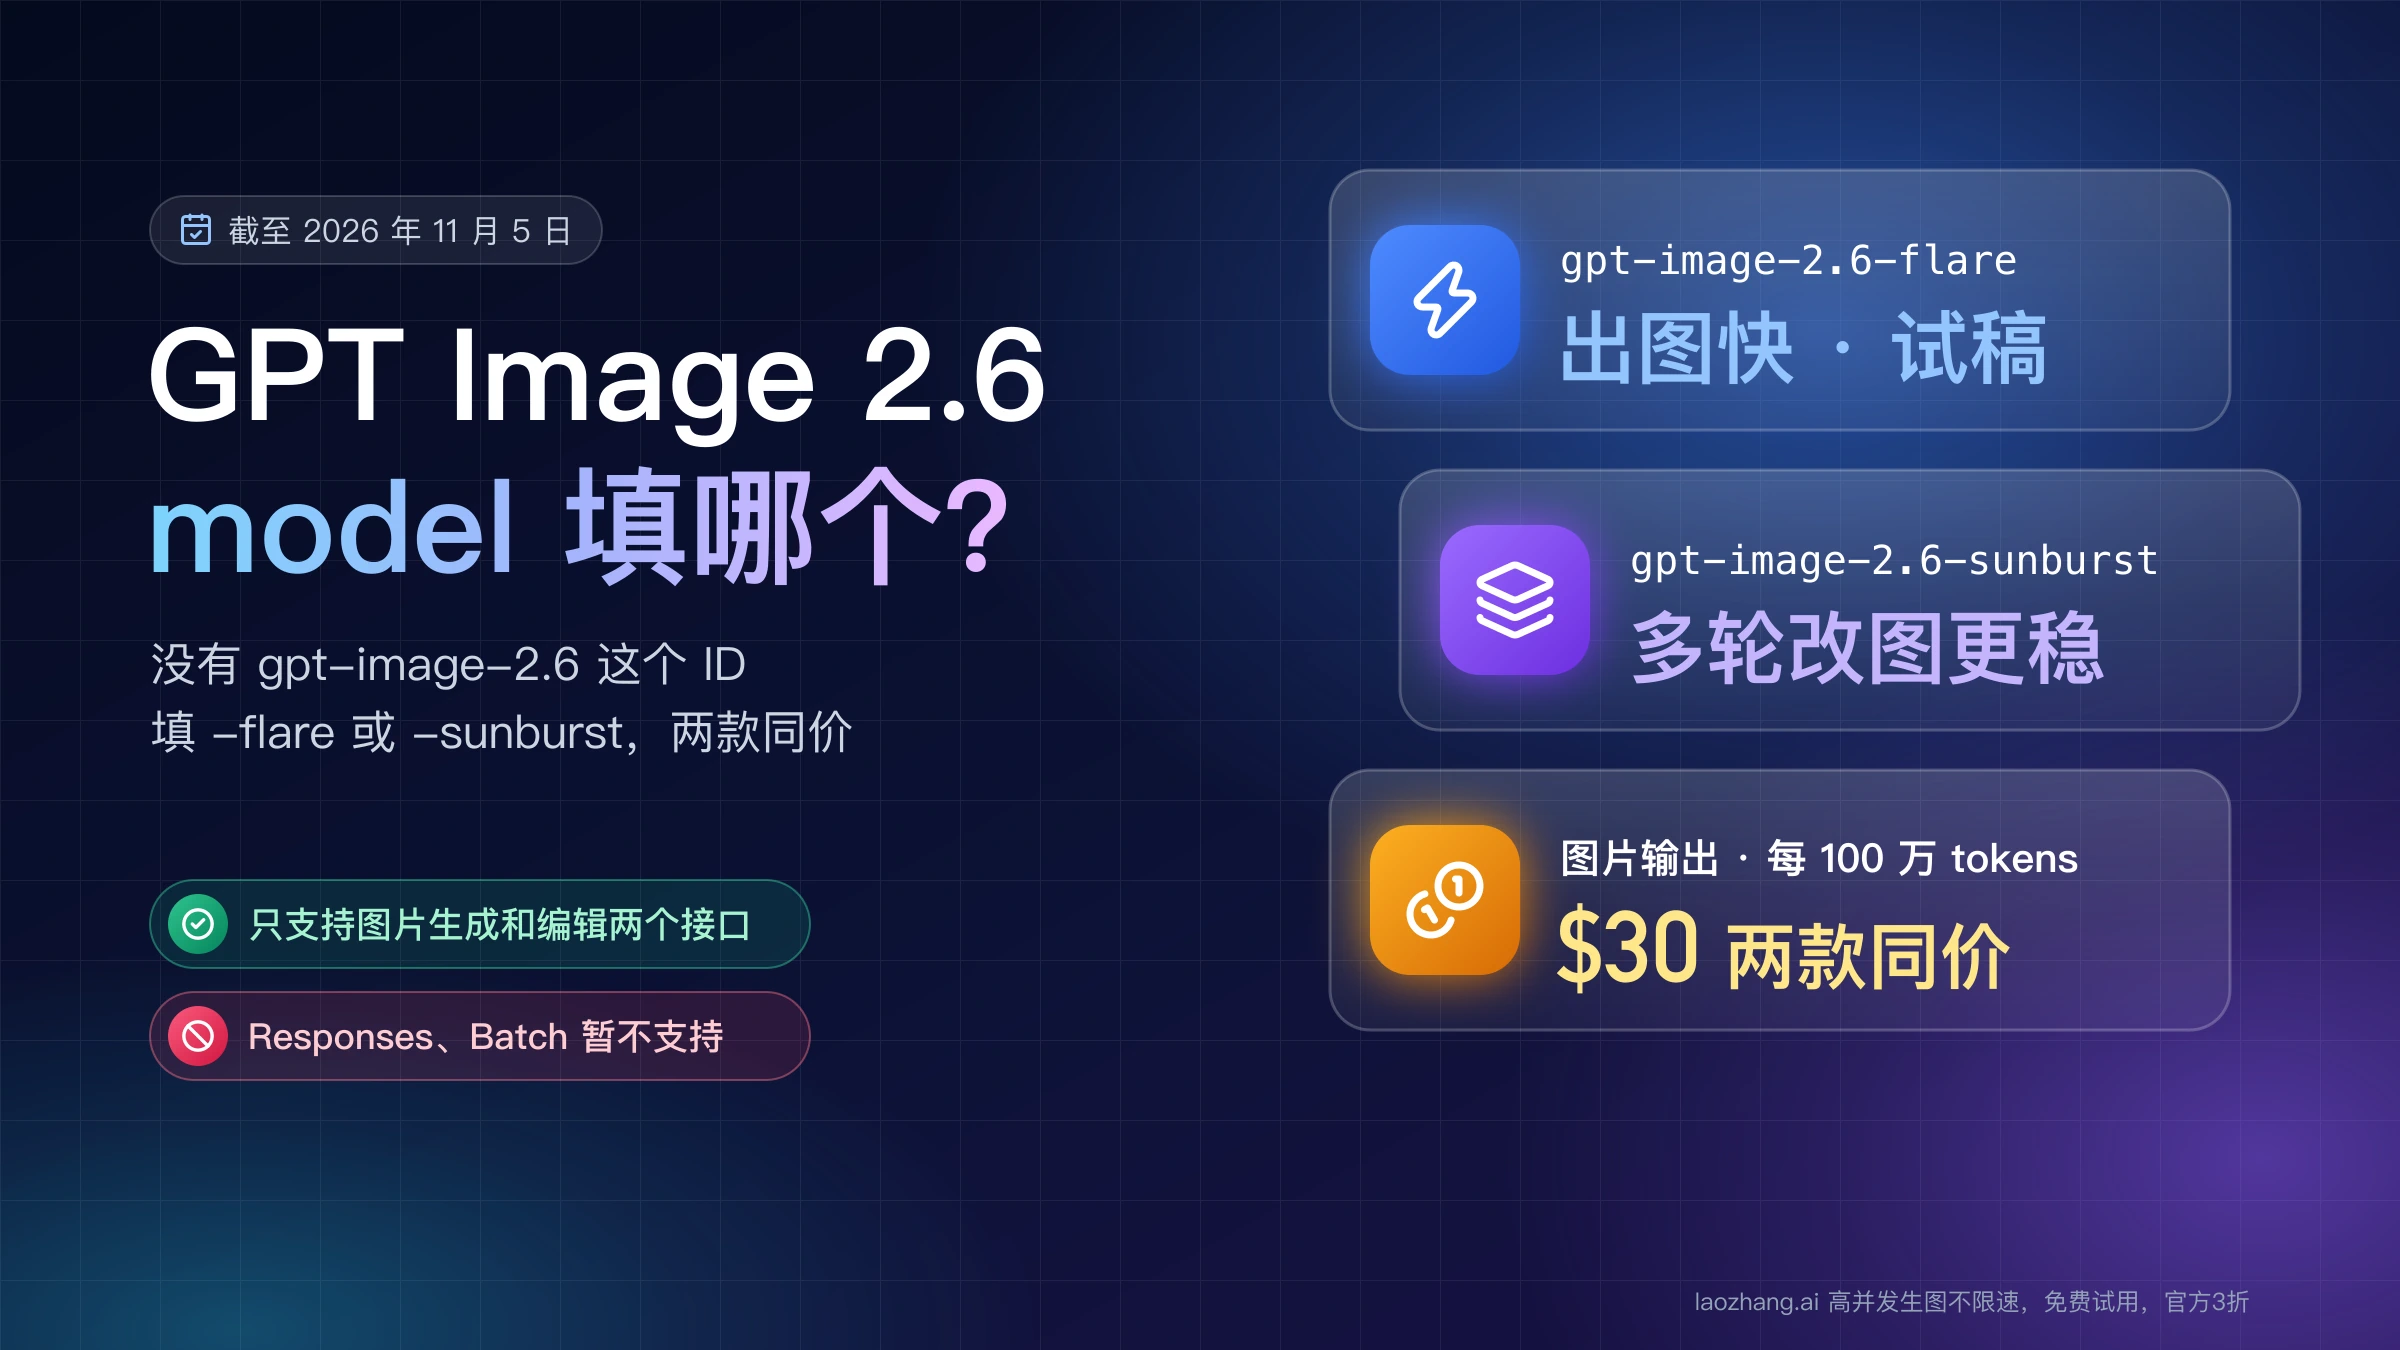
先看你更在乎哪一项:响应速度最重要,从 gpt-image-2.6-flare 开始;对细节、版式或编辑准确度要求高,从 gpt-image-2.6-sunburst 开始。从旧模型迁移时,OpenAI 的建议是:原来用 GPT Image 2 且质量够用、或者用 2.5 Flare 的,先测 2.6 Flare;GPT Image 2 在复杂任务上不够用、或者原来用 2.5 Sunburst 的,先测 2.6 Sunburst。Sunburst 达标后,再用完全相同的提示词、参考图、尺寸和 quality 试一次 Flare,比较结果和耗时。
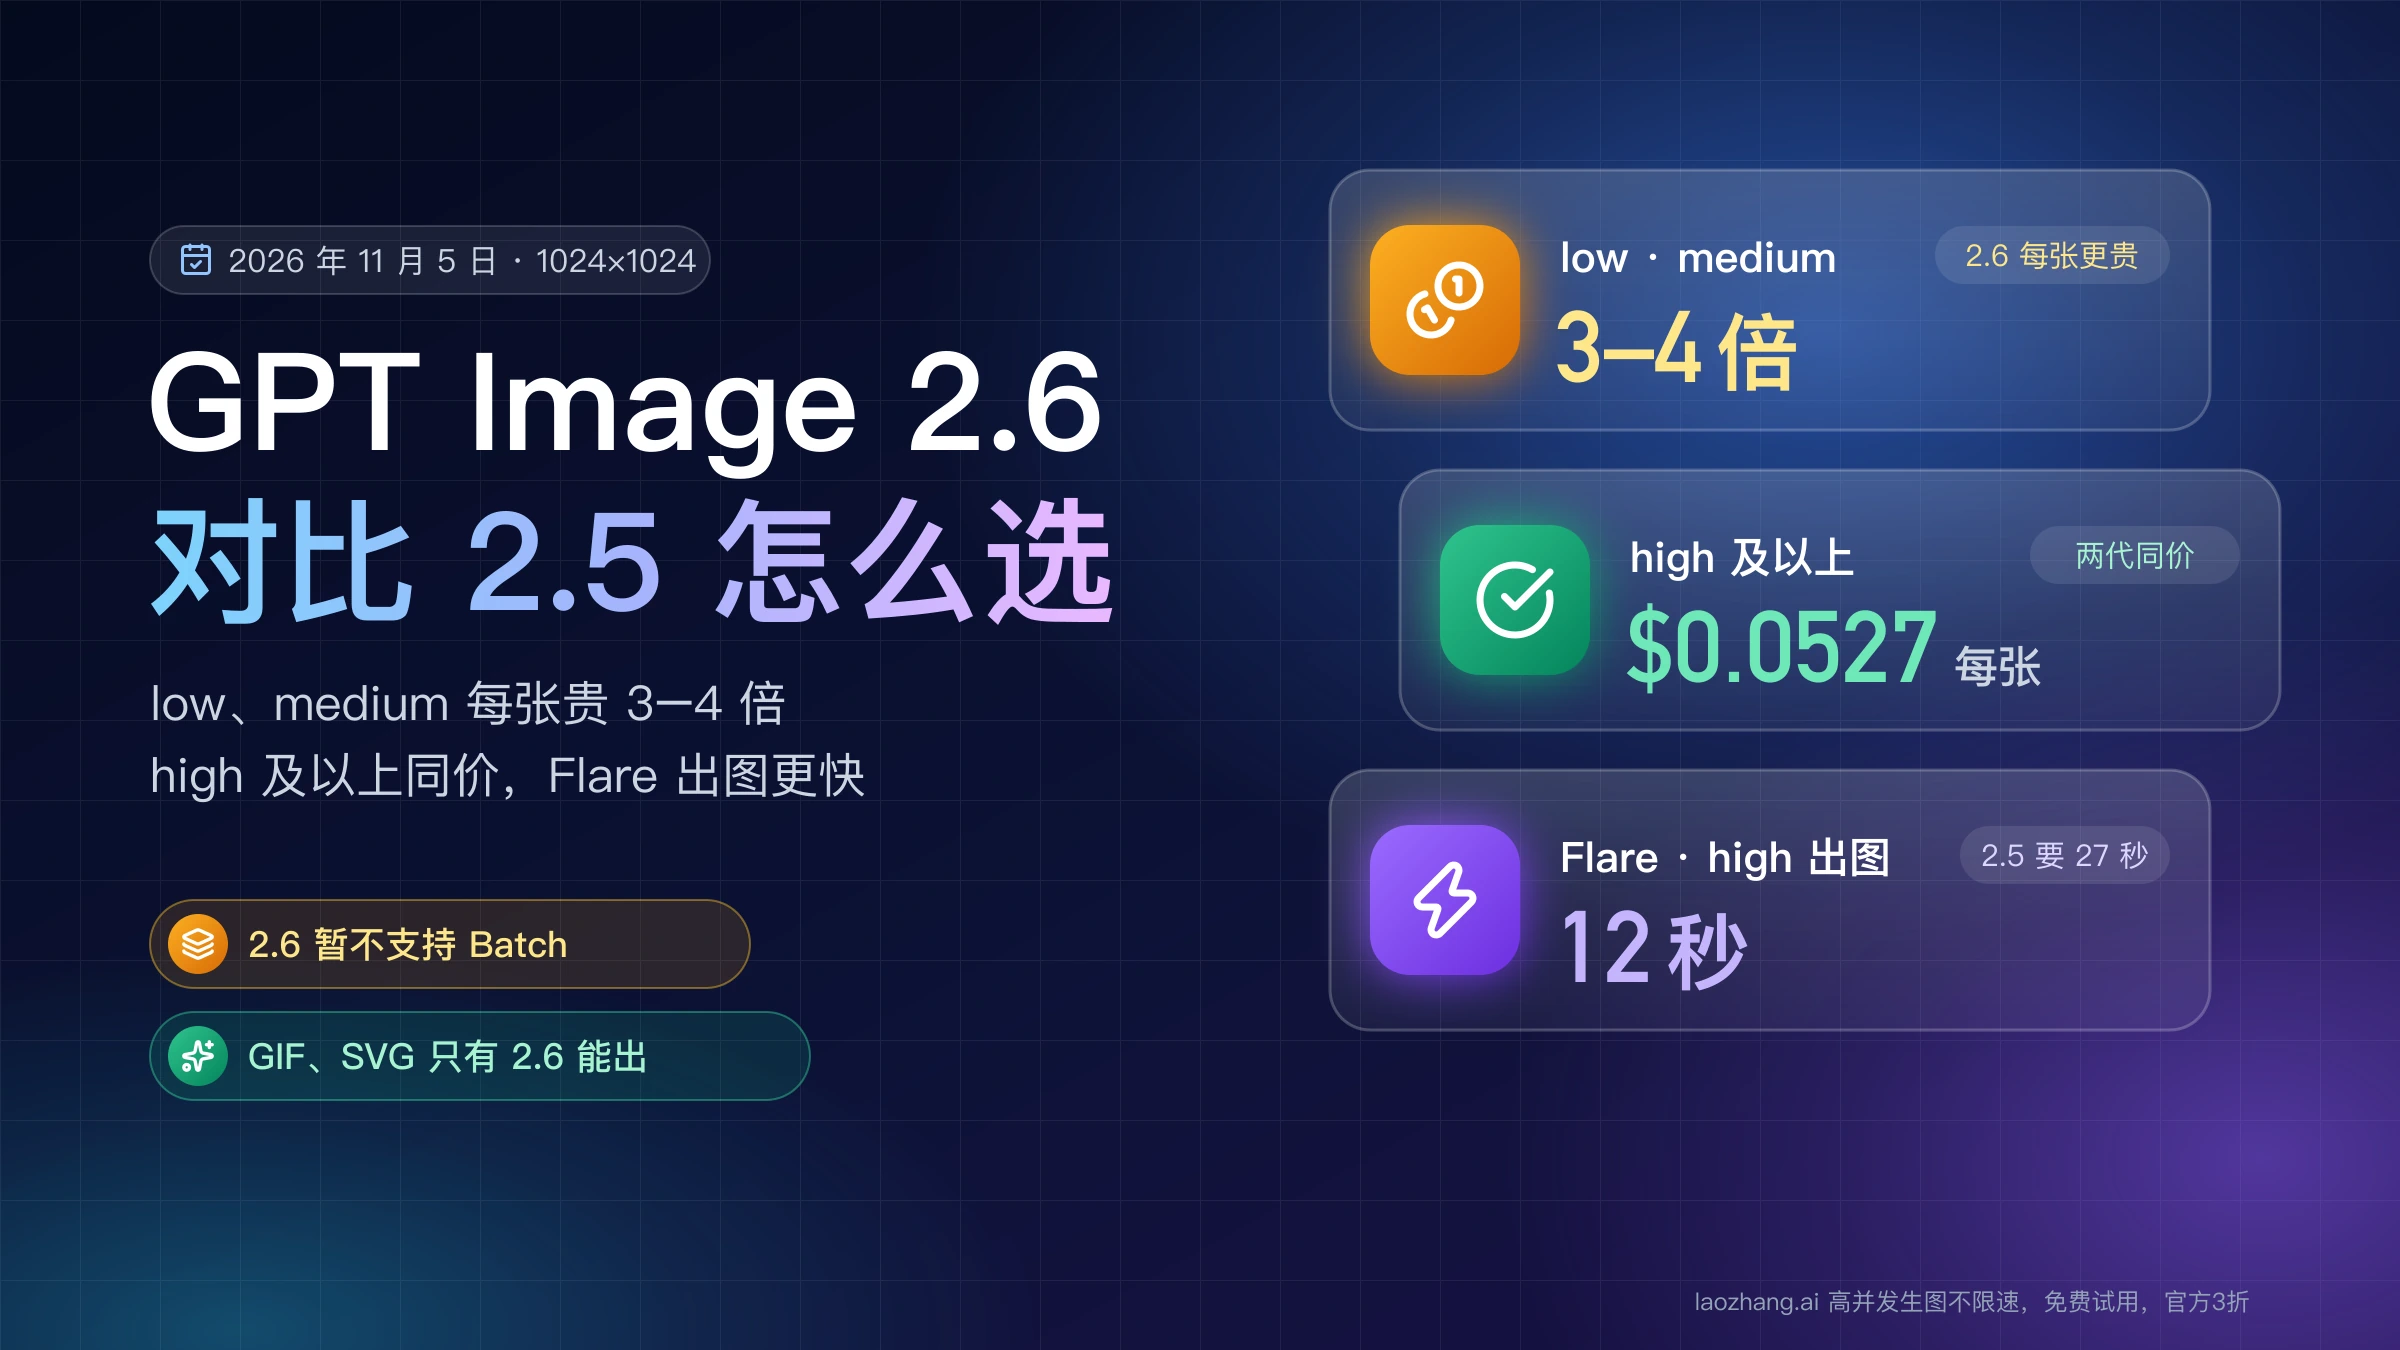
迁移时先存一组基线:有代表性的提示词、参考图和旧模型的输出,难度大的编辑、精确文字、产品外形、透明素材都要包含进去。第一次对比只换模型,提示词、参考图、size、quality 和输出格式都不动,complexity 保持默认;之后一次只调 quality 或 complexity 中的一个,每个请求重复几次,看达标的比例和耗时。2.6 和 2.5 在价格和速度上差多少、值不值得换,见 GPT Image 2.6 和 2.5 区别:low/medium 贵 3–4 倍,high 档起同价。
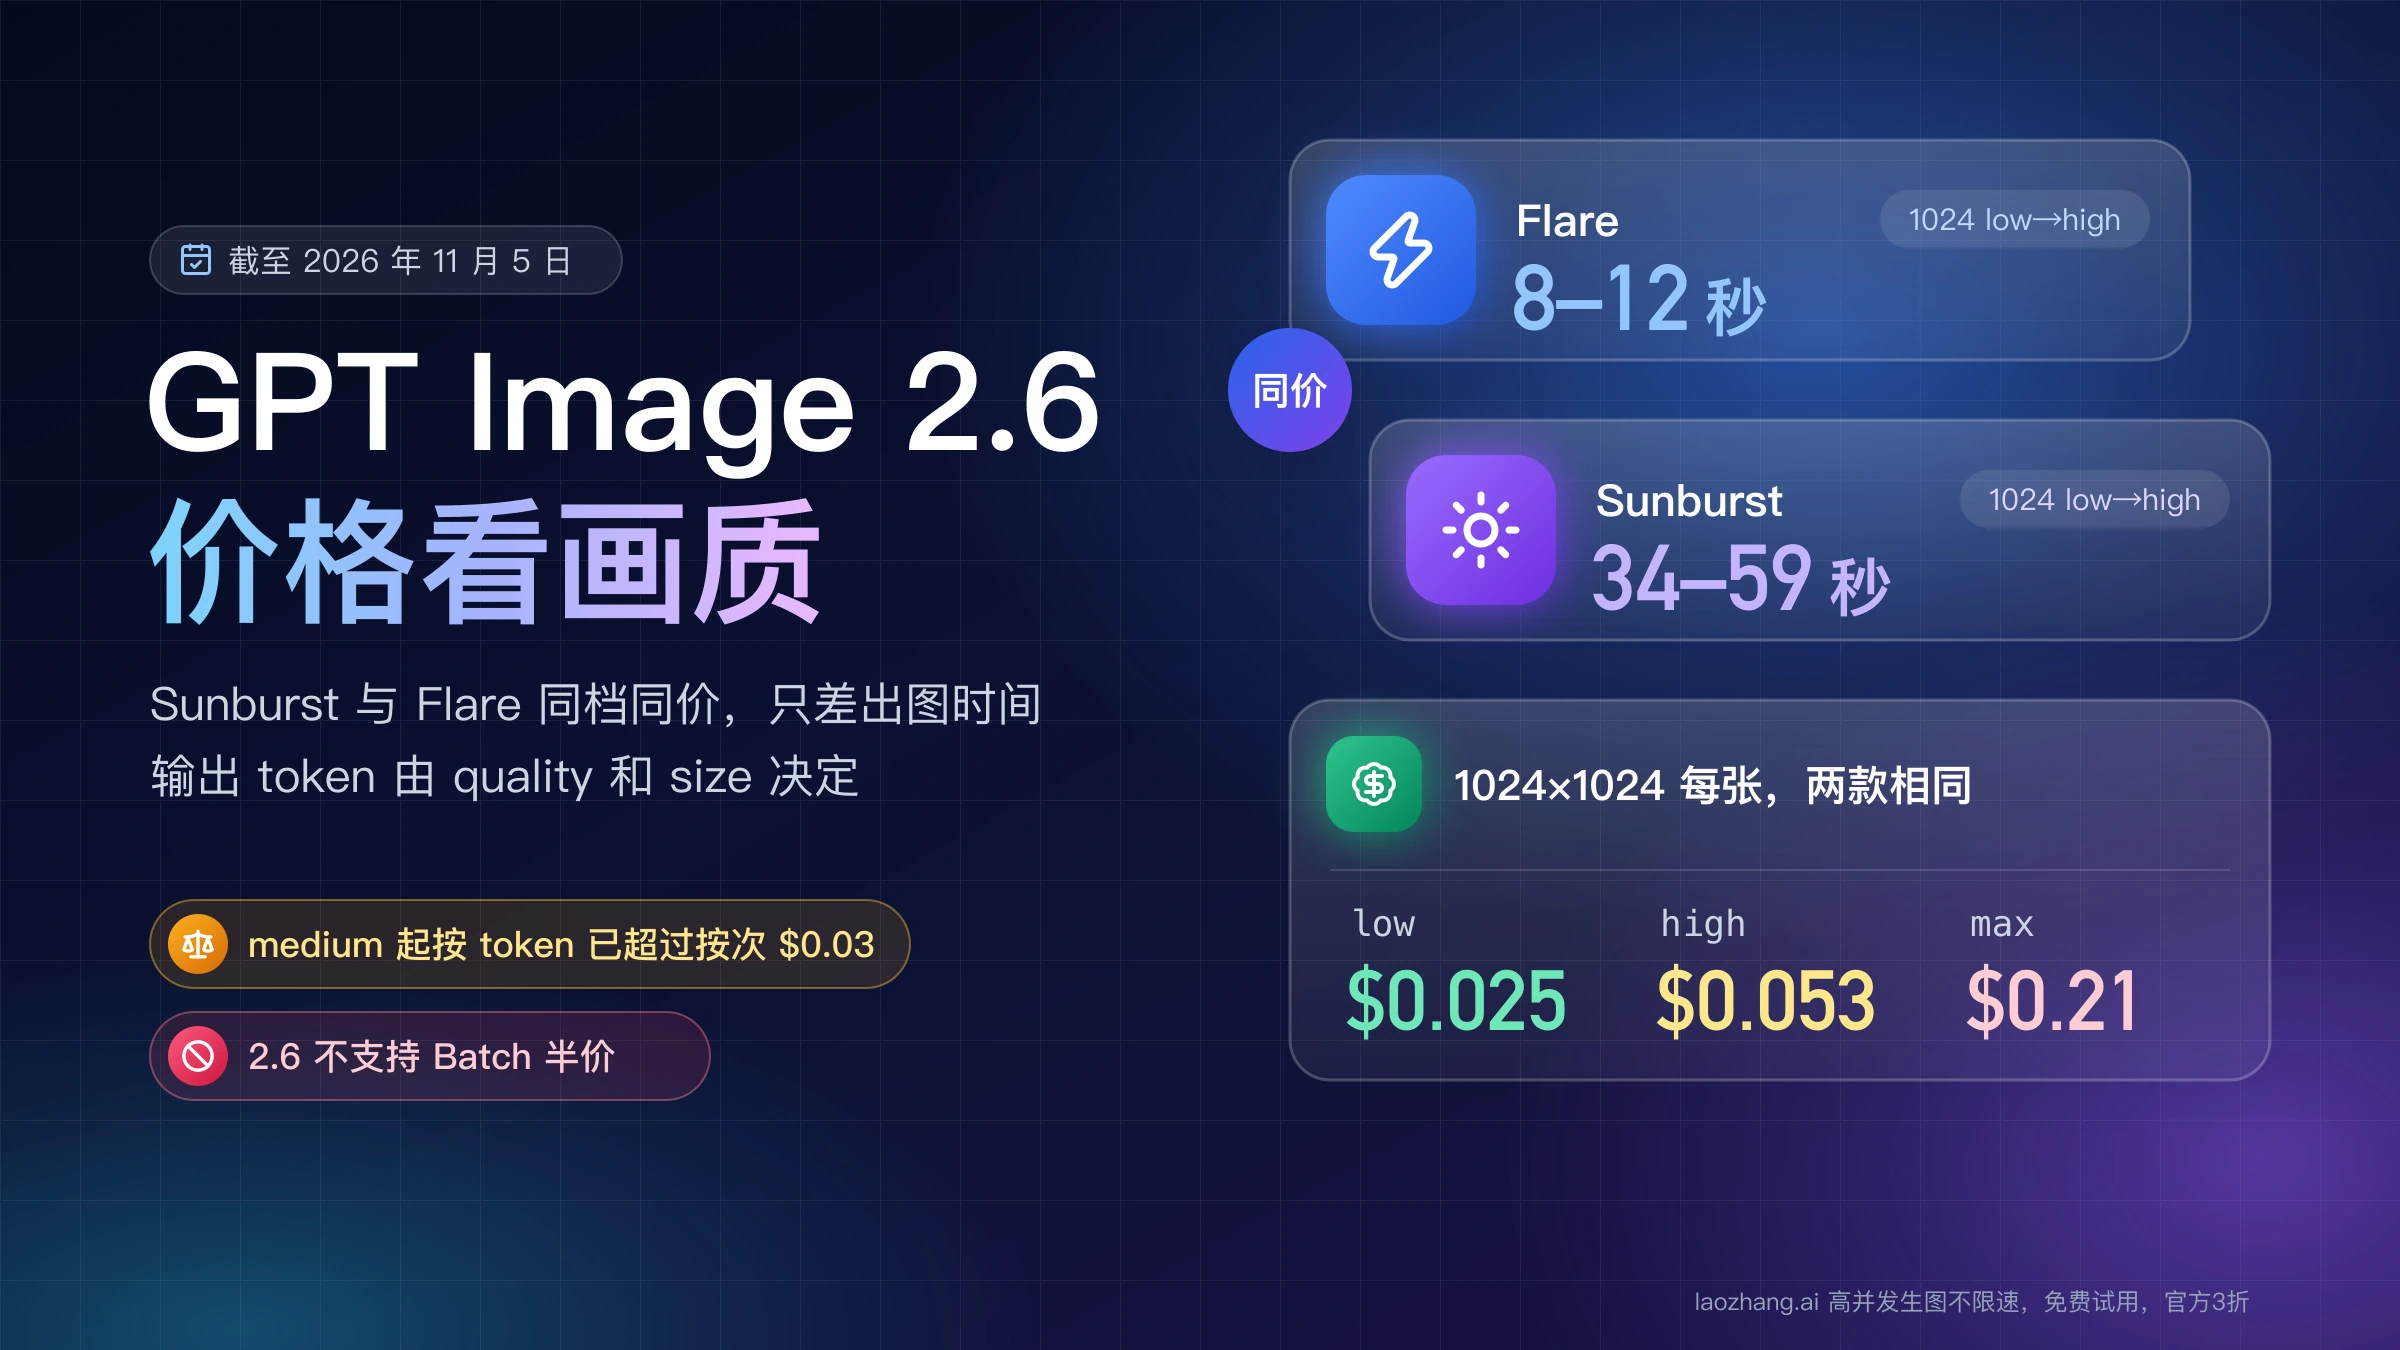
只是想便宜地反复试提示词,可以用 LaoZhang API。按 LaoZhang API 的 GPT Image 文档,default 分组里的 gpt-image-2.6-flare-vip 和 gpt-image-2.6-sunburst-vip 每张 $0.03,只出 PNG,quality 最高到 high;gpt-image-2.6-web 每次 $0.03,可以出 GIF。要 SVG、xhigh、max,或者要用 markup 叠加层,需用 OpenAI Official 分组调用 gpt-image-2.6-flare / gpt-image-2.6-sunburst,按 OpenAI 的 token 价格计费,这一组也能出 GIF。上文所有 2026 年 11 月 5 日的测试都是在按次计费的模型上做的,官方模型的表现以 OpenAI 文档为准。
说明:laozhang.ai 是我们自己的服务,其价格是平台报价,不是独立比较的结论。
出图后怎么验收:收下、重抽,还是只改一处
每张图在用之前按同一份清单检查,每一项不通过时对应的做法不同。整体方向错了就重抽;大部分对了、只有一处不对,就把这张图作为下一次编辑的输入,只改这一处。按下面的顺序看:
- 逐字读图里的文字:每个字都能读清、和要求一致吗?多出了没要求的文案,回到提示词补上引号、"exactly once" 和 "No extra text" 后重抽;字对但太小看不清,在同一个
complexity下调高quality再比较。 - 看版式和关系:图解的标注和连线对吗,元素的位置和你写的一致吗?整体布局不对就重抽,必要时把提示词改成分段标签的写法。
- 看该保留的东西:人物身份、产品形状、标签和参考图里的细节还在吗?丢了就在提示词里把它们写进保留清单再试。
- 编辑类的图,看是否只改了要求的地方。改多了先查请求里的
size是否和原图同比例,再把complexity降到low、补全保留清单。 - 需要透明背景时,解码文件看 alpha 通道里有没有透明像素,判断和修复方法见 GPT Image 透明背景变棋盘格:真假透明怎么判断、怎么修。
- 动图和 SVG 另看文件本身:GIF 逐帧看最后一帧能否接回第一帧;SVG 在小尺寸和大尺寸下都打开看一遍。
只改一处时,每轮只提一个改动,并把要保留的细节重新写一遍。"和上一张风格相同"这类说法能带上前文,但结果开始跑偏时,把关键约束完整地再写一次。上线前在有代表性的输入上比较质量、耗时和每张可用图的成本,OpenAI 建议按工作流逐步切换,同时记录失败和重试次数。
GPT Image 2.6 提示词的其他问题
提示词里写相机型号、镜头焦距有用吗?
有用,但只能当作外观提示。OpenAI 的 GPT Image 2.6 提示词指南说,相机参数会影响画面看起来像什么,不保证真的按物理规律模拟出那台相机、那支镜头的效果。想要特定的景深或透视,直接描述画面:主体占多大、背景虚到什么程度、从什么角度拍。
从 GPT Image 2 或 2.5 换到 2.6,请求里要删哪些参数?
按 OpenAI 截至 2026 年 11 月 5 日的参数说明,编辑请求里不要再传 input_fidelity,GPT Image 2.6 也不支持 reasoning.summary。新增的 complexity 不传时默认 high,第一次对比保持默认即可;quality 建议每次都显式写上。
要透明背景的 PNG,提示词怎么写?
提示词和参数要同时写:提示词里要求主体单独呈现、背景完全透明、不要背景和棋盘格,请求里设 background="transparent",输出用 PNG 或 WebP。OpenAI 指南提醒,画出来的棋盘格不等于透明;继续编辑这张图时,还要在提示词里重复"保持透明背景"。拿到文件后解码看 alpha 通道里是否真有透明像素。