Claude 与 OpenAI API 价格对比:按任务算谁更省
GPT-6 Sol 与 Sonnet 5、Astra 与 Fable 5.1 标价相同,Luna 是 Haiku 4.5 的十分之一;同价档看输入是否超过 272K 和缓存命中率。
文章目录
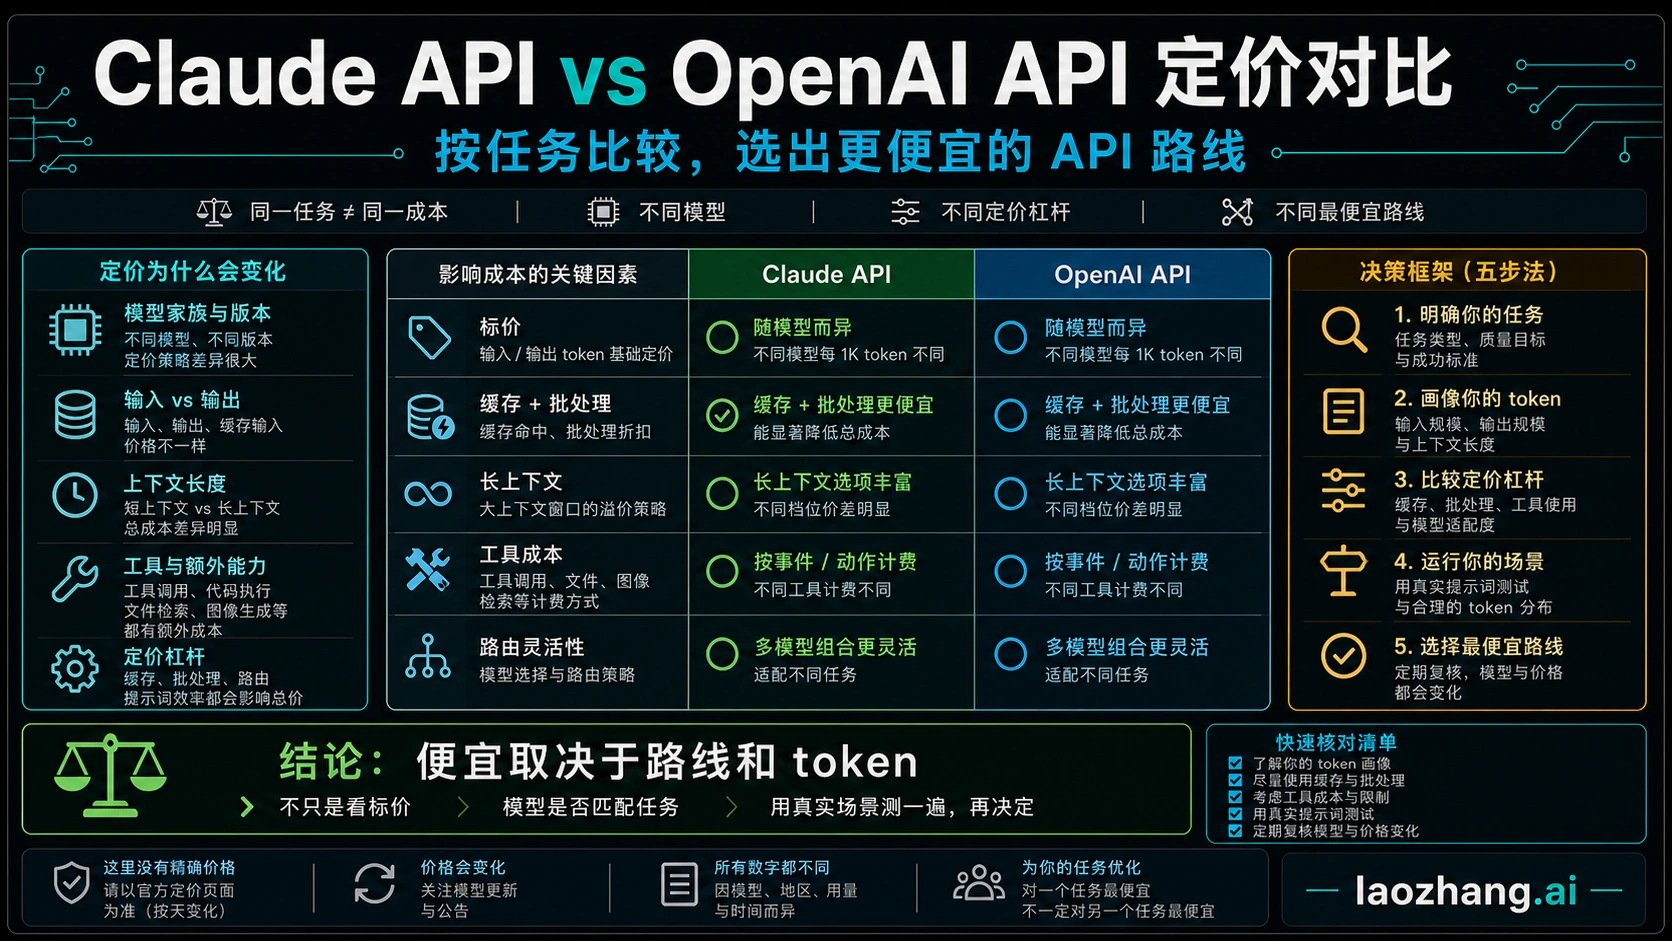
截至 2026 年 9 月 26 日,按两家官方标准价(每 100 万 token),OpenAI 和 Claude 在中档和顶档的短上下文标价已经完全一样:GPT-6 Sol 与 Claude Sonnet 5 都是输入 $2、输出 $10,GPT-6 Astra 与 Claude Fable 5.1 都是输入 $10、输出 $50。差距只剩低价档:GPT-6 Luna 输入 $0.10、输出 $0.50,是 Claude Haiku 4.5 的十分之一。Claude Opus 5.5(输入 $4、输出 $20)在 OpenAI 那边没有同价型号,价格落在 Sol 和 Astra 之间。
所以"哪家更便宜"要分档回答。低价档直接是 OpenAI 便宜。中档和顶档在 token 数相同时账单也相同,谁更省由几个条件决定:单次输入超过 272K token 时,OpenAI 整单改按长上下文价计费,Claude 仍是标准价;大量读缓存时,Fable 5.1 的缓存命中价只有 Astra 的四分之一。缓存写入、上下文窗口、Batch/Flex/Fast 这些服务档位和分词器差异,也会把账单往某一边推。下面先对上档位,再用三个算例把这些条件换成具体金额。
可比档位与官方价格
下表是两家官方页面上的标准处理价,单位是美元每 100 万 token;OpenAI 这一侧是输入不超过 272K 的短上下文价。来源是 OpenAI API 价格页、Claude API 价格页 和 Claude 型号总览。
| 档位 | 型号 | 输入 | 缓存命中 | 缓存写入 | 输出 | 上下文窗口 |
|---|---|---|---|---|---|---|
| 低价 | GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 | 1,050,000 |
| 低价 | Claude Haiku 4.5 | $1 | $0.10 | $1.25 | $5 | 200,000 |
| 中档 | GPT-6 Sol | $2 | $0.20 | $2.50 | $10 | 1,050,000 |
| 中档 | Claude Sonnet 5 | $2 | $0.20 | $2.50 | $10 | 1,000,000 |
| 中高档 | Claude Opus 5.5 | $4 | $0.20 | $5 | $20 | 1,000,000 |
| 顶档 | GPT-6 Astra | $10 | $1 | $12.50 | $50 | 1,050,000 |
| 顶档 | Claude Fable 5.1 | $10 | $0.25 | $12.50 | $50 | 1,000,000 |
OpenAI 一栏的缓存写入是默认的 30 分钟档;OpenAI 在 2026 年 10 月 20 日加了 12 小时档,只在 Responses API 可用,写入价是输入价的 2.5 倍(Luna $0.25,Sol $5,Astra $25)。Claude 一栏的缓存写入是 5 分钟档;Claude 还提供 1 小时缓存,写入价是输入价的 2 倍(Sonnet 5 为 $4,Opus 5.5 为 $8,Fable 5.1 为 $20,Haiku 4.5 为 $2)。GPT-6 三款最多输出 128,000 token;Fable 5.1、Opus 5.5、Sonnet 5 同样是 128K,Haiku 4.5 是 64K。
档位配对只说明预算位置相近,不说明能力相当。同档两款谁能更稳地完成你的任务,要看型号本身:GPT-6 Sol、Luna、Astra 与 Terra 怎么选分清了 OpenAI 这一侧;Claude 这边的高档取舍见 Claude Fable 5.1 和 Opus 5.5 怎么选。
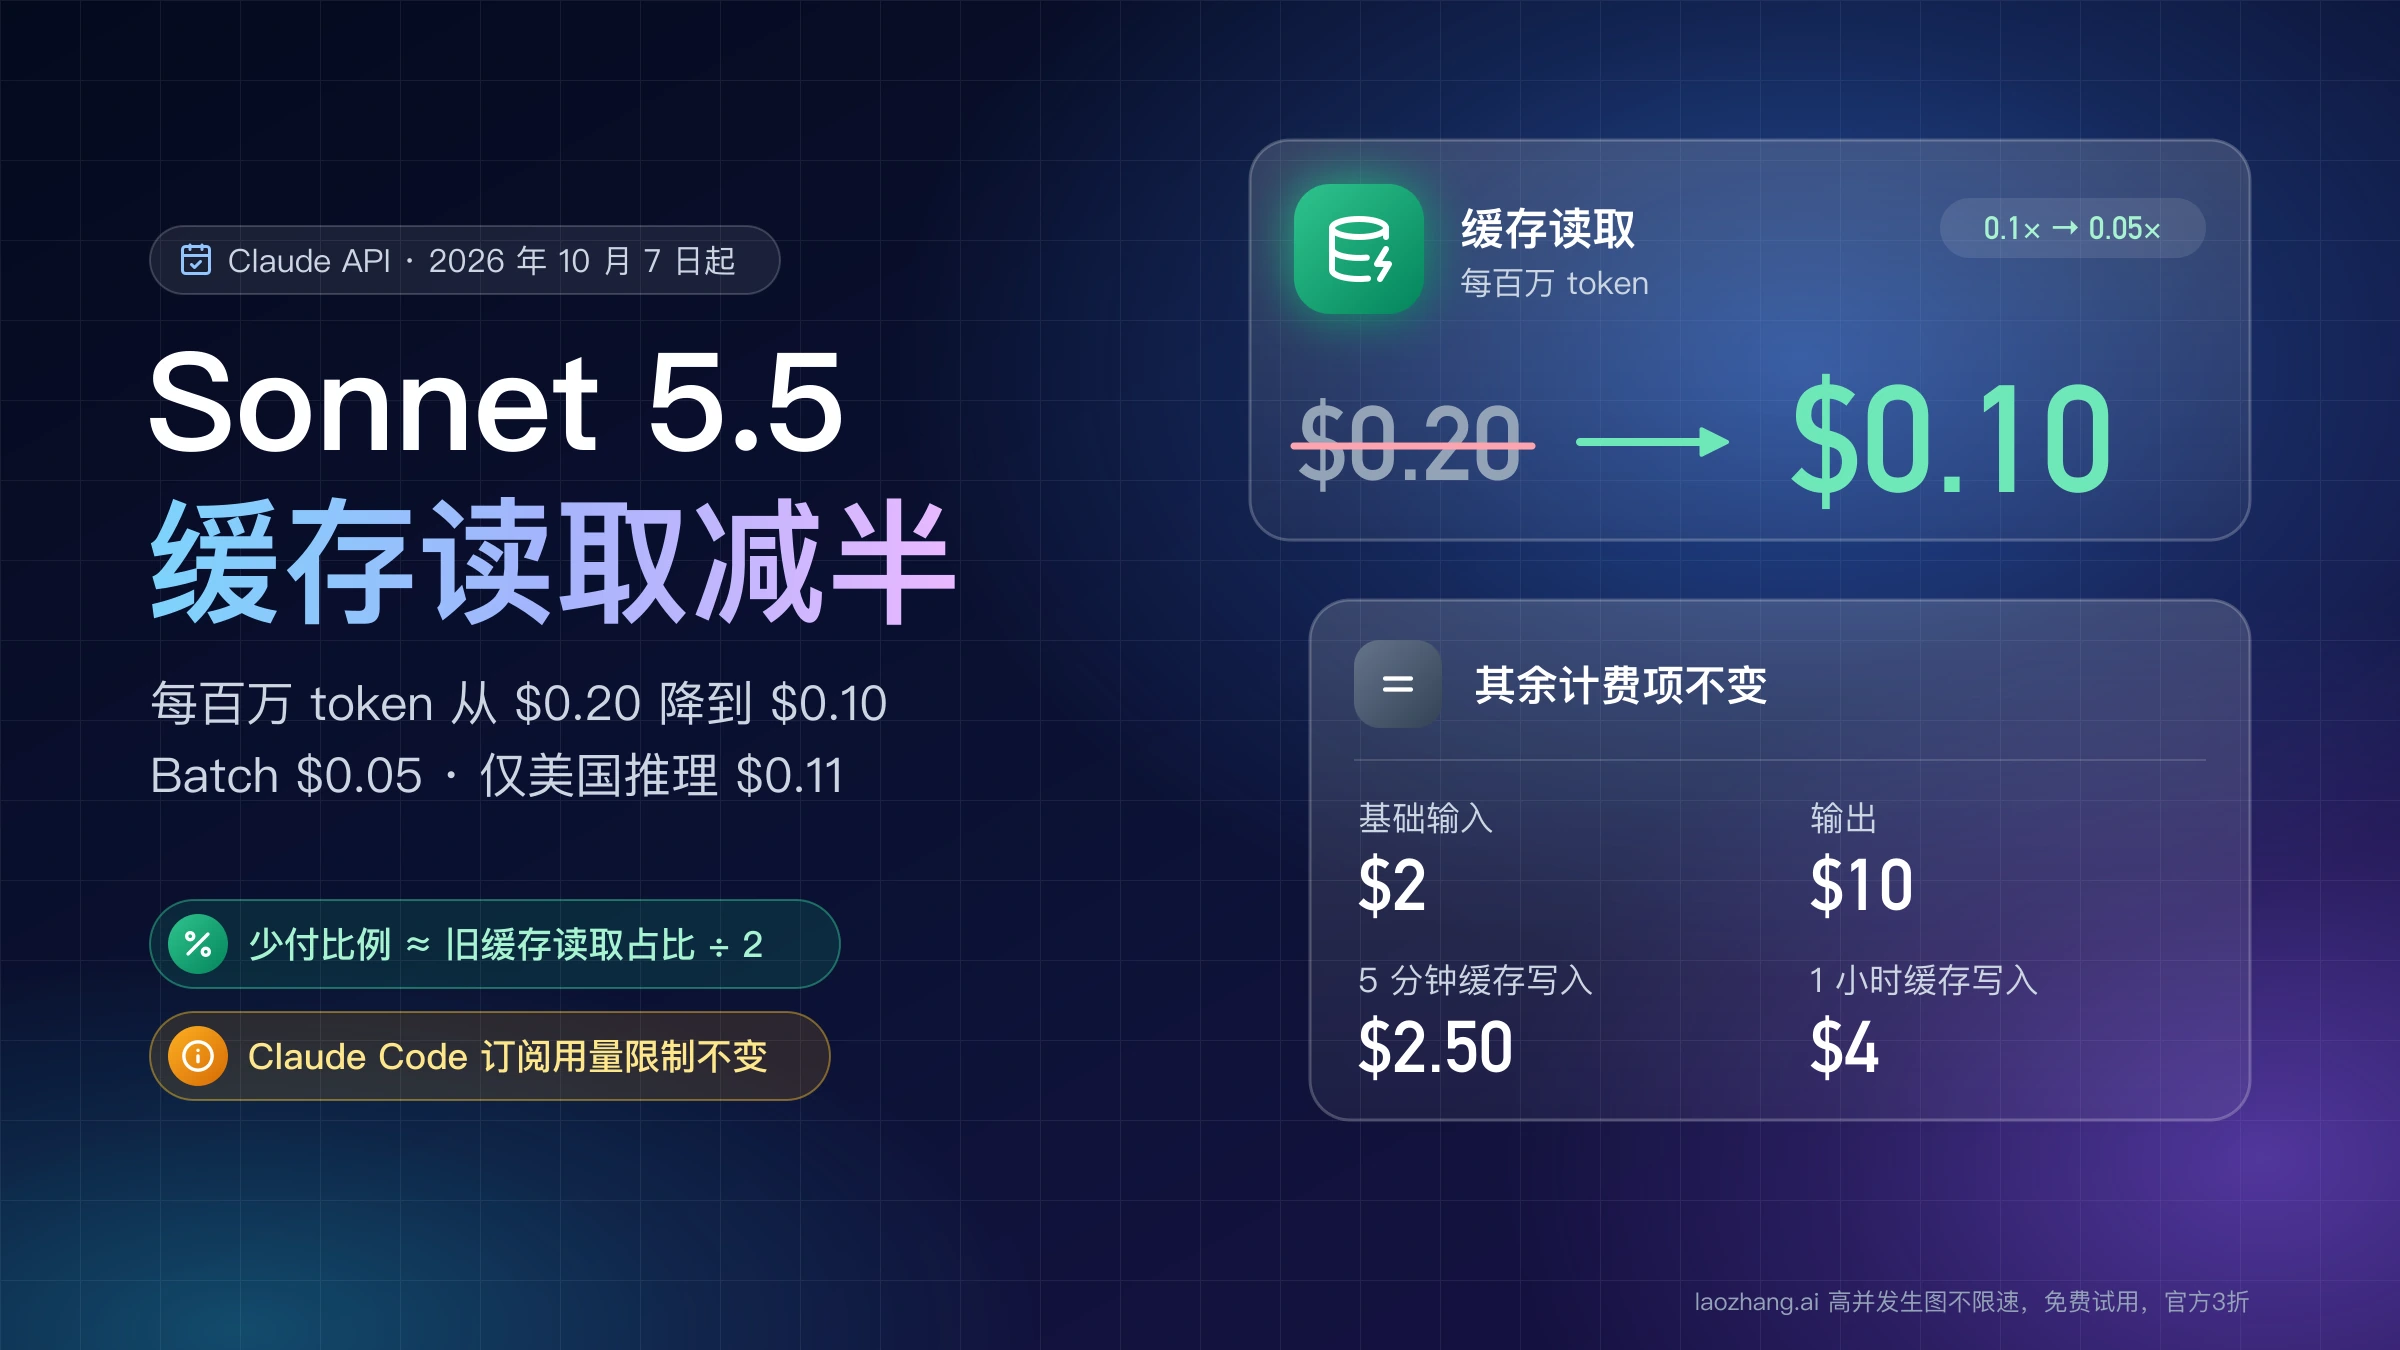
Opus 5.5 值得单独说一句。它的标价比 Opus 5($5 / $25)低 20%,缓存命中只收输入价的 5%,即 $0.20,和 Sonnet 5、GPT-6 Sol 的命中价相同。缓存占输入大头时,Opus 5.5 输入侧的花费会接近中档,主要差距落在未缓存输入和输出上。拿它和 Sol 做任务级比较,可以看 Claude Opus 5.5 对比 GPT-6 Sol。
如果你还在用上一代,GPT-5.6 Sol 仍在 OpenAI 价目表上,标价 $4 / $20,官方写明其促销价至少提供到 2026 年 11 月 21 日;GPT-6 Sol 的标价正好是它的一半。
同价档由哪些条件分胜负
Sol 和 Sonnet 5、Astra 和 Fable 5.1 的四项短上下文标价里,只有 Astra 与 Fable 5.1 的缓存命中价不同。真正让两家账单拉开的,是下面这些计费规则。
| 条件 | OpenAI GPT-6 | Claude | 对账单的影响 |
|---|---|---|---|
| 单次输入超过 272K token | 整单的输入价和缓存价乘 2、输出价乘 1.5;Sol 变成 $4 / $15,Astra 变成 $20 / $75 | Claude 4.6 及以后的型号在 1M 窗口内都按标准价 | 长文档单次请求,Claude 同档明显更便宜 |
| 缓存命中 | 输入价的 10%:Luna $0.01、Sol $0.20、Astra $1 | Haiku 4.5 $0.10、Sonnet 5 $0.20、Opus 5.5 $0.20、Fable 5.1 $0.25 | 中档相同;顶档 Fable 5.1 的命中价是 Astra 的四分之一 |
| 缓存写入 | 30 分钟档 1.25 倍,12 小时档 2.5 倍(仅 Responses API) | 5 分钟档 1.25 倍,1 小时档 2 倍 | 短时缓存两边同价;更长的有效期两边都要多付:Claude 1 小时档 2 倍,OpenAI 12 小时档 2.5 倍 |
| 上下文窗口 | 三款都是 1,050,000 | Fable 5.1、Opus 5.5、Sonnet 5 为 1M;Haiku 4.5 只有 200K | 超过 200K 的低价任务只能用 Luna 或升档到 Sonnet 5 |
| 可以等结果的任务 | Batch 半价,Flex 也是半价 | Batch 半价 | 同档价格关系不变,Sol 与 Sonnet 5 批处理都是 $1 / $5 |
| 更快的输出 | Fast mode 价格翻倍,Sol 为 $4 / $20 | 只有 Opus 系列有 Fast mode,Opus 5.5 为 $8 / $40,仅限 Claude API 直连,不能与 Batch 叠加 | Sonnet 5 没有 Fast 档,中档想加速只能用 OpenAI |
| 数据驻留 | 区域处理端点加 10%,适用于 2026 年 3 月 5 日及以后发布、支持数据驻留的型号 | 指定美国境内推理 inference_geo: "us" 时所有 token 乘 1.1 | 两边加价幅度相同 |
| 分词器 | 无官方跨厂商换算 | Claude 4.7 及以后型号的分词器,同一段文本比旧分词器多出约 30% token | 同一份文本在两家计出的 token 数可能不同,只能用自己的文本实测 |
272K 规则来自 OpenAI 各型号页,例如 GPT-6 Sol 型号页原文写的是"for the full request":一旦输入越过这条线,整次请求都按长上下文价结算,不是只对超出部分加价。Claude 的价格页则写明 Claude 4.6 及以后型号的 1M 窗口按标准价计费,90 万 token 的请求和 9,000 token 的请求单价相同。
分词器这一项决定了"标价相同"不等于"账单相同"。Anthropic 只说明了新旧 Claude 分词器之间约 30% 的差异,没有给出和 OpenAI 的换算比例。最可靠的做法是拿同一批真实请求分别调用两家,读响应里的 usage 计数。
三个算例:条件怎样变成金额
下面三个例子都假设两家计出的 token 数相同,按标准处理价计算。价格单位是每 100 万 token,所以公式里的 token 数也写成百万。
一次 agent 回合:输入九成来自缓存
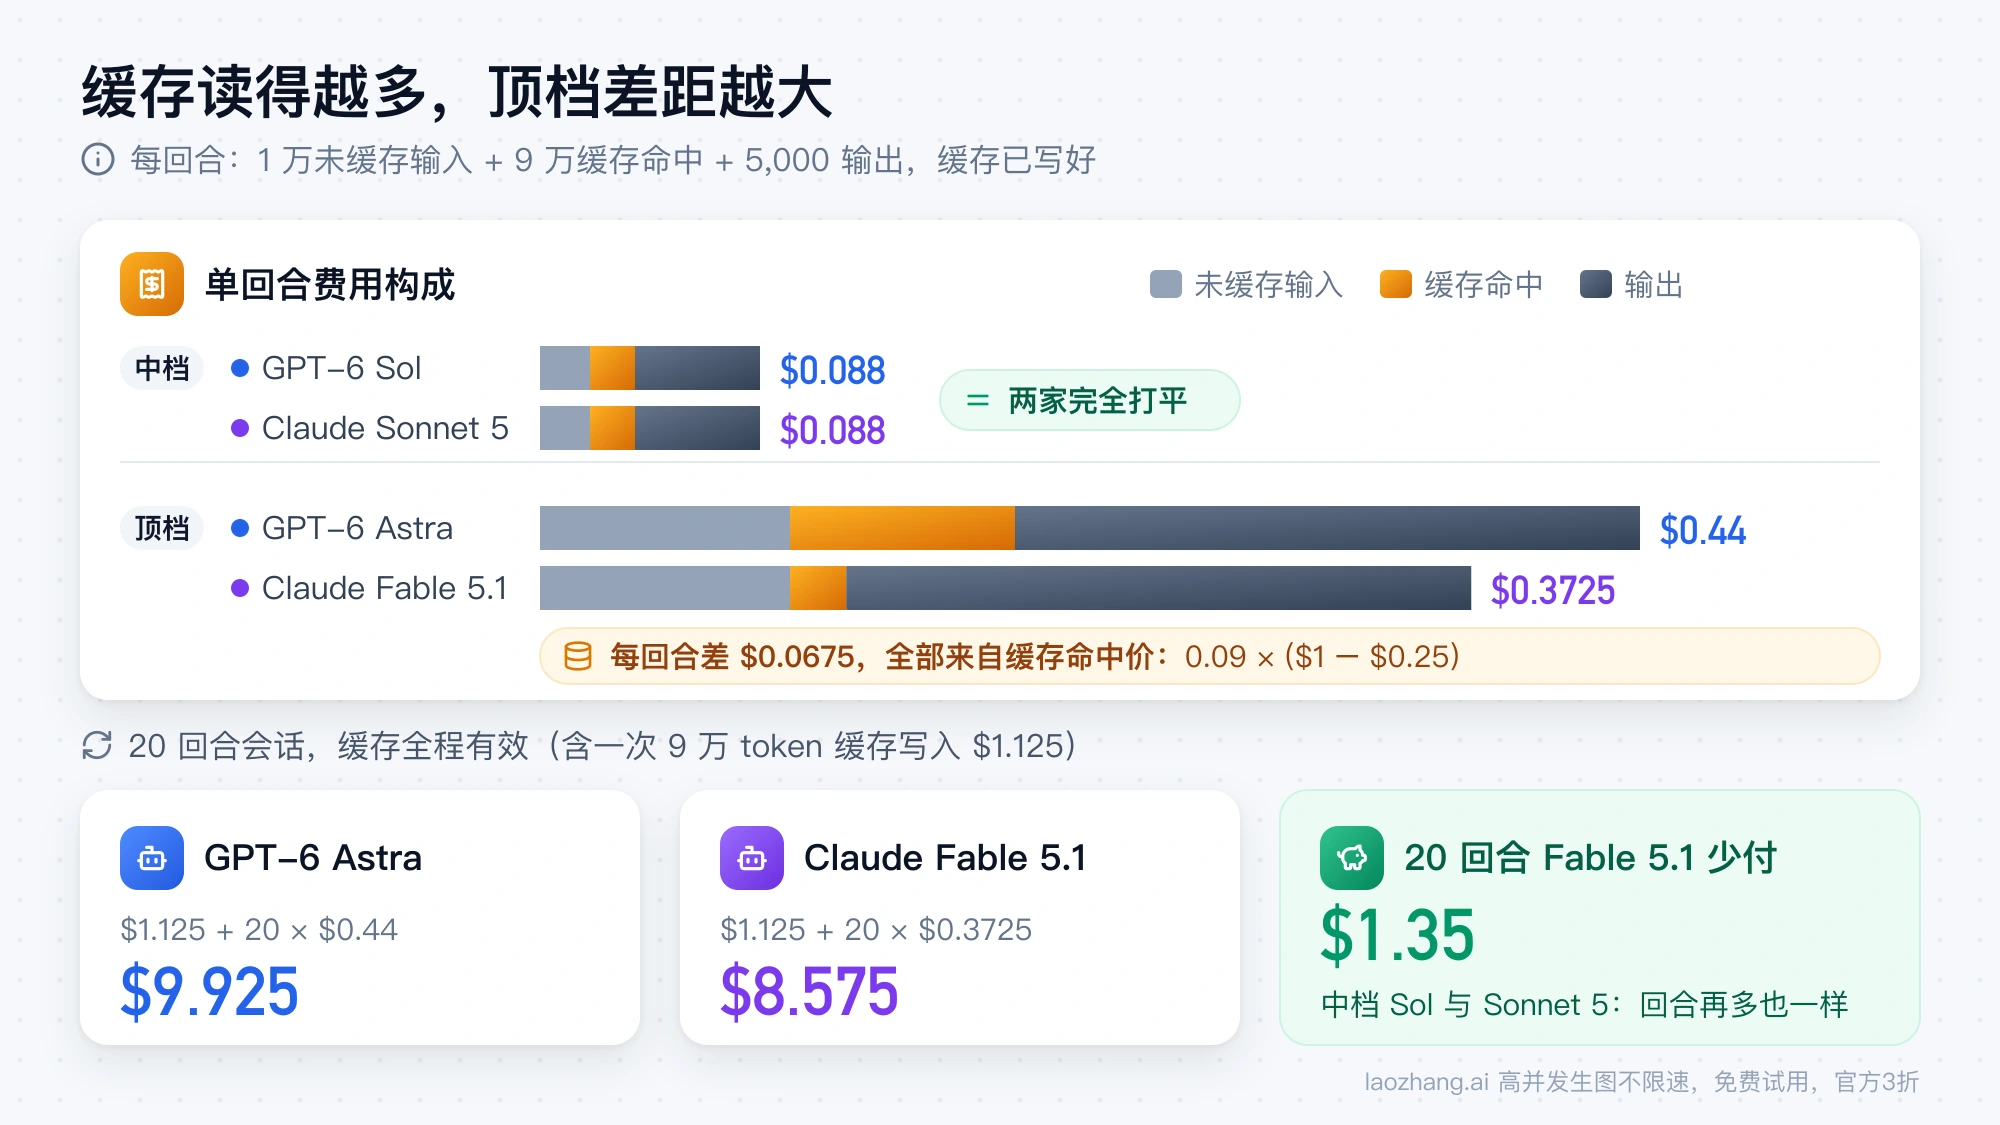
设定:1 万 token 未缓存输入、9 万 token 缓存命中、5,000 token 输出,缓存已经写好。
费用 = 0.01 × 输入价 + 0.09 × 缓存命中价 + 0.005 × 输出价
| 型号 | 单次回合费用 |
|---|---|
| GPT-6 Luna | $0.0044 |
| Claude Haiku 4.5 | $0.044 |
| GPT-6 Sol | $0.088 |
| Claude Sonnet 5 | $0.088 |
| Claude Opus 5.5 | $0.158 |
| Claude Fable 5.1 | $0.3725 |
| GPT-6 Astra | $0.44 |
Sol 和 Sonnet 5 完全打平。Fable 5.1 每回合比 Astra 少 $0.0675,这笔差额全部来自缓存命中价:0.09 × ($1 − $0.25)。Opus 5.5 的 $0.158 里有 $0.10 是输出费,缓存部分只花 $0.018,和 Sol 一样。
上表不含第一次写入缓存的费用。写入这 9 万 token,Sol 和 Sonnet 5 的 5 分钟档都是 0.09 × $2.50 = $0.225,Sonnet 5 改用 1 小时档是 0.09 × $4 = $0.36;Opus 5.5 的 5 分钟档是 $0.45;Astra 和 Fable 5.1 都是 0.09 × $12.50 = $1.125。
放到一个 20 回合的会话里,并假设缓存全程有效:Astra 为 $1.125 + 20 × $0.44 = $9.925,Fable 5.1 为 $1.125 + 20 × $0.3725 = $8.575,差 $1.35。重复上下文越长、回合越多,顶档的差距越大;中档无论多少回合都一样。
一次长文档请求:30 万 token 输入
设定:30 万 token 未缓存输入、2 万 token 输出。30 万已经超过 272K,GPT-6 三款整单按长上下文价。
- GPT-6 Sol:0.3 × $4 + 0.02 × $15 = $1.50
- Claude Sonnet 5:0.3 × $2 + 0.02 × $10 = $0.80
- Claude Opus 5.5:0.3 × $4 + 0.02 × $20 = $1.60
- GPT-6 Astra:0.3 × $20 + 0.02 × $75 = $7.50
- Claude Fable 5.1:0.3 × $10 + 0.02 × $50 = $4.00
- GPT-6 Luna:0.3 × $0.20 + 0.02 × $0.75 = $0.075
- Claude Haiku 4.5:放不下,窗口只有 200K
同一档里 Claude 便宜近一半,而且 Opus 5.5 的 $1.60 已经和 Sol 的长上下文价差不多。272K 附近还有一道台阶:Sol 输入 27 万、输出 2 万时是 0.27 × $2 + 0.02 × $10 = $0.74;输入涨到 28 万,就变成 0.28 × $4 + 0.02 × $15 = $1.42。多 1 万 token 输入,账单接近翻倍;同样 28 万输入,Sonnet 5 是 $0.76。
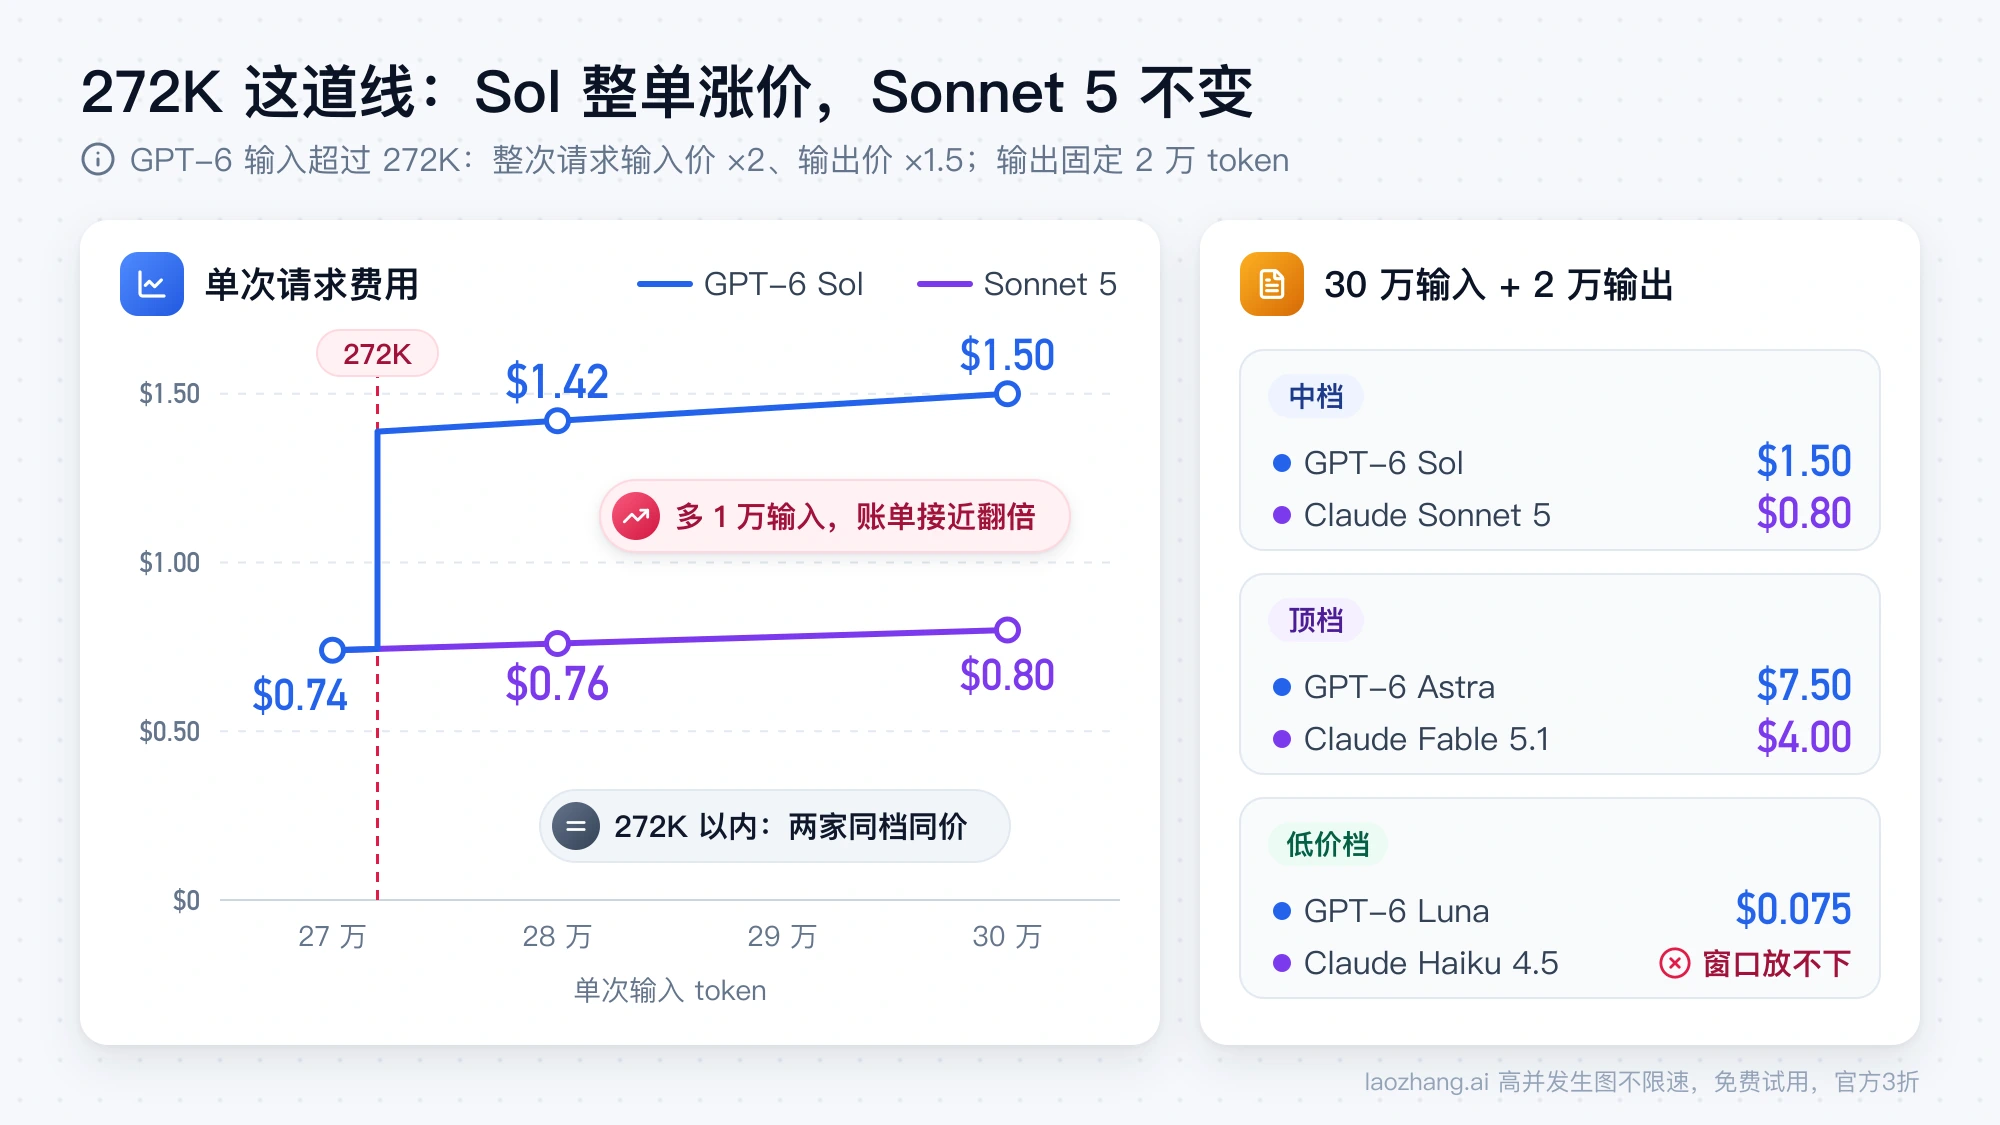
结论很直接:如果能靠检索或切块把单次输入稳定压在 272K 以内,OpenAI 同档回到同价;做不到时,长文档请求在 Claude 同档更便宜。
一个月不用缓存:1 亿输入、2,000 万输出
费用 = 100 × 输入价 + 20 × 输出价
| 型号 | 月费用 |
|---|---|
| GPT-6 Luna | $20 |
| Claude Haiku 4.5 | $200 |
| GPT-6 Sol | $400 |
| Claude Sonnet 5 | $400 |
| Claude Opus 5.5 | $800 |
| GPT-6 Astra | $2,000 |
| Claude Fable 5.1 | $2,000 |
不用缓存、输入也都在 272K 以内时,中档和顶档两两打平,全部改用 Batch 时各自减半,关系不变。这时真实账单的差距只来自 token 数本身:分词器计出多少、模型习惯写多长、失败后要重跑几次。
用自己的请求算一遍
把日志里几类典型请求的 token 数代进下面的函数,就能按上面的规则得到每个型号的单次费用。价格写在字典里,调价时改一处即可。
# 价格:美元 / 每 100 万 token,标准处理,截至 2026 年 9 月 26 日
# (输入, 缓存命中, 缓存写入, 输出, 上下文窗口, 是否适用 272K 整单加价)
PRICES = {
    "gpt-6-luna":                (0.10, 0.01, 0.125, 0.50, 1_050_000, True),
    "gpt-6-sol":                 (2.00, 0.20, 2.50, 10.00, 1_050_000, True),
    "gpt-6-astra":               (10.00, 1.00, 12.50, 50.00, 1_050_000, True),
    "claude-haiku-4-5-20251001": (1.00, 0.10, 1.25, 5.00, 200_000, False),
    "claude-sonnet-5":           (2.00, 0.20, 2.50, 10.00, 1_000_000, False),
    "claude-opus-5-5":           (4.00, 0.20, 5.00, 20.00, 1_000_000, False),
    "claude-fable-5-1":          (10.00, 0.25, 12.50, 50.00, 1_000_000, False),
}

def cost(model, uncached, cache_hit, output, cache_write=0, batch=False):
    """估算一次请求的美元费用;Claude 的缓存写入按 5 分钟档计。"""
    inp, hit, write, out, window, long_rule = PRICES[model]
    prompt = uncached + cache_hit + cache_write
    if prompt + output > window:
        raise ValueError(f"{model}:上下文窗口放不下 {prompt + output:,} token")
    if long_rule and prompt > 272_000:
        inp, hit, write, out = inp * 2, hit * 2, write * 2, out * 1.5
    total = (uncached * inp + cache_hit * hit + cache_write * write + output * out) / 1_000_000
    return total * 0.5 if batch else total

# 示例:30 万 token 输入、2 万 token 输出,不用缓存
for m in PRICES:
    try:
        print(f"{m:28} ${cost(m, 300_000, 0, 20_000):.4f}")
    except ValueError as e:
        print(e)
运行结果与上面长文档算例一致:Sol $1.5000、Sonnet 5 $0.8000,Haiku 4.5 报窗口不足。函数没有覆盖 Fast mode、数据驻留加价和工具调用费,需要时在结果上另乘或另加。
代入的 token 数最好来自真实响应的 usage,而不是按字数估。至少取三类样本:短输入短输出、长输入短输出、长输入长输出;有缓存的场景再单独记下命中和写入各占多少。每类样本在两家各跑一遍,把总费用除以真正合格的结果数,得到的"每次合格交付成本"比单次调用价更能说明谁省钱,因为重试和过长的输出都会算进去。
先测哪一家
- 分类、抽取、短摘要这类大批量简单任务,先测 GPT-6 Luna。Haiku 4.5 在所有 token 类别上都贵十倍,只有 Luna 的质量过不了线时才值得拿来比。
- 常规编码、agent、客服这类短上下文任务,Sol 和 Sonnet 5 同价,两家都测,选一次通过率更高、输出更精简的一家。这一档的账单差距来自 token 数,不来自单价。
- 单次输入经常超过 272K 的长文档任务,先测 Sonnet 5;需要更强推理时,Opus 5.5 的长文档单次费用已接近 Sol 的长上下文价。
- 顶档加长会话、大段重复上下文(例如反复查询同一个代码库),Fable 5.1 的缓存命中价优势会随回合数累积;缓存少、输出多的顶档任务,Fable 5.1 与 Astra 打平。
- 能等结果的离线任务,两家 Batch 都是半价,OpenAI 另有同价的 Flex,不改变同档的价格关系。
- 需要更快输出时,OpenAI 三款都能用 Fast mode,价格翻倍;Claude 只有 Opus 5.5 等 Opus 型号可以用,$8 / $40。
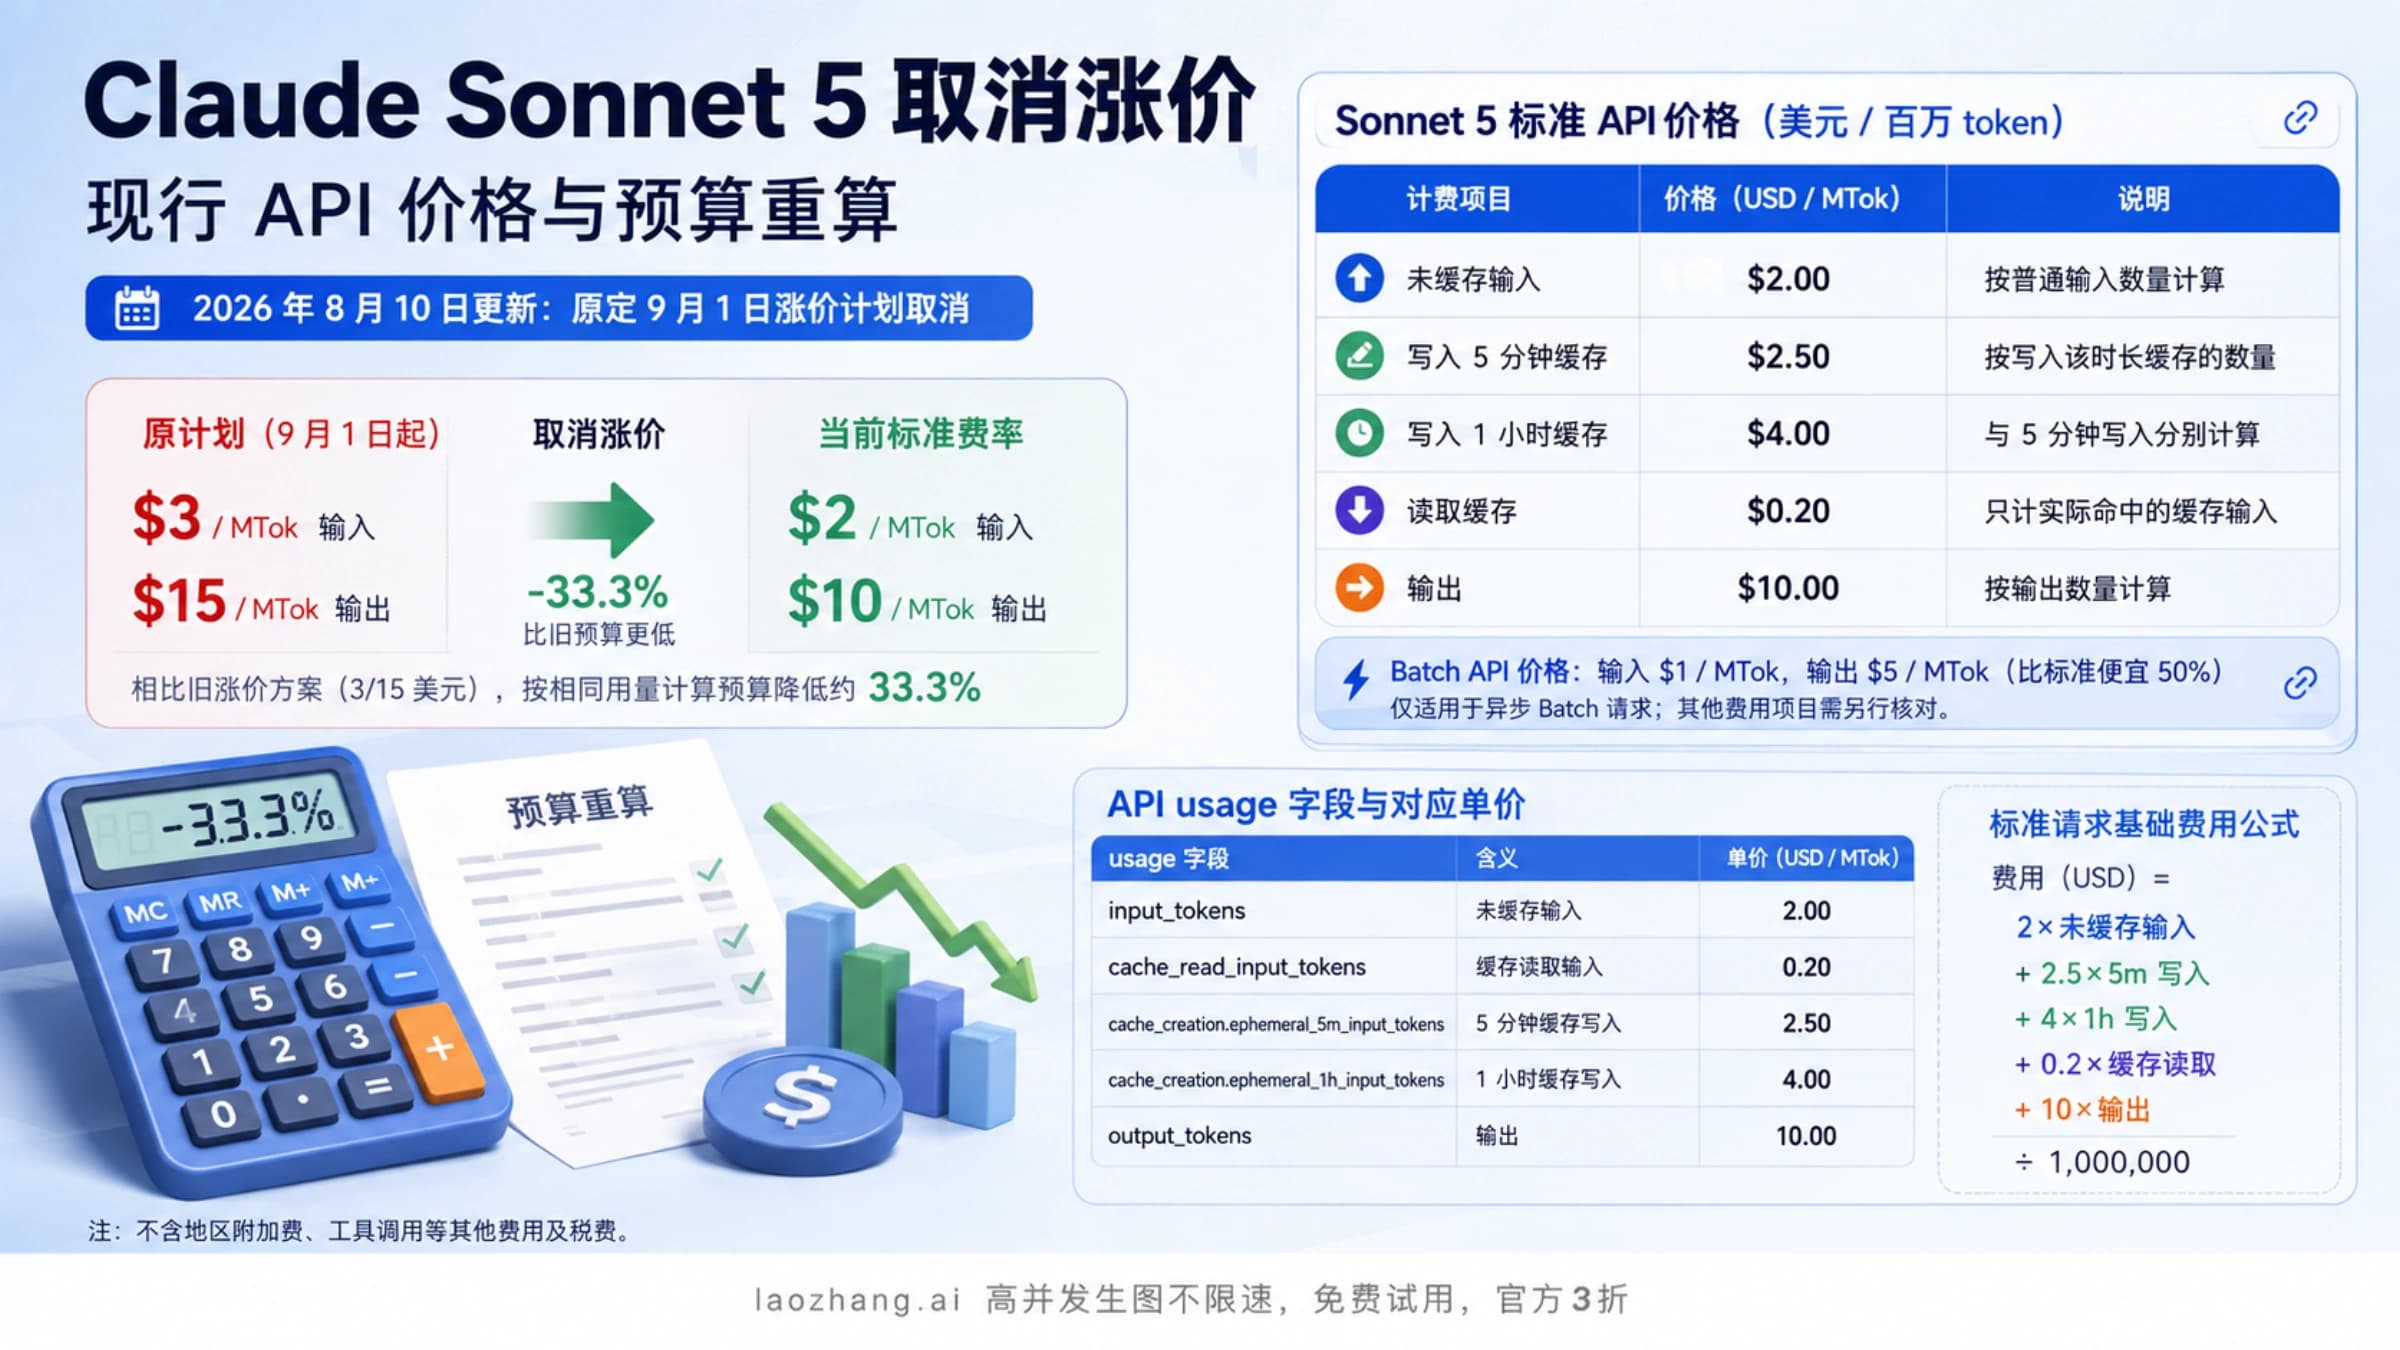
单个型号的完整价格与服务档位细节,可以看 GPT-6 Astra API 定价与成本计算、Claude Fable 5.1 API 价格、Claude Sonnet 5 现行 API 价格和 Claude Opus 5.5 价格与用量重置。
上线前核对
- 上线当天重新打开两家价格页,确认型号名、价格和你的账号是否已经能调用该型号。
- 用真实请求的 usage 核对输入、输出、缓存命中和缓存写入四项 token 数,缓存命中率按实测填,不按理想值填。
- 工具费另算。网页搜索两家都是每 1,000 次 $10,搜到的内容再按模型价计入 token;OpenAI 的容器、文件搜索存储也有单独收费项。
- 需要数据驻留或美国境内推理时,两边都要在 token 费上再加 10%。
- 以上都是两家官方直连价。中转平台或网关的价格是另一份合同,折扣、限额和风险都要单独比较,见最便宜的 LLM API Provider:按价格、质量、延迟和网关风险比较。
- ChatGPT、Claude 的订阅套餐不按 token 计费,不能和这里的价格直接比;重度使用 Claude Code 的人可以看 Claude Code 重度用户:保留订阅、降级,还是改用 API?盈亏点怎么算。
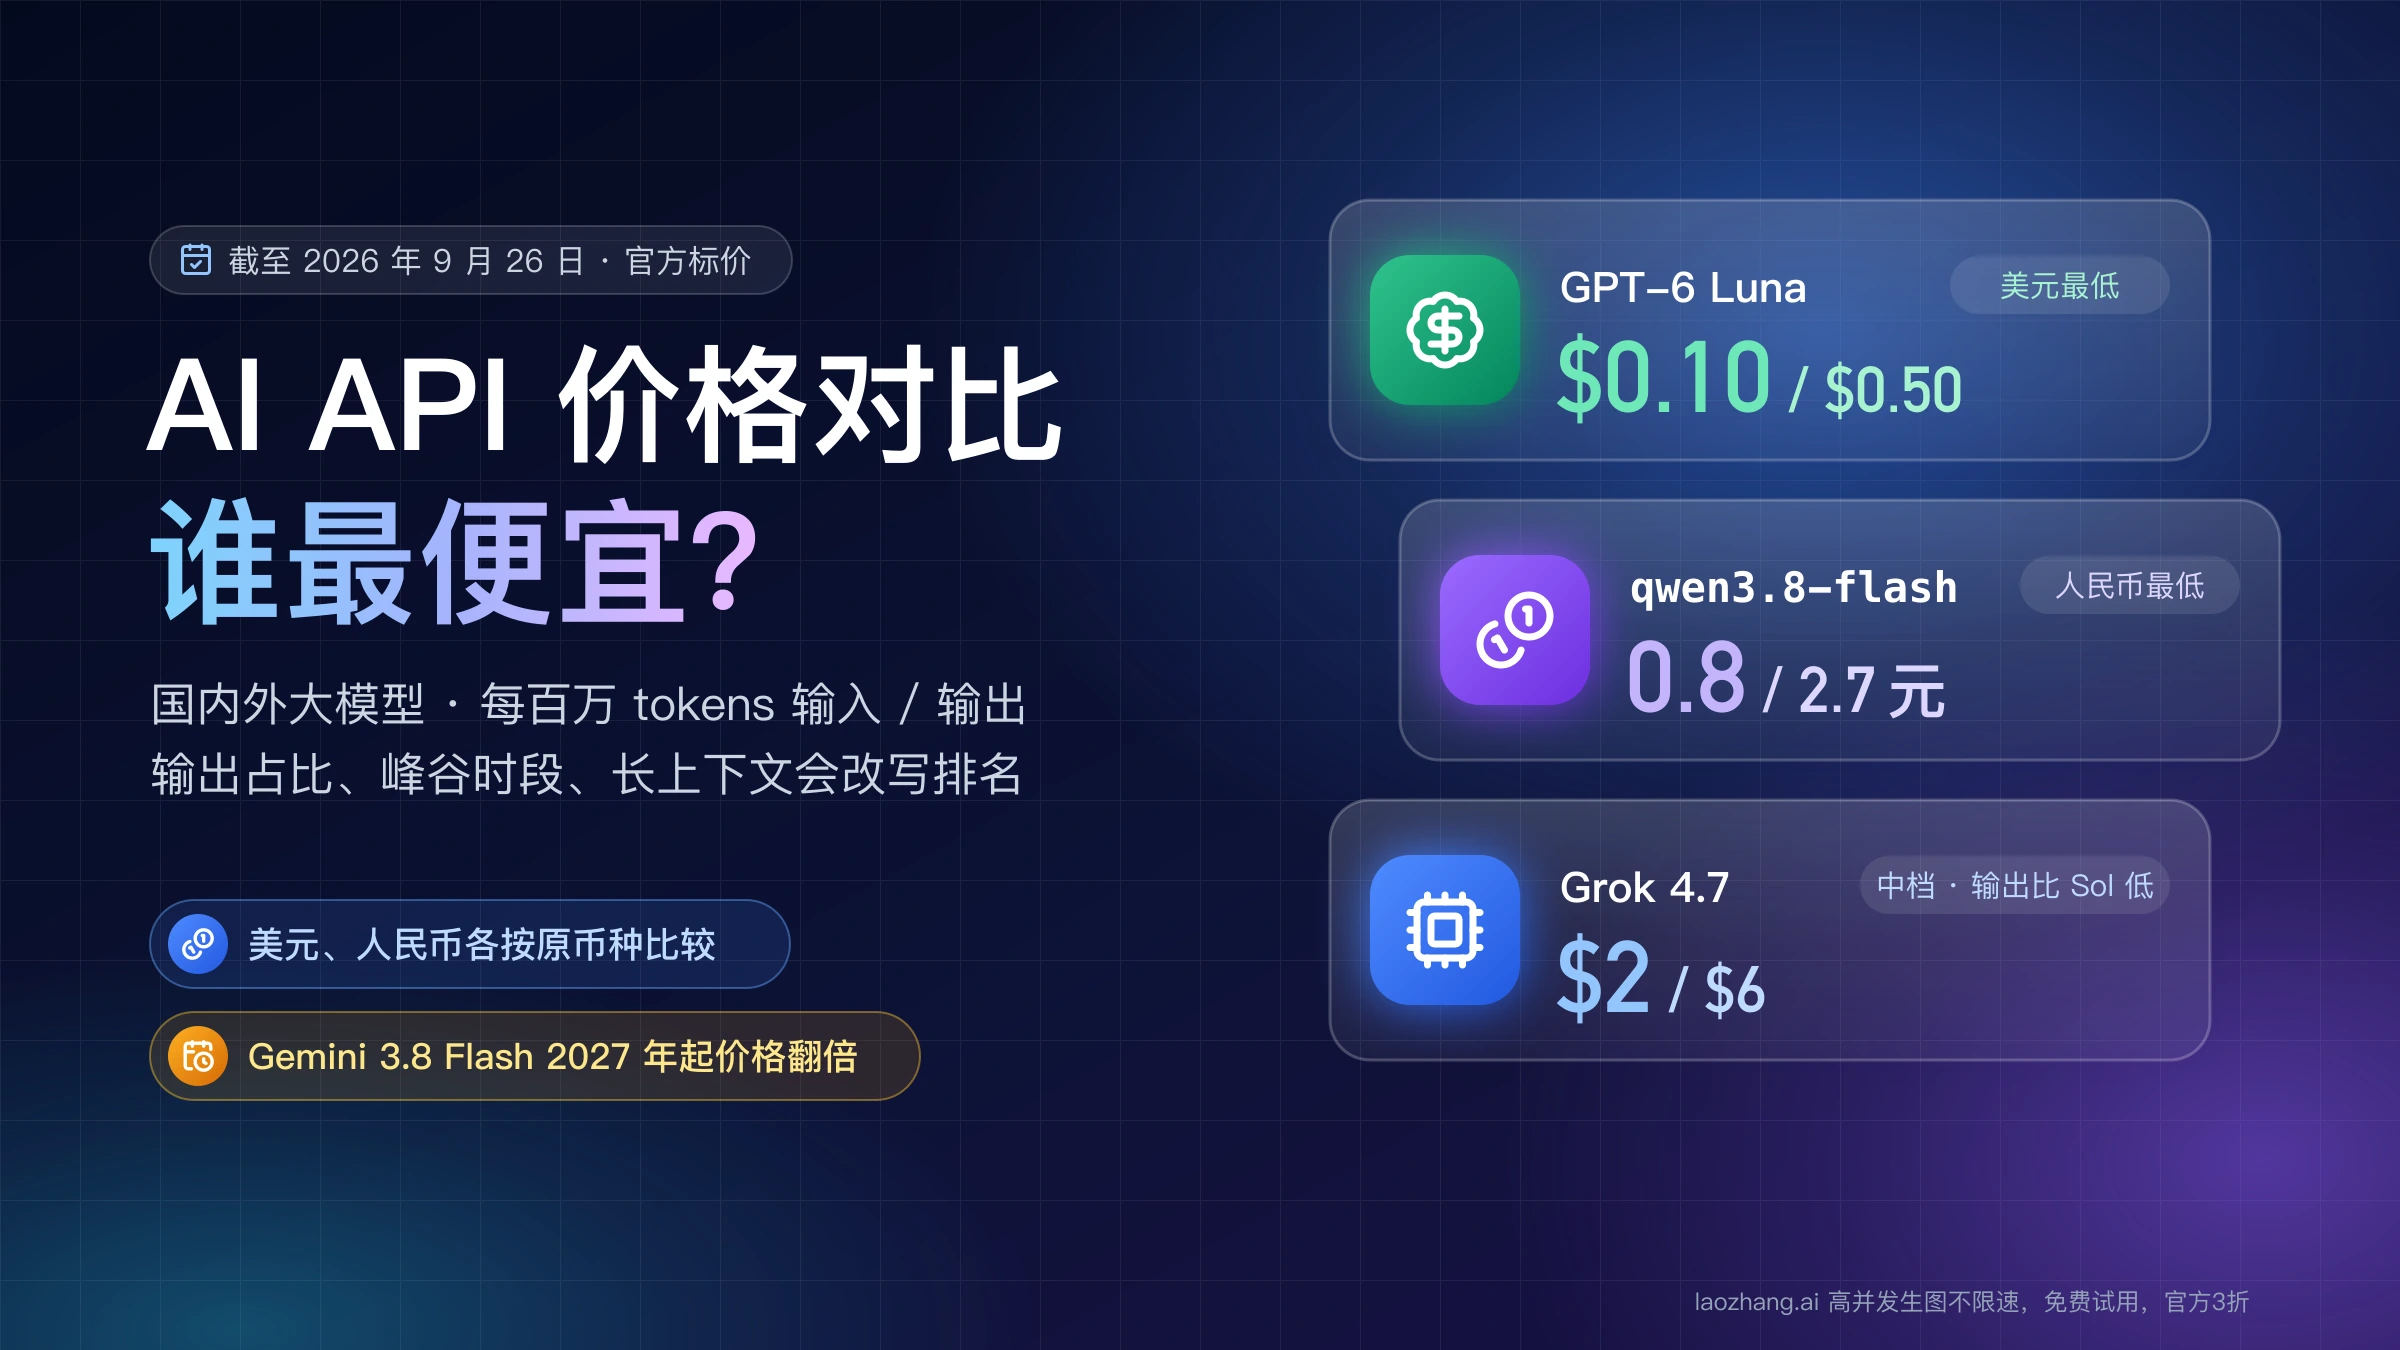
- 还想把国内模型和其他厂商一起算进来,看 AI API 价格对比:国内外大模型谁最便宜、月费怎么算。
常见问题
Claude API 和 OpenAI API 哪个更便宜?
低价档 OpenAI 更便宜:GPT-6 Luna 是 Claude Haiku 4.5 价格的十分之一。中档(GPT-6 Sol 对 Sonnet 5)和顶档(GPT-6 Astra 对 Fable 5.1)的短上下文标价相同,单次输入超过 272K 时 Claude 更便宜,顶档大量读缓存时 Fable 5.1 更便宜,其余情况下账单由 token 数和重试次数决定。
GPT-6 Sol 和 Claude Sonnet 5 标价一样,账单也会一样吗?
输入不超过 272K、token 数相同时,账单一样,连缓存命中价($0.20)和 5 分钟缓存写入价($2.50)都相同。实际账单会因为分词器计数不同、输出长短不同、重试次数不同而分开;输入超过 272K 时,Sol 整单变为 $4 / $15,Sonnet 5 仍是 $2 / $10。
Claude Opus 5.5 应该和 OpenAI 哪个型号比价?
OpenAI 没有同价型号。Opus 5.5 的 $4 / $20 是 Sol 的两倍、Astra 的五分之二。短上下文任务里,它比 Sol 贵的部分主要是未缓存输入和输出;输入超过 272K 后,Sol 按长上下文价计费,两者的单次费用会很接近。
缓存写入费要不要算进成本?
要算,尤其是缓存只被读一两次的场景。5 分钟档写入是输入价的 1.25 倍,按 Anthropic 的说明,读一次就能回本;1 小时档是 2 倍,要读两次才回本。只请求一次的内容写进缓存,只会多付写入费。