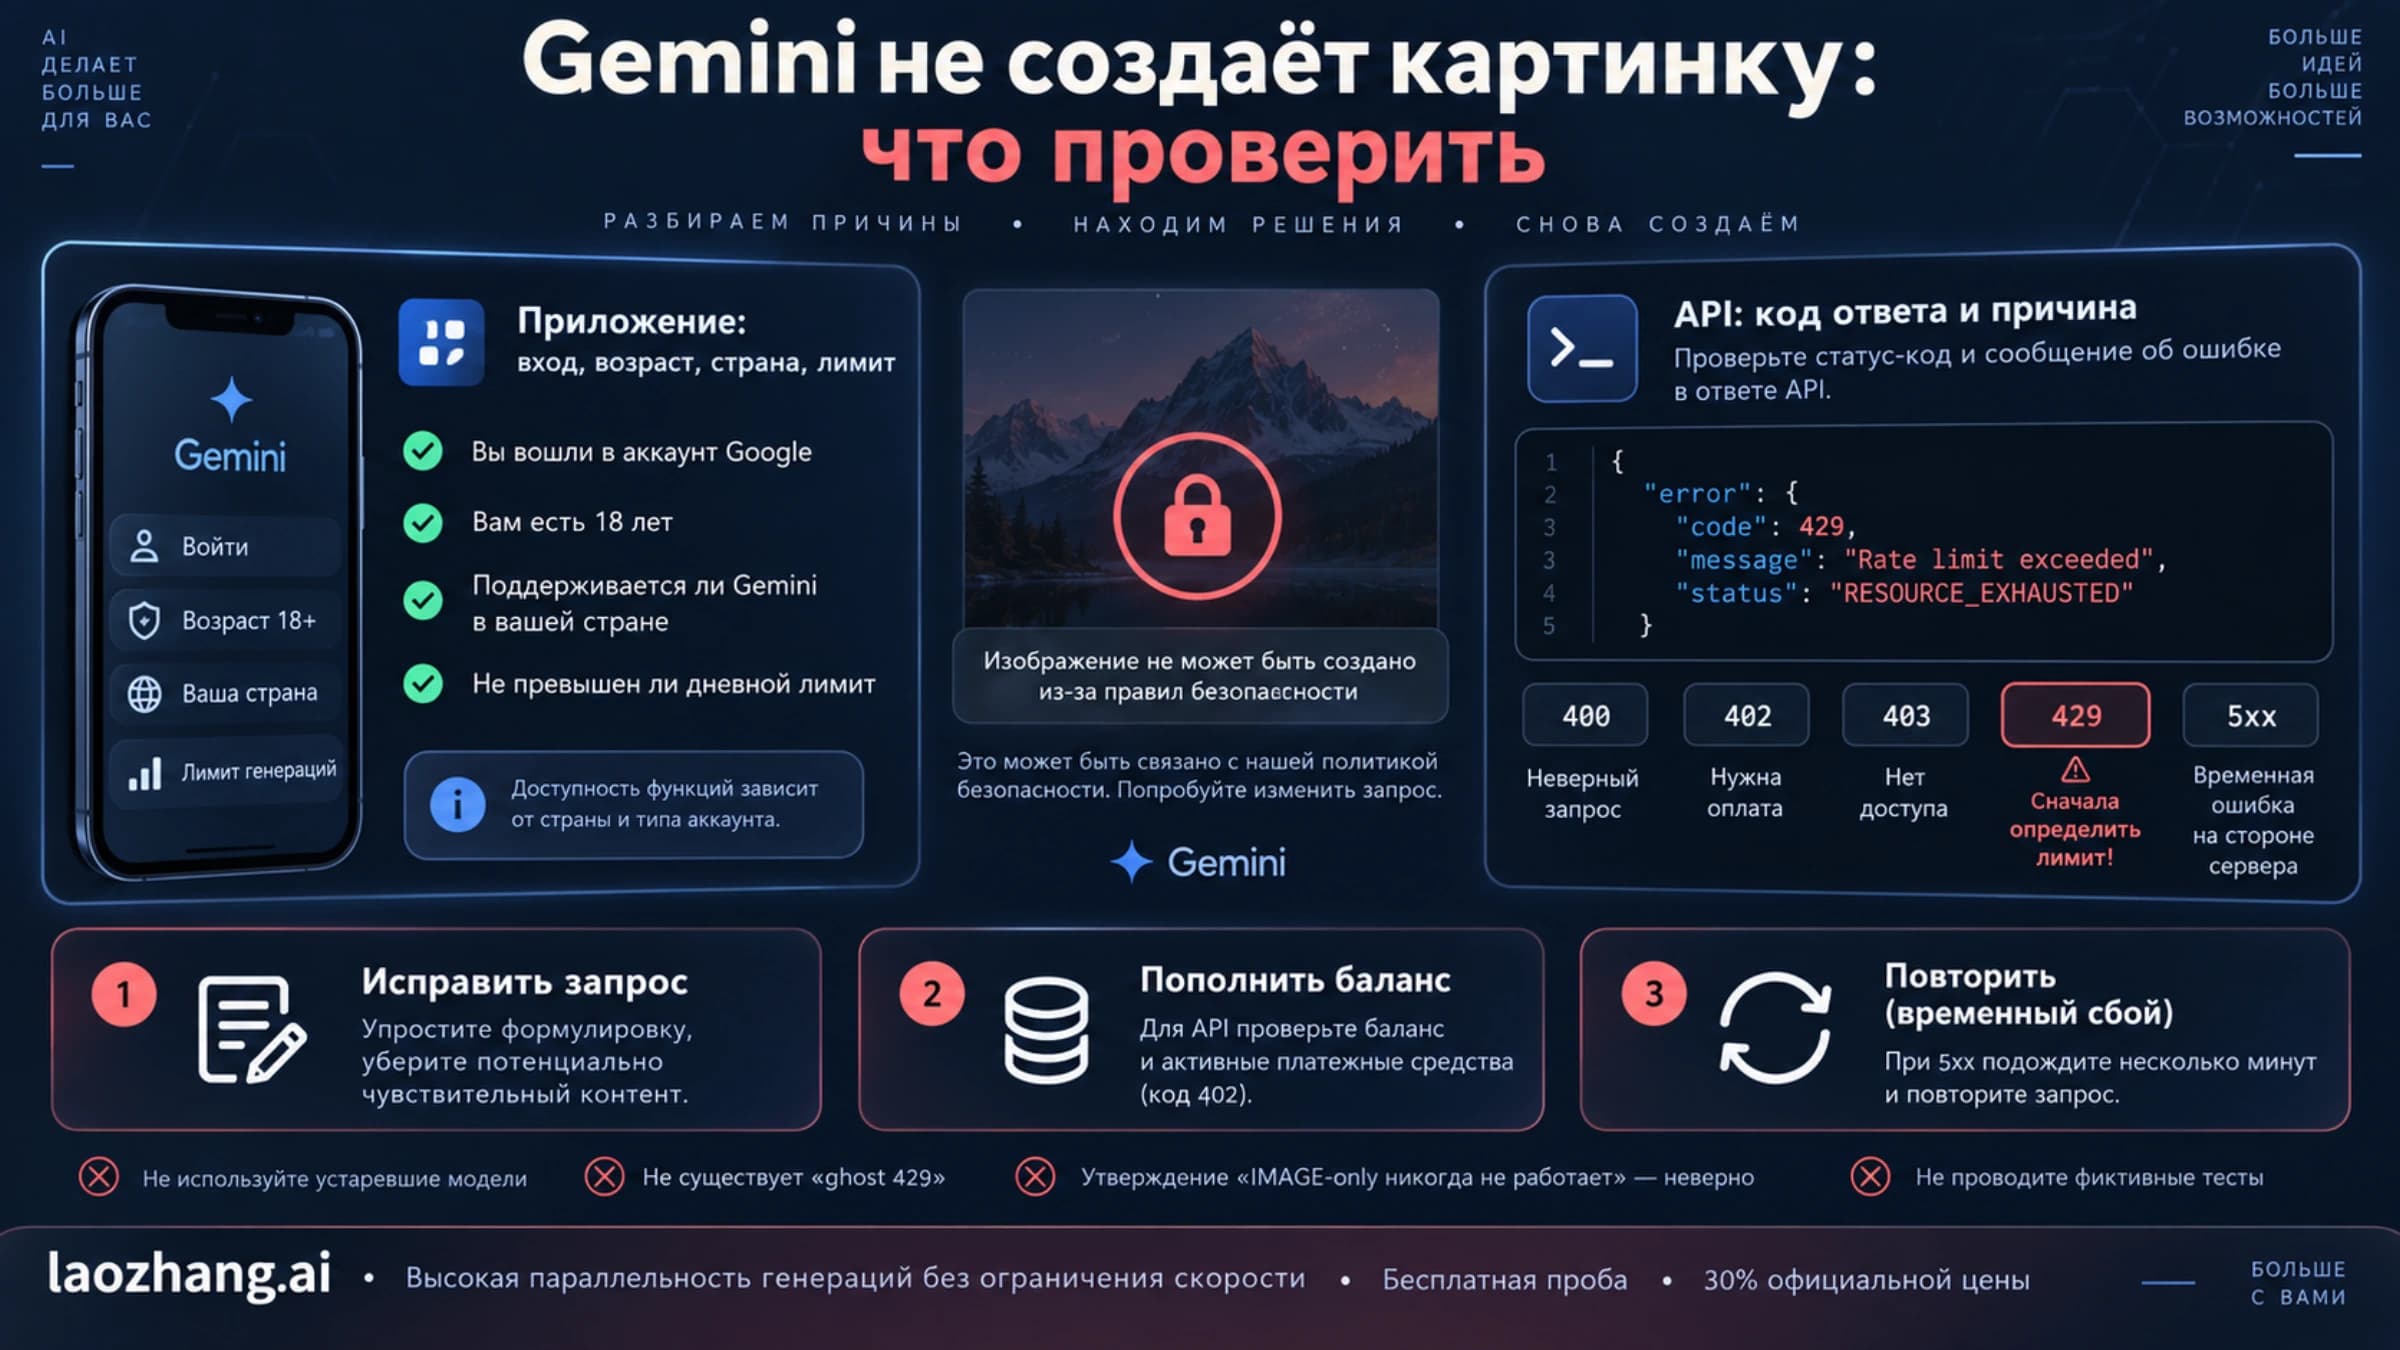
Nano Banana не генерирует изображение в API: как найти причину
Ответ пришёл, а картинки нет: причина в finishReason, promptFeedback или status. Текст вместо изображения исправляет запрос, IMAGE_SAFETY повтором не обойти.
Содержание
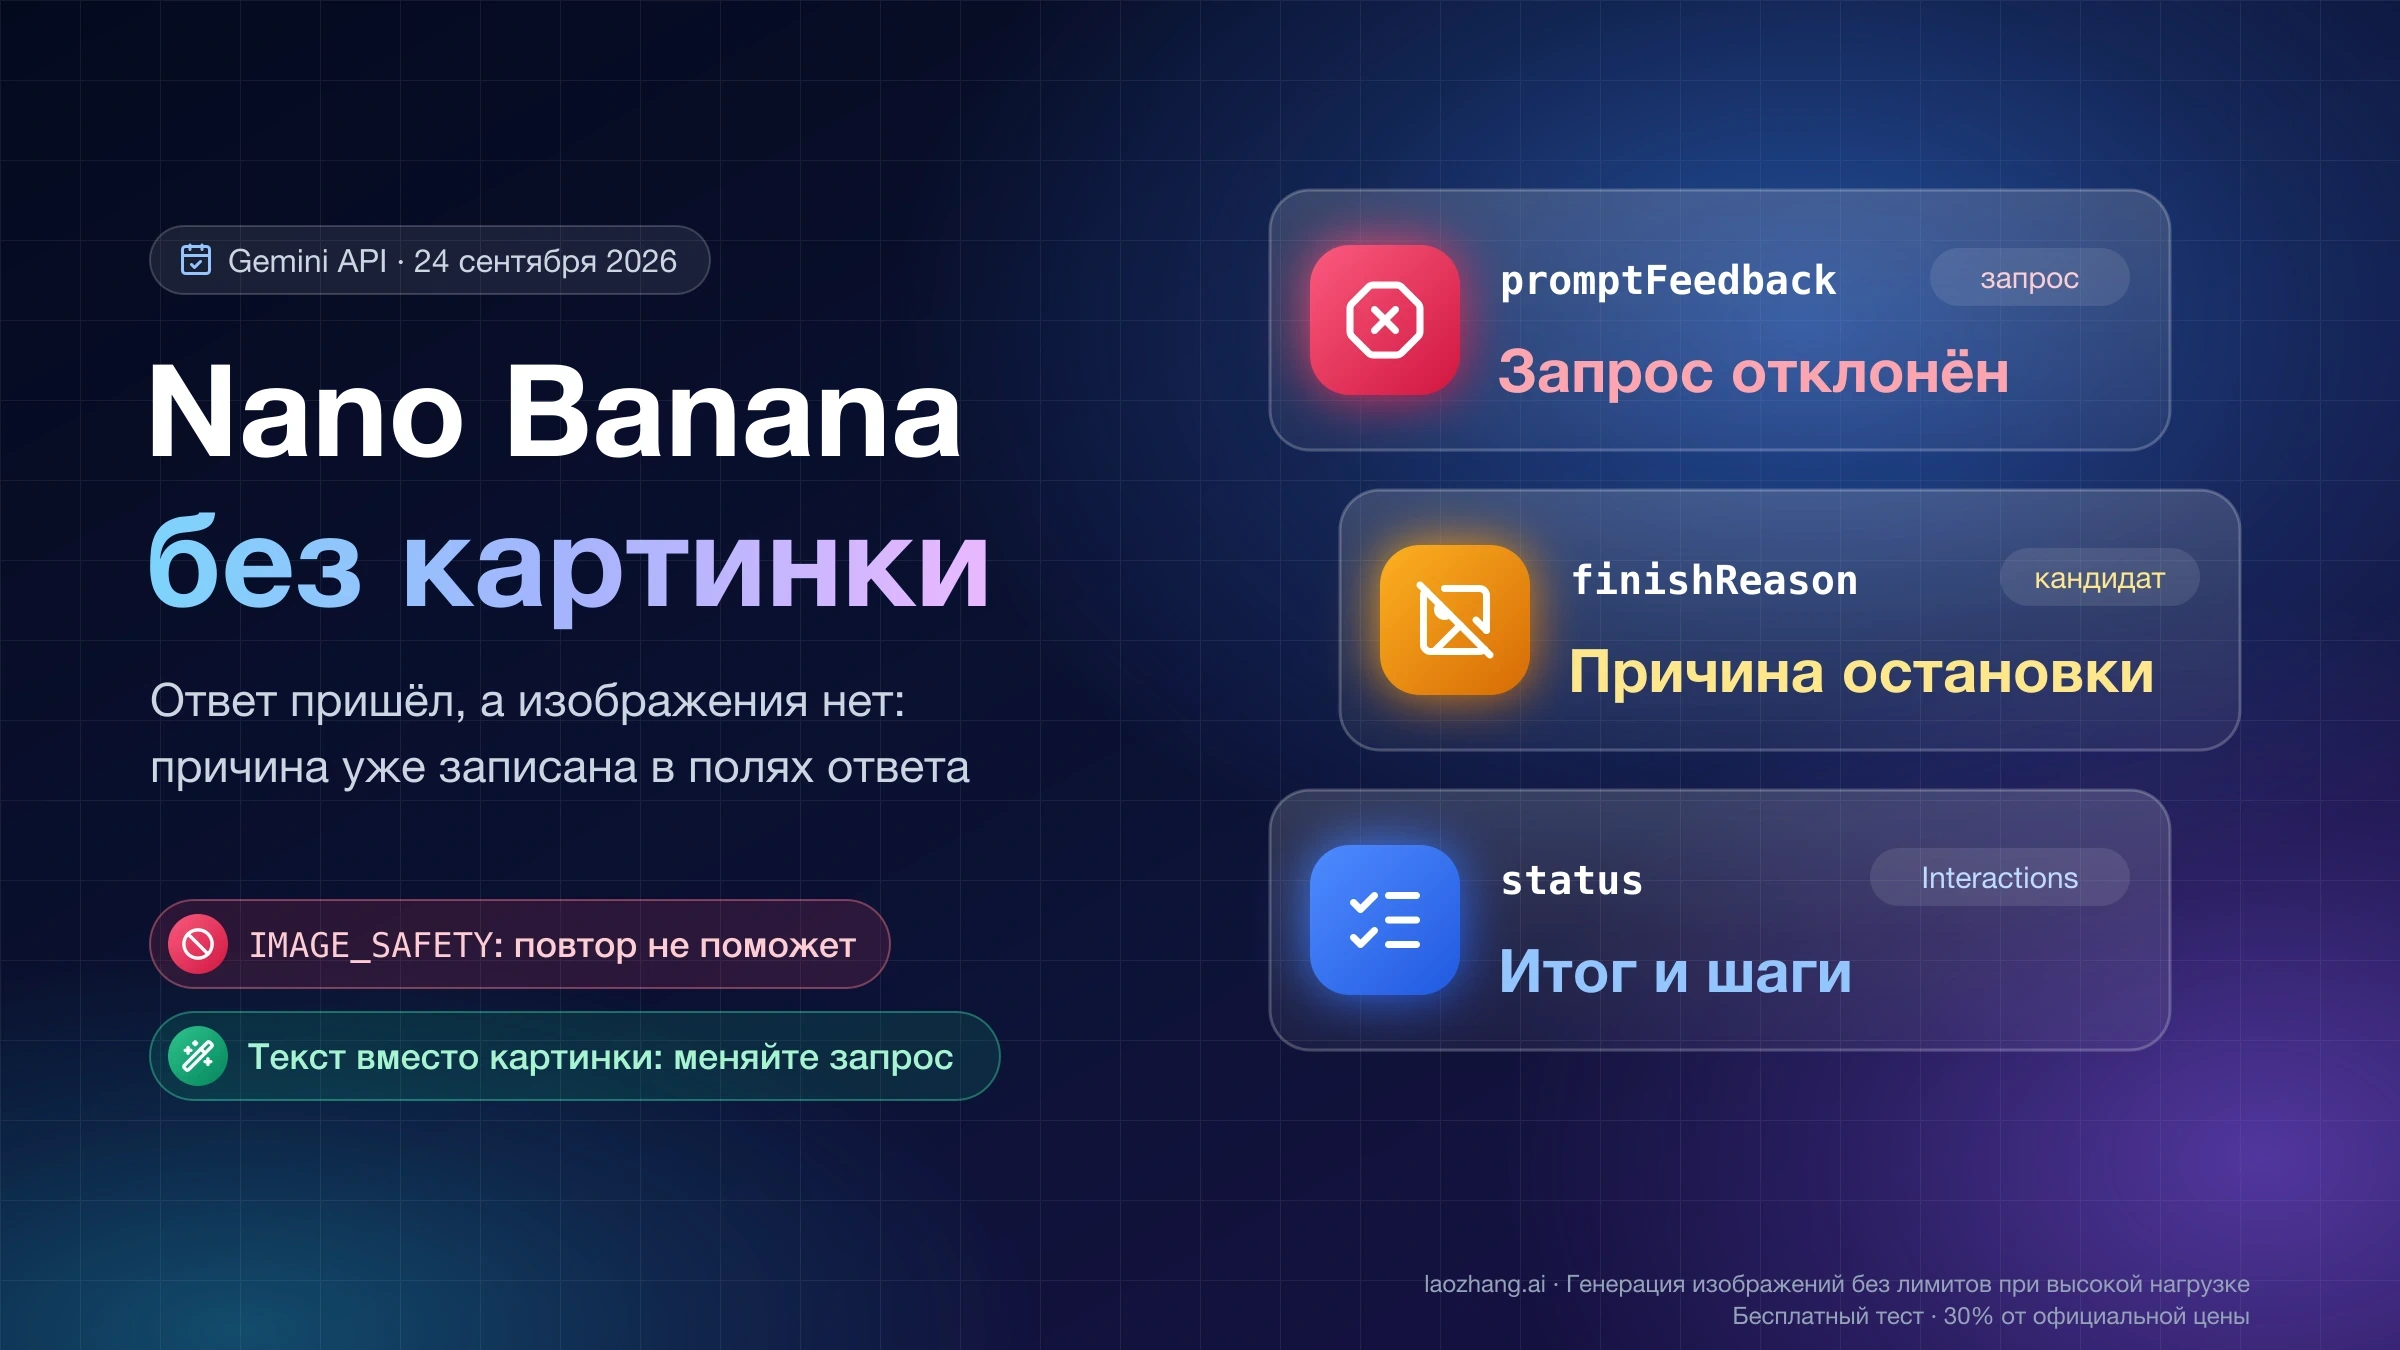
Если вызов Nano Banana завершился без ошибки, но изображения нет, ответ уже содержит причину. В generateContent она записана в promptFeedback.blockReason (запрос отклонён, candidates пуст) или в finishReason кандидата (NO_IMAGE, IMAGE_SAFETY, MAX_TOKENS и другие). В Interactions API смотрите status и шаги steps. От этого значения зависит всё остальное: текстовый ответ вместо картинки исправляется запросом и настройкой формата вывода, отказ IMAGE_SAFETY или PROHIBITED_CONTENT повтором того же запроса не обойти, а отключённый ID модели нужно заменить в коде.
По состоянию на 24 сентября 2026 года семейство Nano Banana в Gemini API — это gemini-3.1-flash-image (Nano Banana 2), gemini-3.1-flash-lite-image (Nano Banana 2 Lite), gemini-3-pro-image (Nano Banana Pro) и исходная gemini-2.5-flash-image, которую Google отключает 2 октября 2026 года (документация Google, график отключений). Всё ниже относится к API, AI Studio, официальным SDK и программам, которые вызывают API. Если картинка не появляется в приложении или на сайте Gemini, вам нужна другая инструкция: Nano Banana не работает в Gemini: 12 исправлений для ошибок изображения.
Что в ответе и что делать
Таблица читается слева направо: найдите в сохранённом JSON строку, которая совпадает с вашим ответом, и выполните одно действие из правой колонки.
| Что в ответе | Что это значит | Следующее действие |
|---|---|---|
candidates пуст, задан promptFeedback.blockReason | Запрос отклонён до генерации | Изменить текст или входные изображения; повтор без изменений бесполезен |
finishReason: STOP, в parts только текст | Модель ответила текстом | Прямо попросить изображение и задать responseModalities |
finishReason: NO_IMAGE | Изображение ожидалось, но не создано | Одна попытка с более прямым запросом, затем упростить сцену |
IMAGE_SAFETY, IMAGE_PROHIBITED_CONTENT | Созданное изображение заблокировано политикой | Менять содержание; настройки безопасности не помогут |
SAFETY, PROHIBITED_CONTENT, BLOCKLIST, SPII | Остановлено по безопасности, запрещённым терминам или персональным данным | Смотреть safetyRatings, убрать спорное из запроса |
IMAGE_RECITATION, RECITATION | Результат слишком похож на существующие данные | Сделать запрос и референсы уникальнее |
IMAGE_OTHER | Сбой без пояснения | Сохранить ответ, повторить один раз |
MAX_TOKENS | Не хватило лимита вывода | Убрать или поднять maxOutputTokens |
MISSING_THOUGHT_SIGNATURE | В многоходовом диалоге потеряна подпись | Передавать ответ модели в историю целиком |
Interactions: status: completed, в steps только текст | Модель ответила текстом | Задать response_format с типом image |
Interactions: incomplete или failed | Результат неполный или ошибка | Смотреть errors и лимит max_output_tokens |
| HTTP 4xx или 5xx вместо ответа | Это не пустой ответ, а ошибка запроса | Проверить ID модели, ключ, квоту |
| Картинка в JSON есть, но программа её не сохранила | Ошибка разбора ответа | Перебирать все части и пропускать промежуточные (thought) |
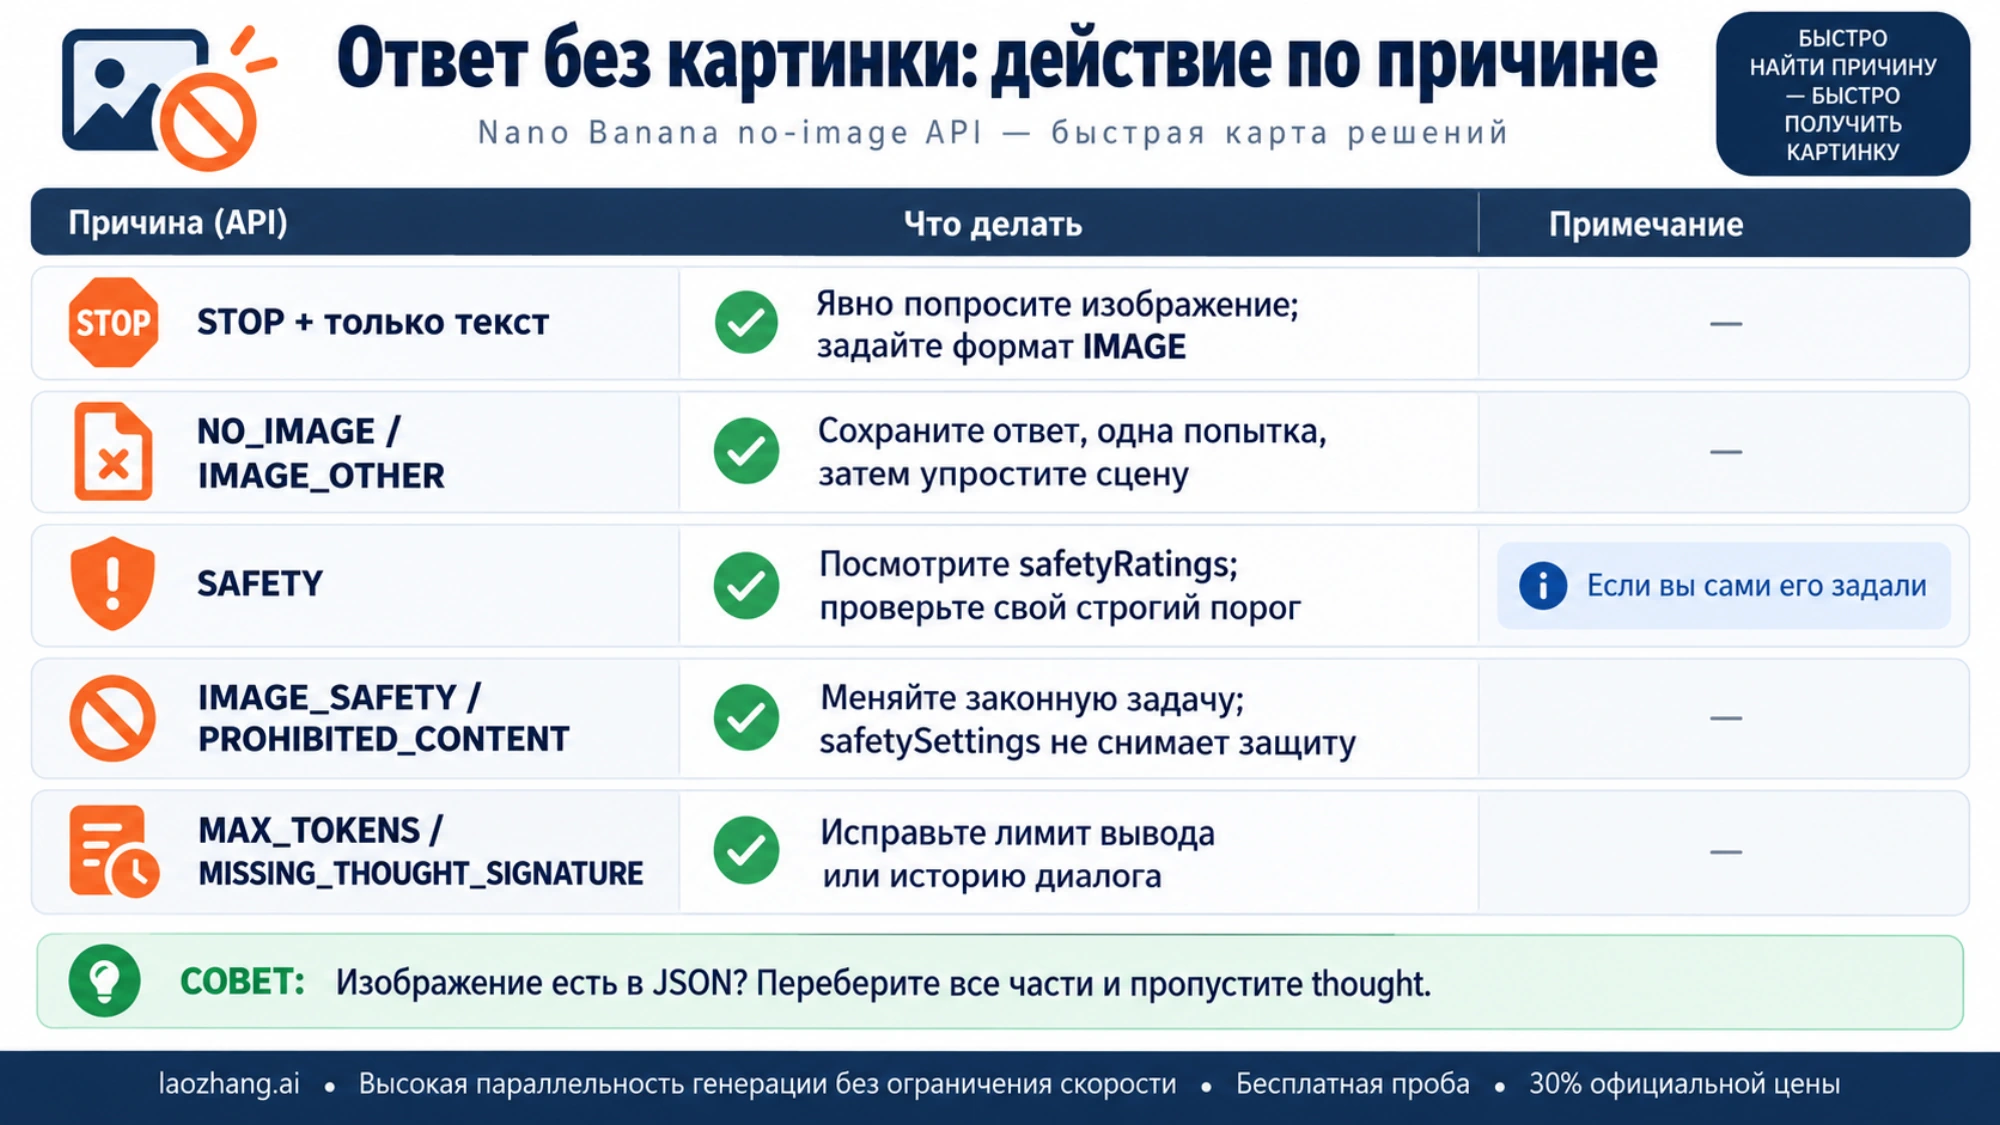
Значения finishReason и blockReason взяты из справочника generateContent, статусы — из справочника Interactions API. Ниже — подробности по каждой группе и скрипт, который выносит такой вердикт по файлу с ответом.
Сначала исключите отключённый ID модели
Если код работал весной и перестал, первым делом проверьте ID модели, а не промпт. Google отключил preview-версии, и вызов по такому ID возвращает ошибку, а не ответ без картинки. Точный текст этой ошибки в документации не приводится, поэтому ориентируйтесь на сам ID в вашем коде.
| ID модели | Название | Статус на 24 сентября 2026 года |
|---|---|---|
gemini-3.1-flash-image | Nano Banana 2 | Стабильная версия с 28 мая 2026 года, дата отключения не объявлена |
gemini-3-pro-image | Nano Banana Pro | Стабильная версия с 28 мая 2026 года, дата отключения не объявлена |
gemini-3.1-flash-lite-image | Nano Banana 2 Lite | Стабильная версия с 30 июня 2026 года |
gemini-2.5-flash-image | Nano Banana (исходная) | Отключается 2 октября 2026 года |
gemini-3.1-flash-image-preview | Nano Banana 2 (preview) | Отключена 25 июня 2026 года, замена gemini-3.1-flash-image |
gemini-3-pro-image-preview | Nano Banana Pro (preview) | Отключена 25 июня 2026 года, замена gemini-3-pro-image |
gemini-2.5-flash-image-preview | — | Отключена 15 января 2026 года |
gemini-2.0-flash-preview-image-generation | — | Отключена 14 ноября 2025 года |
Для gemini-2.5-flash-image таблица отключений до сих пор называет заменой уже отключённую gemini-3.1-flash-image-preview. На странице генерации изображений Google советует переходить на Nano Banana 2 Lite, а на странице цен — на gemini-3.1-flash-image или gemini-3.1-flash-lite-image. Берите стабильный ID без -preview; какой из трёх подходит под вашу задачу, разобрано в статье Nano Banana 2 vs Pro vs 2.1: что выбрать, если NB2 устарела.
Второе, что стоит проверить в старом коде, — библиотеку. Текущие примеры Google написаны на SDK google-genai (from google import genai в Python, @google/genai в JavaScript). С июня 2026 года Interactions API вышел в стабильную версию и рекомендован для новых проектов, а generateContent Google называет устаревшим (legacy), но полностью поддерживаемым (обзор Interactions API). Структура ответа у двух API разная, и путать их при разборе нельзя: у generateContent есть candidates, parts и finishReason, у Interactions — status и steps.
Ошибка 429 — отдельный симптом, связанный с квотами, а не с содержанием запроса; он разобран в статье Лимиты Nano Banana 2: сколько изображений в день в Gemini и API.
Разбор ответа generateContent
Успешный вызов возвращает GenerateContentResponse: массив candidates, где у каждого кандидата есть content.parts и finishReason, а также promptFeedback и usageMetadata. Изображение приходит частью с полем inlineData (mimeType вида image/png и данные в base64). Если такой части среди финальных нет, причину показывают поля ниже.
Пустой candidates: запрос отклонён
Справочник API прямо говорит: кандидатов нет только тогда, когда что-то не так с самим запросом, и тогда смотреть нужно promptFeedback. Возможные blockReason:
SAFETY— запрос остановлен по категории безопасности, подробности вpromptFeedback.safetyRatings;PROHIBITED_CONTENT— запрещённое содержание;BLOCKLIST— в запросе есть термины из списка запрещённых;IMAGE_SAFETY— заблокирована генерация небезопасного изображения;OTHER— причина не раскрывается.
Повторять тот же запрос без изменений нет смысла: решение принимается по его содержанию, включая входные изображения. Случаю blockReason: OTHER посвящено отдельное руководство — Nano Banana 2 blockReason OTHER: что значит ошибка и что делать.
STOP, но в ответе только текст
По документации модель по умолчанию возвращает и текст, и изображение, поэтому ответ из одной реплики вроде «Опишите, какой стиль вам нужен» формально корректен: finishReason равен STOP, ошибки нет. Два шага, которые стоит сделать:
- Сформулировать запрос как команду на создание картинки: «Сгенерируй изображение: …», а не «придумай» или «опиши». Русский (ru-RU) входит в список языков, на которых Google рекомендует работать с моделью, так что сам язык запроса причиной быть не должен.
- Задать формат вывода. В
generateContentэтоgenerationConfig.responseModalities:["IMAGE"], если текст не нужен, или["TEXT", "IMAGE"]. По справочнику значение должно точно совпадать с модальностями ответа, а неподдерживаемая комбинация вернёт ошибку.
from google import genai
from google.genai import types

client = genai.Client()
response = client.models.generate_content(
    model="gemini-3.1-flash-image",
    contents="Сгенерируй изображение: керамическая чашка на деревянном столе, мягкий утренний свет",
    config=types.GenerateContentConfig(response_modalities=["IMAGE"]),
)
Гарантии, что с ["IMAGE"] картинка будет всегда, документация не даёт: настройка ограничивает, в каком виде может прийти ответ, но вызов всё равно может закончиться NO_IMAGE или блокировкой. Если вы просили несколько изображений и получили одно, это описанное ограничение: модель не всегда выдаёт ровно столько картинок, сколько запрошено.
NO_IMAGE, IMAGE_OTHER и IMAGE_RECITATION
NO_IMAGE означает, что модель должна была создать изображение, но не создала. Причину справочник не уточняет. Разумно один раз повторить запрос в более прямой формулировке, а если ответ повторится — сократить сцену: меньше объектов, меньше референсов. У моделей есть пределы по входным изображениям: gemini-2.5-flash-image лучше всего работает максимум с тремя, gemini-3-pro-image — с пятью в высокой точности и до 14 всего, gemini-3.1-flash-image удерживает сходство до четырёх персонажей и до десяти объектов в одном сценарии.
IMAGE_OTHER — «прочая проблема» без подробностей. Сохраните ответ целиком, повторите вызов один раз; если результат тот же, упрощайте запрос так же, как при NO_IMAGE.
IMAGE_RECITATION значит, что генерация остановлена из-за сходства с существующими данными. Для обычного RECITATION в руководстве по устранению неполадок Google советует сделать промпт и контекст как можно более уникальными и поднять температуру. Для изображений логично начать с референсов: убрать узнаваемые чужие работы и описать собственную сцену.
Если finishMessage заполнено, прочитайте его: это поле поясняет причину остановки, но какой именно элемент запроса сработал, оно обычно не сообщает.
IMAGE_SAFETY и IMAGE_PROHIBITED_CONTENT: почему настройки безопасности не помогут
IMAGE_SAFETY означает, что созданное изображение нарушает правила безопасности, а IMAGE_PROHIBITED_CONTENT — что в нём другое запрещённое содержание. Снять это через safetySettings нельзя, и причина видна в документации по настройкам безопасности:
- настраиваются только четыре категории: домогательства (harassment), язык вражды (hate speech), откровенно сексуальное содержание (sexually explicit) и опасный контент (dangerous);
- если порог не задан, для моделей Gemini 2.5 и 3 он уже выключен (
OFF), так чтоBLOCK_NONEничего не ослабляет; - защита от основных видов вреда, например угроз безопасности детей, работает всегда и не настраивается;
- в Interactions API пользовательских настроек безопасности нет вообще.
Настройки имеют значение в одном случае: если вы сами поставили более строгий порог (например, BLOCK_LOW_AND_ABOVE), и ответ остановлен с SAFETY. Тогда safetyRatings покажут категорию и вероятность, а возврат порога к значению по умолчанию уберёт эту блокировку.
При IMAGE_SAFETY и IMAGE_PROHIBITED_CONTENT одинаковый запрос даёт одинаковый исход, поэтому циклы повторов в коде только тратят время и токены. Менять нужно то, что изображается, а не подбирать синонимы к тому же сюжету. В AI Studio такой отказ выглядит как надпись Content blocked; если навести на неё курсор, появятся категория и вероятность.
MAX_TOKENS и MISSING_THOUGHT_SIGNATURE
Изображение тоже расходует токены вывода. По прайсу Google картинка Nano Banana 2 в 1K занимает 1 120 токенов, в 4K — 2 520. Если в generationConfig задан небольшой maxOutputTokens, изображение может в него не поместиться, и ответ закончится MAX_TOKENS. Уберите ограничение или поднимите его с запасом.
MISSING_THOUGHT_SIGNATURE появляется при многоходовом редактировании, когда в историю диалога не вернули подписи thought_signature из прошлых ответов. Официальные SDK в режиме чата передают их сами; если историю вы собираете вручную, добавляйте ответ модели в неё целиком. Подробный разбор — в статье Ошибка Thought Signature в Nano Banana 2: полное руководство по исправлению (2026).
Разбор ответа Interactions API
У Interactions API нет candidates и finishReason. Ответ — объект interaction с полем status и массивом steps. Значения status:
| status | Что означает |
|---|---|
completed | Interaction завершён |
incomplete | Завершён, но результат неполный (например, достигнут max_tokens) |
failed | Завершился ошибкой |
in_progress, queued | Ещё выполняется или ждёт очереди |
requires_action | Требуется действие или ввод со стороны пользователя |
cancelled | Отменён |
Финальные изображения лежат в шагах type: "model_output" как блоки content с type: "image", data и mime_type. Шаги type: "thought" содержат промежуточные наброски в поле summary. Удобное свойство interaction.output_image из SDK возвращает только последний блок изображения; для ответов, где текст и картинки чередуются, Google прямо рекомендует перебирать steps вручную.
Если status равен completed, а изображений в model_output нет, это тот же текстовый ответ, что и выше. Формат вывода задаётся в response_format: объект {"type": "image"} оставляет только изображение (там же можно указать aspect_ratio и image_size), массив из {"type": "text"} и {"type": "image"} запрашивает и текст, и картинку.
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-3.1-flash-image",
    input="Сгенерируй изображение: керамическая чашка на деревянном столе, мягкий утренний свет",
    response_format={"type": "image", "aspect_ratio": "1:1"},
)
print(interaction.status)
При failed смотрите массив errors (в каждом элементе есть code и message). Как в Interactions API выглядит именно блокировка изображения политикой, в опубликованной документации не описано. Поэтому сохраняйте весь объект interaction, а если нужен конкретный finishReason, отправьте тот же запрос через generateContent: он по-прежнему полностью поддерживается и возвращает причину остановки в явном виде.
Картинка в ответе есть, а программа её не видит
Модели Gemini 3 для изображений всегда «думают», и в API это не отключается. По документации модель создаёт до двух промежуточных изображений, чтобы проверить композицию; последнее из них совпадает с финальной картинкой. В generateContent такие части помечены thought: true и возвращаются, только если включён includeThoughts. В Interactions API они лежат в шагах thought.
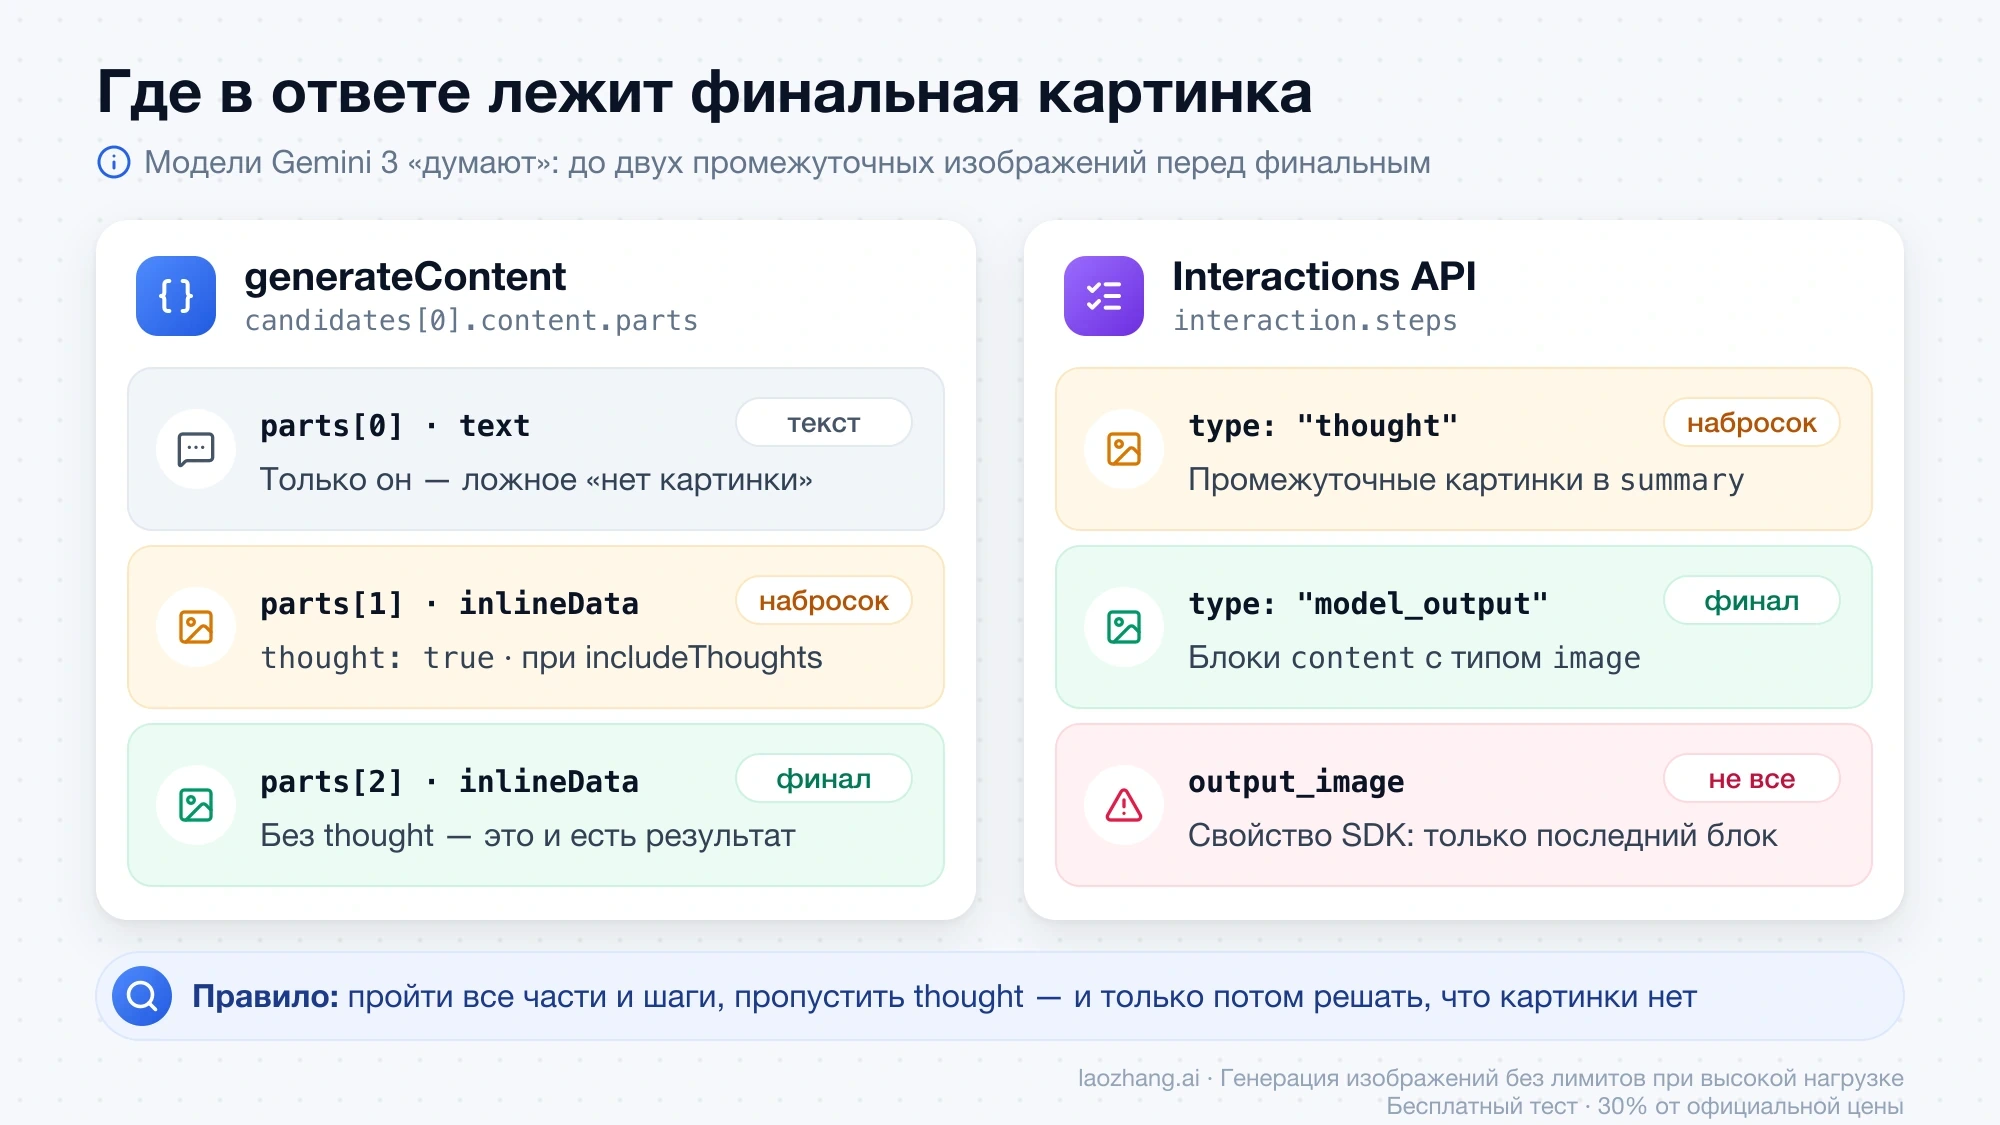
Из этого следует несколько типичных ошибок разбора (это вывод из структуры ответа, а не описанные Google сбои):
- код читает только
parts[0], а там текст — и сообщает «картинки нет», хотя она в следующей части; - код берёт первое найденное изображение и при включённом
includeThoughtsсохраняет набросок, а не финальный результат; - код полагается на
output_imageв ответе, где картинок несколько, и теряет все, кроме последней; - программа поверх API показывает только текст ответа и не выводит изображение, хотя оно в JSON есть.
Правило простое: прежде чем решить, что изображения нет, пройдите по всем частям всех кандидатов (или по всем шагам interaction), пропустите помеченные как мысли и только потом делайте вывод. Именно так устроен скрипт ниже.
Скрипт: вердикт по сохранённому ответу
Скрипт на Python 3 без внешних зависимостей читает JSON-файл с ответом, определяет, какой это API, и печатает вердикт, подсказку, число финальных и промежуточных изображений и поля расхода токенов. Если передать второй аргумент — папку, он сохранит найденные финальные изображения.
Как получить файл с ответом:
- REST: добавьте к вызову
curlпараметр-o response.json; - Python SDK
google-genai:open("response.json", "w").write(response.model_dump_json(exclude_none=True)). SDK выгружает поля в snake_case (finish_reason,inline_data), а байты изображения — в URL-safe base64; скрипт понимает оба варианта.
#!/usr/bin/env python3
"""Разбор сохранённого ответа Nano Banana: есть ли изображение и что делать дальше.

Вход: JSON-файл с ответом generateContent или Interactions API
(сырой REST или выгрузка объекта SDK, camelCase и snake_case).
Выход: вердикт, подсказка, число изображений, поля usage.
Код возврата: 0 — финальное изображение есть, 1 — нет, 2 — файл не разобран.
"""
import base64
import json
import pathlib
import re
import sys

HINTS = {
    "TEXT_ONLY": "Модель ответила текстом. Попросите изображение явно и ограничьте вывод форматом IMAGE.",
    "NO_IMAGE": "Изображение ожидалось, но не создано. Одна попытка с более прямым запросом, затем упростите сцену.",
    "IMAGE_SAFETY": "Политика Google заблокировала сгенерированное изображение. Меняйте содержание, повтор не поможет.",
    "IMAGE_PROHIBITED_CONTENT": "Запрещённое содержание в изображении. Меняйте тему, повтор не поможет.",
    "IMAGE_RECITATION": "Результат слишком похож на существующие данные. Сделайте запрос и референсы уникальнее.",
    "IMAGE_OTHER": "Сбой без уточнения. Сохраните ответ, повторите один раз, затем упростите запрос.",
    "SAFETY": "Блокировка по категории безопасности. Смотрите safetyRatings и свои safetySettings.",
    "PROHIBITED_CONTENT": "Запрещённое содержание. Меняйте тему, повтор не поможет.",
    "BLOCKLIST": "Сработал список запрещённых терминов. Уберите их из запроса.",
    "SPII": "В ответе могли оказаться персональные данные. Уберите их из запроса.",
    "RECITATION": "Результат похож на существующие данные. Сделайте запрос уникальнее.",
    "MAX_TOKENS": "Не хватило лимита токенов. Уберите или увеличьте maxOutputTokens.",
    "MISSING_THOUGHT_SIGNATURE": "В истории диалога потеряны thought signature. Передавайте ответ модели целиком.",
    "PROMPT_BLOCKED": "Запрос отклонён до генерации, кандидатов нет. Меняйте текст или входные изображения.",
    "EMPTY": "Ни изображения, ни причины. Сохраните сырой ответ и повторите один раз.",
    "FAILED": "Interaction завершился ошибкой. Смотрите errors и шаги.",
    "INCOMPLETE": "Результат неполный (например, лимит токенов). Проверьте max_output_tokens.",
    "NOT_FINISHED": "Interaction ещё не завершён. Дождитесь статуса completed.",
    "HTTP_ERROR": "Запрос не выполнен. Проверьте ID модели, ключ и квоту.",
}


def snake(key):
    return re.sub(r"(?<!^)(?=[A-Z])", "_", key).lower()


def norm(obj):
    """Приводит ключи к snake_case, чтобы REST и SDK читались одинаково."""
    if isinstance(obj, dict):
        return {snake(k): norm(v) for k, v in obj.items()}
    if isinstance(obj, list):
        return [norm(v) for v in obj]
    return obj


def check_generate_content(r):
    usage = r.get("usage_metadata", {})
    cands = r.get("candidates") or []
    if not cands:
        reason = (r.get("prompt_feedback") or {}).get("block_reason")
        return ("PROMPT_BLOCKED", reason) if reason else ("EMPTY", None), [], 0, usage
    final, thought, has_text = [], 0, False
    finish = message = None
    for c in cands:
        finish = finish or c.get("finish_reason")
        message = message or c.get("finish_message")
        for p in (c.get("content") or {}).get("parts") or []:
            blob = p.get("inline_data") or {}
            if str(blob.get("mime_type", "")).startswith("image/"):
                if p.get("thought"):
                    thought += 1
                else:
                    final.append(blob)
            elif p.get("text") and not p.get("thought"):
                has_text = True
    if final:
        return ("OK", finish), final, thought, usage
    if finish in (None, "STOP"):
        return ("TEXT_ONLY" if has_text else "EMPTY", finish), [], thought, usage
    return (finish, message), [], thought, usage


def check_interaction(r):
    usage = r.get("usage", {})
    status = r.get("status")
    final, thought, has_text = [], 0, False
    for step in r.get("steps") or []:
        if step.get("type") == "model_output":
            for block in step.get("content") or []:
                if block.get("type") == "image":
                    final.append(block)
                elif block.get("type") == "text":
                    has_text = True
        elif step.get("type") == "thought":
            thought += sum(1 for b in step.get("summary") or [] if b.get("type") == "image")
    if final:
        return ("OK", status), final, thought, usage
    errors = "; ".join(e.get("message", "") for e in r.get("errors") or [])
    if status == "failed":
        return ("FAILED", errors or None), [], thought, usage
    if status == "incomplete":
        return ("INCOMPLETE", None), [], thought, usage
    if status in ("in_progress", "queued", "requires_action"):
        return ("NOT_FINISHED", status), [], thought, usage
    return ("TEXT_ONLY" if has_text else "EMPTY", status), [], thought, usage


def main(path, save_dir=None):
    try:
        r = norm(json.loads(pathlib.Path(path).read_text(encoding="utf-8")))
    except (OSError, ValueError) as exc:
        print(f"Не удалось прочитать JSON: {exc}")
        return 2
    if "error" in r:
        e = r["error"]
        print(f"verdict: HTTP_ERROR ({e.get('code')} {e.get('status', '')})")
        print(f"hint: {HINTS['HTTP_ERROR']}")
        return 1
    if "steps" in r or r.get("object") == "interaction":
        api, check = "interactions", check_interaction
    elif "candidates" in r or "prompt_feedback" in r:
        api, check = "generateContent", check_generate_content
    else:
        print("Это не похоже на ответ generateContent или Interactions API.")
        return 2
    (verdict, detail), final, thought, usage = check(r)
    print(f"api: {api}")
    print(f"verdict: {verdict}" + (f" ({detail})" if detail else ""))
    if verdict != "OK":
        print(f"hint: {HINTS.get(verdict, 'Новое значение: сохраните ответ и сверьтесь со справочником API.')}")
    print(f"final images: {len(final)}, thought images: {thought}")
    print(f"usage: {json.dumps(usage, ensure_ascii=False)}")
    if save_dir and final:
        out = pathlib.Path(save_dir)
        out.mkdir(parents=True, exist_ok=True)
        for i, img in enumerate(final, 1):
            ext = str(img.get("mime_type", "image/png")).split("/")[-1]
            data = img.get("data", "").replace("-", "+").replace("_", "/")  # SDK пишет URL-safe base64
            (out / f"image_{i}.{ext}").write_bytes(base64.b64decode(data))
        print(f"saved: {len(final)} -> {out}")
    return 0 if final else 1


if __name__ == "__main__":
    if len(sys.argv) not in (2, 3):
        print("Использование: python3 check_nb_response.py response.json [папка_для_картинок]")
        sys.exit(2)
    sys.exit(main(*sys.argv[1:]))
Запуск и пример вывода для ответа, где изображение заблокировано:
python3 check_nb_response.py response.json ./outapi: generateContent
verdict: IMAGE_SAFETY (пример finishMessage)
hint: Политика Google заблокировала сгенерированное изображение. Меняйте содержание, повтор не поможет.
final images: 0, thought images: 0
usage: {"prompt_token_count": 18, "candidates_token_count": 12, "thoughts_token_count": 240, "total_token_count": 270, "candidates_tokens_details": [{"modality": "TEXT", "token_count": 12}]}Код возврата удобно использовать в пайплайне: 0 — финальное изображение найдено (и сохранено, если указана папка), 1 — изображения нет, 2 — файл не разобран. Неизвестные значения finishReason скрипт не пытается угадать, а печатает как есть: список причин в API пополняется.
Скрипт проверен офлайн на 16 синтетических JSON-файлах, а не на живых запросах к Google. В набор вошли ответы generateContent в формате REST (camelCase) и в выгрузке SDK google-genai 1.65.0 (snake_case), ответы Interactions API со статусами completed, failed и incomplete, тело ошибки 404 и повреждённый файл. Все 16 случаев дали ожидаемый вердикт и код возврата, изображения из ответов с картинкой сохранились как корректные PNG. Структура файлов повторяет схемы из справочников Google, но значения в них, включая finishMessage и числа токенов, придуманы для теста — в реальных ответах тексты будут другими.
Сколько стоит вызов без изображения
Google публикует цены за токены по типу вывода, но не пишет, как тарифицируется ответ, в котором изображение заблокировано или не создано. Ни правила «платите полную цену картинки», ни правила «такой вызов бесплатен» в прайсе Gemini API нет. Проверяемая опора — поля расхода в самом ответе: usageMetadata в generateContent и usage в Interactions API.
| Тариф Standard, за 1 млн токенов | Nano Banana 2 (gemini-3.1-flash-image) | Nano Banana Pro (gemini-3-pro-image) |
|---|---|---|
| Ввод (текст и изображения) | $0,50 | $2 |
| Вывод: текст и мышление | $3 | $12 |
| Вывод: изображения | $60 | $120 |
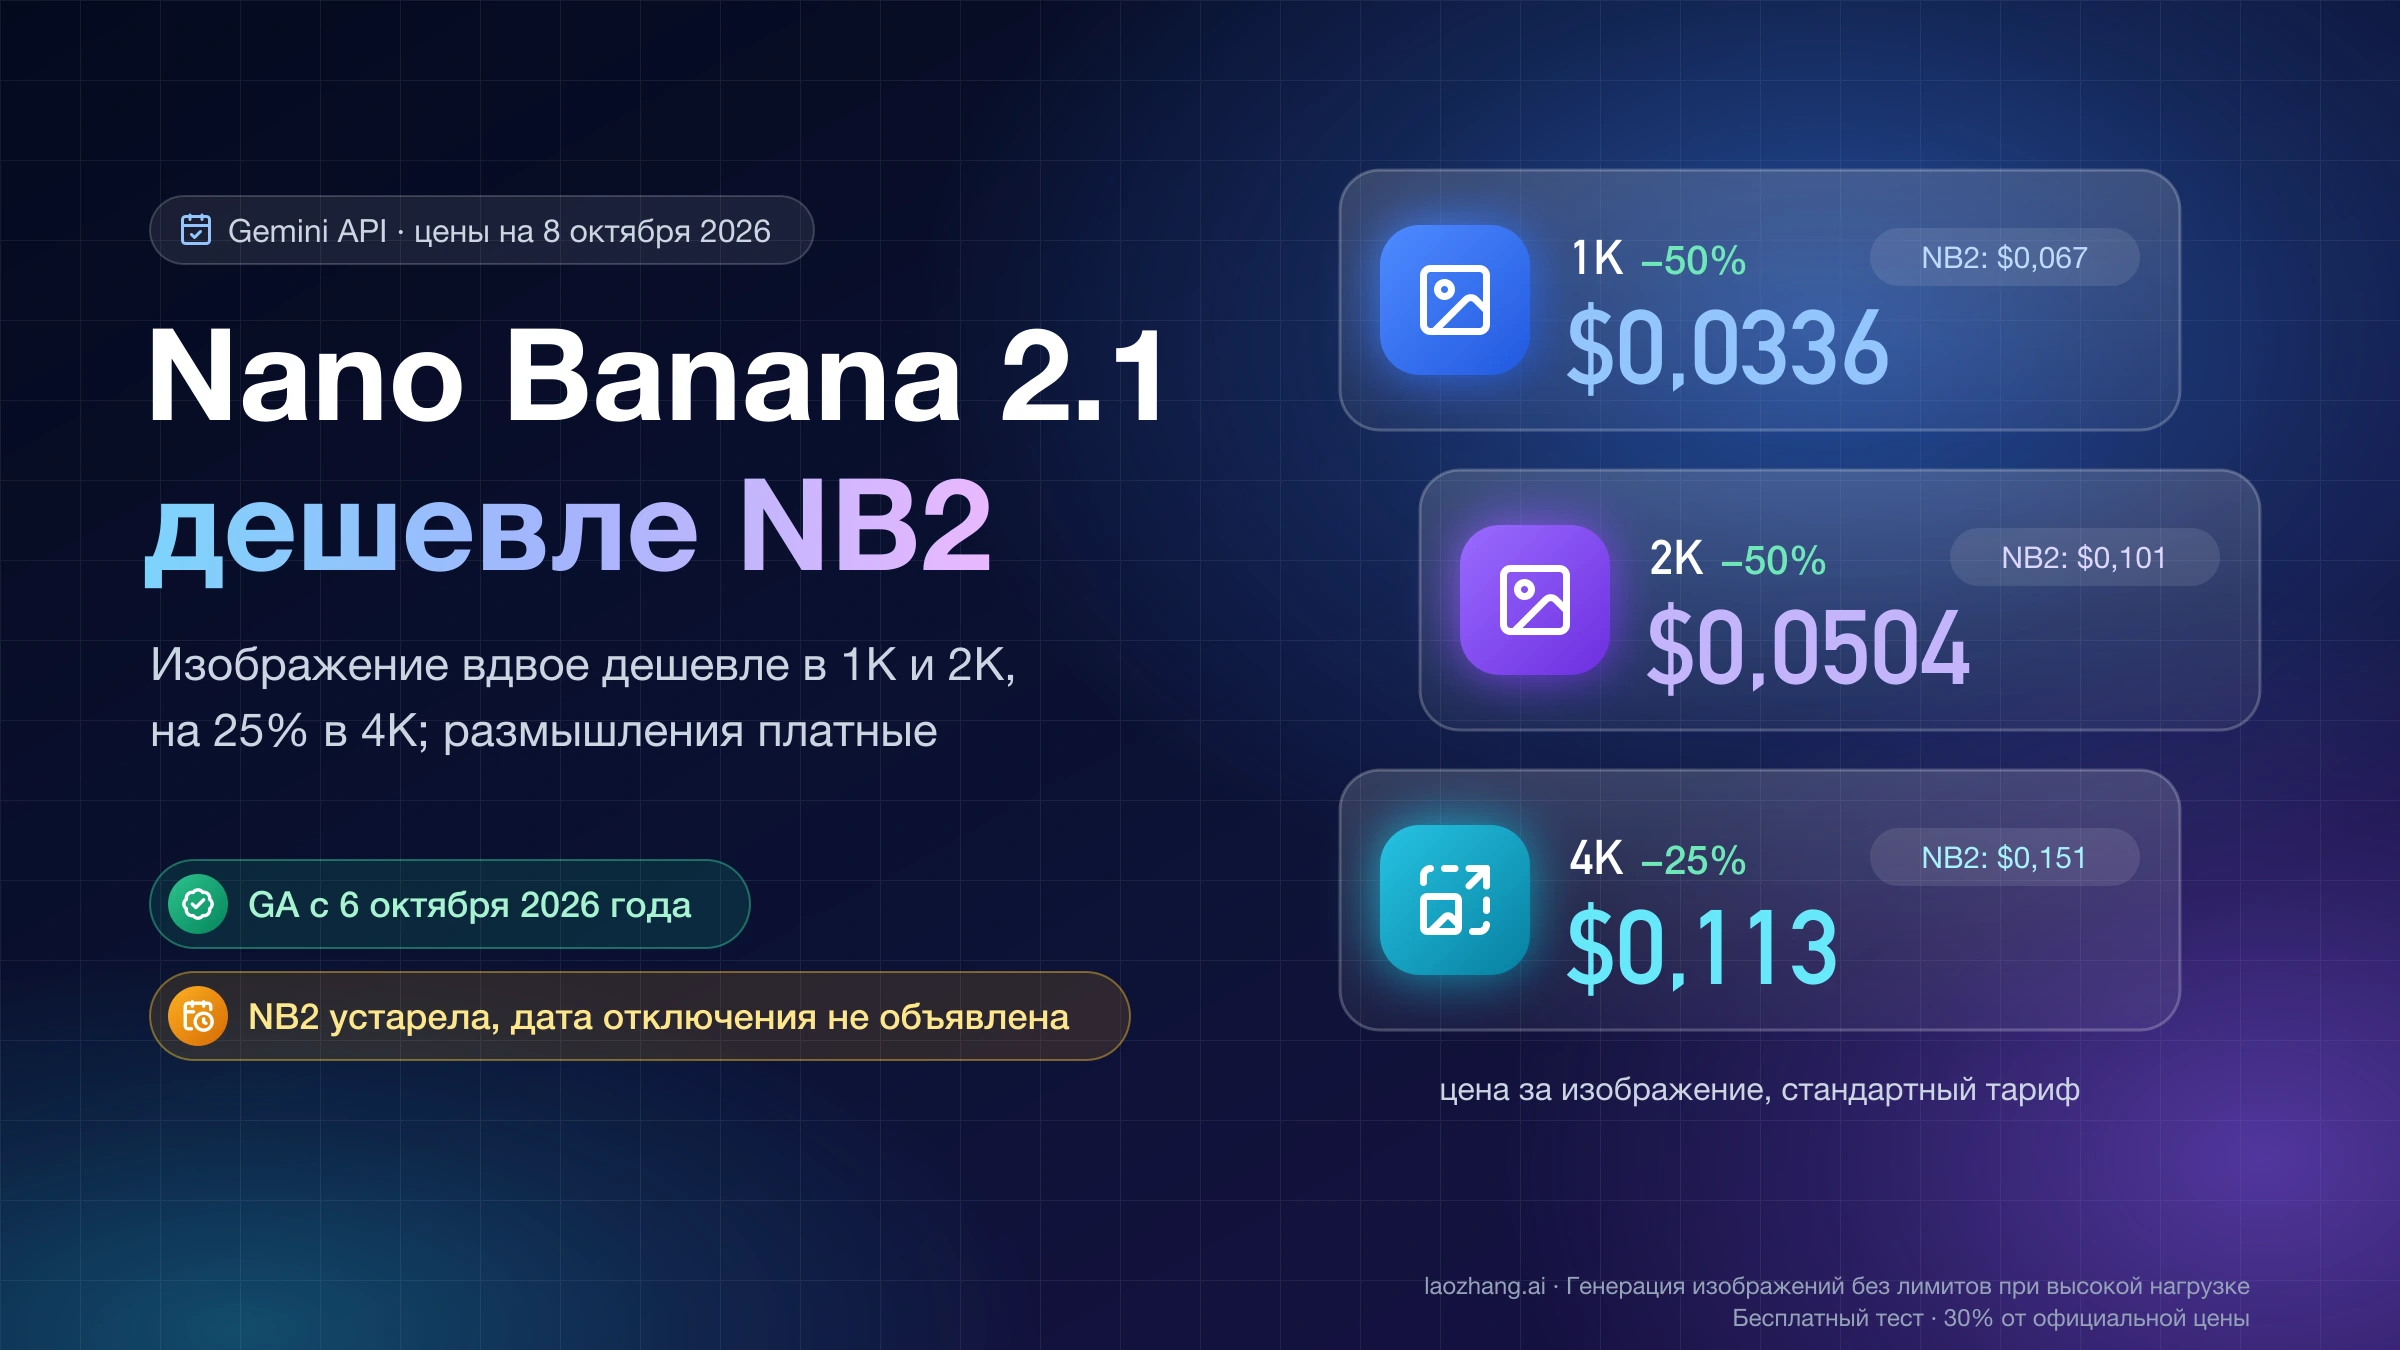
| Готовое изображение | $0,045 (0,5K), $0,067 (1K), $0,101 (2K), $0,151 (4K) | $0,134 (1K и 2K), $0,24 (4K) |
Бесплатного уровня для вывода изображений у этих моделей нет. Оценка по полям ответа generateContent для Nano Banana 2:
ввод        = promptTokenCount × 0,50 / 1 000 000
мышление    = thoughtsTokenCount × 3 / 1 000 000
текст       = (candidatesTokenCount − токены IMAGE) × 3 / 1 000 000
изображение = токены IMAGE из candidatesTokensDetails × 60 / 1 000 000
Формулу легко проверить на успешном вызове: картинка 1K — это 1 120 токенов IMAGE, 1 120 × 60 / 1 000 000 = 0,0672, то есть те самые $0,067 из прайса. В ответе без изображения токенов IMAGE в candidatesTokensDetails нет или они равны нулю, поэтому по формуле остаются ввод, мышление и текст. Мышление при этом учитывается всегда: по документации токены мышления тарифицируются независимо от includeThoughts, потому что процесс идёт в любом случае. В Interactions API те же величины называются total_input_tokens, total_thought_tokens и output_tokens_by_modality.
Это оценка по опубликованным ставкам, а не счёт. Итоговую сумму показывает биллинг вашего проекта; если вы разбираете крупный расход, сопоставьте её с сохранёнными usage неудачных вызовов. Пересчитать бюджет по разрешениям для успешных генераций поможет статья Цены Nano Banana 2 API: 512, 1K, 2K, 4K и расчёт бюджета.
Частые вопросы
Почему API отвечает без ошибки, если изображения нет?
Потому что запрос принят и обработан, а результат обработки, включая отказ, записан в поля ответа: finishReason, promptFeedback.blockReason или status. Отказ по содержанию — это не сбой соединения, а исход генерации. Проверка «ответ пришёл, значит картинка есть» поэтому ненадёжна: наличие изображения нужно проверять по частям ответа.
Поможет ли BLOCK_NONE при IMAGE_SAFETY?
Нет. Для моделей Gemini 2.5 и 3 настраиваемые фильтры и так выключены по умолчанию, защита от основных видов вреда не настраивается, а в Interactions API пользовательских настроек безопасности нет. Порог важен, только если вы сами сделали его строже и получаете SAFETY.
Поможет ли другой ключ, VPN или сервис-посредник?
Если запрос в итоге обрабатывает та же модель Google, решение о блокировке принимается по содержанию запроса, а не по тому, откуда он пришёл. Смена ключа или канала не превращает IMAGE_SAFETY в картинку. VPN здесь тоже ни при чём: ни одно значение finishReason или blockReason не связано с регионом.
Почему в AI Studio картинка не появилась, а в коде появляется (или наоборот)?
Сравните модель и параметры: в AI Studio могут быть выбраны другой ID модели, формат вывода или пороги безопасности в Run settings. Самый надёжный способ — сохранить JSON из кода и прогнать его через скрипт выше: вердикт покажет, есть ли изображение и почему его нет.
Сколько раз имеет смысл повторять запрос?
При IMAGE_OTHER, NO_IMAGE и пустом ответе без причины — один раз, затем менять запрос. При IMAGE_SAFETY, IMAGE_PROHIBITED_CONTENT, PROHIBITED_CONTENT и blockReason — ноль: сначала меняется содержание. Ошибки 429 и 5xx — отдельный случай: руководство Google по устранению неполадок советует повторять их с экспоненциальной задержкой, а официальные SDK делают это сами.
Официальная документация
Параметры запросов, цены и правила списания средств описаны в документации LaoZhang API для разработчиков: биллинг и ошибки генерации изображений.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Источники7
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 5 окт. 2026 г..
Источники7
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 5 окт. 2026 г..
- 1.документация Googleai.google.dev/gemini-api/docs/image-generation
- 2.график отключенийai.google.dev/gemini-api/docs/deprecations
- 3.справочника generateContentai.google.dev/api/generate-content
- 4.справочника Interactions APIai.google.dev/api/interactions
- 5.обзор Interactions APIai.google.dev/gemini-api/docs/interactions-overview
- 6.документации по настройкам безопасностиai.google.dev/gemini-api/docs/safety-settings
- 7.прайсе Gemini APIai.google.dev/gemini-api/docs/pricing