Opus, Sonnet, Haiku, Fable: разница и какую модель Claude выбрать
На 26 октября 2026 года Claude Opus 5.5 вдвое дороже Sonnet 5.5 за токен, но за задачу — в 1,5–3,1 раза; Haiku 5.5 в 20 раз дешевле, Fable 5.1 — после Opus.
Содержание
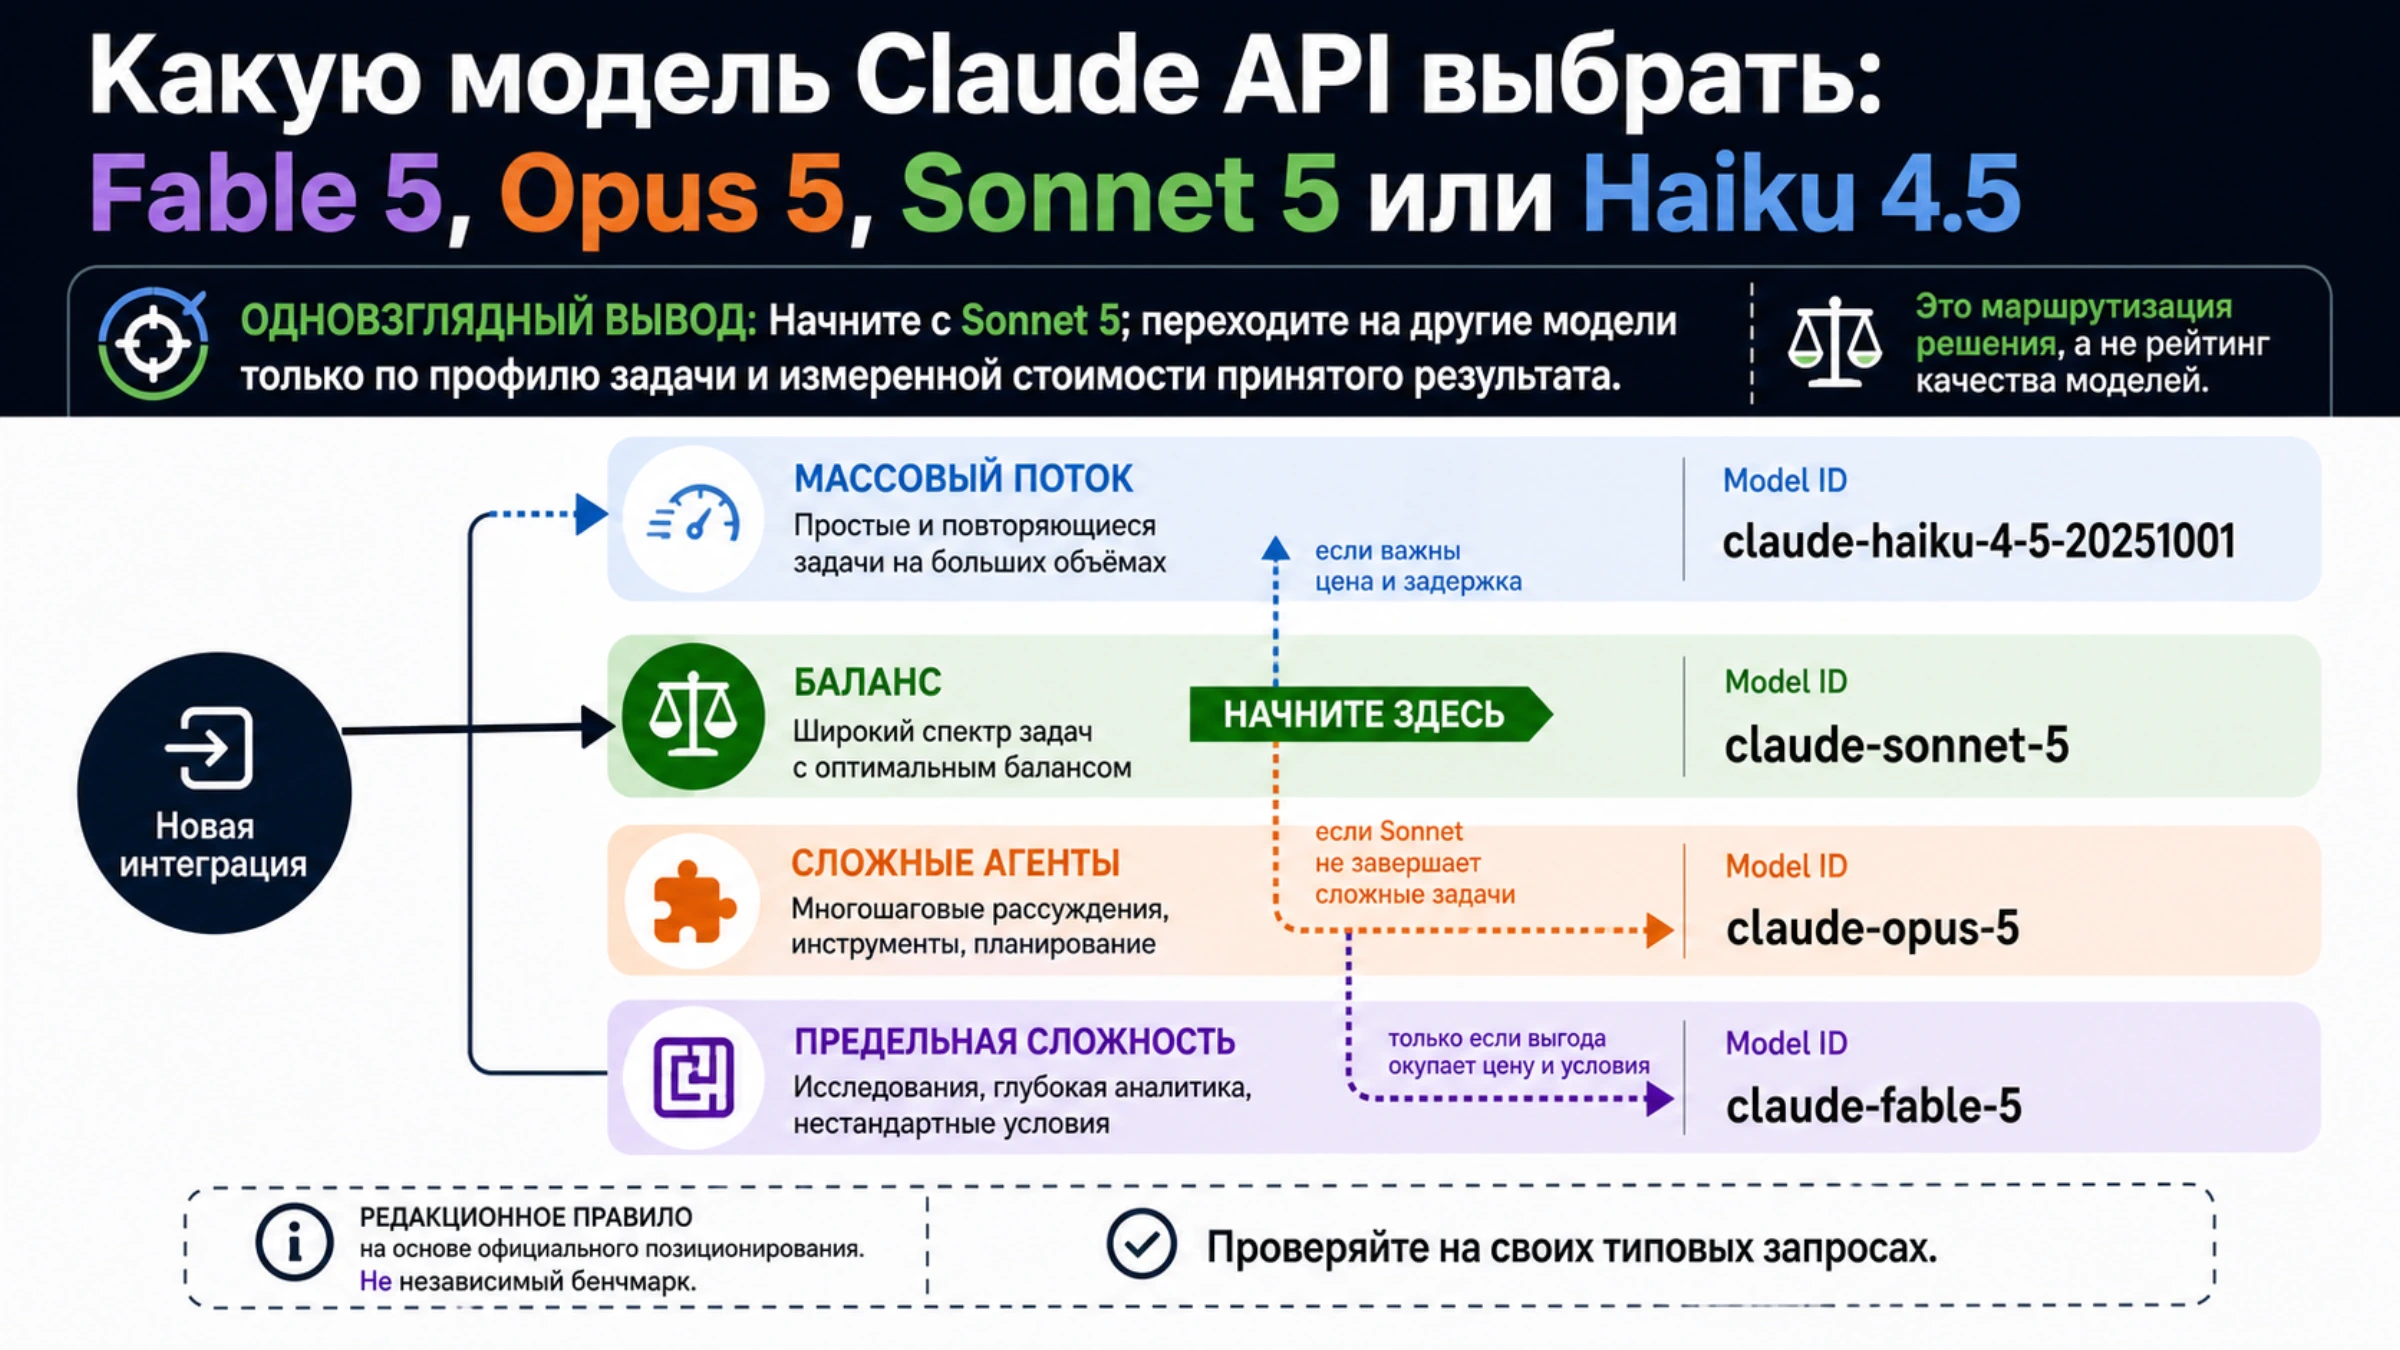
Если вы работаете в приложении Claude и не знаете, что выбрать, начните с Sonnet 5.5: Opus 5.5 включайте, когда Sonnet не справился с конкретной задачей, а Fable 5.1 — когда не справился и Opus. Для API у Anthropic другой стартовый совет: большинство нагрузок начинать на Opus 5.5 (claude-opus-5-5), большой поток простых запросов отдавать Haiku 5.5, а к Fable 5.1 переходить, только если Opus на высоком effort, то есть с более глубокой настройкой рассуждения, всё ещё не дотягивает. Оба совета действуют по состоянию на 26 октября 2026 года и не спорят друг с другом: в приложении вы расплачиваетесь долей лимита подписки, а в API — деньгами за каждый токен.
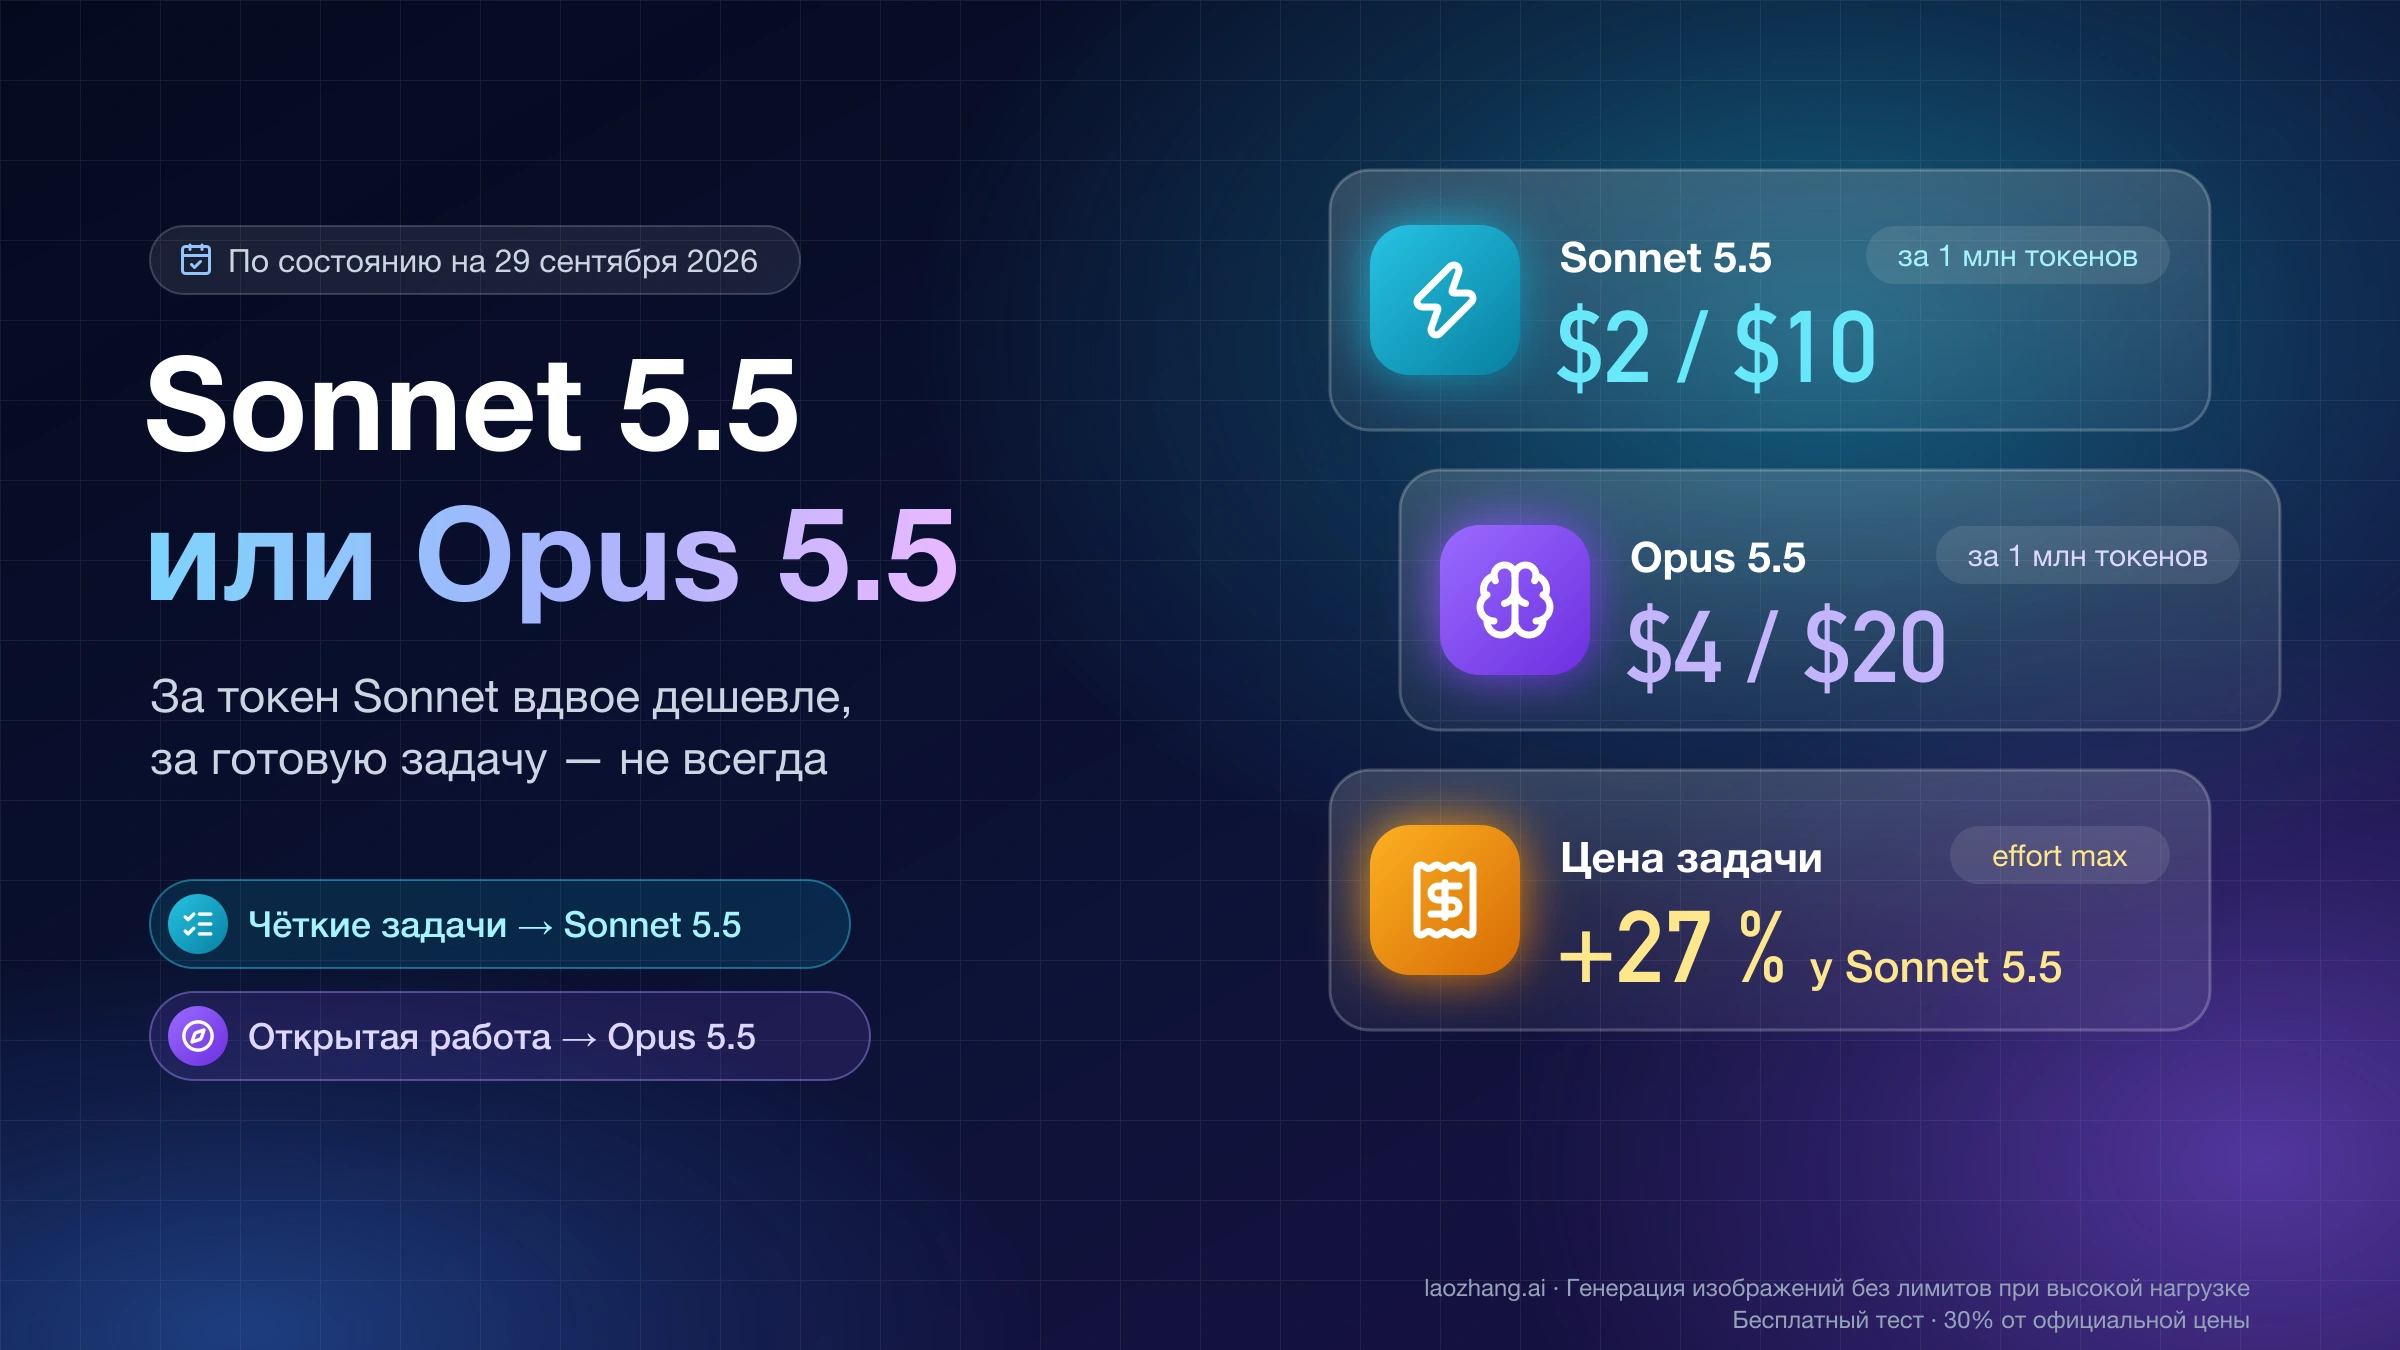
Шаг вверх по линейке при равном качестве стоит меньше, чем кажется по прайсу. За токен Opus 5.5 вдвое дороже Sonnet 5.5, но на настройках по умолчанию задача из индекса Artificial Analysis обходится в нём в 1,52 раза дороже и набирает 51 балл против 47. В тесте 26 октября 2026 года Haiku, Sonnet и Opus 5.5 прошли все проверки на девяти одинаковых задачах, а счёт составил $0,0087, $0,0866 и $0,2695. Прежде чем менять модель, попробуйте поднять или опустить effort у текущей: Anthropic называет это более действенным рычагом, чем переход на другую ступень.
Если вы ищете по старым названиям, то Haiku 4.5, Sonnet 5, Opus 5 и Fable 5 теперь считаются устаревшими, хотя в API ещё работают. Их сменили Haiku 5.5, Sonnet 5.5, Opus 5.5 и Fable 5.1, и всё сравнение ниже относится к новым версиям; соответствие старых и новых моделей с ценами собрано в отдельном разделе.
Сравнение моделей Claude: в чём разница Haiku, Sonnet, Opus и Fable
Все четыре актуальные модели Claude принимают до 1 млн токенов контекста, выдают до 128 тысяч токенов в синхронном ответе, понимают текст и изображения, умеют вызывать инструменты и знают события примерно до июня 2026 года. Различаются они ценой, относительной скоростью, глубиной рассуждения по умолчанию и тем, на каких тарифах приложения они открыты. Так это выглядит по сравнительной таблице в обзоре моделей Anthropic, странице цен Claude API и руководству Claude Academy по выбору модели на 26 октября 2026 года:
| Модель и ID в API | Ввод / вывод за 1 млн токенов | Чтение кэша | Скорость по Anthropic | effort по умолчанию в API | Тарифы приложения | Для чего Anthropic её позиционирует |
|---|---|---|---|---|---|---|
Haiku 5.5, claude-haiku-5-5 | $0,10 / $0,50 (запрос до 100 000 токенов), $0,50 / $2,50 (свыше) | $0,01 (свыше 100 000 — $0,05) | Самая быстрая | medium | Free, Pro, Max | Большие потоки задач, где важна задержка: классификация, извлечение, маршрутизация |
Sonnet 5.5, claude-sonnet-5-5 | $2 / $10 | $0,10 | Быстрая | high | Free, Pro, Max | Лучшее сочетание скорости и интеллекта: повседневный код, агенты, анализ |
Opus 5.5, claude-opus-5-5 | $4 / $20 | $0,20 | Умеренная | medium | Pro, Max | Долгие агентные задачи с кодом и сложная работа со знаниями |
Fable 5.1, claude-fable-5-1 | $10 / $50 | $0,25 | Медленнее | high | Pro, Max | Требовательные рассуждения и многочасовые агентные задачи |
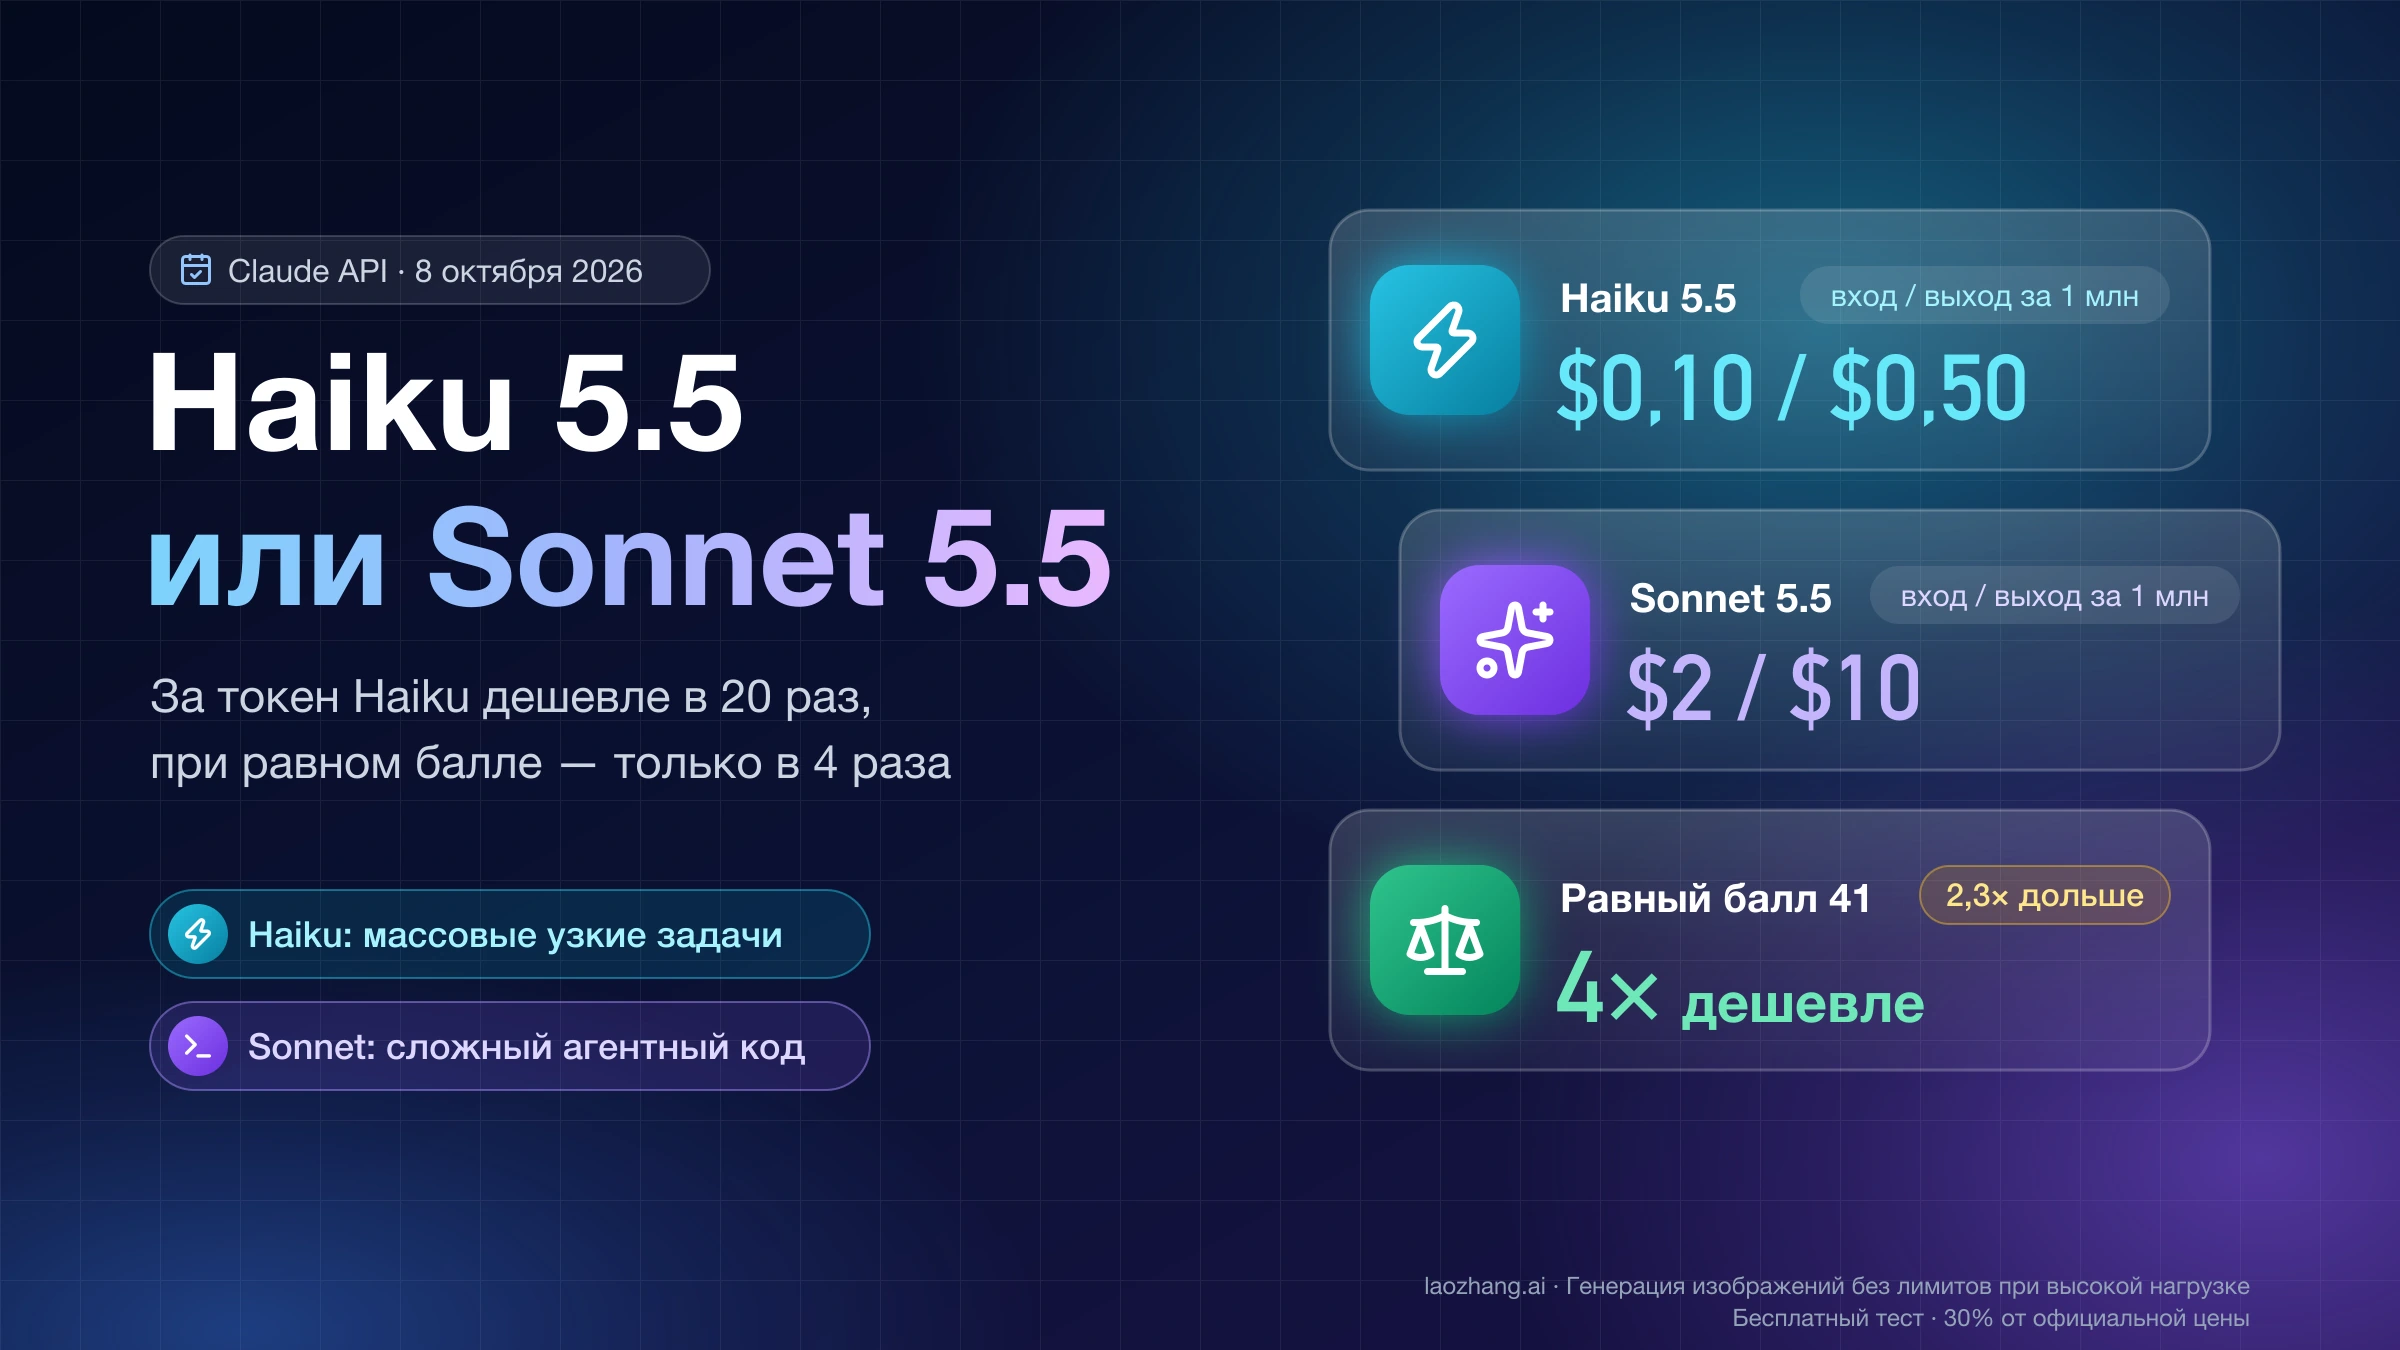
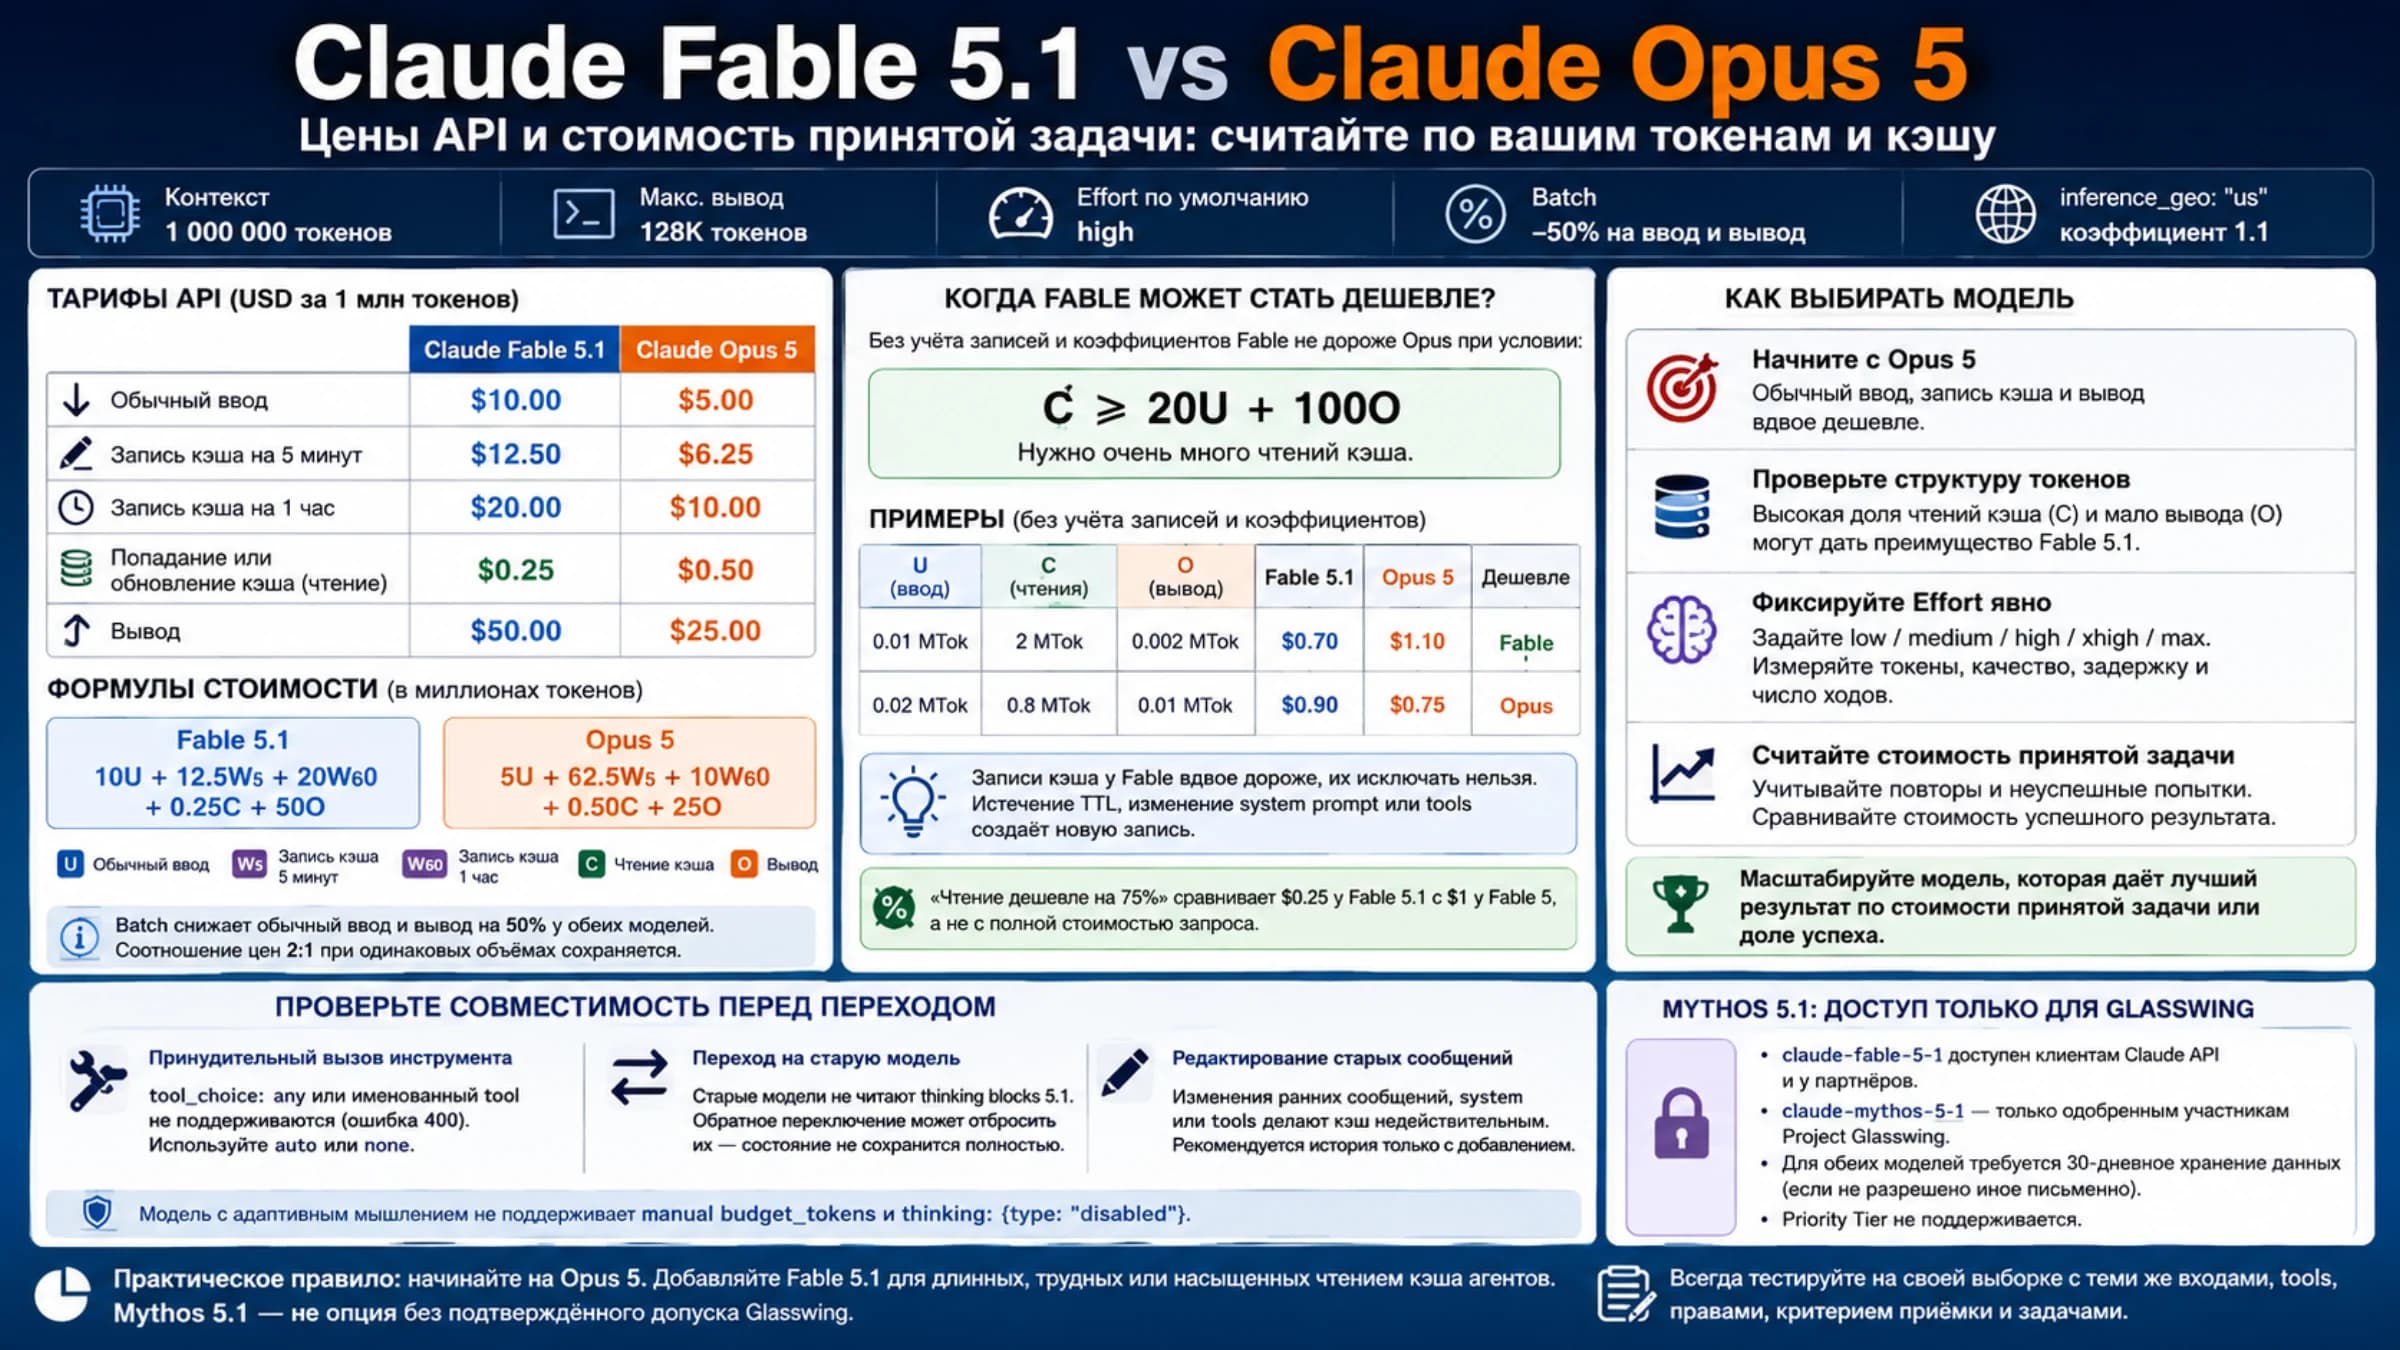
Градация моделей Claude поэтому прежде всего ценовая: за токен Sonnet 5.5 дороже Haiku 5.5 в 20 раз (на запросах до 100 000 токенов), Opus 5.5 дороже Sonnet вдвое, Fable 5.1 дороже Opus в 2,5 раза, то есть в 100 раз дороже Haiku. Эти кратности относятся к цене за токен; сколько стоит одна задача, зависит ещё от того, сколько токенов модель тратит на рассуждение и ответ, и об этом следующие разделы. Batch API снижает обе ставки у всех моделей вдвое.
Метки «самая быстрая», «быстрая», «умеренная» и «медленнее» — относительные оценки Anthropic, а не замер: в сноске к таблице сказано, что реальная задержка зависит от длины запроса, длины ответа и effort. В тесте 26 октября, описанном ниже, на коротких задачах первым финишировал не Haiku, а Sonnet 5.5. Кроме четырёх моделей в таблице есть ещё Claude Mythos 5.1 с возможностями Fable 5.1, но её открывают только организациям, прошедшим проверку Anthropic, так что в обычном выборе её нет.
Почему Anthropic советует приложению Sonnet, а API — Opus 5.5
Совет «если не уверены, начните с Sonnet» относится к приложениям Claude — сайту, десктопу и мобильным клиентам, а совет «для большинства нагрузок начните с Opus 5.5» — к API. В руководстве Claude Academy Sonnet 5.5 назван универсальной моделью по умолчанию, а в обзоре моделей для разработчиков стартовой точкой назван Opus 5.5. Оба совета действующие, и ни один не ошибочен: они написаны для разных способов оплаты и разного набора доступных моделей.
В приложении вы платите не деньгами за запрос, а запасом лимита подписки. На тарифе Free доступны только Haiku и Sonnet, Pro и Max добавляют Opus и Fable и дают больше запаса. Haiku расходует лимит меньше всех, Sonnet — умеренно, Opus — много, Fable — больше всего; точных коэффициентов Anthropic не публикует. Поэтому Opus в приложении разумно держать для задач, где Sonnet уже не справился: каждый ответ Opus приближает момент, когда лимит закончится. В меню выбора модели есть и настройка effort: значение по умолчанию подходит для большинства задач, пониженное даёт ответы быстрее и бережёт лимит, а самое высокое стоит оставлять для самых трудных вопросов. Сколько запаса дают платные тарифы, разобрано в материале Claude Pro vs Max vs Ultra: цены, лимиты Claude Code, окупаемость, а что делать, когда лимит Opus закончился, — в статье Claude Opus 5.5: цена API и как сбросить лимит подписки.
В API лимит использования не играет роли, и решает цена задачи при нужном качестве. Opus 5.5 по умолчанию работает на effort medium, а Sonnet 5.5 — на high, и на этих настройках Opus даёт более высокий балл качества при разнице в стоимости задачи меньше двукратной; цифры — в следующем разделе. Для прототипов, жёстких требований к задержке и больших потоков простых задач в руководстве Anthropic по выбору модели описан и обратный путь: начать с Haiku 5.5 и повышать класс только там, где обнаружится конкретный недостаток.
Россию Anthropic не обслуживает: по списку поддерживаемых стран Anthropic ни приложение Claude, ни Claude API в ней официально не доступны, и это одинаково касается всех четырёх моделей.
Что лучше, Sonnet или Opus, и что дороже: цена задачи, а не токена
Opus 5.5 дороже Sonnet 5.5 и за токен, и за задачу, но в индексе Artificial Analysis за задачу заметно меньше чем вдвое, а качество при этом выше. По замерам Artificial Analysis на всех пяти уровнях effort, пересчитанным 26 октября 2026 года, Opus 5.5 на своём medium по умолчанию набирает 51 балл индекса интеллекта при стоимости $1,34 за задачу индекса, а Sonnet 5.5 на своём high — 47 баллов за $0,88. Opus дороже в 1,52 раза и сильнее на 4 балла. Чтобы Sonnet догнал его, нужен xhigh: 52 балла за $2,01, то есть дороже, чем Opus на medium. Если вашей задаче нужно больше, чем даёт Sonnet по умолчанию, самый дешёвый способ получить это — Opus на medium.
Ниже — самый дешёвый вариант для каждого уровня индекса среди всех 20 сочетаний модели и effort. Данные взяты из сравнений Artificial Analysis Haiku 5.5 и Sonnet 5.5, Sonnet 5.5 и Opus 5.5, Opus 5.5 и Fable 5.1; стоимость посчитана по прейскуранту Anthropic.
| Нужный балл индекса | Самый дешёвый вариант | Стоимость задачи | Время задачи |
|---|---|---|---|
| 34 и выше | Haiku 5.5, medium | $0,05 | 119 с |
| 41 и выше | Haiku 5.5, xhigh | $0,12 | 291 с |
| 47 и выше | Sonnet 5.5, high | $0,88 | 217 с |
| 51 и выше | Opus 5.5, medium | $1,34 | 198 с |
| 54 и выше | Opus 5.5, high | $1,82 | 282 с |
| 56 и выше | Opus 5.5, xhigh | $3,46 | 494 с |
| 58 | Opus 5.5, max | $5,98 | 791 с |
Шаг от Haiku к Sonnet на настройках по умолчанию даёт 13 баллов и стоит в 17,6 раза дороже за задачу, шаг от Sonnet к Opus — 4 балла и в 1,52 раза дороже. Эти множители не совпадают с ценой за токен (20 и 2 раза), потому что модели тратят разное количество токенов. Потолки на max тоже разные: Haiku 43, Sonnet 56, Opus 58.
Fable 5.1 в таблице нет ни на одном уровне. На своём high она набирает те же 51 балл, что Opus 5.5 на medium, но задача обходится в 2,92 раза дороже ($3,91) и идёт в 2,09 раза дольше, а её потолок на max — 53. Индекс усредняет десять тестов и прячет области, где Fable сильнее: Anthropic оставляет за ней многочасовые агентные сессии и глубокие исследования, доведённые до готового документа. Когда такая доплата оправдана, разобрано в материале Claude Fable 5.1 или Opus 5.5: что выбрать и когда стоит доплатить. Учтите, что Artificial Analysis — сторонний замер со своим набором задач, и на ваших задачах соотношения могут сдвинуться.
Haiku, Sonnet и Opus 5.5 на девяти одинаковых задачах: тест 26 октября
26 октября 2026 года Haiku 5.5, Sonnet 5.5 и Opus 5.5 получили одни и те же девять задач, проверки к которым были зафиксированы до чтения ответов: текстовая задача на подсчёт, пять функций на Python со скрытыми наборами тестов, сжатие статьи на 6 723 слова ровно в пять пунктов не длиннее 25 слов, комбинаторный подсчёт и исправление файла billing.py с пятью подброшенными ошибками и двумя недописанными функциями (36 скрытых тестов). Модели работали с настройками API по умолчанию — Haiku и Opus на medium, Sonnet на high, — без системной инструкции, инструментов и кэша. Запросы шли через шлюз LaoZhang API в формате Anthropic Messages (/v1/messages), стоимость посчитана по возвращённому числу токенов и прейскуранту Anthropic.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
| Модель | Пройдено задач | Стоимость 9 задач | Суммарное время | Выходных токенов |
|---|---|---|---|---|
| Haiku 5.5 | 9 из 9 | $0,0087 | 74,9 с | 13 843 |
| Sonnet 5.5 | 9 из 9 | $0,0866 | 50,6 с | 5 061 |
| Opus 5.5 | 9 из 9 | $0,2695 | 103,5 с | 9 875 |
Все три модели прошли все 27 проверок, поэтому качество эти задачи не различили: они небольшие и чётко поставленные. Различились деньги и время. Sonnet обошёлся в 9,9 раза дороже Haiku, хотя за токен дороже в 20 раз: Haiku написал в 2,74 раза больше выходных токенов, и около половины его ценового преимущества ушло на длину ответа. Opus вышел в 3,11 раза дороже Sonnet при двукратной разнице за токен, потому что выдал в 1,95 раза больше токенов. Sonnet первым закончил 8 задач из 9, Haiku оказался быстрее только на одной, Opus был самым медленным на всех девяти; время включает работу шлюза и потоковую передачу.
На этих коротких задачах Sonnet на high отвечал сжато, поэтому его разрыв с Opus вышел больше, чем в индексе Artificial Analysis (3,11 раза против 1,52). Множитель «за задачу» зависит от типа работы, и его стоит мерить на своих запросах. Ограничения теста: по одному прогону на задачу, один шлюз, один день, только настройки по умолчанию. Fable 5.1 не запускали из-за ограничения расходов, а прямой эндпоинт Anthropic, другие уровни effort, кэширование и приложения Claude не проверялись. Вывода «Haiku не хуже Opus» этот тест не даёт: для сравнения качества остаётся индекс из предыдущего раздела.
Условный расчёт: один запрос, ход агента и миллион вызовов
Стоимость одного запроса считается по формуле ниже: каждый вид токенов умножается на свою ставку, и сумма делится на миллион. Для четырёх типовых профилей по прейскуранту Anthropic на 26 октября 2026 года, без Batch API и без записи кэша на первом ходе, получается такая таблица. Число токенов взято одинаковым для всех моделей: токенизатор у них общий, но реальные ответы разной длины, как показал тест выше.
стоимость = (новые входные токены × ставка ввода
           + токены из кэша × ставка чтения кэша
+ выходные токены × ставка вывода) / 1 000 000| Профиль запроса | Haiku 5.5 | Sonnet 5.5 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|---|
| A. 10 000 входных + 1 000 выходных, без кэша | $0,0015 | $0,030 | $0,060 | $0,150 |
| B. Ход агента: 90 000 из кэша + 5 000 новых + 2 000 выходных | $0,0024 | $0,039 | $0,078 | $0,1725 |
| C. Тот же ход, но 150 000 из кэша | $0,015 | $0,045 | $0,090 | $0,1875 |
| D. 1 млн вызовов классификации по 2 000 входных + 300 выходных | $350 | $7 000 | $14 000 | $35 000 |
Для проверки строка B у Sonnet: (90 000 × 0,10 + 5 000 × 2 + 2 000 × 10) / 1 000 000 = 39 000 / 1 000 000, то есть $0,039. Ставка чтения кэша Sonnet 5.5 в $0,10 действует с 7 октября 2026 года, до этого она была $0,20; подробный расчёт — в материале Claude Sonnet 5.5: цена чтения кэша $0,10 — расчёт экономии.
Строка C показывает ловушку Haiku 5.5. Как только запрос вместе с токенами из кэша превышает 100 000 токенов, он целиком считается по ставкам $0,50 / $2,50 и чтению кэша $0,05: в документации по ценам прямо сказано, что в длину запроса входят и чтение, и запись кэша. Поэтому ход агента у Haiku дорожает в 6,25 раза, а у Sonnet и Opus — примерно на 15 %, у Fable — на 9 %. Долгие агентные циклы на Haiku доходят до этой границы быстрее, чем кажется, потому что Haiku 5.5 сохраняет блоки рассуждения прошлых ходов во входе.
Три сценария, в которых выбор начинается с разных моделей
Для потока коротких однотипных запросов начинайте с Haiku 5.5, для рабочего агента с кодом — с Sonnet 5.5 или Opus 5.5, а для многочасовых и самых сложных задач — с Opus 5.5 на повышенном effort, и только после него пробуйте Fable 5.1. Ниже — что решает выбор в каждом случае.
Классификация и короткие ответы в большом потоке
Здесь первым кандидатом остаётся Haiku 5.5: Anthropic позиционирует её как модель с самой низкой задержкой и ценой для классификации, извлечения и маршрутизации, а на миллионе вызовов из строки D разница с Sonnet составляет $350 против $7 000. Если Haiku ошибается на ваших проверках, сначала попробуйте xhigh, но Anthropic советует включать xhigh и max только там, где проверки показывают выигрыш, и сравнивать результат с Sonnet 5.5 по качеству, цене и скорости. Следите и за длиной запроса: длинные входы переводят Haiku в дорогую полосу.
Если коротко, чем Haiku отличается от Sonnet: Haiku в 20 раз дешевле за токен и рассчитана на узкие задачи вроде сжатия текста, пересказа и работы субагентом, а для сложных агентных задач с кодом Anthropic в анонсе Haiku 5.5 называет лучшим выбором Sonnet 5.5 и Opus 5.5. Какие задачи Sonnet можно отдать Haiku без потерь, разобрано в материале Claude Haiku 5.5 или Sonnet 5.5: что выбрать по цене задачи.
Рабочий агент для кода и инструментов
Для повседневного кода, анализа данных и агентов с инструментами Anthropic предлагает Sonnet 5.5, а для многочасовых автономных агентов, крупного рефакторинга и сложной системной инженерии — Opus 5.5. В тесте выше обе модели решили все задачи с кодом, так что разница проявляется на более длинных и запутанных задачах, а не на отдельных функциях. В собственных анонсах Anthropic по Terminal-Bench 4.0 у Haiku 5.5 указано 39,2 %, у Opus 5.5 на xhigh — 66,4 %; это данные производителя из разных публикаций, и на ваших задачах их надо проверять.
В Claude Code те же модели доступны по псевдонимам: opus на API Anthropic указывает на Opus 5.5, haiku — на Haiku 5.5 (с версии 2.1.293), а effort по умолчанию в Claude Code — medium у всех трёх. Для простых задач субагентов документация Claude Code советует указать model: haiku в настройке субагента. На Bedrock, Google Cloud и Foundry псевдоним haiku пока ведёт на более раннюю версию, поэтому там указывайте ID claude-haiku-5-5 явно.
Длинная аналитическая или предельно сложная агентная задача
Начните с Opus 5.5 и, если результат не устраивает, поднимите effort до xhigh или max. Только если ваши проверки и на этих уровнях не дотягивают, Anthropic советует переходить на Fable 5.1, которую в матрице выбора модели связывает с многочасовыми агентными сессиями, многошаговыми исследованиями и анализом, доведённым до готового документа, таблицы или презентации. В приложении логика та же: Fable — для длинных задач со множеством связанных шагов и плотного исходного материала, она отвечает медленнее и расходует лимит быстрее всех. В том же Terminal-Bench 4.0 анонс Opus 5.5 даёт Fable 5.1 55,8 %, ниже, чем у Opus, так что Fable не «лучше во всём», а сильнее в своём классе задач.
Когда повышать или понижать класс модели и почему сначала effort
Сначала меняйте effort, потом модель. Effort — параметр Anthropic, который задаёт, сколько модель рассуждает перед ответом: low, medium, high, xhigh или max. Все четыре модели поддерживают все пять уровней, а значение по умолчанию равнозначно отсутствию параметра. В руководстве Anthropic по выбору модели прямо сказано, что настройка effort часто оказывается лучшим рычагом, чем смена модели, и цифры Artificial Analysis это подтверждают: Haiku 5.5 на xhigh набирает 41 балл за $0,12 на задачу, а Sonnet 5.5 выходит на те же 41 балл только на medium и за $0,48, вчетверо дороже.
Признак, что пора повышать класс, — повторяющаяся неудача на ваших задачах, а не ощущение, что «можно лучше». В приложении Anthropic советует переходить на Opus для задач, которые вы уже пробовали на Sonnet и он не справился, и на Fable — для задач, где не справился Opus. В API этот признак — набор собственных проверок: если более дешёвая модель не проходит их и на повышенном effort, переходите на ступень выше, а к Fable 5.1 — после того как Opus 5.5 не прошёл их на xhigh или max. Понижать класс стоит, когда более дешёвая модель проходит тот же набор проверок с нужной точностью и форматом: тогда доплата за старшую модель ничего не покупает.
Если переключаться приходится посреди диалога, учитывайте блоки рассуждения. На Claude API и Google Cloud Opus 5.5 читает блоки рассуждения Haiku 5.5 и Sonnet 5.5, поэтому при переходе вверх, с Haiku или Sonnet на Opus, рассуждения дешёвой модели сохраняются. При переходе вниз они теряются молча: Haiku 5.5 не читает блоки Opus 5.5, Sonnet 5.5 — блоки Opus и Fable, запрос при этом проходит, а отброшенные блоки не оплачиваются. В Claude Code смена модели командой /model посреди сессии заново читает весь разговор без попаданий в кэш, так что каждое переключение оплачивается полным перечитыванием.
Haiku 4.5, Sonnet 5, Opus 5 и Fable 5: чем их заменили и сколько стоят
На 26 октября 2026 года Haiku 4.5, Sonnet 5, Opus 5 и Fable 5 входят в список устаревших (legacy) моделей Anthropic: в API они по-прежнему работают, но для новых проектов предназначены их преемники. Если вы сравнивали «Sonnet 5 или Opus 5» и «Haiku 4.5 или Sonnet 5», логика выбора переносится на новые версии, а цены сдвинулись так, по странице цен Claude API:
| Старая модель | Ввод / вывод за 1 млн токенов | Преемник | Цена преемника | Что изменилось |
|---|---|---|---|---|
| Haiku 4.5 | $1 / $5 | Haiku 5.5 | $0,10 / $0,50 до 100 000 токенов, $0,50 / $2,50 свыше | В 10 раз дешевле на коротких запросах, вдвое — на длинных |
| Sonnet 5 | $2 / $10 | Sonnet 5.5 | $2 / $10 | Чтение кэша $0,20 → $0,10 |
| Opus 5 | $5 / $25 | Opus 5.5 | $4 / $20 | На 20 % дешевле |
| Fable 5 | $10 / $50 | Fable 5.1 | $10 / $50 | Чтение кэша $1 → $0,25 |
Что лучше, Opus 5 или Sonnet 5, решалось по тому же правилу, что и сейчас: Opus 5 стоил за токен в 2,5 раза дороже и имел смысл там, где Sonnet не справлялся. Объявленное повышение цены Sonnet 5 до $3 / $15 с 1 сентября 2026 года не состоялось, вводная цена $2 / $10 стала постоянной. Что лучше, Sonnet 5 или Haiku 4.5: Sonnet 5 был за токен вдвое дороже, а теперь, в паре Haiku 5.5 и Sonnet 5.5, разрыв вырос до 20 раз, поэтому перенести на Haiku часть простых задач стало заметно выгоднее. Сроки отключения устаревших моделей публикуются на странице жизненного цикла моделей Claude.
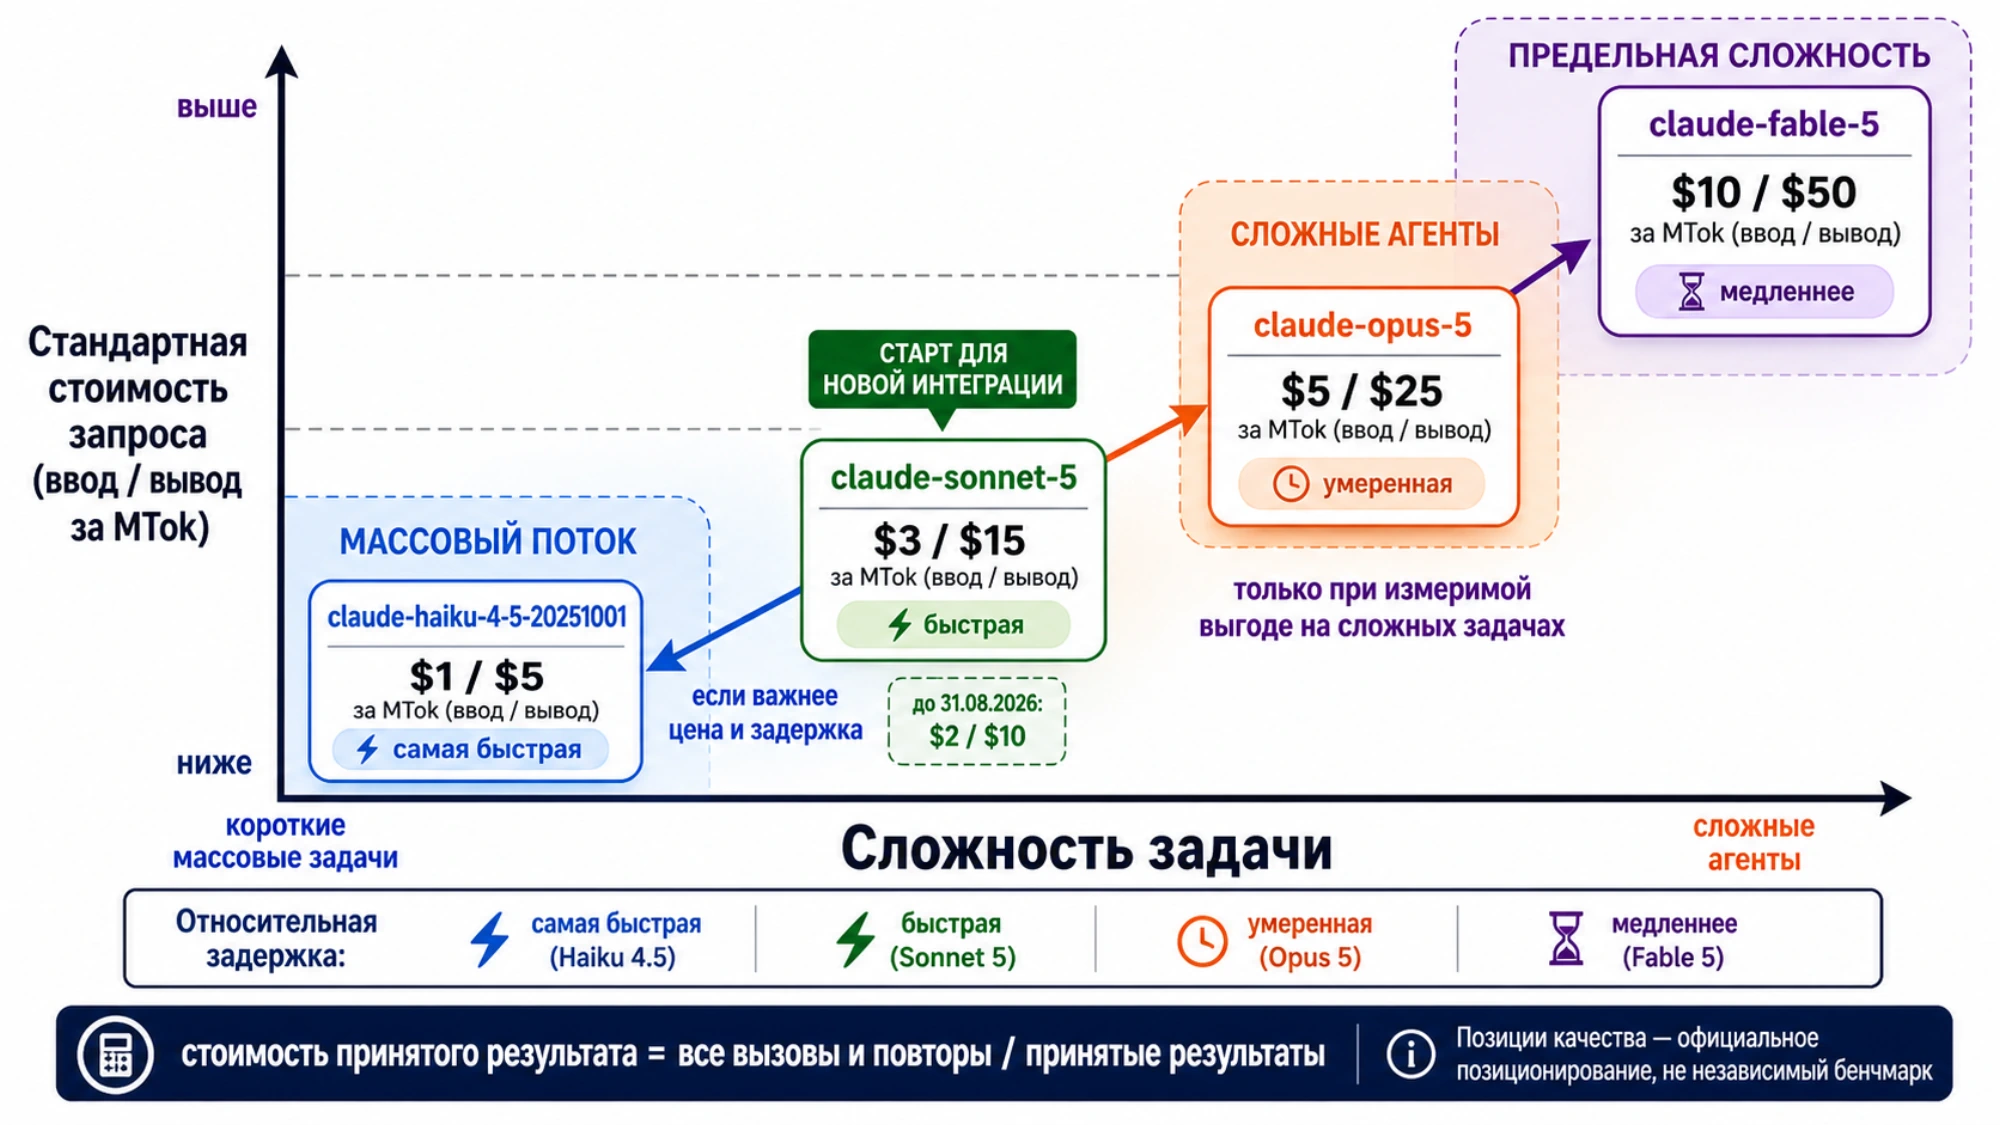
На схеме — линейка и цены августа 2026 года; актуальные модели и цены — в тексте и таблицах выше.
Миграция без неожиданного HTTP 400: что проверить при смене ID модели
Смена ID модели не сводится к замене строки: несколько параметров, которые принимали старые модели, у новых возвращают ошибку HTTP 400. По разделам «что нового» для Opus 5.5, Sonnet 5.5 и Haiku 5.5 перед переключением проверьте в запросах следующее:
- принудительный вызов инструмента (
tool_choiceс типомanyилиtool) на Opus 5.5 и Sonnet 5.5 возвращает 400tool_choice: type "tool" and "any" are not supported for this model., вместо него используйтеautoи строгое описание инструментов (strict tool use); thinking: {"type": "disabled"}на Opus 5.5 даёт 400, потому что рассуждение у него включено всегда; на Sonnet 5.5 тоже 400, а вместо отключения есть{"type": "between_tools"}, работающий только наlow,mediumиhigh;- ручной бюджет рассуждения
budget_tokensотклоняют все четыре модели; - при переходе с Haiku 4.5 на Haiku 5.5 нестандартные
temperature,top_pиtop_kвозвращают 400, предзаполненный ответ ассистента (prefill) — ошибку, а отключить рассуждение у Haiku 5.5 можно только на efforthighи ниже; - Opus 5.5 не принимает инструмент управления компьютером
computer_20251124.
На партнёрских платформах ID другие: на Bedrock это anthropic.claude-haiku-5-5, anthropic.claude-sonnet-5-5, anthropic.claude-opus-5-5 и anthropic.claude-fable-5-1, а Google Cloud, Microsoft Foundry и Claude Platform on AWS используют обычные ID. Сроки жизни там тоже свои. На API Anthropic актуальные модели отключат не раньше 1 сентября 2027 года (Fable 5.1), 22 сентября 2027 года (Opus 5.5), 28 сентября 2027 года (Sonnet 5.5) и 7 октября 2027 года (Haiku 5.5).
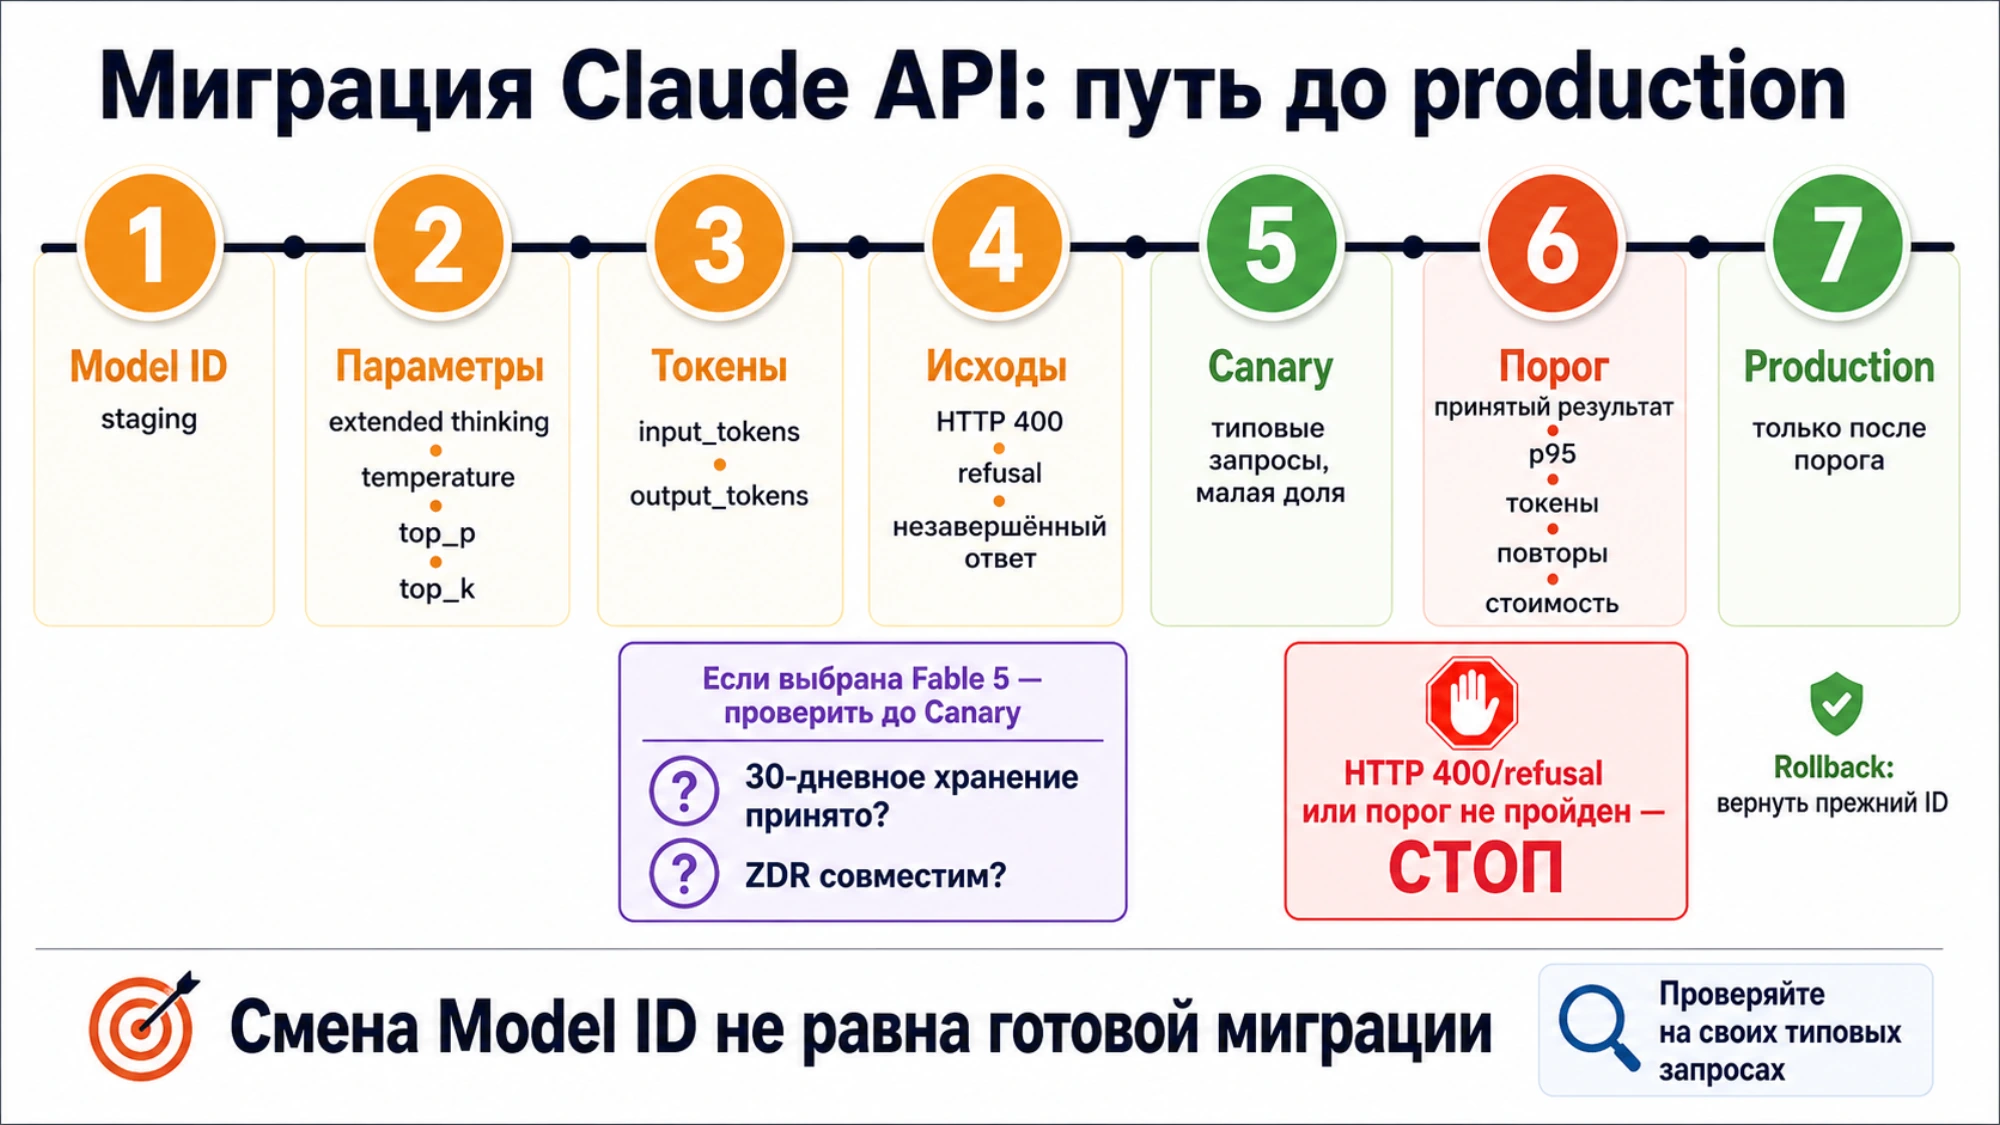
Схема составлена для линейки августа 2026 года, поэтому в ней упомянуты Fable 5 и extended thinking; порядок шагов прежний, а параметры для текущих моделей — в списке выше.
Практический выбор на сегодня: проверка на своих задачах
На 26 октября 2026 года рабочий выбор такой: в приложении — Sonnet 5.5 с effort по умолчанию, в API — Opus 5.5 на medium для сложной работы и Sonnet 5.5 или Haiku 5.5 там, где ваши проверки показывают, что их хватает. Точнее решить помогает короткая проверка на своих задачах, а не чужой рейтинг.
В приложении Anthropic предлагает простой самотест: отправить одну и ту же просьбу сначала Haiku, потом Sonnet, например «Кратко изложи приложенный отчёт в пяти пунктах, затем отметь одно утверждение, которое ты бы перепроверил по второму источнику», и сравнить, где ответы расходятся по сути, а не по длине. Если расхождений нет, для таких задач хватает младшей модели и лимит расходуется медленнее.
В API возьмите 10–20 типовых задач, прогоните их на двух соседних моделях с effort по умолчанию и запишите для каждой долю результатов, принятых без доработки, число повторов, входные и выходные токены и итоговую стоимость. Сравнивать модели по цене десяти вызовов нельзя: если у одной принято восемь результатов, а у другой пять, делить надо на число принятых.
стоимость принятого результата =
  стоимость всех вызовов и повторов / число принятых результатов
Если у более дешёвой модели эта величина ниже при допустимой для вашего продукта доле ошибок, оставайтесь на ней; если старшая модель за счёт меньшего числа повторов выходит дешевле, повышайте класс. Перед сменой модели в production поменяйте ID сначала в тестовой среде и проверьте запросы по списку из раздела о миграции.
Источники12
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 26 окт. 2026 г..
Источники12
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 26 окт. 2026 г..
- 1.сравнительной таблице в обзоре моделей Anthropicplatform.claude.com/docs/en/about-claude/models/overview
- 2.странице цен Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 3.руководству Claude Academy по выбору моделиacademy.claude.com/tutorials/choosing-the-right-claude-model
- 4.руководстве Anthropic по выбору моделиplatform.claude.com/docs/en/about-claude/models/choosing-a-model
- 5.списку поддерживаемых стран Anthropicanthropic.com/supported-countries
- 6.Haiku 5.5 и Sonnet 5.5artificialanalysis.ai/models/releases/comparisons/claude-haiku-5-5-vs-claude-sonnet-5-5
- 7.Sonnet 5.5 и Opus 5.5artificialanalysis.ai/models/releases/comparisons/claude-sonnet-5-5-vs-claude-opus-5-5
- 8.Opus 5.5 и Fable 5.1artificialanalysis.ai/models/releases/comparisons/claude-opus-5-5-vs-claude-fable-5-1
- 9.странице жизненного цикла моделей Claudeplatform.claude.com/docs/en/about-claude/model-deprecations
- 10.Opus 5.5platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
- 11.Sonnet 5.5platform.claude.com/docs/en/models/sonnet-5-5/whats-new-sonnet-5-5
- 12.Haiku 5.5platform.claude.com/docs/en/models/haiku-5-5/whats-new-haiku-5-5