Claude Fable 5.2 vs GPT-6.2 Sol: сравнение, цена задачи и тест
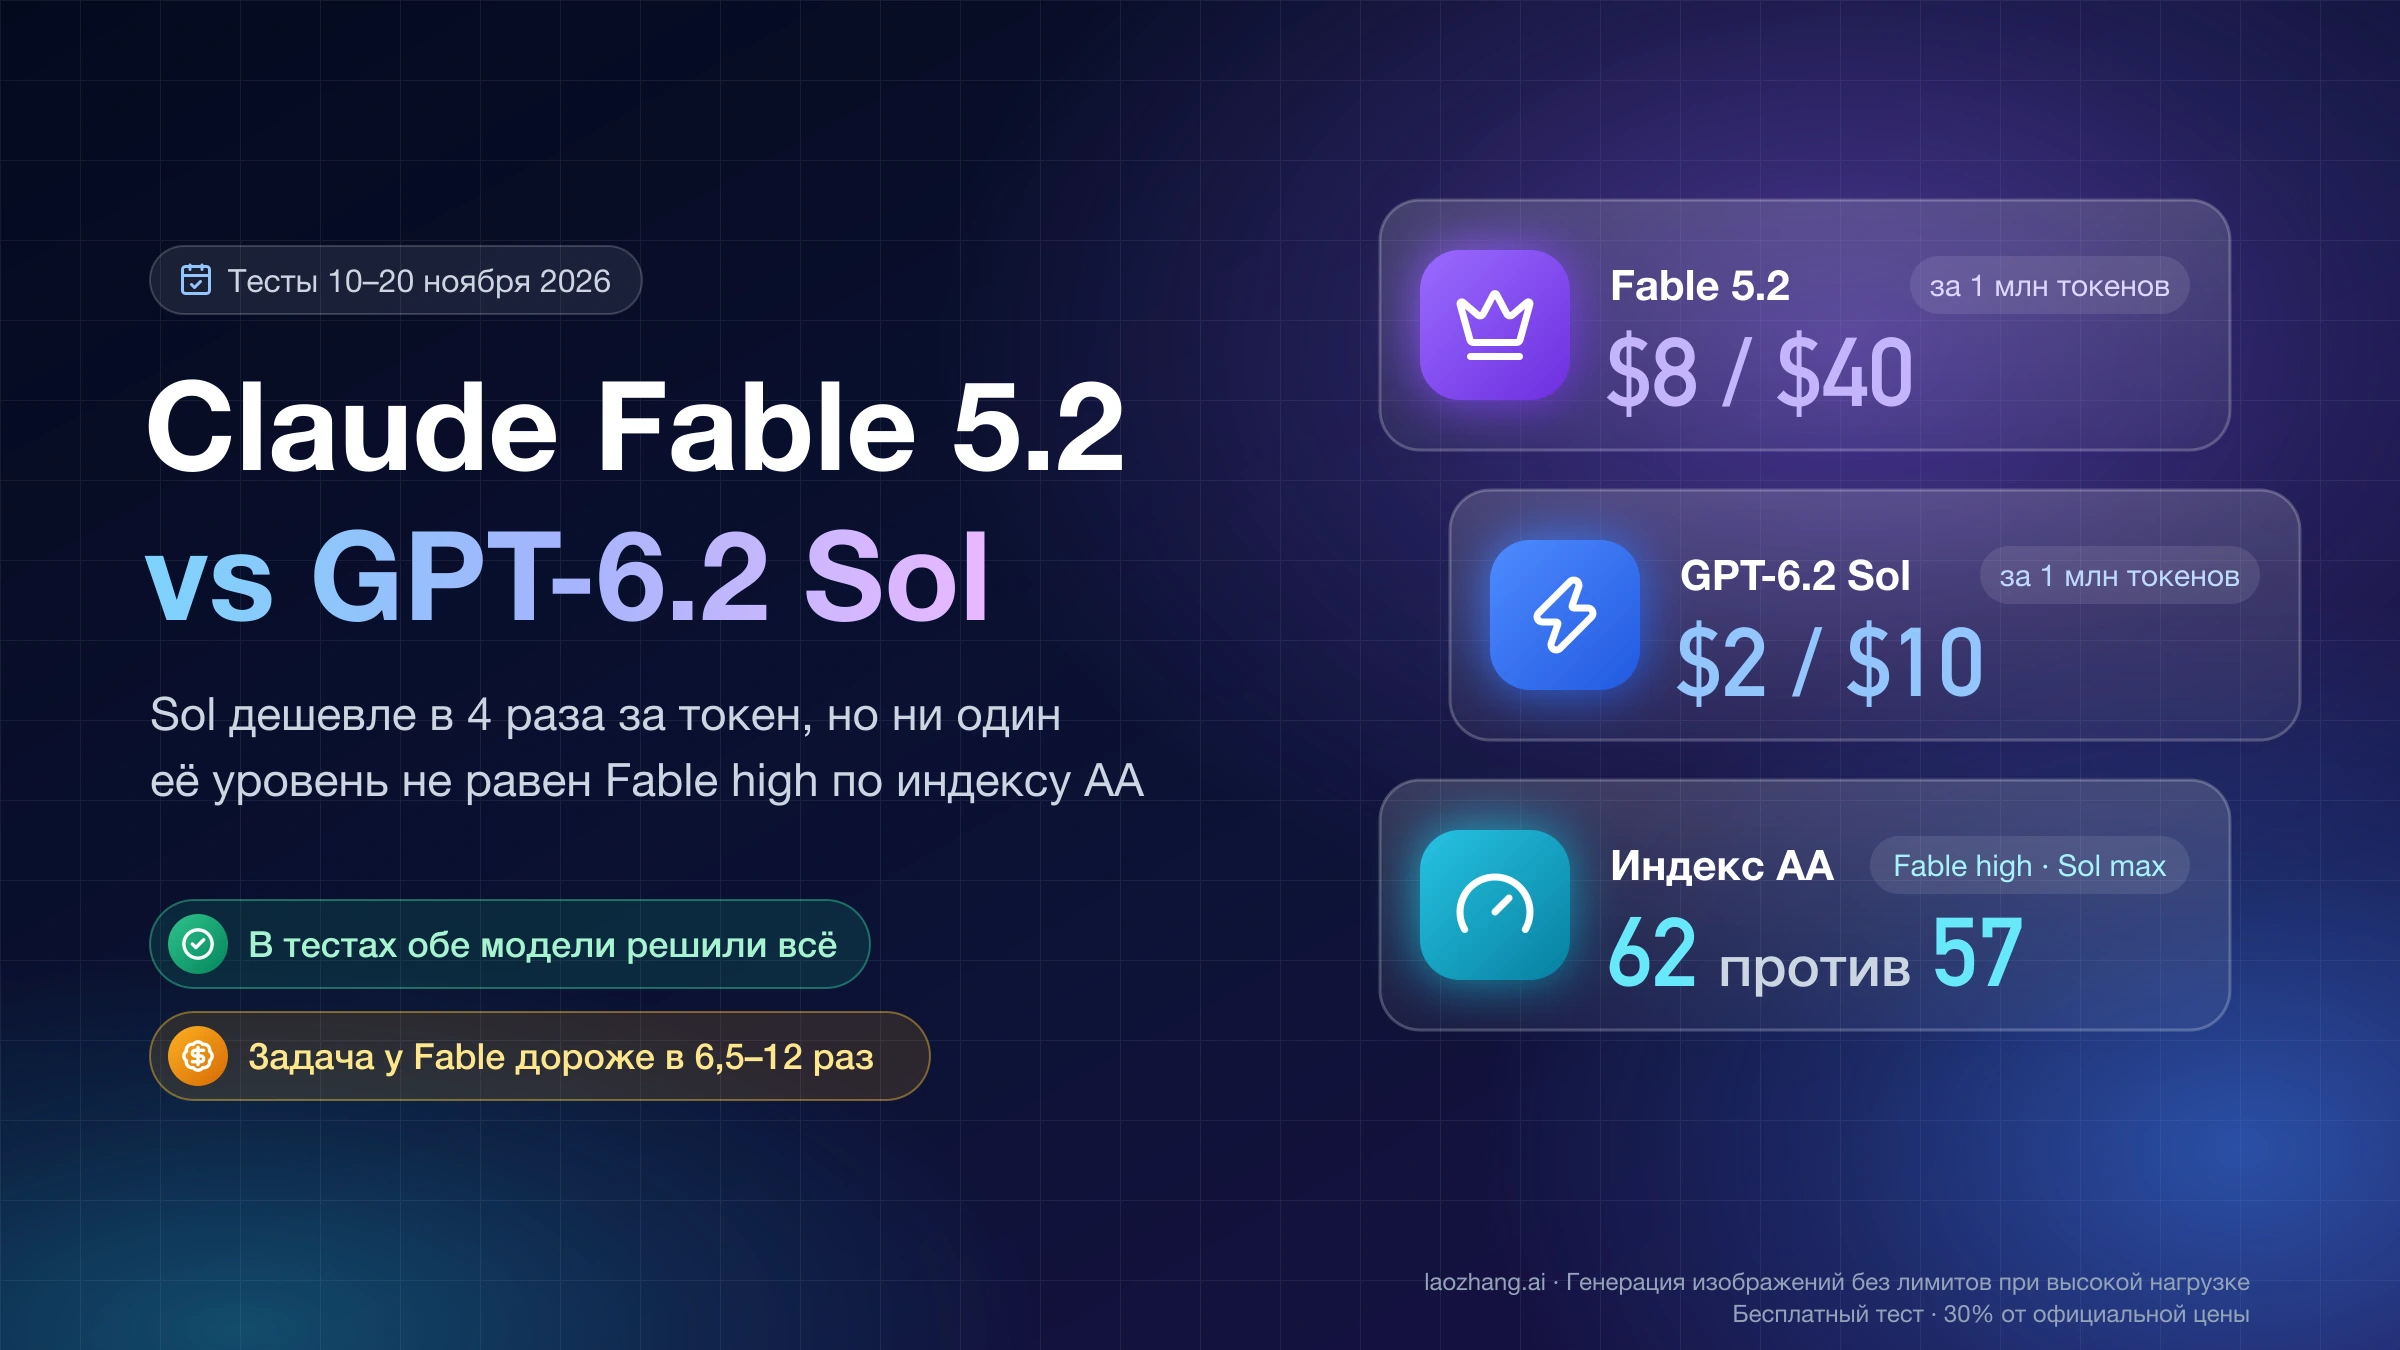
GPT-6.2 Sol в 4 раза дешевле Claude Fable 5.2 за токен и в 6,5–12 раз за задачу, но ни один уровень Sol не дотягивает в индексе AA до Fable high.
Содержание
Если вы платите за Claude Fable 5.2 и присматриваетесь к вышедшей 17 ноября 2026 года GPT-6.2 Sol, переводите на gpt-6.2-sol повседневную работу — код по понятной спецификации, задачи с тестами, разбор логов, небольшие агентские задачи в CLI — и начинайте с уровня medium, который у Sol стоит по умолчанию; high или xhigh включайте, только когда проверки начинают падать. На claude-fable-5-2 с уровнем high оставьте работу, где нужен потолок качества: по индексу Artificial Analysis ни один уровень Sol не набирает столько, сколько Fable на high (57 против 62 по состоянию на 20 ноября 2026 года), а на собственных графиках OpenAI Fable на верхних уровнях впереди в четырёх бенчмарках из пяти.
За токен Fable дороже в 4 раза, за задачу — намного сильнее, потому что тот же текст она считает большим числом токенов и пишет более длинные ответы. В четырёх тестах на одинаковых заданиях с 10 по 20 ноября 2026 года Fable обошлась в 6,5–12 раз дороже Sol, и при этом обе модели решили всё, включая набор, составленный специально, чтобы их развести. Измеренная разница, таким образом, — это цена, токены и время; разница в качестве известна только по индексу AA и графикам OpenAI, и на своих задачах её придётся проверять самим.
Часть условий решает выбор раньше качества. Fable 5.2 требует 30-дневного хранения данных и отвечает ошибкой 400 на принудительный tool_choice; Sol отвечает 400 на уровень none, при входе больше 272 000 токенов тарифицирует весь запрос по $4 / $15 и в обычном чате ChatGPT недоступна — только в ChatGPT Work и Codex.
Цена Fable 5.2 и Sol: в 4 раза за токен, в 9–26 раз за задачу
По странице цен Claude API и странице цен OpenAI API на 18 ноября 2026 года Fable 5.2 стоит вчетверо дороже GPT-6.2 Sol и за вход, и за выход. Но за задачу разрыв больше: в индексе Artificial Analysis на одном и том же уровне effort Fable дороже в 9–26 раз, потому что тратит больше токенов с обеих сторон. Ставки ниже — за 1 млн токенов, в долларах США.
| Тариф | Claude Fable 5.2 | GPT-6.2 Sol | Во сколько раз дороже Fable |
|---|---|---|---|
| Ввод | $8 | $2 | 4 |
| Вывод | $40 | $10 | 4 |
| Чтение из кэша | $0,20 | $0,10 | 2 |
| Ввод / вывод, если вход больше 272 000 токенов | $8 / $40 | $4 / $15 | 2 и 2,67 |
| Batch | $4 / $20 | $1 / $5 | 4 |
| Быстрый режим (fast mode у Fable, Fast у Sol) | $16 / $80 | $4 / $20 | 4 |
У Fable весь контекст в 1 млн токенов тарифицируется по обычной ставке, а у Sol после 272 000 входных токенов дорожает весь запрос, а не только излишек. Запись в кэш устроена по-разному: у Fable $10 за 5 минут хранения и $16 за час, у Sol $2,50 за 30 минут и $5 за 12 часов. Ultrafast у Sol стоит втрое дороже обычного тарифа до 28 февраля 2027 года, а потом вшестеро.
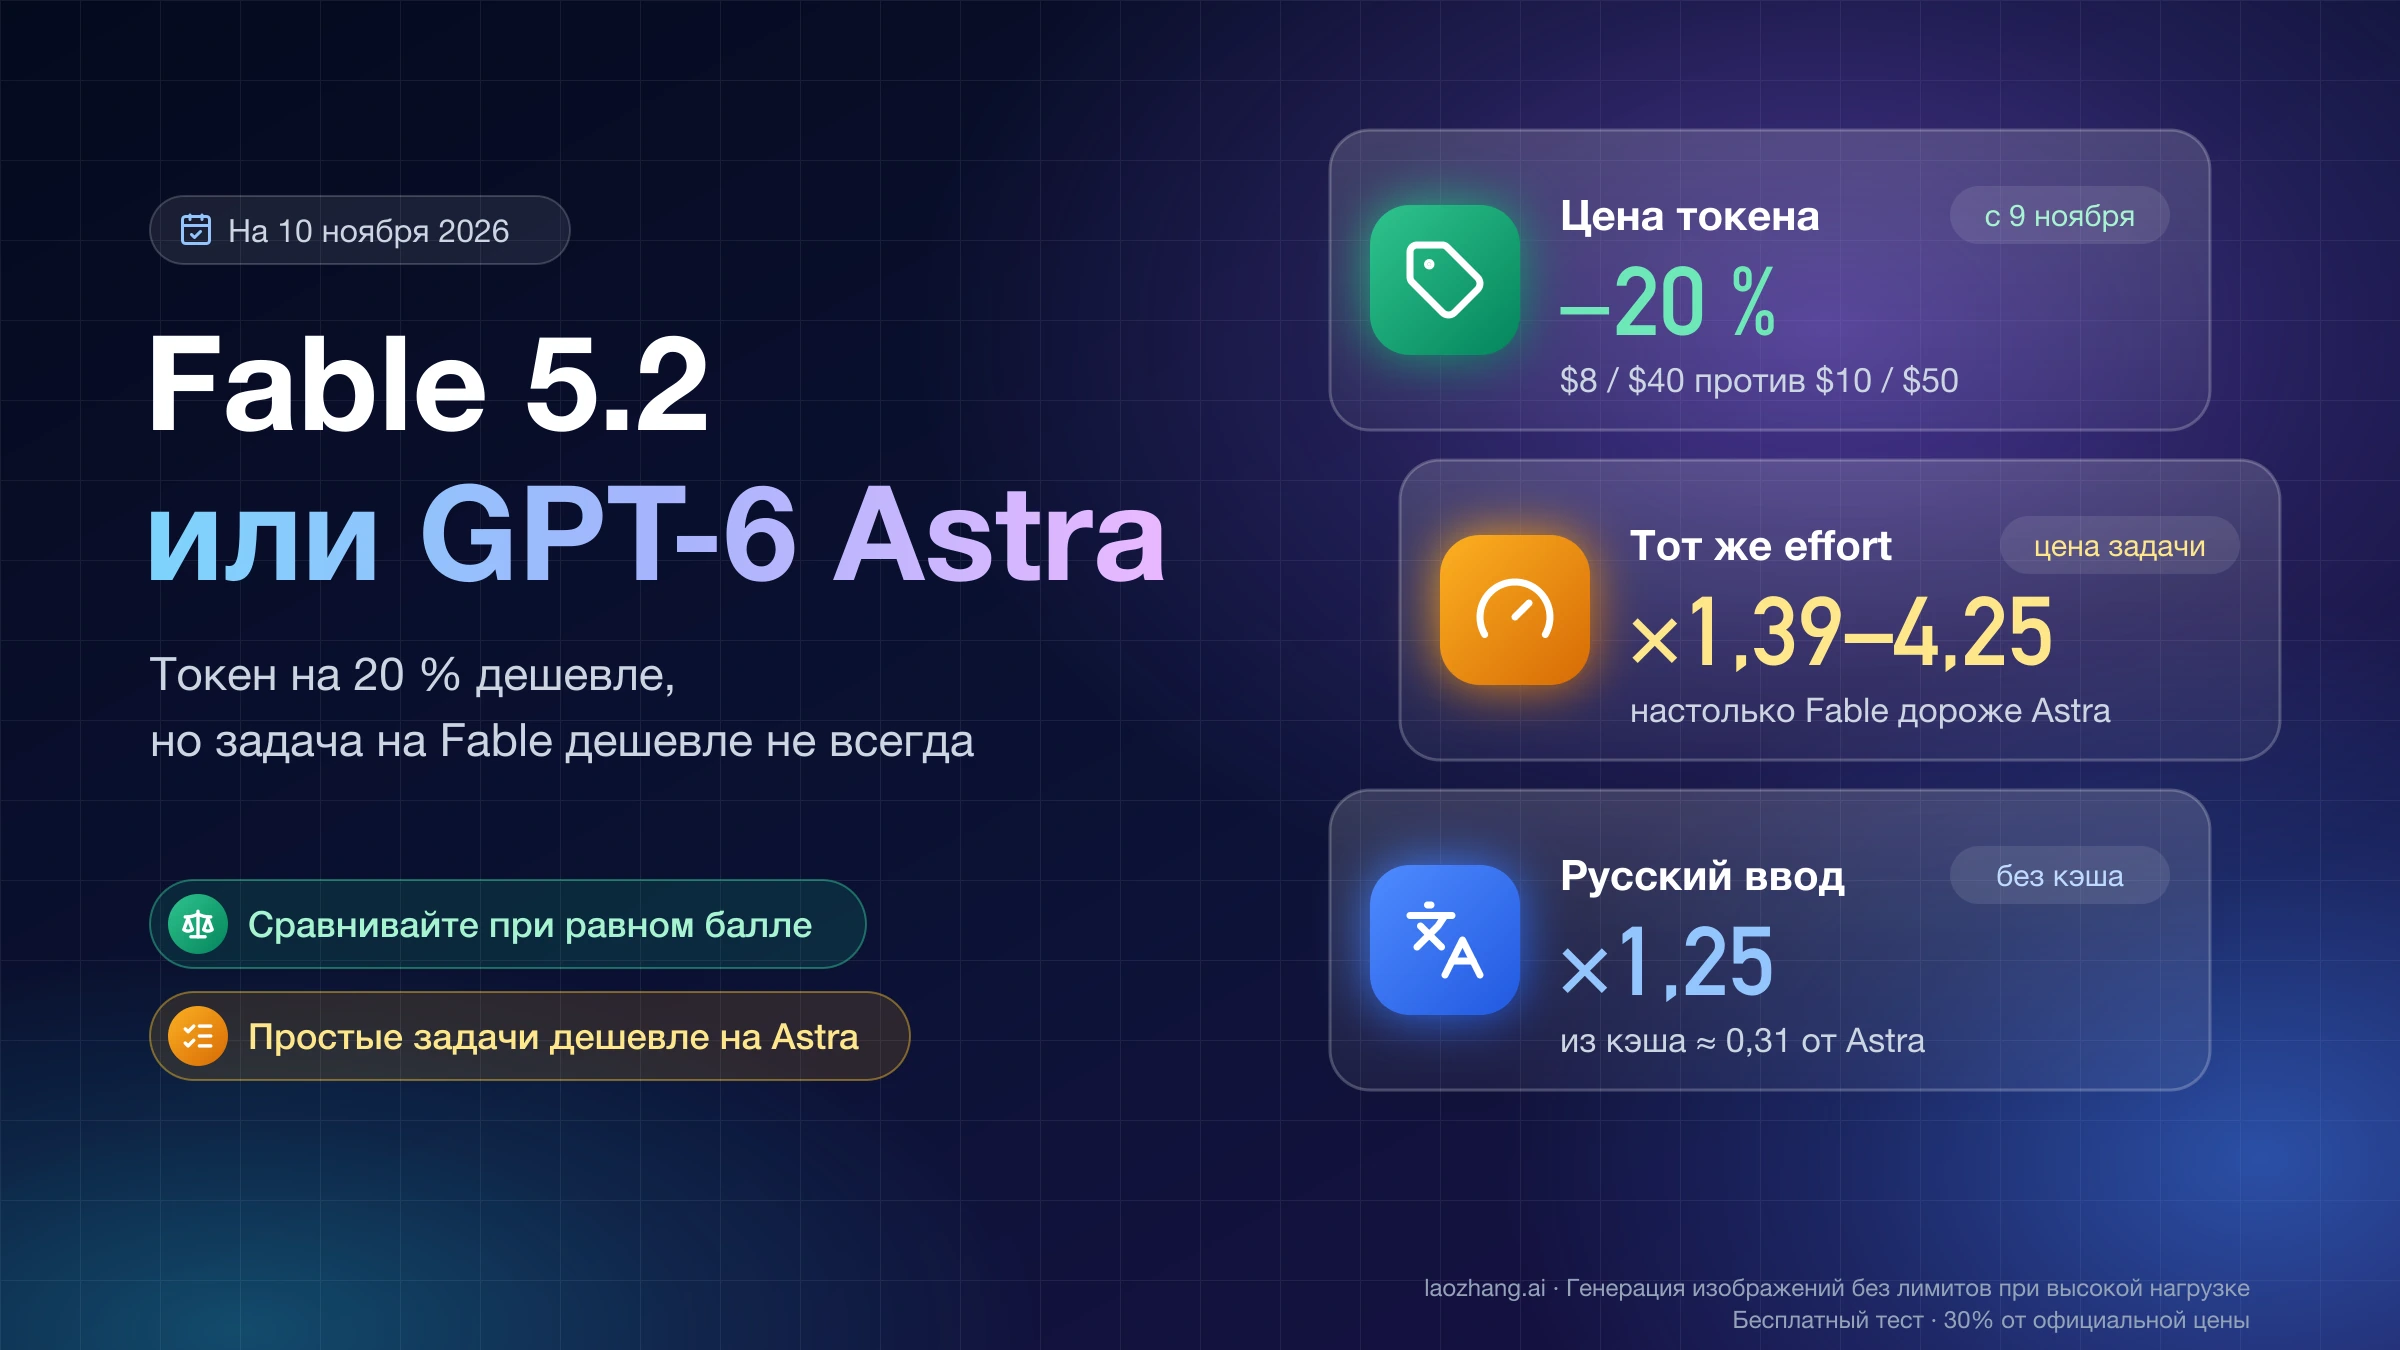
Первая причина, по которой 4 раза за токен превращаются в большее число за задачу, — счёт токенов. 18 ноября 2026 года один и тот же русский абзац Fable 5.2 посчитала как 1,56 раза больше входных токенов, чем GPT-6.2 Astra, английский — как 1,45 раза больше. Sol на 11 одинаковых запросах вернула ровно ту же сумму входных токенов, что и Astra (11 407), поэтому разумно считать, что Sol считает токены так же, — это вывод, а не опубликованный факт. Отсюда вход того же русского промпта у Fable стоит примерно 4 × 1,56 ≈ 6,2 раза больше, чем у Sol. Вторая причина — длина ответа: в тестах ниже Fable писала в 3–4 раза больше выходных токенов на те же задания.
Индекс Artificial Analysis Intelligence Index v5.0.1 показывает, что это даёт на каждом уровне. Данные по состоянию на 20 ноября 2026 года; минуты на задачу AA уже пересчитывала для Fable без объявления, поэтому они привязаны к этой дате.
| Уровень effort | Fable 5.2: балл / цена задачи / минут | GPT-6.2 Sol: балл / цена задачи / минут | Во сколько раз задача Fable дороже |
|---|---|---|---|
low | 54 / $3,10 / 5,5 | 41 / $0,18 / 1,6 | 17,2 |
medium | 56 / $3,80 / 6,5 | 53 / $0,41 / 3,5 | 9,3 |
high | 62 / $9,08 / 15,2 | 55 / $0,56 / 5,0 | 16,2 |
xhigh | 62 / $14,83 / 24,5 | 56 / $0,65 / 5,9 | 22,8 |
max | 65 / $26,54 / 42,0 | 57 / $1,01 / 9,6 | 26,3 |
Кратности — частное двух цен задачи из строки (например, $9,08 / $0,56 ≈ 16,2). Сравнивать «уровень с уровнем» удобно для бюджета, но не для выбора: одинаковые названия уровней у двух производителей не означают одинаковый результат, и Fable на каждом уровне набирает больше. Поэтому полезнее сравнивать уровни с одинаковым баллом.
Какой уровень Sol равен уровню Fable: до high не дотягивает ни один
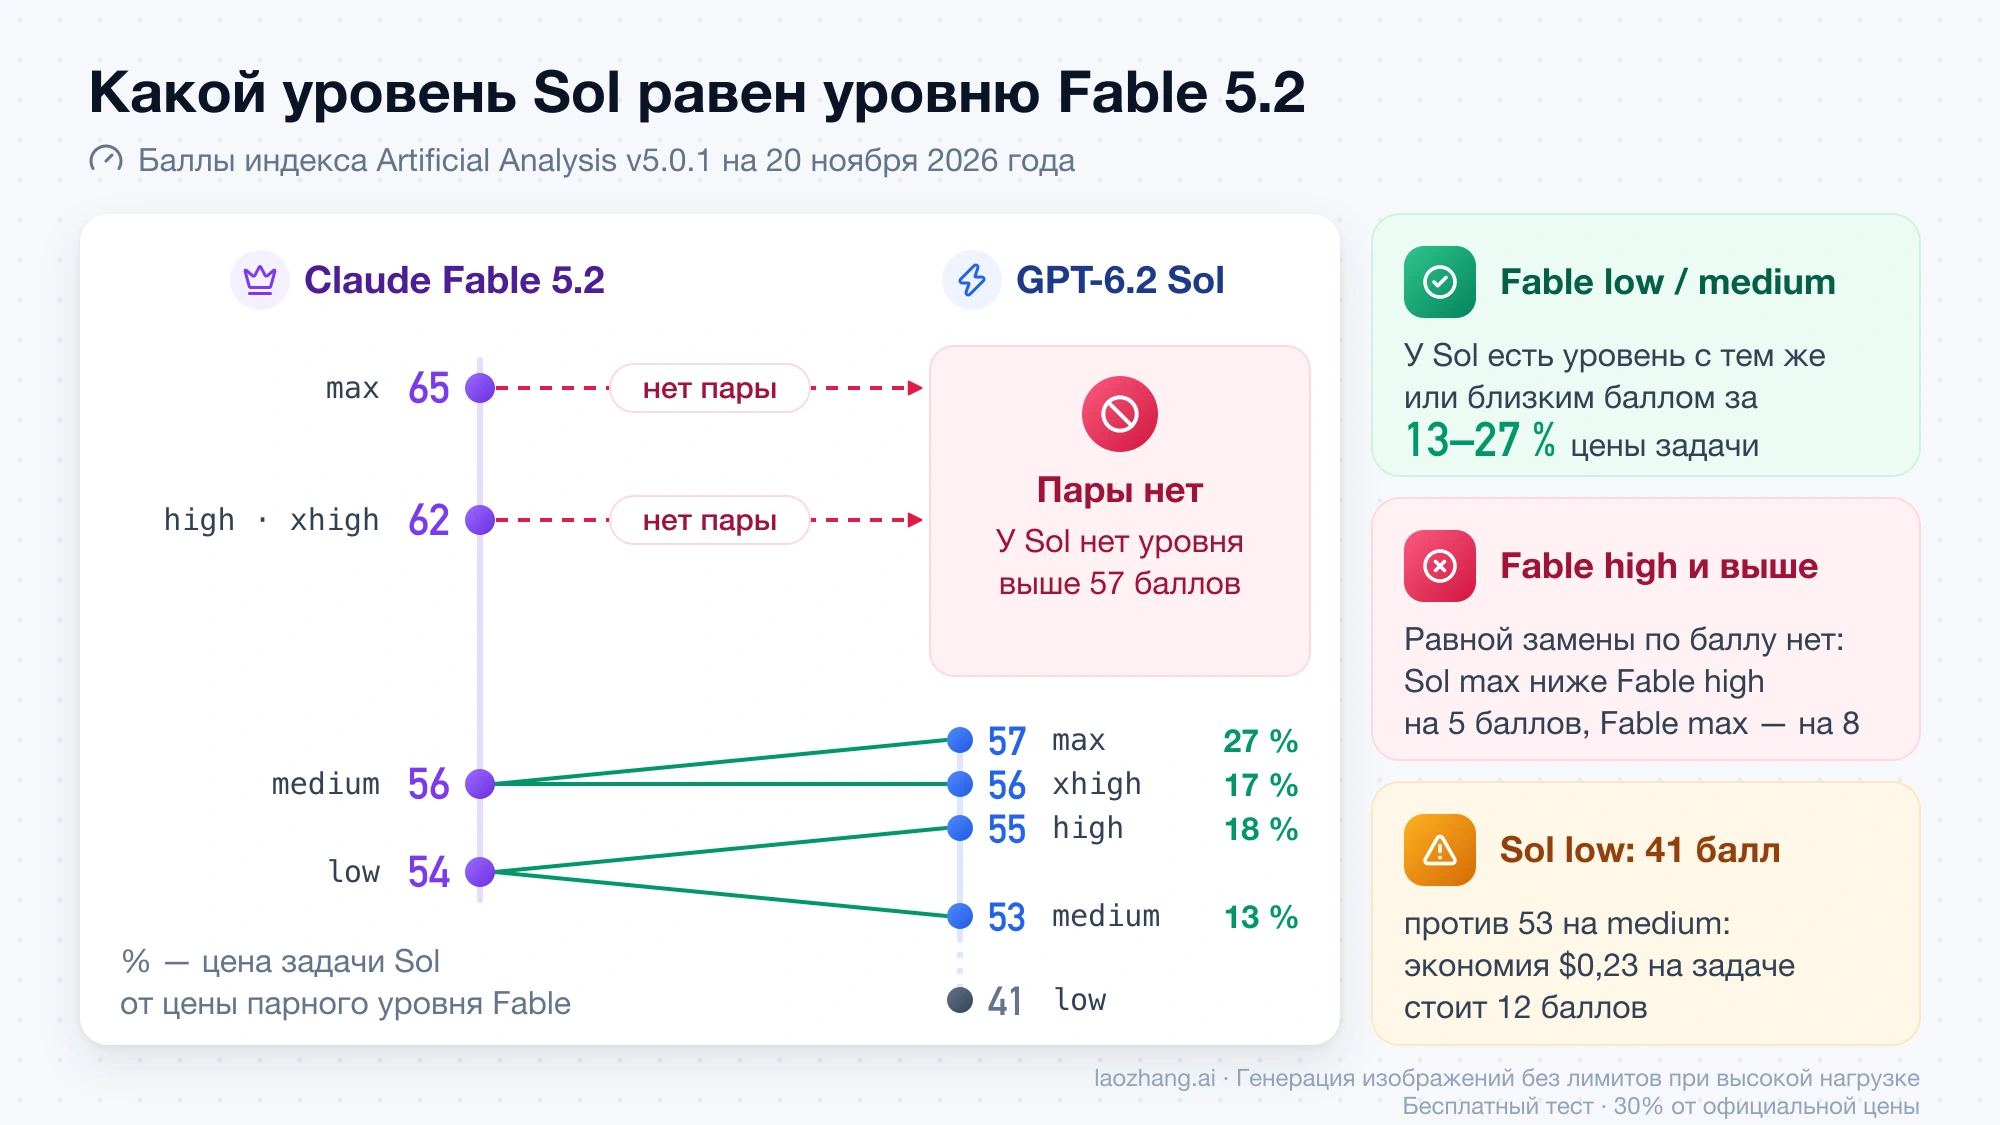
Если вы сейчас держите Fable на low или medium, у Sol есть уровень с тем же или близким баллом AA за 13–27 % цены задачи. Если вы держите Fable на high и выше, равной замены по баллу у Sol нет: её потолок, max, на 5 баллов ниже Fable high и на 8 баллов ниже Fable max. Пары посчитаны по данным AA из таблицы выше.
| Ваш уровень Fable 5.2 | Уровень Sol с тем же или ближайшим баллом | Цена задачи Sol от цены Fable |
|---|---|---|
low | high (на 1 балл выше) или medium (на 1 балл ниже) | 18 % или 13 % |
medium | xhigh (тот же балл) или max (на 1 балл выше) | 17 % или 27 % |
high | нет, max ниже на 5 баллов | — |
xhigh | нет, max ниже на 5 баллов | — |
max | нет, max ниже на 8 баллов | — |
Разрыв не исчезает и в неокруглённых значениях: на графике того же индекса в анонсе OpenAI у Fable high 61,8, у Sol max 57,3. В отраслевых подындексах AA на лучших уровнях Fable впереди на 8–12 баллов: финансы и бухгалтерия 65 против 57, стратегия и операции 67 против 59, право 63 против 55, здравоохранение 65 против 53.
Нижний уровень Sol стоит особняком: на low она набирает 41 балл против 53 на medium, то есть экономия $0,23 на задаче обходится в 12 баллов. low у Sol имеет смысл только для простой работы, которую вы на нём проверили. Индекс AA ранжирует настройки на его наборе задач и не предсказывает результат на ваших — это отправная точка для выбора уровня, а не замена проверке.
Графики OpenAI: где Sol догоняет Fable 5.2, а где отстаёт
В анонсе GPT-6.2 Astra и Sol от 17 ноября 2026 года OpenAI нарисовала Sol рядом с Fable 5.2 на пяти бенчмарках. Даже на этих данных производителя Sol опережает Fable high только в BenchCAD, а на верхних уровнях Fable впереди везде, кроме Agents' Last Exam, где разница в 0,2 пункта. Значения сняты с подписей точек на графиках; цена — за одну задачу.
| Бенчмарк | Fable 5.2 high | GPT-6.2 Sol high | Лучший результат Fable | Лучший результат Sol |
|---|---|---|---|---|
| Agents' Last Exam v1.1 | на графике одна точка Fable | 72,0 %, $0,69 | 72,8 % (max), $60,05 | 73,0 % (max), $1,32 |
| Terminal-Bench-Science 0.1 | 70,0 %, $24,28 | 67,7 %, $1,51 | 73,3 % (max), $45,21 | 68,0 % (max), $2,21 |
| Vals Science Index v1 | на графике одна точка Fable | уровни не подписаны | 63,7 %, $8,79 | 58,5 %, $0,71 |
| BenchCAD 2.1 Core | 61,0 %, $9,99 | 64,0 %, $0,75 | 83,5 % (max), $50,77 | 73,1 % (max), $1,60 |
| AutomationBench 1.0.6 | 44,3 %, $1,69 | 41,2 %, $0,21 | 51,4 % (max), $4,64 | 41,2 % (high), $0,21 |
У каждой строки есть оговорки. В Agents' Last Exam результат Fable посчитан без девяти задач, на которых сработала резервная модель, так что 73,0 против 72,8 нельзя читать как победу Sol. Terminal-Bench-Science для Fable прогоняла Artificial Analysis в обвязке mini-swe-agent, а сама Anthropic, как сказано в сноске OpenAI, получила для Fable 5.2 в Claude Code на max 74,6 %. На каждом графике задача Sol дешевле в разы — от 7,5 раза в AutomationBench на medium до 45 раз в Agents' Last Exam на max, а в BenchCAD на high Sol дала 64,0 % за $0,75 против 61,0 % за $9,99 у Fable. Бенчмарки и обвязку выбирал производитель, поэтому эти цифры показывают направление, а не гарантируют результат на вашей работе.
Тесты 10–20 ноября: обе модели решили всё, Fable дороже в 6,5–12 раз
Четыре прогона на одинаковых заданиях не показали разницы в качестве: обе модели прошли все проверки, а Fable каждый раз стоила в 6,5–12 раз больше Sol и работала дольше. Три теста шли через API-шлюз laozhang.ai (Messages API для Fable, Chat Completions для Sol) с одними и теми же промптами и проверками, и в них обе модели работали на своих уровнях по умолчанию: Fable на high, Sol на medium. Четвёртый прошёл в фирменных CLI-агентах по подписке, и там обе стояли на high — для Fable в Claude Code это выше её уровня по умолчанию medium. В первых трёх строках таблицы Fable прогонялась на 7–10 дней раньше Sol, даты указаны; цена Fable за это время не менялась.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
| Тест | Даты (Fable / Sol) | Fable 5.2 | GPT-6.2 Sol | Fable дороже в |
|---|---|---|---|---|
| 8 заданий, 11 проверяемых ответов, API | 11 / 18 ноября | high по умолчанию: 11/11, $0,7436, 173,2 с | medium по умолчанию: 11/11, $0,0610, 56 с | 12,2 раза |
| Лог 146 КБ, семь точных подсчётов, API | 11 / 18 ноября | high: всё верно, $1,02, 73,7 с | medium: всё верно, $0,1581, 13,6 с | 6,5 раза |
| 11 задач в агенте: Claude Code и Codex CLI | 10 / 20 ноября | Claude Code, high: 22/22, $2,1545, 221,8 с | Codex CLI 0.166.0, high: 33/33, $0,184, 195 с | 11,7 раза |
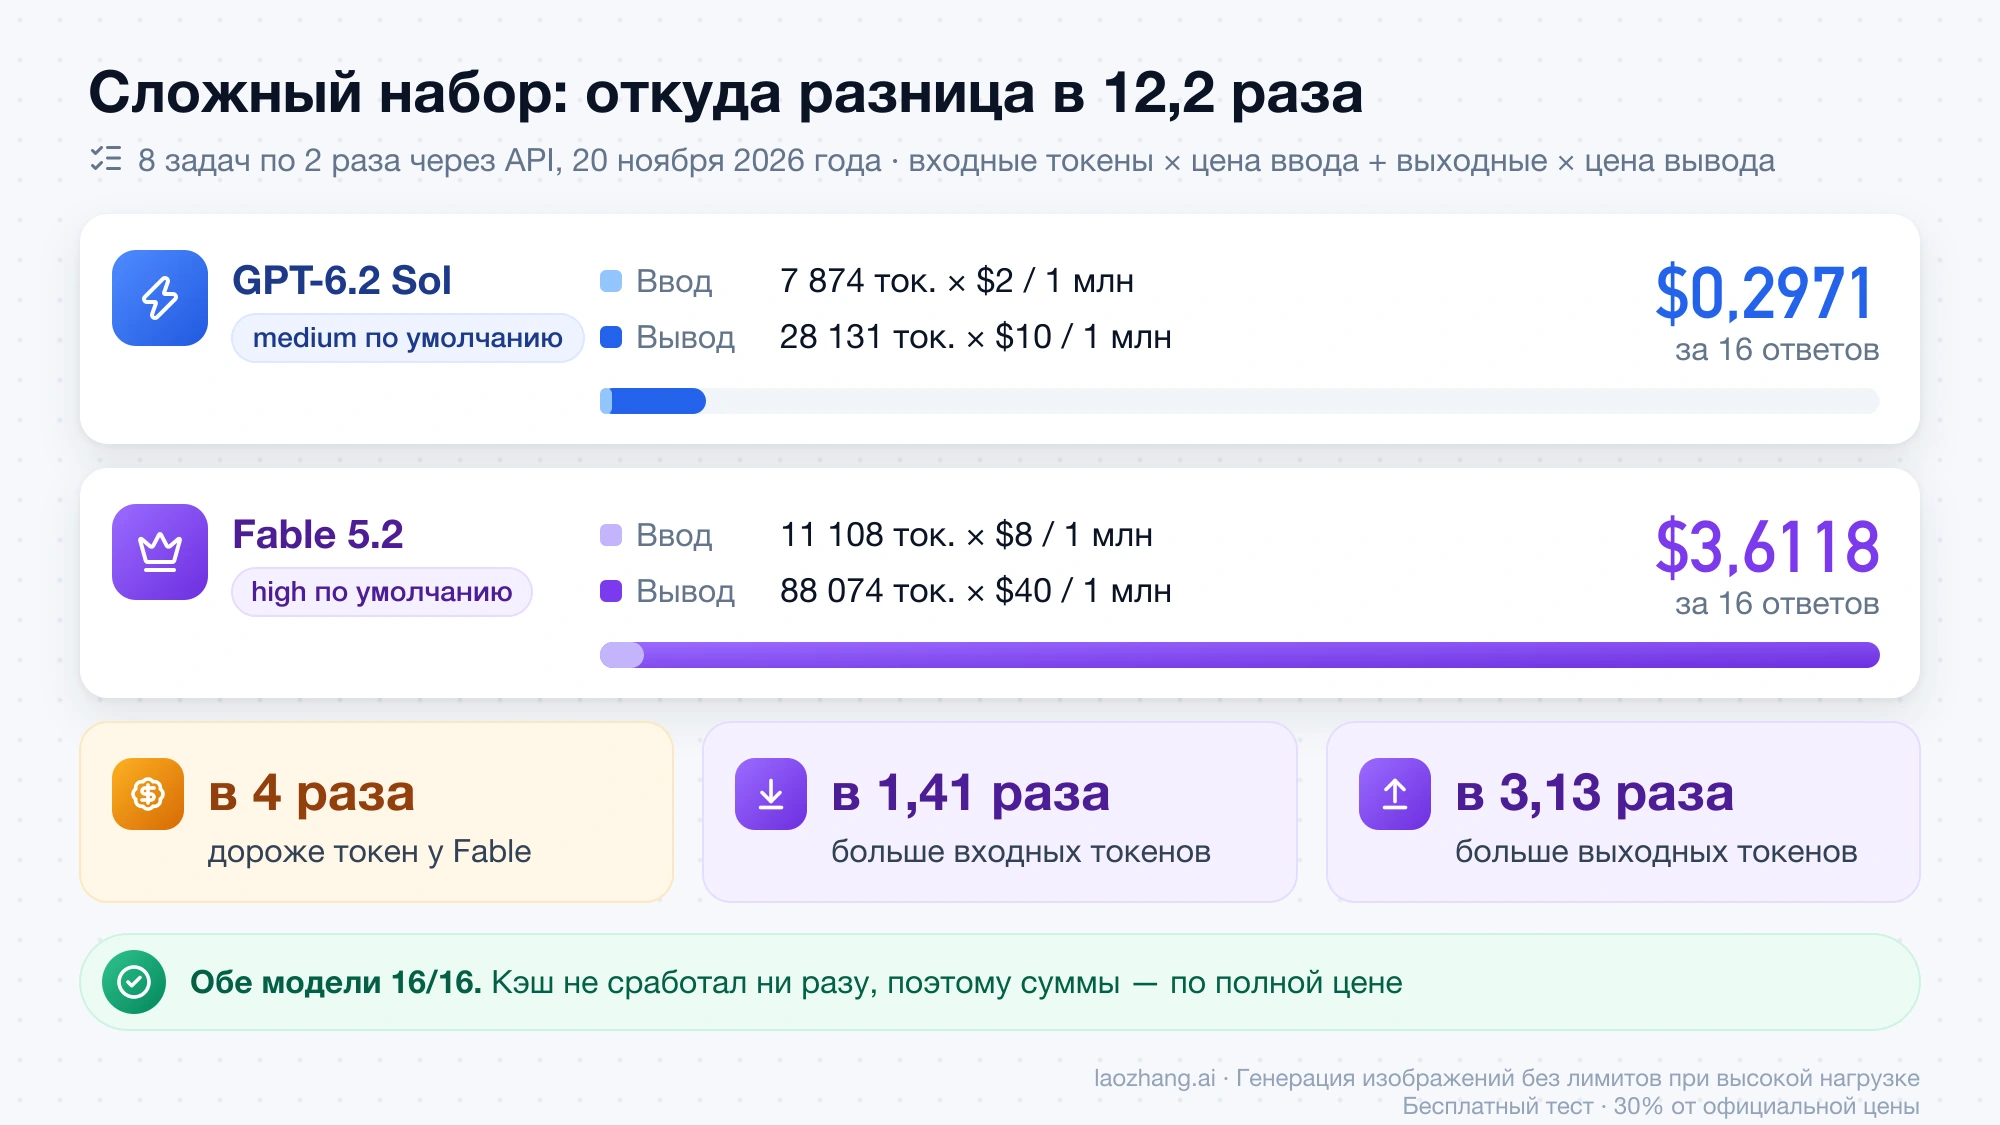
| Новый сложный набор, 8 задач по 2 раза, API | 20 ноября | high по умолчанию: 16/16, $3,6118, медиана 25,8 с на вызов | medium по умолчанию: 16/16, $0,2971, медиана 7,3 с | 12,2 раза |
Сложный набор собран 20 ноября 2026 года именно для того, чтобы найти разницу в качестве. Задания и скрытые проверки зафиксированы до первого вызова: поиск свободных окон для встреч (37 проверок), интерпретатор целочисленных выражений с приоритетами, унарным минусом, ленивыми операторами и исключениями, планировщик с переходом на летнее время (пропущенные и двойные часы, получасовой сдвиг на острове Лорд-Хау, пропущенный день в Апиа в 2011 году), сопоставление glob-шаблонов с раскрытием фигурных скобок и **, поиск и исправление двух ошибок в 83-строчном LRU/TTL-кэше, JSON-план под восемь связанных правил, подсчёт строк длины 12 (точный ответ 6503) и 12-дневная симуляция склада (точный ответ $130,10). Все 80 вызовов, по два на задачу и конфигурацию, вернулись с первого раза без обрезки, и все пять конфигураций решили все 16 ответов. После прогона из проверок исключён один скрытый тест для glob-шаблонов: он проверял правило о запятой внутри [...], которого в условии не было, и на нём одинаково споткнулись все 10 ответов, так что на сравнение моделей это не влияет.
Повышение effort у Sol на этом наборе стоило денег и ничего не изменило в результате. На high Sol обошлась в $0,4574, на xhigh — в $0,7008, а токенов рассуждений на xhigh ушло почти вчетверо больше, чем по умолчанию (55 000 против 14 502). Fable на medium решила то же самое за $1,7857 — вдвое дешевле своего уровня по умолчанию, но всё ещё в 2,55 раза дороже Sol xhigh. По отдельным задачам Fable на high была дороже Sol на medium в 9,2–19,7 раза и не выиграла по цене ни одну из восьми.
Цену вызова легко пересчитать: входные токены × цена ввода + выходные токены × цена вывода. Для сложного набора у Sol это 7 874 × $2 / 1 млн + 28 131 × $10 / 1 млн ≈ $0,2971, у Fable — 11 108 × $8 / 1 млн + 88 074 × $40 / 1 млн ≈ $3,6118. Видны обе причины разрыва: на тех же промптах у Fable в 1,41 раза больше входных токенов и в 3,13 раза больше выходных. Кэш в этом тесте не сработал ни разу, поэтому суммы — по полной цене.
Тест в CLI-агентах читать нужно с поправками. Sol прогонялась 20 ноября 2026 года в Codex CLI по подписке ChatGPT, Fable — 10 ноября в Claude Code; суммы — это расход подписки, пересчитанный по ценам API, а не счёт, и сравниваются не только модели, но и два разных агента. У Sol стоимость определял контекст: около 300 000 входных токенов за прогон, примерно 88 % из кэша по $0,10. Выходных токенов у Fable было в 3,1 раза больше (24 052 против 7 755). Sol на medium в том же наборе тоже решила 33 из 33 за $0,176.
Чего эти тесты не покрывают: все задания одиночные или короткие агентские, долгих многофайловых сессий среди них нет. Именно там, по отзыву разработчика kunchenguid в X от 19 ноября 2026 года после дня работы на реальных проектах, GPT-6.2 Astra и Sol «не заменяют Fable 5.2 и Opus 5.5 один к одному»: по его словам, они не вполне верно решают, когда спросить пользователя, а когда действовать самим. Это мнение одного человека, известное по краткой публикации, но оно указывает на тот тип работы, где разницу в качестве стоит искать.
Что быстрее: Sol при равном балле, кроме уровня max
На равном или близком балле Sol тратит на задачу меньше времени, за одним исключением: Sol max догоняет Fable medium по баллу, но работает дольше. По данным AA на 20 ноября 2026 года Sol high укладывается в 5,0 минуты против 5,5 у Fable low, Sol xhigh — в 5,9 минуты против 6,5 у Fable medium, а Sol max идёт 9,6 минуты. До первого токена ответа Sol medium доходит за 3,6 секунды, Fable low — за 8,3, а на max ожидание растёт до 83,9 и 262,5 секунды соответственно.
В тестах через API разница по времени была от 3,1 до 5,4 раза в пользу Sol: 56 секунд против 173,2 на 11 ответах и 13,6 против 73,7 на логе. В агентах разрыв почти пропал — 195 секунд у Codex CLI с Sol против 221,8 у Claude Code с Fable, — потому что там значительная часть времени уходит на запуск команд и чтение контекста, а не на генерацию.
Какую работу перевести на Sol и на каком effort
Переводите на Sol ту работу, которую ваша автоматическая проверка принимает на Sol medium или high, и оставляйте на Fable задачи, ради которых вы включали её верхние уровни. Таблица — отправная точка по состоянию на 21 ноября 2026 года; основания для каждой строки — в разделах выше.
| Работа | С чего начать | Когда менять |
|---|---|---|
| Код по понятной спецификации, задачи с тестами, небольшие задачи в Codex CLI | Sol medium | Проверки падают — Sol high, затем xhigh; не помогает — Fable high |
| Разбор логов и документов до 272 000 токенов, подсчёты, извлечение данных | Sol medium | Ошибки в числах — Sol high |
Всё, что сейчас идёт на Fable low или medium | Sol high или xhigh | Тот же балл AA за 17–18 % цены задачи; вернуться, если ваша проверка покажет обратное |
Долгие многошаговые агентские сессии, трудный код, финансы, право, медицина — то, ради чего вы включали Fable high и выше | Fable high | Sol max можно проверить как дешёвый вариант, но по баллу AA он ниже |
| Вход больше 272 000 токенов | Sol: за токен всё ещё в 2–2,67 раза дешевле | Fable, если длинный контекст нужен вместе с качеством уровня high |
| PDF-документы на вход | Fable: Sol принимает только текст и изображения | — |
Учитывайте, что «по умолчанию» у Fable зависит от того, где вы её вызываете: в Claude API это high, в приложениях Claude и Claude Code — medium. Если вы сравниваете счёт за Claude Code с Sol в Codex, то с Fable на medium и сравнивайте; у Sol уровень по умолчанию везде medium.
Что исключает Fable 5.2 или Sol ещё до сравнения качества
Перед тестами проверьте ограничения, при которых одна из моделей не подходит при любом качестве. Они независимы друг от друга, поэтому пройдите все.
- Если ваша организация работает с нулевым хранением данных (zero data retention), Fable 5.2 без отдельного разрешения ответит 400: модель требует хранения данных 30 дней.
- Если код принудительно вызывает инструмент через
tool_choiceсо значениемanyилиtool, Fable 5.2 вернёт 400. - Если ваши задачи связаны с высокорисковой кибербезопасностью или исследовательской биологией, классификаторы Anthropic отправят их (в биологии — большую часть) с Fable на более старую модель.
- Если вам нужна высокая пропускная способность, учтите, что лимиты запросов у Fable 5.2 ниже, чем у Opus 5.5.
- Если сервис работает без рассуждений, на Sol его придётся перевести минимум на
low: 18 ноября 2026 года запрос кgpt-6.2-solсnoneвернул 400 «Unsupported value: 'none' is not supported with the 'gpt-6.2-sol' model. Supported values are: 'low', 'medium', 'high', 'xhigh', and 'max'.» - Если вы вызываете Sol через Chat Completions, уровни с
lowпоxhighработают, аmaxдоступен только в Responses API. - Если вход регулярно превышает 272 000 токенов, у Sol весь такой запрос идёт по повышенному тарифу.
В том же приёмочном тесте 18 ноября 2026 года Responses API без поля effort работал на medium, а вызов функций, вывод по JSON-схеме, изображения на входе и потоковая выдача работали так же, как напрямую у OpenAI. Если вы переносите на Sol длинный системный промпт, поместите его в developer-сообщение первым элементом input: начиная с GPT-6.2 инструкции верхнего уровня в Responses API добавляются после входа, и без этого они не попадут в кэш, как сказано в руководстве OpenAI по переходу на последние модели.
Есть ли Fable 5.2 и GPT-6.2 Sol в подписках ChatGPT и Claude
Есть, но не везде. По справке OpenAI на 18 ноября 2026 года GPT-6.2 Sol доступна подписчикам Plus, Pro, Enterprise и Edu в ChatGPT Work и Codex, а в обычный чат ChatGPT не добавлена; лимиты сообщений для неё OpenAI не публикует, режим Ultrafast есть на тарифах Pro за $200 и $500. У Claude модели Fable входят в подписки Max и Ultra и в премиум-места Team и Enterprise в пределах половины недельного лимита, а на Pro и стандартных местах Team оплачиваются отдельно из кредитов использования. На неделе запуска, с 9 по 16 ноября, Fable входила и в эти тарифы, но этот период закончился.
Как сравнить Fable 5.2 и Sol на своих задачах
Сравнивайте цену одного принятого результата, а не счёт за токены: это единственная мерка, которая учитывает и разницу в токенах, и повторы при ошибках.
- Соберите 15–30 реальных задач с автоматической проверкой — тестами, точным ответом или JSON-схемой. Добавьте те, на которых сейчас ошибается Fable или человек: если обе модели пройдут всё, как в тестах выше, набор слишком лёгкий, чтобы увидеть разницу в качестве.
- Прогоните Fable на том уровне, который используете сейчас, а Sol — на
mediumиhigh, по 2–3 раза на задачу, с одинаковыми промптами и без системного промпта, если в работе его нет. - Сохраняйте из ответа входные, выходные токены и токены рассуждений, время и результат проверки.
- Разделите сумму всех прогонов на число принятых ответов — это и есть цена принятого результата для каждой конфигурации.
- Если промпты на русском, сравните входные токены отдельно: у Fable их будет примерно в полтора раза больше, и в бюджете это нужно учесть.
- Переводите на Sol те типы задач, где она принята на
mediumилиhigh; где нет, попробуйтеxhighи только потом оставляйте задачу на Fable.
Fable 5.2 и GPT-6.2 Sol: другие вопросы
Что такое GPT-6.2 Sol Pro?
Это не отдельная модель, а GPT-6.2 Sol с параметром reasoning.mode: "pro" в Responses API. По руководству OpenAI по рассуждениям режим pro рассчитан на трудные задачи, где допустимы большие задержки и расход токенов, и настраивается независимо от effort. Отдельной строки в прайс-листе OpenAI у Sol Pro нет; OpenRouter на 20 ноября 2026 года указывает ту же цену за токен, $2 / $10, и предупреждает, что обычный запрос стоит в несколько раз дороже и идёт заметно дольше. Баллы AA для Sol, приведённые выше, относятся к обычному режиму.
Почему OpenAI сравнивает с Fable 5.2 не Sol, а Astra?
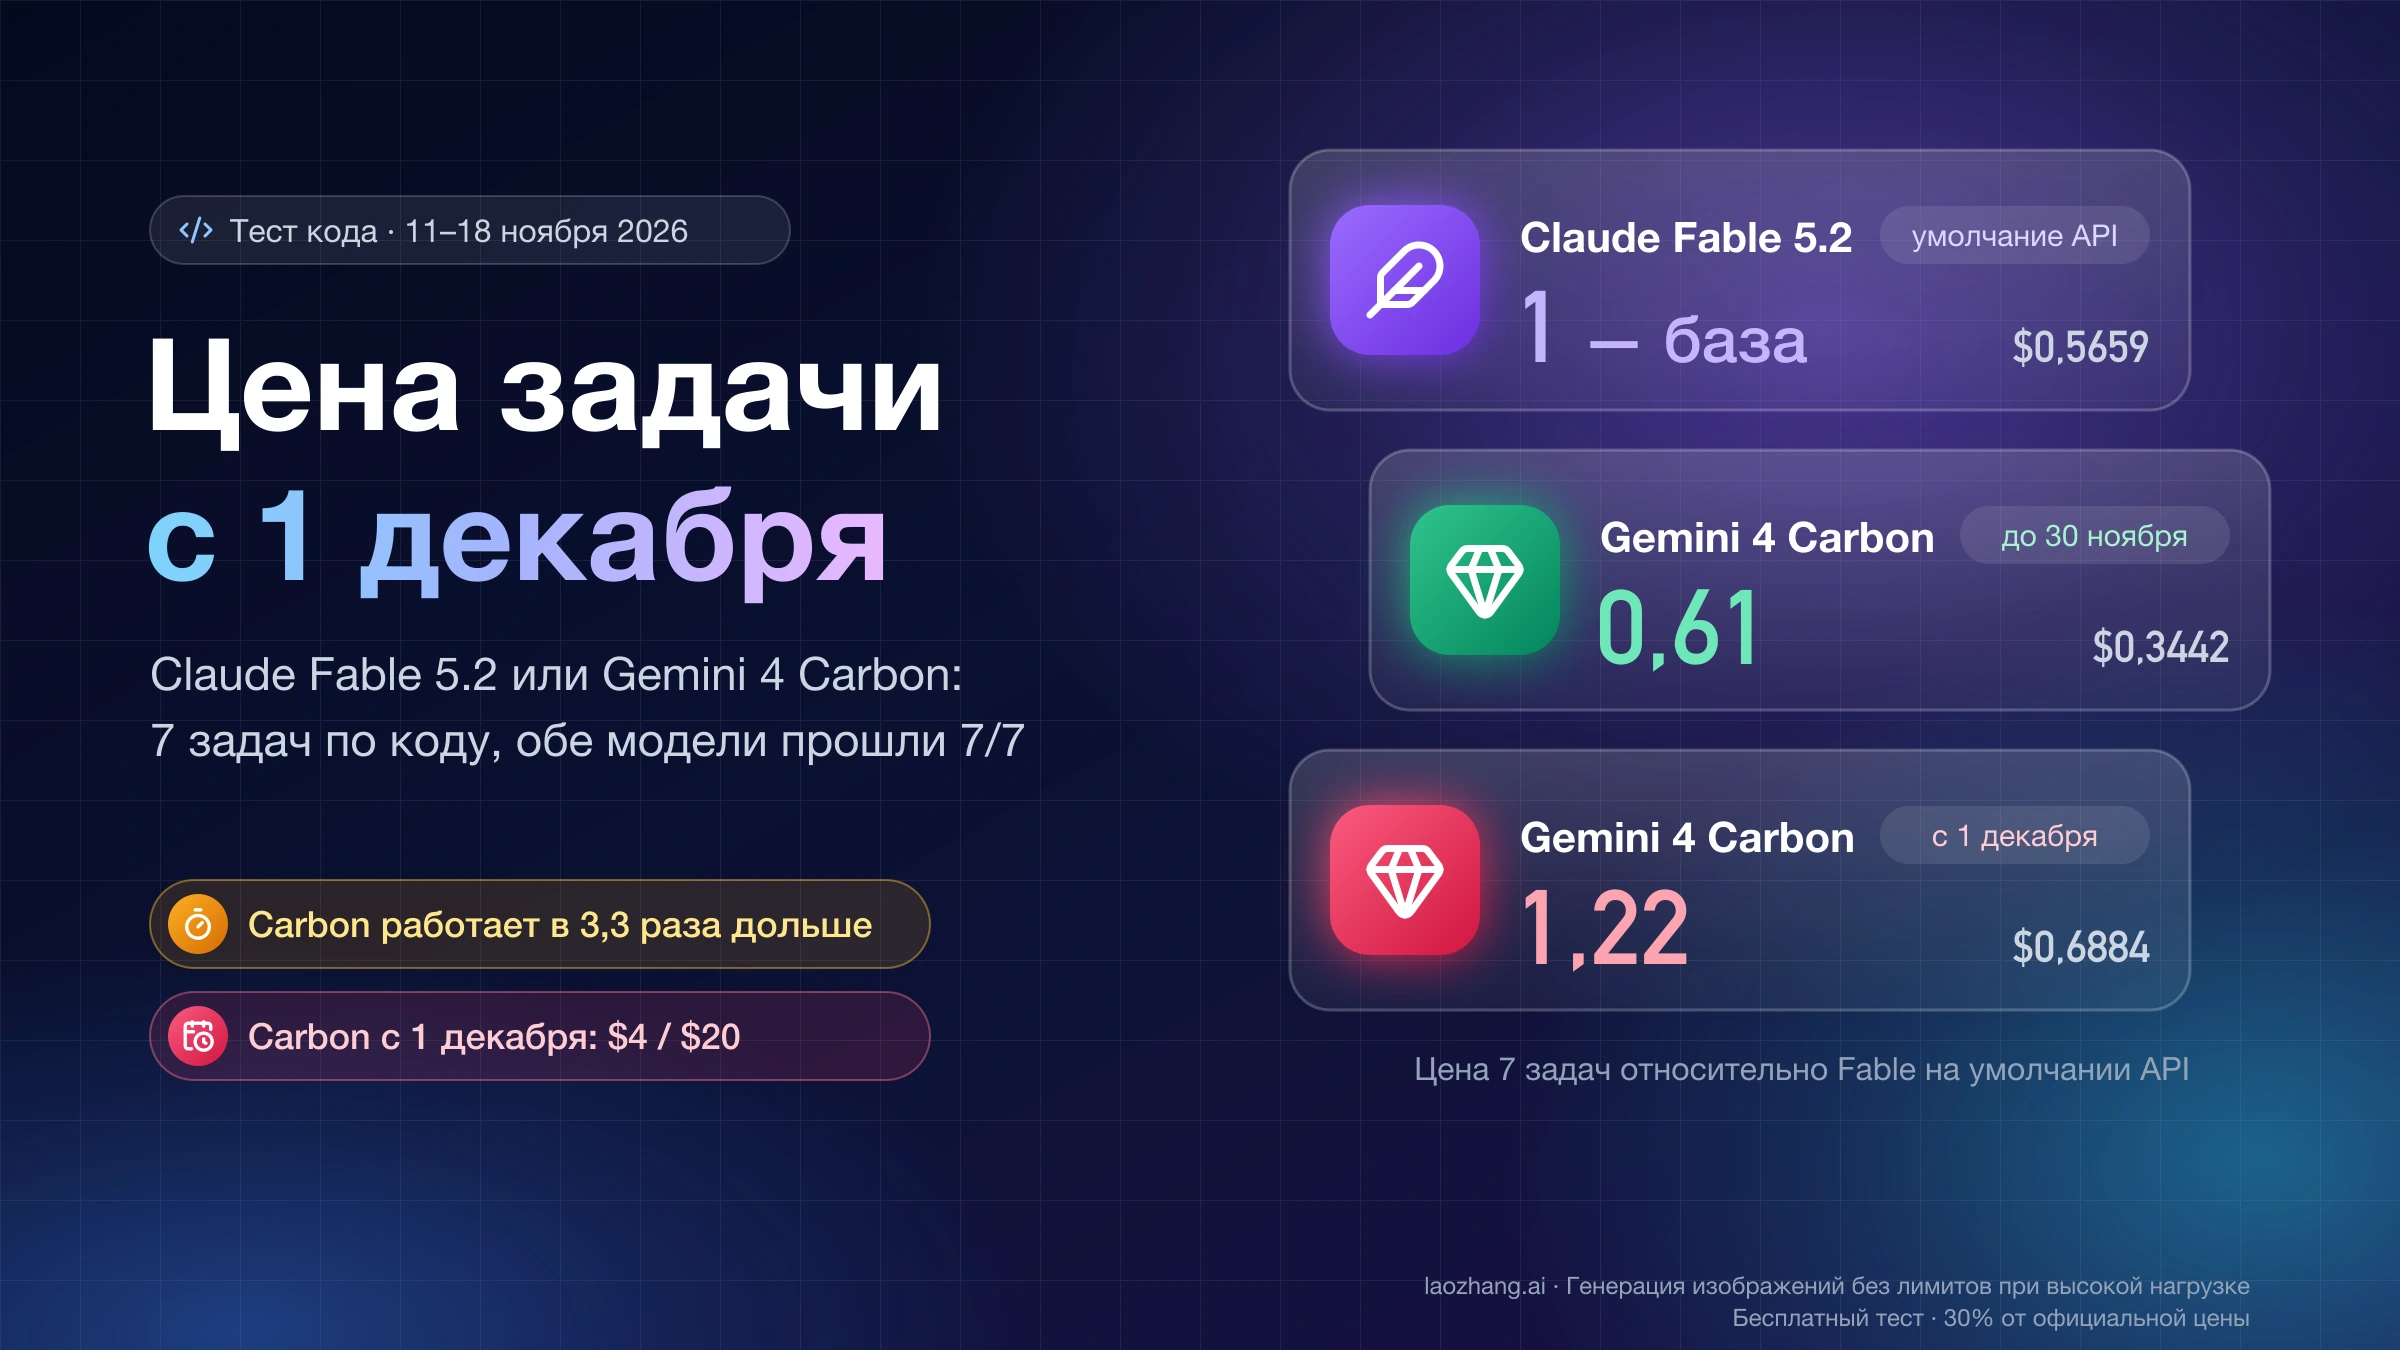
Против Fable OpenAI ставит флагман GPT-6.2 Astra, который вышел в тот же день, что и Sol, и стоит за токен столько же, сколько Fable; Sol в журнале изменений OpenAI описана как модель «для повседневного кода и агентских задач». Как Fable выглядит против Astra по цене задачи, разобрано в статье «Fable 5.2 или GPT-6 Astra и GPT-6.2 Astra: что дешевле за задачу».
Чем GPT-6.2 Sol отличается от GPT-6.1 Sol и Opus 5.5?
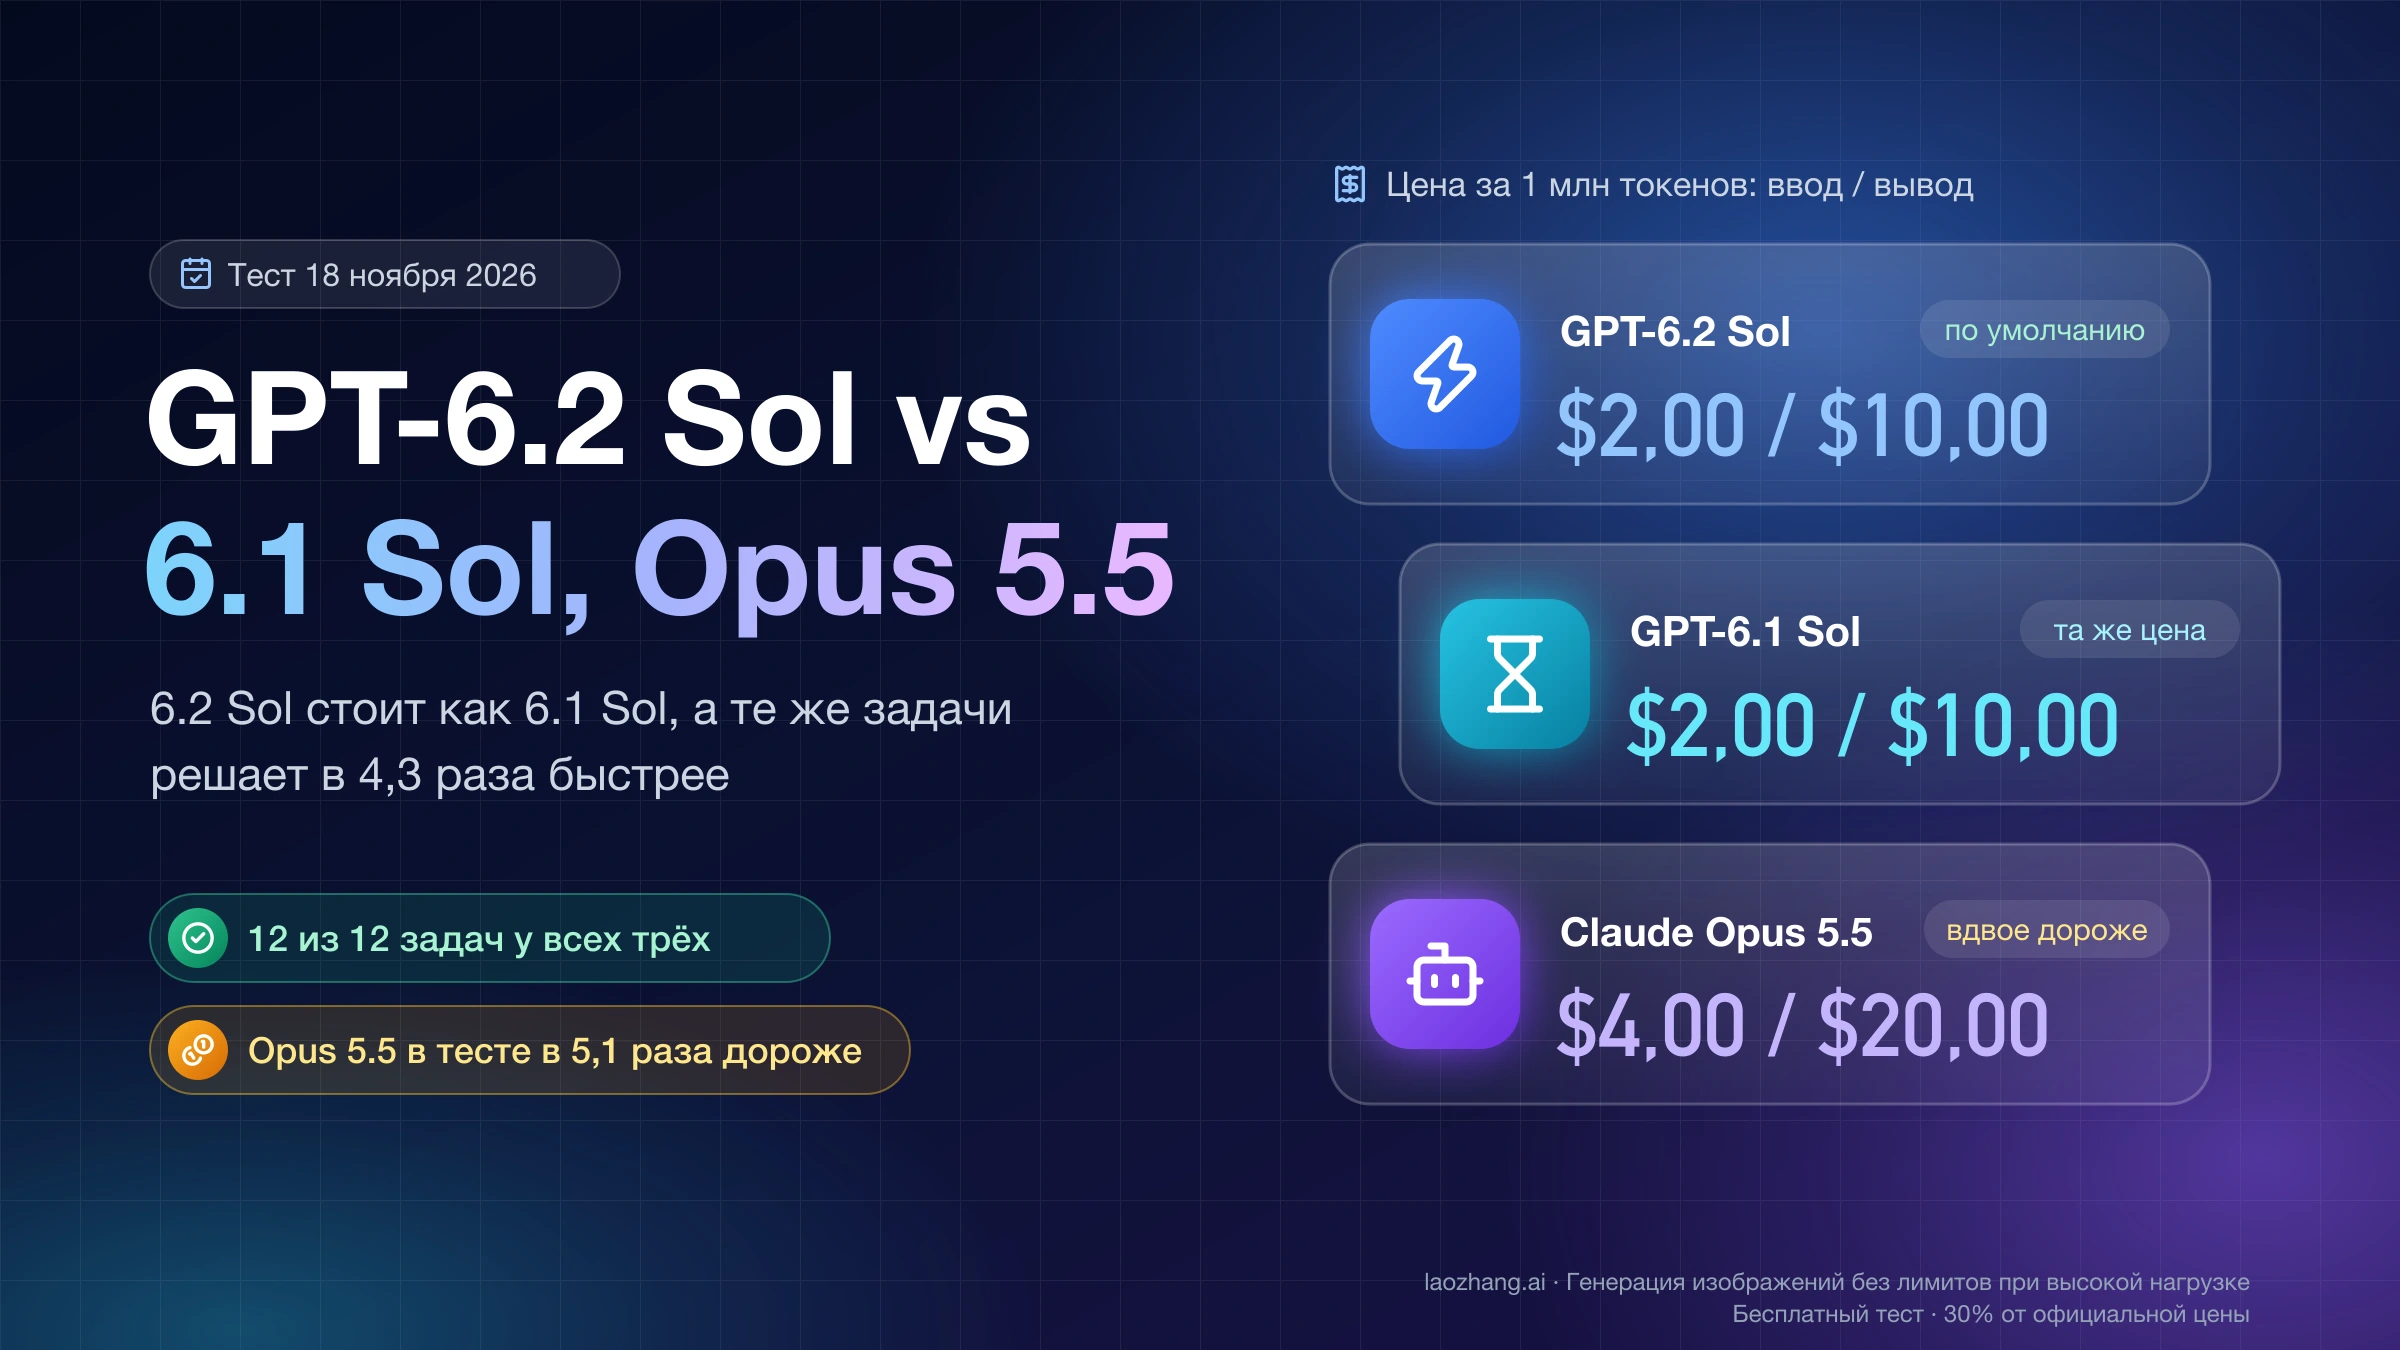
Цена за токен у 6.2 Sol та же, что у 6.1 Sol, а баллы в индексе AA выше. Подробности и тест на 12 задачах — в статье «GPT-6.2 Sol vs 6.1 Sol vs Opus 5.5: тест 12 задач и что выбрать».
Можно ли сэкономить на Fable 5.2, не уходя из Claude?
Да: более дешёвая модель Anthropic — Opus 5.5, и у неё выше лимиты запросов. Какую работу на неё переводить и на каком уровне, разобрано в статье «Claude Fable 5.2 или Opus 5.5: что выбрать и на каком effort», а подключение к API Fable — в материале «Claude Fable 5.2 API: как получить доступ, ключ и первый запрос».
Есть ли у Google модель дешевле GPT-6.2 Sol за задачу?
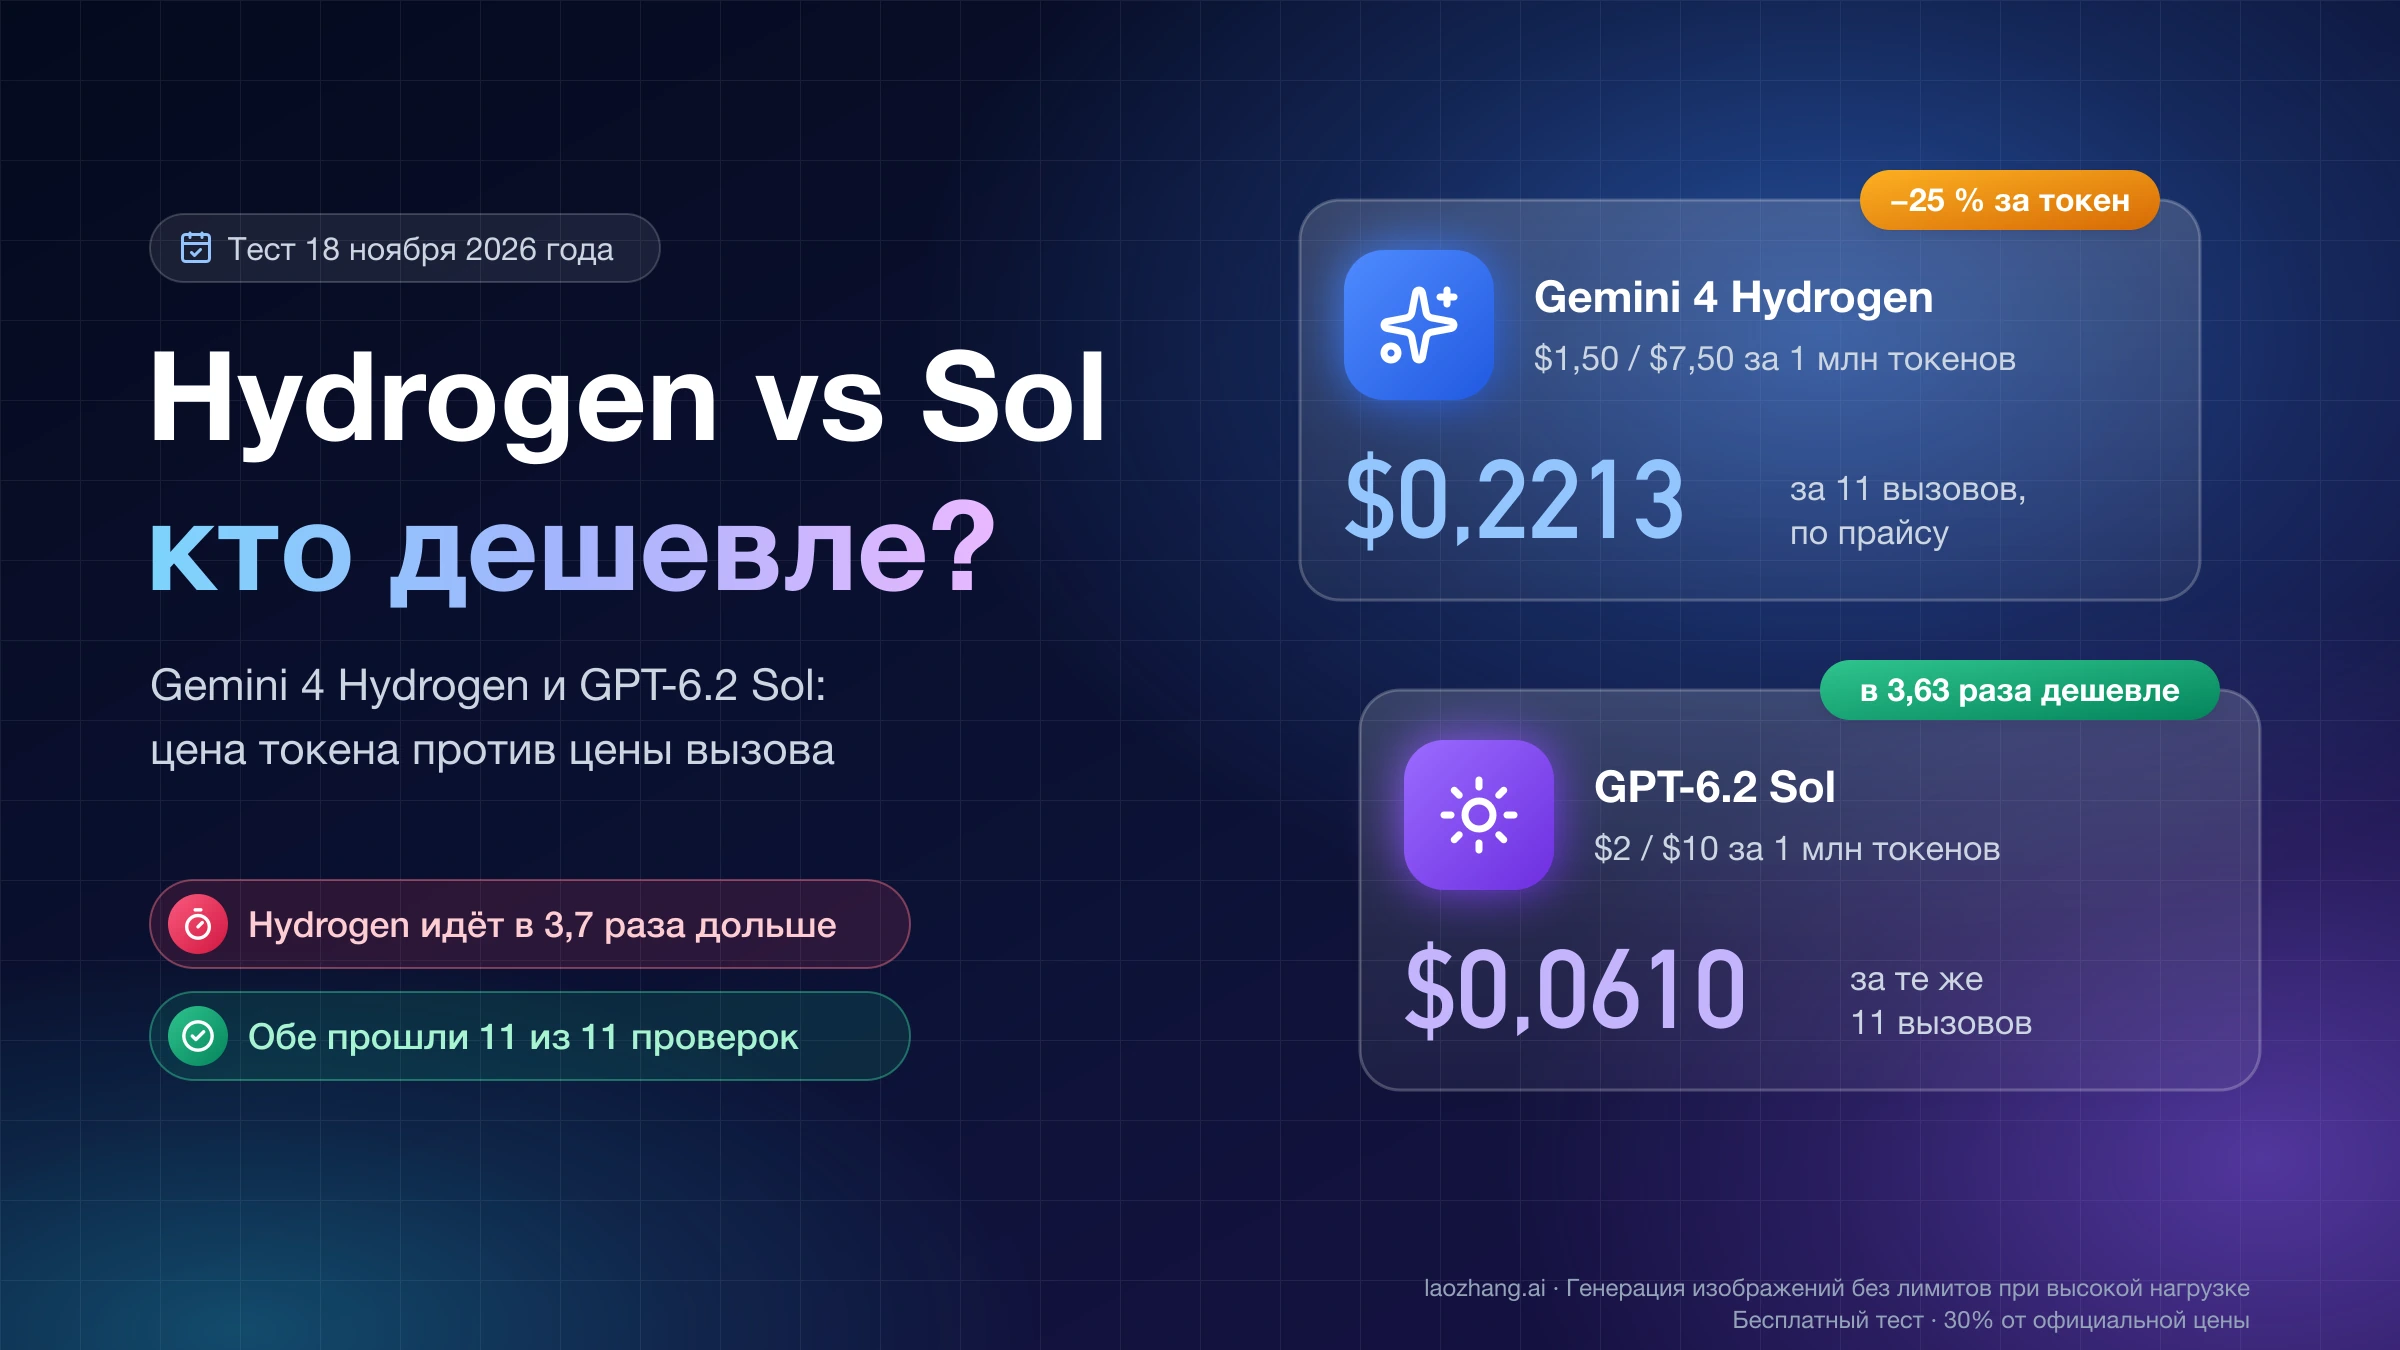
Gemini 4 Hydrogen — нет: она дешевле Sol за токен, но на тех же 11 вызовах 18 ноября 2026 года обошлась в 3,6 раза дороже. Подробно — в статье «Gemini 4 Hydrogen vs GPT-6.2 Sol: сравнение, цена задачи и тест».
Источники7
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 21 нояб. 2026 г..
Источники7
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 21 нояб. 2026 г..
- 1.странице цен Claude APIplatform.claude.com/docs/en/about-claude/pricing
- 2.странице цен OpenAI APIdevelopers.openai.com/api/docs/pricing
- 3.Artificial Analysis Intelligence Index v5.0.1artificialanalysis.ai/models/comparisons/claude-fable-5-2-vs-gpt-6-2-sol
- 4.анонсе GPT-6.2 Astra и Solopenai.com/index/introducing-gpt-6-2-astra-sol
- 5.руководстве OpenAI по переходу на последние моделиdevelopers.openai.com/api/docs/guides/latest-model
- 6.справке OpenAIhelp.openai.com/en/articles/20001354-gpt-6-and-other-models-in-chatgpt
- 7.руководству OpenAI по рассуждениямdevelopers.openai.com/api/docs/guides/reasoning