Диалог нескольких персонажей в ИИ-видео: один кадр или по планам
Двое персонажей, реплики в пределах одного клипа, редкие правки — диалог одним кадром. Трое и больше, длинный текст или частые правки — монтаж по планам.
Содержание
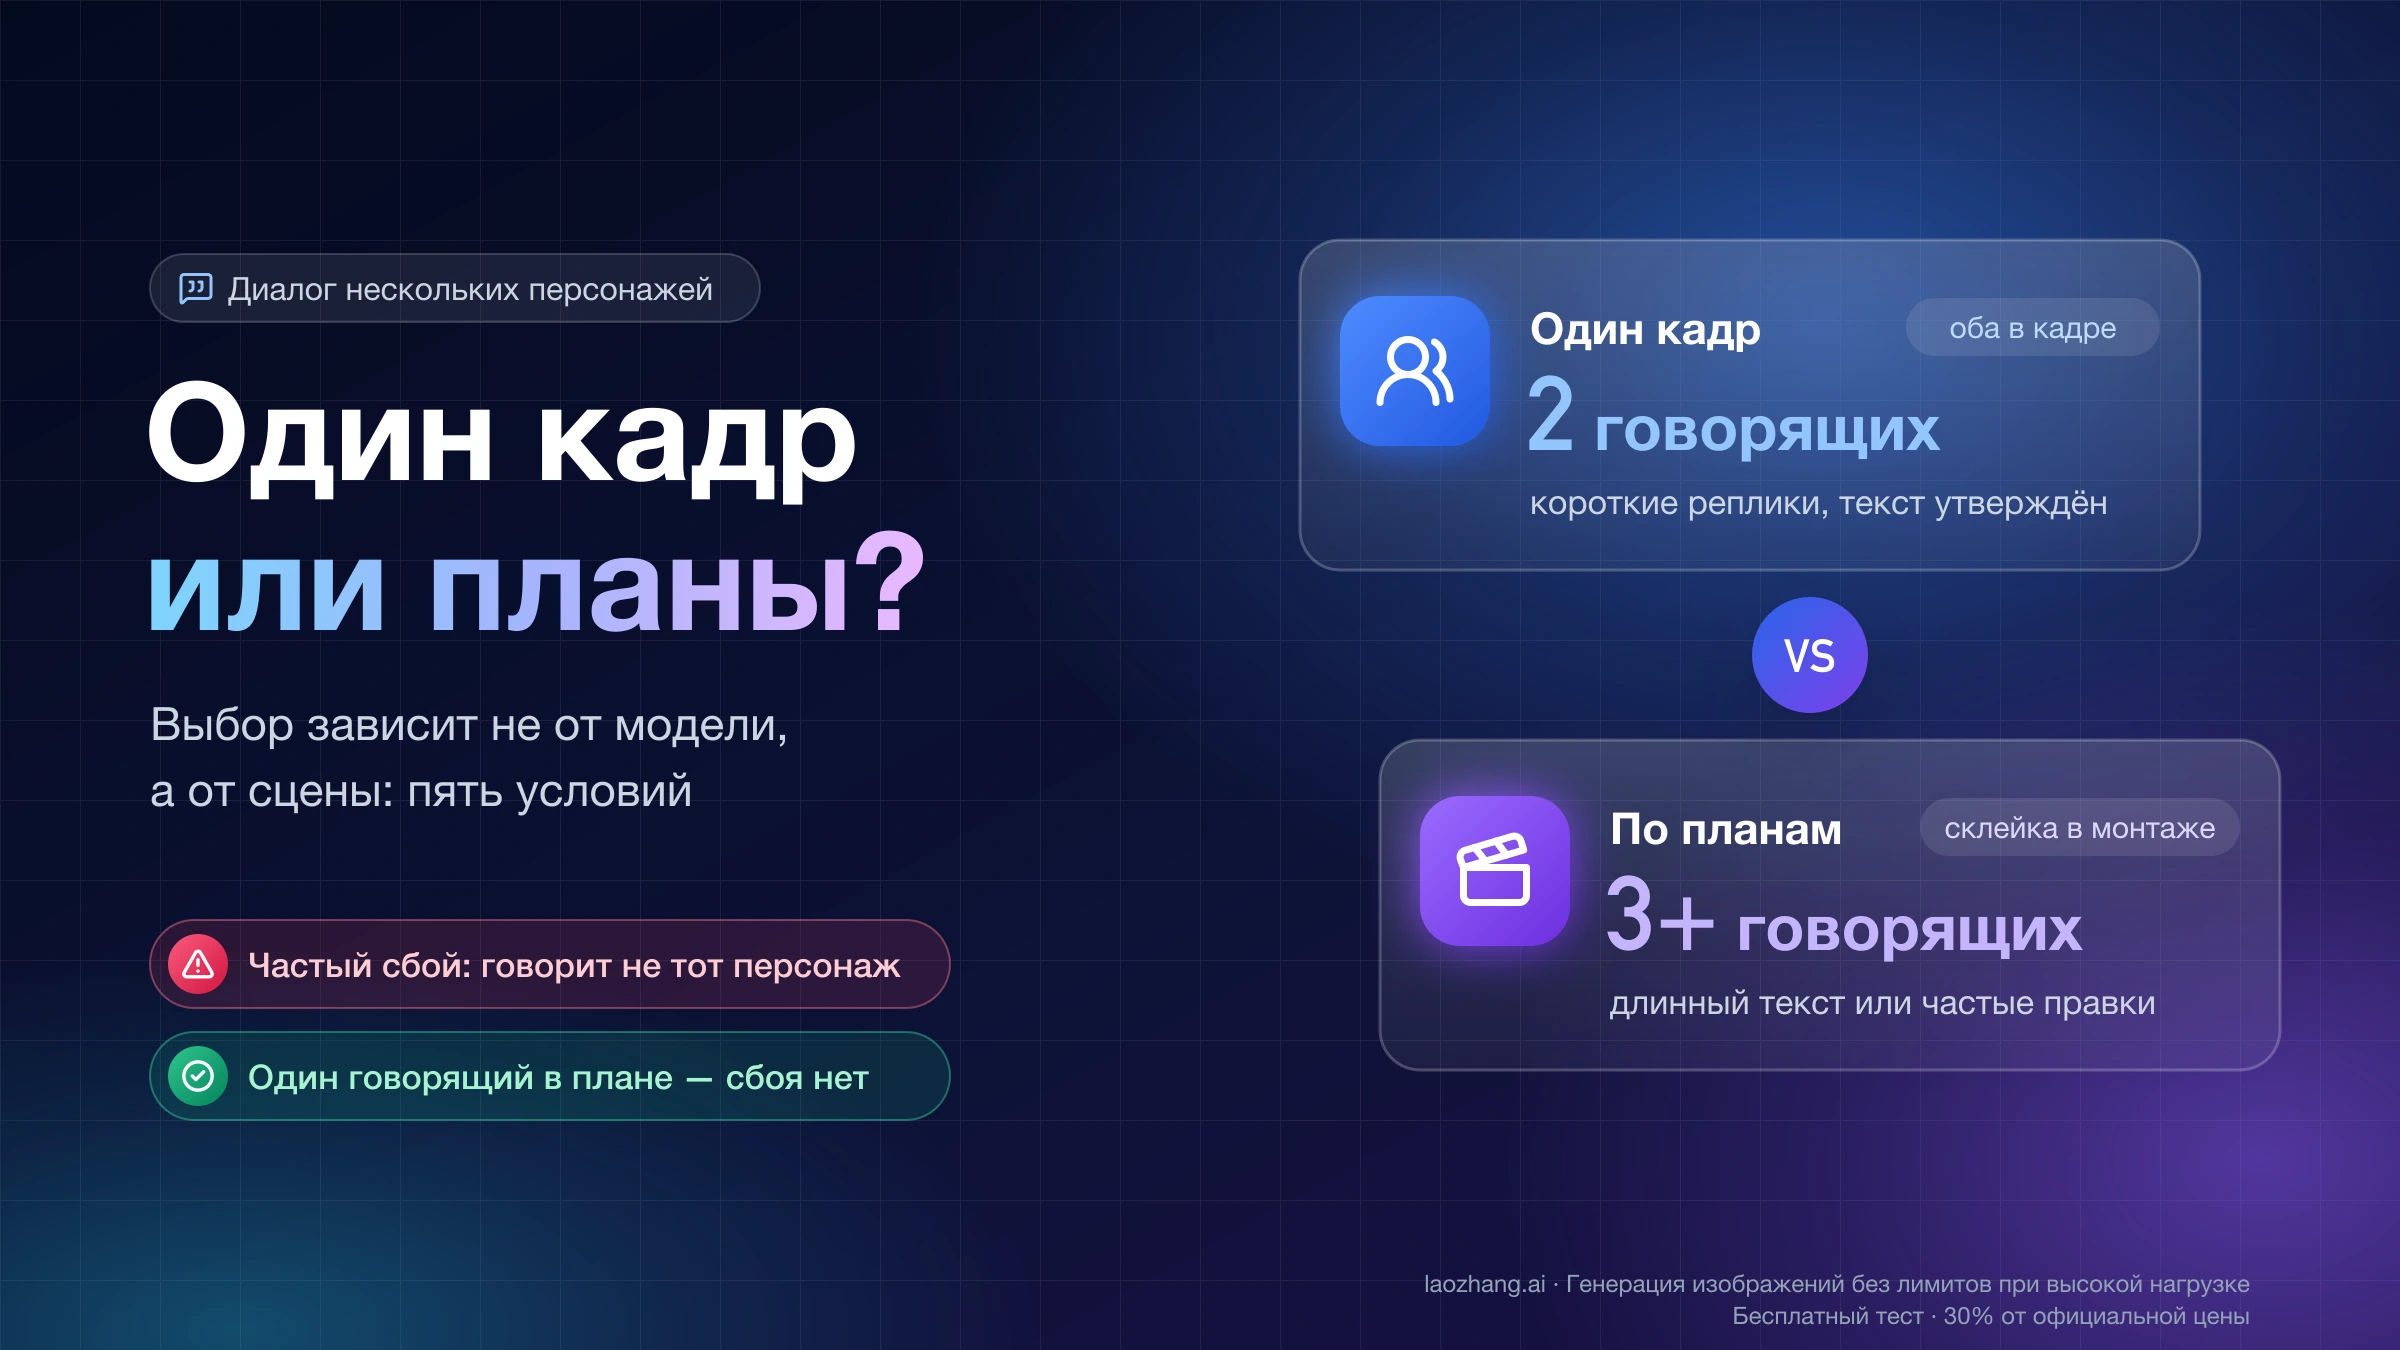
Диалог двух персонажей с короткими репликами, который укладывается в один клип и почти не будет переписываться, разумно генерировать одним кадром: оба героя в кадре, голоса и движение губ получаются за одну генерацию. Если персонажей трое и больше, текст длиннее одного клипа, реплики будут меняться после согласования или сбой «говорит не тот» повторяется, сцену надёжнее разбить на планы: крупные планы, «восьмёрка», через плечо. В каждом плане говорит один человек, а склейка делается в монтажке.
Есть и промежуточные варианты. Модель может сама нарезать короткий ролик на несколько планов (мультикадровый режим Kling 3.0, MiniMax H3, Gemini Omni Flash по умолчанию). Или можно оставить обоих героев в одном кадре, а игру каждого сгенерировать отдельно и совместить, как в официальной схеме Runway для Act-Two.
Ниже — правила выбора, что каждая модель реально документирует для диалога, шаблоны промптов, расчёт стоимости и таблица сбоев с конкретной правкой. Все характеристики взяты из документации вендоров по состоянию на 19 октября 2026 года: это заявленные возможности, а не результаты тестовых генераций, и процентов успеха среди них нет. Сторонние наблюдения подписаны источником.
Один кадр или по планам: пять условий, которые решают выбор
Решение зависит не от модели, а от сцены. Пройдитесь по пяти условиям.
| Условие сцены | Один кадр | По планам |
|---|---|---|
| Сколько персонажей говорит | Двое | Трое и больше |
| Длина диалога | Помещается в один клип модели (у Veo 3.1 — 8 секунд) | Длиннее клипа, или продление теряет голос |
| Физическое взаимодействие | Передают предмет, обнимаются, толкаются — контакт должен быть виден | Говорят на расстоянии, контакт не нужен |
| Как часто меняются реплики | Текст утверждён, правок не ждёте | Заказчик или режиссёр будет переписывать отдельные фразы |
| Цена одного принятого дубля | Перегенерация всей сцены из-за одной реплики укладывается в бюджет | Переделывать хочется только сбойный план |
Если в четырёх-пяти строках вы оказались в левой колонке, начинайте с одного кадра. Если правая перевешивает, планируйте раскадровку сразу, а не после десятой неудачной попытки уместить всех в один промпт.
Почему число персонажей стоит первым. Единственный вендор, который прямо описывает сбой с несколькими говорящими, — BytePlus для Seedance 2.5: в многосубъектных видео персонажи могут не совпасть со своими референсами, тембрами голоса или порядком появления, а первый появившийся герой может быть заменён другим (руководство BytePlus по промптам Seedance 2.5). Каждый дополнительный говорящий добавляет ещё одну пару «лицо — голос», которую модель может перепутать. Сторонний блог Seedance TV называет двух персонажей самой управляемой конфигурацией и советует для группы собирать сцену из отдельных планов на пару или на реакцию (статья Seedance TV о диалоге нескольких персонажей). Это мнение автора блога, а не замер.
Физическое взаимодействие тянет в сторону одного кадра по простой причине: если герой передаёт другому чашку, а сцена разбита на два крупных плана, контакт приходится додумывать на склейке. Монтаж по планам хорош там, где люди разговаривают, но друг друга не касаются.
Когда диалог одним кадром работает
Один кадр — это средний или общий план, где видны оба персонажа, а реплики стоят в промпте по очереди. Google сама показывает такой пример для Veo 3.1: двое помечены в промпте, у каждого реплика в кавычках, и всё это — один клип (документация Veo в Gemini API). В руководстве Vertex AI тот же приём записан иначе: «детектив говорит: …, информатор отвечает: …», без кавычек, а средний план двух собеседников и план через плечо названы типичными для разговора (руководство по промптам Veo в Vertex AI). Ограничения на число говорящих в клипе Google не публикует. Это не значит, что их нет; значит, что документация молчит.
Что ограничивает одиночный кадр на практике:
- Длина клипа. У Veo 3.1
durationSeconds— 4, 6 или 8 секунд, а с референсными изображениями, продлением, 1080p и 4K — только 8. Два-три коротких обмена репликами туда помещаются, полноценная сцена — нет. - Продление. Veo 3.1 продлевает ролик шагами по 7 секунд до 148 секунд на выходе, но в документации прямо сказано: голос плохо продлевается, если его нет в последней секунде видео. Пауза между репликами в конце клипа может оборвать звук в продолжении.
- Референсы персонажей. Veo принимает до трёх изображений-ассетов, но формулировка — «одного человека, персонажа или продукта». Можно ли отдать два изображения двум разным героям, из этой фразы не следует. Тестируйте на коротком клипе, прежде чем строить на этом сцену.
- Привычка модели резать сцену. Gemini Omni Flash по умолчанию «пытается создать видео из нескольких планов»; чтобы получить непрерывную сцену, нужно прямо написать «No scene cuts» (документация Gemini Omni Flash).
У Seedance 2.5 запас по длине больше: от 4 до 30 секунд на выходе, до 50 ассетов (30 изображений, 10 видео, 10 аудио), причём каждому персонажу можно привязать свой голосовой референс (страница модели Seedance 2.5 у BytePlus). Привязка записывается текстом: «Изображения 1–2 — Персонаж 1, ему соответствует Аудио 1; изображения 3–4 — Персонаж 2, Аудио 2». Подписывать имя прямо на картинке BytePlus не советует: так легко получить путаницу или дублирование героя. Подробнее о том, как связывать референсы, — в материале «Промпты для Seedance 2 и 2.5: раскадровка, референсы и правки».
Когда монтаж по планам надёжнее
По планам — значит, каждая реплика или пара реплик живёт в отдельной генерации: общий план для знакомства с местом, затем крупный план говорящего, затем ответ собеседника крупно или через его плечо, затем реакция. В каждом плане говорит один человек. Модели не нужно решать, чьи губы двигать, а значит, исчезает самый частый сбой.
Что даёт этот способ:
- Правка одной реплики не трогает остальные. Заказчик переписал третью фразу — перегенерируется третий план.
- Длина сцены не упирается в клип. Восемь секунд Veo или 15 секунд Kling 3.0 становятся длиной плана, а не всего диалога.
- Любое число персонажей. Группа из пяти человек — это пять крупных планов и пара общих, а не один промпт с пятью голосами.
Чем приходится платить:
- Постоянство внешности. Каждый план — новая генерация, и лицо может «поплыть». Держите для каждого героя один и тот же набор референсов во всех планах и не меняйте описание одежды и причёски между промптами. В блоге Elser AI это сформулировано как набор запретов: не генерировать весь разговор одним клипом, не менять описания персонажей между планами, не принимать план, где говорит не тот герой (руководство Elser AI по диалогам нескольких персонажей).
- Склейка. Направление взглядов, положение героев слева и справа, свет и фоновый звук должны совпадать от плана к плану. Это работа монтажёра, модель её не сделает.
- Больше генераций. Расчёт — в разделе о стоимости ниже.
На плане через плечо следите за слушателем: если его лицо видно хотя бы частично, модель может начать двигать и его губы. Надёжнее показывать слушателя со спины или срезать его лицо кадром.
Для сериала с одним и тем же виртуальным героем во всех планах у Seedance есть ассеты: прямую загрузку реальных лиц BytePlus не разрешает, но допускает собственные результаты ModelArk того же аккаунта не старше 30 дней, предустановленных цифровых персонажей или верифицированные ассеты реальных людей. У laozhang.ai есть API для таких ассетов: виртуальный персонаж создаётся из одного публичного HTTPS-изображения, а реальный человек — после официального согласия и проверки живости; дальше ассет передаётся в каждый план как reference_image (документация laozhang.ai по ассетам Seedance). Пакетная генерация планов по API снимает ручную возню с десятком одинаковых запросов.
Примечание: laozhang.ai — наш собственный сервис; его цены — наши тарифы, а не независимое сравнение.
Компромиссы: мультикадровый режим модели и схема Runway Act-Two
Между «всё в одном кадре» и «всё по отдельности» есть два задокументированных варианта.
Мультикадровый режим: модель режет сама
Несколько моделей умеют сгенерировать за один запрос короткий ролик с несколькими планами.
- Kling 3.0 (выпуск 31 января 2026 года): режим Multi-Shot прямо заявлен для «классических диалогов восьмёркой» с автоматическими ракурсами; в мультиперсонажных сценах с нативным звуком, по словам вендора, можно «точно указать говорящего персонажа». Длина — от 3 до 15 секунд; в API параметр
multi_shotподдерживает от 1 до 6 планов, каждый не короче секунды, до 512 символов на план (заметка о выпуске Kling 3.0). «Устранение путаницы» — формулировка маркетинга, а не независимый замер. - Kling 4.0 (доступен всем с 15 октября 2026 года): 3–30 секунд, голосовой референс, до 7 элементов, «более точная синхронизация губ». Про число планов и указание говорящего в заметке о выпуске Kling 4.0 ничего не сказано, а документация API по состоянию на 19 октября описывает 3.0. Заявления 3.0 на 4.0 автоматически не переносите.
- MiniMax H3 (31 июля 2026 года): «нативное мультикадровое моделирование», 4–15 секунд, диалоги на 11 языках, до 3 аудиореференсов. Привязку голоса к конкретному персонажу MiniMax не описывает.
- Wan 2.7: планы задаются прямо в промпте («Shot 1 [0–3 seconds]…»), длина 2–15 секунд, аудио по ссылке 2–30 секунд. Многоголосая привязка в документации Alibaba Cloud тоже не описана.
- Gemini Omni Flash режет на планы по умолчанию, но голос к персонажу не привязывает, загружать аудиореференсы нельзя, редактировать голос нельзя, и продлить загруженное видео с говорящим, чтобы добавить реплики, тоже нельзя (документация Gemini Omni Flash). Доступность Omni зависит от региона сервиса; о доступе и идентификаторе модели — в материале «Gemini Omni 1.1 Flash: что это, где доступна модель и какой идентификатор API использовать».
Мультикадровый режим удобен для коротких сцен на 10–15 секунд: склейка уже внутри ролика. Но если ошибся один план, перегенерируется весь ролик — по цене правки это ближе к одному кадру, чем к монтажу.
Runway Act-Two: оба в кадре, но каждый играет отдельно
Act-Two принимает только одного персонажа. Runway описывает обходной путь для двоих и более (справка Runway о диалогах нескольких персонажей в Act-Two):
- Записать игру каждого персонажа отдельным видео (суммарно до 30 секунд — это максимум Act-Two).
- Сгенерировать кадр с обоими героями (Gen-4 Image с референсами).
- Оживить его в Gen-4 Video на 10 секунд; если диалог длиннее, продлить от последнего кадра.
- Обрезать видео так, чтобы был виден один персонаж, и прогнать Act-Two с его записью. Повторить для второго.
- Совместить три ролика в монтажке: базовое видео снизу, два результата Act-Two поверх.
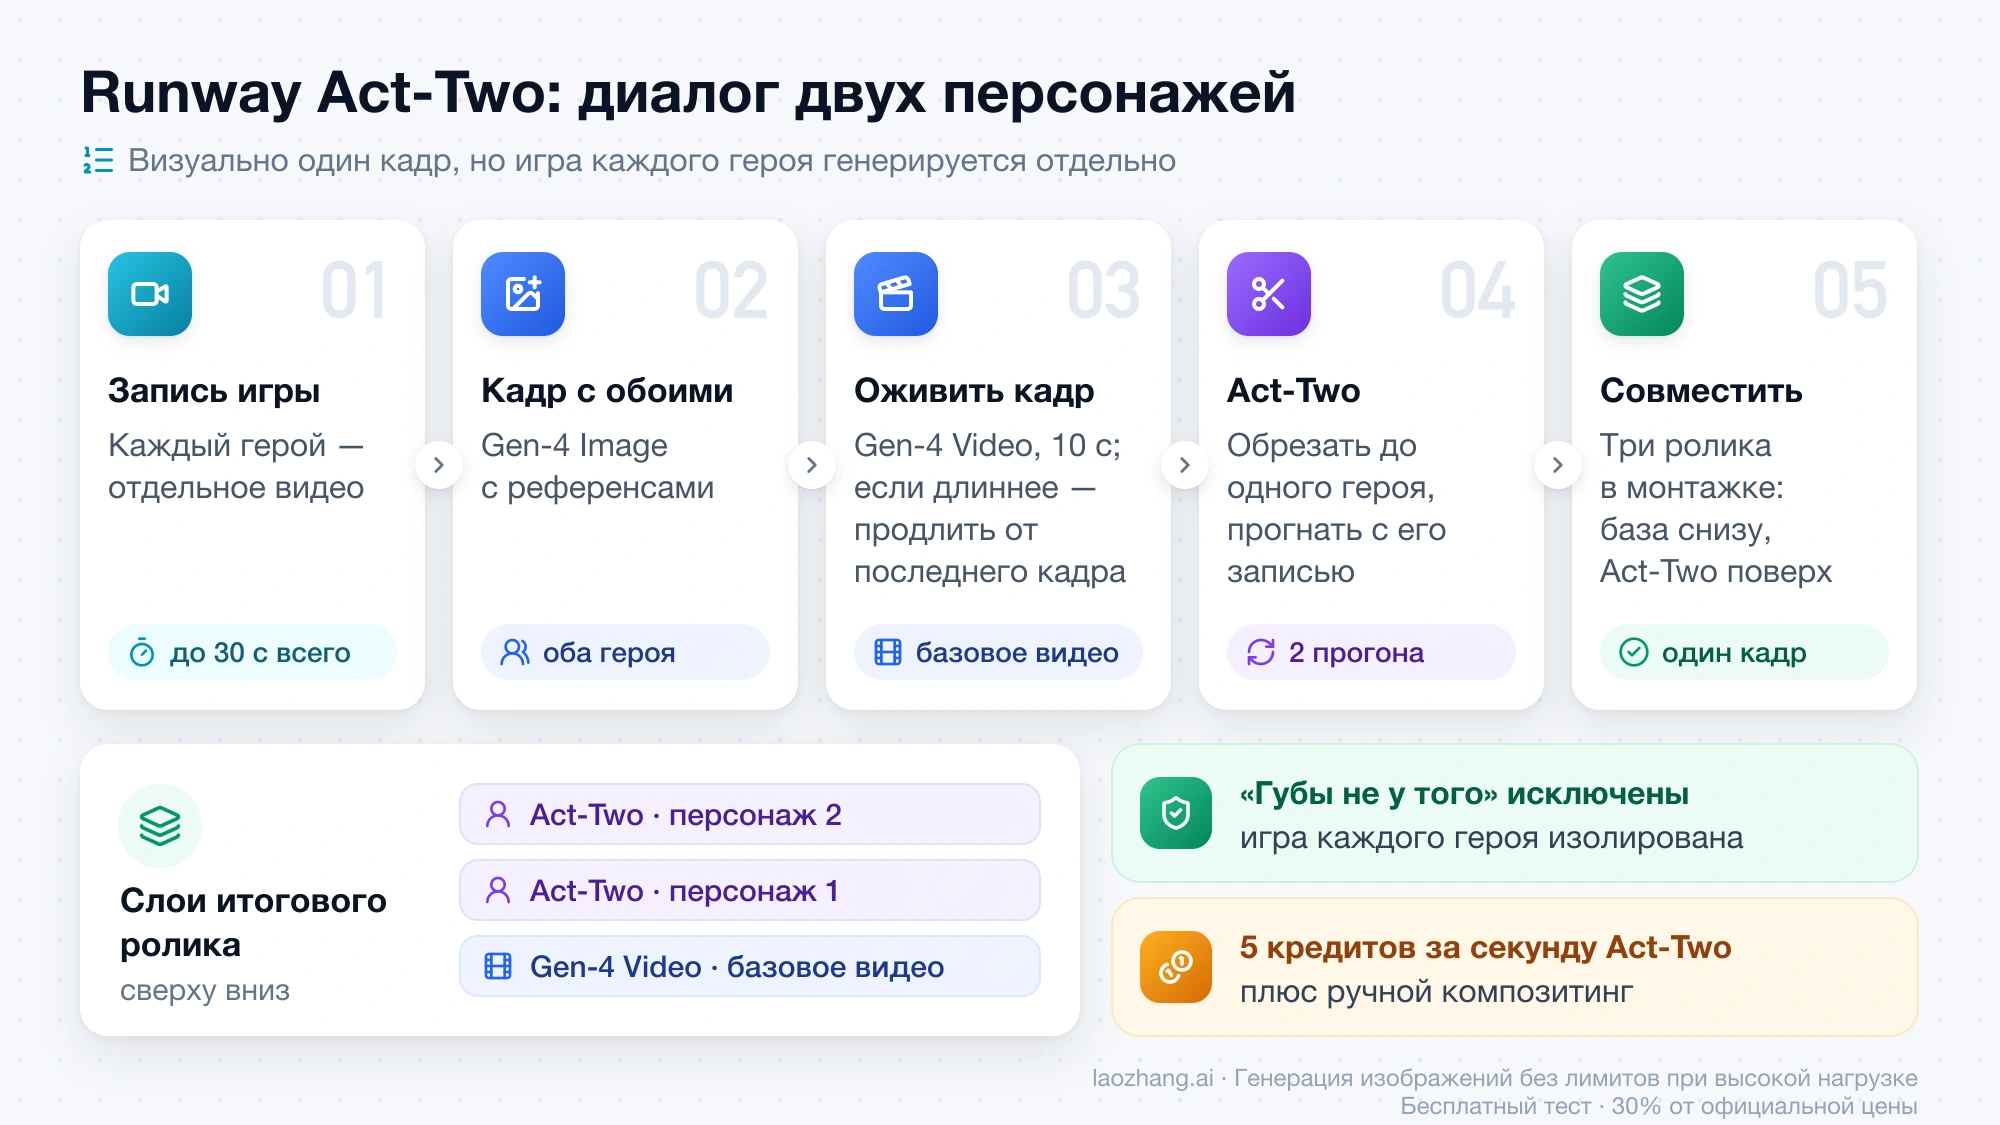
Визуально это один кадр, но игра каждого героя изолирована, поэтому «губы не у того» здесь исключены самой схемой. Цена — ручной композитинг и 5 кредитов за секунду Act-Two. Схема подходит, когда у вас есть актёры или собственная запись голоса и важна точная мимика. Старый инструмент Lip Sync Runway отключила 27 мая 2026 года; замена — Act-Two.
Какие модели что документируют для диалога
Данные — из первичных документов вендоров по состоянию на 19 октября 2026 года. Прочерк означает «в документации не описано», а не «не умеет».
| Модель | Длина клипа | Диалог в промпте | Привязка голоса к персонажу | Свои планы | Ограничения, важные для диалога |
|---|---|---|---|---|---|
| Veo 3.1 (Gemini API) | 4, 6, 8 с; продление до 148 с | Реплики в кавычках с меткой говорящего | — | — | До 3 референсов «одного человека, персонажа или продукта»; голос не продлевается без звука в последней секунде |
| Gemini Omni Flash | Продление по 10 с до 40 с | Да | Не поддерживается: аудиореференсы и редактирование голоса недоступны | По умолчанию; «No scene cuts» отключает | Нельзя продлить видео с говорящим, чтобы добавить реплики; некоторые узнаваемые люди не поддерживаются |
| Seedance 2.5 | 4–30 с | Фигурные скобки для реплик, язык указывается перед репликой | Текстом: «Изображение N — Персонаж N, Аудио N» | ShotN и таймкоды в целых секундах | Персонажи могут перепутаться с референсами; реальные лица только через ассеты |
| Kling 3.0 | 3–15 с | Да | Заявлено: «точно указать говорящего» | 1–6 планов (multi_shot) | Заявление вендора, без независимой проверки |
| Kling 4.0 | 3–30 с | Да | Голосовой референс, про мультиспикер — ничего | — | API-документация пока описывает 3.0 |
| MiniMax H3 | 4–15 с | 11 языков | — | Да | Аудио не может быть единственным входом |
| Wan 2.7 | 2–15 с | Да | — | Через промпт | Аудио 2–30 с |
| Runway Act-Two | До 30 с записи | Через вашу запись игры | По одному персонажу за прогон | — | Многоперсонажность — только через композитинг |
| MultiTalk / InfiniteTalk (open source) | До 15 с / по умолчанию до 40 с | Через аудиодорожки | cond_audio: person1, person2 | — | Нужна своя видеокарта; авторы сами называют проблему неверной привязки аудио к людям |
Open source MultiTalk прямо заточен под «разговорное видео нескольких людей, управляемое аудио»: каждый голос привязывается к человеку в JSON (репозиторий MultiTalk). InfiniteTalk использует тот же формат и держит качество image-to-video примерно до минуты (репозиторий InfiniteTalk). Это бесплатный путь, если есть собственное железо; требования к видеокарте смотрите в README репозиториев.
Sora в таблице нет: приложение закрыто 26 апреля 2026 года, а модели Sora 2 и Videos API отключены 24 сентября 2026 года. Если вы выбираете между Seedance и Veo по длительности, референсам и цене, сравнение есть в материале «Seedance или Veo: что выбрать после закрытия Sora 2», а с какой из моделей Wan 3.0, MiniMax H3 и Seedance 2.5 начать тест, — в разборе «Wan 3.0, MiniMax H3 или Seedance 2.5: что проверить первым».
Как вписать реплики нескольких персонажей в промпт: два шаблона
Ниже два шаблона, собранных из синтаксиса, который приводят Google и BytePlus. Они не проверялись генерацией — считайте их отправной точкой. Промпты написаны по-английски, как примеры в документации; на каком языке модель лучше произносит русские реплики, проверьте на коротком клипе.
Один кадр в Veo 3.1 (структура по примеру Google: метка говорящего и реплика в кавычках):
Medium two-shot in a small café, static camera, no scene cuts.
On the left, a man in a grey coat leans forward. Man: "You're late again."
On the right, a woman in a red scarf smiles. Woman: "But I brought news."
The man listens silently while she speaks.
Audio: quiet café ambience, no music.
Каждого героя описывайте по внешности и положению в кадре (слева, справа), а не только по имени. Отдельной строкой укажите, кто молчит, пока говорит другой.
Сцена по планам в Seedance 2.5 (привязка ассетов по порядку загрузки, реплики в фигурных скобках, язык перед репликой):
Image 1 is Character 1 and uses the voice from Audio 1.
Image 2 is Character 2 and uses the voice from Audio 2.

Shot 1, 0-4 s: wide two-shot, Character 1 sits screen left, Character 2 screen right. No dialogue.
Shot 2, 4-8 s: close-up of Character 1. Character 1 says in Russian: {Ты опять опоздала.} Character 2 is off-screen.
Shot 3, 8-12 s: over-the-shoulder from behind Character 1, Character 2 faces camera.
Character 2 says in Russian: {Зато с новостями.} Character 1 is seen only from the back.
Загружайте ассеты в том порядке, в котором персонажи впервые появляются в кадре, — это прямая рекомендация BytePlus против подмены первого героя. Не повторяйте слова реплик в других частях промпта: BytePlus предупреждает, что это может вызвать появление субтитров. Если сцена требует одновременно много референсов и правок, разбейте её на несколько простых задач — в одной задаче такие комбинации, по словам BytePlus, ведут себя нестабильно.
Для полностью раздельных генераций по планам возьмите из второго шаблона по одному плану на запрос: те же строки привязки, один говорящий, лицо слушателя вне кадра.
Сколько стоит диалог одним кадром и по планам: расчёт на прайсе
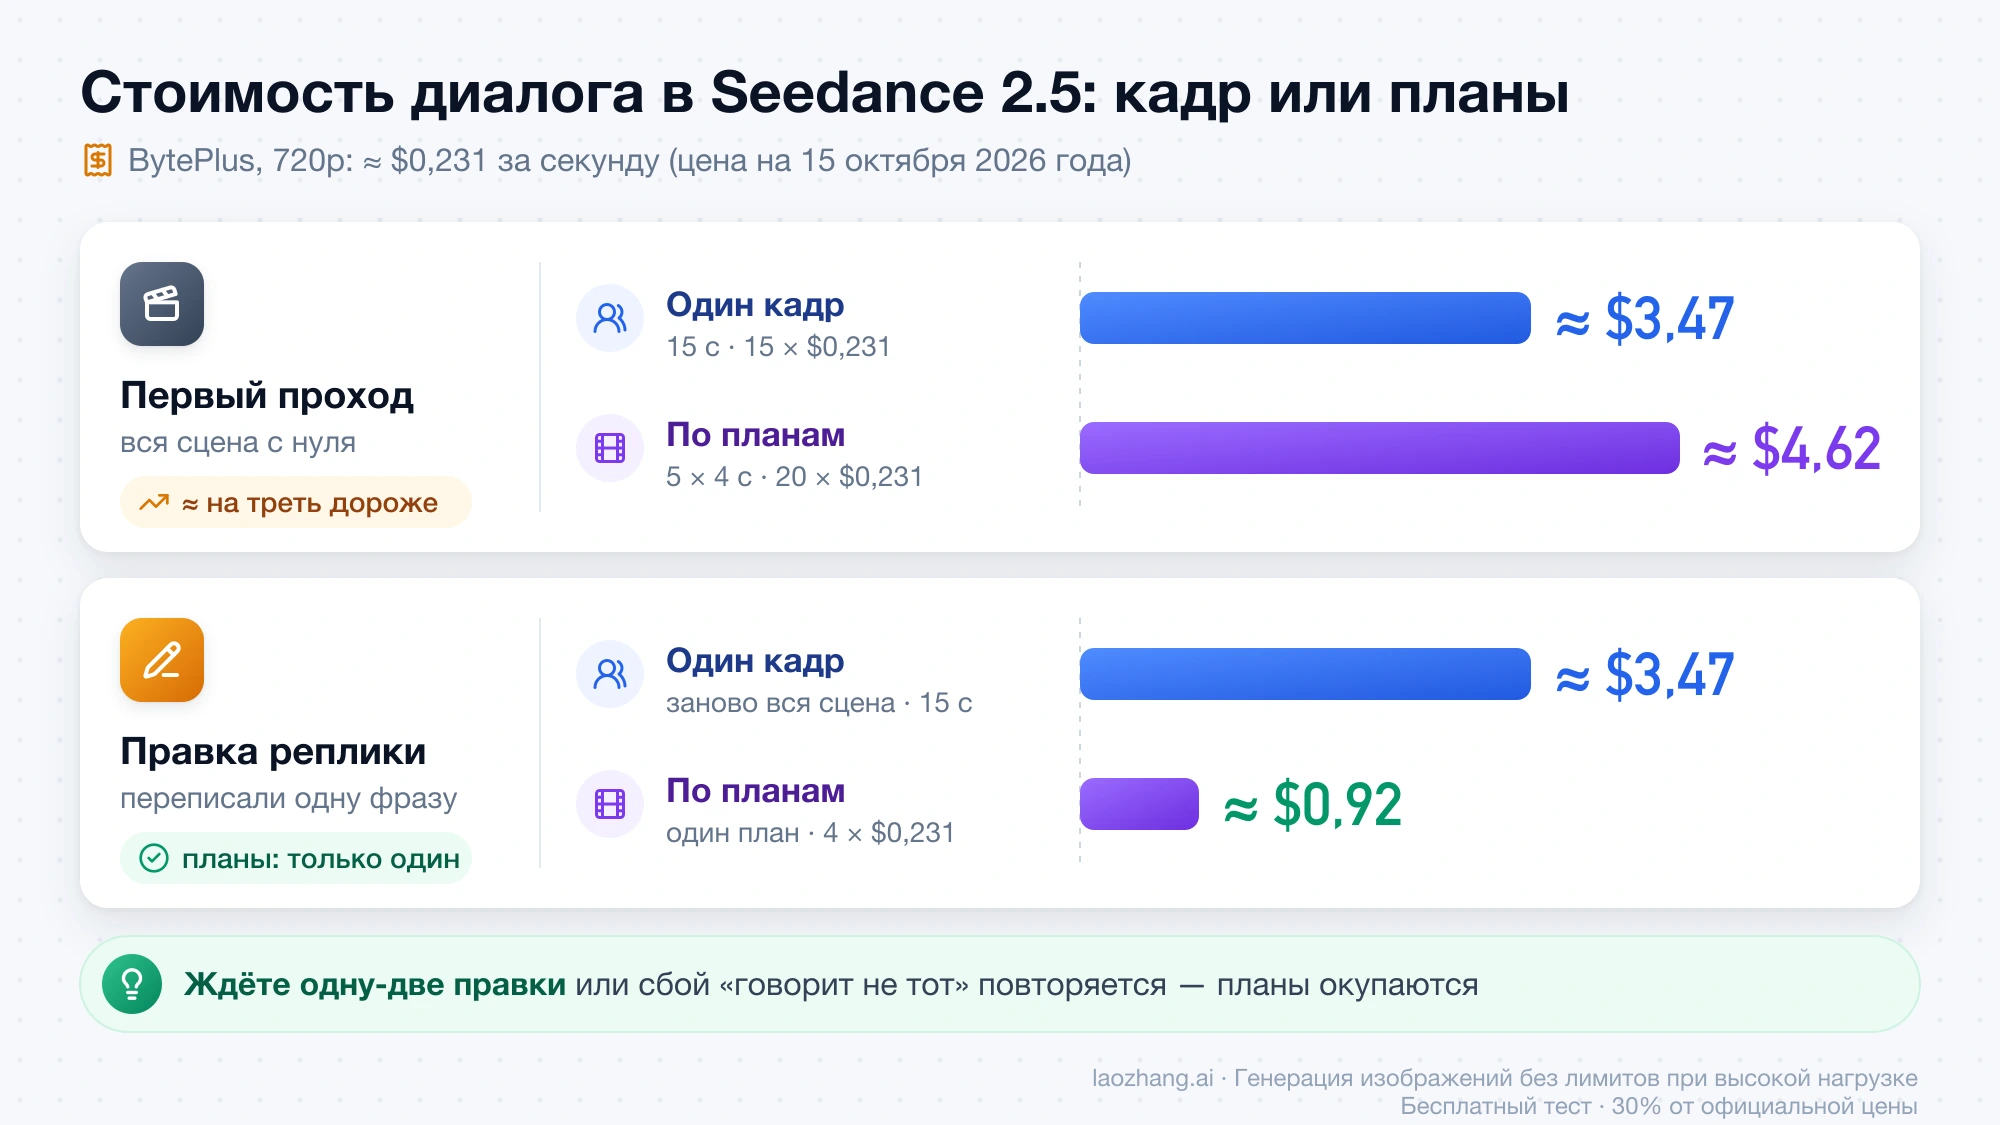
Монтаж по планам почти всегда требует больше сгенерированных секунд за проход, но дешевле переделывать. Пример на прайсе Seedance 2.5 в BytePlus — около $0,231 за секунду при 720p (цена по состоянию на 15 октября 2026 года, меняется часто).
| Сценарий | Секунд генерации | Расчёт | Стоимость |
|---|---|---|---|
| Один кадр, 15 с | 15 | 15 × $0,231 | ≈ $3,47 |
| По планам: 5 планов по 4 с (минимум Seedance 2.5) | 20 | 20 × $0,231 | ≈ $4,62 |
| Переписали одну реплику: один кадр | 15 | 15 × $0,231 | ≈ $3,47 |
| Переписали одну реплику: по планам | 4 | 4 × $0,231 | ≈ $0,92 |
Первый проход по планам дороже примерно на треть. Но каждая правка одной реплики в одном кадре стоит всю сцену, а в монтаже — только один план. Если вы ждёте хотя бы одну-две правки или сбой «говорит не тот» повторяется, планы окупаются.
Для других моделей подставьте свою цену за секунду. Прайс по состоянию на 1–15 октября 2026 года: Veo 3.1 Standard — $0,40 за секунду (720p и 1080p), Veo 3.1 Fast — $0,10 / $0,12, Veo 3.1 Lite — $0,05 / $0,08, Kling 3.0 — $0,084–$0,168, MiniMax H3 — $0,08 при 768P. У Veo есть дополнительный нюанс: с референсными изображениями клип всегда 8 секунд, поэтому пять планов по 4 секунды превращаются в пять планов по 8 — 40 секунд генерации вместо 20. На Veo 3.1 Fast при 720p это 40 × $0,10 = $4,00 за проход против 8 × $0,10 = $0,80 за один восьмисекундный кадр.
Губы двигаются не у того, голоса перепутаны: таблица сбоев
| Симптом | Вероятная причина | Что сделать |
|---|---|---|
| Говорит не тот персонаж, губы двигаются у слушателя | Реплика не закреплена за конкретным героем, оба лица в кадре | Описать говорящего по внешности и положению, отдельно написать, что второй молчит; в Seedance связать изображение и аудио текстом. Не помогло — перейти на планы, где видно одно лицо |
| Первый появившийся герой заменён другим референсом | Порядок загрузки ассетов не совпадает с порядком появления (описано BytePlus для Seedance) | Загрузить ассеты в порядке первого появления и перенумеровать их в промпте |
| Голоса поменялись местами | Нет привязки голоса к персонажу | В Seedance — строка «Изображение N — Персонаж N, Аудио N»; в Omni привязки нет вовсе, нужны планы с одним говорящим или другая модель |
| Лицо «плывёт» между планами | Каждый план генерировался с разными референсами или описаниями | Один набор референсов на героя во всех планах, описание внешности слово в слово; в Seedance — ассет персонажа |
| Модель сама порезала сцену на планы | Поведение Gemini Omni Flash по умолчанию | Добавить «No scene cuts» |
| В кадре появились субтитры | Слова реплики повторяются в промпте (Seedance) | Убрать повторы, оставить реплику один раз |
| Голос пропал после продления | В последней секунде исходного клипа не было речи (Veo 3.1) | Заканчивать клип на реплике или начинать следующую реплику новым планом |
| Реплика не помещается в клип | Предел длины клипа (Veo 3.1 — 8 с) | Разделить реплику на два плана или перейти на модель с более длинным клипом |
| Нестабильный результат при множестве референсов и правок | Слишком сложная задача в одном запросе (Seedance) | Разбить на несколько простых задач |
| Внешность одного героя перетекает к другому | Герои слишком похожи | Сделать различия явными: цвет одежды, причёска, рост |
Сторонние авторы описывают те же сбои своими словами: в блоге Seedance TV это «утечка личности» (один герой заимствует причёску или куртку другого) и «утечка роли» (говорит не тот). Совет оттуда же совпадает с документацией: не добавлять прилагательных, а закрепить за каждым героем референс, имя роли и момент реплики.
Вопросы о диалоге нескольких персонажей в ИИ-видео
Можно ли сделать диалог нескольких персонажей в ИИ-видео бесплатно?
Бесплатный вариант с понятной привязкой голосов — open source MultiTalk или InfiniteTalk на собственной видеокарте: каждый голос назначается человеку в кадре в JSON-файле. Облачные модели из таблицы выше платные на уровне API; бесплатные лимиты отдельных сервисов меняются, поэтому смотрите их на сайте сервиса в день генерации.
Сколько персонажей нейросеть может озвучить в одном кадре?
Ни Google, ни BytePlus не публикуют жёсткого предела говорящих в одном клипе. Практическая граница другая: начиная с третьего говорящего растёт риск, что лица, голоса и порядок появления перепутаются, — BytePlus описывает этот сбой прямо. Для троих и больше надёжнее планы.
Какая нейросеть лучше для диалога двух персонажей?
Зависит от того, что вам важнее. Seedance 2.5 — единственная из облачных моделей в таблице с задокументированной текстовой привязкой голоса к персонажу и длиной до 30 секунд. Veo 3.1 даёт короткие клипы по 8 секунд с понятным синтаксисом реплик. Kling 3.0 заявляет указание говорящего в мультикадровом режиме, но это слова вендора. Runway Act-Two подходит, если у вас есть запись игры актёров.
Почему Gemini Omni Flash путает голоса персонажей?
Omni Flash не умеет привязывать голос к персонажу: загружать аудиореференсы и редактировать голос нельзя. Модель сама решает, какой голос кому дать, и по умолчанию ещё и режет сцену на планы. Для диалога с жёстко заданными голосами нужна другая модель или генерация по одному говорящему на план.
Источники12
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 19 окт. 2026 г..
Источники12
Внешние страницы, на которые ссылается это руководство, в порядке упоминания. Последнее обновление: 19 окт. 2026 г..
- 1.руководство BytePlus по промптам Seedance 2.5docs.byteplus.com/en/docs/modelark/seedance-2-5-prompt-guide
- 2.статья Seedance TV о диалоге нескольких персонажейseedance.tv/blog/seedance-2-5-multi-character-dialogue
- 3.документация Veo в Gemini APIai.google.dev/gemini-api/docs/veo
- 4.руководство по промптам Veo в Vertex AIcloud.google.com/vertex-ai/generative-ai/docs/video/video-gen-prompt-guide
- 5.документация Gemini Omni Flashai.google.dev/gemini-api/docs/omni
- 6.страница модели Seedance 2.5 у BytePlusdocs.byteplus.com/en/docs/modelark/seedance-2-5
- 7.руководство Elser AI по диалогам нескольких персонажейelser.ai/blog/how-to-create-multi-character-dialogue-videos-with-ai-without-losing-character-consistency
- 8.заметка о выпуске Kling 3.0kling.ai/release-note/release-notes/whbvu8hsip
- 9.заметке о выпуске Kling 4.0kling.ai/release-note/release-notes/Kling_4
- 10.справка Runway о диалогах нескольких персонажей в Act-Twohelp.runwayml.com/hc/en-us/articles/41748090660499
- 11.репозиторий MultiTalkgithub.com/MeiGen-AI/MultiTalk
- 12.репозиторий InfiniteTalkgithub.com/MeiGen-AI/InfiniteTalk