GLM-5.3-Flash Claude Code 설정: Flash로 도는 슬롯 매핑과 effort
Claude Code에서 GLM-5.3-Flash를 쓰려면 Opus 슬롯까지 Flash로 지정해야 메인 대화가 Flash로 돕니다. 기본 effort는 Z.ai 권장 max가 아닌 high입니다.
목차
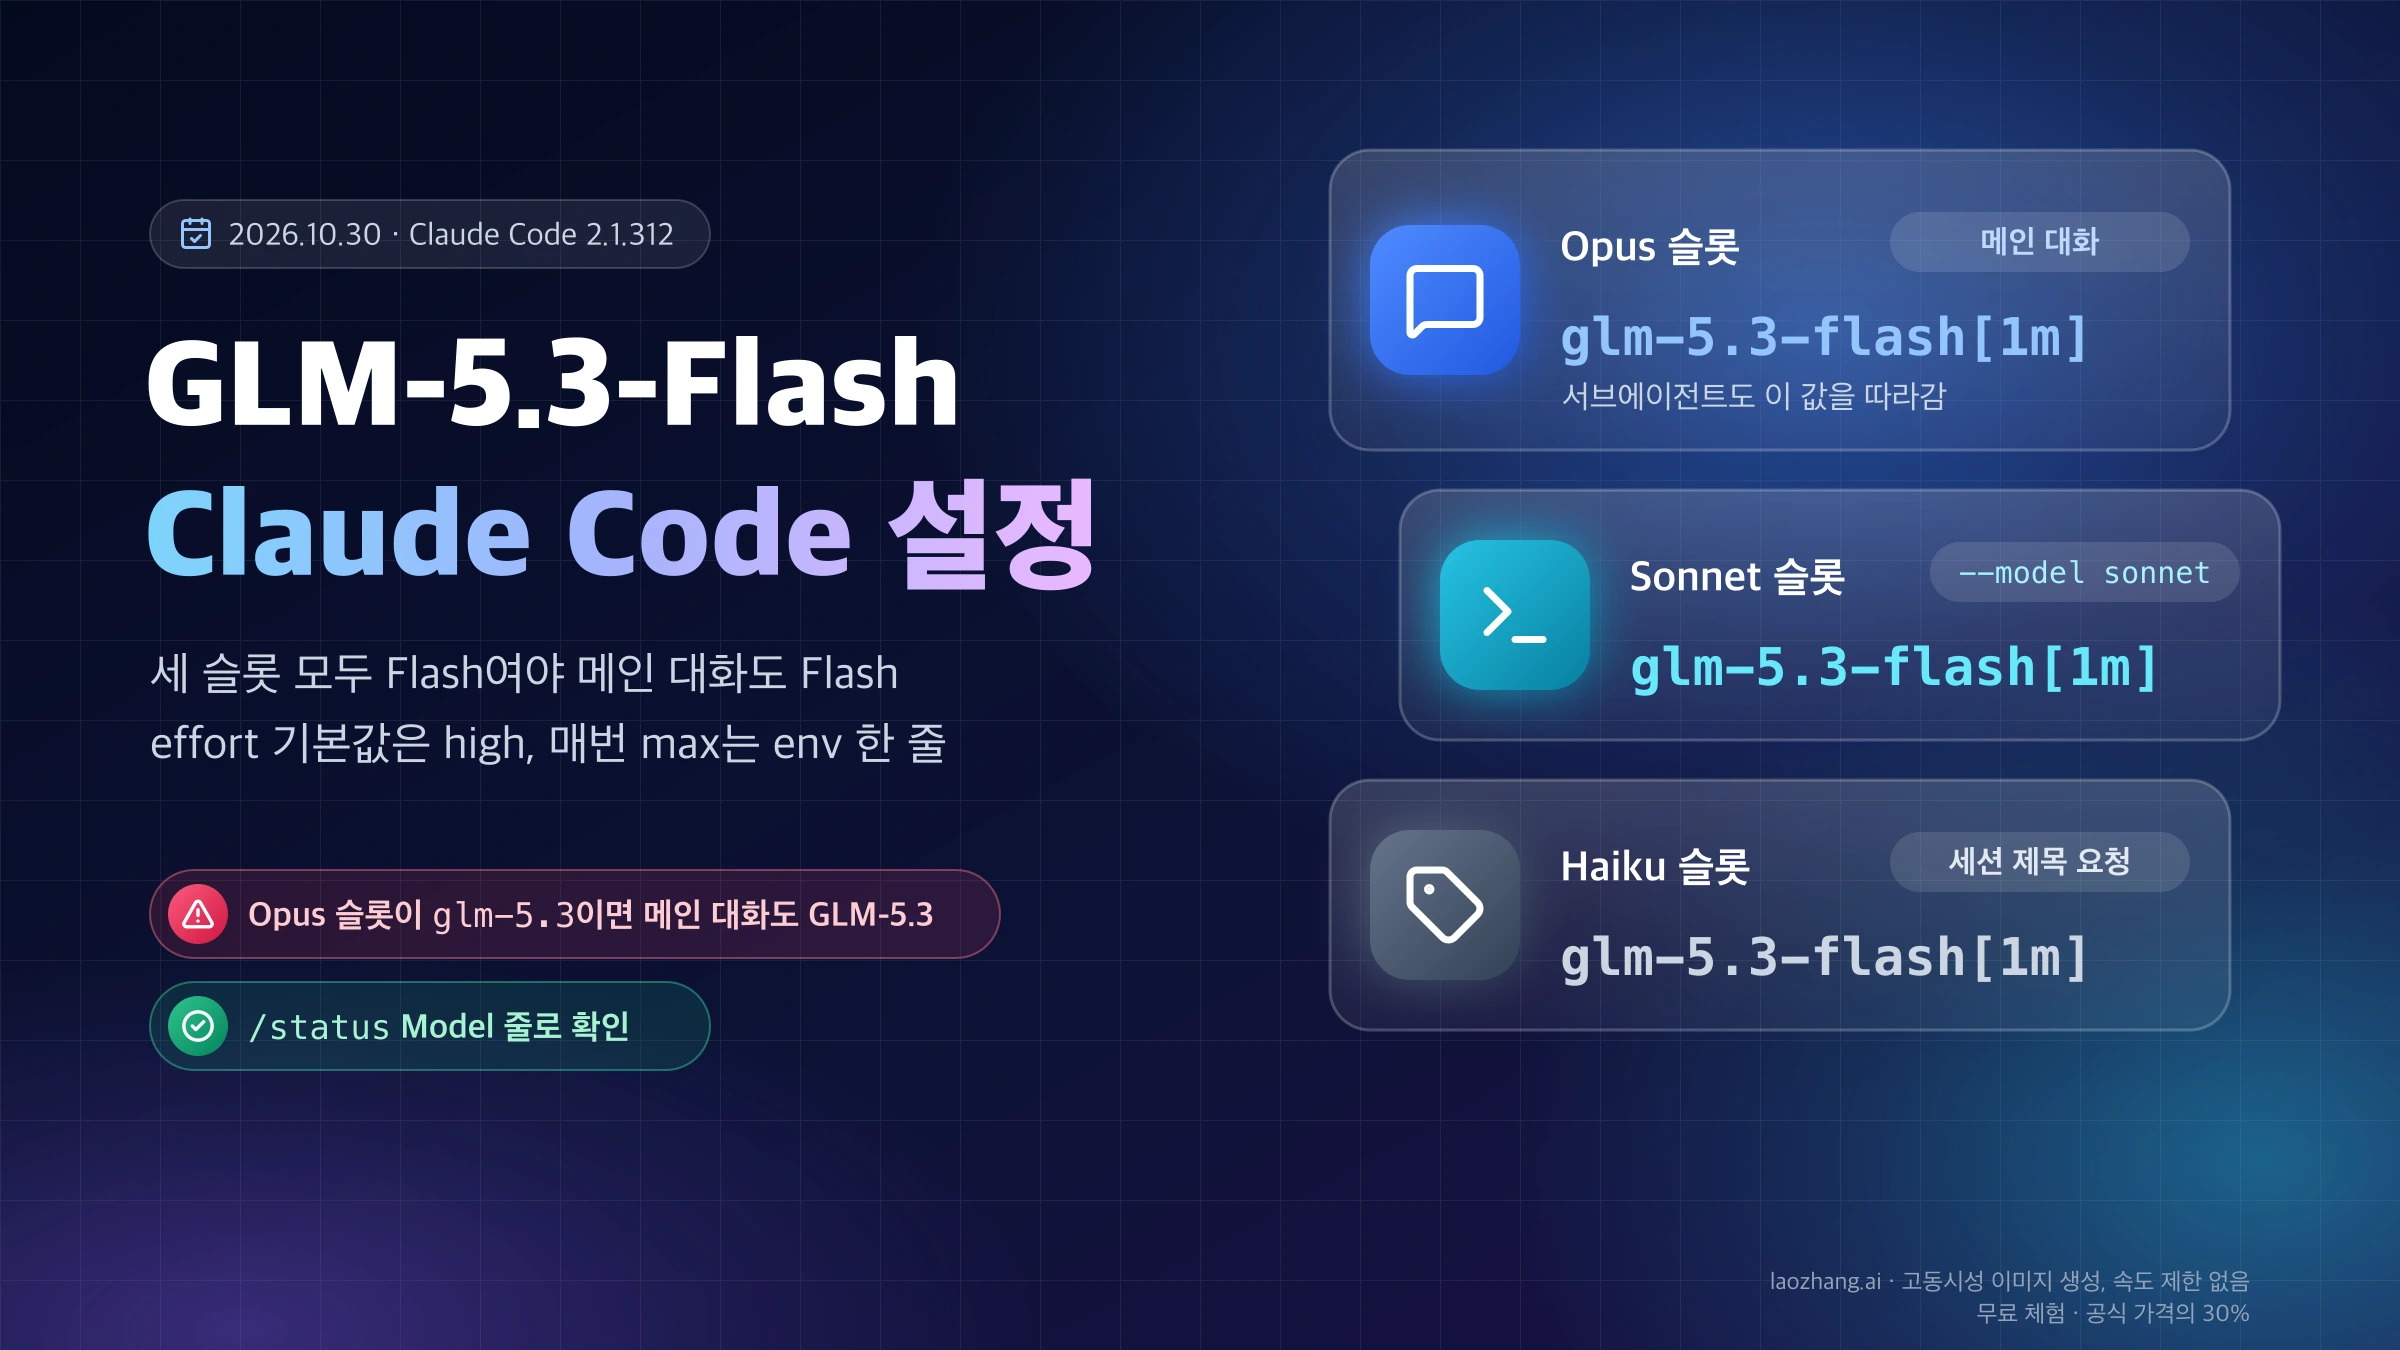
Claude Code에서 GLM-5.3-Flash를 쓰려면 Z.ai의 GLM Coding Plan(월 $18부터)을 구독해 API 키를 만들고, ~/.claude/settings.json의 env에 다음 값을 넣습니다. ANTHROPIC_BASE_URL은 https://api.z.ai/api/anthropic, ANTHROPIC_AUTH_TOKEN은 Z.ai 키, 그리고 ANTHROPIC_DEFAULT_OPUS_MODEL·ANTHROPIC_DEFAULT_SONNET_MODEL·ANTHROPIC_DEFAULT_HAIKU_MODEL 세 값은 모두 glm-5.3-flash[1m]입니다. Claude Code는 요청을 보내는 클라이언트일 뿐이고, 어느 모델이 답하고 어느 쿼터가 차감될지는 이 주소와 모델 값이 정합니다.
가장 많이 틀리는 곳은 Opus 값입니다. 2026년 10월 30일 Claude Code 2.1.312가 보내는 요청을 캡처해 보면 --model 없이 시작한 메인 대화는 Opus 값을 모델 이름으로 보냈습니다. 그래서 Z.ai Claude Code 문서의 수동 설정 예시처럼 Opus와 Sonnet에 glm-5.3[1m]을 넣으면 메인 대화는 Flash가 아니라 GLM-5.3으로 갑니다. 저장한 뒤에는 Claude Code 창을 모두 닫고 새 터미널에서 claude를 실행해 /status의 Model 줄에 glm-5.3-flash[1m]이 보이는지 확인하세요.
effort(사고 강도)도 한 번은 직접 정해야 합니다. Claude Code는 기본으로 high를 보내기 때문에, Z.ai가 코딩용으로 권하는 max로 매번 돌리려면 env에 "CLAUDE_CODE_EFFORT_LEVEL": "max"를 추가합니다. 세션 안에서 입력하는 /effort max는 그 세션에만 적용되고, max는 사고 토큰이 늘어나는 만큼 크레딧도 더 씁니다.
Claude Code의 세 모델 슬롯과 Z.ai 엔드포인트가 정하는 것
Claude Code는 내부적으로 opus, sonnet, haiku라는 세 별칭을 쓰고, 각 별칭이 실제로 어떤 모델 ID를 부를지는 ANTHROPIC_DEFAULT_OPUS_MODEL, ANTHROPIC_DEFAULT_SONNET_MODEL, ANTHROPIC_DEFAULT_HAIKU_MODEL 환경 변수가 정합니다. 아래에서는 이 세 변수를 '슬롯'이라고 부릅니다. 요청은 ANTHROPIC_BASE_URL로 가고, 그 주소가 Z.ai의 Coding Plan 엔드포인트일 때만 플랜 크레딧이 차감됩니다. Anthropic의 Claude Code 모델 설정 문서는 Haiku 슬롯을 "haiku 별칭이나 백그라운드 기능에 쓰는 모델"로 설명하므로, 슬롯 하나만 바꾸면 요청 일부만 GLM-5.3-Flash로 갑니다.
Z.ai GLM Coding Plan 개요에 따르면 2026년 10월 30일 기준 Lite, Pro, Max 모든 플랜에서 부를 수 있는 모델은 GLM-5.3과 GLM-5.3-Flash 두 가지입니다. 예전 설정에 남은 GLM-4.7 요청은 GLM-5.3-Flash로, GLM-5.2·GLM-5.1 요청은 GLM-5.3으로 자동 전환되며, GLM-5.3-FlashX는 아직 플랜에서 쓸 수 없습니다. 플랜은 유료이고, 무료로 쓰는 길은 공개된 가중치를 직접 돌리는 로컬 실행뿐입니다. 중국 본토용 bigmodel.cn 계정이라면 주소만 https://open.bigmodel.cn/api/anthropic으로 바꾸면 됩니다.
아래의 요청 캡처 결과는 2026년 10월 30일 macOS의 Claude Code 2.1.312(npm 설치, 이날 npm 최신 버전)에서 얻었습니다. Z.ai 대신, 받은 요청을 그대로 기록하고 고정된 답만 돌려주는 로컬 모의(mock) 엔드포인트를 ANTHROPIC_BASE_URL에 지정하고 Z.ai 문서의 설정 값을 넣어 실행했습니다. 그래서 Claude Code가 어떤 모델 이름과 effort, 헤더를 보내는지는 확인할 수 있지만, Z.ai 서버가 실제로 어떤 모델로 답하는지와 크레딧이 얼마나 빠지는지는 캡처에 담기지 않습니다. 그 부분은 Z.ai 공식 문서를 근거로 적었습니다.
settings.json에 GLM-5.3-Flash 설정하기: 주소, 키, 슬롯 세 개
설정은 사용자 설정 파일 하나에 끝납니다. macOS와 Linux는 ~/.claude/settings.json, Windows는 %USERPROFILE%\.claude\settings.json이며, WSL과 Windows용 Claude Code를 함께 쓴다면 실제로 실행하는 쪽이 읽는 파일인지부터 확인해야 합니다. 순서는 다음과 같습니다.
- Z.ai 구독 페이지에서 플랜을 구독하고, Personal Coding Plan의 Plan Overview에서 API 키를 만들어 복사합니다.
- 위 경로의
settings.json을 엽니다. 파일이 없으면 새로 만듭니다. - 파일에 다른 항목이 이미 있다면 파일 전체를 덮어쓰지 말고,
env안에 아래 키만 추가하거나 고칩니다. - 열려 있는 Claude Code 창을 모두 닫고, 새 터미널에서 프로젝트 폴더로 이동해
claude를 실행합니다. "Do you want to use this API key"라는 질문이 나오면 Yes를 고릅니다.
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.z.ai/api/anthropic",
    "ANTHROPIC_AUTH_TOKEN": "your_zai_api_key",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "glm-5.3-flash[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "glm-5.3-flash[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "glm-5.3-flash[1m]",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1000000",
    "API_TIMEOUT_MS": "3000000"
  }
}[1m]은 1M 컨텍스트를 쓰겠다는 표시입니다. 캡처에서 Claude Code는 이 접미사를 떼고 model: "glm-5.3-flash"로 보내면서 context-1m beta 헤더를 붙였고, CLAUDE_CODE_AUTO_COMPACT_WINDOW를 1000000으로 두면 대화 자동 압축이 1M 토큰 기준으로 맞춰집니다. API_TIMEOUT_MS는 Z.ai의 Claude Code 연결 문서가 넣는 값(3,000,000ms, 50분)이고, 같은 문서의 수동 설정에 있는 CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC는 캡처에서 메인 요청을 바꾸지 않았으므로 넣어도 되고 빼도 됩니다.
Z.ai가 안내하는 자동 설정 도구 npx @z_ai/coding-helper나 macOS·Linux용 claude_code_zai_env.sh 스크립트를 써도 됩니다. 다만 이 스크립트가 쓰는 키는 ANTHROPIC_AUTH_TOKEN, ANTHROPIC_BASE_URL, API_TIMEOUT_MS 세 개뿐이고, 같은 날 이 세 키만 둔 상태로 캡처하니 Claude Code는 자기 기본 모델 이름인 claude-opus-5-5를 그대로 보냈습니다. Z.ai가 이 이름을 어느 모델로 처리하는지는 공개 문서에 없으므로, 스크립트를 썼더라도 세 슬롯은 직접 추가해 두는 편이 확실합니다.
Z.ai 공식 설정 두 개 중 메인 대화가 Flash로 도는 것
Z.ai 문서에는 서로 다른 매핑이 두 개 있습니다. How to Switch Models 페이지는 세 슬롯을 모두 glm-5.3-flash[1m]로 두고, Claude Code 연결 문서의 "Manual configuration" 예시는 Haiku만 glm-5.3-flash[1m], Sonnet과 Opus는 glm-5.3[1m]로 둡니다. 같은 연결 문서의 본문 목록은 세 슬롯 기본값이 모두 GLM-5.3-Flash라고 적고 있어 더 헷갈립니다. 어느 쪽이 Flash로 도는지는 Claude Code가 요청마다 어떤 슬롯을 쓰는지에 달려 있고, 2026년 10월 30일 캡처에서는 다음과 같았습니다.
| 요청 종류 | Claude Code가 쓴 슬롯 | How to Switch Models 설정 | Manual configuration 설정 |
|---|---|---|---|
메인 대화(--model 없이 시작) | Opus | glm-5.3-flash | glm-5.3 |
| 메시지마다 먼저 가는 세션 제목 요청 | Haiku | glm-5.3-flash | glm-5.3-flash |
| Explore·general-purpose 서브에이전트 | 세션 모델(Opus) | glm-5.3-flash | glm-5.3 |
--model sonnet으로 시작 | Sonnet | glm-5.3-flash | glm-5.3 |
대화형 세션에서는 사용자가 메시지를 보낼 때마다 Haiku 슬롯으로 도구 목록 없이 세션 제목을 만드는 요청이 먼저 나갔고, 본 응답은 Opus 슬롯으로 갔습니다. claude -p로 실행하는 출력 모드에서는 이 제목 요청이 없었습니다. 서브에이전트 두 종류는 Haiku 슬롯이 아니라 세션 모델을 그대로 썼는데, 자체 model 값을 지정한 사용자 정의 서브에이전트는 캡처하지 않았습니다. 세션 안에서 /model haiku를 고르면 settings.json에 "model": "haiku"가 기록되어 다음 세션부터 기본값이 되므로, 잠깐 바꿔 본 뒤에는 이 줄을 지우거나 되돌려야 합니다.
슬롯마다 무엇을 넣을지는 비용과 작업 종류로 정하면 됩니다. 크레딧을 가장 오래 쓰려면 세 슬롯을 모두 Flash로 둡니다. 크레딧 계수로 계산하면 같은 턴에서 GLM-5.3은 Flash의 약 3배를 쓰기 때문입니다. 메인 대화만 GLM-5.3으로 돌리고 싶다면 Opus 슬롯만 glm-5.3[1m]로 바꾸되, Haiku 슬롯은 메시지마다 요청을 받으니 Flash로 남겨 두세요. 스크린숏이나 이미지를 붙여 넣으며 작업한다면 메인 슬롯은 Flash여야 합니다. Z.ai는 GLM-5.3을 텍스트 전용, GLM-5.3-Flash를 멀티모달로 안내합니다. 두 모델 중 어느 쪽이 작업에 맞는지는 GLM-5.3와 GLM-5.3-Flash 비교: 먼저 테스트할 모델에서 따로 다룹니다.
/status로 GLM-5.3-Flash 적용 여부 확인하기
설정이 먹었는지는 모델에게 물어보지 말고 /status로 확인합니다. 모델이 답변에서 자기를 Claude라고 소개하더라도 그것은 어떤 모델이 응답했는지 판별하는 근거가 되지 않습니다.
- 새 터미널에서
claude를 실행합니다. - 프롬프트에
/status를 입력합니다. - 2026년 10월 30일 Claude Code 2.1.312 화면 기준으로 다음 네 줄을 봅니다.
Model: Default (glm-5.3-flash[1m]),Auth token: ANTHROPIC_AUTH_TOKEN,Anthropic base URL: https://api.z.ai/api/anthropic,Setting sources: User settings.
Model 줄의 Default는 Opus 슬롯 값입니다. 여기에 glm-5.3[1m]이 보이면 메인 대화는 GLM-5.3으로 가고, haiku처럼 별칭이 보이면 앞에서 말한 /model 저장이 남아 있는 것입니다. 시작 화면에 glm-5.3-flash[1m] · API Usage Billing이라고 표시되는 것은 Claude Code가 붙이는 이름표이며, 플랜 크레딧이 얼마나 줄었는지는 Z.ai 구독 관리 페이지에서 확인합니다.
GLM-5.3-Flash effort: Claude Code 기본 high를 max로 바꿀지
Claude Code 2.1.312는 아무것도 지정하지 않으면 thinking: {"type": "adaptive"}와 함께 output_config.effort: "high"를 보냅니다. Z.ai 문서의 처리 규칙은 "명시된 effort > thinking 켜고 끄기 > 기본값 max" 순서이고 high는 high로, xhigh와 max는 max로 바꿉니다. 결국 Claude Code 기본 설정으로 쓰면 GLM-5.3-Flash는 Z.ai가 기본값이자 코딩용 권장값이라고 적은 max가 아니라 high로 돕니다.
캡처에서 확인한 effort 지정 방법은 세 가지입니다. 세션 안에서 /effort max를 입력하면 다음 요청부터 max가 나갔지만 Claude Code가 "Set effort level to max (this session only)"라고 표시했고, 새 세션에서는 원래대로 돌아갑니다. 실행할 때마다 claude --effort max처럼 지정하면 그 값이 그대로 나갑니다. 새 세션에서도 계속 max를 쓰려면 settings.json의 env에 다음 한 줄을 추가합니다.
"CLAUDE_CODE_EFFORT_LEVEL": "max"settings.json 최상위에 "effortLevel": "xhigh"를 넣어도 매번 xhigh가 나갔고, Z.ai는 이를 max로 처리합니다. 반대로 CLAUDE_CODE_DISABLE_THINKING=1로 thinking을 꺼도 effort high는 계속 전송되므로, Z.ai의 우선순위상 low로 내려가지 않고 high가 유지됩니다.
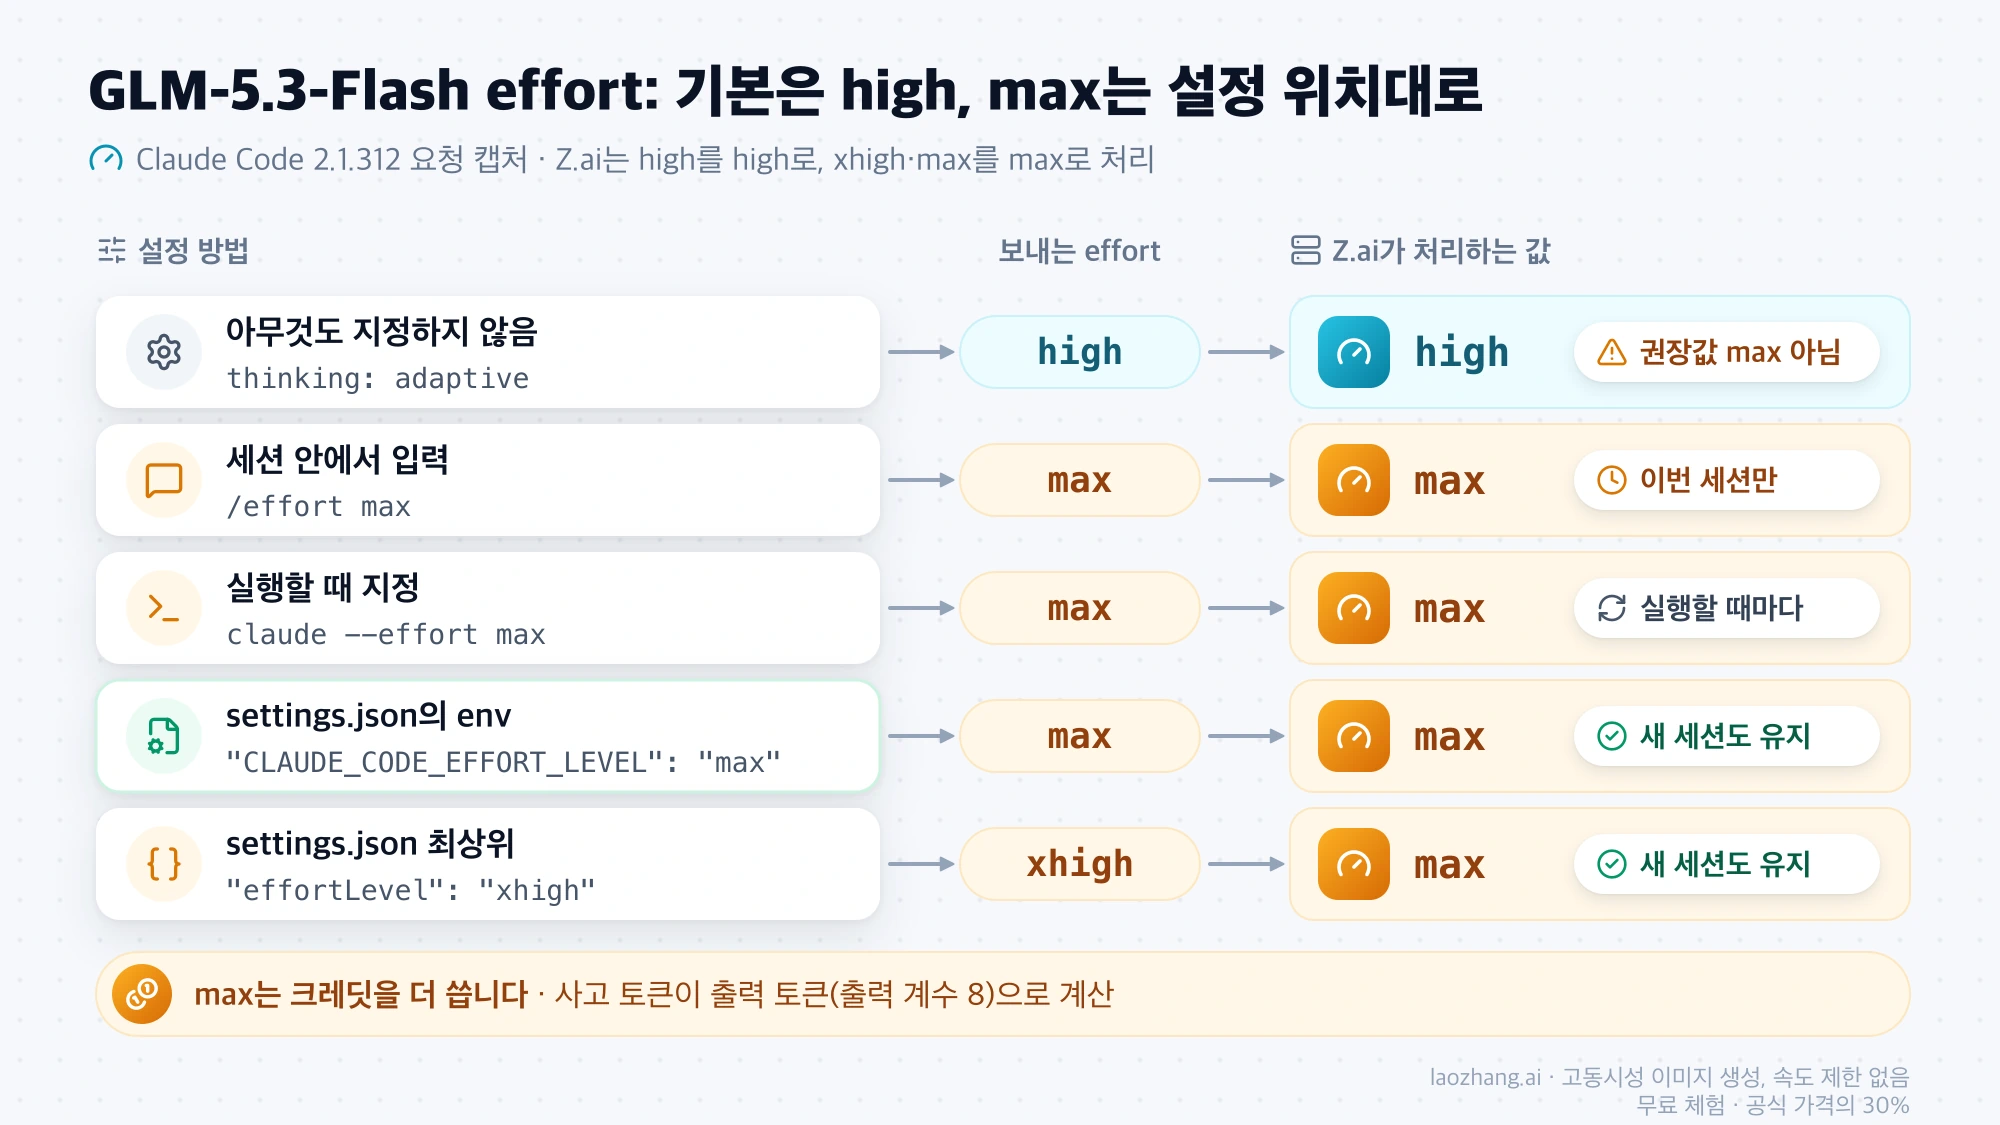
어느 쪽을 고를지는 작업 무게로 정합니다. Z.ai의 GLM-5.3-Flash 모델 문서는 Claude Code 2.1.207에서 돌린 자체 Z.ai Code Bench v1.0에서 Flash가 max effort일 때 Claude Opus 4.8과 거의 같은 점수(29.0 대 29.5)를 냈다고 밝히는데, 이 수치는 max 기준이고 effort에 따라 결과가 달라진다고 덧붙입니다. 대신 사고 토큰은 출력 토큰으로 계산되어 출력 계수 8이 적용되므로, 파일 몇 줄 고치는 일은 high로 두고 긴 디버깅이나 설계 작업에서만 max를 쓰거나 max를 비피크 시간에 쓰는 편이 크레딧을 아낍니다.
출력 길이 상한도 별도로 정할 수 있습니다. Claude Code는 max_tokens를 32000으로 보냈고, env에 "CLAUDE_CODE_MAX_OUTPUT_TOKENS": "128000"을 넣으면 GLM-5.3-Flash의 최대 출력인 128K에 맞춰 128000이 나갔습니다. Z.ai가 Claude Code에서 온 이 값을 그대로 받는지는 공개 문서에 나와 있지 않습니다.
GLM Coding Plan 크레딧: Flash 한 턴 약 6.68, Lite 5시간에 약 299턴
아래 가정으로 계산하면 GLM-5.3-Flash 한 턴은 피크 시간에 약 6.68크레딧, 비피크에 약 3.34크레딧이 들어 Lite의 5시간 한도 2,000크레딧으로 약 299턴에서 598턴을 쓸 수 있습니다. 같은 턴을 GLM-5.3으로 돌리면 20.16크레딧(비피크 10.08)이라 약 99턴에서 198턴입니다. 한도를 다 쓰면 지원 도구 안의 호출은 계정 잔액에서 빠지지 않고, 5시간 한도가 갱신될 때까지 기다려야 합니다.
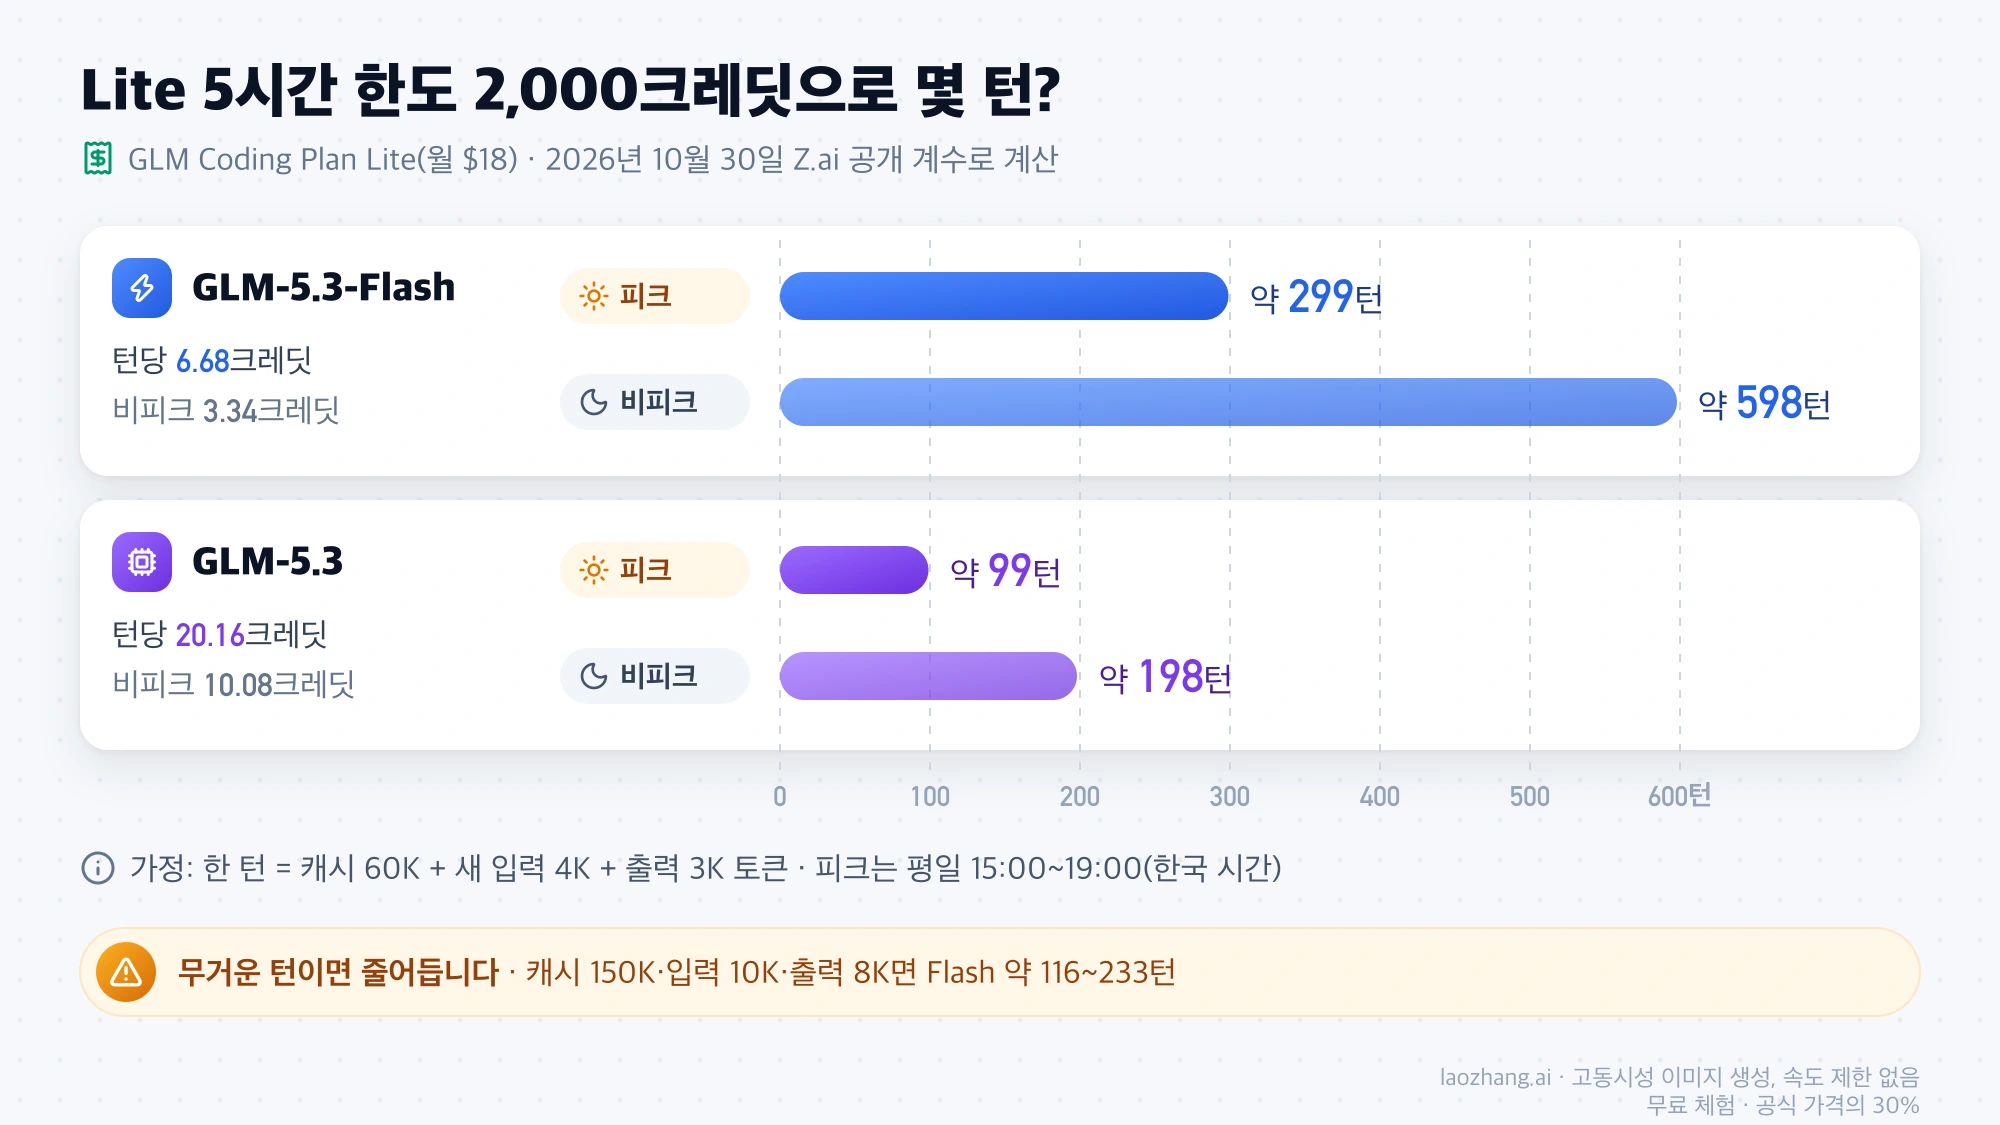
크레딧 공식은 Z.ai GLM Coding Plan 개요에 공개되어 있습니다. 소모량은 (입력 토큰 × 입력 계수 + 캐시된 입력 토큰 × 캐시 계수 + 출력 토큰 × 출력 계수) ÷ 10,000이고, 계수는 GLM-5.3-Flash가 2.3 / 0.56 / 8, GLM-5.3이 6.9 / 1.7 / 24입니다. 피크 시간은 월~금 14:00~18:00(UTC+8), 한국 시간으로 15:00~19:00이며 이 밖의 시간과 주말은 비피크라 크레딧이 50%만 듭니다. 5시간 한도는 쓴 시점에서 5시간 뒤에 다시 채워지고, 주간 한도는 구독 시점부터 7일마다 초기화됩니다.
계산에 쓴 가정은 Claude Code 에이전트 한 턴에 캐시된 앞부분 60K 토큰, 새 입력 4K 토큰, 사고를 포함한 출력 3K 토큰입니다. 이 경우 Flash는 (4,000 × 2.3 + 60,000 × 0.56 + 3,000 × 8) ÷ 10,000 = 6.68크레딧, GLM-5.3은 (4,000 × 6.9 + 60,000 × 1.7 + 3,000 × 24) ÷ 10,000 = 20.16크레딧입니다. 실제 토큰 수는 저장소 크기와 작업에 따라 달라지므로 아래 표는 플랜 간 상대 크기를 보는 용도입니다. 가격은 2026년 10월 30일 기준 z.ai 구독 페이지의 월 결제 가격이며, 분기 결제는 20%, 연간 결제는 30% 할인됩니다.
| 플랜(월 결제) | 5시간 / 주간 크레딧 | Flash 피크 | Flash 비피크 | GLM-5.3 피크 | GLM-5.3 비피크 |
|---|---|---|---|---|---|
| Lite, $18 | 2,000 / 10,000 | 약 299턴 | 약 598턴 | 약 99턴 | 약 198턴 |
| Pro, $80 | 12,000 / 60,000 | 약 1,796턴 | 약 3,592턴 | 약 595턴 | 약 1,190턴 |
| Max, $168 | 28,000 / 140,000 | 약 4,191턴 | 약 8,383턴 | 약 1,388턴 | 약 2,777턴 |
표의 턴 수는 5시간 한도 기준입니다. 캐시 150K, 새 입력 10K, 출력 8K인 무거운 턴이라면 Flash 한 턴이 17.10크레딧(비피크 8.55)으로 늘어 Lite 5시간 한도는 약 116턴에서 233턴으로 줄고, effort를 max로 올리면 출력 토큰이 늘어 같은 방향으로 줄어듭니다. 메시지마다 Haiku 슬롯으로 가는 세션 제목 요청은 입력 약 1K, 출력 약 30토큰으로 잡으면 Flash로 약 0.25크레딧이라 본 턴의 4% 정도입니다. 주간 한도도 따로 있어 Lite는 Flash 기준 일주일에 약 1,497턴(전부 비피크면 2,994턴)에서 멈춥니다. 위의 계수, 한도, 비피크 50% 규칙은 2026년 10월 30일 기준 Z.ai가 공개한 조건이므로, 이보다 앞선 기간 한정 행사 안내보다 이 값을 기준으로 삼으세요.
1113 Insufficient Balance·[1m]·200k 경고: 증상별 원인과 조치
처음 연결할 때 나오는 문제는 대부분 주소, 슬롯 값, Claude Code 버전 셋 중 하나에서 생깁니다. Z.ai GLM Coding Plan FAQ와 Claude Code 모델 설정 문서, 2026년 10월 30일 캡처를 합치면 증상별 조치는 다음과 같습니다.
| 증상 | 원인 | 조치 |
|---|---|---|
1113 Insufficient Balance, 또는 구독했는데 계정 잔액이 빠짐 | 플랜 엔드포인트가 아닌 주소, 플랜에 없는 모델, 지원 도구 밖에서 호출 | ANTHROPIC_BASE_URL이 https://api.z.ai/api/anthropic인지, 슬롯 값이 glm-5.3-flash나 glm-5.3인지 확인 |
| 설정을 바꿨는데 반영되지 않음 | 이미 열린 Claude Code 창, JSON 문법 오류(쉼표 누락 등), 다른 설치가 읽는 설정 파일 | 모든 창을 닫고 새 터미널에서 실행, JSON 검사, /status의 Setting sources 확인 |
/status의 Model이 glm-5.3[1m]이나 haiku | Opus 슬롯에 GLM-5.3, 또는 /model로 저장된 "model" 값 | Opus 슬롯을 glm-5.3-flash[1m]로 고치고 settings.json의 "model" 줄 정리 |
[1m]이 붙은 모델이 없다는 메시지 | [1m] 표기를 모르는 구버전 Claude Code | claude update로 최신 버전으로 업데이트 |
| "Claude Code doesn't recognize the model … assumes a context window of 200k tokens" | 슬롯 값에 [1m]이 없는 상태에서 --model sonnet 등 별칭으로 실행 | 슬롯 값에 [1m]을 붙이고 CLAUDE_CODE_AUTO_COMPACT_WINDOW를 1000000으로 설정 |
| 한동안 잘 되다가 요청이 막힘 | 5시간 또는 주간 크레딧 소진 | 갱신까지 대기, 비피크 시간 활용, Haiku 슬롯은 Flash 유지 |
구독을 마쳤는데도 1113 오류가 나온다면 대개 플랜의 사용 조건을 벗어난 경우입니다. Z.ai FAQ는 GLM Coding Plan이 공식 지원 도구 안에서, 플랜 전용 주소로, GLM-5.3과 GLM-5.3-Flash만 부를 때 적용된다고 적고 있고, 주소를 다른 것으로 두면 호출이 플랜 밖으로 나가 이 오류가 나거나 계정 잔액이 차감됩니다. 200k 경고는 Claude Code가 모델 이름을 몰라 컨텍스트를 200K로 가정한다는 뜻이라, 1M을 그대로 쓰려면 [1m] 표기가 필요합니다. [1m] 없이 --model glm-5.3-flash로 실행해도 CLAUDE_CODE_AUTO_COMPACT_WINDOW가 1000000이면 캡처에서 경고가 나오지 않았지만, 이때는 1M beta 헤더가 빠졌습니다.
플랜 없이 Claude Code에서 GLM-5.3-Flash를 쓰는 경로
GLM Coding Plan 없이도 GLM-5.3-Flash를 Claude Code에 붙일 수는 있지만, 그때는 크레딧이 아니라 토큰당 요금을 냅니다. OpenRouter는 z-ai/glm-5.3-flash를 제공하고 2026년 10월 25일 기준 Z.AI 자체 엔드포인트가 100만 토큰당 입력 0.15달러, 출력 0.50달러였습니다. 연결 방법은 Claude Code에서 OpenRouter와 DeepSeek 쓰기: 경로, 설정, 첫 오류 해결의 OpenRouter 경로와 같고, 모델 ID만 바꾸면 됩니다.
Z.ai 종량 API의 가격과 모델 ID, 가중치를 받아 로컬에서 돌리는 요건은 GLM-5.3-Flash 사용 가이드: Ox Alpha 정체, API 가격, 로컬 실행에 정리되어 있습니다. 같은 작업을 DeepSeek으로 돌릴 때 비용이 어떻게 달라지는지는 DeepSeek V4.1 Flash vs GLM-5.3-Flash 비교: 시간대·캐시가 가르는 비용, 설정 파일 우선순위와 게이트웨이 확인 순서 전반은 Claude Code API 설정: 키, settings.json, 모델, 게이트웨이 확인 순서를 보세요.
Claude Code와 GLM Coding Plan 자주 묻는 질문
Claude Code는 어느 버전을 쓰면 되나요?
최신 버전을 쓰면 됩니다. Z.ai는 Claude Code 2.0.14와의 호환을 확인했다고 적고 claude update로 최신 버전을 쓰라고 권하며, 벤치마크는 2.1.207에서 돌렸습니다. 2026년 10월 30일 기준 npm 최신 버전은 2.1.312이고, 위의 슬롯 선택과 effort 기본값은 이 버전에서 캡처한 것입니다. 기본 모델을 고르는 방식은 버전마다 바뀔 수 있으므로 업데이트한 뒤에는 /status를 한 번 다시 확인하세요.
서브에이전트를 여러 개 동시에 돌려도 되나요?
돌릴 수는 있지만 동시 요청 한도가 플랜 등급에 따라 다릅니다. Z.ai 사용 정책은 동시성 한도가 Max > Pro > Lite 순이고 자원 상황에 따라 바뀌며 비피크 시간에 높아진다고 설명합니다. 권장 규모는 Lite가 한 번에 프로젝트 하나, Pro가 1~2개, Max가 2개 이상입니다. 계정 공유는 금지되어 있어 위반하면 이용이 제한될 수 있습니다.
GLM Coding Plan은 해지하거나 환불받을 수 있나요?
해지는 구독 관리 페이지에서 할 수 있지만, 2026년 10월 30일 기준 Z.ai는 구매한 구독을 환불하지 않습니다. 자동 갱신을 막으려면 다음 결제일 전에 해지해야 하는데, FAQ는 24시간 전, 사용 정책은 3일 전이라고 서로 다르게 적고 있으므로 3일 이상 여유를 두는 편이 안전합니다. 해지해도 남은 구독 기간은 그대로 쓸 수 있습니다.
참고 자료8
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 30일.
참고 자료8
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 30일.
- 1.Anthropic의 Claude Code 모델 설정 문서code.claude.com/docs/en/model-config
- 2.Z.ai GLM Coding Plan 개요docs.z.ai/devpack/overview
- 3.Z.ai 구독 페이지z.ai/subscribe
- 4.Z.ai의 Claude Code 연결 문서docs.z.ai/devpack/tool/claude
- 5.How to Switch Models 페이지docs.z.ai/devpack/latest-model
- 6.Z.ai의 GLM-5.3-Flash 모델 문서docs.z.ai/guides/vlm/glm-5.3-flash
- 7.Z.ai GLM Coding Plan FAQdocs.z.ai/devpack/faq
- 8.Z.ai 사용 정책docs.z.ai/devpack/usage-policy