Claude Fable 5.2 vs GPT-6.2 Sol 비교: 단가 4배, 실측 비용 6.5~12배
GPT-6.2 Sol 단가는 Fable 5.2의 4분의 1이고, 둘 다 전부 통과한 실측의 작업당 비용은 6.5~12배 차이였습니다. Sol max도 AA 지수에선 Fable high 아래입니다.
목차
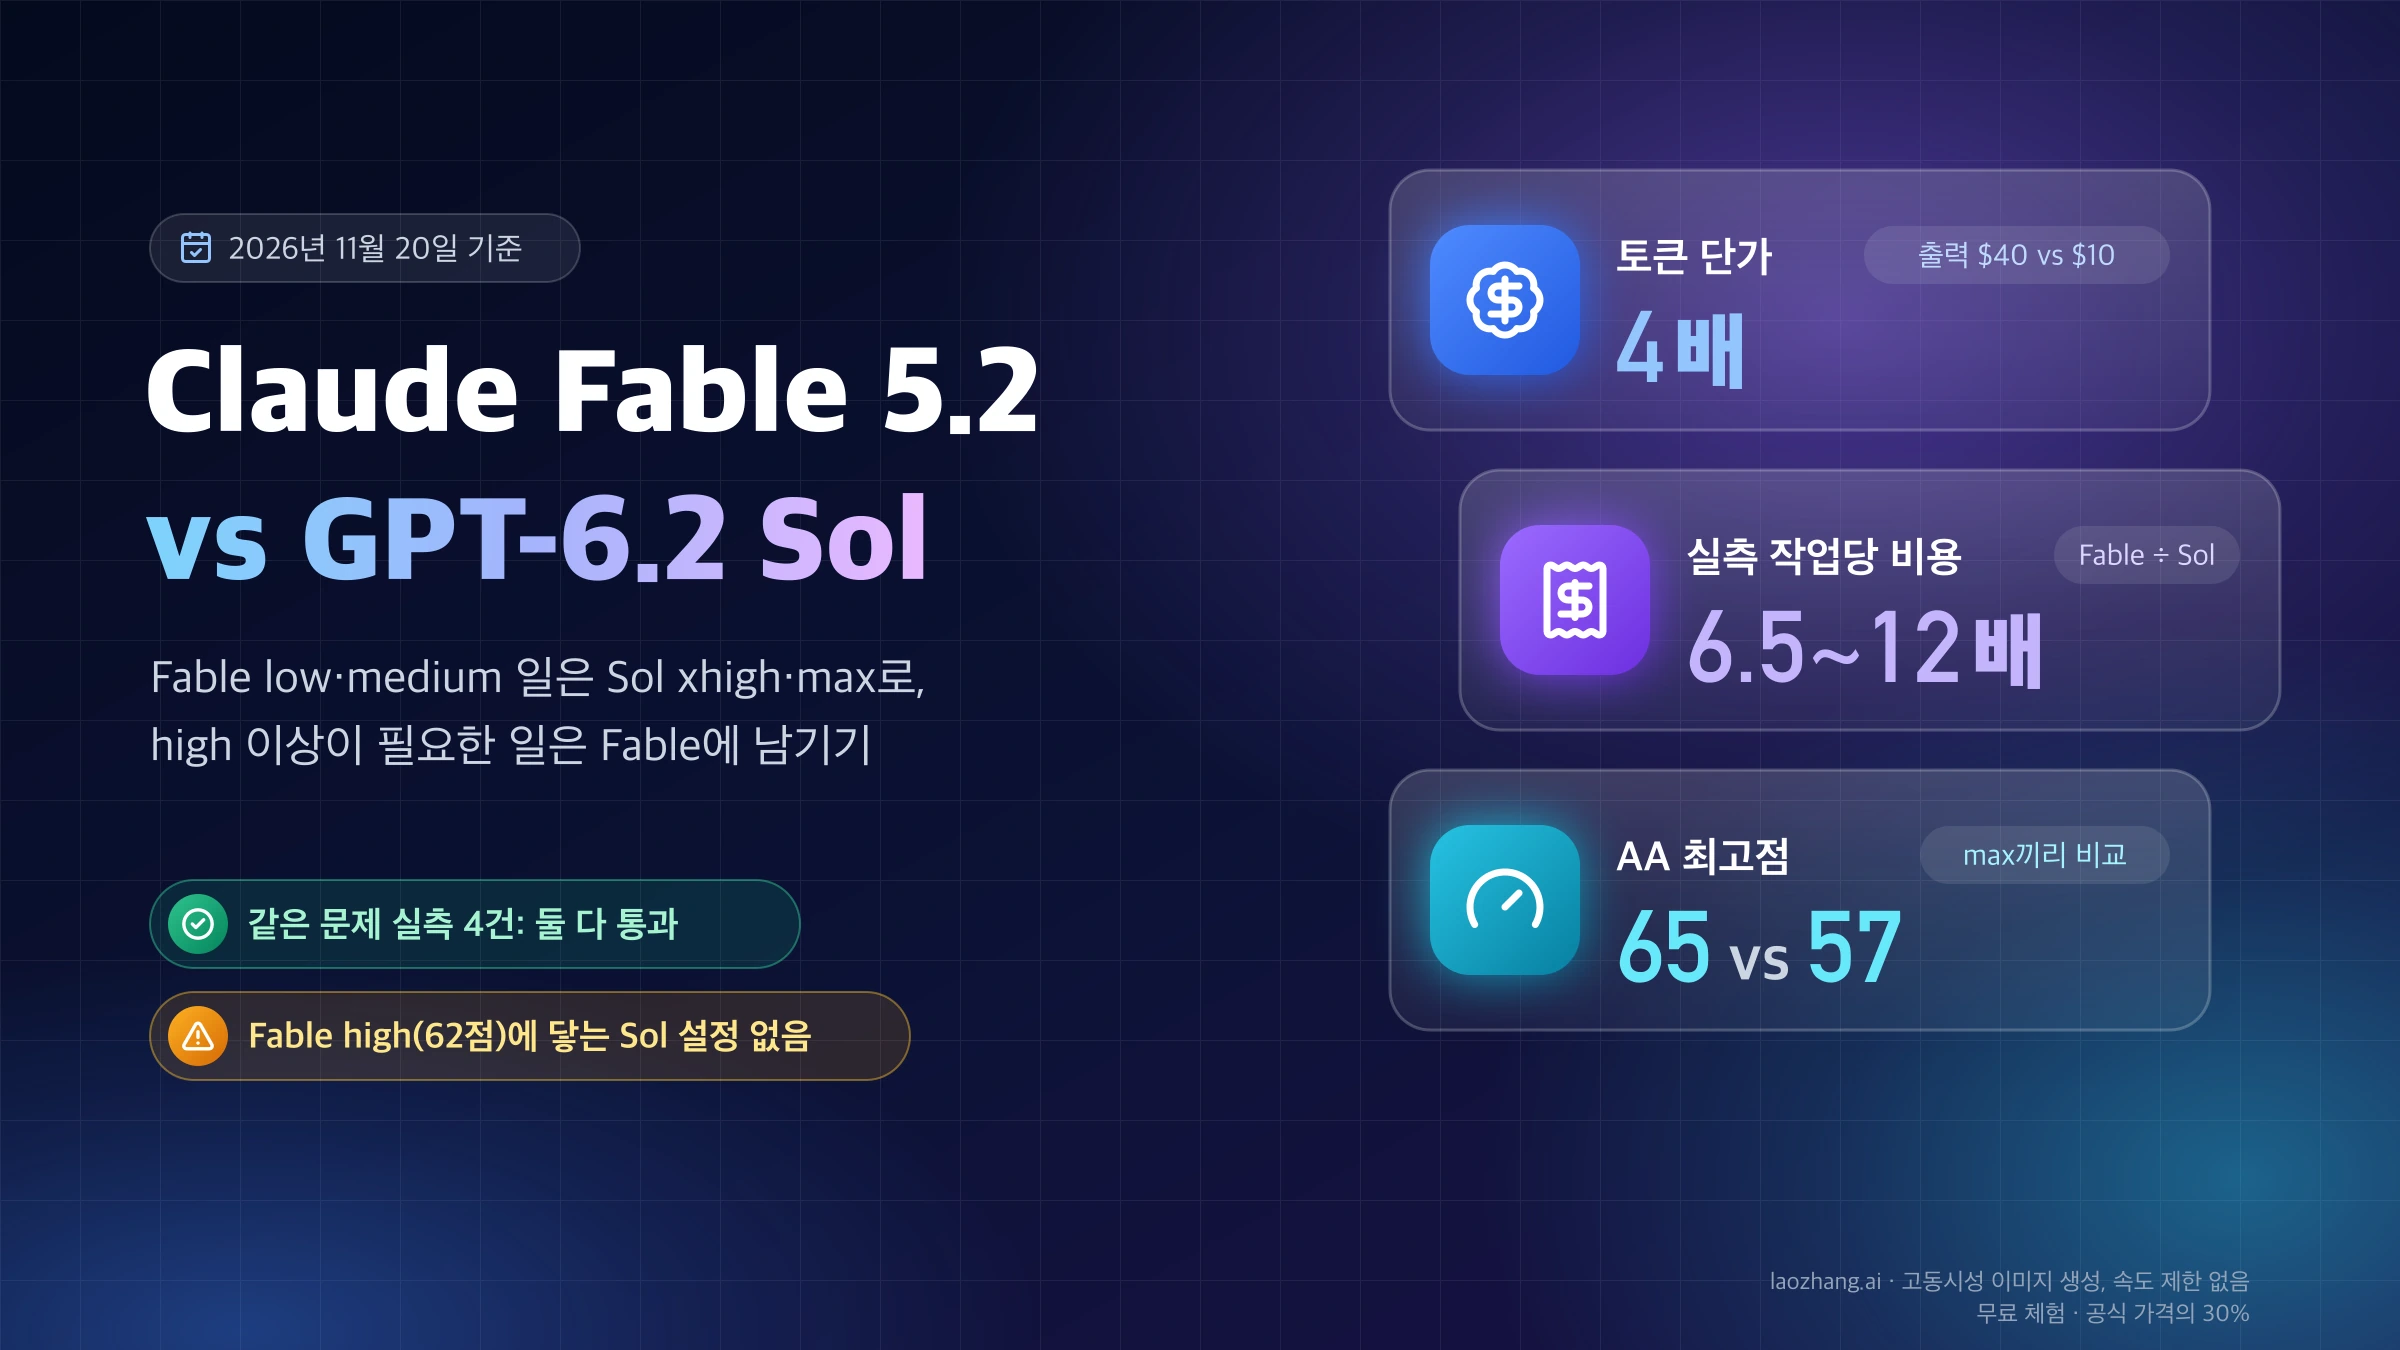
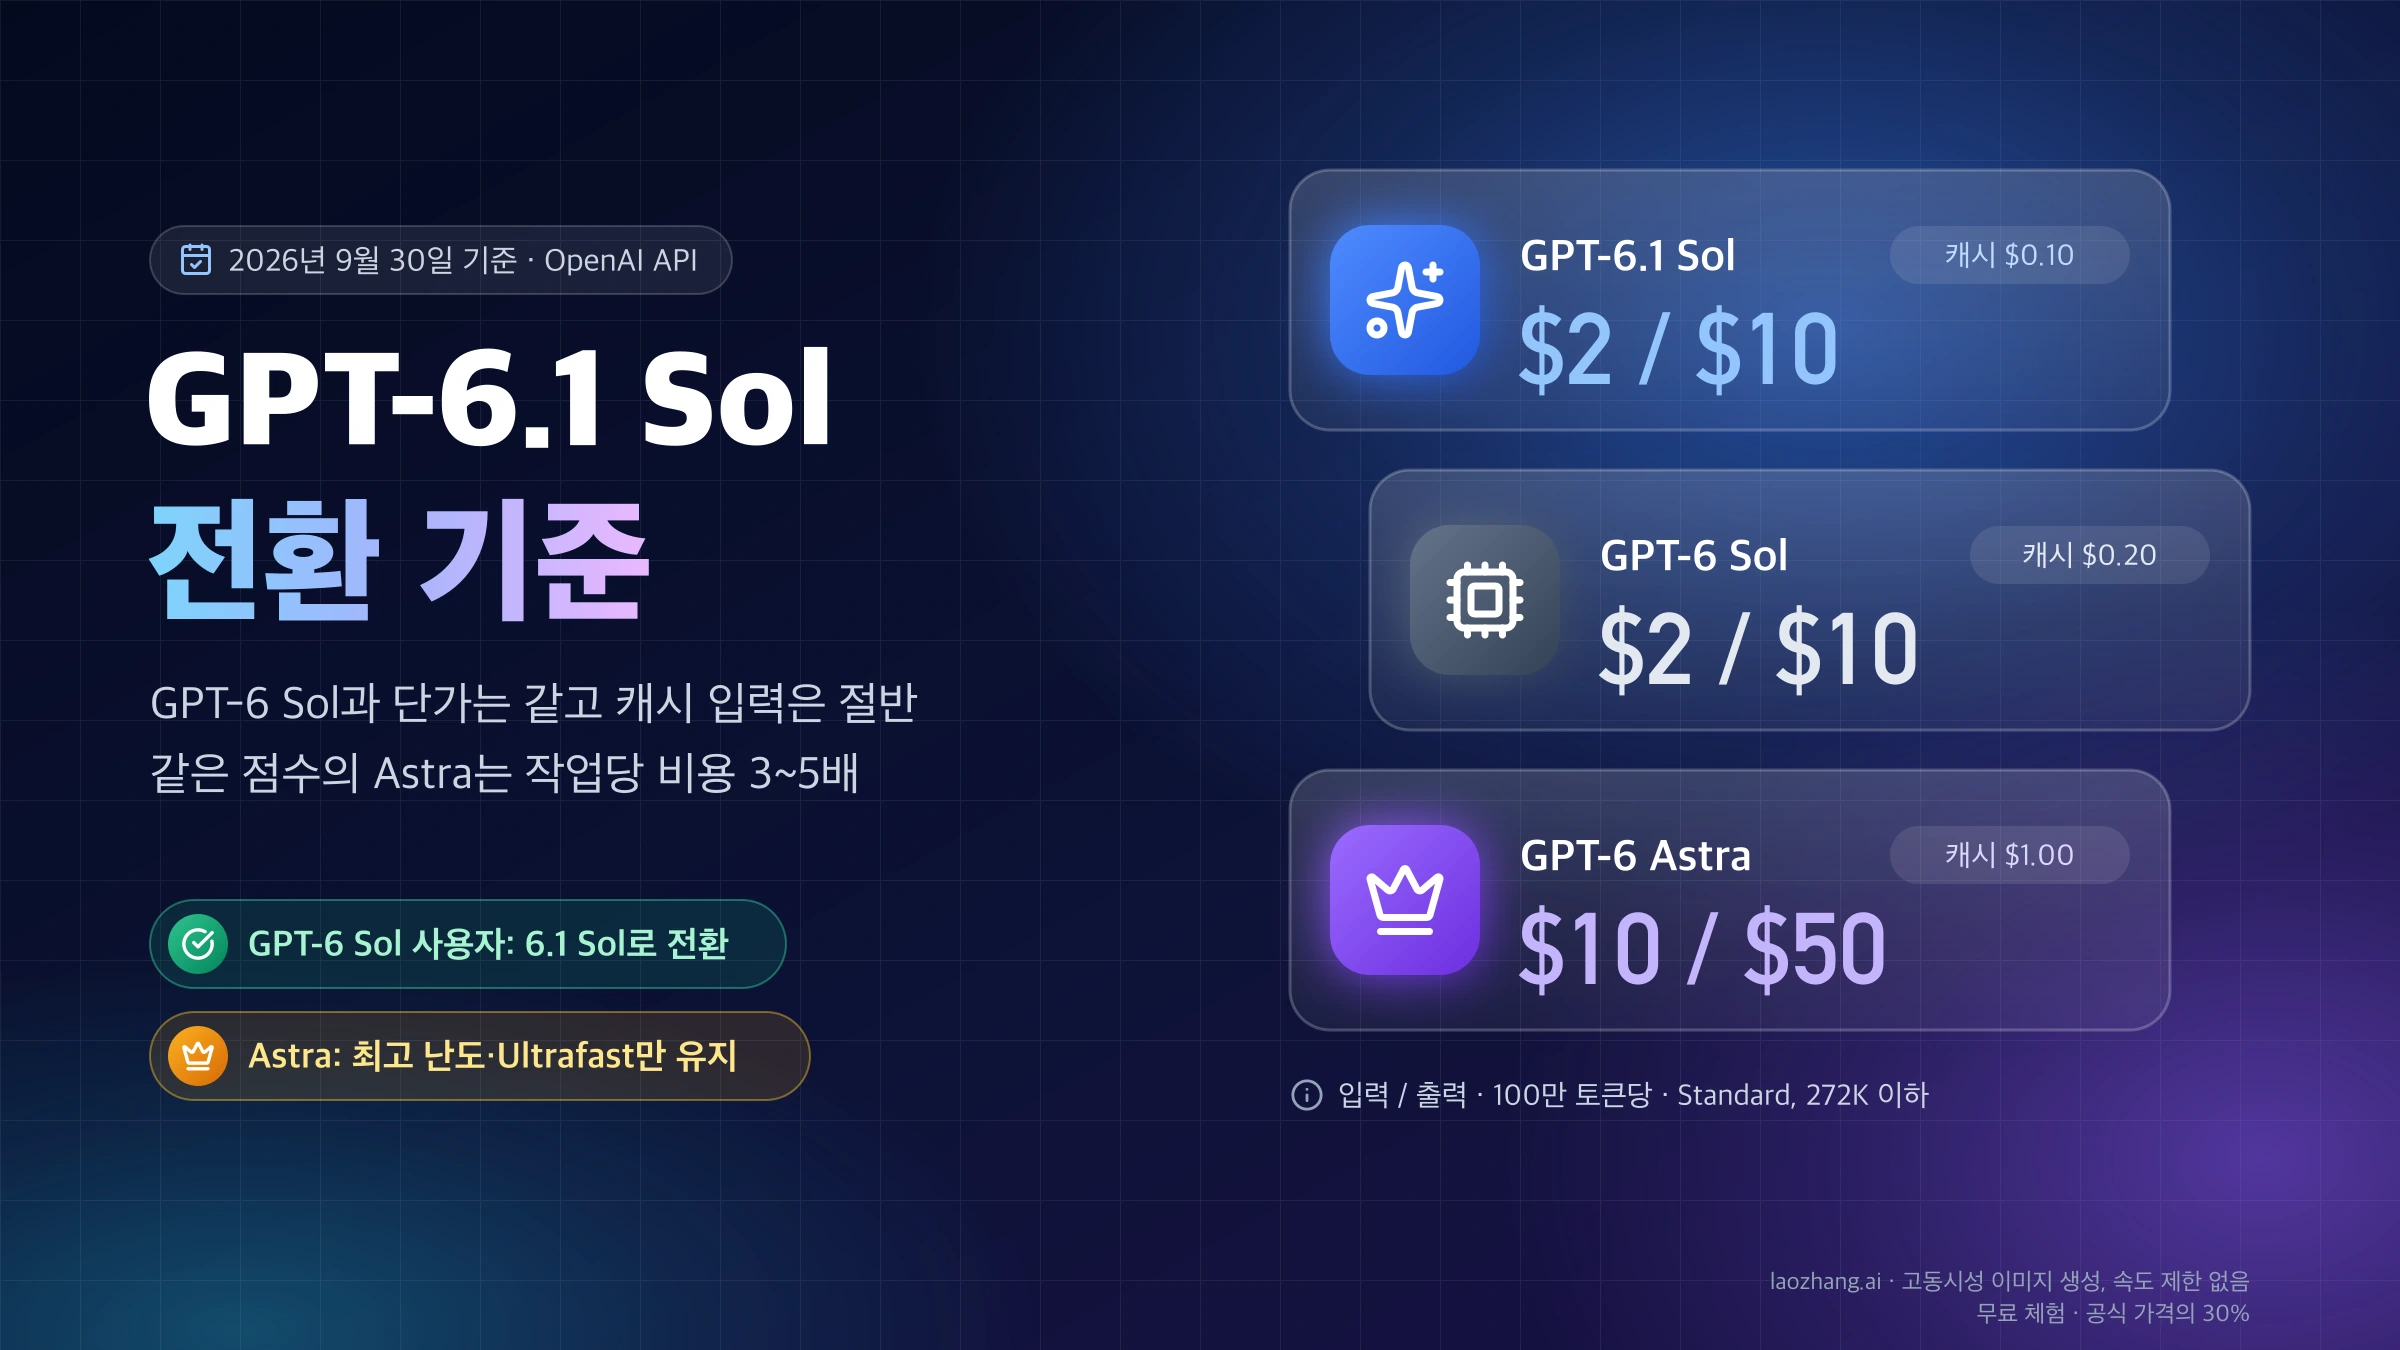
Claude Fable 5.2로 하던 일 중 상당 부분은 GPT-6.2 Sol(gpt-6.2-sol)로 옮길 수 있습니다. 2026년 11월 17일 나온 Sol의 API 단가는 100만 토큰당 입력 $2, 출력 $10으로 Fable 5.2(입력 $8, 출력 $40)의 4분의 1입니다. 같은 문제를 두 모델에 보낸 네 가지 실측(2026년 11월 10~20일)에서는 두 모델 모두 모든 답이 채점을 통과했고, 작업 1건 비용은 Fable이 Sol의 6.5~12배였습니다.
어디까지 옮길지는 지금 Fable을 어떤 effort로 쓰고 있느냐로 정합니다. Artificial Analysis(AA) 지수에서 Sol max(57점)는 Fable medium(56점)과 비슷한 점수를 27%의 비용으로 내기 때문에, Fable low·medium으로 충분했던 일은 Sol xhigh나 max로 시험해 볼 만합니다. 반대로 Fable high(62점) 이상이 있어야 풀리던 일은 Fable에 남겨 두세요. 2026년 11월 20일 기준 Sol은 어떤 설정으로도 62점에 닿지 않습니다.
실측에서 품질 차이는 드러나지 않았다는 점도 함께 봐야 합니다. 측정된 차이는 비용, 토큰, 시간뿐이고 Fable이 더 낫다는 근거는 AA 지수와 OpenAI 자체 발표 그래프에서만 나옵니다. 그러니 데이터 무보존 조직이라 Fable을 못 쓰는지, 일반 ChatGPT 채팅에서 Sol을 찾고 있는지 같은 사용 조건부터 확인한 다음, 자기 작업 10~20개를 두 모델에 돌려 합격 1건당 비용으로 비교하는 것이 가장 확실한 방법입니다.
Fable 5.2와 GPT-6.2 Sol API 가격: 토큰 단가는 4배
같은 토큰 수라면 Claude Fable 5.2는 GPT-6.2 Sol보다 입력과 출력 모두 4배 비쌉니다. 아래는 2026년 11월 18일 기준 OpenAI API 가격표와 Claude API 가격표의 Standard 처리 단가이며, 모두 100만 토큰당 미국 달러입니다.
| 과금 항목 | Claude Fable 5.2 | GPT-6.2 Sol | Fable ÷ Sol |
|---|---|---|---|
| 입력 | $8 | $2 | 4배 |
| 캐시 읽기 | $0.20 | $0.10 | 2배 |
| 출력 | $40 | $10 | 4배 |
| 캐시 쓰기 | 5분 $10, 1시간 $16 | 30분 $2.50, 12시간 $5 | 보존 시간이 달라 직접 비교 불가 |
| 입력 272K 토큰 초과 요청 | 단가 그대로 | 요청 전체 입력 $4, 출력 $15 | 입력 2배, 출력 2.67배 |
| Batch | 입력 $4, 출력 $20 | 입력 $1, 출력 $5 | 4배 |
| 빠른 처리 | fast mode 입력 $16, 출력 $80 | Fast 입력 $4, 출력 $20 | 4배 |
4배가 그대로 유지되지 않는 경우가 둘 있습니다. Sol은 입력이 272K 토큰을 넘는 요청이면 그 요청 전체를 높은 단가로 계산하는 반면 Fable은 100만 토큰 컨텍스트 전체를 같은 단가로 받기 때문에, 긴 입력에서는 차이가 2~2.67배로 줄어듭니다. 캐시 읽기도 2배 차이라서 긴 시스템 프롬프트를 캐시로 반복해 읽는 에이전트 작업일수록 전체 단가 차이는 4배보다 작아집니다.
한국어 프롬프트는 반대로 차이가 커집니다. 2026년 11월 18일 같은 한국어 문단을 두 회사 API에 보냈을 때 Fable 5.2는 입력 토큰을 GPT-6.2 Astra의 1.90배로 셌습니다. Sol은 11개 프롬프트에서 Astra와 입력 토큰 합계가 11,407로 정확히 같았으므로 같은 방식으로 센다고 보면, 같은 한국어 프롬프트의 입력 비용은 Fable이 약 7.6배(4 × 1.90)가 됩니다. 영어는 1.45배여서 약 5.8배입니다. 언어마다 문단 하나로 잰 값이고, Sol이 Astra와 같은 토크나이저를 쓴다는 것은 공개된 사실이 아니라 합계가 같다는 데서 나온 추정입니다.
같은 effort 이름끼리 작업 1건 비용: Fable이 9~26배
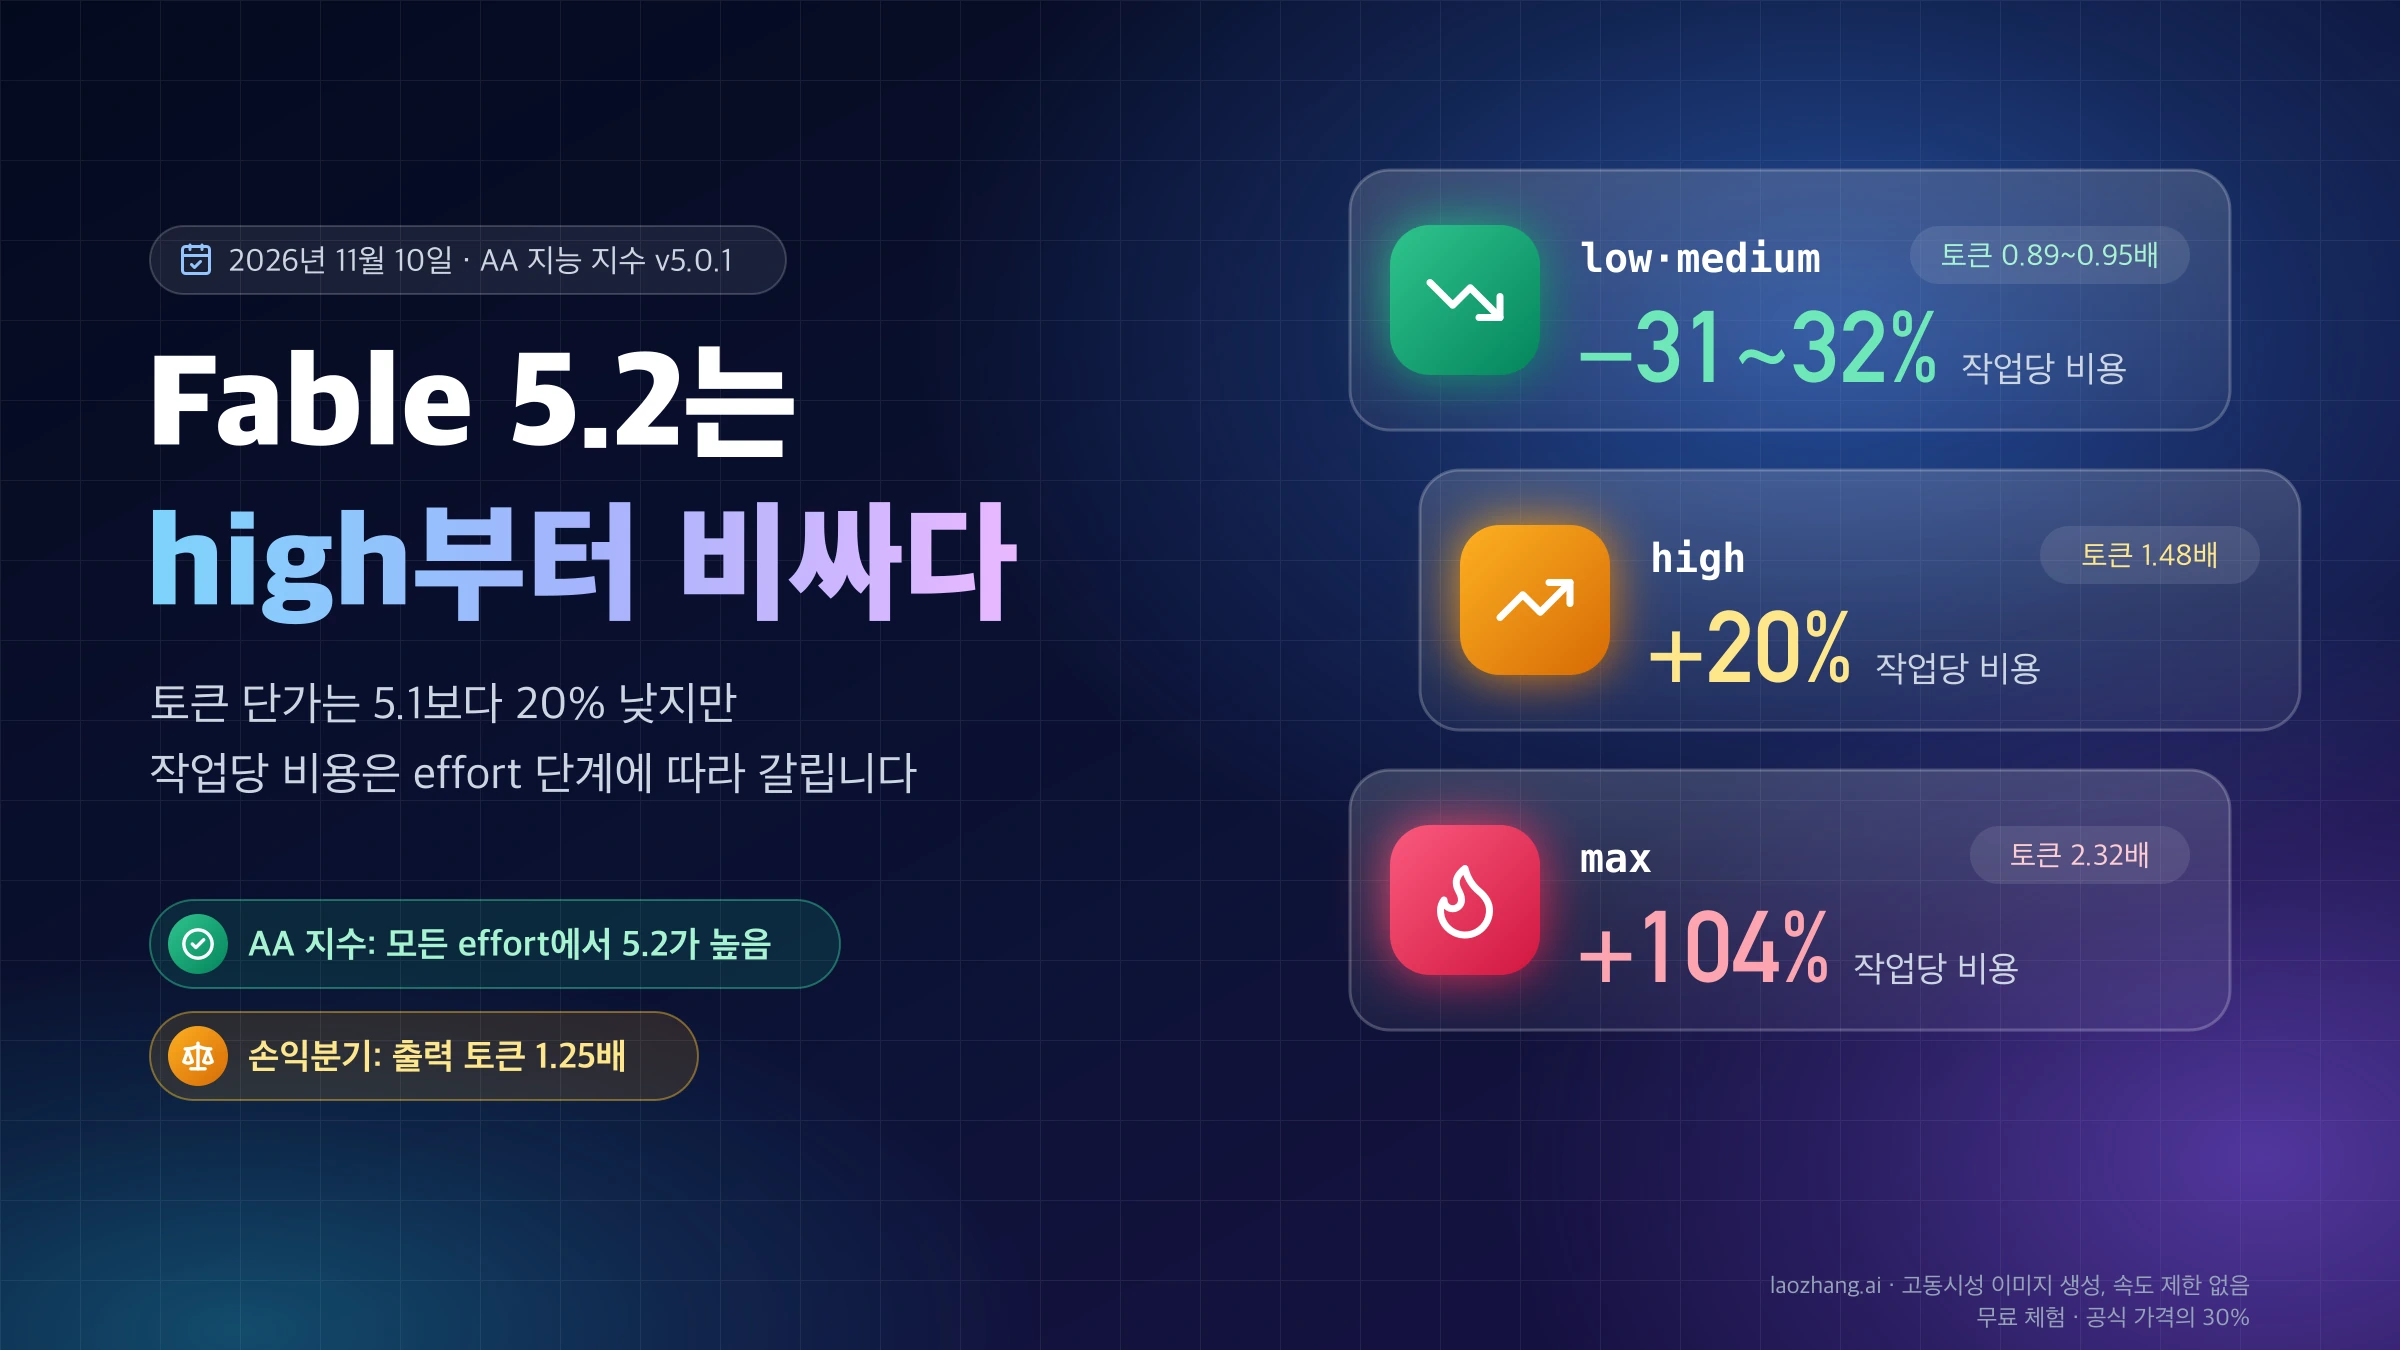
청구서에 더 가까운 숫자는 작업 1건의 비용이고, 같은 effort 이름끼리 비교하면 Fable 5.2가 GPT-6.2 Sol의 9.3~26.3배입니다. 같은 글을 더 많은 토큰으로 세는 데다 같은 일에 출력 토큰도 더 많이 쓰기 때문입니다. 아래는 Artificial Analysis의 Claude Fable 5.2 vs GPT-6.2 Sol 비교 페이지에 실린 Intelligence Index v5.0.1 값이며 2026년 11월 20일 기준입니다.
| effort | Fable 5.2 점수 | Fable 작업당 비용 | GPT-6.2 Sol 점수 | Sol 작업당 비용 | 비용 배수 |
|---|---|---|---|---|---|
max | 65 | $26.54 | 57 | $1.01 | 26.3배 |
xhigh | 62 | $14.83 | 56 | $0.65 | 22.8배 |
high | 62 | $9.08 | 55 | $0.56 | 16.2배 |
medium | 56 | $3.80 | 53 | $0.41 | 9.3배 |
low | 54 | $3.10 | 41 | $0.18 | 17.2배 |
이름이 같다고 같은 양을 생각하는 설정은 아닙니다. Sol low는 41점으로 다른 단계보다 크게 떨어지고, Fable은 high와 xhigh가 같은 62점입니다. 그래서 "Fable high를 Sol high로" 식으로 이름만 옮기면 비용은 16분의 1로 줄지만 점수도 7점 내려갑니다. 분야별 지수에서도 두 모델의 max끼리 금융·회계 65 대 57, 전략·운영 67 대 59, 법률 63 대 55, 의료 65 대 53으로 Fable이 8~12점 앞섭니다. AA는 지수를 예고 없이 고치기도 하고 Fable의 작업당 시간은 이전에도 바뀐 적이 있으므로, 이 값들은 날짜와 함께 읽어야 합니다.
Sol max는 Fable medium급, Fable high에 닿는 Sol 설정은 없음
점수를 맞춰 짝을 지으면 무엇을 옮길지가 분명해집니다. 위 AA 지수에서 Sol xhigh(56점)는 Fable medium과 같은 점수를 17%의 비용으로, Sol max(57점)는 1점 높은 점수를 27%의 비용으로 냅니다. 하지만 Fable high·xhigh의 62점과 max의 65점에 해당하는 Sol 설정은 없습니다. Sol의 최고점 57점은 Fable high보다 5점, max보다 8점 낮습니다.
| 지금 쓰는 Fable 설정 | 점수가 가장 가까운 Sol 설정 | Sol 비용 비율 | 작업당 시간 (Fable / Sol) |
|---|---|---|---|
max (65점) | 없음 | 해당 없음 | 42.0분 / 해당 없음 |
xhigh (62점) | 없음 | 해당 없음 | 24.5분 / 해당 없음 |
high (62점) | 없음 | 해당 없음 | 15.2분 / 해당 없음 |
medium (56점) | xhigh (56점) 또는 max (57점) | 17% 또는 27% | 6.5분 / 5.9분 또는 9.6분 |
low (54점) | high (55점) | 18% | 5.5분 / 5.0분 |
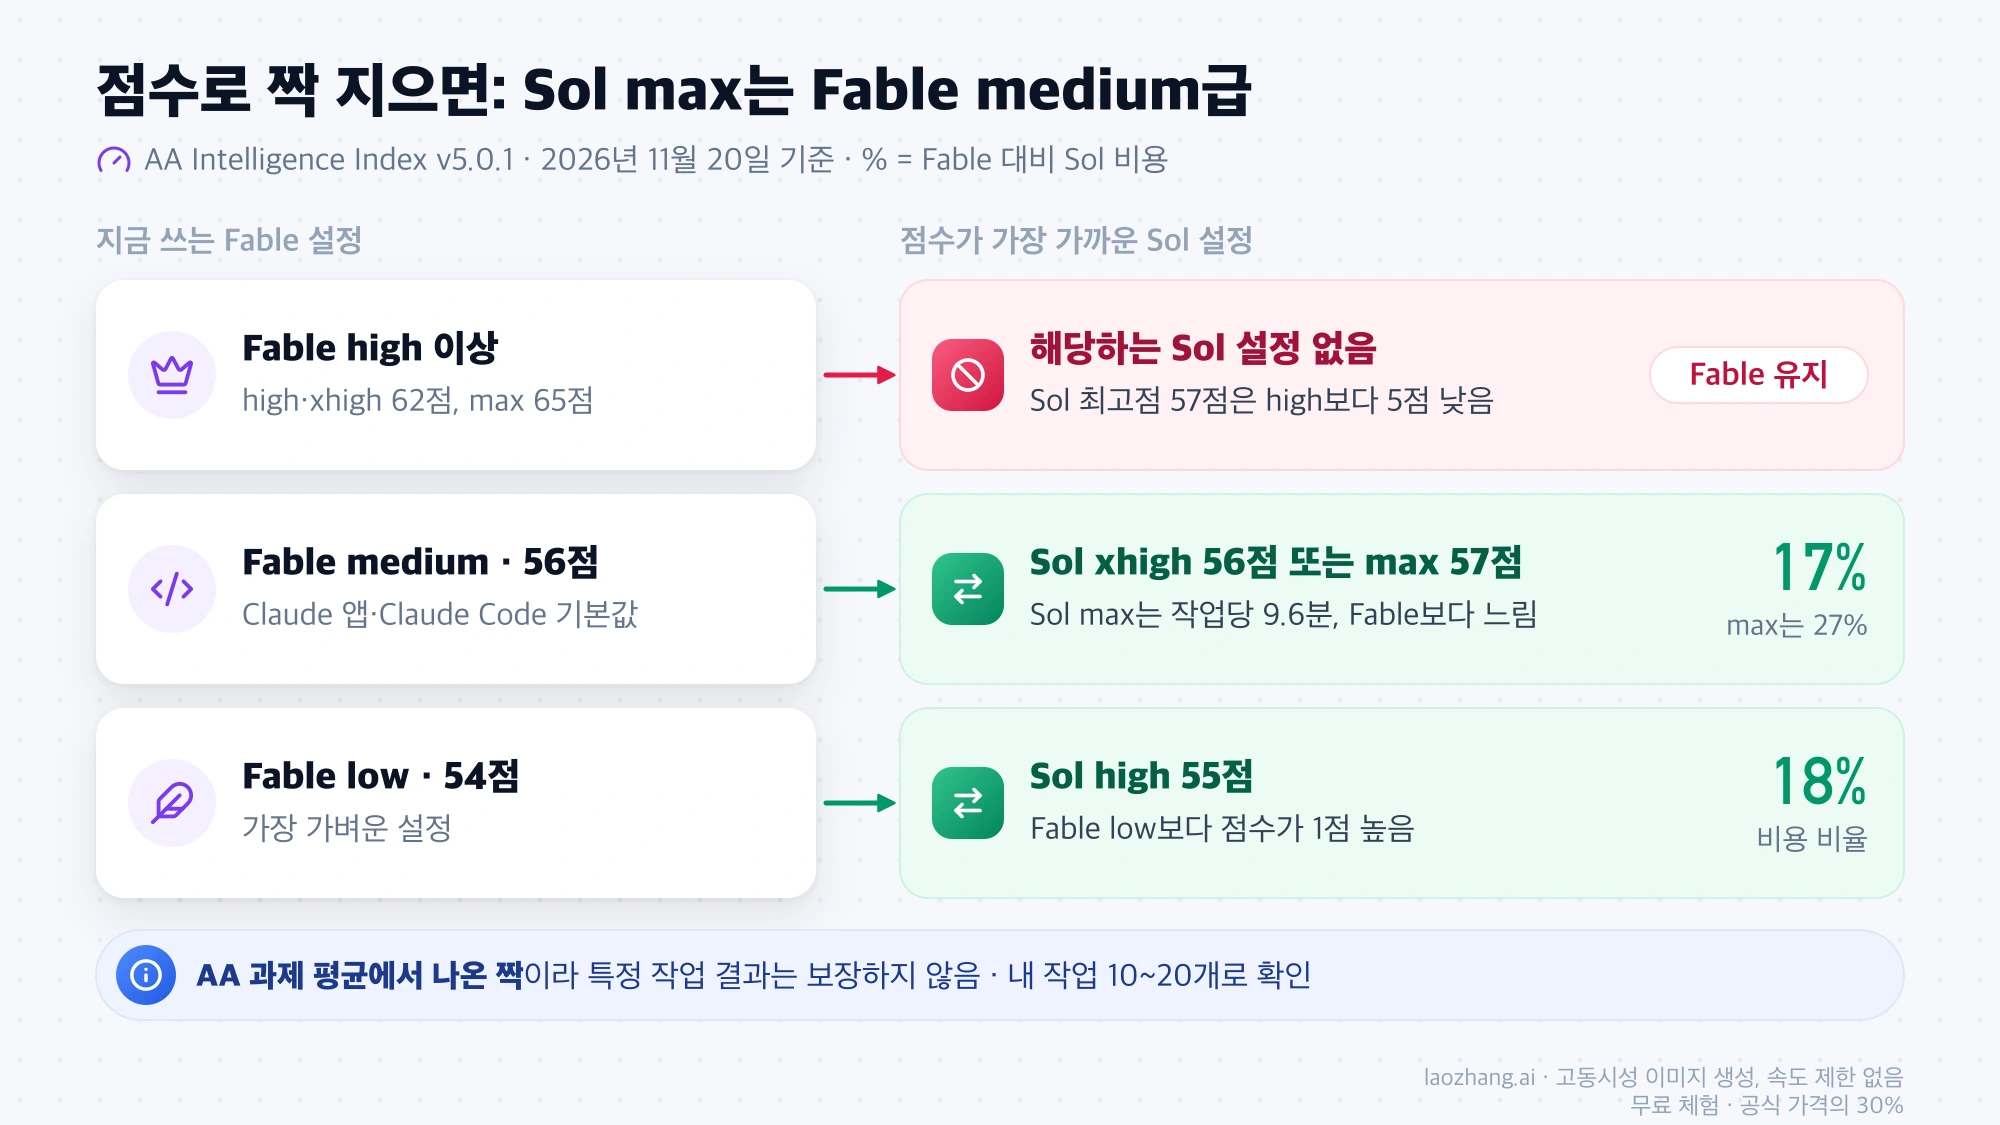
그래서 기준은 Fable을 지금 어떤 effort로 돌리고 있느냐입니다. Fable 5.2의 기본값은 Claude API가 high, Claude 앱과 Claude Code가 medium으로 서로 다릅니다(Fable 5.2 모델 개요). Claude Code 기본 설정으로 충분했던 코딩 작업은 Sol xhigh부터 시험하고, Fable low로 돌리던 일은 Sol high로 옮겨도 AA 기준 점수가 1점 높습니다. Sol medium(53점)도 Fable low보다 1점 낮을 뿐이고 비용은 13%입니다.
API에서 Fable을 기본값 그대로 쓰고 있었다면 한 단계를 더 거쳐야 합니다. 그 일이 정말 high가 필요한지 먼저 Fable medium과 비교해, medium으로도 통과하면 Sol로 옮길 후보로 보고 high에서만 통과하는 일은 Fable에 남깁니다. 다만 이 짝은 AA 지수 과제의 평균에서 나온 것이라 특정 작업의 결과를 보장하지 않습니다. 시간도 함께 보세요. Sol max는 작업당 9.6분으로 Fable medium보다 오래 걸립니다.
OpenAI 발표 그래프의 Sol vs Fable: 최고점은 5개 중 4개가 Fable
OpenAI가 11월 17일 GPT-6.2 Astra·Sol 발표 글에 실은 그래프 중 Sol과 Fable 5.2의 점수가 함께 찍힌 아래 다섯 개를 보면, 두 모델의 최고점은 네 개에서 Fable이 앞섭니다. 공급사가 고른 벤치마크와 실행 환경에서 나온 값이며, 아래 숫자는 그래프의 데이터 라벨 기준이고 괄호 안은 과제당 비용입니다.
| 벤치마크 | Fable 5.2 최고점 | Fable high | GPT-6.2 Sol 최고점 | Sol high |
|---|---|---|---|---|
| Agents' Last Exam v1.1 | 72.8% ($60.05, 유일한 점) | 표시 없음 | 73.0% ($1.32) | 72.0% ($0.69) |
| Terminal-Bench-Science 0.1 | 73.3% ($45.21) | 70.0% ($24.28) | 68.0% ($2.21) | 67.7% ($1.51) |
| Vals Science Index v1 | 63.7% ($8.79, 유일한 점) | 표시 없음 | 58.5% ($0.71) | 단계 표기 없음 |
| BenchCAD 2.1 Core | 83.5% ($50.77) | 61.0% ($9.99) | 73.1% ($1.60) | 64.0% ($0.75) |
| AutomationBench 1.0.6 | 51.4% ($4.64) | 44.3% ($1.69) | 41.2% (high, $0.21) | 41.2% ($0.21) |
Agents' Last Exam에서는 Sol max가 0.2점 높지만, Fable 값은 대체 모델로 넘어간 9개 과제를 뺀 결과라 품질의 우열로 볼 차이가 아닙니다. 같은 effort 이름끼리 보면 Sol이 앞서는 칸도 있습니다. BenchCAD는 medium(41.2% 대 32.4%)과 high(64.0% 대 61.0%), Terminal-Bench-Science는 medium(63.1% 대 60.5%)에서 Sol이 높고, AutomationBench medium은 40.2%로 같습니다. 반면 Fable을 xhigh나 max로 올리면 Agents' Last Exam을 뺀 네 그래프 모두에서 Sol의 최고점을 넘습니다. 중간 단계에서는 Sol이 Fable과 비슷하거나 앞서고 꼭대기에서는 Fable이 앞선다는 점에서, 앞의 AA 점수 짝과 같은 그림입니다. Terminal-Bench-Science의 Fable 값은 Artificial Analysis가 mini-swe-agent로 돌린 결과이며, Anthropic은 Claude Code에서 max로 74.6%를 냈다고 밝혔습니다.
Fable에 남길 일을 고르는 단서로 읽으면, 터미널에서 오래 이어지는 과학 작업, 과학 지식 문제, 정밀도가 높은 CAD, 여러 단계로 된 업무 자동화처럼 최고점이 필요한 일입니다. 이 네 그래프에서 Fable이 5~10점 앞서지만, 최고점끼리 과제당 비용도 Fable이 12~32배입니다. 그 점수 차가 결과물의 합격 여부를 바꾸는 일인지가 판단 기준입니다.
같은 문제 실측: 네 번 모두 둘 다 통과, 차이는 비용과 시간
같은 문제를 두 모델에 보낸 네 가지 실측에서는 Fable 5.2와 GPT-6.2 Sol 모두 모든 답이 채점을 통과했습니다. 그래서 측정된 차이는 비용, 토큰 수, 걸린 시간뿐이고 품질 차이는 측정되지 않았습니다. 앞에서 본 Fable의 점수 우위는 AA 지수와 OpenAI 그래프에서 나온 것이며, 이 실측들로 확인한 것이 아닙니다.
| 테스트 | Claude Fable 5.2 | GPT-6.2 Sol | Fable ÷ Sol |
|---|---|---|---|
| 8문제 11개 답, API | 기본(high) 11/11, $0.7436, 173.2초 (11월 11일) | 기본(medium) 11/11, $0.0610, 56초 (11월 18일) | 비용 12.2배, 시간 3.1배 |
| 146KB 로그에서 일곱 가지 개수 세기, API | 기본 전부 정답, $1.02, 73.7초 (11월 11일) | 기본 전부 정답, $0.1581, 13.6초 (11월 18일) | 비용 6.5배, 시간 5.4배 |
| 11문제 에이전트 키트, 코딩 CLI | Claude Code high 22/22, 실행당 $2.1545, 221.8초 (11월 10일) | Codex CLI high 33/33, 실행당 $0.184, 195초 (11월 20일) | 비용 11.7배, 시간 1.14배 |
| 고난도 8문제 16개 답, API | 기본(high) 16/16, $3.6118, 호출당 중앙값 25.8초 (11월 20일) | 기본(medium) 16/16, $0.2971, 7.3초 (11월 20일) | 비용 12.2배, 합산 시간 3.27배 |
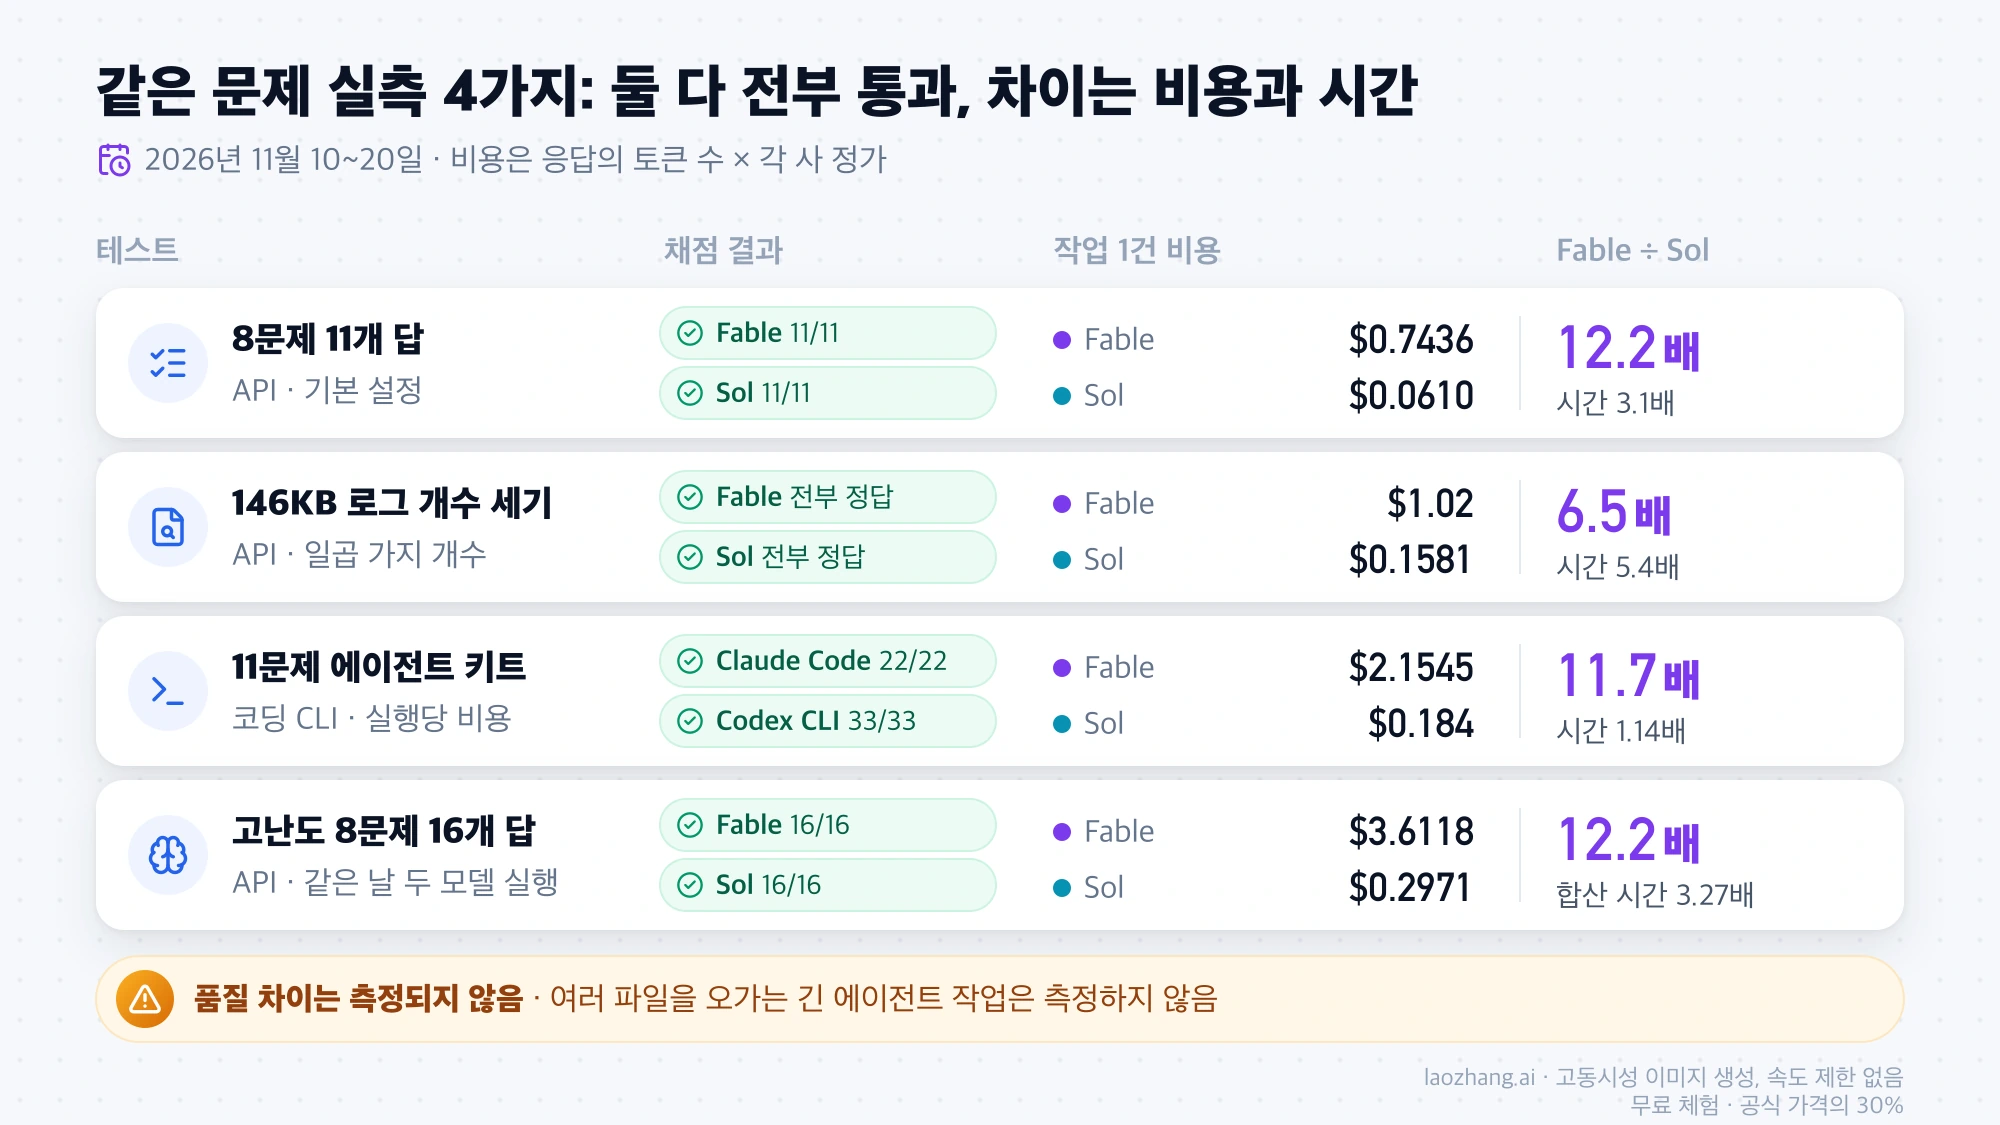
API 테스트는 모두 LaoZhang API 게이트웨이를 거쳐 같은 프롬프트와 같은 채점기로 보냈습니다. Sol은 Chat Completions, Fable은 Messages API로 호출했고, 비용은 응답에 찍힌 토큰 수에 각 사 정가를 곱한 값입니다. 앞의 세 테스트는 Fable이 11월 10~11일, Sol이 11월 18~20일 결과로 날짜가 다르지만 그 사이 Fable 가격은 바뀌지 않았고, 고난도 세트는 같은 날 두 모델을 함께 돌렸습니다. 설정마다 1~3회씩 돌린 결과라 표본은 작고, 날짜는 모두 UTC 기준입니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
첫 두 테스트에서 비용 차이를 만든 것은 출력량과 토큰 계산 방식입니다. 8문제 세트에서 Fable은 출력 토큰을 Sol의 3.97배 썼고, Fable을 low로 내려도 비용은 Sol 기본의 6.9배였습니다. Sol을 high로 올려도 11/11에 $0.0812로 크게 늘지 않았습니다. 로그 세기에서는 같은 로그를 Fable이 78,537 입력 토큰, Sol이 55,843 입력 토큰으로 세어 입력만으로 1.41배 차이가 났습니다. 이 로그는 272K보다 훨씬 작아 Sol의 긴 입력 단가는 적용되지 않았습니다.
코딩 CLI 테스트는 모델과 함께 도구도 다릅니다. Sol은 Codex CLI 0.166.0에서 codex exec -m gpt-6.2-sol로 매번 빈 디렉터리에서 3회씩 돌렸고, Fable은 Claude Code에서 2회 돌린 11월 10일 기록입니다. 둘 다 구독으로 실행한 사용량을 API 정가로 환산한 값이라 실제 청구액은 아닙니다. Sol 비용의 대부분은 실행마다 약 30만 토큰씩 들어간 컨텍스트이고 그중 약 88%가 $0.10의 캐시 입력이었습니다. Sol medium도 33/33에 실행당 $0.176, 159초로 high와 거의 같았습니다.
고난도 세트는 품질 차이를 드러내려고 새로 만든 8문제입니다. 회의 시간 찾기, 연산자 우선순위와 지연 평가가 있는 수식 언어, 로드하우섬의 30분 서머타임과 2011년 하루가 사라진 아피아까지 다루는 일정 계산, 중괄호 확장과 **가 있는 glob 매칭, 83줄짜리 LRU·TTL 캐시의 버그 두 개 고치기, 규칙 8개를 맞춘 JSON 계획, 길이 12 문자열 개수 세기(정답 6503), 12일 재고 시뮬레이션(정답 $130.10)이고, 숨긴 테스트와 정답은 첫 호출 전에 고정했습니다. 문제당 2회씩 보낸 결과 Fable medium(16/16, $1.7857)과 Sol high(16/16, $0.4574), Sol xhigh(16/16, $0.7008)까지 다섯 설정이 모두 전부 통과했습니다. Sol을 기본에서 xhigh로 올리자 추론 토큰은 14,502에서 55,000으로 늘었지만 결과는 그대로였습니다. 문제별로 보면 Fable 기본이 Sol 기본의 9.2~19.7배였고 Sol이 8문제 모두에서 쌌습니다.
채점기는 실행 뒤 한 번 고쳤습니다. glob 문제의 숨긴 테스트 하나가 프롬프트에 없던 규칙을 검사하고 있었고, 10개 답이 모두 그 테스트 하나만 똑같이 틀렸기 때문에 그 테스트를 뺐습니다. 고치기 전 기준으로도 모든 설정이 같은 점수라 비교 결과는 달라지지 않습니다.
측정하지 않은 것도 분명히 해 둡니다. 네 테스트는 모두 단발 문제이거나 작은 CLI 과제이고, 여러 파일을 오가며 몇 시간 이어지는 에이전트 작업은 없습니다. 실제 프로젝트에서 하루를 써 본 X 사용자 kunchenguid는 11월 19일 GPT-6.2 Astra와 Sol이 Fable 5.2와 Opus 5.5를 그대로 대체하지는 못하고, 사용자에게 물어볼지 그냥 진행할지 판단하는 부분이 "아직 딱 맞지 않는다"고 적었습니다. 한 사람의 사용 소감이지만, 실측에서 차이가 안 났다고 긴 작업에서도 같다고 볼 수는 없다는 뜻입니다.
속도: Sol medium은 첫 답 3.6초, Sol max는 Fable medium보다 느림
대부분의 설정에서 GPT-6.2 Sol이 빠르지만, 점수를 맞추려고 Sol을 max까지 올리면 Fable medium보다 느려집니다. AA 기준(2026년 11월 20일) 첫 답 토큰까지 걸린 시간은 Sol medium 3.6초, high 13.5초, max 83.9초이고 Fable은 low 8.3초, medium 11.2초, high 25.1초, max 262.5초입니다.
실측에서도 단발 API 문제는 Fable 기본이 Sol 기본보다 3.1~5.4배 오래 걸렸지만, 명령 실행과 파일 읽기가 섞이는 코딩 CLI 키트에서는 차이가 1.14배로 작았습니다. 더 빠른 응답이 필요하면 두 모델 모두 유료 고속 옵션이 있습니다. Fable fast mode는 표준 단가의 2배이고, Sol은 Fast가 2배, Ultrafast가 2027년 2월 28일까지 3배(입력 $6, 출력 $30)이고 그 뒤로는 6배입니다.
Fable이나 Sol을 아예 쓸 수 없게 만드는 조건
품질과 비용을 비교하기 전에, 아래 조건 중 하나에 걸리면 비교할 필요 없이 한쪽만 남거나 코드를 고쳐야 합니다. 서로 독립된 조건이므로 하나씩 확인하세요.
- 조직이 데이터 무보존(ZDR)으로 설정돼 있다면 Fable 5.2는 별도 승인 없이 400을 돌려줍니다. Fable 5.2는 30일 데이터 보존을 요구합니다(Anthropic의 모델별 데이터 보존 요건).
- 도구 호출에서
tool_choice를any나 특정tool로 강제하고 있다면 Fable 5.2에서는 400이 납니다(Fable 5.2 마이그레이션 가이드). - 보안 취약점 분석이나 생물학 연구가 주된 작업이라면, Fable 5.2의 안전 분류기가 위험도 높은 사이버보안 작업과 대부분의 생물학 연구 작업을 이전 모델로 넘깁니다. 이런 요청에는 Fable 5.2가 답하지 않습니다.
- 요청량이 많다면 Fable 5.2의 요청 한도(rate limit)가 Opus 5.5보다 낮다는 점을 감안해야 합니다.
- PDF를 그대로 넣어야 한다면 Fable 5.2는 PDF를 직접 받지만 Sol은 텍스트와 이미지만 받으므로 변환이 필요합니다.
- 입력이 272K 토큰을 넘는 요청이 잦다면 Sol의 그 요청 단가가 입력 2배, 출력 1.5배로 오르므로 절감 폭을 다시 계산해야 합니다.
- 코드가 effort를
none으로 보내고 있다면 Sol은 400을 돌려줍니다. 2026년 11월 18일 API 게이트웨이를 거친 호출에서 돌아온 메시지는Unsupported value: 'none' is not supported with the 'gpt-6.2-sol' model…이었고, effort를 빼면 기본값medium으로 처리됐습니다. - Sol을 Chat Completions로 부르고 있다면
reasoning_effort는low~xhigh까지만 받고max는 Responses API에서만 됐습니다(11월 18일 호출 기준). OpenAI의 GPT-6.2 Sol 모델 페이지에 따르면 도구 호출도 Responses API가 필요합니다. - 긴 지시문을 Responses API의 최상위
instructions에 넣고 있다면 GPT-6.2부터는 입력 뒤에 붙어 캐시가 맞지 않습니다. OpenAI 안내대로 input의 첫 항목인 developer 메시지로 옮겨야 캐시 단가를 받을 수 있습니다. - 구독의 일반 ChatGPT 채팅에서 Sol을 찾고 있다면 그곳에는 없습니다. Sol은 ChatGPT Work와 Codex에만 들어갔습니다.
구독에서 쓸 때: ChatGPT Work·Codex의 Sol, Claude 요금제의 Fable
구독 안에서는 API와 비교 조건이 다릅니다. OpenAI 도움말의 GPT-6 모델 안내에 따르면 11월 17일부터 GPT-6.2 Sol은 Plus, Pro, Enterprise, Edu 요금제의 ChatGPT Work와 Codex에서 쓸 수 있고, 그 안에서 Sol을 몇 번 쓸 수 있는지는 공개되지 않았습니다. Sol Ultrafast는 Pro($200, $500 요금제)에서 쓸 수 있습니다.
Claude 쪽은 요금제별 Fable 모델 이용 조건에 따라 Max, Ultra, 프리미엄 Team·Enterprise 좌석에서는 Fable 모델이 주간 한도의 50%까지 포함되고, Pro와 표준 Team 좌석에서는 사용량 크레딧으로 과금됩니다. 11월 9~16일 출시 주간에 Pro에도 포함됐던 혜택은 끝났습니다. 그래서 Claude Pro에서 Fable을 크레딧으로 쓰고 있다면, 이미 ChatGPT Plus가 있는 경우 Codex에서 Sol을 추가 비용 없이 먼저 시험해 볼 수 있습니다. 위 코딩 CLI 실측도 Codex를 구독으로 돌린 것입니다.
내 작업으로 확인하는 법: 합격 1건당 비용 비교
AA 평균이나 공급사 그래프보다 확실한 것은 자기 작업에서 통과한 결과 1건에 드는 비용입니다. 계산식은 합격 1건당 비용 = 전체 비용 ÷ 통과한 답 수이고, 요청 1건 비용은 입력·캐시 입력·출력 토큰 수에 각 단가를 곱해 더한 값입니다. 예를 들어 위 고난도 세트라면 Fable 기본은 $3.6118 ÷ 16 = 약 $0.226, Sol 기본은 $0.2971 ÷ 16 = 약 $0.019입니다.
- 최근 Fable로 처리한 작업 10~20개를 고르고, 테스트나 정답처럼 통과 여부를 기계적으로 가를 기준을 먼저 적어 둡니다. 둘 다 쉽게 통과하는 일만 고르면 위 실측처럼 차이가 드러나지 않으므로, Fable도 한 번에 풀지 못했거나 재작업이 많았던 일을 꼭 섞습니다.
- Fable은 지금 쓰는 설정 그대로(API는
high, Claude Code는medium), Sol은 기본medium과xhigh두 가지로 같은 프롬프트를 2회 이상씩 보냅니다. Fable API를 처음 호출한다면 Claude Fable 5.2 API 키 발급·사용법: 전용 키 없음, 첫 호출과 오류 해결에서 시작하면 됩니다. - 응답의 usage에서 입력, 캐시 입력, 출력 토큰을 기록합니다. Fable은 같은 한국어를 더 많은 토큰으로 세므로 한쪽 토큰 수로 다른 쪽 비용을 추정하지 않습니다.
- 같은 기준으로 채점해 모델과 설정별로 합격 1건당 비용을 내고, 사람이 결과를 고치는 데 든 시간도 함께 적습니다.
- Sol이 통과한 유형의 작업은 Sol로 옮기고, Sol
xhigh에서도 떨어지고 Fable만 통과한 유형은 Fable에 남깁니다.
두 모델이 모두 전부 통과한다면 그 작업 유형에서는 비용과 속도만 비교하면 되므로 Sol로 옮기는 쪽이 유리합니다. Sol이 떨어지는 작업이 소수라면 그 작업만 Fable로 보내는 라우팅이 전체 비용을 가장 많이 줄입니다.
Fable 5.2 vs GPT-6.2 Sol 자주 묻는 질문
GPT-6.2 Sol Pro는 Sol과 다른 모델인가요?
아닙니다. OpenRouter 등이 "GPT-6.2 Sol Pro"로 따로 표시하는 것은 같은 gpt-6.2-sol에 Responses API의 reasoning.mode를 pro로 보낸 것입니다. OpenAI 추론 가이드에 따르면 mode와 effort는 따로 정하며, OpenAI 가격표에 Sol Pro 단가 행은 없습니다. 2026년 11월 20일 기준 OpenRouter의 GPT-6.2 Sol Pro 페이지는 토큰 단가가 Sol과 같지만 요청 1건 비용이 몇 배 들고 훨씬 오래 걸린다고 설명합니다. AA 지수의 Sol 점수는 모두 기본 mode 값입니다.
Fable 5.2와 맞붙는 OpenAI 모델로 GPT-6.2 Astra는 어떤가요?
OpenAI가 Fable 5.2의 상대로 내세운 모델은 Sol이 아니라 같은 날 나온 GPT-6.2 Astra이며, 정가가 Fable과 같은 입력 $8, 출력 $40입니다. 두 모델의 점수와 실측 비용은 Fable 5.2 vs GPT-6 Astra 비교: GPT-6.2 Astra는 같은 정가, 실측 비용 25%에서 비교합니다.
Sol을 6.1 Sol, Opus 5.5, Gemini 4 Hydrogen과도 비교하려면?
이전 버전과 Claude 중간 모델과의 차이는 GPT-6.2 Sol vs 6.1 Sol vs Opus 5.5 비교: 12문제 실측과 effort 선택에, Google 저가 모델과의 비교는 Gemini 4 Hydrogen vs GPT-6.2 Sol 비교: 단가 싼 Hydrogen, 실측 비용 3.6배에 있습니다. OpenAI로 옮기지 않고 Claude 안에서 Fable 비용을 줄이고 싶다면 Claude Fable 5.2 vs Opus 5.5 비교: 실측 비용 1.86배와 effort 고르는 법을 보세요.
참고 자료12
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 21일.
참고 자료12
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 11월 21일.
- 1.OpenAI API 가격표developers.openai.com/api/docs/pricing
- 2.Claude API 가격표platform.claude.com/docs/en/about-claude/pricing
- 3.Artificial Analysis의 Claude Fable 5.2 vs GPT-6.2 Sol 비교 페이지artificialanalysis.ai/models/comparisons/claude-fable-5-2-vs-gpt-6-2-sol
- 4.Fable 5.2 모델 개요platform.claude.com/docs/en/models/fable-5-2/overview
- 5.GPT-6.2 Astra·Sol 발표 글openai.com/index/introducing-gpt-6-2-astra-sol
- 6.Anthropic의 모델별 데이터 보존 요건platform.claude.com/docs/en/manage-claude/api-and-data-retention
- 7.Fable 5.2 마이그레이션 가이드platform.claude.com/docs/en/models/fable-5-2/migration-guide
- 8.OpenAI의 GPT-6.2 Sol 모델 페이지developers.openai.com/api/docs/models/gpt-6.2-sol
- 9.OpenAI 도움말의 GPT-6 모델 안내help.openai.com/en/articles/20001354-gpt-6-and-other-models-in-chatgpt
- 10.요금제별 Fable 모델 이용 조건support.claude.com/en/articles/15424964-claude-fable-models-on-your-plan
- 11.OpenAI 추론 가이드developers.openai.com/api/docs/guides/reasoning
- 12.OpenRouter의 GPT-6.2 Sol Pro 페이지openrouter.ai/openai/gpt-6.2-sol-pro