Claude Batch API 가격: 50% 할인보다 캐싱이 더 아끼는 경우
Claude Batch API는 모든 토큰을 반값으로 받지만, 공유 프리픽스가 긴 작업은 일반 호출+캐싱이 캐싱 없는 배치보다 쌉니다. 배치 안 캐싱은 적중률 약 21%부터 이득입니다.
목차

Claude Batch API(Message Batches API)는 결과를 바로 받지 않아도 되는 요청을 모아 POST /v1/messages/batches로 보내면 입력·출력·캐시 토큰을 모두 표준 가격의 50%로 처리합니다. 2026년 10월 30일 기준 Sonnet 5.5는 100만 토큰당 입력 $2·출력 $10이 배치에서 $1·$5가 되고, 대부분의 배치는 1시간 안에 끝나지만 최대 24시간까지 걸릴 수 있습니다. 평가, 분류, 추출, 야간 리포트처럼 몇 시간 기다려도 되는 작업이라면 배치로 옮길 이유가 충분합니다.
다만 반값이 곧 가장 싼 방법은 아닙니다. 요청마다 같은 긴 시스템 프롬프트나 문서를 앞에 붙이는 작업에서 이미 일반 호출로 프롬프트 캐싱을 쓰고 있다면, 캐싱 없이 배치로 옮기는 순간 비용이 오히려 늘 수 있습니다. 공유 프리픽스 3,000토큰, 고유 입력 800토큰, 출력 250토큰인 요청 1만 건을 Sonnet 5.5로 계산하면 일반 호출+캐싱은 $44.00, 캐싱 없는 배치는 $50.50입니다. 그래서 배치로 옮길 때는 공유 프리픽스의 cache_control을 그대로 남겨 두세요. 같은 작업에서 배치 안 캐시 적중률이 98%면 $22.72까지 내려갑니다.
실패 처리도 비용의 일부입니다. 결과는 입력 순서와 다르게 돌아오므로 요청마다 붙인 custom_id로 맞춰야 하고, expired와 서버 쪽 errored는 과금되지 않으니 그대로 다시 보내되 invalid_request_error는 요청 본문을 고친 뒤에 보내야 합니다. Amazon Bedrock과 Google Vertex AI는 각자의 배치 추론 조건을 따르고, 배치 엔드포인트가 없는 게이트웨이에서는 이 할인을 받을 수 없습니다.
Claude Batch API 가격: 입력·출력·캐시 토큰 모두 50%
Anthropic의 배치 처리 문서는 Message Batches API가 표준 API 가격 대비 모든 사용량을 50% 할인하며, 입력 토큰과 출력 토큰은 물론 "특수 토큰"에도 적용된다고 설명합니다. Claude API 요금 페이지는 프롬프트 캐싱 배수가 배치 할인과 겹쳐 적용된다고 밝히고 있어서, 캐시 읽기와 캐시 쓰기도 배치 안에서는 반값이 됩니다. 2026년 10월 30일 기준 현행 모델의 100만 토큰당 가격은 다음과 같습니다.
| 모델 | 일반 입력 / 출력 | 배치 입력 / 출력 | 배치 캐시 읽기 |
|---|---|---|---|
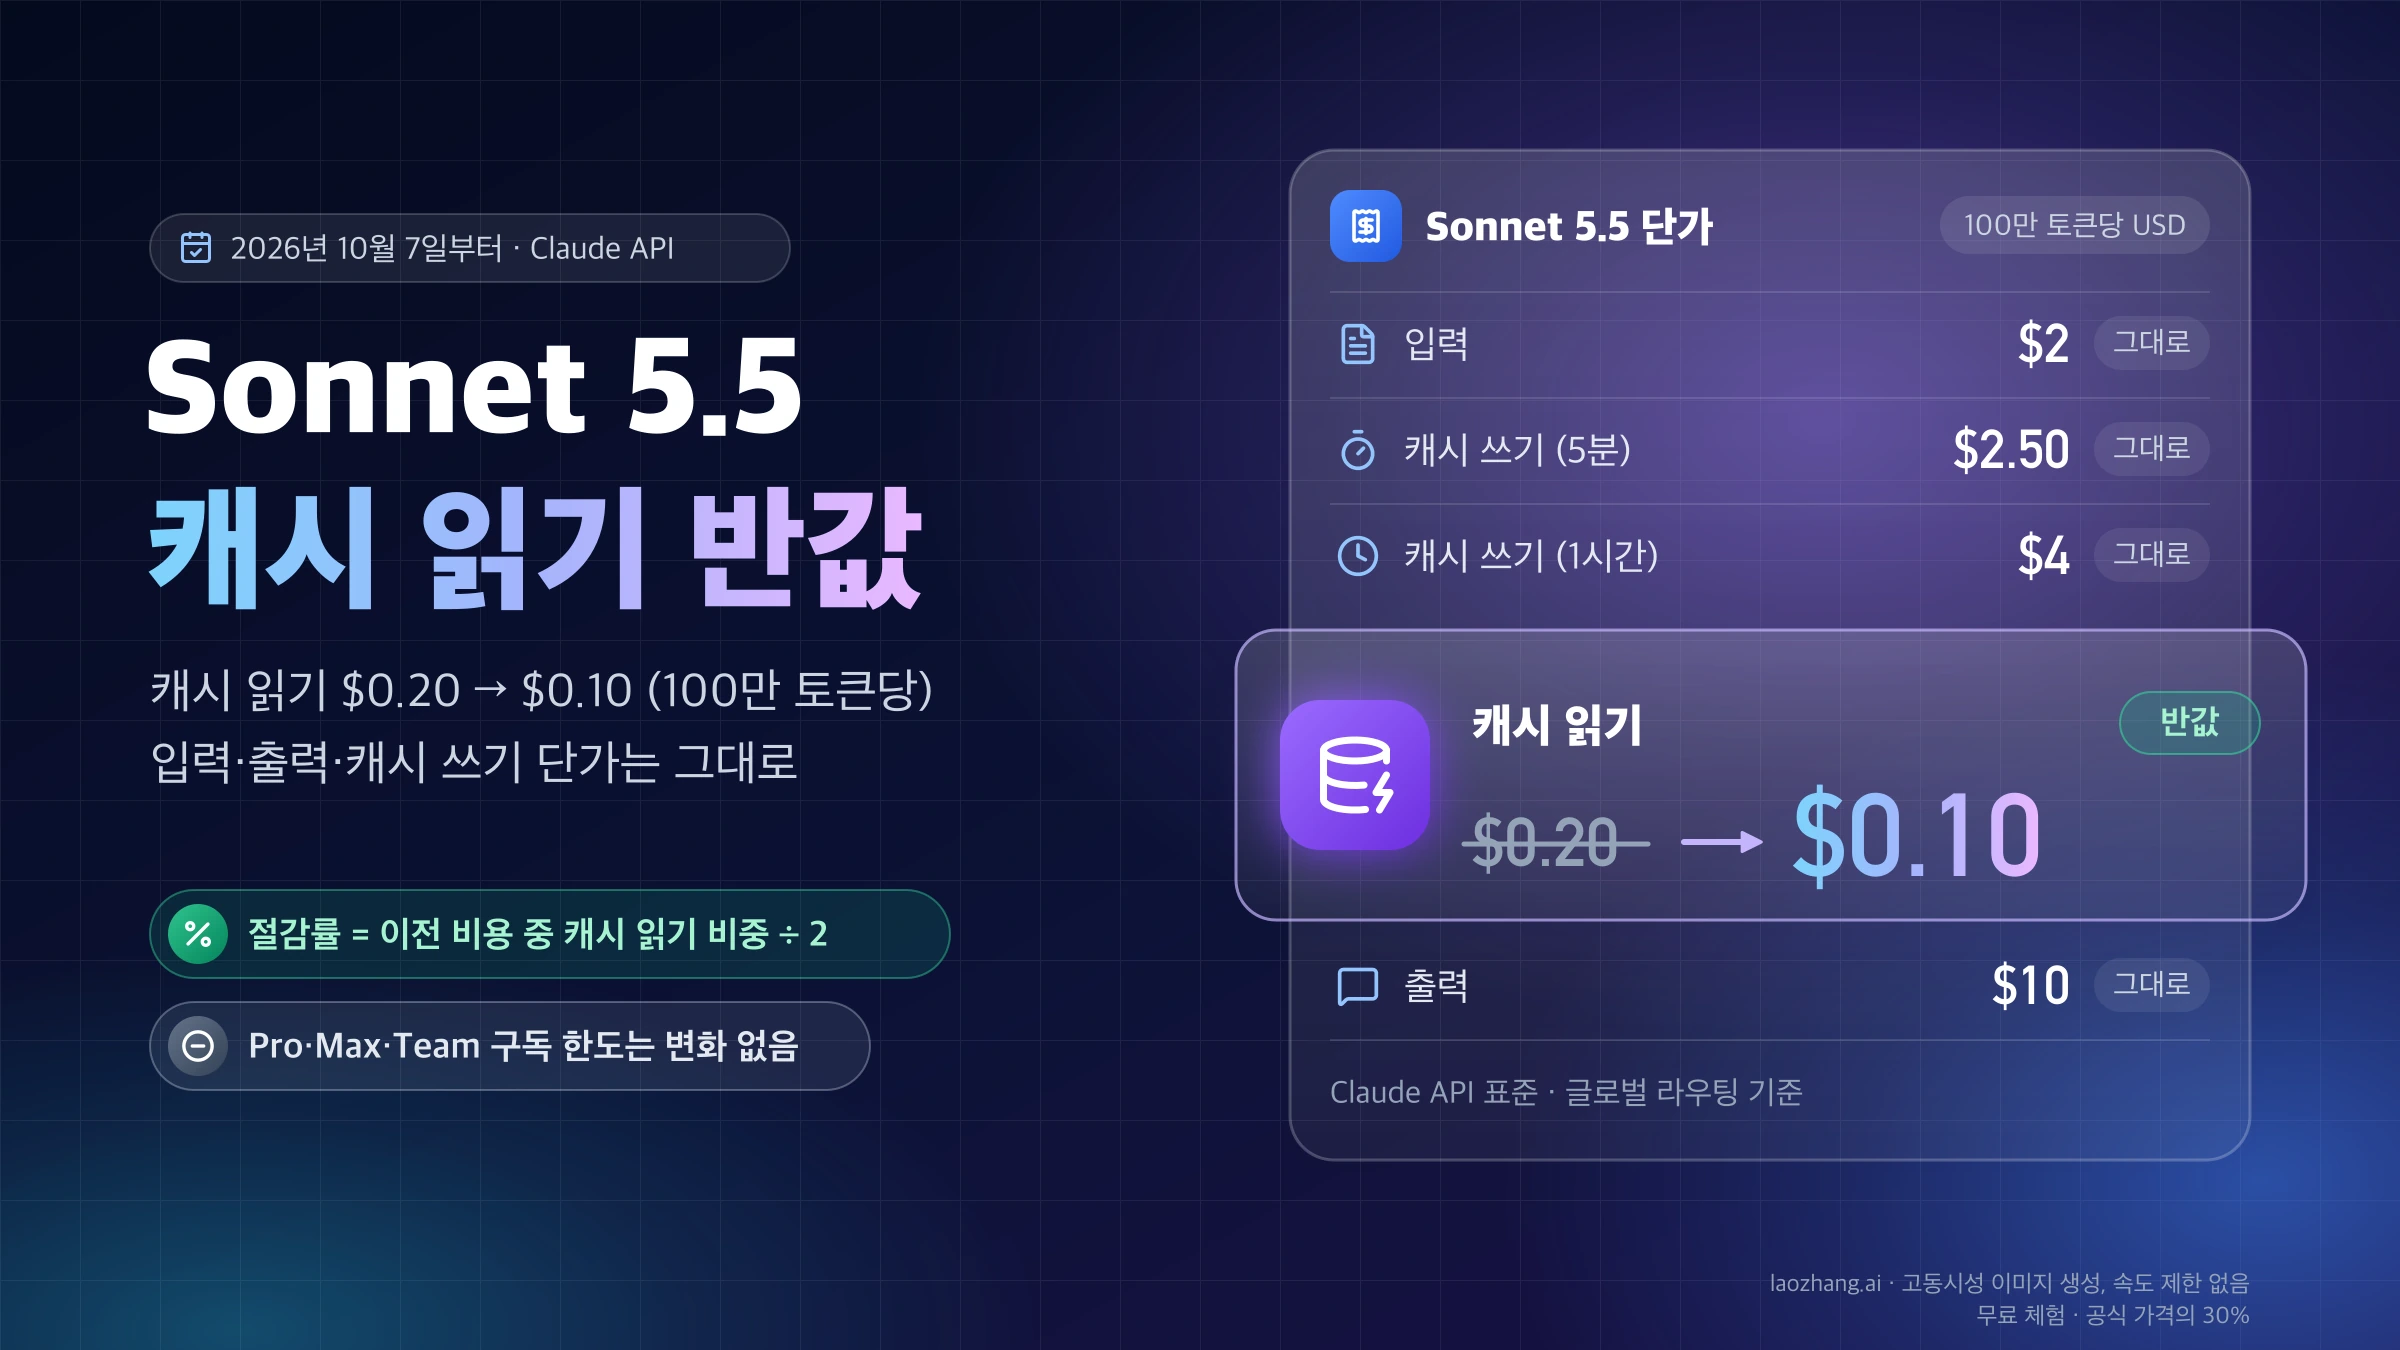
| Claude Sonnet 5.5 | $2 / $10 | $1 / $5 | $0.05 |
| Claude Opus 5.5 | $4 / $20 | $2 / $10 | $0.10 |
| Claude Haiku 5.5 (프롬프트 10만 토큰 이하) | $0.10 / $0.50 | $0.05 / $0.25 | $0.005 |
| Claude Haiku 5.5 (10만 토큰 초과) | $0.50 / $2.50 | $0.25 / $1.25 | $0.025 |
| Claude Fable 5.1 | $10 / $50 | $5 / $25 | $0.125 |
배치 캐시 읽기 열은 기본 입력 단가 × 캐시 읽기 배수(Sonnet·Opus 5.5는 0.05배, Haiku 5.5는 0.1배, Fable 5.1은 0.025배) × 0.5로 계산한 값입니다. 캐시 쓰기는 5분 TTL이 입력 단가의 1.25배, 1시간 TTL이 2배이고 여기에도 0.5가 곱해지므로, Sonnet 5.5라면 배치 안의 5분 캐시 쓰기는 $1.25, 1시간 캐시 쓰기는 $2.00입니다. 이전 세대의 배치 가격은 Opus 5·4.8·4.7·4.6·4.5가 $2.50 / $12.50, Sonnet 5가 $1 / $5, Sonnet 4.6·4.5가 $1.50 / $7.50, Haiku 4.5가 $0.50 / $2.50입니다. 미국 내 처리를 지정하는 inference_geo: "us"의 1.1배도 배치 할인과 겹쳐 적용됩니다. 모델별 표준 가격과 캐시 읽기 인하의 자세한 내용은 Claude Fable 5.1 API 가격: 내 청구액은 얼마나 줄까와 Claude Sonnet 5.5 캐시 가격: 캐시 읽기 $0.10로 반값, 청구액 계산법에서 다룹니다.
같은 작업 1만 건: 일반 호출·캐싱·배치 중 어느 쪽이 싼가
공유 프리픽스가 있는 작업에서는 배치와 캐싱을 함께 쓰고 적중률이 충분히 나오는 조합이 가장 싸고, 캐싱 없는 배치는 일반 호출+캐싱보다 비쌉니다. 아래 표는 2026년 10월 30일 Claude API 공식 표시 가격으로 같은 작업량을 다시 계산한 결과입니다. 작업량은 요청 10,000건, 요청마다 공유 프리픽스 3,000토큰 + 고유 입력 800토큰 + 출력 250토큰이고, 일반 호출+캐싱은 요청을 순서대로 보내 거의 모두 캐시에 적중하는 경우이고, 배치 안의 값에는 캐시 미스가 날 때마다 프리픽스를 다시 쓰는 비용까지 들어 있습니다.
| 모델 | 일반 | 일반 + 5분 캐싱 | 배치 | 배치 + 5분 캐싱 (적중 30%) | 배치 + 5분 캐싱 (적중 98%) | 배치 + 1시간 캐싱 (적중 30%) |
|---|---|---|---|---|---|---|
| Haiku 5.5 | $5.05 | $2.35 | $2.52 | $2.38 | $1.21 | $3.17 |
| Sonnet 5.5 | $101.00 | $44.00 | $50.50 | $47.20 | $22.72 | $62.95 |
| Opus 5.5 | $202.00 | $88.00 | $101.00 | $94.40 | $45.44 | $125.90 |
| Fable 5.1 | $505.00 | $212.50 | $252.50 | $234.88 | $109.92 | $313.62 |
네 모델 모두 일반 호출+캐싱이 캐싱 없는 배치보다 쌉니다. 1,000건당으로 보면 Sonnet 5.5는 $4.40 대 $5.05, Haiku 5.5는 $0.235 대 $0.253입니다. 프리픽스 3,000토큰이 요청 입력의 대부분을 차지하므로, 그 부분을 0.025~0.1배로 깎는 캐시 읽기가 0.5배인 배치 할인보다 훨씬 많이 줄이기 때문입니다. 반대로 출력은 캐싱으로 전혀 줄지 않고 배치에서만 반으로 줄어듭니다. 이 작업량에서 출력은 캐싱 없는 일반 청구액의 24.8%인데, 출력이 길거나 공유 프리픽스가 짧은 작업일수록 배치 단독의 효과가 커지고 캐싱의 효과는 작아집니다.

내 작업으로 다시 계산하려면 요청당 비용을 (프리픽스 토큰 × 입력 단가 × (적중률 × 읽기 배수 + (1 − 적중률) × 쓰기 배수) + 고유 입력 토큰 × 입력 단가 + 출력 토큰 × 출력 단가) × 할인으로 두면 됩니다. 할인은 일반 호출이 1, 배치가 0.5이고, 캐싱을 쓰지 않으면 괄호 안의 첫 항을 프리픽스 토큰 × 입력 단가로 바꿉니다. 이미 일반 호출로 캐싱을 쓰고 있다면 위 표에서 비교할 기준은 "일반" 열이 아니라 "일반 + 5분 캐싱" 열입니다.
배치 안에서 캐싱이 이득인 적중률: 5분 약 21%, 1시간 약 51%
배치 안에서 공유 프리픽스를 캐싱하면 적중률이 5분 TTL 기준 약 21%, 1시간 TTL 기준 약 51%를 넘을 때부터 캐싱하지 않는 것보다 쌉니다. 배치 요청은 동시에, 순서 없이 처리되기 때문에 Anthropic은 배치 안의 캐시 적중을 최선 노력(best effort)으로만 제공하며, 사용자들이 보통 30~98%의 적중률을 겪는다고 안내합니다. 적중하지 못한 요청은 프리픽스를 쓰기 배수(w)로 다시 쓰고, 적중한 요청은 읽기 배수(r)만 내므로 손익분기는 적중률 > (w − 1) / (w − r)입니다.
이 식에 2026년 10월 30일 기준 배수를 넣으면 5분 캐시는 Sonnet·Opus 5.5가 20.8%, Haiku 5.5가 21.7%, Fable 5.1이 20.4%이고, 1시간 캐시는 각각 51.3%, 52.6%, 50.6%입니다. Anthropic이 말하는 하한 30%도 5분 캐시의 손익분기를 넘으므로, 요청들이 같은 프리픽스를 공유한다면 배치 안에서도 5분 캐싱은 켜 두는 편이 거의 항상 낫습니다. 1시간 캐시는 사정이 다릅니다. Anthropic은 배치가 5분 넘게 걸릴 수 있으니 1시간 캐시를 고려하라고 권하지만, 쓰기 비용이 2배라서 적중률이 51% 근처를 넘지 못하면 손해입니다. 위 표에서 적중 30%일 때 Sonnet 5.5의 1시간 캐싱 배치가 캐싱 없는 배치보다 비싼 이유가 이것입니다. 다만 이 손익분기에는 1시간 TTL이 적중률 자체를 끌어올리는 효과가 들어 있지 않습니다.
이미 일반 호출+캐싱을 쓰고 있다면 넘어야 할 선은 더 높습니다. 같은 작업량에서 배치 + 5분 캐싱이 일반 호출+캐싱(적중 거의 100%)보다 싸지려면 배치 안 적중률이 Sonnet·Opus 5.5는 약 39%, Haiku 5.5는 약 32%, Fable 5.1은 약 42%를 넘어야 합니다. 위 요청당 비용 식에서 배치 쪽 값이 일반 호출+캐싱 값과 같아지는 적중률을 풀어 얻은 수치로, 프리픽스·고유 입력·출력의 비율이 바뀌면 함께 바뀝니다. 내 작업의 실제 적중률은 미리 알 수 없으므로 수백 건짜리 시험 배치를 먼저 돌리고, 결과마다 usage.cache_read_input_tokens가 0보다 큰 요청의 비율을 세어 보는 것이 가장 빠릅니다.
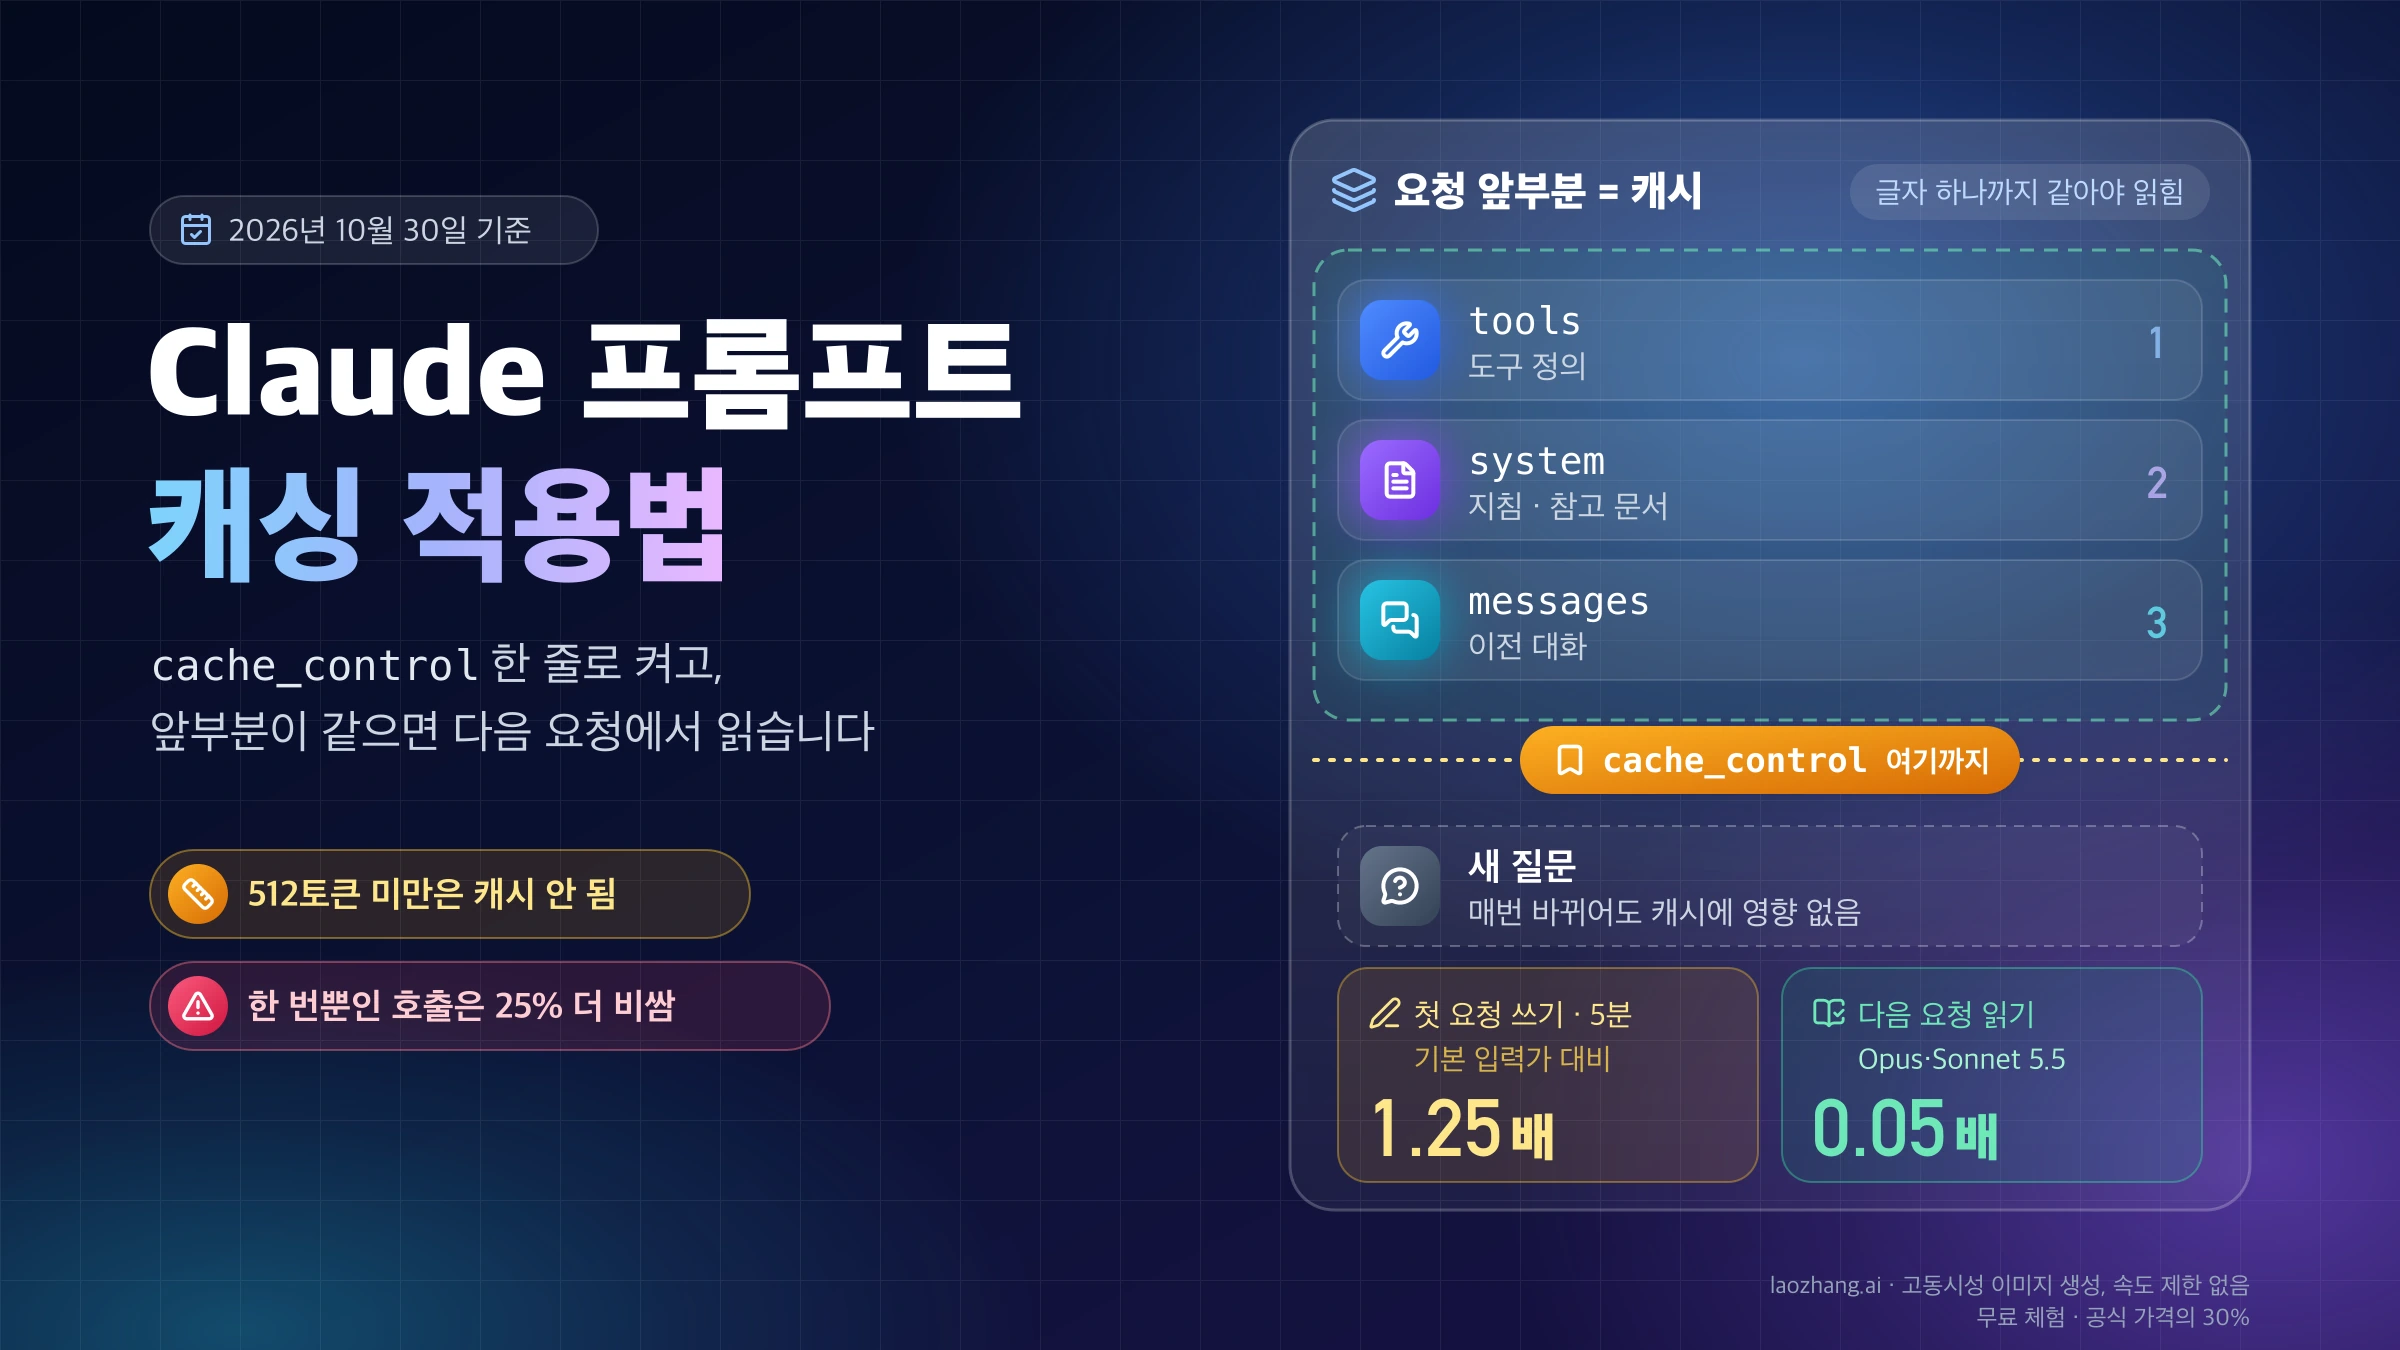
적중률을 높이려면 Anthropic 안내대로 모든 요청에 똑같은 cache_control 블록을 넣고, 공유할 수 있는 내용은 최대한 앞쪽 프리픽스로 모으세요. 일반 호출에서 쓰던 max_tokens: 0 캐시 예열은 배치 안에서는 허용되지 않습니다. 캐시가 동작하는 원리와 cache_control 위치는 Claude(클로드) 프롬프트 캐싱 적용법: 캐시 읽기 0.05배, 최소 512토큰에 정리되어 있습니다.
첫 배치 제출부터 custom_id로 결과 맞추기까지
첫 배치가 형식 문제로 통째로 실패하지 않게 하려면, 요청 한 건을 일반 Messages API로 먼저 보내 본 뒤 배치로 제출하고, processing_status가 ended가 될 때까지 폴링한 다음 결과를 custom_id로 맞추면 됩니다. 배치의 params는 비동기로 검증되기 때문에 잘못된 파라미터는 배치 전체가 끝난 뒤에야 errored로 드러납니다. 공식 문서에는 완료 웹훅이 안내되어 있지 않고 폴링 루프를 예시로 듭니다.
- 배치에 넣을 요청 형식 하나를 일반
POST /v1/messages로 보내 정상 응답이 오는지 확인합니다. 도구나 베타 기능을 쓰는 요청이라면 특히 이 단계를 건너뛰지 마세요. - 요청마다
custom_id와params를 만듭니다.custom_id는 영문·숫자·-·_로 된 1~64자이고 배치 안에서 겹치면 안 되며,params는 일반 Messages API 파라미터 그대로입니다.max_tokens는 1 이상이어야 합니다. client.messages.batches.create()로 제출하고retrieve()로 상태를 읽습니다.request_counts의 succeeded·errored 같은 값은 배치가 끝날 때까지 0으로 남으므로, 진행 중에는processing숫자만 의미가 있습니다.- 상태가
ended가 되면results()로 결과를 한 줄씩 읽으며custom_id로 원래 요청과 맞추고, 결과 유형에 따라 저장·재전송·수정 목록으로 나눕니다.
아래 코드는 위 순서를 그대로 구현한 Python 예시입니다. Python anthropic 2.3.0과 TypeScript @anthropic-ai/sdk 1.3.0(둘 다 2026년 10월 23일 배포)은 모두 messages.batches의 create / retrieve / list / cancel / delete / results 메서드를 제공합니다.
import time
import anthropic

client = anthropic.Anthropic()  # ANTHROPIC_API_KEY 환경 변수를 읽습니다

def make_request(custom_id: str, text: str) -> dict:
    return {
        "custom_id": custom_id,  # 1~64자: 영문, 숫자, - 와 _
        "params": {
            "model": "claude-haiku-5-5",
            "max_tokens": 300,
            "messages": [{"role": "user", "content": text}],
        },
    }

def run_batch(requests: list[dict], poll_seconds: int = 60) -> tuple[dict, list[str], list[str]]:
    batch = client.messages.batches.create(requests=requests)
    print("created", batch.id, batch.processing_status)
    while batch.processing_status != "ended":
        time.sleep(poll_seconds)
        batch = client.messages.batches.retrieve(batch.id)
        print("status", batch.processing_status, batch.request_counts)
    done, retry, fix = {}, [], []
    for item in client.messages.batches.results(batch.id):  # 입력 순서가 보장되지 않음
        r = item.result
        if r.type == "succeeded":
            done[item.custom_id] = r.message.content[0].text
        elif r.type == "expired":
            retry.append(item.custom_id)          # 모델까지 가지 못함, 과금 없음
        elif r.type == "errored" and r.error.error.type == "invalid_request_error":
            fix.append(item.custom_id)            # 같은 본문을 다시 보내면 또 실패
        elif r.type == "errored":
            retry.append(item.custom_id)          # 서버 쪽 오류, 그대로 다시 보내도 됨
    return done, retry, fix

docs = {"doc-001": "다음 문장을 요약하세요: ...", "doc-002": "다음 문장을 요약하세요: ..."}
done, retry, fix = run_batch([make_request(cid, t) for cid, t in docs.items()])
if retry:  # expired와 서버 쪽 errored만 두 번째 배치로
    done2, retry2, fix2 = run_batch([make_request(cid, docs[cid]) for cid in retry])
    done.update(done2)
print("succeeded:", sorted(done), "needs_fix:", sorted(fix))
이 코드는 2026년 10월 30일 anthropic Python SDK 2.3.0으로, 공식 문서의 엔드포인트와 응답 형식대로 만든 로컬 모의 서버를 상대로 처음부터 끝까지 실행했습니다. Anthropic 서버에서 실제 배치를 처리한 것이 아니므로 처리 시간, 실제 검증 오류 문구, 과금은 이 실행이 보여 주지 않고, 코드 경로와 결과 분류만 확인한 것입니다. 5건 중 2건이 succeeded, api_error로 errored된 1건과 expired 1건은 두 번째 배치로 다시 보내 모두 성공했고, invalid_request_error 1건은 수정 목록으로 따로 빠졌습니다. 모의 서버가 결과를 역순으로 돌려줘도 custom_id로 정확히 맞았고, 상태를 읽을 때마다 request_counts는 ended 전까지 processing=5 외에는 모두 0이었습니다.
succeeded·errored·canceled·expired: 다시 보낼 것과 고칠 것
배치 결과 네 가지 중 과금되는 것은 succeeded뿐이고, errored·canceled·expired는 비용이 나가지 않습니다. 그래서 실패한 요청을 다시 보내는 데 드는 비용은 성공할 때 한 번만 냅니다. 갈리는 지점은 errored 안의 오류 종류입니다. Anthropic의 예시 코드도 invalid_request_error는 본문을 고친 뒤 보내고, 그 밖의 오류는 바로 다시 보내도록 나눕니다.

| 결과 유형 | 의미 | 과금 | 할 일 |
|---|---|---|---|
succeeded | 정상 응답, message가 들어 있음 | 배치 가격으로 과금 | 결과 저장 |
errored + invalid_request_error | 요청 본문이 잘못됨 | 없음 | 본문을 고친 뒤 새 배치로 제출 |
errored + 그 밖의 오류 | 서버 내부 오류 등 | 없음 | 같은 본문을 그대로 다시 제출 |
canceled | 취소 시점까지 처리되지 않음 | 없음 | 필요하면 새 배치로 제출 |
expired | 24시간 안에 처리되지 못함 | 없음 | 그대로 다시 제출 |
요청 하나가 실패해도 같은 배치의 다른 요청에는 영향이 없고, 결과는 배치를 만들 때의 API 버전 형식으로 돌아옵니다. 결과 파일은 .jsonl이라 요청 수가 많으면 한 번에 내려받지 말고 SDK의 results()처럼 스트리밍으로 읽는 것이 안전합니다. 동기 호출에서 만나는 과부하 오류와 재시도 설정은 배치와 별개이며, Claude API 529 overloaded_error 해결: 뜻과 SDK 재시도 설정에서 다룹니다.
Batch API 한도: 배치당 10만 건·256MB, 24시간, 결과 29일
2026년 10월 30일 기준 Anthropic 문서의 배치 한도는 아래 네 가지입니다. 배치당 1만 건이라는 수치는 출시 초기 안내였고, 지금은 한 배치에 요청 10만 건까지 담을 수 있습니다. 한도를 넘으면 무엇이 일어나는지까지 알아야 작업을 어떻게 나눌지 정할 수 있습니다.
| 항목 | 한도 | 넘거나 지나면 |
|---|---|---|
| 배치 하나의 크기 | 100,000건 또는 256MB 중 먼저 닿는 쪽 | 413 request_too_large, 나눠서 제출 |
| 처리 기한 | 생성 후 24시간 (expires_at) | 남은 요청은 expired |
| 결과 보관 | created_at부터 29일 (ended_at 기준 아님) | 배치는 보이지만 결과 다운로드 불가 |
| 접근 범위 | 배치를 만든 Console Workspace | 다른 Workspace의 키로는 조회 불가 |
조직의 사용량 티어에 따라 Batch API 자체의 HTTP 요청 수와 처리 대기열에 쌓아 둘 수 있는 요청 수가 정해집니다. Claude API 속도 제한 문서의 Message Batches API 항목에 따르면 이 한도는 모든 모델이 함께 씁니다.
| 티어 | Batch API HTTP 요청 (분당) | 처리 대기열의 배치 요청 수 |
|---|---|---|
| Start | 1,000 | 200,000 |
| Build | 2,000 | 300,000 |
| Scale | 4,000 | 500,000 |
새 조직은 이보다 낮은 Evaluation 티어에서 시작할 수 있는데, 이 티어의 배치 수치는 공개되어 있지 않습니다. 배치 사용량은 일반 Messages API의 속도 제한을 차지하지 않으므로, 대량 작업을 배치로 옮기면 동기 호출 쪽 한도에 여유가 생깁니다. 동기 호출에서 이미 제한에 걸리고 있다면 Claude API Rate Limit Reached: 재시도 전에 제한 소유자를 확인하세요에서 원인부터 나눠 보세요. 또 배치는 동시 처리 때문에 Console에서 Workspace에 걸어 둔 지출 한도를 조금 넘을 수 있습니다.
배치가 몇 시간 걸리거나 expired로 끝날 때
배치 처리 시간에는 보장이 없습니다. Anthropic 문서는 대부분의 배치가 1시간 안에 끝난다고 하면서도, 처리 시간은 배치 크기, 현재 수요, 내 요청량에 따라 달라지고 수요가 몰리면 24시간 안에 끝나지 못해 expired가 되는 요청이 늘 수 있다고 적어 둡니다. 그래서 마감이 있는 작업은 "보통 1시간"이 아니라 "최악 24시간"을 기준으로 일정을 잡아야 합니다.
공개된 사용자 보고도 편차가 큽니다. Hacker News 사용자 erans는 2026년 4월 27일, 에이전트의 매 턴을 Batch API로 돌린 경험을 공유하며 요청 하나짜리 배치가 보통 90~120초 걸렸고 Haiku 배치가 Sonnet·Opus보다 느리게 느껴졌다고 썼습니다(본인도 엄밀한 측정은 아니라고 밝혔습니다). developersdigest는 2026년 10월 18일 업데이트한 글에서 자체 측정의 중앙값이 5~30분이라고 적었습니다. status.claude.com 기록에서 Message Batches 관련 장애는 2024년 11월 4일 "Elevated errors on Message Batches API"와 11월 6~7일 "Delayed processing on Message Batches API"뿐이고 2025년과 2026년에는 없지만, 문서가 말하는 수요에 따른 지연은 장애로 기록되지 않습니다.
배치가 오래 걸릴 때 할 수 있는 일은 많지 않습니다. 결과는 배치 전체가 끝나야 받을 수 있으므로 기다리는 동안에는 상태 폴링만 이어 가고, 끝난 뒤 expired로 돌아온 요청은 과금되지 않으니 위 코드의 재전송 목록으로 다시 보내면 됩니다. 아주 큰 데이터는 Anthropic 권장대로 여러 배치로 나누면 한 배치가 늦어져도 나머지 결과를 먼저 쓸 수 있습니다. 결과가 당장 필요한 일부 요청만 일반 호출로 돌리는 것도 방법입니다. 배치가 길어질수록 5분 캐시는 만료되기 쉬우므로, 1시간 캐시로 바꿀지는 앞에서 본 손익분기와 함께 판단하세요.
배치에 넣을 수 있는 기능과 검증 오류가 나는 파라미터
Messages API로 보낼 수 있는 요청은 거의 모두 배치에 넣을 수 있습니다. 2026년 10월 30일 기준 Anthropic 문서는 이미지 입력, 웹 검색·웹 가져오기·코드 실행·MCP 커넥터 같은 서버 도구를 포함한 도구 사용, 시스템 메시지, 멀티턴 대화, 확장 사고(extended thinking), 대부분의 베타 기능을 배치 대상으로 명시하고, 종류가 다른 요청을 한 배치에 섞는 것도 허용합니다.
검증 오류가 나는 것은 네 가지 파라미터뿐입니다. stream: true는 결과가 스트림이 아니라 파일 하나로 돌아오기 때문에, speed(fast mode)는 동기 응답 지연을 줄이는 기능이라 비동기 처리와 무관하기 때문에, fallbacks(서버 측 폴백)는 배치에 적용되지 않기 때문에 막혀 있습니다. 캐시 예열용 max_tokens: 0도 배치 안에서 쓴 캐시가 후속 요청 전에 만료될 가능성이 커서 허용되지 않으므로, 동기 코드의 요청을 그대로 옮길 때는 이 네 가지부터 빼세요.
배치에서 멀티턴 도구 호출이 안 된다는 설명은 정확하지 않습니다. 실제 제약은 배치 안의 요청 하나가 Messages API 호출 한 번이라서, 내 코드가 실행해야 하는 도구의 결과를 그 요청 안에서 기다릴 수 없다는 점입니다. 따라서 클라이언트 도구를 쓰는 에이전트는 결과에서 tool_use를 모아 도구를 실행하고, 도구 결과를 붙인 다음 턴을 새 배치나 일반 호출로 보내야 합니다. 반면 서버 도구는 배치 워커가 서버 쪽 루프를 그대로 돌리고, 연결을 유지할 필요가 없어 동기 호출보다 한 턴에 더 많이 반복한 뒤 stop_reason: "pause_turn"을 돌려줍니다. 이때는 멈춘 assistant 내용을 그대로 붙여 이어서 보내면 됩니다.
배치에서만 쓸 수 있는 기능도 있습니다. 베타 헤더 output-300k-2026-03-24를 붙이면 Opus 5.5, Opus 5, Opus 4.8·4.7·4.6, Sonnet 5.5, Sonnet 5, Sonnet 4.6, Haiku 5.5에서 max_tokens를 300,000까지 올릴 수 있고, 가격은 일반 배치 가격 그대로입니다. Claude API와 Claude Platform on AWS에서만 지원되며, 30만 토큰을 생성하는 요청은 한 시간 넘게 걸릴 수 있습니다.
Bedrock·Vertex·게이트웨이에서도 Batch API 할인이 되나
Anthropic의 Message Batches API와 50% 할인은 Claude API, Claude Platform on AWS, Anthropic이 관리하는 Google Cloud의 Claude(Claude Models on Google Cloud)에서 정식 제공됩니다. 반면 같은 AWS·Google Cloud 안에 있어도 Amazon Bedrock과 Google이 관리하는 Vertex AI는 각 회사의 배치 추론 기능이라서 입력 형식, 지원 모델, 가격 조건이 따로 정해집니다.
Amazon Bedrock 요금 페이지는 Anthropic 등 일부 모델의 배치 추론을 온디맨드보다 50% 낮은 가격에 제공한다고 안내하지만, 입력은 S3에 올린 JSONL 파일(줄마다 recordId와 modelInput)이고 Claude 모델은 작업당 최소 100건, 최대 100,000건·5GB입니다. 2026년 10월 30일 기준 Bedrock의 배치 지원 모델 목록에 있는 Claude는 Opus 5, Opus 4.6, Sonnet 4.6, Haiku 4.5 등이며 5.5 세대와 Fable 5.1은 없습니다. 도구 호출이 필요하면 Converse 형식이 아니라 InvokeModel 형식을 써야 합니다.
Google Vertex AI의 Claude 배치 예측 문서는 BigQuery 테이블이나 Cloud Storage의 JSONL(custom_id와 "anthropic_version": "vertex-2023-10-16"을 담은 request)을 입력으로 받고, 전역(global) 엔드포인트는 지원하지 않으며, 기본적으로 프로젝트당 동시 배치 작업 4개까지라고 설명합니다. 2026년 10월 28일 업데이트된 이 문서에는 Sonnet 5.5, Opus 5.5, Haiku 5.5, Fable 5.1이 올라 있지만 배치 할인율은 적혀 있지 않으므로, Vertex AI 요금 페이지에서 내 모델의 배치 가격을 확인한 뒤 계산해야 합니다.
게이트웨이나 중계 서비스는 /v1/messages/batches 엔드포인트를 실제로 구현했을 때만 배치 할인이 의미가 있습니다. 2026년 10월 30일 laozhang.ai의 사용량 과금 키로 GET /v1/messages/batches?limit=1, POST /v1/messages/batches, GET /v1/messages/batches/{id}를 호출하자 세 경로 모두 HTTP 404 Invalid URL(invalid_request_error)을 반환했고, 처리된 요청이 없어 과금도 없었습니다. 이처럼 동기 호출만 중계하는 경로에서는 같은 작업이 일반 호출 가격으로 계산됩니다.
안내: laozhang.ai는 이 블로그 운영팀의 자사 서비스입니다. 그 가격은 독립적인 비교가 아니라 자사 제시 가격입니다.
Claude Batch API 자주 묻는 질문
Claude Code의 /batch는 Batch API로 처리되나요?
아닙니다. 2026년 10월 30일 기준 Claude Code 명령어 문서에서 /batch는 코드베이스 전체에 걸친 큰 변경을 5~30개의 독립 단위로 나눠, 단위마다 별도 git worktree에서 백그라운드 서브에이전트를 돌리는 내장 스킬이며 Message Batches API와는 관계가 없습니다. Claude Code 작업을 Batch API로 보내 주는 것은 s2-streamstore가 만든 제3자 도구 claude-batch-toolkit(MCP 서버와 스킬) 같은 별도 도구이며, 이 도구는 내장 /batch가 생긴 뒤 자기 스킬 이름을 /batchy로 바꿨습니다. 두 제품의 과금 차이는 Claude API와 Claude Code 차이: 내 작업엔 무엇을 쓸까를 참고하세요.
이미 제출한 Claude 배치를 수정하거나 취소할 수 있나요?
제출한 배치는 수정할 수 없고, 바꾸려면 취소한 뒤 새 배치를 제출해야 합니다. POST /v1/messages/batches/{id}/cancel을 보내면 상태가 canceling을 거쳐 ended가 되고, 그 전에 끝난 요청의 결과는 남으며 처리되지 않은 요청은 과금 없이 canceled로 돌아옵니다. Anthropic 문서는 취소가 즉시 반영되지 않을 수 있다고 안내합니다. 처리가 끝난 배치는 DELETE /v1/messages/batches/{id}로 29일 보관 기간 전에 지울 수 있습니다.
Claude Batch API를 쓰려면 별도의 API 키가 필요한가요?
필요 없습니다. Message Batches API는 일반 Messages API와 같은 Claude Console API 키로 호출하며, 배치와 결과는 그 키가 속한 Workspace 안에서만 보입니다. 키 발급과 무료 크레딧 여부는 Claude API 키 구매 가이드: 공식 결제·키 발급·무료 크레딧·가격 확인법에서 확인하세요.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 30일.
참고 자료6
이 글이 링크한 외부 페이지를 본문에 나온 순서대로 정리했습니다. 마지막 업데이트: 2026년 10월 30일.
- 1.Anthropic의 배치 처리 문서platform.claude.com/docs/en/build-with-claude/batch-processing
- 2.Claude API 요금 페이지platform.claude.com/docs/en/about-claude/pricing
- 3.Claude API 속도 제한 문서platform.claude.com/docs/en/api/rate-limits
- 4.Amazon Bedrock 요금 페이지aws.amazon.com/bedrock/pricing
- 5.Claude 배치 예측 문서docs.cloud.google.com/vertex-ai/generative-ai/docs/partner-models/claude/batch
- 6.Claude Code 명령어 문서code.claude.com/docs/en/commands.md