Qwen3-30B-A3B: qué versión elegir y cómo ejecutarla en local
Empieza con Instruct-2507 para tareas de texto, con Coder para programación o con Thinking-2507 para problemas complejos. El original sigue siendo útil si necesitas alternar el razonamiento; A3B no significa que baste la memoria de un modelo de 3B.
En esta página
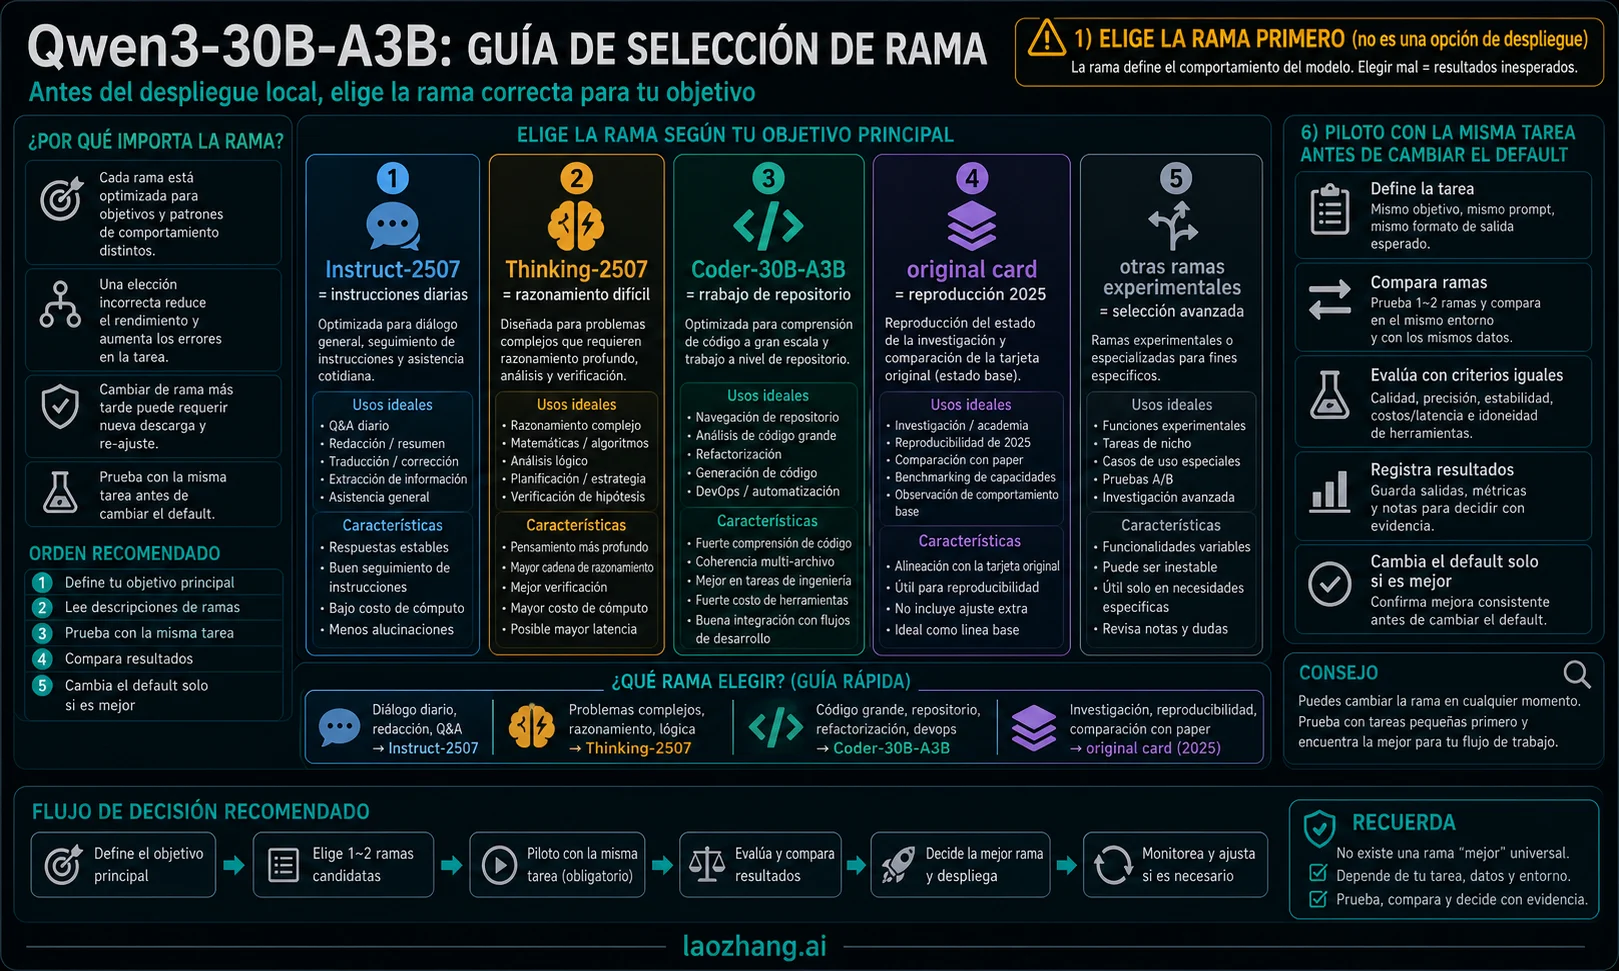
Para resúmenes, extracción de datos y conversación local, empieza con Qwen3-30B-A3B-Instruct-2507. Si tu trabajo principal es programar, prueba Qwen3-Coder-30B-A3B-Instruct. Para problemas complejos en los que quieres reservar espacio a una fase de razonamiento, evalúa Thinking-2507. Y si necesitas activar y desactivar esa fase dentro del mismo modelo, el Qwen3-30B-A3B original conserva una ventaja práctica: permite alternar ambos modos.
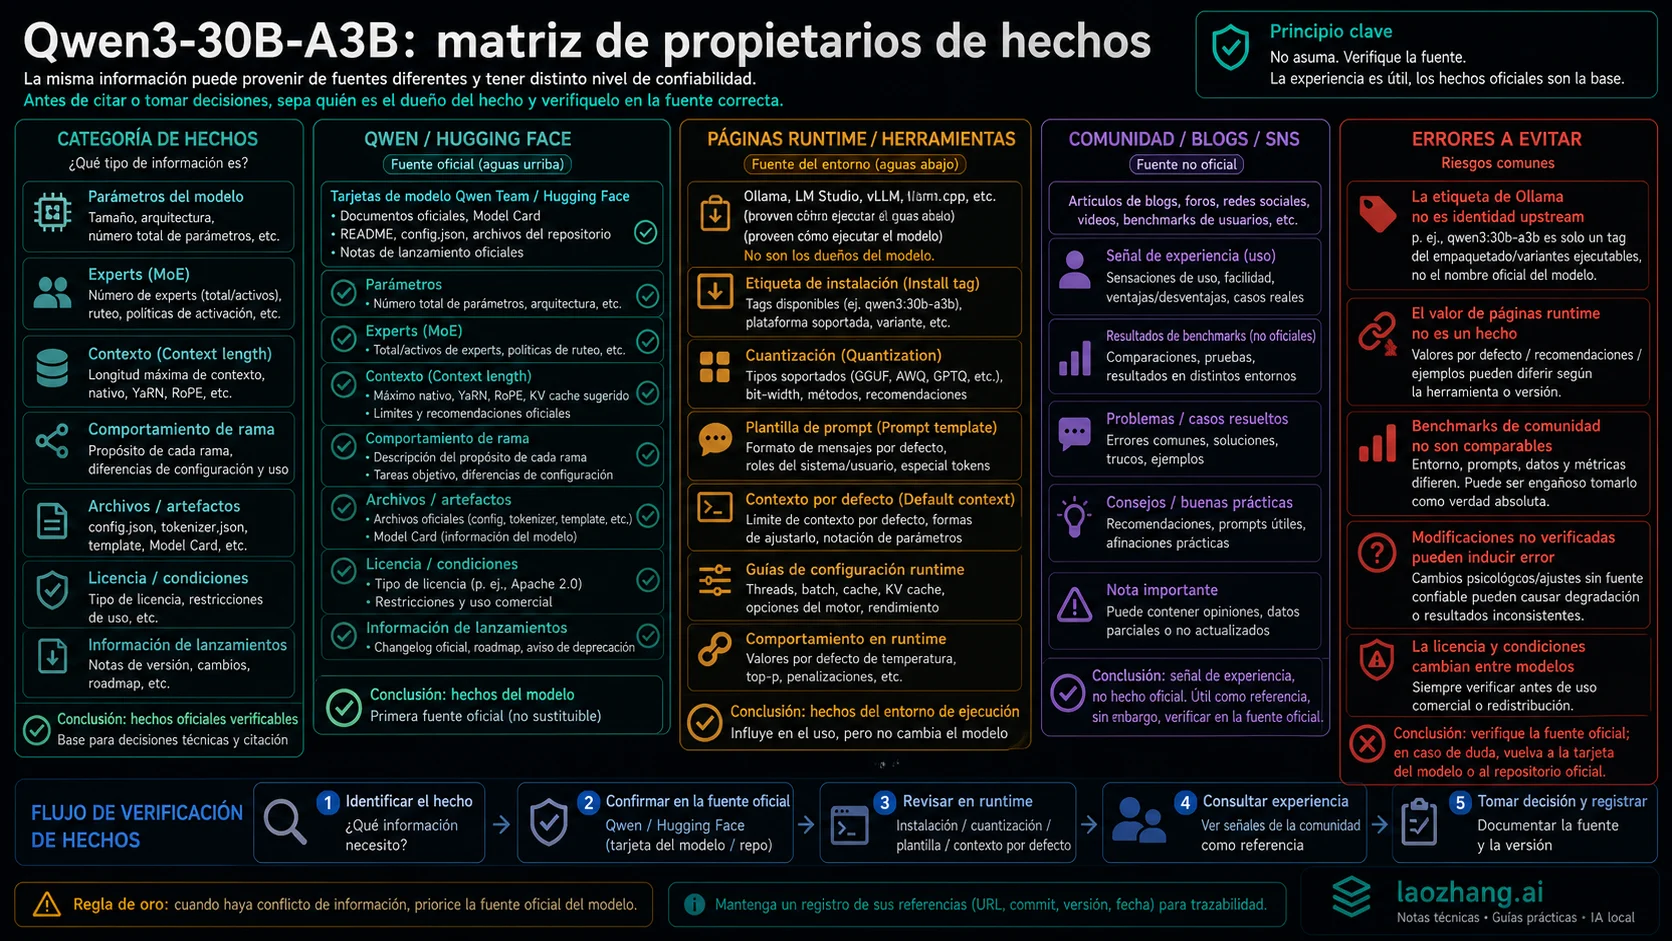
La elección tiene dos partes: identificar los pesos que quieres usar y comprobar cómo los carga tu programa. Una etiqueta corta de Ollama, el tamaño del archivo o la cifra «A3B» no bastan para resolver ambas. Las fichas de Instruct-2507, Thinking-2507 y Coder describen versiones distintas, aunque compartan 30.500 millones de parámetros totales y unos 3.300 millones activados por token.
Qué versión te conviene
| Lo que necesitas | Versión inicial | Diferencia que importa |
|---|---|---|
| Resumir, clasificar, extraer campos o conversar sin una fase de razonamiento visible | Qwen/Qwen3-30B-A3B-Instruct-2507 | Solo admite el modo sin razonamiento; no genera bloques <think>. |
| Resolver un problema con muchas restricciones o revisar una deducción difícil | Qwen/Qwen3-30B-A3B-Thinking-2507 | Solo admite el modo de razonamiento; hay que reservar presupuesto de salida para él. |
| Trabajar con código, archivos de un repositorio y llamadas a herramientas | Qwen/Qwen3-Coder-30B-A3B-Instruct | Está orientado a programación y herramientas, con su propio formato de llamadas. |
| Alternar respuestas directas y razonamiento en un mismo modelo | Qwen/Qwen3-30B-A3B | El original combina los dos modos. También sirve para reproducir configuraciones anteriores. |
Esta es una elección por comportamiento y tarea, no una clasificación de calidad universal. Instruct también puede resolver problemas lógicos; Thinking no garantiza una respuesta correcta por generar más texto. Coder es un punto de partida razonable para programación, pero la aplicación que lo acompaña debe interpretar y ejecutar las llamadas a herramientas. El modelo por sí solo no abre archivos ni ejecuta pruebas. Las diferencias están documentadas en las fichas enlazadas arriba y en la ficha del original.
El sufijo 2507 identifica la actualización de julio de 2025. No convierte una versión en la otra: escribir /no_think no transforma Thinking-2507 en Instruct-2507. Para cambiar entre esas dos versiones necesitas cargar otros pesos.
Qué significa A3B y cuánta memoria necesitas
Qwen3-30B-A3B es un modelo de mezcla de expertos, o MoE. Según la ficha original, tiene 128 expertos y activa 8 para procesar cada token. Esa selección reduce la cantidad de parámetros utilizados en el cálculo de cada token, pero no convierte los pesos completos en un modelo de 3B.
Una cuenta ayuda a entender la diferencia: 30.500 millones de parámetros a 4 bits ocuparían idealmente 30.500.000.000 × 4 / 8 = 15.250.000.000 bytes, unos 15,25 GB decimales o 14,20 GiB. Es solo la carga teórica de los valores: faltan escalas de cuantización, partes con otra precisión y costes del formato. El archivo Q4_K_M de la etiqueta explícita Instruct-2507 de Ollama se anuncia con aproximadamente 19 GB. Su tamaño tampoco equivale al pico de RAM o VRAM durante la ejecución.
Además de los pesos, necesitas memoria para la caché de atención —la caché KV—, los cálculos temporales y el programa de inferencia. El contexto y las peticiones simultáneas pueden cambiar mucho la cuenta. Como ejemplo condicionado, con las dimensiones de Coder-30B-A3B, una caché KV en F16 para una sola secuencia almacena:
2 × 48 capas × 4 cabezas KV × 128 valores × 2 bytes = 98.304 bytes por token.
| Tokens almacenados en una secuencia | Carga teórica de esa caché KV en F16 |
|---|---|
| 8.192 | 0,75 GiB |
| 32.768 | 3 GiB |
| 65.536 | 6 GiB |
| 262.144 | 24 GiB |
Son cálculos de la carga KV, no mediciones del consumo total. No incluyen activaciones, reservas o relleno del programa, y otra precisión de caché cambia el resultado. Cuantizar los pesos a 4 bits no implica que la caché también use 4 bits.
Por eso una GPU de 16 GB no garantiza que puedas alojar íntegramente este archivo de unos 19 GB y su contexto en VRAM. Repartir pesos entre CPU y GPU puede permitir otras configuraciones, pero hay que comprobar su velocidad y memoria en tu equipo. En memoria unificada, los pesos también comparten espacio con el sistema y las demás aplicaciones. Empieza con una petición corta y un contexto acotado antes de intentar cargar documentos largos.
Cómo empezar con una versión identificada en Ollama
Con Ollama ya instalado y su servicio local disponible, puedes empezar por una etiqueta que indique la versión y la cuantización. La comprobación del catálogo realizada el 7 de octubre de 2026 encontró Instruct-2507 Q4_K_M y Coder de 30B, ambos anunciados con unos 19 GB. Los siguientes comandos son un recorrido basado en la documentación; no son resultados de una ejecución nuestra.
Descarga y revisa Instruct-2507
En tu terminal:
ollama pull qwen3:30b-a3b-instruct-2507-q4_K_M
ollama show qwen3:30b-a3b-instruct-2507-q4_K_M
ollama show --modelfile qwen3:30b-a3b-instruct-2507-q4_K_M
show permite revisar los datos del modelo; --modelfile muestra la plantilla y los parámetros. Para consultar también los metadatos que expone la API local:
curl http://localhost:11434/api/show -d '{
  "model": "qwen3:30b-a3b-instruct-2507-q4_K_M"
}'
Comprueba la cuantización en details, la arquitectura y el contexto declarado en model_info, y la plantilla en template. Los campos de pensamiento, cuando estén presentes, describen los controles disponibles para ese archivo. La ausencia de ese dato no demuestra por sí sola que un modelo no razone internamente. Las etiquetas son modificables: para reproducir un resultado, guarda también el identificador o digest del archivo y la versión de Ollama. Consulta la documentación de pensamiento y la referencia de Modelfile.
Evita sustituir el nombre por qwen3 sin comprobarlo: la etiqueta predeterminada del catálogo correspondía a 8B, no a 30B, en la consulta citada. Tampoco atribuyas automáticamente al original de abril las etiquetas cortas qwen3:30b-a3b o qwen3:30b. En ese catálogo ambas mostraban el mismo digest y un contexto declarado de 262.144 tokens; esa información describe el archivo publicado, no demuestra por sí sola su correspondencia con la ficha original.
Envía una tarea breve con el contexto fijado
Este ejemplo propio pide extraer pedidos pendientes anteriores a una fecha. Fija 8.192 tokens de contexto y un máximo de 512 tokens de salida para una prueba corta; no intenta aprovechar los 262K anunciados.
curl http://localhost:11434/api/chat -d '{
  "model": "qwen3:30b-a3b-instruct-2507-q4_K_M",
  "stream": false,
  "messages": [
    {
      "role": "user",
      "content": "Devuelve solo un objeto JSON con los campos pedidos y total. En pedidos incluye los identificadores de pedidos pendientes cuya fecha prometida sea anterior al 10 de octubre de 2026. Datos: P-81, pendiente, 8 de octubre de 2026; P-82, entregado, 7 de octubre de 2026; P-83, pendiente, 12 de octubre de 2026. No añadas pedidos ni explicaciones."
    }
  ],
  "options": {
    "num_ctx": 8192,
    "num_predict": 512,
    "temperature": 0.7,
    "top_p": 0.8,
    "top_k": 20
  }
}'
La respuesta de la API es un objeto que envuelve la respuesta del asistente. Busca el texto generado en message.content. Para aceptar este caso, ese texto debe contener JSON válido, seleccionar únicamente P-81 y contar 1 pedido. P-82 ya está entregado y P-83 queda fuera del plazo. Es un criterio de comprobación derivado de los datos del ejemplo, no una salida observada del modelo. Si no lo cumple, conserva la respuesta para revisar formato, filtro y fecha por separado.
Con el modelo todavía cargado, ejecuta:
ollama psRevisa CONTEXT, que indica el contexto asignado, y PROCESSOR, que muestra el reparto entre CPU y GPU. Así puedes distinguir una petición con 8K de un archivo que admite un contexto máximo mayor. Si no aparece ninguna fila, el modelo ya no está residente y esa salida no permite comprobar su asignación. El parámetro num_ctx y la comprobación con ps están documentados en la FAQ y en la guía de contexto.
Si tu tarea es programar
La alternativa del catálogo es:
ollama pull qwen3-coder:30b
ollama run qwen3-coder:30b
Para comparar una tarea mediante la API, cambia el campo model por qwen3-coder:30b y utiliza una petición de programación con criterios concretos: comportamiento esperado, casos límite y archivos permitidos. Una respuesta con código debe pasar las pruebas de tu aplicación; el tamaño del modelo o una explicación convincente no sustituye esa comprobación. Si conectas herramientas, verifica además que tu aplicación admite el formato de llamadas de Coder. La ficha de Coder documenta esa especialización.
Cómo activar o desactivar el razonamiento
En el original de Hugging Face, enable_thinking es un parámetro de la plantilla de conversación. Con True, la plantilla admite las instrucciones /think y /no_think; con False, el modo de razonamiento queda desactivado y esas instrucciones no lo vuelven a activar. Esta posibilidad hace útil al original cuando necesitas cambiar de modo sin cargar otra versión. Consulta la ficha exacta del original.
En las versiones 2507, el modo está fijado por los pesos: Instruct solo funciona sin bloques de razonamiento y Thinking solo en modo de razonamiento. En Thinking-2507, la plantilla ya incluye la apertura <think>, de modo que el texto generado puede contener únicamente el cierre </think>. La ficha de Thinking-2507 explica esta diferencia; un cierre sin apertura en los tokens generados no demuestra un fallo.
En Ollama, el control de la API se llama think, y su disponibilidad depende del modelo y de la versión instalada. Consulta los valores y el valor predeterminado que exponga /api/show antes de añadir, por ejemplo, "think": false a una petición de un modelo que permita desactivarlo. Ollama separa el razonamiento en message.thinking y la respuesta final en message.content. --hidethinking oculta su visualización; no desactiva su generación. No intercambies ese control con enable_thinking de Hugging Face. Véase la guía de pensamiento de Ollama.
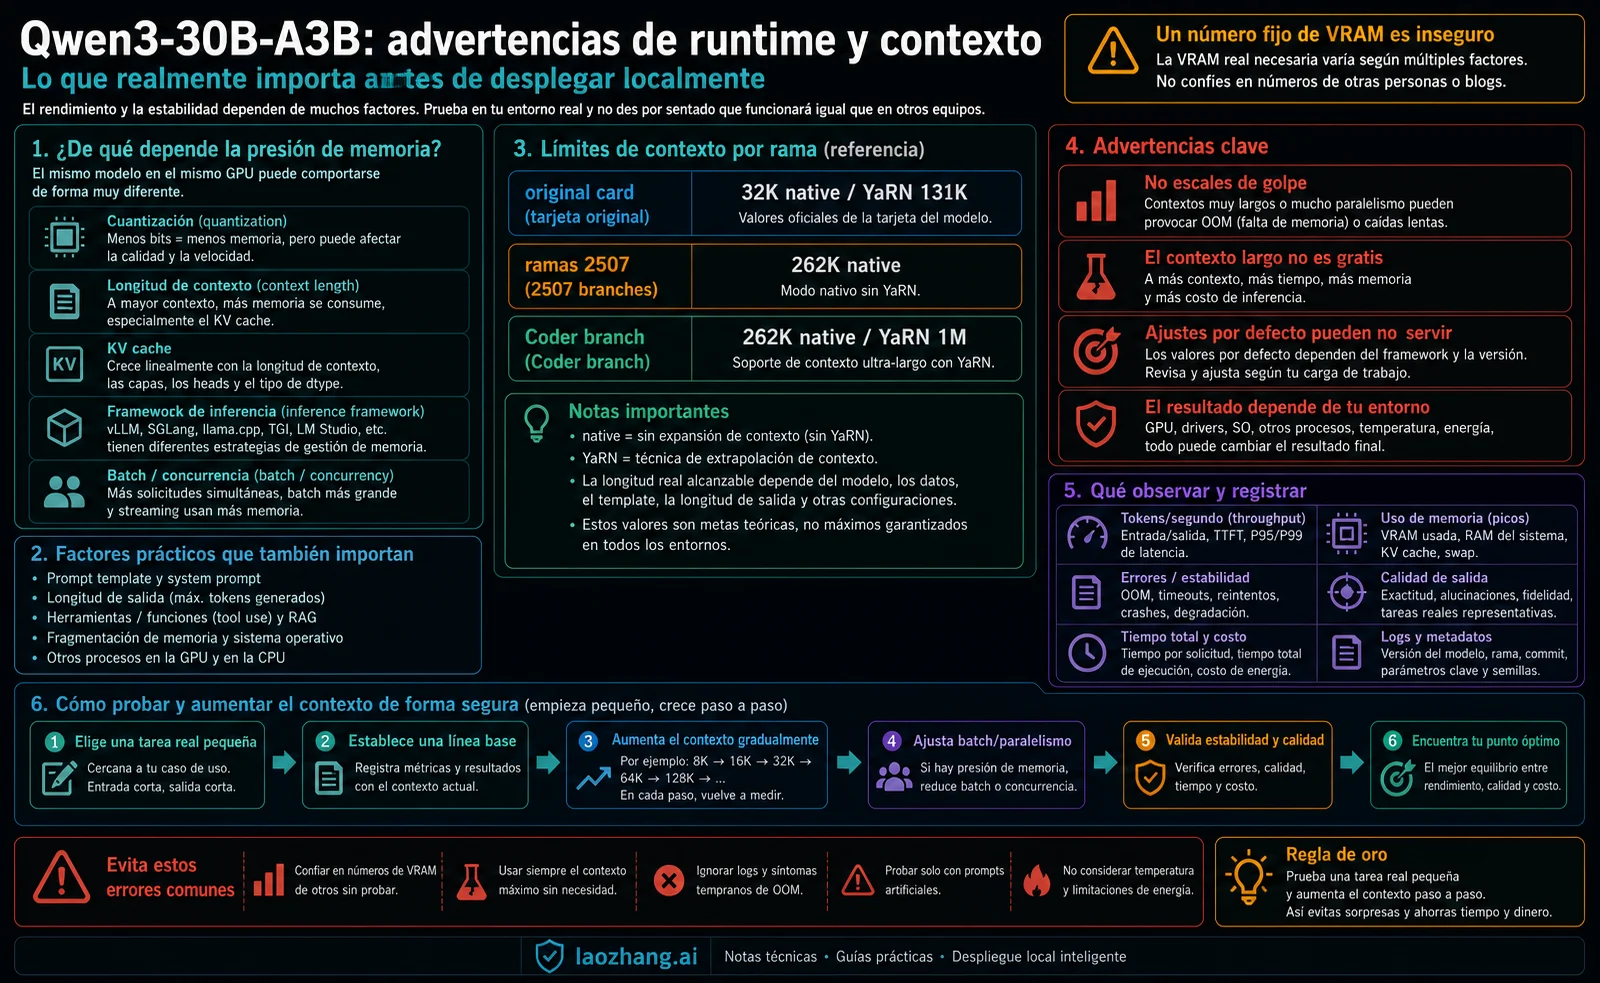
32K, 256K y 1M: qué contexto puedes utilizar
| Versión de pesos | Contexto nativo declarado | Extensión documentada |
|---|---|---|
| Qwen3-30B-A3B original | 32.768 tokens | 131.072 mediante YaRN |
| Instruct-2507 y Thinking-2507 | 262.144 tokens | Receta especializada de 1M con DCA y MInference |
| Coder-30B-A3B-Instruct | 262.144 tokens | Hasta 1M mediante YaRN |
Las fuentes son las fichas del original, Instruct-2507, Thinking-2507 y Coder. La capacidad nativa, el contexto que asigna Ollama y el espacio útil para tu entrada son cifras diferentes. El historial, las instrucciones, los resultados de herramientas y la salida comparten el presupuesto; el razonamiento generado también necesita espacio.
Por ejemplo, con un contexto total de 8.192 tokens y una reserva de 512 para la salida, quedan como máximo 7.680 para todo lo anterior a esa salida. No significa que puedas pegar un documento de 7.680 tokens además de un historial completo: ambos consumen la misma reserva de entrada.
Hay una discrepancia en la documentación de Ollama consultada: la guía de contexto describe valores predeterminados de 4K con menos de 24 GiB de VRAM, 32K entre 24 y 48 GiB, y 256K a partir de 48 GiB; la FAQ todavía indica 4.096 como valor general. No des por hecho uno de ellos para cualquier instalación. Fija el contexto de tu petición y comprueba la asignación real con ollama ps.
El millón de tokens tampoco es una opción gratuita que se active cambiando num_ctx. La receta de Instruct/Thinking descrita en sus fichas usa DCA, MInference y una configuración específica, y estima aproximadamente 240 GB de memoria GPU total para ese escenario de 1M. Ese requisito no corresponde a una conversación corta ni garantiza que cualquier versión de Ollama implemente la receta. La extensión con YaRN que anuncia Coder es otra configuración y no debe confundirse con ella.
¿Y Qwen3.6 o Qwen3.8?
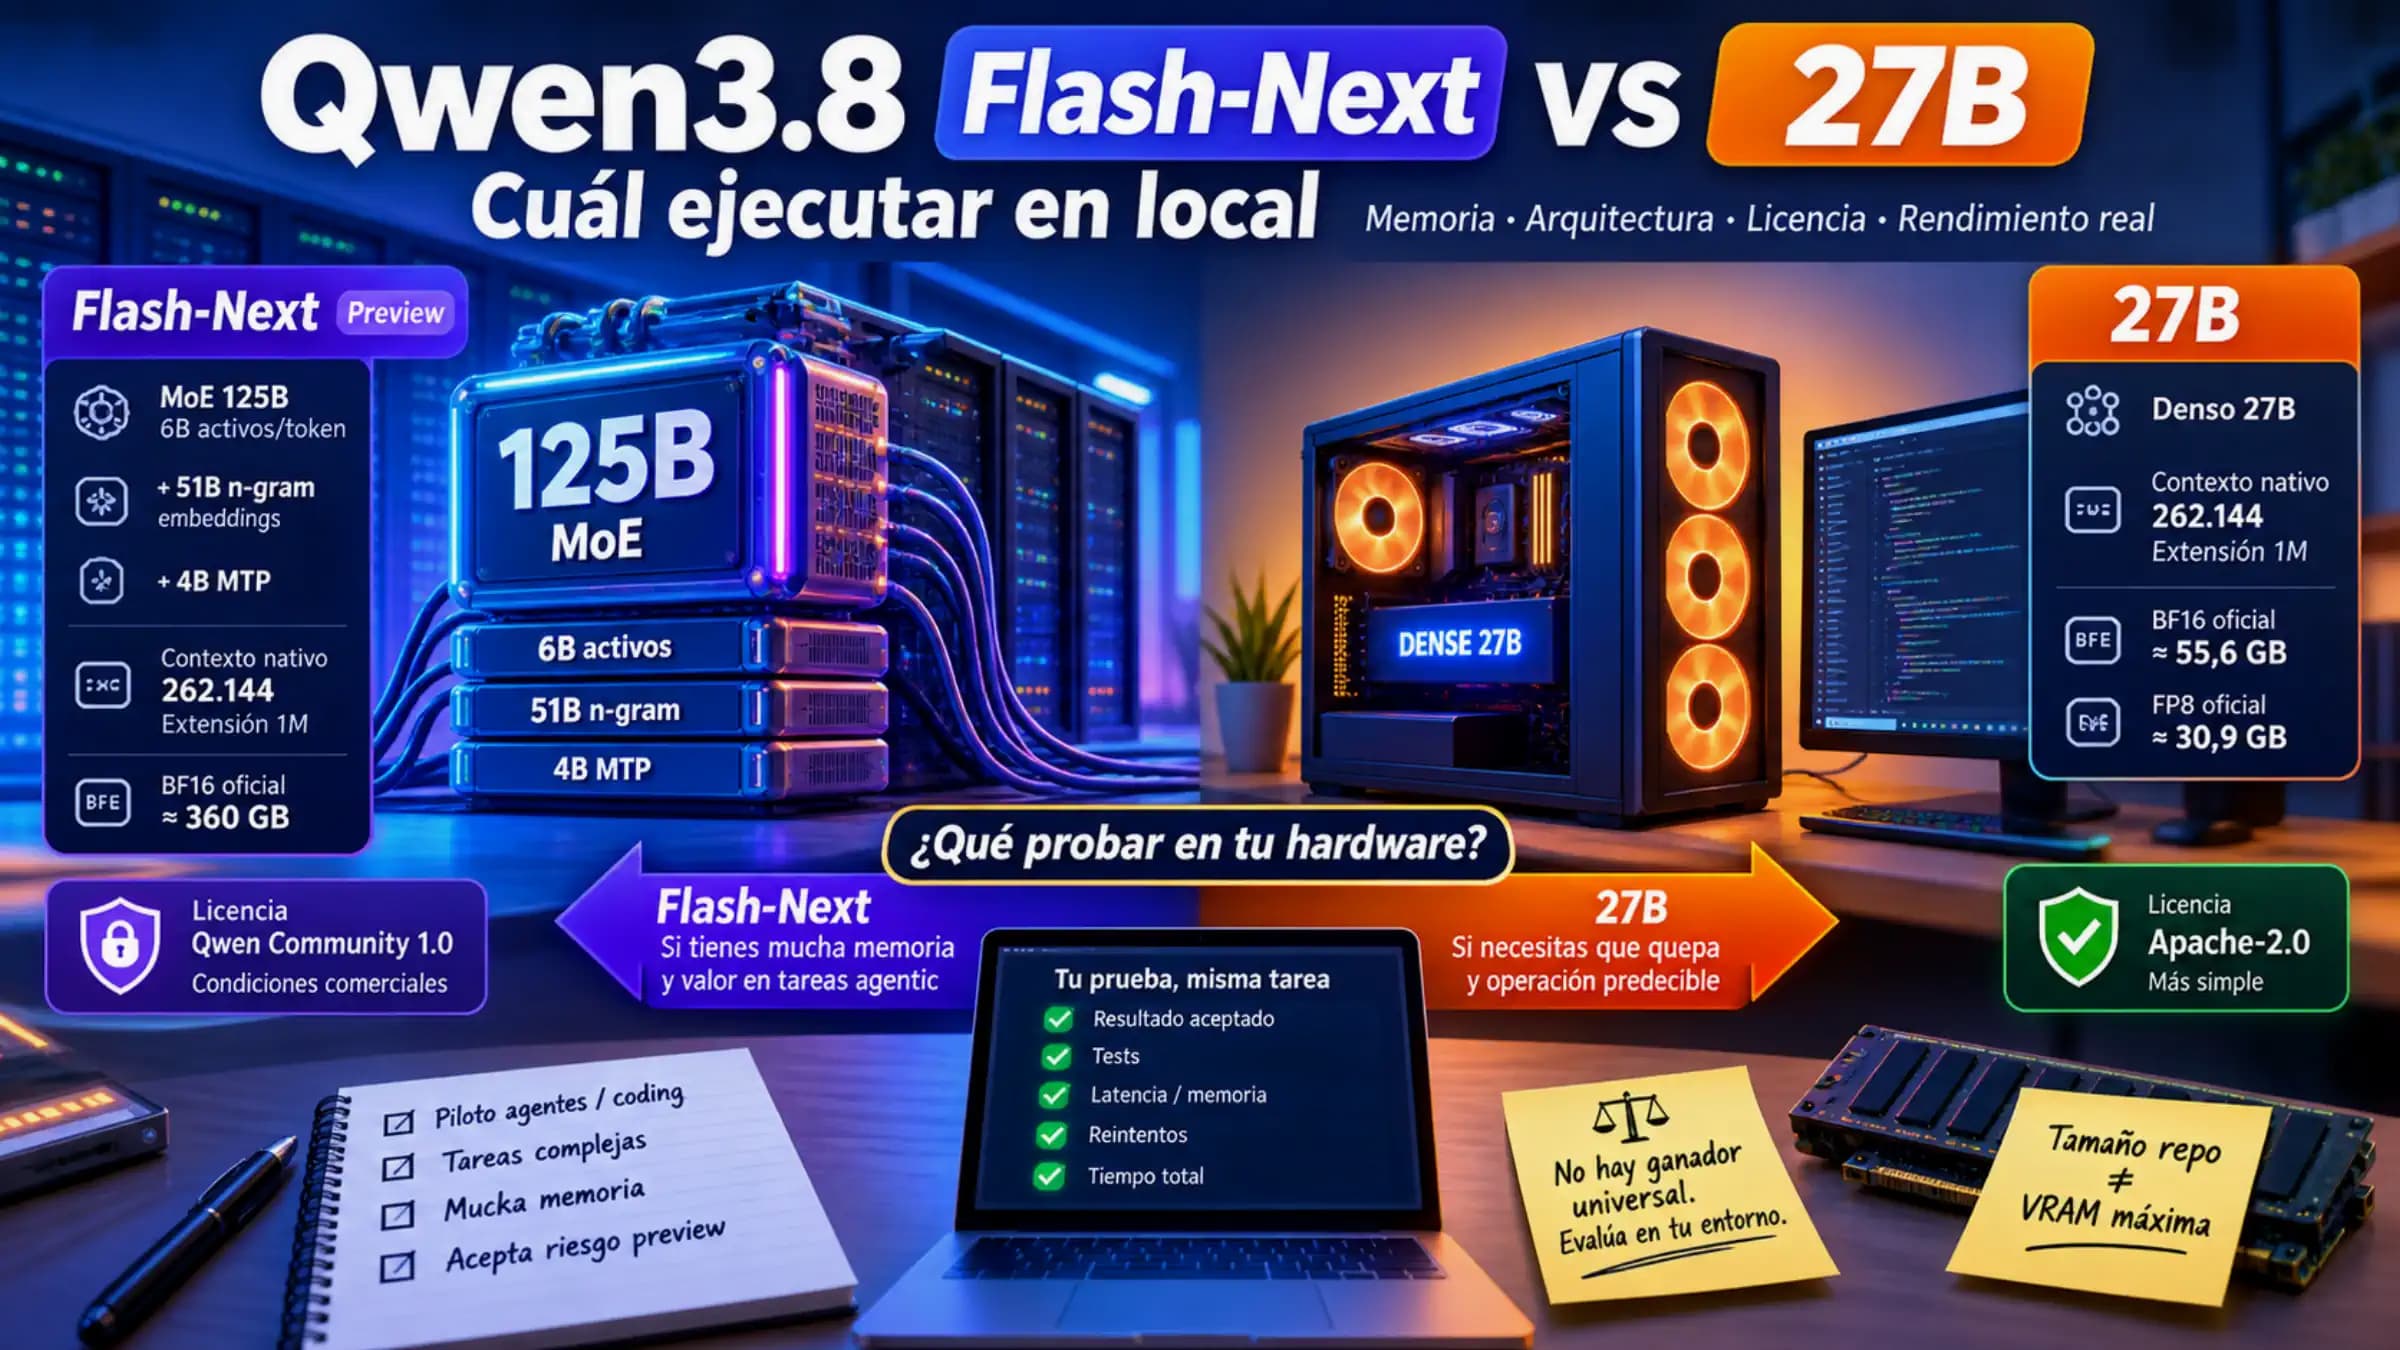
Son decisiones sobre otros modelos. Qwen3.6-35B-A3B tiene 35B parámetros totales y admite visión; Qwen3.8-27B es un modelo denso de visión y lenguaje con 27B parámetros. Ninguno es un nombre alternativo de Qwen3-30B-A3B o de sus versiones 2507.
Si necesitas trabajar con imágenes o dimensionar específicamente el 27B, continúa en la guía de VRAM y contexto de Qwen3.8-27B. Para elegir entre las cuatro versiones de 30B de esta página, conserva tu tarea como referencia: ¿necesitas cambiar de modo, generar texto directo, resolver un problema complejo o programar? Una versión más reciente de otra familia no responde automáticamente a esa pregunta.
Preguntas frecuentes
¿Qwen3-30B-A3B sigue siendo útil en local?
Sí. El original permite alternar modos; Instruct-2507 ofrece una versión sin bloques de razonamiento; Thinking-2507 fija el modo de razonamiento, y Coder se orienta a programación. Elige según ese comportamiento y comprueba los resultados en tu tarea. Las fichas de Qwen describen las capacidades; no garantizan velocidad ni ajuste en tu equipo.
¿Puedo desactivar el razonamiento de Thinking-2507 con /no_think?
No convierte esa versión en un modelo sin razonamiento. Thinking-2507 solo admite su modo de razonamiento. Para tener el modo fijo contrario, carga Instruct-2507; para alternarlos dentro de un mismo modelo, utiliza el original con una plantilla compatible.
¿Puedo ejecutar Qwen3-30B-A3B con 16 GB de VRAM?
Puede haber configuraciones con reparto entre CPU y GPU, pero 16 GB no garantizan alojarlo íntegramente en VRAM. La versión Instruct Q4_K_M de Ollama ocupa unos 19 GB como archivo, y la caché y el programa requieren memoria adicional. Comprueba el contexto y el reparto con ollama ps; A3B describe parámetros activados, no un presupuesto de memoria de 3B.
¿Por qué Ollama muestra menos contexto del anunciado?
El contexto máximo del archivo y el asignado al proceso son distintos. options.num_ctx permite fijar la asignación de una petición y ollama ps permite comprobarla mientras el modelo está cargado. Aumentarla consume más memoria, según la guía de contexto de Ollama.
¿Qwen3-Coder necesita generar razonamiento visible para programar?
No. Coder-30B-A3B-Instruct solo admite el modo sin bloques <think> y está orientado a código y herramientas. La corrección de un cambio se comprueba con las pruebas y requisitos del proyecto, no por la presencia de una traza de razonamiento.
Fuentes16
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 8 oct 2026.
Fuentes16
Páginas externas que cita esta guía, en el orden en que aparecen. Última actualización: 8 oct 2026.
- 1.Instruct-2507huggingface.co/Qwen/Qwen3-30B-A3B-Instruct-2507
- 2.Thinking-2507huggingface.co/Qwen/Qwen3-30B-A3B-Thinking-2507
- 3.Coderhuggingface.co/Qwen/Qwen3-Coder-30B-A3B-Instruct
- 4.ficha del originalhuggingface.co/Qwen/Qwen3-30B-A3B
- 5.etiqueta explícita Instruct-2507 de Ollamaollama.com/library/qwen3:30b-a3b-instruct-2507-q4_K_M
- 6.Coder-30B-A3Bhuggingface.co/Qwen/Qwen3-Coder-30B-A3B-Instruct/blob/main/config.json
- 7.Coder de 30Bollama.com/library/qwen3-coder:30b
- 8.documentación de pensamientodocs.ollama.com/capabilities/thinking
- 9.referencia de Modelfilegithub.com/ollama/ollama/blob/main/docs/modelfile.mdx
- 10.etiqueta predeterminada del catálogoollama.com/library/qwen3
- 11.qwen3:30b-a3bollama.com/library/qwen3:30b-a3b
- 12.qwen3:30bollama.com/library/qwen3:30b
- 13.FAQdocs.ollama.com/faq
- 14.guía de contextogithub.com/ollama/ollama/blob/main/docs/context-length.mdx
- 15.Qwen3.6-35B-A3Bhuggingface.co/Qwen/Qwen3.6-35B-A3B
- 16.Qwen3.8-27Bhuggingface.co/Qwen/Qwen3.8-27B